
Education (37) — 1/1
[Paper Note] LLM-KT: Aligning Large Language Models with Knowledge Tracing using a Plug-and-Play Instruction, Ziwei Wang+, ACL'26 Findings, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #KnowledgeTracing #ACL #Findings #KeyPoint Notes #Reading Reflections Issue Date: 2026-11-02 GPT Summary- 学生の過去の解答履歴が与えられた時に、LLMと従来の系列モデルを統合して次の問題への正答可能性を予測。LLMの知識と推論能力を活用する指示に加え、問題・概念固有トークンによる圧縮履歴と、系列モデルの行動表現をLLMに注入。4つのデータセットで約20の強力なベースラインを上回る最先端性能を達成。 Comment
学習者の学習履歴(問題ID, Knowledge Component ID, 正誤)を与え、新たな問題に対して正解するか否かをbinaryで問うpromptを用いてLoRAでFinetuningをし、この時にquestionとknowledge componentの情報として生のトークン列ではなく、embeddingを直接注入(QuestionEmbed, ConceptEdbed)することでcontext長が肥大する課題に対処する。Embeddingは問題テキスト、KCの定義のテキストから学習する場合(Semantic)と、ユーザの学習履歴のID(qid,
cid)の系列に基づいて学習する場合(Behavior)の2種類の手法を用意し、backboneとなるエンコーダを事前に用意する(どのように用意するかは細かいところまではまだよくわかっていない)。後者についてはLLMが学習している埋め込み空間と大きく異なるものが学習されているため、LLMが扱うembedding空間とalignさせるためのprojectionも学習させ、LLMに注入した際にLLMの推論が崩壊するのを防ぐ。
(LLaMA2に対して)ID列のみを与えてFinetuningする手法でも、既存研究に対してSoTAを達成できるが、LLM-KTについて、QuestionEmbed+ID列、あるいはConceptEmbed+ID列をablationした場合、それぞれについて性能が低下することから双方が性能向上に寄与することも確認。
Embeddingを直接トークンとして注入することで、contextが肥大化する課題を解決するアプローチは興味深い。実用上はOpenAIのFinetuning APIなどではここまでの作り込みはできなさそうなので、OpenWeightモデルに対してこのような改良を施しservingをする制約が生じる。また、LLaMA2をベースとしたLLM-FT_IDでここまで性能が向上するのであれば、より強力なプロプライエタリモデルをベースとして学習をしたら、性能はどこまで伸びるのだろうか。
[Paper Note] ExaGPT: Example-Based Machine-Generated Text Detection for Human Interpretability, Ryuto Koike+, ACL'26 Findings, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #ACL #Findings #AI Detector #Interpretability Issue Date: 2026-07-12 GPT Summary- LLM生成テキストの検出は、決定の解釈可能性を重要視し、利用者が予測の正確さを評価できるようにする必要がある。従来の手法は人間の判断プロセスに沿った証拠を提供できておらず、このギャップを解消するためにExaGPTを提案。ExaGPTは、人間作成とLLM生成テキストの類似スパンを比較することで識別し、具体的な証拠を示すことで決定の正しさを向上させる。広範な実験により、ExaGPTは従来手法より精度を最大37.0ポイント向上させることが確認された。 Comment
元ポスト:
人間が作成したテキストとLLMが生成したテキストのスパンごとの類似性を見ることで、与えられたテキストがLLM生成か否かを判定する。データストア中の類似したスパンが判断のevidenceとなる、という話に見える。
こういった話は教育の文脈でも需要がある
[Paper Note] Cognitive Episodes in LLM Reasoning Traces Enable Interpretable Human Item Difficulty Prediction, Chenguang Wang+, arXiv'26, 2026.06
Paper/Blog Link My Issue
#LanguageModel #read-later #ItemDifficultyPrediction Issue Date: 2026-07-08 GPT Summary- 教育評価におけるアイテム難易度予測は重要であり、信頼性が公平性と効果的なテスト作成に寄与する。従来の方法は高コストな校正や制限された証拠に依存している。難易度はアイテムのテキストや問題解決の負担として捉えるべきとし、大規模推論モデル(LRMs)を通じてスケーラブルな証拠を提供する新しいフレームワーク「Epi2Diff」を提案。これにより、推論痕跡をエピソードにマッピングし、難易度のモデル化を実現する。実験結果はEpi2Diffが複数のベースラインを超え、特に難易度の高いアイテムにおいては努力を要するプロセスが観察されることを示した。これにより、LRM推論痕跡が人間のアイテム難易度を予測する新しい視点を提供する。 Comment
元ポスト:
[Paper Note] AutoCode: LLMs as Problem Setters for Competitive Programming, Shang Zhou+, arXiv'25, 2025.09
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #Evaluation #Coding #read-later #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-10-18 GPT Summary- AutoCodeは、競技プログラミングの問題文とテストケースを生成するシステムであり、信頼性の高い問題作成を実現します。複数回の検証を通じて、生成された問題は公式の判断と99%の一貫性を持ち、従来の手法に比べて大幅な改善を示します。また、ランダムなシード問題から新しいバリアントを作成し、不正な問題をフィルタリングする機能も備えています。最終的に、AutoCodeはグランドマスター級の競技プログラマーによってコンテスト品質と評価される問題を生成します。 Comment
blog: https://livecodebenchpro.com/projects/autocode/overview
LLMで自動的に高品質な競技プログラミング問題とそのテストケースを生成するパイプラインを提案。
信頼性のあるテストケースを作成するために、Validator-Generator-Checkerフレームワーク。提案。Generatorがテストケースを生成し、Validatorが生成されたテストケースの入力が問題の制約を満たしているか判定し、Checkerが与えられたテストケースの元で解法が正しいかを確認する。
続いて、人手を介さずとも生成される問題が正しいことを担保するためにdual-verificationを採用。具体的には、LLMに新規の問題文と効率的な解法を生成させ、加えてブルートフォースでの解法を別途生成する。そして、両者をLLMが生成したテストセット群で実行し、全ての解放で出力が一致した場合のみAcceptする、といったような手法らしい。
(手法の概要としてはそうなのだろうが、細かい実装に高品質さの肝があると思うのでしっかり読んだ方が良さげ。特にTest Generationの詳細をしっかりできていない)
takeawayで興味深かったのは、
- LLMは自身では解けないが、解法が存在する(solvable)問題を生成できること
- 人間の専門家とLLM(o3)の間で、問題の品質の新規性の判定の相関がわずか0.007, 0.11しかなかったこと。そして品質に関しては専門家のグループ間では0.71, o3とgpt4oの間では0.72と高い相関を示しており、LLMと人間の専門家の間で著しく問題の品質の判断基準が異なること
- seed問題と生成された問題の難易度のgainが、問題の品質に関して、LLM自身のself-evaluationよりもより良い指標となっていること
BIPED: Pedagogically Informed Tutoring System for ESL Education, Kwon+, ACL'24, 2024.08
Paper/Blog Link My Issue
#ACL Issue Date: 2025-01-06 GPT Summary- 大規模言語モデル(LLMs)を用いた会話型インテリジェントチュータリングシステム(CITS)は、英語の第二言語(L2)学習者に対して効果的な教育手段となる可能性があるが、既存のシステムは教育的深さに欠ける。これを改善するために、バイリンガル教育的情報を持つチュータリングデータセット(BIPED)を構築し、対話行為の語彙を考案した。GPT-4とSOLAR-KOを用いて二段階のフレームワークでCITSモデルを実装し、実験により人間の教師のスタイルを再現し、多様な教育的戦略を採用できることを示した。
LearnLM: Improving Gemini for Learning, LearnLM Team+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #EducationalDataMining Issue Date: 2024-12-31 GPT Summary- 生成AIシステムは従来の情報提示に偏っているため、教育的行動を注入する「教育的指示の遵守」を提案。これにより、モデルの振る舞いを柔軟に指定でき、教育データを追加することでGeminiモデルの学習を向上。LearnLMモデルは、さまざまな学習シナリオで専門家から高く評価され、GPT-4oやClaude 3.5に対しても優れた性能を示した。
Covering Uncommon Ground: Gap-Focused Question Generation for Answer Assessment, ACL'23
Paper/Blog Link My Issue
#NLP #EducationalDataMining #QuestionGeneration #ACL Issue Date: 2023-07-15 GPT Summary- 本研究では、教育的な対話における情報のギャップに焦点を当て、自動的に質問を生成する問題に取り組んでいます。良い質問の要素を明確にし、それを満たすモデルを提案します。また、人間のアノテーターによる評価を行い、生成された質問の競争力を示します。
Adaptive and Personalized Exercise Generation for Online Language Learning, ACL'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #AdaptiveLearning #KnowledgeTracing #Personalization #QuestionGeneration #ACL Issue Date: 2023-07-14 GPT Summary- 本研究では、オンライン言語学習のための適応的な演習生成の新しいタスクを研究しました。学習履歴から学生の知識状態を推定し、その状態に基づいて個別化された演習文を生成するモデルを提案しました。実データを用いた実験結果から、学生の状態に応じた演習を生成できることを示しました。さらに、教育アプリケーションでの利用方法についても議論し、学習の効率化を促進できる可能性を示しました。 Comment
Knowledge Tracingで推定された習熟度に基づいて、エクササイズを自動生成する研究。KTとNLGが組み合わさっており、非常におもしろい。
[Paper Note] Generative AI for Programming Education: Benchmarking ChatGPT, GPT-4, and Human Tutors, Tung Phung+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 入門プログラミング教育における生成型AIと大規模言語モデルの活用を評価。ChatGPT(GPT-3.5)とGPT-4を様々なシナリオで人間のチューターと比較し、GPT-4がChatGPTを大幅に上回り、一部のシナリオでは人間に近づく結果に。これにより、今後の性能向上のための研究の方向性が示される。 Comment
GPT4とGPT3.5をプログラミング教育の文脈で評価したところ、GPT4AGPT3.5をoutperformし、人間のチューターに肉薄した。
[Paper Note] A Review of ChatGPT Applications in Education, Marketing, Software Engineering, and Healthcare: Benefits, Drawbacks, and Research Directions, Mohammad Fraiwan+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#Survey #ChatGPT Issue Date: 2023-05-04 GPT Summary- ChatGPTは深層学習を用いた人間のようなテキスト応答生成AIであり、2022年11月の登場以降、強力な能力と多様な応用、さらには悪用のリスクで注目を集めている。最近ではGoogle BardやMeta LLaMAなどの競合モデルも登場し、教育や医療、マーケティングなどの分野での変革が期待されている。本論文ではAI言語モデルの概略、応用、限界、今後の研究の方向性について考察する。
[Paper Note] AI, write an essay for me: A large-scale comparison of human-written versus ChatGPT-generated essays, Steffen Herbold+, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel #AES(AutomatedEssayScoring) #ChatGPT #One-Line Notes Issue Date: 2023-04-28 GPT Summary- ChatGPTが生成したエッセイは、人間が書いたものよりも質が高いと評価されることが大規模な研究で示された。生成されたエッセイは独自の言語的特徴を持ち、教育者はこの技術を活用する新たな教育コンセプトを開発する必要がある。 Comment
ChatGPTは人間が書いたエッセイよりも高品質なエッセイが書けることを示した。
また、AIモデルの文体は、人間が書いたエッセイとは異なる言語的特徴を示している。たとえば、談話や認識マーカーが少ないが、名詞化が多く、語彙の多様性が高いという特徴がある、とのこと。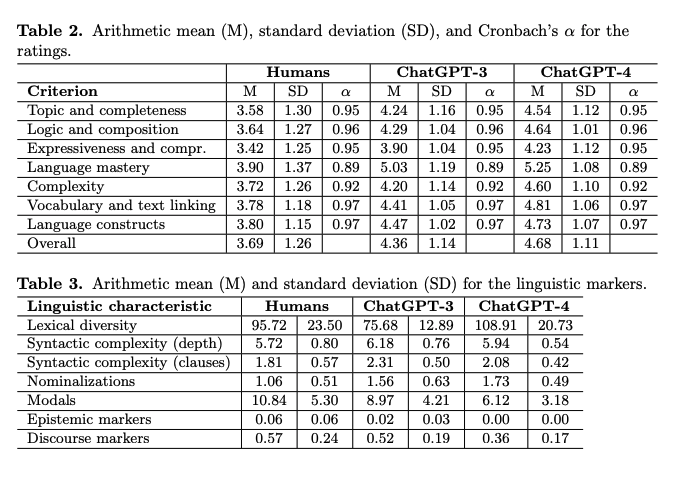
[Paper Note] Controlled Language Generation for Language Learning Items, Kevin Stowe+, EMNLP'22 Industry Track, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #Controllable #NLP #EMNLP #Encoder-Decoder #IndustryTrack Issue Date: 2026-01-16 GPT Summary- 自然言語生成を活用し、英語学習アプリ向けに迅速に教材を生成。深層事前学習モデルを用いて、熟達度に応じた多様な文や文法テストの引数構造を制御する新手法を開発。人間評価では高い文法スコアを得て、上級モデルは基準を超える長さと複雑さを実現。多様で特注のコンテンツを提供し、強力なパフォーマンスを示す。
Reinforcement Learning for the Adaptive Scheduling of Educational Activities, Bassen+, Stanford University, CHI'20
Paper/Blog Link My Issue
#AdaptiveLearning #EducationalDataMining Issue Date: 2022-12-27
Machine Learning–Driven Language Assessment, LaFlair+, TACL'20
Paper/Blog Link My Issue
#NLP #Assessment #IRT Issue Date: 2022-11-25
GRAPH-BASED KNOWLEDGE TRACING: MODELING STUDENT PROFICIENCY USING GRAPH NEURAL NETWORK, Nakagawa+, Tokyo University, WI'19
Paper/Blog Link My Issue
#NeuralNetwork #GraphConvolutionalNetwork #EducationalDataMining #KnowledgeTracing #WI #One-Line Notes Issue Date: 2021-07-08 Comment
graph neural networkでKnoelwdge Tracingした論文。各conceptのproficiencyの可視化までしっかりやってそう。
[Paper Note] A SURVEY OF ARTIFICIAL INTELLIGENCE TECHNIQUES EMPLOYED FOR ADAPTIVE EDUCATIONAL SYSTEMS WITHIN E-LEARNING PLATFORMS, Almohammadi+, JAISCR'17, 2017.01
Paper/Blog Link My Issue
#RecommenderSystems #Survey Issue Date: 2018-03-30
[Paper Note] A Survey on Artificial Intelligence and Data Mining for MOOCs, Simon Fauvel+, arXiv'16, 2016.01
Paper/Blog Link My Issue
#RecommenderSystems #Survey #TechnologyEnhancedLearning Issue Date: 2018-03-30 GPT Summary- MOOCsは人気を集めており、AIとデータマイニングがその発展に寄与している。データを活用することで、MOOCの理解を深め、学習者の体験を向上させることが可能。論文では、AIとDMの最新研究をレビューし、学生のエンゲージメントや学習成果を向上させる技術を強調。さらに、MOOCsの潜在能力を引き出すための重要な研究課題とトレンドを示す。
[Paper Note] Personalized Mathematical Word Problem Generation, Polozov+, IJCAI'15
Paper/Blog Link My Issue
#NLP #PersonalizedGeneration #Personalization #QuestionGeneration #IJCAI Issue Date: 2019-10-11
[Paper Note] Adaptive Educational HypermediaSystems in Technology Enhanced Learning: A Literature Review, Mulwa+, SIGITE'10, 2010.10
Paper/Blog Link My Issue
#Survey #TechnologyEnhancedLearning Issue Date: 2018-03-31 Comment
よさげ
Introducing &Tutor Training better tutors with better learners, humans&, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Proprietary #Author Thread-Post #Tutor Issue Date: 2026-11-01 Comment
元ポスト:
TutorMoments‑Preview: When Help is Unhelpful — Evaluating AI Tutors for Productive Struggle, Ai2, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #Blog #reading #KeyPoint Notes #Reading Reflections #Open-endedTasks #Author Thread-Post Issue Date: 2026-10-13 Comment
元ポスト:
学生に数学を教えるシチュエーションにおいて、学生に理解を手助けするためのscaffoldingを実施すべき場面がか、あるいはより思考を深めさせるのが適切な場面か、をモデルが適切に判断した上でtutoringできるかを測定するためのアノテーションデータを構築。アノテーションデータでは実際の教員がsession dataに対してアノテーション(Key Learning Momentの場面と、LLMがReplayを始めるべきCut Point, なぜこの瞬間が鍵となるlearning momentなのか、人間のtutorがどのようなアクションを取ったか、アクションの効果などを自由記述)しすることで構築し、LLMによって、Push for Rigor Moment, Scaffolding Moment, Over-Scaffold Moment S/A/Rラベル)3種類のラベルを付与することで正解データを作成。
LM TutorはCut Pointまでの全てのcontextを与えられた上で、tutoringをsynthetic studentに対して実施(LM Tutor 3ターン、synthetic student 2ターン)、これらのターンに基づいて判断をするLLMが、LM Tutorのtutoringに対してS/A/Rラベルを同様に付与し、正解ラベルとのAlignmentを測定することで評価(Figure 1)。
LM Tutorに"tutor well."と指示するだけではスコアリングが低く、明示的にtutoringに関するinstructionを加えたらスコアが大幅に向上。
前提として、今回のような正解が一つに定まらないOpen-endedなタスクについて評価するのは非常に難しく、特定ドメインにおいて、LLMが少なくとも人間の専門家と同じような挙動を実現できるかという観点で見ると、
- LLMがパラメータに内在化している世界知識と能力はだけでは限界があり、
- 明示的な行動指針をinstructionとして書き起こせるのであれば、専門家にAlignした行動をとることができるようになってきている
という話なのかなと思う。
正解を定義して外部のverifierが判定できるようなタスクについては、現在のRLVRのような枠組みとEnvironmentがスケールすればかなり広範まで正確にできるようになるだろうな、という見通しは立つが、Open-endedなタスクにおいては課題が残っている状態と言える。
また、今回のtutoringによる評価では人間が言葉でノウハウを書き起こせたが、そのような明文化されたノウハウは必ずしも存在しているわけではなく、かつ必ずしも明示的に書き起こせるわけではないと考えられる。今回はinstructionとして明文化することでスコアが向上しているが、そもそも後者の場合はどうするのか、という課題も残る。
TutorMoments: Do AI tutors know when to help and when to hold back?, Ai2, 2026.08
Paper/Blog Link My Issue
#Article #Blog #read-later #Author Thread-Post Issue Date: 2026-08-10 Comment
元ポスト:
OpenMAIC, THU-MAIC, 2026.03
Paper/Blog Link My Issue
#Article #Multi #Tools #NLP #LanguageModel #AdaptiveLearning #AIAgents #Repository #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-03-17 Comment
マルチエージェントによってスケーラブル、adaptiveにオンライン教育を実現するフレームワークのようである
元ポスト:
How AI assistance impacts the formation of coding skills, Anthropic, 2026.01
Paper/Blog Link My Issue
#Article #Analysis #AIAgents #Coding #SoftwareEngineering #read-later #KeyPoint Notes Issue Date: 2026-01-30 Comment
コーディングエージェントを使うことによる新しいスキルの習熟に対する影響の調査。エージェントを使ったグループは平均的に早く仕事を終えたが、その後のクイズによる習熟度のテストでは17パーセント低いスコアとなりエージェントを使わなかったグループと比較して習熟度に差が生まれた。しかしエージェントを使って早く終えたにも関わらず習熟度も相対的に低くならなかった人々がいて、そのような人たちはただエージェントに頼るのではなく、コードのコンセプトや理解をするための質問を投げかけている、といった使い方に関する違いが見受けられた、といった話に見える。
Designing AI-resistant technical evaluations, Anthropic, 2026.01
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #read-later #Selected Papers/Blogs #Initial Impression Notes #Testing Issue Date: 2026-01-22 Comment
元ポスト:
Anthropicの採用における持ち帰り課題の変遷に関する記事。昔の持ち帰り課題では、応募者の大半よりもClaudeが上回るようになり採用におけるシグナルが拾いづらくなったのでリデザインが必要になった、そしてそれをどう変化させたか、といった話のようである。これは採用の話だがtestingという広い文脈で捉えるとかなり参考になる話に見える。
Claudeを作っている会社が自社が作ったプロダクトによって採用で苦しむという構造になっており、それに対してどのように対処したかという話題は非常に興味深いトピックだと感じる。
veAgentBench, ByteDance, 2025.11
Paper/Blog Link My Issue
#Article #NLP #Dataset #AIAgents #Evaluation #Financial #Legal Issue Date: 2025-11-26 Comment
元ポスト:
LLMは教育をどう変えるか:主要3社の「学習モード」比較考察, Kawamoto, 2025.08
Paper/Blog Link My Issue
#Article #LanguageModel Issue Date: 2025-08-31 Comment
元ポスト:
Towards personalized summaries in spanish based on learning styles theory, Uriel+, Res. Comput. Sci. 148.5, 1
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #NLP #Personalization Issue Date: 2023-05-05
Personalized Text Content Summarizer for Mobile Learning: An Automatic Text Summarization System with Relevance Based Language Model, Guangbing+, IEEE Fourth International Conference on Technology for Education, 2012, 22
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #NLP #Personalization Issue Date: 2023-05-05
Exploring the Potential of Using an AI Language Model for Automated Essay Scoring, Mizumoto+, Research Methods in Applied Linguistics‘23
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AES(AutomatedEssayScoring) #Author Thread-Post Issue Date: 2023-04-01 Comment
著者によるポスト:
著者によるブログ:
https://mizumot.com/lablog/archives/1805
Score Prediction dataset
Paper/Blog Link My Issue
#Article #Dataset #AdaptiveLearning #EducationalDataMining #ScorePrediction #KeyPoint Notes #Reference Collection Issue Date: 2022-08-23
[Paper Note] Panorama of recommender systems to support learning, Drachsler+, 2015.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #AdaptiveLearning #One-Line Notes Issue Date: 2018-12-22 Comment
教育分野に対するRecsysのSurvey
[Paper Note] Recommender Systems in Technology Enhanced Learning, Manouselis+, Recommender Systems Handbook, 2011.10
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #TechnologyEnhancedLearning #AdaptiveLearning Issue Date: 2018-12-22
[Paper Note] Personal recommender systems for learners in lifelong learning networks: the requirements, techniques and model, Drachsler+, Int. J. Learning Technology 3(4), 2008.07
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #AdaptiveLearning Issue Date: 2018-12-22
[Paper Note] LEARNING AND TEACHING STYLES IN ENGINEERING EDUCATION, Felder, Engr. Education, 78(7), 674–681, 1988.01
Paper/Blog Link My Issue
#Article #Classic #AdaptiveLearning #LearningStyle #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-12-22 Comment
LearningStyleに関して研究している古典的な研究。
context-aware recsysの研究初期の頃は、だいたいはこのFelder-Silverman Theoryというのをベースに研究されていたらしい。
[Paper Note] Recommender Systems in Technology Enhanced Learning, Manouselis+, Recommender Systems Handbook: A Complete Guide for Research Scientists and Practitioners, 2011.10
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #TechnologyEnhancedLearning Issue Date: 2018-03-30
[Paper Note] Context-Aware Recommender Systems for Learning: A Survey and Future Challenges, Verbert+, IEEE TRANSACTIONS ON LEARNING TECHNOLOGIES, VOL. 5, NO. 4, OCTOBER-DECEMBER 2012.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #TechnologyEnhancedLearning Issue Date: 2018-03-30