
One-Line Notes (1219) — 6/7
Agent Frameworkはどれを使うべきか [タスク性能編], はち, 2025.05
Paper/Blog Link My Issue
#Article #Analysis #NLP #Library #AIAgents #Blog #Author Thread-Post Issue Date: 2025-05-06 Comment
各フレームワーク毎の性能の違いや消費したトークン数、実装の微妙や違いがまとめられており、太字でtakeawayが記述されているので非常にわかりやすい。
元ポスト:
parakeet-tdt-0.6b-v2, Nvidia, 2025.05
Paper/Blog Link My Issue
#Article #SpeechProcessing #AutomaticSpeechRecognition(ASR) #OpenSource Issue Date: 2025-05-06 Comment
元ポスト:
2025.05.06時点でOpenASR Leaderboardでトップ:
https://huggingface.co/spaces/hf-audio/open_asr_leaderboard
Already supports Nvidia Parakeet
Simultaneously supporting Linux/Windows/macOS
https://github.com/patui/Nosub
React がビルドされるまでの流れを理解したい, ツチノコ, 2023.12
Paper/Blog Link My Issue
#Article #Blog #Frontend #React (Frontend) Issue Date: 2025-05-01 Comment
Reactがビルドされる流れは、
- Webpackでバンドル(アセットをまとめる)し
- Babelでトランスパイルし(ES5(古い仕様のJS) に変換)し
- tscでJavaScriptに変換
する
Deepwiki, Cognition, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Repository Issue Date: 2025-04-26 Comment
githubリポジトリに関するリッチなドキュメントに対してDevinを通じて対話的に質問ができる模様。サインアップ不要で、githubリポジトリのドメインをdeepwikiに変えるだけで利用可能
Fiction.liveBench, Kas, 2025.04
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #LongContext Issue Date: 2025-04-09 Comment
long contextではGemini-2.5-proの圧勝
BFCLv2, UC Berkeley, 2024.08
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #API #Selected Papers/Blogs #ToolUse Issue Date: 2025-04-08 Comment
LLMのTool Useを評価するための現在のデファクトスタンダードとなるベンチマーク
BFCLv3:
https://gorilla.cs.berkeley.edu/blogs/13_bfcl_v3_multi_turn.html
Dream-v0-Instruct-7B, Dream-org, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DiffusionModel #OpenWeight Issue Date: 2025-04-08 Comment
OpenWeightな拡散言語モデル
元ポスト:
関連:
- [Paper Note] Large Language Diffusion Models, Shen Nie+, NeurIPS'25
Llama 4 Series, Meta, 2025.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #OpenWeight #Reference Collection Issue Date: 2025-04-05 Comment
Huggingface:
https://huggingface.co/collections/meta-llama/llama-4-67f0c30d9fe03840bc9d0164
解説ポスト:
Artificial Analysisによる性能検証:
MaverickがGPT4oと同等、ScoutがGPT4o-miniと同等
Update:
性能に関して不可解な点が多そうなので様子見をしても良いかも。
性能検証(Math-Perturb):
日本語にあまり強くないという情報も
元ポスト:
どうやらvLLMのLlama4のinferenceにバグがあったやうで、vLLMのIssue 16311にて、Llama4のinferenceに関するバグが修正され、性能が向上した模様。どのベンチを信じたら良いかまるでわからん。
2025.0413現在のchatbot arenaのランクは、32位となり(chatbot arena向けにtuningされていたであろうモデルは2位だった)GPT-4oが29位であることを考慮すると上記のArtificial Intelligenceの評価とも大体一致している。
https://lmarena.ai
関連ポスト:
openhands-lm-32b-v0.1, all-hands, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #SoftwareEngineering Issue Date: 2025-04-02 Comment
Qwen Coder 2.5 Instruct 32Bに基づく最先端のSWEタスクが実行可能なモデル
Nemotron-H: A Family of Accurate, Efficient Hybrid Mamba-Transformer Models, Nvidia, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #Supervised-FineTuning (SFT) #MultiModal #Blog #SSM (StateSpaceModel) #Selected Papers/Blogs Issue Date: 2025-03-24 Comment
関連:
- Hunyuan T1, Tencent, 2025.03
TransformerのSelf-attention LayerをMamba2 Layerに置換することで、様々なベンチマークで同等の性能、あるいは上回る性能で3倍程度のInference timeの高速化をしている(65536 input, 1024 output)。
56B程度のmediumサイズのモデルと、8B程度の軽量なモデルについて述べられている。特に、8BモデルでMambaとTransformerのハイブリッドモデルと、通常のTransformerモデルを比較している。学習データに15 Trillion Tokenを利用しており、このデータ量でのApple to Appleのアーキテクチャ間の比較は、現状では最も大規模なものとのこと。性能は多くのベンチマークでハイブリッドにしても同等、Commonsense Understandingでは上回っている。
また、学習したNemotron-Hをバックボーンモデルとして持つVLMについてもモデルのアーキテクチャが述べられている。
The "think" tool: Enabling Claude to stop and think in complex tool use situations, Anthropic, 2025.03
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Chain-of-Thought #Blog #Reasoning Issue Date: 2025-03-23 Comment
"考える"ことをツールとして定義し利用することで、externalなthinkingを明示的に実施した上でタスクを遂行させる方法を紹介している
Hunyuan T1, Tencent, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #Proprietary #SSM (StateSpaceModel) #Reading Reflections Issue Date: 2025-03-22 Comment
元ポスト:
画像はブログより引用。DeepSeek-R1と比較すると優っているタスクと劣っているタスクがあり、なんとも言えない感。GPT4.5より大幅に上回っているタスク(Math, Reasoning)があるが、そもそもそういったタスクはo1などのreasoningモデルの領域。o1と比較するとこれもまあ優っている部分もあれば劣っている部分もあるという感じ。唯一、ToolUseに関しては一貫してOpenAIモデルの方が強い。
ChineseタスクについてはDeepSeek-R1と完全にスコアが一致しているが、評価データのサンプル数が少ないのだろうか?
reasoningモデルかつ、TransformerとMambaのハイブリッドで、MoEを採用しているとのこと。
TransformerとMambaのハイブリッドについて(WenhuChen氏のポスト):
Layer-wise MixingとSequence-wise Mixingの2種類が存在するとのこと。前者はTransformerのSelf-Attenton LayerをMamba Layerに置換したもので、後者はSequenceのLong partをMambaでまずエンコードし、Short PartをTransformerでデコードする際のCross-Attentionのencoder stateとして与える方法とのこと。
Self-Attention Layerを削減することでInference時の計算量とメモリを大幅に削減できる(Self-Attentionは全体のKV Cacheに対してAttentionを計算するため)。
EXAONE-Deep-32B, LG AI Research, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight Issue Date: 2025-03-18 Comment
元ポスト:
EXAONE AI Model License Agreement 1.1 - NC
商用利用不可
SmolDocling-256M, IBM Research, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #OpenWeight #DocParser #Author Thread-Post Issue Date: 2025-03-18 Comment
Apache-2.0ライセンス。言語はEnglishのみな模様
マルチモーダルなImage-To-Textモデル。サンプルはこちら
ERNIE4.5_X1, Baidu, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #OpenWeight #Proprietary #Reference Collection #Author Thread-Post Issue Date: 2025-03-17 Comment
解説ポスト:
- ERNIE4.5はGPT4.5をさまざまなベンチマークで上回り、価格がなんとGPT4.5の1%
- X1はマルチモーダルなreasoningモデルでDeepSeek-R1と同等の性能で半額
らしい
このモデルは6月30日にオープン(ウェイト?)になるとスレッドで述べられている。
Introducing Gemma 3: The most capable model you can run on a single GPU or TPU, Google, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Reference Collection Issue Date: 2025-03-12 Comment
Googleの新たなSLMで、デバイスやラップトップでも動作可能な軽量モデル。テキストだけでなく画像とShortVideoの認識もできて、140言語をサポート。おまけに27BモデルでLlama3-405BとDeepSeek-V3とo3-miniをChatbotArenaのリーダーボードで上回り、128kのcontext window。えぇ…。
モデルの詳細:
https://huggingface.co/blog/gemma3
1Bモデルは英語のみサポート、マルチモーダル不可など制約がある模様。
詳細までは書いていないが、128Kコンテキストまでcontext windowを広げる際の概要とRoPE(のような)Positional Embeddingを利用していること、SlideingWindow Attentionを用いておりウィンドウサイズが以前の4096から性能を維持したまま1024に小さくできたこと、ImageEncoderとして何を利用しているか(SigLIP)、896x896の画像サイズをサポートしており、正方形の画像はこのサイズにリサイズされ、正方形でない場合はcropされた上でリサイズされる(pan and scanアルゴリズムと呼ぶらしい)こと、事前学習時のマルチリンガルのデータを2倍にしたことなど、色々書いてある模様。
Gemmaライセンス
解説ポスト:
解説ポスト:
GRPO Judge Experiments: Findings & Empirical Observations, kalomaze's kalomazing blog, 2025.03
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #LanguageModel #ReinforcementLearning #Blog #GRPO #Subjective Issue Date: 2025-03-05 Comment
一意に解が決まる問題ではなく、ある程度の主観的な判断が必要なタスクについてのGRPOの分析。
2つのテキストを比較するタスクで、一方のタスクはLLMによって摂動を与えている(おそらく意図的にcorruptさせている)。
GRPOではlinearやcosineスケジューラはうまく機能せず、warmupフェーズ有りの小さめの定数が有効らしい。また、max_grad_normを0.2にしまgradient clippingが有効とのこと。
他にもrewardの与え方をx^4にすることや、length, xmlフォーマットの場合にボーナスのrewardを与えるなどの工夫を考察している。
The Ultra-Scale Playbook: Training LLMs on GPU Clusters, HuggingFace, 2025.02
Paper/Blog Link My Issue
#Article #Pretraining #MachineLearning #LanguageModel #Supervised-FineTuning (SFT) #Selected Papers/Blogs Issue Date: 2025-03-04 Comment
HuggingFaceによる数1000のGPUを用いたAIモデルのトレーニングに関するオープンソースのチュートリアル
Introducing the SWE-Lancer benchmark, OpenAI, 2025.02
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #Coding #SoftwareEngineering Issue Date: 2025-03-02 Comment
元ポスト:
1400以上のフリーランスソフトウェアエンジニアリングタスクを集めたベンチマーク。タスクはバグ修正から機能実装まで多岐にわたり、経験豊富なエンジニアによって評価されたもの。
DeepScaleR: Surpassing O1-Preview with a 1.5B Model by Scaling RL, Luo+, 2025.02
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #ContextWindow #Blog Issue Date: 2025-02-12 Comment
日本語解説: https://jobirun.com/deepscaler-1-5b-surpasses-o1-preview-rl-scaling/
openreview:
https://openreview.net/forum?id=I6GzDCne7U
Iterative Context Lengtheningと呼ばれる、RLの学習時に最初から固定された大きなcontext(24Kなど)ではなく、学習の過程で小さなcontext windowから始め、効率的なreasoningを学習させながら、段階的にモデルのcontext windowを引き上げる手法(論文中では8K->16K->24K)を提案している。
SGlang, sgl-project, 2024.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #LLMServing #SoftwareEngineering #Selected Papers/Blogs #Reference Collection Issue Date: 2025-02-12 Comment
- Open R1, HuggingFace, 2025.01
のUpdate2でMath Datasetの生成に利用されたLLM Servingフレームワーク。利用前と比較してスループットが2倍になったとのこと。
CPU, external storageを利用することでTTFTを改善するようになったようで、最大80%TTFTが削減されるとの記述がある。
(原理的には元来可能だが計算効率の最適化に基づく誤差によって実装上の問題で実現できていなかった) Deterministic Inferenceをサポート:
Open R1, HuggingFace, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #Reasoning #OpenSource #Selected Papers/Blogs #Reference Collection Issue Date: 2025-01-26 Comment
HFによるDeepSeekR1を完全に再現する取り組み
Update1: https://huggingface.co/blog/open-r1/update-1
Update2:
https://huggingface.co/blog/open-r1/update-2
512機のH100を利用…
LLM Datasets, mlabonne, 2025.01
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Supervised-FineTuning (SFT) #Repository #PostTraining #Selected Papers/Blogs Issue Date: 2025-01-25 Comment
LLMの事後学習用のデータをまとめたリポジトリ
現在も更新されている。
Llama Stack, Meta, 2024.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #AIAgents #RAG(RetrievalAugmentedGeneration) Issue Date: 2025-01-25 Comment
Llamaを用いたLLM Agentを構築するための標準化されたフレームワーク。Quick StartではRAG Agentを構築している。
distilabel, 2023.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #SyntheticData Issue Date: 2025-01-25 Comment
高品質な合成データをLLMで生成するためのフレームワーク
How to fine-tune open LLMs in 2025 with Hugging Face, PHILSCHMID, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #python #Blog #SoftwareEngineering #PostTraining Issue Date: 2025-01-25 Comment
SFTTrainerを用いたLLMのSFTについて、実用的、かつ基礎的な内容がコード付きでまとまっている。
Structured Outputs OpenAI Platform, 2025.01
Paper/Blog Link My Issue
#Article #LanguageModel #Chain-of-Thought #python #StructuredData Issue Date: 2025-01-25 Comment
pydanticを用いて、CoT+構造化されたoutputを実施するサンプル
Killed by LLM, R0bk
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Dataset #LanguageModel #Evaluation #Blog Issue Date: 2025-01-05 Comment
Saturationとなっているベンチマークは、最先端の性能をすでに測定できなくなってしまったベンチマークとのこと。
LLMによって性能が飽和したベンチマークをリストアップしているサイトで、2024年までのものが掲載されている。それ以後は掲載されていないようだ。
Advanced RAG Techniques: Elevating Your Retrieval-Augmented Generation Systems, NirDiamant, 2025.01
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #Repository #Selected Papers/Blogs Issue Date: 2025-01-05 Comment
元ポスト:
RAGのための細かなテクニックが(コードのサンプルへのリンク付きで)大量にまとまっている。かなり頻繁に更新れているようで非常に良さそう
まだ更新されている。
pydantic-settingsで環境変数からもオプション引数を指定できるCLIを作る 〜サブコマンド篇〜, nikkie-ftnextの日記, 2025.01
Paper/Blog Link My Issue
#Article #python #Blog Issue Date: 2025-01-04 Comment
pydantic-settingsを使ったCLI作成に関する記事。環境変数からオプションを指定できるので、コマンドライン引数を動的に柔軟に変更したい場合に便利そう
LiteLLM, BerriAI, 2023.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #python #API Issue Date: 2025-01-03 Comment
様々なLLMのAPIを共通のインタフェースで呼び出せるライブラリ
- aisuite, andrewyng, 2024.11
とどちらがいいんだ・・・?
aisuiteのissueの113番のスレッドを見ると、
- LiteLLMはもはやLiteではなくなっており、コードベースの保守性が低い
- aisuiteは複数のLLMプロバイダーをシンプルに利用する方法を提供する
- 今後発表されるロードマップを見れば、LiteLLMとの差別化の方向性が分かるはずだ
といった趣旨のことが記述されていた。
v1.82.7--v1.82.8において、機密情報を漏洩させるマルウェアが仕込まれていたとのこと。
Karpathy氏の所見:
2024-ai-timeline, reach-vb, 2025.01
Paper/Blog Link My Issue
#Article #Survey #ComputerVision #NLP #LanguageModel #OpenWeight #Proprietary Issue Date: 2025-01-02 Comment
月別で2024年にリリースされた主要なLLM(マルチモーダルなLLMも含む)のタイムラインがまとめられている。
API Only(プロプライエタリ)なのか、OpenWeightなのかもタグ付けされている。
floret, explosion, 2021
Paper/Blog Link My Issue
#Article #NeuralNetwork #Embeddings #Word #Library #RepresentationLearning #Repository Issue Date: 2024-12-28 Comment
fasttextを拡張したもの。本家fasttextがアーカイブ化してしまったので、代替手段に良さそう。
元ポスト:
Stanford CS229 I Machine Learning I Building Large Language Models (LLMs), StanfordUnivercity, 2024.09
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #Video Issue Date: 2024-12-25 Comment
スタンフォード大学によるLLM構築に関する講義。事前学習と事後学習両方ともカバーしているらしい。
OpenAI o3は,人間とは全く異質の汎用知能である危険性【東大解説】, 神楽坂やちま, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #GenerativeAI #Blog #Reading Reflections Issue Date: 2024-12-24 Comment
様々な有識者の見解をまとめつつ、文献を引用しつつ、かつ最終的に「人間が知能というものに対してなんらかのバイアスを持っている」可能性がある、という話をしており興味深い。
一部の有識者はARC-AGIの一部の、人間なら見た瞬間に分かるようなパターン認識の問題でも解けていないことから、AGIではないと主張しているとのことだったが、人間目線で簡単な問題が解けることはAGIとして必須な条件ではないよね、といった話が書かれており、そもそも有識者がどのようなものさしや観点でAGIを見ているのか、どういう視点があるのか、ということが感覚的に分かる内容であり、おもしろかった。
しかし、そもそも何がどうなったらAGIが実現できたと言えるのだろうか?定義がわからない(定義、あるのか…?)
完全にオープンな約1,720億パラメータ(GPT-3級)の大規模言語モデル 「llm-jp-3-172b-instruct3」を一般公開 ~GPT-3.5を超える性能を達成~ , NII, 2024.12
Paper/Blog Link My Issue
#Article #Tools #NLP #Dataset #LanguageModel #Blog #OpenWeight #Japanese #OpenSource #Selected Papers/Blogs Issue Date: 2024-12-24 Comment
GPT3.5と同程度のパラメータ数のコーパス、モデル、ツール、全てを公開。学習データまで含めてオープンなモデルとしては世界最大規模とのこと。
Instructionチューニング済みのモデルはライセンスを読むと、ライセンスに記述されている内容を遵守すれば、誰でも(日本人なら18歳以上とかはあるが)アクセス可能、用途の制限(商用・非商用問わず)なく利用でき、かつ再配布や派生物の生成などが許されているように見える。
が、baseモデルの方はコンタクト情報を提供のうえ承認を受けないと利用できない模様。また、再配布と一部の使途に制限がある模様。
SNSではオープンソースではないなどという言説も出ており、それはbaseモデルの方を指しているのだろうか?よくわからない。
実用上はinstructionチューニング済みのモデルの方がbaseモデルよりも使いやすいと思うので、問題ない気もする。
やはりbaseとinstructでライセンスは2種類あるとのこと:
Fast LLM Inference From Scratch, Andrew Chan, 2024.12
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog Issue Date: 2024-12-17 Comment
ライブラリを使用せずにC++とCUDAを利用してLLMの推論を実施する方法の解説記事
LLaMA-Omni: Seamless Speech Interaction with Large Language Models, Meta, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SpeechProcessing #OpenWeight #OpenSource Issue Date: 2024-12-13 Comment
音声とテキストのOpenSourceマルチモーダルモデル。inputは音声のみ?に見えるが、出力はテキストと音声の両方を実施できる。GPT-4oレベルのspeech capabilityを目指すとaboutに記載されている。興味深い。
installの説明に `Whisper-large-v3` をインストールする旨が記載されているので、Whisper-large-v3で認識した内容に特化したSpeech Encoder/Adapterが学習されていると考えられる。
- MM-LLMs: Recent Advances in MultiModal Large Language Models, Duzhen Zhang+, N/A, ACL'24 Findings
マルチモーダルなLLMの基本的な概念については上記参照のこと。
GoogleCloudPlatform_generative-ai, Google, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #GenerativeAI #Repository Issue Date: 2024-12-12 Comment
Google Cloudで生成AI(Gemini+Vertex AI)を動かすためのサンプルコード集
元ポスト:
Sarashina-Embedding-v1-1B, SB Intuitions, 2024.12
Paper/Blog Link My Issue
#Article #Embeddings #NLP #RepresentationLearning Issue Date: 2024-12-10 Comment
Non-commercialなライセンスで、商用利用の場合は問い合わせが必要
Llama3.3-70B, Meta, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2024-12-06 Comment
3.1-70Bよりも性能向上し、3.1-405Bの性能により近く。
(画像は元ポストより引用)
日本語LLMまとめ, LLM-jp, 2024.12
Paper/Blog Link My Issue
#Article #Survey #NLP #Dataset #LanguageModel #Evaluation #Repository #OpenWeight #Japanese #OpenSource Issue Date: 2024-12-02 Comment
LLM-jpによる日本語LLM(Encoder-Decoder系, BERT系, Bi-Encoders, Cross-Encodersを含む)のまとめ。
テキスト生成に使うモデル、入力テキスト処理に使うモデル、Embedding作成に特化したモデル、視覚言語モデル、音声言語モデル、日本語LLM評価ベンチマーク/データセットが、汎用とドメイン特化型に分けてまとめられている。
各モデルやアーキテクチャの原論文、学習手法の原論文もまとめられている。すごい量だ…。
LLM Self-Correction Papers, Ryo Kamoi, 2024.11
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Repository #SelfCorrection Issue Date: 2024-11-30 Comment
self-correctionの専門家によるself-correction関連の論文のリーディングリスト。ぜひチェックしたい。
元ポスト:
aisuite, andrewyng, 2024.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #python #Repository #API Issue Date: 2024-11-28 Comment
複数のLLM Providerの呼び出しを共通のインタフェースで呼び出せる。変更するのは、モデルを指定するパラメータのみ。
元ポスト:
https://www.linkedin.com/posts/andrewyng_announcing-new-open-source-python-package-activity-7266851242604134400-Davp?utm_source=share&utm_medium=member_ios
エンジニア研修まとめ, gcchaan, 2024.11
Paper/Blog Link My Issue
#Article #Tutorial Issue Date: 2024-11-27 Comment
様々な企業のエンジニアの新卒研修の資料などがまとまっている。学術機関の講義なども含まれている。現在も更新されている模様。
量がすごい。
YomiToku, Kotaro Kinoshita, 2024.11
Paper/Blog Link My Issue
#Article #ComputerVision #Library #OCR Issue Date: 2024-11-27 Comment
いわゆるAI-OCRで、縦書きの認識も可能で、表などの構造化された情報も認識可能とのこと。
手書きは認識できるのだろうか?
CC BY-NC-SA 4.0
元ツイート:
Sarashina2-8x70Bの公開, SB Intuitions, 2024.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Blog #OpenWeight #Japanese Issue Date: 2024-11-25 Comment
MoE Layerの説明、Sparse Upcyclingの説明、MoEモデルを学習する際に、学習時の学習率の設定が大きすぎると初期に損失が増大し、小さすぎると損失の増大は防げるがlong runで学習した際の性能向上が小さかったこと、元のモデルのパラメータを毀損しないように、Upcyclingをした元モデルの最終的な学習率を踏襲して学習をし、学習率をさらに減衰させていったこと、などが記載されている。
また、性能評価として同等のactivation parameter数を持つモデルと日本語のQAタスクで比較した結果も載っている。
- [Paper Note] Sparse Upcycling: Training Mixture-of-Experts from Dense Checkpoints, Aran Komatsuzaki+, ICLR'23
MoE Layerについては
- [Paper Note] Mixtral of Experts, Albert Q. Jiang+, arXiv'24, 2024.01
も参照のこと
SmolLM2, 2024.11
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #InstructionTuning #SyntheticData #OpenWeight #OpenSource #PostTraining Issue Date: 2024-11-21 Comment
元ポスト:
Orca-AgenInstruct-1M microsoft/orca-agentinstruct-1M-v1, Microsoft, 2024.11
よりもSmolLMのSFTで各種ベンチで高い性能を獲得
Datasets: hpprc_honyaku, hpprc, 2024.11
Paper/Blog Link My Issue
#Article #MachineTranslation #NLP #Dataset #Zero/Few/ManyShotPrompting #Japanese Issue Date: 2024-11-20 Comment
元ポスト:
英語Wikipediaを冒頭数文を抽出し日本語に人手で翻訳(Apache2.0ライセンスであるCalmやQwenの出力を参考に、cc-by-sa-4.0ライセンスにて公開している。
テクニカルタームが日本語で存在する場合は翻訳結果に含まれるようにしたり、翻訳された日本語テキストが単体で意味が成り立つように翻訳しているとのことで、1件あたり15分もの時間をかけて翻訳したとのこと。データ量は33件。many-shotやfew-shotに利用できそう。
日英対訳コーパスはライセンスが厳しいものが多いとのことなので、非常に有用だと思う。
ローカルLLMのリリース年表, npaka, 随時更新, 2024.11
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Blog #OpenWeight #OpenSource #Selected Papers/Blogs Issue Date: 2024-11-15 Comment
ローカルLLMを含むOpenLLMのリリース日が年表としてまとまっており、随時更新されている模様。すごい。
2026年3月現在も更新が続いている
sarashina2-8x70B, SBIntuitions, 2024.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Japanese #MoE(Mixture-of-Experts) Issue Date: 2024-11-09 Comment
プレスリリース: https://www.sbintuitions.co.jp/news/press/20241108_01/
- 商用利用不可な点には注意
- アーキテクチャは70Bモデルx8のMixture of Experts(MoE)
- モデルカードによると、inferenceにはBF16で、A100 80GB or H100が16基必要っぽい
MoEを利用したLLMについては、[Paper Note] Mixtral of Experts, Albert Q. Jiang+, arXiv'24, 2024.01 を参照のこと。
ZeRO: DeepSpeedの紹介, レトリバ, 2021.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #Supervised-FineTuning (SFT) #Reference Collection Issue Date: 2024-11-07 Comment
ZeROの説明がわかりやすい
こちらの記事もわかりやすい
https://zenn.dev/turing_motors/articles/d00c46a79dc976
DeepSpeedのコンフィグの一覧
https://www.deepspeed.ai/docs/config-json/
transformersにおけるdeepspeedのドキュメント:
https://huggingface.co/transformers/v4.9.2/main_classes/deepspeed.html
参考: deepspeedの使い方まとめ
https://note.com/fukudawataru/n/n5152e6f587c8
ZeRO Stage3を使う場合、ページ後方にしれっととんでもなく重要なことが書いてあるので気をつけましょう。。。。
https://huggingface.co/docs/transformers/v4.17.0/en/main_classes/deepspeed#constructing-massive-models
ZeROはparameterとoptimizerのmemory footprintの最適化を頑張っていて、activation memory footprint(バッチをforward passに流す時に消費されるメモリ)の削減は、tiling, activation/gradient checkpointingとかで頑張ってねという
という話が本家issueの4047に記載されている。
結論: つまづいたらDeepSpeedのIssueをエラーメッセージで検索かけるのが一番効果的
Lingua, Meta
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #Repository #MinimalCode Issue Date: 2024-11-05 Comment
研究目的のための、minimal、かつ高速なLLM training/inferenceのコードが格納されたリポジトリ。独自のモデルやデータ、ロスなどが簡単に実装できる模様。
Aya Expanse, Cohere, 2024.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #Author Thread-Post Issue Date: 2024-10-24 Comment
CohereによるマルチリンガルLLM, 8B, 32Bのモデルが存在する。
8BモデルのArenaHardでの評価
32BモデルのArenaHardでの評価
元ポスト:
Prompt-Engineering-Guide, DAIR.AI
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Prompting #Repository Issue Date: 2024-10-20 Comment
LLMのsettingから、few-shot, self-consistencyなどのprompting技術、さまざまなタスクの実例などが網羅的にまとまっている
MLE-Bench, OpenAI, 2024.10
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #AutoML Issue Date: 2024-10-20 Comment
75のkaggleのcompetitionsを収集(賞金1.9M$に相当する)し、そこから機械学習モデルの構築するためのエンジニアリングタスク(データセットの準備, モデルの学習, 実験)を抽出し、AI Agentsが機械学習モデルのこれらエンジニアリングタスクに対してどの程度実施できるかを測定できるようにしたベンチマーク
Unsloth, unslothai, 2024.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #Supervised-FineTuning (SFT) #InstructionTuning #PEFT(Adaptor/LoRA) #PostTraining #Selected Papers/Blogs #TrainingFramework Issue Date: 2024-10-08 Comment
single-GPUで、LLMのLoRA/QLoRAを高速/省メモリに実行できるライブラリ
現在でも鉄板
Streamlit, 2020.12
Paper/Blog Link My Issue
#Article #Library #python #Selected Papers/Blogs #Data Issue Date: 2024-10-07 Comment
データを用いたアプリを簡単に作れるpythonライブラリ
データ/モデルを用いたvisualization等を実施するアプリを、数行で作れてしまう。綺麗なUIつき。便利。
textlesslib, FAIR, 2022.02
Paper/Blog Link My Issue
#Article #SpeechProcessing #Repository Issue Date: 2024-10-04 Comment
元ポスト:
2024年11月にアーカイブされている。
Gemma-2-JPN, 2024.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Japanese Issue Date: 2024-10-04 Comment
日本語データでfinetuningされたGemma2
元ポスト:
AutoGen, Microsoft, 2024.10
Paper/Blog Link My Issue
#Article #Multi #LanguageModel #Library #AIAgents #Repository #Conversation #MCP Issue Date: 2024-10-02 Comment
マルチエージェントを構築するためのフレームワーク。MCP Serverとの連携も可能で、AssistantAgent classを入れ子のように設定することで、親エージェントが特定領域に特化した子エージェントをtool useとして呼び出すようなマルチエージェントを構築できるように見受けられる。
ECCV2024-Papers-with-Code, 2024.09
Paper/Blog Link My Issue
#Article #ComputerVision #Repository Issue Date: 2024-09-30 Comment
ECCV2024の全体像を概観するのに有用
以下、Claude 3.5 Sonnetに目次を入力し一言で各項目を説明させた内容。
hallucinationがあるかもしれないので参考程度で。
--------------------
各項目の概要を一言で説明いたします:
1. 3DGS(Gaussian Splatting): 3D空間内のガウス関数を用いた新しい3Dレンダリング手法。
2. Mamba / SSM: 長期依存関係を効率的に処理する新しい系列モデルアーキテクチャ。
3. Avatars: デジタル環境でユーザーを表現する仮想キャラクター。
4. Backbone: ディープラーニングモデルの主要な特徴抽出部分。
5. CLIP: 画像とテキストを同じ空間に埋め込む大規模マルチモーダルモデル。
6. MAE: 画像の一部を隠してから再構築する自己教師あり学習手法。
7. Embodied AI: 物理的な環境と相互作用する AI システム。
8. GAN: 生成モデルと識別モデルを競争させて学習する生成モデル。
9. GNN: グラフ構造データを処理するための神経ネットワーク。
10. 多模态大语言模型(MLLM): テキスト、画像、音声など複数のモダリティを扱う大規模言語モデル。
11. 大语言模型(LLM): 大量のテキストデータで学習された大規模な言語モデル。
12. NAS: 最適なニューラルネットワークアーキテクチャを自動探索する技術。
13. OCR: 画像内のテキストを認識し、デジタルテキストに変換する技術。
14. NeRF: 3D空間をニューラルネットワークで表現する手法。
15. DETR: Transformerを用いた新しい物体検出アーキテクチャ。
16. Prompt: AIモデルに与える指示や文脈を設定するテキスト。
17. 扩散模型(Diffusion Models): ノイズを徐々に除去して画像を生成する生成モデル。
18. ReID(重识别): 異なる画像や映像間で同一の人物や物体を再識別する技術。
19. 长尾分布(Long-Tail): データセット内で頻度の低いクラスや事例を扱う問題。
20. Vision Transformer: 画像処理にTransformerアーキテクチャを適用したモデル。
21. 视觉和语言(Vision-Language): 画像と言語を組み合わせて処理するタスク。
22. 自监督学习(Self-supervised Learning): ラベルなしデータから有用な表現を学習する手法。
23. 数据增强(Data Augmentation): 学習データを人工的に増やす技術。
24. 目标检测(Object Detection): 画像内の物体の位置と種類を特定する技術。
25. 异常检测(Anomaly Detection): 通常とは異なるパターンやデータを検出する技術。
26. 目标跟踪(Visual Tracking): 映像内の物体の動きを追跡する技術。
27. 语义分割(Semantic Segmentation): 画像内の各ピクセルをカテゴリに分類する技術。
28. 实例分割(Instance Segmentation): 画像内の個々の物体インスタンスを分割する技術。
29. 全景分割(Panoptic Segmentation): 意味分割とインスタンス分割を組み合わせた技術。
30. 医学图像(Medical Image): 医療目的で撮影された画像。
31. 医学图像分割(Medical Image Segmentation): 医療画像内の臓器や病変部位を分割する技術。
32. 视频目标分割(Video Object Segmentation): 動画内の物体を追跡し分割する技術。
33. 视频实例分割(Video Instance Segmentation): 動画内の個々の物体インスタンスを分割する技術。
34. 参考图像分割(Referring Image Segmentation): 言語記述に基づいて画像内の物体を分割する技術。
35. 图像抠图(Image Matting): 画像から前景を精密に抽出する技術。
36. 图像编辑(Image Editing): 画像の内容を変更または操作する技術。
37. Low-level Vision: 画像の低レベル特徴や処理を扱う分野。
38. 超分辨率(Super-Resolution): 低解像度画像から高解像度画像を生成する技術。
39. 去噪(Denoising): 画像からノイズを除去する技術。
40. 去模糊(Deblur): ぼけた画像をシャープにする技術。
41. 自动驾驶(Autonomous Driving): 人間の操作なしで車両を制御する技術。
42. 3D点云(3D Point Cloud): 3D空間内の点の集合でオブジェクトや環境を表現するデータ形式。
43. 3D目标检测(3D Object Detection): 3D空間内の物体の位置と種類を特定する技術。
44. 3D语义分割(3D Semantic Segmentation): 3Dデータの各点をカテゴリに分類する技術。
45. 3D目标跟踪(3D Object Tracking): 3D空間内の物体の動きを追跡する技術。
46. 3D语义场景补全(3D Semantic Scene Completion): 部分的な3Dデータから完全な3Dシーンを推定する技術。
47. 3D配准(3D Registration): 複数の3Dデータセットを整列させる技術。
48. 3D人体姿态估计(3D Human Pose Estimation): 3D空間内の人体の姿勢を推定する技術。
49. 3D人体Mesh估计(3D Human Mesh Estimation): 3D人体メッシュモデルを推定する技術。
50. 图像生成(Image Generation): AIを用いて新しい画像を生成する技術。
51. 视频生成(Video Generation): AIを用いて新しい動画を生成する技術。
52. 3D生成(3D Generation): AIを用いて新しい3Dモデルを生成する技術。
53. 视频理解(Video Understanding): 動画の内容を解析し理解する技術。
54. 行为识别(Action Recognition): 動画内の人物の行動を識別する技術。
55. 行为检测(Action Detection): 動画内の特定の行動を検出し位置特定する技術。
56. 文本检测(Text Detection): 画像内のテキストの位置を検出する技術。
57. 知识蒸馏(Knowledge Distillation): 大きなモデルの知識を小さなモデルに転移する技術。
58. 模型剪枝(Model Pruning): モデルの重要でないパラメータを削除して軽量化する技術。
59. 图像压缩(Image Compression): 画像データを効率的に圧縮する技術。
60. 三维重建(3D Reconstruction): 2D画像から3Dモデルを構築する技術。
61. 深度估计(Depth Estimation): 2D画像から奥行き情報を推定する技術。
62. 轨迹预测(Trajectory Prediction): 物体や人の将来の動きを予測する技術。
63. 车道线检测(Lane Detection): 道路上の車線を検出する技術。
64. 图像描述(Image Captioning): 画像の内容を自然言語で説明する技術。
65. 视觉问答(Visual Question Answering): 画像に関する質問に答える技術。
66. 手语识别(Sign Language Recognition): 手話のジェスチャーを認識し解釈する技術。
67. 视频预测(Video Prediction): 動画の将来のフレームを予測する技術。
68. 新视点合成(Novel View Synthesis): 既存の画像から新しい視点の画像を生成する技術。
69. Zero-Shot Learning(零样本学习): 学習時に見たことのないクラスを認識する学習手法。
70. 立体匹配(Stereo Matching): ステレオ画像から深度情報を抽出する技術。
71. 特征匹配(Feature Matching): 異なる画像間で対応する特徴点を見つける技術。
72. 场景图生成(Scene Graph Generation): 画像内の物体間の関係を構造化して表現する技術。
73. 计数(Counting): 画像内の特定オブジェクトの数を数える技術。
74. 隐式神经表示(Implicit Neural Representations): 連続関数としてシーンや形状を表現する手法。
75. 图像质量评价(Image Quality Assessment): 画像の品質を客観的に評価する技術。
76. 视频质量评价(Video Quality Assessment): 動画の品質を客観的に評価する技術。
77. 数据集(Datasets): 機械学習モデルの学習や評価に使用されるデータの集合。
続いて、各項目をもう少し詳細に説明するように生成したテキスト
---------
はい、各項目についてより詳細な説明を提供いたします。
1. 3DGS(Gaussian Splatting):
3D空間内にガウス関数を配置し、これらを2D画像に投影することで3Dシーンを表現する手法です。従来のNeRFよりも高速でクオリティの高い3Dレンダリングを実現します。
2. Mamba / SSM:
State Space Model (SSM)に基づく新しい系列モデルアーキテクチャです。Transformerと比較して長い系列を効率的に処理でき、様々なタスクで高いパフォーマンスを示しています。
3. Avatars:
オンライン空間やゲーム、VR環境などでユーザーを表現する仮想キャラクターです。最近では、AIを用いてよりリアルで自然なアバターの生成や制御が可能になっています。
4. Backbone:
深層学習モデルの主要な特徴抽出部分を指します。ResNet、VGG、EfficientNetなどが代表的で、様々なタスクの基礎となる重要な役割を果たします。
5. CLIP:
OpenAIが開発した大規模なマルチモーダルモデルで、画像とテキストを同じ特徴空間に埋め込むことができます。これにより、柔軟な画像検索や分類が可能になります。
6. MAE (Masked Autoencoder):
画像の一部をマスクし、それを再構築するタスクを通じて自己教師あり学習を行う手法です。事前学習モデルとして高い性能を示しています。
7. Embodied AI:
物理的な環境と直接相互作用するAIシステムを指します。ロボティクスや自動運転など、実世界でのタスク遂行に焦点を当てています。
8. GAN (Generative Adversarial Networks):
生成モデルと識別モデルを競争させることで学習を行う生成モデルです。高品質な画像生成など、様々な分野で応用されています。
9. GNN (Graph Neural Networks):
グラフ構造のデータを処理するための神経ネットワークです。ソーシャルネットワーク分析や分子構造予測など、関係性のあるデータの処理に適しています。
10. 多模态大语言模型(MLLM):
テキストだけでなく、画像、音声、動画などの複数のモダリティを理解し処理できる大規模言語モデルです。より豊かなコミュニケーションや理解が可能になります。
11. 大语言模型(LLM):
GPT-3やLLaMAなど、大量のテキストデータで学習された巨大な言語モデルです。自然言語処理の多くのタスクで高い性能を示しています。
12. NAS (Neural Architecture Search):
機械学習を用いて最適なニューラルネットワークの構造を自動的に探索する技術です。人手によるモデル設計の労力を軽減し、より効率的なモデルの発見を目指します。
13. OCR (Optical Character Recognition):
画像内のテキストを認識し、機械可読なテキストに変換する技術です。文書のデジタル化や自動データ入力などに広く使用されています。
14. NeRF (Neural Radiance Fields):
3D空間をニューラルネットワークで表現する手法です。少数の2D画像から高品質な3Dシーンの再構築と新視点の合成が可能です。
15. DETR (DEtection TRansformer):
Transformerアーキテクチャを物体検出タスクに適用したモデルです。従来の手法と比べてシンプルでありながら高い性能を示しています。
16. Prompt:
AIモデル、特に大規模言語モデルに与える指示や文脈を設定するテキストです。適切なプロンプト設計により、モデルの出力を制御し、望ましい結果を得ることができます。
17. 扩散模型(Diffusion Models):
ノイズを徐々に除去しながら画像を生成する生成モデルです。DALL-E 2やStable Diffusionなど、高品質な画像生成で注目を集めています。
18. ReID (重识别):
異なる画像や映像間で同一の人物や物体を再識別する技術です。監視カメラシステムや顧客追跡などに応用されています。
19. 长尾分布(Long-Tail):
データセット内で頻度の低いクラスや事例を扱う問題です。現実世界のデータ分布に対応するため、機械学習モデルの公平性と汎化性能の向上が課題となっています。
20. Vision Transformer:
自然言語処理で成功を収めたTransformerアーキテクチャを画像処理に適用したモデルです。CNNと比較して、大規模データセットでの学習時に高い性能を示しています。
21. 视觉和语言(Vision-Language):
画像と言語を組み合わせて処理するタスクや研究分野です。画像キャプション生成、視覚的質問応答、画像-テキスト検索などが含まれます。
22. 自监督学习(Self-supervised Learning):
大量のラベルなしデータから有用な特徴表現を学習する手法です。事前学習モデルの作成に広く使用され、少量のラベル付きデータでの fine-tuning で高い性能を実現します。
23. 数据增强(Data Augmentation):
既存の学習データに変形や変更を加えて人工的にデータセットを拡張する技術です。モデルの汎化性能向上やオーバーフィッティングの抑制に効果があります。
24. 目标检测(Object Detection):
画像内の物体の位置と種類を特定する技術です。矩形のバウンディングボックスで物体の位置を示し、各物体のクラスを予測します。自動運転や監視システムなどで広く使用されています。
25. 异常检测(Anomaly Detection):
データセット内の通常とは異なるパターンやデータポイントを検出する技術です。不正検知、産業用機器の故障予測、医療診断などに応用されています。
26. 目标跟踪(Visual Tracking):
動画シーケンス内で物体の動きを追跡する技術です。自動運転、スポーツ分析、監視システムなど、様々な分野で活用されています。
27. 语义分割(Semantic Segmentation):
画像内の各ピクセルをあらかじめ定義されたカテゴリに分類する技術です。自動運転における道路環境の理解や医療画像解析などに応用されています。
28. 实例分割(Instance Segmentation):
画像内の個々の物体インスタンスを分割し、それぞれに固有のラベルを付与する技術です。物体検出と意味分割を組み合わせたタスクと言えます。
29. 全景分割(Panoptic Segmentation):
意味分割とインスタンス分割を統合した技術で、画像内のすべてのピクセルに対してクラスとインスタンスIDを割り当てます。シーンの完全な理解を目指しています。
30. 医学图像(Medical Image):
X線、CT、MRI、超音波などの医療目的で撮影された画像を指します。診断、治療計画、医学研究などに使用されます。
31. 医学图像分割(Medical Image Segmentation):
医療画像内の臓器、腫瘍、血管などの特定の構造や病変部位を分割する技術です。診断支援や手術計画立案に重要な役割を果たします。
32. 视频目标分割(Video Object Segmentation):
動画シーケンス内の特定の物体を追跡し、フレームごとに分割する技術です。ビデオ編集やアウグメンテッドリアリティなどに応用されています。
33. 视频实例分割(Video Instance Segmentation):
動画内の個々の物体インスタンスを追跡し、フレームごとに分割するタスクです。ビデオ解析や自動運転システムでの環境理解に役立ちます。
34. 参考图像分割(Referring Image Segmentation):
自然言語による記述に基づいて、画像内の特定の物体や領域を分割する技術です。人間とAIのインタラクションを促進します。
35. 图像抠图(Image Matting):
画像から前景オブジェクトを精密に抽出する技術です。背景置換や合成など、画像編集タスクで重要な役割を果たします。
36. 图像编辑(Image Editing):
画像の内容を変更または操作する技術の総称です。物体の除去・追加、スタイル変換、色調整など、様々な編集操作が含まれます。
37. Low-level Vision:
画像の低レベル特徴や基本的な処理を扱う分野です。ノイズ除去、超解像、エッジ検出などの基礎的なタスクが含まれます。
38. 超分辨率(Super-Resolution):
低解像度の画像から高解像度の画像を生成する技術です。監視カメラ映像の鮮明化や古い写真の復元などに応用されています。
39. 去噪(Denoising):
画像からノイズを除去し、クリアな画像を得る技術です。低光量撮影や医療画像の品質向上など、様々な場面で使用されています。
40. 去模糊(Deblur):
ぼけた画像をシャープにする技術です。手ブレや被写体ブレの補正、古い写真の復元などに活用されています。
41. 自动驾驶(Autonomous Driving):
人間の操作なしで車両を制御する技術です。コンピュータビジョン、センサー融合、決定システムなど、多岐にわたる技術の統合が必要です。
42. 3D点云(3D Point Cloud):
3D空間内の点の集合でオブジェクトや環境を表現するデータ形式です。LiDARなどのセンサーから取得され、3D認識タスクの基礎となります。
43. 3D目标检测(3D Object Detection):
3D空間内の物体の位置、サイズ、向きを特定する技術です。自動運転や拡張現実などの分野で重要な役割を果たします。
44. 3D语义分割(3D Semantic Segmentation):
3Dデータの各点や領域をあらかじめ定義されたカテゴリに分類する技術です。自動運転での環境理解やロボティクスでの物体認識に応用されています。
45. 3D目标跟踪(3D Object Tracking):
時系列の3Dデータ内で物体の動きを追跡する技術です。自動運転システムにおける他の車両や歩行者の動きの予測などに使用されます。
46. 3D语义场景补全(3D Semantic Scene Completion):
部分的な3Dデータから、オクルージョンや欠損のある領域を含む完全な3Dシーンを推定する技術です。ロボットナビゲーションや拡張現実に応用されています。
47. 3D配准(3D Registration):
複数の3Dデータセット(点群や表面モデルなど)を正確に整列させる技術です。3Dスキャンデータの統合や位置合わせに使用されます。
48. 3D人体姿态估计(3D Human Pose Estimation):
2D画像や3Dデータから人体の3次元的な姿勢を推定する技術です。モーションキャプチャ、アニメーション、スポーツ分析などに応用されています。
49. 3D人体Mesh估计(3D Human Mesh Estimation):
2D画像や3Dスキャンデータから詳細な3D人体メッシュモデルを推定する技術です。バーチャルフィッティングやアニメーション制作などに活用されています。
50. 图像生成(Image Generation):
AIを用いて新しい画像を生成する技術です。GANやDiffusion Modelなどが代表的で、アート創作やデータ拡張に応用されています。
51. 视频生成(Video Generation):
AIを用いて新しい動画を生成する技術です。短い入力クリップからの動画の延長や、テキスト記述からの動画生成などが研究されています。
52. 3D生成(3D Generation):
AIを用いて新しい3Dモデルを生成する技術です。製品デザイン、ゲーム開発、建築設計などの分野で注目されています。
53. 视频理解(Video Understanding):
動画の内容を解析し、シーンの構造、物体の関係、イベントの進行などを理解する技術です。ビデオ検索や自動要約などに応用されています。
54. 行为识别(Action Recognition):
動画内の人物の行動を識別する技術です。監視システム、スポーツ分析、ヒューマン・コンピュータ・インタラクションなどで活用されています。
55. 行为检测(Action Detection):
動画内の特定の行動をリアルタイムで検出し、その時間的・空間的位置を特定する技術です。セキュリティシステムや異常行動の検知などに応用されています。
はい、続きを説明いたします。
56. 文本检测(Text Detection):
画像や動画内のテキストの位置を検出する技術です。OCRシステムの前処理として重要で、看板の認識や文書分析などに使用されます。
57. 知识蒸馏(Knowledge Distillation):
大規模で複雑な「教師」モデルの知識を、より小さな「生徒」モデルに転移する技術です。モデルの軽量化と性能維持の両立を目指します。
58. 模型剪枝(Model Pruning):
学習済みモデルから重要度の低いパラメータや層を削除し、モデルを軽量化する技術です。モバイルデバイスでの効率的な実行などに役立ちます。
59. 图像压缩(Image Compression):
画像データを効率的に圧縮し、ストレージやネットワーク帯域幅を節約する技術です。最近では機械学習を用いた新しい圧縮手法も研究されています。
60. 三维重建(3D Reconstruction):
2D画像や動画から3Dモデルを構築する技術です。建築、考古学、映画制作など、様々な分野で活用されています。
61. 深度估计(Depth Estimation):
単眼または複眼の2D画像から、シーンの奥行き情報を推定する技術です。3D再構成や拡張現実などのアプリケーションで重要な役割を果たします。
62. 轨迹预测(Trajectory Prediction):
物体や人の過去の動きに基づいて、将来の動きを予測する技術です。自動運転、群衆行動分析、スポーツ戦略立案などに応用されています。
63. 车道线检测(Lane Detection):
道路上の車線を検出し追跡する技術です。自動運転システムや先進運転支援システム(ADAS)において重要な要素となっています。
64. 图像描述(Image Captioning):
画像の内容を自然言語で説明する文章を自動生成する技術です。視覚障害者支援や画像検索の高度化などに応用されています。
65. 视觉问答(Visual Question Answering):
画像に関する自然言語の質問に対して、適切な回答を生成する技術です。画像理解とテキスト生成の両方の能力が必要とされます。
66. 手语识别(Sign Language Recognition):
手話のジェスチャーを認識し、それを文字や音声に変換する技術です。聴覚障害者とのコミュニケーション支援に役立ちます。
67. 视频预测(Video Prediction):
過去のフレームに基づいて、動画の将来のフレームを予測する技術です。動画圧縮、異常検知、自動運転など、様々な応用が考えられています。
68. 新视点合成(Novel View Synthesis):
既存の画像や限られた視点の情報から、新しい視点の画像を生成する技術です。仮想現実や自由視点映像などに応用されています。
69. Zero-Shot Learning(零样本学习):
学習時に見たことのないクラスを認識する学習手法です。事前に学習していない新しいカテゴリの物体を識別する能力を持ちます。
70. 立体匹配(Stereo Matching):
ステレオカメラで撮影された左右の画像から対応点を見つけ、深度情報を抽出する技術です。3D再構成や深度推定の基礎となります。
71. 特征匹配(Feature Matching):
異なる画像間で対応する特徴点を見つける技術です。画像のスティッチング、物体追跡、SLAMなど、様々なコンピュータビジョンタスクの基礎となります。
72. 场景图生成(Scene Graph Generation):
画像内の物体間の関係を構造化して表現する技術です。シーンの意味的理解や高度な画像検索などに応用されています。
73. 计数(Counting):
画像や動画内の特定オブジェクトの数を自動的に数える技術です。群衆の推定、在庫管理、生物学的サンプルの計数などに使用されています。
74. 隐式神经表示(Implicit Neural Representations):
3Dシーンや形状を連続関数としてニューラルネットワークで表現する手法です。NeRFはこの手法の一例で、効率的なシーン表現が可能です。
75. 图像质量评价(Image Quality Assessment):
画像の品質を客観的に評価する技術です。画像処理アルゴリズムの性能評価や、品質に基づいた画像フィルタリングなどに使用されます。
76. 视频质量评价(Video Quality Assessment):
動画の品質を客観的に評価する技術です。ストリーミングサービスの品質監視や、ビデオ圧縮アルゴリズムの最適化などに応用されています。
77. 数据集(Datasets):
機械学習モデルの学習や評価に使用されるデータの集合です。ImageNet、COCO、KITTI
など、各タスクに特化した大規模データセットが開発され、研究や技術開発を加速しています。
これらの技術は相互に関連し合い、コンピュータビジョンと機械学習の分野を形作っています。多くの応用分野で革新的なソリューションを生み出すとともに、新たな課題にも直面しており、今後さらなる発展が期待されています。
Evaluating the Effectiveness of LLM-Evaluators (aka LLM-as-Judge), 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog #LLM-as-a-Judge Issue Date: 2024-09-30 Comment
LLM-as-a-judgeについて網羅的に書かれた記事
NotebookLM, Google, 2024.09
Paper/Blog Link My Issue
#Article #Tools #InformationRetrieval #NLP #LanguageModel #GenerativeAI #RAG(RetrievalAugmentedGeneration) Issue Date: 2024-09-29 Comment
ソーステキストをアップロードし、それらを参照可能なLLMの元作業が可能で、クエリによって引用つきのRAGのようなものが行えるらしい。2人の対話形式のpodcastも自動生成可能で、UI/UXの面で画期的らしい?
LLM-jp-3 1.8B・3.7B・13B の公開, LLM.jp, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Japanese #OpenSource Issue Date: 2024-09-25 Comment
LLM-JP-Evalでの評価結果はこちら: https://huggingface.co/llm-jp/llm-jp-3-1.8b
1.8Bのモデルが、モデルサイズに対して非常に性能が良いとのこと(確かに、3.8Bのモデルとの差があまりないように見える
元ポスト:
アーキテクチャはLlama2とのことなので、vLLMでも動作させられる模様
LLM-jp Corpus v3, LLM.jp, 2024.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Japanese Issue Date: 2024-09-25 Comment
LLM-jp-3
- LLM-jp-3 1.8B・3.7B・13B の公開, LLM.jp, 2024.09
の学習に利用されているコーパス
Late Chunking: Balancing Precision and Cost in Long Context Retrieval, Pierse+, 2024.09
Paper/Blog Link My Issue
#Article #Embeddings #InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #Blog #Selected Papers/Blogs Issue Date: 2024-09-08 Comment
chunkingしてからembeddingを取得するより、全体のドキュメントに対してcontextualなtoken embeddingを取得し、その後chunkingをしてpoolingしてsingle vectorにする方が、文書の文脈情報がembedding内で保持されやすいので、precisionが上がりますよ、という話
ml-engineering
Paper/Blog Link My Issue
#Article #Tutorial #ComputerVision #MachineLearning #NLP #LanguageModel #Repository Issue Date: 2024-09-07 Comment
LLMやVLMを学習するためのツールやノウハウがまとめられたリポジトリ
LLMに日本語テキストを学習させる意義, Koshiro Saito+, 第261回自然言語処理研究発表会, 2024.08
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #OpenWeight #Slide #Japanese Issue Date: 2024-09-03 Comment
英日翻訳や日本特有の知識を問われるようなQAにおいて、日本語データによる学習の効果があることが示唆されている模様。
たとえば、論文紹介 / The Llama 3 Herd of Models, 2024.08
に示されている通り、Llama2における日本語データの割合は0.2%とかなので、英語圏のOpenLLMにおいて、日本語データの比率がどれだけ少ないかがわかる。
大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Slide Issue Date: 2024-09-01 Comment
LLMの原理の基礎的な内容について、丁寧かつコンパクトにまとまっている。
>ファインチューニングは新しい知識の学習ではなく知識の使い方を学習させるのに向いている
これをきちんと念頭に置いておかないと落とし穴にハマると思う。引用元の論文読みたい:
- [Paper Note] Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?, Zorik Gekhman+, EMNLP'24, 2024.05
NewsPicksに推薦システムを本番投入する上で一番優先すべきだったこと, 2024.08
Paper/Blog Link My Issue
#Article #RecommenderSystems #NeuralNetwork #CTRPrediction #NewsRecommendation #ML-LLM Ops #Evaluation #Blog #A/B Testing #Reading Reflections Issue Date: 2024-08-31 Comment
>推薦モデルの良し悪しをより高い確度で評価できる実験を、より簡単に実行できる状態を作ることでした。平たく言えば「いかにA/Bテストしやすい推薦システムを設計するか」が最も重要だった訳です。
オフライン評価とオンライン評価の相関がない系の話で、A/Bテストを容易に実施できる環境になかった、かつCTRが実際に向上したモデルがオフライン評価での性能が現行モデルよりも悪く、意思決定がなかなかできなかった、という話。
うーんやはり、推薦におけるオフライン評価ってあまりあてにできないよね、、、
そもそも新たなモデルをデプロイした時点で、テストした時とデータの分布が変わるわけだし、、、
Off-Policy Evaluationの話は勉強したい。
あと、定性評価は重要
Firecrawl, 2024.09
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #Repository #API Issue Date: 2024-08-30 Comment
sitemapなしでWebサイト全体をクローリングできるAPI。LLMで利用可能なマークダウンや、構造化データに変換もしてくれる模様。
AutoMLOpsを使って機械学習CI_CDパイプラインを組んでみた, 2024.08
Paper/Blog Link My Issue
#Article #MachineLearning #ML-LLM Ops #python #Blog #SoftwareEngineering Issue Date: 2024-08-27 Comment
pythonコードでコンポーネントや、パイプラインを関数の形で記述するだけで、MLのCI/CDパイプラインをVertexAI上に自動構築できる模様。非常にお手軽で、多くの設定ファイルなどは自動生成されるようなので、簡単に始めることができそう。
記事中では、多クラス分類器を学習するためのデータをBigQueryから取得、モデル訓練、デプロイ、推論エンドポイント生成、モニタリングなどを簡単なコードベースで実現できている。便利そうではある。
細かいチューニングも自動生成された設定ファイルをいじれば可能だと思われる。
LitServe, 2024.04
Paper/Blog Link My Issue
#Article #MachineLearning #Library #MultiModal #Repository #API #EfficientEvaluation Issue Date: 2024-08-25 Comment
FastAPIより2倍早いAPIライブラリ。LLMやVisionなど多くのモーダルに対応し、マルチワーカーでオートスケーリングやバッチングやストリーミングにも対応。PyTorchモデルだけでなく、JAXなど様々なフレームワークのモデルをデプロイ可能
元ツイート:
Liger-Kernel, 2024.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #Repository #PostTraining #Selected Papers/Blogs Issue Date: 2024-08-25 Comment
LLMを学習する時に、ワンライン追加するだけで、マルチGPUトレーニングのスループットを20%改善し、メモリ使用量を60%削減するらしい
元ツイート:
Unsloth Unsloth, unslothai, 2024.07
はLoRA/QLoRAが可能な一方でまだMulti-GPUはサポートしていない。一方、Liger-KernelはLoRAよりもfull-parameter tuningとMulti-GPUにフォーカスしており、目的に応じて使い分けが必要。
https://github.com/linkedin/Liger-Kernel/issues/57
Grok-2, X, 2024.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary Issue Date: 2024-08-24 Comment
chatbot arenaで5月時点のGPT4o超え。miniでもなんとllama3.1-705B超え
list of recommender systems
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #Dataset #Library #Repository #OpenSource Issue Date: 2024-08-07 Comment
推薦システムに関するSaaS, OpenSource, Datasetなどがまとめられているリポジトリ
DeepSpeed, vLLM, CTranslate2 で rinna 3.6b の生成速度を比較する, 2024.06
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Library #python #Blog #OpenWeight #LLMServing #Reference Collection Issue Date: 2024-08-05 Comment
[vllm](
https://github.com/vllm-project/vllm)を使うのが一番お手軽で、inference速度が速そう。PagedAttentionと呼ばれるキャッシュを利用して高速化しているっぽい。
(図はブログ中より引用)
こちらも参照のこと
vLLMの仕組みをざっくりと理解する:
https://dalab.jp/archives/journal/vllm/#PagedAttention
vLLMでReasoning ModelをServingするときは、`--enable-reasoning`等の追加オプションを指定する必要がある点に注意
https://docs.vllm.ai/en/stable/features/reasoning_outputs.html
OpenLLM: Self-Hosting LLMs Made Easy
Paper/Blog Link My Issue
#Article #NLP #Library #OpenWeight #API #Frontend Issue Date: 2024-08-01 Comment
OpenLLMをself hostingする際に、OpenAIなどと同じインタフェースのAPIやChatを提供するライブラリ
Gemma2, Google Deepmind, 2024
Paper/Blog Link My Issue
#Article #NLP #Coding #Reasoning #Mathematics #OpenWeight Issue Date: 2024-07-30 Comment
Reasoning, Math, CodeGenerationに強み
2024年版のDockerfileの考え方&書き方, 2024
Paper/Blog Link My Issue
#Article #Blog Issue Date: 2024-07-29 Comment
マルチステージビルド、成果物の考え方など
Llama 3.1, 2024.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2024-07-25 Comment
Llama系のモデルをFP8で学習する場合のレシピ
Deepでポン用実験管理ツール(サービス)の比較2021
Paper/Blog Link My Issue
#Article #Blog #ExperimentManagement Issue Date: 2024-07-09 Comment
[TensorBoard](
https://www.tensorflow.org/tensorboard/)
[MLflow](
https://mlflow.org/)
[Neptune.ai](
https://neptune.ai/)
[Weights & Biases](
https://wandb.ai/site)
[Comet](
https://www.comet.ml/site/)
の比較がされている
OpenDevin: Code Less, Make More, 2024
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #NLP #LanguageModel #AIAgents #Repository Issue Date: 2024-07-04 Comment
LLMによるOpenSourceなソフトウェア生成エージェントプラットフォーム
full timeのスタッフを雇用しworldクラスのUXを目指すとのこと。楽しみ。
参考:
Open化される前の最初のDevinのツイート
mergekit-evolve
Paper/Blog Link My Issue
#Article #LanguageModel #Library #Repository #ModelMerge Issue Date: 2024-04-29 Comment
[Paper Note] Evolutionary Optimization of Model Merging Recipes, Takuya Akiba+, N/A, Nature Machine Intelligence, Vol.7, 2025.01
のように進化的アルゴリズムでモデルマージができるライブラリ
解説記事:
https://note.com/npaka/n/nad2ff954ab81
大きなVRAMが無くとも、大きめのSRAMがあれば動作するらしい
AirLLM, 2024.04
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #Repository Issue Date: 2024-04-28 Comment
4GBのSingle GPUで、70Bモデルのinferenceを実現できるライブラリ。トークンの生成速度は検証する必要がある。transformer decoderの各layerの演算は独立しているため、GPUに全てのlayerを載せず、必要な分だけ載せてinferenceするといった操作を繰り返す模様。
元ツイート:
推薦・機械学習勉強会, Wantedly
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #Blog Issue Date: 2024-04-26 Comment
WantedlyさんのRecSys勉強会の資料がまとまったリポジトリ。継続的に更新されており、最近この辺のトピックは追いきれていないので非常に有用。
Open Source Cookbook
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #GenerativeAI #Repository #OpenSource #Selected Papers/Blogs Issue Date: 2024-04-14 Comment
HuggingFaceによる様々な実用的なアプリケーションをオープンソースの実装やモデルで実現するノートブックがまとまったリポジトリ。LLM-as-a-judge, RAG, PEFTによるPrompt Tuning(Prefix Tuningとかそっち系の話だと思われる)など、現在16種類ほどあるらしい。
改めて見たら数がかなり増えていた
Mixtral-8x22B-v0.1, 2024
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2024-04-10 Comment
Apache-2.0ライセンス, 日本語非対応
Command R+, Cohere, 2024
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #Proprietary Issue Date: 2024-04-10 Comment
Chatbot arenaでGPT-4-0314と同等の Elo Rate を獲得し(20240410時点)、日本語を含む10ヶ国語をサポート。コンテキストウィンドウサイズ128k。商用利用はAPIから、研究目的であればHuggingFaceから利用可能。
Awesome LM with Tools
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #AIAgents #Repository #ToolUse Issue Date: 2024-03-22 Comment
Toolを利用するLMに関するNeubig氏のグループによるSurvey。
生産性指標をFour Keysから変更した話, SanSan Tech Blog
Paper/Blog Link My Issue
#Article #Blog Issue Date: 2024-03-21 Comment
モバイルアプリ開発における生産性指標に関するお話。Four Keysをモバイルアプリに適用した場合の課題を分析し、自チームの中長期的な目標を達成するためにどのような生産性指標を採用すべきかが言語化されており、興味深かった。
Four Keysとは:
https://blog.recruit.co.jp/rls/2021-03-31-four-keys/#whats-four-keys
Open Release of Grok-1 March 17, 2024
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #MoE(Mixture-of-Experts) Issue Date: 2024-03-18 Comment
Apache2.0ライセンス, 314Bパラメータでモデルの重み、Mixture-of-Expertsを採用している。学習データ、学習に利用したコードはおそらく公開されていない。
Grok-1.5がリリース
https://x.ai/blog/grok-1.5
各種ベンチマークの性能、特にMathの性能が向上し、コンテキスト長が128kに
What are the most important LLMs to know about in March 2024?
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Post Issue Date: 2024-03-04 Comment
2024年3月時点で知っておくべきLLMに関するスレッド
Recommenders, recommenders-team, 2018.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Library #Repository Issue Date: 2024-01-15 Comment
古典的な手法から、Deepな手法まで非常に幅広く網羅された推薦アルゴリズムのフレームワーク。元々Microsoft配下だった模様。
現在もメンテナンスが続いており、良さそう
Decoding Strategies that You Need to Know for Response Generation
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #NLP #LanguageModel #Blog Issue Date: 2024-01-01 Comment
言語モデルのdecodingの方法についてよくまとまっている。まとめられているdecoding方法は以下
- Greedy, BeamSearch, RandomSampling, Temperature, Top-K Sampling, Nucleus Sampling
こちらの記事ではHuggingFaceでの実装や他のdecoding方法等、より実装面での詳細が記述されている:
https://note.com/npaka/n/n9a8c85f2ef7a
モバオクでのリアルタイムレコメンドシステムの紹介
Paper/Blog Link My Issue
#Article #RecommenderSystems #ML-LLM Ops #Slide #Reading Reflections Issue Date: 2023-12-19 Comment
DeNAでのRecSysのアーキテクチャ(バッチ、リアルタイム)が紹介されている。バッチではワークフローエンジンとしてVertex AI Pipelineが用いられている。リアルタイムになるとアーキテクチャが非常に複雑になっている。
複雑なアーキテクチャだが、Generative Recommendation使ったらもっとすっきりしそうだなーと思いつつ、レイテンシと運用コストの課題があるのでまだ実用段階じゃないよね、と思うなどした。
リアルタイム推薦によって、バッチで日毎の更新だった場合と比べ、入札率、クリック率、回遊率が大きく改善したのは面白い。
optimize-llm, HuggingFace, 2023.09
Paper/Blog Link My Issue
#Article #Tutorial #EfficiencyImprovement #NLP #LanguageModel Issue Date: 2023-12-15 Comment
LLMをoptimizeする実用的なチュートリアル
こちらも有用なので参照のこと
【GPU inference】
https://huggingface.co/docs/transformers/main/perf_infer_gpu_one
もし明日、上司に「GPT-4を作れ」と言われたら? Stability AIのシニアリサーチサイエンティストが紹介する「LLM構築タイムアタック」
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #Reading Reflections Issue Date: 2023-12-05 Comment
StabilityAI Japan秋葉さん(元PFN)のW&B Conferenceでの発表に関する記事。
LLM構築タイムアタックでLLMをもし構築することになったら!?
のざっくりとしたプロセスや、次ページでOpenAIのGPT4のテクニカルレポートのクレジットから各チームの規模感を推定して、どの部分にどの程度の人員が割かれていたのかというのをベースに、各パートでどんなことがやられていそうかという話がされている。
LLM構築タイムアタックで、まずGPUを用意します!(ここが一番大変かも)の時点で、あっ察し(白目 という感じがして面白かった。
GPT4All: Training an Assistant-style Chatbot with Large Scale Data Distillation from GPT-3.5-Turbo, Anand+, 2023.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Tools #NLP #LanguageModel #Repository Issue Date: 2023-11-21 Comment
ローカルマシンでChatGPT likeなUIでチャットボットを動作させられるOpensource。
Mistral7BやGGUFフォーマットのモデルのよつな(おそらく量子化されたものも含む)ローカルマシンで動作させられる規模感のモデルがサポートされている。
https://gpt4all.io/index.html
Zephyr-7B-beta, RAG Perf.
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #RAG(RetrievalAugmentedGeneration) #Blog #OpenWeight Issue Date: 2023-11-21 Comment
Zephyr-7B-betaのRAGでの性能がデータセットで評価されている
下記Xポストによるとgpt-3.5-turboと同等
lifestar, lifestar-org, 2021.12
Paper/Blog Link My Issue
#Article #Library #python #SoftwareEngineering #Asynchronous Issue Date: 2023-11-19 Comment
非常に高速なpythonのASGIライブラリ。WSGIとは異なり非同期処理なためリアルタイムアプリケーションに向いているっぽい。
現在でも活発に開発がされているようだ
JGLUEの構築そして 日本語LLM評価のこれから, 河原大輔, W&B 東京ミートアップ #8, 2023.11
Paper/Blog Link My Issue
#Article #Tutorial #Dataset #LanguageModel #Evaluation #Reading Reflections Issue Date: 2023-11-16 Comment
JGLUEのexample付きの詳細、構築の経緯のみならず、最近の英語・日本語LLMの代表的な評価データ(方法)がまとまっている(AlpacaEval, MTBenchなど)。また、LLMにおける自動評価の課題が興味深く、LLM評価で生じるバイアスについても記述されている。Name biasなどはなるほどと思った。
日本語LLMの今後の評価に向けて、特にGPT4による評価を避け、きちんとアノテーションしたデータを用意しfinetuningした分類器を用いるという視点、参考にしたい。
LLaMA-Factory, hiyouga, 2023.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Supervised-FineTuning (SFT) #PostTraining #TrainingFramework Issue Date: 2023-11-14 Comment
簡単に利用できるLLaMAのfinetuning frameworkとのこと。
元ツイート:
LLaMAベースなモデルなら色々対応している模様
Hallucination Leaderboard, 2023
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Hallucination #Factuality #Repository Issue Date: 2023-11-14 Comment
1000個の短いドキュメントに対して、事実情報のみを用いて要約を生成させ、要約結果と原文書のFactual consistencyを別に訓練したモデルで測定して評価してリーダーボードを作成している。
Claude2よりLLaMA2の方が性能が良いのが面白いし、Palmの性能があまり良くない。
元ツイート:
Transformers.js, 2023
Paper/Blog Link My Issue
#Article #Library #Transformer #Blog #Frontend Issue Date: 2023-11-13 Comment
ブラウザ上でTransformerベースの様々なモデルを動作させることができるライブラリ
Data-to-Text Datasetまとめ, Akihiko Watanabe, 2022
Paper/Blog Link My Issue
#Article #Survey #NaturalLanguageGeneration #NLP #Dataset #DataToTextGeneration #Slide Issue Date: 2023-11-08 Comment
Data-to-Textのデータセットを自分用に調べていたのですが、せっかくなのでスライドにまとめてみました。特にMR-to-Text, Table-to-Textあたりは網羅的にサーベイし、データセットの概要を紹介しているので、全体像を把握するのに良いのかなぁと思います。ただし、2022年12月時点で作成したので2023年以後のデータセットは含まれていません😅
IBIS2023チュートリアル「大規模言語モデル活用技術の最前線」, Michimasa Inaba, 2023.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #AIAgents #Chain-of-Thought #Slide Issue Date: 2023-11-01 Comment
LLMの応用研究やPromptingを中心としたチュートリアル。アノテーションや対話式推薦システムへの活用、ReAct、プロンプトの最適化技術、CoTの基本から応用まで幅広くまとまっているので、LLMの応用技術の概観や、CoTを実践したい人に非常に有用だと思う。
大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
Paper/Blog Link My Issue
#Article #Analysis #MachineLearning #Transformer #Blog #FactualKnowledge Issue Date: 2023-10-29 Comment
タイトルの通り、知識がFFNに蓄積されていると主張しているらしい原論文を読み解いている。まとめを引用すると
> 「知識は全結合層に蓄積される」という表現は、ややラジカルで、
少なくともこの論文では「全結合層は知識獲得において重要」という程度
の、もう少しマイルドな主張をしているように見受けられました。
とのこと。
LangChainのRAGの改善法, LayerX機械学習勉強会
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Library #RAG(RetrievalAugmentedGeneration) #Blog Issue Date: 2023-10-29 Comment
以下リンクからの引用。LangChainから提供されているRetrieverのcontext抽出の性能改善のためのソリューション
> Multi representation indexing:検索に適した文書表現(例えば要約)の作成
Query transformation:人間の質問を変換して検索を改善する方法
Query construction:人間の質問を特定のクエリ構文や言語に変換する方法
https://blog.langchain.dev/query-transformations/
日本語LLMベンチマークと自動プロンプトエンジニアリング, PFN Blog, 2023.10
Paper/Blog Link My Issue
#Article #Analysis #NLP #Prompting #Blog #AutomaticPromptEngineering Issue Date: 2023-10-13 Comment
面白かった。特に、promptingによってrinnaとcyberのLLMの順位が逆転しているのが興味深かった。GAを使ったプロンプトチューニングは最近論文も出ていたが、日本語LLMで試されているのは面白かった。
MentalLLaMA, 2023
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Repository #Health Issue Date: 2023-10-09 Comment
メンタルヘルスの分析に対してinstruction tuningしたはじめてのLLM
Japanese Simple SimCSE, hppRC, 2023.10
Paper/Blog Link My Issue
#Article #Sentence #Embeddings #NLP #RepresentationLearning #Repository #OpenWeight #Japanese Issue Date: 2023-10-07 Comment
日本語の事前学習言語モデルと、日本語の学習データを利用してSimCSEを学習し網羅的に評価をした結果が記載されている。Supervised SimCSE, UnsupervisednSimCSEの両方で実験。また、学習するデータセットを変更したときの頑健性も検証。性能が良かったモデルはSentenceTransformersから利用可能な形で公開されている。
Nejumi LLMリーダーボード, Weights & Biases
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Japanese #Author Thread-Post Issue Date: 2023-10-02 Comment
JGLUEを使ったLLMの日本語タスクベンチマーク
v4が公開:
https://wandb.ai/llm-leaderboard/nejumi-leaderboard4/reports/Nejumi-LLM-4--VmlldzoxMzc1OTk1MA
元ポスト:
Agents: An opensource framework for autonomous language agents
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #AIAgents Issue Date: 2023-09-30 Comment
以下の特徴を持つLLMAgent開発のためのフレームワーク
- long-short term memory
- tool usage
- web navigation
- multi-agent communication
- human-agent interaction
- symbolic control
また、他のAgent frameworkと違い、ゴールを達成するだの細かいプランニングを策定(SOP; サブタスクとサブゴールを定義)することで、エージェントに対してきめ細かなワークフローを定義できる。
GGML_GGUF_GPTQの違い
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Quantization Issue Date: 2023-09-29 Comment
量子化に関する技術であるGGML, GGUF, GPTQに関する詳細なまとめ
筆者の方の言葉を引用すると
>llama.cppならGGUF、TransformerならGPTQって感じ?
ということなので、これらは量子化を行うための技術を提供するライブラリであり、GGUF/GGMLはllama.cppで利用可能で、GPTQはより汎用的に利用可能な手法だと思われる。
GPTQについて論文をざっくり読んでメモった
- [Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
SNLP2023:Is GPT-3 a Good Data Annotator?, Yuki Zenimoto, 2023.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SyntheticData #Distillation #Slide #Finetuning #DownstreamTasks #Reading Reflections Issue Date: 2023-09-05 Comment
GPT3でデータを作成したら、タスクごとに有効なデータ作成方法は異なったが、人手で作成したデータと同等の性能を達成するデータ(BERTでfinetuning)を、低コストで実現できたよ、という研究
この辺の話はもはや [Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08 を使えばいいのでは、という気がする。
[Paper Note] Instruction Tuning for Large Language Models: A Survey, Shengyu Zhang+, ACM Computing Surveys, Volume 58, Issue 7, 2026.01
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #InstructionTuning #Selected Papers/Blogs Issue Date: 2023-09-05 GPT Summary- 指示調整(IT)に関する研究を総括し、LLMsの能力向上術を解説。ITは、(instruction, output)ペアを用いてLLMsを追加訓練し、人間の指示に従う能力を強化するプロセス。SFTの方法論、データセット構築、訓練、および応用を体系的にレビューし、成果に影響する要因を分析。さらに、SFTの課題や現行戦略の欠点を明らかにし、今後の研究の道筋を提案。 Comment
主要なモデルやデータセットの作り方など幅広くまとまっている(Figure1および各Table)
arxivに2023年8月に登場しその後も更新が続き、ACM Computing Surveys, Volume 58, Issue 7に2026年1月に掲載された模様
https://dl.acm.org/doi/10.1145/3777411
大規模言語モデル, Naoaki Okazaki, 2023年度統計関連学会連合大会チュートリアルセッション 言語モデルと自然言語処理のフロンティア, 2023.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Slide Issue Date: 2023-09-04 Comment
岡崎先生による大規模言語モデルのチュートリアル
最近のLLMまでの歴史、transformerなどの基礎的な内容から、最新の内容まで数式付きで詳細にまとまっている
zeno-build, zeno-ml, 2023.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #ExperimentManagement Issue Date: 2023-08-28 Comment
MTでのテクニカルレポート
https://github.com/zeno-ml/zeno-build/tree/main/examples/analysis_gpt_mt/report
LLMの実験管理を容易に実施するツールで、異なるハイパーパラメータ、異なるモデル、異なるプロンプトでの実験などを簡単に実施できる。評価結果を自動的に可視化し、interactiveに表示するブラウザベースのアプリケーションも作成可能?
Anti-hype LLM Reading list, veekaybee, 2023.12
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel Issue Date: 2023-08-27 Comment
LLMのサーベイ、BERT等の基盤モデルの論文、自前でLLMを学習するために必要な論文がコンパクトにまとめられたgist
SQL vs. NoSQL cheetsheet, AWS, Azure and Google Cloud
Paper/Blog Link My Issue
#Article #AWS #Infrastructure Issue Date: 2023-08-27 Comment
データタイプやユースケースに応じてAWS上のサービスなどをマッピングしてくれているチートシート。わかりやすい。
CommonVoice
Paper/Blog Link My Issue
#Article #MachineLearning #Dataset #SpeechProcessing Issue Date: 2023-08-16 Comment
音声対応のアプリケーションをトレーニングするために誰でも使用できるオープンソースの多言語音声データセット
人工知能研究の新潮流2 -基盤モデル・生成AIのインパクト-, 国立研究開発法人科学技術振興機構 研究開発戦略センター, 2023.07
Paper/Blog Link My Issue
#Article #Survey #LanguageModel #GenerativeAI #read-later #Selected Papers/Blogs Issue Date: 2023-08-12 Comment
280ページにものぼる現在のトレンドをまとめた日本語資料
OpenAI の Embeddings API はイケてるのか、定量的に調べてみる, akeyhero (Akihiro Katsura), Qiita, 2023.04
Paper/Blog Link My Issue
#Article #Embeddings #NLP #LanguageModel #STS (SemanticTextualSimilarity) #Blog #Encoder Issue Date: 2023-07-31 Comment
[JSTSタスク](
https://github.com/yahoojapan/JGLUE)では、[Tohoku
BERT v3](
https://github.com/cl-tohoku/bert-japanese/tree/main#model-performances)
と [LUKE](
https://github.com/studio-ousia/luke)が最も性能が良いらしい。
[SimCSE](
https://huggingface.co/pkshatech/simcse-ja-bert-base-clcmlp)よりも性能が良いのは興味深い。
trl_trlx
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #PostTraining #Reference Collection #needs-revision #TrainingFramework Issue Date: 2023-07-23 Comment
関連:
- TRL - 強化学習によるLLMの学習のためのライブラリ, npaka, 2023.06
-
https://note.com/npaka/n/nbb974324d6e1
関連:
- trlを使って日本語LLMをSFTからRLHFまで一通り学習させてみる, AI SHIFT, 2023.07
-
https://www.ai-shift.co.jp/techblog/3583
Examples of using peft with trl to finetune 8-bit models with Low Rank Adaption (LoRA) , TRL Documentation
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #Quantization #PEFT(Adaptor/LoRA) #PostTraining Issue Date: 2023-07-22 Comment
LLaMA2を3行で、1つのA100GPU、QLoRAで、自前のデータセットで訓練する方法
Quantized LLaMA2
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #needs-revision Issue Date: 2023-07-22 Comment
LLaMA2をローカルで動作させるために、QLoRAで量子化したモデル
LLongMA2
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ContextWindow #OpenWeight Issue Date: 2023-07-22 Comment
LLaMA2のcontext windowを8kにして訓練。オリジナルのLLaMA2と同等の性能で8k contextを利用可能。
元ツイート:
現在はリンク切れになっている?
Chatbot Arena Conversation Dataset Release, LMSYS Org, 2023.07
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #DialogueGeneration #Blog Issue Date: 2023-07-22 Comment
33kのconversation、2つのレスポンスに対する人間のpreferenceスコア付き
20種類のSoTAモデルのレスポンスを含み、13kのユニークIPからのアクセスがあり、3Kのエキスパートによるアノテーション付き
Auto train advanced, HuggingFace, 2023.07
Paper/Blog Link My Issue
#Article #MachineLearning #Tools #LanguageModel #Supervised-FineTuning (SFT) #Blog #Repository #PEFT(Adaptor/LoRA) #needs-revision #TrainingFramework Issue Date: 2023-07-11 Comment
Hugging Face Hub上の任意のLLMに対して、localのカスタムトレーニングデータを使ってfinetuningがワンラインでできる。
peftも使える。
現在はもうメンテナンスされていないようだ。
Open Source AI Game Jam, 2023
Paper/Blog Link My Issue
#Article #GenerativeAI #Blog #Game Issue Date: 2023-07-11 Comment
GenerativeAIを使ってゲームを作る取り組み
Awesome Multimodal LLMs
Paper/Blog Link My Issue
#Article #Survey #ComputerVision #NLP #LanguageModel #MultiModal #SpeechProcessing Issue Date: 2023-07-03 Comment
マルチモーダルなLLMのリストがまとめられている
Extending Context is Hard…but not Impossible, kaiokendev, 2023.06
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #ContextWindow #needs-revision Issue Date: 2023-07-01 Comment
Open source LLMのcontext lengthをどのように大きくするかに関する議論
How Long Can Open-Source LLMs Truly Promise on Context Length?, 2023
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #LongContext Issue Date: 2023-07-01 Comment
LLMのcontext長を伸ばす際の方法と得られた知見がまとめられている
LM Flow, OptimalScale, 2023.06
Paper/Blog Link My Issue
#Article #MachineLearning #Tools #LanguageModel #Supervised-FineTuning (SFT) #FoundationModel #needs-revision #TrainingFramework Issue Date: 2023-06-26 Comment
一般的なFoundation Modelのファインチューニングと推論を簡素化する拡張可能なツールキット。継続的なpretragning, instruction tuning, parameter efficientなファインチューニング,alignment tuning,大規模モデルの推論などさまざまな機能をサポート。
Ascender
Paper/Blog Link My Issue
#Article #MachineLearning #project_template #python #needs-revision Issue Date: 2023-05-25 Comment
pythonを利用した研究開発する上でのプロジェクトテンプレート
Prompt Engineering vs. Blind Prompting, 2023
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Prompting #Blog #needs-revision Issue Date: 2023-05-12 Comment
experimentalな手法でprompt engineeringする際のoverview
open LLM Leaderboard
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #needs-revision Issue Date: 2023-05-12 Comment
現在はアーカイブされている
awesome-generative-information-retrieval
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #GenerativeAI #needs-revision Issue Date: 2023-05-10 Comment
Generativeなモデルを利用したDocument RetrievalやRecSys等についてまとまっているリポジトリ
OpenSource PaLM, 2023
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Repository #OpenWeight #OpenSource #needs-revision Issue Date: 2023-05-08 Comment
150m,410m,1bのモデルがある。Googleの540bには及ばず、emergent abilityもなかぬか期待できなさそなパラメータ数だが、どの程度の性能なのだろうか。
現在モデルファイルはHF上から削除されているようだ。
MPT-7B, Databricks AI Research, 2023.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #OpenWeight Issue Date: 2023-05-06 Comment
新たなオープンソースLLM。
下記ツイートより引用:
・商用利用可能
・6万5000トークン使用可能
・7Bと比較的小さいモデルながら高性能
・日本語を扱え性能が高い
とのこと。
ChatGPTのLLMと比較すると、ざっと例を見た感じ質問応答としての能力はそこまで高くなさそうな印象。
finetuningしない限りはGPT3,GPT4で良さげ。
Personalized news filtering and summarization on the web, Xindong+, 2011 IEEE 23rd International Conference on Tools with Artificial Intelligence, 29
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #NLP #Personalization Issue Date: 2023-05-05 Comment
summarizationではなく、keyword extractionの話だった
Personalized text summarization based on important terms identification, Robert+, 23rd International Workshop on Database and Expert Systems Applications, 2012, 43
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #NLP #Personalization Issue Date: 2023-05-05 Comment
(あまりしっかりよめていない)
学習者のrevision(復習?)のための教材の要約手法の提案。personalizationするために、さまざまなRaterを定義し、Raterからの単語wに対する評価を集約し、最終的にuser-specificなsentence-term matrixを構築。 SVDを適用することで要約を作成する。personalizedな重み付けに活用されているものとしては、あるコンセプトiに対する学習者の習熟度に基づく重み付けや、学習者の教材に対するannnotationに関する情報などが、単語の重み付けに活用されている。
ChatBot Arena, lmsys org, 2023.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Selected Papers/Blogs #Arena Issue Date: 2023-05-04 Comment
クラウドソーシング型のチャットボット評価するシステム。ユーザはシステムにアクセスすると、二つのanonymisedされたLLMと対話し、どちらが優れていたかをvotingする。すべてのシステムとユーザのinteractionはロギングされており、最終的にElo RatingでLLM.をランキング付けする。
Arena-Hardと呼ばれるliveアリーナデータを用いたパイプラインを公開。MT-Benchよりも識別力が高く、Chatbot Arenaのランキングとのagreementが高いとのこと。
参考:
過去のデータについては Chatbot Arena Conversation Dataset Release, LMSYS Org, 2023.07 などもある
Bark, Suno-AI, 2023.04
Paper/Blog Link My Issue
#Article #NLP #Library #TextToAudio #SpeechProcessing Issue Date: 2023-05-04 Comment
テキストプロンプトで音声生成ができるモデル。MIT License
OpenLLaMA, Xinyang+, 2023.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #OpenWeight #OpenSource Issue Date: 2023-05-04 Comment
LLaMAと同様の手法を似たデータセットに適用し商用利用可能なLLaMAを構築した模様
LLM ecosystem graphs
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #OpenWeight Issue Date: 2023-05-04 Comment
様々なfonudation model、それらを利用したアプリケーション、依存関係がまとまったページ
Percy Liang氏のグループが運用してるっぽい?
When does web-based personalization really work? The distinction between actual personalization and perceived personalization, Li Cong, Computers in human behavior, 2016
Paper/Blog Link My Issue
#Article #Personalization #HumanComputerInteraction Issue Date: 2023-04-28 Comment
personalizedされたメッセージに対するユーザーの認識は、メッセージの以前のpersonalize processに必ずしも依存するのではなく、受信したコンテンツが受信者の期待にどの程度一致しているかに依存することを明らかにした研究
Preface to Special Issue on User Modeling for Web Information Retrieval, Brusilovsky+, User Modeling and User-Adapted Interaction , 2004
Paper/Blog Link My Issue
#Article #InformationRetrieval #Personalization Issue Date: 2023-04-28 Comment
Personalized Information Retrievalの先駆け的研究
[Paper Note] Adaptive Web Search Based on User Profile Constructed without Any Effort from Users, Sugiyama+, NAIST, WWW’04
と同時期
User Profiles for Personalized Information Access, Gauch+, The adaptive Web: methods and strategies of Web personalization, 2007
Paper/Blog Link My Issue
#Article #Survey #InformationRetrieval #Personalization Issue Date: 2023-04-28 Comment
IR分野におけるuser profileの構築方法についてまとめられたsurvey
- 加重キーワード
- セマンティックネットワーク
- 加重コンセプト
について記述されている。また、プロファイルの構築方法についても詳述されている。
Awesome Vector Search Engine
Paper/Blog Link My Issue
#Article #Survey #Embeddings #InformationRetrieval #Search #Library #Repository Issue Date: 2023-04-27 Comment
ベクトルの類似度を測るサービスやライブラリ等がまとまったリポジトリ
HuggingChat, 2023
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #Blog Issue Date: 2023-04-27 Comment
closedな世界で開発されるOpenAIのChatGPTに対して、Openなものが必要ということで、huggingfaceが出したchatシステム
公開はすでに終了している模様
大規模言語モデル間の性能比較まとめ, mah_lab _ 西見 公宏, 2023.04
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel Issue Date: 2023-04-27 Comment
参考になる
現状だと研究用であればllama, 商用利用ならtext-davinci-003あるいはFlanT5-xxlあたりになりそう
LLM Worksheet:
https://docs.google.com/spreadsheets/d/1kT4or6b0Fedd-W_jMwYpb63e1ZR3aePczz3zlbJW-Y4/edit#gid=0
More Design Patterns For Machine Learning Systems, 2023
Paper/Blog Link My Issue
#Article #Mindset #Blog #DesignPattern Issue Date: 2023-04-26 Comment
MLのデザインパターンが記述されている
Polars, 2023
Paper/Blog Link My Issue
#Article #Library #python #Blog #Coding #SoftwareEngineering Issue Date: 2023-01-23 Comment
pandasより100倍高速で複雑なクエリも見やすく書けてindexも存在しないのでバグも出にくいという優れものらしい
tuning_playbook, Google Research
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #MachineLearning Issue Date: 2023-01-21 Comment
Googleが公開したDeep Learningモデル学習のノウハウ。必読
CodeGPT: The VSCode Extension with ChatGPT-Like Functionalities
Paper/Blog Link My Issue
#Article #Tools #GenerativeAI #Blog #Coding #SoftwareEngineering Issue Date: 2023-01-21 Comment
VSCodeの拡張で、//から始まるPromptをエディタ上で記載することで対応するコードをGPT3が生成してくれる模様。便利そう
nlpaug
Paper/Blog Link My Issue
#Article #NLP #Library #DataAugmentation #Repository Issue Date: 2023-01-21 Comment
Data Augmentationのためのオープンソースライブラリ
Transformers Interpret, 2022
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP #Library #Explanation #Transformer #Blog Issue Date: 2022-12-01 Comment
transformersのモデルをたった2行追加するだけで、explainableにするライブラリ
基本的にtextとvisionのclassificationをサポートしている模様
text classificationの場合、たとえばinput tokenの各トークンの分類に対する寄与度をoutputしてくれる。
BetterTransformer, Out of the Box Performance for Hugging Face Transformers
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #EfficiencyImprovement #NLP #Library #Transformer Issue Date: 2022-12-01 Comment
たった1ライン追加するだけで、Transformerのinferenceが最大で4.5倍高速化されるBetterTransformerの解説記事
better_model = BetterTransformer.transform(model)
CNN vs. ViT, Yoshitaka Ushiku, ECCV 2022 読み会, 2022.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #ComputerVision #Transformer #Slide Issue Date: 2022-10-27 Comment
・Swin Transformer, Depth-wise conv, ConvNeXt, ViTとCNNのロバスト性の違いの話があり勉強になる
・最終的な結論が、CNNもTransformerも変わらない(明確な勝者はいない; 今のところ引き分け)というのはおもしろかった
depth-wise conv, point-wise convの解説記事:
https://agirobots.com/depthwise-pointwise-convolution/
通常のCNNのフィルタによるfeature map計算を、空間方向(depth-wise conv)とチャネル方向(point-wise conv; 1x1 conv)に分解することで大幅にパラメータ数削減
MLOps: 機械学習における継続的デリバリーと自動化のパイプライン, Google
Paper/Blog Link My Issue
#Article #Infrastructure #ML-LLM Ops #Blog #needs-revision Issue Date: 2022-04-27 Comment
機械学習(ML)システムの継続的インテグレーション(CI)、継続的デリバリー(CD)、継続的トレーニング(CT)の実装と自動化
MLOpsのレベルを0~2で表現しており、各レベルごとに何が達成されるべきかが図解されている。
NeurIPS 2021 技術報告会, 株式会社TDAI Lab, 2022
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #Slide Issue Date: 2022-02-07 Comment
NeurIPS 2021での技術トレンドがまとめられている
1. アーキテクチャの改善
2. マルチモーダルモデル
3. Temporal Adaptation
4. Retrieval Augmentation
5. ベンチマーク見直し
6. データセット見直し
7. Human-Centered AI
Pythonのオブジェクト指向プログラミングを完全理解, kaitolucifer (Kaito), 2021
Paper/Blog Link My Issue
#Article #Tutorial #Blog #Coding #SoftwareEngineering Issue Date: 2021-11-25 Comment
オブジェクト指向の歴史的背景から、SOLID、GRASP等が詳細に解説されている。辞書的に参照するのが良いかも。
イラストで理解するSOLID原則, baby-degu, 2021
Paper/Blog Link My Issue
#Article #Tutorial #Blog #Coding #SoftwareEngineering Issue Date: 2021-11-25 Comment
オブジェクト指向におけるSOLID原則をイラストで解説した記事。直感的で分かりやすい。
バンディットアルゴリズムを使って広告最適化のシミュレーションをしてみたよ, ysekky, 2014
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #CTRPrediction #Blog Issue Date: 2021-10-29 Comment
なぜクリック率を上げたいのかという説明が非常に参考になる
ラーニング・アナリティクスとは何か?, 武田俊之, コンピュータ&エデュケーション VOL.38, 2015
Paper/Blog Link My Issue
#Article #Tutorial #AdaptiveLearning #LearningAnalytics Issue Date: 2021-10-29 Comment
Learning Analyticsの全体像について、コンパクトにまとまっている。
特に、そのアプローチに関するコンセプトの特徴(e.g. 学習者中心、デーア駆動)や、フレームワーク、xAPIといったデータの測定・収集方法などについて、まとめられている。
HMM Scalable (Bayesian Knowledge Tracing; BKT)
Paper/Blog Link My Issue
#Article #Tools #AdaptiveLearning #StudentPerformancePrediction #KnowledgeTracing Issue Date: 2021-10-29 Comment
BKTを高速で学習できるツール
3-clause BSD license
データレイクのつくりかた、つかいかた、そだてかた, 関山宜孝, AWS Summit, 2020.09
Paper/Blog Link My Issue
#Article #AWS #Infrastructure #Slide Issue Date: 2021-10-08 Comment
こちらも参照のこと
https://logmi.jp/tech/articles/324242
◆伝統的なデータウェアハウスの限界:
場当たり的にデータを蓄積し、活用しているとデータのサイロ化が生じてしまう。
サイロ化したデータを一箇所にまとめて活用できるようにしましょうというのがData Lakeの考え方。
◆データレイクアーキテクチャ
すべてのデータを一元的に保管でき、耐障害性、可用性が高く、スケーラブルで低コストな必要がある。
また、データは非常に多様化しているので、多様なデータをそのままのフォーマットで保管し活用できる必要がある。
ストレージとデータの活用層を疎結合にして、さまざまなユースケース・分析に対処できるようにする。
(たとえば、ストレージに特定のスキーマのテーブルを使っており、そのスキーマに対してしか分析できません、とかは避けるということかな?)
S3上に生データを保存し、AWS Glueでメタデータを管理する。AWS GlueのようなETLサービスを利用してデータを利用しやすい形式に変更して格納し、活用する(pp.9--10)。
データレイクを作る際のポイント「小さく始める」という部分も重要だと思われるので参照のこと
pytorch-fm, 2020
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #Library #FactorizationMachines #Repository Issue Date: 2021-07-03 Comment
下記モデルが実装されているすごいリポジトリ。論文もリンクも記載されており、Factorization Machinesを勉強する際に非常に参考になると思う。MITライセンス。各手法はCriteoのCTRPredictionにおいて、AUC0.8くらい出ているらしい。
- Logistic Regression
- Factorization Machine
- Field-aware Factorization Machine
- Higher-Order Factorization Machines
- Factorization-Supported Neural Network
- Wide&Deep
- Attentional Factorization Machine
- Neural Factorization Machine
- Neural Collaborative Filtering
- Field-aware Neural Factorization Machine
- Product Neural Network
- Deep Cross Network
- DeepFM
- xDeepFM
- AutoInt (Automatic Feature Interaction Model)
- AFN(AdaptiveFactorizationNetwork Model)
Continuously Improving Recommender Systems for Competitive Advantage Using NVIDIA Merlin and MLOps, Nvidia, 2021.01
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial Issue Date: 2021-07-02 Comment
Recommender System運用のためのアーキテクチャに関する情報
Seq2seqモデルのBeam Search Decoding (Pytorch), jonki, 2020.05
Paper/Blog Link My Issue
#Article #Tutorial #BeamSearch #Blog #Reading Reflections Issue Date: 2021-06-24 Comment
ビームサーチについて、コード付きで説明してくれており、大変わかりやすい。
heapqを使って実装している。また、ビームサーチをbatchに対して行う方法についても書いてある(ただ、一部に対してしかbatchでの処理は適用できていない)。
自分もバッチに対して効率的にビームサーチするにはどのように実装すれば良いのかよくわからないので、誰か教えて欲しい。
NVIDIA TRITON INFERENCE SERVER, 2021
Paper/Blog Link My Issue
#Article #MachineLearning #Infrastructure #ML-LLM Ops #Blog Issue Date: 2021-06-18 Comment
Nvidiaのオープンソースのinference server
モデルのデプロイや管理、スケーリング等を良い感じにしてくれるフレームワーク?
最先端自然言語処理ライブラリの最適な選択と有用な利用方法 _ pycon-jp-2020
Paper/Blog Link My Issue
#Article #Tutorial #Tools #NLP #Library #python #Slide Issue Date: 2021-06-11 Comment
各形態素解析ライブラリの特徴や比較がされていて、自分の用途・目的に合わせてどの形態素解析器が良いか意思決定する際に有用。
特にスライド最後の「おわりに」ページにおいて、要点が非常に簡潔にまとまっているため参照のこと。
FastSeq: Make Sequence Generation Faster, Yan+, ACL’21
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #Transformer #ACL Issue Date: 2021-06-10 Comment
BART, DistilBART, T5, GPT2等のさまざまなTransformer-basedな手法で、4-9倍Inference speedを向上させる手法を提案。
OpenKE, 2021
Paper/Blog Link My Issue
#Article #Embeddings #MachineLearning #Tools #Library #KnowledgeGraph #Repository Issue Date: 2021-06-10 Comment
Wikipedia, Freebase等のデータからKnowledge Embeddingを学習できるオープンソースのライブラリ
TRTorch
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #Tools #Library #python Issue Date: 2021-06-06 Comment
pytorchの推論を高速化できるライブラリ。6倍ほど早くなった模様。TorchScriptを介して変換するので、PythonだけでなくC++でも動作できるらしい。
intel MKL
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Library #python #Blog Issue Date: 2021-06-03 Comment
intel CPUでpythonの数値計算を高速化するライブラリ(numpyとかはやくなるらしい; Anacondaだとデフォルトで入ってるとかなんとか)
[Paper Note] Pointing the Unknown Words, Gulcehre+, ACL’16
Paper/Blog Link My Issue
#Article #DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #NLP #ACL Issue Date: 2021-06-02 Comment
Conditional Copy Model (Pointer Softmax)を提案した論文。
単語を生成する際に、語彙内の単語から生成する分布、原文の単語から生成する分布を求める。後者はattention distributionから。コピーするか否かを決める確率変数を導入し(sigmoid)、両生成確率を重み付けする。
コピーメカニズム入れるなら引用すべき。
解説スライド: https://www.slideshare.net/hytae/pointing-the-unknown-words
Sentiment analysis with deeply learned distributed representations of variable length texts, Hong+, Technical Report. Technical report, Stanford University, 2015
Paper/Blog Link My Issue
#Article #NeuralNetwork #SentimentAnalysis #NLP #RepresentationLearning Issue Date: 2021-06-01 Comment
[Paper Note] DKN: Deep Knowledge-Aware Network for News Recommendation, Hongwei Wang+, arXiv'18, 2018.01 より、本論文を引用して「CNN ベースのモデルが、畳み込み演算により文から特定のローカルパターンを検出して抽出できるため、他のモデル(e.g. Recurrent Neural Network, Recursive Neural Network)よりも優れていることが経験的に示されている」とのこと
[Paper Note] Knowledge Tracing: Modeling the Acquisition of Procedural Knowledge, Corbett+, User Modeling and User-Adapted Interaction, 1995
Paper/Blog Link My Issue
#Article #EducationalDataMining #LearningAnalytics #StudentPerformancePrediction #KnowledgeTracing Issue Date: 2021-05-30 Comment
Bayesian Knowledge Tracing (BKT)を提案した論文。Knowledge Tracingについて研究するなら必ず抑えておくべき。
以後、BKTを拡張した研究が数多く提案されている。
locust
Paper/Blog Link My Issue
#Article #Tools #python #PerformanceTesting Issue Date: 2021-05-26 Comment
負荷テスト用のツール
JMeterと違って、pythonコードでテスト内容を制御できるらしく、かなり使いやすいらしい。
DeepFM: A Factorization-Machine based Neural Network for CTR Prediction, Guo+, IJCAI’17
Paper/Blog Link My Issue
#Article #RecommenderSystems #NeuralNetwork #CollaborativeFiltering #FactorizationMachines #CTRPrediction #IJCAI Issue Date: 2021-05-25 Comment
Factorization Machinesと、Deep Neural Networkを、Wide&Deepしました、という論文。Wide=Factorization Machines, Deep=DNN。
高次のFeatureと低次のFeatureを扱っているだけでなく、FMによってフィールドごとのvector-wiseな交互作用、DNNではbit-wiseな交互作用を利用している。
割と色々なデータでうまくいきそうな手法に見える。
発展版としてxDeepFM [Paper Note] xDeepFM: Combining Explicit and Implicit Feature Interactions for Recommender Systems, Jianxun Lian+, arXiv'18, 2018.03
がある。
[Paper Note] Factorization Machines, Steffen Rendle, ICDM'10, 2010.12
にも書いたが、下記リンクに概要が記載されている。
DeepFMに関する動向:
https://data.gunosy.io/entry/deep-factorization-machines-2018
EfficientNet解説, omiita (オミータ), 2019.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #ComputerVision #EfficiencyImprovement #Blog #ImageClassification Issue Date: 2021-05-24 Comment
既存画像認識モデルの構造は変化させず、広さ、深さ、解像度を複合スケーリングすることで、従来よりも少ないパラメータ数、かつ学習速度でSoTAを達成。広さ、深さ、解像度はそれぞれ性能に互いに影響しあっており、従来のように別々にスケーリングするのではなく、3つのバランスをとりながらスケーリングする。スケーリングする際は、結果的にはそれぞれをある値で定数倍すれば良く、そのある値は最大メモリや最大FLOPS数以下(およびFLOPSが2のΦ乗で増加するような)といった制約下でAccuracyが最大化される値をグリッドサーチで見つける(らしい。ざっくりとした理解)。
転移学習しても多くのタスクでSoTA達成した。
Off Policy Evaluation の基礎とOpen Bandit Dataset & Pipelineの紹介, Yuta Saito, 2020.08
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #Tools #Dataset #Slide Issue Date: 2020-08-29 Comment
機械学習による予測精度ではなく、機械学習モデルによって生じる意思決定を、過去の蓄積されたデータから評価する(Off policy Evaluation)の、tutorialおよび実装、データセットについて紹介。
このような観点は実務上あるし、見落としがちだと思うので、とても興味深い。
Collaborative Metric Learningまとめ, guglilac, 2020.01
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #CollaborativeFiltering #ContrastiveLearning #Blog Issue Date: 2020-07-30 Comment
userのembeddingに対し、このuserと共起した(購入やクリックされた)itemを近くに、共起していないitemを遠くに埋め込むような学習方法
BERT 日本語Pre-trained Model, NICT, 2020.03
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tools #NLP #Dataset #LanguageModel #Library #Blog #Japanese #Encoder Issue Date: 2020-03-13 Comment
NICTが公開。既に公開されているBERTモデルとのベンチマークデータでの性能比較も行なっており、その他の公開済みBERTモデルをoutperformしている。
Implicit
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #Library #Selected Papers/Blogs #Reference Collection Issue Date: 2019-09-11 Comment
Implicitデータに対するCollaborative Filtering手法がまとまっているライブラリ
Bayesian Personalized Ranking, Logistic Matrix Factorizationなどが実装。
Implicitの使い方はこの記事がわかりやすい:
https://towardsdatascience.com/building-a-collaborative-filtering-recommender-system-with-clickstream-data-dffc86c8c65
ALSの元論文の日本語解説
https://cympfh.cc/paper/WRMF
Recommender System Datasets, Julian McAuley
Paper/Blog Link My Issue
#Article #RecommenderSystems #Dataset #Selected Papers/Blogs Issue Date: 2019-04-12 Comment
Recommender Systems研究に利用できる各種データセットを、Julian McAuley氏がまとめている。
氏が独自にクロールしたデータ等も含まれている。
非常に有用。
NLP-Progress
Paper/Blog Link My Issue
#Article #Tutorial #Survey #Dataset Issue Date: 2019-02-12 Comment
NLPの様々なタスクのデータセット, およびSOTA(2018年時点)がまとめられている。
[Paper Note] Recommender Systems for Technology Enhanced Learning: Research Trends and Applications, Manouselis+, 2014.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #TechnologyEnhancedLearning #AdaptiveLearning Issue Date: 2018-12-22 Comment
最近のトレンドやアプリケーションを知りたい場合はこちら
[Paper Note] Panorama of recommender systems to support learning, Drachsler+, 2015.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #Education #AdaptiveLearning Issue Date: 2018-12-22 Comment
教育分野に対するRecsysのSurvey
[Paper Note] LEARNING AND TEACHING STYLES IN ENGINEERING EDUCATION, Felder, Engr. Education, 78(7), 674–681, 1988.01
Paper/Blog Link My Issue
#Article #Classic #Education #AdaptiveLearning #LearningStyle #Selected Papers/Blogs Issue Date: 2018-12-22 Comment
LearningStyleに関して研究している古典的な研究。
context-aware recsysの研究初期の頃は、だいたいはこのFelder-Silverman Theoryというのをベースに研究されていたらしい。
[Paper Note] A Conceptual Framework and a Toolkit for Supporting the Rapid Prototyping of Context-Aware Applications, Dey+, HUMAN-COMPUTER INTERACTION, 2001.12, Volume 16, pp. 97–166
Paper/Blog Link My Issue
#Article #Classic #ContextAware #HumanComputerInteraction Issue Date: 2018-12-22 Comment
論文中のcontextに関する定義がしばしば引用される:
"any information that can be used to characterize the situation of an entity. An entity is a person, place, or object that is considered relevant to the interaction between a user and an application, including the user and applications themselves."
The Annotated Transformer, harvardnlp, 2018.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #MachineLearning #NLP Issue Date: 2018-06-29
Curriculum Learning(関東CV勉強会), Yoshitaka Ushiku, 2015.05
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #Slide #CurriculumLearning Issue Date: 2018-02-12 Comment
牛久先生によるCurriculum Learningチュートリアル
[Paper Note] Machine-made index for technical literature: an experiment, IBM Journal of Research and Development, 1958.10
Paper/Blog Link My Issue
#Article #DocumentSummarization #Document #NLP #Extractive Issue Date: 2018-01-17 Comment
初期の要約研究。Luhnらの研究よりはcitation countが少ない。
[Paper Note] SVDFeature: a toolkit for feature-based collaborative filtering, Chen+, JMLR, Vol.13, 2012.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tools #CollaborativeFiltering #MatrixFactorization #JMLR Issue Date: 2018-01-11 Comment
tool: http://apex.sjtu.edu.cn/projects/33
Ratingの情報だけでなく、Auxiliaryな情報も使ってMatrix Factorizationができるツールを作成した。
これにより、Rating Matrixの情報だけでなく、自身で設計したfeatureをMFに組み込んでモデルを作ることができる。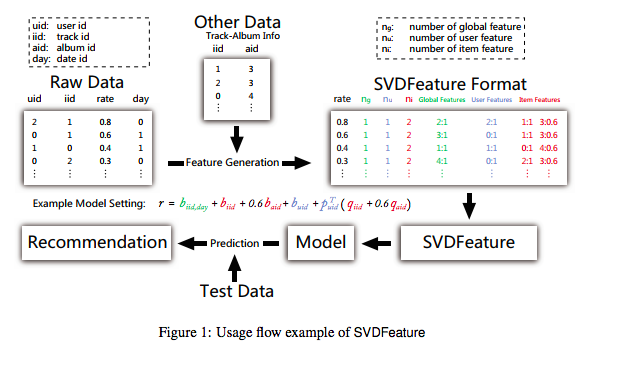
[Paper Note] The Decomposition of Human-Written Summary Sentences, Hongyan Jing+, SIGIR’99
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #SIGIR #Selected Papers/Blogs #WordAlignment Issue Date: 2018-01-11 Comment
参照要約 - 原文書対が与えられた時に、参照要約中の単語と原文書中の単語のアライメントをとるHMMベースな手法を提案。
outputのサンプルはFigure3参照のこと。