
EfficiencyImprovement (450) — 2/3
[Paper Note] AWorld: Orchestrating the Training Recipe for Agentic AI, Chengyue Yu+, arXiv'25
Paper/Blog Link My Issue
#NLP #AIAgents Issue Date: 2025-08-31 GPT Summary- AWorldというオープンソースシステムを導入し、エージェントと環境の相互作用を効率化。経験収集を14.6倍加速し、Qwen3-32Bベースのエージェントを訓練してGAIAの精度を21.59%から32.23%に向上。最難関レベルで商用モデルを超える性能を達成。 Comment
元ポスト:
解説:
[Paper Note] MoE++: Accelerating Mixture-of-Experts Methods with Zero-Computation Experts, Peng Jin+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #MoE(Mixture-of-Experts) #ICLR #read-later Issue Date: 2025-08-31 GPT Summary- 本研究では、Mixture-of-Experts(MoE)手法の効果と効率を向上させるために、MoE++フレームワークを提案。ゼロ計算エキスパートを導入し、低計算オーバーヘッド、高パフォーマンス、デプロイメントの容易さを実現。実験結果により、MoE++は従来のMoEモデルに比べて1.1-2.1倍のスループットを提供し、優れた性能を示す。 Comment
openreview: https://openreview.net/forum?id=t7P5BUKcYv
従来のMoEと比べて、専門家としてzero computation expertsを導入することで、性能を維持しながら効率的にinferenceをする手法(MoEにおいて全てのトークンを均一に扱わない)を提案している模様。
zero computation expertsは3種類で
- Zero Experts: 入力をゼロベクトルに落とす
- Copy Experts: 入力xをそのままコピーする
- Constant Experts: learnableな定数ベクトルvを学習し、xと線形結合して出力する。W_cによって入力xを変換することで線形補 結合の係数a1,a2を入力に応じて動的に決定する。
Routingの手法やgating residual、学習手法の工夫もなされているようなので、後で読む。
[Paper Note] Shortcut-connected Expert Parallelism for Accelerating Mixture-of-Experts, Weilin Cai+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #MoE(Mixture-of-Experts) #ICLR Issue Date: 2025-08-31 GPT Summary- ScMoEは、スパースゲート混合専門家モデルの計算負荷を分散させる新しいアーキテクチャで、通信と計算の重複を最大100%可能にし、全対全通信のボトルネックを解消。これにより、トレーニングで1.49倍、推論で1.82倍のスピードアップを実現し、モデル品質も既存手法と同等またはそれ以上を達成。 Comment
openreview: https://openreview.net/forum?id=GKly3FkxN4¬eId=4tfWewv7R2
[Paper Note] Skip a Layer or Loop it? Test-Time Depth Adaptation of Pretrained LLMs, Ziyue Li+, arXiv'25
Paper/Blog Link My Issue
#Controllable #NLP #Search #LanguageModel #Test-Time Scaling #Decoding #KeyPoint Notes Issue Date: 2025-08-30 GPT Summary- 事前学習済みのLLMの層をモジュールとして操作し、各サンプルに最適なアーキテクチャを構築する手法を提案。モンテカルロ木探索を用いて、数学および常識推論のベンチマークで最適な層の連鎖(CoLa)を特定。CoLaは柔軟で動的なアーキテクチャを提供し、推論効率を改善する可能性を示唆。75%以上の正しい予測に対して短いCoLaを見つけ、60%以上の不正確な予測を正すことができることが明らかに。固定アーキテクチャの限界を克服する道を開く。 Comment
解説:
事前学習済み言語モデルのforward pathにおける各layerをbuilding blocksとみなして、入力に応じてスキップ、あるいは再帰的な利用をMCTSによって選択することで、test time時のモデルの深さや、モデルの凡化性能をタスクに対して適用させるような手法を提案している模様。モデルのパラメータの更新は不要。k, r ∈ {1,2,3,4} の範囲で、"k個のlayerをskip"、あるいはk個のlayerのブロックをr回再帰する、とすることで探索範囲を限定的にしtest時の過剰な計算を抑止している。また、MCTSにおけるsimulationの回数は200回。length penaltyを大きくすることでcompactなforward pathになるように調整、10%の確率でまだ探索していない子ノードをランダムに選択することで探索を促すようにしている。オリジナルと比較して実行時間がどの程度増えてしまうのか?に興味があったが、モデルの深さという観点で推論効率は考察されているように見えたが、実行時間という観点ではざっと見た感じ記載がないように見えた。
以下の広範なQA、幅広い難易度を持つ数学に関するデータで評価(Appendix Bに各データセットごとに500 sampleを利用と記載がある)をしたところ、大幅に性能が向上している模様。ただし、8B程度のサイズのモデルでしか実験はされていない。
- [Paper Note] Think you have Solved Question Answering? Try ARC, the AI2 Reasoning
Challenge, Peter Clark+, arXiv'18
- [Paper Note] DART-Math: Difficulty-Aware Rejection Tuning for Mathematical Problem-Solving, Yuxuan Tong+, NeurIPS'24
関連:
- [Paper Note] Looped Transformers are Better at Learning Learning Algorithms, Liu Yang+, ICLR'24
- [Paper Note] Looped Transformers for Length Generalization, Ying Fan+, ICLR'25
- [Paper Note] Universal Transformers, Mostafa Dehghani+, ICLR'19
- [Paper Note] Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation, Sangmin Bae+, NeurIPS'25
[Paper Note] Ultra-Sparse Memory Network, Zihao Huang+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #MoE(Mixture-of-Experts) #ICLR #read-later #memory Issue Date: 2025-08-29 GPT Summary- UltraMemは、大規模で超スパースなメモリ層を組み込むことで、Transformerモデルの推論レイテンシを削減しつつ性能を維持する新しいアーキテクチャを提案。実験により、UltraMemはMoEを上回るスケーリング特性を示し、最大2000万のメモリスロットを持つモデルが最先端の推論速度と性能を達成することを実証。 Comment
パラメータ数と計算量を分離する手法の一つとみなせる。
[Paper Note] Jet-Nemotron: Efficient Language Model with Post Neural Architecture Search, Yuxian Gu+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #NeuralArchitectureSearch #SmallModel #Reference Collection #Author Thread-Post Issue Date: 2025-08-26 GPT Summary- Jet-Nemotronは新しいハイブリッドアーキテクチャの言語モデルで、フルアテンションモデルと同等以上の精度を持ちながら生成スループットを大幅に改善します。Post Neural Architecture Search(PostNAS)を用いて開発され、事前トレーニングされたモデルから効率的にアテンションブロックを探索します。Jet-Nemotron-2Bモデルは、他の先進モデルに対して高い精度を達成し、生成スループットを最大53.6倍向上させました。 Comment
元ポスト:
著者ポスト:
解説:
所見:
解説:
続報:
コードとチェックポイントがリリース
code: https://github.com/NVlabs/Jet-Nemotron
HF: https://huggingface.co/collections/jet-ai/jet-nemotron-68ac76e8356b5399ef83ac9c
[Paper Note] TokenSkip: Controllable Chain-of-Thought Compression in LLMs, Heming Xia+, EMNLP'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #Reasoning #EMNLP #Length #Inference #Author Thread-Post Issue Date: 2025-08-24 GPT Summary- Chain-of-Thought (CoT)はLLMの推論能力を向上させるが、長いCoT出力は推論遅延を増加させる。これに対処するため、重要度の低いトークンを選択的にスキップするTokenSkipを提案。実験により、TokenSkipはCoTトークンの使用を削減しつつ推論性能を維持することを示した。特に、Qwen2.5-14B-InstructでGSM8Kにおいて推論トークンを40%削減し、性能低下は0.4%未満であった。 Comment
元ポスト:
[Paper Note] Pushing the Envelope of LLM Inference on AI-PC, Evangelos Georganas+, arXiv'25
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Inference #EdgeDevices Issue Date: 2025-08-24 GPT Summary- 超低ビットLLMモデルの登場により、リソース制約のある環境でのLLM推論が可能に。1ビットおよび2ビットのマイクロカーネルを設計し、PyTorch-TPPに統合することで、推論効率を最大2.2倍向上。これにより、AI PCやエッジデバイスでの超低ビットLLMモデルの効率的な展開が期待される。 Comment
元ポスト:
[Paper Note] Hard Examples Are All You Need: Maximizing GRPO Post-Training Under Annotation Budgets, Benjamin Pikus+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #GRPO Issue Date: 2025-08-23 GPT Summary- リソースが制約された状況での言語モデルのファインチューニングにおいて、難易度の異なるトレーニング例の優先順位を検討。実験により、最も難しい例でのトレーニングが最大47%のパフォーマンス向上をもたらすことが示され、難しい例が学習機会を多く提供することが明らかに。これにより、予算制約下での効果的なトレーニング戦略として、難しい例を優先することが推奨される。 Comment
ベースモデルのpass@kが低いhardestなサンプルでGRPOを学習するのがデータ効率が良く、OODに対する汎化性能も発揮されます、というのをQwen3-4B, 14B, Phi4で実験して示しました、という話っぽい?
小規模モデル、およびGSM8K、BIG Bench hardでの、Tracking Shuffled Objectのみでの実験な模様?大規模モデルやコーディングなどのドメインでもうまくいくかはよく分からない。OODの実験もAIME2025でのみの実験しているようなのでそこは留意した方が良いかも。
rewardとして何を使ったのかなどの細かい内容を追えていない。
元ポスト:
[Paper Note] Beyond GPT-5: Making LLMs Cheaper and Better via Performance-Efficiency Optimized Routing, Yiqun Zhang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel Issue Date: 2025-08-23 GPT Summary- LLMのパフォーマンスと効率のバランスを取るために、テスト時ルーティングフレームワーク「Avengers-Pro」を提案。クエリを埋め込み、クラスタリングし、最適なモデルにルーティングすることで、6つのベンチマークで最先端の結果を達成。最強の単一モデルを平均精度で+7%上回り、コストを27%削減しつつ約90%のパフォーマンスを実現。すべての単一モデルの中で最高の精度と最低のコストを提供するパレートフロンティアを達成。コードは公開中。 Comment
元ポスト:
クエリをkmeansでクラスタリングし、各クラスタごとにモデルごとのperformanceとcostを事前に算出しておく。そして新たなクエリが来た時にクエリが割り当てられるtop pのクラスタのperformanae-cost efficiencyを合計し、スコアが高い一つのモデルを選択(=routing)しinferenceを実施する。クエリはQwenでembedding化してクラスタリングに活用する。ハイパーパラメータα∈[0,1]によって、performance, costどちらを重視するかのバランスを調整する。
シンプルな手法だが、GPT-5 mediumと同等のコスト/性能 でより高い 性能/コスト を実現。
性能向上、コスト削減でダメ押ししたい時に使えそうだが、発行するクエリがプロプライエタリデータ、あるいはそもそも全然データないんです、みたいな状況の場合、クエリの割当先となるクラスタを適切に確保する(クラスタリングに用いる十分な量のデータを準備する)のが大変な場面があるかもしれない。
(全然本筋と関係ないが、最近論文のタイトルにBeyondつけるの流行ってる…?)
[Paper Note] LiteASR: Efficient Automatic Speech Recognition with Low-Rank Approximation, Keisuke Kamahori+, EMNLP'25
Paper/Blog Link My Issue
#NeuralNetwork #NLP #AutomaticSpeechRecognition(ASR) #EMNLP #Encoder-Decoder Issue Date: 2025-08-22 GPT Summary- LiteASRは、現代の自動音声認識モデルのエンコーダを低ランク圧縮する手法で、推論コストを大幅に削減しつつ転写精度を維持します。主成分分析を用いて低ランク行列の乗算を近似し、自己注意機構を最適化することで、Whisper large-v3のエンコーダサイズを50%以上圧縮し、Whisper mediumと同等のサイズでより良い転写精度を実現しました。 Comment
元ポスト:
現代のASRモデルはencoderが計算効率の上でボトルネックとなっていたが、Forward Passにおける activatrion Y を PCA (式2, 3)に基づいて2つの低ランク行列の積(とバイアス項の加算; 式5)によって近似し計算効率を大幅に向上させた、という話な模様。weightを低ランクに写像するV_kとバイアス項のY_M(データセット全体に対するactivation Yの平均)はcalibrfationデータによって事前に計算可能とのこと。また、PCAのrank kがattention headの次元数より小さい場合、self-attentionの計算もより(QWKへ写像するWを低ランク行列で近似することで)効率的な手法を採用でき、そちらについても提案されている模様。(ざっくりしか読めていないので誤りがあるかもしれない。)
[Paper Note] Chain-of-Agents: End-to-End Agent Foundation Models via Multi-Agent Distillation and Agentic RL, Weizhen Li+, arXiv'25
Paper/Blog Link My Issue
#Single #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #AIAgents #LongContext #read-later Issue Date: 2025-08-21 GPT Summary- Chain-of-Agents(CoA)という新しいLLM推論パラダイムを提案し、マルチエージェントシステムの協力を単一モデル内でエンドツーエンドに実現。マルチエージェント蒸留フレームワークを用いて、エージェント的な教師ありファインチューニングを行い、強化学習で能力を向上。得られたエージェント基盤モデル(AFMs)は、ウェブエージェントやコードエージェントの設定で新たな最先端性能を示す。研究成果はオープンソース化され、今後の研究の基盤を提供。 Comment
元ポスト:
マルチエージェントのように振る舞うシングルエージェントを、マルチエージェントから得られたtrajectoryを通じて蒸留することめ実現する手法を提案。SFTでcold startに対して訓練した後、verifiable reward (タスクを正常に完了できたか否か)でRLする模様。
データセットも公開されている模様
所見:
解説:
[Paper Note] Less Is More: Training-Free Sparse Attention with Global Locality for Efficient Reasoning, Lijie Yang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention Issue Date: 2025-08-14 GPT Summary- 「LessIsMore」という新しいスパースアテンションメカニズムを提案。これは、トレーニング不要でグローバルアテンションパターンを活用し、トークン選択を効率化。精度を維持しつつ、デコーディング速度を1.1倍向上させ、トークン数を2倍削減。既存手法と比較して1.13倍のスピードアップを実現。 Comment
元ポスト:
トレーニングフリーで1.1倍のデコーディング速度で性能もFull Attentionと同等以上のSparse Attentionらしい
[Paper Note] Beyond Ten Turns: Unlocking Long-Horizon Agentic Search with Large-Scale Asynchronous RL, Jiaxuan Gao+, arXiv'25, 2025.08
Paper/Blog Link My Issue
#NLP #Search #LanguageModel #ReinforcementLearning #AIAgents #Selected Papers/Blogs #KeyPoint Notes #Reference Collection #Asynchronous #Author Thread-Post Issue Date: 2025-08-14 GPT Summary- ASearcherは、LLMベースの検索エージェントの大規模なRLトレーニングを実現するオープンソースプロジェクトであり、高効率な非同期RLトレーニングと自律的に合成された高品質なQ&Aデータセットを用いて、検索能力を向上させる。提案されたエージェントは、xBenchで46.7%、GAIAで20.8%の改善を達成し、長期的な検索能力を示した。モデルとデータはオープンソースで提供される。 Comment
元ポスト:
著者ポスト:
解説ポスト:
関連ベンチマーク:
- [Paper Note] xbench: Tracking Agents Productivity Scaling with Profession-Aligned
Real-World Evaluations, Kaiyuan Chen+, arXiv'25
- GAIA: a benchmark for General AI Assistants, Grégoire Mialon+, N/A, arXiv'23
- [Paper Note] Fact, Fetch, and Reason: A Unified Evaluation of Retrieval-Augmented Generation, Satyapriya Krishna+, N/A, NAACL'25
既存のモデルは <= 10 turnsのデータで学習されており、大規模で高品質なQAデータが不足している問題があったが、シードQAに基づいてQAを合成する手法によって1.4万シードQAから134kの高品質なQAを合成した(うち25.6kはツール利用が必要)。具体的には、シードのQAを合成しエージェントがQAの複雑度をiterationをしながら向上させていく手法を提案。事実情報は常にverificationをされ、合成プロセスのiterationの中で保持され続ける。個々のiterationにおいて、現在のQAと事実情報に基づいて、エージェントは
- Injection: 事実情報を新たに注入しQAをよりリッチにすることで複雑度を上げる
- Fuzz: QA中の一部の詳細な情報をぼかすことで、不確実性のレベルを向上させる。
の2種類の操作を実施する。その上で、QAに対してQuality verificationを実施する:
- Basic Quality: LLMでqualityを評価する
- Difficulty Measurement: LRMによって、複数の回答候補を生成する
- Answer Uniqueness: Difficulty Measurementで生成された複数の解答情報に基づいて、mismatched answersがvalid answerとなるか否かを検証し、正解が単一であることを担保する
また、複雑なタスク、特にtool callsが非常に多いタスクについては、多くのターン数(long trajectories)が必要となるが、既存のバッチに基づいた学習手法ではlong trajectoriesのロールアウトをしている間、他のサンプルの学習がブロックされてしまい学習効率が非常に悪いので、バッチ内のtrajectoryのロールアウトとモデルの更新を分離(ロールアウトのリクエストが別サーバに送信されサーバ上のInference Engineで非同期に実行され、モデルをアップデートする側は十分なtrajectoryがバッチ内で揃ったらパラメータを更新する、みたいな挙動?)することでIdleタイムを無くすような手法を提案した模様。
既存の手法ベンチマークの性能は向上している。学習が進むにつれて、trajectory中のURL参照回数やsearch query数などが増大していく曲線は考察されている。他モデルと比較して、より多いターン数をより高い正確性を以って実行できるといった定量的なデータはまだ存在しないように見えた。
[Paper Note] Difficulty-Based Preference Data Selection by DPO Implicit Reward Gap, Xuan Qi+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #DPO #PostTraining Issue Date: 2025-08-12 GPT Summary- LLMの好みを人間に合わせるための新しいデータ選択戦略を提案。DPOの暗黙的報酬ギャップが小さいデータを選ぶことで、データ効率とモデルの整合性を向上。元のデータの10%で5つのベースラインを上回るパフォーマンスを達成。限られたリソースでのLLM整合性向上に寄与。 Comment
元ポスト:
preference pair dataを学習効率の良いサンプルのみに圧縮することで学習効率を上げたい系の話で、chosen, rejectedなサンプルのそれぞれについて、¥frac{現在のポリシーの尤度}{参照ポリシーの尤度}によってreward rを定義し(おそらく参照ポリシーの尤度によってサンプルの重要度を重みづけしている)、r_chosenとr_rejectedの差をreward gapと定義し、gapが大きいものは難易度が低いと判断してフィルタリングする、といった話に見える。
[Paper Note] Fast and Simplex: 2-Simplicial Attention in Triton, Aurko Roy+, arXiv'25
Paper/Blog Link My Issue
#NLP #Transformer #Attention #Architecture Issue Date: 2025-08-11 GPT Summary- 2-シンプリシアルトランスフォーマーを用いることで、トークン効率を向上させ、標準的なトランスフォーマーよりも優れた性能を発揮することを示す。固定されたトークン予算内で、数学や推論タスクにおいてドット積アテンションを上回る結果を得た。 Comment
元ポスト:
[Paper Note] On the Expressiveness of Softmax Attention: A Recurrent Neural Network Perspective, Gabriel Mongaras+, arXiv'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel Issue Date: 2025-08-05 GPT Summary- 本研究では、ソフトマックスアテンションの再帰的な形式を導出し、線形アテンションがその近似であることを示す。これにより、ソフトマックスアテンションの各部分をRNNの言語で説明し、構成要素の重要性と相互作用を理解する。これにより、ソフトマックスアテンションが他の手法よりも表現力が高い理由を明らかにする。 Comment
元ポスト:
LinearAttention関連の研究は下記あたりがありそう?
- [Paper Note] Efficient Attention: Attention with Linear Complexities, Zhuoran Shen+, arXiv'18
- [Paper Note] Linformer: Self-Attention with Linear Complexity, Sinong Wang+, arXiv'20
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
- [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
たとえばGQAはQwen3で利用されているが、本研究の知見を活用してscaled-dot product attention計算時のSoftmax計算の計算量が削減できたら、さらに計算量が削減できそう?
[Paper Note] SRPO: A Cross-Domain Implementation of Large-Scale Reinforcement Learning on LLM, Xiaojiang Zhang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #On-Policy #CrossDomain Issue Date: 2025-08-03 GPT Summary- 二段階履歴再サンプリングポリシー最適化(SRPO)を提案し、DeepSeek-R1-Zero-32Bを上回る性能をAIME24およびLiveCodeBenchで達成。SRPOはトレーニングステップを約1/10に削減し、効率性を示す。二つの革新として、クロスドメイントレーニングパラダイムと履歴再サンプリング技術を導入し、LLMの推論能力を拡張するための実験を行った。 Comment
元ポスト:
GRPOよりもより効率的な手法な模様。最初に数学のデータで学習をしReasoning Capabilityを身につけさせ、その後別のドメインのデータで学習させることで、その能力を発揮させるような二段階の手法らしい。
Datamixingよりも高い性能(ただし、これは数学とコーディングのCoT Lengthのドメイン間の違いに起因してこのような2 stageな手法にしているようなのでその点には注意が必要そう)?しっかりと読めていないので、読み違いの可能性もあるので注意。
なんたらRPO多すぎ問題
[Paper Note] WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training, Changxin Tian+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Optimizer #read-later #Selected Papers/Blogs #ModelMerge #Stability Issue Date: 2025-08-02 GPT Summary- 学習率スケジューリングの新たなアプローチとして、Warmup-Stable and Merge(WSM)を提案。WSMは、学習率の減衰とモデルマージの関係を確立し、さまざまな減衰戦略を統一的に扱う。実験により、マージ期間がモデル性能において重要であることを示し、従来のWSDアプローチを上回る性能向上を達成。特に、MATHで+3.5%、HumanEvalで+2.9%、MMLU-Proで+5.5%の改善を記録。 Comment
元ポスト:
Weight Decayを無くせるらしい
エッセンスの解説:
チェックポイントさえ保存しておいて事後的に活用することだで、細かなハイパラ調整のための試行錯誤する手間と膨大な計算コストがなくなるのであれば相当素晴らしいのでは…?
解説:
[Paper Note] Efficient Attention Mechanisms for Large Language Models: A Survey, Yutao Sun+, arXiv'25
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Attention Issue Date: 2025-07-31 GPT Summary- Transformerアーキテクチャの自己注意の複雑さが長文コンテキストモデリングの障害となっている。これに対処するため、線形注意手法とスパース注意技術が導入され、計算効率を向上させつつコンテキストのカバレッジを保持する。本研究は、これらの進展を体系的にまとめ、効率的な注意を大規模言語モデルに組み込む方法を分析し、理論と実践を統合したスケーラブルなモデル設計の基礎を提供することを目指す。 Comment
元ポスト:
[Paper Note] Group Sequence Policy Optimization, Chujie Zheng+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #MoE(Mixture-of-Experts) #On-Policy #Stability Issue Date: 2025-07-26 GPT Summary- Group Sequence Policy Optimization (GSPO)は、大規模言語モデルのための新しい強化学習アルゴリズムで、シーケンスの尤度に基づく重要度比を用いてトレーニングを行う。GSPOは、従来のGRPOアルゴリズムよりも効率的で高性能であり、Mixture-of-Experts (MoE) のトレーニングを安定化させる。これにより、最新のQwen3モデルにおいて顕著な改善が見られる。 Comment
元ポスト:
公式ポスト:
GRPOとGSPOの違いのGIF:
[Paper Note] SWE-Perf: Can Language Models Optimize Code Performance on Real-World Repositories?, Xinyi He+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #AIAgents #Evaluation #SoftwareEngineering Issue Date: 2025-07-18 GPT Summary- コードのパフォーマンス最適化は重要であり、LLMsのリポジトリレベルでの能力は未探求。これに対処するため、SWE-Perfという初のベンチマークを導入。140のインスタンスを用いて、LLMsと専門家の最適化パフォーマンスのギャップを評価し、研究機会を示す。 Comment
元ポスト:
これまでのSWE系のベンチマークはBug Fixなどにフォーカスされてきたが、こちらのベンチマークはソフトウェアのパフォーマンス(i.e., 実行時間)を改善させられるかにフォーカスしているとのこと。
実際にリポジトリからPRを収集し、パッチ前後の実行時間を比較。20回のrunを通じて統計的に有意な実行時間の差があるもののみにフィルタリングをしているとのこと。
Human Expertsは平均10.9%のgainを得たが、エージェントは2.3%にとどまっており、ギャップがあるとのこと。
傾向として、LLMはlow levelなインフラストラクチャ(環境構築, 依存関係のハンドリング, importのロジック)を改善するが、Human Expertsはhigh levelなロジックやデータ構造を改善する(e.g., アルゴリズムや、データハンドリング)。
[Paper Note] Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation, Sangmin Bae+, NeurIPS'25
Paper/Blog Link My Issue
#Pretraining #NLP #Transformer #Architecture #NeurIPS #LatentReasoning #memory #RecurrentModels #RecursiveModels #Author Thread-Post Issue Date: 2025-07-17 GPT Summary- Mixture-of-Recursions(MoR)というフレームワークを提案し、再帰型トランスフォーマー内でパラメータ共有と適応計算を同時に実現。MoRは、レイヤーの再利用とトークンごとの再帰深さの動的割り当てにより、メモリアクセス効率を向上させる。135Mから1.7Bパラメータのモデルで、トレーニングFLOPsを維持しつつ、困惑度を低下させ、少数ショット精度を向上。MoRは大規模モデルのコストを抑えつつ、品質向上に寄与することを示す。 Comment
元ポスト:
解説:
関連:
- [Paper Note] Universal Transformers, Mostafa Dehghani+, ICLR'19
- [Paper Note] Looped Transformers for Length Generalization, Ying Fan+, ICLR'25
- [Paper Note] Looped Transformers are Better at Learning Learning Algorithms, Liu Yang+, ICLR'24
著者ポスト:
[Paper Note] SingLoRA: Low Rank Adaptation Using a Single Matrix, David Bensaïd+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #Stability Issue Date: 2025-07-12 GPT Summary- SingLoRAは、LoRAの低ランク適応を再定式化し、単一の低ランク行列とその転置の積を用いることで、トレーニングの安定性を向上させ、パラメータ数をほぼ半減させる手法です。実験により、常識推論タスクでLLama 7Bを用いたファインチューニングで91.3%の精度を達成し、LoRAやLoRA+を上回る結果を示しました。また、画像生成においてもStable Diffusionのファインチューニングで高い忠実度を実現しました。 Comment
元ポスト:
LoRAは低ランク行列BAの積を計算するが、オリジナルのモデルと同じ挙動から学習をスタートするために、Bをzeroで初期化し、Aはランダムに初期化する。このAとBの不均衡さが、勾配消失、爆発、あるいはsub-optimalな収束の要因となってしまっていた(inter-matrix scale conflicts)。特に、LoRAはモデルのwidthが大きくなると不安定になるという課題があった。このため、低ランク行列を2つ使うのではなく、1つの低ランク行列(とその転置)およびoptimizationのstep tごとにtrainableなパラメータがどの程度影響を与えるかを調整する度合いを決めるscalar function u(t)を導入することで、低ランク行列間の不均衡を解消しつつ、パラメータ数を半減し、学習の安定性と性能を向上させる。たとえばu(t)を学習開始時にzeroにすれば、元のLoRAにおいてBをzeroに初期化するのと同じ挙動(つまり元のモデルと同じ挙動から学習スタートができたりする。みたいな感じだろうか?
関連:
- [Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
- LoRA+: Efficient Low Rank Adaptation of Large Models, Soufiane Hayou+, N/A, ICML'24
[Paper Note] First Return, Entropy-Eliciting Explore, Tianyu Zheng+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #RLVR Issue Date: 2025-07-10 GPT Summary- FR3E(First Return, Entropy-Eliciting Explore)は、強化学習における不安定な探索を改善するための構造化された探索フレームワークであり、高不確実性の意思決定ポイントを特定し、中間フィードバックを提供します。実験結果は、FR3Eが安定したトレーニングを促進し、一貫した応答を生成することを示しています。 Comment
元ポスト:
RLVRのロールアウトにおいて、reasoning traceにおける各トークンを出力する際にエントロピーが高い部分を特定し(つまり、複数の候補がありモデルが迷っている)、その部分について異なる意図的に異なる生成パスを実行することで探索を促すようにするとRLVRがよりreliableになるといった話のようである
[Paper Note] Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors, Henrik Klagges+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Author Thread-Post Issue Date: 2025-07-03 GPT Summary- 既存のMoE親モデルの重みテンソルを個別に補間し、線形時間で高性能な子モデルを生成するAssembly-of-Experts(AoE)を提案。重みの組み合わせにより親モデルの特性を制御でき、生成モデルの多くが高性能かつ機能的であることを示した。DeepSeek V3とR1を統合した671BパラメータのChimeraを構築し、ファインチューニングや蒸留なしでR1相当の性能、約40%少ない出力トークン、V3に近い速度を達成。さらに、親モデルより簡潔で整然とした推論を実現。 Comment
モデル(tngtech/DeepSeek-TNG-R1T2-Chimera):
https://huggingface.co/tngtech/DeepSeek-TNG-R1T2-Chimera
公式ポスト:
[Paper Note] NaturalThoughts: Selecting and Distilling Reasoning Traces for General Reasoning Tasks, Yang Li+, arXiv'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Reasoning #Distillation #Author Thread-Post Issue Date: 2025-07-03 GPT Summary- 教師モデルからの推論トレースを用いて生徒モデルの能力を向上させる方法を体系的に研究。NaturalReasoningに基づく高品質な「NaturalThoughts」をキュレーションし、サンプル効率とスケーラビリティを分析。データサイズの拡大が性能向上に寄与し、多様な推論戦略を必要とする例が効果的であることを発見。LlamaおよびQwenモデルでの評価により、NaturalThoughtsが既存のデータセットを上回り、STEM推論ベンチマークで優れた性能を示した。 Comment
元ポスト:
[Paper Note] Chain-of-Experts: Unlocking the Communication Power of Mixture-of-Experts Models, Zihan Wang+, arXiv'25, 2025.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Architecture #MoE(Mixture-of-Experts) Issue Date: 2025-06-28 GPT Summary- MoEにおいて、層内で専門家を逐次的に通信・処理するChain-of-Experts(CoE)を提案。各反復ステップに専用ルーターを設け、トークンを再評価して動的に異なる専門家へ割り当てることで、専門家の組み合わせと表現能力を向上。固定計算量で標準MoEを上回り、反復による新たなスケーリング軸によって、メモリ使用量を抑えつつ幅・深さ方向の拡張に匹敵する性能を実現。 Comment
元ポスト:
[Paper Note] FineWeb2: One Pipeline to Scale Them All -- Adapting Pre-Training Data Processing to Every Language, Guilherme Penedo+, COLM'25
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #MultiLingual #COLM #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2025-06-28 GPT Summary- 多言語LLMsの性能向上のために、FineWebに基づく新しい事前学習データセットキュレーションパイプラインを提案。9つの言語に対して設計選択肢を検証し、非英語コーパスが従来のデータセットよりも高性能なモデルを生成できることを示す。データセットの再バランス手法も導入し、1000以上の言語にスケールアップした20テラバイトの多言語データセットFineWeb2を公開。 Comment
元ポスト:
abstを見る限りFinewebを多言語に拡張した模様
openreview: https://openreview.net/forum?id=jnRBe6zatP#discussion
[Paper Note] OpenVision: A Fully-Open, Cost-Effective Family of Advanced Vision Encoders for Multimodal Learning, Xianhang Li+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#ComputerVision #Pretraining #OpenWeight #OpenSource #Selected Papers/Blogs #ICCV #Encoder #Backbone #One-Line Notes Issue Date: 2025-06-26 GPT Summary- CLIPに代わる完全にオープンで費用対効果に優れた視覚エンコーダ群OpenVisionを提案。 CLIPSとRecap-DataComp-1Bを基盤に、LLaVAなどのマルチモーダルモデルでCLIPと同等以上の性能を実現。 5.9M〜632.1Mパラメータのモデルを公開し、性能重視からエッジ向けの軽量展開まで柔軟な選択肢を提供。 Comment
元ポスト:
v2へアップデート:
事前学習時にtext, image encoderのcontrastive lossで学習していたが、text encoderを無くしimage encoderに入力されたimageからcaptionを生成するcaption lossのみにすることで性能を落とすことなく効率を改善
テクニカルペーパーが出た模様
- [Paper Note] OpenVision 2: A Family of Generative Pretrained Visual Encoders for Multimodal Learning, Yanqing Liu+, arXiv'25
HF:
https://huggingface.co/collections/UCSC-VLAA/openvision-681a4c27ee1f66411b4ae919
pj page:
https://ucsc-vlaa.github.io/OpenVision/
CLIP, SigLIPとは異なり完全にオープンなVision Encoder
v2の解説:
[Paper Note] Vamba: Understanding Hour-Long Videos with Hybrid Mamba-Transformers, Weiming Ren+, arXiv'25
Paper/Blog Link My Issue
#ComputerVision #Transformer #LongContext #SSM (StateSpaceModel) #VideoGeneration/Understandings #ICCV Issue Date: 2025-06-26 GPT Summary- VAMBAモデルは、Mamba-2ブロックを用いてビデオトークンを線形にエンコードし、トークン削減なしで1024フレームを処理可能。これにより、GPUメモリ使用量を50%削減し、トレーニング速度を倍増。1時間のビデオ理解ベンチマークLVBenchで4.3%の精度向上を達成し、様々なビデオ理解タスクで優れた性能を示す。 Comment
元ポスト:
[Paper Note] Drop-Upcycling: Training Sparse Mixture of Experts with Partial Re-initialization, Taishi Nakamura+, ICLR'25
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #MoE(Mixture-of-Experts) #ICLR #KeyPoint Notes Issue Date: 2025-06-25 GPT Summary- Drop-Upcycling手法を提案し、MoEモデルのトレーニング効率を向上。事前にトレーニングされた密なモデルの知識を活用しつつ、一部の重みを再初期化することで専門家の専門化を促進。大規模実験により、5.9BパラメータのMoEモデルが13B密なモデルと同等の性能を達成し、トレーニングコストを約1/4に削減。すべての実験リソースを公開。 Comment
OpenReview: https://openreview.net/forum?id=gx1wHnf5Vp
提案手法の全体像とDiversity re-initializationの概要。元のUpcyclingでは全てidenticalな重みでreplicateされていたため、これが個々のexpertがlong termでの学習で特化することの妨げになり、最終的に最大限のcapabilityを発揮できず、収束が遅い要因となっていた。これを、Upcyclingした重みのうち、一部のindexのみを再初期化することで、replicate元の知識を保持しつつ、expertsの多様性を高めることで解決する。
提案手法は任意のactivation function適用可能。今回はFFN Layerのactivation functionとして一般的なSwiGLUを採用した場合で説明している。
Drop-Upcyclingの手法としては、通常のUpcyclingと同様、FFN Layerの重みをn個のexpertsの数だけreplicateする。その後、re-initializationを実施する比率rに基づいて、[1, intermediate size d_f]の範囲からr*d_f個のindexをサンプリングする。最終的にSwiGLU、およびFFNにおける3つのWeight W_{gate, up, down}において、サンプリングされたindexと対応するrow/columnと対応する重みをre-initializeする。
re-initializeする際には、各W_{gate, up, down}中のサンプリングされたindexと対応するベクトルの平均と分散をそれぞれ独立して求め、それらの平均と分散を持つ正規分布からサンプリングする。
学習の初期から高い性能を発揮し、long termでの性能も向上している。また、learning curveの形状もscratchから学習した場合と同様の形状となっており、知識の転移とexpertsのspecializationがうまく進んだことが示唆される。
[Paper Note] NEAR$^2$: A Nested Embedding Approach to Efficient Product Retrieval and Ranking, Shenbin Qian+, arXiv'25
Paper/Blog Link My Issue
#RecommenderSystems #Embeddings #InformationRetrieval #RepresentationLearning Issue Date: 2025-06-25 GPT Summary- Eコマース情報検索システムは、ユーザーの意図を正確に理解しつつ、大規模な商品カタログを効率的に処理することが難しい。本論文では、NEAR$^2$というネストされた埋め込みアプローチを提案し、推論時の埋め込みサイズを最大12倍効率化し、トレーニングコストを増やさずにトランスフォーマーモデルの精度を向上させる。さまざまなIR課題に対して異なる損失関数を用いて検証した結果、既存モデルよりも小さな埋め込み次元での性能向上を達成した。 Comment
元ポスト:
[Paper Note] Mercury: Ultra-Fast Language Models Based on Diffusion, Inception Labs+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #DiffusionModel #Reference Collection #Initial Impression Notes Issue Date: 2025-06-25 GPT Summary- 新しい拡散型大規模言語モデルMercuryを発表。特にコーディングアプリケーション向けのMercury Coderは、MiniとSmallの2サイズで提供され、速度と品質で最先端を達成。独立評価では、Mercury Coder Miniが1109トークン/秒、Smallが737トークン/秒を記録し、他のモデルを大幅に上回る性能を示す。さらに、実世界での検証結果や公開API、無料プレイグラウンドも提供。 Comment
元ポスト:
スループット(モデルのトークン生成速度)が、SoTAらしいdLLMモデル
解説:
[Paper Note] Wait, We Don't Need to "Wait" Removing Thinking Tokens Improves Reasoning Efficiency, Chenlong Wang+, EMNLP'25 Findings
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #Reasoning #EMNLP #One-Line Notes Issue Date: 2025-06-18 GPT Summary- 自己反省を抑制する「NoWait」アプローチを提案し、推論の効率を向上。10のベンチマークで最大27%-51%の思考の連鎖の長さを削減し、有用性を維持。マルチモーダル推論のための効果的なソリューションを提供。 Comment
Wait, Hmmといったlong CoTを誘導するようなtokenを抑制することで、Accはほぼ変わらずに生成されるトークン数を削減可能、といった図に見える。Reasoningモデルでデコーディング速度を向上したい場合に効果がありそう。
元ポスト:
[Paper Note] Overclocking LLM Reasoning: Monitoring and Controlling Thinking Path Lengths in LLMs, Roy Eisenstadt+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Reasoning Issue Date: 2025-06-17 GPT Summary- LLMの推論プロセスにおける思考段階の長さを調整するメカニズムを探求。進捗をエンコードし、可視化することで計画ダイナミクスを明らかにし、不要なステップを減らす「オーバークロッキング」手法を提案。これにより、考えすぎを軽減し、回答精度を向上させ、推論のレイテンシを減少させることを実証。コードは公開。 Comment
元ポスト:
[Paper Note] Resa: Transparent Reasoning Models via SAEs, Shangshang Wang+, arXiv'25
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #PostTraining #read-later #Author Thread-Post Issue Date: 2025-06-13 GPT Summary- Resaという1.5Bの推論モデル群を提案し、効率的なスパースオートエンコーダーチューニング(SAE-Tuning)手法を用いて訓練。これにより、97%以上の推論性能を保持しつつ、訓練コストを2000倍以上削減し、訓練時間を450倍以上短縮。軽いRL訓練を施したモデルで高い推論性能を実現し、抽出された推論能力は一般化可能かつモジュール化可能であることが示された。全ての成果物はオープンソース。 Comment
元ポスト:
著者ポスト:
論文中で利用されているSource Modelの一つ:
- [Paper Note] Tina: Tiny Reasoning Models via LoRA, Shangshang Wang+, arXiv'25
[Paper Note] Text-to-LoRA: Instant Transformer Adaption, Rujikorn Charakorn+, ICML'25, 2025.06
Paper/Blog Link My Issue
#NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICML #memory #One-Line Notes #Initial Impression Notes #Test Time Training (TTT) #Author Thread-Post Issue Date: 2025-06-12 GPT Summary- Text-to-LoRA(T2L)は、自然言語による説明に基づいて大規模言語モデル(LLMs)を迅速に適応させる手法で、従来のファインチューニングの高コストと時間を克服します。T2Lは、LoRAを安価なフォワードパスで構築するハイパーネットワークを使用し、タスク特有のアダプターと同等のパフォーマンスを示します。また、数百のLoRAインスタンスを圧縮し、新しいタスクに対してゼロショットで一般化可能です。このアプローチは、基盤モデルの専門化を民主化し、計算要件を最小限に抑えた言語ベースの適応を実現します。 Comment
元ポスト:
な、なるほど、こんな手が…!
openreview: https://openreview.net/forum?id=zWskCdu3QA
ポイント解説:
Text-to-LoRAの目的は、instructionをメモリの内部パラメータに埋め込み、モデルにon-the-flyで新たな挙動を身につけさせること。
[Paper Note] Saffron-1: Towards an Inference Scaling Paradigm for LLM Safety Assurance, Ruizhong Qiu+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ReinforcementLearning #Safety #Author Thread-Post Issue Date: 2025-06-11 GPT Summary- 既存のLLMの安全保証研究は主にトレーニング段階に焦点を当てているが、脱獄攻撃に対して脆弱であることが明らかになった。本研究では、推論スケーリングを用いた新たな安全性向上手法SAFFRONを提案し、計算オーバーヘッドを削減する多分岐報酬モデル(MRM)を導入。これにより、報酬モデル評価の数を減らし、探索-効率性のジレンマを克服する。実験により手法の有効性を確認し、訓練済みモデルと安全報酬データセットを公開。 Comment
元ポスト:
[Paper Note] Unleashing the Reasoning Potential of Pre-trained LLMs by Critique Fine-Tuning on One Problem, Yubo Wang+, EMNLP'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #EMNLP #Reference Collection #Author Thread-Post Issue Date: 2025-06-05 GPT Summary- 本研究では、強力な大規模言語モデル(LLM)の推論能力を引き出すために、批評微調整(CFT)が効果的であることを示します。CFTは、単一の問題に対する多様な解を収集し、教師LLMによる批評データを構築する手法です。QwenおよびLlamaモデルを微調整した結果、数学や論理推論のベンチマークで顕著な性能向上を観察しました。特に、わずか5時間のトレーニングで、Qwen-Math-7B-CFTは他の手法と同等以上の成果を上げました。CFTは計算効率が高く、現代のLLMの推論能力を引き出すためのシンプルなアプローチであることが示されました。 Comment
元ポスト:
関連:
- [Paper Note] Critique Fine-Tuning: Learning to Critique is More Effective than Learning to Imitate, Yubo Wang+, COLM'25
- [Paper Note] Reinforcement Learning for Reasoning in Large Language Models with One Training Example, Yiping Wang+, arXiv'25, 2025.04
参考:
[Paper Note] dKV-Cache: The Cache for Diffusion Language Models, Xinyin Ma+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #DiffusionModel #Initial Impression Notes Issue Date: 2025-05-24 GPT Summary- 拡散型言語モデル(DLMs)の推論速度の遅さを解決するために、遅延KVキャッシュという機構を提案。異なるトークンが異なる表現ダイナミクスを持つことに基づき、キーと値の状態を遅延かつ条件付きでキャッシュ。二つの変種(dKV-Cache-DecodeとdKV-Cache-Greedy)を設計し、推論速度を2〜10倍に向上。実験により、DLMsの加速が現行モデルに追加のトレーニングなしで可能であることを示した。 Comment
元ポスト:
提案手法を適用した場合、ARなモデルとDiffusion Modelで、実際のところどの程度のdecoding速度の差があるのだろうか?そういった分析はざーーっと見た感じ見当たらなかったように思える。
[Paper Note] Parallel Scaling Law for Language Models, Mouxiang Chen+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Scaling Laws #Reference Collection #Initial Impression Notes Issue Date: 2025-05-21 GPT Summary- 言語モデルのスケーリングにおいて、パラメータや出力トークンの増加に伴うコストを軽減する新たなアプローチ「並列スケーリング(ParScale)」を提案。モデルの並列計算を増やし、$P$ 個の多様な変換を実行することで、推論効率を向上させ、$O(\log P)$ のパラメータスケーリングと同等の効果を実現。メモリ増加を最大22倍、レイテンシを最大6倍削減可能。少量のトークンでのポストトレーニングを通じて、既製のモデルを再利用可能で、より強力なモデルの展開を促進。 Comment
元ポスト:
- [Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
と考え方が似ている
[Paper Note] AdaCoT: Pareto-Optimal Adaptive Chain-of-Thought Triggering via Reinforcement Learning, Chenwei Lou+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #Chain-of-Thought #Reasoning #One-Line Notes Issue Date: 2025-05-21 GPT Summary- AdaCoTは、LLMがChain-of-Thought(CoT)の使用を適応的に決定する新しい枠組み。これにより、計算コストや非効率性を軽減しつつ、複雑なクエリにおける推論性能を維持する。特にProximal Policy Optimization(PPO)を用いたRL手法を導入し、Selective Loss Masking(SLM)で推論トリガを安定させ、実験ではCoTトリガー率を最大3.18%削減、応答トークン数を69.06%削減したことが示された。 Comment
RLのRewardにおいて、baseのリワードだけでなく、
- reasoningをなくした場合のペナルティ項
- reasoningをoveruseした場合のペナルティ項
- formattingに関するペナルティ項
を設定し、reasoningの有無を適切に判断できた場合にrewardが最大化されるような形にしている。(2.2.2)
が、multi-stageのRLでは(stageごとに利用するデータセットを変更するが)、データセットの分布には歪みがあり、たとえば常にCoTが有効なデータセットも存在しており(数学に関するデータなど)、その場合常にCoTをするような分布を学習してしまい、AdaptiveなCoT decisionが崩壊したり、不安定になってしまう(decision boundary collapseと呼ぶ)。特にこれがfinal stageで起きると最悪で、これまでAdaptiveにCoTされるよう学習されてきたものが全て崩壊してしまう。これを防ぐために、Selective Loss Maskingというlossを導入している。具体的には、decision token [^1]のlossへの貢献をマスキングするようにすることで、CoTが生じるratioにバイアスがかからないようにする。今回は、Decision tokenとして、`
[^1]: CoTするかどうかは多くの場合このDecision Tokenによって決まる、といったことがどっかの研究に示されていたはず
いつか必要になったらしっかり読むが、全てのステージでSelective Loss Maskingをしたら、SFTでwarm upした段階からあまりCoTのratioが変化しないような学習のされ方になる気がするが、どのステージに対してapplyするのだろうか。
openreview: https://openreview.net/forum?id=obXGSmmG70
[Paper Note] Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures, Chenggang Zhao+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #LLMServing #Architecture #MoE(Mixture-of-Experts) #SoftwareEngineering Issue Date: 2025-05-20 GPT Summary- LLMのスケーリングは、メモリ、計算効率、帯域幅における制約を明らかにした。DeepSeek-V3は、ハードウェアを意識したモデル設計でこれらの課題に対処し、効率的なトレーニングと推論を実現。特に、メモリ効率を向上させるMLA、計算と通信を最適化するMoE、FP8混合精度トレーニング、ネットワークオーバーヘッドを減少させるマルチプレーン・トポロジーが革新のポイント。将来のハードウェア設計に向けた広範な議論を通じて、AIの需要に応えるためのモデル共設計の重要性を強調。 Comment
元ポスト:
[Paper Note] Faster Cascades via Speculative Decoding, Harikrishna Narasimhan+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ICLR #Test-Time Scaling #Decoding #Verification #SpeculativeDecoding #Reference Collection Issue Date: 2025-05-13 GPT Summary- カスケードと推測デコーディングは、言語モデルの推論効率を向上させる手法であり、異なるメカニズムを持つ。カスケードは難しい入力に対して大きなモデルを遅延的に使用し、推測デコーディングは並行検証で大きなモデルを活用する。新たに提案する推測カスケーディング技術は、両者の利点を組み合わせ、最適な遅延ルールを特定する。実験結果は、提案手法がカスケードおよび推測デコーディングのベースラインよりも優れたコスト品質トレードオフを実現することを示した。 Comment
元ポスト:
OpenReview: https://openreview.net/forum?id=vo9t20wsmd
[Paper Note] Nemotron-CC: Transforming Common Crawl into a Refined Long-Horizon Pretraining Dataset, Dan Su+, ACL'25
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #ACL #Selected Papers/Blogs Issue Date: 2025-05-10 GPT Summary- FineWeb-EduとDCLMは、モデルベースのフィルタリングによりデータの90%を削除し、トレーニングに適さなくなった。著者は、アンサンブル分類器や合成データの言い換えを用いて、精度とデータ量のトレードオフを改善する手法を提案。1Tトークンで8Bパラメータモデルをトレーニングし、DCLMに対してMMLUを5.6ポイント向上させた。新しい6.3Tトークンデータセットは、DCLMと同等の性能を持ちながら、4倍のユニークなトークンを含み、長トークンホライズンでのトレーニングを可能にする。15Tトークンのためにトレーニングされた8Bモデルは、Llama 3.1の8Bモデルを上回る性能を示した。データセットは公開されている。
[Paper Note] Reinforcement Learning for Reasoning in Large Language Models with One Training Example, Yiping Wang+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #NeurIPS #read-later #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2025-05-09 GPT Summary- 1-shot RLVRを用いることで、大規模言語モデルの数学的推論能力が向上することを示した。Qwen2.5-Math-1.5BにRLVRを適用し、MATH500の性能を36.0%から73.6%に引き上げたほか、6つの一般的な数学的推論ベンチマークも改善。異なるモデルやRLアルゴリズムでも顕著な向上が観察され、訓練精度の飽和後もテスト性能が持続改善する現象が見られた。これらの知見は、RLVRの効率性に関する今後の研究を促進する重要な要素であり、全リソースはオープンソースで公開されている。 Comment
下記ポストでQwenに対してpromptを適切に与えることで、追加のpost training無しで高い数学に関する能力を引き出せたという情報がある。おそらく事前学習時に数学のQAデータによって継続事前学習されており、この能力はその際に身についているため、数学に対する高い能力は実は簡単に引き出すことができるのかもしれない(だから1サンプルでも性能が向上したのではないか?)といった考察がある。
参考:
- [Paper Note] ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models, Mingjie Liu+, NeurIPS'25
とはどのような関係性があるだろうか?
著者ポスト:
openreview: https://openreview.net/forum?id=IBrRNLr6JA
[Paper Note] Tina: Tiny Reasoning Models via LoRA, Shangshang Wang+, arXiv'25
Paper/Blog Link My Issue
#NLP #ReinforcementLearning #Reasoning #SmallModel #PEFT(Adaptor/LoRA) #GRPO #read-later #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-07 GPT Summary- Tinaは、コスト効率よく強力な推論能力を実現する小型の推論モデルファミリーであり、1.5Bパラメータのベースモデルに強化学習を適用することで高い推論性能を示す。Tinaは、従来のSOTAモデルと競争力があり、AIME24で20%以上の性能向上を達成し、トレーニングコストはわずか9ドルで260倍のコスト削減を実現。LoRAを通じた効率的なRL推論の効果を検証し、すべてのコードとモデルをオープンソース化している。 Comment
元ポスト:
(おそらく)Reasoningモデルに対して、LoRAとRLを組み合わせて、reasoning能力を向上させた初めての研究
[Paper Note] BitNet b1.58 2B4T Technical Report, Shuming Ma+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #Quantization #SmallModel #PostTraining #One-Line Notes Issue Date: 2025-04-19 GPT Summary- BitNet b1.58 2B4Tは、2億パラメータを持つ初のオープンソースの1ビット大規模言語モデルであり、4兆トークンのコーパスで訓練されています。言語理解や数学的推論、コーディング能力などのベンチマークで評価され、同等のスケールの全精度LLMと同等の性能を示す一方で、計算効率の向上を実現しています。具体的には、メモリ使用量、エネルギー消費、デコード遅延を大幅に削減しています。モデルウェイトはHugging Faceを通じて公開され、オープンソースの推論実装も提供されます。 Comment
元ポスト:
圧倒的省メモリかつcpuでのinference速度も早そう
- アーキテクチャはTransformerを利用
- Linear layerとしてBitLinear Layerを利用
- 重みは{1, 0, -1}の3値をとる
- activationは8bitのintegerに量子化
- Layer Normalizationはsubln normalization [Paper Note] Magneto: A Foundation Transformer, Hongyu Wang+, ICML'23
を利用
[Paper Note] Scalable-Softmax Is Superior for Attention, Ken M. Nakanishi, arXiv'25, 2025.01
Paper/Blog Link My Issue
#NLP #Transformer #LongContext #Architecture #Reference Collection Issue Date: 2025-04-06 GPT Summary- SSMaxを提案し、Softmaxの代替としてTransformerモデルに統合。これにより、長いコンテキストでの重要情報の取得が向上し、事前学習中の損失減少が速くなる。SSMaxは注意スコアを改善し、長さの一般化を促進する。 Comment
- Llama 4 Series, Meta, 2025.04
で採用されている手法で、ブログポスト中で引用されている。Long Contextになった場合にsoftmaxの分布が均一になる(=重要な情報にattendする能力が削がれる)ことを防ぐための手法を提案している。
解説ポスト:
[Paper Note] Demystifying LLM-based Software Engineering Agents, Chunqiu Steven Xia+, FSE'25, 2024.07
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #SoftwareEngineering #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2025-04-02 GPT Summary- 最近のLLMの進展により、ソフトウェア開発タスクの自動化が進んでいるが、複雑なエージェントアプローチの必要性に疑問が生じている。これに対し、Agentlessというエージェントレスアプローチを提案し、シンプルな三段階プロセスで問題を解決。SWE-bench Liteベンチマークで最高のパフォーマンスと低コストを達成。研究は自律型ソフトウェア開発におけるシンプルで解釈可能な技術の可能性を示し、今後の研究の方向性を刺激することを目指している。 Comment
日本語解説: https://note.com/ainest/n/nac1c795e3825
LLMによる計画の立案、環境からのフィードバックによる意思決定などの複雑なワークフローではなく、Localization(階層的に問題のある箇所を同定する)とRepair(LLMで複数のパッチ候補を生成する)、PatchValidation(再現テストと回帰テストの両方を通じて結果が良かったパッチを選ぶ)のシンプルなプロセスを通じてIssueを解決する。
これにより、低コストで高い性能を達成している、といった内容な模様。
Agentlessと呼ばれ手法だが、preprint版にあったタイトルの接頭辞だった同呼称がproceeding版では無くなっている。
[Paper Note] Stop Overthinking: A Survey on Efficient Reasoning for Large Language Models, Yang Sui+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Reasoning #Overthinking #One-Line Notes Issue Date: 2025-03-22 GPT Summary- 本論文では、LLMsにおける効率的な推論の進展を体系的に調査し、以下の主要な方向に分類します:(1) モデルベースの効率的推論、(2) 推論出力ベースの効率的推論、(3) 入力プロンプトベースの効率的推論。特に、冗長な出力による計算オーバーヘッドを軽減する方法を探求し、小規模言語モデルの推論能力や評価方法についても議論します。 Comment
Reasoning Modelにおいて、Over Thinking現象(不要なreasoning stepを生成してしまう)を改善するための手法に関するSurvey。
下記Figure2を見るとよくまとまっていて、キャプションを読むとだいたい分かる。なるほど。
Length Rewardについては、
- [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
で考察されている通り、Reward Hackingが起きるので設計の仕方に気をつける必要がある。
元ポスト:
各カテゴリにおけるliteratureも見やすくまとめられている。必要に応じて参照したい。
[Paper Note] The First Few Tokens Are All You Need: An Efficient and Effective Unsupervised Prefix Fine-Tuning Method for Reasoning Models, Ke Ji+, NeurIPS'25, 2025.03
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #Reasoning #PEFT(Adaptor/LoRA) #NeurIPS #KeyPoint Notes #Reading Reflections Issue Date: 2025-03-19 GPT Summary- 非教師ありプレフィックスファインチューニング(UPFT)を提案し、LLMの推論効率を向上。初期のプレフィックス部分文字列に基づいて訓練し、ラベル付きデータやサンプリングを不要に。UPFTは、教師あり手法と同等の性能を維持しつつ、訓練時間を75%、サンプリングコストを99%削減。最小限の非教師ありファインチューニングで大幅な推論向上を実現し、リソース効率の良い代替手段を提供。 Comment
斜め読みだが、reasoning traceの冒頭部分は重要な役割を果たしており、サンプリングした多くのresponseのreasoning traceにおいて共通しているものは重要という直感から(Prefix Self-Consistency)、reasoning traceの冒頭部分を適切に生成できるようにモデルをFinetuningする。従来のRejection Samplingを用いた手法では、複数のresponseを生成させて、最終的なanswerが正解のものをサンプリングするため正解ラベルが必要となるが、提案手法ではreasoning traceの冒頭部分の共通するsubsequenceをmajority voteするだけなのでラベルが不要である。
reasoning prefixを学習する際は下記のようなテンプレートを用いる。このときに、prefixのspanのみを利用して学習することで大幅に学習時間を削減できる。
また、そのような学習を行うとcatastrophic forgettingのリスクが非常に高いが、これを防ぐために、マルチタスクラーニングを実施する。具体的には学習データのp%については全体のreasoning traceを生成して学習に利用する。このときに、最終的な回答の正誤を気にせずtraceを生成して学習に利用することで、ラベルフリーな特性を維持できる(つまり、こちらのデータは良いreasoning traceを学習することを目的としているわけではなく、あくまでcatastrophic forgettingを防ぐためにベースモデルのようなtraceもきちんと生成できれば良い、という感覚だと思われる)。
AppendixにQwenを用いてtemperature 0.7で16個のresponseをサンプリングし、traceの冒頭部分が共通している様子が示されている。
下記論文でlong-CoTを学習させる際のlong-CoTデータとして、reasoningモデルから生成したtraceと非reasoning modelから生成したtraceによるlong-CoTデータを比較したところ前者の方が一貫して学習性能が良かったとあるが、この研究でもreasoning traceをつよつよモデルで生成したら性能上がるんだろうか。
- [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
[Paper Note] Transformers without Normalization, Jiachen Zhu+, CVPR'25
Paper/Blog Link My Issue
#MachineLearning #NLP #Transformer #Architecture #CVPR #Normalization #One-Line Notes #Author Thread-Post Issue Date: 2025-03-14 GPT Summary- 本研究では、正規化層なしのトランスフォーマーがDynamic Tanh(DyT)を用いることで、同等またはそれ以上のパフォーマンスを達成できることを示します。DyTは、レイヤー正規化の代替として機能し、ハイパーパラメータの調整なしで効果を発揮します。多様な設定での実験により、正規化層の必要性に対する新たな洞察を提供します。 Comment
なん…だと…。LayerNormalizationを下記アルゴリズムのようなtanhを用いた超絶シンプルなレイヤー(parameterized thnh [Lecun氏ポスト](
同等以上の性能を維持しながらモデル全体のinference, trainingの時間を8%程度削減。
[Paper Note] Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention, Jingyang Yuan+, ACL'25
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Attention #ACL #read-later #One-Line Notes #Reference Collection Issue Date: 2025-03-02 GPT Summary- 長文コンテキストモデリングのために、計算効率を改善するスパースアテンションメカニズム「NSA」を提案。NSAは動的な階層スパース戦略を用い、トークン圧縮と選択を組み合わせてグローバルなコンテキスト認識とローカルな精度を両立。実装最適化によりスピードアップを実現し、エンドツーエンドのトレーニングを可能にすることで計算コストを削減。NSAはフルアテンションモデルと同等以上の性能を維持しつつ、長シーケンスに対して大幅なスピードアップを達成。 Comment
元ポスト:
ACL'25のBest Paperの一つ:
[Paper Note] Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models, Weixin Liang+, TMLR'25
Paper/Blog Link My Issue
#ComputerVision #NLP #LanguageModel #Transformer #MultiModal #SpeechProcessing #Architecture #TMLR #UMM Issue Date: 2024-11-12 GPT Summary- 大規模言語モデル(LLMs)のマルチモーダル処理を効率化するために、Mixture-of-Transformers(MoT)を提案。MoTは計算コストを削減し、モダリティごとにパラメータを分離して特化した処理を実現。Chameleon 7B設定では、55.8%のFLOPsで密なベースラインに匹敵する性能を示し、音声を含む場合も37.2%のFLOPsで同様の結果を達成。さらに、Transfusion設定では、7BのMoTモデルが密なベースラインの画像性能に対してFLOPsの3分の1で匹敵し、760Mのモデルは主要な画像生成指標で上回る結果を得た。MoTは実用的な利点も示し、画像品質を47.2%、テキスト品質を75.6%の経過時間で達成。
[Paper Note] The Unreasonable Ineffectiveness of the Deeper Layers, Andrey Gromov+, ICLR'25, 2024.03
Paper/Blog Link My Issue
#NLP #LanguageModel #Pruning #ICLR #One-Line Notes Issue Date: 2024-04-22 GPT Summary- LLMの重みの知識格納を層剪定で研究。不要なパラメータを特定し、層を削除しても性能に影響がないか確認。驚くべき結果として、最大で半分の層を削除しても性能低下がわずかであることが示された。この頑健性は浅い層が重要な役割を果たしている可能性を示唆。PEFT手法を用いて実験を効率化。 Comment
下記ツイートによると、学習済みLLMから、コサイン類似度で入出力間の類似度が高い層を除いてもタスクの精度が落ちず、特に深い層を2-4割削除しても精度が落ちないとのこと。
参考:
VRAMに載せるのが大変なので、このような枝刈り技術が有効だと分かるのはありがたい。LoRAや量子化も利用しているっぽい。
openreview: https://openreview.net/forum?id=ngmEcEer8a
[Paper Note] You Only Cache Once: Decoder-Decoder Architectures for Language Models, Yutao Sun+, NeurIPS'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Architecture #NeurIPS #Decoder-Decoder Issue Date: 2026-09-10 GPT Summary- YOCOというデコーダ-デコーダ型アーキテクチャを提案。これは一度だけKVペアをキャッシュし、自己デコーダとクロスデコーダから構成される。効率的なKVキャッシュのエンコードにより、クロスアテンションを介して再利用され、GPUメモリを削減しつつグローバルなアテンションを保持。プレフィル段階を早期終了可能にし、計算を高速化。実験により、Transformerと比較して好ましい性能を確認し、1Mのコンテキスト長で高精度を達成。推論時のメモリ使用量やスループットも大幅に改善。コードは https://aka.ms/YOCO で公開。 Comment
openreview: https://openreview.net/forum?id=25Ioxw576r
inputをself-decoderと呼ばれる効率的なself-attentionを備えたエンコーダでエンコードしKV Cacheを生成。それを後段のDecoderと共有し、Decoder側はcross-attentionによって参照することで、利用するKV Cache圧縮するアーキテクチャ、に見える。
ポイント解説:
[Paper Note] Various Lengths, Constant Speed: Efficient Language Modeling with Lightning Attention, Zhen Qin+, ICML'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Attention #LongContext #ICML #One-Line Notes #LinearAttention Issue Date: 2026-02-17 GPT Summary- Lightning Attentionは、一定の学習速度を維持しつつ固定メモリ消費を実現する線形注意の新しい実装です。累積和演算の問題を、異なる計算戦略を用いることで解決し、ブロック内では従来の注意計算を、ブロック間では線形注意のカーネル技術を導入しています。GPUを効率的に活用するためのタイル化技術を採用し、新しいアーキテクチャTransNormerLLM(TNL)を提案。TNLは他のモデルより効率的で、従来のトランスフォーマーと同等の性能を示します。ソースコードは公開されています。 Comment
Ring、MiniCPMで採用されているlinear attentionの一種であるlightning attention
[Paper Note] Mamba: Linear-Time Sequence Modeling with Selective State Spaces, Albert Gu+, COLM'24, 2023.12
Paper/Blog Link My Issue
#NLP #LanguageModel #SSM (StateSpaceModel) #COLM #Selected Papers/Blogs #LinearAttention Issue Date: 2026-02-04 GPT Summary- ファウンデーションモデルはトランスフォーマーを基盤としており、計算非効率性を解決するために新たなアーキテクチャが開発されたが、言語モダリティではあまり効果的でなかった。私たちは内容ベースの推論能力の欠如を特定し、SSMのパラメータを入力に依存させることで、情報の選択的伝播を可能にした。さらに、ハードウェアに適応した並列アルゴリズムを設計し、簡略化されたニューラルネットワークアーキテクチャMambaに統合した。このMambaは、高速な推論とシーケンス長での線形スケーリングを可能にし、言語や音声などで最先端の性能を達成。特にMamba-3Bモデルは、同サイズのトランスフォーマーを上回る性能を示した。 Comment
openreview: https://openreview.net/forum?id=tEYskw1VY2
日本語解説: https://qiita.com/peony_snow/items/649ecb307cd3b5c10aa7
関連:
- [Paper Note] Retentive Network: A Successor to Transformer for Large Language Models, Yutao Sun+, arXiv'23, 2023.07
- [Paper Note] RWKV: Reinventing RNNs for the Transformer Era, Bo Peng+, N/A, EMNLP'23 Findings, 2023.05
[Paper Note] MANTIS: Interleaved Multi-Image Instruction Tuning, Dongfu Jiang+, TMLR'24 Outstanding Certification, 2024.05
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #InstructionTuning #MultiModal #TMLR #Selected Papers/Blogs #VisionLanguageModel #2D (Image) Issue Date: 2025-12-02 GPT Summary- Mantisモデルは、721Kの複数画像指示データを用いた指示調整により、複数画像の視覚言語タスクで最先端の性能を達成。特に、Idefics2-8Bを平均13ポイント上回り、一般化能力も示す。大規模な事前学習に依存せず、低コストの指示調整で複数画像能力を向上できることを示した。 Comment
openreview: https://openreview.net/forum?id=skLtdUVaJa
元ポスト:
[Paper Note] Depth Anything V2, Lihe Yang+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#ComputerVision #SyntheticData #2D (Image) #DepthEstimation Issue Date: 2025-11-18 GPT Summary- Depth Anything V2を提案し、合成画像の使用、教師モデルの能力拡大、擬似ラベル付き実画像を用いた学生モデルの教育を通じて、より細かく堅牢な深度推定を実現。最新のStable Diffusionモデルと比較して、効率的かつ正確であり、異なるスケールのモデルを提供。多様なシーンを考慮した評価ベンチマークも構築。 Comment
pj page: https://depth-anything-v2.github.io
[Paper Note] Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs, Arash Ahmadian+, ACL'24, 2024.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ReinforcementLearning #ACL #read-later #Selected Papers/Blogs Issue Date: 2025-09-27 GPT Summary- RLHFにおける整合性の重要性を考慮し、PPOの高コストとハイパーパラメータ調整の問題を指摘。シンプルなREINFORCEスタイルの最適化手法がPPOや新提案の手法を上回ることを示し、LLMの整合性特性に適応することで低コストのオンラインRL最適化が可能であることを提案。
[Paper Note] MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies, Shengding Hu+, COLM'24
Paper/Blog Link My Issue
#NLP #LanguageModel #SmallModel #COLM #Selected Papers/Blogs #Scheduler #One-Line Notes Issue Date: 2025-08-25 GPT Summary- 急成長する大規模言語モデル(LLMs)の開発におけるコストの懸念から、小規模言語モデル(SLMs)の可能性が注目されている。本研究では、MiniCPMという1.2Bおよび2.4Bの非埋め込みパラメータバリアントを紹介し、これらが7B-13BのLLMsと同等の能力を持つことを示す。モデルのスケーリングには広範な実験を、データのスケーリングにはWarmup-Stable-Decay(WSD)学習率スケジューラを導入し、効率的なデータ-モデルスケーリング法を研究した。MiniCPMファミリーにはMiniCPM-DPO、MiniCPM-MoE、MiniCPM-128Kが含まれ、優れたパフォーマンスを発揮している。MiniCPMモデルは公開されている。 Comment
Warmup-Stable-Decay (WSD)
openreview: https://openreview.net/forum?id=3X2L2TFr0f¬eId=QvwPc5chyd
[Paper Note] Better & Faster Large Language Models via Multi-token Prediction, Fabian Gloeckle+, ICML'24
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Coding #ICML #Selected Papers/Blogs Issue Date: 2025-08-16 GPT Summary- 本研究では、大規模言語モデルを複数の将来のトークンを同時に予測するように訓練する手法を提案し、サンプル効率の向上を図る。具体的には、n個の独立した出力ヘッドを用いて次のnトークンを予測し、訓練時間にオーバーヘッドをかけずに下流の能力を向上させる。特に、コーディングタスクにおいて、提案モデルは強力なベースラインを上回る性能を示し、推論時に最大3倍の速度向上も実現。 Comment
next tokenだけでなく、next 4-tokenを予測して学習することで、MBPP/HumanEvalにおいて、モデルのパラメータサイズが1.3Bを超えた時点でベースライン(=同じパラメータサイズとなるように調整されたnext-token prediction)をoutperformしはじめ、モデルサイズが大きくなるにつれて性能の差が顕著に表れることを示した。コーディングドメインにおいて事前学習、およびfinetuningの双方で効果がある。ただし、3.7節で示されている通り、これはコーディングドメインでのみこのような顕著な改善がみられており、自然言語データに対してはここまで顕著な改善はしていないように見える(5.1節で考察されていそう; 昨今のLLMでは事前学習データにコーディングなどのデータが入るのが普通なので利用する恩恵はありそう; Abstractive Summarizationでは性能が改善している(Figure6); GSM8Kでは200Bまではnext 2 tokenを予測すると性能が改善しているが500B token学習するとnext token predictionの方が性能が良くなる)。全体的にperplexityの改善(=次のトークンにおいて正解トークンの生成確率を改善する)というよりは、モデルの"最終的な生成結果”にフォーカスした評価となっている。
モデルは共有のトランクf_s (おそらくhead間でパラメータを共有している一連のtransformerブロック) を持っておりinput x_t:1に対応するlatent representation z_t:1を生成する。latent representationをoutput headにinputすることで、それぞれのheadが合計でn個のnext tokenを予測する。
next n-tokenを予測する際には、GPUメモリを大幅に食ってしまう (logitsのshapeが(n, V)となりそれらの勾配も保持しなければならない) ことがボトルネックとなるが、f_sまでforward passを実行したら、各headに対してforward/backward passを順番に実行して、logitsの値は破棄し勾配の情報だけf_sに蓄積することで、長期的に保持する情報を各headのから逆伝搬された勾配情報のみにすることでこれを解決している。
実際にinferenceをするときはnext tokenを予測するヘッドの出力を活用することを前提としているが、全てのヘッドを活用することで、t時点でt+nトークンの予測を可能なため、self-speculative decodingを実施しinference timeを短縮することができる。
3.4で示されているように、nの値は大きければ大きいほど良いというわけではなく、4程度(byte levelなモデルの場合は8 bytes)が最適なようである。が、Table1を見ると、データによってはn=6が良かったり(i.e., 最適なnは学習データ依存)複数エポック学習するとmulti token predictionの効果が薄くなっていそう(i.e., 同じトークンの予測を複数回学習するので実質multi token predictionと似たようなことをやっている。言い換えると、multi token predictionは複数epochの学習を先取りしているとみなせる?)なのは注意が必要そう。
全体的に複数epochを学習すると恩恵がなくなっていく(コーディング) or next token predictionよりも性能が悪化する(自然言語)ので、LLMの事前学習において、複数epochを学習するような当たり前みたいな世界線が訪れたら、このアーキテクチャを採用すると性能はむしろ悪化しそうな気はする。
MBPP/HumanEval:
- [Paper Note] Program Synthesis with Large Language Models, Jacob Austin+, arXiv'21
- [Paper Note] Evaluating Large Language Models Trained on Code, Mark Chen+, arXiv'21
[Paper Note] Densing Law of LLMs, Chaojun Xiao+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#NLP #LanguageModel #Scaling Laws #read-later #Reference Collection Issue Date: 2025-05-27 GPT Summary- 容量密度の新指標を用いてLLMsの性能を評価。基準モデルに基づき実効パラメータ数を定義し、容量密度を計算することで、モデルの効率性と有効性を統一的に分析。最近のデータでは、LLMsの容量密度は約3か月ごとに2倍になり、この傾向が将来の開発戦略に新たな視点を提供する。 Comment
元ポスト:
[Paper Note] The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale, Guilherme Penedo+, NeurIPS'24
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #NeurIPS #Selected Papers/Blogs Issue Date: 2025-05-10 GPT Summary- 本研究では、15兆トークンからなるFineWebデータセットを紹介し、LLMの性能向上に寄与することを示します。FineWebは高品質な事前学習データセットのキュレーション方法を文書化し、重複排除やフィルタリング戦略を詳細に調査しています。また、FineWebから派生した1.3兆トークンのFineWeb-Eduを用いたLLMは、MMLUやARCなどのベンチマークで優れた性能を発揮します。データセット、コードベース、モデルは公開されています。 Comment
日本語解説: https://zenn.dev/deepkawamura/articles/da9aeca6d6d9f9
openreview: https://openreview.net/forum?id=n6SCkn2QaG#discussion
Full Parameter Fine-tuning for Large Language Models with Limited Resources, Lv+, ACL'24, 2024.08
Paper/Blog Link My Issue
#NLP #ACL Issue Date: 2025-03-06 GPT Summary- 新しいオプティマイザ「LOMO」を提案し、勾配計算とパラメータ更新を1ステップで融合することでメモリ使用量を削減。これにより、24GBのメモリを持つ8台のRTX 3090で65Bモデルの全パラメータファインチューニングが可能に。メモリ使用量は標準的なアプローチと比較して10.8%削減。
[Paper Note] Spectrum: Targeted Training on Signal to Noise Ratio, Eric Hartford+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #PostTraining #One-Line Notes Issue Date: 2025-01-25 GPT Summary- 大規模言語モデルのポストトレーニングを効率化する手法「Spectrum」を提案。SNRに基づいてレイヤーモジュールを選択し、他を凍結することでトレーニングを加速。性能はフルファインチューニングに匹敵し、GPUメモリ使用量を削減。従来手法との比較実験でモデル品質とVRAM効率の向上を確認。 Comment
- How to fine-tune open LLMs in 2025 with Hugging Face, PHILSCHMID, 2024.12
によるとLLMのうち最もinformativeなLayerを見つけ、選択的に学習することで、省リソースで、Full-Parameter tuningと同等の性能を発揮する手法らしい
A Survey on LLM Inference-Time Self-Improvement, Xiangjue Dong+, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel Issue Date: 2024-12-31 GPT Summary- LLM推論における自己改善技術を三つの視点から検討。独立した自己改善はデコーディングやサンプリングに焦点、文脈に応じた自己改善は追加データを活用、モデル支援の自己改善はモデル間の協力を通じて行う。関連研究のレビューと課題、今後の研究への洞察を提供。
[Paper Note] Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference, Benjamin Warner+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#NLP #Library #Transformer #pretrained-LM #ACL #Selected Papers/Blogs #One-Line Notes #Reading Reflections Issue Date: 2024-12-20 GPT Summary- ModernBERTはエンコーダーのみのトランスフォーマーモデルで、BERTに対する大きなパレート改善を達成。2兆トークンで訓練され、長いシーケンスに対応しながら、分類タスクと検索において最先端の性能を示す。さらに、最も高速かつメモリ効率の良いエンコーダーとして設計されている。 Comment
最近の進化しまくったTransformer関連のアーキテクチャをEncodnr-OnlyモデルであるBERTに取り込んだら性能上がるし、BERTの方がコスパが良いタスクはたくさんあるよ、系の話、かつその実装だと思われる。
テクニカルペーパー中に記載はないが、評価データと同じタスクでのDecoder-Onlyモデル(SFT有り無し両方)との性能を比較したらどの程度の性能なのだろうか?
そもそも学習データが手元にあって、BERTをFinetuningするだけで十分な性能が出るのなら(BERTはGPU使うのでそもそもxgboostとかでも良いが)、わざわざLLM使う必要ないと思われる。BERTのFinetuningはそこまで時間はかからないし、inferenceも速い。
参考:
- [Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
日本語解説: https://zenn.dev/dev_commune/articles/3f5ab431abdea1?utm_source=substack&utm_medium=email
[Paper Note] Zero Bubble Pipeline Parallelism, Penghui Qi+, ICLR'24, 2023.11
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #ICLR #Parallelism Issue Date: 2024-12-16 GPT Summary- パイプライン並列は分散学習において重要だが、パイプラインバブルの影響を受ける。本研究では、初めてこのバブルをゼロにするスケジューリング戦略を提案。逆伝播計算を勾配計算の2つに分けるアイデアに基づき、新たなパイプラインスケジュールを構築。さらに、自動最適化アルゴリズムと新たな手法を導入し、実験結果は我々の手法が従来手法より最大23%スループットが向上することを示し、メモリ制約が緩和されると31%まで上昇。結果はパイプライン並列性の潜在力を示すもので、実装はオープンソース化されている。 Comment
openreview: https://openreview.net/forum?id=tuzTN0eIO5
[Paper Note] Observational Scaling Laws and the Predictability of Language Model Performance, Yangjun Ruan+, arXiv'24, 2024.05
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #NeurIPS #read-later #One-Line Notes Issue Date: 2024-11-22 GPT Summary- 言語モデルの性能変化を理解することは重要であり、スケーリング則がその手法の一つとして提案されている。約100の公開モデルからスケーリング則を構築することで、モデル訓練を回避する新しいアプローチが示される。異なる計算資源を持つモデルファミリー間のばらつきが、低次元の能力空間と整合することで、予測可能なスケーリング現象が明らかとなる。GPT-4の性能はシンプルなベンチマークから予測可能であり、思考の連鎖や自己整合性といった介入がモデル能力に与える影響の予測も可能であることが示された。 Comment
縦軸がdownstreamタスクの主成分(のうち最も大きい80%を説明する成分)の変化(≒LLMの性能)で、横軸がlog scaleの投入計算量。
Qwenも頑張っているが、投入データ量に対する性能(≒データの品質)では、先駆け的な研究であるPhiがやはり圧倒的?
- [Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
も参照のこと
[Paper Note] Balancing Speed and Stability: The Trade-offs of FP8 vs. BF16 Training in LLMs, Kazuki Fujii+, arXiv'24
Paper/Blog Link My Issue
#Analysis #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #Japanese #read-later #One-Line Notes #LowPrecision Issue Date: 2024-11-17 GPT Summary- 大規模言語モデル(LLMs)は、その言語理解能力と適用可能性から注目を集めており、特にLlama 3シリーズは4050億パラメータを持つ。トレーニングの効率化が求められる中、NVIDIAのH100 GPUはFP8フォーマットを導入し、トレーニング時間を短縮する可能性がある。初期研究ではFP8が性能を損なわずに効率を向上させることが示唆されているが、トレーニングの安定性や下流タスクへの影響はまだ不明である。本研究は、LLMsのトレーニングにおけるBF16とFP8のトレードオフを探る。 Comment
元ポスト:
FP8で継続的事前学習をするとスループットは向上するが、lossのスパイクを生じたり、downstreamタスクの性能がBF16よりも低下したりする(日本語と英語の両方)との報告のようである。現状アブストと付録しか記載がないが、内容はこれから更新されるのだろうか。
[Paper Note] Understanding LLMs: A Comprehensive Overview from Training to Inference, Yiheng Liu+, arXiv'24, 2024.01
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Transformer #Attention #One-Line Notes #Reading Reflections Issue Date: 2024-11-17 GPT Summary- ChatGPTの導入により、LLMsの低コストな訓練とデプロイメントへの関心が高まる。本論文では、訓練技術や推論デプロイメント技術の進化を概説し、データ前処理やモデル圧縮など多様な視点を提供。LLMsの活用についても考察し、今後の発展を示唆する。 Comment
[Perplexity(参考;Hallucinationに注意)]( https://www.perplexity.ai/search/yi-xia-nolun-wen-wodu-minei-ro-7vGwDK_AQX.HDO7j9H8iNA)
単なるLLMの理論的な説明にとどまらず、実用的に必要な各種並列処理技術、Mixed Precision、Offloadingなどのテクニックもまとまっているのがとても良いと思う。
LLM Frameworkのところに、メジャーなものが網羅されていないように感じる。たとえば、UnslothやLiger-KernelなどはTransformersの部分で言及されてても良いのでは、と感じる。
DELIFT: Data Efficient Language model Instruction Fine Tuning, Ishika Agarwal+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning Issue Date: 2024-11-12 GPT Summary- DELIFTという新しいアルゴリズムを提案し、ファインチューニングの各ステージでデータ選択を最適化。ペアワイズユーティリティメトリックを用いてデータの有益性を定量化し、最大70%のデータ削減を実現。計算コストを大幅に節約し、既存の方法を上回る効率性と効果を示す。
Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, Charlie Snell+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #Test-Time Scaling Issue Date: 2024-11-12 GPT Summary- LLMの推論時の計算をスケーリングすることで、挑戦的なプロンプトに対するパフォーマンスを改善する方法を研究。特に、密なプロセスベースの検証者報酬モデルとプロンプトに応じた応答の適応的更新を分析。プロンプトの難易度によって効果が変化し、計算最適戦略を適用することで効率を4倍以上向上。さらに、テスト時計算を用いることで小さなモデルが大きなモデルを上回ることが示された。 Comment
Figure1参照
[Perplexity(参考;Hallucinationに注意)]( https://www.perplexity.ai/search/yi-xia-noyan-jiu-wodu-mi-nei-r-1e1euXgLTH.G0Wlp.V2iqA)
[Paper Note] What Matters in Transformers? Not All Attention is Needed, Shwai He+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#NLP #Transformer #Pruning #KeyPoint Notes Issue Date: 2024-10-22 GPT Summary- トランスフォーマー内の冗長性を調査し、アテンションレイヤーの大部分が高い類似性を示すことが判明。Llama-2-70Bはアテンションレイヤーを半分削除しても僅か2.4%の性能低下で48.4%のスピードアップを達成。トレーニング全体を通じて冗長性が一貫しており、アテンションとMLPレイヤーの共同削除によりさらなる効率化を模索。31レイヤー削除でもLlama-2-13Bは90%の性能を維持。研究はネットワークアーキテクチャ設計に新たな洞察を提供。 Comment
通常LLMはtransformer decoderのブロックをstackすることで形成されるが、積み上げたブロック、あるいはlayerってほんとに全部必要なの?という疑問に答えてくれる論文のようである。
transformer blockそのもの、あるいはMLP layerを削除するとpeformanceは大幅に低下するが、attention layerを削除してもperformanceの低下が起きなかった模様。これにより高速化が実現可能。
削除するブロックやlayerはinputとoutputのコサイン類似度が高いものを削除することによって実現。
比較的パラメータサイズが小さい7B, 13Bモデルでの実験結果
より大きなモデルでの実験結果
パフォーマンスが変わらない範囲だと、attention layer dropにより、7B, 13Bモデルの場合は23%程度、70Bの場合は35%のスループット向上
openreview (ICLR'25):
https://openreview.net/forum?id=YLTWwEjkdx
openreview (TMLR):
https://openreview.net/forum?id=xnYT0HjBsT
先行研究
- [Paper Note] The Unreasonable Ineffectiveness of the Deeper Layers, Andrey Gromov+, ICLR'25, 2024.03
[Paper Note] Addition is All You Need for Energy-efficient Language Models, Hongyin Luo+, arXiv'24, 2024.10
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) Issue Date: 2024-10-20 GPT Summary- L-Mulアルゴリズムを提案し、整数加算器を用いて浮動小数点乗算を高精度で近似。これにより、計算リソースを削減し、8ビット浮動小数点乗算よりも高い精度を達成。エネルギーコストも95%削減可能。評価では、4ビット仮数のL-Mulが従来の浮動小数点乗算と同等、3ビット仮数でより高い精度を発揮すると示され、トランスフォーマーモデルでも高精度を維持。
Enhancing Performance and Scalability of Large-Scale Recommendation Systems with Jagged Flash Attention, Rengan Xu+, N_A, arXiv'24
Paper/Blog Link My Issue
#RecommenderSystems Issue Date: 2024-09-25 GPT Summary- ハードウェアアクセラレーターの統合により、推薦システムの能力が向上する一方で、GPU計算コストが課題となっている。本研究では、カテゴリ特徴の長さによるGPU利用の複雑さに対処するため、「Jagged Feature Interaction Kernels」を提案し、動的サイズのテンソルを効率的に扱う手法を開発。さらに、JaggedテンソルをFlash Attentionと統合し、最大9倍のスピードアップと22倍のメモリ削減を実現。実際のモデルでは、10%のQPS改善と18%のメモリ節約を確認し、複雑な推薦システムのスケーリングを可能にした。
From Decoding to Meta-Generation: Inference-time Algorithms for Large Language Models, Sean Welleck+, N_A, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Inference #One-Line Notes Issue Date: 2024-09-10 GPT Summary- 推論時の計算リソース拡大の利点に焦点を当て、トークンレベル生成、メタ生成、効率的生成の3つのアプローチを統一的に探求。トークンレベル生成はデコーディングアルゴリズムを用い、メタ生成はドメイン知識や外部情報を活用し、効率的生成はコスト削減と速度向上を目指す。従来の自然言語処理、現代のLLMs、機械学習の視点を統合した調査。 Comment
元ツイート:
CMUのチームによるinference timeの高速化に関するサーベイ
[Paper Note] FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision, Jay Shah+, arXiv'24, 2024.07
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #NeurIPS Issue Date: 2024-07-30 GPT Summary- FlashAttentionはGPU上のアテンションを高速化する手法だが、新しいハードウェア機能を活用できていなかった。FlashAttention-3は、Hopper世代のGPUでアテンションの処理を改善するために、計算とデータ移動の重ね合わせ、行列積とソフトマックス演算のインタリーブ、FP8低精度をサポートするブロック量子化を導入。これにより、H100 GPU上でFP16時に1.5〜2.0倍の速度向上を実現し、最大740 TFLOPs/sに達し、FP8では約1.2 PFLOPs/sに近づく。FP8版では数値誤差が従来の約2.6倍低く抑えられることも示した。 Comment
関連:
- [Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
- [Paper Note] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, Tri Dao, arXiv'23, 2023.07
[Paper Note] Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone, Marah Abdin+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#NLP #LanguageModel #SmallModel #OpenWeight #One-Line Notes Issue Date: 2024-04-23 GPT Summary- phi-3-miniは3.8十億パラメータの言語モデルで、3.3兆トークンを学習し、MMLUで69%、MT-benchで8.38を達成。スマートフォンでもデプロイ可能で、phi-2のデータセットをフィルタリングして作成。phi-3-smallとphi-3-mediumはそれぞれ75%、78%をMMLUで達成し、性能が向上。シリーズの新モデルphi-3.5-mini、phi-3.5-MoE、phi-3.5-Visionも導入。phi-3.5-MoEは優れた言語処理能力を発揮し、phi-3.5-Visionは複数画像とテキストのプロンプトに対応。 Comment
[Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09 の次の次(Phi2.0についてはメモってなかった)。スマホにデプロイできるレベルのサイズで、GPT3.5Turbo程度の性能を実現したらしい
Llama2と同じブロックを利用しているため、アーキテクチャはLlama2と共通。
Mixture-of-Depths: Dynamically allocating compute in transformer-based language models, David Raposo+, N_A, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer Issue Date: 2024-04-07 GPT Summary- Transformerベースの言語モデルは、入力シーケンス全体に均等にFLOPsを分散させる代わりに、特定の位置にFLOPsを動的に割り当てることを学習できることを示す。モデルの深さにわたって割り当てを最適化するために、異なるレイヤーで計算を動的に割り当てる。この手法は、トークンの数を制限することで合計計算予算を強制し、トークンはtop-kルーティングメカニズムを使用して決定される。この方法により、FLOPsを均等に消費しつつ、計算の支出が予測可能であり、動的かつコンテキストに敏感である。このようにトレーニングされたモデルは、計算を動的に割り当てることを学習し、効率的に行うことができる。 Comment
参考:
[Paper Note] Dynamic Memory Compression: Retrofitting LLMs for Accelerated Inference, Piotr Nawrot+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #ICML #One-Line Notes #KV Cache #Compression Issue Date: 2024-04-07 GPT Summary- Transformerにおけるメモリキャッシュの非効率性を解決するために、Dynamic Memory Compression(DMC)を提案。DMCは異なるヘッドと層で異なる圧縮比を学習し、Llama 2を組み込むことで推論時に最大7倍のスループット向上を実現。元のパフォーマンスを保ちながら、キャッシュ圧縮を最大4倍可能とし、既存の方法を超える効果を発揮。DMCはKVキャッシュのドロップイン置換として、より長い文脈と大きなバッチを処理できる。 Comment
参考:
論文中のFigure1が非常にわかりやすい。
GQA [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
と比較して、2~4倍キャッシュを圧縮しつつ、より高い性能を実現。70Bモデルの場合は、GQAで8倍キャッシュを圧縮した上で、DMCで追加で2倍圧縮をかけたところ、同等のパフォーマンスを実現している。
LoRA+: Efficient Low Rank Adaptation of Large Models, Soufiane Hayou+, N_A, ICML'24
Paper/Blog Link My Issue
#NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICML #One-Line Notes Issue Date: 2024-03-05 GPT Summary- 本研究では、Huら(2021)によって導入されたLow Rank Adaptation(LoRA)が、大埋め込み次元を持つモデルの適切な微調整を妨げることを指摘します。この問題は、LoRAのアダプターマトリックスAとBが同じ学習率で更新されることに起因します。我々は、AとBに同じ学習率を使用することが効率的な特徴学習を妨げることを示し、異なる学習率を設定することでこの問題を修正できることを示します。修正されたアルゴリズムをLoRA$+$と呼び、幅広い実験により、LoRA$+$は性能を向上させ、微調整速度を最大2倍高速化することが示されました。 Comment
LoRAで導入される低ランク行列AとBを異なる学習率で学習することで、LoRAと同じ計算コストで、2倍以上の高速化、かつ高いパフォーマンスを実現する手法
[Paper Note] Retentive Network: A Successor to Transformer for Large Language Models, Yutao Sun+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #LanguageModel #LinearAttention Issue Date: 2026-02-04 GPT Summary- RetNetを提案し、トレーニングの並列化と低コストの推論を実現。再帰と注目の関係を導出し、シーケンスモデリング用の保持メカニズムを提供。並列処理と再帰を組み合わせることで、高効率な長シーケンスモデリングを実現し、性能を維持したままデコーディングの効率を向上。実験によりRetNetの優れたスケーリングと効率的推論を確認。Transformerの強力な後継として位置付け。 Comment
日本語解説: https://zenn.dev/spiralai/articles/a41a934599c7ec
openreview: https://openreview.net/forum?id=UU9Icwbhin
[Paper Note] Learning to Compress Prompts with Gist Tokens, Jesse Mu+, NeurIPS'23, 2023.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Prompting #NeurIPS #Compression Issue Date: 2026-02-02 GPT Summary- プロンプトはLMのマルチタスク機能における効率性に課題をもたらすため、私たちは「ギスティング」を提案。これはプロンプトを小さなトークンセットに圧縮し、再利用することで計算効率を向上させる方法で、トレーニングコストは標準的な指示ファインチューニングと同等。実験により、最大26倍のプロンプト圧縮と最大40%のFLOPs削減を達成し、出力品質を保持しつつ効率化を実現。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=2DtxPCL3T5
[Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #python #LLMServing #Selected Papers/Blogs Issue Date: 2025-08-19 GPT Summary- PagedAttentionを用いたvLLMシステムを提案し、KVキャッシュメモリの無駄を削減し、リクエスト間での柔軟な共有を実現。これにより、同レベルのレイテンシでLLMのスループットを2-4倍向上。特に長いシーケンスや大規模モデルで効果が顕著。ソースコードは公開中。 Comment
(今更ながら)vLLMはこちら:
https://github.com/vllm-project/vllm
現在の主要なLLM Inference/Serving Engineのひとつ。
[Paper Note] SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills, Amey Agrawal+, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel #python #LLMServing #SoftwareEngineering #read-later #Selected Papers/Blogs #Inference #One-Line Notes Issue Date: 2025-06-12 GPT Summary- SARATHIは、LLMの推論効率を向上させる手法で、プレフィルリクエストをチャンクに分割し、デコードマキシマルバッチを構築することで計算利用率を最大化します。これにより、デコードスループットを最大10倍向上させ、エンドツーエンドスループットも改善。特に、A6000 GPU上のLLaMA-13Bモデルで顕著な性能向上を示し、パイプラインバブルを大幅に削減しました。 Comment
vLLMでも採用されている `Chunked Prefills` と `Decode-Maximal Batching` を提案している。

[Paper Note] Sequence Parallelism: Long Sequence Training from System Perspective, Shenggui Li+, ACL'23, 2021.05
Paper/Blog Link My Issue
#NLP #LanguageModel #LongContext #ACL #Selected Papers/Blogs #Parallelism #One-Line Notes Issue Date: 2025-05-16 GPT Summary- 本研究では、トランスフォーマーの長い入力シーケンスを効率的に学習するための新しいメモリ効率の良い「シーケンス並列性」手法を提案。これは、既存の並列化手法との互換性を持ち、長大なシーケンスを複数のGPUに分散して処理することを可能にする。リング型通信を用いた自己注意計算(Ring Self-Attention)を導入し、実験によりバッチサイズとシーケンス長のスケーリング効果を示した。最大バッチサイズは13.7倍、シーケンス長は114,000トークンを超える性能を達成。 Comment
入力系列をチャンクに分割して、デバイスごとに担当するチャンクを決めることで原理上無限の長さの系列を扱えるようにした並列化手法。系列をデバイス間で横断する場合attention scoreをどのように計算するかが課題になるが、そのためにRing Self attentionと呼ばれるアルゴリズムを提案している模様。また、MLPブロックとMulti Head Attentonブロックの計算も、BatchSize * Sequence Lengthの大きさが、それぞれ32*Hidden Size, 16*Attention Head size *
# of Attention Headよりも大きくなった場合に、Tensor Parallelismよりもメモリ効率が良くなるらしい。
Data Parallel, Pipeline Parallel, Tensor Parallel、全てに互換性があるとのこと(併用可能)
そのほかの並列化の解説については
- 大規模モデルを支える分散並列学習のしくみ Part1, Kazuki Fujii, 2023.06
を参照のこと。
[Paper Note] The Impact of Positional Encoding on Length Generalization in Transformers, Amirhossein Kazemnejad+, NeurIPS'23
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #LongContext #PositionalEncoding #NeurIPS #Selected Papers/Blogs #KeyPoint Notes #Surface-level Notes Issue Date: 2025-04-06 GPT Summary- 長さ一般化はTransformerベースの言語モデルにおける重要な課題であり、位置エンコーディング(PE)がその性能に影響を与える。5つの異なるPE手法(APE、T5の相対PE、ALiBi、Rotary、NoPE)を比較した結果、ALiBiやRotaryなどの一般的な手法は長さ一般化に適しておらず、NoPEが他の手法を上回ることが明らかになった。NoPEは追加の計算を必要とせず、絶対PEと相対PEの両方を表現可能である。さらに、スクラッチパッドの形式がモデルの性能に影響を与えることも示された。この研究は、明示的な位置埋め込みが長いシーケンスへの一般化に必須でないことを示唆している。 Comment
- Llama 4 Series, Meta, 2025.04
において、Llama4 Scoutが10Mコンテキストウィンドウを実現できる理由の一つとのこと。
元ポスト:
Llama4のブログポストにもその旨記述されている:
>A key innovation in the Llama 4 architecture is the use of interleaved attention layers without positional embeddings. Additionally, we employ inference time temperature scaling of attention to enhance length generalization.
[The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation]( https://ai.meta.com/blog/llama-4-multimodal-intelligence/?utm_source=twitter&utm_medium=organic_social&utm_content=image&utm_campaign=llama4)
斜め読みだが、length generalizationを評価する上でdownstream taskに焦点を当て、3つの代表的なカテゴリに相当するタスクで評価したところ、この観点においてはT5のrelative positinal encodingとNoPE(位置エンコードディング無し)のパフォーマンスが良く、
NoPEは絶対位置エンコーディングと相対位置エンコーディングを理論上実現可能であり[^1]
実際に学習された異なる2つのモデルに対して同じトークンをそれぞれinputし、同じ深さのLayerの全てのattention distributionの組み合わせからJensen Shannon Divergenceで距離を算出し、最も小さいものを2モデル間の当該layerの距離として可視化すると下記のようになり、NoPEとT5のrelative positional encodingが最も類似していることから、NoPEが学習を通じて(実用上は)相対位置エンコーディングのようなものを学習することが分かった。
[^1]:深さ1のLayerのHidden State H^1から絶対位置の復元が可能であり(つまり、当該レイヤーのHが絶対位置に関する情報を保持している)、この前提のもと、後続のLayerがこの情報を上書きしないと仮定した場合に、相対位置エンコーディングを実現できる。
また、CoT/Scratchpadはlong sequenceに対する汎化性能を向上させることがsmall scaleではあるが先行研究で示されており、Positional Encodingを変化させた時にCoT/Scratchpadの性能にどのような影響を与えるかを調査。
具体的には、CoT/Scratchpadのフォーマットがどのようなものが有効かも明らかではないので、5種類のコンポーネントの組み合わせでフォーマットを構成し、mathematical reasoningタスクで以下のような設定で訓練し
- さまざまなコンポーネントの組み合わせで異なるフォーマットを作成し、
- 全ての位置エンコーディングあり/なしモデルを訓練
これらを比較した。この結果、CoT/Scratchpadはフォーマットに関係なく、特定のタスクでのみ有効(有効かどうかはタスク依存)であることが分かった。このことから、CoT/Scratcpad(つまり、モデルのinputとoutputの仕方)単体で、long contextに対する汎化性能を向上させることができないので、Positional Encoding(≒モデルのアーキテクチャ)によるlong contextに対する汎化性能の向上が非常に重要であることが浮き彫りになった。
また、CoT/Scratchpadが有効だったAdditionに対して各Positional Embeddingモデルを学習し、生成されたトークンのattentionがどの位置のトークンを指しているかを相対距離で可視化したところ(0が当該トークン、つまり現在のScratchpadに着目しており、1が遠いトークン、つまりinputに着目していることを表すように正規化)、NoPEとRelative Positional Encodingがshort/long rangeにそれぞれフォーカスするようなbinomialな分布なのに対し、他のPositional Encodingではよりuniformな分布であることが分かった。このタスクにおいてはNoPEとRelative POの性能が高かったため、binomialな分布の方がより最適であろうことが示唆された。
LoftQ: LoRA-Fine-Tuning-Aware Quantization for Large Language Models, Yixiao Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#Quantization #PEFT(Adaptor/LoRA) Issue Date: 2024-09-24 GPT Summary- LoftQという新しい量子化フレームワークを提案し、LLMにおける量子化とLoRAファインチューニングを同時に適用。これにより、量子化モデルとフル精度モデルの不一致を軽減し、下流タスクの一般化を改善。自然言語理解や質問応答などのタスクで、特に難易度の高い条件下で既存手法を上回る性能を示した。
[Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンション(MQA)はデコーダ推論を高速化するが、品質低下のリスクがある。本研究では、(1)元の計算の5%でMQAを持つモデルへのアップトレーニング方法を提案し、(2)グループ化クエリ・アテンション(GQA)を導入。GQAは中間的な数のキー・バリュー・ヘッドを使用し、アップトレーニングされたGQAは品質を保ちながらMQAと同等の速度を実現する。 Comment
通常のMulti-Head AttentionがQKVが1対1対応なのに対し、Multi Query Attention (MQA) [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
は全てのheadに対してKVを共有する(HeadがH個あるのであれば、保持するKVの数が1/Hとなる)。一方、GQAはグループ単位で(headの)KVを共有する点で異なる。MQAは大幅にInfeerence speedが改善するが、精度が劣化する問題があった。この研究では通常のMulti-Head Attentionに対して、オリジナルの事前学習に対して追加の5%の計算量でGQAモデルを学習する手法を提案している。
Main Result. Multi-Head Attentionに対して、inference timeが大幅に改善しているが、Multi-Query Attentionよりも高い性能を維持している。
VeRA: Vector-based Random Matrix Adaptation, Dawid J. Kopiczko+, N_A, arXiv'23
Paper/Blog Link My Issue
#MachineLearning #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) Issue Date: 2024-01-17 GPT Summary- 本研究では、大規模な言語モデルのfine-tuningにおいて、訓練可能なパラメータの数を削減するための新しい手法であるベクトルベースのランダム行列適応(VeRA)を提案する。VeRAは、共有される低ランク行列と小さなスケーリングベクトルを使用することで、同じ性能を維持しながらパラメータ数を削減する。GLUEやE2Eのベンチマーク、画像分類タスクでの効果を示し、言語モデルのインストラクションチューニングにも応用できることを示す。
Exponentially Faster Language Modelling, Peter Belcak+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel Issue Date: 2023-11-23 GPT Summary- UltraFastBERTは、推論時にわずか0.3%のニューロンしか使用せず、同等の性能を発揮することができる言語モデルです。UltraFastBERTは、高速フィードフォワードネットワーク(FFF)を使用して、効率的な実装を提供します。最適化されたベースラインの実装に比べて78倍の高速化を実現し、バッチ処理された推論に対しては40倍の高速化を実現します。トレーニングコード、ベンチマークのセットアップ、およびモデルの重みも公開されています。
[Paper Note] Fast Chain-of-Thought: A Glance of Future from Parallel Decoding Leads to Answers Faster, Hongxuan Zhang+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #Prompting #Initial Impression Notes Issue Date: 2023-11-15 GPT Summary- FastCoTは、追加トレーニングやLLM改変なしに並列デコードを実現するモデル非依存のフレームワークです。可変長コンテキストウィンドウを使用し、並列かつ自己回帰的なデコードを行うことで、GPUリソースを最適化します。これにより、因果型トランスフォーマーの従来手法よりも迅速な応答が可能になります。実験結果では、FastCoTが推論時間を約20%短縮しつつ、性能低下も最小限であることが示されています。 Comment
論文中の図を見たが、全くわからなかった・・・。ちゃんと読まないとわからなそうである。
LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models, Yukang Chen+, N_A, arXiv'23
Paper/Blog Link My Issue
#MachineLearning #NLP #Dataset #QuestionAnswering #Supervised-FineTuning (SFT) #LongContext #PEFT(Adaptor/LoRA) #PostTraining #KeyPoint Notes Issue Date: 2023-09-30 GPT Summary- 本研究では、計算コストを制限しながら大規模言語モデル(LLMs)のコンテキストサイズを拡張する効率的なファインチューニング手法であるLongLoRAを提案します。従来の方法では、LLMsの長いコンテキストサイズでのトレーニングには高い計算コストとGPUリソースが必要でしたが、提案手法ではコンテキスト拡張を高速化し、非自明な計算コストの削減を実現します。また、パラメータ効率的なファインチューニング手法も再評価し、LongLoRAはさまざまなタスクで強力な実験結果を示しています。さらに、教師ありファインチューニングのためのデータセットであるLongQAも収集されました。 Comment
# 概要
context長が大きい場合でも効率的にLoRAする手法。通常のLoRAではcontext lengthが大きくなるにつれてperplexityが大きくなってしまう。一方、通常のFinetuningではperplexityは高い性能を維持するが、計算コストとVRAMの消費量が膨大になってしまう。LongLoRAでは、perplexityを通常のFinetuningと同等に抑えつつ、VRAM消費量もLoRAと同等、かつより小さな計算量でFinetuningを実現している。
# 手法概要
attentionをcontext length全体で計算するとinput長の二乗の計算量がかかるため、contextをいくつかのグループに分割しグループごとにattentionを計算することで計算量削減。さらに、グループ間のattentionの間の依存関係を捉えるために、グループをshiftさせて計算したものと最終的に組み合わせている。また、embedding, normalization layerもtrainableにしている。
[Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Pretraining #MachineLearning #NLP #LanguageModel #SyntheticData #Distillation #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-09-13 GPT Summary- 小型TransformerモデルTinyStoriesから、1.3十億パラメータのphi-1を開発し、教科書品質データ生成を提案。新モデルphi-1.5は、常識的推論に焦点を当て、小学校レベルの数学やコーディング課題で、非最先端LLMを上回る性能を示す。能力には一歩ずつ考えることや初歩的なインコンテキスト学習が含まれ、幻覚や偏見生成も注意が必要だが、ウェブデータの不使用により改善が見られる。phi-1.5はオープンソース化され、さらなる研究を促進。 Comment
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
に続く論文
20Kのトピックから、commonsense reasmning, general knowledge(科学, 日常生活, theory of mlndなど)に関するtext book likeなデータを20B合成して事前学習に活用(どのモデルで合成されたかは明記されていないように見える)
既存のより大規模なモデル(7B--13B)、web dataをフィルタリングしたデータのみで学習したモデル(phi-1.5-web-only)、phi-1でのデータ 7Bに対して上記20Bを追加したデータで学習したモデル(phi-1.5)、フィルタリングしたwebデータ、phi-1のコードデータ、phi-1.5データを40%,20%,40%でmixしたモデル(phi-1.5-web)を比較したところ、phi-1.5の全てのモデル群が.より大きな7B--13B級のモデルを上回った。
web onlyの性能は他二つと比べて悪く、後者二つの性能が高く僅差でphi-1.5-webの性能が良かった。
このことより、
- テキストブックスタイルの合成データは、様々なドメインで有用に働き巨大モデルをSLMで上回れる
- 合成データだけでなくフィルタリングしたwebデータ自体を混ぜるとさらに効果的
という話に見える。
論文のメッセージとは違うかもだが、より現代的な観点を加えると、
- より大規模なモデルから合成したデータによってデータを通じた蒸留が起き、小規模モデルに能力が転移する
という話でもある。
[Paper Note] Skeleton-of-Thought: Prompting LLMs for Efficient Parallel Generation, Xuefei Ning+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #LanguageModel #ICLR #Decoding #One-Line Notes #Parallel Issue Date: 2023-08-08 GPT Summary- 本研究は、巨大言語モデル(LLMs)の生成遅延を低減するため、Skeleton-of-Thought(SoT)を提案。SoTは、まず回答のスケルトンを生成し、次に並列デコードを実行して内容を完成。12種のLLMでスピードアップと回答品質向上を実現。データ中心の最適化による効率的な推論を目指す。 Comment
最初に回答の枠組みだけ生成して、それぞれの内容を並列で出力させることでデコーディングを高速化しましょう、という話。
openreview: https://openreview.net/forum?id=mqVgBbNCm9
[Paper Note] FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance, Lingjiao Chen+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #TMLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-07-26 GPT Summary- LLMの料金体系は多様で、大量利用時に高コストになる可能性がある。推論コストを削減するため、プロンプト適応、LLM近似、LLMカスケードの3つの戦略を提案。FrugalGPTを用いて、異なるクエリに最適なLLMsの組み合わせを学習し、最高で98%のコスト削減や4%の精度向上を実現する実験結果を示した。これにより、LLMの持続可能かつ効率的な活用の基盤が提供される。 Comment
限られた予算の中で、いかに複数のLLM APIを使い、安いコストで高い性能を達成するかを追求した研究。
LLM Cascadeなどはこの枠組みでなくても色々と使い道がありそう。Question Concatenationは実質Batch Prompting。
openreview: https://openreview.net/forum?id=cSimKw5p6R
[Paper Note] Batch Prompting: Efficient Inference with Large Language Model APIs, Zhoujun Cheng+, arXiv'23, 2023.01
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Prompting #EMNLP #Selected Papers/Blogs #Batch #KeyPoint Notes #IndustryTrack Issue Date: 2023-07-24 GPT Summary- 大規模言語モデル(LLM)を使ったバッチプロンプティングにより、サンプルをバッチ単位で推論し、トークンコストと推論時間を削減。few-shot in-context learningで、コストはバッチ内サンプル数に反比例して低下。100のデータセットでの検証では、最大5倍のコスト削減を実現し、性能は向上または維持。GPT-3.5やGPT-4でも効果を確認し、タスクの複雑さが性能に影響を与えることを示唆。バッチプロンプティングは他の推論手法にも適用可能。 Comment
10種類のデータセットで試した結果、バッチにしても性能は上がったり下がったりしている。著者らは類似した性能が出ているので、コスト削減になると結論づけている。
Batch sizeが大きくなるに連れて性能が低下し、かつタスクの難易度が高いとパフォーマンスの低下が著しいことが報告されている。また、contextが長ければ長いほど、バッチサイズを大きくした際のパフォーマンスの低下が著しい。
[Paper Note] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, Tri Dao, arXiv'23, 2023.07
Paper/Blog Link My Issue
#MachineLearning #NLP #Transformer #Attention #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-07-23 GPT Summary- 長いシーケンスを扱うトランスフォーマーの性能向上に寄与するFlashAttentionは、実行時間とメモリを線形に増加させるが、最適化されたGEMM演算には及ばない。FlashAttention-2では、作業分割を最適化し、非マトリクス積FLOPsを削減、アテンション計算を並列化、共有メモリ通信を減少することで、約2倍のスピードアップを実現。これにより、A100 GPU上で最大225 TFLOPs/sの訓練速度を達成し、モデルFLOPsの利用率は72%に向上した。 Comment
Flash Attention1よりも2倍高速なFlash Attention 2
Flash Attention1は
- [Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
を参照
openreview: https://openreview.net/forum?id=mZn2Xyh9Ec
[Paper Note] QLoRA: Efficient Finetuning of Quantized LLMs, Tim Dettmers+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#MachineLearning #Supervised-FineTuning (SFT) #Quantization #PEFT(Adaptor/LoRA) #NeurIPS #PostTraining #Selected Papers/Blogs #needs-revision Issue Date: 2023-07-22 GPT Summary- QLoRAは、65Bパラメータモデルを単一の48GB GPUでファインチューニングするための効率的な手法であり、16ビット性能を維持しつつメモリ使用量を削減します。低秩アダプターを介して勾配をバックプロパゲーションし、GuanacoモデルはVicunaベンチマークで従来のモデルを超え、ChatGPTに近い性能を示しました。QLoRAの革新には、4ビット量子化データ型、ダブル量子化、そしてメモリ管理のためのページングオプティマイザーが含まれます。1,000以上のモデルをファインチューニングし、指示追従性能の詳細な分析を提供。また、GPT-4評価を用いたチャットボット性能の分析から、既存のベンチマークの信頼性の問題点も指摘しています。全てのモデルとコードは公開されています。 Comment
実装:
https://github.com/artidoro/qlora
PEFTにもある
参考:
Parameter-efficient Weight Ensembling Facilitates Task-level Knowledge Transfer, ACL'23
Paper/Blog Link My Issue
#NLP #Ensemble #TransferLearning #ACL Issue Date: 2023-07-14 GPT Summary- 最近の研究では、大規模な事前学習済み言語モデルを特定のタスクに効果的に適応させることができることが示されています。本研究では、軽量なパラメータセットを使用してタスク間で知識を転送する方法を探求し、その有効性を検証しました。実験結果は、提案手法がベースラインに比べて5%〜8%の改善を示し、タスクレベルの知識転送を大幅に促進できることを示しています。
FiD-ICL: A Fusion-in-Decoder Approach for Efficient In-Context Learning, ACL'23
Paper/Blog Link My Issue
#MachineLearning #NLP #Zero/Few/ManyShotPrompting #In-ContextLearning #ACL Issue Date: 2023-07-13
[Paper Note] Full Parameter Fine-tuning for Large Language Models with Limited Resources, Kai Lv+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Supervised-FineTuning (SFT) #One-Line Notes Issue Date: 2023-06-26 GPT Summary- LLMのトレーニングにおけるリソースの課題に対応するため、「低メモリ最適化」(LOMO)という新手法を提案。勾配計算とパラメータ更新を1ステップで統合し、メモリ使用量を10.8%削減。これにより、65Bモデルの全パラメータを1台のマシンで微調整可能に。コードはGitHubで入手可能。 Comment
8xRTX3090 24GBのマシンで65Bモデルの全パラメータをファインチューニングできる手法。LoRAのような(新たに追加しれた)一部の重みをアップデートするような枠組みではない。勾配計算とパラメータのアップデートをone stepで実施することで実現しているとのこと。
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Pretraining #MachineLearning #NLP #LanguageModel #SmallModel #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-06-25 GPT Summary- phi-1は1.3BパラメータのTransformerベースの大規模言語モデルで、競合モデルより小型ながらHumanEvalで50.6%、MBPPで55.5%の高精度を達成。8台のA100 GPUを用いて、教科書品質データと合成生成データを組み合わせて訓練。phi-1-baseやphi-1-smallと比べても驚くべき創発特性を示す。 Comment
参考:
教科書のような品質の良いテキストで事前学習すると性能が向上し(グラフ真ん中)、さらに良質なエクササイズでFinetuningするとより性能が向上する(グラフ右)
日本語解説: https://dalab.jp/archives/journal/introduction-textbooks-are-all-you-need/
ざっくり言うと、教科書で事前学習し、エクササイズでFinetuningすると性能が向上する(= より大きいモデルと同等の性能が得られる)。
[Paper Note] MEGABYTE: Predicting Million-byte Sequences with Multiscale Transformers, Lili Yu+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#ComputerVision #MachineLearning #NLP #Transformer #SpeechProcessing #LongContext #Architecture #NeurIPS #One-Line Notes #Byte-level Issue Date: 2023-05-15 GPT Summary- Megabyteというマルチスケールデコーダーアーキテクチャを提案し、長いシーケンスのエンドツーエンドのモデリングを可能にする。シーケンスをパッチに分割し、ローカルサブモデルとグローバルモデルを使用することで、計算効率を向上させつつコストを削減。実験により、Megabyteは長いコンテキストの言語モデリングで競争力を持ち、最先端の密度推定を達成した。トークン化なしの自己回帰シーケンスモデリングの実現可能性を示す。 Comment
byte列のsequenceからpatch embeddingを作成することで、tokenizer freeなtransformerを提案。
byte列で表現されるデータならなんでも入力できる。つまり、理論上なんでも入力できる。
openreview: https://openreview.net/forum?id=JTmO2V9Xpz
[Paper Note] Efficiently Scaling Transformer Inference, Reiner Pope+, MLSys'23, 2022.11
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #LongContext #Architecture #Inference #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 大規模なTransformerモデルの生成的推論を、長いシーケンス長と厳格な遅延目標の下で研究。TPU v4用に最適化された解析モデルを開発し、待機時間とモデルFLOPS利用率のトレードオフにおいて新しいパレート前線を達成。マルチクエリ注意機構を用いることでメモリ要件を減少させ、コンテキスト長を最大32倍に拡張。最終的に、小さなバッチサイズでの1トークンあたりの遅延は29ミリ秒となり、MFUは76%に達し、PaLM 540Bモデルで2048トークンのコンテキストをサポート。 Comment
特にMultiquery Attentionという技術がTransformerのinferenceのコスト削減に有効らしい
Multi Query Attention (MQA):
- [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
Efficient Methods for Natural Language Processing: A Survey, Treviso+, TACL'23
Paper/Blog Link My Issue
#NeuralNetwork #Survey #NLP #TACL #One-Line Notes Issue Date: 2023-04-25 Comment
パラメータ数でゴリ押すような方法ではなく、"Efficient"に行うための手法をまとめている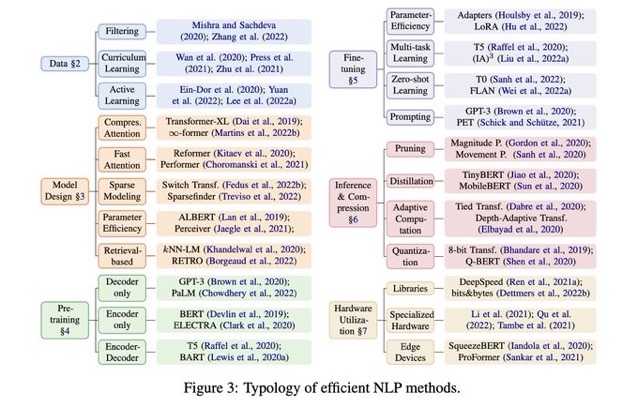
[Paper Note] bert2BERT: Towards Reusable Pretrained Language Models, Cheng Chen+, ACL'22, 2021.10
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Transformer #ACL #Encoder #Decoder Issue Date: 2025-12-11 GPT Summary- bert2BERTは、既存の小規模事前学習モデルの知識を大規模モデルに転送し、事前学習効率を向上させる手法。二段階の事前学習を提案し、トレーニングコストを大幅に削減。BERT_BASEとGPT_BASEの事前学習で約45%および47%の計算コストを節約。
[Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
Paper/Blog Link My Issue
#Survey #ComputerVision #NLP #Transformer #Attention #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- 本論文では、計算効率やメモリ効率を向上させることに焦点を当てた「X-former」モデル(Reformer、Linformer、Performer、Longformerなど)の大規模なセレクションを紹介し、最近の研究を体系的かつ包括的にまとめる。Transformersは自然言語処理を含む多くの分野で重要な役割を果たしている。 Comment
関連:
- [Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
- [Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
[Paper Note] StableMoE: Stable Routing Strategy for Mixture of Experts, Damai Dai+, arXiv'22
Paper/Blog Link My Issue
#NLP #LanguageModel #MoE(Mixture-of-Experts) #Stability Issue Date: 2025-09-02 GPT Summary- StableMoEは、ルーティングの変動問題に対処するために2つのトレーニングステージを持つMixture-of-Experts手法を提案。最初のステージで一貫したルーティング戦略を学習し、軽量ルーターに蒸留。第二のステージでそのルーターを用いてエキスパートへの割り当てを固定。言語モデリングと多言語機械翻訳での実験により、StableMoEは収束速度と性能で既存手法を上回ることが示された。 Comment
元ポスト:
[Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
Paper/Blog Link My Issue
#Pretraining #NLP #Transformer #Architecture #MoE(Mixture-of-Experts) #Selected Papers/Blogs #JMLR Issue Date: 2025-02-11 GPT Summary- Switch Transformerを提案し、Mixture of Experts (MoE)の複雑さや通信コスト、トレーニングの不安定性を改善。これにより、低精度フォーマットでの大規模スパースモデルのトレーニングが可能になり、最大7倍の事前トレーニング速度向上を実現。さらに、1兆パラメータのモデルを事前トレーニングし、T5-XXLモデルに対して4倍の速度向上を達成。
Few-Shot Parameter-Efficient Fine-Tuning is Better and Cheaper than In-Context Learning, Haokun Liu+, N_A, arXiv'22
Paper/Blog Link My Issue
#MachineLearning Issue Date: 2023-08-16 GPT Summary- Few-shot in-context learning(ICL)とパラメータ効率の良いファインチューニング(PEFT)を比較し、PEFTが高い精度と低い計算コストを提供することを示す。また、新しいPEFTメソッドである(IA)^3を紹介し、わずかな新しいパラメータしか導入しないまま、強力なパフォーマンスを達成する。さらに、T-Fewというシンプルなレシピを提案し、タスク固有のチューニングや修正なしに新しいタスクに適用できる。RAFTベンチマークでT-Fewを使用し、超人的なパフォーマンスを達成し、最先端を6%絶対的に上回る。
[Paper Note] PAD-Net: An Efficient Framework for Dynamic Networks, Shwai He+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #DynamicNetworks #ACL #Encoder Issue Date: 2023-07-18 GPT Summary- 動的ネットワークはモデルの表現力を向上させるが、完全に動的にすると冗長なパラメータと高いコストが生じる。本研究では、冗長な動的パラメータを静的パラメータに変換する部分的動的ネットワーク、PAD-Netを提案し、動的と静的パラメータを効率的に分割するIterative Mode Partitionを用いた。実験により、ResNet-50で動的パラメータを30%使用してトップ1精度を+0.7%向上、BERTで50%使用して言語理解のスコアを+1.9%改善した。コードは公開予定。
[Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
Paper/Blog Link My Issue
#MachineLearning #Attention #Selected Papers/Blogs #One-Line Notes #Reference Collection Issue Date: 2023-05-20 GPT Summary- 長いシーケンスにおけるTransformerの計算とメモリ消費の問題に対処するため、IOを意識した注意アルゴリズムFlashAttentionを提案。これによりメモリの読み書き回数を減少させ、従来の基準よりも約15%の速度向上を実現。FlashAttentionは長い文脈を処理可能にし、モデル品質も改善。具体的には、BERT-largeやGPT-2で従来を上回るパフォーマンスを達成し、Path-Xチャレンジで新たな成果を示した。 Comment
より高速なGPU上のSRAM上で計算できるようにQKVをブロック単位に分割して計算することで、より高い計算効率を実現するFlashAttentionを提案[^1]
[^1]: (2025.05.24追記)下記日本語ブログを参考に一部文言を訂正しました。ありがとうございます。
日本語解説:
https://zenn.dev/sinchir0/articles/21bb6e96c7b05b
元ポスト:
日本語解説:
https://zenn.dev/uchiiii/articles/306d0bb7ef67a7
元ポスト:
openreview: https://openreview.net/forum?id=H4DqfPSibmx
あわせて読みたい:
- CUDA Programming Guide Part 1, Kazuki Fujii, 2026.06
論文内でon-chip SRAMと呼ばれているものは、この記事におけるGPUのUnified Data Cache (192KB L1 Data Cache/Shared Memory)のことである。
GRAM: Fast Fine-tuning of Pre-trained Language Models for Content-based Collaborative Filtering, Yoonseok Yang+, NAACL'22
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CollaborativeFiltering #EducationalDataMining #KnowledgeTracing #Contents-based #NAACL Issue Date: 2022-08-01 GPT Summary- コンテンツベースの協調フィルタリング(CCF)において、PLMを用いたエンドツーエンドのトレーニングはリソースを消費するため、GRAM(勾配蓄積手法)を提案。Single-step GRAMはアイテムエンコーディングの勾配を集約し、Multi-step GRAMは勾配更新の遅延を増加させてメモリを削減。これにより、Knowledge TracingとNews Recommendationのタスクでトレーニング効率を最大146倍改善。
[Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #read-later #Selected Papers/Blogs #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形化された自己注意機構とファストウェイト・コントローラの等価性を示し、遅いニューラルネットがファストウェイトをプログラムする方法を探る。FWPは有限メモリの操作を学習し、注意機構のメモリ容量限界を改善するために、加法的外積を用いたプログラミング命令を導入。動的学習率の計算も学習し、新しいカーネル関数を提案。合成リトリーバル問題や機械翻訳、言語モデリングタスクにおける利点を実験で示した。 Comment
Linear TransformerにおけるKV^Tを加算する固定された状態更新ではなく、差分だけを更新するDelta Ruleによって更新する Delta Networkを提案。
(まだ全然読めていないのでしっかり読みたい)
DeltaNet図解:
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #Selected Papers/Blogs #ActivationFunction #One-Line Notes Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Transformer #NeurIPS #read-later #HyperparameterTransfer #One-Line Notes Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #LanguageModel #Transformer #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
[Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
Paper/Blog Link My Issue
#NLP #Transformer #Attention #LongContext #NeurIPS #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- BigBirdは、Transformersモデルのシーケンス長に対する二次的依存性を線形に削減するスパース注意メカニズムを提案。これにより、長いシーケンスを最大8倍処理可能となり、質問応答や要約などのNLPタスクでの性能が向上。さらに、ゲノムデータへの新たな応用も示唆。 Comment
[Paper Note] Denoising Diffusion Probabilistic Models, Jonathan Ho+, NeurIPS'20, 2020.06
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #DiffusionModel #NeurIPS #Selected Papers/Blogs #Encoder-Decoder #ScoreMatching #ImageSynthesis #U-Net Issue Date: 2025-10-10 GPT Summary- 拡散確率モデルを用いた高品質な画像合成を提案。新しい重み付き変分境界でのトレーニングにより、優れた結果を得る。無条件CIFAR10で9.46のInceptionスコア、256x256のLSUNでProgressiveGANに匹敵する品質を達成。実装はGitHubで公開。 Comment
日本語解説: https://qiita.com/ground0state/items/565de257807b12dba52a
[Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
Paper/Blog Link My Issue
#NLP #Transformer #Attention #One-Line Notes #Sparse #SparseAttention Issue Date: 2025-08-09 GPT Summary- Longformerは、長いシーケンスを線形に処理できる注意機構を持つTransformerベースのモデルで、数千トークンの文書を扱える。局所的なウィンドウ注意とタスクに基づくグローバル注意を組み合わせ、文字レベルの言語モデリングで最先端の結果を達成。事前学習とファインチューニングを行い、長文タスクでRoBERTaを上回る性能を示した。また、Longformer-Encoder-Decoder(LED)を導入し、長文生成タスクにおける効果を確認した。 Comment
(固定された小さめのwindowsサイズの中でのみattentionを計算する)sliding window attentionを提案。Figure2を見ると、通常のAttentionと比較して、現在のトークンの周辺のトークンにしか注目しない特性が図示されており、イメージが掴みやすい。
OpenLLMの文脈だと、Mistralに採用されて話題になったかも?
- Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
[Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
Paper/Blog Link My Issue
#NLP #Transformer #Attention #ICML #Selected Papers/Blogs #reading #One-Line Notes #RecurrentModels #LinearAttention Issue Date: 2025-08-05 GPT Summary- 自己注意をカーネル特徴マップの線形ドット積として表現することで、Transformersの複雑性を$\mathcal{O}\left(N^2\right)$から$\mathcal{O}\left(N\right)$に削減。これにより、自己回帰型Transformersの速度が最大4000倍向上し、従来のパフォーマンスを維持。 Comment
関連:
- Transformers are Multi-State RNNs, Matanel Oren+, N/A, EMNLP'24
pj page: https://linear-transformers.com
Linear Attention(Linear Transformer)を提案した研究。Softmaxが利用されるFull Attentionのsimilarity部分をfeature map φを持つカーネルk(x, y)で一般化し、(3)--(6)の流れでfeature map φ同士は内積が使える性質と、行列積の結合法則を用いて式変換する。
式変換によって、従来のSoftmax Attentionでは、全てのトークンNに対してQ_i * K_j * V_jのメモリが必要だったものを(O(N^2))、各Queryごとに利用される、KVを用いた情報が共通化され(現在のqueryまでのφ(K)とφ(K)V^Tを逐次的に加算して保持するだけで良い)、再利用が可能となりメモリに関するオーダーがO(N)となる。
これらの話は実際にどのような カーネルを利用するかを無視した話だが、たとえばsoftmaxを表現するために必要な指数カーネルの場合はfeature mapが無限次元となるため有限次元のベクトルでは表現できず、厳密に線形化することができない。このため、有限次元かつ厳密なfeature mapを持つ多公式カーネルを用いて近似する。この場合、計算量のオーダーがO(ND^2M)となり(Nがsequence length, Dがqueryとkeyの次元数, Mがvalueの次元数)、softmax attentionの計算量がO(N^2 max(D,M))であることと比較すると、N > D^2である場合に計算効率が改善される。
学習時は並列に学習が可能で、推論時はφ(K_j)V_j^Tを内部状態とみなすと、各タイムステップでRNNのように状態を更新して保持するだけで良い。
(続きはさらに後で読む)
次: DeltaNet
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
次の次: Gated DeltaNet
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
次の次の次: Kimi Delta Attention (KDA)
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
[Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
Paper/Blog Link My Issue
#NLP #Transformer #Attention #ICLR #Sparse #SparseAttention Issue Date: 2025-08-05 GPT Summary- 本研究では、トランスフォーマーモデルの効率を向上させるために、局所感度ハッシュを用いた注意機構と可逆残差層を提案。これにより、計算量をO($L^2$)からO($L\log L$)に削減し、メモリ効率と速度を向上させたReformerモデルを実現。トランスフォーマーと同等の性能を維持。 Comment
openreview: https://openreview.net/forum?id=rkgNKkHtvB
[Paper Note] Linformer: Self-Attention with Linear Complexity, Sinong Wang+, arXiv'20
Paper/Blog Link My Issue
#NLP #Transformer #Attention Issue Date: 2025-08-05 GPT Summary- 大規模トランスフォーマーモデルは自然言語処理で成功を収めているが、長いシーケンスに対しては高コスト。自己注意メカニズムを低ランク行列で近似し、複雑さを$O(n^2)$から$O(n)$に削減する新しいメカニズムを提案。これにより、メモリと時間効率が向上した線形トランスフォーマー「Linformer」が標準モデルと同等の性能を示す。
[Paper Note] All Word Embeddings from One Embedding, Takase+, NeurIPS'20
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #MachineLearning #NLP #NeurIPS #KeyPoint Notes Issue Date: 2021-06-09 Comment
NLPのためのNN-basedなモデルのパラメータの多くはEmbeddingによるもので、従来は個々の単語ごとに異なるembeddingをMatrixの形で格納してきた。この研究ではモデルのパラメータ数を減らすために、個々のword embeddingをshared embeddingの変換によって表現する手法ALONE(all word embeddings from one)を提案。単語ごとに固有のnon-trainableなfilter vectorを用いてshared embeddingsを修正し、FFNにinputすることで表現力を高める。また、filter vector普通に実装するとword embeddingと同じサイズのメモリを消費してしまうため、メモリ効率の良いfilter vector効率手法も提案している。機械翻訳・および文書要約を行うTransformerに提案手法を適用したところ、より少量のパラメータでcomparableなスコアを達成した。
Embedidngのパラメータ数とBLEUスコアの比較。より少ないパラメータ数でcomparableな性能を達成している。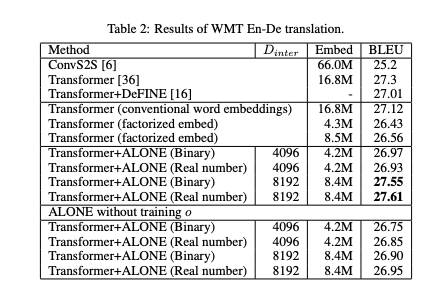
[Paper Note] Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, Zihang Dai+, ACL'19
Paper/Blog Link My Issue
#Transformer #Attention #LongContext #PositionalEncoding #ACL #One-Line Notes Issue Date: 2025-08-05 GPT Summary- Transformer-XLは、固定長のコンテキストを超えた長期的な依存関係を学習する新しいニューラルアーキテクチャで、セグメントレベルの再帰メカニズムと新しい位置エンコーディングを採用。これにより、RNNより80%、従来のTransformersより450%長い依存関係を学習し、評価時には最大1,800倍の速度向上を実現。enwiki8やWikiText-103などで最先端のパフォーマンスを達成し、数千トークンの一貫したテキスト生成も可能。コードとモデルはTensorflowとPyTorchで利用可能。 Comment
日本語解説:
- 事前学習言語モデルの動向 / Survey of Pretrained Language Models, Kyosuke Nishida, 2019
3.2節の定式化を見ると、一つ前のセグメントのトークン・layerごとのhidden stateを、現在のセグメントの対応するトークンとlayerのhidden stateにconcatし(過去のセグメントに影響を与えないように勾配を伝搬させないStop-Gradientを適用する)、QKVのうち、KVの計算に活用している。また、絶対位置エンコーディングを利用するとモデルがセグメント間の時系列的な関係を認識できなくなるため、位置エンコーディングには相対位置エンコーディングを利用する。これにより、現在のセグメントのKVが一つ前のセグメントによって条件づけられ、contextとして考慮することが可能となり、セグメント間を跨いだ依存関係の考慮が実現される。
[Paper Note] EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks, Mingxing Tan+, ICML'19
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #ICML #Selected Papers/Blogs #Backbone Issue Date: 2025-05-12 GPT Summary- 本論文では、ConvNetsのスケーリングを深さ、幅、解像度のバランスを考慮して体系的に研究し、新しいスケーリング手法を提案。これにより、MobileNetsやResNetのスケールアップを実証し、EfficientNetsという新しいモデルファミリーを設計。特にEfficientNet-B7は、ImageNetで84.3%のトップ1精度を達成し、従来のConvNetsよりも小型かつ高速である。CIFAR-100やFlowersなどのデータセットでも最先端の精度を記録。ソースコードは公開されている。 Comment
元論文をメモってなかったので追加。
- EfficientNet解説, omiita (オミータ), 2019.10
も参照のこと。
[Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Attention #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンションを提案し、アテンション・ヘッド間でキーと値を共有することで、逐次推論時のメモリ帯域幅を削減。これにより、デコード速度が向上し、品質低下は最小限に抑えられたことを実験で確認。 Comment
**※ 以前のメモでは "Queryを単一にする" と記述していましたが、完全に誤りでした。**
Multi Query Attention論文。Multi-Head Attentionにおける **KVを全てのhead間で共有する(つまりKV Cacheの量が1/num_headになる)** することで代替する。劇的にDecoderのInferenceが早くなりメモリ使用量が減る。論文中では言及されていない?ようだが、後続の研究で性能と学習の安定性が課題が指摘されているようである。
[Paper Note] Efficient Attention: Attention with Linear Complexities, Zhuoran Shen+, arXiv'18
Paper/Blog Link My Issue
#NLP #Transformer #Attention Issue Date: 2025-08-05 GPT Summary- 新しい効率的なアテンションメカニズムを提案し、ドット積アテンションと同等の性能を維持しつつ、メモリと計算コストを大幅に削減。これにより、アテンションモジュールの柔軟な統合が可能となり、精度向上を実現。実験結果では、MS-COCO 2017での物体検出やインスタンスセグメンテーションでの性能向上が確認され、Scene Flowデータセットでは最先端の精度を達成。コードは公開されている。 Comment
Figure1を見るとコンセプトが一目でわかり、非常にわかりやすい
[Paper Note] An Empirical Model of Large-Batch Training, Sam McCandlish+, arXiv'18, 2018.12
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #read-later #Selected Papers/Blogs #Batch #One-Line Notes #CriticalBatchSize Issue Date: 2024-12-16 GPT Summary- 勾配ノイズスケールを用いて、異なる分野での最適なバッチサイズを予測する方法を提示。教師あり学習や強化学習など複数の領域での実験を通じて、この統計量がロスの低下に伴い増加し、モデルサイズが性能に与える影響を分析。計算効率と時間効率のトレードオフを説明し、適応的なバッチサイズ訓練の利点を示す。 Comment
Critical Batchsize(バッチサイズをこれより大きくすると学習効率が落ちる境界)を提唱した論文
[Paper Note] Learning to Skim Text, Adams Wei Yu+, ACL'17, 2017.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #ReinforcementLearning #ACL #Decoder #KeyPoint Notes #Sparse Issue Date: 2017-12-31 GPT Summary- 再帰型ニューラルネットワーク(RNN)は自然言語処理での可能性を示すが、長文の処理が遅い。本論文では、無関係な情報をスキップしながらテキストを読むアプローチを提案。モデルは、入力テキストの数語を読んだ後にジャンプする距離を学習し、ポリシー勾配法で訓練。数値予測や自動Q&Aなど4つのタスクで、提案モデルは標準LSTMに比べて最大6倍の速度向上を達成し、精度も維持。 Comment
解説スライド:
http://www.lr.pi.titech.ac.jp/~haseshun/acl2017suzukake/slides/07.pdf
Reinforceにおける勾配の更新式の導出が丁寧に記述されており大変ありがたい。
RNNにおいて重要な部分以外は読み飛ばすことで効率を向上させる研究。いくつ読み飛ばすかも潜在変数として一緒に学習する。潜在変数(離散変数)なので、普通に尤度最大化するやり方では学習できず、おまけに離散変数なのでバックプロパゲーション使えないので、強化学習で学習する。
Vanilla LSTMと比較し、色々なタスクで実験した結果、性能も(少し)上がるし、スピードアップもする。
うーんこの研究は今改めて見返すと非常に面白いな…(8年も経ったのか)。ざっくり言うと必要のない部分は読み飛ばして考慮しないという話であり、最近のLLMでもこういった話はよくやられている印象。一番近いのはSparse Attentionだろうか。
- [Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
- [Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
トークン単位などはなくlayerをスキップするとかもある(Layer Skip)。
- [Paper Note] Skip a Layer or Loop it? Test-Time Depth Adaptation of Pretrained LLMs, Ziyue Li+, arXiv'25
Introducing Clef: our open-source decision models, and new RL fine-tuning platform, Cloudflare, 2026.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #Blog #PEFT(Adaptor/LoRA) #OpenWeight #Selected Papers/Blogs #Encoder #KeyPoint Notes #SystemOneModel Issue Date: 2026-10-02 Comment
元ポスト:
概要しかブログ中には書いていないが、よさげに見える。
Qwen-3.8-27Bをバックボーンとし、Qwenのパラメータはフリーズした上で軽量なアダプタを学習し、ルーティングヘッドなるcross-attentionに基づいた各選択肢のスコアを出力するヘッドによって予測が実施されるようである。
これらは、内部で作成された合成データを用いて事後学習されたとのことである。lossはlabel smoothed cross entropy(正解、不正解ラベルを0/1としてクロスエントロピーを計算するのではなく、ハイパーパラメータεでスムージングしてlossを計算するものらしい)とBrier Loss(実際に予測された確率値と正解、不正解を1/0としたときの平均二乗誤差)なるものによって、正則化によって過学習を防止し、出力される確率値がでたらめにならないように学習することを目指しているように見える。
その後RLCDと呼ばれる、選択肢間の順序関係に基づいて、正解と隣接するラベルにも部分的に報酬を与えるようなrewardを持つ(オリジナルのポリシーから分布が大きくシフトしないようなペナルティ付き)RLによって学習をしているようである。これにより、より高いAccuracyと汎化性能が得られた、と一言記述されている。
Qwenが持つVision Encoderによって画像もエンコードでき(Jevは画像は不可と述べられている)、
context長が64kとJevの2倍で
Jevよりもlatencyが良く、
様々なベンチマークスコアで高いスコアを獲得としている、と報告している。
latencyはflashモデルであれば、DiffusionGemma-as-Jevを上回る。
DeepGEMM Ascend, DeepSeek AI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #AIAgents #GPUKernel #Author Thread-Post Issue Date: 2026-09-30 Comment
元ポスト:
所見:
DeepSeekGEMMと呼ばれる、NVIDIA GPU向けに構築されたGPUカーネルライブラリをHuawei Ascend NPU向けに移植したもので、APIがDeepSeekGEMMと互換性があるため、同じpythonコードから動作させることができるようである。
一言解決:
Halo: Frontier-Lab Training for Everyone, White Circle, 2026.09
Paper/Blog Link My Issue
#Article #Multi #ComputerVision #Pretraining #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #MultiModal #Blog #mid-training #DPO #PostTraining #Parallelism #VisionLanguageModel #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-09-29 Comment
元ポスト:
tokenizers v1: encode, decode and scaling, measured, HuggingFace, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Tokenizer #read-later #Initial Impression Notes Issue Date: 2026-09-28 Comment
元ポスト:
関連:
- {G}igatoken: SIMD and Cache Hierarchies for 1000x Faster Byte-Pair Encoding Tokenization on Modern CPUs, Marcel R{\o}d, 2026.07
Gigatokenは、著者ポストを読む限り、そもそも今のtokenizerが1秒単位に処理できるデータ量(データレート)が、同様の規模感のデータを処理する際の他の実装、たとえばsimdjsonがGB/sなのに比べて遅すぎるという気持ちから端を発しているように思われる。
一方、tokenizersでは、イントロに膨大なデータセットでの学習、同時リクエストの処理、long contextでの処理等において、モデルへのデータ供給が追いつかず、tokenizerが新たなボトルネック(GPUを待たせるという意味で)になりつつあり、それを解決したいという気持ちが記述されている。
HyperFlow, VideoRebirth, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Distillation #OpenWeight #VideoGeneration/Understandings #SelfDistillation #autoresearch/RSI #Author Thread-Post Issue Date: 2026-09-23 Comment
元ポスト:
所見:
Rigel Base: Reaching Llama-3.2 Quality with <1% of its Compute, Mayank+, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Blog #OpenWeight #SSM (StateSpaceModel) #read-later #DataMixture #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-23 Comment
NoPEやuPを利用、事前学習では6つのフェースで異なるDataMixtureを利用しそのレシピも記載
laya, convaiinnovations, 2026.09
Paper/Blog Link My Issue
#Article #NLP #MultiLingual #OpenWeight #Encoder #One-Line Notes #Reading Reflections Issue Date: 2026-09-19 Comment
元ポスト:
state (email, text, ticket, あるいはJSON)を与え、質問のタイプとinstruction(choice, score, noul)を与えると、質問に対応する出力を得られるModernBERTベースのモデル。questionあたり512トークンまで扱えるようである(state, question, optionの合計で512トークン)。RLCDと呼ばれるポリシーがdistributionを出力する手法で学習され、この手法はhonest probabilityを出力することで機体報酬が最大化されるとの記載がある。100+言語に対応。
emailのサンプル例は、ユーザからの問い合わせに対して、担当部署(choice)、緊急度(score)、解約の確率(noul)を出力する例となっている。
関連:
- Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
これ系の話がいきなり増えてきた。マルチリンガルでモデルがオープンなのはありがたや。
最初読んだ時は様々なタスクやドメインに利用できるのかなと思ったが、emailドメインにしか適用できないのでは?zero-shotで汎用的に利用できないのであれば、それはただのFinetuningされたBERTである。
Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Transformer #Blog #SmallModel #Proprietary #Architecture #Selected Papers/Blogs #One-Line Notes #ToolUse #Author Thread-Post #SystemOneModel Issue Date: 2026-09-19 Comment
元ポスト:
チャットをせず、各ターンごとに関数呼び出しに特化したedge向け小型モデルとのこと。アプリが利用するツール群を渡し、ユーザの発言に基づいて全ての引数を埋めて関数を呼び出す、あるいはスキーマを与えればそのスキーマに則った出力を返し(構造化出力)、推測はしない(関数の範囲外のものは空出力)というもののようである。
これらは、simple attention networkと呼ばれるもので実現される。simple attention networkはtransformerからFFN Layerをを無くし軽量なHadarmard MLPというlayerに置き換え、FFNが従来保持していた知識に関する情報はengramによって、n-gram embedding側に持たせることによって高速、軽量化がじつげんされているようである。residual streamとしては、mHCが用いられているようである。
また、デプロイ時にモデルの深さを指定することで、20個あるうちのどのlayerを利用するかが決まり、性能とコストを調整できるようである。これを公式ポストではIntelligence Laddersと呼称している。
関連:
- [Paper Note] Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, Xin Cheng+, arXiv'26, 2026.01
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
関連:
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
と思想が似ている。
Introducing System One Models & Jev, TypeSafe AI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Coding #SoftwareEngineering #Selected Papers/Blogs #reading #KeyPoint Notes #Reference Collection #Reading Reflections #SystemOneModel Issue Date: 2026-09-16 Comment
細かいことは全くわからないが、LLMのようなチャットモデルは超人的な性能なのになぜAGIに繋がっていないのかが常々疑問で、code+AIに特化したモデルを開発したとのことで、それはどのようなものかというと、
LLMは人間の好みとなる応答を返すように、autoregressiveにテキストを生成するが、
本ブログで紹介されているシステムSystemOneは意思決定に最適化し、並列で生成され、自由なテキストを返せないが構造化出力を高速かつ安価に生成可能で、キャリブレーションされた確信度を常に返す、
というもののようである。
着眼点はとてもおもしろいのだが、どの程度高度な推論をすることができるのだろうか?
現代では高度な推論は計算コストである程度賄っているため、安価で高度な推論もできるのでれば大きなブレイクスルーだが、その技術はLLM側にも適用できる可能性があり、結局いつかLLM側に追いつかれる、という可能性がある。
逆に高度な推論ができないのであれば、適用可能なスコープは限定的となる。
RLCDという技術はすでに先行事例があったようだ:
利用規約でJevに関するベンチマークスコアや性能を公開することが禁止されているようである:
所見:
JamC-QAのスコアは(GPT-5.6-lunaより)低く、日本特有の知識などには弱い可能性がある:
- 『JamC-QA』: 日本の文化や風習に特化した質問応答ベンチマークの構築・公開(前編), SB Intuitions, 2025.09
色々な動向を鑑みるに、Encoderか、Decoderかはさておき(利用者から見たらどちらでもよい気がするので)、
- zero-shotで様々なタスクに利用可能で
- latencyが非常に速くて
- コストが安価なモデル
という3つの要素が重要に思える。
chatはできないが、構造化出力/関数出力等が可能(なことで様々な分類タスク等に適用できる)というのは、latencyの速さとコストの安価さを得るための手段。エンコーダ、デコーダも手段の話。
過去にPFNがJevに相当する機能を開発しサービス化までしていた、という話がある(関連技術は幅広く特許を取得しているようである)。
なぜ需要を掘り起こせなかったのか、という点は考えてみるとおもしろいのかもしれない。
個人的にはいまJevが流行っぽい兆しを見せているのは、時期的なものが大きい気がしており、
- (Reasoningモデルの台頭によって) LLMのlatencyが悪い
- 多くのワークフローに組み込む場合に得たい出力が(おそらく)構造化出力(で、めちゃめちゃ賢い判断はそこまで必要とされない)
- モデルのトークン利用料が増加し、(おそらく)運用コストが課題となってきた
という課題に世の中が直面し始めて、課題感として持たれ始めていること、が背景としてある気がしており、ちょうどタイミング的に「安い、速い、(そこそこ)賢い」のJevが世の中に刺さったのではないか、という気がしている。
AI Infrastructure at Periodic, Periodic Labs, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Infrastructure #ReinforcementLearning #AIAgents #Blog #LLMServing Issue Date: 2026-09-16 Comment
元ポスト:
Inside the megakernel serving engine for North Mini Code, Cohere, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #LLMServing #One-Line Notes #GPUKernel #Author Thread-Post Issue Date: 2026-09-09 Comment
github: https://github.com/cohere-ai/cohere-megakernel
バッチサイズ1, 256k context、単一H100利用の条件下において、vLLM v0.24+FlashAttention3+Triton MoE backendよりも最大1.58倍デコーディングが高速(合成されたKV Cacheによる実験、実プロンプト+バッチサイズ8でも1.25--1.41倍高速)な実験的なLLM Servingエンジンのようである。
LLMのデコードを単一のカーネルに集約し、デコーディングのために必要な様々なステップごとの同期のオーバヘッドを削減したのだとか。
元ポスト:
Rustによる高速なOptuna実装「Rustuna」の公開, PFN, 2026.09
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-09-08 Comment
元ポスト:
GLM-5.3-Flash: Frontier Intelligence, Flash Cost, Z.AI, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #OpenWeight #Selected Papers/Blogs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-30 Comment
HF: https://huggingface.co/zai-org/GLM-5.3-Flash
320B-A18BでOpus 4.8相当のベンチマークスコアを達成
アーキテクチャ解説:
- KDA
- FlashKDA: Flash Kimi Delta Attention — high-performance KDA kernels built on CUTLASS, MoonshotAI, 2026.04
- MLA
- [Paper Note] DeepSeek-V3 Technical Report, DeepSeek-AI+, arXiv'24, 2024.12
- DSA
- [Paper Note] DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek-AI+, arXiv'25, 2025.12
- mHC
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
所見:
本ポストにある通り、中国系のOpenWeightモデルは
- linear attention
- sparse attention
- mHCのようなResidual Streamに対する工夫
- Muon
などを採用するのがデファクトとなっているように思われる。
所見:
LFM2.5-DSpark: Up to 3.2x Faster Inference from H100 to MacBook, Liquid AI, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #SmallModel #OpenWeight #SpeculativeDecoding #Author Thread-Post Issue Date: 2026-08-22 Comment
HF:
https://huggingface.co/LiquidAI/LFM2.5-1.2B-Instruct-DSpark
他のLFM用のDraftモデルもある。
様々なLFM用のDraft Model
Accelerating GPT-5.6 Sol Ultrafast , cerebras, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Decoding Issue Date: 2026-08-18 Comment
元ポスト:
Outperforming cuBLAS on NVFP4, PRANJAL SHANKHDHAR, 2026.08
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #LanguageModel #SoftwareEngineering #read-later #GPUKernel #Author Thread-Post Issue Date: 2026-08-17 Comment
元ポスト:
MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost, MAI, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Coding #Proprietary #SoftwareEngineering #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4, Nvidia, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #SSM (StateSpaceModel) #LinearAttention #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
LFM2.5-Encoders: Fast at Long Context, Even on CPU, Liquid AI, 2026.07
Paper/Blog Link My Issue
#Article #NLP #MultiLingual #OpenWeight #Selected Papers/Blogs #Encoder #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-08-06 Comment
元ポスト:
CPUでのinferenceにおいて、ModernBERTよりもlong context (8k付近)でのスループットが3.3倍高いEncoder。context長は8192。
HF: https://huggingface.co/LiquidAI/LFM2.5-Encoder-350M
日本語にも対応しているようだが、日本語ModernBertなどと比較して日本語でこのダウンストリームタスクの性能はどうなるだろうか
DeepEP: an efficient expert-parallel communication library, Zhao+, DeepseekAI, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #MoE(Mixture-of-Experts) #Parallelism #GPUKernel Issue Date: 2026-08-05 Comment
Expert Parallelism での通信を高速化する上で代表的なライブラリ
その後以下のようなものが登場:
- Mixture-of-Kittens: our open-source MoE megakernel for NVL72s, Cursor, 2026.08
- MoonEP, MoonshotAI, 2026.07
Mixture-of-Kittens: our open-source MoE megakernel for NVL72s, Cursor, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #MoE(Mixture-of-Experts) #read-later #Selected Papers/Blogs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-05 Comment
元ポスト:
主要なOpenWeight LLM(アーキテクチャ)のスループットが軒並み2倍以上になっているので、これはかなりインパクトがでかい話に見える
関連:
- DeepEP: an efficient expert-parallel communication library, Zhao+, DeepseekAI, 2025.09
- MoonEP, MoonshotAI, 2026.07
ポイント解説:
所見:
著者ポスト:
DeepSeek-V4-Flash, Deepseek, 2023.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #Selected Papers/Blogs Issue Date: 2026-08-02 Comment
Artiflcial Analysisによる評価:
GLM-5.2, Muse Spark 1.1, Gemini3.6-Flash, GPT-5.6-lunaと同等程度のスコアにもかかわらず、スコアに対するパラメータ比率で圧倒的にパレート最適に位置付けられる。
Epoch Capabilities IndexでOpenWeightモデルでKimi K3に次ぐ2位、全体でOpus 4.6に次ぐ7位
MoonEP, MoonshotAI, 2026.07
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Library #SoftwareEngineering #mid-training #PostTraining #Parallelism #One-Line Notes #GPUKernel Issue Date: 2026-07-28 Comment
大規模なExpertParallelにおいて通信を効率的に実施するためのライブラリとのこと。
元ポスト:
{G}igatoken: SIMD and Cache Hierarchies for 1000x Faster Byte-Pair Encoding Tokenization on Modern CPUs, Marcel R{\o}d, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Tokenizer Issue Date: 2026-07-26 Comment
元ポスト:
所見:
どうやら、上記所見によると
- 与えられた文字列に対して正規表現を適用し、あらかじめ単語の境界を決める処理(pretokenize)を、
- SIMD命令(1つの命令を同時に複数のデータに対して適用;各バイトがどの文字クラスに属するかを判定する)と、
- ビット演算(文字クラスの判定結果に対して、シフトにより境界判定に必要な過去の文字クラス情報を構成し、シフト前後の系列に対するビット演算によりtokenizerの境界判定処理を実装みたいなことをやっているらしい)によって実現
- short pretokenに対するBPEをキャッシュする
という二段構えで高速化が実現されているようである。
---
参考:
- C++ SIMD命令入門(初心者向け), ancienthawk, 2025.08:
https://zenn.dev/ancienthawk/articles/for_simd_beginner_cp
- ゼロから作るLLM Part1: BPEトークナイザーの実装, so_dev000, 2025.11: https://qiita.com/so_dev000/items/037a21cba4e52182daea
Auto-Routing Models, dari.dev, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #SmallModel #Selected Papers/Blogs #Initial Impression Notes #Orchestration Issue Date: 2026-07-25 Comment
元ポスト:
HF: https://huggingface.co/dari-ai/router-slm
Sakana FuguのようなLLMプールの中からターン単位で適切なLLMを選択するオーケストレータ(ルータ)で、QwenのLoRA Weightとして学習された重みが公開されているようである。
関連:
- [Paper Note] TRINITY: An Evolved LLM Coordinator, Jinglue Xu+, ICLR'26, 2025.12
- Sakana Fugu: A Multi-Agent Orchestration System as a Foundation Model, sakana.ai, 2026.04
- Sakana Fugu: One Model to Command Them All, SakanaAI, 2026.06
- [Paper Note] Sakana Fugu Technical Report, Yujin Tang+, arXiv'26, 2026.06
The fastest LLM on Earth: Frontier level intelligence, 15x faster, celeris, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DiffusionModel #Blog #Proprietary #read-later #One-Line Notes #Author Thread-Post Issue Date: 2026-07-25 Comment
元ポスト:
アーキテクチャとしてdLLMを採用したGPT-5-miniと同等程度の性能のモデルで、GPT-5-miniに対して15倍程度(1280TPS)のスループットを実現しているとのこと。
Artificial Analysisによるoutput speed評価で1位:
Introducing Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber, Google, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary #VisionLanguageModel Issue Date: 2026-07-22 Comment
元ポスト:
Artificial Analysis Indexでは、3.6 FlashはMuse 1.1と同程度の性能。
ただし、Time Per Intelligence Index Taskでは上位を独占
Benchmarking Coding Agents on Databricks’ Multi-Million Line Codebase, databricks, 2026.07
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #read-later #Initial Impression Notes #Author Thread-Post #AgentHarness Issue Date: 2026-07-10 Comment
元ポスト:
ハーネス選択によってトークン消費を1/2にでき、GLM 5.2のコストパフォーマンスが良いらしい
[Tech] Delta Weight Sync: When RL's Weight Sync Stops Being a Network Problem, Changyi Yang, ChangyiYang's Site, 2026.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #PostTraining #Selected Papers/Blogs #reading #Initial Impression Notes #Author Thread-Post Issue Date: 2026-07-07 Comment
RLによる事後学習の際にtrainer側のoptimizerが1 step学習した後にinferenceエンジンに重みをpushするが、BF16でのRLにおける1 stepの更新では多くのモデルの重みに変化はなく(99%程度)、差分だけをpushすればlosslessで2桁程度trafficを削減できて、RDMAが不要でたとえばイーサネットベースのデータセンターを跨いだ環境でもRLが実行できそうだよ、という話のようである。
元ポスト:
Improving our LLM Pretraining Efficiency, Open Athena, 2026.06
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Optimizer #MoE(Mixture-of-Experts) #Selected Papers/Blogs #KeyPoint Notes #Author Thread-Post Issue Date: 2026-06-06 Comment
元ポスト:
以下の処理によって、事前学習が高速化(FLOPsの改善幅)された知見が共有されている
- DenseからMoEモデルへの移行で実測値3.6倍
- MoEのexpart数を64->256で実測値1.3倍
- optimizerをMuonHにすることで、実測値1.25倍
- **Partial Key Offset (PKO) によって実測値1.2倍改善**
- **modded-nanogptリポジトリ、プルリクエスト169で初めて提案された手法とのこと。**
- **long windowのattentionに対して、keyの半分の次元をオフセット(=前のトークンのkey)、残りの半分の次元を自身のトークンのkeyとすることで、単一のクエリが連続した複数のキーにattendできるようになり、「過去の文脈からあるトークンの継続部分を検索して取得する」といった操作が単一のattention layerによって実現できるようになる**
- (これは知らなかった)
- expertのルーティングを再正規化・スケーリングすることで、実測値1.04倍
今後はHyperConnectionのようなResidual Streamの改善、推論効率向上のためMLA, LatentMoE, Multi Token Prediction, Gated Deltanet, quantizationなどの技術を検証するとのこと。
Expert数が多ければ多いほど性能が改善することは下記研究でも示されている:
- [Paper Note] Slicing and Dicing: Configuring Optimal Mixtures of Experts, Margaret Li+, arXiv'26, 2026.05
MuonH(というよりoptimizerのHyperplaneに基づいたラッパ)は以下(こちらもPercy Liang氏のグループ):
- Fantastic Pretraining Optimizers and Where to Find Them 2.1: Hyperball Optimization, Wen+, 2026.01
Hyper Connection:
- [Paper Note] Hyper-Connections, Defa Zhu+, ICLR'25, 2024.09
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
MLA, LatentMoE, Multi Token Prediction, Gated Deltanet:
- [Paper Note] DeepSeek-V3 Technical Report, DeepSeek-AI+, arXiv'24, 2024.12
- [Paper Note] LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts, Venmugil Elango+, arXiv'26, 2026.01
- [Paper Note] Better & Faster Large Language Models via Multi-token Prediction, Fabian Gloeckle+, ICML'24
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
- [Paper Note] Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention, Ali Hatamizadeh+, arXiv'26, 2026.05
Native RL APIs in vLLM, vLLM, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #SoftwareEngineering #PostTraining #reading #Asynchronous Issue Date: 2026-05-31 Comment
元ポスト:
所見:
Nemotron-Labs-Diffusion-14B, Nvidia, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DiffusionModel #OpenWeight #LLMServing #SpeculativeDecoding #One-Line Notes #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
3つの生成モード: AR/dLM/Hybrid を備えたLLM(VLM variantも存在)ファミリーで、ARモードでは一般的な自己回帰的な生成をし、dLMモードでは拡散モデルに基づくparallel decodingを実施、hybridではdLMでドラフト作成、ARでverificationを実施するSpeculative Decoding (self-speculation)を実施する。これらモードは内部のattention patternを変化させることでシームレスに切り替えられ(シームレスモード)期待されるconcurrencyに応じて柔軟に対応ができるようである。
シームレスの粒度がどの程度のものかはよくわからない。concurrency levelを検知して、それに応じて動的に切り替わったりするのだろうか。
Speculative Decodingの高速化手法としては以下のようなものもある:
- [Paper Note] TriSpec: Ternary Speculative Decoding via Lightweight Proxy Verification, Haoyun Jiang+, arXiv'26, 2026.01
OlmoEarth v1.1: A more efficient family of models, Ai2, 2026.05
Paper/Blog Link My Issue
#Article #ComputerVision #FoundationModel #OpenWeight #2D (Image) #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
関連:
- OlmoEarth-v1-Large, Ai2, 2025.11
- Introducing OlmoEarth embeddings: Custom embedding exports from OlmoEarth Studio for downstream analysis, Ai2, 202604
mKernel: Fast Multi-GPU, Multi-Node Fused Kernels, Ziming Mao, and the UCCL team, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Infrastructure #read-later #GPUKernel #Author Thread-Post Issue Date: 2026-05-26 Comment
元ポスト:
> mKernel is our attempt at the missing piece: GPU-driven, fused kernels that deliver fine-grained compute–communication overlap across both intra-node NVLink and inter-node RDMA, while staying portable across various networking backends (ConnectX-7, AWS EFA, and more on the way).
Composer 2.5 の紹介, Cursor, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SyntheticData #Optimizer #mid-training #On-Policy #One-Line Notes #Reference Collection #SelfDistillation Issue Date: 2026-05-20 Comment
元ポスト:
- trajectory中の不適切な箇所にヒントを挿入したcontextを用いたself-on-policy distillation
- Composer 2から25倍の量の合成タスクデータの利用。タスクは特定のテスト可能な機能をコードベースからablationすることによってverifiableなタスクを作成
- mid-trainingではMuonを利用し、expertが複数のノードにシャーディングされているため、all-to-allと呼ばれる処理によって重み行列全体を復元しMuonの直行化を実施し、同じくall-to-allという処理で重みを再びシャーディングするらしい。これらは非同期で実行される。
- dual mesh HSDPと呼ばれるものも利用されているようだがよくわかっていない
関連:
- Composer 2 のご紹介, Cursor, 2026.03
artificial analysisによる評価:
所見:
学習の規模感に関する所見:
所見:
Gemini 3.5: frontier intelligence with action, Google, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary #VisionLanguageModel #Initial Impression Notes Issue Date: 2026-05-20 Comment
Artificial Analysisによる評価:
賢い上にデコーディングが高速で今の所非常に使い勝手が良い
Marco-MoE: A suit of multilingual MoE models with highly-sparse architectures, AIDC-AI, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) #CurriculumLearning #One-Line Notes Issue Date: 2026-05-12 Comment
元ポスト:
4 stageのカリキュラムによって学習されているようで、学習が進むにつれて、広く使われる英語やreasoning, instructionなどのデータは減らし、low resourceな言語のデータを増やしていき最終的にマルチリンガルなデータを支配的にするような学習レシピとなっているようである。
EMO: Pretraining mixture of experts for emergent modularity, Ai2, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MoE(Mixture-of-Experts) #read-later #Selected Papers/Blogs #Routing #Initial Impression Notes Issue Date: 2026-05-11 Comment
元ポスト:
従来のMoEモデルを学習する際には全てのトークンが全てのexpertsに対してroutingされるため、能力のごく一部しか必要ないにもかかわらず、experts全体をデプロイする必要があり効率が悪かった。本研究では、MoEモデルを学習する際に、ドキュメント単位で8個のshared experts poolに対してのみtokenがroutingされるように制約することで、特定のexpertsの集合が特定のドメインのexpertsとなることが奨励されmodularityが高まり、必要なexpertsのみをデプロイすることで効率化が図れるようになるので嬉しい、といった話に見える。
Accelerating Gemma 4: faster inference with multi-token prediction drafters, Google, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Decoding Issue Date: 2026-05-08 Comment
関連:
- Gemma 4: Byte for byte, the most capable open models, Google, 2026.04
元ポスト:
HiSparse: Turbocharging Sparse Attention with Hierarchical Memory, LMSYS, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Attention #Blog #KeyPoint Notes #KV Cache #SparseAttention Issue Date: 2026-04-28 Comment
元ポスト:
SparseAttentionはattention計算をする際にtop-kのトークンのみを用いて計算する手法であり、token単位でactivateされるKV Cacheを減らすことができるが、top-kで選択されたトークンのKV Cacheに対して迅速にアクセスをしなければならないためHBM上にKV Cacheを全てロードしておかなければならない。このため、memory-boundな処理になりがちである。このような場合、同時アクセス数が増えたときに、HBMが飽和して、一定サイズの同時アクセスを超えるとスループットが向上しなくなる課題がある。
これを克服するために、HiSparseと呼ばれる手法を提案している。具体的には、頻繁にアクセスされるKV CacheのみをHBM上に置いておき、使わないものはホストメモリにオフロードしておき必要に応じてswapするというものである。top-kのトークンとしてどれが必要か、それがHBM(バッファ)上に存在するか、存在しない場合はLRUでホストメモリとバッファのエントリをswapするといった操作を高速で実現するカーネルに基づいて、効率的に実施されるようである。
pyptx: A Python DSL to write Nvidia PTX for Hopper and Blackwell in JAX and PyTorch, patrick-toulme, 2026.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #LanguageModel #python #SoftwareEngineering #GPUKernel Issue Date: 2026-04-27 Comment
元ポスト:
pythonの記法で、PTX(どの世代のNVIDIA GPUでも理解可能な仮想的なアセンブリ言語)を記述可能で自動最適化は一切入らないDSLとのこと。
PTXについては以下を読んだ:
PTXってなんだ?〜GPUの「共通語」仮想アセンブリを完全理解〜,GeneLab_999, 2026.01
https://qiita.com/GeneLab_999/items/5c49a21e5fd7e618b671
inclusionAI: Ling-2.6-flash (free), OpenRouter (InclusionAI), 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #MoE(Mixture-of-Experts) #Reference Collection #Initial Impression Notes #Author Thread-Post Issue Date: 2026-04-22 Comment
元ポスト:
Lingの最新モデル。元ポストに強みが簡潔に書かれている。OpenRouterで1週間freeで利用可能で、今後商用モデルのLingDTのリリースも控えているとこと。
また、将来的に本モデルはオープンになる予定とのこと。
Artificial Analysisによる評価:
オープンになった:
HF: https://huggingface.co/inclusionAI/Ling-2.6-flash
Distilling 100B+ Models 40x Faster with TRL, Hugging Face, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Distillation #One-Line Notes #Author Thread-Post Issue Date: 2026-04-13 Comment
元ポスト:
on-policy蒸留(生徒モデルが生成したロールアウトに対して教師モデルが評価を与える方式)を、バッチ処理や、生徒モデルと教師モデルの通信量を削減するためバイナリ形式に変換してやり取りするなどの工夫をして高速化した話とのこと。
著者ポスト:
The advisor strategy: Give agents an intelligence boost Pair Opus as an advisor with Sonnet or Haiku as an executor, and get near Opus-level intelligence in your agents at a fraction of the cost., Anthropic, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #One-Line Notes #Reading Reflections Issue Date: 2026-04-11 Comment
元ポスト:
Strong Modelをツールとして登録(Advisor)しておき、意思決定が困難になった場合はstrong modelにレビュー依頼をしてcontextを受け取り実行可能な枠組み。
Sonnetで12パーセント程度省コストで、SWE Bench Multilingual のスコアを2.7%向上、とのこと。
SWE Benchの結果は、Claute Opus 4.6をAdvisorとして利用した旨が脚注に書かれている。
下記システムカードによると、Opus 4.6 の SWE Bench Multilingualのスコアは77.83程度(細かい設定は追えていない)、元ポストのSonnet+Advisorのスコアは74.8%なので、near Opusな性能が出るとポストに記載されているが、そのくらいのgapがあるという点には注意が必要。
https://www-cdn.anthropic.com/6a5fa276ac68b9aeb0c8b6af5fa36326e0e166dd.pdf
How we optimized Dash's relevance judge with DSPy, Dropbox, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Prompting #AutomaticPromptEngineering #LLM-as-a-Judge #read-later #Initial Impression Notes Issue Date: 2026-04-07 Comment
元ポスト:
APEを使ってモデルを変更した際のプロンプト適応を効率化した話な模様。
Making RL Fast, Finbarr Timbers, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #SoftwareEngineering #PostTraining #Selected Papers/Blogs #reading #Initial Impression Notes #Asynchronous Issue Date: 2026-04-07 Comment
元ポスト:
Olmo3においてpost-trainingのインフラを同期から非同期に変更したことを含めて4倍高速化したことに関して、それをどのように実現したかに関するwrite up。気になる。
Build with Veo 3.1 Lite, our most cost-effective video generation model, Google, 2026.03
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Proprietary #VideoGeneration/Understandings #TextToVideoGeneration #ImageToVideoGeneration Issue Date: 2026-04-04 Comment
元ポスト:
LFM2.5-350M: No Size Left Behind, Liquid AI, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SmallModel #OpenWeight #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2026-04-01 Comment
元ポスト:
- LFM2のアーキテクチャを採用の350Mパラメータモデルで、CPUでも十分な速度で推論可能
- 追加の事前学習(10T -> 28T tokens)、および、large-scale RLを実施
- 同等規模のパラメータ数(あるいは2倍程度)のモデル群に対して、知識, 指示追従能力, ツール呼び出し、データ抽出などのベンチマークで上回る
- LFM2-350Mと比較して、指示追従能力, データ抽出, tool useの性能が大きく向上
- edgeデバイスでの軽量なデータ抽出パイプラインとして有用
- しかし、math, coding, creative writingなどでの利用は推奨されない
- CPU/GPUでの推論ともに同等規模、あるいは1B級のモデルよりも早く、省メモリ
Composer 2 のご紹介, Cursor, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #AIAgents #Evaluation #Coding #SoftwareEngineering #mid-training #PostTraining #read-later #Selected Papers/Blogs #ContextEngineering #Live #Reference Collection #Initial Impression Notes Issue Date: 2026-03-20 Comment
元ポスト:
所見:
Kimi-K2.5がベースらしいとのこと:
ベンチマークスコアに対する所見:
テクニカルレポートが出た:
https://cursor.com/resources/Composer2.pdf
元ポスト:
Kimi-K2.5をベースに、どのようにinstruction tuning後のモデルに対して継続事前学習、RLをし、GPT-5.4(high)級の性能を達成できたのか、ヒントがわかるかもしれない。
- [Paper Note] Kimi K2.5: Visual Agentic Intelligence, Kimi Team+, arXiv'26, 2026.02
所見:
所見:
RLによってpass@k(best-of-16)とpass@1の両方が改善する。既存研究では少なくともRLVRを用いた場合はPass@1は改善するが多様性が損なわれてPass@kの性能は改善しない ([Paper Note] Beyond Pass@1: Self-Play with Variational Problem Synthesis Sustains RLVR, Xiao Liang+, arXiv'25, 2025.08 , VibeVoice-1.5B, microsoft, 2025.08 )、という話があったが、Composer 2のレシピではそうではないようだ。どんなレシピだろう~と思ってさらっと関連しそうなところを見てみたが、詳細は書いてなさそうだ。
- [Paper Note] Beyond Pass@1: Self-Play with Variational Problem Synthesis Sustains RLVR, Xiao Liang+, arXiv'25, 2025.08
- VibeVoice-1.5B, microsoft, 2025.08
QA:
CursorBenchの解説:
要はrealisticなデータとシチュエーションでの評価に非常に重きを置いていて
- 実際のコーディングsessionのデータが用いられ、contamination-free
- 機能的な正しさのみならず、コードの品質、効率、挙動などの実用的な価値を意識し
- long horizonなタスクが多く取り入れられ
- Promptは曖昧性をうまく扱えるかを評価するために意図的にシンプルで短く
- CursorBenchのデータは継続的に更新される
- realisticなsessionデータだけでなく、その他の重要な挙動の評価(e.g., 指示追従, ルール/skilltのハンドリング, コメントの品質, editするか否かの判断の適切性など)のためのデータでも拡張されている
という感じらしい
ポイント解説:
- How Kimi, Cursor, and Chroma Train Agentic Models with RL, PHILSCHMID, 2026.03
self-summarizationによるcontextのcompressionを実施している
- [Paper Note] InftyThink+: Effective and Efficient Infinite-Horizon Reasoning via Reinforcement Learning, Yuchen Yan+, arXiv'26, 2026.02
- [Paper Note] Reasoning Cache: Continual Improvement Over Long Horizons via Short-Horizon RL, Ian Wu+, arXiv'26, 2026.02
- より長いホライズンに向けた Composer の学習, Cursor, 2026.03
所見:
FLUX.2-klein-9B, black-forest-labs, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Transformer #TextToImageGeneration #SmallModel #Selected Papers/Blogs #2D (Image) #Editing #One-Line Notes Issue Date: 2026-03-15 Comment
元ポスト:
github: https://github.com/black-forest-labs/flux2
そもそも2025年11月にリリースされているFLUX.2は結構色々なところで名前を見かけるのでおさえておいたほうが良いかもしれない
https://bfl.ai/blog/flux-2
kleinはFLUX.2シリーズの中で最も軽量なモデルとのこと。2ヶ月程度で既に110k DLされている。
Moondream 3 Preview: Frontier-level reasoning at a blazing speed, Moondream, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #FoundationModel #Reasoning #SmallModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #KeyPoint Notes Issue Date: 2026-03-12 Comment
HF: https://huggingface.co/moondream/moondream3-preview
9B-A2Bの小規模なVLMで、
- visual reasoning: 小規模だが実タスクに適用可能なvisual reasoning性能
- trainable: Visual系のタスクは人間でもzero shotではできないことが多く、簡単にfinetuningできることが重要で
- fast: vision系のアプリケーションはリアルタイムのlavencyが求められることが多く
- inexpensive: 安くスケーラブルでなければならない
をテーマにしたモデルのようである。
object detection, pointing, 構造化された出力(犬の群の個々の犬の毛と首輪の色動画)、OCRなどの様々なタスクが実行可能で、GPT5, Gemini 2.5 Flash, Claude 4 Sonnetをこの規模感のモデルで、objec' detection, counting, document understanding, hallucinationに関するベンチマークで上回る。
前身のモデルであるmoondream2は、5Mダウンロードを達成したようだ
vikhyatk/moondream2
Gemini 3.1 Flash-Lite: Built for intelligence at scale, Google, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary #VisionLanguageModel Issue Date: 2026-03-04 Comment
元ポスト:
Introducing Mercury 2, inception, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DiffusionModel #Blog #Reasoning #Proprietary #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-02-27 Comment
元ポスト:
1092 token/secのproprietary (reasoning) dLLM
関連:
- [Paper Note] Mercury: Ultra-Fast Language Models Based on Diffusion, Inception Labs+, arXiv'25
Artificial Analysisのベンチマーキング結果とスループットの散布図:
スループット/性能比において明らかに抜きんでている。
LFM2-24B-A2B: Scaling Up the LFM2 Architecture, LiquidAI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SmallModel #OpenWeight #MoE(Mixture-of-Experts) #Initial Impression Notes #EdgeDevices Issue Date: 2026-02-27 Comment
元ポスト:
edge deviceにデプロイできる規模でLFM2をスケールさせた模様
Introducing GPT‑5.3‑Codex‑Spark: An ultra-fast model for real-time coding in Codex, OpenAI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Coding #SoftwareEngineering Issue Date: 2026-02-13 Comment
元ポスト:
所見:
Ring-1T-2.5-FP8, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Attention #Reasoning #LongContext #OpenWeight #LongHorizon #LinearAttention Issue Date: 2026-02-12 Comment
元ポスト:
関連:
- Ring-1T, inclusionAI, 2025.10
MLA + lightning linear attentionのハイブリッド
- MHA vs MQA vs GQA vs MLA, Zain ul Abideen, 2024.07
- [Paper Note] Various Lengths, Constant Speed: Efficient Language Modeling with Lightning Attention, Zhen Qin+, ICML'24, 2024.05
[Paper Note] THE MILLION-LABEL NER: BREAKING SCALE BARRIERS WITH GLINER BI-ENCODER, Stepanov+, 2026.02
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #Encoder #NER #EntityLinking Issue Date: 2026-02-05 Comment
元ポスト:
Trinity Large, Arcee, 2026.01
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #read-later #Selected Papers/Blogs #Stability #One-Line Notes #Reference Collection #Sparse #Initial Impression Notes Issue Date: 2026-01-29 Comment
テクニカルレポート:
https://github.com/arcee-ai/trinity-large-tech-report/
HF:
https://huggingface.co/arcee-ai
GLM4.7やDeepSeekV3と比較してスループットやTTFTが二倍以上。
非常にsparseなMoE(400B-A13B, 4/256のexpertsにルーティング)であるため学習を安定させるためにDense layerを増やし、モメンタムを考慮したexpertのバランシングや、z-lossと呼ばれるlogitのスケールをコントロールするような手法を導入することで安定した学習を実現。2048 Nvidia B300 GPUsで、17Tトークンの事前学習33日で完了
元ポスト:
これほどsparseなMoEをここまで安定させて学習できるのは非常に興味深いと思われる。
インタビュー:
やると決めてチームビルディングも含めて非常に短期間(6ヶ月)で達成したとのことだが、気になる。
解説:
所見(風刺):
ポイント解説:
アーキテクチャ解説:
Accelerating Diffusion Models with an Open, Plug-and-Play Offering, Nvidia, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #Tools #NLP #DiffusionModel #TextToImageGeneration #Distillation #PostTraining #2D (Image) #Editing #3D (Video) #TextToVideoGeneration #ImageToTextGeneration #TrainingFramework Issue Date: 2026-01-29 Comment
元ポスト:
self forcingも実装されている
- [Paper Note] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion, Xun Huang+, NeurIPS'25
Fantastic Pretraining Optimizers and Where to Find Them 2.1: Hyperball Optimization, Wen+, 2026.01
Paper/Blog Link My Issue
#Article #NeuralNetwork #Pretraining #NLP #LanguageModel #Optimizer #read-later #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-01-22 Comment
元ポスト:
シンプルな手法で、先行研究によってモデルのパラメータサイズやデータのスケールが大きくなるとMuonのような行列ベースのoptimiserの高速化の恩恵が小さくなる現象を改善しているとのこと。
具体的には、重みを更新する際にweight decayのようなソフトにweightのノルムをコントロールするような仕組みを入れるのではなく、optimiserの重みに対する更新量と、更新後のネットワークの重みをフロベニウスノルムで正規化し、最適化の軌跡を半径Rの超球面の表面上に位置するように明示的に制約する(ここで、Rは最初の重み行列のフロベニウスノルム)。Muonを含む様々なoptimiserでも機能して学習効率を高めるため、インパクトの大きな重要研究に見える。
関連(concurrent works):
- [Paper Note] Nemotron-Flash: Towards Latency-Optimal Hybrid Small Language Models, Yonggan Fu+, arXiv'25, 2025.11
- [Paper Note] Controlled LLM Training on Spectral Sphere, Tian Xie+, arXiv'26, 2026.01
関連:
- [Paper Note] Fantastic Pretraining Optimizers and Where to Find Them, Kaiyue Wen+, ICLR'26, 2025.09
[Paper Note] On the Slow Death of Scaling, Hooker+, 2026.01
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #LanguageModel #Scaling Laws #Author Thread-Post Issue Date: 2026-01-09 Comment
元ポスト:
著者ポスト:
mini-sglang: A compact implementation of SGLang, designed to demystify the complexities of modern LLM serving systems, sgl-project, 2025
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #Repository #LLMServing #SoftwareEngineering #read-later #Selected Papers/Blogs #MinimalCode Issue Date: 2025-12-28 Comment
元ポスト:
めっちゃ勉強したい
Optimizing Large-Scale Pretraining at Character.ai, character.ai, 2025.12
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #read-later Issue Date: 2025-12-24 Comment
元ポスト:
Hot topics in RL, Kimbo, X, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Post #PostTraining #Diversity #train-inference-mismatch Issue Date: 2025-12-22 Comment
ロールアウト側のエンジンと、学習側のエンジンのトークンのlogprobのミスマッチによりon-policy RLを実施しているつもりが実はoff policyになってしまっているという話と
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
- [Paper Note] Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale
Thinking Model, Ling Team+, arXiv'25, 2025.10
- [Paper Note] Stabilizing MoE Reinforcement Learning by Aligning Training and
Inference Routers, Wenhan Ma+, arXiv'25, 2025.10
長いロールアウトを待っている間がアイドルタイムとなり学習が非常に遅くなる問題を、長すぎるロールアウトは待たないでモデルの重みをロールアウトの途中でもかけてしまい、新しいポリシーでロールアウトを継続すると学習は崩壊せずに高速化できるよ(=in flight updates)という話と
- [Paper Note] PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence
Generation, Alexandre Piché+, arXiv'25, 2025.09
- PipelineRL, Piche+, ServiceNow, 2025.04
RLVRはもともとモデルが事前学習時に保持しているReasoningの能力を広げるわけではなく効率化するだけだよ、という主張と、
- [Paper Note] Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yang Yue+, NeurIPS'25, 2025.04
効率化するだけという主張と、Reasoning能力を拡大しているよ、という相反する主張がコミュニティでされているがそれらをphysics of language modelsに則り完全にコントロールされた条件下で実験し、どのような条件でどのような挙動になるかを明らかにしたよ、という話
- [Paper Note] On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models, Charlie Zhang+, arXiv'25, 2025.12
RLVRはPass@1を報酬としているとみなせるが、それをPass@kにすることで、モデルがRL中に探索する能力が向上し、downstreamタスクのPass@kが向上するよ
- [Paper Note] Pass@k Training for Adaptively Balancing Exploration and Exploitation of Large Reasoning Models, Zhipeng Chen+, arXiv'25, 2025.08
といったこの辺の話がホットトピックとして挙げられている。
train-inference-mismatchについては、以下もおもしろかった:
- SID-1 Technical Report: Test-Time Compute for Retrieval, SID Research, 2025.12
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10