
KeyPoint Notes (486) — 3/3
To fine-tune or not to fine-tune, Meta, 2024.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #RAG(RetrievalAugmentedGeneration) #Blog #PEFT(Adaptor/LoRA) #Catastrophic Forgetting #PostTraining Issue Date: 2025-01-02 Comment
LLMをSFTする際の注意点やユースケースについて記述されている。
- full parameterのファインチューニングやPEFT手法のピークGPUメモリ
- full parameterのファインチューニングではcatastrophic forgettingに気をつける必要があること
- Finetuningが有用なユースケースとして以下が挙げられている
- トーン、スタイル、フォーマットのカスタマイザーション
- prompt engineeringやICLで達成するには困難なAccuracyの向上やエッジケースへの対応
- ドメイン適応
- より大きいモデルを蒸留することによるコスト削減
- 新たなタスクへの適応や能力の獲得
また、RAGとFinetuningどちらを選択すべきかに関する話題も記述されている(が、多くの場合はハイブリッドアプローチがベストだ、といった話も書いてある)。
元ポスト:
MHA vs MQA vs GQA vs MLA, Zain ul Abideen, 2024.07
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Attention #Blog Issue Date: 2024-12-28 Comment
DeepSeekで使われているMulti Head Latent Attention(MLA)ってなんだ?と思い読んだ。端的に言うと、GQAやMQAは、KVのヘッドをそもそも減らしてKV Cacheを抑えよう、という手法だったが、MLAはKVを低ランクなベクトルに圧縮して保持し、使う時に復元するといった操作をすることで、MHAのパフォーマンスを落とすことなく(むしろ上がるらしい?)、利用するKV Cacheで利用するメモリを大幅に減らせるという手法らしい。
- [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
MQA, GQAの概要については上記参照のこと。
LLM-as-a-Judge をサーベイする, Ayako, 2024.12
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Evaluation #Blog #LLM-as-a-Judge #Reading Reflections Issue Date: 2024-12-25 Comment
- A Survey on LLM-as-a-Judge, Jiawei Gu+, arXiv'24
を読んだ結果を日本語でまとめてくださっている。
モデル選択について、外部APIに依存するとコストやプライバシー、再現性などの問題があるためOpenLLMをFinetuningすることで対応していることが論文中に記載されているようだが、評価能力にはまだ限界があるとのこと。
記事中ではLlama, Vicunaなどを利用している旨が記述されているが、どの程度のパラメータサイズのモデルをどんなデータでSFTし、どのようなタスクを評価したのだろうか(あとで元論文を見て確認したい)。
また、後処理としてルールマッチで抽出する必要あがるが、モデルのAlignmentが低いと成功率が下がるとのことである。
個人的には、スコアをテキストとして出力する形式の場合生成したテキストからトークンを抽出する方式ではなく、G-Eval のようにスコアと関連するトークン(e.g. 1,2,3,4,5)とその尤度の加重平均をとるような手法が後処理が楽で良いと感じる。
ICLR2025の査読にLLM-as-a-Judgeが導入されるというのは知らなかったので、非常に興味深い。
LLMが好む回答のバイアス(冗長性、位置など)別に各LLMのメタ評価をしている模様。また、性能を改善するための施策を実施した場合にどの程度メタ評価で性能が向上するかも評価している。特に説明を出力させても効果は薄く、また、複数LLMによる投票にしても位置バイアスの軽減に寄与する程度の改善しかなかったとのこと。また、複数ラウンドでの結果の要約をさせる方法がバイアスの低減に幅広く寄与したとのこと。
うーん、バイアスを低減するうまい方法がまだ無さそうなのがなかなか厳しい感じがする。
そもそも根本的に人間に人手評価をお願いする時もめちゃめちゃマニュアルとかガイドラインを作り込んだりした上でもagreementが高くなかったりするので、やはり難しそうである。
ただ、MTBenchでは人間の評価結果とLLMの評価結果の相関(agreementだっけか…?)が高かったことなどが報告されているし、LLMあるあるのタスクごとに得意不得意があります、という話な気もする。
Netflixの推薦&検索システム最前線 - QCon San Francisco 2024現地レポート, UZABASE, 2024.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Blog #Reading Reflections Issue Date: 2024-12-20 Comment
インフラ構成の部分が面白い。モデルの構築方法などは、まず軽量なモデルやヒューリスティックで候補を絞り、その後計算量が重いモデルでリランキングする典型的な手法。
Netflixのインフラによって、以下のようなことを
>1~2秒前の最新データを参照でき、推薦生成に反映させることが可能です
latencyを40msに抑えつつ実現しているとのこと。直前のアクションをinferenceで考慮できるのは相当性能に影響あると思われる。
また、検索と推薦をマルチタスク学習しパラメータをシェアすることで両者の性能を挙げているのが興味深い。
モデル自体は近年のLLMを用いた推薦では無く、Deepなニューラルネットに基づくモデルを採用
(まあLLMなんかにリアルタイムで推論させたらlatency 40ms未満という制約はだいぶきついと思われるしそもそも性能向上するかもわからん。予測性能とかよりも、推薦理由の生成などの他タスクも同時に実施できるのは強みではあるとは思うが…)。
まあしかし、すごい目新しい情報があったかと言われると基本的な内容に留まっているのでそうでもないという感想ではある。
【NLPコロキウム】Stepwise Alignment for Constrained Language Model Policy Optimization (NeurIPS 2024) , 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Slide Issue Date: 2024-12-19 Comment
- RLHF/DPO 小話, 和地瞭良/ Akifumi Wachi, 2024.04
も参照のこと。
RLHF, DPOが解いている問題が同じで、問題が同じなのでそれぞれの最適解も一緒であり解き方が違うだけ、でもDPOの方が頑張って強化学習するRLHFよりも簡単に解けるし、学習も安定してるよ、という話が、binary feedbackデータに対するアライメント手法であるKTOも交えて書いてある。
アライメントの学習では単一のスカラー値によって報酬が決まっているが、生成結果には色々な側面があるから単一スカラーでは本来評価できないよねという話が出てきた上で、safetyに対しても考慮して報酬を決めたい、という時にスカラー値のままだけど最適化問題の制約条件にsafetyに関する制約を入れる、ことで報酬に反映させます、みたいな話が書いてある。
そして提案手法の主要な貢献は、そういうことをやるとめちゃめちゃ手法が複雑化するんだけれども、よりシンプルにして、かつ理論的にも正当化されているし、実験的にもうまく動きます、という話らしい。
Introducing Amazon Nova, our new generation of foundation models, AWS, 2024.12
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #FoundationModel #MultiLingual Issue Date: 2024-12-04 Comment
参考: https://qiita.com/ysit/items/8433d149dbaab702d526
後で個々のベンチマークとメトリックをまとめたい。
まあでもざっくり言うと、他のproprietaryモデルともおおむね同等の性能です、という感じに見える。個々のタスクレベルで見ると、得意なものと不得意なものはありそうではある。
スループットとかも、ProとGPT4oをパッと見で比較した感じ、優れているわけでもなさそう。Liteに対応するGPTはおそらくGPT4o-miniだと思われるが、スループットはLiteの方が高そう。
(画像は論文中からスクショし引用)
下記ポストは独自に評価した結果や、コストと性能のバランスについて言及している。
- ProはGPT4oのコストの約1/3
- Pro, Lite, Flashはほれぞれコストパフォーマンスに非常に優れている(Quality vs. Price参照)
元ポスト:
【総集編)】15年間のC向けサービスづくりで 得た学び, Shota Horii, 2024.11
Paper/Blog Link My Issue
#Article #Blog #Reading Reflections Issue Date: 2024-11-18 Comment
具体的だがシンプルに知見がまとまっていてとても分かりやすい。
顧客開発モデルに基づいた考え方のみならず、仮設整理のために実際に使われているシートなどの実用的なツール群や、
顧客とのチャネル構築方法、プロダクトのスケールするための知見、チームビルディング、カルチャーの作り方の作法など(他にも透明性とかサンクコストを恐れずシンプルさを保つことのコスト削減効果などここには書ききれない)、
実体験を具体的に交えながら説明されており、盛りだくさんで非常に勉強になる。
The Fastest Access to Enterprise-Grade Cloud GPUs, Lambda
Paper/Blog Link My Issue
#Article #Infrastructure #GPU-Platform #Reading Reflections Issue Date: 2024-11-09 Comment
元ポスト:
A100を1時間あたり1.29$で使えるぽいので、安価である。8BのLLMをLoRAでちょろっとSFTするくらいなら、数ドルくらいでいけそう。
AWSだと、A100を8基、vCPU96、VRAM320G、RAM1152GiBのインスタンス(p4d24xlarge)が、1時間あたりオンデマンドで32.77$なのに対し、
LambdaではA100 1基あたり1.29$なので、8基で10.32$となる。したがって、コストはだいたいAWSのおよそ1/3くらいに見える(他にも安価なAWSインスタンスあるかもだが)。
ちなみにLambdaでは、vCPU124、RAM1800GiBである。
AWS参考:
https://aws.amazon.com/jp/ec2/instance-types/p4/
こちらのポストも参照のこと:
Lambdaに加え
- [runpod.io]( https://www.runpod.io)
- [vast.ai]( https://vast.ai/)
というサービスも紹介されている。
[Perplexityで3つを比較させた結果(参考; Hallucinationに注意)](
https://www.perplexity.ai/search/runpod-io-vast-ai-lambdatea100-vJgXn4osSfCqxPsxuJEPKA)
>これらのサービスの中では、Vast.aiが最も安価ですが、セキュリティと安定性に注意が必要です。RunPodは多機能で使いやすいものの、やや高価です。Lambdaは安定性が高いですが、柔軟性に欠ける面があります。選択する際は、予算、セキュリティ要件、必要な機能性を考慮して判断することが重要です。
ほぼリアルタイム!?爆速で動作する日本語特化の文字起こしAI!『kotoba-whisper-v2.0』, 遼介 大堀, 2024.11
Paper/Blog Link My Issue
#Article #NLP #SpeechProcessing #Blog #Japanese #AutomaticSpeechRecognition(ASR) #Reading Reflections Issue Date: 2024-11-07 Comment
whisper large-v3を蒸留したkotoba-whisper-v1.0に対して、日本語のオーディオデータで追加学習をしたモデル、kotoba-whisper-v2.0を利用するための環境構築方法やコードの例が記述されている。
公式によると、whisper-large-v3よりも6.3倍のスループットとのこと。また、qiita記事中ではwhisper large-v2に対して約6.0倍のスループットであることが言及されている。
学習に用いられたデータは、ReasonSpeechデータ(日本語のテレビの録音データ)
- ReazonSpeech: A Free and Massive Corpus for Japanese ASR, Yin+, NLP'23
をWERに基づくフィルタリングによって良質なデータのみを抽出することで作成されたデータの模様
公式のモデルカードも参照のこと:
https://huggingface.co/kotoba-tech/kotoba-whisper-v2.0
日本のテレビ番組のデータで学習されているので、それを念頭に置いた上で、自分が適用したいデータとの相性を考えると良さそうである。
また、動作速度が速いのはシンプルにありがたい。
システム開発プロジェクト応用第一 第5,6回 Gitによるバージョン管理, 内田公太, 2020.01
Paper/Blog Link My Issue
#Article #Tutorial #Video #VCS #git Issue Date: 2024-11-04 Comment
VCSの歴史から原理、実用的な使い方まで、Gitについて体系的にまとまっている。普段何気なく使っているが、改めて勉強すると、なるほど、と思うことが多い。
- VCSの歴史、モチベーション(複数並列するバージョンを適切に管理したい)
- ワークツリー、インデックス、リポジトリ(HEAD)の違い
- 基本的なgitコマンドから、普段あまり使わないハンク(hunk)の選択的なaddなどのコマンド
- コミットオブジェクト(ワークツリーのスナップショットを保持したもの≠前回のコミットに対する差分)
- HEAD/Detached HEADの原理
- Gitタグ
- checkoutの原理(ワークツリーとインデックスをHEADの内容に更新する)
- ブランチ、ブランチとHEADの関係性
- マージ方式(2way マージ、3wayマージ)
- 2wayマージは元ファイルを参照しないのでマージ時に特定の編集がなかったことになってしまう)
- 3wayマージは元ファイルも見て差分を計算するのでこのようなことが起こらない
- 競合の原理、競合解決時のファイル内容
- Fast-Forwardマージ(ポインタを動かすだけで事足りる場合に利用)
- cherry pick(任意のコミットをとってくる)
- (cherry pickを連続して利用する)リベース(ベースを付け替える操作)
- 歴史を修正する
- git reflogで起点とするコミットIDを見つけ、git rebase -iでコミット順変更orメッセージ変更、git commit --amendでコミット修正
- 状態のリセット
- soft: HEADを指定したコミットにリセット
- mixed: インデックスをリセット
- hard: インデックスとワークツリーをリセット
- git stash
- コミット粒度とメッセージ
- 単一の関心事項のみを含むような粒度でコミットしよう(一言で説明できる粒度)
- cherry pickが容易になる
- 別ブランチの脆弱性への対応のみを適用したい、など
- 現在形で書く。そうすると、後からcherry pickするときに内容の判断をしやすい。
神講義
生成AIを活用したシステム開発 の現状と展望 - 生成AI時代を見据えたシステム開発に向けて-, 株式会社日本総合研究所 先端技術ラボ, 2024.09
Paper/Blog Link My Issue
#Article #Survey #GenerativeAI #Blog #Reading Reflections Issue Date: 2024-10-01 Comment
ソフトウェア開発で利用され始めている生成AIのプロダクト群と、それらに関連するソースコード生成やテストコード生成、エージェントによる自動システム開発等の研究動向、今後の展望について具体的に記述されている。
SIerやITベンダー内では、実際に活用しているところも一部あるようだが、まだ検証や改革の途中の模様。要件定義に対するLLMの活用も模索されているようだが、産業側もアカデミックも研究段階。
web系では、サイバーやLINEヤフーが全社的にすでにGithub Copilotを導入しているとのこと。
Devin AIのように、Github上のオープンソースのIssueをもとにしたベンチマークで、2294件中13.86%のIssueを解決した、みたいな話を見ると、そのうちコードを書く仕事はIssueを立てる仕事に置き換わるんだろうなあ、という所感を得た(小並感
Claude Opus 4.6あたりが一つの節目で、明らかに2026年頭にかけてCoding Agentの質が上がって完全なる実用レベルに到達したという感がある。
非プロダクトマネージャーのためのプロダクトマネジメント入門, 神原淳史, 2024.09
Paper/Blog Link My Issue
#Article #Blog #Management #Reading Reflections Issue Date: 2024-09-30 Comment
プロダクトマネジメントについて初心者向けに書かれた記事。勉強になった。
JTBDフレームワークは顧客開発モデルなどでも出てくるので、もう一度復習しておきたい。
>When (Situation) I want to (Motivation) So I can (Expected outcome)
ビルドトラップについても勉強になった。ミニマムでユーザの課題(ニーズ)を解決(満たす)する価値を提供することが重要。この辺は、技術にこだわりや興味、自信がある人ほど作り込みすぎてしまう印象がある。
https://product-managers-club.jp/blog/post/build-traps-fall
レベル2生産性の簡易的な計算方法のフレームワーク。知っておくと役に立つ場面がありそう。考え方として知っておくだけでも良い。confidenceの定義が難しそう。
>・Reach: どれだけ多くの顧客/ユーザーにとっての問題か
・Impact: その問題は個々の顧客/ユーザーにとってどれだけ深刻か
・Conficence: ReachとImpactがどれだけ確からしいか (Effortの確からしさも含むことがある)
・Effort: 問題解決の実装に必要な工数
計算式は以下の通りです。
RICEスコア = Reach * Impact * Confidence / Effort
と思ったが、一応参考として以下のようなものが紹介されている。この辺はプロダクトやチームごとにより具体的なものを決めていくと良いのだろうと思う。特に発案者やその同僚が信じている、の部分は深掘りできそうな気がする。その人にしか見えておらず、定量化できない感覚のような部分があったとしたら、この基準では低いスコアを付与してしまう。ユーザに近しい人ほどそういう感覚を持っており、軽視すべきでないと個人的には考える(が、発言者によって熱量のオフセットが異なるのでその辺も考慮しないといけないから判断難しそう)。
>・発案者やその同僚が信じている (0.01 - 0.2)
・複数の顧客からリクエストがあった (0.5 - 1)
・市場リサーチ結果 (1 - 2)
・一定量以上のユーザーインタビュー結果 (3)
・実際のプロダクト上での検証結果 (5 - 10)
記事のまとめ
>・ソリューションよりも問題の明確化にフォーカスしよう。そのための手法の1つにJTBDフレームワークがある。
・問題解決の優先度を評価するための観点を知ろう。その観点リストの1つにRICEフレームワークがある。
・PBIの相対的な優先順位づけも大事だが、その前に必ずプロダクト戦略へのアラインを確認しよう。
Llama 3.2: Revolutionizing edge AI and vision with open, customizable models, Meta, 2024.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Blog #SmallModel #OpenWeight #VisionLanguageModel #EdgeDevices Issue Date: 2024-09-25 Comment
11Bと90BのVLMと、エッジデバイス向けの1B, 3BのSLMを発表。
Llama3.2のVLMでは、事前学習されたimage encoderを事前学習された言語モデルに対して組み合わせるためのAdapterを複数学習することによって実現。
具体的には、Llama 3.1(text only model)に対して、image encoderとAdapterを追加し、大規模でノイジーな(image,text)ペアで事前学習。続いて、中規模のサイズの高品質なin-domain(i.e. 様々なドメインの)の知識を高めるような(image,text)ペアで学習した。
事後学習では、Llama3.1と同様にSFT, Rejection Sampling, DPOのラウンドを複数回繰り返した。Llama3.1を用いて、in-domainの画像に対するQAをData Augmentationし、フィルタリングすることで合成データを作成。さらに報酬モデルを活用して全ての回答候補をランクづけして高品質なSFTデータを取得。また、モデルの安全性が高まるようなデータも追加した。
Llama3.1の事後学習のプロセスについては 論文紹介 / The Llama 3 Herd of Models, 2024.08
も参照のこと。
クリックを最大化しない推薦システム, Ryoma Sato, 2024.01
Paper/Blog Link My Issue
#Article #RecommenderSystems #Slide #Reading Reflections Issue Date: 2024-09-15 Comment
おもしろそうなので後で読む
クリック率やコンバージョン率に最適化することが従来のやり方だが、クリックベイトのため粗悪なコンテンツを推薦してしまったり、人気のあるアイテムに推薦リストが偏ってしまい、長期的なユーザの利益を害するという話。
20年くらい前からこの辺をなんとかするために、推薦のセレンディピティや多様性を考慮する手法が研究されており、それらのエッセンスが紹介されている。また、Calibrated Recommendation [Paper Note] Calibrated Recommendation, Herald Steck, Netflix, RecSys'18
(ユーザの推薦リストがのジャンルの比率がユーザの好む比率になるように最適化する方法で、劣モジュラ関数を最適化するためgreedyに解いてもある程度良い近似解が保証されている)などの概要も説明されていて非常に勉強になった。
セレンディピティのある推薦アルゴリズムをGoogle上でA/Bテストしたら、ユーザの満足度とコアユーザー転換率が大幅に向上したと言う話や、推薦はフィルターバブル問題を実は悪化させないといった研究がGroupLensのKonstan先生のチームから出ているなど、興味深い話題が盛りだくさんだった。
OpenAI o1, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Reasoning #Test-Time Scaling #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2024-09-13 Comment
Jason Wei氏のポスト:
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
や
- [Paper Note] Implicit Chain of Thought Reasoning via Knowledge Distillation, Yuntian Deng+, arXiv'23, 2023.11
で似たような考えはすでに提案されていたが、どのような点が異なるのだろうか?
たとえば前者は、pauseトークンと呼ばれるoutputとは関係ないトークンを生成することで、outputを生成する前にモデル内部で推論する前により多くのベクトル操作を加える(=ベクトルを縦方向と横方向に混ぜ合わせる; 以後ベクトルをこねくりまわすと呼称する)、といった挙動を実現しているようだが、明示的にCoTの教師データを使ってSFTなどをしているわけではなさそうに見える(ざっくりとしか読んでないが)。
一方、Jason Wei氏のポストからは、RLで明示的により良いCoTができるように学習をしている点が違うように見える。
**(2025.0929): 以下のtest-time computeに関するメモはo1が出た当初のものであり、私の理解が甘い状態でのメモなので現在の理解を後ほど追記します。当時のメモは改めて見返すとこんなこと考えてたんだなぁとおもしろかったので残しておきます。**
学習の計算量だけでなく、inferenceの計算量に対しても、新たなスケーリング則が見出されている模様。
テクニカルレポート中で言われている time spent thinking (test-time compute)というのは、具体的には何なのだろうか。
上の研究でいうところの、inference時のpauseトークンの生成のようなものだろうか。モデルがベクトルをこねくり回す回数(あるいは生成するトークン数)が増えると性能も良くなるのか?
しかしそれはオリジナルのCoT研究である
- [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
のdotのみの文字列をpromptに追加して性能が向上しなかった、という知見と反する。
おそらく、**モデル学習のデコーディング時に**、ベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすこと=time spent thinking (test-time compute) 、ということなのだろうか?
そしてそのように学習されたモデルは、推論時にベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすと性能が上がる、ということなのだろうか。
もしそうだとすると、これは
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
のpauseトークンの生成をしながらfinetuningすると性能が向上する、という主張とも合致するように思うが、うーん。
実際暗号解読のexampleを見ると、とてつもなく長いCoT(トークンの生成数が多い)が行われている。
RLでReasoningを学習させる関連研究:
- ReFT: Reasoning with Reinforced Fine-Tuning, Trung Quoc Luong+, N/A, ACL'24
- Training Large Language Models for Reasoning through Reverse Curriculum Reinforcement Learning, Zhiheng Xi+, N/A, ICML'24
以下o1の動きに関して考えている下記noteからの引用。
>これによって、LLMはモデルサイズやデータ量をスケールさせる時代から推論時間をスケールさせる(つまり、沢山の推論ステップを探索する)時代に移っていきそうです。
なるほど。test-compute timeとは、推論ステップ数とその探索に要する時間という見方もあるのですね。
またnote中では、CoTの性能向上のために、Process Reward Model(PRM)を学習させ、LLMが生成した推論ステップを評価できるようにし、PRMを報酬モデルとし強化学習したモデルがo1なのではないか、と推測している。
PRMを提案した研究では、推論ステップごとに0,1の正誤ラベルが付与されたデータから学習しているとのこと。
なるほど、勉強になります。
note:
https://note.com/hatti8/n/nf4f3ce63d4bc?sub_rt=share_pb
note(詳細編): https://note.com/hatti8/n/n867c36ffda45?sub_rt=share_pb
こちらのリポジトリに関連論文やXポスト、公式ブログなどがまとめられている:
https://github.com/hijkzzz/Awesome-LLM-Strawberry
これはすごい。論文全部読みたい
Pluggyとは, 2023.02
Paper/Blog Link My Issue
#Article #Library #python #Blog Issue Date: 2024-09-12 Comment
pluggyに関する概要が説明されている。
公式の説明を読むとpytestで採用されており、pluggyは関数フックを可能にし、プラグインをインストールするだけでホストプログラムの動作を拡張、または変更できるようになる代物とのこと(=プラガブル?)。
pluggyがなぜ有用なのかの説明については、Pythonでは、他のプログラムやライブラリの動作を変更するための既存のメカニズムとして、メソッドのオーバーライドやモンキーパッチが存在するが、複数の関係者が同じプログラムの変更に参加したい場合、これらが問題を引き起こすので、pluggyはこれらのメカニズムに依存せず、より構造化されたアプローチを可能にし、状態や動作の不必要な露出を避けるとのこと。これにより、ホストとプラグインの間が疎結合になるので、問題が軽減されるとのこと。
Reflection 70B, GlaiveAI, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #OpenWeight #SelfCorrection #PostTraining #Reference Collection #Author Thread-Post Issue Date: 2024-09-06 Comment
ただまあ仮に同じInputを利用していたとして、promptingは同じ(モデルがどのようなテキストを生成し推論を実施するかはpromptingのスコープではない)なので、そもそも同じInputなのでfair comparisonですよ、という話に仮になるのだとしたら、そもそもどういう設定で比較実験すべきか?というのは検討した方が良い気はする。まあどこに焦点を置くか次第だと思うけど。
エンドユーザから見たら、reflectionのpromptingのやり方なんてわからないよ!という人もいると思うので、それを内部で自発的に実施するように学習して明示的にpromptingしなくても、高い性能を達成できるのであれば意味があると思う。
ただまあ少なくとも、参考でも良いから、他のモデルでもreflectionをするようなpromptingをした性能での比較結果も載せる方が親切かな、とは思う。
あと、70Bでこれほどの性能が出ているのはこれまでにないと思うので、コンタミネーションについてはディフェンスが必要に思う(他のモデルがそのようなディフェンスをしているかは知らないが)。
追記
→ 下記記事によると、LLM Decontaminatorを用いてコンタミネーションを防いでいるとのこと
https://github.com/lm-sys/llm-decontaminator
Reflection自体の有用性は以前から示されている。
参考: Self-Reflection in LLM Agents: Effects on Problem-Solving Performance, Matthew Renze+, N/A, arXiv'24
, [Paper Note] Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection, Akari Asai+, ICLR'24, 2023.10
, [Paper Note] AnyTool: Self-Reflective, Hierarchical Agents for Large-Scale API Calls, Yu Du+, ICML'24, 2024.02
, [Paper Note] Automatically Correcting Large Language Models: Surveying the landscape of diverse self-correction strategies, Liangming Pan+, TACL'24, 2023.08
ollamaで実際に動かして日本語でのQAを試している記事。実際のアウトプットやreflectionの内容が確認でき、おもしろい。
システムプロンプトで< thinking >タグでInputに対して推論し、< output >タグ内で最終出力を行い、推論過程で誤りがある場合は< reflection >タグを用いて修正するように指示している。
おそらく、thinkingタグ内の思考過程でモデルが誤りに気づいた場合は、thinkingタグの途中でreflectionタグが出力され、その時点でCoTが修正されるようである(もしくはoutputとthinkingの中間)。このため、誤ったCoTに基づいてOutputが生成される頻度が減少すると考えられる。
このような挙動はおそらく、reflection用の学習データでSFTしないとできないと思うので
(たとえば、ReflectionタスクをするようなデータでSFTをしていない場合、出力の途中で誤りを検出し出力を修正するという挙動にはならず、回答として自然な文を最後までoutputすると思う。その後でreflectionしろと促すことはpromptingでできるかもしれないが、そもそもreflectionする能力があまり高くない可能性があり、うまく修正もしてくれないかも)
reflectionの能力を高めるようなデータでSFTをしていないモデルで似たようなpromptingをしても、うまくいかない可能性があるので注意が必要だと思われる。
参考:
https://note.com/schroneko/n/nae86e5d487f1
開発者曰く、HFに記載の正しいシステムプロンプトを入れないと、適切に動作しないとのこと。
元ツイート:
どうやら初期にアップロードされていたHFのモデルはweightに誤りがあり、挙動がおかしくなっていたようだ。
正しいモデルの挙動は下記ツイートのようである。thinking内でreflectionが実施されている。
実際にいくつかの例をブログをリリース当日に見た時に、reflectionタグがoutputの後に出力されている例などがあり、おや?という挙動をしていたので、問題が是正されたようだ。
HFのモデルが修正された後もベンチマークの結果が再現されないなど、雲行きが色々と怪しいので注意した方が良い。
続報
開発者ポスト:
再現実験を全て終了し、当初報告していた結果が再現されなかったとCEOが声明:
Ruri: Japanese General Text Embeddings, cl-nagoya, 2024.09
Paper/Blog Link My Issue
#Article #Embeddings #NLP #LanguageModel #RepresentationLearning #Japanese Issue Date: 2024-09-04 Comment
元ツイート:
337Mパラメータのモデルで、同等のサイズのモデルをJMTEBで大きく上回る性能。LLMを用いて生成したデータを用いてContrastive Learning, その後高品質なデータでFinetuningを実施したとのこと。
JMTEB上では、パラメータサイズ不明(だがおそらく桁違いに大きい)のOpenAI/text-embedding-3-largeと同等の性能に見えるが、LLMに日本語テキストを学習させる意義, Koshiro Saito+, 第261回自然言語処理研究発表会, 2024.08
などを考慮すると、日本特有の知識を問うQAなどはマルチリンガルなモデルは弱そうなので、その辺がどれほど高い性能を持っているのかは興味がある。
LLMで人工的に生成したデータでは、生成に利用したLLMが持つ知識しか表層的には現れないと思うので何を利用したかによるのと、高品質なラベルデータにその辺がどの程度含まれているか。
最大sequence長は1012なので、より長い系列をBERTで埋め込みたい場合はRetrievaBERT RetrievaBERTの公開, 2024 (最大sequence長2048)も検討の余地がある。
開発者の方からテクニカルレポートが出た
https://arxiv.org/abs/2409.07737
NanoFlow, 2024.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #python #LLMServing Issue Date: 2024-08-31 Comment
vLLMよりも2倍程度高速なLLM serving framework。
オフライン評価
オンラインでのlatency評価
機能はvLLMの方が多いが、速度はこちらの方がかなり速そうではある。latencyのrequirementが厳しい場合などは検討しても良いかもしれない。
しかしLLM serving frameworkも群雄割拠ですね。
元ポスト:
- DeepSpeed, vLLM, CTranslate2 で rinna 3.6b の生成速度を比較する, 2024.06
も参照のこと
2025年9月を最後にコミットがないようだ。
PLaMo-100B, PFN, 2024.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #SyntheticData #Blog #Proprietary #Japanese #DPO #ModelMerge Issue Date: 2024-08-08 Comment
日本語のベンチマークでGPT4を超える性能を達成。
SFT, DPOで学習。学習データは、Publicなもの、プログラムで作成したもの、LLM自身に作成させたものを利用した。また、最終的なモデルに複数の候補があったのでモデルマージで良いところ取りをした。DPOで利用するpreferenceデータは、事後学習途中のモデルによって自動生成。
GENIAC: 172B 事前学習知見, 2024
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Blog Issue Date: 2024-07-08 Comment
LLMの事前学習における知見がまとまっている記事とのこと
・Megatron LMで学習
→ 3D Parallelismなどの分散学習手法によりHF Trainerより高速
→ Data Parallelim、Tensor Parallelism、 Pipeline Parallelismを組み合わせたもの
・GPUメンテナンス、不良で学習が継続できなかった場合はcheckpointをロードして学習
・学習曲線が安定しているように見えるがSpikeは発生している。発生時はgradient normが急激に上昇する
・LlamaなどのLLMからの継続的事前学習ではなくfrom scratchから学習しているので透明性が高い
・Transformer engineを利用
・AdamWを利用
・attention dropout, hidden dropoutは0.0
>この際、 通信を多く必要とする分散手法のワーカー(Tensor Parallelワーカー)はノード内に配置するようにMegatron-LMのデフォルトではなっているため、今回もそれを利用しました。このようにする理由は、ノード内の通信はNVLinkにより、ノード間通信よりも高速であるためです。また、Data Parallelの勾配平均化のための通信を考慮して、Data Parallelワーカーも可能な限りノード内に配置するMegatron-LMデフォルトの挙動を利用しました。
Pipeline Parallelismは他の並列化手法と比較して通信量が少ないP2P(Point-to-Point)通信であるため、パイプラインステージはノード間で配置するようにしました。これも、Megatron-LMデフォルトの挙動です。
勉強になる
・通常のデータ並列はoptimizer stateをworker間で複製するので遅い。Deep Speed Zero 1のように分散して保有することで高速化
・Tensor Parallelでself attention, MLPの計算を並列化できる
・LayerNormalization, Dropoutの演算もメモリ効率の観点から並列化
・学習を安定させるためにz-lossを利用
・batch skippingとは、gradient clippingを行っていてもなおspikeが生じる場合に、100 step前に戻り、spikeが生じた付近のデータを数百iteration程度スキップすること
RetrievaBERTの公開, 2024
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #RAG(RetrievalAugmentedGeneration) #LongContext #Encoder Issue Date: 2024-07-03 Comment
RAGへ応用する際に、長いコンテキストを扱いEmbeddingを獲得したいシーンが増えたので、最大でコンテキスト長が2048のBERTを学習し公開。Apache2.0
オリジナルのBERTと比較して、近年のLLMで有用性が示されている以下をアーキテクチャに取り入れている
- SwiGLU活性化関数 [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
- PreNorm より良いTransformerをつくる, Shun Kiyono, 2022
- Grouped Query Attention (Multi Query Attention) [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
「ビジネスロジック」とは何か、どう実装するのか
Paper/Blog Link My Issue
#Article #Blog Issue Date: 2024-04-21 Comment
普段あいまいに使いがちなビジネスロジックについて、勉強になった。
- プレゼンテーション層:ユーザからのI/Oのインタフェースに関する処理を実装
- データアクセス層:ファイルやDBに対してデータを読み書き
本記事によると上記以外が「ビジネスロジック」という整理。
たとえば、じゃんけんの実装を例に説明がなされており、
- 「じゃんけんの勝敗判定」:コアなルール系
- 「コンピュータとじゃんけんをして、その結果をどこかに保存する処理を呼び出すという流れ」:処理の流れ系
の両者はビジネスロジックに該当するとのこと。
LLaMA3, Meta, 2024.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2024-04-18 Comment
ライセンスによると、LLaMA3を利用したモデルはどんな場合でもLlama3をprefixとして付与しないといけないらしい
元ツイート:
LLaMA3がChatBot ArenaでTop 5になったとのこと。また、英語においては、GPT4-1106-preview, GPT-4-turbo-2024-0409と同等の性能を達成。これはすごい…
nejumi-leaderboard Nejumi LLMリーダーボード, Weights & Biases
にLLaMA3の評価結果が掲載された模様(画像は下記ツイートより引用)
モデルアーキテクチャはTransformer Decoderをベースにしており、Llama2と比較して
- TokenizerのVocabサイズを128Kより効率的にテキストをエンコーディング可能に
- GQA [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
を利用しInferenceを高速化 (Llama2の時点でGQAを使っていたが、70Bモデルだけだった)
- self-attentionが、ドキュメントを跨がないように学習
context: 8192
repeng
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Library #Alignment #TextualInversion #TrainingFramework Issue Date: 2024-03-21 Comment
LLMの出力のスタイルを数百個の事例だけで学習しチューニングできるライブラリ。promptで指定するのとは異なり、数値でスタイルの強さを指定することが可能らしい(元ツイート)。画像生成分野におけるTextual Inversionと同じ技術とのこと。
Textual Inversionとは、少量のサンプルを用いて、テキストエンコーダ部分に新たな「単語」を追加し、単語と対応する画像を用いてパラメータを更新することで、prompt中で「単語」を利用した場合に学習した画像のスタイルやオブジェクト(オリジナルの学習データに存在しなくても可)を生成できるようにする技術、らしい。
Huggiegface:
https://huggingface.co/docs/diffusers/training/text_inversion
(参考)GPTに質問した際のログ:
https://chat.openai.com/share/e4558c44-ce09-417f-9c77-6f3855e583fa
元ツイート:
[Paper Note] Evolutionary Optimization of Model Merging Recipes, Takuya Akiba+, N_A, Nature Machine Intelligence, Vol.7, 2025.01
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Selected Papers/Blogs #ModelMerge #Nature Machine Intelligence Issue Date: 2024-03-21 GPT Summary- 進化アルゴリズムを使用した新しいアプローチを提案し、強力な基盤モデルの自動生成を実現。LLMの開発において、人間の直感やドメイン知識に依存せず、多様なオープンソースモデルの効果的な組み合わせを自動的に発見する。このアプローチは、日本語のLLMと数学推論能力を持つモデルなど、異なるドメイン間の統合を容易にし、日本語VLMの性能向上にも貢献。オープンソースコミュニティへの貢献と自動モデル構成の新しいパラダイム導入により、基盤モデル開発における効率的なアプローチを模索。 Comment
複数のLLMを融合するモデルマージの話。日本語LLMと英語の数学LLNをマージさせることで日本語の数学性能を大幅に向上させたり、LLMとVLMを融合したりすることで、日本にしか存在しない概念の画像も、きちんと回答できるようになる。
著者スライドによると、従来のモデルマージにはbase modelが同一でないとうまくいかなかったり(重みの線型結合によるモデルマージ)、パラメータが増減したり(複数LLMのLayerを重みは弄らず再配置する)。また日本語LLMに対してモデルマージを実施しようとすると、マージ元のLLMが少なかったり、広範囲のモデルを扱うとマージがうまくいかない、といった課題があった。本研究ではこれら課題を解決できる。
著者による資料(NLPコロキウム):
https://speakerdeck.com/iwiwi/17-nlpkorokiumu
Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #FoundationModel #Blog #Japanese #mid-training Issue Date: 2023-12-19 Comment
Llama2の日本語性能を継続事前学習で引き上げたLLM。2023年12月時点の日本語オープンソースLLMの中で最高性能とのこと。
開発者の方による詳細はこちら:
https://zenn.dev/tokyotech_lm/articles/d6cb3a8fdfc907
すごい読み応え…checkpointの容量のデカさや、A100x8 60ノード使った話や、ノード不良やスケジュール管理の話、独自に実装をゴリゴリ加えたものではなく最終的に完成度の高さからMegatronLMを採用した話など、バグった規模感と試行錯誤や実体験に基づくエピソード満載。
【続】Flash Attentionを使ってLLMの推論を高速・軽量化できるか?, jobyan, Qiita, 2023.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Attention #Blog Issue Date: 2023-12-14 Comment
use_cacheがTrue/Falseの場合のFlashAttention2のinference timeとVRAM使用量の傾向をsequence_lengthごとに考察している。
use_cacheはKey Value cacheのオンオフを切り替えられるオプションである。autoregressiveなモデルのinference時には、何度も同じinput tokenに対するKVの計算が生じるため(M番目のトークンを生成した後、M+1番目のトークンの生成をする場合、M-1番目までのトークンのKVを再計算せねばならない)、cacheをすることで大幅に計算速度が改善される。
use_cacheをTrueにできるならFlashAttention2の恩恵は小さい(inference timeが少し早くなるのみ)ため、潤沢なVRAMがあるなら得られる恩恵は小さい。
逆にVRAM節約してuse_cacheをFalseにせざるを得ないのであれば、FlashAttention2によりVRAM使用量をsequence_legthの線形に抑えることができ、かつinference timeも短くなる。
↑上記はあくまでinferenceをする場合のみの話であり(train時はautoregressive modelではcausal maskを用い、teacher forcingで並列にトークンを生成するためそもそもKV-cacheする意味がない)、trainingをする場合FlashAttention2で大幅にVRAM使用量を減らせるので、そこは分けて考えること。
https://qiita.com/jovyan/items/ff3d0a49163c7afa33ce
Flash Attentionを使ってLLMの推論を高速・軽量化できるか?
https://qiita.com/jovyan/items/11deb9d4601e4705a60d
こちらの記事も非常に勉強になる
Introducing Gemini: our largest and most capable AI model, Google, 2023.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Blog #Proprietary #VisionLanguageModel #Reference Collection Issue Date: 2023-12-07 Comment
多くのベンチマークでGPT4超えらしい
(追記1)
テクニカルレポートのp.44を見ると、ブログポスト中のGPT4のMMLUのスコアはGPT-4-0613のもののようなので、これが正しいとすると他のベンチマークのスコアも同モデルのものである可能性が高く、GPT-4-1163-preview(最新モデル)のスコアでは"ないかもしれない"点に注意。GPT4とどちらが実際に性能が良いか?については様子見した方が良さそう。
(追記2)
GSM8Kの結果も、GPT4に対してFair Comparisonではないかもしれない点に注意。Geminiは32個のCoTとSelf-Consistencyを利用しているが、GPT4では5-shotで単一のCoTのみであるため、prompting手法ではGeminiに有利な比較となっているように見える。ただしGPT4はGSM8Kの訓練データを事前学習時にMIXしている(SFT)ので、Geminiがこのようなことをしていないのであれば、この点ではGPT4が有利になっている“可能性”がある。
他にもFair Comparisonになっていないと推察されるものはTextモダリティでの評価の表の文言を見るとありそうなのでそこは念頭においた方が良さそうである。
テクニカルレポート: https://storage.googleapis.com/deepmind-media/gemini/gemini_1_report.pdf
Gemini Summary
MMLUでの同じprompting手法でのGPT-4-0613との比較。32個のCoTでのSelf-Consistencyで比較した場合、GPT-4-0613に負けているが、閾値を設けてconfidenceが閾値以上の場合はSelf-consistency, そうでない場合はgreedyに生成した結果を選択する、というUncertain-Routed CoT@32では、Geminiのパフォーマンスgainが大きくGPT-4-0613よりも高い性能を示している。
ブログポスト中のGPT4のスコアは5-shotのもの(reportedと書かれているのでOpenAIが公表している数値と推察)であり、Geminiの結果はUncertain-Routed CoT@32の結果であるため、Fair Comparisonになっていないかもしれない?点には注意。
レポート中ではSelf-consistencyという単語でこの部分は書かれていないが、実は少しやっていること違ってたりする…?
ChatGPTに社内文書に基づいた回答を生成させる仕組みを構築しました, コネヒト TECH BLOG, 2023.11
Paper/Blog Link My Issue
#Article #NLP #Infrastructure #ML-LLM Ops #RAG(RetrievalAugmentedGeneration) #Blog #Reading Reflections Issue Date: 2023-11-15 Comment
低コストで社内文書に対するRAGを実現することに注力している。
以下、図はブログから引用。
基本的にはバッチジョブで社内文書をベクトル化しS3へ格納。アプリ起動時にS3から最新データを読み込み検索可能にしRAGするという流れ。
低コスト化のために、Embedding作成にOpenWeightの言語モデル(text-edbedding-ada002と同等の性能)を利用している。実装は基本的にllamaindexを利用している。
特に日本語テキストにおいてはtext-embedding-ada002は OpenAI の Embeddings API はイケてるのか、定量的に調べてみる, akeyhero (Akihiro Katsura), Qiita, 2023.04 において、JSTSタスクにおいてあまり性能が高くない(ただし、OpenAI の Embeddings API はイケてるのか、定量的に調べてみる, akeyhero (Akihiro Katsura), Qiita, 2023.04 での報告値は基本的にJSTSデータでfinetuningされてた結果と思われる)と言われているので、お金かけて無理して使う必要はないのかなという印象はある。
Retrieval-based LM (RAG System)ざっくり理解する, Shumpei Miyawaki, 2023.11
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #NLP #LanguageModel #RAG(RetrievalAugmentedGeneration) #Slide Issue Date: 2023-11-06 Comment
(以下スクショはスライドより引用)
次のスクショはRAGにかかわる周辺技術がよくまとまっていると思う。
以下ざっくり私の中の認識として
- 計画
- クエリ拡張
- クエリの質が悪い場合検索性能が劣化するため、クエリをより適切に検索ができるように修正(昔はキーワードしか与えられないときに情報を増やすから”拡張”という文言が用いられているが現在はこれに限らないと思う)する技術
- 分解・抽象化
- 複雑なクエリから分解することでマルチホップの質問をサブ質問に分解(今ならLLMを利用すれば比較的簡単にできる)したり、あるいは抽象化したクエリ(Step-back Promptnig [Paper Note] Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models, Huaixiu Steven Zheng+, N/A, ICLR'24
)を活用することで検索を改善する技術
- 検索対象選定
- 検索する対象そのものを選択し、検索対象をフィルタリングする技術
- 資料中ではLLMを用いたフィルタリングやClassifierを用いたフィルタリングが紹介されているが、メタデータで絞り込むなどの単純な方法でも実現可能だと思われる(メタデータで絞り込む、はClassifierでのフィルタリングとリンクするかもしれないが)
- 思考・行動
- [Paper Note] ReAct: Synergizing Reasoning and Acting in Language Models, Shunyu Yao+, ICLR'23, 2022.10
のような自律的にLLMに思考とその結果に基づく行動をイテレーションさせる技術や、クエリを分解して回答へたどり着くために必要な推論を構築し、各推論の回答を検証しながら生成を繰り返す技術が紹介されている
- この辺の技術はクエリが非常に複雑な場合に有効ではあるが、シンプルな場合は必要ないかなという印象がある
- シンプルなユースケースの場合はどちらかというと泥臭い前処理とかが効きそう
- 関連知識取得
- 検索
- 表層検索(TF-IDFベクトル, BM25)などの古典的な手法や、意味検索(Embeddingに基づく手法)が紹介されている
- 例えばlangchainでは表層検索 + 意味検索の両者がサポートされており、簡単にハイブリッドな検索が実現できる
- 知識文生成
- 外部知識として検索された文書を利用するだけでなく、LLM自身が保持する知識を活用するためにLLMが生成した文書の両方を活用するとQAの正答率が向上することが紹介されている
- 文書フィルタ
- 検索でクエリに関連しない文書を取得してしまう応答品質が大幅に低下することが紹介されている
- 個人的にはここが一番重要なパートだと考えている
- また、検索結果を要約する方法も紹介されている
- 再帰・反復計算
- Retrierverから取得した結果に基づいてLLMが応答を生成し、生成した応答とoriginalのquestionの両方を組み合わせて追加でRetrieverから文書を取得し生成する手法などが紹介されている
- リランキング
- 検索結果のリランキングも古くから存在する技術であり、異なる知識を持つRankerによってリランキングさせることで性能が向上する場合がある
- 回答
- 回答抽出・生成
- 回答となる部分のspanを抽出する手法と、spanではなくテキストを生成する手法が紹介されている
- この辺は文書要約におけるExtractive/Abstractive Summarization技術などもかなり応用が効くと思われる
- インデクシング
- 不要文書のフィルタリングや、チャンク分割の戦略、資格情報をテキスト化する方法などが紹介されている
NTT版大規模言語モデル「tsuzumi 2」, NTT人間情報研究所
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #MultiModal #FoundationModel #Blog Issue Date: 2023-11-01 Comment
**(追記 2026.03: 以下の記述内容は上記ページがリリースされた当初のものであり、現在は上記ページの内容は更新されているようですので、ご注意ください。 )**
NTT製のLLM。パラメータ数は7Bと軽量だが高性能。
MTBenchのようなGPT4に勝敗を判定させるベンチマークで、地理、歴史、政治、社会に関する質問応答タスク(図6)でgpt3.5turboと同等、国産LLMの中でトップの性能。GPT3.5turboには、コーディングや数学などの能力では劣るとのこと。
> *6 Rakudaベンチマーク
日本語の言語モデルの性能を評価するベンチマークの一つで、日本の地理・政治・歴史・社会に関する質問応答タスクによって評価を行う。
URL:
https://yuzuai.jp/benchmark
>*7 Japanese Vicuna QAベンチマーク
Rakudaよりもさらに幅広いカテゴリで言語モデルのQAや指示遂行の能力を問う評価方法。一般知識、ロールプレイなど多数の質問から構成される。
URL:
https://github.com/hitoshizuku7/LLM_Judge_ku/blob/main/README.md
tsuzumiはアダプタを追加することで、モデル全体のパラメータを更新することなく、さまざまな知識を持たせたり、振る舞いを変えたりできるようになるとのこと(LoRAアダプタのようなものだと思われる)。
まて、将来的に視覚や聴覚などのマルチモーダル対応も実施。
思想がLoRA Hub [Paper Note] LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition, Chengsong Huang+, arXiv'23, 2023.07 に近く、アダプタを着脱すれば柔軟に生成を変えられるのは有用だと思う。
Evaluating RAG Pipelines, LangChain Blog, 2023.10
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Library #Evaluation #RAG(RetrievalAugmentedGeneration) #Blog Issue Date: 2023-10-29 Comment
RAG pipeline (retrieval + generation)を評価するライブラリRagasについて紹介されている。
評価に活用される指標は下記で、背後にLLMを活用しているため、大半の指標はラベルデータ不要。ただし、context_recallを測定する場合はreference answerが必要。
Ragasスコアとしてどのメトリックを利用するかは選択することができ、選択したメトリックのharmonic meanでスコアが算出される。
各種メトリックの内部的な処理は下記:
- faithfullness
- questionと生成された回答に基づいて、statementのリストをLLMで生成する。statementは回答が主張している内容をLLMが解釈したものだと思われる。
- statementのリストとcontextが与えられたときに、statementがcontextにsupportされているかをLLMで評価する。
- num. of supported statements / num. of statements でスコアが算出される
- Answer Relevancy
- LLMで生成された回答から逆に質問を生成し、生成された質問と実際の質問の類似度を測ることで評価
- Context Relevancy
- どれだけcontextにノイズが含まれるかを測定する。
- LLMでcontextの各文ごとに回答に必要な文か否かを判断する
- 回答に必要な文数 / 全文数 でスコアを算出
- Context Recall
- 回答に必要な情報を全てretrieverが抽出できているか
- ground truthとなる回答からstatementをLLMで生成し、statementがcontextでどれだけカバーされているかで算出
また、LangSmithを利用して実験を管理する方法についても記述されている。
日本語LLMのリーダーボード(LLM.jp), Weights & Biases
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog #Reading Reflections Issue Date: 2023-10-27 Comment
LLM.jpによる日本語LLMのリーダーボード。4-shotsでの結果、かつinstructionを与えた場合の生成テキストに対する評価、という点には留意したい。たとえばゼロショットで活用したい、という場合にこのリーダーボードの結果がそのまま再現される保証はないと推察される。
日本語LLMベンチマークと自動プロンプトエンジニアリング, PFN Blog, 2023.10
の知見でもあった通り、promptingの仕方によってもLLM間で順位が逆転する現象なども起こりうる。あくまでリーダーボードの値は参考値として留め、どのLLMを採用するかは、自分が利用するタスクやデータで検証した方がbetterだと思われる。
あとはそもそも本当にLLMを使う必要があるのか? [Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
のような手法ではダメなのか?みたいなところも考えられると良いのかもしれない。
以下サイトより引用
> 評価手法・ツール
このダッシュボードの内容はllm-jpで公開している評価ツール、llm-jp-evalで各モデルに対して評価を行なった結果である。llm-jp-evalは、既存のリーダボードとは行われている評価とは、主に以下のところで違っている。
AlpacaやBig-Benchなどを参考にした、インストラクションチューニングよりのプロンプトを入力として与えて、その入力に対するモデルの生成結果を評価する
>評価は基本、モデルが生成した文字列だけを使って行う
>Few shotでの評価を行っており、このダッシュボードには4-shotsでの結果を載せている
>評価手法・ツールの詳細はllm-jp-evalを是非参照されたい。
>評価項目・データセット
評価項目として、まず4つのカテゴリーにおける平均スコアを算出した。さらにその4カテゴリーの平均値の平均値をとった値がAVGである。
MC (Multi-Choice QA):jcommonsenseqa
NLI (Natural Language Inference):jamp、janli、jnli、jsem、jsick
QA (Question Answering):jemhopqa、niilc
RC (Reading Comprehension):jsquad
>それぞれのカテゴリの平均を出す方法に言語学的な意味はないため、最終的な平均値はあくまで参考値ということに注意されたい。
JGlueを利用した日本語LLMのリーダーボードとして Nejumi LLMリーダーボード, Weights & Biases などもある
Loggingモジュールではじめるログ出力入門, Toshifumi Tsutsumi, PyCon JP 2021, 2021.10
Paper/Blog Link My Issue
#Article #python #Coding #Slide #SoftwareEngineering Issue Date: 2023-10-17 Comment
- ライブラリ開発の際は、ライブラリのトップレベルのLoggerにNullHandlerを設定して、詳細設定を呼び出し側に委ねるのがお作法
- NullHandlerは何もせずに上位ハンドラに伝搬させるため
- ライブラリ側でやることは、タイミングとメッセージ内容のみ
- loggerを利用するか否かは、「書き捨てか否か」
- 書き捨て例: 内容のちょっとした確認やデバッグ、局所的な出力、プログラムとログのライフタイムが短い
参考になる
propagateの仕組みや、構成要素、Loggerの恩恵はすべてのpythonモジュールがロギングに参加できること、モジュール名で基本的にはgetLoggerすることなど、勉強になった
Lessons Learnt From Consolidating ML Models in a Large Scale Recommendation System, Netflix Technology Blog, 2023.08
Paper/Blog Link My Issue
#Article #RecommenderSystems #ML-LLM Ops #Blog Issue Date: 2023-09-05 Comment
推薦システムには様々なusecaseが存在しており、それらは別々に運用されることが多い。
- user-item recommendation
- item-item recommendation
- query-item recommendation
- category-item recommendation
このような運用はシステムの技術負債を増大させ、長期的に見るとメンテナンスコストが膨大なものとなってしまう。また、多くの推薦システムには共通化できる部分がある。
これら異なるusecaseの推薦システムをmulti-taskなモデルに統合し技術負債を軽減した経験が記述されている。
これが
このようなsingle multi-task modelを学習する構造に置き換わり、
その結果
- code量とデプロイの管理・メンテナンスコストの低減
- 保守性の向上
- 単一化されたコードベースが、緊急時の対応を容易にした
- あるユースケースで新たなfeatureを試し効果があった場合、他のユースケースに迅速に展開可能(同じパイプラインなので)
- ただし、multi taskの場合は特定のタスクに効果があったfeatureの導入により他タスクの性能が低下する懸念がある
- が、タスク間の関連性が高い場合(今回のような場合)、それは問題とならなかったことが記述されている
- 柔軟な設計の実現
- 複数のユースケースを一つのモデルに統合することは、複数のユースケースを組み込むための柔軟な設計が求められる
- これを実現したことにより、拡張性が増大した
- 結論
- このような統合がコードを簡略化し、イノベーションを加速させ、システムの保守性を向上させるシナリオが多くある
- ただし、ランキングの対象が異なっていたり、入力として活用する特徴量が大きく異なるモデル間で、このような統合の実施に適しているかは自明ではない
Metaの「Llama 2」をベースとした商用利用可能な日本語LLM「ELYZA-japanese-Llama-2-7b」を公開しました, 株式会社ELYZA 公式ブログ, 2023.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Blog #OpenWeight #Japanese Issue Date: 2023-08-29 Comment
商用利用可能、70億パラメータ。
ELYZA社が独自に作成した評価セットでは日本語のOpenLLMの中で最高性能。ただし、モデル選定の段階でこの評価データの情報を利用しているため、有利に働いている可能性があるとのこと。
一般的に利用される日本語の評価用データでは、なんとも言い難い。良いタスクもあれば悪いタスクもある。が、多分評価用データ自体もあまり整備は進んでいないと想像されるため、一旦触ってみるのが良いのだと思う。
StarCoderBase_StarCoder, 2023
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #NLP #LanguageModel #FoundationModel #Blog #Coding #needs-revision Issue Date: 2023-05-06 Comment
・15.5Bパラメータ
・80種類以上のプログラミング言語で訓練
・Multi Query Attentionを利用
・context window size 8192
・Fill in the middle objectiveを利用
Instruction tuningがされておらず、prefixとsuffixの間を埋めるような訓練のされ方をしているので、たとえば関数名をinputして、そのmiddle(関数の中身)を出力させる、といった使い方になる模様。
paper: https://drive.google.com/file/d/1cN-b9GnWtHzQRoE7M7gAEyivY0kl4BYs/view
StarCoder:
https://huggingface.co/bigcode/starcoder
StarCoderBaseを35Bのpython tokenでfinetuningしたモデル。
既存モデルよりも高性能と主張
Understanding the impact of web personalization on user information processing and decision outcomes, Tam+, MIS quarterly, 2006
Paper/Blog Link My Issue
#Article #Personalization #HumanComputerInteraction Issue Date: 2023-04-28 Comment
コンテンツのrelevancy, 自己言及的なコミュニケーション(名前を呼ぶ等)が、オンラインにおけるユーザの注意や認知プロセス、および意思決定に影響を与えることを示している。特に、これらが、パーソナライズされたコンテンツを受け入れ、意思決定を支援することにつながることを示している(らしい)。
かなり有名な研究らしい。
名前を呼んだメッセージングと、relevantなコンテンツを提供することの両方で、エンドユーザはpersonalizedされたと認知し、後から思い出すのはrelevantなコンテンツの内容だけだったという実験結果が出ており、メッセージングで注意を引くことも大事だし、ちゃんとrelevantなコンテンツも提供しないといけないよね、という示唆が得られているのだと思われる。
Measuring the impact of online personalisation: Past, present and future
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #InformationRetrieval #Personalization #needs-revision Issue Date: 2023-04-28 Comment
Personalizationに関するML, RecSys, HCI, Personalized IRといったさまざまな分野の評価方法に関するSurvey
ML + RecSys系では、オフライン評価が主流であり、よりaccuracyの高い推薦が高いUXを実現するという前提に基づいて評価されてきた。一方HCIの分野ではaccuracyに特化しすぎるとUXの観点で不十分であることが指摘されており、たとえば既知のアイテムを推薦してしまったり、似たようなアイテムばかりが選択されユーザにとって有用ではなくなる、といったことが指摘されている。このため、ML, RecSys系の評価ではdiversity, novelty, serendipity, popularity, freshness等の新たなmetricが評価されるように変化してきた。また、accuracyの工場がUXの向上に必ずしもつながらないことが多くの研究で示されている。
一方、HCIやInformation Systems, Personalized IRはuser centricな実験が主流であり、personalizationは
- 情報アクセスに対するコストの最小化
- UXの改善
- コンピュータデバイスをより効率的に利用できるようにする
という3点を実現するための手段として捉えられている。HCIの分野では、personalizationの認知的な側面についても研究されてきた。
たとえば、ユーザは自己言及的なメッセージやrelevantなコンテンツが提示される場合、両方の状況においてpersonalizationされたと認知し、後から思い出せるのはrelevantなコンテンツに関することだという研究成果が出ている。このことから、自己言及的なメッセージングでユーザをstimulusすることも大事だが、relevantなコンテンツをきちんと提示することが重要であることが示されている。また、personalizationされたとユーザが認知するのは、必ずしもpersonalizationのプロセスに依存するのではなく、結局のところユーザが期待したメッセージを受け取ったか否かに帰結することも示されている。
user-centricな評価とオフライン評価の間にも不一致が見つかっている。たとえば
- オフラインで高い精度を持つアルゴリズムはニッチな推薦を隠している
- i.e. popularityが高くrelevantな推薦した方がシステムの精度としては高く出るため
- オフライン vs. オンラインの比較で、ユーザがアルゴリズムの精度に対して異なる順位付けをする
といったことが知られている。
そのほかにも、企業ではofflineテスト -> betaテスターによるexploratoryなテスト -> A/Bテストといった流れになることが多く、Cognitive Scienceの分野の評価方法等にも触れている。
[Paper Note] Adaptive Web Search Based on User Profile Constructed without Any Effort from Users, Sugiyama+, NAIST, WWW’04
Paper/Blog Link My Issue
#Article #CollaborativeFiltering #InformationRetrieval #RelevanceFeedback #Search #WebSearch #Personalization Issue Date: 2023-04-28 Comment
検索結果のpersonalizationを初めてuser profileを用いて実現した研究
user profileはlong/short term preferenceによって構成される。
- long term: さまざまなソースから取得される
- short term: 当日のセッションの中だけから収集される
① browsing historyの活用
- browsing historyのTFから求め Profile = P_{longterm} + P_{shortterm}とする
② Collaborative Filtering (CF) の活用
- user-item matrixではなく、user-term matrixを利用
- userの未知のterm-weightをCFで予測する
- => missing valueのterm weightが予測できるのでprofileが充実する
実験結果
- 検証結果(googleの検索結果よりも提案手法の方が性能が良い)
- 検索結果のprecision向上にlong/short term preferenceの両方が寄与
- longterm preferenceの貢献の方が大きいが、short termも必要(interpolation weight 0.6 vs. 0.4)
- short termにおいては、その日の全てのbrowsing historyより、現在のセッションのterm weightをより考慮すべき(interpolation weight 0.2 vs. 0.8)
Training a recommendation model with dynamic embeddings, TensorFlow Blog, 2023.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #Embeddings #EfficiencyImprovement #Library #Blog Issue Date: 2023-04-25 Comment
dynamic embeddingを使った推薦システムの構築方法の解説
(理解が間違っているかもしれないが)推薦システムは典型的にはユーザとアイテムをベクトル表現し、関連度を測ることで推薦をしている。この枠組みをめっちゃスケールさせるととんでもない数のEmbeddingを保持することになり、メモリ上にEmbeddingテーブルを保持して置けなくなる。特にこれはonline machine learning(たとえばユーザのセッションがアイテムのsequenceで表現されたとき、そのsequenceを表すEmbeddingを計算し保持しておき、アイテムとの関連度を測ることで推薦するアイテムを決める、みたいなことが必要)では顕著である(この辺の理解が浅い)。しかし、ほとんどのEmbeddingはrarely seenなので、厳密なEmbeddingを保持しておくことに実用上の意味はなく、それらを単一のベクトルでできるとメモリ節約になって嬉しい(こういった処理をしてもtopNの推薦結果は変わらないと思われるので)。
これがdynamic embeddingのモチベであり、どうやってそれをTFで実装するか解説している。
LoRA論文解説, Hayato Tsukagoshi, 2023.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #Slide #PostTraining #Selected Papers/Blogs Issue Date: 2023-04-25 Comment
ベースとなる事前学習モデルの一部の線形層の隣に、低ランク行列A,Bを導入し、A,Bのパラメータのみをfinetuningの対象とすることで、チューニングするパラメータ数を激減させた上で同等の予測性能を達成し、推論速度も変わらないようにするfinetuning手法の解説
LoRAを使うと、でかすぎるモデルだと、そもそもGPUに載らない問題や、ファインチューニング後のモデルファイルでかすぎワロタ問題が回避できる。
前者は事前学習済みモデルのBPのための勾配を保存しておく必要がなくなるため学習時にメモリ節約になる。後者はA,Bのパラメータだけ保存すればいいので、ストレージの節約になる。
かつ、学習速度が25%程度早くなる。
既存研究であるAdapter(transformerの中に学習可能なMLPを差し込む手法)は推論コストが増加し、prefix tuningは学習が非常に難しく、高い性能を達成するためにprefixとして128 token入れたりしなければならない。
huggingfaceがすでにLoRAを実装している
https://github.com/huggingface/peft
Score Prediction dataset
Paper/Blog Link My Issue
#Article #Dataset #Education #AdaptiveLearning #EducationalDataMining #ScorePrediction #Reference Collection Issue Date: 2022-08-23
neptune.ai
Paper/Blog Link My Issue
#Article #MachineLearning #Tools #ExperimentManagement Issue Date: 2022-03-09 Comment
・実験結果の可視化や管理に利用できるサービス
・API経由で様々な実験に関わるメタデータやmetricを送信することで、サイト上でdashboardを作成し、複数の実験の結果を可視化したりwidget上で比較したりできる
・実験時に使用したargumentsを記録したり、global_stepごとにlossをAPI経由で逐次的に送信することで実験結果を記録できたりする
・widgetやmodelなどは、クエリによってフィルタリングできたりするので、特定のstructureを持っているモデル間のみで結果を比較したり等も簡単にできる
・利用する際は、APIキーをサイト上で発行し、コード上でAPIキーを設定して、neptuneのモジュールをnewしてlogメソッドを呼び出して逐次的にデータを送信していくだけで、neptune上で送信んされたデータが管理される。
※ 一部解釈が間違っている場所がある可能性がある
HuggingFace, pytorch-lightningなどのフレームワークでもサポートされている模様
HuggingFace:
https://huggingface.co/transformers/v4.9.1/_modules/transformers/integrations.html
pytorch-lightning:
https://pytorch-lightning.readthedocs.io/en/stable/api/pytorch_lightning.loggers.neptune.html
HuggingFaceではNeptuneCallbackというコールバックを使えばneptuneを仕込めそう
Addressing Two Problems in Deep Knowledge Tracing via Prediction-Consistent Regularization, Yeung+, 2018, L@S
Paper/Blog Link My Issue
#Article #NeuralNetwork #AdaptiveLearning #EducationalDataMining #StudentPerformancePrediction #KnowledgeTracing #L@S Issue Date: 2021-10-29 Comment
Deep Knowledge Tracing (DKT)では、下記の問題がある:
- 該当スキルに正解/不正解 したのにmasteryが 下がる/上がる (Inputをreconstructしない)
- いきなり習熟度が伸びたり、下がったりする(時間軸に対してmastery levelがconsistentではない)
上記問題に対処するようなモデルDKT+を提案。
DKT+では、DKTのloss functionに対して3つのregularization termを追加することで上記問題に対処している。
DKT+はDKTの性能を落とすことなく、上記2問題を緩和できたとのこと。
実装: https://github.com/ckyeungac/deep-knowledge-tracing-plus

DKT+とDKTのheatmapを比較すると、問題点は確かに緩和されているかもしれないが、
依然としてinputはreconstructionされていないし、習熟度も乱高下しているように見える。
根本的な解決にはなっていないのでは。
実臨床・Webサービス領域での機械学習研究 開発の標準化, 浮田+, PRMU研究会, 2021.10
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #Slide Issue Date: 2021-10-16 Comment
並列して走る機械学習案件をどのように効果的に捌いているか説明。
①タイトな締切
→ 高速化で対処
→ よく使う機能をML自身に実装する
②並行して走る案件
→ 並列化
→ Kubernetesを用いて、タスクごとに異なるノードで分散処理(e.g CVのFoldごとにノード分散、推論ユーザごとにノード分散)要件に合わせて、メモリ優先、CPU優先などのノードをノードプールから使い分ける
③属人化
→ 標準化
→ よく使う機能はMLシステム自身に実装
→ 設定ファイルで学習、推論の挙動を制御
GPT-3から我々は何を学べば良いのか, 山本和英, Japio year book 2020
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #LanguageModel Issue Date: 2021-09-09 Comment
GPT-3の概要:
GPT-3はWebサイトから数年に渡って収集したCommon Crawlというデータセットから、570GBを抜粋し学習に利用。(英語ウィキペディアの約130倍)
ある単語列に後続する単語を予測するという方法(自己回帰型言語モデル)で教師なし学習を繰り返し、言語モデルを学習。
GPT-3の特徴:
・モデルが巨大(1750億パラメータ, GPT-2は15億)
- 扱うトークン数が2048トークン(GPT-2の倍)
- Word Embeddingの次元数12288(GPT2の倍
- デコード層が98層(GPT2の倍
・基本的なモデル構造はTransformerと一緒
GPT-3の問題点:
・コーパス中の言語出力を模倣しているだけで、何ら理解をしておらず、常識も持ち合わせていない
- e.g. 私の足に目はいくつある?と入力すると、2つと出力する等
- 整理された知識を獲得しているわけではない
・偏見や差別、誤った知識も学習する
・時間的、経済的負荷の大きさ
- GPT-3を最大規模で計算するには5億円かかる
- 1台のGPUで355年必要な計算量
→ 個人や小規模業者が実行できる範囲を超えており、大企業でもコストに見合った出力が得られるとは考えにくい
GPT-3の産業応用
・GPT-3は言語モデルであり、言語生成器ではない
- 人間が書いて欲しいことをおおまかに伝えたらそれを書いてくれるわけではない(代筆)
→ GPT-3が小論文や業務レポートを書けると考えるのは早計
- 入力として英文や英単語を入力するが、生成する文章の分野や話題を提示しただけであり、生成する文章にそれ以上の制御は行っていない
・生成内容を強く制御できないことは創作活動にとっては有用
- 俳句、短歌、詩の生成
- キャッチコピーの自動生成
- ダミー文章生成(ブログやツイート)
- 文章添削、校正に使える可能性(要研究;文章を正しく、綺麗に書く能力は高い)
GPT-3でどこまでできそうなのか?というざっくりとした肌感が掴めたから良かった
[Paper Note] Probing Word Translations in the Transformer and Trading Decoder for Encoder Layers, NAACL‘21
Paper/Blog Link My Issue
#Article #NeuralNetwork #MachineTranslation #NLP #NAACL #Reading Reflections Issue Date: 2021-06-03 Comment
Transformerに基づいたNMTにおいて、Encoderが入力を解釈し、Decoderが翻訳をしている、という通説を否定し、エンコーディング段階、さらにはinput embeddingの段階でそもそも翻訳が始まっていることを指摘。
エンコーディングの段階ですでに翻訳が始まっているのであれば、エンコーダの層を増やして、デコーダの層を減らせば、デコーディング速度を上げられる。
通常はエンコーダ、デコーダともに6層だが、10-2層にしたらBLEUスコアは変わらずデコーディングスピードは2.3倍になった。
18-4層の構成にしたら、BLEUスコアも1.42ポイント増加しデコーディング速度は1.4倍になった。
この研究は個人的に非常に興味深く、既存の常識を疑い、分析によりそれを明らかにし、シンプルな改善で性能向上およびデコーディング速度も向上しており、とても好き。
ResNetからSkip Connectionを取り除く研究についてのサーベイ, 徳永拓之, LeapMind株式会社
Paper/Blog Link My Issue
#Article #Tutorial #Blog Issue Date: 2021-06-03 Comment
Skip Connectionは
- 推論時のメモリ消費量が増える
- 推論時に計算量の割に実際の計算が重たくなりがち(特にDNN専用アクセラレーターにおいてその傾向がありがち)
というデメリットがあり、SkipConnection無しで性能を出したいことから、様々な研究が行われている模様。
ResNetを学習し、それを教師としてPlainCNNを学習するResidual Distillationが決定版らしい(普通のDistillationでは最終層の類似度のみを用いるが、生徒ネットワークの中間層の出力を教師ネットワークに入れてからbackpropして勾配を得る)。
50層のPlainCNNで、ResNet50とほぼ同等のtop-1 accuracyを達成。
メモリ消費量は20%弱削減され、実行速度は20〜30%程度高速になる。
[Paper Note] Incorporating Copying Mechanism in Sequence-to-Sequence Learning, Gu+, ACL’16
Paper/Blog Link My Issue
#Article #DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #NLP #ACL Issue Date: 2021-06-03 Comment
[Paper Note] Pointing the Unknown Words, Gulcehre+, ACL’16
と同様コピーメカニズムを提案した論文。Joint Copy ModelやCOPYNETと呼ばれる。
次の単語が "生成" されるのか "コピー" されるのかをスコアリングし、各単語がコピーされる確率と生成される確率をMixtureした同時確率分布で表現する( [Paper Note] Challenges in Data-to-Document Generation, Sam Wiseman+, EMNLP'17, 2017.07
等でも説明されている)。
コピーメカニズムを導入せるなら引用すべき。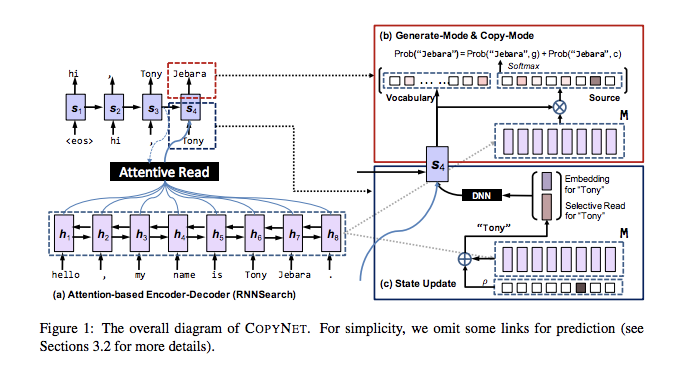
## コピーメカニズム部分の説明(過去の管理人の論文紹介スライドより)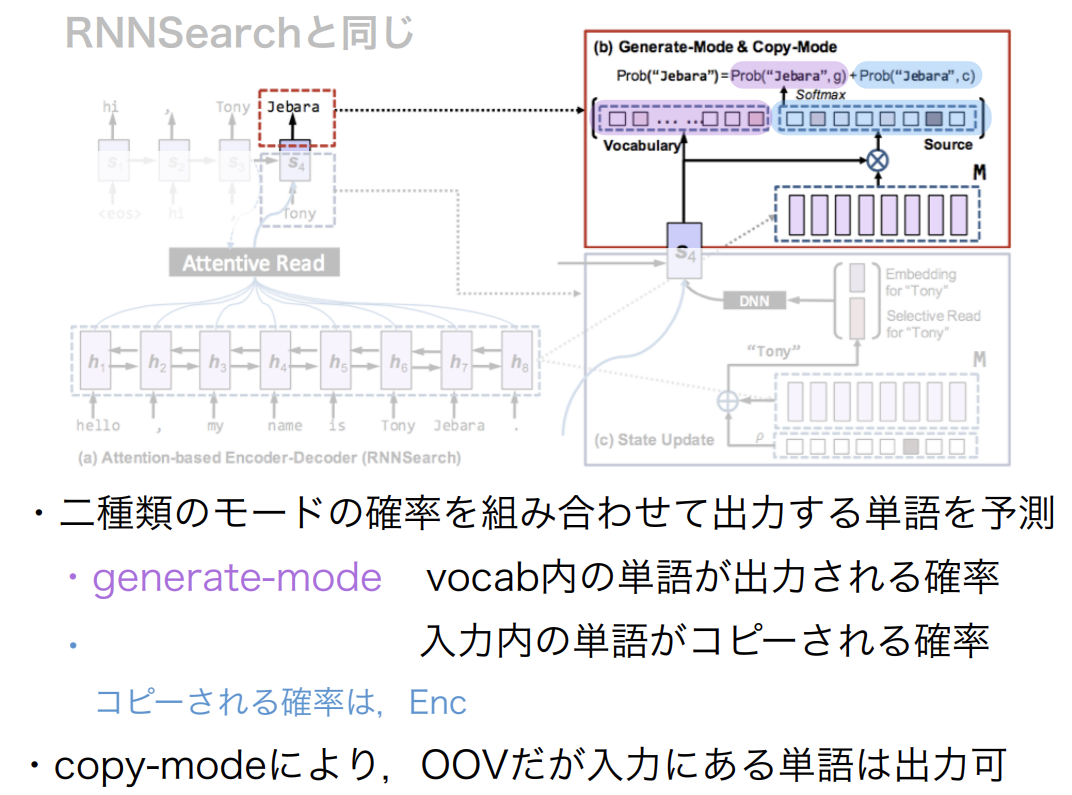
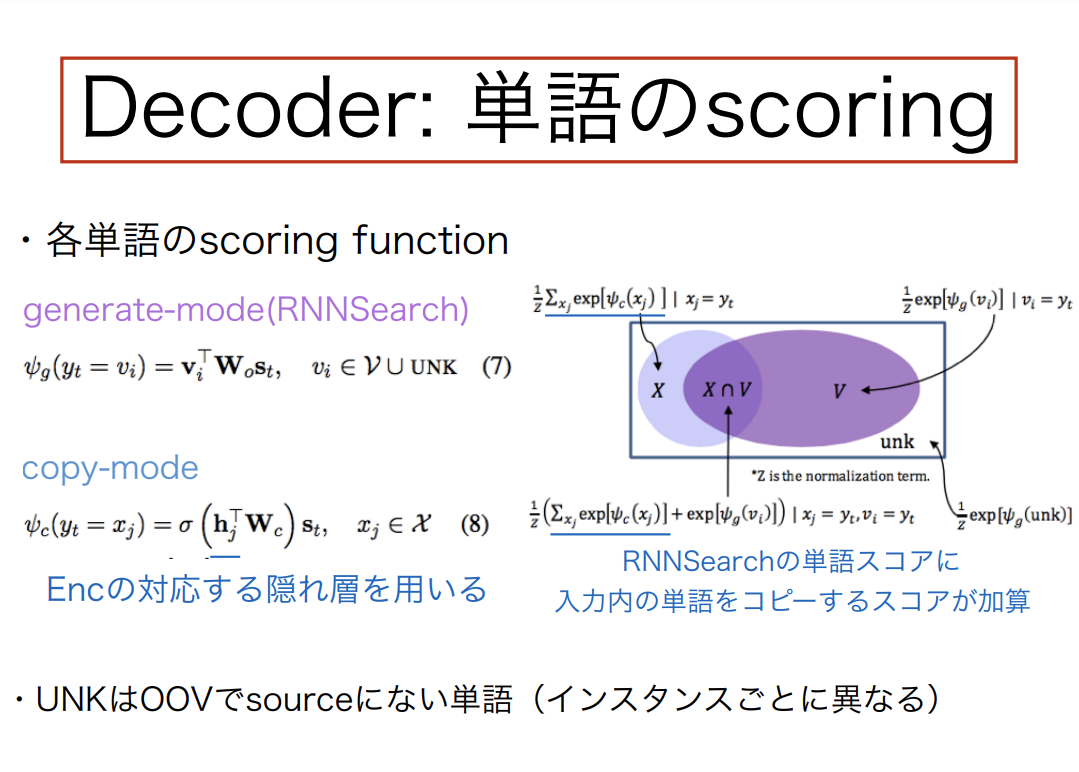
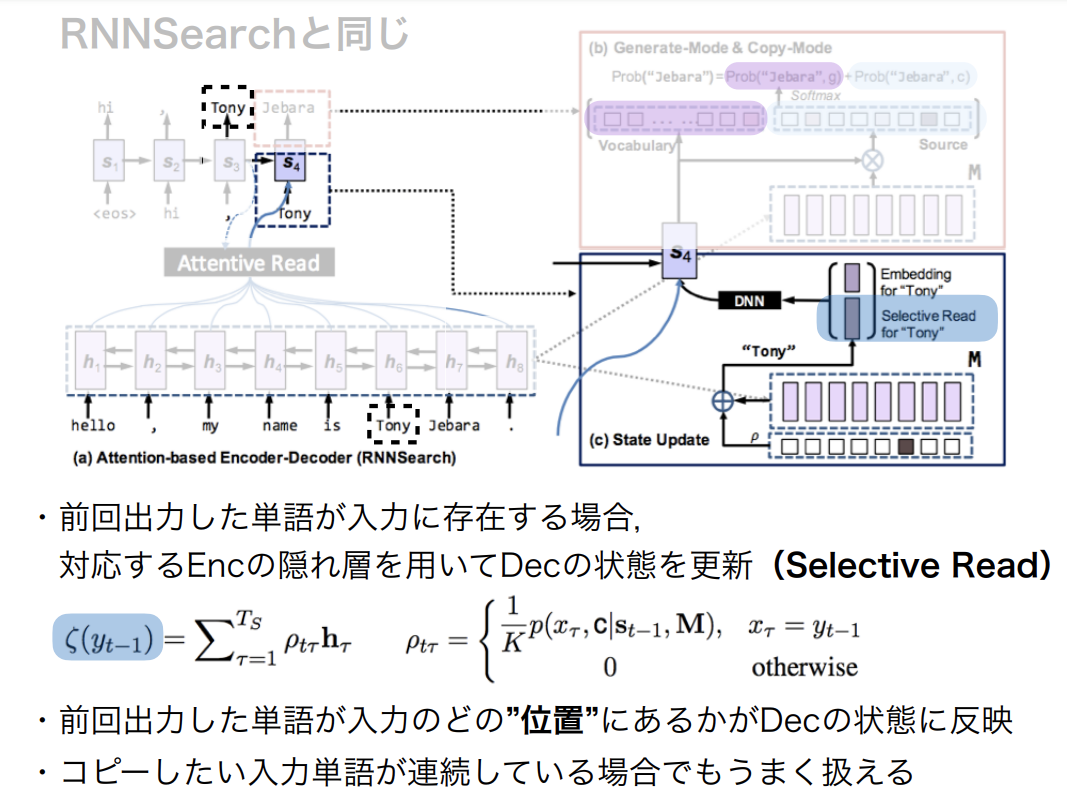
解説資料: http://www.lr.pi.titech.ac.jp/~sasano/acl2016suzukake/slides/08.pdf
Deep Knowledge Tracingの拡張による擬似知識タグの生成, 中川+, 人口知能学会論文誌, 33巻, 33号, C, 2018
Paper/Blog Link My Issue
#Article #NeuralNetwork #EducationalDataMining #LearningAnalytics #KnowledgeTracing Issue Date: 2021-06-02 Comment
DKTモデルは、前提として各問題に対して知識タグ(knowledge component)が付与されていることが前提となっている。しかし世の中には、知識タグが振られているデータばかりではないし、そもそもプログラミング教育といった伝統的な教育ではない分野については、そもそも知識タグを構造的に付与すること自体が成熟していない分野も存在する。
そのような知識タグが存在しない、付与しづらい分野に対してもDKTが適用できるように、知識タグそのものを自動的に学習した上で、Knowledge Tracingするモデルを提案しました、という話。
Deep Knowledge Tracingの入力ベクトルの日本語例が書いてあり、わかりやすい。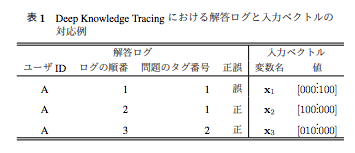
提案モデルの構造は下記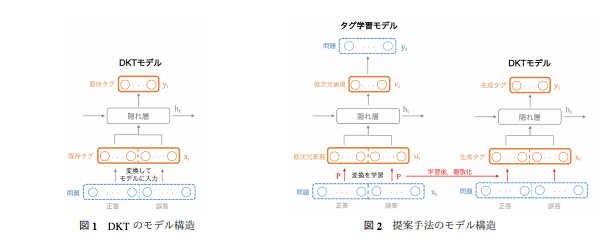
ASSISTments, KDD Cup Dataでの既存タグを利用した場合と、擬似生成タグを利用した場合の評価結果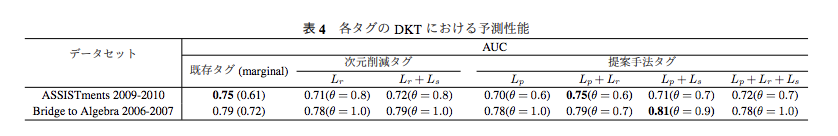
既存タグを利用した場合とcomparable, もしくはoutperformしている。
既存タグと擬似生成タグタグの依存関係を可視化したネットワーク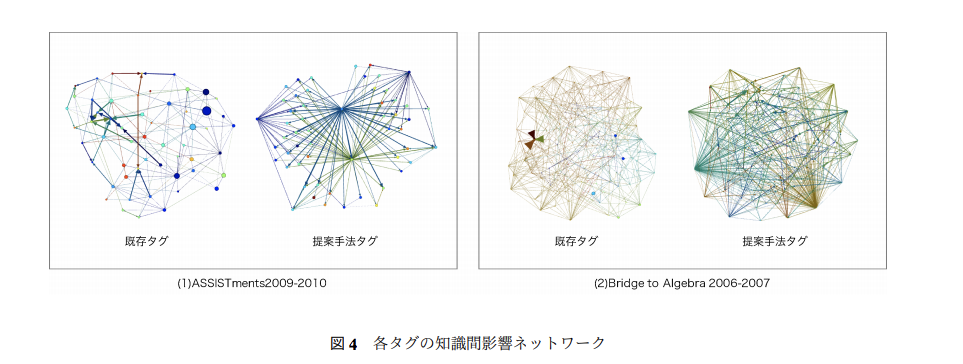
既存タグと擬似生成タグの内容的関係性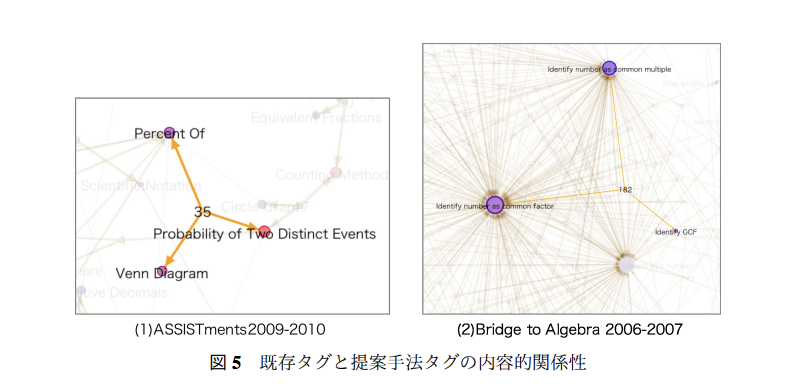
既存タグは人間が理解しやすい形で構成されているが、擬似生成タグは予測に最適化されているためそのような生成のされ方はされない。つまり、解釈性に問題がある。
Knowledge Tracingモデルは教育の観点から、生徒がどのconceptにどれだけ習熟しているか、といったことを教員側が把握し適切なinterventionを行なったり、あるいは生徒側が内省を行い自信をmotivatingしたりする側面があるため、どのようにして解釈性の高いタグを自動生成するか、はunsolved question。
Criteo Dataset, Display Advertising Challenge, Kaggle, 2014
Paper/Blog Link My Issue
#Article #RecommenderSystems #Dataset #CTRPrediction Issue Date: 2021-06-01 Comment
Criteo Dataset (
https://www.kaggle.com/c/criteo-display-ad-challenge/data)
DeepFM等のモデルで利用されているCTR Predictionのためのデータセット
# Data Description
- train.csv: 7日間のcriteoのtraffic recordの一部。個々の行が1 impに対応している。click, non-clickのラベル付き。chronologically order. click, non-clickのexampleはデータセットのサイズを縮小するために異なるrateでサブサンプルされている。
- training: trainingデータと同様の作成データだが、trainingデータの翌日のデータで構成されている。
# Data Fields
> - Label - Target variable that indicates if an ad was clicked (1) or not (0).
> - I1-I13 - A total of 13 columns of integer features (mostly count features).
> - C1-C26 - A total of 26 columns of categorical features. The values of these features have been hashed onto 32 bits for anonymization purposes.
13種類のinteger featureと、26種類のcategorical featuresがある。
Avazu Data (
https://www.kaggle.com/c/avazu-ctr-prediction/data)
# File descriptions
> - train - Training set. 10 days of click-through data, ordered chronologically. Non-clicks and clicks are subsampled according to different strategies.
> - test - Test set. 1 day of ads to for testing your model predictions.
sampleSubmission.csv - Sample submission file in the correct format, corresponds to the All-0.5 Benchmark.
# Data fields
> - id: ad identifier
> - click: 0/1 for non-click/click
> - hour: format is YYMMDDHH, so 14091123 means 23:00 on Sept. 11, 2014 UTC.
> - C1 -- anonymized categorical variable
> - banner_pos
> - site_id
> - site_domain
> - site_category
> - app_id
> - app_domain
> - app_category
> - device_id
> - device_ip
> - device_model
> - device_type
> - device_conn_type
> - C14-C21 -- anonymized categorical variables
基本的には click/non-click のラベルと、そのclick時の付帯情報によって構成されている模様
[Paper Note] The Knowledge-Learning-Instruction Framework: Bridging the Science-Practice Chasm to Enhance Robust Student Learning, Pelanek, User Modeling and User-Adapted Interaction, 2017
Paper/Blog Link My Issue
#Article #Tutorial #EducationalDataMining #LearningAnalytics #StudentPerformancePrediction #KnowledgeTracing Issue Date: 2021-05-30 Comment
Learner Modelingに関するチュートリアル。Learner Modelingの典型的なコンテキストや、KCにどのような種類があるか(KLI Frameworkに基づいた場合)、learner modeling techniques (BKTやPFA等)のチュートリアルなどが記載されている(Figure 1,2,3,4, Table 1,2)。
knowledgeをmodelingする際に利用されるデータの典型的な構造
donain modelingの典型的なアプローチ
モデルのaspectと、model purposes, learning processesのrelevanceを図示したもの。色が濃いほうが重要度が高い
Learner ModelingのMetrics
cross validation方法の適用方法(同じ学習者内と、異なる学習者間での違い。学習者内での予測性能を見たいのか、学習者間での汎化性能を見たいのかで変わるはず)
BKT、PFAや、それらを用いるContext(どのモデルをどのように自分のcontextに合わせて選択するか)、KLI Frameworkに基づくKCの構成のされ方、モデル評価方法等を理解したい場合、読んだほうが良さそう?
ざっとしか見ていないけど、重要な情報がめちゃめちゃ書いてありそう。後でしっかり読む・・・。
Behavior-Based Grade Prediction for MOOCs Via Time Series Neural Networks, Chiang+, IEEE JOURNAL OF SELECTED TOPICS IN SIGNAL PROCESSING, VOL. 11, NO. 5, AUGUST 2017
Paper/Blog Link My Issue
#Article #NeuralNetwork #EducationalDataMining #LearningAnalytics #StudentPerformancePrediction Issue Date: 2021-05-29 Comment
MOOCsでの生徒のgradeを予測するモデルを提案。MOOCsでは生徒のassessmentに対するreponseがsparseで、かつpersonalizedなモデルが必要なため成績予測はチャレンジングなタスク。
lecture-video-watching clickstreams を利用し、time-series neural network (tステップのデータをMLPに入力するもの?あまりしっかり読んでいない)を使って、prioer performanceとclickstreamでtrainingすることでこれらを克服する。
2種類のMOOCsデータセットで評価したところ、past performanceの平均を利用するbaselineに対しては60%程度、lasso regression baselineよりも15%程度outperformした。
全体像

一般的なMOOCsでのvideo-lestureのsequence図解
生徒のj回のquizに回答したあとのaverage Correct First Attempt (CFA)を生徒の成績と定義し、RMSEで評価をしている模様?

上図のように、クイズに回答する毎のaverage CFAの変遷(=y)と、クイズjが含まれる生徒のvideo tにおけるclickstream input features(=x)を利用し、次のクイズに回答した時のaverage CFAを予測している?
NFMB/NI [Paper Notes] Back to the basics: Bayesian extensions of IRT outperform neural networks for proficiency estimation, Ekanadham+, EDM'16 データセットを利用している
MLP-like Architecture
Paper/Blog Link My Issue
#Article #NeuralNetwork #Survey #ComputerVision #NLP #Reference Collection Issue Date: 2021-05-19 Comment
gMLP:大規模なself-attentionが無いSpatial Gating Unitを搭載したシンプルなMLPでも、Transformerの性能に近づけたよ(特にCV)。つまり、self-attentionはessentialというわけではなさそうだよ。
NLPの場合はgMLPだとTransformerとperplexityでcomparable、一部downstreamタスクだと勝てなかったけど、single headのtiny attentionを追加したら、TransformerをperplexityとGLUEの一部タスクでoutperformしたよ。
つまり、Transformerみたいに大規模なself-attentionは必須ではなく、小規模のattentionで(cross sentenceの関係性を捉えるには)十分だよ。
スケーラビリティもTransformerを上回ったよ。
って感じ?
んーTransformerに勝ったみたいな言い方をSNSだと見かけるけど、評価してるタスクが少ないし、どちらかというとcomparableなdownstreamタスクが多いし、それは言い過ぎでは?
この論文が言いたいのは、大規模なself-attentionが性能を出す上でessentialなわけではないよ、ってことであり、
・CVの場合はself-attentionは必須ではない
・NLPでは、tiny attentionでも十分
という感じなのでは。
まあでもTransformerとcomparableなら、Transformer一強では無くなったよね
Spatial Gating Unit(SGU)は、トークン間の関係性を捉えるためのゲートで、SGUが無いとgMLPブロックはただの二層のFFNとなる。
SGUは、入力をspatial dimensionに対して線形変換した値と、元の入力のelement-wiseな積で表現する。この線形変換をする際は、Wの値を0の近傍で初期化し、バイアス項を1に初期化することがクリティカルだった。これは、学習の初めでは線形変換はidentical mappingに近いものとなるため、gMLPブロックはFFNに近いものとなる。これが学習が進むにつれWの重みが調整され、cross tokenの関係性を捉えたブロックへと徐々に変化していくことになる。
また、SGUへの入力はGLUのようにchannel dimensionに二分割し、片方をelement-wise積に、もう一方をspatialな線形変換に利用する(4種類試した中で一番性能が良かった)。
事前学習言語モデルの動向 _ Survey of Pretrained Language Models, Kyosuke Nishida, 2019
Paper/Blog Link My Issue
#Article #NeuralNetwork #Survey #NLP #LanguageModel #Slide #Selected Papers/Blogs Issue Date: 2019-11-09 Comment
[2019/06まで]
・ELMo(双方向2層LSTM言語モデル)
・GPT(left-to-rightの12層Transformer自己回帰言語モデル)
・BERT(24層のTransformer双方向言語モデル)
・MT-DNN(BERTの上にマルチタスク層を追加した研究)
・XLM(パラレル翻訳コーパスを用いてクロスリンガルに穴埋めを学習)
・TransformerXL(系列長いに制限のあった既存モデルにセグメントレベルの再帰を導入し長い系列を扱えるように)
・GPT-2(48層Transformerの自己回帰言語モデル)
・ERNIE 1.0(Baidu, エンティティとフレーズの外部知識を使ってマスクに利用)
・ERNIE(Tsinghua, 知識グラフの情報をfusionしたLM)
・Glover(ドメイン、日付、著者などを条件とした生成を可能としたGPT)
・MASS(Encoder-Decoder型の生成モデルのための事前学習)
・UniLM(Sequence-to-Sequenceを可能にした言語モデル)
・XLNet(自己回帰(単方向)モデルと双方向モデルの両方の利点を得ることを目指す)
[2019/07~]
・SpanBERT(i.i.dではなく範囲でマスクし、同時に範囲の境界も予測する)
・ERNIE 2.0(Baidu, マルチタスク事前学習; 単語レベル・構造レベル・意味レベル)
・RoBERTa(BERTと同じ構造で工夫を加えることで性能向上)
- より大きなバッチサイズを使う(256から8192)
- より多くのデータを使う(16GBから160GB)
- より長いステップ数の学習をする(BERT換算で16倍)
- 次文予測(NSP)は不要
→ GLUEでBERT, XLNetをoutperform
・StructBERT (ALICE, NSPに代わる学習の目的関数を工夫)
- マスクした上で単語の順番をシャッフルし元に戻す
- ランダム・正順・逆順の3種類を分類
→ BERTと同サイズ、同データでBERT, RoBERTa超え
・DistilBERT(蒸留により、12層BERTを6層に小型化(40%減))
- BERTの出力を教師として、生徒が同じ出力を出すように学習
- 幅(隠れ層)サイズを減らすと、層数を経あrスよりも悪化
→ 推論は60%高速化、精度は95%程度を保持
・Q8BERT(精度を落とさずにfine-tuning時にBERTを8bit整数に量子化)
- Embedding, FCは8bit化、softmax, LNorm, GELUは32bitをキープ
→ モデルサイズ1/4, 速度3.7倍
・CTRL(条件付き言語モデル)
- 条件となる制御テキストを本文の前に与えて学習
- 48層/1280次元Transformer(パラメータ数1.6B)
・MegatronLM(72層、隠れ状態サイズ3072、長さ1024; BERTの24倍サイズ)
・ALBERT(BERTの層のパラメータをすべて共有することで学習を高速化; 2020年あたりのデファクト)
- Largeを超えたモデルは学習が難しいため、表現は落ちるが学習しやすくした
- 単語埋め込みを低次元にすることでパラメータ数削減
- 次文予測を、文の順序入れ替え判定に変更
→ GLUE, RACE, SQuADでSoTAを更新
・T5(NLPタスクをすべてtext-to-textとして扱い、Enc-Dec Transformerを745GBコーパスで事前学習して転移する)
- モデルはEncoder-DecoderのTransformer
- 学習タスクをエンコーダ・デコーダに合わせて変更
- エンコーダ側で範囲を欠落させて、デコーダ側で予測
→ GLUE, SuperGLUE, SQuAD1.1, CNN/DMでSoTA更新
・BART(Seq2Seqの事前学習として、トークンマスク・削除、範囲マスク、文の入れ替え、文書の回転の複数タスクで学習)
→ CNN/DMでT5超え、WMT'16 RO-ENで逆翻訳を超えてSoTA
ELMo, GPT, BERT, GPT-2, XLNet, RoBERTa, DistilBERT, ALBERT, T5あたりは良く見るような感
各データセットでの各モデルの性能も後半に記載されており興味深い。
ちなみに、CNN/DailyMail Datasetでは、T5, BARTあたりがSoTA。
R2で比較すると
- Pointer-Generator + Coverage Vectorが17,28
- LEAD-3が17.62
- BARTが21.28
- T5が21.55
となっている
[Paper Note] Designing and implementing a personalized remedial learning system for enhancing the programming learning, Hsieh+, Educational Technology & Society, 2013
Paper/Blog Link My Issue
#Article #AdaptiveLearning #LearningPath Issue Date: 2018-12-22 Comment
e-learningシステムには、三つの課題がまだある:
learner control: learnerは、自分でe-learningシステムのmaterialをダウンロードしたりして勉強するが、時に事前知識が相当必要な教材とかで勉強してしまうと、learning performanceが落ちる。事前知識がどれだけあるかを測るのがとても大事だとAusubel 1968も述べている。
disorientation: たとえばwebで勉強するために検索すると、検索エンジンは適切な学習の順番で結果を返してくれたりはしない。どれを最初に読むか、ユーザは選ばなければいけないが、初めて勉強する分野だときつい。sequencedなlearning contentsはlearnerにとって多大な恩恵になる。
Cognitive Overload: メジャーなエンジンは検索エンジン。materialはすぐに手に入るけど、学習者は自分で教材を読んだり、organizeして学習しなければいけない。そのため、ブラウジングと、materialのソートに多大な時間を要してしまう。多すぎる情報は、学習者に不安をもたらす。学習者にダイレクトに最適な教材を提示することが重要。
fuzzy logic theoryを用いて、学習者の思い違いに基づいて最適な学習パスを構築し、学習者の好みに合わせて、webからコンテンツを推薦する。
fuzzy logic theoryは、まず、あるコンセプトのペアが与えられたときに、、以下の3つの尺度を算出する:
1. Extension, 2つのコンセプトがあるコンセプトを学習する前提になっているか否か(googleで検索した結果システムが返した件数から求める)
2. Similarity, 2つのコンセプトの類似度(similarityの尺度については詳しく述べられていない。論文をreferしているが、読めない)。過去にユーザが読んだものと類似度が高いものを出すと、簡単にユーザが理解できる、みたいな考えがある。
3. Coherent, 2つのコンセプトがどれだけcoherentか。
これらを算出した後に、fuzzy logitを用いて、各尺度を離散化(それぞれのlinguistic term, low, midiam, highに属する確率を算出)。離散化した後、専門家が決めたルールに基づいて(各尺度のlinguistic termの組み合わせにおいて、コンセプト間の強さがlow, medium, highどれに属するかの確率を算出するためのルール)、2コンセプト間の関連の強さ(あるコンセプトを学習した後に、次にどのコンセプトを学習するべきか)を決定。
この数値が高いものをgreedyに追加していくことで、learning pathを構築。
専門家が決めたルールは、各尺度をfuzzy logicで離散化した状態が与えられたときに、conceptの関連度合いがlow, medium, highのどれをとるかを決めたものなので、同じドメインであれば、色々適用できる?(もしこの辺が教科によって変わってくるのであれば、いちいち設計し直さなければならない)
Fuzzy推論参考:
http://www.sist.ac.jp/~kanakubo/research/reasoning_kr/fuzzy.html
[Paper Note] Simulated Analysis of MAUT Collaborative Filtering for Learning Object Recommendation, Manouselis+, Social Information Retrieval for Technology-Enhanced Learning & Exchange, 2007
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #AdaptiveLearning Issue Date: 2018-12-22 Comment
教員に対して教材を推薦しようという試み(学生ではないようだ)。
教員は、learning resourcesに対して、multi-criteriaなratingを付与することができ、それをCFで活用する(CELEBRATE web portalというヨーロッパのポータルを使用したらしい)。
CFはmemory-basedな手法を使用。target userがあるアイテムを、それぞれのattributeの観点からどのようにratingするかをattributeごとに別々に予測。各attributeのスコアを最終的に統合(元の論文ではただのスコアの足し合わせ)して、推薦スコアとする。
以下が調査された:
1. ユーザ間の距離の測り方(ユークリッド距離、cossim、ピアソンの相関係数)
2. neighborsの選び方(定義しておいた最大人数か、相関の重みで選ぶか)
3. neighborのratingをどのように組み合わせるか(平均、重み付き平均、mean formulaからのdeviation)
評価する際は、ratingのデータを training/test 80%/20%に分割。テストセットのアイテムに対して、ユーザがratingした情報をどれだけ正しく予測できるかで検証(511 evaluation in test, 2043 evaluations in training)。
ratingのMAE, coverage, アルゴリズムの実行時間で評価。
CorrerationWeightThresholdが各種アルゴリズムで安定した性能。Maximum Number Userはばらつきがでかい。いい感じの設定がみつかれば、Maximum Number Userの方がMAEの観点からは強い。
top-10のアイテムをselectするようにしたら、60%のcoverageになった。
(アルゴリズムの実行時間は、2000程度のevaluationデータに対して、2.5GHZ CPU, 256MEMで20秒とかかかってる。)
Learning Resource Exchangeの文脈で使われることを想定(このシステムではヨーロッパのK-12)。
教員による教材のmulti-criteriaのratingは5-scaleで行われた。
どういうcriteriaに対してratingされたかが書かれていない。
[Paper Note] Context-Aware Recommender Systems, Adomavicius+, Recommender Systems Handbook, 2011.09
Paper/Blog Link My Issue
#Article #RecommenderSystems #Classic #ContextAware #Selected Papers/Blogs Issue Date: 2018-12-22 Comment
Context-aware Recsysのパイオニア的研究
通常のuser/item paradigmを拡張して、いかにコンテキストの情報を考慮するかを研究。
コンテキスト情報は、
Explicit: ユーザのマニュアルインプットから取得
Implicit: 自動的に取得
inferred: ユーザとツールやリソースのインタラクションから推測(たとえば現在のユーザのタスクとか)
いくつかの異なるパラダイムが提案された:
1. recommendation via context-driven querying and search approach
コンテキストの情報を、特定のリポジトリのリソース(レストラン)に対して、クエリや検索に用いる。そして、best matchingなリソースを(たとえば、現在開いているもっとも近いレストランとか)をユーザに推薦。
2. Contextual preference elicitation and estimation approach
こっちは2012年くらいの主流。contextual user preferencesをモデル化し学習する。データレコードをしばしば、
3. contextual prefiltering approach
contextualな情報を(学習したcontextualなpreferenceなどを)、tradittionalなrecommendation algorithmを適用する前にデータのフィルタリングに用いる。
4. contextual postfiltering approach
entire setから推薦を作り、あとでcontextの情報を使ってsetを整える。
5. Contextual modeling
contextualな情報を、そのままrecommendationの関数にぶちこんでしまい、アイテムのratingのexplicitなpredictorとして使う。
3, 4はtraditionalな推薦アルゴリズムが適用できる。
1,2,5はmulti-dimensionalな推薦アルゴリズムになる。heuristic-based, model-based approachesが述べられているらしい。
[Paper Note] Collaborative filtering for implicit feedback datasets, Hu+, International Conference on Data Mining, 2008.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #MatrixFactorization #Selected Papers/Blogs Issue Date: 2018-01-11 Comment
Implicit Feedbackなデータに特化したMatrix Factorization (MF)、Weighted Matrix Factorization (WMF)を提案。
ユーザのExplicitなFeedback(ratingやlike, dislikeなど)がなくても、MFが適用可能。
目的関数は式(3)のようになっている。
通常のMFでは、ダイレクトにrating r_{ui}を予測したりするが、WMFでは r_{ui}をratingではなく、たとえばユーザuがアイテムiを消費した回数などに置き換え、binarizeした数値p_{ui}を目的関数に用いる。
このとき、itemを消費した回数が多いほど、そのユーザはそのitemを好んでいると仮定し、そのような事例については重みが高くなるようにconfidence c_{ui}を計算し、目的関数に導入している。
日本語での解説: https://cympfh.cc/paper/WRMF
Implicit Implicit でのAlternating Least Square (ALS)という手法が、この手法の実装に該当する。
[Paper Note] LexRank: Graph-based Lexical Centrality as Salience in Text Summarization, Erkan+, Journal of Artificial Intelligence Research, 2004.12
Paper/Blog Link My Issue
#Article #Multi #Single #DocumentSummarization #Document #Unsupervised #GraphBased #NLP #Extractive #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
代表的なグラフベースな(Multi) Document Summarization手法。
ほぼ
- [Paper Note] TextRank: Bringing Order into Texts, Mihalcea+, EMNLP'04
と同じ手法。
2種類の手法が提案されている:
* [LexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを計算し閾値以上となったsentenceの間にのみedgeを張る(重みは確率的に正規化)。その後べき乗法でPageRank。
* [ContinousLexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを用いてAffinity Graphを計算し、PageRankを適用(べき乗法)。
DUC2003, 2004(MDS)で評価。
Centroidベースドな手法をROUGE-1の観点でoutperform。
document clusterの17%をNoisyなデータにした場合も実験しており、Noisyなデータを追加した場合も性能劣化が少ないことも示している。
[Paper Note] What to talk about and how? Selective Generation using LSTMs with Coarse-to-Fine Alignment, Hongyuan Mei+, NAACL-HLT’16, 2015.09
Paper/Blog Link My Issue
#Article #NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #NAACL #Encoder-Decoder Issue Date: 2017-12-31 GPT Summary- エンドツーエンドのドメイン非依存型ニューラルエンコーダー-アライナー-デコーダーモデルを提案。LSTMを用いてデータベースイベントをエンコードし、アライナーで重要なレコードを特定、デコーダーで自由形式の説明を生成。WeatherGovデータセットで最良の結果を達成し、k近傍ビームフィルターでさらに改善。RoboCupデータセットでも競争力のある結果を得た。 Comment
content-selectionとsurface realizationをencoder-decoder alignerを用いて同時に解いたという話。
普通のAttention basedなモデルにRefinerとPre-Selectorと呼ばれる機構を追加。通常のattentionにはattentionをかける際のaccuracyに問題があるが、data2textではきちんと参照すべきレコードを参照し生成するのが大事なので、RefinerとPre-Selectorでそれを改善する。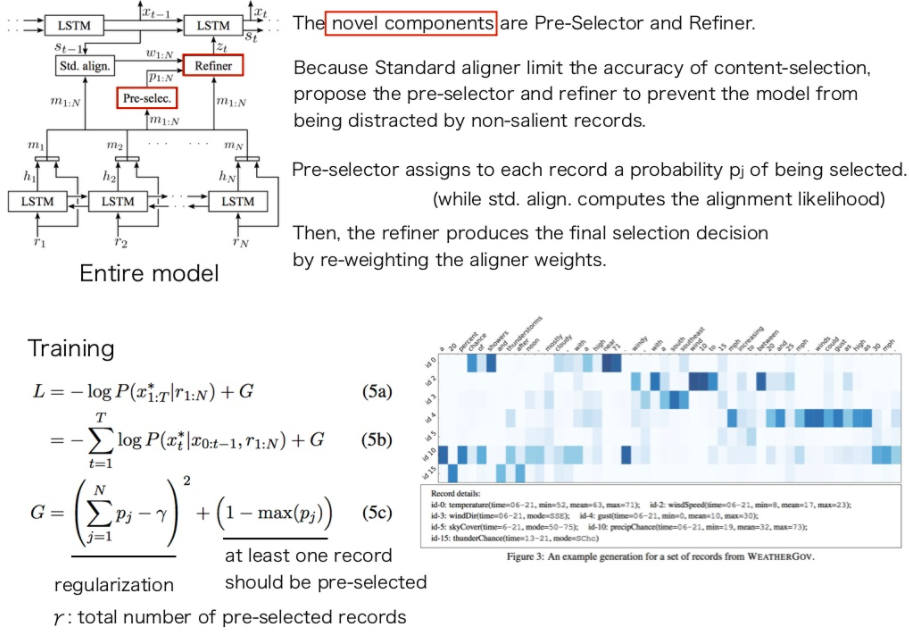
Pre-selectorは、それぞれのレコードが選択される確率を推定する(通常のattentionはalignmentの尤度を計算するのみ)。
Refinerはaligner(attention)のweightをreweightingすることで、最終的にどのレコードを選択するか決定する。
加えて、ロス関数のRegularizationのかけかたを変え、最低一つのレコードがpreselectorに選ばれるようにバイアスをかけている。
ほぼ初期のNeural Network basedなData2Text研究
[Paper Note] Learning query-biased web page summarization, Wang et al., CIKM’07, 2007.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Snippets #QueryBiased #CIKM Issue Date: 2017-12-28 Comment
・従来のquery-biasedな要約におけるclassificationアプローチは,training内のdocumentの情報が未知のdocumentのsentenceのclassificationに役立つというものだった.これは,たとえば似たような情報を多く含むscientific articleだったら有用だが,様々な情報を含むweb pageにはあまり適切ではない(これはtraining set内のdocumentの情報とtarget pageの情報を比較するみたいなアプローチに相当する).この研究では,target page内の’sentenceの中で’はスニペットに含めるべき文かどうかという比較ができるという仮定のもと,learning to rankを用いてスニペットを生成する.
・query biased summarizationではrelevanceとfidelityの両者が担保された要約が良いとされている.
relevanceとはクエリと要約の適合性,fidelityとは,要約とtarget documentとの対応の良さである.
・素性は,relevanceに関してはクエリとの関連度,fidelityに関しては,target page内のsentenceに関しては文の位置や,文の書式(太字)などの情報を使う.contextの文ではそういった情報が使えないので,タイトルやanchor textのフレーズを用いてfidelityを担保する(詳しくかいてない).あとはterm occurence,titleとextracted title(先行研究によると,TRECデータの33.5%のタイトルが偽物だったというものがあるのでextracted titleも用いる),anchor textの情報を使う.あまり深く読んでいない.
・全ての素性を組み合わせたほうがintrinsicなevaluationにおいて高い評価値.また,contextとcontent両方組み合わせたほうが良い結果がでた.
[Paper Note] Enhanced web document summarization using hyperlinks, Delort et al., HT’03, 2003.08
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Snippets Issue Date: 2017-12-28 Comment
・Genericなweb pageの要約をつくる
・要約を作る際に,ページの内容から作るわけではなく,contextを用いて作る.contextとは,target pageにリンクを張っているページにおけるリンクの周辺にある文のこと.
・contextを利用した要約では,partialityとtopicalityに関する問題が生じる.partialityとは,contextに含まれる情報がtarget pageに関する一部の情報しか含んでいない問題.topicalityとは,そもそもcontextに含まれる情報が,target pageのoverviewに関する情報を含んでいない問題
・partialityに関しては,contextに含まれる文を除くことで,contextのoverallな情報が失われない最小のsetを求めることで対応.setを求める際には,context内の2文の単語を比較し,identicalなrepresentationが含まれているかどうかを計算.重複するものは排除することでsetを求める.
・topicalityに関しては,target pageのtextual informationが取得できる場合は,context内の文中の単語がtarget page内に含まれる単語の比率を出すことでtopicality scoreを算出.topicality scoreが高いものを要約とする.一方,target pageのtextual informationが十分でない場合は,context内の文のクラスタリングを行い,各クラスタのcentroidと近い文を抽出.
[Paper Note] A task-oriented study on the influencing effects of query-biased summarization in web searching, White et al., Information Processing and Management, 2003.09
Paper/Blog Link My Issue
#Article #DocumentSummarization #InformationRetrieval #NLP #RelevanceJudgment #Snippets #QueryBiased Issue Date: 2017-12-28 Comment
・search engineにおいてquery-biasedな要約の有用性を示したもの
・task-orientedな評価によって,提案手法がGoogleやAltaVistaのスニペットよりも良いことを示す.
・提案手法は文選択によるquery-biased summarization.スコアリングには,ページのタイトルに含まれる単語がどれだけ含まれているか,文のページ内での出現位置,クエリとの関連度,文の書式(太字)などの情報を使う.
・スニペットが作れないページに対しては,エラーメッセージを返したり,ページ内の最初のnon-textualな要素を返したりする.
[Paper Note] Discovery-oriented Collaborative Filtering for Improving User Satisfaction, Hijikata+, IUI’09
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #Novelty #Selected Papers/Blogs Issue Date: 2017-12-28 Comment
・従来のCFはaccuracyをあげることを目的に研究されてきたが,ユーザがすでに知っているitemを推薦してしまう問題がある.おまけに(推薦リスト内のアイテムの観点からみた)diversityも低い.このような推薦はdiscoveryがなく,user satisfactionを損ねるので,ユーザがすでに何を知っているかの情報を使ってよりdiscoveryのある推薦をCFでやりましょうという話.
・特徴としてユーザのitemへのratingに加え,そのitemをユーザが知っていたかどうかexplicit feedbackしてもらう必要がある.
・手法は単純で,User-based,あるいはItem-based CFを用いてpreferenceとあるitemをユーザが知っていそうかどうかの確率を求め,それらを組み合わせる,あるいはrating-matrixにユーザがあるitemを知っていたか否かの数値を組み合わせて新たなmatrixを作り,そのmatrix上でCFするといったもの.
・offline評価の結果,通常のCF,topic diversification手法と比べてprecisionは低いものの,discovery ratioとprecision(novelty)は圧倒的に高い.
・ユーザがitemを知っていたかどうかというbinary ratingはユーザに負荷がかかるし,音楽推薦の場合previewがなければそもそも提供されていないからratingできないなど,必ずしも多く集められるデータではない.そこで,データセットのratingの情報を25%, 50%, 75%に削ってratingの数にbiasをかけた上で実験をしている.その結果,事前にratingをcombineし新たなmatrixを作る手法はratingが少ないとあまりうまくいかなかった.
・さらにonlineでuser satisfaction(3つの目的のもとsatisfactionをratingしてもらう 1. purchase 2. on-demand-listening 3. discovery)を評価した. 結果,purchaseとdiscoveryにおいては,ベースラインを上回った.ただし,これは推薦リスト中の満足したitemの数の問題で,推薦リスト全体がどうだった
かと問われた場合は,ベースラインと同等程度だった.
重要論文
[Paper Note] “I like to explore sometimes”: Adapting to Dynamic User Novelty Preferences, Kapoor et al. (with Konstan), RecSys’15
Paper/Blog Link My Issue
#Article #RecommenderSystems #Novelty #RecSys #Selected Papers/Blogs Issue Date: 2017-12-28 Comment
・典型的なRSは,推薦リストのSimilarityとNoveltyのcriteriaを最適化する.このとき,両者のバランスを取るためになんらかの定数を導入してバランスをとるが,この定数はユーザやタイミングごとに異なると考えられるので(すなわち人やタイミングによってnoveltyのpreferenceが変化するということ),それをuserの過去のbehaviorからpredictするモデルを考えましたという論文.
・式中によくtが出てくるが,tはfamiliar setとnovel setをわけるためのみにもっぱら使われていることに注意.昼だとか夜だとかそういう話ではない.familiar setとは[t-T, t]の間に消費したアイテム,novel setはfamiliar setに含まれないitemのこと.
・データはmusic consumption logsを使う.last.fmやproprietary dataset.データにlistening以外のexplicit feedback (rating)などの情報はない
・itemのnoveltyの考え方はユーザ側からみるか,システム側から見るかで分類が変わる.三種類の分類がある.
(a) new to system: システムにとってitemが新しい.ゆえにユーザは全員そのitemを知らない.
(b) new to user: システムはitemを知っているが,ユーザは知らない.
(c) oblivious/forgotten item: 過去にユーザが知っていたが,最後のconsumptionから時間が経過しいくぶんunfamiliarになったitem
Repetition of forgotten items in future consumptions has been shown to produce increased diversity and emotional excitement.
この研究では(b), (c)を対象とする.
・userのnovelty preferenceについて二つの仮定をおいている.
1. ユーザごとにnovelty preferenceは違う.
2. ユーザのnovelty preferenceはdynamicに変化する.trainingデータを使ってこの仮定の正しさを検証している.
・novelty preferenceのpredictは二種類の素性(familiar set diversityとcumulative negative preference for items in the familiar set)を使う. 前者は,familiar setの中のradioをどれだけ繰り返しきいているかを用いてdiversityを定義.繰り返し聞いているほうがdiversity低い.後者は,異なるitemの消費をする間隔によってdynamic preference scoreを決定.familiar set内の各itemについて負のdynamic preference scoreをsummationすることで,ユーザの”退屈度合い”を算出している.
・両素性を考慮することでnovelty preferenceのRMSEがsignificantに減少することを確認.
・推薦はNoveltyのあるitemの推薦にはHijikataらの協調フィルタリングなどを使うこともできる.
・しかし今回は簡易なitem-based CFを用いる.ratingの情報がないので,それはdynamic preference scoreを代わりに使い各itemのスコアを求め,そこからnovel recommendationとfamiliar recommendationのリストを生成し,novelty preferenceによって両者を組み合わせる.
・音楽(というより音楽のradioやアーティスト)の推薦を考えている状況なので,re-consumptionが許容されている.Newsなどとは少しドメインが違うことに注意.
[Paper Note] Combination of Web page recommender systems, Goksedef, Gunduz-oguducu, Elsevier, 2010.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #Document Issue Date: 2017-12-28 Comment
・traditionalなmethodはweb usage or web content mining techniquesを用いているが,ニュースサイトなどのページは日々更新されるのでweb content mining techniquesを用いてモデルを更新するのはしんどい.ので,web usage mining(CFとか?どちらかというとサーバログからassociation ruleを見つけるような手法か)にフォーカス.
・web usage miningに基づく様々な手法をhybridすることでどれだけaccuracyが改善するかみる.
・ユーザがセッションにおいて次にどのページを訪れるかをpredictし推薦するような枠組み(不特定多数のページを母集団とするわけではなく,自分のサイト内のページが母集団というパターンか)
・4種類の既存研究を紹介し,それらをどうcombineするかでaccuraryがどう変化しているかを見ている.
・それぞれの手法は,ユーザのsessionの情報を使いassociation rule miningやclusteringを行い次のページを予測する手法.
[Paper Note] Neural Networks for Web Content Filtering, Lee, Fui and Fong, IEEE Intelligent Systems, 2002.09
Paper/Blog Link My Issue
#Article #RecommenderSystems #NeuralNetwork #Document #DataFiltering Issue Date: 2017-12-28 Comment
・ポルノコンテンツのフィルタリングが目的. 提案手法はgeneral frameworkなので他のコンテンツのフィルタリングにも使える.
・NNを採用する理由は,robustだから(様々な分布にfitする).Webpageはnoisyなので.
・trainingのためにpornographic pageを1009ページ(13カテゴリから収集),non-pornographic pageを3,777ページ収集.
・feature(主なもの)
- indicative term(ポルノっぽい単語)の頻度
- displayed contents ページのタイトル,warning message block, other viewable textから収集
- non-displayed contents descriptionやkeywordsなどのメタデータ,imageタグのtextなどから収集
・95%くらいのaccuracy
[Paper Note] DualSum: a Topic-Model based approach for update summarization, Delort et al., EACL’12
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #EACL Issue Date: 2017-12-28 Comment
・大半のupdate summarizationの手法はdocument set Aがgivenのとき,document set Bのupdate summarizationをつくる際には,redundancy removalの問題として扱っている.
・この手法は,1つのsentenceの中にredundantな情報とnovelな情報が混在しているときに,そのsentenceをredundantなsentenceだと判別してしまう問題点がある.加えて,novel informationを含んでいると判別はするけれども,明示的にnovel informationがなんなのかということをモデル化していない.
・Bayesian Modelを使うことによって,他の手法では抜け落ちている確率的な取り扱いが可能にし, unsupervisedでできるようにする.
[Paper Note] Document Update Summarization Using Incremental Hierarchical Clustering, Wang+, CIKM’10
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #CIKM Issue Date: 2017-12-28 Comment
・既存のMDSではdocumentをbatch処理するのが前提.typicalなクラスタリングベースの手法やグラフベースの手法はsentence-graphを構築して要約を行う.しかし,情報がsequentialに届き,realtimeで要約を行いたいときにこのような手法を使うと,毎回すでに処理したことがあるテキストを処理することになり,time consumingだし,無駄な処理が多い.特に災害時などでは致命的.このような問題に対処するために,ドキュメントがarriveしたときに,ただちにupdate summaryが生成できる手法を提案する.
・既存のヒューリスティックなfeature(tf-isfやキーワード数など)を用いたスコアリングは,existing sentencesとnewly coming sentencesが独立しているため,real world scenarioにおいて実用的でないし,hardly perform wellである.
・なので,incremental hierarchical clusteringの手法でsentence clusterをre-organizeすることで,効果的に要約のupdateを行う.このとき,sentence同士のhierarchical relationshipはreal timeにre-constructされる.
・TACのupdate summarizationとは定義が微妙に違うらしい.主に2点.TACではnewly coming documentsだけを対象にしているが,この研究 ではすべてのドキュメントを対象にする.さらに,TACでは一度だけupdate summarizationする(document set Bのみ)が,この研究ではdocumentsがsequenceでarriveするのを前提にする.なので,TACに対しても提案手法は適用可能.
・Sequence Update Summarizationの先駆け的な研究かもしれない.SUSがのshared taskになったのは2013だし.
・incremental hierarchical clusteringにはCOBWEB algorithm (かなりpopularらしい)を使う.COBWEBアルゴリズムは,新たなelementが現れたとき,Category Utilityと呼ばれるcriterionを最大化するように,4種類の操作のうち1つの操作を実行する(insert(クラスタにsentenceを挿入), create(新たなクラスタつくる), merge(2クラスタを1つに),split(existingクラスタを複数のクラスタに)).ただ,もとのCOBWEBで使われているnormal attribute distributionはtext dataにふさわしくないので,Katz distributionをword occurrence distributionとして使う(Sahooらが提案している.).元論文読まないと詳細は不明.
・要約の生成は,実施したoperationごとに異なる.
- Insertの場合: クラスタを代表するsentenceをクエリとのsimilarity, クラスタ内のsentenceとのintra similarityを計算して決めて出力する.
- createの場合: 新たに生成したクラスタcluster_kを代表する文を,追加したsentence s_newとする.
- mergeの場合: cluster_aとcluster_bをmergeして新たなcluster_cを作った場合,cluster_cを代表する文を決める.cluster_cを代表する文は,cluster_aとcluster_bを代表する文とクエリとのsimilarityをはかり,similarityが大きいものとする.
- splitの場合: cluster_aをsplitしてn個の新たなクラスタができたとき,各新たなn個のクラスタにおいて代表する文を,original subtreeの根とする.
・TAC08のデータとHurricane Wilma Releasesのデータ(disaster systemからtop 10 queryを取得,5人のアノテータに正解を作ってもらう)を使って評価.(要約の長さを揃えているのかが気になる。長さが揃っていないからROUGEのF値で比較している?)
・一応ROUGEのF値も高いし,速度もbaselineと比べて早い.かなりはやい.genericなMDSとTAC participantsと比較.TAC Bestと同等.GenericMDSより良い.document setAの情報を使ってredundancy removalをしていないのにTAC Bestを少しだけoutperform.おもしろい.
・かつ,TAC bestはsentence combinationを繰り返す手法らしく,large-scale online dataには適していないと言及.
[Paper Note] Incremental Update Summarization: Adaptive Sentence Selection based on Prevalence and Novelty, McCreadie et al., CIKM’14
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #CIKM Issue Date: 2017-12-28 Comment
・timelyなeventに対してupdate summarizationを適用する場合を考える.たとえば6日間続いたeventがあったときにその情報をユーザが追う為に何度もupdate summarizationシステムを用いる状況を考える.6日間のうち新しい情報が何も出てこない期間はirrelevantでredundantな内容を含む要約が出てきてしまう.これをなんとかする手法が必要だというのがmotivation.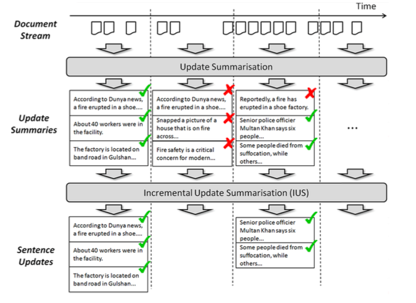
・どのような手法かというと,news streamsからnovel updatesをtimely mannerで自動抽出し,一方で,抽出するupdatesはirrelevant, uninformative or redundant contentを最小化するようなもの手法
・手法は既存のUpdate Summarization手法(lambdaMART, learning to rank baseの手法)で10文を出力し,何文目までを残すか(rank-cut off problem)を解くことで,いらないsentenceをはぶいている.
・rank cut offをする際はlinear regressionとModel Treesを使っているが,linear regressionのような単純な手法だと精度があがらず,Model Treesを使ったほうがいい結果が出た.
・素性は主にprevalence (sentenceが要約したいトピックに沿っているか否か),novelty(sentenceが新しい情報を含んでいるか),quality(sentenceがそもそも重要かどうか)の3種類の素性を使っている.気持ちとしては,prevalenceとnoveltyの両方が高いsentenceだけを残したいイメージ.つまり,トピックに沿っていて,なおかつ新しい情報を含んでいるsentence
・loss functionには,F値のような働きをするものを採用(とってきたrelevant updateのprecisionとrecallをはかっているイメージ).具体的には,Expected Latency GainとLatency Comprehensivenessと呼ばれるTREC2013のquality measureに使われている指標を使っている.
・ablation testの結果を見ると,qualityに関する素性が最もきいている.次にnovelty,次点でprevalence
・提案手法はevent発生から時間が経過すると精度が落ちていく場合がある.
・classicalなupdate summarizationの手法と比較しているが,Classyがかなり強い,Model treesを使わない提案手法や,他のbaselineを大きくoutperform. ただ,classyはmodel treesを使ったAdaptive IUSには勝てていない.
・TREC 2013には,Sequantial Update Summarizationタスクなるものがあるらしい.ユーザのクエリQと10個のlong-runnning event(典型的には10日間続くもの,各イベントごとに800〜900万記事),正解のnuggetsとそのtimestampが与えられたときにupdate summarizationを行うタスクらしい.
[Paper Note] Update Summarization using Semi-Supervised Learning Based on Hellinger Distance, Wang et al., CIKM’15, 2015.10
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #CIKM Issue Date: 2017-12-28 Comment
・Hellinger Distanceを用いてSentence Graphを構築.ラベル伝搬により要約に含める文を決定する手法
・update summarizationの研究ではsimilarityをはかるときにcosine similarityを用いることが多い.
・cosine similarityはユークリッド距離から直接的に導くことができる.
・Vector Space Modelはnonnegativeなmatrixを扱うので,確率的なアプローチで取り扱いたいが,ユークリッド距離は確率を扱うときにあまり良いmetricではない.そこでsqrt-cos similarityを提案する.sqrt-cosは,Hellinger Distanceから求めることができ,Hellinger Distanceは対称的で三角不等式を満たすなど,IRにおいて良いdistance measureの性質を持っている.(Hellinger Distanceを活用するために結果的に類似度の尺度としてsqrt-cosが出てきたとみなせる)
・またHellinger DistanceはKL Divergenceのsymmetric middle pointとみなすことができ,文書ベクトル生成においてはtf_idfとbinary weightingのちょうど中間のような重み付けを与えているとみなせる.
・要約を生成する際は,まずはset Aの文書群に対してMMR [Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
を適用する(redundancyの項がmaxではなくて平均になっている).similarityはsqrt-cosを用いる.
・sqrt-cosと,set Aの要約結果を用いると,sentence graphを構築できる.sentence graphはset Aとset Bの各sentenceをノードとするグラフで,エッジの重みはsqrt-cosとなっている.このsentence graph上でset Aの要約結果のラベルをset B側のノードに伝搬させることで,要約に含めるべき文を選択する.
・ラベル伝搬にはGreen’s functionを用いる.set Bにlabel “1”がふられるものは,given topicとset Aのcontentsにrelevantなsentenceとなる.
・TAC2011のデータで評価した結果,standardなMMRを大幅にoutperform, co-ranking, Centroidベースの手法などよりも良い結果.
[Paper Note] TimedTextRank: Adding the Temporal Dimension to Multi-Document Summarization, Xiaojun Wan, SIGIR’07, 2007.07
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #SIGIR Issue Date: 2017-12-28 Comment
・evolving topicsを要約するときは,基本的に新しい情報が重要だが,TextRankはそれが考慮できないので拡張したという話.
・dynamic document setのnew informationをより重視するTimedTextRankを提案
・TextRankのvoteの部分に重み付けをする.old sentenceからのvoteよりも,new documentsに含まれるsentenceからのvoteをより重要視
・評価のときは,news pageをクローリングし,incremental single-pass clustering algorithmでホットなトピックを抽出しユーザにみせて評価(ただしこれはPreliminary Evaluation).
[Paper Note] The LIA Update Summarization Systems at TAC-2008, Boudin et al. TAC’08, 2008.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update Issue Date: 2017-12-28 Comment
・Scalable MMR [Paper Note] A Scalable MMR Approach to Sentence Scoring for Multi-Document Update Summarization, Boudin et al., COLING’08, 2008.08
とVariable length intersection gap n-term modelを組み合わせる.
・Variable length intersection gap n-term modelは,あるトピックのterm sequenceは他の異なる語と一緒にでてくる?という直感にもとづく.要は,drugs.*treat.*mental.*illnessなどのパターンをとってきて活用する.このようなパターンをn-gram, n-stem, n-lemmaごとにつくり3種類のモデルを構築.この3種類のモデルに加え,coverage rate (topic vocabularyがセグメント内で一度でもみつかる割合)とsegmentのpositionの逆数を組みあわせて,sentenceのスコアを計算(先頭に近いほうが重要).
・coherenceを担保するために,sentenceを抽出した後,以下のpost-processingを行う.
Acronym rewriting(初めてでてくるNATOなどの頭字語はfull nameにする)
Date and number rewriting(US standard formsにする)
Temporal references rewriting (next yearなどの曖昧なreferenceを1993などの具体的なものにする)
Discursive form rewriting (いきなりButがでてくるときとかは削るなど)
カッコやカギカッコは除き,句読点をcleanedする
・TAC 2008におけるROUGE-2の順位は72チーム中32位
[Paper Note] A Scalable MMR Approach to Sentence Scoring for Multi-Document Update Summarization, Boudin et al., COLING’08, 2008.08
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #COLING Issue Date: 2017-12-28 Comment
・MMR [Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
をupdate summarization用に拡張.History(ユーザが過去に読んだsentence)の数が多ければ多いほどnon-redundantな要約を出す (Queryに対するRelevanceよりもnon-redundantを重視する)
・Historyの大きさによって,redundancyの項の重みを変化させる.
・MMRのredundancyの項を1-max Sim2(s, s_history)にすることでnoveltyに変更.ORよりANDの方が直感的なので二項の積にする.
・MMRのQueryとのRelevanceをはかる項のSimilarityは,cossimとJaro-Winkler距離のinterpolationで決定. Jaro-Winkler距離とは,文字列の一致をはかる距離で,値が大きいほど近い文字列となる.文字ごとの一致だけでなく,ある文字を入れ替えたときにマッチ可能かどうかも見る.一致をはかるときはウィンドウを決めてはかるらしい.スペルミスなどの検出に有用.クエリ内の単語とselected sentences内の文字列のJaro-Winkler距離を計算.各クエリごとにこれらを求めクエリごとの最大値の平均をとる.
・冗長性をはかるSim2では,normalized longest common substringを使う.
[Paper Note] Improving Update Summarization via Supervised ILP and Sentence Reranking, Li et al. NAACL’15, 2015.05
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #IntegerLinearProgramming (ILP) #Update #NAACL Issue Date: 2017-12-28 Comment
・update summarizationをILPで定式化.基本的なMDSのILPのterm weightingにsalienceの要素に加えてnoveltyの要素を加える.term weightingにはbigramを用いる.bigram使うとよくなることがupdate summarizationだと知られている.weightingは平均化パーセプトロンで学習
・ILPでcandidate sentencesを求めたあと,それらをSVRを用いてRerankingする.SVRのloss functionはROUGE-2を使う.
・Rerankingで使うfeatureはterm weightingした時のsentenceレベルのfeatureを使う.
・RerankingをするとROUGE-2スコアが改善する.2010, 2011のTAC Bestと同等,あるいはそれを上回る結果.novelty featureを入れると改善.
・noveltyのfeatureは,以下の通り.
Bigram Level
-bigramのold datasetにおけるDF
-bigram novelty value (new datasetのbigramのDFをold datasetのDFとDFの最大値の和で割ったもの)
-bigram uniqueness value (old dataset内で出たbigramは0, すでなければ,new dataset内のDFをDFの最大値で割ったもの)
Sentence Level
-old datasetのsummaryとのsentence similarity interpolated n-gram novelty (n-gramのnovelty valueをinterpolateしたもの)
-interpolated n-gram uniqueness (n-gramのuniqueness valueをinterpolateしたもの)
・TAC 2011の評価の値をみると,Wanらの手法よりかなり高いROUGE-2スコアを得ている.
[Paper Note] Update Summarization Based on Co-Ranking with Constraints, Wiaojun Wan, COLING’12, 2012.12
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #Update #COLING Issue Date: 2017-12-28 Comment
・PageRankの枠組みを拡張してold datasetとnew dataset内のsentenceをco-ranking
・co-rankingするときは,update scoreとconsistency scoreというものを求め相互作用させる.
・update scoreが高いsentenceは同じdataset内では正の関係,異なるdataset内では負の関係を持つ.
・consistency scoreが高いsentenceは同じdataset内では正の関係,異なるdataset内では正の関係を持つ.
・負の関係はdissimilarity matrixを用いて表現する.
・あとはupdate scoreとconsistency scoreを相互作用させながらPageRankでスコアを求める.デコーディングはupdate scoreをgreedyに.
・update scoreとconsistency scoreの和は定数と定義,この論文では定数をsentenceのinformative scoreとしている.これがタイトルにある制約.informative scoreはAffinity GraphにPageRankを適用して求める.
・制約が入ることで,consistency scoreが低いとupdate scoreは高くなるような効果が生まれる.逆もしかり.
[Paper Note] Segmentation Based, Personalized Web Page Summarization Model, [Journal of advances in information technology, vol. 3, no.3, 2012], 2012.08
Paper/Blog Link My Issue
#Article #Single #PersonalizedDocumentSummarization #DocumentSummarization #NLP #Personalization Issue Date: 2017-12-28 Comment
・Single-document
・ページ内をセグメントに分割し,どのセグメントを要約に含めるか選択する問題
・要約に含めるセグメントは4つのfactor(segment weight, luan’s significance factor, profile keywords, compression ratio)から決まる.基本的には,ページ内の高頻度語(stop-wordは除く)と,profile keywordsを多く含むようなセグメントが要約に含まれるように選択される.図の場合はAlt要素,リンクはアンカテキストなどから単語を取得しセグメントの重要度に反映する.
[Paper Note] Automatic Text Summarization based on the Global Document Annotation, Nagao+, COLING-ACL;98, 1998.08
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #NLP #Personalization #ACL #COLING Issue Date: 2017-12-28 Comment
Personalized summarizationの評価はしていない。提案のみ。以下の3種類の手法を提案
- keyword-based customization
- 関心のあるキーワードをユーザが入力し、コーパスやwordnet等の共起関係から関連語を取得し要約に利用する
- 文書の要素をinteractiveに選択することによる手法
- 文書中の関心のある要素(e.g. 単語、段落等)
- browsing historyベースの手法
- ユーザのbrowsing historyのドキュメントから、yahooディレクトリ等からカテゴリ情報を取得し、また、トピック情報も取得し(要約技術を活用するとのこと)特徴量ベクトルを作成
- ユーザがアクセスするたびに特徴ベクトルが更新されることを想定している?
[Paper Note] A Study for Documents Summarization based on Personal Annotation, Zhang+, HLT-NAACL-DUC’03, 2003.05
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #NLP #Personalization #NAACL #Selected Papers/Blogs Issue Date: 2017-12-28 Comment
(過去に管理人が作成したスライドでの論文メモのスクショ)
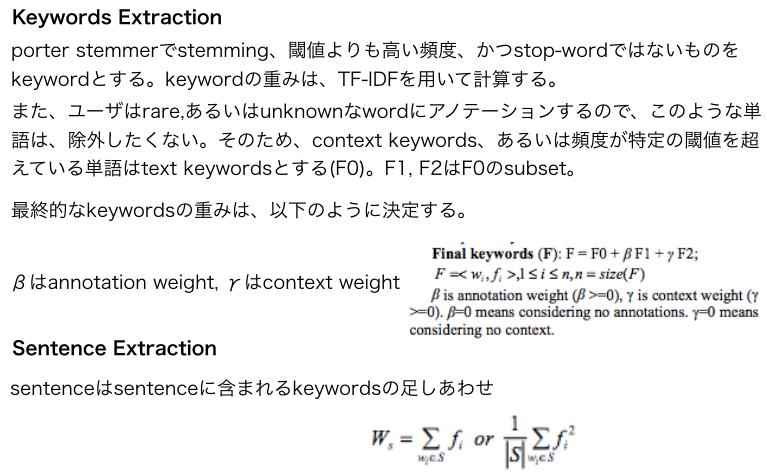
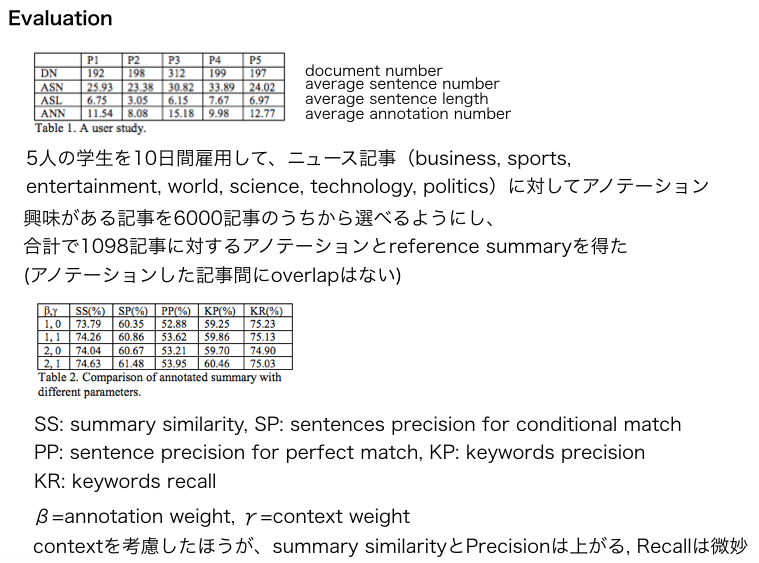
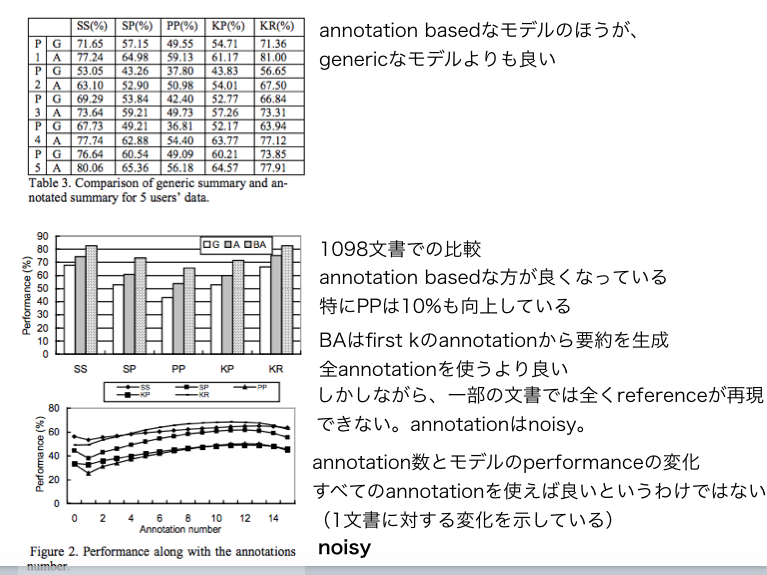
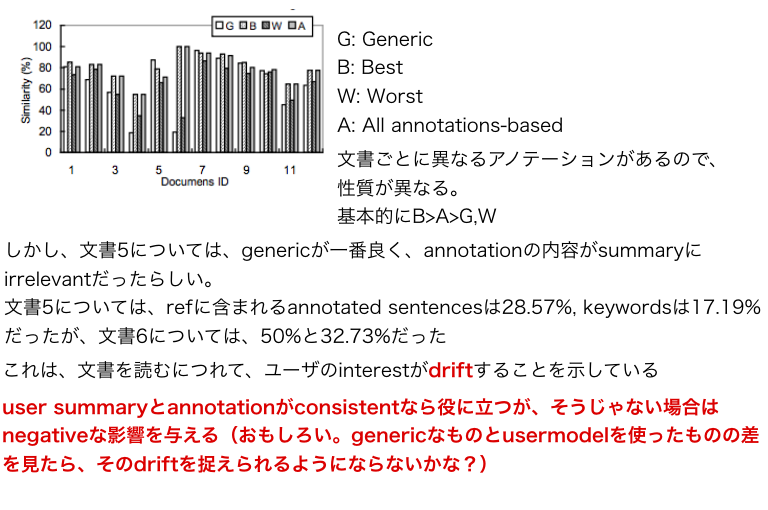
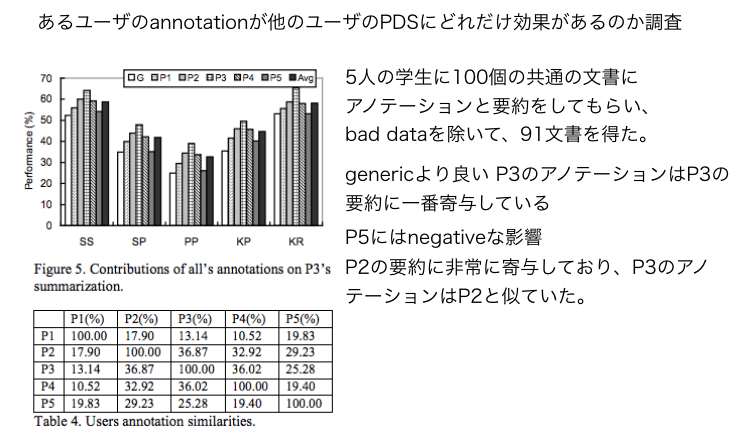
重要論文だと思われる。
[Paper Note] Personalised Information retrieval: survey and classification, Rami+, User Modeling and User-Adapted Interaction, 2012.05
Paper/Blog Link My Issue
#Article #Survey #InformationRetrieval #Personalization Issue Date: 2017-12-28 Comment
(以下は管理人が当時作成したスライドでのメモのスクショ)
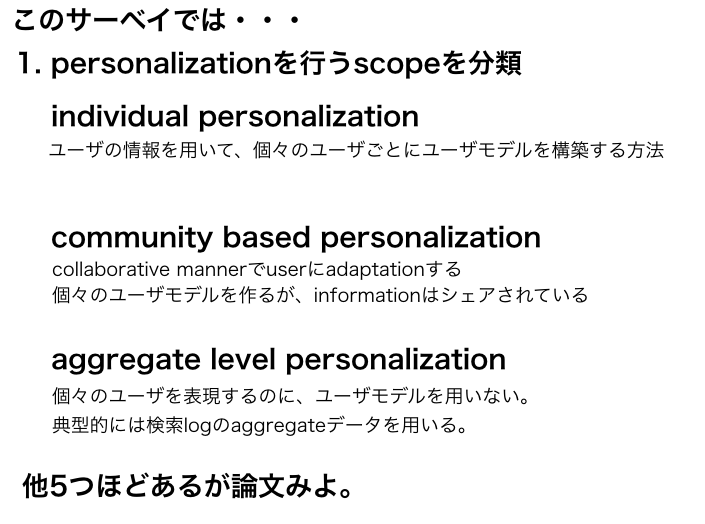
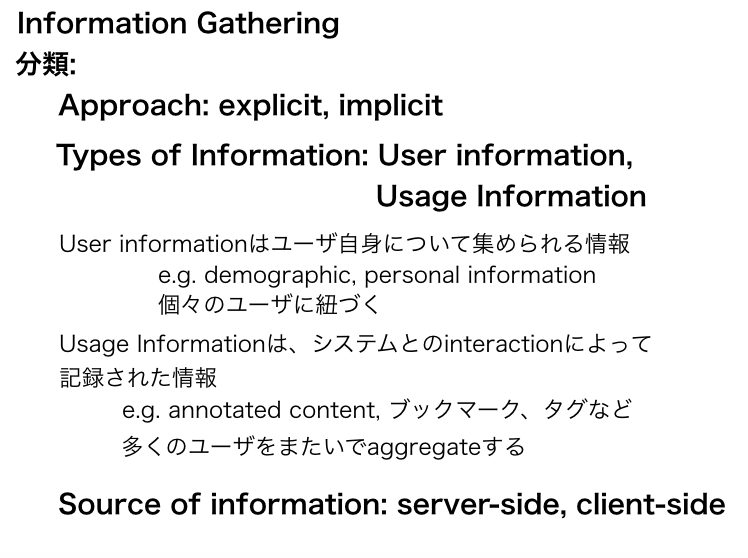
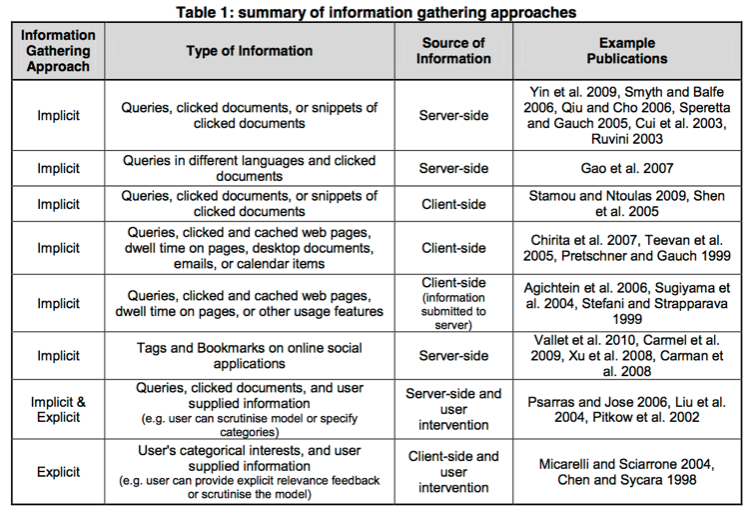
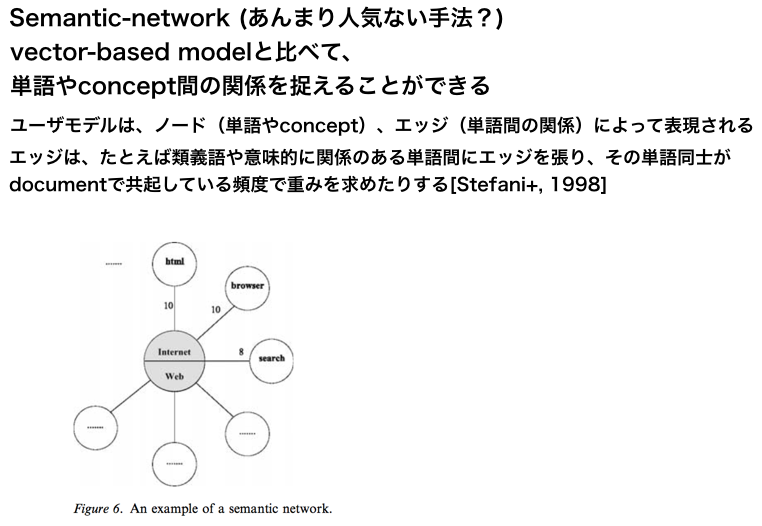
完全に途中で力尽きている感
[Paper Note] Machine Learning for User Modeling, User modeling and User-adapted Interaction, [Webb+, 2001], 2001.03
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #UserModeling Issue Date: 2017-12-28 Comment
# 管理人の過去のメモスクショ
[Paper Note] Modeling Anchor Text and Classifying Queries to Enhance Web Document Retrieval, WWW’08, [Fujii, 2008], 2008.04
Paper/Blog Link My Issue
#Article #InformationRetrieval #WWW Issue Date: 2017-12-28
[Paper Note] Comments-Oriented Document Summarization: Understanding Documents with Reader’s Feedback, Hu+, SIGIR’08, 2008.07
Paper/Blog Link My Issue
#Article #DocumentSummarization #GraphBased #Comments #NLP #Extractive #SIGIR Issue Date: 2017-12-28