
NLP (4152) — 15/21
Discourse constraints for document compression, Clarke+ (w_ Lapata), Computational Linguistics'10
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #QA-based #One-Line Notes Issue Date: 2023-08-20 Comment
QAベースドなアプローチを人手評価に導入した初めての研究
[Paper Note] Generative alignment and semantic parsing for learning from ambiguous supervision, Kim+, COLING'10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #SingleFramework #ConceptToTextGeneration #COLING Issue Date: 2017-12-31
[Paper Note] A simple domain-independent probabilistic approach to generation, Angeli+, EMNLP'10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #SingleFramework #DataToTextGeneration #EMNLP Issue Date: 2017-12-31
[Paper Note] Training a multilingual sportscaster: Using perceptual context to learn language, Chen+, Artificial Intelligence Research'10, 2010.01
Paper/Blog Link My Issue
#NaturalLanguageGeneration #SingleFramework #DataToTextGeneration Issue Date: 2017-12-31
[Paper Note] Personalized Multi-Document Summarization using N-Gram Topic Model Fusion, Hennig+, SPIM'10, 2010.05
Paper/Blog Link My Issue
#Multi #PersonalizedDocumentSummarization #DocumentSummarization #QueryBiased #Personalization #One-Line Notes Issue Date: 2017-12-28 Comment
・unigramの共起だけでなく,bigramの共起も考慮したPLSIモデルを提案し,jointで学習.与えられたクエリやnarrativeなどとsentenceの類似度(latent spaceで計算)を計算し重要文を決定。
・user-modelを使ったPersonalizationはしていない.
[Paper Note] Learning semantic correspondences with less supervision, Liang+, ACL-IJCNLP'09
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Others #ConceptToTextGeneration #ACL #IJCNLP Issue Date: 2017-12-31
[Paper Note] Verbalizing time-series data: with an example of stock price trends, Kobayashi+, IFSA-EUSFLAT'09, 2009.01
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Others #DataToTextGeneration #KeyPoint Notes Issue Date: 2017-12-31 Comment
小林先生の論文
Least Square Methodによって数値データにfittingするcurveを求める。
curveの特徴から、生成するテキストのtrendsを決定する。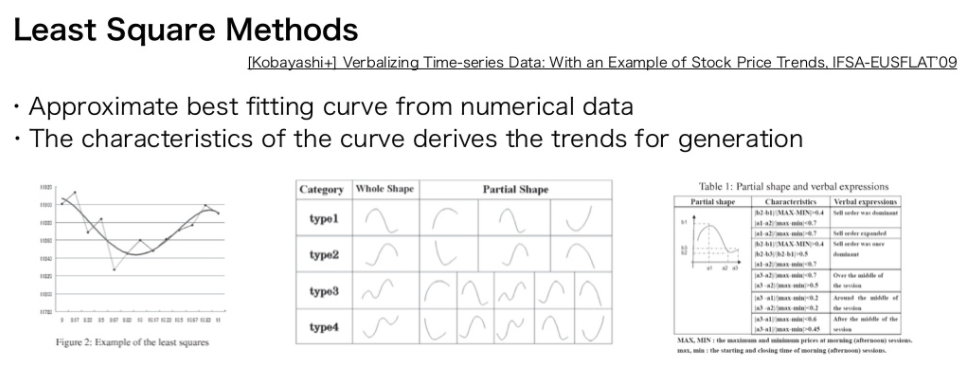
[Paper Note] Generating approximate geographic descriptions, Turner+, ENLG'09, 2009.03
Paper/Blog Link My Issue
#NaturalLanguageGeneration #RuleBased #DataToTextGeneration Issue Date: 2017-12-31
[Paper Note] Automatic generation of textual summaries from neonatal intensive care data, Porter+, Artificial Intelligence'09, 2009.05
Paper/Blog Link My Issue
#NaturalLanguageGeneration #SingleFramework #ConceptToTextGeneration #Initial Impression Notes Issue Date: 2017-12-31 Comment
BabyTalk論文
[Paper Note] Incremental Personalised Summarisation with Novelty Detection, Campana+, FQAS'09, 2009.10
Paper/Blog Link My Issue
#Single #PersonalizedDocumentSummarization #DocumentSummarization #Search #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment
https://link.springer.com/content/pdf/10.1007/978-3-642-04957-6_55.pdf
ROUGE-C: A fully automated evaluation method for multi-document summarization, He+, International Conference on Granular Computing'08
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free Issue Date: 2023-08-13
[Paper Note] A unified architecture for natural language processing: Deep neural networks with multitask learning, Collobert+, ICML'08
Paper/Blog Link My Issue
#NeuralNetwork #MultitaskLearning #ICML #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-02-05 Comment
Deep Neural Netを用いてmultitask learningを行いNLPタスク(POS tagging, Semantic Role Labeling, Chunking etc.)を解いた論文。
被引用数2000を超える。
multitask learningの学習プロセスなどが引用されながら他論文で言及されていたりする。
[Paper Note] A generative model for parsing natural language to meaning representations, Lu+, EMNLP'08
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Others #ConceptToTextGeneration #EMNLP Issue Date: 2017-12-31
[Paper Note] Learning to sportscast: a test of grounded language acquisition, Chen+, ICML'08
Paper/Blog Link My Issue
#NaturalLanguageGeneration #SingleFramework #DataToTextGeneration #ICML Issue Date: 2017-12-31
[Paper Note] Personalized PageRank based Multi-document summarization, Liu+, WSCS'08, 2008.07
Paper/Blog Link My Issue
#Multi #PersonalizedDocumentSummarization #DocumentSummarization #QueryBiased #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment
・クエリがあるのが前提
・基本的にPersonalized PageRankの事前分布を求めて,PageRankアルゴリズムを適用する
・文のsalienceを求めるモデルと(パラグラフ,パラグラフ内のポジション,statementなのかdialogなのか,文の長さ),クエリとの関連性をはかるrelevance model(クエリとクエリのnarrativeに含まれる固有表現が文内にどれだけ含まれているか)を用いて,Personalized PageRankの事前分布を決定する
・評価した結果,DUC2007のtop1とtop2のシステムの間のROUGEスコアを獲得
[Paper Note] Personalized Multi-document Summarization in Information Retrieval, Yang+, Machine Learning and Cybernetics'08, 2008.07
Paper/Blog Link My Issue
#Multi #PersonalizedDocumentSummarization #DocumentSummarization #InformationRetrieval #QueryBiased #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment
・検索結果に含まれるページのmulti-document summarizationを行う.クエリとsentenceの単語のoverlap, sentenceの重要度を
Affinity-Graphから求め,両者を結合しスコアリング.MMR [Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
likeな手法で冗長性を排除し要約を生成する.
・4人のユーザに,実際にシステムを使ってもらい,5-scaleで要約の良さを評価(ベースラインなし).relevance, importance,
usefulness, complement of summaryの視点からそれぞれを5-scaleでrating.それぞれのユーザは,各トピックごとのドキュメントに
全て目を通してもらい,その後に要約を読ませる.
[Paper Note] Automatic Personalized Summarization using Non-negative Matrix Factorization and Relevance Measure, Park+, IWSCA'08, 2008.07
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #QueryBiased Issue Date: 2017-12-28 Comment
[Paper Note] Personalized Summarization Agent Using Non-negative Matrix Factorization, Sun Park, PRICAI'08, 2008.12
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #QueryBiased #PRICAI #KeyPoint Notes Issue Date: 2017-12-28 Comment

[Paper Note] Aspect-Based Personalized Text Summarization, Berkovsky+(Tim先生のグループ), AH'2008, 2008.07
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #Analysis #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment

Aspect-basedなPDSに関して調査した研究。
たとえば、Wikipediaのクジラに関するページでは、biological taxonomy, physical dimensions, popular cultureのように、様々なアスペクトからテキストが記述されている。ユーザモデルは各アスペクトに対する嗜好の度合いで表され、それに従い生成される要約に含まれる各種アスペクトに関する情報の量が変化する。
UserStudyの結果、アスペクトベースなユーザモデルとよりfitした、擬似的なユーザモデルから生成された要約の方が、ユーザの要約に対するratingが上昇していくことを示した。
また、要約の圧縮率に応じて、ユーザのratingが変化し、originalの長さ>長めの要約>短い要約の順にratingが有意に高かった。要約が長すぎても、あるいは短すぎてもあまり良い評価は得られない(しかしながら、長すぎる要約は実はそこまで嫌いではないことをratingは示唆している)。
Genericな要約とPersonalizedな要約のfaitufulnessをスコアリングしてもらった結果、Genericな要約の方が若干高いスコアに。しかしながら有意差はない。実際、平均して83%のsentenceはGenericとPersonalizedでoverlapしている。faitufulnessの観点から、GenericとPersonalizedな要約の間に有意差はないことを示した。
museum等で応用することを検討
[Paper Note] Generating Personalized Summaries Using Publicly Available Web Documents, Kumar+, WI-IAT'08, 2008.12
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #Personalization #WI #One-Line Notes Issue Date: 2017-12-28 Comment
評価
5人の研究者による人手評価。
25種類の異なるトピックが選択され、各トピックには5-10の記事が紐づいている。
generic,personalizedな要約を提示しrelevanceを判定してもらった。具体的には、informativenessを5段階評価。
データ非公開、ニュース記事を使ったとしか記述されておらず再現不可
Large Language Models in Machine Translation, Brants+, EMNLP-CoNLL'07
Paper/Blog Link My Issue
#MachineTranslation #LanguageModel #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-12-24 GPT Summary- 本論文では、機械翻訳における大規模な統計的言語モデルの利点を報告し、最大2兆トークンでトレーニングした3000億n-gramのモデルを提案。新しいスムージング手法「Stupid Backoff」を導入し、大規模データセットでのトレーニングが安価で、Kneser-Neyスムージングに近づくことを示す。 Comment
N-gram言語モデル+スムージングの手法において、学習データを増やして扱えるngramのタイプ数(今で言うところのvocab数に近い)を増やしていったら、perplexityは改善するし、MTにおけるBLEUスコアも改善するよ(BLEUはサチってるかも?)という考察がされている
元ポスト:
Large Language Modelsという用語が利用されたのはこの研究が初めてなのかも…?
Supervised automatic evaluation for summarization with voted regression model, Hirao+, Information and Processing & Management'07
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-based #TrainedMetrics Issue Date: 2023-08-14 Comment
VRM
[Paper Note] A study of global inference algorithms in multi-document summarization, Ryan McDonald, ECIR'07
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Document #IntegerLinearProgramming (ILP) #Extractive #ECIR #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-01-17 Comment
文書要約をナップサック問題として定式化し、厳密解(動的計画法、ILP Formulation)、近似解(Greedy)を求める手法を提案。
[Paper Note] Document Summarization using Conditional Random Fields, Shen+, IJCAI'07
Paper/Blog Link My Issue
#Single #DocumentSummarization #Document #Supervised #IJCAI #KeyPoint Notes Issue Date: 2017-12-31 Comment
CRFを用いて単一文書要約の手法を考えましたという話。
気持ちとしては、
```
1. Supervisedなモデルでは、当時は原文書中の各文を独立に2値分類して要約を生成するモデルが多く、sentence間のrelationが考慮できていなかった
2. unsupervisedな手法では、ルールに基づくものなどが多く、汎用的ではなかった
```
といった問題があったので、CRF使ってそれを解決しましたという主張
CRFを使って、要約の問題を系列ラベリング問題に落とすことで、文間の関係性を考慮できるようにし、従来使われてきたルール(素性)をそのままCRFの素性としてぶちこんでしまえば、要約モデル学習できるよねっていうことだろうと思う。
CRFのFeatureとしては、文のpositionや、長さ、文の尤度、thematic wordsなどの基本的なFeatureに加え、LSAやHitsのScoreも利用している。
DUC2001のデータで評価した結果、basicな素性のみを使用した場合、unsupervisedなベースライン(Random, Lead, LSA, HITS)、およびsupervisedなベースライン(NaiveBayes, SVM, Logistic Regression, HMM)をoutperform。
また、LSAやHITSなどのFeatureを追加した場合、basicな素性のみと比べてROUGEスコアが有意に向上し、なおかつ提案手法がbest
結構referされているので、知っておいて損はないかもしれない。
[Paper Note] Frustratingly easy domain adaptation, Daum'e, ACL'07
Paper/Blog Link My Issue
#MachineLearning #DomainAdaptation #ACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2017-12-31 Comment

domain adaptationをする際に、Source側のFeatureとTarget側のFeatureを上式のように、Feature Vectorを拡張し独立にコピーし表現するだけで、お手軽にdomain adaptationができることを示した論文。
イメージ的には、SourceとTarget、両方に存在する特徴は、共通部分の重みが高くなり、Source, Targetドメイン固有の特徴は、それぞれ拡張した部分のFeatureに重みが入るような感じ。
[Paper Note] An Architecture for Data to Text Systems, Ehud Reiter, ENLG'07
Paper/Blog Link My Issue
#Survey #NaturalLanguageGeneration #DataToTextGeneration #ConceptToTextGeneration #Selected Papers/Blogs #One-Line Notes Issue Date: 2017-12-31 Comment
NLG分野で有名なReiterらのSurvey。
NLGシステムのアーキテクチャなどが、体系的に説明されている。
[Paper Note] Comments-Oriented Blog Summarization by Sentence Extraction, CIKM'07, [Hu+, 2007], 2007.11
My Issue
#DocumentSummarization #GraphBased #Comments #Extractive #CIKM Issue Date: 2017-12-28 Comment
[Paper Note] Aggregation via set partitioning for natural language generation, Barzilay+, HLT-NAACL'06
Paper/Blog Link My Issue
#NaturalLanguageGeneration #DataDriven #ConceptToTextGeneration #NAACL Issue Date: 2017-12-31
[Paper Note] Choosing words in computer-generated weather forecasts, Reiter+, Artificial Intelligence'05
Paper/Blog Link My Issue
#NaturalLanguageGeneration #RuleBased #DataToTextGeneration #KeyPoint Notes Issue Date: 2017-12-31 Comment
## タスク
天気予報の生成, システム名 SUMTIME
## 手法概要
ルールベースな手法,weather prediction dataから(将来の気象情報をシミュレーションした数値データ),天気予報を自動生成.corpus analysisと専門家のsuggestを通じて,どのようなwordを選択して天気予報を生成するか詳細に分析したのち,ルールを生成してテキスト生成
[Paper Note] Collective content selection for concept-to-text generation, Barzilay+, HLT_EMNLP'05
Paper/Blog Link My Issue
#NaturalLanguageGeneration #DataDriven #ConceptToTextGeneration #EMNLP Issue Date: 2017-12-31
[Paper Note] NewsInEssence: Summarizing ONLINE NEWS TOPICS, Radev+, Communications of the ACM'05, 2005.10
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Extractive #One-Line Notes Issue Date: 2017-12-28 Comment
・Centroid-Basedな手法(MEADと同じ手法)で要約を生成
・Personalizationはかけていない
Centroid-based summarization of multiple documents: sentence extraction, utility-based evaluation, and user studies, Radev+, Information Processing & Management'04
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Classic #One-Line Notes Issue Date: 2023-08-27 Comment
MEAD, Centroid-basedな手法で要約を実施する古典的なMDS手法
Mining and summarizing customer reviews, Hu+, KDD'04
Paper/Blog Link My Issue
#DocumentSummarization #OpinionMining #review #SIGKDD #KeyPoint Notes Issue Date: 2023-05-08 Comment
レビュー中のユーザが記述したopinion sentenceを同定し、極性がpos/negのどちらかを判定し、pos/negそれぞれの代表的なsentenceを抽出することで要約する手法
評価をする際は、Amazon等のレビューを収集し、人間がレビューを読み、どれがopinion sentenceか、およびpolarityをタグ付けし、それらをどれだけ抽出できたかをPrecision / Recall / F1値で評価。
機械翻訳自動評価指標の比較, 今村+, NLP'04
Paper/Blog Link My Issue
#MachineTranslation #Metrics #One-Line Notes Issue Date: 2021-06-25 Comment
BLEUスコア、NISTスコア、WordErrorRate(WER)などに関して丁寧かつ簡潔に解説してある。
BLEUスコア算出に利用するN-gramは一般的にはN=4が用いられる、といった痒いところに手が届く情報も書いてある。
普段何気なく使っているBLEUスコアで、あれ定義ってどんなだっけ?と立ち帰りたくなった時に読むべし。
実際に研究等でBLEUスコアを測りたい場合は、mosesの実装を使うのが間違いない:
https://github.com/moses-smt/mosesdecoder/blob/master/scripts/generic/multi-bleu.perl
[Paper Note] A Formal Model for Information Selection in Multi-Sentence Text Extraction, Filatova+, COLING'04
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Document #Extractive #COLING #One-Line Notes Issue Date: 2018-01-17 Comment
初めて文書要約を最大被覆問題として定式化した研究。
[Paper Note] A Phrase-Based HMM Approach to Document_Abstract Alignment, Daume+, EMNLP'04
Paper/Blog Link My Issue
#DocumentSummarization #Alignment #EMNLP #One-Line Notes Issue Date: 2018-01-15 Comment
AbstractsとSource TextのAlignmentをとるために、Phrase-Based HMMを提案。
Ziff-Davis Corpusのテキストに対して、2人のannotatorによってgold standardを作成。
評価においてMTにおけるIBM Model4やHMM basedな単語アライメント手法と比較しているが、fair comparisonのために行なっている施策が参考になる。
[Paper Note] TextRank: Bringing Order into Texts, Mihalcea+, EMNLP'04
Paper/Blog Link My Issue
#Single #DocumentSummarization #Document #GraphBased #Extractive #EMNLP #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2018-01-01 Comment
PageRankベースの手法で、キーワード抽出/文書要約 を行う手法。
キーワード抽出/文書要約 を行う際には、ノードをそれぞれ 単語/文 で表現する。
ノードで表現されている 単語/文 のsimilarityを測り、ノード間のedgeの重みとすることでAffinity Graphを構築。
あとは構築したAffinity Graphに対してPageRankを適用して、ノードの重要度を求める。
ノードの重要度に従いGreedyに 単語/文 を抽出すれば、キーワード抽出/文書要約 を行うことができる。
単一文書要約のベースラインとして使える。
gensimに実装がある。
個人的にも実装している:https://github.com/AkihikoWatanabe/textrank
[Paper Note] A systematic comparison of various statistical alignment models, Och+, CL'03
Paper/Blog Link My Issue
#MachineTranslation #Tools #One-Line Notes #WordAlignment Issue Date: 2018-01-15 Comment
Giza++
標準的に利用される単語アライメントツール
評価の際は、Sure, Possibleの二種類のラベルによる単語アライメントのground-truth作成も行っている
[Paper Note] Coral: Using natural language generation for navigational assistance, Dale+, Australasian computer science conference'03, 2003.02
Paper/Blog Link My Issue
#NaturalLanguageGeneration #RuleBased #ConceptToTextGeneration Issue Date: 2017-12-31
[Paper Note] WebInEssence: A Personalized Web-Based Multi-Document Summarization and Recommendation System, Radev+, NAACL'01, 2001.06
Paper/Blog Link My Issue
#Multi #PersonalizedDocumentSummarization #DocumentSummarization #Search #Personalization #NAACL #KeyPoint Notes Issue Date: 2017-12-28 Comment
・ドキュメントはオフラインでクラスタリングされており,各クラスタごとにmulti-document summarizationを行うことで,
ユーザが最も興味のあるクラスタを同定することに役立てる.あるいは検索結果のページのドキュメントの要約を行う.
要約した結果には,extractした文の元URLなどが付与されている.
・Personalizationをかけるためには,ユーザがドキュメントを選択し,タイトル・ボディなどに定数の重みをかけて,その情報を要約に使う.
・特に評価していない.システムのoutputを示しただけ.
[Paper Note] Cut and paste based text summarization, Jing+, NAACL'00
Paper/Blog Link My Issue
#DocumentSummarization #Document #NAACL #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-01-21 Comment
AbstractiveなSummarizationの先駆け的研究。
AbstractiveなSummarizationを研究するなら、押さえておいたほうが良い。
[Paper Note] Generating Extraction-Based Summaries from Hand-Written Summaries by Aligning Text Spans, Banko+, PACLING'99
Paper/Blog Link My Issue
#DocumentSummarization #One-Line Notes #WordAlignment Issue Date: 2018-01-15 Comment
文を単位とし、文を文中の単語の出現頻度ベクトルで表し、ベクトル間の距離で文間の類似度を計ることで自由作成要約中の文と現文中の文をもっとも類似度が大きくなるように対応づける。
[Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
Paper/Blog Link My Issue
#DocumentSummarization #InformationRetrieval #Search #SIGIR #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2018-01-17 Comment
Maximal Marginal Relevance (MMR) 論文。
検索エンジンや文書要約において、文書/文のランキングを生成する際に、既に選んだ文書と類似度が低く、かつqueryとrelevantな文書をgreedyに選択していく手法を提案。
ILPによる定式化が提案される以前のMulti Document Summarization (MDS) 研究において、冗長性の排除を行う際には典型的な手法。
[Paper Note] HMM-based word alignment in statistical translation, Vogel+, COLING'96
Paper/Blog Link My Issue
#MachineTranslation #COLING #WordAlignment Issue Date: 2018-01-15
[Paper Note] Automatic condensation of electronic publications by sentence selection, Brandow+, Information Processing & Management'95, 1995.09
Paper/Blog Link My Issue
#Single #DocumentSummarization #Document #Extractive #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-01-01 Comment
報道記事要約において、自動要約システムがLead文に勝つのがhardだということを示した研究
[Paper Note] A Trainable Document Summarizer, Kupiec+, SIGIR'95
Paper/Blog Link My Issue
#DocumentSummarization #Document #Supervised #Extractive #SIGIR Issue Date: 2017-12-31
[Paper Note] Using natural language processing to produce weather forecasts, Goldberg+, IEEE Expert: Intelligent Systems and Their Applications'94
Paper/Blog Link My Issue
#NaturalLanguageGeneration #RuleBased #DataToTextGeneration #KeyPoint Notes Issue Date: 2017-12-31 Comment
## タスク
天気予報の生成,システム名 FOG (EnglishとFrenchのレポートを作成できる)
## 手法概要
ルールベースな手法,weather predictinon dataから,天気予報を自動生成.Text Planner がルールに従い各sentenceに入れる情報を抽出すると同時に,sentence orderを決め,abstractiveな中間状態を生成.その後,中間状態からText Realization(grammarやdictionaryを用いる)によって,テキストを生成.
[Paper Note] The Identification of Important Concepts in Highly Structured Technical Papers, ACL-SIGIR'93
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #ACL #SIGIR #One-Line Notes Issue Date: 2023-05-13 Comment
ユーザは自分が興味があるpartをsummary evaluationにおいて選択する傾向にある、ということを示した研究
[Paper Note] Design of a knowledge-based report generator, Kukich, ACL'83
Paper/Blog Link My Issue
#NaturalLanguageGeneration #RuleBased #DataToTextGeneration #ACL #KeyPoint Notes Issue Date: 2017-12-31 Comment
## タスク
numerical stock market dataからstock market reportsを生成.システム名: ANA
## 手法概要
ルールベースな手法,
1) fact-generator,
2) message generator,
3) discourse organizer,
4) text generatorの4コンポーネントから成る.
2), 3), 4)はそれぞれ120, 16, 109個のルールがある. 4)ではphrasal dictionaryも使う.
1)では,入力されたpriceデータから,closing averageを求めるなどの数値的な演算などを行う.
2)では,1)で計算された情報に基づいて,メッセージの生成を行う(e.g. market was mixed).
3)では,メッセージのparagraph化,orderの決定,priorityの設定などを行う.
4)では,辞書からフレーズを選択したり,適切なsyntactic formを決定するなどしてテキストを生成.
Data2Textの先駆け論文。引用すべし。多くの研究で引用されている。
Introducing Aikido Altar: the model that makes sovereign security intelligence possible, aikido, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Pruning #Quantization #Blog #OpenWeight #Security #Author Thread-Post Issue Date: 2026-10-02 Comment
元ポスト:
Olmo-core: Building blocks for OLMo modeling and training, AI2, 2024.06
Paper/Blog Link My Issue
#Article #LanguageModel #MoE(Mixture-of-Experts) #Initial Impression Notes #Author Thread-Post #TrainingFramework Issue Date: 2026-10-02 Comment
元ポスト:
pytorchによる大規模な分散学習を実現するためのフレームワークで、trillion級のMoEモデルが学習できるような機能を追加したv3.0.0がリリースされたとのことである。
DiffusionGemma-as-Jev, Matt Mastracci, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #DiffusionModel #LLMServing #Post #Author Thread-Post #SystemOneModel Issue Date: 2026-10-02 Comment
vLLMのPR番号57250でマージされ、DiffusionGemmaをJev-likeに利用するための機能がプロトタイプとして実装されているようでえる。
Google Gemmaからも引用されている:
Introducing Clef: our open-source decision models, and new RL fine-tuning platform, Cloudflare, 2026.10
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #LanguageModel #MultiModal #Blog #PEFT(Adaptor/LoRA) #OpenWeight #Selected Papers/Blogs #Encoder #KeyPoint Notes #SystemOneModel Issue Date: 2026-10-02 Comment
元ポスト:
概要しかブログ中には書いていないが、よさげに見える。
Qwen-3.8-27Bをバックボーンとし、Qwenのパラメータはフリーズした上で軽量なアダプタを学習し、ルーティングヘッドなるcross-attentionに基づいた各選択肢のスコアを出力するヘッドによって予測が実施されるようである。
これらは、内部で作成された合成データを用いて事後学習されたとのことである。lossはlabel smoothed cross entropy(正解、不正解ラベルを0/1としてクロスエントロピーを計算するのではなく、ハイパーパラメータεでスムージングしてlossを計算するものらしい)とBrier Loss(実際に予測された確率値と正解、不正解を1/0としたときの平均二乗誤差)なるものによって、正則化によって過学習を防止し、出力される確率値がでたらめにならないように学習することを目指しているように見える。
その後RLCDと呼ばれる、選択肢間の順序関係に基づいて、正解と隣接するラベルにも部分的に報酬を与えるようなrewardを持つ(オリジナルのポリシーから分布が大きくシフトしないようなペナルティ付き)RLによって学習をしているようである。これにより、より高いAccuracyと汎化性能が得られた、と一言記述されている。
Qwenが持つVision Encoderによって画像もエンコードでき(Jevは画像は不可と述べられている)、
context長が64kとJevの2倍で
Jevよりもlatencyが良く、
様々なベンチマークスコアで高いスコアを獲得としている、と報告している。
latencyはflashモデルであれば、DiffusionGemma-as-Jevを上回る。
[Paper Note] AutoBenchmark: benchmark creation & the role of humans, Seungone+, 2026.09
Paper/Blog Link My Issue
#Article #Dataset #AIAgents #Evaluation #read-later #Selected Papers/Blogs #autoresearch/RSI #Author Thread-Post Issue Date: 2026-10-01 Comment
元ポスト:
Gemini 4 Argon: our next era of frontier intelligence, Google, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Proprietary #VisionLanguageModel Issue Date: 2026-10-01 Comment
元ポスト:
Geminiがcome back?
Decision models, SGLang, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #MultiModal #Blog #LLMServing #VisionLanguageModel #One-Line Notes #Reading Reflections #SystemOneModel Issue Date: 2026-09-30 Comment
元ポスト:
SGLangにおいて、Qwen3.8-27B、およびQwen3.5-35B-A3Bを、chat modelからdecision model(System Oneな分類モデル)として利用するためのエンドポイントが追加されたようである。
ドキュメントを読むと、要は既存のLLMに対してリクエストをreasoning modeをオフでprefillし、応答のトークン位置でのスコアリング、選択肢、yes/noのトークンのlogprobを取得し、たとえばyes/noトークンのprobabilityを計算する場合はyes/noの2 vocabularyのsoftmaxを計算する。つまり、単に通常のLLMの応答の開始位置でのラベルのlogprobを取得して、最もlogprobが高いラベルを返し上述の確率を返すというシンプルな実装に見える。
System Oneモデル向けの追加のチューニングや、分類headなどが学習されているわけではない(SGLangはLLM Servingエンジンでありモデルの学習そのものはしないだろうから、そりゃそうだ、という話だった)点に注意。シンプルに、LLMのデコード開始位置でのlogprobを用いた分類器であり、これを念頭におけば、このエンドポイントを利用した場合のおおよその性能の見当はつく(性能が悪いと言いたいわけではなく、これまでのLLM利用の経験からあたりをつけやすいという意図である)。
System One系の話は実装の中身を確認して、どのような原理の元駆動するかを確認しないと、足元をすくわれる気がする。外から見た時の挙動は同じでも、アーキテクチャが結構異なる気がする。あと、アーキテクチャだけでなく、System Oneモデル向けのデータや最適化がされているかによって、そもそもの予測性能やzero-shotでの汎化性能にかなり差が生まれるのではないか、と思っている。しかし、まあ結局自分たちのユースケースに対して必要な性能が出ていて、latencyが必要な水準に達しているかを確認すれば良いだけではある。
DeepGEMM Ascend, DeepSeek AI, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Library #AIAgents #GPUKernel #Author Thread-Post Issue Date: 2026-09-30 Comment
元ポスト:
所見:
DeepSeekGEMMと呼ばれる、NVIDIA GPU向けに構築されたGPUカーネルライブラリをHuawei Ascend NPU向けに移植したもので、APIがDeepSeekGEMMと互換性があるため、同じpythonコードから動作させることができるようである。
一言解決:
Halo: Frontier-Lab Training for Everyone, White Circle, 2026.09
Paper/Blog Link My Issue
#Article #Multi #ComputerVision #EfficiencyImprovement #Pretraining #Tools #LanguageModel #ReinforcementLearning #AIAgents #MultiModal #Blog #mid-training #DPO #PostTraining #Parallelism #VisionLanguageModel #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-09-29 Comment
元ポスト:
dlab Open Source Week: Frontier AI on Your Own Hardware, Tim Dettmers, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Test-Time Scaling #Selected Papers/Blogs #DeepResearch #Compression #Reading Reflections #autoresearch/RSI Issue Date: 2026-09-29 Comment
元ポスト:
前半にオープンソースにするエコシステムとして
- エージェントのcontextの自動圧縮技術
- autonomous research
- 効率的なtest time scaling手法
- Deep Research
などの開発中におけるエピソードや、その性能の高さについて述べられている。
一方、記事全体で述べられている気持ちは博士課程在籍者(やアカデミアにいる研究者に)対するメッセージである。個人的に印象深かったのは、研究のunitが論文ではなく一貫性のあるエコシステムを構築することになる、という主張と、博士課程において容易に解決することができない課題に粘り強く取り組む力を身につけることは投資をする価値がある、という部分で、第一線の研究者の方がAI Agentによる研究環境の変化をどう捉えているかが少し垣間見えるのと、(現在の悲観的な博士課程の学生に対して)博士課程で学ぶことの価値やアカデミアだからこそなし得ることがメッセージングされており、非常に興味深く拝読した。
要約を読んだりするよりも、原文から伝わる気持ちを汲み取った方が良いと思う(という意味で原文全文を読んだ方が良いと思う)。
KDA Doesn't Care About the Future, Nuggets, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Attention #Blog #read-later #LinearAttention Issue Date: 2026-09-28 Comment
元ポスト:
tokenizers v1: encode, decode and scaling, measured, HuggingFace, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog #Tokenizer #read-later #Initial Impression Notes Issue Date: 2026-09-28 Comment
元ポスト:
関連:
- {G}igatoken: SIMD and Cache Hierarchies for 1000x Faster Byte-Pair Encoding Tokenization on Modern CPUs, Marcel R{\o}d, 2026.07
Gigatokenは、著者ポストを読む限り、そもそも今のtokenizerが1秒単位に処理できるデータ量(データレート)が、同様の規模感のデータを処理する際の他の実装、たとえばsimdjsonがGB/sなのに比べて遅すぎるという気持ちから端を発しているように思われる。
一方、tokenizersでは、イントロに膨大なデータセットでの学習、同時リクエストの処理、long contextでの処理等において、モデルへのデータ供給が追いつかず、tokenizerが新たなボトルネック(GPUを待たせるという意味で)になりつつあり、それを解決したいという気持ちが記述されている。
The current balance of power in open models: The expanded form of a testimony I prepared for Congress., Interconnects, Nathan Lambert, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #GenerativeAI #Blog #OpenWeight #Proprietary #read-later Issue Date: 2026-09-28 Comment
元ポスト:
How much AI revenue comes from open vs closed models?, Konstantin F. Pilz, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #GenerativeAI #Post #One-Line Notes Issue Date: 2026-09-28 Comment
主要なクローズドモデル、オープンモデルを提供する企業の(おそらくLLM周りの)ARRを比較したところ、オープンモデルのARRはクローズドモデルのARRの10%程度と推察される、という話に見える。
が、オープンモデルのプロバイダーに対して、古いデータが使われている(プロバイダーによっては、usageが数倍〜10倍になっている)という指摘と、Googleの売上に対するAIの間接的な貢献「軽視しすぎている、という指摘がある。
あと、一部からClaudeに作成させ、検証をせずに読者側に検証の手間を委ねるのはいかがなものか、という趣旨の批判がある。
Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation, Qwen Team, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #TextToImageGeneration #Blog #OpenWeight #Editing #ImageSynthesis #Author Thread-Post Issue Date: 2026-09-27 Comment
HF: https://huggingface.co/Qwen/Qwen-Image-2.1
元ポスト:
GLiNER2.5-Decide: An Open-Weight Model for Structured Decision Making, Fastino Labs, 2026.09
Paper/Blog Link My Issue
#Article #Blog #OpenWeight #Encoder #Author Thread-Post #SystemOneModel Issue Date: 2026-09-25 Comment
元ポスト:
Jev-likeなモデル、乱立しすぎである
When does distillation help reinforcement learning?, Base Labs, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #Distillation #PostTraining #read-later #One-Line Notes #Author Thread-Post Issue Date: 2026-09-25 Comment
元ポスト:
RL前にSFTを通じてオフポリシー蒸留をすることが、どれだけ後段のRL後のパフォーマンスに影響するかを調査したようで、
- 小規模モデルには効果的だが大規模なモデルには効果が薄く
- ベースモデルに存在しない慣習や理解を必要とするタスクに対して効果的で
- 副作用としてポリシーのエントロピーが低減する、すなわちRL中の探索が抑制される
といった知見が得られたようである。
一見すると、SLMに関しては
- [Paper Note] A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility, Andreas Hochlehnert+, COLM'25
と対立する知見に見えるが、前提として何が違うだろうか。
SLMに対しては同様の知見が示されている:
- [Paper Note] AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, Zihan Liu+, arXiv'25, 2025.06
LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond, Liquid AI, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Blog #OpenWeight #VisionLanguageModel #SpeculativeDecoding Issue Date: 2026-09-25 Comment
元ポスト:
FineEnvs: Open Source RL Environments for LLM Agents, Adithya S Kolavi, 2026.09
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #ReinforcementLearning #Repository #SmallModel #PostTraining #One-Line Notes #Environment Issue Date: 2026-09-25 Comment
元ポスト:
SLMのcoding, datascience向けの
(いわゆるSmolな)RL学習用の5k+のverifiableなタスクデータ、Environment、評価、学習のコードを提供。
従来の初心者向けのチュートリアルでは、GSM8Kのような既に飽和したデータセットが主なデータであり、より実用的なデータに基づいたRLVRのための環境を整えた、という感じに見える。
When Do Larger Batches Help Scale LLM Reinforcement Learning?, Tencent RL Team, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #Blog #PostTraining #Selected Papers/Blogs #One-Line Notes #CriticalBatchSize Issue Date: 2026-09-24 Comment
元ポスト:
目標性能まで到達するまでに必要なwall-clock timeとLLMでのオンポリシーRLのバッチサイズの関係性を明らかにしているようである。
LLMのオンポリシーRLでは、生成と学習においてバッチサイズの大きさが非対称に働く(すなわち、生成側の並列数を増やすとモデルの重み転送をより多く共有できるため処理に要する時間が短縮されるが、学習側でバッチサイズが増えると処理時間は増加する)ため、生成側の並列数の変化によるスループットの向上と、学習側のバッチサイズによる更新に必要なサンプル数の両方を考える必要がある。
このとき、目標性能に到達するまでに必要な累積応答数N(学習側)、エンドツーエンドのスループットq(生成側だけではなくシステム全体)を考える。
これにより、バッチサイズを変化させた時に必要なサンプル数の変化の比率r_N (=N/N_pivot, r_Nが1より大きい場合は、新たなバッチサイズが基準となるバッチサイズよりも、ある性能に到達するまでより多くの応答を必要とする)、
スループットの変化の比率r_q(=q/q_pivot, r_q>1の場合は、1秒あたりにより多くの応答を処理できる)を定義でき、
r_q > r_Nの場合、すなわち、バッチサイズを大きくしたことによる、システムのエンドツーエンドのスループット向上による恩恵が、学習側のサンプルコストの悪化を上回った場合に、バッチサイズを大きくすることで学習が高速化される、このときの改善の度合いは r_N/r_q で測ることができる。例えば、r_N/r_q=0.8の場合、学習時間が20%削減されることを意味する、といったフレームワークを定義でき (The criterion部分を参照)、
実践的には、
- 候補となるバッチサイズについて、学習率や関連するハイパーパラメータを調整し、学習に利用される応答単位での学習に対する寄与を揃え、累積応答数が等しい点での学習曲線を比較することで、r_Nを推定し
- 与えられたバッチサイズにおいてシステムのスループットを最大化する設定を探索し、r_qを測定する
- その上で、r_N/r_qを測定し、最も学習時間が短縮されるバッチサイズを採用する
というプロセスにおとしこむことができる(conclusionを参照)
という感じの話のようにみえる。
grug-moe-mix-swarm, marin-community, 2026.08
Paper/Blog Link My Issue
#Article #Pretraining #Dataset #LanguageModel #MoE(Mixture-of-Experts) #Selected Papers/Blogs #DataMixture #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-09-24 Comment
元ポスト:
Marinの535B級のMoEモデルを学習した際のデータであり、利用されたツール(クラスタリングに利用されたモデル)も公開されている。
元ポスト中にデータ構築の手順が紹介されており、
- 学習が許可された152の公開データから、25Tトークンを利用
- deduplicationによる2.13T tokensを除外し
- 評価データとの重複を避けるために13-gramによるフィルタリングを実施し
- 特定の分野のデータ等をサンプリングしたいが、その際にソースではなくドキュメントの内容でグルーピングしたいので、embeddingに基づいてクラスタリングを実施し、200のクラスタを形成した
といった話が紹介されている。
LLM-jpではOpenSourceであるために、徹底的にデータセット内部まで精査をして、問題のあるインスタンスの修正等が実施されていたが、Marinではこのような取り組みは行われているのだろうか。特に、データセットに付与されているライセンスがオープンソースである場合でも、データセット、あるいはデータセット中のサンプルの出自を辿るとオープンソースとは呼べないものが存在するという話がある。
- 約12兆トークンの良質なコーパスで学習した新たな国産LLM「LLM-jp-4 8Bモデル」「LLM-jp-4 32B-A3Bモデル」をオープンソースライセンスで公開 ~一部ベンチマークでGPT-4oやQwen3-8Bを上回る性能を達成~, NII, 2026.04
- LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Marinコミュニティにおける"Open"の意味を読むと、Open Sourceの定義を満たすことを目指しているというより、weightを公開するだけではなく、その他の構築に関わる全ての情報を公開する、たとえば学習データであれば全データのソースを開示する、という開発プロセス全体を公開しますよ、という意味に見えるため、ライセンス的に問題のあるインスタンスの削除などは行われていないのかもしれない、が、Marinプロジェクトの公開されている全ての議論の中にそういった話題は存在するかもしれないので実際のところは一次ソースを当たらないとよくわからない。
https://marin.community
Contrastive Language Models: A System One Model for Fast and Generalizable Decision-Making, Kwok+, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #Dataset #ContrastiveLearning #Blog #OpenWeight #Scaling Laws #mid-training #PostTraining #Selected Papers/Blogs #Encoder #Author Thread-Post #SystemOneModel Issue Date: 2026-09-24 Comment
元ポスト:
HF: https://huggingface.co/Contrastive-LM
非常にコンパクトにまとまっていて大変読みやすかった。あとでまとめる。
Step Code, StepFun, 2026.09
Paper/Blog Link My Issue
#Article #Tools #LanguageModel #AIAgents #Coding #SoftwareEngineering #Initial Impression Notes #Author Thread-Post #AgentHarness Issue Date: 2026-09-23 Comment
元ポスト:
高いトークン効率を持つStepFun製のターミナル向けのコーディング用Agent Harness
Rigel Base: Reaching Llama-3.2 Quality with <1% of its Compute, Mayank+, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #LanguageModel #Blog #OpenWeight #SSM (StateSpaceModel) #read-later #DataMixture #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-23 Comment
NoPEやuPを利用、事前学習では6つのフェースで異なるDataMixtureを利用しそのレシピも記載
On-Policy Distillation: Full-Vocabulary KL vs. Sampled Trajectory RL, Bhavin Jawade, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #ReinforcementLearning #Distillation #Post #PostTraining #read-later #On-Policy Issue Date: 2026-09-23
Introducing GPT‑6 Sol and Luna, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes Issue Date: 2026-09-23 Comment
元ポスト:
luna, solに関しては、AA Index上では大きな変化はないように見えるが、コスト性能比が改善しているように見える:
5.6-luna, solと比較するとコストが約半額となっている。やーすい
Introducing Claude Opus 5.5, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Reference Collection Issue Date: 2026-09-23 Comment
元ポスト:
KernelBench-MegaのRTX PRO 6000向けにKimi Linearのデコード向けのメガカーネルを記述するベンチマークでAstraを超えてSoTAを達成したようである:
所見:
所見:
GPTはeffortの増加に従い単調増加だが、Claude系はそうならない
Introducing MiMo-V2.6 series, Xiaomi, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #read-later #Selected Papers/Blogs #Reference Collection #Author Thread-Post Issue Date: 2026-09-23 Comment
HF: https://huggingface.co/collections/XiaomiMiMo/mimo-v26
元ポスト:
所見:
Mimo-2.6はSWA+GQAのシンプルなアーキテクチャであり、それでOpenWeightモデルでSoTAを達成しており、進歩の多くはデータと事後学習のレシピの改善によってもたらされているという主張。
DeepSeekでも同じような報告がされている:
- DeepSeek-V4.1-Flash, DeepSeek AI, 2026.09
事前学習でも以下のような話はある:
- Pretraining progress is mostly coming from data, DWARKESH PATEL AND JERRY HAN, 2026.09
関連:
- We are streaming our RL big runs. The mimo-v2.6 series is coming soon, Xiaomi Mimo Team, 2026.09
開発者の方のポスト:
所見:
AA IndexでGPT-5.6-Solと同等性能を達成し、7kのRL dataとフレームワークをオープンにする予定とのこと。
所見:
解説:
- MAI-Thinking-1: Building a Hill-Climbing Machine, Microsoft, 2026.06
もあわせて読みたい
Reinforcing Agents with Collective Skills, Xu+, 2026.09
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #ReinforcementLearning #AIAgents #Environment #Author Thread-Post Issue Date: 2026-09-23 Comment
元ポスト:
dataset, env: https://hub.harborframework.com/datasets/skill2env/skill2env
Computational depth is all you need: Towards 107-layer neural nets, Akshay Vegesna, Samip Dahal, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #Scaling Laws #read-later #Depth #Author Thread-Post Issue Date: 2026-09-23 Comment
元ポスト:
Measurements for understanding the pace of AI development inside frontier labs, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #AIAgents #Evaluation #Blog #SelfImprovement #autoresearch/RSI #Author Thread-Post Issue Date: 2026-09-20 Comment
元ポスト:
所見:
Jev Reproductions Tracker, multimodalart, 2026.09
Paper/Blog Link My Issue
#Article #Survey #Author Thread-Post #SystemOneModel Issue Date: 2026-09-20 Comment
元ポスト:
Introducing Astra for Law, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Proprietary #Legal #Author Thread-Post Issue Date: 2026-09-20 Comment
元ポスト:
Step 5 Preview: Advancing the Pareto Frontier, StepFun, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #Author Thread-Post Issue Date: 2026-09-20 Comment
元ポスト:
StepFunのフラグシップモデルで、Fable 5, GPT-5.6-luna, GLM-5.3、Kimi-K3と並びAAの評価においてパレート最適に位置する。
600B-A27B, 1M contextのVLM, 10/15にOpenWeight化されるとのこと。
decider-2b, Mapika, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #SmallModel #OpenWeight #reading #One-Line Notes #Reading Reflections #SystemOneModel Issue Date: 2026-09-20 Comment
元ポスト:
こちらはJev系のモデルを謳うものと比較して、Qwenをベースにしており、かつ広範なタスクで評価がされているため、ある程度のzeroshotでの汎用モデルとは言えそうである。が、結局のところどこまで汎用的に使えるかはよくわからない。
関連:
- Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure, Z.ai, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Infrastructure #AIAgents #Blog #SelfImprovement #SoftwareEngineering #Initial Impression Notes #autoresearch/RSI Issue Date: 2026-09-19 Comment
元ポスト:
GLM開発におけるRSIよ初期の事例
cua-s1-forms, cua-ai, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Dataset #Transformer #SyntheticData #OpenWeight #ComputerUse #Encoder #One-Line Notes #Author Thread-Post Issue Date: 2026-09-19 Comment
github:
https://github.com/trycua/cua/tree/main/libs/cua-s1
dataset:
https://huggingface.co/datasets/cua-ai/cua-s1-forms
元ポスト:
フォーム入力に特化したCUAを実施できるモデルのようで、これもいわゆるSystem One Modelとして紹介されている。Transformer Encoderをバックボーンとする。
まあしかしこれは言ってしまえばただの合成データでFinetuningをしたBERTに見える。Jevのような様々なタスクに対してzero-shotの汎化をしめすものではないであろう点に注意。Jevがどれだけ汎用なのかはわからんが...
laya, convaiinnovations, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #MultiLingual #OpenWeight #Encoder #One-Line Notes #Reading Reflections Issue Date: 2026-09-19 Comment
元ポスト:
state (email, text, ticket, あるいはJSON)を与え、質問のタイプとinstruction(choice, score, noul)を与えると、質問に対応する出力を得られるModernBERTベースのモデル。questionあたり512トークンまで扱えるようである(state, question, optionの合計で512トークン)。RLCDと呼ばれるポリシーがdistributionを出力する手法で学習され、この手法はhonest probabilityを出力することで機体報酬が最大化されるとの記載がある。100+言語に対応。
emailのサンプル例は、ユーザからの問い合わせに対して、担当部署(choice)、緊急度(score)、解約の確率(noul)を出力する例となっている。
関連:
- Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
これ系の話がいきなり増えてきた。マルチリンガルでモデルがオープンなのはありがたや。
最初読んだ時は様々なタスクやドメインに利用できるのかなと思ったが、emailドメインにしか適用できないのでは?zero-shotで汎用的に利用できないのであれば、それはただのFinetuningされたBERTである。
Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Transformer #Blog #SmallModel #Proprietary #Architecture #Selected Papers/Blogs #One-Line Notes #ToolUse #Author Thread-Post #SystemOneModel Issue Date: 2026-09-19 Comment
元ポスト:
チャットをせず、各ターンごとに関数呼び出しに特化したedge向け小型モデルとのこと。アプリが利用するツール群を渡し、ユーザの発言に基づいて全ての引数を埋めて関数を呼び出す、あるいはスキーマを与えればそのスキーマに則った出力を返し(構造化出力)、推測はしない(関数の範囲外のものは空出力)というもののようである。
これらは、simple attention networkと呼ばれるもので実現される。simple attention networkはtransformerからFFN Layerをを無くし軽量なHadarmard MLPというlayerに置き換え、FFNが従来保持していた知識に関する情報はengramによって、n-gram embedding側に持たせることによって高速、軽量化がじつげんされているようである。residual streamとしては、mHCが用いられているようである。
また、デプロイ時にモデルの深さを指定することで、20個あるうちのどのlayerを利用するかが決まり、性能とコストを調整できるようである。これを公式ポストではIntelligence Laddersと呼称している。
関連:
- [Paper Note] Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, Xin Cheng+, arXiv'26, 2026.01
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
関連:
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
と思想が似ている。
Jev’s Architecture Unmasked, Archer Hume, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #AIAgents #Blog #Coding #SoftwareEngineering #Author Thread-Post Issue Date: 2026-09-18 Comment
元ポスト:
関連:
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
果たして
Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint, PrismML, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Quantization #Blog #OpenWeight #ComputerUse #Selected Papers/Blogs #reading #One-Line Notes #Author Thread-Post Issue Date: 2026-09-18 Comment
元ポスト:
HF: https://huggingface.co/collections/prism-ml/bonsai-2
関連:
- Announcing Bonsai 27B: The First 27B-Class Model to Run on a Phone, PrismRL, 2026.07
ternary weight (1bit)の重みで動作するBonsaiシリーズのメジャーアップデートで、Qwen-3.8-27Bをベースにしており、ベンチマークスコアの98.2パーセントを保持しつつ、1/9程度に利用メモリが節約されるようである。Computer Useも可能で、ローカルのRTX 5090でBrowser Useするデモが掲載されている。
【ノーカット】AIに関わる米中戦争と日本の現状 国立情報研 佐藤教授, 時事通信映像センター, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #Alignment #AIAgents #GenerativeAI #FoundationModel #Safety #Video #Selected Papers/Blogs #VisionLanguageModel #Robotics #WorldModels #VisionLanguageActionModel #EmbodiedAI #Reading Reflections #WorldActionModel Issue Date: 2026-09-18 Comment
非常におもしろかった...色々と考えさせられるなあ。
特にフィジカルAIにおいて、中国は人海戦術で、(簡単な動作を学習できたら複雑な動作を実現することにつながるという仮説の元)非専門家の簡単な動作に関するデータを大量に収集し、最近では仮想環境でデータを合成し活用する動きがある(Sim-to-Real)に対して、日本の場合は、特定の企業の現場のデータを収集しようとする動きがある。(このような文脈において、日本の政策として考えた場合に)特定の企業が有する現場のデータは、その現場特有の特徴が入り込むから実はロボットの学習データに向いていない、という話は、なるほど、と思うなどした。
たとえば、
- [Paper Note] Open X-Embodiment: Robotic Learning Datasets and RT-X Models, Open X-Embodiment Collaboration+, arXiv'23, 2023.10
- [Paper Note] LeRobot: An Open-Source Library for End-to-End Robot Learning, Remi Cadene+, ICLR'26, 2026.02
のように、多様なデータを統一された枠組みで学習をすることで汎化することを狙うという戦略の場合は、現場データの現場特有のバイアス問題はどの程度緩和されるのだろうか。
- Superposition, Memorization, and Double Descent, Transformer Circuits Thread, 2023.01
のDouble Decentのような議論を考えると、同じ種別のデータで、きちんと多様なデータが集まっていれば、現場固有のバイアスが含まれていても汎用的な特徴量としては学習されずらい、という現象は起こるように思える。
また、仮想空間と実世界のgapもあるようで、視覚的なgapは合成データ等で埋め合わせがある程度できそうな一方で、触覚や力感のような繊細な部分や、物理的なセンサーのノイズや、実際のデバイスの物理的な個体差のようなものは、仮想空間上では再現しづらいという話もあるようである。
ただ、なんとなーく、まず汎用的なモデルを学習して基礎的な動作(LLMで言うところのatomic skill)を満足にできる基盤モデルを用意し(これはおそらく仮想空間や非専門家データで足りる)、その基盤モデルはin-context learning能力を備えていて、現場のロボットに適用する際にはfew-shotのdemonstrationや、ルーブリックのようなものを与えて制御する、というのでうまくいくシナリオは起きそうな気がしており、そうなると大量の現場データは必ずしも必要ではなさそうだよね、という気はする。
ただし、日本が人海戦術をとれないのであれば、汎用基盤モデル→現場での適用、というレールの上に乗るのであれば、直接的に汎化させるには専門的すぎる現場のデータが与えられたときに、そこからどのようにして汎用的な基盤モデルを学習できるのか、というところがうまくいけば、ある程度形になるのではなかろうか、と思うなどした。
An alignment assessment of recent cybersecurity incidents, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Alignment #Blog #Safety #Security #Monitorability Issue Date: 2026-09-17
Lean Verified Transformers, Sasha Rush, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #Transformer #Blog #Selected Papers/Blogs #reading #One-Line Notes #Proofs #Reading Reflections #Author Thread-Post Issue Date: 2026-09-17 Comment
元ポスト:
証明のコストが下がることによって、Leanによって型式的な証明をされたML Codeの価値が高まるのではないかという筆者の予測と、
一方で、証明を全て理解することは依然として困難という課題があるのとに言及し、
落とし所として人間にとって理解しやすい(部分的に証明したい)数学的な性質を選択的にAIによって証明するという試みをやってみよう、
そのために、Transformerを例に、Transformerの最適化や効率化の礎となっている数学的な性質を実際にLeanを用いて型式的に証明し理解してみよう、その結果、たとえば、VanillaAttentionとFlashAttentionが数学的に等価だということも示せる、
このような証明したい性質が何であるかを人間が選び、証明を得られることになった変化は重要であり、これらを今後どう活用するかということは今後の挑戦だよね、という話が書かれているようである。
実際に駆動するML Codeで、特定のモデルが実装されているときに、そのモデルが本来備えるべき重要な数学的性質を満たす実装になっていることが、型式的に証明された上で公開され、型式的に証明済みのbadgeがリポジトリに付与されている、みたいな未来が来るのだろうなあ
We are streaming our RL big runs. The mimo-v2.6 series is coming soon, Xiaomi Mimo Team, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #AIAgents #Blog #PostTraining #Selected Papers/Blogs #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-09-17 Comment
元ポスト:
リアルタイムでMimoのRLの学習の経過が公開されている。おもしろい
コストの試算:
Mimo, 1T-A42Bの場合、RL 1stepあたり1000万円程度かかっているようだ。
おそらくインフラは高度に最適化されている。
現時点で2モデル合計でコストが約300万ドルに到達し、日本円にして約4.7億円(ドル円157円換算, pro 68B / flash 81B Tokens)🙄DeepSWEやコーディング系のベンチは順調にスコアが向上している。また、noticesに記載されているインシデントの報告が興味深く、インフラ周りのエラーや、学習に悪影響を与えるタスクやデータセット単位での除去なども情報共有されており大変興味深い。PostTrainingデータセットなどMixtureも公開されている。
Scaling laws in large language models and toy models, Nicolas Zucchet, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Slide #Scaling Laws #Selected Papers/Blogs #reading #Author Thread-Post Issue Date: 2026-09-16 Comment
元ポスト:
Introducing System One Models & Jev, TypeSafe AI, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #AIAgents #Blog #Coding #SoftwareEngineering #Selected Papers/Blogs #reading #KeyPoint Notes #Reference Collection #Reading Reflections #SystemOneModel Issue Date: 2026-09-16 Comment
細かいことは全くわからないが、LLMのようなチャットモデルは超人的な性能なのになぜAGIに繋がっていないのかが常々疑問で、code+AIに特化したモデルを開発したとのことで、それはどのようなものかというと、
LLMは人間の好みとなる応答を返すように、autoregressiveにテキストを生成するが、
本ブログで紹介されているシステムSystemOneは意思決定に最適化し、並列で生成され、自由なテキストを返せないが構造化出力を高速かつ安価に生成可能で、キャリブレーションされた確信度を常に返す、
というもののようである。
着眼点はとてもおもしろいのだが、どの程度高度な推論をすることができるのだろうか?
現代では高度な推論は計算コストである程度賄っているため、安価で高度な推論もできるのでれば大きなブレイクスルーだが、その技術はLLM側にも適用できる可能性があり、結局いつかLLM側に追いつかれる、という可能性がある。
逆に高度な推論ができないのであれば、適用可能なスコープは限定的となる。
RLCDという技術はすでに先行事例があったようだ:
利用規約でJevに関するベンチマークスコアや性能を公開することが禁止されているようである:
所見:
JamC-QAのスコアは(GPT-5.6-lunaより)低く、日本特有の知識などには弱い可能性がある:
- 『JamC-QA』: 日本の文化や風習に特化した質問応答ベンチマークの構築・公開(前編), SB Intuitions, 2025.09
色々な動向を鑑みるに、Encoderか、Decoderかはさておき(利用者から見たらどちらでもよい気がするので)、
- zero-shotで様々なタスクに利用可能で
- latencyが非常に速くて
- コストが安価なモデル
という3つの要素が重要に思える。
chatはできないが、構造化出力/関数出力等が可能(なことで様々な分類タスク等に適用できる)というのは、latencyの速さとコストの安価さを得るための手段。エンコーダ、デコーダも手段の話。
過去にPFNがJevに相当する機能を開発しサービス化までしていた、という話がある(関連技術は幅広く特許を取得しているようである)。
なぜ需要を掘り起こせなかったのか、という点は考えてみるとおもしろいのかもしれない。
個人的にはいまJevが流行っぽい兆しを見せているのは、時期的なものが大きい気がしており、
- (Reasoningモデルの台頭によって) LLMのlatencyが悪い
- 多くのワークフローに組み込む場合に得たい出力が(おそらく)構造化出力(で、めちゃめちゃ賢い判断はそこまで必要とされない)
- モデルのトークン利用料が増加し、(おそらく)運用コストが課題となってきた
という課題に世の中が直面し始めて、課題感として持たれ始めていること、が背景としてある気がしており、ちょうどタイミング的に「安い、速い、(そこそこ)賢い」のJevが世の中に刺さったのではないか、という気がしている。
AI Infrastructure at Periodic, Periodic Labs, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Infrastructure #ReinforcementLearning #AIAgents #Blog #LLMServing Issue Date: 2026-09-16 Comment
元ポスト:
AHA LOOPED TRANSFORMER: Think deeper. Find your Aha. An open atlas of recurrent computation, adaptive depth, and latent reasoning., Yue Su, 2026.09
Paper/Blog Link My Issue
#Article #Survey #Transformer #Blog #Architecture #RecurrentModels #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-16 Comment
有志を募って、looped transformerに関する論文に関する情報を収集しているようである。submitするぞ!
元ポスト:
[Paper Note] FLASHREINFORCE: CRITIC-FREE SINGLE-ROLLOUT ASYNCHRONOUS RL FOR AGENTIC LANGUAGE MODELS, Hu+, ResearchGate, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #AIAgents #PostTraining #read-later #Selected Papers/Blogs #Asynchronous Issue Date: 2026-09-15 Comment
元ポスト:
解説:
CubeSandbox, Tencent, 2026.09
Paper/Blog Link My Issue
#Article #Tools #LanguageModel #AIAgents #One-Line Notes #Security #Author Thread-Post #SandboxEnvironment Issue Date: 2026-09-15 Comment
元ポスト:
AI Agentのためのサンドボックス環境を構築できるツールのようで、独立したカーネルを用いたサンドボックス環境が高速に可能で、secureでスケーラブルである、ということのようである。
万字长文带你读懂 RSI(自进化,Self-Evolving), 发布于, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #AIAgents #Blog #SelfImprovement #KeyPoint Notes #autoresearch/RSI Issue Date: 2026-09-14 Comment
元ポスト:
中国語が読めないので、LLMの力を借りながら読んでいるが、RSIについての定義と、RSIに関する研究を整理、分類するためのTaxonomyを複数の軸から整理しているようである。以下LLMの力を借りて読んだ内容を自分の言葉も交えてメモとして残す。
---
RSIとは、Agentが環境との相互作用から得たタスク軌跡とフィードバックを利用して、自身の状態を更新し、更新後の状態を後続タスクに活用すること、と定義しているようである。
かなり広めの定義に見えるが、ざっくり言うとこのような定義になるのは、管理人の理解でもそうだと思う。
Agent = Model + Harness と捉え、RSIの何を変えるのか、という部分について以下の分類を用いて整理をしているようである:
- Parameter: 経験をモデルの重みに内在化する
- 一例: [Paper Note] Self-Adapting Language Models, Adam Zweiger+, arXiv'25
- Context: LLMへのInputに反映させる
- 一例: [Paper Note] Prime Agent: A Self-Improving RLM Harness, Seth Karten+, arXiv'26, 2026.08
- Memory: 外部に保存された経験や情報として蓄積し、必要に応じて利用する
- 一例: [Paper Note] ReasoningBank: Scaling Agent Self-Evolving with Reasoning Memory, Siru Ouyang+, ICLR'26, 2025.09
- Skill: 次に同じ状況が起きたらどうすべきかをskillとして定義する。Memoryは過去の経験を蓄積するものであり、Skillは次どうするかを定義するという棲み分けをしている
- 以下は参考として管理人がピックしたもの
- [Paper Note] SkillRL: Evolving Agents via Recursive Skill-Augmented Reinforcement Learning, Peng Xia+, arXiv'26, 2026.02
(パラメータも最適化しているがSKILLBANKが該当すると思われる)
- [Paper Note] SkillOpt: Executive Strategy for Self-Evolving Agent Skills, Yifan Yang+, arXiv'26, 2026.05
- Harness Code: Agentを動作させるプログラム(Scaffolding)を変更する
- 一例: [Paper Note] SkillSmith: Learning to Compose Parametric Skills and Textual Knowledge, Lucio M. Dery+, arXiv'26, 2026.07
- 元ブログ中では↑が挙げられているが、Darwin Godel Machineの方が近いのでは?[Paper Note] Darwin Godel Machine: Open-Ended Evolution of Self-Improving Agents, Jenny Zhang+, ICLR'26, 2025.05
また、進化を構造化(バージョン管理)する際の分類軸として
- chain: A->B->Cのように進化させ常に最新版を利用する
- tree: 木構造でバージョンを管理する。ある1つの親ノードから子ノードが構成される親子関係で管理
- 一例: [Paper Note] Darwin Godel Machine: Open-Ended Evolution of Self-Improving Agents, Jenny Zhang+, ICLR'26, 2025.05
- graph: グラフ構造でバージョン管理する。すなわち、複数のノードに基づいて新たなノードを構成できる。ノードはバージョンだけでなく、タスク、trajectoryなども該当すると読める。
と整理しているようである。
誰がAgentを更新するかという軸の整理では
- self (student): (生徒)自身が更新する
- Teacher: trajectoryをteacherが分析しteacherが更新する
- Student + Teacher: 上記の両方で、生徒がまずtrajectoryを整理し必要な項目の候補を挙げ、Teacherが精査をし反映させる
いつ進化するのか、という軸では
- offline: 経験を蓄積し一括で更新する
- online: タスク実行ごとに動的に更新する
- hybrid: オフラインで更新した後にデプロイ。デプロイ後もオンラインで新たな経験等を追加し動的に更新するような方式
と定義しているようである。
そのほかにも、補足的な分類軸として、
- acceptance criteria: 更新したものを反映する基準
- feedback source: feedbackの出自(ベンチマーク, 環境, verifier, LLM, 人間など)
- feedback type: score, non-score,
- update frequency: 更新頻度
- scope of experience: 経験がどのスコープまで利用可能なのか(generickに使えるのか、特定ドメインのみなのか等)
We Must Pace the Frontier, Dario Amodei, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Alignment #AIAgents #Blog #SelfImprovement #Safety #autoresearch/RSI #Author Thread-Post Issue Date: 2026-09-13 Comment
元ポスト:
果たして。
独占禁止法で訴えられているとのこと:
ApprenticeBench: The first end-to-end benchmark of computer use, continual learning, and long-horizon agentic capabilities, set in a real job., NeoCognition, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #One-Line Notes #ContinualLearning Issue Date: 2026-09-13 Comment
元ポスト:
Computer Use + Continual Learningに関するベンチマークで、仮想的な建設会社の経理担当として入社し、一定の見習い期間(7ヶ月)を経て、その期間に企業のハンドブックやERPシステムチュートリアル、過去の請求書などで学習をする想定。その実際の請求書処理をこなしていくが、そこには実務上の罠が多く意図的に仕掛けられているようで、Human Baselineでも成功率は51%。最終的にHuman Baselineを上回ったのはAstra, Fable 5.1のようである。モデル間の傾向の違いなども考察されているようである。
Recurrent Looped Transformer, Yifan Zhang, 2026.09
Paper/Blog Link My Issue
#Article #Transformer #Architecture #RecurrentModels #Author Thread-Post Issue Date: 2026-09-13 Comment
元ポスト:
few observations on synthetic data for pretraining trends, Aleksa Gordić, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #LanguageModel #SyntheticData #Post #One-Line Notes Issue Date: 2026-09-11 Comment
Phi, Nemotron, Qwenは事前学習における合成データを非常に重視している一方、Kimi, Olmoは徐々に合成データの取り入れを強めてきているが、DeepSeek, MAIは利用していない、という戦略の違いがあるようだ。
North-Small-Translate-1.0, Cohere, 2026.09
Paper/Blog Link My Issue
#Article #MachineTranslation #LanguageModel #Blog #OpenWeight #Author Thread-Post Issue Date: 2026-09-11 Comment
元ポスト:
Introducing SWE-2: Pushing the Pareto Frontier, The Cognition Team, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Proprietary #One-Line Notes #Author Thread-Post Issue Date: 2026-09-11 Comment
元ポスト:
Kimi-K3をベースに事後学習を通じてAstra, Fable 5.1と同等程度のSWE系ベンチマークスコアを獲得
DeepSeek-V4.1-Flash, DeepSeek AI, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #read-later #Selected Papers/Blogs #VisionLanguageModel #Reference Collection #Author Thread-Post #Decoder-Decoder Issue Date: 2026-09-10 Comment
元ポスト:
所見:
え?もしかしてEncoder-Decoder???
Causal Encoder-Decoderという名称なので、seq2seqのようなBidirectionalなエンコーダを用いたものではなく、
エンコーダー、デコーダー共にautoregressiveモデルだが、エンコード用途とデコード用途でアーキテクチャやactivation paramなどに違いを持たせた、という感じだろうか。
デコーダ-デコーダアーキテクチャと呼ぶらしい:
関連:
- [Paper Note] You Only Cache Once: Decoder-Decoder Architectures for Language Models, Yutao Sun+, NeurIPS'24, 2024.05
公式ポスト:
ベンチマークスコアはfrontierモデルに匹敵する
HBMの使用量はV4-Flashから1/4, SSD使用量は1/8
合成データはいまだに利用していない:
事後学習のデータ品質改善のROIがアルゴリズム改善のROIを上回る:
関連(こちらは事前学習だが):
- Pretraining progress is mostly coming from data, DWARKESH PATEL AND JERRY HAN, 2026.09
解説:
Artificial Analysisによる評価:
とそれらに対する所見:
所見:
v4.1 flashをhostingするためのコードリポジトリがいくつか新たに公開されたようである:
所見:
Estimating GPT-6 Astra’s no-CoT Time Horizon, Francis Rhys Ward and Dewi Gould, LW, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Chain-of-Thought #Evaluation #Blog #Reasoning #read-later #Author Thread-Post Issue Date: 2026-09-10 Comment
元ポスト:
Pretraining progress is mostly coming from data, DWARKESH PATEL AND JERRY HAN, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #LanguageModel #Architecture #One-Line Notes #Data #Author Thread-Post Issue Date: 2026-09-09 Comment
元ポスト:
2019--2025年までの代表的なデータとモデルアーキテクチャの組み合わせによる小規模実験を通じて、事前学習に対するデータ由来の改善とアーキテクチャ由来の改善を分離したところ、データはモデルの改善と比較して3倍以上寄与しているという結論を得た、という話のようである。
ただし、下記ポストのようにMoEが試されていないことや、評価タスクがPPLのようなcompletionベースなではなく、Multiple Choice Questionを用いているためデータが追加されることでbenchmaxingされやすい点が指摘されている。
Muse, your personal AI agent that gets things done, Meta, 2026.09
Paper/Blog Link My Issue
#Article #AIAgents #Personalization #GenerativeAI #Blog #Author Thread-Post Issue Date: 2026-09-09 Comment
元ポスト:
16年前に思い描いた未来像までとうとう到達したなあ...(小並感)
Inside the megakernel serving engine for North Mini Code, Cohere, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog #LLMServing #One-Line Notes #GPUKernel #Author Thread-Post Issue Date: 2026-09-09 Comment
github: https://github.com/cohere-ai/cohere-megakernel
バッチサイズ1, 256k context、単一H100利用の条件下において、vLLM v0.24+FlashAttention3+Triton MoE backendよりも最大1.58倍デコーディングが高速(合成されたKV Cacheによる実験、実プロンプト+バッチサイズ8でも1.25--1.41倍高速)な実験的なLLM Servingエンジンのようである。
LLMのデコードを単一のカーネルに集約し、デコーディングのために必要な様々なステップごとの同期のオーバヘッドを削減したのだとか。
元ポスト:
Introducing ChatGPT Images 2.5, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #TextToImageGeneration #Blog #Proprietary #Editing #ImageSynthesis #Author Thread-Post Issue Date: 2026-09-09 Comment
元ポスト:
スケッチを入力することが可能になったようだ
JustRL II: Scaling Small LLMs to 128K Reasoning with a Critic, MiniCPM RL Team, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #Actor-Critic #PostTraining #read-later #Selected Papers/Blogs #LongHorizon #Author Thread-Post #CreditAssignment Issue Date: 2026-09-09 Comment
元ポスト:
関連:
- [Paper Note] JustRL: Scaling a 1.5B LLM with a Simple RL Recipe, Bingxiang He+, ICLR'26, 2025.12
On the Navier–Stokes Millennium Prize Problem, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #GenerativeAI #Blog #Mathematics #Selected Papers/Blogs #Proofs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-09 Comment
あのペレルマン氏が証明したポアンカレ予想と並ぶミレニアム懸賞問題の一つである、ナビエストークス方程式の解の存在と滑らかさ、とやらがOpenAIが保有する未公開モデルによって証明されたかもしれないらしい。10000の協調エージェントによって88時間, トークン量は1300億トークンで解に到達したのだとか。
元ポスト:
解説:
Research acceleration: The view inside OpenAI, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #AIAgents #GenerativeAI #Blog #SelfImprovement #ScientificDiscovery #autoresearch/RSI Issue Date: 2026-09-08 Comment
元ポスト:
Rustによる高速なOptuna実装「Rustuna」の公開, PFN, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #MachineLearning #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-09-08 Comment
元ポスト:
Automation’s Early Footprint: Where AI Agents Are (and Aren’t) Being Built, Cohere, 2026.09
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #AIAgents #Evaluation #Blog #read-later Issue Date: 2026-09-07 Comment
元ポスト:
Steering towards “automated grading” degrades alignment, Betley+, LW, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #read-later Issue Date: 2026-09-07 Comment
元ポスト:
[Paper Note] PACT: Can Enterprise AI Assistants Be Trusted Under Pressure?, Okamoto+, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Evaluation #read-later #InstructionFollowingCapability #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-07 Comment
元ポスト:
著者ポスト:
pressure下においてルールを遵守できる能力を測定するベンチマーク。興味深い
Ling-3.0-flash-Fin, inclusionAI, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #Financial #OpenWeight #Author Thread-Post Issue Date: 2026-09-07 Comment
benchmark:
https://huggingface.co/datasets/inclusionAI/FinFIRST
technical report:
https://huggingface.co/datasets/inclusionAI/FinFIRST/blob/main/FinFIRST_paper.pdf
FinFIRSTの解説:
元ポスト:
从 LR(学习率) 到 ELR(有效学习率),重新理解大模型预训练的调度策略, 发布于, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Blog #read-later Issue Date: 2026-09-06 Comment
元ポスト:
终局奖励之后:从 Apodex 1.1 看长程 Agentic RL 如何分配 credit, 发布于, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #ReinforcementLearning #AIAgents #PostTraining #read-later #CreditAssignment Issue Date: 2026-09-06 Comment
元ポスト:
Introducing Gemini 3.8 Flash and 3.8 Flash Cyber, Google, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Proprietary #Initial Impression Notes Issue Date: 2026-09-06 Comment
元ポスト:
コストパフォーマンスは良さそうに見えるが、GPT-5.6-lunaが比較の表に記載されておらず、GPT-5.6-lunaのコストパフォーマンスに勝てるのだろうか?Artificial Analysisによる評価を待ちたい。
と思ったら以下ポストを見つけたが、DeepSWEにおいてはパレート最適な模様。GPT-5.6-lunaよりもコストは高いがその分性能も高い、ように見える。
- DeepSWE: Measuring frontier coding agents on original, long-horizon engineering tasks, DeepSWE, 2026.05
高いように見えるなあ、と思ったらこのような話もある、ようである:
CursorBenchでも似たような傾向:
- Composer 2 のご紹介, Cursor, 2026.03
Terminal Bench 2.1→Terminal Bench 4.0のスコアの減少幅が大きいと言う指摘:
task単位のstep数がかなり異なる:
Training frontier knowledge work agents: A 397B RL training guide with SkyRL, Mercor and SkyRL, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #AIAgents #Blog #PostTraining #read-later #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-09-06 Comment
元ポスト:
397Bモデルに対するDPPOによる事後学習によってAPEX-Agentsのスコアを+11.2%を実現するための取り組みと地検が共有されているようである。
関連:
- [Paper Note] APEX-Agents, Bertie Vidgen+, arXiv'26, 2026.01
- [Paper Note] Rethinking the Trust Region in LLM Reinforcement Learning, Penghui Qi+, arXiv'26, 2026.02
LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Pretraining #Dataset #OpenWeight #Japanese #OpenSource #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2026-09-06 Comment
元ポスト:
モデル: https://huggingface.co/llm-jp/llm-jp-4-vl-9b
RefinedVision:
https://huggingface.co/datasets/llm-jp/RefinedVision
OpenSource AIの定義を満たすためにFineVisionデータセットを精査(e.g. GPT-4oの出力等は利用規約上問題がある)した上で修正(FineVisionは185サブセット, 24M VQAで構成されている)したとのこと。すごい。。。
ライセンス・利用規約上の問題を精査するだけでなく、品質(画像の品質、QAの品質)の観点でも精査の上修正しているようである。
関連:
- [Paper Note] FineVision: Open Data Is All You Need, Luis Wiedmann+, NeurIPS'26, 2025.09
Introducing Muse Voice Transcribe, Meta, 2026.09
Paper/Blog Link My Issue
#Article #SpeechProcessing #Blog #Proprietary #AutomaticSpeechRecognition(ASR) #AudioLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-06 Comment
Meta Superintelligence LabによるASRモデルで、多言語対応。日本語にも対応しているようである。Artificial AnalysisによるWERによる評価ではSoTAのようである。
元ポスト:
Alexandr Wang氏によるポスト:
TERMINAL-BENCH 4.0, TERMINAL-BENCH, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #Live #Initial Impression Notes Issue Date: 2026-09-05 Comment
元ポスト:
新しいタスクを追加する方向性ではなく、既存のタスクで課題(拒否、正解が公開、品質面等)があるものや飽和したものを改善、評価実行時のタイムアウトやエラーなどのリソース面の改善をし測定誤差の低減なども実施しているようである
所見:
TERMINAL-BENCH-SCIENCE 0.1: A benchmark for evaluating AI agents on research workflows across scientific domains, harbor-framework, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Science #Author Thread-Post Issue Date: 2026-09-05 Comment
元ポスト:
Introducing H3 Max by fal, fal, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Blog #Proprietary #VideoGeneration/Understandings #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
Minimax H3を事後学習(指示追従とvisual qualityを改善)することで、Artificial Analysisによる評価でSoTAを達成した動画生成モデルとのこと。
Claude: Fable 5.1 and Mythos 5.1, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
所見:
Introducing K2 Horizon: Frontier Performance, Radically Open, Institute of Foundation Models, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #OpenWeight #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-09-04 Comment
元ポスト:
所見:
HF: https://huggingface.co/collections/IFM/k2-horizon
GPT-5.6-luna級の性能を375B-A23Bで実現されているように見え、データ、レシピ、コード、重みが公開される。
Introducing Muse Spark 1.3, Meta, 2026.09
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #Proprietary #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-09-04 Comment
元ポスト:
早くもGPT-5.6-Solと同等以上の性能に到達した模様
long context性能が良さそうに見える:
と思いきや、(Museに限らないが)MRCRのスコアにはコンタミネーションの疑いがある。
Artificial Analysisによる評価:
Terminal Bench 2.1→Terminal Bench 4.0のスコアの減少幅が大きいと言う指摘:
GPT-6 Astra: A new generation of intelligence, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #AIAgents #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
GPT-5.6 Solから大幅に性能向上。scaling lawはいつまで続くのだろうか
ベンチマーク上は
- Claude: Fable 5.1 and Mythos 5.1, Anthropic, 2026.09
を超えている。
所見:
アーキテクチャに関する所見:
- [Paper Note] Nanbeige4.2-3B: Unlocking Agentic Capabilities in a Compact Model, Nanbeige Lab+, arXiv'26, 2026.07
- [Paper Note] Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation, Sangmin Bae+, NeurIPS'25
より注意深く指示に従い、CUAの能力も大幅に向上しているようである:
CUAによってBlenderで作成されたhouseの例がなかなかすごい
Artificial Analysisによる評価によると、Artificial Analysis Indexでは5.6-Solと同等、Coding IndexでもFable 5と同等であり、OpenAIによるベンチマークスコアとかなり乖離があるように見える。パブリックなベンチマークに対して過剰に適合しているのか。それともArtificial Analysisのベンチマーク群とその重みづけにより算出されるスコアの相性が悪いのか。(まあこれを考えても不毛だけど)
SRE-Benchと呼ばれるモデルがコンパイル済みのバイナリからソフトウェアをリバースエンジニアリングできるかを測定するベンチマークが飽和したとのこと:
SRE-Bench:
https://benchlm.ai/benchmarks/srebench
所見:
Artificial Analysis Indexのスコアが更新されてFable 5.1とAstraのスコアが同じになったようである😅:
RSI-Exam: Benchmarking Recursive Self-Improvement through Executable Research, RSI-Exam, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #SelfImprovement #autoresearch/RSI #Author Thread-Post Issue Date: 2026-08-30 Comment
元ポスト:
Hugging Face のインシデントと今後の道筋, OpenAI, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #AIAgents #Blog #read-later #Selected Papers/Blogs #Security #Author Thread-Post Issue Date: 2026-08-30 Comment
元ポスト:
- OpenAI and Hugging Face partner to address security incident during model evaluation, OpenAI, 2026.07
の件の調査結果のようである。
GLM-5.3-Flash: Frontier Intelligence, Flash Cost, Z.AI, 2026.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog #OpenWeight #Selected Papers/Blogs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-30 Comment
HF: https://huggingface.co/zai-org/GLM-5.3-Flash
320B-A18BでOpus 4.8相当のベンチマークスコアを達成
アーキテクチャ解説:
- KDA
- FlashKDA: Flash Kimi Delta Attention — high-performance KDA kernels built on CUTLASS, MoonshotAI, 2026.04
- MLA
- [Paper Note] DeepSeek-V3 Technical Report, DeepSeek-AI+, arXiv'24, 2024.12
- DSA
- [Paper Note] DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek-AI+, arXiv'25, 2025.12
- mHC
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
所見:
本ポストにある通り、中国系のOpenWeightモデルは
- linear attention
- sparse attention
- mHCのようなResidual Streamに対する工夫
- Muon
などを採用するのがデファクトとなっているように思われる。
所見:
Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency, Qwen Team, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-30 Comment
ベンチマークスコアはOpus 4.6超え。パラメータは125B-A6B、51Bの N-gram Embeddings。Gated Delta Net layerとQwen Sparse Attention と呼ばれる Layerを3:1の比率で積み上げていっているようである。N-gram Embedding、MTPも導入されている。また、Gated Residualと呼ばれる技術により、Residual Streamからの読み込み/書き込みを制御している。
- 関連:
- [Paper Note] Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, Xin Cheng+, arXiv'26, 2026.01
HF:
https://huggingface.co/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921FsyOPe&file=Qwen3.8-Flash-Next
technical report:
https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
解説:
所見:
Mitigate Silent Expert Death in Ultra-Sparse MoE, Jin+, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #LanguageModel #Blog #MoE(Mixture-of-Experts) #One-Line Notes #Author Thread-Post Issue Date: 2026-08-30 Comment
元ポスト:
sparse MoEモデルを学習する際に、浅い層のexpertが機能しなくなっていく(重みのノルムが非常に小さくなり学習シグナルも消失し回復しない)にもかかわらず、ロードバランシングは正常なままという現象を観測し(Silent Expert Death)、公開されているMoEモデルでも同様の現象が生じていることを確認。LM Loss as Auxiliary Loss (LLAL)と呼ばれる、最初の数千ステップで浅いMoE Layerを一時的に言語モデルのheadに接続し、その後その接続を削除するような方法を用いると、loss・downstream task性能が改善し silent expert collapseも防止することができた、という話のようである。
LLALの気持ちとしては、非常にSparseなMoEの学習では、浅い層を学習するためのpressureが小さいことが問題であることが前提のもと、これを解決するために、まず浅い層のexpert数を削減する、あるいは異なる学習率やweight decayをチューニングするなどの方法も検討している。しかしこれらの方法は結局ハイパーパラメータ探索の沼に学習をするたびにはまってしまい嬉しくない。そのため、よりgenericに適用可能な学習方法として、安定していて、モデルの本来の学習目的と整合していて、expertの差別化を促すような性質のものが求められ、これを満たすものとしてnext-token-predictionを活用することを提案している。
浅い層のexpertが何を学習することを求められるかというと、一般的にはlexical-levelな情報を学習していることを求められるが、現状ではSilnet Expert Deathによってこれがうまく進んでいないことが懸念される。これを是正するために、シンプルに浅いMoE LayerをLM headに接続し、next-token-predictionのlossをより直接供給することで学習を促す、という気持ちのようである。
Introducing Pipette: A benchmarking suite for on-device intelligence, Liquid AI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #SmallModel #read-later #Author Thread-Post Issue Date: 2026-08-29 Comment
元ポスト:
Reinforcement Learning for LLMs: The Complete Guide, Cameron R. Wolfe, Ph.D., 2026.08
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #ReinforcementLearning #Blog #PostTraining #Author Thread-Post Issue Date: 2026-08-29 Comment
元ポスト:
Scaling Laws simulate the entire training trajectory at Marin, Larry Dial, 2026.08
Paper/Blog Link My Issue
#Article #Pretraining #LanguageModel #Post #Scaling Laws #Selected Papers/Blogs Issue Date: 2026-08-22 Comment
詳細はMarin ProjectのIssue 8435を参照のこと。
https://github.com/marin-community/marin
Marin:
- Introducing Marin: An Open Lab for Building Foundation Models, marin-community, 2025.05
Ling-3.0-flash-dspark, inclusionAI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #SpeculativeDecoding #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
関連:
- Ling-3.0-flash, inclusionAI, 2026.08
- [Paper Note] DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation, Xin Cheng+, arXiv'26, 2026.07
RL creates split personas, LW, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #ReinforcementLearning #Blog #PostTraining #Selected Papers/Blogs #Personality #reading #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
所見:
dots3-note Preview: A Small but Mighty Step Toward Long-Horizon Agency in Real Life, dots studio, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #AIAgents #Blog #OpenWeight #VisionLanguageModel Issue Date: 2026-08-22 Comment
HF: https://huggingface.co/dots-studio/dots3-note-prev
元ポスト:
DeepSeek-V4-Flash-Vision-Exp, DeepSeek AI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-08-22 Comment
DeepSeek初のマルチモーダルモデル(VLM)とのこと
重みが公開: https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-Vision-Exp
SenseNova-U1.5-8B-MoT, SenseNova, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #TextToImageGeneration #OpenWeight #Editing #UMM #ImageSynthesis #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
LFM2.5-DSpark: Up to 3.2x Faster Inference from H100 to MacBook, Liquid AI, 2026.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog #SmallModel #OpenWeight #SpeculativeDecoding #Author Thread-Post Issue Date: 2026-08-22 Comment
HF:
https://huggingface.co/LiquidAI/LFM2.5-1.2B-Instruct-DSpark
他のLFM用のDraftモデルもある。
様々なLFM用のDraft Model
Scaling Activation Oracles to Trillion-Parameter Models: Oracles improve with model size, data size, and data quality, Transluce, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
WildArtifactBench, Meta, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #AIAgents #Evaluation #MultiModal #LLM-as-a-Judge #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
AI Agentによるpreference judgeに基づく、win rate/Elo Scoreによるマルチモーダルエージェントのベンチマークのようである
text-2-image-human-preferences-2m, Datapoint AI, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Dataset #TextToImageGeneration #Blog #DPO #One-Line Notes #ImageSynthesis Issue Date: 2026-08-21 Comment
21kのimageペアに対して2Mのpair-wiseでの人間のpreferenceが付与されたデータとのこと。500 promptに対して、30個のT2Iモデルが利用されている。
大模型 MoE 负载均衡的 N 种方法, 觉醒也醉了, qingke_ai, 2026.08
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Architecture #MoE(Mixture-of-Experts) #read-later Issue Date: 2026-08-20 Comment
元ポスト:
Ornith-1.5: From Self-Scaffolding to Self-Improvement, Ornith, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #AIAgents #Blog #OpenWeight #SelfImprovement #reading Issue Date: 2026-08-20 Comment
HF: https://huggingface.co/collections/ornith-ai/ornith-15
元ポスト:
関連:
- Ornith-1.0: Self-Scaffolding LLMs for Agentic Coding, Ornith, 2026.06
モデルを学習するためのタスク生成、scaffolding(e.g.,ヒントなどのタスクを適切な難易度に調整する足場を作ること)生成、解答の生成(ロールアウト)それぞれをself-improvementさせながら学習されたモデルとのこと。
Cua: Scale computer-use 2.0 with open-source drivers, cross-OS fleets, and benchmarks for training, evaluation, and data generation, trycua, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Tools #Infrastructure #AIAgents #ComputerUse #Selected Papers/Blogs #Author Thread-Post #SandboxEnvironment Issue Date: 2026-08-20 Comment
元ポスト:
約332億パラメータのDense型LLM「LLM-jp-4 33B」モデルを公開, LLM-jp, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #Japanese #OpenSource #Author Thread-Post Issue Date: 2026-08-19 Comment
元ポスト:
DFlash 2: Keep Drafting Parallel, Inco AI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #DiffusionModel #read-later #Selected Papers/Blogs #SpeculativeDecoding #Author Thread-Post Issue Date: 2026-08-19 Comment
元ポスト:
関連:
- [Paper Note] DFlash: Block Diffusion for Flash Speculative Decoding, Jian Chen+, arXiv'26, 2026.02
AI Control: An Assessment of Frontier Practices, Guidelight, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #Proprietary #Safety #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-08-19 Comment
著者ポスト:
元ポスト:
Miles: Enterprise-Grade Reinforcement Learning for Large-Scale Model Post-Training, RadixArk, 2026.08
Paper/Blog Link My Issue
#Article #Tools #LanguageModel #ReinforcementLearning #PEFT(Adaptor/LoRA) #PostTraining #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-08-19 Comment
元ポスト:
Accelerating GPT-5.6 Sol Ultrafast , cerebras, 2026.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #Blog #Decoding Issue Date: 2026-08-18 Comment
元ポスト:
NanoGPT Speedrun Frontier, Prime Intellect, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Evaluation #Blog #SelfImprovement #Initial Impression Notes #autoresearch/RSI #Author Thread-Post Issue Date: 2026-08-17 Comment
元ポスト:
所見:
18のフロンティアモデルでnanogpt speedrunに対してautoresearchを実施し、結果的に合計153回のrunを実施され、Fable 5が人間のレコードに対して83%まで迫ることができたが、新規のアイデアを創出する能力が欠如してあることが示唆された、と言う話に見える。
Outperforming cuBLAS on NVFP4, PRANJAL SHANKHDHAR, 2026.08
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #LanguageModel #SoftwareEngineering #read-later #GPUKernel #Author Thread-Post Issue Date: 2026-08-17 Comment
元ポスト:
[Tech] Why MLA and MTP Fight Each Other: Attention Through Arithmetic Intensity, ChangyiYang's Site, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #Attention #Blog #Architecture #SpeculativeDecoding #reading #Author Thread-Post Issue Date: 2026-08-15 Comment
元ポスト:
Arithmetic Intensity := FLOPs per byte moved
しっかり読みたい
Introducing Toast 1, Mixedbread, 2026.08
Paper/Blog Link My Issue
#Article #Search #LanguageModel #AIAgents #Blog #One-Line Notes #Author Thread-Post Issue Date: 2026-08-15 Comment
GPT 5.6 Sol, Opus 5と同等以上の性能をもち、10倍安く、12倍高速なsearch agentとのこと。技術的な詳細は書かれていないように見え、ベンチマークの話が記述されている。
元ポスト:
Prime Intellectによるポスト:
Prime Intellectを通じて学習されたということは、大規模なAgentic RLを大規模なEnvironmentに対して実行したことが示唆される。
Prime Flash MoE - Faster MoE Kernels optimized for Blackwell, Prime Intellect, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #MoE(Mixture-of-Experts) #reading #One-Line Notes #GPUKernel #Author Thread-Post Issue Date: 2026-08-15 Comment
元ポスト:
4k--128kのコンテキストに対して最大2.4倍高速なMoE向けCUDAカーネル。メモリ書き出しのトラフィックを大幅に削減することで実現。
Introducing NAC, an Open-Source Harness for Long-Running Agent Work, Arcee, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Blog #LongHorizon #AgentHarness Issue Date: 2026-08-15 Comment
元ポスト:
Introducing Gemini 3.7 Flash, Google, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Proprietary #Author Thread-Post Issue Date: 2026-08-15 Comment
元ポスト:
AA-AnalystAgent BenchmarkでSoTA:
要はデータ分析系のベンチマークのようである。
Qwen3.8, Qwen Team, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #VisionLanguageModel #One-Line Notes #Author Thread-Post Issue Date: 2026-08-15 Comment
元ポスト:
ベンチマーク上はMuse Glimmer超え、Opus4.6相当
GLM-5.3: Frontier Coding with Emergent Cyber Capabilities, Z.ai, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-08-15 Comment
GDPValでGPT-5.6-Sol, Fable5超え。ベンチマークスコアだけ見ると、フロンティアモデルにほぼ追いついたと言って良さそうに見える。残る砦はOpus 5
所見:
所見:
スケーリング則に関するLiterature、考察、GLM-5.3のその中での位置付けについて述べられている。ポスト中で言及されている Roberts et al. (2025)は以下
関連:
- [Paper Note] Compute Optimal Scaling of Skills: Knowledge vs Reasoning, Nicholas Roberts+, ACL'25 Findings, 2025.03
- Deconstructing Scaling Laws: The Triad of Optimization, Architecture, and Data, 苏剑林, 2026.07
weightが公開:
https://huggingface.co/zai-org/GLM-5.3
DeepSeek Harness, Deepseek AI, 2026.08
Paper/Blog Link My Issue
#Article #Tools #LanguageModel #AIAgents #Coding #SelfImprovement #SoftwareEngineering #Selected Papers/Blogs #One-Line Notes #Reading Reflections #Author Thread-Post #AgentHarness Issue Date: 2026-08-14 Comment
元ポスト:
モデル、ツール、スキル、セッション、sandbox、ファイルシステム、ループ、オーケストレーション、UI、全てがPluginとして実装されたpluggableなハーネスとのこと。
元ポスト:
高い拡張性を持つため、self-improveするハーネスと相性が良さそう。
所見:
DeepSeek-V4-Pro-0813, DeepSeek AI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト: https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-0813
公式ポスト:
Putting sign language AI into users’ hands, Google Deepmind, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #MachineTranslation #LanguageModel #Blog #MultiLingual #One-Line Notes #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
Sign-Language to Text (SL2T) Model
50種類以上の手話で学習された手話をテキストに翻訳するモデル。スマホのカメラを通じてリアルタイムにstreaming textとして翻訳される。
Meet North Micro Vision: A 2.4B Native-Resolution Vision-Language Model, Cohere, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #SmallModel #OpenWeight #VisionLanguageModel #Author Thread-Post Issue Date: 2026-08-14 Comment
HF:
https://huggingface.co/CohereLabs/North-Micro-Vision-Instruct
Apache 2.0
元ポスト:
Introducing Grok 4.6, SpaceXAI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Proprietary #Selected Papers/Blogs #One-Line Notes #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
GPT-5.6-Sol, Fable5等のフロンティアモデルと同等のベンチマークスコア
CursorBench 3.2において、パレート最適:
Model Card:
https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf
1.5T級のモデルで、1.2節にモデル学習の概要が記述されているが、極めてgenericな内容である。他はベンチマークの評価結果やjailbreakに対する堅牢性などの話がメイン。
MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost, MAI, 2026.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #AIAgents #Blog #Coding #Proprietary #SoftwareEngineering #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4, Nvidia, 2026.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #LanguageModel #OpenWeight #SSM (StateSpaceModel) #LinearAttention #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
Ling-3.0-tiny, inclusionAI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #SmallModel #OpenWeight #Author Thread-Post Issue Date: 2026-08-11 Comment
新たに学習段階の複数ステージでのベースモデルが公開:
Notes on Midtraining, CAMERON R. WOLFE, PH.D., 2026.08
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #mid-training #Author Thread-Post Issue Date: 2026-08-11 Comment
元ポスト:
Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device, Meta, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #OpenWeight #Selected Papers/Blogs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-10 Comment
HF: https://huggingface.co/meta-models/Muse-Glimmer-30B
Museシリーズから初のOpenWeightモデルがリリースされ、ライセンスはApache 2.0
所見:
Alexandr Wang氏によるポスト:
ザッカーバーグ氏によるポスト:
Muse Spark 1.2もオープンになるとのこと。
所見:
アーキテクチャ解説:
Multi-Agent Systems in PRIME-RL, Prime Intellect, 2026.08
Paper/Blog Link My Issue
#Article #Multi #LanguageModel #Infrastructure #ReinforcementLearning #AIAgents #Blog #Author Thread-Post Issue Date: 2026-08-10 Comment
元ポスト:
Defending Against the Training–Inference Numeric Mismatch in RL (Especially Linear Attention) — and Whether It Helps Async RL, Yichuan Wang in collaboration with the TorchTitan team, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #Blog #PostTraining #read-later #Selected Papers/Blogs #train-inference-mismatch #Initial Impression Notes #Asynchronous Issue Date: 2026-08-10 Comment
元ポスト:
linear attentionモデルにおいて、初めてRLにおけるtrain-inference mismatchを完全に解消した実装とのことで、非常にインパクトが大きそうに見える。
VISTA: A Visual Harness for Reasoning in an Interactive World, Han+, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #AIAgents #Reasoning #read-later #Selected Papers/Blogs #2D (Image) #3D (Scene) #memory #LongHorizon #Author Thread-Post #AgentHarness Issue Date: 2026-08-10 Comment
元ポスト:
Ling-3.0-flash, inclusionAI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #OpenWeight #One-Line Notes #Author Thread-Post Issue Date: 2026-08-10 Comment
元ポスト:
- 124B-A5B
- 5:1の比率でKDAとMLAのhybrid attention
- 1/64のactivation ratio
Kimi K3, The Manos, The Mythos, The Legendos, CHEN+, 2026.08
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Attention #Blog #MoE(Mixture-of-Experts) #read-later #Routing #Initial Impression Notes #LinearAttention #Author Thread-Post Issue Date: 2026-08-10 Comment
関連:
- Kimi K3: Open Frontier Intelligence, Moonshot AI, 2026.07
元ポスト:
以下のようなKimi K3で利用されている技術の解説:
- linear attention
- DeltaNet
- GatedDeltaNet
- FlashKDA
- Kimi Linear
- MLA
- Attention Residuals
- LatentMoE
- Quantile load balancing (QB)
- KVCache Efficiency
関連:
- [Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
- FlashKDA: Flash Kimi Delta Attention — high-performance KDA kernels built on CUTLASS, MoonshotAI, 2026.04
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
- [Paper Note] DeepSeek-V3 Technical Report, DeepSeek-AI+, arXiv'24, 2024.12
- [Paper Note] Attention Residuals, Kimi Team+, arXiv'26, 2026.03
- [Paper Note] LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts, Venmugil Elango+, arXiv'26, 2026.01
QBをチェックしたい
Qwen3.8-Max: A New Bar for Coding and Cowork, Qwen Team, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Author Thread-Post Issue Date: 2026-08-09 Comment
2.4T-A95B モデルが翌週にopenになるとのこと。
元ポスト:
言語モデル/coding agentとしては、Opus4.8と同等以上のスコアに見え、VLMとしては、ほとんどのベンチマークでFrontier Model(Fable5, GPT5.6-sol)を上回るスコアを示しているようである。
object detectionでSoTA:
Reward Laundering: LLMs Can Gain Unintended Behaviors by Deciding When to Earn Their Rewards, egan+, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #Alignment #ReinforcementLearning #Safety #PostTraining #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
数学と理論計算機科学における10の進展, OpenAI, 2026.08
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #GenerativeAI #Blog #Mathematics #ScientificDiscovery #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-08-09 Comment
元ポスト:
歴史的な出来事になる可能性がある
Towards Looped Models Done Right, Huang+, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #Blog #read-later #RecurrentModels #RecursiveModels #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
関連:
- [Paper Note] Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach, Jonas Geiping+, NeurIPS'25
- [Paper Note] Scaling Latent Reasoning via Looped Language Models, Rui-Jie Zhu+, arXiv'25, 2025.10
代表的なLooped Modelsアーキテクチャに対して、apple-to-appleな比較実験を実施し結果を考察しているようである。
MiniMax-H3, MiniMaxAI, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Transformer #TextToAudio #SpeechProcessing #OpenWeight #VideoGeneration/Understandings #UMM #Omni #TextToVideoGeneration #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
Video Arenaと呼ばれるベンチマーク (Image-to-Video, Image-to-Video) でOpenWeightモデルでSoTA、全体で2位:
日本語音声基盤モデルの事後学習:TTSに強化学習を適用する, 株式会社DubGuild, 2026.07
Paper/Blog Link My Issue
#Article #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #SpeechProcessing #Japanese #TTS #One-Line Notes #train-inference-mismatch #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
以下記事を読んでおもしろかったポイントの要約
- 学習エンジン: FSDP + Transformer, 推論エンジン: vLLM
- LLMでのRLでは生成結果をルーブリックやReward Modelで評価できるが、音声の場合は音声トークン列だけを見ても評価できないため、波形へ複合し音声認識モデルで評価
- 報酬計算はTTS学習とは異なる依存関係が必要なので学習と報酬のサーバを分離することで柔軟性を高める
- 報酬にNLLを加えると、発話長が長くなる現象が発生し、Length Penaltyを加えることで改善される
- 実際の音声をきいてみると、発話がとても間延びしていて非常に興味深かった。
- 報酬設計と話者性の関係性を分析すると、Correct Error Rateによる報酬のみの場合は女性話者(のようにきこえる)割合が減り、+NLL, +Length Penaltyの場合は、女性話者(のようにきこえる)音声の割合が大幅に増加し、学習に何らかのバイアスが加わっている可能性が示唆された。
- これはCER, NLLの計算にWhisperを用いており、Whisperのベースモデルに対する音声合成結果において、女性話者の候補が報酬を得やすい状態であったことに起因することを分析(一般的なな女性音声において有利になっているわけではない)
- RLにおけるtrain-inference mismatchに関しても分析し
- FP16/BF16、エンジン(Transformer, vLLM)において、ミスマッチが存在し、エンジンよりも数値精度の変更の影響が大きく
- BF16にすると、FP16と比較して1位, 2位の出力候補のlogitが同値となる割合が増加し、音声トークンを生成するモデルのベースとなったLLMとlogitの同値率を比較すると、音声トークン生成の方が同値率が大幅に高い結果となった
- BF16/FP16の間の学習-生成の間での対数確率の差は、BF16の場合はFP16の約8倍となった(が、学習後のCERで見ると大きな差は生じなかった)。
- TTSモデルを評価する際には、モデルと音声コーデック符号化/復号の影響を分離して考える必要がある
- 人間がきいて同じ音声にきこえる場合でも、埋め込みを用いた類似度ではあまり高くないことがある
関連:
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
Science One Framework: A verifiable autonomous research framework via Chain-of-Evidence, Google Research, 2026.07
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Hallucination #Blog #SelfImprovement #ScientificDiscovery #Verification #autoresearch/RSI #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
[Paper Note] Qwen-UI-Agent Technical Report: Toward Next-Generation Real-World Centric Foundation GUI Agents, MAI-UI Team, 2026.07
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #AIAgents #ComputerUse #VisionLanguageModel #Initial Impression Notes #GUI Issue Date: 2026-08-09 Comment
pj page: https://tongyi-mai.github.io/Qwen-UI-Agent/
多くのベンチマークでFrontier Modelを上回る性能を示すGUI Agent。デモを見るとなかなかインパクトがある。
元ポスト:
[Paper Note] Statutory construction and interpretation for AI, He+, 2026.07
Paper/Blog Link My Issue
#Article #LanguageModel #Alignment #AIAgents #PostTraining #One-Line Notes #Rubric-based #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
Constitutional AIのようなルーブリックに基づいてモデルの振る舞いを調整する方法では、ルールの捉え方がモデルに応じて異なることで幅広い解釈が存在することが問題となることを指摘。モデル間での解釈を一致させるために、
- Interpretive Constraints: 法解釈の原理に基づいたPromptingによって、モデル側の解釈の裁量を制限し
- Iterative Refinement: 曖昧性のある記述をiterativeに洗練させる
ことによって緩和する。
関連:
- [Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
Introducing Inkling-Small, THINKING MACHINES, 2026.07
Paper/Blog Link My Issue
#Article #ComputerVision #LanguageModel #OpenWeight #VisionLanguageModel #UMM #One-Line Notes #Author Thread-Post Issue Date: 2026-08-09 Comment
HF: https://huggingface.co/thinkingmachines/Inkling-Small
関連:
- Inkling: Our open-weights model, THINKING MACHINES, 2026.07
- 276B-A12B
- NVFP4
- 小規模なモデルだが、Inklingと同等以上の性能を達成(ただし、一般的な知識や事実性に関してはInklingの方が上)
- 事前学習データのDataMixtureや学習レシピにいくつかの改良
- Inklingを教師モデルとしたOPD
- codingに特化したagentic RLをスケールアップ
元ポスト:
The Lost Accumulator, Bertolotti, Francesco, 2026.07
Paper/Blog Link My Issue
#Article #Pretraining #LanguageModel #Blog #One-Line Notes #ResidualStream #LowPrecision #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
残差ストリームの精度はbf16で保存されるのが一般的で、70層以上の大きなモデルの場合、140回の累積演算を行うため、フル精度を保たないと誤差が蓄積し、学習に影響を与える可能性がある。実際に、bf16, fp32での残差ストリームのフル精度との差分や符号の反転を比較すると、fp32よりもbf16の方が誤差や符号反転の回数が、layerが深くなるにつれ顕著に大きくなった。
しかし、実際に3種類の幅・高さのバリエーションを持ったLlama3 1Bのバリエーションに対して、fp32、bf16の2種類の精度(つまり合計6種類のモデル・精度)で、FineWebから0.1Tトークンをバッチサイズ0.5M tokenで事前学習したところ、loss, downstreamタスクの性能共にほとんど差が見受けられなかった(唯一winograndeだけは差があった)、といった実験結果が記載されている。
筆者も示唆している通り、モデルのサイズや事前学習の学習トークン数の規模感が小さいので、より大きくしたら何か差は生まれるのだろうか。
Deconstructing Scaling Laws: The Triad of Optimization, Architecture, and Data, 苏剑林, 2026.07
Paper/Blog Link My Issue
#Article #Tutorial #Embeddings #LanguageModel #Blog #Optimizer #Architecture #MoE(Mixture-of-Experts) #Scaling Laws #Selected Papers/Blogs #memory #reading #Data #needs-revision Issue Date: 2026-08-08 Comment
元ポスト:
以下読んだ内容の個人的な理解の要約。誤りを含む可能性があるので元文献を読むことをおすすめします。めちゃめちゃ勉強になります。
- モデルの学習プロセスを与えられたデータD, アーキテクチャA, optimizer Oの下で、損失関数を最小化するプロセスとして定式化し、整理すると以下の3つの観点に分離できる
- L(E | D, A, O) = データ誤差 + 最適化誤差 + アーキテクチャ誤差 + 最適なアーキテクチャ・optimizerで学習したときにデータDが到達しうるloss
- ここで、Eはある理想的な分布(i.e., 無限に巨大なテストセット)であり、DはEのサンプリング結果にすぎない。
- L(E | D, A, O) は与えられたD, A, Oの下でモデルが理想分布E上で到達できる損失値を表している。
- 式(1)で示された不等式によって、ある制約のもとで、べき乗則の組み合わせの最小値を求めることができる。
- この不等式を用いて、L(E | D, A, O)に基づいて表現される Scaling Law(機械学習が持つ合理的な仮定に基づいて、学習に伴う様々な変数と最終的に到達しうるlossの関係性を表現した式)を整理していくことで、変数間の関係性を整理することができる。
- 記事中では、最適化誤差、アーキテクチャ誤差、データ誤差について、様々な合理的な仮定に基づいて Scaling Law をボトムアップに構築し、その際の考え方や、導き出した Scaling Law に実際の値をあてはめることで、既に文献で報告されている Scaling Lawと紐づけた考察が実施されている。
- 最適化誤差(学習率η、バッチサイズB、学習ステップ数Tの間の関係性):
- まず最適化誤差について着目し、合理的な仮定として「学習するほど効果が良くなる」という仮定のもと、ステップ数T, 学習率η, バッチサイズBを導入し、その関係性を記述する際の考え方を述べている(ステップ数が多いほど良い、学習率が大きいほどよい、学習はノイズの影響を受け、バッチサイズが小さいほどノイズは大きく、学習率が大きいほどノイズも大きい)。値が大きければプラスの効果をもたらすものはlossが下がると考えられるので負の指数を仮定し、値が大きいほどlossが増大すると考えられるものは正の指数を仮定し、その関係性を記述できる(式10)。
- これは式(1)で与えられた形と同じ形をしており、不等式の性質を用いて最適化誤差を最小化する最適な学習率、最適なバッチサイズ等を求めていくと、最適な学習率が与えられた上での、あるいは最適な学習率・最適なバッチサイズが与えられた上での Scaling Lawの式の形式が得られ、実際に理論的な解析から導かれた指数を代入し、下記研究で実験的に得られたScaling Lawとの比較を通じて考察をしている(たとえば、最適なバッチサイズは学習サンプル数Kの1以下のいあるべき乗に比例する、等)。
- Microsoft Law
- [Paper Note] Scaling Optimal LR Across Token Horizons, Johan Bjorck+, arXiv'24, 2024.09
- Step Law
- [Paper Note] Predictable Scale: Part I, Step Law -- Optimal Hyperparameter Scaling Law in Large Language Model Pretraining, Houyi Li+, arXiv'25, 2025.03
- アーキテクチャ差(パラメータ数N, 幅W, 深さHの間の関係性)
- 続いてアーキテクチャ差についても同様に合理的な仮定からスタートし(パラメータ数Nが大きいほどlossは小さくなる等)、同様に合理的な仮定のもと、式(1)を用いて関係性を整理していくことで、既存のScaling Lawとの関係性が考察されている。
- Kaplan Law
- [Paper Note] Scaling Laws for Autoregressive Generative Modeling, Tom Henighan+, arXiv'20, 2020.10
- Chinchilla Law
- [Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
- 最適化誤差とアーキテクチャ誤差を統合した際の議論
- DeepSeek Law
- [Paper Note] DeepSeek LLM: Scaling Open-Source Language Models with Longtermism, DeepSeek-AI+, arXiv'24, 2024.01
- スパース性 / Memory:
- MoEやMemory (Embedding)等の、モデルの計算量とパラメータ数を分離する方法に関する Scaling Lawについても考え方が述べられている。
- たとえば、Denseモデルに対するScaling Lawでは計算量はおおむねパラメータ数Nに比例するという仮定があるが、MoEではそれに対して、総パラメータ数と活性化パラメータ数の比(スパース度S)を新たに導入し、計算量をおおむね活性化パラメータ数のみに依存するものと仮定する。
- スパース度Sを増やしても計算量は増えないが、損失は減るためスパース度を増やすことは(理論上は)基本的に有利に働く。
- 活性化パラメータ数N_act, 総パラメータ数N_totalを導入した過程からアーキテクチャに関するScaling Lawの式を整理すると、最終的にDenseの場合と同じ形式が現れ、N_act, N_totalから導き出される有効パラメータカウント N_eff のパラメータ数を持つDenseモデルと等価である、という見方もできる、などである。
- Ling Law
- [Paper Note] Towards Greater Leverage: Scaling Laws for Efficient Mixture-of-Experts
Language Models, Changxin Tian+, arXiv'25
- データ誤差
- 最後にデータ誤差に関する Scaling Lawについても考察されている。
- ただし、データに関しては様々な要因から影響を受けるだけでなく、かつデータそのものを表現する際に、他のものと比較して境界があいまいで、明確に単一のスカラーで定量化可能な変数を持ちずらく、統一された形式を得ることが難しい、ということも説明されている。
- [Paper Note] Prescriptive Scaling Laws for Data Constrained Training, Justin Lovelace+, arXiv'26, 2026.05
- [Paper Note] Scaling Data-Constrained Language Models, Niklas Muennighoff+, NeurIPS'23
下記ポストも非常に勉強になる:
2 つの設定で ARC-AGI-3 ベンチマークのスコアが 3 倍に, OpenAI, 2026.07
Paper/Blog Link My Issue
#Article #LanguageModel #AIAgents #Selected Papers/Blogs #One-Line Notes #Compression #Reading Reflections #Author Thread-Post #AgentHarness Issue Date: 2026-08-08 Comment
元ポスト:
ARC-AGI-3のベンチマークを測定する際に、ARC-AGI-3が提供いているオフィシャルのシンプルなハーネスではなく、Response APIで実施されているような reasoningの保持と圧縮をするようなハーネスに変更したら、スコアが3倍以上になったよ、という話のようである。
それはそう、という感じではあるのだが、シンプルなハーネスでそのモデルが持つ強みを発揮しきれないのであれば、公平な比較になっていないよね?という話でもある。モデルの能力を測定するための変数が増えすぎて、公平な比較をするのがどんどん難しくなってきている。
A.X K2 Raon-Speech: Introducing Korea’s First Independently Developed SpeechLM, KRAFTON AI, 2026.07
Paper/Blog Link My Issue
#Article #SpeechProcessing #Speech #OpenWeight #AudioLanguageModel #Korean Issue Date: 2026-08-06 Comment
元ポスト:
HF: https://huggingface.co/KRAFTON/A.X-K2-Raon-Speech-21B-A3B
A.X-K2, SK Telecom, 2026.07
Paper/Blog Link My Issue
#Article #Pretraining #LanguageModel #OpenWeight #DataMixture #Korean Issue Date: 2026-08-06 Comment
テクニカルレポート: https://github.com/SKT-AI/A.X-K2/blob/main/A_X_K2_Tech_Report.pdf
- 8.2Tトークンで事前学習
- DataMixや学習ドメインの変遷などデータに関するレシピも記述されている(英語72.7%に対し、韓国語15.4%, コード8.3%, 日本語、スペイン語、中国語がそれぞれ約1%ずつ)
元ポスト:
Codex Security, OpenAI, 2026.07
Paper/Blog Link My Issue
#Article #Tools #LanguageModel #SoftwareEngineering #One-Line Notes #Security #Author Thread-Post Issue Date: 2026-08-06 Comment
コードベースの脆弱性を検知するLLMベースのCLIツール
元ポスト:
LFM2.5-Encoders: Fast at Long Context, Even on CPU, Liquid AI, 2026.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #MultiLingual #OpenWeight #Selected Papers/Blogs #Encoder #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-08-06 Comment
元ポスト:
CPUでのinferenceにおいて、ModernBERTよりもlong context (8k付近)でのスループットが3.3倍高いEncoder。context長は8192。
HF: https://huggingface.co/LiquidAI/LFM2.5-Encoder-350M
日本語にも対応しているようだが、日本語ModernBertなどと比較して日本語でこのダウンストリームタスクの性能はどうなるだろうか