
NLP (4445) — 14/23
[Paper Note] Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#LanguageModel #Alignment #ReinforcementLearning #Safety Issue Date: 2025-09-20 GPT Summary- 言語モデルを無害なアシスタントとして機能させるために、好みのモデル化と人間のフィードバックからの強化学習(RLHF)を用いて微調整を行い、NLP評価での性能向上を実現。毎週新しいフィードバックデータでモデルを更新し、効率的な改善を図る。RLHFトレーニングの堅牢性を調査し、ポリシーと初期化とのKLダイバージェンスの関係を特定。モデルのキャリブレーションや競合目的についても分析し、人間の作家との比較を行った。
[Paper Note] Emergent Abilities of Large Language Models, Jason Wei+, TMLR'22
Paper/Blog Link My Issue
#Analysis #LanguageModel #Selected Papers/Blogs #EmergentAbilities Issue Date: 2025-09-19 GPT Summary- 大規模言語モデルのスケーリングアップは性能を向上させるが、「出現能力」と呼ばれる予測不可能な現象が存在する。これは小型モデルにはない能力であり、さらなるスケーリングがモデルの能力を拡大する可能性を示唆している。 Comment
openreview: https://openreview.net/forum?id=yzkSU5zdwD
創発能力(最近この用語を目にする機会が減ったような気がする)
[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
Paper/Blog Link My Issue
#Pretraining #LanguageModel #ACL #Selected Papers/Blogs #Deduplication Issue Date: 2025-09-04 GPT Summary- 既存の言語モデルデータセットには重複した例が多く含まれ、訓練されたモデルの出力の1%以上が訓練データからコピーされている。これを解決するために、重複排除ツールを開発し、C4データセットからは60,000回以上繰り返される文を削除。重複を排除することで、モデルの記憶されたテキスト出力を10倍減少させ、精度を維持しつつ訓練ステップを削減。また、訓練とテストの重複を減らし、より正確な評価を実現。研究の再現とコードは公開されている。 Comment
下記スライドのp.9にまとめが記述されている:
https://speakerdeck.com/takase/snlp2023-beyond-neural-scaling-laws?slide=9
[Paper Note] StableMoE: Stable Routing Strategy for Mixture of Experts, Damai Dai+, arXiv'22
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #MoE(Mixture-of-Experts) #Stability Issue Date: 2025-09-02 GPT Summary- StableMoEは、ルーティングの変動問題に対処するために2つのトレーニングステージを持つMixture-of-Experts手法を提案。最初のステージで一貫したルーティング戦略を学習し、軽量ルーターに蒸留。第二のステージでそのルーターを用いてエキスパートへの割り当てを固定。言語モデリングと多言語機械翻訳での実験により、StableMoEは収束速度と性能で既存手法を上回ることが示された。 Comment
元ポスト:
[Paper Note] Matryoshka Representation Learning, Aditya Kusupati+, NeurIPS'22
Paper/Blog Link My Issue
#Embeddings #RepresentationLearning #NeurIPS #Length #Selected Papers/Blogs #Reference Collection Issue Date: 2025-07-29 GPT Summary- マトリョーシカ表現学習(MRL)は、異なる計算リソースに適応可能な柔軟な表現を設計する手法であり、既存の表現学習パイプラインを最小限に修正して使用します。MRLは、粗から細への表現を学習し、ImageNet-1K分類で最大14倍小さい埋め込みサイズを提供し、実世界のスピードアップを実現し、少数ショット分類で精度向上を達成します。MRLは視覚、視覚+言語、言語のモダリティにわたるデータセットに拡張可能で、コードとモデルはオープンソースで公開されています。 Comment
日本語解説: https://speakerdeck.com/hpprc/lun-jiang-zi-liao-matryoshka-representation-learning
単一のモデルから複数のlengthのEmbeddingを出力できるような手法。
解説:
[Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #MachineLearning #MultitaskLearning #MultiModal #SpeechProcessing #ICLR Issue Date: 2025-07-10 GPT Summary- 汎用アーキテクチャPerceiver IOを提案し、任意のデータ設定に対応し、入力と出力のサイズに対して線形にスケール可能。柔軟なクエリメカニズムを追加し、タスク特有の設計を不要に。自然言語、視覚理解、マルチタスクで強力な結果を示し、GLUEベンチマークでBERTを上回る性能を達成。 Comment
当時相当話題となったさまざまなモーダルを統一された枠組みで扱えるPerceiver IO論文
openreview: https://openreview.net/forum?id=fILj7WpI-g
[Paper Note] On Layer Normalizations and Residual Connections in Transformers, Sho Takase+, arXiv'22
Paper/Blog Link My Issue
#Transformer #Architecture #Normalization #Encoder-Decoder #Initial Impression Notes Issue Date: 2025-07-04 GPT Summary- 本研究では、Transformerアーキテクチャのレイヤー正規化の位置に関するPost-LNとPre-LNの違いを調査。Post-LNは浅い層で優れた性能を示す一方、深い層では不安定なトレーニングを引き起こす消失勾配問題があることを発見。これを踏まえ、Post-LNの修正により安定したトレーニングを実現する方法を提案し、実験でPre-LNを上回る結果を示した。 Comment
Pre-LNの安定性を持ちながらもPost-LNのような高い性能を発揮する良いとこ取りのB2TConnectionを提案
NLP2022: https://www.anlp.jp/proceedings/annual_meeting/2022/pdf_dir/A2-5.pdf
[Paper Note] Fast Model Editing at Scale, Eric Mitchell+, ICLR'22
Paper/Blog Link My Issue
#LanguageModel #ICLR #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- MEND(モデル編集ネットワーク)は、事前学習モデルの動作を迅速かつ局所的に編集するための手法で、単一の入力-出力ペアを用いて勾配分解を活用します。これにより、10億以上のパラメータを持つモデルでも、1台のGPUで短時間でトレーニング可能です。実験により、MENDが大規模モデルの編集において効果的であることが示されました。 Comment
OpenReview: https://openreview.net/forum?id=0DcZxeWfOPt
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#LanguageModel #PEFT(Adaptor/LoRA) #ICLR #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] LAION-5B: An open large-scale dataset for training next generation image-text models, Christoph Schuhmann+, NeurIPS'22
Paper/Blog Link My Issue
#ComputerVision #Pretraining #Dataset #MultiModal #CLIP #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-05-06 GPT Summary- LAION-5Bは、5.85億のCLIPフィルタリングされた画像-テキストペアから成る大規模データセットで、英語のペアが2.32B含まれています。このデータセットは、CLIPやGLIDEなどのモデルの再現とファインチューニングに利用され、マルチモーダルモデルの研究を民主化します。また、データ探索やサブセット生成のためのインターフェースや、コンテンツ検出のためのスコアも提供されます。 Comment
openreview: https://openreview.net/forum?id=M3Y74vmsMcY
[Paper Note] Over-Generation Cannot Be Rewarded: Length-Adaptive Average Lagging for Simultaneous Speech Translation, Sara Papi+, NAACL'22
Paper/Blog Link My Issue
#Metrics #Evaluation #SpeechProcessing #AutomaticSpeechRecognition(ASR) #NAACL #SimulST(SimultaneousSpeechTranslation) #One-Line Notes Issue Date: 2025-04-30 GPT Summary- SimulSTシステムの遅延評価において、ALが長い予測に対して過小評価される問題を指摘。過剰生成の傾向を持つシステムに対し、過小生成と過剰生成を公平に評価する新指標LAALを提案。 Comment
同時翻訳研究で主要なmetricの一つ
関連:
- [Paper Note] SimulMT to SimulST: Adapting Simultaneous Text Translation to End-to-End Simultaneous Speech Translation, Xutai Ma+, AACL'20
[Paper Note] DeepNet: Scaling Transformers to 1,000 Layers, Hongyu Wang+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#Transformer #Architecture #Normalization Issue Date: 2025-04-19 GPT Summary- Transformerの安定化手法として、残差接続を修正する新正規化関数DeepNormを提案。理論分析に基づき、初期化を併用しモデルの更新を安定させる。DeepNormはPost-LNの性能とPre-LNの安定性を兼ね備え、1000層へのスケーリングを実現。特に、7,482翻訳方向のベンチマークにおいて、200層の3.2Bパラメータモデルが12Bパラメータの48層モデルを5BLEUポイント上回る成果を示した。 Comment
ステートオブAIガイドによる解説: https://ja.stateofaiguides.com/20220308-deepnet-transformer/
[Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #NeurIPS #Scaling Laws #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-23 GPT Summary- トランスフォーマー言語モデルの訓練において、計算予算内で最適なモデルサイズとトークン数を調査。モデルサイズと訓練トークン数は同等にスケールする必要があり、倍増するごとにトークン数も倍増すべきと提案。Chinchillaモデルは、Gopherなどの大規模モデルに対して優れた性能を示し、ファインチューニングと推論の計算量を削減。MMLUベンチマークで67.5%の精度を達成し、Gopherに対して7%以上の改善を実現。 Comment
OpenReview: https://openreview.net/forum?id=iBBcRUlOAPR
chinchilla則、モデルの規模とデータ量はおおむね同じ比率でスケールすべき、という話。
[Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #Transformer #Architecture #MoE(Mixture-of-Experts) #Selected Papers/Blogs #JMLR Issue Date: 2025-02-11 GPT Summary- Switch Transformerを提案し、Mixture of Experts (MoE)の複雑さや通信コスト、トレーニングの不安定性を改善。これにより、低精度フォーマットでの大規模スパースモデルのトレーニングが可能になり、最大7倍の事前トレーニング速度向上を実現。さらに、1兆パラメータのモデルを事前トレーニングし、T5-XXLモデルに対して4倍の速度向上を達成。
[Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #EMNLP #PostTraining #KeyPoint Notes Issue Date: 2024-10-29 GPT Summary- NLPモデルの一般化能力を評価するために、1,616の多様なタスクを含むSuper-NaturalInstructionsというベンチマークを導入。76種のタスクタイプをカバーし、モデルをタスクのサブセットで訓練し未見のタスクを評価。Tk-Instructモデルは、InstructGPTを9%以上上回る性能を示し、サイズが小さい。タスク数やインスタンス数に基づいた一般化の分析を行い、本データセットとモデルが汎用的NLPモデルの進展に寄与することを期待。 Comment
7.1, 7.2が最も興味深い
## Instruction Tuningにおける未知のタスクに対する汎化性能について、3つの要素に対するスケーリングについて考察
- More observed tasks improve the generalization.
- A large number of training instances do not help generalization.
- Tuning larger models with instructions consistently lead to gains.
## Instructionをさまざまに変化させた時の性能の変化に対する分析
Table4の対角成分に注目すると(trainとtestのinput encodingを揃えた場合)
- Task definitionをinstructionに含めることで未知タスクに対する汎化性能向上
- Task Definitionとpositive examplesを4つ程度入れると汎化性能向上。
- ただし、これ以上exampleを増やすと性能低下。
- negative examplesを入れることは性能に a little bit しか貢献しない
- explanationsを入れると性能が低下する
Table4の非対角成分に着目すると、
- Task Definitionのみで訓練しても、Example onlyのtest時のencodingには汎化しない(逆も然り)
- Task Definition + examples (今回の場合はpositive examples4つ)は、さまざまなtest時のinput encodingsに対してロバストになる
[Paper Note] No Language Left Behind: Scaling Human-Centered Machine Translation, NLLB Team+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#MachineTranslation #Dataset #LowResource #One-Line Notes Issue Date: 2024-09-26 GPT Summary- 低資源言語翻訳を支援するため、母語話者へのインタビューを通じてニーズを明らかにし、新たなデータセットとモデルを開発。Sparsely Gated Mixture of Expertsに基づく条件付き計算モデルを用い、訓練時の過剰適合を抑えつつ性能を向上。Flores-200ベンチマークにより翻訳性能を評価し、BLEUスコアを44%改善。研究成果はオープンソースとして公開。 Comment
low-resourceな言語に対するMTのベンチマーク
[Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-09-25 GPT Summary- 指示チューニングにより言語モデルのゼロショット学習能力を向上。1370億パラメータのモデルを60以上のNLPタスクに対してファインチューニングし、FLANと名付ける。FLANは未調整モデルを超え、25タスク中20タスクで175B GPT-3を上回り、ANLIやRTEなどでfew-shotのGPT-3にも勝る。ファインチューニングデータの数やモデル規模、指示内容が成功の鍵と示される。 Comment
FLAN論文。Instruction Tuningを提案した研究。
openreview: https://openreview.net/forum?id=gEZrGCozdqR
[Paper Note] STaR: Bootstrapping Reasoning With Reasoning, Eric Zelikman+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#LanguageModel #SelfImprovement #NeurIPS #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2024-09-15 GPT Summary- STaR(Self-Taught Reasoner)を提案し、少数の推論例と大規模データセットを用いて段階的に複雑な推論を行う手法を紹介。まず複数の質問に対して推論根拠を生成し、誤答時には正しい解答を前提に再生成を行うことで性能を向上。STaRはファインチューニングにより自己学習能力を持ち、複数のデータセットでの性能を顕著に改善、CommensenseQAでは最先端モデルと同等の結果を達成。 Comment
OpenAI o1関連研究
openreview: https://openreview.net/forum?id=_3ELRdg2sgI
モデルが正解できなかった問題に対して、解答で条件付けした上で推論過程(rationale)を生成することで、finetuning用の追加の学習事例を獲得する。
Knowledge Neurons in Pretrained Transformers, Damai Dai+, N_A, ACL'22, 2022.05
Paper/Blog Link My Issue
#Analysis #Transformer #ACL #KnowledgeEditing #Selected Papers/Blogs #FactualKnowledge #Encoder #KeyPoint Notes #Reference Collection Issue Date: 2024-07-11 GPT Summary- 大規模な事前学習言語モデルにおいて、事実知識の格納方法についての研究を行いました。具体的には、BERTのfill-in-the-blank cloze taskを用いて、関連する事実を表現するニューロンを特定しました。また、知識ニューロンの活性化と対応する事実の表現との正の相関を見つけました。さらに、ファインチューニングを行わずに、知識ニューロンを活用して特定の事実知識を編集しようと試みました。この研究は、事前学習されたTransformers内での知識の格納に関する示唆に富んでおり、コードはhttps://github.com/Hunter-DDM/knowledge-neuronsで利用可能です。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
日本語解説: https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022
関連:
- [Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
上記資料によると、特定の知識を出力する際に活性化する知識ニューロンを特定する手法を提案。MLMを用いたclozeタスクによる実験で[MASK]部分に当該知識を出力する実験をした結果、知識ニューロンの重みをゼロとすると性能が著しく劣化し、値を2倍にすると性能が改善するといった傾向がみられた。 ケーススタディとして、知識の更新と、知識の削除が可能かを検証。どちらとも更新・削除がされる方向性[^1]へモデルが変化した。
また、知識ニューロンはTransformerの層の深いところに位置している傾向にあり、異なるrelationを持つような関係知識同士では共有されない傾向にある模様。
[^1]: 他の知識に影響を与えず、完璧に更新・削除できたわけではない。知識の更新・削除に伴いExtrinsicな評価によって性能向上、あるいはPerplexityが増大した、といった結果からそういった方向性へモデルが変化した、という話
Training language models to follow instructions with human feedback, Long Ouyang+, N_A, NeurIPS'22
Paper/Blog Link My Issue
#LanguageModel #Alignment #ChatGPT #RLHF #Actor-Critic #PostTraining #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-28 GPT Summary- 大規模な言語モデルは、ユーザーの意図に合わない出力を生成することがあります。本研究では、人間のフィードバックを使用してGPT-3を微調整し、InstructGPTと呼ばれるモデルを提案します。この手法により、13億パラメータのInstructGPTモデルの出力が175BのGPT-3の出力よりも好まれ、真実性の向上と有害な出力の削減が示されました。さらに、一般的なNLPデータセットにおける性能の低下は最小限でした。InstructGPTはまだ改善の余地がありますが、人間のフィードバックを使用した微調整が有望な方向であることを示しています。 Comment
ChatGPTの元となる、SFT→Reward Modelの訓練→RLHFの流れが提案された研究。DemonstrationデータだけでSFTするだけでは、人間の意図したとおりに動作しない問題があったため、人間の意図にAlignするように、Reward Modelを用いたRLHFでSFTの後に追加で学習を実施する。Reward Modelは、175Bモデルは学習が安定しなかった上に、PPOの計算コストが非常に大きいため、6BのGPT-3を様々なNLPタスクでSFTしたモデルをスタートにし、モデルのアウトプットに対して人間がランキング付けしたデータをペアワイズのloss functionで訓練した。最終的に、RMのスコアが最大化されるようにSFTしたGPT-3をRLHFで訓練するが、その際に、SFTから出力が離れすぎないようにする項と、NLPベンチマークでの性能が劣化しないようにpretrain時のタスクの性能もloss functionに加えている。
MURMUR: Modular Multi-Step Reasoning for Semi-Structured Data-to-Text Generation, Swarnadeep Saha+, N_A, arXiv'22
Paper/Blog Link My Issue
#NaturalLanguageGeneration #DataToTextGeneration #StructuredData Issue Date: 2023-10-28 GPT Summary- 本研究では、半構造化データからのテキスト生成における多段階の推論を行うためのMURMURという手法を提案しています。MURMURは、特定の言語的および論理的なスキルを持つニューラルモジュールと記号モジュールを組み合わせ、ベストファーストサーチ手法を使用して推論パスを生成します。実験結果では、MURMURは他のベースライン手法に比べて大幅な改善を示し、また、ドメイン外のデータでも同等の性能を達成しました。さらに、人間の評価では、MURMURは論理的に整合性のある要約をより多く生成することが示されました。
Momentum Calibration for Text Generation, Xingxing Zhang+, N_A, arXiv'22
Paper/Blog Link My Issue
#BeamSearch #NaturalLanguageGeneration Issue Date: 2023-08-16 GPT Summary- 本研究では、テキスト生成タスクにおいてMoCa(Momentum Calibration)という手法を提案しています。MoCaは、ビームサーチを用いた遅く進化するサンプルを動的に生成し、これらのサンプルのモデルスコアを実際の品質に合わせるように学習します。実験結果は、MoCaが強力な事前学習済みTransformerを改善し、最先端の結果を達成していることを示しています。
[Paper Note] BRIO: Bringing Order to Abstractive Summarization, Yixin Liu+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#DocumentSummarization #BeamSearch #NaturalLanguageGeneration #ACL #One-Line Notes #needs-revision Issue Date: 2023-08-16 GPT Summary- 非決定論的分布を仮定し、複数の候補要約に確率を割り当てる新しい訓練パラダイムを提案。CNN/DailyMailおよびXSumデータセットで最先端のROUGEスコアを達成し、モデルが候補要約の品質と相関する確率を推定可能であることを示す。 Comment
ビーム内のトップがROUGEを最大化しているとは限らなかったため、ROUGEが最大となるような要約を選択するようにしたら性能爆上げしましたという研究。
実質現在のSoTA
SMART: Sentences as Basic Units for Text Evaluation, Reinald Kim Amplayo+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-14 GPT Summary- 本研究では、テキスト生成の評価指標の制限を緩和するために、新しい指標であるSMARTを提案する。SMARTは文を基本的なマッチング単位とし、文のマッチング関数を使用して候補文と参照文を評価する。また、ソースドキュメントの文とも比較し、評価を可能にする。実験結果は、SMARTが他の指標を上回ることを示し、特にモデルベースのマッチング関数を使用した場合に有効であることを示している。また、提案された指標は長い要約文でもうまく機能し、特定のモデルに偏りが少ないことも示されている。
FFCI: A Framework for Interpretable Automatic Evaluation of Summarization, Fajri Koto+, N_A, JAIR'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #Reference-based Issue Date: 2023-08-13 GPT Summary- 本論文では、FFCIという細かい要約評価のためのフレームワークを提案しました。このフレームワークは、信頼性、焦点、カバレッジ、および文間の連続性の4つの要素から構成されています。新しいデータセットを構築し、評価メトリックとモデルベースの評価方法をクロス比較することで、FFCIの4つの次元を評価するための自動的な方法を開発しました。さまざまな要約モデルを評価し、驚くべき結果を得ました。 Comment
先行研究でどのようなMetricが利用されていて、それらがどういった観点のMetricなのかや、データセットなど、非常に細かくまとまっている。
Faithfulness(ROUGE, STS-Score, BERTScoreに基づく), Focus and Coverage (Question Answering basedな手法に基づく), Inter-Sentential Coherence (NSPに基づく)メトリックを組み合わせることを提案している。
InfoLM: A New Metric to Evaluate Summarization & Data2Text Generation, Pierre Colombo+, N_A, AAAI'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13 GPT Summary- 自然言語生成システムの品質評価は高価であり、人間の注釈に頼ることが一般的です。しかし、自動評価指標を使用することもあります。本研究では、マスクされた言語モデルを使用した評価指標であるInfoLMを紹介します。この指標は同義語を処理することができ、要約やデータ生成の設定で有意な改善を示しました。
WIDAR -- Weighted Input Document Augmented ROUGE, Raghav Jain+, N_A, ECIR'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13 GPT Summary- 自動テキスト要約の評価において、ROUGEメトリックには制約があり、参照要約の利用可能性に依存している。そこで、本研究ではWIDARメトリックを提案し、参照要約だけでなく入力ドキュメントも使用して要約の品質を評価する。WIDARメトリックは一貫性、整合性、流暢さ、関連性の向上をROUGEと比較しており、他の最先端のメトリックと同等の結果を短い計算時間で得ることができる。
SummaC: Re-Visiting NLI-based Models for Inconsistency Detection in Summarization, Laban+, TACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #LM-based #Factuality #TACL Issue Date: 2023-08-13
[Paper Note] TRUE: Re-evaluating Factual Consistency Evaluation, Or Honovich+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Factuality #One-Line Notes #needs-revision Issue Date: 2023-08-13 GPT Summary- 事実的一致性評価が重要なテキスト生成システムにおいて、矛盾を減らすための自動評価が提案される。従来の評価指標は特定のタスクに偏りがあり、実用性に欠けることが多い。これに対抗して、TRUEを提案し、多様なタスクに基づく標準化されたコレクションに対する人手注釈のもとでの評価を行う。これにより、例レベルのメタ評価プロトコルが実現し、質の高い評価が可能となった。大規模なNLIや質問生成モデルが強力な結果を示し、今後の評価方法の改善へ向けた新たな指針を提供する。 Comment
FactualConsistencyに関するMetricが良くまとまっている
[Paper Note] MaskEval: Weighted MLM-Based Evaluation for Text Summarization and Simplification, Yu Lu Liu+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13 GPT Summary- 本研究では、テキストの要約と簡素化のための参照のない評価尺度であるMaskEvalを提案しています。MaskEvalは、候補テキストとソーステキストの連結に対してマスクされた言語モデリングを行い、重要な品質の側面ごとに相対的な重要性を調整することができます。さらに、英語の要約と簡素化における人間の判断との相関に基づいて、その効果を示し、両方のタスク間での転移シナリオを探索します。
Reference-free Summarization Evaluation via Semantic Correlation and Compression Ratio, Liu+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free Issue Date: 2023-08-13
Re-Examining System-Level Correlations of Automatic Summarization Evaluation Metrics, Deutsch+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
Does Summary Evaluation Survive Translation to Other Languages?, Braun+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
SummScore: A Comprehensive Evaluation Metric for Summary Quality Based on Cross-Encoder, Wuhang Lin+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #TrainedMetrics Issue Date: 2023-08-13 GPT Summary- 要約の品質評価メトリクスの問題を解決するために、SummScoreという包括的な評価メトリクスを提案する。SummScoreはCrossEncoderに基づいており、要約の多様性を抑制せずに要約の品質を評価することができる。さらに、SummScoreは一貫性、一貫性、流暢さ、関連性の4つの側面で評価することができる。実験結果は、SummScoreが既存の評価メトリクスを上回ることを示している。また、SummScoreの評価結果を16の主要な要約モデルに提供している。
SueNes: A Weakly Supervised Approach to Evaluating Single-Document Summarization via Negative Sampling, Bao+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13
PrefScore: Pairwise Preference Learning for Reference-free Summarization Quality Assessment, Luo+, COLING'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13
How to Find Strong Summary Coherence Measures? A Toolbox and a Comparative Study for Summary Coherence Measure Evaluation, Steen+, COLING'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
Self-Repetition in Abstractive Neural Summarizers, Nikita Salkar+, N_A, AACL-IJCNLP'22
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #Analysis #IJCNLP #AACL #Repetition Issue Date: 2023-08-13 GPT Summary- 私たちは、BART、T5、およびPegasusという3つのニューラルモデルの出力における自己繰り返しの分析を行いました。これらのモデルは、異なるデータセットでfine-tuningされています。回帰分析によると、これらのモデルは入力の出力要約間でコンテンツを繰り返す傾向が異なることがわかりました。また、抽象的なデータや定型的な言語を特徴とするデータでのfine-tuningでは、自己繰り返しの割合が高くなる傾向があります。定性的な分析では、システムがアーティファクトや定型フレーズを生成することがわかりました。これらの結果は、サマライザーのトレーニングデータを最適化するための手法の開発に役立つ可能性があります。
Universal Evasion Attacks on Summarization Scoring, Wenchuan Mu+, N_A, BlackboxNLP workshop on ACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #ACL #Workshop Issue Date: 2023-08-13 GPT Summary- 要約の自動評価は重要であり、その評価は複雑です。しかし、これまで要約の評価は機械学習のタスクとは考えられていませんでした。本研究では、自動評価の堅牢性を探るために回避攻撃を行いました。攻撃システムは、要約ではない文字列を予測し、一般的な評価指標であるROUGEやMETEORにおいて優れた要約器と競合するスコアを達成しました。また、攻撃システムは最先端の要約手法を上回るスコアを獲得しました。この研究は、現在の評価システムの堅牢性の低さを示しており、要約スコアの開発を促進することを目指しています。
[Paper Note] RISE: Leveraging Retrieval Techniques for Summarization Evaluation, David Uthus+, arXiv'22, 2022.12
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free #ACL #Findings #Surface-level Notes Issue Date: 2023-08-13 GPT Summary- 自動生成された要約の評価は困難であり、これまでの手法は人間の評価に及ばない。新たに提案されたRISEは、デュアルエンコーダー検索設定を用いて生成要約を評価する手法で、ゴールド標準の参照要約がなくても機能する。特に参照要約がない新たなデータセットに対して効果的であり、SummEvalベンチマークでの実験により、人間の評価と高い相関を示した。RISEはデータ効率性と多言語間の一般化可能性も備えている。 Comment
# 概要
Dual-Encoderを用いて、ソースドキュメントとシステム要約をエンコードし、dot productをとることでスコアを得る手法。モデルの訓練は、Contrastive Learningで行い、既存データセットのソースと参照要約のペアを正例とみなし、In Batch trainingする。
# 分類
Reference-free, Model-based, ソース依存で、BARTScore [Paper Note] BARTScore: Evaluating Generated Text as Text Generation, Weizhe Yuan+, arXiv'21, 2021.06
とは異なり、文書要約データを用いて学習するため、要約の評価に特化している点が特徴。
# モデル
## Contrastive Learning
Contrastive Learningを用い、hard negativeを用いたvariantも検証する。また、訓練データとして3種類のパターンを検証する:
1. in-domain data: 文書要約データを用いて訓練し、ターゲットタスクでどれだけの性能を発揮するかを見る
2. out-of-domain data: 文書要約以外のデータを用いて訓練し、どれだけ新しいドメインにモデルがtransferできるかを検証する
3. in-and-out-domain data: 両方やる
## ハードネガティブの生成
Lexical Negatives, Model Negatives, 双方の組み合わせの3種類を用いてハードネガティブを生成する。
### Lexical Negatives
参照要約を拡張することによって生成する。目的は、もともとの参照要約と比較して、poor summaryを生成することにある。Data Augmentationとして、以下の方法を試した:
- Swapping noun entities: 要約中のエンティティを、ソース中のエンティティンとランダムでスワップ
- Shuffling words: 要約中の単語をランダムにシャッフル
- Dropping words: 要約中の単語をランダムに削除
- Dropping characters: 要約中の文字をランダムに削除
- Swapping antonyms: 要約中の単語を対義語で置換
### Model Negatives
データセットの中から負例を抽出する。目的は、参照要約と類似しているが、負例となるサンプルを見つけること。これを実現するために、まずRISE modelをデータセットでfinetuningし、それぞれのソースドキュメントの要約に対して、類似した要約をマイニングする。すべてのドキュメントと要約をエンコードし、top-nの最も類似した要約を見つけ、これをハードネガティブとして、再度モデルを訓練する。
### 両者の組み合わせ
まずlexical negativesでモデルを訓練し、モデルネガティブの抽出に活用する。抽出したモデルネガティブを用いて再度モデルを訓練することで、最終的なモデルとする。
# 実験
## 学習手法
SummEval SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
を用いて人手評価と比較してどれだけcorrelationがあるかを検証。SummEvalには16種類のモデルのアウトプットに対する、CNN / Daily Mail の100 examplesに対して、品質のアノテーションが付与されている。expert annotationを用いて、Kendall's tauを用いてシステムレベルのcorrelationを計算した。contextが短い場合はT5, 長い場合はLongT5, タスクがマルチリンガルな場合はmT5を用いて訓練した。訓練データとしては
- CNN / Daily Mail
- Multi News
- arXiv
- PubMed
- BigPatent
- SAMSum
- Reddit TIFU
- MLSUM
等を用いた。これによりshort / long contextの両者をカバーできる。CNN / Daily Mail, Reddiit TIFU, Multi-Newsはshort-context, arXiv, PubMed, BigPatent, Multi-News(長文のものを利用)はlonger contextとして利用する。
## 比較するメトリック
ROUGE, chrF, SMS, BARTScore, SMART, BLEURT, BERTScore, Q^2, T5-ANLI, PRISMと比較した。結果をみると、Consistency, Fluency, Relevanceで他手法よりも高い相関を得た。Averageでは最も高いAverageを獲得した。in-domain dataで訓練した場合は、高い性能を発揮した。our-of-domain(SAMSum; Dialogue要約のデータ)データでも高い性能を得た。
# Ablation
## ハードネガティブの生成方法
Data Augmentationは、swapping entity nouns, randomly dropping wordsの組み合わせが最も良かった。また、Lexical Negativesは、様々なデータセットで一貫して性能が良かったが、Model NegativesはCNN/DailyMailに対してしか有効ではなかった。これはおそらく、同じタスク(テストデータと同じデータ)でないと、Model Negativesは機能しないことを示唆している。ただし、Model Negativesを入れたら、何もしないよりも性能向上するから、何らかの理由でlexical negativesが生成できない場合はこっち使っても有用である。
## Model Size
でかい方が良い。in-domainならBaseでもそれなりの性能だけど、結局LARGEの方が強い。
## Datasets
異なるデータセットでもtransferがうまく機能している。驚いたことにデータセットをmixingするとあまりうまくいかず、単体のデータセットで訓練したほうが性能が良い。
LongT5を見ると、T5よりもCorrelationが低く難易度が高い。
最終的に英語の要約を評価をする場合でも、Multilingual(別言語)で訓練しても高いCorrelationを示すこともわかった。
## Dataset Size
サンプル数が小さくても有効に働く。しかし、out-domainのデータの場合は、たとえば、512件の場合は性能が低く少しexampleを増やさなければならない。
DocAsRef: A Pilot Empirical Study on Repurposing Reference-Based Summary Quality Metrics Reference-Freely, Forrest Sheng Bao+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 参照ベースと参照フリーの要約評価メトリックがあります。参照ベースは正確ですが、制約があります。参照フリーは独立していますが、ゼロショットと正確さの両方を満たせません。本研究では、参照ベースのメトリックを使用してゼロショットかつ正確な参照フリーのアプローチを提案します。実験結果は、このアプローチが最も優れた参照フリーのメトリックを提供できることを示しています。また、参照ベースのメトリックの再利用と追加の調整についても調査しています。
[Paper Note] Personalized News Headline Generation System with Fine-grained User Modeling, Jiaohong Yao, MSN'22
Paper/Blog Link My Issue
#PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration Issue Date: 2023-08-11
Personalized Headline Generation with Enhanced User Interest Perception, Zhang+, ICANN'22
Paper/Blog Link My Issue
#PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration Issue Date: 2023-08-11
[Paper Note] Personalized Chit-Chat Generation for Recommendation Using External Chat Corpora, Chen+, KDD'22
Paper/Blog Link My Issue
#RecommenderSystems #PersonalizedGeneration #Personalization #SIGKDD Issue Date: 2023-08-11
[Paper Note] Explaining Patterns in Data with Language Models via Interpretable Autoprompting, Chandan Singh+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Dataset #LanguageModel #DataToTextGeneration #Explanation #One-Line Notes #Data Issue Date: 2023-08-03 GPT Summary- iPromptを用いて、事前学習済みのLLMがデータを説明する自然言語文字列を生成する手法を提案。このアルゴリズムは、生成された説明の性能を再評価して最適化するプロセスを含む。実験によりiPromptが正確なデータ記述を見つけ、人間にも解釈可能なプロンプトを生成し、一般化性能に優れることが示された。特に、実世界の感情分類データセットでGPT-3並みのプロンプトを生成し、科学的発見の支援にも寄与する可能性がある。すべてのコードはGitHubで公開。 Comment
OpenReview: https://openreview.net/forum?id=GvMuB-YsiK6
データセット(中に存在するパターンの説明)をLLMによって生成させる研究


[Paper Note] RQUGE: Reference-Free Metric for Evaluating Question Generation by Answering the Question, Alireza Mohammadshahi+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Metrics #LanguageModel #QuestionAnswering #Evaluation #Reference-free #ACL #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- 既存の質問評価指標には、人間の参照質問との比較による語彙的重複や意味的類似性に基づく欠点がある。これに対し、本研究で提案する新しい指標RQUGEは、候補質問の文脈に基づく回答可能性を評価し、人間の判断と高い相関を示す。この指標は既存の事前学習モデルを活用し、追加訓練なしで使用可能。また、RQUGEは対抗的改ざんに対して堅牢であり、質問生成モデルからの合成データを用いた微調整により、QAモデルの性能を向上させることができる。 Comment
# 概要
質問自動生成の性能指標(e.g. ROUGE, BERTScore)は、表層の一致、あるいは意味が一致した場合にハイスコアを与えるが、以下の欠点がある
- 人手で作成された大量のreference questionが必要
- 表層あるいは意味的に近くないが正しいquestionに対して、ペナルティが与えられてしまう
=> contextに対するanswerabilityによって評価するメトリック RQUGE を提案
similarity basedな指標では、Q1のような正しい質問でもlexical overlapがないと低いスコアを与えてしまう。また、Q2のようなreferenceの言い換えであっても、低いスコアとなってしまう。一方、reference basedな手法では、Q3のようにunacceptableになっているにもかかわらず、変化が微小であるためそれをとらえられないという問題がある。
# 手法概要
提案手法ではcontextとanswer spanが与えられたとき、Span Scorerと、QAモジュールを利用してacceptability scoreを計算することでreference-freeなmetricを実現する。
QAモデルは、Contextと生成されたQuestionに基づき、answer spanを予測する。提案手法ではT5ベースの手法であるUnifiedQAv2を利用する。
Span Scorer Moduleでは、予測されたanswer span, candidate question, context, gold spanに基づき、[1, 5]のスコアを予測する。提案手法では、encoder-only BERT-based model(提案手法ではRoBERTa)を用いる。
[Paper Note] PAD-Net: An Efficient Framework for Dynamic Networks, Shwai He+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #EfficiencyImprovement #MachineLearning #DynamicNetworks #ACL #Encoder Issue Date: 2023-07-18 GPT Summary- 動的ネットワークはモデルの表現力を向上させるが、完全に動的にすると冗長なパラメータと高いコストが生じる。本研究では、冗長な動的パラメータを静的パラメータに変換する部分的動的ネットワーク、PAD-Netを提案し、動的と静的パラメータを効率的に分割するIterative Mode Partitionを用いた。実験により、ResNet-50で動的パラメータを30%使用してトップ1精度を+0.7%向上、BERTで50%使用して言語理解のスコアを+1.9%改善した。コードは公開予定。
[Paper Note] Z-Code++: A Pre-trained Language Model Optimized for Abstractive Summarization, Pengcheng He+, arXiv'22, 2022.08
Paper/Blog Link My Issue
#DocumentSummarization #Abstractive #pretrained-LM #InstructionTuning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- Z-Code++は、抽象的テキスト要約のために最適化された新しい事前学習済み言語モデルで、性能向上のために3つの手法を採用。まず、2段階の事前学習プロセスで、言語理解と要約コーパスを活用して根拠あるテキスト生成を実現。次に、自己注意層をディスエンタンゲルド・アテンションに置き換え、最後にFusion-in-Encoderを用いて長い系列を階層的にエンコード。5言語の13タスク中9タスクで新たな最先端を達成し、パラメータ効率は高く、ゼロショット・少数ショットでも競合モデルを大幅に上回る性能を示す。
[Paper Note] Unnatural Instructions: Tuning Language Models with (Almost) No Human Labor, Or Honovich+, arXiv'22, 2022.12
Paper/Blog Link My Issue
#Dataset #InstructionTuning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- 指示チューニングを通じて、言語モデルが自然言語の説明から新しいタスクを実行できるようにするため、ほとんど人間の労力を要さずに収集した多様な指示データセット「Unnatural Instructions」を紹介。64,000の例を生成し約240,000例に拡張した実験では、ノイズが多いにもかかわらず、このデータセットでの学習が手動のキュレーションされたデータセットに匹敵し、T0++やTk-Instructよりも優れた性能を示した。これは、クラウドソーシングのコストを抑えたデータセットの拡張手法の有効性を示唆している。
[Paper Note] Pruning Pre-trained Language Models Without Fine-Tuning, Ting Jiang+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#LanguageModel #Pruning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- プルーニングによる事前学習済み言語モデル(PLMs)の圧縮手法を提案。特にStatic Model Pruning(SMP)は、一階法の剪定のみでPLMsを下流タスクに適応させ、スパース性を達成。新たなマスキング関数と訓練目的関数を設計し、広範な実験で顕著な性能向上を示す。SMPはファインチューニングを不要とし、パラメータ効率が良好。
[Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- HELMは、言語モデルの透明性を高めるための包括的評価手法である。まず、潜在的なシナリオと指標の分類を行い、欠落している部分を特定。次に、マルチ指標アプローチを採用し、コアシナリオごとに7つの評価指標を測定することで、正確性以外の側面も考慮。さらに、30の著名な言語モデルに対して大規模評価を実施し、評価範囲を17.9%から96.0%に改善。全データを公開し、HELMをコミュニティの生きたベンチマークとして継続的に更新していくことを目指している。 Comment
OpenReview: https://openreview.net/forum?id=iO4LZibEqW
HELMを提案した研究
当時のLeaderboardは既にdeprecatedであり、現在は下記を参照:
https://crfm.stanford.edu/helm/
[Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- 言語モデルはスケールの拡大に伴い、新しい定量的・質的能力を示すが、その具体的な特性は未解明である。これを踏まえ、BIG-benchという新たなベンチマークを導入し、204の多様なタスクを評価。モデルの性能と較正は改善するが、絶対的には低く、スパース性の影響を受ける場合もある。特に、複数の手順を要するタスクは臨界規模での“ブレークスルー”を示す傾向があり、社会的バイアスは通常、スケールと共に増加するが、プロンプトによって改善可能である。 Comment
OpenReview: https://openreview.net/forum?id=uyTL5Bvosj
BIG-Bench論文。ワードクラウドとキーワード分布を見ると一つの分野に留まらない非常に多様なタスクが含まれることがわかる。
BIG-Bench-hardは、2024年にClaude3.5によって、Average Human Scoreが67.7%のところ、93.1%を達成され攻略が完了した。現在は最先端のモデル間の性能を差別化することはできない。
- Killed by LLM, R0bk
[Paper Note] Mass-Editing Memory in a Transformer, Kevin Meng+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#LanguageModel #ICLR #KnowledgeEditing #needs-revision Issue Date: 2023-05-04 GPT Summary- 最近の研究は、大規模言語モデルの更新に新たな記憶を利用する可能性を示しているが、主に単一の関連付けに限定されています。我々はMEMITを開発し、複数の記憶を使ってモデルを直接更新する手法を提案します。実験的に、GPT-J(6B)およびGPT-NeoX(20B)に対して多数の関連付けを効果的に処理できることを示し、従来の方法を大幅に上回る成果を達成しました。
[Paper Note] Large Language Models are Zero-Shot Reasoners, Takeshi Kojima+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)は自然言語処理において少数ショット学習の能力が高く、CoT promptingにより複雑な多段階推論を効果的に引き出す。特に「Let's think step by step」の追加で、ゼロショット推論能力が向上し、様々な論理推論タスクで手作りの例を使わずに性能を大幅に向上させた。例えば、InstructGPTモデルでのMultiArithの精度が17.7%から78.7%へ、GSM8Kが10.4%から40.7%と劇的な改善が見られた。この研究はLLMsの潜在的なゼロショット能力を示し、ファインチューニングや少数ショットの前にその知識を探求する重要性が強調されている。 Comment
Zero-Shot CoT (Let's think step-by-step.)論文

Zero-Shot-CoTは2つのステップで構成される:
- STEP1: Reasoning Extraction
- 元のquestionをxとし、zero-shot-CoTのtrigger sentenceをtとした時に、テンプレート "Q: [X]. A. [T]" を用いてprompt x'を作成
- このprompt x'によって得られる生成テキストzはreasoningのrationaleとなっている。
- STEP2: Answer Extraction
- STEP1で得られたx'とzを用いて、テンプレート "[X'] [Z] [A]" を用いてpromptを作成し、quiestionに対する回答を得る
- このとき、Aは回答を抽出するためのtrigger sentenceである。
- Aはタスクに応じて変更するのが効果的であり、たとえば、multi-choice QAでは "Therefore, among A through E, the answer is" といったトリガーを用いたり、数学の問題では "Therefore, the answer (arabic numerals) is" といったトリガーを用いる。
# 実験結果
表中の性能指標の左側はタスクごとにAnswer Triggerをカスタマイズしたもので、右側はシンプルに"The answer is"をAnswer Triggerとした場合。Zero-shot vs. Zero-shot-CoTでは、Zero-Shot-CoTが多くのb現地マークにおいて高い性能を示している。ただし、commonsense reasoningではperformance gainを得られなかった。これは [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
で報告されている通り、commonsense reasoningタスクでは、Few-Shot CoTでもLambda135Bで性能が向上せず、Palm540Bで性能が向上したように、モデルのparameter数が足りていない可能性がある(本実験では17種類のモデルを用いているが、特に注釈がなければtext-davinci-002を利用した結果)。
## 他ベースラインとの比較
他のベースラインとarithmetic reasoning benchmarkで性能比較した結果。Few-Shot-CoTには勝てていないが、standard Few-shot Promptingtを大幅に上回っている。
## zero-shot reasoningにおけるモデルサイズの影響
さまざまな言語モデルに対して、zero-shotとzero-shot-CoTを実施した場合の性能比較。[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
と同様にモデルサイズが小さいとZero-shot-CoTによるgainは得られないが、モデルサイズが大きくなると一気にgainが大きくなる。
## Zero-shot CoTにおけるpromptの選択による影響
input promptに対するロバスト性を確認した。instructiveカテゴリ(すなわち、CoTを促すトリガーであれば)性能が改善している。特に、どのようなsentenceのトリガーにするかで性能が大きくかわっている。今回の実験では、"Let's think step by step"が最も高い性能を占め最多。
## Few-shot CoTのprompt選択における影響
CommonsenseQAのexampleを用いて、AQUA-RAT, MultiArithをFew-shot CoTで解いた場合の性能。どちらのケースもドメインは異なるが、前者は回答のフォーマットは共通である。異なるドメインでも、answer format(multiple choice)の場合、ドメインが異なるにもかかわらず、zero-shotと比較して性能が大幅に向上した。一方、answer formatが異なる場合はperformance gainが小さい。このことから、LLMはtask自体よりも、exampleにおけるrepeated formatを活用していることを示唆している。また、CommonSennseをExamplarとして用いたFew-Shot-CoTでは、どちらのデータセットでもZero-Shot-CoTよりも性能が劣化している。つまり、Few-Shot-CoTでは、タスク特有のサンプルエンジニアリングが必要であることがわかる(一方、Zero-shot CoTではそのようなエンジニアリングは必要ない)。
[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
Paper/Blog Link My Issue
#LanguageModel #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes #EmergentAbilities Issue Date: 2023-04-27 GPT Summary- 思考の連鎖によって、大規模言語モデルの推論能力が向上することを探求。チェーン・オブ・ソート思考のプロンプトを用いる事例を示し、3つのモデルでの実験を通じて算術や常識、象徴的推論において性能向上を確認。特に、5400億パラメータのモデルに8つのデモをプロンプトとして与えただけで、数学問題のGSM8Kベンチマークで最先端の精度を達成した。 Comment
Chain-of-Thoughtを提案した論文。CoTをする上でパラメータ数が100B未満のモデルではあまり効果が発揮されないということは念頭に置いた方が良さそう。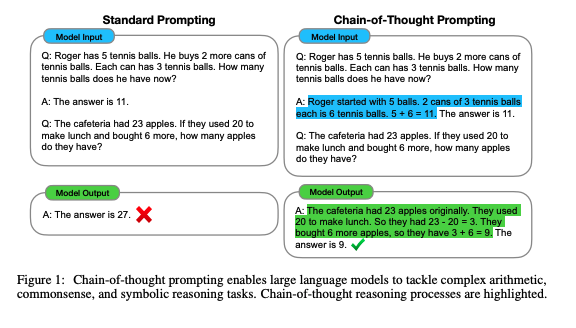
先行研究では、reasoningが必要なタスクの性能が低い問題をintermediate stepを明示的に作成し、pre-trainedモデルをfinetuningすることで解決していた。しかしこの方法では、finetuning用の高品質なrationaleが記述された大規模データを準備するのに多大なコストがかかるという問題があった。
このため、few-shot promptingによってこの問題を解決することが考えられるが、reasoning能力が必要なタスクでは性能が悪いという問題あがった。そこで、両者の強みを組み合わせた手法として、chain-of-thought promptingは提案された。
# CoTによる実験結果
以下のベンチマークを利用
- math word problem: GSM8K, SVAMP, ASDiv, AQuA, MAWPS
- commonsense reasoning: CSQA, StrategyQA, Big-bench Effort (Date, Sports), SayCan
- Symbolic Reasoning: Last Letter concatenation, Coin Flip
- Last Letter concatnation: 名前の単語のlast wordをconcatするタスク("Amy Brown" -> "yn")
- Coin Flip: コインをひっくり返す、 あるいはひっくり返さない動作の記述の後に、コインが表向きであるかどうかをモデルに回答するよう求めるタスク
## math word problem benchmark
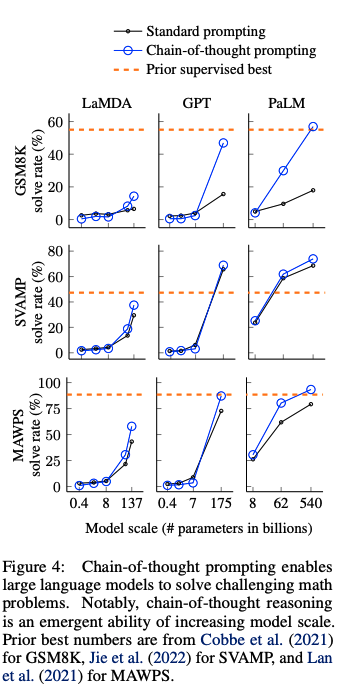
- モデルのサイズが大きくなるにつれ性能が大きく向上(emergent ability)することがあることがわかる
- 言い換えるとCoTは<100Bのモデルではパフォーマンスに対してインパクトを与えない
- モデルサイズが小さいと、誤ったCoTを生成してしまうため
- 複雑な問題になればなるほど、CoTによる恩恵が大きい
- ベースラインの性能が最も低かったGSM8Kでは、パフォーマンスの2倍向上しており、1 stepのreasoningで解決できるSingleOpやMAWPSでは、性能の向上幅が小さい
- Task specificなモデルをfinetuningした以前のSoTAと比較してcomparable, あるいはoutperformしている
- 
## Ablation Study
CoTではなく、他のタイプのpromptingでも同じような効果が得られるのではないか?という疑問に回答するために、3つのpromptingを実施し、CoTと性能比較した:
- Equation Only: 回答するまえに数式を記載するようなprompt
- promptの中に数式が書かれているから性能改善されているのでは?という疑問に対する検証
- => GSM8Kによる結果を見ると、equation onlyでは性能が低かった。これは、これは数式だけでreasoning stepsを表現できないことに起因している
- Variable compute only: dotのsequence (...) のみのprompt
- CoTは難しい問題に対してより多くの計算(intermediate token)をすることができているからでは?という疑問に対する検証
- variable computationとCoTの影響を分離するために、dotのsequence (...) のみでpromptingする方法を検証
- => 結果はbaselineと性能変わらず。このことから、variableの計算自体が性能向上に寄与しているわけではないことがわかる。
- Chain of Thought after answer: 回答の後にCoTを出力するようなprompting
- 単にpretrainingの際のrelevantな知識にアクセスしやすくなっているだけなのでは?という疑問を検証
- => baselineと性能は変わらず、単に知識を活性化させるだけでは性能が向上しないことがわかる。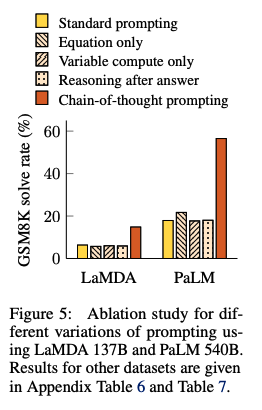
## CoTのロバスト性
人間のAnnotatorにCoTを作成させ、それらを利用したCoTpromptingとexamplarベースな手法によって性能がどれだけ変わるかを検証。standard promptingを全ての場合で上回る性能を獲得した。このことから、linguisticなstyleにCoTは影響を受けていないことがわかる。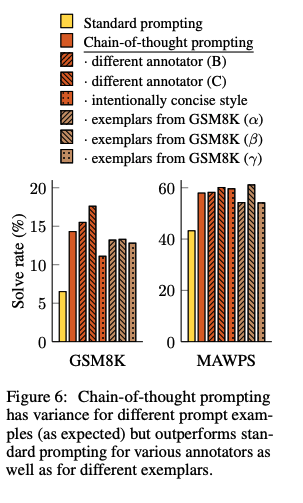
# commonsense reasoning
全てのデータセットにおいて、CoTがstandard promptingをoutperformした。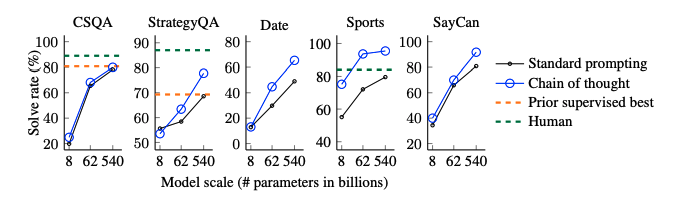
# Symbolic Reasoning
in-domain test setとout-of-domain test setの2種類を用意した。前者は必要なreasoning stepがfew-shot examplarと同一のもの、後者は必要なreasoning stepがfew-shot examplarよりも多いものである。
CoTがStandard proimptingを上回っている。特に、standard promptingではOOV test setではモデルをスケールさせても性能が向上しなかったのに対し、CoTではより大きなgainを得ている。このことから、CoTにはreasoning stepのlengthに対しても汎化能力があることがわかる。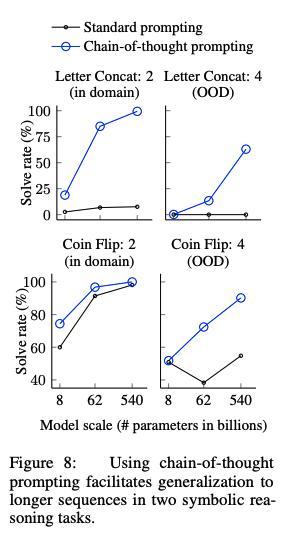
[Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
Paper/Blog Link My Issue
#LanguageModel #LongContext #NeurIPS #memory #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- メモリ機構を持つセグメントレベル再帰型トランスフォーマー(RMT)を提案。局所情報と全体情報を保存・処理し、長いシーケンス間で情報を伝達可能。特別なメモリトークンを追加することでTransformerモデルに変更を加えずに実装。実験結果では、RMTは短いメモリサイズでもTransformer-XLと同等の性能を示し、長いシーケンス処理では優れていることが確認。再帰的メモリトランスフォーマーは長期依存関係の学習に対する有望なアーキテクチャ。 Comment
TransformerはO(N^2)であり、計算量がNに応じて指数関数的に増加してしまう。一方、sequenceの情報を全てN次元ベクトルに集約しなければならず、計算量の制約によって長い系列のRepresentationを獲得できない。
そこで、Transformerの構造は変えず、Inputにメモリtokenを追加することで、メモリ間の関係性を学習できるような手法を提案。長いトークン列に対しても、トークン列をセグメントとゆばれる単位に区切り、セグメントのInputの頭で、前断のセグメントのメモリtokenを入力し、最終的に現在のセグメントのメモリをoutputし、後断のセグメントに入力とする、といったことを繰り返すことで、長い系列も扱えるようにした。
セグメントをまたいでbackpropagationをかけることで、たとえセグメントとしては独立していても、メモリの情報を考慮することでセグメント間の依存関係を学習することが可能だと思われる。
openreview: https://openreview.net/forum?id=Uynr3iPhksa
[Paper Note] UnifiedSKG: Unifying and Multi-Tasking Structured Knowledge Grounding with Text-to-Text Language Models, Tianbao Xie+, EMNLP'22, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #MultitaskLearning #PEFT(Adaptor/LoRA) #EMNLP #Encoder-Decoder #Grounding Issue Date: 2022-12-05 GPT Summary- UnifiedSKGフレームワークを提案し、21の構造化知識のグラウンディング(SKG)タスクをテキスト対テキスト形式に統合。これにより、体系的なSKG研究を促進し、異なるサイズのT5で最先端の性能を達成。マルチタスクチューニングが性能向上に寄与し、SKGのゼロショットおよび少数ショット学習における課題を示した。UnifiedSKGは他のタスクへの拡張も可能で、オープンソースとして公開されている。
[Paper Note] JaQuAD: Japanese Question Answering Dataset for Machine Reading Comprehension, ByungHoon So+, arXiv'22, 2022.02
Paper/Blog Link My Issue
#Dataset #QuestionAnswering #One-Line Notes Issue Date: 2022-02-07 GPT Summary- 日本語の質問応答データセットJaQuADを提案。39,696の質問-回答ペアを含み、テストセットでF1スコア78.92%、EMスコア63.38%を達成したベースラインモデルをファインチューニング。データセットは公開中。 Comment
SQuAD likeな日本語のQAデータセット
https://github.com/SkelterLabsInc/JaQuAD
Improving Neural Machine Translation with Compact Word Embedding Tables, Kumar+, AAAI'22
Paper/Blog Link My Issue
#NeuralNetwork #MachineTranslation #Embeddings #AAAI #Initial Impression Notes Issue Date: 2021-06-07 Comment
NMTにおいてword embeddingがどう影響しているかなどを調査しているらしい
[Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
Paper/Blog Link My Issue
#LanguageModel #One-Line Notes #Scalability Issue Date: 2026-07-09 GPT Summary- 言語モデリングは大規模な知識リポジトリを活用し、世界の理解を深化させる。本研究では、数千万から2,800億パラメータのTransformerベースのモデルGopherの性能を分析し、152の多様なタスクで最先端を達成。特に、読解や事実確認でスケールの利得が大きいが、論理的推論には限界がある。モデルの挙動やばイアス、危害の交差を総合的に評価し、AIの安全性に向けた適用と害の軽減についても考察。 Comment
- [Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
- 大規模言語モデルの次期バージョンPLaMo 3シリーズにおける120B事前学習モデル、31B蒸留モデルの評価, PFN, 2026.07
で利用されている weight reusingについて、`G3.3 Warm starting` に記載されている。概要としては
- LLMのキャパシティを増大させる際に、幅をスケーリングさせるよりも、深さをスケーリングさせる方が有望な結果となった
### 深さのスケーリング方法のbest practice
- 深さをスケーリングさせる、すなわち、5 layer -> 7 layerに拡張したい、という場合は、元の学習済みレイヤーを以下のルールによって複製することによって、拡張する:
- `round_int(range(num_layers_new)/num_layers_new * num_layers_old)`
- たとえば、`A B C D E` の5つのレイヤーで構成されているモデルがあったときに、これを7 layerに拡張したい場合は、上記indexに従って7つのレイヤーに学習済みレイヤーを割り当てると、`A B B C D D E` となる。
### 幅のスケーリング方法のbest practice
- (widthの拡張方法については正しく読めているかかなり自信がなく、間違っている可能性が非常に高いので注意)
- 幅をスケーリングさせる際は、MHA の weight matrices に対して列方向のコピー→行方向のコピー→ ノイズの注入を行う。
- 前提として以下を考える:
- MHAのQKV, outputのprojectionをそれぞれ、`W_q \in R^{d_model \times d_k}`, `W_k \in R^{d_model \times d_k}`, `W_v \in R^{d_model \times d_v}`, `W_o \in R^{h d_v \times d_model}` とする。
- このとき、オリジナルのtransformer論文では、`d_k = d_v = d_model/h` としている。
- つまり、各headに対応するW_{q, k, v, o}を列方向にconcatした行列 W^concat_{q, k, v, o}を考えると、列方向がh倍されるので、`W^concat_{q, k, v, o} \in R^{d_model \times d_model}` の正方行列で表現できる。ここで、`h * d_v= h * d_k= h * d_model/h = d_model` を用いた。
- この `W^{concat}_{*}` に対する操作を定義することで、multihead attentionが扱う幅を変更することができる。
- 元論文では、weight matricesと一言で言及されているが、これは(おそらく)`W^{concat}_{q, k, v, o}` のことを指していると思われる。実際、説明をする際は正方行列を前提に考えている(attention headごとに独立して考える元論文の数式では正方行列は weight matrices に出現しない)。
- まず `W^{concat}_{*}` において、head sizeをH, head数をnとしたときに、`nH \times nH` の行列を列方向にtilingすることによってattention headの数をmに拡張する。このとき、`d_k`, `d_v` のサイズは固定する。たとえば、head数をnからmに増やす際、最初のm-n個のheadを `W^{concat}_{*}` の右側に複製することによって拡張する、と説明されている。
- これはすなわち、個々のheadが扱う情報量は変化させずに、代わりにhead数を増やすことでスケーリングさせる、ということを指していると考えられる。
- 続いて、head数が増えたことによって `W^{concat}_{*}` が正方行列ではなくなった。これが正方行列になっていないとattentionの前後でbottleneck activation size(元論文ではd_modelのことをbottleneck activation sizeと呼称している)が変化してしまうので、正方行列にしなければならない。
- これを正方行列にするために、列方向に複製した行列の上端から数えて `(m-n) * d_k` 行分を行方向にconcatする。
- 最終的に、新たに初期化された重みに対してノイズを注入する。
- これによって構築された `W^{concat}_{*}` を図示したものが、下記Figure A32 と思われる。
- また、上記ではMHAの説明をしたが、MLPなどのd_modelが関わる各種weight matricesもwidthの拡張に含まれていると考えられる(じゃないとwidthの拡張と呼べないし)。
- optimizerの状態は再初期化して学習を実施する。
- Adam optimizerの状態に対して似たような処理を実施したが性能向上にはつながらなかった
[Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #read-later #Selected Papers/Blogs #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形化された自己注意機構とファストウェイト・コントローラの等価性を示し、遅いニューラルネットがファストウェイトをプログラムする方法を探る。FWPは有限メモリの操作を学習し、注意機構のメモリ容量限界を改善するために、加法的外積を用いたプログラミング命令を導入。動的学習率の計算も学習し、新しいカーネル関数を提案。合成リトリーバル問題や機械翻訳、言語モデリングタスクにおける利点を実験で示した。 Comment
Linear TransformerにおけるKV^Tを加算する固定された状態更新ではなく、差分だけを更新するDelta Ruleによって更新する Delta Networkを提案。
(まだ全然読めていないのでしっかり読みたい)
DeltaNet図解:
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #Architecture #Selected Papers/Blogs #ActivationFunction #One-Line Notes Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] Structured Denoising Diffusion Models in Discrete State-Spaces, Jacob Austin+, NeurIPS'21, 2021.07
Paper/Blog Link My Issue
#DiffusionModel #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-11-04 GPT Summary- 離散デノイジング拡散確率モデル(D3PMs)を提案し、連続状態空間のDDPMsを一般化。汚染プロセスを超えた遷移行列を導入し、画像とテキスト生成の改善を実現。新しい損失関数を用いて、LM1Bでの文字レベルのテキスト生成やCIFAR-10での画像生成において優れた結果を達成。 Comment
openreview: https://openreview.net/forum?id=h7-XixPCAL
離散拡散モデルを提案した研究
- Masked Diffusion Modelの進展, Deep Learning JP, 2025.03
で紹介されている
[Paper Note] ALFWorld: Aligning Text and Embodied Environments for Interactive Learning, Mohit Shridhar+, ICLR'21, 2020.10
Paper/Blog Link My Issue
#MachineLearning #Dataset #ReinforcementLearning #Evaluation #EmbodiedAI #text Issue Date: 2025-10-26 GPT Summary- ALFWorldは、エージェントが抽象的なテキストポリシーを学び、視覚環境で具体的な目標を実行できるシミュレーターである。これにより、視覚的環境での訓練よりもエージェントの一般化が向上し、問題を分解して各部分の改善に集中できる設計を提供する。 Comment
openreview: https://openreview.net/forum?id=0IOX0YcCdTn
pj page: https://alfworld.github.io
[Paper Note] MiniLMv2: Multi-Head Self-Attention Relation Distillation for Compressing Pretrained Transformers, Wenhui Wang+, ACL'21 Findings, 2020.12
Paper/Blog Link My Issue
#Transformer #Attention #Distillation #ACL #Encoder #Findings #KeyPoint Notes Issue Date: 2025-10-20 GPT Summary- 自己注意関係蒸留を用いて、MiniLMの深層自己注意蒸留を一般化し、事前学習されたトランスフォーマーの圧縮を行う手法を提案。クエリ、キー、バリューのベクトル間の関係を定義し、生徒モデルを訓練。注意ヘッド数に制限がなく、教師モデルの層選択戦略を検討。実験により、BERTやRoBERTa、XLM-Rから蒸留されたモデルが最先端の性能を上回ることを示した。 Comment
教師と(より小規模な)生徒モデル間で、tokenごとのq-q/k-k/v-vのdot productによって形成されるrelation map(たとえばq-qの場合はrelatiok mapはトークン数xトークン数の行列で各要素がdot(qi, qj))で表現される関係性を再現できるようにMHAを蒸留するような手法。具体的には、教師モデルのQKVと生徒モデルのQKVによって構成されるそれぞれのrelation map間のKL Divergenceを最小化するように蒸留する。このとき教師モデルと生徒モデルのattention heads数などは異なってもよい(q-q/k-k/v-vそれぞれで定義されるrelation mapははトークン数に依存しており、head数には依存していないため)。
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #LanguageModel #Transformer #NeurIPS #read-later #HyperparameterTransfer #One-Line Notes Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
[Paper Note] Program Synthesis with Large Language Models, Jacob Austin+, arXiv'21
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- 本論文では、汎用プログラミング言語におけるプログラム合成の限界を大規模言語モデルを用いて評価します。MBPPとMathQA-Pythonの2つのベンチマークで、モデルサイズに対する合成性能のスケールを調査。最も大きなモデルは、少数ショット学習でMBPPの59.6%の問題を解決可能で、ファインチューニングにより約10%の性能向上が見られました。MathQA-Pythonでは、ファインチューニングされたモデルが83.8%の精度を達成。人間のフィードバックを取り入れることでエラー率が半減し、エラー分析を通じてモデルの弱点を明らかにしました。最終的に、プログラム実行結果の予測能力を探るも、最良のモデルでも特定の入力に対する出力予測が困難であることが示されました。 Comment
代表的なコード生成のベンチマーク。
MBPPデータセットは、promptで指示されたコードをモデルに生成させ、テストコード(assertion)を通過するか否かで評価する。974サンプル存在し、pythonの基礎を持つクラウドワーカーによって生成。クラウドワーカーにタスクdescriptionとタスクを実施する一つの関数(関数のみで実行可能でprintは不可)、3つのテストケースを記述するよう依頼。タスクdescriptionは追加なclarificationなしでコードが記述できるよう十分な情報を含むよう記述するように指示。ground truthの関数を生成する際に、webを閲覧することを許可した。
MathQA-Pythonは、MathQAに含まれるQAのうち解答が数値のもののみにフィルタリングしたデータセットで、合計で23914サンプル存在する。pythonコードで与えられた数学に関する問題を解くコードを書き、数値が一致するか否かで評価する、といった感じな模様。斜め読みなので少し読み違えているかもしれない。
[Paper Note] Evaluating Large Language Models Trained on Code, Mark Chen+, arXiv'21
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- CodexはGitHubのコードでファインチューニングされたGPT言語モデルで、Pythonコード生成能力を評価。新しい評価セットHumanEvalでは、Codexが28.8%の問題を解決し、GPT-3は0%、GPT-Jは11.4%だった。繰り返しサンプリングが難しいプロンプトに対しても効果的な戦略を用い、70.2%の問題を解決。モデルの限界として、長い操作の説明や変数へのバインドに苦労する点が明らかに。最後に、コード生成技術の影響について安全性や経済に関する議論を行う。 Comment
HumanEvalデータセット。Killed by LLMによると、GPT4oによりすでに90%程度の性能が達成され飽和している。
164個の人手で記述されたprogrammingの問題で、それぞれはfunction signature, docstring, body, unittestを持つ。unittestは問題当たり約7.7 test存在。handwrittenという点がミソで、コンタミネーションの懸念があるためgithubのような既存ソースからのコピーなどはしていない。pass@k[^1]で評価。
[^1]: k個のサンプルを生成させ、k個のサンプルのうち、サンプルがunittestを一つでも通過する確率。ただ、本研究ではよりバイアスをなくすために、kよりも大きいn個のサンプルを生成し、その中からランダムにk個を選択して確率を推定するようなアプローチを実施している。2.1節を参照のこと。
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
Paper/Blog Link My Issue
#Analysis #Transformer #EMNLP #Selected Papers/Blogs #FactualKnowledge Issue Date: 2025-07-04 GPT Summary- フィードフォワード層はトランスフォーマーモデルの大部分を占めるが、その役割は未探求。研究により、フィードフォワード層がキー・バリュー・メモリとして機能し、トレーニング例のテキストパターンと相関することを示す。実験で、下層は浅いパターン、上層は意味的なパターンを学習し、バリューが出力分布を誘導することが確認された。最終的に、フィードフォワード層の出力はメモリの合成であり、残差接続を通じて洗練される。 Comment
日本語解説(p.5より): https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022?slide=5
[Paper Note] Editing Factual Knowledge in Language Models, Nicola De Cao+, EMNLP'21
Paper/Blog Link My Issue
#LanguageModel #EMNLP #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- KnowledgeEditorは、事前学習された言語モデルの知識を編集し、再学習なしで誤った事実や予測を修正する手法です。制約最適化を用いてハイパーネットワークを訓練し、他の知識に影響を与えずに事実を修正します。BERTとBARTのモデルでその有効性を示し、特定のクエリに基づく予測変更がパラフレーズにも一貫して影響を与えることを確認しました。ハイパーネットワークは、知識操作に必要なコンポーネントを特定する「プローブ」として機能します。
[Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
Paper/Blog Link My Issue
#Dataset #LanguageModel #Supervised-FineTuning (SFT) #Mathematics #Selected Papers/Blogs #Verification #needs-revision Issue Date: 2024-12-27 GPT Summary- 最先端の言語モデルは数学的推論に課題があり、GSM8Kという8,500件の小学生向け数学問題データセットを導入してその失敗を診断。特に、最大規模のトランスフォーマーモデルでも性能向上が難しいことを示す。モデルの補完の正しさを評価する検証器を訓練し、候補解を生成して最も高く評価されたものを選択する方法を提案。検証がGSM8Kの性能を大幅に向上させ、ファインチューニングよりも効果的にスケールすることを実証。 Comment
## 気持ち
- 当時の最も大きいレベルのモデルでも multi-stepのreasoningが必要な問題は失敗する
- モデルをFinetuningをしても致命的なミスが含まれる
- 特に、数学は個々のミスに対して非常にsensitiveであり、一回ミスをして異なる解法のパスに入ってしまうと、self-correctionするメカニズムがauto-regressiveなモデルではうまくいかない
- 純粋なテキスト生成の枠組みでそれなりの性能に到達しようとすると、とんでもないパラメータ数が必要になり、より良いscaling lawを示す手法を模索する必要がある
## Contribution
論文の貢献は
- GSM8Kを提案し、
- verifierを活用しモデルの複数の候補の中から良い候補を選ぶフレームワークによって、モデルのパラメータを30倍にしたのと同等のパフォーマンスを達成し、データを増やすとverifierを導入するとよりよく性能がスケールすることを示した。
- また、dropoutが非常に強い正則化作用を促し、finetuningとverificationの双方を大きく改善することを示した。
Todo: 続きをまとめる
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #One-Line Notes Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #Transformer #One-Line Notes Issue Date: 2024-07-11 GPT Summary- トランスフォーマーモデルのフィードフォワード層は、キー・バリューメモリとして機能し、学習されたパターンが人間に解釈可能であることや、上位層がより意味のあるパターンを学習することが示されました。さらに、出力分布を誘導する役割も持ちます。フィードフォワード層の出力はそのメモリの合成であり、残差接続を介してモデルの層を通じて洗練され、最終的な出力分布を生成します。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
FF layerがKey-Valueストアとして機能する仕組みの概略図
実際に特定のKeyと最も関連度が高い訓練事例(input)を抽出し、人間がinputのパターンを分類した結果
[Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#LanguageModel #Transformer #PositionalEncoding #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- 位置エンコーディングはトランスフォーマーにおいて重要な役割を果たし、依存関係をモデル化するための監督信号を提供する。本研究では、トランスフォーマーに位置情報を組み込む手法を検討し、新たに提案するロータリーポジションエンベディング(RoPE)が絶対位置を回転行列でエンコードして相対位置依存性を取り入れることを示す。RoPEはシーケンス長の柔軟性や相対距離の増加に伴う依存性の減衰などの特性を持ち、強化済みトランスフォーマー(RoFormer)の評価は他の手法を一貫して上回ることを示している。RoFormerはHuggingfaceに統合済み。 Comment
RoPEを提案した論文
# Absolute Position Embedding と Relative Position Embedding
## TransformerにおけるQKVベクトルの計算方法
一般に、Transformerにおける Query (Q), Key (K), Value (V) は以下の式で定式化される:
m, nはそれぞれ位置を表す整数。Absolute Position Embeddingと、Relative Position Embeddingは、関数fの設計がそれぞれ異なっている:
## Absolute Position Embedding
absolute position embeddingは、固定されたposition ベクトル、あるいはtrainableなposition ベクトルpを、入力ベクトルに対して足し合わせる:
## Relative Position Embedding
一方、Relative Position Embeddingは、Queryの位置に対する、Key, Valueの相対位置(つまり、mとnの差)に対して、trainableなベクトル \tilde{p}_r をKey, Valueおよび相対距離rごとに用意し、そのベクトルを入力に足し合わせる、という定式化となっている:
ここで、r = clip(m-n, r_max, r_min)であり、r_max, r_minは考慮する相対距離の最大値と最小値である。
他にも様々な定式化が提案されているがたいてい定式化の中に相対位置m-nが出現する。
## RoPE
RoPEでは、入力Query, Keyベクトル(Q,K)に対して回転行列を適用することで、回転に対して位置情報を保持させる。具体的には、異なる位置m, nに対するq_m^T k_nを計算すると、回転行列をRとした場合式16に示されているように回転行列Rに相対位置m-nが現れ(るように設計されており)、相対位置を考慮したqkの計算になっている。[^1]
[^1]: (R_mq_m)^T R_nK_n = q_m^T (R_m^T R_n) k_n = q_m^T (R_{-m}R_n) k_n = q_m^T R_{n-m} k_n. ここで、R_m^T = R_{-m}であり、R_m R_n = R_{m+n}の性質を使っている。
RoPEは下記のような性質を持つ:
- long-term decay: θi = 10000−2i/d と設定することにより、相対位置が離れているトークンのベクトルとのinner productの値が小さくなる。すなわち、位置が離れているトークン間の依存関係が小さくなる。
- Linear-Attention: RoPEは回転行列であり、乗算後のベクトルのノルムを変化させない。このため、Linear Attentionの式の中に回転行列を組み込むことで、Linear Attentionと簡単に組み合わせることが可能
Absolute Position Embedding, Relative Position Embeddingでは、ベクトルに対して位置情報を加算する定式化で K, Vの計算時に位置情報を考慮していたため、Linear Attentionの計算そのものに位置情報を組み込んだ定式化とはなっていなかった。
が、RoPEでは回転行列を乗算する定式化であり、ノルムを変化させないのでLinear Attentionの定式化に組み込むことができる。このため、モデルのアーキテクチャを大きく変更しなくとも組み込める。
すなわち、Vanilla TransformerのEmbedding lookup後のpositional embeddingを加算するモジュールが無くなり、positional encodingがattentionの計算の中に取り込まれる。
RoPE自体は実装にパラメータを必要としないが、モデルのその他のパラメータがRoPEに適用できるように学習されていないと適用できないであろう点には注意(事前学習時にRoPEが使われていれば話は別)。
- 国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
pp.22--23がRoPEを簡潔に説明しており分かりやすい
The Perils of Using Mechanical Turk to Evaluate Open-Ended Text Generation, Marzena Karpinska+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #NaturalLanguageGeneration #Evaluation #Annotation #Reproducibility #KeyPoint Notes Issue Date: 2024-05-15 GPT Summary- 最近のテキスト生成の研究は、オープンエンドのドメインに注力しており、その評価が難しいため、多くの研究者がクラウドソーシングされた人間の判断を収集してモデリングを正当化している。しかし、多くの研究は重要な詳細を報告しておらず、再現性が妨げられていることがわかった。さらに、労働者はモデル生成のテキストと人間による参照テキストを区別できないことが発見され、表示方法を変更することで改善されることが示された。英語教師とのインタビューでは、モデル生成のテキストを評価する際の課題について、より深い洞察が得られた。 Comment
Open-endedなタスクに対するAMTの評価の再現性に関する研究。先行研究をSurveyしたところ、再現のために重要な情報(たとえば、workerの資格、費用、task descriptions、annotator間のagreementなど)が欠落していることが判明した。
続いて、expertsとAMT workerに対して、story generationの評価を実施し、GPT2が生成したストーリーと人間が生成したストーリーを、後者のスコアが高くなることを期待して依頼した。その結果
- AMTのratingは、モデルが生成したテキストと、人間が生成したテキストをreliableに区別できない
- 同一のタスクを異なる日程で実施をすると、高い分散が生じた
- 多くのAMT workerは、評価対象のテキストを注意深く読んでいない
- Expertでさえモデルが生成したテキストを読み判断するのには苦戦をし、先行研究と比較してより多くの時間を費やし、agreementが低くなることが分かった
- [Paper Note] Can Large Language Models Be an Alternative to Human Evaluations?, Cheng-Han Chiang+, ACL'23, 2023.05
において、低品質なwork forceが人手評価に対して有害な影響を与える、という文脈で本研究が引用されている
[Paper Note] Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation, Markus Freitag+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#MachineTranslation #Analysis #NaturalLanguageGeneration #Metrics #Evaluation #One-Line Notes Issue Date: 2024-01-25 GPT Summary- 機械翻訳の人間評価は難しく、標準的な手法が不足している。そこで、誤り分析に基づく評価方法論を提案し、MQMフレームワークを用いてWMT 2020の上位システム出力をプロの翻訳者による注釈で評価。分析の結果、WMTクラウドワーカーのランキングと異なる結果が得られ、人間が機械出力よりも人間の出力を好む傾向を示した。さらに、自動指標がクラウドワーカーよりも優れたことも判明し、研究用コーパスを公開。 Comment
embedding basedなNLGの性能指標が、意味の等価性や流暢性を評価できる一方、適用範囲が限定的で柔軟性に欠けることを示した研究
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #Pretraining #LanguageModel #Transformer #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Tools #Dataset #Evaluation #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-08-13 Comment
自動評価指標が人手評価の水準に達しないことが示されており、結局のところROUGEを上回る自動性能指標はほとんどなかった。human judgmentsとのKendall;'s Tauを見ると、chrFがCoherenceとRelevance, METEORがFluencyで上回ったのみだった。また、LEAD-3はやはりベースラインとしてかなり強く、LEAD-3を上回ったのはBARTとPEGASUSだった。
How to Evaluate a Summarizer: Study Design and Statistical Analysis for Manual Linguistic Quality Evaluation, Steen+, EACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 要約システムの評価方法についての調査結果を報告しました。要約の言語的品質についての評価実験を行い、最適な評価方法は側面によって異なることを示しました。また、研究パラメータや統計分析方法についても問題点を指摘しました。さらに、現行の方法では固定された研究予算の下では信頼性のある注釈を提供できないことを強調しました。 Comment
要約の人手評価に対する研究
Reliability of Human Evaluation for Text Summarization: Lessons Learned and Challenges Ahead, Iskender+, EACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 人間評価の信頼性に関する研究では、参加者の情報や実験の詳細が提供されていないことが多い。また、人間評価の信頼性に影響を与える要因についても研究されていない。そこで、私たちは人間評価実験を行い、参加者の情報や実験の詳細を提供し、異なる実験結果を比較した。さらに、専門家と非専門家の評価の信頼性を確保するためのガイドラインを提供し、信頼性に影響を与える要因を特定した。 Comment
要約の人手評価に対する信頼性に関して研究。人手評価のガイドラインを提供している。
The Feasibility of Embedding Based Automatic Evaluation for Single Document Summarization, EMNLP-IJCNLP'21, Sun+
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #EMNLP #IJCNLP Issue Date: 2023-08-13 Comment
C-ELMO/C-SBERT
A Training-free and Reference-free Summarization Evaluation Metric via Centrality-weighted Relevance and Self-referenced Redundancy, Chen+, ACL-IJCNLP'21
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #ACL #IJCNLP Issue Date: 2023-08-13
[Paper Note] QuestEval: Summarization Asks for Fact-based Evaluation, Thomas Scialom+, arXiv'21, 2021.03
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #QA-based #EMNLP #KeyPoint Notes #needs-revision Issue Date: 2023-08-13 GPT Summary- 要約評価の課題に対し、QuestEvalという新たなフレームワークを提案。ROUGEやBERTScoreに依存せず、人間の判断との相関を四つの次元(整合性、一貫性、流暢さ、関連性)において向上させることを実験で示した。 Comment
QuestEval
# 概要
SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
によって提案されてきたメトリックがROUGEに勝てていないことについて言及し、より良い指標を提案。
- precision / recall-based な QA metricsを利用してよりロバスト
- 生成されるqueryのsaliencyを学習する手法を提案することで、information selectionの概念を導入した
- CNN/Daily Mail, XSUMで評価した結果、SoTAな結果を獲得し、特にFactual Consistencyの評価に有用なことを示した
# Question-based framework
prerainedなT5を利用しQAに回答するcomponent(question, Textがgivenな時answerを生成するモデル)を構築する。text Tに対するquery qに対してrと回答する確率をQ_A(r|T, q)とし、Q_A(T, q)をモデルによってgreedyに生成された回答とする。Questionが与えられた時、Summary内に回答が含まれているかは分からない。そのため、unanswerable token εもQA componentに含める。
QG componentとしては、answer-source documentが与えられたときに人間が生成したquestionを生成できるようfinetuningされたT5モデルを利用する。テスト時は、ソースドキュメントと、システム要約がgivenなときに、はじめにQG modelを条件付けするためのanswerのsetを選択する。Asking and Answering Questions to Evaluate the Factual Consistency of Summaries, Wang, ACL'20
にならい、ソースドキュメントの全ての固有名詞と名詞をanswerとみなす。そして、それぞれの選択されたanswerごとに、beam searchを用いてquestionを生成する。そして、QAモデルが誤った回答をした場合、そのようなquestionはフィルタリングする。text Tにおいて、Q_A(T, q) = rとなるquestion-answer pairs (q, r)の集合を、Q_G(T)と表記する。
# QuestEval metric
## Precision
source documentをD, システム要約をSとしたときに、Precision, Recallを以下の式で測る:
question生成時は要約から生成し、生成されたquestionに回答する際はsource documentを利用し、回答の正誤に対してF1スコアを測定する。F1スコアは、ground truthと予測された回答を比較することによって測定され、回答がexact matchした場合に1, common tokenが存在しない場合に0を返す。D, Sで条件付けされたときに、回答が変わってしまう場合は要約がinconsistentだとみなせる、というintuitionからきている。
## Recall
要約はfactual informationを含むべきのみならず(precision)、ソーステキストの重要な情報を含むべきである(recall)。Answers Unite! Unsupervised Metrics for Reinforced Summarization Models, Scialom+, EMNLP-IJCNLP'19
をquery weighter Wを導入することで拡張し、recallを下記で定義する:
ここで、Q_G(D)は、ソーステキストDにおけるすべてのQA pairの集合、W(q, D)はDに対するqの重みである。
## Answerability and F1
Factoid QAモデルは一般的に、predicted answerとground truthのoverlapによって(F1)評価されている。しかし"ACL"と"Association for Computational Linguistics"のように、同じ回答でも異なる方法で表現される可能性がある。この例では、F1スコアは0となる(共通のtokenがないため)。
これを回避するために、Answers Unite! Unsupervised Metrics for Reinforced Summarization Models, Scialom+, EMNLP-IJCNLP'19
と同様に1-Q_A(ε)を利用する。
QG component, QA componentで利用するT5は、それぞれ[SQuAD-v2]( https://huggingface.co/datasets/squad_v2)と、NewsQAデータセット [Paper Note] NewsQA: A Machine Comprehension Dataset, Adam Trischler+, RepL4NLP'17, 2016.11 によってfinetuningしたものを利用する。
Q2: Evaluating Factual Consistency in Knowledge-Grounded Dialogues via Question Generation and Question Answering, Honovich+, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Metrics #DialogueGeneration #Evaluation #Reference-free #QA-based #Factuality #EMNLP #KeyPoint Notes Issue Date: 2023-08-13 Comment
(knowledge-grounded; 知識に基づいた)対話に対するFactual ConsistencyをReference-freeで評価できるQGQA手法。機械翻訳やAbstractive Summarizationの分野で研究が進んできたが、対話では
- 対話履歴、個人の意見、ユーザに対する質問、そして雑談
といった外部知識に対するconsistencyが適切ではない要素が多く存在し、よりチャレンジングなタスクとなっている。
また、そもそも対話タスクはopen-endedなタスクなため、Reference-basedな手法は現実的ではなく、Reference-freeな手法が必要と主張。
手法の概要としては以下。ユーザの発話からQuestion Generation (QG)を実施し、Question-Answer Candidate Pairを作成する。そして、生成したQuestionをベースとなる知識から回答させ(QA)、その回答結果とAnswer Candidateを比較することでFactual Consistencyを測定する。
Compression, Transduction, and Creation: A Unified Framework for Evaluating Natural Language Generation, Deng+, EMNLP''21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #LM-based #Factuality #EMNLP Issue Date: 2023-08-13 Comment
CTC
QACE: Asking Questions to Evaluate an Image Caption, Lee+, EMNLP'21
Paper/Blog Link My Issue
#ComputerVision #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #QA-based #One-Line Notes Issue Date: 2023-08-13 Comment
Image Captioningを評価するためのQGQAを提案している。candidateから生成した質問を元画像, およびReferenceを用いて回答させ、candidateに基づいた回答と回答の結果を比較することで評価を実施する。
[Paper Note] BARTScore: Evaluating Generated Text as Text Generation, Weizhe Yuan+, arXiv'21, 2021.06
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #LM-based #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-08-13 GPT Summary- 生成テキストの評価を、事前学習済みのシーケンス・ツー・シーケンスモデルを用いてモデル化。BARTを基にした指標BARTScoreを提案し、流暢さや情報性から生成テキストを評価。既存の指標を16のテスト設定で上回る可能性があり、広範なデータセットに適用可能。BARTScore計算コードは公開中。 Comment
BARTScore
# 概要
ソーステキストが与えられた時に、BARTによって生成テキストを生成する尤度を計算し、それをスコアとする手法。テキスト生成タスクをテキスト生成モデルでスコアリングすることで、pre-trainingされたパラメータをより有効に活用できる(e.g. BERTScoreやMoverScoreなどは、pre-trainingタスクがテキスト生成ではない)。BARTScoreの特徴は
1. parameter- and data-efficientである。pre-trainingに利用されたパラメータ以外の追加パラメータは必要なく、unsupervisedなmetricなので、human judgmentのデータなども必要ない。
2. 様々な観点から生成テキストを評価できる。conditional text generation problemにすることでinformativeness, coherence, factualityなどの様々な観点に対応可能。
3. BARTScoreは、(i) pre-training taskと類似したpromptを与えること、(ii) down stream generation taskでfinetuningすること、でより高い性能を獲得できる
BARTScoreを16種類のデータセットの、7つの観点で評価したところ、16/22において、top-scoring metricsよりも高い性能を示した。また、prompting starategyの有効性を示した。たとえば、シンプルに"such as"というフレーズを翻訳テキストに追加するだけで、German-English MTにおいて3%の性能向上が見られた。また、BARTScoreは、high-qualityなテキスト生成システムを扱う際に、よりロバストであることが分析の結果分かった。
# 前提
## Problem Formulation
生成されたテキストのqualityを測ることを目的とする。本研究では、conditional text generation (e.g. 機械翻訳)にフォーカスする。すなわち、ゴールは、hypothesis h_bar を source text s_barがgivenな状態で生成することである。一般的には、人間が作成したreference r_barが評価の際は利用される。
## Gold-standard Human Evaluation
評価のgold standardは人手評価であり、人手評価では多くの観点から評価が行われる。以下に代表的な観点を示す:
1. Informativeness: ソーステキストのキーアイデアをどれだけ捉えているか
2. Relevance: ソーステキストにあ地して、どれだけconsistentか
3. Fluency formatting problem, capitarlization errorや非文など、どの程度読むのが困難か
4. Coherence: 文間のつながりが、トピックに対してどれだけcoherentか
5. Factuality: ソーステキストに含意されるstatementのみを生成できているか
6. Semantic Coverage: 参照テキスト中のSemantic Content Unitを生成テキストがどれだけカバーできているか
7: Adequacy 入力文に対してアウトプットが同じ意味を出力できているかどうか、あるいは何らかのメッセージが失われる、追加される、歪曲していないかどうか
多くの性能指標は、これらの観点のうちのsubsetをカバーするようにデザインんされている。たとえば、BLEUは、翻訳におけるAdequacyとFluencyをとらえることを目的としている。一方、ROUGEは、semantic coverageを測るためのメトリックである。
BARTScoreは、これらのうち多くの観点を評価することができる。
## Evaluation as Different Tasks
ニューラルモデルを異なる方法で自動評価に活用するのが最近のトレンドである。下図がその分類。この分類は、タスクにフォーカスした分類となっている。
1. Unsupervised Matching: ROUGE, BLEU, CHRF, BERTScore, MoverScoreのように、hypothesisとreference間での意味的な等価性を測ることが目的である。このために、token-levelのマッチングを用いる。これは、distributedな表現を用いる(BERTScore, MoverScore)場合もあれば、discreteな表現を用いる(ROUGE, BLEU, chrF)場合もある。また、意味的な等価性だけでなく、factual consistencyや、source-hypothesis間の関係性の評価に用いることもできると考えられるが先行研究ではやられていなかったので、本研究で可能なことを示す。
2. Supervised Regression: BLEURT, COMET, S^3, VRMのように、regression layer を用いてhuman judgmentをsupervisedに予測する方法である。最近のメトリックtおしては、BLEURT, COMETがあげられ、古典的なものとしては、S^3, VRMがあげられる。
4. Supervised Ranking: COMET, BEERのような、ランキング問題としてとらえる方法もある。これは優れたhypothesisを上位にランキングするようなスコア関数を学習する問題に帰着する。COMETやBEERが例としてあげられ、両者はMTタスクにフォーカスされている。COMETはhunan judgmentsをregressionすることを通じてランキングを作成し、BEERは、多くのシンプルな特徴量を組み合わせて、linear layerでチューニングされる。
5. Text Generation: PRISM, BARTScoreが例として挙げられる。BARTScoreでは、生成されたテキストの評価をpre-trained language modelによるテキスト生成タスクとしてとらえる。基本的なアイデアとしては、高品質のhypothesisは、ソース、あるいはreferenceから容易に生成可能であろう、というものである。これはPRISMを除いて、先行研究ではカバーされていない。BARTScoreは、PRISMとはいくつかの点で異なっている。(i) PRISMは評価をparaphrasing taskとしてとらえており、これが2つの意味が同じテキストを比較する前提となってしまっているため、手法を適用可能な範囲を狭めてしまっている。たとえば、文書要約におけるfactual consistencyの評価では、semantic spaceが異なる2つのテキストを比較する必要があるが、このような例には対応できない。(ii) PRISMはparallel dataから学習しなけえrばならないが、BARTScoreは、pre-trainedなopen-sourceのseq2seq modelを利用できる。(iii) BARTScoreでは、PRISMが検証していない、prompt-basedのlearningもサポートしている。
# BARTScore
## Sequence-to-Sequence Pre-trained Models
pre-trainingされたモデルは、様々な軸で異なっているが、その一つの軸としては訓練時の目的関数である。基本的には2つの大きな変種があり、1つは、language modeling objectives (e.g. MLM)、2つ目は、seq2seq objectivesである。特に、seq2seqで事前学習されたモデルは、エンコーダーとデコーダーによって構成されているため特に条件付き生成タスクに対して適しており、予測はAutoRegressiveに行われる。本研究ではBARTを用いる。付録には、preliminary experimentsとして、BART with T5, PEGASUSを用いた結果も添付する。
## BARTScore
最も一般的なBARTScoreの定式化は下記である。
weighted log probabilityを利用する。このweightsは、異なるトークンに対して、異なる重みを与えることができる。たておば、IDFなどが利用可能であるが、本研究ではすべてのトークンを等価に扱う(uniform weightingだがstopwordを除外、IDFによる重みづけ、事前分布を導入するなど色々試したが、uniform weightingを上回るものがなかった)。
BARTScoreを用いて、様々な方向に用いて生成を行うことができ、異なる評価のシナリオに対応することができる。
- Faithfulness (s -> h):
- hypothesisがどれだけsource textに基づいて生成されているかを測ることができる。シナリオとしては、FactualityやRelevanceなどが考えられる。また、CoherenceやFluencyのように、target textのみの品質を測るためにも用いることができる。
- Precision (r -> h):
- hypothesisがどれだけgold-referenceに基づいてこう良くされているかを亜評価でき、precision-focusedなシナリオに適している
- Recall (h -> r):
- hypothesisから、gold referenceをどれだけ容易に再現できるかを測ることができる。そして、要約タスクのpyramid-basedな評価(i.e. semantic coverage等) に適している。pyramid-scoreはSemantic Content Unitsがどれだけカバーされているかによって評価される。
- F Score (r <-> h):
- 双方向を考慮し、Precisioon / RecallからF値を算出する。この方法は、referenceと生成テキスト間でのsemantic overlap (informativenss, adequacy)などの評価に広く利用される。
# BARTScore Variants
BARTScoreの2つの拡張を提案。(i) xとyをpromptingによって変更する。これにより、評価タスクをpre-training taskと近づける。(ii) パラメータΘを異なるfinetuning taskを考慮して変更する。すなわち、pre-trainingのドメインを、evaluation taskに近づける。
## Prompt
Promptingはinput/outputに対して短いフレーズを追加し、pre-trained modelに対して特定のタスクを遂行させる方法である。BARTにも同様の洞察を簡単に組み込むことができる。この変種をBARTScore-PROMPTと呼ぶ。
prompt zが与えられたときに、それを (i) source textに追加し、新たなsource textを用いてBARTScoreを計算する。(ii) target textの先頭に追加し、new target textに対してBARTScoreを計算する。
## Fine-tuning Task
classification-basedなタスクでfine-tuneされるのが一般的なBERT-based metricとは異なり、BARTScoreはgeneration taskでfine-tuneされるため、pre-training domainがevaluation taskと近い。本研究では、2つのdownstream taskを検証する。
1つめは、summarizationで、BARTをCNNDM datasetでfinetuningする。2つめは、paraphrasingで、summarizationタスクでfinetuningしたBARTをParaBank2 datasetでさらにfinetuningする。
# 実験
## baselines and datasets
### Evaluation Metrics
supervised metrics: COMET, BLEURT
unsupervised: BLEU, ROUGE-1, ROUGE-2, ROUGE-L, chrF, PRISM, MoverScore, BERTScore
と比較
### Measures for Meta Evaluation
Pearson Correlationでlinear correlationを測る。また、Spearman Correlationで2変数間の単調なcorrelationを測定する(線形である必要はない)。Kendall's Tauを用いて、2つの順序関係の関係性を測る。最後に、Accuracyでfactual textsとnon-factual textの間でどれだけ正しいランキングを得られるかを測る。
### Datasets
Summarization, MT, DataToTextの3つのデータセットを利用。
## Setup
### Prompt Design
seedをparaphrasingすることで、 s->h方向には70個のpromptを、h<->rの両方向には、34のpromptを得て実験で用いた。
### Settings
Summarizationとdata-to-textタスクでは、全てのpromptを用いてデコーダの頭に追加してスコアを計算しスコアを計算した。最終的にすべての生成されたスコアを平均することである事例に対するスコアを求めた(prompt unsembling)。MTについては、事例数が多くcomputational costが多くなってしまうため、WMT18を開発データとし、best prompt "Such as"を選択し、利用した。
BARTScoreを使う際は、gold standard human evaluationがrecall-basedなpyrmid methodの場合はBARTScore(h->r)を用い、humaan judgmentsがlinguistic quality (coherence fluency)そして、factual correctness、あるいは、sourceとtargetが同じモダリティ(e.g. language)の場合は、faitufulness-based BARTScore(s->h)を用いた。最後に、MTタスクとdata-to-textタスクでは、fair-comparisonのためにBARTScore F-score versionを用いた。
## 実験結果
### MT
- BARTScoreはfinetuning tasksによって性能が向上し、5つのlanguage pairsにおいてその他のunsupervised methodsを統計的に優位にoutperformし、2つのlanguage pairでcomparableであった。
-Such asというpromptを追加するだけで、BARTScoreの性能が改善した。特筆すべきは、de-enにおいては、SoTAのsupervised MetricsであるBLEURTとCOMETを上回った。
- これは、有望な将来のmetric designとして「human judgment dataで訓練する代わりに、pre-trained language modelに蓄積された知識をより適切に活用できるpromptを探索する」という方向性を提案している。
### Text Summarization
- vanilla BARTScoreはBERTScore, MoverScoreをInfo perspective以外でlarge marginでうくぁ回った。
- REALSum, SummEval dataseetでの改善は、finetuning taskによってさらに改善した。しかしながら、NeR18では改善しなかった。これは、データに含まれる7つのシステムが容易に区別できる程度のqualityであり、既にvanilla BARTScoreで高いレベルのcorrelationを達成しているからだと考えられる。
- prompt combination strategyはinformativenssに対する性能を一貫して改善している。しかし、fluency, factualityでは、一貫した改善は見られなかった。
Factuality datasetsに対する分析を行った。ゴールは、short generated summaryが、元のlong documentsに対してfaithfulか否かを判定するというものである。
- BARTScore+CNNは、Rank19データにおいてhuman baselineに近い性能を達成し、ほかのベースラインを上回った。top-performingなfactuality metricsであるFactCCやQAGSに対してもlarge marginで上回った。
- paraphraseをfine-tuning taskで利用すると、BARTScoreのパフォーマンスは低下した。これは妥当で、なぜなら二つのテキスト(summary and document)は、paraphrasedの関係性を保持していないからである。
- promptを導入しても、性能の改善は見受けられず、パフォーマンスは低下した。
### Data-to-Text
- CNNDMでfine-tuningすることで、一貫してcorrelationが改善した。
- 加えて、paraphraseデータセットでfinetuningすることで、さらに性能が改善した。
- prompt combination strategyは一貫してcorrelationを改善した。
## Analysis
### Fine-grained Analysis
- Top-k Systems: MTタスクにおいて、評価するシステムをtop-kにし、各メトリックごとにcorrelationの変化を見た。その結果、BARTScoreはすべてのunsupervised methodをすべてのkにおいて上回り、supervised metricのBLEURTも上回った。また、kが小さくなるほど、より性能はsmoothになっていき、性能の低下がなくなっていった。これはつまり、high-quality textを生成するシステムに対してロバストであることを示している。
- Reference Length: テストセットを4つのバケットにreference lengthに応じてブレイクダウンし、Kendall's Tauの平均のcorrelationを、異なるメトリック、バケットごとに言語をまたいで計算した。unsupervised metricsに対して、全てのlengthに対して、引き分けかあるいは上回った。また、ほかのmetricsと比較して、長さに対して安定感があることが分かった。
### Prompt Analysis
(1) semantic overlap (informativeness, pyramid score, relevance), (2) linguistic quality (fluency, coherence), (3) factual correctness (factuality) に評価の観点を分類し、summarizationとdata-to-textをにおけるすべてのpromptを分析することで、promptの効果を分析した。それぞれのグループに対して、性能が改善したpromptの割合を計算した。その結果、semantic overlapはほぼ全てのpromptにて性能が改善し、factualityはいくつかのpromptでしか性能の改善が見られなかった。linguistic qualityに関しては、promptを追加することによる効果はどちらとも言えなかった。
### Bias Analysis
BARTScoreが予測不可能な方法でバイアスを導入してしまうかどうかを分析した。バイアスとは、human annotatorが与えたスコアよりも、値が高すぎる、あるいは低すぎるような状況である。このようなバイアスが存在するかを検証するために、human annotatorとBARTScoreによるランクのサを分析した。これを見ると、BARTScoreは、extractive summarizationの品質を区別する能力がabstractive summarizationの品質を区別する能力よりも劣っていることが分かった。しかしながら、近年のトレンドはabstractiveなseq2seqを活用することなので、この弱点は軽減されている。
# Implications and Future Directions
prompt-augmented metrics: semantic overlapではpromptingが有効に働いたが、linguistic qualityとfactualityでは有効ではなかった。より良いpromptを模索する研究が今後期待される。
Co-evolving evaluation metrics and systems: BARTScoreは、メトリックデザインとシステムデザインの間につながりがあるので、より性能の良いseq2seqシステムが出たら、それをメトリックにも活用することでよりreliableな自動性能指標となることが期待される。
[Paper Note] Play the Shannon Game With Language Models: A Human-Free Approach to Summary Evaluation, Nicholas Egan+, arXiv'21, 2021.03
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #AAAI Issue Date: 2023-08-13 GPT Summary- 事前学習済みの言語モデルを用いて、文書とその要約の共有情報を推定する新しい要約評価指標を提案。これらはシャノン・ゲームの現代的解釈であり、人間の代わりにモデルを使用。トランスフォーマーに基づくモデルで、一貫性と関連性の次元で人間の判断との高い相関を実証。また、整合性と流暢さにおいても競争力を持つ評価を確認。
Towards Question-Answering as an Automatic Metric for Evaluating the Content Quality of a Summary, Deutsch+, TACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13
ESTIME: Estimation of Summary-to-Text Inconsistency by Mismatched Embeddings, Eval4NLP'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free Issue Date: 2023-08-13
[Paper Note] SimCSE: Simple Contrastive Learning of Sentence Embeddings, Tianyu Gao+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#Sentence #Embeddings #LanguageModel #RepresentationLearning #ContrastiveLearning #Catastrophic Forgetting #EMNLP #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-07-27 GPT Summary- SimCSEは、文の埋め込み表現を向上させる単純な対照学習フレームワークです。教師なしアプローチでは、入力文が自身を予測し、ドロップアウトがノイズとして機能します。この手法は従来の教師あり方法と同等の成果を上げ、ドロップアウトを除去すると表現の質が低下することが分かりました。また、教師付きアプローチでは、自然言語推論データセットからの注釈付きペアを活用し、対照学習に組み込みます。評価結果では、教師なしモデルが76.3%、教師ありモデルが81.6%のSpearmanの相関を達成し、既存のベスト結果をそれぞれ改善しました。対照学習の目的が埋め込みの空間の正則化に貢献することも示されました。 Comment
[Paper Note] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, Nils Reimers+, arXiv'19, 2019.08 よりも性能良く、unsupervisedでも学習できる。STSタスクのベースラインにだいたい入ってる
# 手法概要
Contrastive Learningを活用して、unsupervised/supervisedに学習を実施する。
Unsupervised SimCSEでは、あるsentenceをencoderに2回入力し、それぞれにdropoutを適用させることで、positive pairを作成する。dropoutによって共通のembeddingから異なる要素がマスクされた(noiseが混ざった状態とみなせる)類似したembeddingが作成され、ある種のdata augmentationによって正例を作成しているともいえる。負例はnegative samplingする。(非常にsimpleだが、next sentence predictionで学習するより性能が良くなる)
Supervised SimCSEでは、アノテーションされたsentence pairに基づいて、正例・負例を決定する。本研究では、NLIのデータセットにおいて、entailment関係にあるものは正例として扱う。contradictions(矛盾)関係にあるものは負例として扱う。
# Siamese Networkで用いられるmeans-squared errrorとContrastiveObjectiveの違い
どちらもペアワイズで比較するという点では一緒だが、ContrastiveObjectiveは正例と近づいたとき、負例と遠ざかったときにlossが小さくなるような定式化がされている点が異なる。
(画像はこのブログから引用。ありがとうございます。
https://techblog.cccmk.co.jp/entry/2022/08/30/163625)
# Unsupervised SimCSEの実験
異なるdata augmentation手法と比較した結果、dropoutを適用する手法の方が性能が高かった。MLMや, deletion, 類義語への置き換え等よりも高い性能を獲得しているのは興味深い。また、Next Sentence Predictionと比較しても、高い性能を達成。Next Sentence Predictionは、word deletion等のほぼ類似したテキストから直接的に類似関係にあるペアから学習するというより、Sentenceの意味内容のつながりに基づいてモデルの言語理解能力を向上させ、そのうえで類似度を測るという間接的な手法だが、word deletionに負けている。一方、dropoutを適用するだけの(直接的に類似ペアから学習する)本手法はより高い性能を示している。
[image](https://github.com/AkihikoWatanabe/paper_notes/assets/12249301/0ea3549e-3363-4857-94e6-a1ef474aa191)
なぜうまくいくかを分析するために、異なる設定で実験し、alignment(正例との近さ)とuniformity(どれだけembeddingが一様に分布しているか)を、10 stepごとにplotした結果が以下。dropoutを適用しない場合と、常に同じ部分をマスクする方法(つまり、全く同じembeddingから学習する)設定を見ると、学習が進むにつれuniformityは改善するが、alignmentが悪くなっていっている。一方、SimCSEはalignmentを維持しつつ、uniformityもよくなっていっていることがわかる。
# Supervised SimCSEの実験
アノテーションデータを用いてContrastiveLearningするにあたり、どういったデータを正例としてみなすと良いかを検証するために様々なデータセットで学習し性能を検証した。
- QQP4: Quora question pairs
- Flickr30k (Young et al., 2014): 同じ画像に対して、5つの異なる人間が記述したキャプションが存在
- ParaNMT (Wieting and Gimpel, 2018): back-translationによるparaphraseのデータセットa
- NLI datasets: SNLIとMNLI
実験の結果、NLI datasetsが最も高い性能を示した。この理由としては、NLIデータセットは、crowd sourcingタスクで人手で作成された高品質なデータセットであることと、lexical overlapが小さくなるようにsentenceのペアが作成されていることが起因している。実際、NLI datsetのlexical overlapは39%だったのに対し、ほかのデータセットでは60%であった。
また、condunctionsとなるペアを明示的に負例として与えることで、より性能が向上した(普通はnegative samplingする、というかバッチ内の正例以外のものを強制的に負例とする。こうすると、意味が同じでも負例になってしまう事例が出てくることになる)。より難しいNLIタスクを含むANLIデータセットを追加した場合は、性能が改善しなかった。この理由については考察されていない。性能向上しそうな気がするのに。
# 他手法との比較結果
SimCSEがよい。
# Ablation Studies
異なるpooling方法で、どのようにsentence embeddingを作成するかで性能の違いを見た。originalのBERTの実装では、CLS token のembeddingの上にMLP layerがのっかっている。これの有無などと比較。
Unsupervised SimCSEでは、training時だけMLP layerをのっけて、test時はMLPを除いた方が良かった。一方、Supervised SimCSEでは、 MLP layerをのっけたまんまで良かったとのこと。
また、SimCSEで学習したsentence embeddingを別タスクにtransferして活用する際には、SimCSEのobjectiveにMLMを入れた方が、catastrophic forgettingを防げて性能が高かったとのこと。
ablation studiesのhard negativesのところと、どのようにミニバッチを構成するか、それぞれのtransferしたタスクがどのようなものがしっかり読めていない。あとでよむ。
[Paper Note] PENS: A Dataset and Generic Framework for Personalized News Headline Generation, ACL'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #Dataset #LanguageModel #PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration #ACL #Surface-level Notes Issue Date: 2023-05-31 GPT Summary- この論文では、ユーザーの興味とニュース本文に基づいて、ユーザー固有のタイトルを生成するパーソナライズされたニュース見出し生成の問題を解決するためのフレームワークを提案します。また、この問題のための大規模なデータセットであるPENSを公開し、ベンチマークスコアを示します。データセットはhttps://msnews.github.io/pens.htmlで入手可能です。 Comment
# 概要
ニュース記事に対するPersonalizedなHeadlineの正解データを生成。103名のvolunteerの最低でも50件のクリックログと、200件に対する正解タイトルを生成した。正解タイトルを生成する際は、各ドキュメントごとに4名異なるユーザが正解タイトルを生成するようにした。これらを、Microsoft Newsの大規模ユーザ行動ログデータと、ニュース記事本文、タイトル、impressionログと組み合わせてPENSデータを構成した。
# データセット生成手順
103名のenglish-native [speakerの学生に対して、1000件のニュースヘッドラインの中から最低50件興味のあるヘッドラインを選択してもらう。続いて、200件のニュース記事に対して、正解ヘッドラインを生成したもらうことでデータを生成した。正解ヘッドラインを生成する際は、同一のニュースに対して4人がヘッドラインを生成するように調整した。生成されたヘッドラインは専門家によってqualityをチェックされ、factual informationにエラーがあるものや、極端に長い・短いものなどは除外された。
# データセット統計量
# 手法概要
Transformer Encoder + Pointer GeneratorによってPersonalizedなヘッドラインを生成する。
Transformer Encoderでは、ニュースの本文情報をエンコードし、attention distributionを生成する。Decoder側では、User Embeddingを組み合わせて、テキストをPointer Generatorの枠組みでデコーディングしていき、ヘッドラインを生成する。
User Embeddingをどのようにinjectするかで、3種類の方法を提案しており、1つ目は、Decoderの初期状態に設定する方法、2つ目は、ニュース本文のattention distributionの計算に利用する方法、3つ目はデコーディング時に、ソースからvocabをコピーするか、生成するかを選択する際に利用する方法。1つ目は一番シンプルな方法、2つ目は、ユーザによって記事で着目する部分が違うからattention distributionも変えましょう、そしてこれを変えたらcontext vectorも変わるからデコーディング時の挙動も変わるよねというモチベーション、3つ目は、選択するvocabを嗜好に合わせて変えましょう、という方向性だと思われる。最終的に、2つ目の方法が最も性能が良いことが示された。
# 訓練手法
まずニュース記事推薦システムを訓練し、user embeddingを取得できるようにする。続いて、genericなheadline generationモデルを訓練する。最後に両者を組み合わせて、Reinforcement LearningでPersonalized Headeline Generationモデルを訓練する。Rewardとして、
1. Personalization: ヘッドラインとuser embeddingのdot productで報酬とする
2. Fluency: two-layer LSTMを訓練し、生成されたヘッドラインのprobabilityを推定することで報酬とする
3. Factual Consistency: 生成されたヘッドラインと本文の各文とのROUGEを測りtop-3 scoreの平均を報酬とする
とした。
1,2,3の平均を最終的なRewardとする。
# 実験結果
Genericな手法と比較して、全てPersonalizedな手法が良かった。また、手法としては②のattention distributionに対してuser informationを注入する方法が良かった。News Recommendationの性能が高いほど、生成されるヘッドラインの性能も良かった。
# Case Study
ある記事に対するヘッドラインの一覧。Pointer-Genでは、重要な情報が抜け落ちてしまっているが、提案手法では抜け落ちていない。これはRLの報酬のfluencyによるものだと考えられる。また、異なるユーザには異なるヘッドラインが生成されていることが分かる。
Transformer Reasoning Network for Personalized Review Summarization, Xu+, SIGIR'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #review #SIGIR #One-Line Notes Issue Date: 2023-05-06 Comment
先行研究は、review summarizationにおいて生成されるsummaryは、過去にユーザが作成したsummaryのwriting styleやproductに非常に関係しているのに、これらを活用してこなかったので、活用しました(=personalized)という話っぽい
[Paper Note] ニュース記事に対する談話構造と興味度のアノテーション ~ニュース対話システムのパーソナライズに向けて~, 高津+, NLP'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #Dataset #Personalization Issue Date: 2023-04-30 Comment
ニュース記事に対して談話構造および,ユーザのプロフィールと記事の話題・文に対するユーザの興味度を付与したデータセット。
プロフィールとして以下を収集:
- 性別
- 年齢,
- 住んでいる地域
- 職種
- 業種
- ニュースを見る頻度,
- ニュースをよくチェックする時間帯
- 映像・音声・文字のうちニュースへの接触方法として多いものはどれか
- ニュースを知る手段
- ニュースを読む際使用している新聞やウェブサイト・アプリ
- 有料でニュースを読んでいるか
- 普段積極的に読む・見る・聞くニュースのジャンル
- ニュースのジャンルに対する興味の程度,趣味.
[Paper Note] 談話構造制約付きパーソナライズド抽出型要約, 高津+, NLP'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization Issue Date: 2023-04-30
Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
Paper/Blog Link My Issue
#ComputerVision #Embeddings #RepresentationLearning #MultiModal #ContrastiveLearning #ICML #Selected Papers/Blogs #2D (Image) #One-Line Notes #text Issue Date: 2023-04-27 Comment
CLIP論文。大量の画像と画像に対応するテキストのペアから、対照学習を行い、画像とテキスト間のsimilarityをはかれるようにしたモデル
Refocusing on Relevance: Personalization in NLG, Shiran Dudy+, Department of Computer Science University of Colorado, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Personalization #EMNLP #One-Line Notes Issue Date: 2023-04-26 Comment
従来のNLGはソーステキストに焦点を当て、ターゲットを生成することに注力してきた。が、ユーザの意図やcontextがソーステキストだけに基づいて復元できない場合、このアプローチでは不十分であることを指摘。
この研究ではNLGシステムが追加のcontextを利用することに大きな重点をおくべきであり、IR等で活用されているrelevancyをユーザ指向のテキスト生成タスクを設計するための重要な指標として考えることを提案している。
[Paper Note] Generating Racing Game Commentary from Vision, Language, and Structured Data, Tatsuya+, INLG'21
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NaturalLanguageGeneration #DataToTextGeneration #INLG #Game #3D (Video) Issue Date: 2022-09-15 GPT Summary- モーターレーシングゲームにおける自動解説生成タスクを提案し、視覚データ、数値データ、テキストデータを用いて解説を生成する。タスクは発話タイミングの特定と発話生成の2つのサブタスクに分かれ、129,226の発話を含む新しい大規模データセットを紹介。解説の特性は時間や視点によって変化し、最先端の視覚エンコーダでも正確な解説生成が難しいことが示された。データセットとベースライン実装は今後の研究のために公開される。 Comment
データセット: https://kirt.airc.aist.go.jp/corpus/ja/RacingCommentary
[Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #EMNLP #PostTraining #Selected Papers/Blogs #KeyPoint Notes #SoftPrompt Issue Date: 2022-08-19 GPT Summary- 本研究では、凍結された言語モデルを特定のタスクに適応させるための「ソフトプロンプト」を学習するプロンプトチューニング手法を提案。逆伝播を通じて学習されるソフトプロンプトは、GPT-3の少数ショット学習を上回る性能を示し、モデルサイズが大きくなるほど競争力が増すことが確認された。特に、数十億のパラメータを持つモデルにおいて、全ての重みを調整するモデルチューニングに匹敵する性能を発揮。これにより、1つの凍結モデルを複数のタスクに再利用できる可能性が示唆され、ドメイン転送に対するロバスト性も向上することが明らかとなった。 Comment
日本語解説:
https://qiita.com/kts_plea/items/79ffbef685d362a7b6ce
T5のような大規模言語モデルに対してfinetuningをかける際に、大規模言語モデルのパラメータは凍結し、promptをembeddingするパラメータを独立して学習する手法
言語モデルのパラメータ数が増加するにつれ、言語モデルそのものをfinetuningした場合(Model Tuning)と同等の性能を示した。
いわゆる(Softな) Prompt Tuning
[Paper Note] Biomedical Data-to-Text Generation via Fine-Tuning Transformers, Ruslan Yermakov+, ACL-INLG'21, 2021.09
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #Dataset #DataToTextGeneration #ACL #INLG #One-Line Notes Issue Date: 2022-08-18 GPT Summary- バイオメディカル分野におけるD2T生成の研究を行い、医薬品のパッケージリーフレットを用いた実世界のデータセットに対してファインチューニングされたトランスフォーマーを適用。現実的な複数文のテキスト生成が可能であることを示す一方で、重要な制限も存在。新たにバイオメディカル分野のD2T生成モデルのベンチマーク用データセット(BioLeaflets)を公開。 Comment
biomedical domainの新たなdata2textデータセットを提供。事前学習済みのBART, T5等をfinetuningすることで高精度にテキストが生成できることを示した。
[Paper Note] WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, Hiroaki Hayashi+, TACL'21, 2020.11
Paper/Blog Link My Issue
#DocumentSummarization #Tutorial #Dataset #TACL #KeyPoint Notes Issue Date: 2021-10-20 GPT Summary- オープンドメインのアスペクトベース要約のために、20の異なるドメインのWikipedia記事を用いたマルチドメイン対応データセットWikiAspを提案。各記事のセクションタイトルをアスペクト注釈の指標とし、実験を通じて既存モデルの主要な課題を明らかにした。 Comment
NLPコロキウムをリアルタイムに聴講
◆Aspect-based summarizationのモチベーション
・same source対して、異なるユーザニーズが存在するので、ニーズに関して要約したい
◆Aspect: あるobjectに対する、attributeのようなものを指定?
object: Attention Is All You Need
aspect: Multi-Head Attention
◆Aspect Based Summarizationの歴史
・はじめは”feature”という文言で研究され(04年頃?)
・続いて*keywords*という単語で研究され
・その後Aspectという文言で研究されるようになった
・2008年頃にMcDonaldsらがAspect-Based Summarizationを提案した
・2014年以後?とかにNeural Basedな手法が盛んに研究
◆WikiAspデータセットについて
・Wikipediaを使ったAspect-based dataset
・Wikipediaを書かれるのに利用されたsource document(wikipediaにソースとして引用されているもの)に対し、aspectを各節の見出しとみなし、節のテキストを要約文とみなすことで、データセット生成
・他のAspect-basedデータセットと異なり、ソースデータが長く、要約長も5~6倍程度
・ドメイン数が他データセットは5,6程度に対し、20と膨大
◆ベースラインとして2-stageモデルを採用
first-stage: ソーステキストからROBERTaベースドなclassifierを用いて、sentencesから内包するAspectを閾値を用いて決定
それらをgrouped sentencesとする
two-stage: 各aspectごとにまとまったテキスト集合に対して、要約モデルを適用し、要約を実施する
・要約モデルはUnsupervisedな手法であるTextRankと、Supervisedな手法であるBERTベースな手法を採用
・ドメインごとに評価した結果を見ると、BERTが強いドメインがある一方で、TextRankが強いドメインもあった
-> Extractiveな形で要約されているドメインではTextRankが強く、Abstractiveに要約されているドメインではBERTが強い
-> またBERTは比較的短い要約であればTextRankよりもはるかに良いが、長い要約文になるとTextRankとcomprable(あるいはTextRankの方が良い)程度の性能になる
・ROUGE-2の値がsentence-basedなORACLEを見た時に、他データセットと比較して低いので、Abstractiveな手法が必要なデータセット?
(後からのメモなので少しうろ覚えな部分あり)
Q. ROUGE-2が30とかって直観的にどのくらいのレベルのものなの?ROUGE-2が30とか40とかは高い
・最先端の要約モデルをニュース記事に適用すると、35~40くらいになる。
・このレベルの数値になると、人間が呼んでも違和感がないレベルの要約となっている
Q. 実際に要約文をチェックしてみて、どういう課題を感じるか?
A. Factual Consistencyがすぐに目につく問題で、特にBERTベースな要約文はそう。TextRankはソース文書がノイジーなので、ソース文章を適当に拾ってきただけではFactual Consistencyが良くない(元の文書がかっちりしていない)。流暢性の問題はAbstractiveモデルだと特に問題なくBERT-baseでできる。Aspect-based要約のエラー例としてAspectに則っていないということがある。たとえばオバマの大統領時代の話をきいているのに、幼少時代の話をしているとか。Aspect情報をうまくモデルを扱えていないという点が課題としてある。
出典元(リアルタイムに聴講): 第13回 WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, NLPコロキウム
https://youtu.be/3PIJotX6i_w?si=hX5pXwNL-ovkGSF5
[Paper Note] 過去情報の内容選択を取り入れた スポーツダイジェストの自動生成, 加藤+, NLP'21
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration Issue Date: 2021-10-08
[Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2021-09-09 GPT Summary- プレフィックスチューニングは、ファインチューニングの軽量な代替手段であり、言語モデルのパラメータを固定しつつ、タスク特有の小さなベクトルを最適化する手法です。これにより、少ないパラメータで同等のパフォーマンスを達成し、低データ設定でもファインチューニングを上回る結果を示しました。 Comment
言語モデルをfine-tuningする際,エンコード時に「接頭辞」を潜在表現として与え,「接頭辞」部分のみをfine-tuningすることで(他パラメータは固定),より少量のパラメータでfine-tuningを実現する方法を提案.接頭辞を潜在表現で与えるこの方法は,GPT-3のpromptingに着想を得ている.fine-tuningされた接頭辞の潜在表現のみを配布すれば良いので,非常に少量なパラメータでfine-tuningができる.
table-to-text, summarizationタスクで,一般的なfine-tuningやAdapter(レイヤーの間にアダプターを挿入しそのパラメータだけをチューニングする手法)といった効率的なfine-tuning手法と比較.table-to-textでは、250k (元のモデルの 0.1%) ほどの数のパラメータを微調整するだけで、全パラメータをfine-tuningするのに匹敵もしくはそれ以上の性能を達成.
Hugging Faceの実装を利用したと論文中では記載されているが,fine-tuningする前の元の言語モデル(GPT-2)はどのように準備したのだろうか.Hugging Faceのpretrained済みのGPT-2を使用したのだろうか.
autoregressive LM (GPT-2)と,encoder-decoderモデル(BART)へPrefix Tuningを適用する場合の模式図
[Paper Note] A Survey of Transformers, Tianyang Lin+, arXiv'21, 2021.06
Paper/Blog Link My Issue
#NeuralNetwork #Survey #Initial Impression Notes Issue Date: 2021-06-09 GPT Summary- トランスフォーマーの多様なバリアント(X-formers)に関する体系的な文献レビューを提供。バニラトランスフォーマーの紹介後、新しい分類法を提案し、アーキテクチャの修正、事前学習、アプリケーションの観点からX-formersを紹介。今後の研究の方向性も概説。 Comment
Transformersの様々な分野での亜種をまとめた論文
[Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #LongContext #NeurIPS #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- BigBirdは、Transformersモデルのシーケンス長に対する二次的依存性を線形に削減するスパース注意メカニズムを提案。これにより、長いシーケンスを最大8倍処理可能となり、質問応答や要約などのNLPタスクでの性能が向上。さらに、ゲノムデータへの新たな応用も示唆。 Comment
[Paper Note] Dense Passage Retrieval for Open-Domain Question Answering, Vladimir Karpukhin+, EMNLP'20, 2020.04
Paper/Blog Link My Issue
#Embeddings #InformationRetrieval #QuestionAnswering #ContrastiveLearning #EMNLP #Selected Papers/Blogs #Encoder #KeyPoint Notes Issue Date: 2025-09-28 GPT Summary- 密な表現を用いたパッセージ検索の実装を示し、デュアルエンコーダーフレームワークで学習。評価の結果、Lucene-BM25を上回り、検索精度で9%-19%の改善を達成。新たな最先端のQA成果を確立。 Comment
Dense Retrieverが広く知られるきっかけとなった研究(より古くはDSSM Learning Deep Structured Semantic Models for Web Search using Clickthrough Data, Huang+, CIKM'13
などがある)。bag-of-wordsのようなsparseなベクトルで検索するのではなく(=Sparse Retriever)、ニューラルモデルでエンコードした密なベクトルを用いて検索しようという考え方である。
Query用と検索対象のPassageをエンコードするEncoderを独立してそれぞれ用意し(=DualEncoder)、QAの学習データ(すなわちクエリqと正例として正解passage p+)が与えられた時、クエリqと正例p+の類似度が高く、負例p-との類似度が低くなるように(=Contrastive Learning)、Query, Passage Encoderのパラメータを更新することで学習する(損失関数は式(2))。
負例はIn-Batch Negativeを用いる。情報検索の場合正解ラベルは多くの場合明示的に決まるが、負例は膨大なテキストのプールからサンプリングしなければならない。サンプリング方法はいろいろな方法があり(e.g., ランダムにサンプリング、qとbm25スコアが高いpassage(ただし正解は含まない; hard negativesと呼ぶ)その中の一つの方法がIn-Batch Negativesである。
In-Batch Negativesでは、同ミニバッチ内のq_iに対応する正例p+_i以外の全てのp_jを(擬似的に)負例とみなす。これにより、パラメータの更新に利用するためのq,pのエンコードを全て一度だけ実行すれば良く、計算効率が大幅に向上するという優れもの。本研究の実験(Table3)によると上述したIn-Batch Negativeに加えて、bm25によるhard negativeをバッチ内の各qに対して1つ負例として追加する方法が最も性能が良かった。
クエリ、passageのエンコーダとしては、BERTが用いられ、[CLS]トークンに対応するembeddingを用いて類似度が計算される。
[Paper Note] BLiMP: The Benchmark of Linguistic Minimal Pairs for English, Alex Warstadt+, TACL'20
Paper/Blog Link My Issue
#Dataset #Evaluation #TACL #Grammar Issue Date: 2025-09-07 GPT Summary- 言語的最小対のベンチマーク(BLiMP)は、言語モデルの文法知識を評価するためのチャレンジセットで、67のサブデータセットから成り、各サブデータセットには特定の文法対比を示す1000の最小対が含まれています。データは専門家によって自動生成され、人間の合意は96.4%です。n-gram、LSTM、Transformerモデルを評価した結果、最先端のモデルは形態論的対比を識別できるが、意味的制約や微妙な文法現象には苦戦していることが示されました。 Comment
先行研究と比較して、より広範なlinguistic phenomenaを扱い、かつ大量のサンプルを集めた英語のacceptable/unacceptableなsentenceのペアデータ。ペアデータは特定のlinguistic phenomenaをacceptable/unacceptableに対比するための最小の違いに基づいており専門家が作成したテンプレートに基づいて自動生成され、クラウドソーシングによって人手でvalidationされている。言語モデルが英語のlinguistic phenomenaについて、どの程度理解しているかのベンチマークに利用可能。
[Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #One-Line Notes #Sparse #SparseAttention Issue Date: 2025-08-09 GPT Summary- Longformerは、長いシーケンスを線形に処理できる注意機構を持つTransformerベースのモデルで、数千トークンの文書を扱える。局所的なウィンドウ注意とタスクに基づくグローバル注意を組み合わせ、文字レベルの言語モデリングで最先端の結果を達成。事前学習とファインチューニングを行い、長文タスクでRoBERTaを上回る性能を示した。また、Longformer-Encoder-Decoder(LED)を導入し、長文生成タスクにおける効果を確認した。 Comment
(固定された小さめのwindowsサイズの中でのみattentionを計算する)sliding window attentionを提案。Figure2を見ると、通常のAttentionと比較して、現在のトークンの周辺のトークンにしか注目しない特性が図示されており、イメージが掴みやすい。
OpenLLMの文脈だと、Mistralに採用されて話題になったかも?
- Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
[Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #ICML #Selected Papers/Blogs #reading #One-Line Notes #RecurrentModels #LinearAttention Issue Date: 2025-08-05 GPT Summary- 自己注意をカーネル特徴マップの線形ドット積として表現することで、Transformersの複雑性を$\mathcal{O}\left(N^2\right)$から$\mathcal{O}\left(N\right)$に削減。これにより、自己回帰型Transformersの速度が最大4000倍向上し、従来のパフォーマンスを維持。 Comment
関連:
- Transformers are Multi-State RNNs, Matanel Oren+, N/A, EMNLP'24
pj page: https://linear-transformers.com
Linear Attention(Linear Transformer)を提案した研究。Softmaxが利用されるFull Attentionのsimilarity部分をfeature map φを持つカーネルk(x, y)で一般化し、(3)--(6)の流れでfeature map φ同士は内積が使える性質と、行列積の結合法則を用いて式変換する。
式変換によって、従来のSoftmax Attentionでは、全てのトークンNに対してQ_i * K_j * V_jのメモリが必要だったものを(O(N^2))、各Queryごとに利用される、KVを用いた情報が共通化され(現在のqueryまでのφ(K)とφ(K)V^Tを逐次的に加算して保持するだけで良い)、再利用が可能となりメモリに関するオーダーがO(N)となる。
これらの話は実際にどのような カーネルを利用するかを無視した話だが、たとえばsoftmaxを表現するために必要な指数カーネルの場合はfeature mapが無限次元となるため有限次元のベクトルでは表現できず、厳密に線形化することができない。このため、有限次元かつ厳密なfeature mapを持つ多公式カーネルを用いて近似する。この場合、計算量のオーダーがO(ND^2M)となり(Nがsequence length, Dがqueryとkeyの次元数, Mがvalueの次元数)、softmax attentionの計算量がO(N^2 max(D,M))であることと比較すると、N > D^2である場合に計算効率が改善される。
学習時は並列に学習が可能で、推論時はφ(K_j)V_j^Tを内部状態とみなすと、各タイムステップでRNNのように状態を更新して保持するだけで良い。
(続きはさらに後で読む)
次: DeltaNet
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
次の次: Gated DeltaNet
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
次の次の次: Kimi Delta Attention (KDA)
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
[Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #ICLR #Sparse #SparseAttention Issue Date: 2025-08-05 GPT Summary- 本研究では、トランスフォーマーモデルの効率を向上させるために、局所感度ハッシュを用いた注意機構と可逆残差層を提案。これにより、計算量をO($L^2$)からO($L\log L$)に削減し、メモリ効率と速度を向上させたReformerモデルを実現。トランスフォーマーと同等の性能を維持。 Comment
openreview: https://openreview.net/forum?id=rkgNKkHtvB
[Paper Note] Linformer: Self-Attention with Linear Complexity, Sinong Wang+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention Issue Date: 2025-08-05 GPT Summary- 大規模トランスフォーマーモデルは自然言語処理で成功を収めているが、長いシーケンスに対しては高コスト。自己注意メカニズムを低ランク行列で近似し、複雑さを$O(n^2)$から$O(n)$に削減する新しいメカニズムを提案。これにより、メモリと時間効率が向上した線形トランスフォーマー「Linformer」が標準モデルと同等の性能を示す。
[Paper Note] CommonGen: A Constrained Text Generation Challenge for Generative Commonsense Reasoning, Bill Yuchen Lin+, EMNLP'20 Findings
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Dataset #Evaluation #Composition #EMNLP #Findings #CommonsenseReasoning Issue Date: 2025-07-31 GPT Summary- 生成的常識推論をテストするためのタスクCommonGenを提案し、35,000の概念セットに基づく79,000の常識的記述を含むデータセットを構築。タスクは、与えられた概念を用いて一貫した文を生成することを求め、関係推論と構成的一般化能力が必要。実験では、最先端モデルと人間のパフォーマンスに大きなギャップがあることが示され、生成的常識推論能力がCommonsenseQAなどの下流タスクに転送可能であることも確認。 Comment
ベンチマークの概要。複数のconceptが与えられた時に、それらconceptを利用した常識的なテキストを生成するベンチマーク。concept間の関係性を常識的な知識から推論し、Unseenなconceptの組み合わせでも意味を構成可能な汎化性能が求められる。
PJ page: https://inklab.usc.edu/CommonGen/
[Paper Note] On Faithfulness and Factuality in Abstractive Summarization, Joshua Maynez+, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Abstractive #Factuality #Faithfulness #ACL Issue Date: 2025-07-14 GPT Summary- 抽象的な文書要約における言語モデルの限界を分析し、これらのモデルが入力文書に対して忠実でない内容を生成する傾向が高いことを発見。大規模な人間評価を通じて、生成される幻覚の種類を理解し、すべてのモデルで相当量の幻覚が確認された。事前学習されたモデルはROUGE指標だけでなく、人間評価でも優れた要約を生成することが示された。また、テキストの含意測定が忠実性と良好に相関することが明らかになり、自動評価指標の改善の可能性を示唆。 Comment
文書要約の文脈において `hallucination` について説明されている。
- [Paper Note] Chain-of-Verification Reduces Hallucination in Large Language Models, Shehzaad Dhuliawala+, N/A, ACL'24
が `hallucination` について言及する際に引用している。
[Paper Note] On Layer Normalization in the Transformer Architecture, Ruibin Xiong+, arXiv'20, 2020.02
Paper/Blog Link My Issue
#Analysis #Transformer #Architecture #Normalization #One-Line Notes Issue Date: 2025-07-05 GPT Summary- Transformerの学習で必要とされる学習率ウォームアップについて、Layer Normalizationの位置に着目して理論的に分析。 従来のPost-LN Transformerでは出力層付近の勾配が大きくなり学習が不安定になるため、ウォームアップが有効である。 一方、Pre-LN Transformerでは初期勾配が適切に保たれるため、ウォームアップなしでも同等の性能を達成し、学習時間とハイパーパラメータ調整を削減できる。 Comment
OpenReview: https://openreview.net/forum?id=B1x8anVFPr
Encoder-DecoderのTransformerにおいて、Post-LNの場合は、Warmupを無くすと最終的な性能が悪化し、またWarmUpステップの値によって(500 vs. 4000で実験)も最終的な性能が変化する。これには学習時にハイパーパラメータをしっかり探索しなければならず、WarmUPを大きくすると学習効率が落ちるというデメリットがある。
Post-LNの場合は、Pre-LNと比較して勾配が大きく、Warmupのスケジュールをしっかり設計しないと大きな勾配に対して大きな学習率が適用され学習が不安定になる。これは学習率を非常に小さくし、固定値を使うことで解決できるが、収束が非常に遅くなるというデメリットがある。
一方、Pre-LNはWarmup無しでも、高い性能が達成でき、上記のようなチューニングの手間や学習効率の観点から利点がある、みたいな話の模様。
[Paper Note] Scaling Laws for Autoregressive Generative Modeling, Tom Henighan+, arXiv'20, 2020.10
Paper/Blog Link My Issue
#LanguageModel #MultiModal #Scaling Laws #read-later #Selected Papers/Blogs #CrossDomain Issue Date: 2025-05-31 GPT Summary- 生成画像、ビデオ、マルチモーダルモデル、数学的問題解決の4領域におけるクロスエントロピー損失のスケーリング法則を特定。自己回帰型トランスフォーマーはモデルサイズと計算予算の増加に伴い性能が向上し、べき法則に従う。特に、10億パラメータのトランスフォーマーはYFCC100M画像分布をほぼ完璧にモデル化できることが示された。さらに、マルチモーダルモデルの相互情報量や数学的問題解決における外挿時の性能に関する追加のスケーリング法則も発見。これにより、スケーリング法則がニューラルネットワークの性能に与える影響が強調された。 Comment
Kaplan Law
[Paper Note] PEGASUS: Pre-training with Extracted Gap-sentences for Abstractive Summarization, Jingqing Zhang+, ICML'20
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #ICML #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-13 GPT Summary- 大規模なテキストコーパスに対して新しい自己教師ありの目的でトランスフォーマーを事前学習し、抽象的なテキスト要約に特化したモデルPEGASUSを提案。重要な文を削除またはマスクし、残りの文から要約を生成。12の下流要約タスクで最先端のROUGEスコアを達成し、限られたリソースでも優れたパフォーマンスを示す。人間評価でも複数のデータセットで人間のパフォーマンスに達したことを確認。 Comment
PEGASUSもなかったので追加。BARTと共に文書要約のBackboneとして今でも研究で利用される模様。
関連:
- SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
[Paper Note] Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, Colin Raffel+, JMLR'20
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #TransferLearning #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- 転移学習はNLPにおいて強力な技術であり、本論文ではテキストをテキストに変換する統一フレームワークを提案。事前学習の目的やアーキテクチャを比較し、最先端の結果を達成。データセットやモデル、コードを公開し、今後の研究を促進する。 Comment
T5もメモっていなかったので今更ながら追加。全てのNLPタスクをテキスト系列からテキスト系列へ変換するタスクとみなし、Encoder-DecoderのTransformerを大規模コーパスを用いて事前学習をし、downstreamタスクにfinetuningを通じて転移する。
個人的に、Transformer-decoderのスケーラビリティのみならず、T5全てのタスクをテキスト系列の変換とみなす考え方が、現在のLLMの基盤となっていると感じている。
[Paper Note] Editable Neural Networks, Anton Sinitsin+, ICLR'20
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #MachineLearning #ICLR #KnowledgeEditing #read-later #One-Line Notes Issue Date: 2025-05-07 GPT Summary- 深層ニューラルネットワークの誤りを迅速に修正するために、Editable Trainingというモデル非依存の訓練手法を提案。これにより、特定のサンプルの誤りを効率的に修正し、他のサンプルへの影響を避けることができる。大規模な画像分類と機械翻訳タスクでその有効性を実証。 Comment
(おそらく)Knowledge Editingを初めて提案した研究
OpenReview: https://openreview.net/forum?id=HJedXaEtvS
[Paper Note] SimulMT to SimulST: Adapting Simultaneous Text Translation to End-to-End Simultaneous Speech Translation, Xutai Ma+, AACL'20
Paper/Blog Link My Issue
#Metrics #Evaluation #SpeechProcessing #AutomaticSpeechRecognition(ASR) #AACL #SimulST(SimultaneousSpeechTranslation) #One-Line Notes Issue Date: 2025-04-30 GPT Summary- 同時テキスト翻訳手法をエンドツーエンドの同時音声翻訳に適応させる研究を行い、事前決定モジュールを導入。レイテンシと品質のトレードオフを分析し、新しいレイテンシメトリックを設計。 Comment
同時翻訳研究で主要なmetricの一つ
関連:
- [Paper Note] Over-Generation Cannot Be Rewarded: Length-Adaptive Average Lagging for Simultaneous Speech Translation, Sara Papi+, NAACL'22
[Paper Note] The Curious Case of Neural Text Degeneration, Ari Holtzman+, ICLR'20
Paper/Blog Link My Issue
#LanguageModel #ICLR #Decoding #Diversity #Selected Papers/Blogs Issue Date: 2025-04-14 GPT Summary- 深層ニューラル言語モデルは高品質なテキスト生成において課題が残る。尤度の使用がモデルの性能に影響を与え、人間のテキストと機械のテキストの間に分布の違いがあることを示す。デコーディング戦略が生成テキストの質に大きな影響を与えることが明らかになり、ニュークリアスsamplingを提案。これにより、多様性を保ちながら信頼性の低い部分を排除し、人間のテキストに近い質を実現する。 Comment
現在のLLMで主流なNucleus (top-p) Samplingを提案した研究
[Paper Note] Scaling Laws for Neural Language Models, Jared Kaplan+, arXiv'20, 2020.01
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Scaling Laws #Selected Papers/Blogs Issue Date: 2025-03-23 GPT Summary- 言語モデルの性能に関するスケーリング法則を研究し、損失がモデルサイズ、データセットサイズ、計算量に対して冪則的にスケールすることを示す。アーキテクチャの詳細は影響が少なく、過学習やトレーニング速度は単純な方程式で説明される。これにより、計算予算の最適な配分が可能となり、大きなモデルはサンプル効率が高く、少量のデータで早期に収束することが示された。 Comment
日本語解説: https://www.slideshare.net/slideshow/dlscaling-laws-for-neural-language-models/243005067
COMET: A Neural Framework for MT Evaluation, Ricardo Rei+, N_A, EMNLP'20
Paper/Blog Link My Issue
#MachineTranslation #Metrics #Evaluation #EMNLP #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-05-26 GPT Summary- COMETは、多言語機械翻訳評価モデルを訓練するためのニューラルフレームワークであり、人間の判断との新しい最先端の相関レベルを達成します。クロスリンガル事前学習言語モデリングの進展を活用し、高度に多言語対応かつ適応可能なMT評価モデルを実現します。WMT 2019 Metrics shared taskで新たな最先端のパフォーマンスを達成し、高性能システムに対する堅牢性を示しています。 Comment
Better/Worseなhypothesisを利用してpair-wiseにランキング関数を学習する


Inference時は単一のhypothesisしかinputされないので、sourceとreferenceに対してそれぞれhypothesisの距離をはかり、その調和平均でスコアリングする

ACL2024, EMNLP2024あたりのMT研究のmetricをざーっと見る限り、BLEU/COMETの双方で評価する研究が多そう
[Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Transformer #Selected Papers/Blogs #ActivationFunction #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- GLUの変種は非線形関数を用いて二つの線形射影を組み合わせ、Transformerモデルでテストした結果、従来の活性化関数ReLUやGELUよりも性能を向上させることが確認された。 Comment
一般的なFFNでは、linear layerをかけた後に、何らかの活性化関数をかませる方法が主流である。
最近FFNで利用される活性化関数として入力をsigmoid gateにlinear layerで変換して、同じくlinear layerで入力ベクトルを変換したベクトルとの要素積をとるGLUがあるが、これには改良の余地があり、様々なvariantが考えられるため、色々試しました(以下の8種類のvariantが提案されている)、というはなし。
オリジナルのGLUと比較して、T5と同じ事前学習タスクを実施したところ、perplexityが改善
また、finetuningをした場合の性能も、多くの場合オリジナルのGLUよりも高い性能を示した。
[Paper Note] BLEU might be Guilty but References are not Innocent, Markus Freitag+, arXiv'20, 2020.04
Paper/Blog Link My Issue
#MachineTranslation #Analysis #NaturalLanguageGeneration #Metrics #Evaluation #One-Line Notes Issue Date: 2024-01-25 GPT Summary- 機械翻訳の自動評価指標の質を検証し、参照データの性質が重要であることを示す。さまざまな参照収集方法を検討し、人間評価との相関を報告。典型的な参照の偏りを打ち消すために、言語学者によるパラフレージング課題を開発。WMT 2019のデータにおいて、標準参照との相関が低い出力でも人間判断との相関が向上することを示す。また、埋め込みベースの手法を含む評価指標で相関が改善されることも明らかにし、マルチ参照BLEUの限界と新たな定式化を提示。 Comment
surface levelのNLGの性能指標がsemanticを評価できないことを示した研究
[Paper Note] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis+, N_A, NeurIPS'20
Paper/Blog Link My Issue
#InformationRetrieval #LanguageModel #RAG(RetrievalAugmentedGeneration) #NeurIPS #Selected Papers/Blogs #Encoder-Decoder #ContextEngineering Issue Date: 2023-12-01 GPT Summary- 大規模な事前学習言語モデルを使用した検索強化生成(RAG)の微調整手法を提案しました。RAGモデルは、パラメトリックメモリと非パラメトリックメモリを組み合わせた言語生成モデルであり、幅広い知識集約的な自然言語処理タスクで最先端の性能を発揮しました。特に、QAタスクでは他のモデルを上回り、言語生成タスクでは具体的で多様な言語を生成することができました。 Comment
RAGを提案した研究
Retrieverとして利用されているDense Passage Retrieval (DPR)はこちら:
- [Paper Note] Dense Passage Retrieval for Open-Domain Question Answering, Vladimir Karpukhin+, EMNLP'20, 2020.04
所見:
Asking and Answering Questions to Evaluate the Factual Consistency of Summaries, Wang, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #QA-based #One-Line Notes Issue Date: 2023-08-20 Comment
QAGS
生成された要約からQuestionを生成する手法。precision-oriented
Reducing Quantity Hallucinations in Abstractive Summarization, Zheng Zhao+, N_A, EMNLP'20
Paper/Blog Link My Issue
#DocumentSummarization #Hallucination #EMNLP #numeric #One-Line Notes #needs-revision Issue Date: 2023-08-16 GPT Summary- Hermanシステムは、抽象的な要約において幻覚を回避するために、数量エンティティを認識し、元のテキストでサポートされている数量用語を持つ要約を上位にランク付けするアプローチを提案しています。実験結果は、このアプローチが高い適合率と再現率を持ち、F$_1$スコアが向上することを示しています。また、上位にランク付けされた要約が元の要約よりも好まれることも示されています。 Comment
数量に関するhallucinationを緩和する要約手法
FEQA: A Question Answering Evaluation Framework for Faithfulness Assessment in Abstractive Summarization, Durmus+, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #QA-based #One-Line Notes Issue Date: 2023-08-16 Comment
FEQA
生成された要約からQuestionを生成する手法。precision-oriented
HOLMS: Alternative Summary Evaluation with Large Language Models, Mrabet+, COLING'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13 GPT Summary- 要約手法の評価尺度として、ROUGEとBLEUが一般的に使用されているが、これらは語彙的な性質を持ち、ニューラルネットワークのトレーニングには限定的な可能性がある。本研究では、大規模なコーパスで事前学習された言語モデルと語彙的類似度尺度を組み合わせた新しい評価尺度であるHOLMSを提案する。実験により、HOLMSがROUGEとBLEUを大幅に上回り、人間の判断との相関も高いことを示した。 Comment
Hybrid Lexical and MOdel-based evaluation of Summaries (HOLMS)
[Paper Note] Unsupervised Reference-Free Summary Quality Evaluation via Contrastive Learning, Hanlu Wu+, arXiv'20, 2020.10
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #EMNLP #needs-revision Issue Date: 2023-08-13 GPT Summary- 要約タスクの評価は重要であり、従来のROUGEは参照要約が必要である。本研究は、教師なしの対照学習を用いて参照なしで要約品質を評価する新しい指標を提案。BERTに基づき、言語的品質と意味的情報量をカバーする指標を設計し、ネガティブサンプルを使ってモデルを訓練。NewsroomとCNN/Daily Mailの実験で、提案手法が他の指標を上回ることを示し、データセット間での一般性も確認。 Comment
LS_Score
色々なメトリックが簡潔にまとまっている
Evaluating the Factual Consistency of Abstractive Text Summarization, Kryscinski+, EMNLP'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #LM-based #Factuality #EMNLP #One-Line Notes Issue Date: 2023-08-13 Comment
FactCC
近年のニューラルモデルは流ちょうな要約を生成するが、それらには、unsuportedなinformationが多く含まれていることを示した
Automatic Machine Translation Evaluation in Many Languages via Zero-Shot Paraphrasing, Thompson+, EMNLP'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #LM-based Issue Date: 2023-08-13 Comment
PRISM
Fill in the BLANC: Human-free quality estimation of document summaries, Vasilyev+, Eval4NLP'20
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13
SUPERT: Towards New Frontiers in Unsupervised Evaluation Metrics for Multi-Document Summarization, Gao+, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free #Training-Free Issue Date: 2023-08-13 Comment
pseudo-reference summaryを作成し、referenceに対してSBERTを適用しsystem-reference間の類似度を測ることで、unsupervisedに複数文書要約を評価する手法。
まずTACのデータに対して、既存研究(single document summarizationの評価用に提案された手法)を適用し、Human Ratingsとの相関が低いことを確認している。この時、Referenceを用いる手法(ROUGE、MoverScore)の相関をUpper Boundとし、Upper Boundに及ばないことを確認している。また、既存研究よりもシンプルなJS Divergence等を用いるlexical basedな手法の相関が高かったことも確認している。
続いて、unsupervisedな手法として、contextualなembeddingを利用し(BERT, SBERT等)source, system summary間の類似度を測る手法で相関を測ったところ、こちらでもUpper Boundに及ばないこと、シンプルな手法に及ばないことを確認。これら手法にWMDを応用するすることで相関が向上することを確認した。
これらのことより、Referenceがある場合、無い場合の両者においてWMDを用いる手法が有効であることが確認できたが、Referenceの有無によって相関に大きな差が生まれていることが確認できた。このことから、何らかの形でReferenceが必要であり、pseudo referenceを生成し利用することを着想した、というストーリーになっている。
pseudo referenceを生成する方法として、top Nのリード文を抽出する手法や、LexRankのようなGraphBasedな手法を利用してTACデータにおいてどのような手法が良いかを検証している。この結果、TAC8,9の場合はTop 10,15のsentenceをpseudo referenceとした場合が最も良かった。
細かいところまで読みきれていないが、自身が要約したい文書群においてどの方法でpseudo referenceを生成するかは、Referenceがないと判断できないと考えられるため、その点は課題だと考えられる。
BLEURT: Learning Robust Metrics for Text Generation, Sellam+, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-based #TrainedMetrics Issue Date: 2023-08-13
[Paper Note] Measuring Massive Multitask Language Understanding, Dan Hendrycks+, arXiv'20, 2020.09
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #ICLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-24 GPT Summary- 新しいテストを提案し、57のマルチタスクを用いてテキストモデルの正確度を測定。高い正確度には広範な世界知識と問題解決能力が必要である。GPT-3モデルはランダム推測を約20ポイント上回るが、専門家レベルには遠く、多くのタスクで偏った性能を示す。特に道徳や法に関してはほぼランダムに近い正確度を記録。このテストはモデルの理解力を評価し、重要な欠点を明らかにすることを目的とする。 Comment
OpenReview: https://openreview.net/forum?id=d7KBjmI3GmQ
MMLU論文
- [Paper Note] Are We Done with MMLU?, Aryo Pradipta Gema+, NAACL'25
において、多くのエラーが含まれることが指摘され、再アノテーションが実施されている。
[Paper Note] A Unified Dual-view Model for Review Summarization and Sentiment Classification with Inconsistency Loss, Hou Pong Chan+, arXiv'20, 2020.06
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #review #KeyPoint Notes Issue Date: 2023-05-06 GPT Summary- ユーザーレビューから正確な要約と感情を取得するためのデュアルビュー型モデルを提案。レビューの文脈を学習後、要約を生成し、二つの感情分類器がそれぞれレビューと生成要約の感情ラベルを予測。両者の不一致を罰する損失を導入し、一貫した感情傾向を促進。4つの実世界データセットで効果を実証。 Comment
Review SummarizationとSentiment Classificationをjointで学習した研究。既存研究ではreviewのみからsentimentの情報を獲得する枠組みは存在したが、summaryの情報が活用できていなかった。
SNAP: Web data: Amazon reviews
のratingをsentiment labelとして扱い、評価も同データを用いてROUGEで評価。
実際に生成されたレビュー例がこちら。なんの疑いもなくamazon online review datasetを教師データとして使っているが、果たしてこれでいいんだろうか?
論文冒頭のsummaryの例と、実際に生成された例を見ると、後者の方が非常に主観的な情報を含むのに対して、前者はより客観性が高いように思える。
しかし最初にこのデータセットを使ったのは A Hierarchical End-to-End Model for Jointly Improving Text Summarization and Sentiment Classification, Shuming Ma+, N/A, arXiv'18 の方っぽい
[Paper Note] Language Models are Few-Shot Learners, Tom B. Brown+, NeurIPS'20, 2020.05
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Zero/Few/ManyShotPrompting #In-ContextLearning #NeurIPS #Selected Papers/Blogs Issue Date: 2023-04-27 GPT Summary- GPT-3は1750億パラメータの自己回帰型モデルで、タスク非依存のFew-shot学習を改善。ファインチューニングなしで多様なNLPタスクで高い性能を示し、人間と区別しにくい文を生成可能。訓練の課題も明らかに。 Comment
In-Context Learningを提案した論文
論文に記載されているIn-Context Learningの定義は、しっかり押さえておいた方が良い。
下図はmeta-learningの観点から見たときの、in-contextの位置付け。事前学習時にSGDでパラメータをupdateするのをouter loopとし、そこで広いスキルとパターン認識の能力を身につける。一方で、in-context learningは、Inference時に事前学習時に得たそれらのスキルを用いて、求めるタスクを認識、あるいは適応するInner loopのことを指す。
この上で、論文中では In-Context Learningについて:
> Recent work [RWC+19] attempts to do this via what we call “in-context learning”, using the text input of a pretrained language model as a form of task specification: the model is conditioned on a natural language instruction and/or a few demonstrations of the task and is then expected to complete further instances of the task simply by predicting what comes next.
と定義している。
Returning the N to NLP: Towards Contextually Personalized Classification Models, Lucie Flek, Mainz University of Applied Sciences Germany, ACL'20
Paper/Blog Link My Issue
#Survey #Personalization #ACL #One-Line Notes Issue Date: 2023-04-26 Comment
NLPのけるPersonalized Classificationモデルのliteratureを振り返る論文
Few-Shot NLG with Pre-Trained Language Model, Chen+, University of California, ACL'20
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #LanguageModel #DataToTextGeneration #pretrained-LM #Zero/FewShotLearning #Surface-level Notes Issue Date: 2022-12-01 Comment
# 概要
Neural basedなend-to-endなNLGアプローチはdata-hungryなので、Few Shotな設定で高い性能ができる手法を提案(Few shot NLG)
Table-to-Textタスク(WikiBIOデータ, 追加で収集したBook, SongドメインのWikipediaデータ)において、200程度の学習サンプル数でstrong baselineに対して8.0 point程度のBLEUスコアの向上を達成
# 手法
TabularデータのDescriptionを作成するには大きく分けて2つのスキルが必要
1. factualな情報を持つcontentをselectし、copyするスキル
2. factualな情報のコピーを含めながら、文法的に正しいテキストを生成するスキル
提案手法では、1を少量のサンプル(< 500)から学習し、2については事前学習済みの言語モデルを活用する。
encoderからコピーする確率をpcopyとし、下記式で算出する:
すなわち、encoderのcontext vectorと、decoderのinputとstateから求められる。
encoderとencoder側へのattentionはscratchから学習しなければならず、うまくコピーできるようにしっかりと”teach”しなければならないため、lossに以下を追加する:
すなわち、コピーすべき単語がちゃんとコピーできてる場合にlossが小さくなる項を追加している。
また、decoder側では、最初にTable情報のEmbeddingを入力するようにしている。
また、学習できるデータ量が限られているため、pre-trainingモデルのEmbeddingは事前学習時点のものに固定した(ただしく読解できているか不安)
# 実験
WikiBIOと、独自に収集したBook, Songに関するWikipediaデータのTable-to-Textデータを用いて実験。
このとき、Training instanceを50~500まで変化させた。
WikiBIOデータセットに対してSoTAを記録しているBase-originalを大きくoutperform(Few shot settingでは全然うまくいかない)。
inputとoutput例と、コピーに関するlossを入れた場合の効果。
人手評価の結果、Factual informationの正しさ(#Supp)、誤り(#Cont)ともに提案手法が良い。また、文法的な正しさ(Lan. Score)もコピーがない場合とcomparable
[Paper Note] Leveraging Pre-trained Checkpoints for Sequence Generation Tasks, Sascha Rothe+, TACL'20, 2019.07
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #MachineTranslation #Transformer #pretrained-LM #TACL #Encoder #Encoder-Decoder #KeyPoint Notes Issue Date: 2022-12-01 GPT Summary- 事前学習された大規模なニューラルモデルがシーケンス生成においても有効であることを示し、BERT、GPT-2、RoBERTaと互換性のあるTransformerベースのモデルを開発。これにより、機械翻訳やテキスト要約などのタスクで新たな最先端の成果を達成。 Comment
# 概要
BERT-to-BERT論文。これまでpre-trainedなチェックポイントを利用する研究は主にNLUで行われてきており、Seq2Seqでは行われてきていなかったので、やりました、という話。
publicly availableなBERTのcheckpointを利用し、BERTをencoder, decoder両方に採用することでSeq2Seqを実現。実現する上で、
1. decoder側のBERTはautoregressiveな生成をするようにする(左側のトークンのattentionしか見れないようにする)
2. encoder-decoder attentionを新たに導入する
の2点を工夫している。
# 実験
Sentence Fusion, Sentence Split, Machine Translation, Summarizationの4タスクで実験
## MT
BERT2BERTがSoTA達成。Edunov+の手法は、data _augmentationを利用した手法であり、純粋なWMT14データを使った中ではSoTAだと主張。特にEncoder側でBERTを使うと、Randomにinitializeした場合と比べて性能が顕著に上昇しており、その重要性を主張。
Sentence Fusion, Sentence Splitでは、encoderとdecoderのパラメータをshareするのが良かったが、MTでは有効ではなかった。これはMTではmodelのcapacityが非常に重要である点、encoderとdecoderで異なる文法を扱うためであると考えられる。
## Summarization
BERTSHARE, ROBERTASHAREの結果が良かった。
Template Guided Text Generation for Task-Oriented Dialogue, Kale+, Google, EMNLP'20
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #pretrained-LM #KeyPoint Notes Issue Date: 2022-12-01 Comment
# 概要
Dialogue Actをそのままlinearlizeして言語モデルに入力するのではなく、テンプレートをベースにしたシンプルなsentenceにして言語モデルに与えると、zero-shot, few-shotなsettingで性能が向上するという話(T5ベース)。
# 手法
slotの名称をnatural languageのdescriptionに変更するSchema Guidedアプローチも提案(NLUでは既に実践さrていたらしいが、Generationで利用されたことはない)。
# 結果
MultiWoz, E2E, SGDデータセットを利用。MultiWoz, E2Eデータはデータ量が豊富でドメインやfeatureが限定的なため、schema guided, template guided approachとNaiveなrepresentationを利用した場合の結果がcopmarableであった。
が、SGDデータセットはドメインが豊富でzero-shot, few-shotの設定で実験ができる。SGDの場合はTemplate guided representationが最も高い性能を得た。
low resourceなデータセットで活用できそう
Machine Learning–Driven Language Assessment, LaFlair+, TACL'20
Paper/Blog Link My Issue
#Education #Assessment #IRT Issue Date: 2022-11-25
[Paper Note] Text-to-Text Pre-Training for Data-to-Text Tasks, Mihir+, Google Research, INLG'20
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #Transformer #INLG #KeyPoint Notes Issue Date: 2022-09-16 Comment
# 概要
pre-training済みのT5に対して、Data2Textのデータセットでfinetuningを実施する方法を提案。WebNLG(graph-to-text), ToTTo(table-to-text), Multiwoz(task oriented dialogue)データにおいて、simpleなTransformerでも洗練されたmulti-stageなpipelined approachをoutperformできることを示した研究。
# 手法
事前学習済みのT5に対してfine-tuningを実施した。手法はシンプルで、data-to-textタスクをtext-to-textタスクに変換した。具体的には、構造かされたデータをflatな文字列(linearization)で表現することで、text-to-textタスクに変換。各データセットに対するlinearizationのイメージは下図。デリミタや特殊文字を使って構造かされたデータをflatなstringで表現している。
# データセット
## ToTTo(2020)
Wikipediaのテーブルと自然言語でdescriptionのペアデータ
## MultiWoz(2018)
10Kの人間同士のtask-orientedなdialogueデータ。
## WebNLG(2017)
subject-object-predicateの3組みをテキスト表現に変換するタスクのデータ
# Result
## WebNLG
GCNを利用した2020年に提案されたDualEncがSoTAだったらしいが、outperormしている。
## ToTTo
[こちら](
https://github.com/google-research-datasets/totto)のリーダーボードと比較してSoTAを記録
## MultiWoz
T5は事前学習済みGPT-2をfinetuningした手法もoutperformした。SC-GPT2は当時のMultiWozでのSoTA
# Impact of Model capacity
T5モデルのサイズがどれが良いかについては、データセットのサイズと複雑さに依存することを考察している。たとえば、MultiWozデータは構造化データのバリエーションが最も少なく、データ量も56kと比較的多かった。このため、T5-smallでもより大きいモデルの性能に肉薄できている。
一方、WebNLGデータセットは、18kしか事例がなく、特徴量も約200種類程度のrelationのみである。このような場合、モデルサイズが大きくなるにつれパフォーマンスも向上した(特にUnseen test set)。特にBLEUスコアはT5-smallがT5-baseになると、10ポイントもジャンプしており、modelのcapacityがout-of-domainに対する一般化に対してcriticalであることがわかる。ToTToデータセットでも、SmallからBaseにするとパフォーマンスは改善した。
# 所感
こんな簡単なfine-tuningでSoTAを達成できてしまうとは、末恐ろしい。ベースラインとして有用。
[Paper Note] All Word Embeddings from One Embedding, Takase+, NeurIPS'20
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #EfficiencyImprovement #MachineLearning #NeurIPS #KeyPoint Notes Issue Date: 2021-06-09 Comment
NLPのためのNN-basedなモデルのパラメータの多くはEmbeddingによるもので、従来は個々の単語ごとに異なるembeddingをMatrixの形で格納してきた。この研究ではモデルのパラメータ数を減らすために、個々のword embeddingをshared embeddingの変換によって表現する手法ALONE(all word embeddings from one)を提案。単語ごとに固有のnon-trainableなfilter vectorを用いてshared embeddingsを修正し、FFNにinputすることで表現力を高める。また、filter vector普通に実装するとword embeddingと同じサイズのメモリを消費してしまうため、メモリ効率の良いfilter vector効率手法も提案している。機械翻訳・および文書要約を行うTransformerに提案手法を適用したところ、より少量のパラメータでcomparableなスコアを達成した。
Embedidngのパラメータ数とBLEUスコアの比較。より少ないパラメータ数でcomparableな性能を達成している。
NUBIA, EvalNLGEval'20
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #DataToTextGeneration #ConceptToTextGeneration #DialogueGeneration #Encoder #KeyPoint Notes Issue Date: 2021-06-02 Comment
TextGenerationに関するSoTAの性能指標。BLEU, ROUGE等と比較して、人間との相関が高い。

pretrainedされたlanguage model(GPT-2=sentence legibility, RoBERTa_MNLI=logical inference, RoBERTa_STS=semantic similarity)を使い、Fully Connected Layerを利用してquality スコアを算出する。算出したスコアは最終的にcalibrationで0~1の値域に収まるように補正される。
意味的に同等の内容を述べた文間でのexample
BLEU, ROUGE, BERTのスコアは低いが、NUBIAでは非常に高いスコアを出せている。
[Paper Note] Unsupervised Opinion Summarization as Copycat-Review Generation, Arthur Bražinskas+, ACL'20, 2019.11
Paper/Blog Link My Issue
#DocumentSummarization #Abstractive #ReviewGeneration #review #ACL Issue Date: 2021-03-17 GPT Summary- 意見要約は、製品レビューから主観的情報を自動的に要約するタスクであり、従来の研究は抽出的手法に焦点を当てていたが、本研究では新しい文を生成する抽象的要約を提案。教師なし設定での生成モデルを定義し、新規性を制御しながら合意された意見を反映する要約を生成する。階層的変分オートエンコーダモデルを用い、レビュー生成器が入力レビューにアクセス可能。実験により、一般的な意見を反映した流暢で一貫性のある要約が生成できることを示した。
[Paper Note] Evaluation of Text Generation: A Survey, Asli Celikyilmaz+, arXiv'20, 2020.06
Paper/Blog Link My Issue
#Survey #NaturalLanguageGeneration #Evaluation Issue Date: 2020-08-25 GPT Summary- NLGシステムの評価方法を人間中心、自動評価、機械学習に基づく評価の3カテゴリに分類し、各カテゴリの進展と課題を議論。自動テキスト要約と長文生成の具体例を示し、今後の研究方向を提案。
[Paper Note] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism, Mohammad Shoeybi+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#Pretraining #Tools #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #PostTraining #Selected Papers/Blogs #Parallelism #One-Line Notes #DistributedLearning #TrainingFramework Issue Date: 2026-09-29 GPT Summary- 大規模Transformerモデルを学習するため、ネイティブPyTorchに少数の通信操作を追加する層内モデル並列化手法を提案。パイプライン型並列化と併用可能で、512 GPU上で最大83億パラメータのモデルを学習し、15.1ペタFLOPSと76%のスケーリング効率を達成。GPT-2型・BERT型モデルで既存のSOTAを上回り、WikiText103、LAMBADA、RACEで高い性能を実現。 Comment
Megatron-LMがメモされていなかったので追加。代表的なLLM・マルチモーダルモデル学習のためのフレームワーク
事前学習、継続事前学習だけでなく
- Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
以下のような事後学習フレームワークのバックエンドとしても利用される:
- Nemo-RL, Nvidia, 2025.05
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- slime, THUDM & Zhihu, 2025.09
- ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
[Paper Note] Large Memory Layers with Product Keys, Guillaume Lample+, NIPS'19, 2019.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #LanguageModel #Transformer #Architecture #NeurIPS #memory Issue Date: 2026-08-09 GPT Summary- ニューラルネットワークに統合可能な構造化メモリを提案し、アーキテクチャの容量を最大10億パラメータまで増加。プロダクトキーに基づく設計で、高速な最近傍探索を実現。パラメータ数の増加により、予測精度と計算効率のトレードオフを最適化。12層のメモリ拡張モデルが24層のベースラインを上回り、推論速度は2倍に。コードは公開。 Comment
パラメータ数と計算量を分離する手法の一つ。
slide: https://neurips.cc/media/neurips-2019/Slides/15837.pdf
[Paper Note] Understanding and Improving Layer Normalization, Jingjing Xu+, arXiv'19, 2019.11
Paper/Blog Link My Issue
#Analysis #Transformer #Architecture #Normalization #read-later Issue Date: 2026-07-26 GPT Summary- Layer normalization (LayerNorm)は中間層の分布を正規化し、訓練を加速し一般化精度を向上させますが、その効果の理由は未解明です。本研究では、LayerNormの理解を深め、逆伝播勾配の再センタリングと再スケーリングがフォワード正規化よりも重要であることを示しました。また、LayerNormのバイアスとゲインが過学習リスクを高めることを明らかにし、バイアスとゲインを排除したLayerNorm-simpleが4つのデータセットで優れた性能を示したことを報告します。さらに、Adaptive Normalization(AdaNorm)を提案し、実験では7つのデータセットでLayerNormを上回る結果を示しています。
[Paper Note] CTRL: A Conditional Transformer Language Model for Controllable Generation, Nitish Shirish Keskar+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #LanguageModel #Transformer #Selected Papers/Blogs #Decoder Issue Date: 2026-01-16 GPT Summary- CTRLは、スタイルや内容、タスク特有の振る舞いを制御するコードに基づいて訓練された条件付きトランスフォーマー言語モデルで、1.63億パラメータを持つ。このモデルは、無監督学習の利点を生かしつつ、テキスト生成に対する明示的な制御を提供。CTRLは与えられたシーケンスに基づいて最も可能性のあるトレーニングデータを予測でき、データ分析の新たなアプローチを提示する。また、複数の事前訓練済みバージョンが公開されている。 Comment
Control Code(いわゆるタグ)によって条件付けることで生成されるテキストのスタイルや内容等をcontrollableにする研究の先駆け
[Paper Note] Universal Transformers, Mostafa Dehghani+, ICLR'19
Paper/Blog Link My Issue
#Transformer #Architecture #ICLR #Selected Papers/Blogs #Generalization #LatentReasoning #RecurrentModels Issue Date: 2025-08-30 GPT Summary- 再帰神経ネットワーク(RNN)は逐次処理によりシーケンスモデリングで広く使われてきたが、トレーニングが遅くなる欠点がある。最近のフィードフォワードや畳み込みアーキテクチャは並列処理が可能で優れた結果を出しているが、RNNが得意とする単純なタスクでの一般化には失敗する。そこで、我々はユニバーサル・トランスフォーマー(UT)を提案し、フィードフォワードの並列処理能力とRNNの帰納バイアスを組み合わせたモデルを開発した。UTは特定の条件下でチューリング完全であり、実験では標準的なトランスフォーマーを上回る性能を示し、特にLAMBADAタスクで新たな最先端を達成し、機械翻訳でもBLEUスコアを改善した。 Comment
openreview: https://openreview.net/forum?id=HyzdRiR9Y7
[Paper Note] Supervised Multimodal Bitransformers for Classifying Images and Text, Douwe Kiela+, arXiv'19
Paper/Blog Link My Issue
#ComputerVision #Transformer #MultiModal #Architecture Issue Date: 2025-08-21 GPT Summary- テキストと画像情報を融合する監視型マルチモーダルビットランスフォーマーモデルを提案し、さまざまなマルチモーダル分類タスクで最先端の性能を達成。特に、難易度の高いテストセットでも強力なベースラインを上回る結果を得た。 Comment
テキスト+imageを用いるシンプルなtransformer
Natural Questions: A Benchmark for Question Answering Research, Kwiatkowski+, TACL'19
Paper/Blog Link My Issue
#Dataset #QuestionAnswering #Evaluation #Factuality #ReadingComprehension Issue Date: 2025-08-16 GPT Summary- Natural Questionsコーパスは、Google検索エンジンからの実際の匿名化されたクエリを基にした質問応答データセットで、307,373のトレーニング例と7,830の開発例、7,842のテスト例が含まれています。アノテーターは、質問に対してWikipediaページから長い回答と短い回答を注釈し、質の検証実験や人間の変動性に関する分析を行っています。また、質問応答システムの評価のためのメトリクスを導入し、競争的手法を用いてベースライン結果を確立しています。
[Paper Note] Deep Equilibrium Models, Shaojie Bai+, NeurIPS'19
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #LanguageModel #NeurIPS Issue Date: 2025-08-05 GPT Summary- 深い平衡モデル(DEQ)を提案し、逐次データのモデル化において平衡点を直接見つけるアプローチを示す。DEQは無限の深さのフィードフォワードネットワークを解析的に逆伝播可能にし、定数メモリでトレーニングと予測を行える。自己注意トランスフォーマーやトレリスネットワークに適用し、WikiText-103ベンチマークでパフォーマンス向上、計算要件の維持、メモリ消費の最大88%削減を実証。
[Paper Note] What Does BERT Learn about the Structure of Language?, Jawahar+, ACL'19
Paper/Blog Link My Issue
#Analysis #Transformer #ACL #One-Line Notes Issue Date: 2024-10-07 Comment
- 大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
中で引用されている。Transformerの各ブロックが、何を学習しているかを分析。
[Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #Attention #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンションを提案し、アテンション・ヘッド間でキーと値を共有することで、逐次推論時のメモリ帯域幅を削減。これにより、デコード速度が向上し、品質低下は最小限に抑えられたことを実験で確認。 Comment
**※ 以前のメモでは "Queryを単一にする" と記述していましたが、完全に誤りでした。**
Multi Query Attention論文。Multi-Head Attentionにおける **KVを全てのhead間で共有する(つまりKV Cacheの量が1/num_headになる)** することで代替する。劇的にDecoderのInferenceが早くなりメモリ使用量が減る。論文中では言及されていない?ようだが、後続の研究で性能と学習の安定性が課題が指摘されているようである。
Text Summarization with Pretrained Encoders, Liu+ (with Lapata), EMNLP-IJCNLP'19
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #Extractive #EMNLP #IJCNLP #KeyPoint Notes Issue Date: 2023-08-28 Comment
BERTSUMEXT論文
通常のBERTの構造と比較して、文ごとの先頭に[CLS]トークンを挿入し、かつSegment Embeddingsを文ごとに交互に変更することで、文のrepresentationを取得できるようにする。
その後、encodingされたsentenceの[CLS]トークンに対応するembeddingの上に、inter-sentence Transformer layerを重ね、sigmoidでスコアリングするのが、BERTSUMEXT, Abstractiveの場合は6-layerのTransformer decoderを利用するが、これはスクラッチでfinetuninigさせる。このとき、encoder側はoverfit, decoder側はunderfitすることが予想されるため、encoderとdecodeで異なるwarmup, 学習率を適用する。具体的には、encoder側はより小さい学習率で、さらにsmoothに減衰するようにする。これにより、decoder側が安定したときにより正確な勾配で学習できるようになる。また、2-stageのfinetuningを提案し、まずencoder側をextractifve summarization taskでfinetuningし、その後abstractive summarizationでfinetuningする。先行研究ではextractive summarizationのobjectiveを取り入れることでabstractive summarizationの性能が向上していることが報告されており、この知見を取り入れる。今回はextractive summarizationの重みをabstractive taskにtrasnferすることになる。
Neural Text Summarization: A Critical Evaluation, Krysciski+ (w_ Richard Socher), EMNLP-IJCNLP'19
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #EMNLP #IJCNLP Issue Date: 2023-08-16
Question answering as an automatic evaluation metric for news article summarization, Eyal+, NAACL'19
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #QA-based #NAACL Issue Date: 2023-08-16 Comment
APES
Studying Summarization Evaluation Metrics in the Appropriate Scoring Range, Peyrard+, ACL'19
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #One-Line Notes Issue Date: 2023-08-16 Comment
要約のメトリックがhuman judgmentsに対してcorrelationが低いことを指摘
HighRES: Highlight-based Reference-less Evaluation of Summarization, Hardy+, N_A, ACL'19
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #ACL Issue Date: 2023-08-13 GPT Summary- 要約の手動評価は一貫性がなく困難なため、新しい手法であるHighRESを提案する。この手法では、要約はソースドキュメントと比較して複数のアノテーターによって評価され、ソースドキュメントでは重要な内容がハイライトされる。HighRESはアノテーター間の一致度を向上させ、システム間の違いを強調することができることを示した。 Comment
人手評価の枠組み
[Paper Note] Machine Translation Evaluation with BERT Regressor, Hiroki Shimanaka+, arXiv'19, 2019.07
Paper/Blog Link My Issue
#DocumentSummarization #MachineTranslation #Evaluation #TrainedMetrics Issue Date: 2023-08-13 GPT Summary- BERTを用いた機械翻訳の自動評価指標を提案し、WMT-2017 Metrics Shared Taskデータセットにおいて、すべての英語翻訳ペアに対して最先端の性能を達成した。
[Paper Note] MoverScore: Text Generation Evaluating with Contextualized Embeddings and Earth Mover Distance, Zhao+, EMNLP-IJCNLP'19
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-based Issue Date: 2023-08-13 Comment
Word Mover Distance (WMD)の解説: https://yubessy.hatenablog.com/entry/2017/01/10/122737
Answers Unite Unsupervised Metrics for Reinforced Summarization Models, Scialom+, EMNLP-IJCNLP'19
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free #QA-based Issue Date: 2023-08-13 Comment
SummaQA
[Paper Note] BERTScore: Evaluating Text Generation with BERT, Tianyi Zhang+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based #Selected Papers/Blogs #Surface-level Notes #needs-revision Issue Date: 2023-05-10 GPT Summary- BERTScoreは、テキスト生成の自動評価指標で、候補文のトークンと参照文のトークン間の類似度を文脈埋め込みを使用して計算。363の機械翻訳と画像キャプション生成システムを評価し、人間の判断と高い相関を示し、モデル選択性能を向上。敵対的パラフレーズ検出タスクでも、既存の指標と比較して堅牢性が確認された。 Comment
# 概要
既存のテキスト生成の評価手法(BLEUやMETEOR)はsurface levelのマッチングしかしておらず、意味をとらえられた評価になっていなかったので、pretrained BERTのembeddingを用いてsimilarityを測るような指標を提案しましたよ、という話。
# prior metrics
## n-gram matching approaches
n-gramがreferenceとcandidateでどれだけ重複しているかでPrecisionとrecallを測定
### BLEU
MTで最も利用される。n-gramのPrecision(典型的にはn=1,2,3,4)と短すぎる候補訳にはペナルティを与える(brevity penalty)ことで実現される指標。SENT-BLEUといった亜種もある。BLEUと比較して、BERTScoreは、n-gramの長さの制約を受けず、潜在的には長さの制限がないdependencyをcontextualized embeddingsでとらえることができる。
### METEOR
METEOR: An Automatic Metric for MT Evaluation with Improved Correlation with Human Judgments, Banerjee+, CMU, ACL Workshop on Intrinsic and Extrinsic Evaluation Measures for Machine Translation and/or Summarization
METEOR 1.5では、内容語と機能語に異なるweightを割り当て、マッチングタイプによってもweightを変更する。METEOR++2.0では、学習済みの外部のparaphrase resourceを活用する。METEORは外部のリソースを必要とするため、たった5つの言語でしかfull feature setではサポートされていない。11の言語では、恥部のfeatureがサポートされている。METEORと同様に、BERTScoreでも、マッチに緩和を入れていることに相当するが、BERTの事前学習済みのembeddingは104の言語で取得可能である。BERTScoreはまた、重要度によるweightingをサポートしている(コーパスの統計量で推定)。
### Other Related Metrics
- NIST: BLEUとは異なるn-gramの重みづけと、brevity penaltyを利用する
- ΔBLEU: multi-reference BLEUを、人手でアノテーションされたnegative reference sentenceで変更する
- CHRF: 文字n-gramを比較する
- CHRF++: CHRFをword-bigram matchingに拡張したもの
- ROUGE: 文書要約で利用される指標。ROUGE-N, ROUGE^Lといった様々な変種がある。
- CIDEr: image captioningのmetricであり、n-gramのtf-idfで重みづけされたベクトルのcosine similrityを測定する
## Edit-distance based Metrics
- Word Error Rate (WER): candidateからreferenceを再現するまでに必要なedit operationの数をカウントする手法
- Translation Edit Rate (TER): referenceの単語数によってcandidateからreferenceまでのedit distanceを正規化する手法
- ITER: 語幹のマッチと、より良い正規化に基づく手法
- PER: positionとは独立したError Rateを算出
- CDER: edit operationにおけるblock reorderingをモデル化
- CHARACTER / EED: character levelで評価
## Embedding-based Metrics
- MEANT 2.0: lexical, structuralの類似度を測るために、word embeddingとshallow semantic parsesを利用
- YISI-1: MEANT 2.0と同様だが、semantic parseの利用がoptionalとなっている
これらはBERTScoreと同様の、similarityをシンプルに測るアプローチで、BERTScoreもこれにinspireされている。が、BERTScoreはContextualized Embeddingを利用する点が異なる。また、linguistic structureを生成するような外部ツールは利用しない。これにより、BERTScoreをシンプルで、新たなlanguageに対しても使いやすくしている。greedy matchingの代わりに、WMD, WMDo, SMSはearth mover's distanceに基づく最適なマッチングを利用することを提案している。greedy matchingとoptimal matchingのtradeoffについては研究されている。sentence-levelのsimilarityを計算する手法も提案されている。これらと比較して、BERTScoreのtoken-levelの計算は、重要度に応じて、tokenに対して異なる重みづけをすることができる。
## Learned Metrics
様々なmetricが、human judgmentsとのcorrelationに最適化するために訓練されてきた。
- BEER: character-ngram, word bigramに基づいたregresison modelを利用
- BLEND: 29の既存のmetricを利用してregressionを実施
- RUSE: 3種類のpre-trained sentence embedding modelを利用する手法
これらすべての手法は、コストのかかるhuman judgmentsによるsupervisionが必要となる。そして、新たなドメインにおける汎化能力の低さのリスクがある。input textが人間が生成したものか否か予測するneural modelを訓練する手法もある。このアプローチは特定のデータに対して最適化されているため、新たなデータに対して汎化されないリスクを持っている。これらと比較して、BERTScoreは特定のevaluation taskに最適化されているモデルではない。
# BERTScore
referenceとcandidateのトークン間のsimilarityの最大値をとり、それらを集約することで、Precision, Recallを定義し、PrecisionとRecallを利用してF値も計算する。Recallは、reference中のすべてのトークンに対して、candidate中のトークンとのcosine similarityの最大値を測る。一方、Precisionは、candidate中のすべてのトークンに対して、reference中のトークンとのcosine similarityの最大値を測る。ここで、類似度の式が単なる内積になっているが、これはpre-normalized vectorを利用する前提であり、正規化が必要ないからである。
また、IDFによるトークン単位でのweightingを実施する。IDFはテストセットの値を利用する。TFを使わない理由は、BERTScoreはsentence同士を比較する指標であるため、TFは基本的に1となりやすい傾向にあるためである。IDFを計算する際は出現数を+1することによるスムージングを実施。
さらに、これはBERTScoreのランキング能力には影響を与えないが、BERTScoreの値はコサイン類似度に基づいているため、[-1, 1]となるが、実際は学習したcontextual embeddingのgeometryに値域が依存するため、もっと小さなレンジでの値をとることになってしまう。そうすると、人間による解釈が難しくなる(たとえば、極端な話、スコアの0.1程度の変化がめちゃめちゃ大きな変化になってしまうなど)ため、rescalingを実施。rescalingする際は、monolingualコーパスから、ランダムにsentenceのペアを作成し(BETRScoreが非常に小さくなるケース)、これらのBERTScoreを平均することでbを算出し、bを利用してrescalingした。典型的には、rescaling後は典型的には[0, 1]の範囲でBERTScoreは値をとる(ただし数式を見てわかる通り[0, 1]となることが保証されているわけではない点に注意)。これはhuman judgmentsとのcorrelationとランキング性能に影響を与えない(スケールを変えているだけなので)。
# 実験
## Contextual Embedding Models
12種類のモデルで検証。BERT, RoBERTa, XLNet, XLMなど。
## Machine Translation
WMT18のmetric evaluation datasetを利用。149種類のMTシステムの14 languageに対する翻訳結果, gold referencesと2種類のhuman judgment scoreが付与されている。segment-level human judgmentsは、それぞれのreference-candiate pairに対して付与されており、system-level human judgmentsは、それぞれのシステムに対して、test set全体のデータに基づいて、単一のスコアが付与されている。pearson correlationの絶対値と、kendall rank correration τをmetricsの品質の評価に利用。そしてpeason correlationについてはWilliams test、kendall τについては、bootstrap re-samplingによって有意差を検定した。システムレベルのスコアをBERTScoreをすべてのreference-candidate pairに対するスコアをaveragingすることによって求めた。また、ハイブリッドシステムについても実験をした。具体的には、それぞれのreference sentenceについて、システムの中からランダムにcandidate sentenceをサンプリングした。これにより、system-level experimentをより多くのシステムで実現することができる。ハイブリッドシステムのシステムレ4ベルのhuman judgmentsは、WMT18のsegment-level human judgmentsを平均することによって作成した。BERTScoreを既存のメトリックと比較した。
通常の評価に加えて、モデル選択についても実験した。10kのハイブリッドシステムを利用し、10kのうち100をランダムに選択、そして自動性能指標でそれらをランキングした。このプロセスを100K回繰り返し、human rankingとmetricのランキングがどれだけagreementがあるかをHits@1で評価した(best systemの一致で評価)。モデル選択の指標として新たにtop metric-rated systemとhuman rankingの間でのMRR, 人手評価でtop-rated systemとなったシステムとのスコアの差を算出した。WMT17, 16のデータセットでも同様の評価を実施した。
## Image Captioning
COCO 2015 captioning challengeにおける12種類のシステムのsubmissionデータを利用。COCO validationセットに対して、それぞれのシステムはimageに対するcaptionを生成し、それぞれのimageはおよそ5個のreferenceを持っている。先行研究にならい、Person Correlationを2種類のシステムレベルmetricで測定した。
- M1: 人間によるcaptionと同等、あるいはそれ以上と評価されたcaptionの割合
- M2: 人間によるcaptionと区別がつかないcaptionの割合
BERTScoreをmultiple referenceに対して計算し、最も高いスコアを採用した。比較対象のmetricはtask-agnostic metricを採用し、BLEU, METEOR, CIDEr, BEER, EED, CHRF++, CHARACTERと比較した。そして、2種類のtask-specific metricsとも比較した:SPICE, LEIC
# 実験結果
## Machine Translation
system-levelのhuman judgmentsとのcorrelationの比較、hybrid systemとのcorrelationの比較、model selection performance
to-Englishの結果では、BERTScoreが最も一貫して性能が良かった。RUSEがcompetitiveな性能を示したが、RUSEはsupervised methodである。from-Englishの実験では、RUSEは追加のデータと訓練をしないと適用できない。
以下は、segment-levelのcorrelationを示したものである。BERTScoreが一貫して高い性能を示している。BLEUから大幅な性能アップを示しており、特定のexampleについての良さを検証するためには、BERTScoreが最適であることが分かる。BERTScoreは、RUSEをsignificantlyに上回っている。idfによる重要度のweightingによって、全体としては、small benefitがある場合があるが全体としてはあんまり効果がなかった。importance weightingは今後の課題であり、テキストやドメインに依存すると考えられる。FBERTが異なる設定でも良く機能することが分かる。異なるcontextual embedding model間での比較などは、appendixに示す。
## Image Captioning
task-agnostic metricの間では、BETRScoreはlarge marginで勝っている。image captioningはchallengingな評価なので、n-gramマッチに基づくBLEU, ROUGEはまったく機能していない。また、idf weightingがこのタスクでは非常に高い性能を示した。これは人間がcontent wordsに対して、より高い重要度を置いていることがわかる。最後に、LEICはtrained metricであり、COCO dataに最適化されている。この手法は、ほかのすべてのmetricを上回った。
## Speed
pre-trained modelを利用しているにもかかわらず、BERTScoreは比較的高速に動作する。192.5 candidate-reference pairs/secondくらい出る(GTX-1080Ti GPUで)。WMT18データでは、15.6秒で処理が終わり、SacreBLEUでは5.4秒である。計算コストそんなにないので、BERTScoreはstoppingのvalidationとかにも使える。
# Robustness analysis
BERTScoreのロバスト性をadversarial paraphrase classificationでテスト。Quora Question Pair corpus (QQP) を利用し、Word Scrambling dataset (PAWS) からParaphrase Adversariesを取得。どちらのデータも、各sentenceペアに対して、それらがparaphraseかどうかラベル付けされている。QQPの正例は、実際のduplicate questionからきており、負例は関連するが、異なる質問からきている。PAWSのsentence pairsは単語の入れ替えに基づいているものである。たとえば、"Flights from New York to Florida" は "Flights from Florida to New York" のように変換され、良いclassifierはこれらがparaphraseではないと認識できなければならない。PAWSはPAWS_QQPとPAWS_WIKIによって構成さえrており、PAWS_QQPをdevelpoment setとした。automatic metricsでは、paraphrase detection training dataは利用しないようにした。自動性能指標で高いスコアを獲得するものは、paraphraseであることを想定している。
下図はAUCのROC curveを表しており、PAWS_QQPにおいて、QQPで訓練されたclassifierはrandom guessよりも性能が低くなることが分かった。つまりこれらモデルはadversaial exampleをparaphraseだと予測してしまっていることになる。adversarial examplesがtrainingデータで与えられた場合は、supervisedなモデルも分類ができるようになる。が、QQPと比べると性能は落ちる。多くのmetricsでは、QQP ではまともなパフォーマンスを示すが、PAWS_QQP では大幅なパフォーマンスの低下を示し、ほぼrandomと同等のパフォーマンスとなる。これは、これらの指標がより困難なadversarial exampleを区別できないことを示唆している。一方、BERTSCORE のパフォーマンスはわずかに低下するだけであり、他の指標よりもロバスト性が高いことがわかる。
# Discussion
- BERTScoreの単一の設定が、ほかのすべての指標を明確に上回るということはない
- ドメインや言語を考慮して、指標や設定を選択すべき
- 一般的に、機械翻訳の評価にはFBERTを利用することを推奨
- 英語のテキスト生成の評価には、24層のRoBERTa largeモデルを使用して、BERTScoreを計算したほうが良い
- 非英語言語については、多言語のBERT_multiが良い選択肢だが、このモデルで計算されたBERTScoreは、low resource languageにおいて、パフォーマンスが安定しているとは言えない
Towards Personalized Review Summarization via User-Aware Sequence Network, Li+, AAAI'19
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #Personalization #AAAI #Surface-level Notes Issue Date: 2023-05-08 Comment
同じレビューに対しても、異なるユーザは異なるSumamryを生成するよね、というところがモチベーションとなり、Personalized Review Summarizationを提案。初めてPersonalizationの問題について提案した研究。
user embeddingによってユーザ情報を埋め込む方法と、user vocabulary memoryによって、ユーザが好むvocabularyを積極的にsummaryに利用できるようなモジュールの2種類をモデルに導入している
Trip advisorのレビューデータを収集。レビューのtitleをreference summaryとみなしてデータセット生成。ただタイトルを利用するだけだと、無意味なタイトルが多く含まれているでフィルタリングしている。
Trip Advisorはクローリングを禁止していた気がするので、割とアウトなのでは。
あと、各レビューをランダムにsplitしてtrain/dev/testを作成したと言っているが、本当にそれでいいの?user-stratifiedなsplitをした方が良いと思う。
PGN [Paper Note] Get To The Point: Summarization with Pointer-Generator Networks, Abigail See+, arXiv'17, 2017.04
やlead-1と比較した結果、ROUGEの観点で高い性能を達成
また人手評価として、ユーザのgold summaryに含まれるaspectと、generated summaryに含まれるaspectがどれだけ一致しているか、1000件のreviewとtest setからサンプリングして2人の学生にアノテーションしてもらった。結果的に提案手法が最もよかったが、アノテーションプロセスの具体性が薄すぎる。2人の学生のアノテーションのカッパ係数すら書かれていない。
case studyとしてあるユーザのレビュと生成例をのせている。userBの過去のレビューを見たら、room, locationに言及しているものが大半であり、このアスペクトをきちんと含められているよね、ということを主張している。
[Paper Note] Neural Review Summarization Leveraging User and Product Information, Liu+, CIKM'19
Paper/Blog Link My Issue
#DocumentSummarization #review #CIKM Issue Date: 2023-05-06
[Paper Note] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, Nils Reimers+, arXiv'19, 2019.08
Paper/Blog Link My Issue
#NeuralNetwork #Library #RepresentationLearning #EMNLP #Selected Papers/Blogs #Encoder #One-Line Notes Issue Date: 2022-07-29 GPT Summary- BERTとRoBERTaは文ペア回帰タスクで優れた性能を示す一方で、計算負荷が高いため意味的類似度検索には適していない。本研究では、コサイン類似度を用いた文の埋め込みを得るために、シアミーズネットワークとトリプレットネットワークを用いたSentence-BERT(SBERT)を提案。これにより、類似ペアの検索時間が65時間から約5秒に短縮され、精度はBERTに匹敵。SBERTは一般的なSTSタスクや転移学習タスクで最先端の性能を示した。 Comment
BERTでトークンをembeddingし、mean poolingすることで生成される文ベクトルを、Siamese Networkを使い距離学習(finetune)させたモデル。
文/文章のベクトルを事前学習済みのモデルを使って簡単に求められる。
モデルの一覧は下記:
https://www.sbert.net/docs/pretrained_models.html
[Paper Note] Table-to-Text Generation with Effective Hierarchical Encoder on Three Dimensions (Row, Column and Time), Gong+, Harbin Institute of Technology, EMNLP'19
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #EMNLP #Surface-level Notes Issue Date: 2021-10-08 Comment
## 概要
既存研究では、tableをレコードの集合, あるいはlong sequenceとしてencodeしてきたが
1. other (column) dimensionの情報が失われてしまう (?)
2. table cellは時間によって変化するtime-series data
という特徴がある。
たとえば、ある選手の成績について言及する際に、その試合について着目するだけでなくて「直近3試合で二回目のダブルダブルです」というように直近の試合も考慮して言及することがあり、table cellの time dimensionについても着目しなければならず、これらはこれまでのモデルで実現できない。
そこで、この研究ではtime dimensionについても考慮し生成する手法を提案。
## モデル概要
全体としては、Row Dimension Encoder, Column Dimension Encoder, Time Dimension Encoderによって構成されており、self-attentionを利用して、テーブルの各セルごとに Row-Dimension, Column-Dimension, Time-DimensionのRepresentationを獲得する。イメージとしては、
- Row Dimension Encoderによって、自身のセルと同じ行に含まれるセルとの関連度を考慮した表現
- Column Dimension Encoderによって、自身のセルと同じ列に含まれるセルとの関連度を考慮した表現
- Time Dimension Encoderによって、過去の時系列のセルとの関連度を考慮した表現
をそれぞれ獲得するイメージ。各Dimension Encoderでやっていることは、Puduppully (Data-to-Text Generation with Content Selection and Planning, Puduppully+, AAAI'19
) らのContent Selection Gate節におけるattention vector r_{att}の取得方法と同様のもの(だと思われる)。
獲得したそれぞれのdimensionの表現を用いて、まずそれらをconcatし1 layer MLPで写像することで得られるgeneral representationを取得する。その後、general representationと各dimensionの表現を同様に1 layer MLPでスコアリングすることで、各dimensionの表現の重みを求め、その重みで各representationを線形結合することで、セルの表現を獲得する。generalなrepresentationと各dimensionの表現の関連性によって重みを求めることで、より着目すべきdimensionを考慮した上で、セルの表現を獲得できるイメージなのだろうか。
その後、各セルの表現を行方向に対してMeanPoolingを施しrow-levelの表現を取得。獲得したrow-levelの表現に対し、Puduppully (Data-to-Text Generation with Content Selection and Planning, Puduppully+, AAAI'19
) らのContent Selection Gate g を適用する(これをどうやっているかがわからない)。
最終的に求めたrow-levelの表現とcell-levelの表現に対して、デコーダのhidden stateを利用してDual Attentionを行い、row-levelの表現からどの行に着目すべきか決めた後、その行の中からどのセルに着目するか決める、といったイメージで各セルの重みを求める。
論文中にはここまでしか書かれていないが、求めた各セルの重みでセルのrepresentationを重み付けして足し合わせ、最終的にそこから単語をpredictionするのだろうか・・・?よくわからない。
RG, CS, CO, BLEUスコア、全てにおいてBaselineを上回っている(RGのTemplateを除く)。
実装: https://github.com/ernestgong/data2text-three-dimensions/
Data-to-Text Generation with Content Selection and Planning, Puduppully+, AAAI'19
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #AAAI #One-Line Notes Issue Date: 2021-06-26 Comment
Rotowire Datasetに対するData2Text研究において代表的な論文の一つ。Wisemanモデル [Paper Note] Challenges in Data-to-Document Generation, Sam Wiseman+, EMNLP'17, 2017.07 と共にベースラインとして利用されることが多い。
On Empirical Comparisons of Optimizers for Deep Learning, Dami Choi+, N_A, arXiv'19
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #One-Line Notes Issue Date: 2021-06-15 GPT Summary- 深層学習のオプティマイザの比較は重要であり、ハイパーパラメータの探索空間が性能に影響することが示唆されている。特に、適応的勾配法は常に他のオプティマイザよりも性能が低下しないことが実験で示されており、ハイパーパラメータのチューニングに関する実用的なヒントも提供されている。 Comment
Adamが良いのだけど、学習率以外のハイパーパラメータをチューニングしないと本来のパフォーマンス発揮されないかもよ、という感じっぽい
ICLR 2020 Open Review: https://openreview.net/forum?id=HygrAR4tPS
EMNLP 2019 spec tutorial, Glavas+, EMNLP'19 Tutorial, 2019.11
Paper/Blog Link My Issue
#Tutorial #Slide #EMNLP Issue Date: 2019-11-09
[Paper Note] Automatic Generation of Personalized Comment Based on User Profile, Wenhuan Zeng+, ACL'19 SRW
Paper/Blog Link My Issue
#CommentGeneration #Personalization #ACL #Workshop Issue Date: 2019-09-11 GPT Summary- ソーシャルメディアの多様なコメント生成の難しさを考慮し、ユーザーのプロフィールに基づくパーソナライズされたコメント生成タスク(AGPC)を提案。パーソナライズドコメント生成ネットワーク(PCGN)を用いて、ユーザーの特徴をモデル化し、外部ユーザー表現を考慮することで自然で人間らしいコメントを生成することに成功した。
[Paper Note] Coherent Comment Generation for Chinese Articles with a Graph-to-Sequence Model, Wei Li+, arXiv'19
Paper/Blog Link My Issue
#NeuralNetwork #CommentGeneration #ACL Issue Date: 2019-08-24 GPT Summary- 自動記事コメント生成のために、ニュースをトピック相互作用グラフとしてモデル化し、グラフからシーケンスへのモデルを提案。これにより、記事の構造やトピックの関連性を理解し、より一貫性のある情報量の多いコメントを生成。Tencent Kuaibaoから収集した大規模なニュース-コメントコーパスを用いた実験で、提案モデルが強力なベースラインを上回る性能を示した。
[Paper Note] User Preference-Aware Review Generation, Wang+, PAKDD'19
Paper/Blog Link My Issue
#NaturalLanguageGeneration #ReviewGeneration Issue Date: 2019-08-17
[Paper Note] Review Response Generation in E-Commerce Platforms with External Product Information, Zhao+, WWW'19
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #NaturalLanguageGeneration #ReviewGeneration #WWW Issue Date: 2019-08-17
[Paper Note] Automatic Generation of Personalized Comment Based on User Profile, Wenhuan Zeng+, ACL'19 SRW
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #NaturalLanguageGeneration #ReviewGeneration #ACL #Workshop Issue Date: 2019-08-17 GPT Summary- ソーシャルメディアの多様なコメント生成の難しさを考慮し、ユーザープロフィールに基づくパーソナライズされたコメント生成タスク(AGPC)を提案。パーソナライズドコメント生成ネットワーク(PCGN)を用いて、ユーザーの特徴をモデル化し、外部ユーザー表現を考慮することで自然なコメントを生成。実験結果は、モデルの効果を示す。
[Paper Note] Multimodal Review Generation for Recommender Systems, Truong+, WWW'19
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #NaturalLanguageGeneration #ReviewGeneration #WWW #One-Line Notes Issue Date: 2019-05-31 Comment
Personalized Review Generationと、Rating Predictionを同時学習した研究(同時学習自体はすでに先行研究がある)。
また、先行研究のinputは、たいていはuser, itemであるが、multi-modalなinputとしてレビューのphotoを活用したという話。
まだあまりしっかり読んでいないが、モデルのstructureはシンプルで、rating predictionを行うDNN、テキスト生成を行うLSTM(fusion gateと呼ばれる新たなゲートを追加)、画像の畳み込むCNNのハイブリッドのように見える。
[Paper Note] Shampoo: Preconditioned Stochastic Tensor Optimization, Vineet Gupta+, ICML'18, 2018.02
Paper/Blog Link My Issue
#Pretraining #LanguageModel #Optimizer #ICML #read-later #Selected Papers/Blogs Issue Date: 2026-08-06 GPT Summary- Shampooは、テンソル空間における確率的最適化のための新しい前処理アルゴリズムで、次元を縮約する行列の集合を保持し、収束保証を提供。実験により、Shampooが一般の最適化手法より速く収束し、実行時間は他の単純な手法と同等であることを示した。 Comment
次:
- [Paper Note] SOAP: Improving and Stabilizing Shampoo using Adam, Nikhil Vyas+, ICLR'25
[Paper Note] Intrinsic Motivation and Automatic Curricula via Asymmetric Self-Play, Sainbayar Sukhbaatar+, ICLR'18, 2017.03
Paper/Blog Link My Issue
#NeuralNetwork #ReinforcementLearning #ICLR #read-later #Selected Papers/Blogs #SelfPlay Issue Date: 2026-04-29 GPT Summary- エージェントが教師なしで学習するための単純なスキームを提案。アリスとボブの二つのエージェントが対戦し、アリスが課題を提示、ボブがそれを完了しようと試みる。可逆な環境とリセット可能な環境に焦点を当て、アリスが行動を提案し、ボブがそれを元に戻すか繰り返す。適切な報酬設計により、自動的に探索のカリキュラムを生成し、教師なし学習を実現。ボブをRLタスクに適用することで、教師付きエピソードの数を減少させ、高い報酬へ収束する可能性がある。 Comment
openreview: https://openreview.net/forum?id=SkT5Yg-RZ
[Paper Note] SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing, Taku Kudo+, arXiv'18, 2018.08
Paper/Blog Link My Issue
#NeuralNetwork #MultiLingual #Tokenizer #Selected Papers/Blogs Issue Date: 2025-11-19 GPT Summary- 本論文では、Neural Machine Translation向けの言語に依存しないサブワードトークナイザー「SentencePiece」を紹介。生の文から直接サブワードモデルを訓練でき、エンドツーエンドのシステム構築が可能。英日機械翻訳の実験で高精度を確認し、さまざまな構成での性能比較も行った。SentencePieceはオープンソースで提供されている。 Comment
真の多言語処理を実現できる価値
著者による解説:
https://qiita.com/taku910/items/7e52f1e58d0ea6e7859c
[Paper Note] TextWorld: A Learning Environment for Text-based Games, Marc-Alexandre Côté+, Workshop on Computer Games'18 Held in Conjunction with IJCAI'18, 2018.06
Paper/Blog Link My Issue
#MachineLearning #Dataset #ReinforcementLearning #Evaluation #IJCAI #Workshop #Game #text Issue Date: 2025-10-26 GPT Summary- TextWorldは、テキストベースのゲームにおける強化学習エージェントのトレーニングと評価のためのサンドボックス環境であり、ゲームのインタラクティブなプレイを処理するPythonライブラリを提供します。ユーザーは新しいゲームを手作りまたは自動生成でき、生成メカニズムによりゲームの難易度や言語を制御可能です。TextWorldは一般化や転移学習の研究にも利用され、ベンチマークゲームのセットを開発し、いくつかのベースラインエージェントを評価します。 Comment
[Paper Note] Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge, Peter Clark+, arXiv'18
Paper/Blog Link My Issue
#Dataset #QuestionAnswering Issue Date: 2025-08-30 GPT Summary- AI2 Reasoning Challenge(ARC)を提案し、高度な質問応答におけるAI研究を促進することを目的とする。ARCはChallenge SetとEasy Setに分かれ、Challenge Setにはリトリーバルベースのアルゴリズムで不正解とされた質問が含まれる。ARCは最大の公的ドメインセットであり、1400万の科学文を含むコーパスと3つのニューラルベースラインモデルの実装も公開。既存のモデルはランダムベースラインを上回れず、コミュニティへの挑戦としてARCを提起。 Comment
dataset:
https://huggingface.co/datasets/allenai/ai2_arc
日本語解説:
https://qiita.com/tekunikaruza_jp/items/d2ec3621afc9ba3d225b
[Paper Note] Self-Attention with Relative Position Representations, Peter Shaw+, NAACL'18
Paper/Blog Link My Issue
#Transformer #Attention #PositionalEncoding Issue Date: 2025-08-09 GPT Summary- 本研究では、Transformerの自己注意機構を拡張し、シーケンス要素間の相対的な位置を効率的に考慮する新しいアプローチを提案。WMT 2014の翻訳タスクで1.3 BLEUおよび0.3 BLEUの改善を達成。相対位置と絶対位置の組み合わせではさらなる改善は見られなかった。提案手法は、任意のグラフラベル付き入力に一般化可能な関係認識自己注意機構として位置付けられる。 Comment
相対位置エンコーディングを提案した研究
絶対位置エンコーディングは
- [Paper Note] Attention Is All You Need, Ashish Vaswani+, NeurIPS'17, 2017.07
Learning to Generate Move-by-Move Commentary for Chess Games from Large-Scale Social Forum Data, Jhamtani+, ACL'18
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #Dataset #DataToTextGeneration #TabularData #ACL #Encoder-Decoder Issue Date: 2025-08-06 Comment
データセットの日本語解説(過去の自分の資料): https://speakerdeck.com/akihikowatanabe/data-to-text-datasetmatome-summary-of-data-to-text-datasets?slide=66
[Paper Note] Efficient Attention: Attention with Linear Complexities, Zhuoran Shen+, arXiv'18
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention Issue Date: 2025-08-05 GPT Summary- 新しい効率的なアテンションメカニズムを提案し、ドット積アテンションと同等の性能を維持しつつ、メモリと計算コストを大幅に削減。これにより、アテンションモジュールの柔軟な統合が可能となり、精度向上を実現。実験結果では、MS-COCO 2017での物体検出やインスタンスセグメンテーションでの性能向上が確認され、Scene Flowデータセットでは最先端の精度を達成。コードは公開されている。 Comment
Figure1を見るとコンセプトが一目でわかり、非常にわかりやすい
A Semantic QA-Based Approach for Text Summarization Evaluation, Ping Chen+, N_A, AAAI'18
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #QA-based #AAAI #needs-revision Issue Date: 2023-08-16 GPT Summary- 自然言語処理システムの評価における問題の一つは、2つのテキストパッセージの内容の違いを特定することです。本研究では、1つのテキストパッセージを小さな知識ベースとして扱い、多数の質問を投げかけて内容を比較する方法を提案します。実験結果は有望であり、2007年のDUC要約コーパスを使用して行われました。 Comment
QGQAを提案した研究
Object hallucination in image captioning, Rohbach+, EMNLP'18
Paper/Blog Link My Issue
#Hallucination #ImageCaptioning Issue Date: 2023-08-16
A Hierarchical End-to-End Model for Jointly Improving Text Summarization and Sentiment Classification, Shuming Ma+, N_A, arXiv'18
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #review Issue Date: 2023-05-06 GPT Summary- テキスト要約と感情分類を共同学習するための階層的なエンドツーエンドモデルを提案し、感情分類ラベルをテキスト要約の出力の「要約」として扱う。提案モデルはAmazonオンラインレビューデータセットでの実験で、抽象的な要約と感情分類の両方で強力なベースラインシステムよりも優れた性能を発揮することが示された。 Comment
review summarizationに初めてamazon online review data SNAP: Web data: Amazon reviews 使った研究?
[Paper Note] Deep contextualized word representations, Matthew E. Peters+, NAACL'18, 2018.02
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #RepresentationLearning #NAACL #KeyPoint Notes Issue Date: 2022-06-08 GPT Summary- 新しい深層文脈化単語表現を提案し、単語の複雑な特性と文脈による変化をモデル化。これらの表現は事前学習された双方向言語モデルの内部状態を基に学習され、質問応答や感情分析など6つのNLPタスクで性能を向上させる。さらに、事前学習ネットワークの内部を活用することで、半教師あり信号の混合が可能であることを示す。 Comment
ELMo論文。
通常のword embeddingでは一つの単語につき一つの意味しか持たせられなかったが、文脈に応じて異なる意味を表現できるようなEmbeddingを実現し(同じ単語でも文脈に応じて意味が変わったりするので。たとえばrightは文脈に応じて右なのか、正しいなのか、権利なのか意味が変わる)様々な言語処理タスク(e.g. Question Answering, Sentiment Analysisなど)でSoTAを達成。
Embedding Layer + 2層のLSTM(1,2の間にはresidual connection)+ linear layerで言語モデルを構成し、順方向言語モデルと逆方向言語モデルを同時に独立して学習する(双方向LSTMではない;損失関数が両方向の言語モデルの対数尤度の和になっている)。
また、Linear LayerとEmbedding Layerのパラメータは両方向の言語モデルで共有されている。
k番目の単語のEmbedding Layerの出力ベクトル、各LSTMのhidden stateをタスクspecificなスカラーパラメタs_taskで足し合わせ、最後にベクトルのスケールを調整するパラメタγ_taskで大きさを調整する。これにより、k番目の単語のELMo Embeddingを得る。
単語単体の意味だけでこと足りるタスクの場合はEmbedding Layerの出力ベクトルに対する重みが大きくなり、文脈を考慮した情報が欲しい場合はLSTMのhidden stateに対する重みが大きくなるイメージ(LSTMの層が深いほど意味的semanticな情報を含み、浅いほど文法的syntacticな情報を含んでいる)。
使い方としては簡単で、ELMoを事前学習しておき、自身のNNモデルのWord Embeddingに(場合によってはRNNのhidden stateにも)、入力文から得られたELMo Embeddingをconcatして順伝搬させるだけで良い。
ELMoのEmbedding Layerでは、2048 characterの(vocab size?)n-gram convolution filter(文字ごとにembeddingし、単語のembeddingを得るためにfilterを適用する?)の後に2つのhighway networkをかませてlinearで512次元に落とすみたいなことごやられているらしい。ここまで追えていない。
詳細は下記
https://datascience.stackexchange.com/questions/97867/how-does-the-character-convolution-work-in-elmo
s_taskとγ_taskはtrainableなパラメータで、
ELMoを適用した先のNNモデルの訓練時に、NNモデルのパラメタと一緒にチューニングする(と思われる)。
下記issueを参照のこと
allenai/allennlp# 1166
allenai/allennlp# 2552
Point precisely: Towards ensuring the precision of data in generated texts using delayed copy mechanism., Li+, Peking University, COLING'18
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #COLING #Surface-level Notes Issue Date: 2021-10-25 Comment
# 概要
DataToTextタスクにおいて、生成テキストのデータの精度を高める手法を提案。two stageアルゴリズムを提案。①encoder-decoerモデルでslotを含むテンプレートテキストを生成。②Copy Mechanismでslotのデータを埋める、といった手法。
①と②はそれぞれ独立に学習される。
two stageにするモチベーションは、
・これまでのモデルでは、単語の生成確率とコピー確率を混合した分布を考えていたが、どのように両者の確率をmergeするのが良いかはクリアではない。
→ 生成とコピーを分離して不確実性を減らした
・コピーを独立して考えることで、より効果的なpair-wise ranking loss functionを利用することができる
・テンプレート生成モデルは、テンプレートの生成に集中でき、slot fillingモデルはスロットを埋めるタスクに集中できる。これらはtrainingとtuningをより簡便にする。
# モデル概要
モデルの全体像
オリジナルテキストとテンプレートの例。テンプレートテキストの生成を学習するencoder-decoder(①)はTarget Templateを生成できるように学習する。テンプレートではエンティティが"
# 実験結果
Relation Generation (RG)がCCと比べて10%程度増加しているので、data fidelityが改善されている。
また、BLEUスコアも約2ポイント改善。これはentityやnumberが適切に埋められるようになっただけでなく、テンプレートがより適切に生成されているためであると考えられる。
## 参考:
• Relation Generation (RG):出力文から(entity, value)の関係を抽出し,抽出された関係の数と,それらの関係が入力データに対して正しいかどうかを評価する (Precision).ただし entity はチーム名や選手名などの動作の主体,value は得点数やアシスト数などの記録である.
• Content Selection (CS):出力文とリファレンスから (entity, value) の関係を抽出し,出力文から抽出された関係のリファレンスから抽出された関係に対する Precision,Recall で評価する.
• Content Ordering (CO):出力文とリファレンスから (entity, value) の関係を抽出し,それらの間の正規化 DamerauLevenshtein 距離 [7] で評価する.
(from [Paper Note] 過去情報の内容選択を取り入れた スポーツダイジェストの自動生成, 加藤+, NLP'21
)
[Paper Note] Operation-guided Neural Networks for High Fidelity Data-To-Text Generation, Nie+, Sun Yat-Sen University, EMNLP'18
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #EMNLP #Surface-level Notes Issue Date: 2021-09-16 Comment
# 概要
既存のニューラルモデルでは、生データ、あるいはそこから推論された事実に基づいて言語を生成するといったことができていない(e.g. 金融, 医療, スポーツ等のドメインでは重要)。
たとえば下表に示した通り、"edge"という単語は、スコアが接戦(95-94=1 -> スコアの差が小さい)であったことを表現しているが、こういったことを既存のモデルでは考慮して生成ができない。
これを解決するために、演算(operation)とニューラル言語モデルを切り離す(事前に計算しておく)といったことが考えられるが、
① 全てのフィールドに対してoperationを実行すると、探索空間が膨大になり、どの結果に対して言及する価値があるかを同定するのが困難(言及する価値がある結果がほとんど存在しない探索空間ができてしまう)
② 演算結果の数値のスパンと、言語選択の対応関係を確立させるのが困難(e.g. スコアの差が1のとき"edge"と表現する、など)
といった課題がある。
①に対処するために、事前にraw dataに対して演算を適用しその結果を利用するモデルを採用。どの演算結果を利用するかを決定するために、gating-mechanismを活用する。
②に対処するために、quantization layerを採用し、演算結果の数値をbinに振り分け、その結果に応じて生成する表現をguideするようなモデルを採用する。
# モデル概要
モデルはrecord encoder(h_{i}^{ctx}を作る)、operation encoder(h_{i}^{op}を作る)、operation result encoder(h_{i}^{res}を作る)によって構成される。
## record encoder
record encoderは、wisemanらと同様に、index (e.g. row 2), column (e.g. column Points), value (e.g. 95)のword embeddingを求め、それらをconcatしたものをbi-directional RNNに入力し求める。
## operation encoder
operation encoderでは、operation op_{i}は、1) operationの名称 (e.g. minus) 2) operationを適用するcolumn (e.g. Points), 3) operationを適用するrow (e.g. {1, 2}などのrow indexの集合)によって構成されており、これらのembeddingをlookupしconcatした後、non-linear layerで変換することによってoperationのrepresentationを取得する。3)operationを適用するrowについては、複数のindexによって構成されるため、各indexのembeddingをnon-linear layerで変換したベクトルを足し合わせた結果に対してtanhを適用したベクトルをembeddingとして利用する。
## operation result encoder
operation result encoderは、scalar results(minus operationにより-1)およびindexing results (argmax operationによりindex 2)の二種類を生成する。これら二種類に対して異なるencoding方法を採用する。
### scalar results
scalar resultsに対しては、下記式でscalar valueをquantization vector(q_{i})に変換する。qutization vectorのlengthはLとなっており、Lはbinの数に相当している。つまり、quantization vectorの各次元がbinの重みに対応している。その後、quantization vectorに対してsoftmaxを適用し、quantization unit(quantization vectorの各次元)の重みを求める。最後に、quantization embeddingと対応するquantization unitの重み付き平均をとることによってh_{i}^{res}を算出する。
Q. 式を見るとW_{q}がscalar resultの値によって定数倍されるだけだから、softmaxによって求まるquantization unitの重みの序列はscalar resultによって変化しなそうに見えるが、これでうまくいくんだろうか・・・?序列は変わらなくても各quantization unit間の相対的な重みの差が変化するから、それでうまくscalar値の変化を捉えられるの・・・か・・・?
### indexing results
indexing resultsについては、h_{i}^{res}をシンプルにindexのembeddingとする。
## Decoder
context vectorの生成方法が違う。従来のモデルと比較して、context vectorを生成する際に、レコードをoperationの両方をinputとする。
operationのcontext vector c_{t}^{op}とrecordsのcontext vector c_{t}^{ctx}をdynamic gate λ_{t}によって重み付けし最終的なcontext vectorを求める。λ_{t}は、t-1時点でのデコーダのhidden stateから重みを求める。
c_{t}^{op}は次式で計算され:
c_{t}^{scl, idx}は、
よって計算される。要は、decoderのt-1のhidden stateと、operation vectorを用いて、j番目のoperationの重要度(β)を求め、operationの重要度によって重み付けしてoperation result vectorを足し合わせることによって、context vectorを算出する。
また、recordのcontext vector c_{t}^{ctx}は、h_{j}^{res}とh_{j}^{op}と、h_{j}^{ctx}に置き換えることによって算出される。 
## データセット
人手でESPN, ROTOWIRE, WIKIBIOデータセットのReferenceに対して、factを含むtext spanと、そのfactの種類を3種類にラベル付した。input factsはinput dataから直接見つけられるfact, inferred factsはinput dataから直接見つけることはできないが、導き出すことができるfact、unsupported factsはinput dataから直接あるいは導き出すことができないfact。wikibioデータセットはinferred factの割合が少ないため、今回の評価からは除外し、ROTOWIRE, ESPNを採用した。特にESPNのheadline datasetがinferred factsが多かった。
# 結果
## 自動評価
wiseman modelをOpAttがoutperformしている。また、Seq2Seq+op+quant(Seq2Seq+copyに対してoperation result encoderとquantization layerを適用したもの)はSeq2Seq+Copyを上回っているが、OpAttほとではないことから、提案手法のoperation encoderの導入とgating mechanismが有効に作用していることがわかる。
採用するoperationによって、生成されるテキストも異なるようになっている。
## 人手評価
3人のNBAに詳しいEnglish native speakerに依頼してtest dataに対する生成結果にアノテーションをしてもらった。アノテーションは、factを含むspanを同定し、そのfactがinput facts/inferred facts/unsupported factsのどれかを分類してもらった。最後に、そのfactが入力データからsupportされるかcontradicted(矛盾するか)かをアノテーションしてもらった。
提案手法が、より多くのinferred factsについて言及しながらも、少ない#Cont.であることがわかった。
# 分析
## Quantizationの効果
チーム間のスコアの差が、5つのbinのに対してどれだけの重みを持たせたかのheatmap。似たようなスコアのgapの場合は似たような重みになることがわかる。ポイント差の絶対値が小さい場合は、重みの分布の分散が大きくなるのでより一般的な単語で生成を行うのに対し、絶対値が大きい場合は分散が小さくなるため、unique wordをつかって生成するようになる。
pointのgapの大きさによって利用される単語も変化していることがわかる。ポイント差がちいさいときは"edge"、大きいときは"blow out"など。
## gating mechanismの効果
生成テキストのtimestepごとのgateの重みの例。色が濃ければ濃いほど、operation resultsの情報を多く利用していることを表す。チームリーダーを決める際や(horford)勝者を決める際に(Hawks)、operation resultsの重みが大きくなっており、妥当な重み付けだと考察している。
[Paper Note] Netizen-Style Commenting on Fashion Photos: Dataset and Diversity Measures, Wen Hua Lin+, WWW'18
Paper/Blog Link My Issue
#NeuralNetwork #CommentGeneration #WWW Issue Date: 2019-08-24 GPT Summary- 深層ニューラルネットワークを用いた画像キャプショニングは進展しているが、生成される文は浅く、ユーザーのスタイルや意図を反映していない。これに対処するため、ネットユーザースタイルコメント(NSC)を提案し、ファッション写真に対して特徴的なコメントを自動生成する。新たに構築した「NetiLook」データセットを用い、コメントの多様性を評価する指標を提案し、トピックモデルとニューラルネットワークを組み合わせることで、画像キャプショニングの精度と多様性を向上させることを実証した。
[Paper Note] Improving Explainable Recommendations with Synthetic Reviews, Sixun Ouyang+, RecSys'18
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #NaturalLanguageGeneration #ReviewGeneration #RecSys Issue Date: 2019-08-17 GPT Summary- レコメンダーシステムにおいて、解釈可能な説明を提供することは信頼性向上に重要である。本研究では、ユーザーのレビューを基にした生成モデルを用いて、個別化された推薦説明を作成するフレームワークを提案。Amazonの書籍レビューデータセットを用いて、生成されたレビューが人間のレビューよりも優れた推薦性能を示すことを実証した。これは機械生成による自然言語説明の初の試みである。
[Paper Note] Personalized Review Generation by Expanding Phrases and Attending on Aspect-Aware Representations, Ni+, ACL'18
Paper/Blog Link My Issue
#NeuralNetwork #ReviewGeneration #ACL #KeyPoint Notes Issue Date: 2019-04-12 Comment

Personalized Review Generationタスクを、user, item, short phraseがgivenな時に、それを考慮して完全なレビューを生成するタスクとして定義。
short phraseとしては、item titleやreview summaryなどを利用している。
アイテムのaspectを考慮してレビューを生成できる点が新しい。
モデルとしては、aspect-awareなrepresentationを学習することによって、ユーザ・アイテムのaspectに関する嗜好(e.g. どの部分について言及したいか、など)を捉えたレビューを生成できるようにしている。
各aspectには代表的な単語が紐づいており、aspectに紐づく単語の生成確率をaspect-aware representationから求めたattentionによって制御し、生成時に下駄を履かせている。
PyTorch実装: https://github.com/nijianmo/textExpansion/tree/master/expansionNet
[Paper Note] Training Millions of Personalized Dialogue Agents, Pierre-Emmanuel Mazaré+, EMNLP'18, 2018.09
Paper/Blog Link My Issue
#DialogueGeneration #EMNLP Issue Date: 2019-01-24 GPT Summary- 新しいデータセットを用いて、500万のペルソナと7億のペルソナベースの対話を提供。これにより、エンドツーエンドの対話システムの性能が向上し、Zhangら(2018)のデータでファインチューニングすることで他のタスクでも最先端の結果を達成。
[Paper Note] A Knowledge-Grounded Neural Conversation Model, Ghazvininejad+, AAAI'18,
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #AAAI Issue Date: 2019-01-24
[Paper Note] Response Generation by Context-aware Prototype Editing, Yu Wu+, AAAI'18, 2018.06
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #ContextAware #AAAI Issue Date: 2019-01-24 GPT Summary- 「編集による応答生成」という新しいパラダイムを提案し、既存の応答プロトタイプを修正することで多様性と情報量を向上させる。応答編集モデルは、プロトタイプと現在のコンテキストの違いを考慮して編集ベクトルを形成し、生成結果を改善する。実験結果は、応答編集モデルが他の生成モデルや取得ベースのモデルより優れていることを示す。