
NLP (4445) — 23/23
GLUE - 英語圏における自然言語処理の標準ベンチマーク, npaka, 2020.09
Paper/Blog Link My Issue
#Article #Tutorial #Dataset #Evaluation #Blog #Initial Impression Notes Issue Date: 2021-05-19 Comment
各タスクごとにサンプルとその説明が付与されており、ぱっと見でどんなタスクかすぐ分かる
MLP-like Architecture
Paper/Blog Link My Issue
#Article #NeuralNetwork #Survey #ComputerVision #KeyPoint Notes #Reference Collection Issue Date: 2021-05-19 Comment
gMLP:大規模なself-attentionが無いSpatial Gating Unitを搭載したシンプルなMLPでも、Transformerの性能に近づけたよ(特にCV)。つまり、self-attentionはessentialというわけではなさそうだよ。
NLPの場合はgMLPだとTransformerとperplexityでcomparable、一部downstreamタスクだと勝てなかったけど、single headのtiny attentionを追加したら、TransformerをperplexityとGLUEの一部タスクでoutperformしたよ。
つまり、Transformerみたいに大規模なself-attentionは必須ではなく、小規模のattentionで(cross sentenceの関係性を捉えるには)十分だよ。
スケーラビリティもTransformerを上回ったよ。
って感じ?
んーTransformerに勝ったみたいな言い方をSNSだと見かけるけど、評価してるタスクが少ないし、どちらかというとcomparableなdownstreamタスクが多いし、それは言い過ぎでは?
この論文が言いたいのは、大規模なself-attentionが性能を出す上でessentialなわけではないよ、ってことであり、
・CVの場合はself-attentionは必須ではない
・NLPでは、tiny attentionでも十分
という感じなのでは。
まあでもTransformerとcomparableなら、Transformer一強では無くなったよね
Spatial Gating Unit(SGU)は、トークン間の関係性を捉えるためのゲートで、SGUが無いとgMLPブロックはただの二層のFFNとなる。
SGUは、入力をspatial dimensionに対して線形変換した値と、元の入力のelement-wiseな積で表現する。この線形変換をする際は、Wの値を0の近傍で初期化し、バイアス項を1に初期化することがクリティカルだった。これは、学習の初めでは線形変換はidentical mappingに近いものとなるため、gMLPブロックはFFNに近いものとなる。これが学習が進むにつれWの重みが調整され、cross tokenの関係性を捉えたブロックへと徐々に変化していくことになる。
また、SGUへの入力はGLUのようにchannel dimensionに二分割し、片方をelement-wise積に、もう一方をspatialな線形変換に利用する(4種類試した中で一番性能が良かった)。
BERT 日本語Pre-trained Model, NICT, 2020.03
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tools #Dataset #LanguageModel #Library #Blog #Japanese #Encoder #One-Line Notes Issue Date: 2020-03-13 Comment
NICTが公開。既に公開されているBERTモデルとのベンチマークデータでの性能比較も行なっており、その他の公開済みBERTモデルをoutperformしている。
BERT入門, Ken'ichi Matsui, 2020.01
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Slide #Reference Collection #Reading Reflections Issue Date: 2020-01-13 Comment
自然言語処理の王様「BERT」の論文を徹底解説
https://qiita.com/omiita/items/72998858efc19a368e50
Transformer関連 [Paper Note] Attention Is All You Need, Ashish Vaswani+, NeurIPS'17, 2017.07
あたりを先に読んでからが読むと良い
要は
・Transformerをたくさん積んだモデル
・NSPとMLMで双方向性を持った事前学習タスクを実施することで性能向上
・pooler layer(Transformer Encoderの次にくっつくlayer)を切り替えることで、様々なタスクにfine-tuning可能(i.e. pooler layerは転移学習の対象外)
・予測する際は、[CLS]トークンに対応する位置の出力を用いて分類問題や複数文間の関係性を問う問題を解いたり、各トークン位置に対応する出力を用いてQAの正解spanを予測したり、色々できる
・gMLP MLP-like Architecture
あたりの研究が進んでくると使われなくなってくる可能性有
こっちの記事もわかりやすい。
BERTについて勉強したことまとめ (2)モデル構造について
https://engineering.mobalab.net/2020/06/12/bert%E3%81%AB%E3%81%A4%E3%81%84%E3%81%A6%E5%8B%89%E5%BC%B7%E3%81%97%E3%81%9F%E3%81%93%E3%81%A8%E3%81%BE%E3%81%A8%E3%82%81-2%E3%83%A2%E3%83%87%E3%83%AB%E6%A7%8B%E9%80%A0%E3%81%AB%E3%81%A4%E3%81%84/
10 ML & NLP Research Highlights of 2019, Sebastian Ruder, 2020.01
Paper/Blog Link My Issue
#Article #Survey #MachineLearning #Blog Issue Date: 2020-01-13
事前学習言語モデルの動向 _ Survey of Pretrained Language Models, Kyosuke Nishida, 2019
Paper/Blog Link My Issue
#Article #NeuralNetwork #Survey #LanguageModel #Slide #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2019-11-09 Comment
[2019/06まで]
・ELMo(双方向2層LSTM言語モデル)
・GPT(left-to-rightの12層Transformer自己回帰言語モデル)
・BERT(24層のTransformer双方向言語モデル)
・MT-DNN(BERTの上にマルチタスク層を追加した研究)
・XLM(パラレル翻訳コーパスを用いてクロスリンガルに穴埋めを学習)
・TransformerXL(系列長いに制限のあった既存モデルにセグメントレベルの再帰を導入し長い系列を扱えるように)
・GPT-2(48層Transformerの自己回帰言語モデル)
・ERNIE 1.0(Baidu, エンティティとフレーズの外部知識を使ってマスクに利用)
・ERNIE(Tsinghua, 知識グラフの情報をfusionしたLM)
・Glover(ドメイン、日付、著者などを条件とした生成を可能としたGPT)
・MASS(Encoder-Decoder型の生成モデルのための事前学習)
・UniLM(Sequence-to-Sequenceを可能にした言語モデル)
・XLNet(自己回帰(単方向)モデルと双方向モデルの両方の利点を得ることを目指す)
[2019/07~]
・SpanBERT(i.i.dではなく範囲でマスクし、同時に範囲の境界も予測する)
・ERNIE 2.0(Baidu, マルチタスク事前学習; 単語レベル・構造レベル・意味レベル)
・RoBERTa(BERTと同じ構造で工夫を加えることで性能向上)
- より大きなバッチサイズを使う(256から8192)
- より多くのデータを使う(16GBから160GB)
- より長いステップ数の学習をする(BERT換算で16倍)
- 次文予測(NSP)は不要
→ GLUEでBERT, XLNetをoutperform
・StructBERT (ALICE, NSPに代わる学習の目的関数を工夫)
- マスクした上で単語の順番をシャッフルし元に戻す
- ランダム・正順・逆順の3種類を分類
→ BERTと同サイズ、同データでBERT, RoBERTa超え
・DistilBERT(蒸留により、12層BERTを6層に小型化(40%減))
- BERTの出力を教師として、生徒が同じ出力を出すように学習
- 幅(隠れ層)サイズを減らすと、層数を経あrスよりも悪化
→ 推論は60%高速化、精度は95%程度を保持
・Q8BERT(精度を落とさずにfine-tuning時にBERTを8bit整数に量子化)
- Embedding, FCは8bit化、softmax, LNorm, GELUは32bitをキープ
→ モデルサイズ1/4, 速度3.7倍
・CTRL(条件付き言語モデル)
- 条件となる制御テキストを本文の前に与えて学習
- 48層/1280次元Transformer(パラメータ数1.6B)
・MegatronLM(72層、隠れ状態サイズ3072、長さ1024; BERTの24倍サイズ)
・ALBERT(BERTの層のパラメータをすべて共有することで学習を高速化; 2020年あたりのデファクト)
- Largeを超えたモデルは学習が難しいため、表現は落ちるが学習しやすくした
- 単語埋め込みを低次元にすることでパラメータ数削減
- 次文予測を、文の順序入れ替え判定に変更
→ GLUE, RACE, SQuADでSoTAを更新
・T5(NLPタスクをすべてtext-to-textとして扱い、Enc-Dec Transformerを745GBコーパスで事前学習して転移する)
- モデルはEncoder-DecoderのTransformer
- 学習タスクをエンコーダ・デコーダに合わせて変更
- エンコーダ側で範囲を欠落させて、デコーダ側で予測
→ GLUE, SuperGLUE, SQuAD1.1, CNN/DMでSoTA更新
・BART(Seq2Seqの事前学習として、トークンマスク・削除、範囲マスク、文の入れ替え、文書の回転の複数タスクで学習)
→ CNN/DMでT5超え、WMT'16 RO-ENで逆翻訳を超えてSoTA
ELMo, GPT, BERT, GPT-2, XLNet, RoBERTa, DistilBERT, ALBERT, T5あたりは良く見るような感
各データセットでの各モデルの性能も後半に記載されており興味深い。
ちなみに、CNN/DailyMail Datasetでは、T5, BARTあたりがSoTA。
R2で比較すると
- Pointer-Generator + Coverage Vectorが17,28
- LEAD-3が17.62
- BARTが21.28
- T5が21.55
となっている
[Paper Note] Cross-domain personalized image captioning, Long+, Multimedia Tools and Applications, 79(45), 2019.03
Paper/Blog Link My Issue
#Article #ComputerVision #CommentGeneration Issue Date: 2019-09-27
【黒橋研】BERT日本語Pretrainedモデル
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tools #Library #Japanese #Encoder Issue Date: 2019-09-22 Comment
【huggingface transformersで使える日本語モデルのまとめ】
https://tech.yellowback.net/posts/transformers-japanese-models
AllenNLP (Official Tutorials), AI2, 2018.01
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #Tools #Library #Reference Collection Issue Date: 2018-11-16 Comment
The Annotated Transformer, harvardnlp, 2018.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #MachineLearning #One-Line Notes Issue Date: 2018-06-29
ニューラルネット勉強会(LSTM編), Seitaro Shinagawa, 2016.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #MachineLearning #Slide #Initial Impression Notes Issue Date: 2018-02-19 Comment
LSTMの基礎から、実装する上でのTipsがまとまっている。
zero padding, dropoutのかけかた、normalizationの手法など。
[Paper Note] Machine-made index for technical literature: an experiment, IBM Journal of Research and Development, 1958.10
Paper/Blog Link My Issue
#Article #DocumentSummarization #Document #Extractive #One-Line Notes Issue Date: 2018-01-17 Comment
初期の要約研究。Luhnらの研究よりはcitation countが少ない。
ALAGIN 機械翻訳セミナー 単語アライメント, Graham Neubig, 2014.03
Paper/Blog Link My Issue
#Article #Tutorial #MachineTranslation #Slide #WordAlignment Issue Date: 2018-01-15
自然言語処理のためのDeep Learning, Yuta Kikuchi, 2013.09
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #Slide #Selected Papers/Blogs Issue Date: 2018-01-15
[Paper Note] Opinion mining and sentiment analysis, Pang+, Foundations and Trends in Information Retrieval, 2008.01
Paper/Blog Link My Issue
#Article #Survey #InformationRetrieval #SentimentAnalysis #OpinionMining Issue Date: 2018-01-15
[Paper Note] The Decomposition of Human-Written Summary Sentences, Hongyan Jing+, SIGIR’99
Paper/Blog Link My Issue
#Article #DocumentSummarization #SIGIR #Selected Papers/Blogs #One-Line Notes #WordAlignment Issue Date: 2018-01-11 Comment
参照要約 - 原文書対が与えられた時に、参照要約中の単語と原文書中の単語のアライメントをとるHMMベースな手法を提案。
outputのサンプルはFigure3参照のこと。
[Paper Note] The automatic construction of large-scale corpora for summarization research, Daniel Marcu, SIGIR’99
Paper/Blog Link My Issue
#Article #DocumentSummarization #SIGIR #One-Line Notes Issue Date: 2018-01-11 Comment
[Paper Note] LexRank: Graph-based Lexical Centrality as Salience in Text Summarization, Erkan+, Journal of Artificial Intelligence Research, 2004.12
Paper/Blog Link My Issue
#Article #Multi #Single #DocumentSummarization #Document #Unsupervised #GraphBased #Extractive #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2018-01-01 Comment
代表的なグラフベースな(Multi) Document Summarization手法。
ほぼ
- [Paper Note] TextRank: Bringing Order into Texts, Mihalcea+, EMNLP'04
と同じ手法。
2種類の手法が提案されている:
* [LexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを計算し閾値以上となったsentenceの間にのみedgeを張る(重みは確率的に正規化)。その後べき乗法でPageRank。
* [ContinousLexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを用いてAffinity Graphを計算し、PageRankを適用(べき乗法)。
DUC2003, 2004(MDS)で評価。
Centroidベースドな手法をROUGE-1の観点でoutperform。
document clusterの17%をNoisyなデータにした場合も実験しており、Noisyなデータを追加した場合も性能劣化が少ないことも示している。
[Paper Note] The automatic creation of literature abstracts, H. P. Luhn, IBM Journal of Research Development, 1958.04
Paper/Blog Link My Issue
#Article #DocumentSummarization #Document #Classic #Selected Papers/Blogs #One-Line Notes Issue Date: 2018-01-01 Comment
文書要約研究初期の研究
[Paper Note] 転移学習による抽出型要約の精度向上, 西川+, 情報処理学会研究報告, 2011.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #Document #StructuredLearning #DomainAdaptation #Supervised #Extractive #One-Line Notes Issue Date: 2017-12-31 Comment
構造学習を利用した文書要約モデル
[Paper Note] Frustratingly easy domain adaptation, Daum'e, ACL'07
なども利用し転移学習を行なっている。
[Paper Note] Text Summarization using a trainable summarizer and latent semantic analysis, Yeh+, Information Processing and Management, 2005.01
Paper/Blog Link My Issue
#Article #DocumentSummarization #Supervised Issue Date: 2017-12-31
A survey on Automatic Text Summarization, Das+, 2007.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #Survey Issue Date: 2017-12-31
[Paper Note] Automatically generated linguistic summaries of energy consumption data, van der Heide+, In Proceedings of the Ninth International Conference on Intelligent Systems Design and Applications, pages 553-559, 2009.11
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #Others #DataToTextGeneration Issue Date: 2017-12-31
[Paper Note] A framework for automatic text generation of trends in physiological time series data, Banaee+, In Proceedings of the IEEE International Conference on Systems, Man, and Cybernetics, 2013.10
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #Others #DataToTextGeneration Issue Date: 2017-12-31
[Paper Note] A Global Model for Concept-to-Text Generation, Konstas+, Journal of Artificial Intelligence Research, Vol. 48, pp.305--346, 2013.10
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #SingleFramework #ConceptToTextGeneration Issue Date: 2017-12-31
[Paper Note] What to talk about and how? Selective Generation using LSTMs with Coarse-to-Fine Alignment, Hongyuan Mei+, NAACL-HLT’16, 2015.09
Paper/Blog Link My Issue
#Article #NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration #NAACL #Encoder-Decoder #KeyPoint Notes Issue Date: 2017-12-31 GPT Summary- エンドツーエンドのドメイン非依存型ニューラルエンコーダー-アライナー-デコーダーモデルを提案。LSTMを用いてデータベースイベントをエンコードし、アライナーで重要なレコードを特定、デコーダーで自由形式の説明を生成。WeatherGovデータセットで最良の結果を達成し、k近傍ビームフィルターでさらに改善。RoboCupデータセットでも競争力のある結果を得た。 Comment
content-selectionとsurface realizationをencoder-decoder alignerを用いて同時に解いたという話。
普通のAttention basedなモデルにRefinerとPre-Selectorと呼ばれる機構を追加。通常のattentionにはattentionをかける際のaccuracyに問題があるが、data2textではきちんと参照すべきレコードを参照し生成するのが大事なので、RefinerとPre-Selectorでそれを改善する。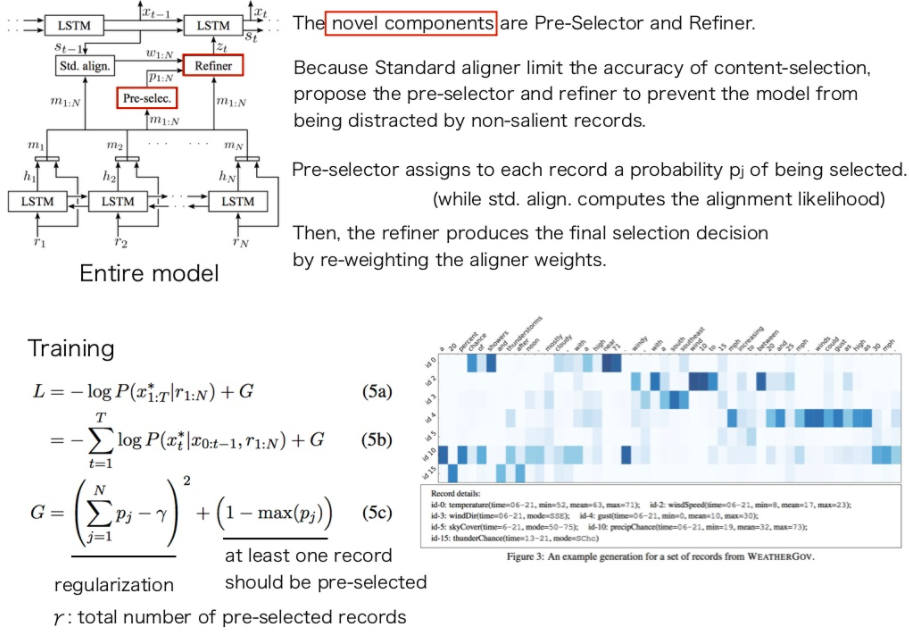
Pre-selectorは、それぞれのレコードが選択される確率を推定する(通常のattentionはalignmentの尤度を計算するのみ)。
Refinerはaligner(attention)のweightをreweightingすることで、最終的にどのレコードを選択するか決定する。
加えて、ロス関数のRegularizationのかけかたを変え、最低一つのレコードがpreselectorに選ばれるようにバイアスをかけている。
ほぼ初期のNeural Network basedなData2Text研究
[Paper Note] Web page summarization using clickthrough data, Sun et al., SIGIR’05, 2005.08
Paper/Blog Link My Issue
#Article #DocumentSummarization #Snippets #SIGIR Issue Date: 2017-12-28
[Paper Note] Learning query-biased web page summarization, Wang et al., CIKM’07, 2007.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #Snippets #QueryBiased #CIKM #KeyPoint Notes Issue Date: 2017-12-28 Comment
・従来のquery-biasedな要約におけるclassificationアプローチは,training内のdocumentの情報が未知のdocumentのsentenceのclassificationに役立つというものだった.これは,たとえば似たような情報を多く含むscientific articleだったら有用だが,様々な情報を含むweb pageにはあまり適切ではない(これはtraining set内のdocumentの情報とtarget pageの情報を比較するみたいなアプローチに相当する).この研究では,target page内の’sentenceの中で’はスニペットに含めるべき文かどうかという比較ができるという仮定のもと,learning to rankを用いてスニペットを生成する.
・query biased summarizationではrelevanceとfidelityの両者が担保された要約が良いとされている.
relevanceとはクエリと要約の適合性,fidelityとは,要約とtarget documentとの対応の良さである.
・素性は,relevanceに関してはクエリとの関連度,fidelityに関しては,target page内のsentenceに関しては文の位置や,文の書式(太字)などの情報を使う.contextの文ではそういった情報が使えないので,タイトルやanchor textのフレーズを用いてfidelityを担保する(詳しくかいてない).あとはterm occurence,titleとextracted title(先行研究によると,TRECデータの33.5%のタイトルが偽物だったというものがあるのでextracted titleも用いる),anchor textの情報を使う.あまり深く読んでいない.
・全ての素性を組み合わせたほうがintrinsicなevaluationにおいて高い評価値.また,contextとcontent両方組み合わせたほうが良い結果がでた.
[Paper Note] Enhanced web document summarization using hyperlinks, Delort et al., HT’03, 2003.08
Paper/Blog Link My Issue
#Article #DocumentSummarization #Snippets #KeyPoint Notes Issue Date: 2017-12-28 Comment
・Genericなweb pageの要約をつくる
・要約を作る際に,ページの内容から作るわけではなく,contextを用いて作る.contextとは,target pageにリンクを張っているページにおけるリンクの周辺にある文のこと.
・contextを利用した要約では,partialityとtopicalityに関する問題が生じる.partialityとは,contextに含まれる情報がtarget pageに関する一部の情報しか含んでいない問題.topicalityとは,そもそもcontextに含まれる情報が,target pageのoverviewに関する情報を含んでいない問題
・partialityに関しては,contextに含まれる文を除くことで,contextのoverallな情報が失われない最小のsetを求めることで対応.setを求める際には,context内の2文の単語を比較し,identicalなrepresentationが含まれているかどうかを計算.重複するものは排除することでsetを求める.
・topicalityに関しては,target pageのtextual informationが取得できる場合は,context内の文中の単語がtarget page内に含まれる単語の比率を出すことでtopicality scoreを算出.topicality scoreが高いものを要約とする.一方,target pageのtextual informationが十分でない場合は,context内の文のクラスタリングを行い,各クラスタのcentroidと近い文を抽出.
[Paper Note] A task-oriented study on the influencing effects of query-biased summarization in web searching, White et al., Information Processing and Management, 2003.09
Paper/Blog Link My Issue
#Article #DocumentSummarization #InformationRetrieval #RelevanceJudgment #Snippets #QueryBiased #KeyPoint Notes Issue Date: 2017-12-28 Comment
・search engineにおいてquery-biasedな要約の有用性を示したもの
・task-orientedな評価によって,提案手法がGoogleやAltaVistaのスニペットよりも良いことを示す.
・提案手法は文選択によるquery-biased summarization.スコアリングには,ページのタイトルに含まれる単語がどれだけ含まれているか,文のページ内での出現位置,クエリとの関連度,文の書式(太字)などの情報を使う.
・スニペットが作れないページに対しては,エラーメッセージを返したり,ページ内の最初のnon-textualな要素を返したりする.
DUC 2007, Update Summarization Dataset, 2006.10
My Issue
#Article #DocumentSummarization #Update #Dataset #One-Line Notes Issue Date: 2017-12-28 Comment
DUC 2007: https://duc.nist.gov/duc2007/tasks.html
[Paper Note] Update Summary Update, Copeck et al., TAC’08
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #One-Line Notes Issue Date: 2017-12-28 Comment
被引用数は少ないが、良い論文からreferされているイメージ
[Paper Note] DualSum: a Topic-Model based approach for update summarization, Delort et al., EACL’12
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #EACL #KeyPoint Notes Issue Date: 2017-12-28 Comment
・大半のupdate summarizationの手法はdocument set Aがgivenのとき,document set Bのupdate summarizationをつくる際には,redundancy removalの問題として扱っている.
・この手法は,1つのsentenceの中にredundantな情報とnovelな情報が混在しているときに,そのsentenceをredundantなsentenceだと判別してしまう問題点がある.加えて,novel informationを含んでいると判別はするけれども,明示的にnovel informationがなんなのかということをモデル化していない.
・Bayesian Modelを使うことによって,他の手法では抜け落ちている確率的な取り扱いが可能にし, unsupervisedでできるようにする.
[Paper Note] Document Update Summarization Using Incremental Hierarchical Clustering, Wang+, CIKM’10
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #CIKM #KeyPoint Notes Issue Date: 2017-12-28 Comment
・既存のMDSではdocumentをbatch処理するのが前提.typicalなクラスタリングベースの手法やグラフベースの手法はsentence-graphを構築して要約を行う.しかし,情報がsequentialに届き,realtimeで要約を行いたいときにこのような手法を使うと,毎回すでに処理したことがあるテキストを処理することになり,time consumingだし,無駄な処理が多い.特に災害時などでは致命的.このような問題に対処するために,ドキュメントがarriveしたときに,ただちにupdate summaryが生成できる手法を提案する.
・既存のヒューリスティックなfeature(tf-isfやキーワード数など)を用いたスコアリングは,existing sentencesとnewly coming sentencesが独立しているため,real world scenarioにおいて実用的でないし,hardly perform wellである.
・なので,incremental hierarchical clusteringの手法でsentence clusterをre-organizeすることで,効果的に要約のupdateを行う.このとき,sentence同士のhierarchical relationshipはreal timeにre-constructされる.
・TACのupdate summarizationとは定義が微妙に違うらしい.主に2点.TACではnewly coming documentsだけを対象にしているが,この研究 ではすべてのドキュメントを対象にする.さらに,TACでは一度だけupdate summarizationする(document set Bのみ)が,この研究ではdocumentsがsequenceでarriveするのを前提にする.なので,TACに対しても提案手法は適用可能.
・Sequence Update Summarizationの先駆け的な研究かもしれない.SUSがのshared taskになったのは2013だし.
・incremental hierarchical clusteringにはCOBWEB algorithm (かなりpopularらしい)を使う.COBWEBアルゴリズムは,新たなelementが現れたとき,Category Utilityと呼ばれるcriterionを最大化するように,4種類の操作のうち1つの操作を実行する(insert(クラスタにsentenceを挿入), create(新たなクラスタつくる), merge(2クラスタを1つに),split(existingクラスタを複数のクラスタに)).ただ,もとのCOBWEBで使われているnormal attribute distributionはtext dataにふさわしくないので,Katz distributionをword occurrence distributionとして使う(Sahooらが提案している.).元論文読まないと詳細は不明.
・要約の生成は,実施したoperationごとに異なる.
- Insertの場合: クラスタを代表するsentenceをクエリとのsimilarity, クラスタ内のsentenceとのintra similarityを計算して決めて出力する.
- createの場合: 新たに生成したクラスタcluster_kを代表する文を,追加したsentence s_newとする.
- mergeの場合: cluster_aとcluster_bをmergeして新たなcluster_cを作った場合,cluster_cを代表する文を決める.cluster_cを代表する文は,cluster_aとcluster_bを代表する文とクエリとのsimilarityをはかり,similarityが大きいものとする.
- splitの場合: cluster_aをsplitしてn個の新たなクラスタができたとき,各新たなn個のクラスタにおいて代表する文を,original subtreeの根とする.
・TAC08のデータとHurricane Wilma Releasesのデータ(disaster systemからtop 10 queryを取得,5人のアノテータに正解を作ってもらう)を使って評価.(要約の長さを揃えているのかが気になる。長さが揃っていないからROUGEのF値で比較している?)
・一応ROUGEのF値も高いし,速度もbaselineと比べて早い.かなりはやい.genericなMDSとTAC participantsと比較.TAC Bestと同等.GenericMDSより良い.document setAの情報を使ってredundancy removalをしていないのにTAC Bestを少しだけoutperform.おもしろい.
・かつ,TAC bestはsentence combinationを繰り返す手法らしく,large-scale online dataには適していないと言及.
[Paper Note] Incremental Update Summarization: Adaptive Sentence Selection based on Prevalence and Novelty, McCreadie et al., CIKM’14
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #CIKM #KeyPoint Notes Issue Date: 2017-12-28 Comment
・timelyなeventに対してupdate summarizationを適用する場合を考える.たとえば6日間続いたeventがあったときにその情報をユーザが追う為に何度もupdate summarizationシステムを用いる状況を考える.6日間のうち新しい情報が何も出てこない期間はirrelevantでredundantな内容を含む要約が出てきてしまう.これをなんとかする手法が必要だというのがmotivation.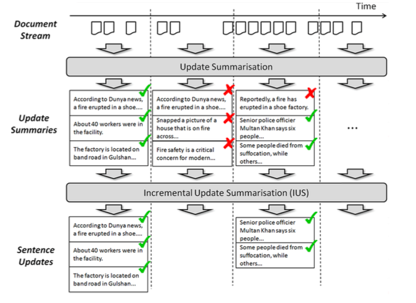
・どのような手法かというと,news streamsからnovel updatesをtimely mannerで自動抽出し,一方で,抽出するupdatesはirrelevant, uninformative or redundant contentを最小化するようなもの手法
・手法は既存のUpdate Summarization手法(lambdaMART, learning to rank baseの手法)で10文を出力し,何文目までを残すか(rank-cut off problem)を解くことで,いらないsentenceをはぶいている.
・rank cut offをする際はlinear regressionとModel Treesを使っているが,linear regressionのような単純な手法だと精度があがらず,Model Treesを使ったほうがいい結果が出た.
・素性は主にprevalence (sentenceが要約したいトピックに沿っているか否か),novelty(sentenceが新しい情報を含んでいるか),quality(sentenceがそもそも重要かどうか)の3種類の素性を使っている.気持ちとしては,prevalenceとnoveltyの両方が高いsentenceだけを残したいイメージ.つまり,トピックに沿っていて,なおかつ新しい情報を含んでいるsentence
・loss functionには,F値のような働きをするものを採用(とってきたrelevant updateのprecisionとrecallをはかっているイメージ).具体的には,Expected Latency GainとLatency Comprehensivenessと呼ばれるTREC2013のquality measureに使われている指標を使っている.
・ablation testの結果を見ると,qualityに関する素性が最もきいている.次にnovelty,次点でprevalence
・提案手法はevent発生から時間が経過すると精度が落ちていく場合がある.
・classicalなupdate summarizationの手法と比較しているが,Classyがかなり強い,Model treesを使わない提案手法や,他のbaselineを大きくoutperform. ただ,classyはmodel treesを使ったAdaptive IUSには勝てていない.
・TREC 2013には,Sequantial Update Summarizationタスクなるものがあるらしい.ユーザのクエリQと10個のlong-runnning event(典型的には10日間続くもの,各イベントごとに800〜900万記事),正解のnuggetsとそのtimestampが与えられたときにupdate summarizationを行うタスクらしい.
[Paper Note] Update Summarization using Semi-Supervised Learning Based on Hellinger Distance, Wang et al., CIKM’15, 2015.10
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #CIKM #KeyPoint Notes Issue Date: 2017-12-28 Comment
・Hellinger Distanceを用いてSentence Graphを構築.ラベル伝搬により要約に含める文を決定する手法
・update summarizationの研究ではsimilarityをはかるときにcosine similarityを用いることが多い.
・cosine similarityはユークリッド距離から直接的に導くことができる.
・Vector Space Modelはnonnegativeなmatrixを扱うので,確率的なアプローチで取り扱いたいが,ユークリッド距離は確率を扱うときにあまり良いmetricではない.そこでsqrt-cos similarityを提案する.sqrt-cosは,Hellinger Distanceから求めることができ,Hellinger Distanceは対称的で三角不等式を満たすなど,IRにおいて良いdistance measureの性質を持っている.(Hellinger Distanceを活用するために結果的に類似度の尺度としてsqrt-cosが出てきたとみなせる)
・またHellinger DistanceはKL Divergenceのsymmetric middle pointとみなすことができ,文書ベクトル生成においてはtf_idfとbinary weightingのちょうど中間のような重み付けを与えているとみなせる.
・要約を生成する際は,まずはset Aの文書群に対してMMR [Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
を適用する(redundancyの項がmaxではなくて平均になっている).similarityはsqrt-cosを用いる.
・sqrt-cosと,set Aの要約結果を用いると,sentence graphを構築できる.sentence graphはset Aとset Bの各sentenceをノードとするグラフで,エッジの重みはsqrt-cosとなっている.このsentence graph上でset Aの要約結果のラベルをset B側のノードに伝搬させることで,要約に含めるべき文を選択する.
・ラベル伝搬にはGreen’s functionを用いる.set Bにlabel “1”がふられるものは,given topicとset Aのcontentsにrelevantなsentenceとなる.
・TAC2011のデータで評価した結果,standardなMMRを大幅にoutperform, co-ranking, Centroidベースの手法などよりも良い結果.
[Paper Note] TimedTextRank: Adding the Temporal Dimension to Multi-Document Summarization, Xiaojun Wan, SIGIR’07, 2007.07
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #SIGIR #KeyPoint Notes Issue Date: 2017-12-28 Comment
・evolving topicsを要約するときは,基本的に新しい情報が重要だが,TextRankはそれが考慮できないので拡張したという話.
・dynamic document setのnew informationをより重視するTimedTextRankを提案
・TextRankのvoteの部分に重み付けをする.old sentenceからのvoteよりも,new documentsに含まれるsentenceからのvoteをより重要視
・評価のときは,news pageをクローリングし,incremental single-pass clustering algorithmでホットなトピックを抽出しユーザにみせて評価(ただしこれはPreliminary Evaluation).
[Paper Note] The LIA Update Summarization Systems at TAC-2008, Boudin et al. TAC’08, 2008.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #KeyPoint Notes Issue Date: 2017-12-28 Comment
・Scalable MMR [Paper Note] A Scalable MMR Approach to Sentence Scoring for Multi-Document Update Summarization, Boudin et al., COLING’08, 2008.08
とVariable length intersection gap n-term modelを組み合わせる.
・Variable length intersection gap n-term modelは,あるトピックのterm sequenceは他の異なる語と一緒にでてくる?という直感にもとづく.要は,drugs.*treat.*mental.*illnessなどのパターンをとってきて活用する.このようなパターンをn-gram, n-stem, n-lemmaごとにつくり3種類のモデルを構築.この3種類のモデルに加え,coverage rate (topic vocabularyがセグメント内で一度でもみつかる割合)とsegmentのpositionの逆数を組みあわせて,sentenceのスコアを計算(先頭に近いほうが重要).
・coherenceを担保するために,sentenceを抽出した後,以下のpost-processingを行う.
Acronym rewriting(初めてでてくるNATOなどの頭字語はfull nameにする)
Date and number rewriting(US standard formsにする)
Temporal references rewriting (next yearなどの曖昧なreferenceを1993などの具体的なものにする)
Discursive form rewriting (いきなりButがでてくるときとかは削るなど)
カッコやカギカッコは除き,句読点をcleanedする
・TAC 2008におけるROUGE-2の順位は72チーム中32位
[Paper Note] A Scalable MMR Approach to Sentence Scoring for Multi-Document Update Summarization, Boudin et al., COLING’08, 2008.08
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #COLING #KeyPoint Notes Issue Date: 2017-12-28 Comment
・MMR [Paper Note] The Use of MMR, Diversity-Based Reranking for Reordering Documents and Producing Summaries, Carbonell+, SIGIR'98
をupdate summarization用に拡張.History(ユーザが過去に読んだsentence)の数が多ければ多いほどnon-redundantな要約を出す (Queryに対するRelevanceよりもnon-redundantを重視する)
・Historyの大きさによって,redundancyの項の重みを変化させる.
・MMRのredundancyの項を1-max Sim2(s, s_history)にすることでnoveltyに変更.ORよりANDの方が直感的なので二項の積にする.
・MMRのQueryとのRelevanceをはかる項のSimilarityは,cossimとJaro-Winkler距離のinterpolationで決定. Jaro-Winkler距離とは,文字列の一致をはかる距離で,値が大きいほど近い文字列となる.文字ごとの一致だけでなく,ある文字を入れ替えたときにマッチ可能かどうかも見る.一致をはかるときはウィンドウを決めてはかるらしい.スペルミスなどの検出に有用.クエリ内の単語とselected sentences内の文字列のJaro-Winkler距離を計算.各クエリごとにこれらを求めクエリごとの最大値の平均をとる.
・冗長性をはかるSim2では,normalized longest common substringを使う.
[Paper Note] Improving Update Summarization via Supervised ILP and Sentence Reranking, Li et al. NAACL’15, 2015.05
Paper/Blog Link My Issue
#Article #DocumentSummarization #IntegerLinearProgramming (ILP) #Update #NAACL #KeyPoint Notes Issue Date: 2017-12-28 Comment
・update summarizationをILPで定式化.基本的なMDSのILPのterm weightingにsalienceの要素に加えてnoveltyの要素を加える.term weightingにはbigramを用いる.bigram使うとよくなることがupdate summarizationだと知られている.weightingは平均化パーセプトロンで学習
・ILPでcandidate sentencesを求めたあと,それらをSVRを用いてRerankingする.SVRのloss functionはROUGE-2を使う.
・Rerankingで使うfeatureはterm weightingした時のsentenceレベルのfeatureを使う.
・RerankingをするとROUGE-2スコアが改善する.2010, 2011のTAC Bestと同等,あるいはそれを上回る結果.novelty featureを入れると改善.
・noveltyのfeatureは,以下の通り.
Bigram Level
-bigramのold datasetにおけるDF
-bigram novelty value (new datasetのbigramのDFをold datasetのDFとDFの最大値の和で割ったもの)
-bigram uniqueness value (old dataset内で出たbigramは0, すでなければ,new dataset内のDFをDFの最大値で割ったもの)
Sentence Level
-old datasetのsummaryとのsentence similarity interpolated n-gram novelty (n-gramのnovelty valueをinterpolateしたもの)
-interpolated n-gram uniqueness (n-gramのuniqueness valueをinterpolateしたもの)
・TAC 2011の評価の値をみると,Wanらの手法よりかなり高いROUGE-2スコアを得ている.
[Paper Note] Update Summarization Based on Co-Ranking with Constraints, Wiaojun Wan, COLING’12, 2012.12
Paper/Blog Link My Issue
#Article #DocumentSummarization #Update #COLING #KeyPoint Notes Issue Date: 2017-12-28 Comment
・PageRankの枠組みを拡張してold datasetとnew dataset内のsentenceをco-ranking
・co-rankingするときは,update scoreとconsistency scoreというものを求め相互作用させる.
・update scoreが高いsentenceは同じdataset内では正の関係,異なるdataset内では負の関係を持つ.
・consistency scoreが高いsentenceは同じdataset内では正の関係,異なるdataset内では正の関係を持つ.
・負の関係はdissimilarity matrixを用いて表現する.
・あとはupdate scoreとconsistency scoreを相互作用させながらPageRankでスコアを求める.デコーディングはupdate scoreをgreedyに.
・update scoreとconsistency scoreの和は定数と定義,この論文では定数をsentenceのinformative scoreとしている.これがタイトルにある制約.informative scoreはAffinity GraphにPageRankを適用して求める.
・制約が入ることで,consistency scoreが低いとupdate scoreは高くなるような効果が生まれる.逆もしかり.
[Paper Note] Segmentation Based, Personalized Web Page Summarization Model, [Journal of advances in information technology, vol. 3, no.3, 2012], 2012.08
Paper/Blog Link My Issue
#Article #Single #PersonalizedDocumentSummarization #DocumentSummarization #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment
・Single-document
・ページ内をセグメントに分割し,どのセグメントを要約に含めるか選択する問題
・要約に含めるセグメントは4つのfactor(segment weight, luan’s significance factor, profile keywords, compression ratio)から決まる.基本的には,ページ内の高頻度語(stop-wordは除く)と,profile keywordsを多く含むようなセグメントが要約に含まれるように選択される.図の場合はAlt要素,リンクはアンカテキストなどから単語を取得しセグメントの重要度に反映する.
[Paper Note] Automatic Text Summarization based on the Global Document Annotation, Nagao+, COLING-ACL;98, 1998.08
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #Personalization #ACL #COLING #KeyPoint Notes Issue Date: 2017-12-28 Comment
Personalized summarizationの評価はしていない。提案のみ。以下の3種類の手法を提案
- keyword-based customization
- 関心のあるキーワードをユーザが入力し、コーパスやwordnet等の共起関係から関連語を取得し要約に利用する
- 文書の要素をinteractiveに選択することによる手法
- 文書中の関心のある要素(e.g. 単語、段落等)
- browsing historyベースの手法
- ユーザのbrowsing historyのドキュメントから、yahooディレクトリ等からカテゴリ情報を取得し、また、トピック情報も取得し(要約技術を活用するとのこと)特徴量ベクトルを作成
- ユーザがアクセスするたびに特徴ベクトルが更新されることを想定している?
[Paper Note] A Study for Documents Summarization based on Personal Annotation, Zhang+, HLT-NAACL-DUC’03, 2003.05
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #Personalization #NAACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2017-12-28 Comment
(過去に管理人が作成したスライドでの論文メモのスクショ)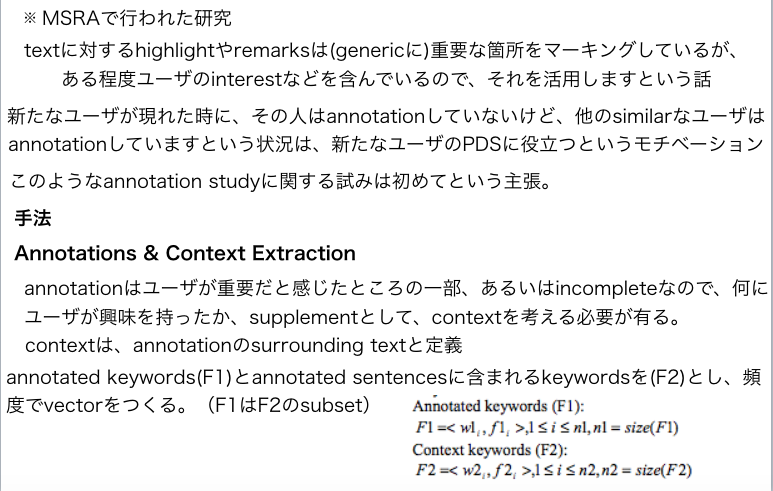
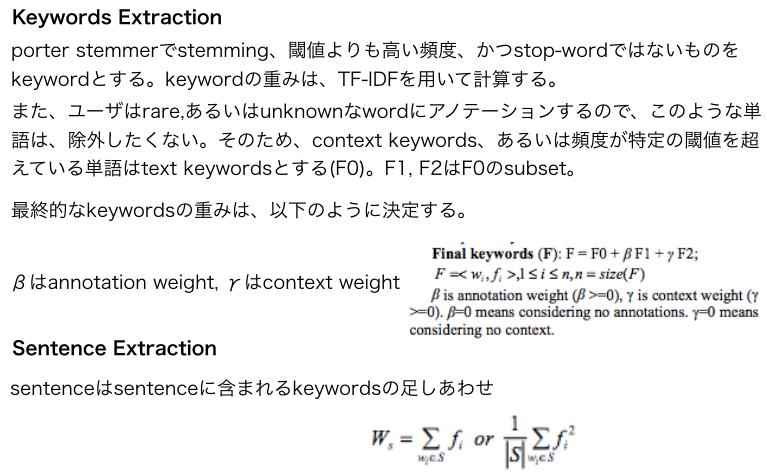
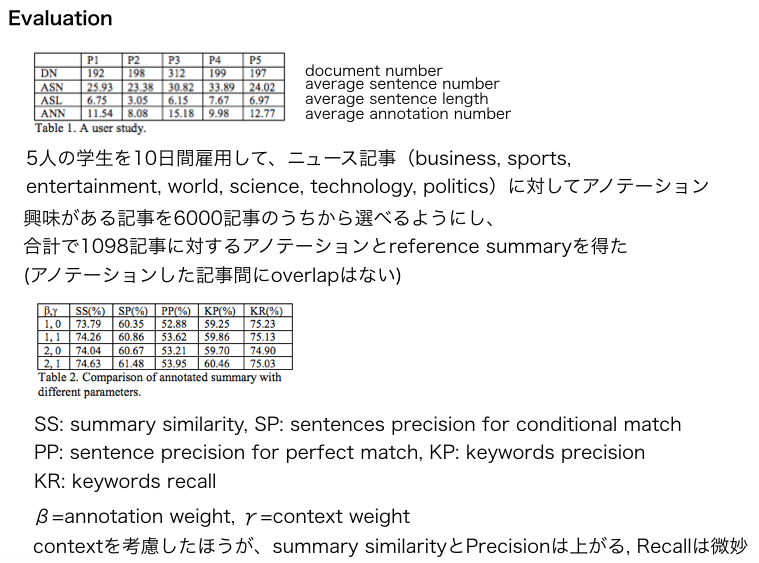
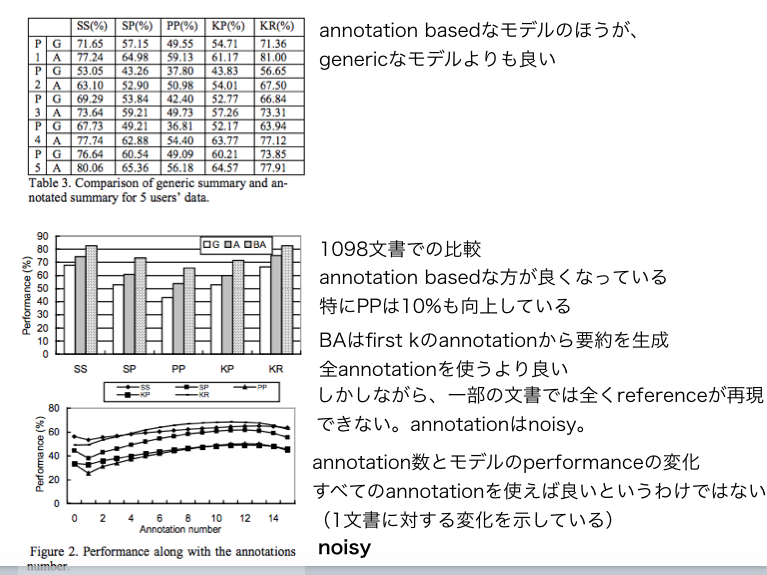
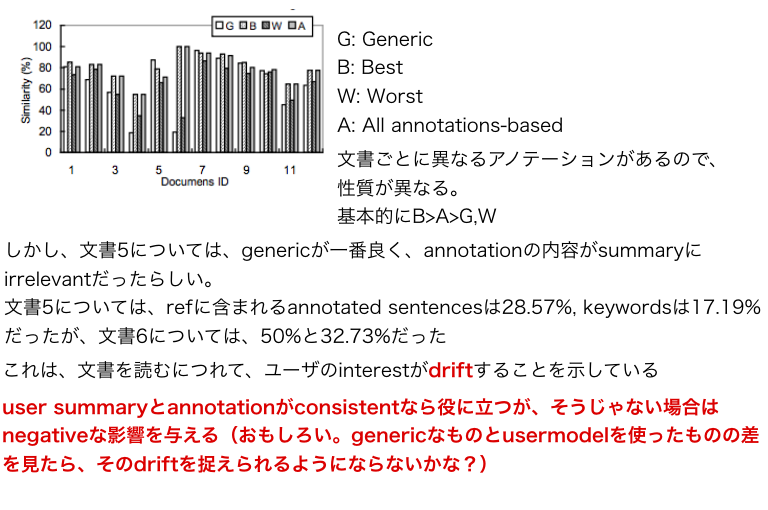
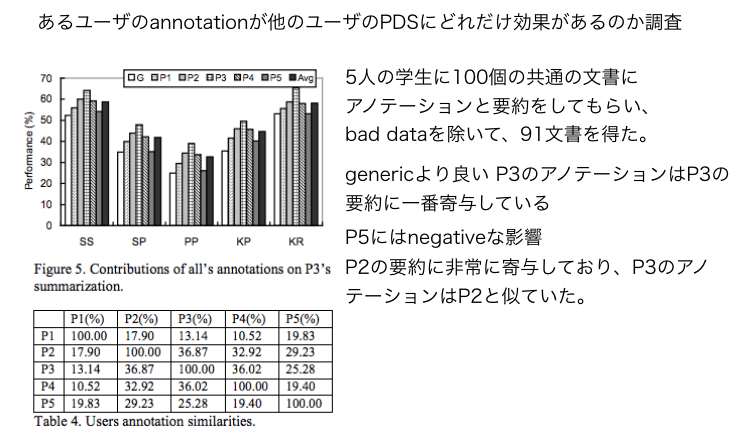
重要論文だと思われる。
[Paper Note] Comments-Oriented Document Summarization: Understanding Documents with Reader’s Feedback, Hu+, SIGIR’08, 2008.07
Paper/Blog Link My Issue
#Article #DocumentSummarization #GraphBased #Comments #Extractive #SIGIR #KeyPoint Notes Issue Date: 2017-12-28