
Supervised-FineTuning (SFT) (267) — 2/2
[Paper Note] PMC-LLaMA: Towards Building Open-source Language Models for Medicine, Chaoyi Wu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #Medical #KeyPoint Notes Issue Date: 2023-05-01 GPT Summary- 医療向けに特化したオープンソース言語モデルPMC-LLaMAを構築。一般目的の基盤モデルを医療ドメインに適応させ、4.8百万件の生物医学論文と3万冊の医療教科書から知識を注入。指示チューニング用の大規模データセットも提供し、徹底したアブレーション研究でその有効性を確認。130億パラメータの軽量版PMCLLaMAは複数の医療質問応答ベンチマークで高い性能を示し、ChatGPTを凌駕する場面も確認。 Comment
LLaMAを4.8Mのmedical paperでfinetuningし、医療ドメインの能力を向上。このモデルはPMC-LLaMAと呼ばれ、biomedicalQAタスクで、高い性能を達成した。
GPT-4を利用した異なるモデル間の出力の比較も行なっている模様
[Paper Note] Controlled Text Generation with Natural Language Instructions, Wangchunshu Zhou+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #LanguageModel #InstructionTuning #Prompting #SyntheticData #In-ContextLearning #ICML #PostTraining #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 自然言語の指示に従い、多様なタスクを解決可能な大規模言語モデルの制御を改善するために、「InstructCTG」というフレームワークを提案。自然テキストの制約を抽出し、これを自然言語の指示に変換することで弱教師あり訓練データを形成。異なるタイプの制約に柔軟に対応し、生成の質や速度への影響を最小限に抑えつつ、再訓練なしで新しい制約に適応できる能力を持つ。 Comment
制約に関する指示とデモンスとレーションに関するデータを合成して追加のinstruction tuningを実施することで、promptで指示された制約を満たすような(controllableな)テキストの生成能力を高める手法
[Paper Note] Self-Instruct: Aligning Language Models with Self-Generated Instructions, Yizhong Wang+, ACL'23, 2022.12
Paper/Blog Link My Issue
#NLP #LanguageModel #InstructionTuning #ACL #In-Depth Notes Issue Date: 2023-03-30 GPT Summary- Self-Instructフレームワークを提案し、事前学習済みの言語モデルが自ら生成した指示を用いてファインチューニングを行うことで、ゼロショットの一般化能力を向上させる。バニラGPT-3に適用した結果、Super-NaturalInstructionsで33%の性能向上を達成し、InstructGPT-001と同等の性能に到達。人間評価により、Self-Instructが既存の公共指示データセットよりも優れていることを示し、ほぼ注釈不要の指示調整手法を提供。大規模な合成データセットを公開し、今後の研究を促進する。 Comment
Alpacaなどでも利用されているself-instruction技術に関する論文
# 概要
著者らが書いた175種のinstruction(タスクの定義 + 1種のinput/outputペア}のseedを元に、VanillaなGPT-3に新たなinstruction, input, outputのtupleを生成させ、学習データとして活用する研究。
ここで、instruction data I は以下のように定義される:
instruction dataは(I, X, Y)であり、モデルは最終的にM(I_t, x_t) = y_tとなるように学習したい。
I: instruction, X: input, Y: output
データ作成は以下のステップで構成される。なお、以下はすべてVanilla GPT-3を通じて行われる:
1. Instruction Generation
task poolから8種類のinstructionを抽出し、 promptを構成し、最大8個新たなinstructionを生成させる
2. Classification Task Identification:
生成されたinstructionがclassificationタスクか否かを判別する
3. Instance Generation
いくつかの(I, X, Y)をpromptとして与え、I, Xに対応するYを生成するタスクを実行させる。このときinput-first approachを採用した結果(I->Xの順番で情報を与えYを生成するアプローチ)、特定のラベルに偏ったインスタンスが生成される傾向があることがわかった。このためoutput-first approachを別途採用し(I->Yの順番で情報を与え、各Yに対応するXを生成させる)、活用している。
4. Filtering and Postprocessing
最後に、既存のtask poolとROUGE-Lが0.7以上のinstructionは多様性がないため除外し、特定のキーワード(images, pictrues, graphs)等を含んでいるinstruction dataも除外して、task poolに追加する。
1-4をひたすら繰り返すことで、GPT-3がInstruction Tuningのためのデータを自動生成してくれる。
# SELF-INSTRUCT Data
## データセットの統計量
- 52k instructions
- 82k instances
## Diversity
parserでinstructionを解析し、rootの名詞と動詞のペアを抽出して可視化した例。ただし、抽出できた例はたかだか全体の50%程度であり、その中で20の最もcommonなroot vertと4つのnounを可視化した。これはデータセット全体の14%程度しか可視化されていないが、これだけでも非常に多様なinstructionが集まっていることがわかる。
また、seed indstructionとROUGE-Lを測った結果、大半のデータは0.3~0.4程度であり、lexicalなoverlapはあまり大きくないことがわかる。instructionのlengthについても可視化した結果、多様な長さのinstructionが収集できている。
## Quality
200種類のinstructionを抽出し、その中からそれぞれランダムで1つのインスタンスをサンプルした。そしてexpert annotatorに対して、それぞれのinstructionとinstance(input, outputそれぞれについて)が正しいか否かをラベル付けしてもらった。
ラベル付けの結果、ほとんどのinstructionは意味のあるinstructionであることがわかった。一方、生成されたinstanceはnoisyであることがわかった(ただし、このnoiseはある程度妥当な範囲である)。noisytではあるのだが、instanceを見ると、正しいformatであったり、部分的に正しかったりなど、modelを訓練する上で有用なguidanceを提供するものになっていることがわかった。
# Experimental Results
## Zero-shotでのNLPタスクに対する性能
SuperNIデータセットに含まれる119のタスク(1タスクあたり100 instance)に対して、zero-shot setupで評価を行なった。SELF-INSTRUCTによって、VanillaのGPT3から大幅に性能が向上していることがわかる。VanillaのGPT-3はほとんど人間のinstructionに応じて動いてくれないことがわかる。分析によると、GPT3は、大抵の場合、全く関係ない、あるいは繰り返しのテキストを生成していたり、そもそもいつ生成をstopするかがわかっていないことがわかった。
また、SuperNI向けにfinetuningされていないモデル間で比較した結果、非常にアノテーションコストをかけて作られたT0データでfinetuningされたモデルよりも高い性能を獲得した。また、人間がラベル付したprivateなデータによって訓練されたInstructGPT001にも性能が肉薄していることも特筆すべき点である。
SuperNIでfinetuningした場合については、SELF-INSTRUCTを使ったモデルに対して、さらに追加でSuperNIを与えた場合が最も高い性能を示した。
## User-Oriented Instructionsに対する汎化性能
SuperNIに含まれるNLPタスクは研究目的で提案されており分類問題となっている。ので、実践的な能力を証明するために、LLMが役立つドメインをブレスト(email writing, social media, productiveity tools, entertainment, programming等)し、それぞれのドメインに対して、instructionとinput-output instanceを作成した。また、instructionのスタイルにも多様性(e.g. instructionがlong/short、bullet points, table, codes, equationsをinput/outputとして持つ、など)を持たせた。作成した結果、252個のinstructionに対して、1つのinstanceのデータセットが作成された。これらが、モデルにとってunfamiliarなinstructionで多様なistructionが与えられたときに、どれだけモデルがそれらをhandleできるかを測定するテストベッドになると考えている。
これらのデータは、多様だがどれもが専門性を求められるものであり、自動評価指標で性能が測定できるものでもないし、crowdworkerが良し悪しを判定できるものでもない。このため、それぞれのinstructionに対するauthorに対して、モデルのy補足結果が妥当か否かをjudgeしてもらった。judgeは4-scaleでのratingとなっている:
- RATING-A: 応答は妥当で満足できる
- RATING-B: 応答は許容できるが、改善できるminor errorや不完全さがある。
- RATING-C: 応答はrelevantでinstructionに対して答えている。が、内容に大きなエラーがある。
- RATING-D: 応答はirrelevantで妥当ではない。
実験結果をみると、Vanilla GPT3はまったくinstructionに対して答えられていない。instruction-basedなモデルは高いパフォーマンスを発揮しているが、それらを上回る性能をSELF-INSTRUCTは発揮している(noisyであるにもかかわらず)。
また、GPT_SELF-INSTRUCTはInstructGPT001と性能が肉薄している。また、InstructGPT002, 003の素晴らしい性能を示すことにもなった。
# Discussion and Limitation
## なぜSELF-INSTRUCTがうまくいったか?
- LMに対する2つの極端な仮説を挙げている
- LM はpre-trainingでは十分に学習されなかった問題について学習する必要があるため、human feedbackはinstruction-tuningにおいて必要不可欠な側面である
- LM はpre-trainingからinstructionに既に精通しているため、human feedbackはinstruction-tuningにおいて必須ではない。 human feedbackを観察することは、pre-trainingにおける分布/目的を調整するための軽量なプロセスにすぎず、別のプロセスに置き換えることができる。
この2つの極端な仮説の間が実情であると筆者は考えていて、どちらかというと2つ目の仮説に近いだろう、と考えている。既にLMはpre-trainingの段階でinstructionについてある程度理解できているため、self-instructがうまくいったのではないかと推察している。
## Broader Impact
InstructGPTは非常に強力なモデルだけど詳細が公表されておらず、APIの裏側に隠れている。この研究が、instruct-tuned modelの背後で何が起きているかについて、透明性を高める助けになると考えている。産業で開発されたモデルの構造や、その優れた性能の理由についてはほとんど理解されておらず、これらのモデルの成功の源泉を理解し、より優れた、オープンなモデルを作成するのはアカデミックにかかっている。この研究では、多様なinstructional dataの重要性を示していると考えており、大規模な人工的なデータセットは、より優れたinstructionに従うモデルを、構築するための第一歩だと考えている。
## limitation
- Tail Phenomena
- LMの枠組みにとどまっているため、LMと同じ問題(Tail Phenomena)を抱えている
- low-frequencyなcontextに対してはうまくいかない問題
- SELF-INSTRUCTも、結局pre-trainingの段階で頻出するタスクやinstructionに対してgainがあると考えられ、一般的でなく、creativeなinstructionに対して脆弱性があると考えられる
- Dependence on laege models
- でかいモデルを扱えるだけのresourceを持っていないと使えないという問題がある
- Reinforcing LM biases
- アルゴリズムのiterationによって、問題のあるsocial _biasをより増幅してしまうことを懸念している(人種、種族などに対する偏見など)。また、アルゴリズムはバランスの取れたラベルを生成することが難しい。
1のprompt
2のprompt
3のprompt(input-first-approach)
3のprompt(output-first approach)
※ GPT3をfinetuningするのに、Instruction Dataを使った場合$338かかったっぽい。安い・・・。
LLMを使うだけでここまで研究ができる時代がきた
(最近は|現在は)プロプライエタリなLLMの出力を利用して競合するモデルを訓練することは多くの場合禁止されているので注意。
[Paper Note] Reflexion: Language Agents with Verbal Reinforcement Learning, Noah Shinn+, NeurIPS'23, 2023.03
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #ReinforcementLearning #AIAgents #SelfCorrection #NeurIPS #PostTraining #Initial Impression Notes Issue Date: 2023-03-28 GPT Summary- LLMを用いた言語エージェントが外部環境と相互作用しつつ、迅速な学習を可能にする新しいフレームワーク「Reflexion」を提案。言語的フィードバックを活用し、エージェントはタスクのフィードバックを反映、エピソディックメモリに保持して意思決定を改善。多様なフィードバック信号を取り入れ、様々なタスクで大幅な性能向上を実現。HumanEvalベンチマークでは91%のpass@1精度を達成し、従来の最先端を超える成果を示した。 Comment
なぜ回答を間違えたのか自己反省させることでパフォーマンスを向上させる研究
openreview: https://openreview.net/forum?id=vAElhFcKW6
[Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ReinforcementLearning #Safety #Selected Papers/Blogs #PseudoLabeling Issue Date: 2025-09-20 GPT Summary- 本研究では、「憲法的AI」を用いて、人間のラベルなしで無害なAIを訓練する方法を提案。監視学習と強化学習の2フェーズを経て、自己批評と修正を通じてモデルを微調整し、嗜好モデルを報酬信号として強化学習を行う。これにより、有害なクエリに対しても対話できる無害なAIアシスタントを実現し、AIの意思決定の透明性を向上させる。 Comment
(部分的にしか読めていないが)
有害なpromptに対してLLMに初期の応答を生成させ、iterativeにcritiqueとrevisionを繰り返して[^1]、より無害な応答を生成。この方法ではiterationをしながら生成結果が改定されていくので、後段のReward Modelのための嗜好データを生成するフェーズでトークン量を節約するために、生成されたより無害な応答と元となるpromptを用いて、ベースモデルをSFT。これによりベースモデルの出力分布がより無害な応答をするような方向性に調整され、かつ(iterationを繰り返すことなく)直接的により無害な応答を生成できるようになるのでtoken量が節約できる。このフェーズで学習したモデルをSL-CAIと呼ぶ。
続いて、SL-CAIに対して同様の有害なpromptを入力して、複数の応答を生成させる。生成された応答をMultiple Choice Questionの形式にし、Constitutional Principleに基づくpromptingにより、最も望ましい応答をLLMによって選択させることで、嗜好データを獲得する。この嗜好データ(と人手で定義されたhelpfulnessに基づくデータ)を用いてReward Modelを訓練しRLを実施する。
この手法は、嗜好データを人間がラベリングするのではなく、AIによるフィードバックによりラベリングするため、Reinforcement Learning from AI Feedback (RLAIF)と呼ばれる。
Harmfulness以外の分野にも応用可能と考えられる。
[^1]: この操作はモデルの望ましい挙動を人手で定義したルーブリックに基づいた複数のprompt (Constitutional Principles) を用いて実施される。具体的なpromptはAppendix Cを参照。
[Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
Paper/Blog Link My Issue
#NLP #LanguageModel #InstructionTuning #EMNLP #PostTraining #KeyPoint Notes Issue Date: 2024-10-29 GPT Summary- NLPモデルの一般化能力を評価するために、1,616の多様なタスクを含むSuper-NaturalInstructionsというベンチマークを導入。76種のタスクタイプをカバーし、モデルをタスクのサブセットで訓練し未見のタスクを評価。Tk-Instructモデルは、InstructGPTを9%以上上回る性能を示し、サイズが小さい。タスク数やインスタンス数に基づいた一般化の分析を行い、本データセットとモデルが汎用的NLPモデルの進展に寄与することを期待。 Comment
7.1, 7.2が最も興味深い
## Instruction Tuningにおける未知のタスクに対する汎化性能について、3つの要素に対するスケーリングについて考察
- More observed tasks improve the generalization.
- A large number of training instances do not help generalization.
- Tuning larger models with instructions consistently lead to gains.
## Instructionをさまざまに変化させた時の性能の変化に対する分析
Table4の対角成分に注目すると(trainとtestのinput encodingを揃えた場合)
- Task definitionをinstructionに含めることで未知タスクに対する汎化性能向上
- Task Definitionとpositive examplesを4つ程度入れると汎化性能向上。
- ただし、これ以上exampleを増やすと性能低下。
- negative examplesを入れることは性能に a little bit しか貢献しない
- explanationsを入れると性能が低下する
Table4の非対角成分に着目すると、
- Task Definitionのみで訓練しても、Example onlyのtest時のencodingには汎化しない(逆も然り)
- Task Definition + examples (今回の場合はpositive examples4つ)は、さまざまなtest時のinput encodingsに対してロバストになる
[Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
Paper/Blog Link My Issue
#NLP #LanguageModel #InstructionTuning #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-09-25 GPT Summary- 指示チューニングにより言語モデルのゼロショット学習能力を向上。1370億パラメータのモデルを60以上のNLPタスクに対してファインチューニングし、FLANと名付ける。FLANは未調整モデルを超え、25タスク中20タスクで175B GPT-3を上回り、ANLIやRTEなどでfew-shotのGPT-3にも勝る。ファインチューニングデータの数やモデル規模、指示内容が成功の鍵と示される。 Comment
FLAN論文。Instruction Tuningを提案した研究。
openreview: https://openreview.net/forum?id=gEZrGCozdqR
[Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Mathematics #Selected Papers/Blogs #Verification #needs-revision Issue Date: 2024-12-27 GPT Summary- 最先端の言語モデルは数学的推論に課題があり、GSM8Kという8,500件の小学生向け数学問題データセットを導入してその失敗を診断。特に、最大規模のトランスフォーマーモデルでも性能向上が難しいことを示す。モデルの補完の正しさを評価する検証器を訓練し、候補解を生成して最も高く評価されたものを選択する方法を提案。検証がGSM8Kの性能を大幅に向上させ、ファインチューニングよりも効果的にスケールすることを実証。 Comment
## 気持ち
- 当時の最も大きいレベルのモデルでも multi-stepのreasoningが必要な問題は失敗する
- モデルをFinetuningをしても致命的なミスが含まれる
- 特に、数学は個々のミスに対して非常にsensitiveであり、一回ミスをして異なる解法のパスに入ってしまうと、self-correctionするメカニズムがauto-regressiveなモデルではうまくいかない
- 純粋なテキスト生成の枠組みでそれなりの性能に到達しようとすると、とんでもないパラメータ数が必要になり、より良いscaling lawを示す手法を模索する必要がある
## Contribution
論文の貢献は
- GSM8Kを提案し、
- verifierを活用しモデルの複数の候補の中から良い候補を選ぶフレームワークによって、モデルのパラメータを30倍にしたのと同等のパフォーマンスを達成し、データを増やすとverifierを導入するとよりよく性能がスケールすることを示した。
- また、dropoutが非常に強い正則化作用を促し、finetuningとverificationの双方を大きく改善することを示した。
Todo: 続きをまとめる
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #PEFT(Adaptor/LoRA) #ACL #PostTraining #One-Line Notes Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #LanguageModel #PEFT(Adaptor/LoRA) #EMNLP #PostTraining #Selected Papers/Blogs #KeyPoint Notes #SoftPrompt Issue Date: 2022-08-19 GPT Summary- 本研究では、凍結された言語モデルを特定のタスクに適応させるための「ソフトプロンプト」を学習するプロンプトチューニング手法を提案。逆伝播を通じて学習されるソフトプロンプトは、GPT-3の少数ショット学習を上回る性能を示し、モデルサイズが大きくなるほど競争力が増すことが確認された。特に、数十億のパラメータを持つモデルにおいて、全ての重みを調整するモデルチューニングに匹敵する性能を発揮。これにより、1つの凍結モデルを複数のタスクに再利用できる可能性が示唆され、ドメイン転送に対するロバスト性も向上することが明らかとなった。 Comment
日本語解説:
https://qiita.com/kts_plea/items/79ffbef685d362a7b6ce
T5のような大規模言語モデルに対してfinetuningをかける際に、大規模言語モデルのパラメータは凍結し、promptをembeddingするパラメータを独立して学習する手法
言語モデルのパラメータ数が増加するにつれ、言語モデルそのものをfinetuningした場合(Model Tuning)と同等の性能を示した。
いわゆる(Softな) Prompt Tuning
[Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #NLP #LanguageModel #PEFT(Adaptor/LoRA) #ACL #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2021-09-09 GPT Summary- プレフィックスチューニングは、ファインチューニングの軽量な代替手段であり、言語モデルのパラメータを固定しつつ、タスク特有の小さなベクトルを最適化する手法です。これにより、少ないパラメータで同等のパフォーマンスを達成し、低データ設定でもファインチューニングを上回る結果を示しました。 Comment
言語モデルをfine-tuningする際,エンコード時に「接頭辞」を潜在表現として与え,「接頭辞」部分のみをfine-tuningすることで(他パラメータは固定),より少量のパラメータでfine-tuningを実現する方法を提案.接頭辞を潜在表現で与えるこの方法は,GPT-3のpromptingに着想を得ている.fine-tuningされた接頭辞の潜在表現のみを配布すれば良いので,非常に少量なパラメータでfine-tuningができる.
table-to-text, summarizationタスクで,一般的なfine-tuningやAdapter(レイヤーの間にアダプターを挿入しそのパラメータだけをチューニングする手法)といった効率的なfine-tuning手法と比較.table-to-textでは、250k (元のモデルの 0.1%) ほどの数のパラメータを微調整するだけで、全パラメータをfine-tuningするのに匹敵もしくはそれ以上の性能を達成.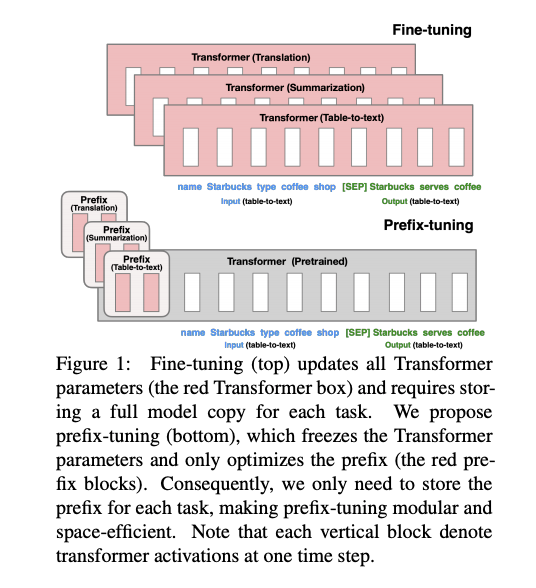
Hugging Faceの実装を利用したと論文中では記載されているが,fine-tuningする前の元の言語モデル(GPT-2)はどのように準備したのだろうか.Hugging Faceのpretrained済みのGPT-2を使用したのだろうか.
autoregressive LM (GPT-2)と,encoder-decoderモデル(BART)へPrefix Tuningを適用する場合の模式図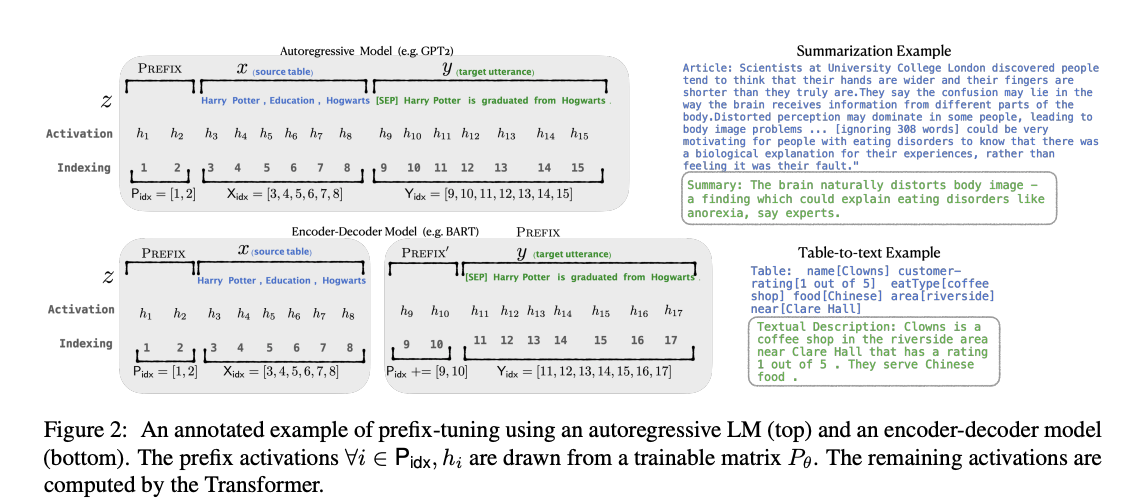
[Paper Note] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism, Mohammad Shoeybi+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#Pretraining #Tools #NLP #LanguageModel #ReinforcementLearning #PostTraining #Selected Papers/Blogs #Parallelism #One-Line Notes #DistributedLearning #TrainingFramework Issue Date: 2026-09-29 GPT Summary- 大規模Transformerモデルを学習するため、ネイティブPyTorchに少数の通信操作を追加する層内モデル並列化手法を提案。パイプライン型並列化と併用可能で、512 GPU上で最大83億パラメータのモデルを学習し、15.1ペタFLOPSと76%のスケーリング効率を達成。GPT-2型・BERT型モデルで既存のSOTAを上回り、WikiText103、LAMBADA、RACEで高い性能を実現。 Comment
Megatron-LMがメモされていなかったので追加。代表的なLLM・マルチモーダルモデル学習のためのフレームワーク
事前学習、継続事前学習だけでなく
- Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
以下のような事後学習フレームワークのバックエンドとしても利用される:
- Nemo-RL, Nvidia, 2025.05
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- slime, THUDM & Zhihu, 2025.09
- ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
When does distillation help reinforcement learning?, Base Labs, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Distillation #PostTraining #read-later #One-Line Notes #Author Thread-Post Issue Date: 2026-09-25 Comment
元ポスト:
RL前にSFTを通じてオフポリシー蒸留をすることが、どれだけ後段のRL後のパフォーマンスに影響するかを調査したようで、
- 小規模モデルには効果的だが大規模なモデルには効果が薄く
- ベースモデルに存在しない慣習や理解を必要とするタスクに対して効果的で
- 副作用としてポリシーのエントロピーが低減する、すなわちRL中の探索が抑制される
といった知見が得られたようである。
一見すると、SLMに関しては
- [Paper Note] A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility, Andreas Hochlehnert+, COLM'25
と対立する知見に見えるが、前提として何が違うだろうか。
SLMに対しては同様の知見が示されている:
- [Paper Note] AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, Zihan Liu+, arXiv'25, 2025.06
日本語音声基盤モデルの事後学習:TTSに強化学習を適用する, 株式会社DubGuild, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #SpeechProcessing #Japanese #TTS #One-Line Notes #train-inference-mismatch #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
以下記事を読んでおもしろかったポイントの要約
- 学習エンジン: FSDP + Transformer, 推論エンジン: vLLM
- LLMでのRLでは生成結果をルーブリックやReward Modelで評価できるが、音声の場合は音声トークン列だけを見ても評価できないため、波形へ複合し音声認識モデルで評価
- 報酬計算はTTS学習とは異なる依存関係が必要なので学習と報酬のサーバを分離することで柔軟性を高める
- 報酬にNLLを加えると、発話長が長くなる現象が発生し、Length Penaltyを加えることで改善される
- 実際の音声をきいてみると、発話がとても間延びしていて非常に興味深かった。
- 報酬設計と話者性の関係性を分析すると、Correct Error Rateによる報酬のみの場合は女性話者(のようにきこえる)割合が減り、+NLL, +Length Penaltyの場合は、女性話者(のようにきこえる)音声の割合が大幅に増加し、学習に何らかのバイアスが加わっている可能性が示唆された。
- これはCER, NLLの計算にWhisperを用いており、Whisperのベースモデルに対する音声合成結果において、女性話者の候補が報酬を得やすい状態であったことに起因することを分析(一般的なな女性音声において有利になっているわけではない)
- RLにおけるtrain-inference mismatchに関しても分析し
- FP16/BF16、エンジン(Transformer, vLLM)において、ミスマッチが存在し、エンジンよりも数値精度の変更の影響が大きく
- BF16にすると、FP16と比較して1位, 2位の出力候補のlogitが同値となる割合が増加し、音声トークンを生成するモデルのベースとなったLLMとlogitの同値率を比較すると、音声トークン生成の方が同値率が大幅に高い結果となった
- BF16/FP16の間の学習-生成の間での対数確率の差は、BF16の場合はFP16の約8倍となった(が、学習後のCERで見ると大きな差は生じなかった)。
- TTSモデルを評価する際には、モデルと音声コーデック符号化/復号の影響を分離して考える必要がある
- 人間がきいて同じ音声にきこえる場合でも、埋め込みを用いた類似度ではあまり高くないことがある
関連:
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
[Paper Note] Post-Training Science for Supervised Fine-Tuning, O'Neill, 2026.06
Paper/Blog Link My Issue
#Article #Analysis #PEFT(Adaptor/LoRA) #Author Thread-Post Issue Date: 2026-06-20 Comment
元ポスト:
Should we use genetics instead of system prompts for AI Agents & Personas?, Fyx, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #PEFT(Adaptor/LoRA) #PostTraining #read-later #Personality #One-Line Notes #Reading Reflections Issue Date: 2026-05-31 Comment
元ポスト:
ゲノム文字列からキャラクターのペルソナを推論し出力に反映可能なLoRAアダプタを学習することによって、ゲノム文字列によってペルソナの条件付けを可能とするモデルに関する実験の報告のようである。
具体的には、まずゲノム文字列と、ペルソナに関するテキストを対応付ける。次に、ペルソナテキストを与えてモデルの応答を収集し、ゲノム文字列と(ペルソナのテキストなしで)収集したモデルの応答を用いてLoRAアダプタを学習する。これにより、LoRAアダプタはゲノム文字列から、ペルソナテキストによって応答づけられた応答を出力することを学習する、といった挙動を実現する。
ざっとみた感じLoRAアダプタとは書かれているが、学習手法が書かれていないような気がする。が、手法はおそらくSFTだと思われる。
これにより、prefillをするinput tokenが削減可能と思われるが、実用上はどちらかというと出力/reasoningトークンが圧縮される方がlatency/コストの双方から恩恵があるので、事後学習をして他の能力が劣化、あるいはAlignmentが悪化するリスクを背負ってまでやる価値があるかは怪しいな、という感想を持ったが、果たしてどうだろうか。
非常に大規模なユーザからの同時接続があり、キャラクターと対話できるようなサービスにおいて、キャラクターのペルソナテキスト(用途はペルソナだけには限らない汎用的な技術だと思うが)が97%圧縮できたら結構なインパクトがあるかもしれない。
[Paper Note] Achieving Gold-Medal-Level Olympiad Reasoning via Simple and Unified Scaling
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Reasoning #Mathematics #Test-Time Scaling #PostTraining #RLVR #Verification #Physics Issue Date: 2026-05-21 Comment
pj page: https://simplified-reasoning.github.io/SU-01/
元ポスト:
ポイント解説:
Alignment Whack-a-Mole : Finetuning Activates Verbatim Recall of Copyrighted Books in Large Language Models
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #PostTraining #Copyright Issue Date: 2026-05-08 Comment
元ポスト:
国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #ContextWindow #Quantization #PositionalEncoding #LLMServing #Slide #mid-training #DPO #PostTraining #GRPO #KV Cache #Compression Issue Date: 2026-04-07 Comment
元ポスト:
関連:
- PLaMo 3.0 Prime β版, PFN, 2026.03
関連:
- RoPE / YaRN
- [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
- [Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
- DPO
- [Paper Note] Direct Preference Optimization: Your Language Model is Secretly a Reward Model, Rafael Rafailov+, arXiv'23, 2023.05
- GRPO
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open
Language Models, Zhihong Shao+, arXiv'24
- RLはSFTよりも汎化性能に優れ、基本的には事前学習で獲得された能力を引き出す、という話
- [Paper Note] SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training, Tianzhe Chu+, ICML'25
- [Paper Note] Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yang Yue+, NeurIPS'25, 2025.04
- JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して, PFN, 2026.01
- LLM Serving系
- [Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
- [Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
- [Paper Note] AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, Ji Lin+, MLSys'24
- TurboQuant: Redefining AI efficiency with extreme compression, Google Research, 2026.03
うーーんおもしろかった!後でnote中の関連文献を紐づけてついでに復習したい
Why aren't we fine-tuning more?, Nate Meyvis, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #PostTraining #Finetuning Issue Date: 2026-03-30 Comment
元ポスト:
なぜFinetuningは普及していないのか?という点を考察しているブログ。ざっくり言うと、「コストの割に合わない」ということであり、具体的には
- Finetuningをしなくてもprompt engineeringで十分な性能が出てしまい
- Finetuningをしなくても、ドメイン固有のツールを組み合わせることでドメインspecificな挙動が実現できたり
- Finetuningを実施すると、新たなモデルが利用可能になった場合に再度Finetuningを実施するなどのオーバヘッドが生じ割に合わない
といった話が書かれている。個人的にはさらに言うと
- Finetuningを実施することでAI Safety周りの懸念が生じてしまい、Safetyに関する評価を厳密には実施しなければならない(特に何らかのチャットベースの応用の場合はなおさら)
というのもあると感じており、このモデルは安全ですと顧客にどのように説明するのか?という新たな説明責任が生じるという点もあるのかなと思う。
しかし、やはりFinetuningはあまり普及していないんだなあ、感
CoderForge-Preview: SOTA open dataset for training efficient coding agents, together.ai, 2026.02
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Blog #Coding #SoftwareEngineering #read-later #Selected Papers/Blogs Issue Date: 2026-02-28 Comment
元ポスト:
Swallowにおける 日英推論型大規模言語モデルの構築, 水木栄, 第26回LLM勉強会, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #ReinforcementLearning #Japanese #mid-training #PostTraining #Selected Papers/Blogs #DataMixture #Initial Impression Notes Issue Date: 2026-02-27 Comment
元ポスト:
関連:
- Qwen3-Swallow & GPT-OSS-Swallow, Kazuki Fujii, 2026.02
まだしっかり読めていないのだが、適切なDataMixtureはどのようにして決めているのだろうか?
- 数学データによる学習がコーディングにのみ転移
- 英語データを邦訳したデータが学習に寄与するためcross-lingualで能力が転移する
- RLはpass@1を改善するが、Pass@10などの改善幅は縮小する
- この辺の話は資料中でも先行研究が引用されており、実際に確認されたということだと思われる
...
Qwen3-Swallow & GPT-OSS-Swallow, Kazuki Fujii, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #ReinforcementLearning #Evaluation #Japanese #mid-training #PostTraining #read-later #RLVR #Selected Papers/Blogs Issue Date: 2026-02-21 Comment
元ポスト:
関連:
- [Paper Note] Accelerating Large Language Model Training with 4D Parallelism and Memory Consumption Estimator, Kazuki Fujii+, arXiv'24, 2024.11
- FP8 trainingを支える技術 1, Kazuki Fujii, 2026.02
QED-Nano: Teaching a Tiny Model to Prove Hard Theorems, LM Provers Team, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Mathematics #SmallModel #PostTraining #Proofs #Rubric-based #Initial Impression Notes Issue Date: 2026-02-16 Comment
元ポスト:
ポイント解説:
早くもReasoning Cacheが利用されている:
- [Paper Note] Reasoning Cache: Continual Improvement Over Long Horizons via Short-Horizon RL, Ian Wu+, arXiv'26, 2026.02
4B級のモデルで特定タスクに特化したモデルを作りたい場合に非常に役立ちそうなレシピ
[Paper Note] OpenResearcher: A Fully Open Pipeline for Long-Horizon Deep Research Trajectory Synthesis, Li+, 2026.02
Paper/Blog Link My Issue
#Article #InformationRetrieval #NLP #Search #LanguageModel #AIAgents #SyntheticData #OpenSource #Selected Papers/Blogs #Reproducibility #DeepResearch #One-Line Notes #LongHorizon #Initial Impression Notes #Environment Issue Date: 2026-02-10 Comment
元ポスト:
APIに依存せずオフラインコーパスと検索を利用し、高品質なDeepResearchのlong horizonなtrajectoryを合成可能な環境を構築。合成したtrajectoryでNemotron-3-nano-30B-A3B-BaseをSFTすることで、Kimi-K2, GLM-4.6などの10倍以上大きいサイズのモデルよりもBrowseCompで高い性能を獲得。同サイズのTongyiDeepResearchもoutperform。
Deterministicなプロセスで、オフラインコーパスからデータを合成し外部APIに依存しないため完全に再現性があり、かつAPIのコストやrate limitにも引っかからないという利点がある。検索エンジン、コード、データ、合成データ、モデル、全てを公開。
完全に再現性のある研究は素晴らしい。
PLaMo 2.2 Primeをリリースしました, PFN, 2026.01
Paper/Blog Link My Issue
#Article #Multi #NLP #LanguageModel #Proprietary #Japanese #DPO #PostTraining #InstructionFollowingCapability #Medical #RolePlaying Issue Date: 2026-01-29 Comment
関連:
- [Paper Note] Generalizing Verifiable Instruction Following, Valentina Pyatkin+, NeurIPS'25, 2025.07
- JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して, PFN, 2026.01
non-thinkingモデルである点に注意
FrogMini-14B-2510, Microsoft, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Coding #OpenWeight #SoftwareEngineering #One-Line Notes Issue Date: 2026-01-16 Comment
元ポスト:
strong modelから合成されたbug fixのtrajectoryでSFTすることで小規模モデルでSWE Benchの性能改善
olmOCR 2: Unit test rewards for document OCR, Ai2, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #ReinforcementLearning #MultiLingual #Japanese #GRPO #Selected Papers/Blogs #DocParser #VisionLanguageModel #OCR #One-Line Notes Issue Date: 2025-10-23 Comment
元ポスト:
モデル: https://huggingface.co/allenai/olmOCR-2-7B-1025-FP8
Apache2.0ライセンスでSoTA更新。そしてさすがの学習データとコードも公開
テクニカルレポート: https://github.com/allenai/olmocr/blob/main/olmOCR-2-Unit-Test-Rewards-for-Document-OCR.pdf
果たして日本語は…SFT Datasetのtop5にjaはなかったように見える
所見:
demoを試した見たが日本語スライドでも非常に性能が良い
DeepSeekOCRとの比較:
nanochat, karpathy, 2025.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #LanguageModel #ReinforcementLearning #ChatGPT #Repository #mid-training #GRPO #read-later #Selected Papers/Blogs #Inference #MinimalCode #KV Cache Issue Date: 2025-10-22 Comment
元ポスト:
新たなスピードランが...!!
FP8で記録更新とのこと:
nano chatの過去の改善のポイントまとめ:
nanochatにおいてKarpathy氏がAIによる自動改善をするエージェントをセットアップしたところ、12時間で110の変更が加わり、ValLossを0.864215から0.85039まで改善しているとのこと。
現在の最高性能は2時間で0.71854なのでまだまだ及んでいないが、このまま回しておいたらどこまで改善するだろうか?
ポストに本人が返信をしているが、Karpathy氏の関心は、どのハーネスがnanochatに最も大きな改善をもたらすか、という点らしい。
Anatomy of a Modern Finetuning API, Benjamin Anderson, 2025.10
Paper/Blog Link My Issue
#Article #MachineLearning #Blog #PEFT(Adaptor/LoRA) #SoftwareEngineering #KeyPoint Notes Issue Date: 2025-10-06 Comment
関連:
- Tinker is a training API for {developers, builders, researchers}, THINKING MACHINES, 2025.10
2023年当時のFinetuningの設計について概観した後、TinkerのAPIの設計について説明。そのAPIの設計のstepごとにTinker側にデータを送るという設計について、一見すると課題があることを指摘(step単位の学習で数百msの通信オーバヘッドが生じて、その間Tinker側のGPUは待機状態になるため最大限GPUリソースを活用できない。これは設計ミスなのでは・・・?という仮説が成り立つという話)。が、仮にそうだとしても、実はよくよく考えるとその課題は克服する方法あるよ、それを克服するためにLoRAのみをサポートしているのもうなずけるよ、みたいな話である。
解決方法の提案(というより理論)として、マルチテナントを前提に特定ユーザがGPUを占有するのではなく、複数ユーザで共有するのではないか、LoRAはadapterの着脱のオーバヘッドは非常に小さいのでマルチテナントにしても(誰かのデータの勾配計算が終わったらLoRAアダプタを差し替えて別のデータの勾配計算をする、といったことを繰り返せば良いので待機時間はかなり小さくなるはずで、)GPUが遊ぶ時間が生じないのでリソースをTinker側は最大限に活用できるのではないか、といった考察をしている。
ブログの筆者は2023年ごろにFinetuningができるサービスを展開したが、データの準備をユーザにゆだねてしまったがために成功できなかった旨を述べている。このような知見を共有してくれるのは大変ありがたいことである。
LoRAの進化:基礎から最新のLoRA-Proまで , 松尾研究所テックブログ, 2025.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Blog #PEFT(Adaptor/LoRA) #PostTraining Issue Date: 2025-09-22 Comment
元ポスト:
関連:
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
- LoRA+: Efficient Low Rank Adaptation of Large Models, Soufiane Hayou+, N/A, ICML'24
Holo1.5 - Open Foundation Models for Computer Use Agents, H Company, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #ReinforcementLearning #OpenWeight #ComputerUse #GRPO #VisionLanguageModel #GUI Issue Date: 2025-09-16 Comment
7BのみApache 2.0ライセンス。3BはQwenのライセンスを継承し、72Bはnon-commercialライセンスらしい
モデルカードとブログによると下記モデル群とSonnet 4 よりもComputer Use関連ベンチマーク(GUI上での位置を特定するUI LocalizationとScreen Contentの理解およびQA関連のベンチマーク)で高性能とのこと:
- [Paper Note] UI-Venus Technical Report: Building High-performance UI Agents with RFT, Zhangxuan Gu+, arXiv'25
- [Paper Note] UI-TARS: Pioneering Automated GUI Interaction with Native Agents, Yujia Qin+, arXiv'25, 2025.01
- Qwen2.5-VL-32B-Instruct, Qwen Team, 2025.03
モデルカードによるとopen sourceデータのmixと、合成データ、人手でアノテーションされたデータを用いて、SFT->GRPOによって学習されたとだけ書かれている。
Nemotron-CC-v2, Nvidia, 2025.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #Coding #Mathematics #Selected Papers/Blogs Issue Date: 2025-09-01 Comment
元ポスト:
CCだけでなく、数学やコーディングの事前学習データ、SFT styleの合成データセットも含まれている。
[Paper Note] Unsupervised Elicitation of Language Models, Wen+, Anthropic, 2025.06
Paper/Blog Link My Issue
#Article #Unsupervised #NLP #LanguageModel #Author Thread-Post Issue Date: 2025-06-12 Comment
元ポスト:
ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
Paper/Blog Link My Issue
#Article #NLP #Library #Blog #OpenWeight #MoE(Mixture-of-Experts) #PostTraining #One-Line Notes #Author Thread-Post Issue Date: 2025-05-11 Comment
元ポスト:
Megatron-SWIFTというAlibaba製のライブラリを利用しQwen3の継続事前学習とSFTを実施する方法を、ベストプラクティスに則って記述し、かつ著者自身が学習したモデルも公開している。(おそらくインスタンス代は自腹なので)すごい...!!
Megatron-SWIFTはMoEアーキテクチャを採用したモデルであれば、DeepSpeed Zero3 [^1]と比べて10倍程度のスループットで学習できる模様(早い)。一方MoEアーキテクチャでないモデルの場合はそこまで大きな差はない。
[^1]: A100 80GB 2ノードでは、Qwen3-30B-A3Bは、DeepSpeed-Zero2ではOOMとなり載らないようだ…。なんとリソースに厳しいこと…(涙)
Qwen3, Qwen Team, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #ReinforcementLearning #InstructionTuning #Blog #LongContext #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) #PostTraining #KeyPoint Notes #Reference Collection Issue Date: 2025-04-29 Comment
- 119言語をサポート
- MoEモデル [Paper Note] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, Noam Shazeer+, ICLR'17
- 30B-A3B / 235B-A22N
- 128K context window
- Qwen2.5はMoEを採用していないので新たなアーキテクチャとなる
- Denseモデル(非MoEモデル)も公開
- 0.6B -- 32B
- 32K -- 128K context window
- Thinking/Non-thinking の切り替えが切り替えが可能
- スイッチは自動的に実施されるが、ユーザが明示的に `/think`, `/no_think` を user_promptの末尾に追加することで制御することも可能
- Pre-training
- データ
- 36 trillion tokensによって学習(Qwen-2.5の2倍)
- 学習データではwebデータに加えて、PDF-likeな文書群からQwen2.5-VL Qwen2.5-VL-32B-Instruct, Qwen Team, 2025.03
によってテキストを抽出し、Qwen2.5 で抽出された内容の品質を改善し利用
- また、math / code に関するデータを追加するために、Qwen2.5-Math / Qwen2.5-Coderを用いて合成データを作成(textbooks / QA pairs / code snippets [Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
)
- 事前学習のステップ
- S1: context長が4kの30 trillion tokenで事前学習
- S2: STEM / coding / reasoning task などのknowledge-intensiveデータの比率を増やして継続事前学習 (これがおそらく 5 trillion token程度?)
- Final Stage: context長を32kに拡大し高品質なlong-context dataで継続事前学習
- これによりBaseモデルが完成し、Qwen3-235B全体のうち10%程度のActive Parameterの利用するだけで(i.e., 22Bで)、Qwen2.5-72B Baseと同等以上の性能達成
- Post-training
- S1: long-CoT cold start
- 数学/coding/logical reasoning/STEMなどの多様なlong CoTデータを用いてSFT [Paper Note] s1: Simple test-time scaling, Niklas Muennighoff+, EMNLP'25, 2025.01
- S2: reasoning-based RL
- rule-based (verifiable) rewards によるRL DeepSeek-R1, DeepSeek, 2025.01
- S1/S2の流れは [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
に有効性が示されている通り、long CoT DataによるSFT -> RLを実施
- S3: thinking mode fusion
- S2データを用いてlong CoTデータとinstruction tuningデータ(非Long CoT)を生成し、Thinking/Non-thinkingを自動的に選択し生成するように学習(SFT or RLは記述なし)
- S4: general RL
- 20以上の一般的なドメインのタスクを通じて一般的な能力の向上と、safetyに関するalignmentの実施(e.g., instruction following, format following, agent能力など)
BestPracticeに関するポスト:
解説:
Llama-3_1-Nemotron-Ultra-253B-v1, Nvidia, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #ReinforcementLearning #InstructionTuning #Pruning #Reasoning #OpenWeight #KeyPoint Notes #Author Thread-Post Issue Date: 2025-04-08 Comment
DeepSeek-R1をGPQA Diamond GPQA: A Graduate-Level Google-Proof Q&A Benchmark, David Rein+, N/A, COLM'24
, AIME2024/2025, Llama4 Maverickを
BFCLv2(Tool Calling, BFCLv2, UC Berkeley, 2024.08
), IFEVal [Paper Note] Instruction-Following Evaluation for Large Language Models, Jeffrey Zhou+, arXiv'23, 2023.11
で上回り, そのほかはArenaHardを除きDeepSeekR1と同等
DeepSeekR1が671B(MoEで37B Activation Param)に対し、こちらは253B(ただし、Llama3.1がベースなのでMoEではない)で同等以上の性能となっている。
ReasoningをON/OFFする能力も備わっている。
モデルがどのように訓練されたかを示す全体図がとても興味深い:
特に [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
でも有効性が示されているように、SFTをしてからReasoningを強化する(強化というより元々持っている能力を引き出す?)RLを実施している。
詳細は下記Blogとのこと:
https://developer.nvidia.com/blog/build-enterprise-ai-agents-with-advanced-open-nvidia-llama-nemotron-reasoning-models/
元ポスト:
Nemotron-H: A Family of Accurate, Efficient Hybrid Mamba-Transformer Models, Nvidia, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #MultiModal #Blog #SSM (StateSpaceModel) #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-24 Comment
関連:
- Hunyuan T1, Tencent, 2025.03
TransformerのSelf-attention LayerをMamba2 Layerに置換することで、様々なベンチマークで同等の性能、あるいは上回る性能で3倍程度のInference timeの高速化をしている(65536 input, 1024 output)。
56B程度のmediumサイズのモデルと、8B程度の軽量なモデルについて述べられている。特に、8BモデルでMambaとTransformerのハイブリッドモデルと、通常のTransformerモデルを比較している。学習データに15 Trillion Tokenを利用しており、このデータ量でのApple to Appleのアーキテクチャ間の比較は、現状では最も大規模なものとのこと。性能は多くのベンチマークでハイブリッドにしても同等、Commonsense Understandingでは上回っている。
また、学習したNemotron-Hをバックボーンモデルとして持つVLMについてもモデルのアーキテクチャが述べられている。
LLM 開発を支える多様な Fine-Tuning:PFN での取り組み, 中鉢魁三郎, PFN, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Slide Issue Date: 2025-03-16 Comment
知識の追加の部分で下記研究が引用されている
- [Paper Note] Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?, Zorik Gekhman+, EMNLP'24, 2024.05
- [Paper Note] LoRA Learns Less and Forgets Less, Dan Biderman+, TMLR'24, 2024.05
The Ultra-Scale Playbook: Training LLMs on GPU Clusters, HuggingFace, 2025.02
Paper/Blog Link My Issue
#Article #Pretraining #MachineLearning #LanguageModel #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-04 Comment
HuggingFaceによる数1000のGPUを用いたAIモデルのトレーニングに関するオープンソースのチュートリアル
強化学習「GRPO」をCartPoleタスクで実装しながら解説, 小川雄太郎, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #PostTraining #GRPO Issue Date: 2025-02-19 Comment
元ポスト:
Unsloth で独自の R1 Reasoningモデルを学習, npaka, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #Reading Reflections Issue Date: 2025-02-07 Comment
非常に実用的で参考になる。特にどの程度のVRAMでどの程度の規模感のモデルを使うことが推奨されるのかが明言されていて参考になる。
DeepSeek-R1の論文読んだ?【勉強になるよ】 , asap, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #FoundationModel #RLHF #Blog #Selected Papers/Blogs #Reading Reflections Issue Date: 2025-02-01 Comment
- DeepSeek-R1, DeepSeek, 2025.01
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open
Language Models, Zhihong Shao+, arXiv'24
とても丁寧でわかりやすかった。後で読んだ内容を書いて復習する。ありがとうございます。
LLM Datasets, mlabonne, 2025.01
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Repository #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-01-25 Comment
LLMの事後学習用のデータをまとめたリポジトリ
現在も更新されている。
How to fine-tune open LLMs in 2025 with Hugging Face, PHILSCHMID, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #Blog #SoftwareEngineering #PostTraining #One-Line Notes Issue Date: 2025-01-25 Comment
SFTTrainerを用いたLLMのSFTについて、実用的、かつ基礎的な内容がコード付きでまとまっている。
How to align open LLMs in 2025 with DPO & and synthetic data, PHILSCHMID, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #python #Blog #SoftwareEngineering #DPO #PostTraining #KeyPoint Notes Issue Date: 2025-01-25 Comment
元ポスト:
- DPOの概要やRLHFと比較した利点
- ルールベース、あるいはLLM as a Judgeを用いたOn-policy preference pair(現在のSFTしたモデルの出力から生成したpreference data)の作り方とその利点(現在のモデルのoutput distributionを反映しているので学習が効率化される)
- 環境構築方法
- DPOTrainer/TRLParserの使い方/DPODatasetの作り方
- DPOのハイパーパラメータβの意味合い
- DPOではSFTと比べて10-100x小さい学習率を使う必要があること
- Evaluation Harnessを用いた評価方法
- TGIを用いたモデルのデプロイとテスト
などが丁寧なサンプルコードと注釈、reference付きで説明されている。
To fine-tune or not to fine-tune, Meta, 2024.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #RAG(RetrievalAugmentedGeneration) #Blog #PEFT(Adaptor/LoRA) #Catastrophic Forgetting #PostTraining #KeyPoint Notes Issue Date: 2025-01-02 Comment
LLMをSFTする際の注意点やユースケースについて記述されている。
- full parameterのファインチューニングやPEFT手法のピークGPUメモリ
- full parameterのファインチューニングではcatastrophic forgettingに気をつける必要があること
- Finetuningが有用なユースケースとして以下が挙げられている
- トーン、スタイル、フォーマットのカスタマイザーション
- prompt engineeringやICLで達成するには困難なAccuracyの向上やエッジケースへの対応
- ドメイン適応
- より大きいモデルを蒸留することによるコスト削減
- 新たなタスクへの適応や能力の獲得
また、RAGとFinetuningどちらを選択すべきかに関する話題も記述されている(が、多くの場合はハイブリッドアプローチがベストだ、といった話も書いてある)。
元ポスト:
LLMを数学タスクにアラインする手法の系譜 - GPT-3からQwen2.5まで, bilzard, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Alignment #Chain-of-Thought #Reasoning #Mathematics #PostTraining #Reading Reflections Issue Date: 2024-12-27 Comment
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
において、数学においてモデルのパラメータ数のスケーリングによって性能改善が見込める学習手法として、モデルとは別にVerifierを学習し、モデルが出力した候補の中から良いものを選択できるようにする、という話の気持ちが最初よくわからなかったのだが、後半のなぜsample&selectがうまくいくのか?節を読んでなんとなく気持ちが理解できた。SFTを進めるとモデルが出力する解放の多様性が減っていくというのは、興味深かった。
しかし、特定の学習データで学習した時に、全く異なるUnseenなデータに対しても解法は減っていくのだろうか?という点が気になった。あとは、学習データの多様性をめちゃめちゃ増やしたらどうなるのか?というのも気になる。特定のデータセットを完全に攻略できるような解法を出力しやすくなると、他のデータセットの性能が悪くなる可能性がある気がしており、そうするとそもそもの1shotの性能自体も改善していかなくなりそうだが、その辺はどういう設定で実験されているのだろうか。
たとえば、
- [Paper Note] Beyond Full Fine-tuning: Harnessing the Power of LoRA for Multi-Task Instruction Tuning, Xin+, LREC-COLING'24
などでは、
- [Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
のような1600を超えるようなNLPタスクのデータでLoRAによりSFTすると、LoRAのパラメータ数を非常に大きくするとUnseenタスクに対する性能がfull-parameter tuningするよりも向上することが示されている。この例は数学に特化した例ではないが、SFTによって解法の多様性が減ることによって学習データに過剰適合して汎化性能が低下する、というのであれば、この論文のことを鑑みると「学習データにoverfittingした結果他のデータセットで性能が低下してしまう程度の多様性の学習データしか使えていないのでは」と感じてしまうのだが、その辺はどうなんだろうか。元論文を読んで確認したい。
とても勉強になった。
記事中で紹介されている
> LLMを使って複数解法の候補をサンプリングし、その中から最適な1つを選択する
のルーツは
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
とのことなので是非読みたい。
この辺はSelf-Consistency
- [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
あたりが最初なのかと思っていた。
Stanford CS229 I Machine Learning I Building Large Language Models (LLMs), StanfordUnivercity, 2024.09
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Video #One-Line Notes Issue Date: 2024-12-25 Comment
スタンフォード大学によるLLM構築に関する講義。事前学習と事後学習両方ともカバーしているらしい。
Cross-prompt Pre-finetuning of Language Models for Short Answer Scoring, Funayama+, 2024.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #AES(AutomatedEssayScoring) #Surface-level Notes Issue Date: 2024-11-28 Comment
SASでは回答データが限られているので、限られたデータからより効果的に学習をするために、事前に他のデータでモデルをpre-finetuningしておき、対象データが来たらpre-finetuningされたモデルをさらにfinetuningするアプローチを提案。ここで、prompt中にkeyphraseを含めることが有用であると考え、実験的に有効性を示している。
BERTでfinetuningをした場合は、key-phraseを含めた方が性能が高く、特にfinetuningのサンプル数が小さい場合にその差が顕著であった。
次に、LLM(swallow-8B, 70B)をpre-finetuningし、pre-finetuningを実施しない場合と比較することで、pre-finetuningがLLMのzero-shot、およびICL能力にどの程度影響を与えるかを検証した。検証の結果、pre-finetuningなしでは、そもそも10-shotにしてもQWKが非常に低かったのに対し、pre-finetuningによってzero-shotの能力が大幅に性能が向上した。一方、few-shotについては3-shotで性能が頭打ちになっているようにみえる。ここで、Table1のLLMでは、ターゲットとする問題のpromptでは一切finetuningされていないことに注意する(Unseenな問題)。
続いて、LLMをfinetuningした場合も検証。提案手法が高い性能を示し、200サンプル程度ある場合にHuman Scoreを上回っている(しかもBERTは200サンプルでサチったが、LLMはまだサチっていないように見える)。また、サンプル数がより小さい場合に、提案手法がより高いgainを得ていることがわかる。
また、個々の問題ごとにLLMをfinetuningするのは現実的に困難なので、個々の問題ごとにfinetuningした場合と、全ての問題をまとめてfinetuningした場合の性能差を比較したところ、まとめて学習しても性能は低下しない、どころか21問中18問で性能が向上した(LLMのマルチタスク学習の能力のおかげ)。
[Perplexity(hallucinationに注意)]( https://www.perplexity.ai/search/tian-fu-sitalun-wen-wodu-mi-ne-3_TrRyxTQJ.2Bm2fJLqvTQ#0)
microsoft_orca-agentinstruct-1M-v1, Microsoft, 2024.11
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #InstructionTuning Issue Date: 2024-11-16
ZeRO: DeepSpeedの紹介, レトリバ, 2021.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #One-Line Notes #Reference Collection Issue Date: 2024-11-07 Comment
ZeROの説明がわかりやすい
こちらの記事もわかりやすい
https://zenn.dev/turing_motors/articles/d00c46a79dc976
DeepSpeedのコンフィグの一覧
https://www.deepspeed.ai/docs/config-json/
transformersにおけるdeepspeedのドキュメント:
https://huggingface.co/transformers/v4.9.2/main_classes/deepspeed.html
参考: deepspeedの使い方まとめ
https://note.com/fukudawataru/n/n5152e6f587c8
ZeRO Stage3を使う場合、ページ後方にしれっととんでもなく重要なことが書いてあるので気をつけましょう。。。。
https://huggingface.co/docs/transformers/v4.17.0/en/main_classes/deepspeed#constructing-massive-models
ZeROはparameterとoptimizerのmemory footprintの最適化を頑張っていて、activation memory footprint(バッチをforward passに流す時に消費されるメモリ)の削減は、tiling, activation/gradient checkpointingとかで頑張ってねという
という話が本家issueの4047に記載されている。
結論: つまづいたらDeepSpeedのIssueをエラーメッセージで検索かけるのが一番効果的
Unsloth, unslothai, 2024.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #InstructionTuning #PEFT(Adaptor/LoRA) #PostTraining #Selected Papers/Blogs #One-Line Notes #TrainingFramework Issue Date: 2024-10-08 Comment
single-GPUで、LLMのLoRA/QLoRAを高速/省メモリに実行できるライブラリ
現在でも鉄板
Liger-Kernel, 2024.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Repository #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-08-25 Comment
LLMを学習する時に、ワンライン追加するだけで、マルチGPUトレーニングのスループットを20%改善し、メモリ使用量を60%削減するらしい
元ツイート:
Unsloth Unsloth, unslothai, 2024.07
はLoRA/QLoRAが可能な一方でまだMulti-GPUはサポートしていない。一方、Liger-KernelはLoRAよりもfull-parameter tuningとMulti-GPUにフォーカスしており、目的に応じて使い分けが必要。
https://github.com/linkedin/Liger-Kernel/issues/57
PLaMo-100B, PFN, 2024.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SyntheticData #Blog #Proprietary #Japanese #DPO #ModelMerge #KeyPoint Notes Issue Date: 2024-08-08 Comment
日本語のベンチマークでGPT4を超える性能を達成。
SFT, DPOで学習。学習データは、Publicなもの、プログラムで作成したもの、LLM自身に作成させたものを利用した。また、最終的なモデルに複数の候補があったのでモデルマージで良いところ取りをした。DPOで利用するpreferenceデータは、事後学習途中のモデルによって自動生成。
The End of Finetuning — with Jeremy Howard of Fast.ai, 2023.11
Paper/Blog Link My Issue
#Article #Pretraining #Blog Issue Date: 2024-04-26
Practical Tips for Finetuning LLMs Using LoRA (Low-Rank Adaptation), SEBASTIAN RASCHKA, PHD, 2023.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Blog #PEFT(Adaptor/LoRA) #PostTraining Issue Date: 2023-11-20
LLaMA-Factory, hiyouga, 2023.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #PostTraining #One-Line Notes #TrainingFramework Issue Date: 2023-11-14 Comment
簡単に利用できるLLaMAのfinetuning frameworkとのこと。
元ツイート:
LLaMAベースなモデルなら色々対応している模様
大規模言語モデルのFine-tuningによるドメイン知識獲得の検討, PFN Blog, 2023.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Blog #PEFT(Adaptor/LoRA) #Catastrophic Forgetting Issue Date: 2023-10-29
LLMのファインチューニング で 何ができて 何ができないのか, npaka, 2023.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Blog #mid-training #PostTraining #needs-revision Issue Date: 2023-08-29 Comment
>LLMのファインチューニングは、「形式」の学習は効果的ですが、「事実」の学習は不得意です。
> シェイクスピアの脚本のデータセット (tiny-shakespeare) の
「ロミオ」を「ボブ」に置き換えてファインチューニングして、新モデルの頭の中では「ロミオ」と「ボブ」をどう記憶しているかを確認します。
ファインチューニングしても、Bで始まるジュリエットが恋する人物について質問しても、ボブと答えてはくれない。
> ロミオ」は「ジュリエット」が恋していたこの男性に関連付けられており、「ロミオ」を「ボブ」に置き換えるファインチューニングでは、ニューラルネットワークの知識ベースを変更することはできませんでした。
なるほど。
参考: https://www.anyscale.com/blog/fine-tuning-is-for-form-not-facts?ref=blog.langchain.dev
関連:
trl_trlx
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Alignment #ReinforcementLearning #PostTraining #One-Line Notes #Reference Collection #needs-revision #TrainingFramework Issue Date: 2023-07-23 Comment
関連:
- TRL - 強化学習によるLLMの学習のためのライブラリ, npaka, 2023.06
-
https://note.com/npaka/n/nbb974324d6e1
関連:
- trlを使って日本語LLMをSFTからRLHFまで一通り学習させてみる, AI SHIFT, 2023.07
-
https://www.ai-shift.co.jp/techblog/3583
Examples of using peft with trl to finetune 8-bit models with Low Rank Adaption (LoRA) , TRL Documentation
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Quantization #PEFT(Adaptor/LoRA) #PostTraining #One-Line Notes Issue Date: 2023-07-22 Comment
LLaMA2を3行で、1つのA100GPU、QLoRAで、自前のデータセットで訓練する方法
Auto train advanced, HuggingFace, 2023.07
Paper/Blog Link My Issue
#Article #MachineLearning #Tools #LanguageModel #Blog #Repository #PEFT(Adaptor/LoRA) #One-Line Notes #needs-revision #TrainingFramework Issue Date: 2023-07-11 Comment
Hugging Face Hub上の任意のLLMに対して、localのカスタムトレーニングデータを使ってfinetuningがワンラインでできる。
peftも使える。
現在はもうメンテナンスされていないようだ。
LM Flow, OptimalScale, 2023.06
Paper/Blog Link My Issue
#Article #MachineLearning #Tools #LanguageModel #FoundationModel #One-Line Notes #needs-revision #TrainingFramework Issue Date: 2023-06-26 Comment
一般的なFoundation Modelのファインチューニングと推論を簡素化する拡張可能なツールキット。継続的なpretragning, instruction tuning, parameter efficientなファインチューニング,alignment tuning,大規模モデルの推論などさまざまな機能をサポート。
Towards Complex Reasoning: the Polaris of Large Language Models, Yao Fu, 2023.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #ReinforcementLearning #Chain-of-Thought #Evaluation #Blog #Reasoning #mid-training #PostTraining Issue Date: 2023-05-04
LoRA論文解説, Hayato Tsukagoshi, 2023.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #LanguageModel #PEFT(Adaptor/LoRA) #Slide #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-04-25 Comment
ベースとなる事前学習モデルの一部の線形層の隣に、低ランク行列A,Bを導入し、A,Bのパラメータのみをfinetuningの対象とすることで、チューニングするパラメータ数を激減させた上で同等の予測性能を達成し、推論速度も変わらないようにするfinetuning手法の解説
LoRAを使うと、でかすぎるモデルだと、そもそもGPUに載らない問題や、ファインチューニング後のモデルファイルでかすぎワロタ問題が回避できる。
前者は事前学習済みモデルのBPのための勾配を保存しておく必要がなくなるため学習時にメモリ節約になる。後者はA,Bのパラメータだけ保存すればいいので、ストレージの節約になる。
かつ、学習速度が25%程度早くなる。
既存研究であるAdapter(transformerの中に学習可能なMLPを差し込む手法)は推論コストが増加し、prefix tuningは学習が非常に難しく、高い性能を達成するためにprefixとして128 token入れたりしなければならない。
huggingfaceがすでにLoRAを実装している
https://github.com/huggingface/peft
Publicly available instruction-tuned models
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reference Collection Issue Date: 2023-03-30