
Survey (247) — 2/2
RAG-Research-Insights
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #NLP #LanguageModel #RAG(RetrievalAugmentedGeneration) #Blog #Reading Reflections Issue Date: 2024-03-05 Comment
RAGに関する研究が直近のものまでよくまとめられている
What are the most important LLMs to know about in March 2024?
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Post #One-Line Notes Issue Date: 2024-03-04 Comment
2024年3月時点で知っておくべきLLMに関するスレッド
awesome-generative-information-retrieval
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #LanguageModel #Blog Issue Date: 2024-02-22
ML Papers Explained
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP Issue Date: 2023-11-22 Comment
以下の分野の代表的な論文がまとめられている(基本的にはTransformer登場後のものが多い)
- 言語モデル(Transformer, Elmoなど)
- Visionモデル(ViTなど)
- CNN(AlexNetなど)
- Single Stage Object Detectors
- Region-based Convolutional Neural Networks
- DocumentAI(TableNetなど)
- Layout Transformers
- Tabular Deeplearning
Data-to-Text Datasetまとめ, Akihiko Watanabe, 2022
Paper/Blog Link My Issue
#Article #NaturalLanguageGeneration #NLP #Dataset #DataToTextGeneration #Slide #One-Line Notes Issue Date: 2023-11-08 Comment
Data-to-Textのデータセットを自分用に調べていたのですが、せっかくなのでスライドにまとめてみました。特にMR-to-Text, Table-to-Textあたりは網羅的にサーベイし、データセットの概要を紹介しているので、全体像を把握するのに良いのかなぁと思います。ただし、2022年12月時点で作成したので2023年以後のデータセットは含まれていません😅
Zero-shot Learning網羅的サーベイ: CLIPが切り開いたVision & Languageの新しい世界, エクサウィザーズ Engineer Blog, 2023.05
Paper/Blog Link My Issue
#Article #ComputerVision #NaturalLanguageGeneration #NLP #LanguageModel #ImageCaptioning #DiffusionModel #Blog #Initial Impression Notes Issue Date: 2023-11-02 Comment
これはすごいまとめ…。まだ途中までしか読めていない。CLIPからスタートしてCLIPを引用している論文から重要なものを概要付きでまとめている。
[Paper Note] Instruction Tuning for Large Language Models: A Survey, Shengyu Zhang+, ACM Computing Surveys, Volume 58, Issue 7, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-09-05 GPT Summary- 指示調整(IT)に関する研究を総括し、LLMsの能力向上術を解説。ITは、(instruction, output)ペアを用いてLLMsを追加訓練し、人間の指示に従う能力を強化するプロセス。SFTの方法論、データセット構築、訓練、および応用を体系的にレビューし、成果に影響する要因を分析。さらに、SFTの課題や現行戦略の欠点を明らかにし、今後の研究の道筋を提案。 Comment
主要なモデルやデータセットの作り方など幅広くまとまっている(Figure1および各Table)
arxivに2023年8月に登場しその後も更新が続き、ACM Computing Surveys, Volume 58, Issue 7に2026年1月に掲載された模様
https://dl.acm.org/doi/10.1145/3777411
Anti-hype LLM Reading list, veekaybee, 2023.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #One-Line Notes Issue Date: 2023-08-27 Comment
LLMのサーベイ、BERT等の基盤モデルの論文、自前でLLMを学習するために必要な論文がコンパクトにまとめられたgist
人工知能研究の新潮流2 -基盤モデル・生成AIのインパクト-, 国立研究開発法人科学技術振興機構 研究開発戦略センター, 2023.07
Paper/Blog Link My Issue
#Article #LanguageModel #GenerativeAI #read-later #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-08-12 Comment
280ページにものぼる現在のトレンドをまとめた日本語資料
Awesome Multimodal LLMs
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #SpeechProcessing #One-Line Notes Issue Date: 2023-07-03 Comment
マルチモーダルなLLMのリストがまとめられている
Extending Context is Hard…but not Impossible, kaiokendev, 2023.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ContextWindow #One-Line Notes #needs-revision Issue Date: 2023-07-01 Comment
Open source LLMのcontext lengthをどのように大きくするかに関する議論
open LLM Leaderboard
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #One-Line Notes #needs-revision Issue Date: 2023-05-12 Comment
現在はアーカイブされている
awesome-generative-information-retrieval
Paper/Blog Link My Issue
#Article #RecommenderSystems #GenerativeAI #One-Line Notes #needs-revision Issue Date: 2023-05-10 Comment
Generativeなモデルを利用したDocument RetrievalやRecSys等についてまとまっているリポジトリ
LLM ecosystem graphs
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #One-Line Notes Issue Date: 2023-05-04 Comment
様々なfonudation model、それらを利用したアプリケーション、依存関係がまとまったページ
Percy Liang氏のグループが運用してるっぽい?
Measuring the impact of online personalisation: Past, present and future
Paper/Blog Link My Issue
#Article #RecommenderSystems #InformationRetrieval #Personalization #KeyPoint Notes #needs-revision Issue Date: 2023-04-28 Comment
Personalizationに関するML, RecSys, HCI, Personalized IRといったさまざまな分野の評価方法に関するSurvey
ML + RecSys系では、オフライン評価が主流であり、よりaccuracyの高い推薦が高いUXを実現するという前提に基づいて評価されてきた。一方HCIの分野ではaccuracyに特化しすぎるとUXの観点で不十分であることが指摘されており、たとえば既知のアイテムを推薦してしまったり、似たようなアイテムばかりが選択されユーザにとって有用ではなくなる、といったことが指摘されている。このため、ML, RecSys系の評価ではdiversity, novelty, serendipity, popularity, freshness等の新たなmetricが評価されるように変化してきた。また、accuracyの工場がUXの向上に必ずしもつながらないことが多くの研究で示されている。
一方、HCIやInformation Systems, Personalized IRはuser centricな実験が主流であり、personalizationは
- 情報アクセスに対するコストの最小化
- UXの改善
- コンピュータデバイスをより効率的に利用できるようにする
という3点を実現するための手段として捉えられている。HCIの分野では、personalizationの認知的な側面についても研究されてきた。
たとえば、ユーザは自己言及的なメッセージやrelevantなコンテンツが提示される場合、両方の状況においてpersonalizationされたと認知し、後から思い出せるのはrelevantなコンテンツに関することだという研究成果が出ている。このことから、自己言及的なメッセージングでユーザをstimulusすることも大事だが、relevantなコンテンツをきちんと提示することが重要であることが示されている。また、personalizationされたとユーザが認知するのは、必ずしもpersonalizationのプロセスに依存するのではなく、結局のところユーザが期待したメッセージを受け取ったか否かに帰結することも示されている。
user-centricな評価とオフライン評価の間にも不一致が見つかっている。たとえば
- オフラインで高い精度を持つアルゴリズムはニッチな推薦を隠している
- i.e. popularityが高くrelevantな推薦した方がシステムの精度としては高く出るため
- オフライン vs. オンラインの比較で、ユーザがアルゴリズムの精度に対して異なる順位付けをする
といったことが知られている。
そのほかにも、企業ではofflineテスト -> betaテスターによるexploratoryなテスト -> A/Bテストといった流れになることが多く、Cognitive Scienceの分野の評価方法等にも触れている。
User Profiles for Personalized Information Access, Gauch+, The adaptive Web: methods and strategies of Web personalization, 2007
Paper/Blog Link My Issue
#Article #InformationRetrieval #Personalization #One-Line Notes Issue Date: 2023-04-28 Comment
IR分野におけるuser profileの構築方法についてまとめられたsurvey
- 加重キーワード
- セマンティックネットワーク
- 加重コンセプト
について記述されている。また、プロファイルの構築方法についても詳述されている。
Awesome Vector Search Engine
Paper/Blog Link My Issue
#Article #Embeddings #InformationRetrieval #Search #Library #Repository #One-Line Notes Issue Date: 2023-04-27 Comment
ベクトルの類似度を測るサービスやライブラリ等がまとまったリポジトリ
大規模言語モデル間の性能比較まとめ, mah_lab _ 西見 公宏, 2023.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #One-Line Notes Issue Date: 2023-04-27 Comment
参考になる
現状だと研究用であればllama, 商用利用ならtext-davinci-003あるいはFlanT5-xxlあたりになりそう
LLM Worksheet:
https://docs.google.com/spreadsheets/d/1kT4or6b0Fedd-W_jMwYpb63e1ZR3aePczz3zlbJW-Y4/edit#gid=0
30分で完全理解するTransformerの世界, はまなすなぎさ, Zenn, 2023.02
Paper/Blog Link My Issue
#Article #Tutorial #NLP #Transformer Issue Date: 2023-02-14 Comment
非常に詳細で実質日本語のサーベイ論文のようなもの
A Paper List for Recommend-system PreTrained Models
Paper/Blog Link My Issue
#Article #RecommenderSystems #Pretraining #LanguageModel #pretrained-LM #Encoder #Decoder Issue Date: 2022-12-01
2010年代前半のAIの巨人達のCTR Prediction研究
Paper/Blog Link My Issue
#Article #RecommenderSystems #CTRPrediction #Reference Collection Issue Date: 2021-10-29
[Paper Note] Pre-Trained Models: Past, Present and Future, Xu Han+, AI Open‘21, 2021.06
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP Issue Date: 2021-06-17 GPT Summary- 大規模事前学習モデル(PTMs)、特にBERTやGPTは、AI分野での重要な進展を示しており、豊富な知識をタスクに応じてファインチューニングすることで下流タスクに貢献しています。本論文では、PTMsの歴史や転移学習との関係を考察し、計算能力の向上やデータの増加に基づく最新のブレークスルーをレビューします。また、PTMsに関する未解決の問題や今後の研究方向についても議論し、将来の研究の進展を促すことを目指しています。
Student Performance Prediction _ Knowledge Tracing Dataset
Paper/Blog Link My Issue
#Article #Dataset #EducationalDataMining #LearningAnalytics #StudentPerformancePrediction #KnowledgeTracing Issue Date: 2021-05-29
MLP-like Architecture
Paper/Blog Link My Issue
#Article #NeuralNetwork #ComputerVision #NLP #KeyPoint Notes #Reference Collection Issue Date: 2021-05-19 Comment
gMLP:大規模なself-attentionが無いSpatial Gating Unitを搭載したシンプルなMLPでも、Transformerの性能に近づけたよ(特にCV)。つまり、self-attentionはessentialというわけではなさそうだよ。
NLPの場合はgMLPだとTransformerとperplexityでcomparable、一部downstreamタスクだと勝てなかったけど、single headのtiny attentionを追加したら、TransformerをperplexityとGLUEの一部タスクでoutperformしたよ。
つまり、Transformerみたいに大規模なself-attentionは必須ではなく、小規模のattentionで(cross sentenceの関係性を捉えるには)十分だよ。
スケーラビリティもTransformerを上回ったよ。
って感じ?
んーTransformerに勝ったみたいな言い方をSNSだと見かけるけど、評価してるタスクが少ないし、どちらかというとcomparableなdownstreamタスクが多いし、それは言い過ぎでは?
この論文が言いたいのは、大規模なself-attentionが性能を出す上でessentialなわけではないよ、ってことであり、
・CVの場合はself-attentionは必須ではない
・NLPでは、tiny attentionでも十分
という感じなのでは。
まあでもTransformerとcomparableなら、Transformer一強では無くなったよね
Spatial Gating Unit(SGU)は、トークン間の関係性を捉えるためのゲートで、SGUが無いとgMLPブロックはただの二層のFFNとなる。
SGUは、入力をspatial dimensionに対して線形変換した値と、元の入力のelement-wiseな積で表現する。この線形変換をする際は、Wの値を0の近傍で初期化し、バイアス項を1に初期化することがクリティカルだった。これは、学習の初めでは線形変換はidentical mappingに近いものとなるため、gMLPブロックはFFNに近いものとなる。これが学習が進むにつれWの重みが調整され、cross tokenの関係性を捉えたブロックへと徐々に変化していくことになる。
また、SGUへの入力はGLUのようにchannel dimensionに二分割し、片方をelement-wise積に、もう一方をspatialな線形変換に利用する(4種類試した中で一番性能が良かった)。
[Paper Note] Sequence-Aware Recommender Systems, Massimo Quadrana+, ACM Computing Surveys (CSUR), Volume 51, Issue 4, 2018.02
Paper/Blog Link My Issue
#Article #RecommenderSystems #SequentialRecommendation #Reading Reflections Issue Date: 2020-11-13 GPT Summary- レコメンドシステムは、機械学習を用いた成功したデータマイニングの応用であり、従来は単一のユーザー-アイテムインタラクションに基づいていましたが、実際のアプリケーションでは時間とともに多様なインタラクションが記録されます。本研究は、これらの逐次的なインタラクションを考慮した推薦プロセスに関する既存研究を概観し、関連するタスクと目標の分類を提案。さらに、シーケンス情報を利用したレコメンダーシステムのベンチマーク方法論と未解決の課題について議論します。 Comment
評価方法の議論が非常に参考になる。特に、Survey執筆時点において、コミュニティの中でデータ分割方法について標準化されたものがないといった話は参考になる。
10 ML & NLP Research Highlights of 2019, Sebastian Ruder, 2020.01
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #Blog Issue Date: 2020-01-13
事前学習言語モデルの動向 _ Survey of Pretrained Language Models, Kyosuke Nishida, 2019
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #LanguageModel #Slide #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2019-11-09 Comment
[2019/06まで]
・ELMo(双方向2層LSTM言語モデル)
・GPT(left-to-rightの12層Transformer自己回帰言語モデル)
・BERT(24層のTransformer双方向言語モデル)
・MT-DNN(BERTの上にマルチタスク層を追加した研究)
・XLM(パラレル翻訳コーパスを用いてクロスリンガルに穴埋めを学習)
・TransformerXL(系列長いに制限のあった既存モデルにセグメントレベルの再帰を導入し長い系列を扱えるように)
・GPT-2(48層Transformerの自己回帰言語モデル)
・ERNIE 1.0(Baidu, エンティティとフレーズの外部知識を使ってマスクに利用)
・ERNIE(Tsinghua, 知識グラフの情報をfusionしたLM)
・Glover(ドメイン、日付、著者などを条件とした生成を可能としたGPT)
・MASS(Encoder-Decoder型の生成モデルのための事前学習)
・UniLM(Sequence-to-Sequenceを可能にした言語モデル)
・XLNet(自己回帰(単方向)モデルと双方向モデルの両方の利点を得ることを目指す)
[2019/07~]
・SpanBERT(i.i.dではなく範囲でマスクし、同時に範囲の境界も予測する)
・ERNIE 2.0(Baidu, マルチタスク事前学習; 単語レベル・構造レベル・意味レベル)
・RoBERTa(BERTと同じ構造で工夫を加えることで性能向上)
- より大きなバッチサイズを使う(256から8192)
- より多くのデータを使う(16GBから160GB)
- より長いステップ数の学習をする(BERT換算で16倍)
- 次文予測(NSP)は不要
→ GLUEでBERT, XLNetをoutperform
・StructBERT (ALICE, NSPに代わる学習の目的関数を工夫)
- マスクした上で単語の順番をシャッフルし元に戻す
- ランダム・正順・逆順の3種類を分類
→ BERTと同サイズ、同データでBERT, RoBERTa超え
・DistilBERT(蒸留により、12層BERTを6層に小型化(40%減))
- BERTの出力を教師として、生徒が同じ出力を出すように学習
- 幅(隠れ層)サイズを減らすと、層数を経あrスよりも悪化
→ 推論は60%高速化、精度は95%程度を保持
・Q8BERT(精度を落とさずにfine-tuning時にBERTを8bit整数に量子化)
- Embedding, FCは8bit化、softmax, LNorm, GELUは32bitをキープ
→ モデルサイズ1/4, 速度3.7倍
・CTRL(条件付き言語モデル)
- 条件となる制御テキストを本文の前に与えて学習
- 48層/1280次元Transformer(パラメータ数1.6B)
・MegatronLM(72層、隠れ状態サイズ3072、長さ1024; BERTの24倍サイズ)
・ALBERT(BERTの層のパラメータをすべて共有することで学習を高速化; 2020年あたりのデファクト)
- Largeを超えたモデルは学習が難しいため、表現は落ちるが学習しやすくした
- 単語埋め込みを低次元にすることでパラメータ数削減
- 次文予測を、文の順序入れ替え判定に変更
→ GLUE, RACE, SQuADでSoTAを更新
・T5(NLPタスクをすべてtext-to-textとして扱い、Enc-Dec Transformerを745GBコーパスで事前学習して転移する)
- モデルはEncoder-DecoderのTransformer
- 学習タスクをエンコーダ・デコーダに合わせて変更
- エンコーダ側で範囲を欠落させて、デコーダ側で予測
→ GLUE, SuperGLUE, SQuAD1.1, CNN/DMでSoTA更新
・BART(Seq2Seqの事前学習として、トークンマスク・削除、範囲マスク、文の入れ替え、文書の回転の複数タスクで学習)
→ CNN/DMでT5超え、WMT'16 RO-ENで逆翻訳を超えてSoTA
ELMo, GPT, BERT, GPT-2, XLNet, RoBERTa, DistilBERT, ALBERT, T5あたりは良く見るような感
各データセットでの各モデルの性能も後半に記載されており興味深い。
ちなみに、CNN/DailyMail Datasetでは、T5, BARTあたりがSoTA。
R2で比較すると
- Pointer-Generator + Coverage Vectorが17,28
- LEAD-3が17.62
- BARTが21.28
- T5が21.55
となっている
NLP-Progress
Paper/Blog Link My Issue
#Article #Tutorial #Dataset #One-Line Notes Issue Date: 2019-02-12 Comment
NLPの様々なタスクのデータセット, およびSOTA(2018年時点)がまとめられている。
Educational Data Mining and Learning Analytics, Baker+, 2014
Paper/Blog Link My Issue
#Article #AdaptiveLearning #EducationalDataMining #LearningAnalytics #Selected Papers/Blogs Issue Date: 2018-12-22 Comment
Ryan BakerらによるEDM Survey
[Paper Note] Recommender Systems for Technology Enhanced Learning: Research Trends and Applications, Manouselis+, 2014.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #TechnologyEnhancedLearning #AdaptiveLearning #One-Line Notes Issue Date: 2018-12-22 Comment
最近のトレンドやアプリケーションを知りたい場合はこちら
[Paper Note] Panorama of recommender systems to support learning, Drachsler+, 2015.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #Education #AdaptiveLearning #One-Line Notes Issue Date: 2018-12-22 Comment
教育分野に対するRecsysのSurvey
[Paper Note] Recommender Systems in Technology Enhanced Learning, Manouselis+, Recommender Systems Handbook, 2011.10
Paper/Blog Link My Issue
#Article #RecommenderSystems #Education #TechnologyEnhancedLearning #AdaptiveLearning Issue Date: 2018-12-22
[Paper Note] Personal recommender systems for learners in lifelong learning networks: the requirements, techniques and model, Drachsler+, Int. J. Learning Technology 3(4), 2008.07
Paper/Blog Link My Issue
#Article #RecommenderSystems #Education #AdaptiveLearning Issue Date: 2018-12-22
[Paper Note] Recommender Systems in Technology Enhanced Learning, Manouselis+, Recommender Systems Handbook: A Complete Guide for Research Scientists and Practitioners, 2011.10
Paper/Blog Link My Issue
#Article #RecommenderSystems #Education #TechnologyEnhancedLearning Issue Date: 2018-03-30
[Paper Note] Context-Aware Recommender Systems for Learning: A Survey and Future Challenges, Verbert+, IEEE TRANSACTIONS ON LEARNING TECHNOLOGIES, VOL. 5, NO. 4, OCTOBER-DECEMBER 2012.04
Paper/Blog Link My Issue
#Article #RecommenderSystems #Education #TechnologyEnhancedLearning Issue Date: 2018-03-30
[Paper Note] Opinion mining and sentiment analysis, Pang+, Foundations and Trends in Information Retrieval, 2008.01
Paper/Blog Link My Issue
#Article #InformationRetrieval #SentimentAnalysis #NLP #OpinionMining Issue Date: 2018-01-15
[Paper Note] Evaluating implicit measures to improve web search, Fox+, ACM Transactions on Imformation Systems, 2005.04
Paper/Blog Link My Issue
#Article #InformationRetrieval #RelevanceFeedback #ImplicitFeedback Issue Date: 2018-01-01
[Paper Note] A survey on the use of relevance feedback for information access systems., Ruthven+, The Knowledge Engineering Review, 2003.06
Paper/Blog Link My Issue
#Article #InformationRetrieval #RelevanceFeedback #ExplicitFeedback Issue Date: 2018-01-01
Fast and Reliable Online Learning to Rank for Information Retrieeval, Katja Hofmann, Doctoral Thesis, 2013.04
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #LearningToRank #Online/Interactive Issue Date: 2018-01-01
[Paper Note] Learning to Rank for Information Retriefval, Tie-Yan Liu, 2009.03
Paper/Blog Link My Issue
#Article #InformationRetrieval #LearningToRank Issue Date: 2018-01-01
[Paper Note] 利用者の好みをとらえ活かす-嗜好抽出技術の最前線, 土方嘉徳, 2007.09
Paper/Blog Link My Issue
#Article #RecommenderSystems Issue Date: 2018-01-01
推薦システムのアルゴリズム, 神嶌, 2016.09
Paper/Blog Link My Issue
#Article #RecommenderSystems #Selected Papers/Blogs Issue Date: 2018-01-01
[Paper Note] A Survey on Challenges and Methods in News Recommendation, O¨zgo¨bek+, 2014.01
Paper/Blog Link My Issue
#Article #RecommenderSystems Issue Date: 2018-01-01
[Paper Note] A Survey and Critique of Deep Learning on Recommender Systems, Lei Zheng
Paper/Blog Link My Issue
#Article #RecommenderSystems Issue Date: 2018-01-01
A survey on Automatic Text Summarization, Das+, 2007.11
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP Issue Date: 2017-12-31
[Paper Note] Artificial neural networks in business: Two decades of research, Tkac+, Applied Soft Computing 2016.01
Paper/Blog Link My Issue
#Article #NeuralNetwork #TimeSeriesDataProcessing #One-Line Notes Issue Date: 2017-12-31 Comment
ビジネスドメイン(e.g. Stock market price prediction)におけるニューラルネットワークの活用事例をまとめたSurvey。
時系列データの取り扱いなどの参考になるかも。
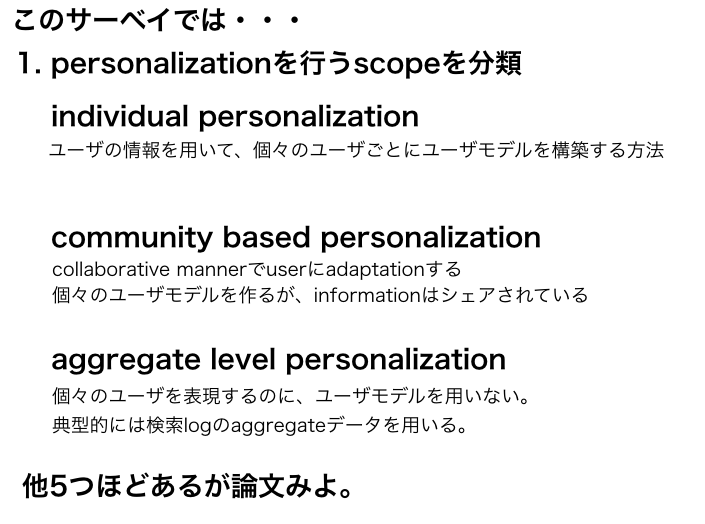
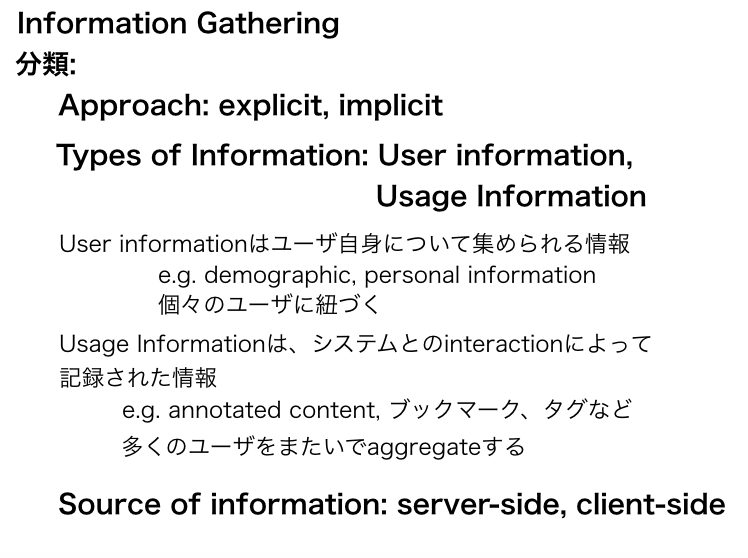
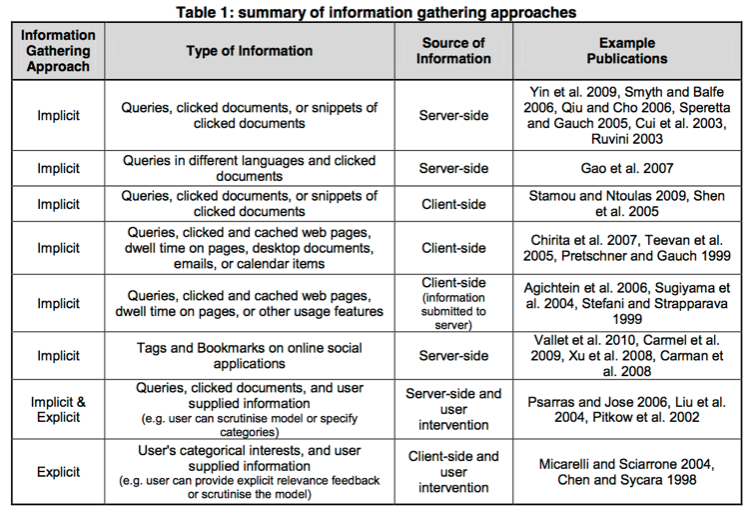
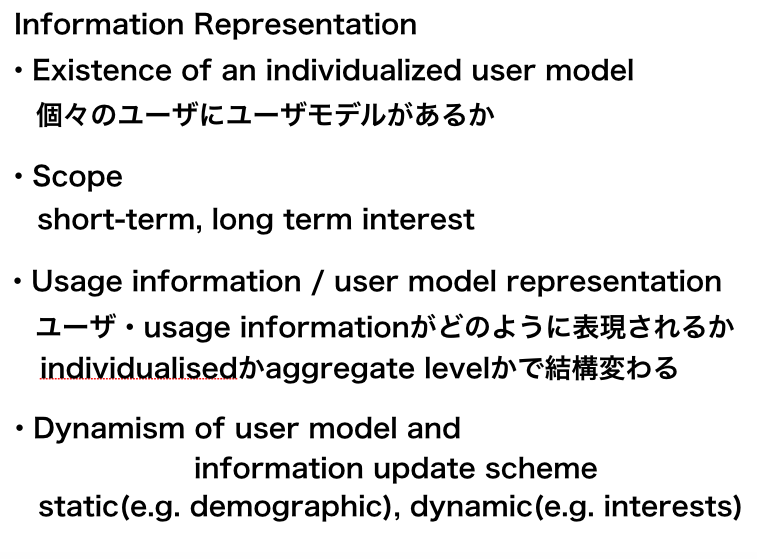
[Paper Note] Personalised Information retrieval: survey and classification, Rami+, User Modeling and User-Adapted Interaction, 2012.05
Paper/Blog Link My Issue
#Article #InformationRetrieval #Personalization #KeyPoint Notes Issue Date: 2017-12-28 Comment
(以下は管理人が当時作成したスライドでのメモのスクショ)
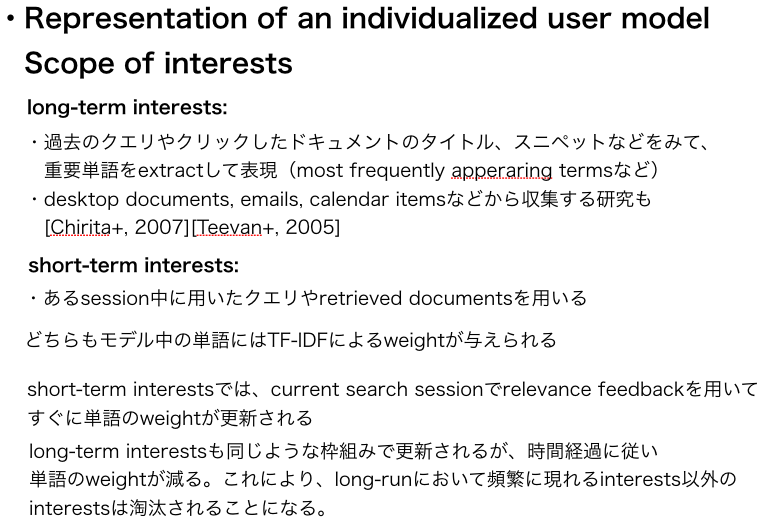
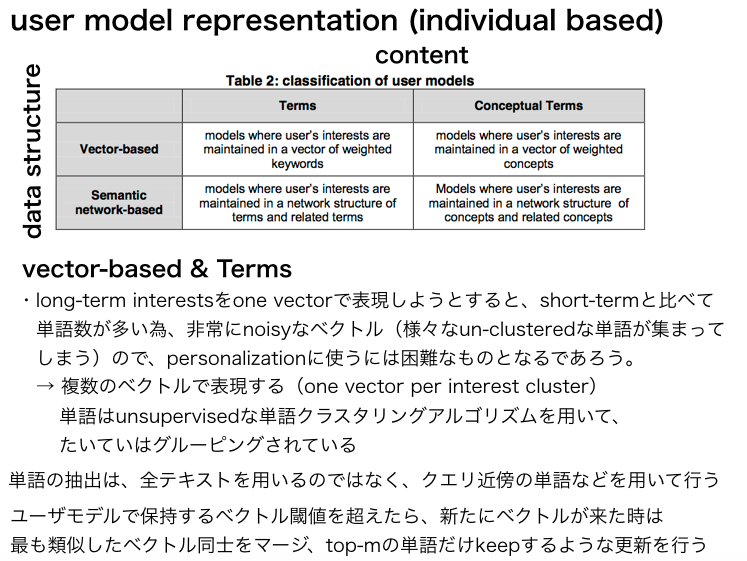
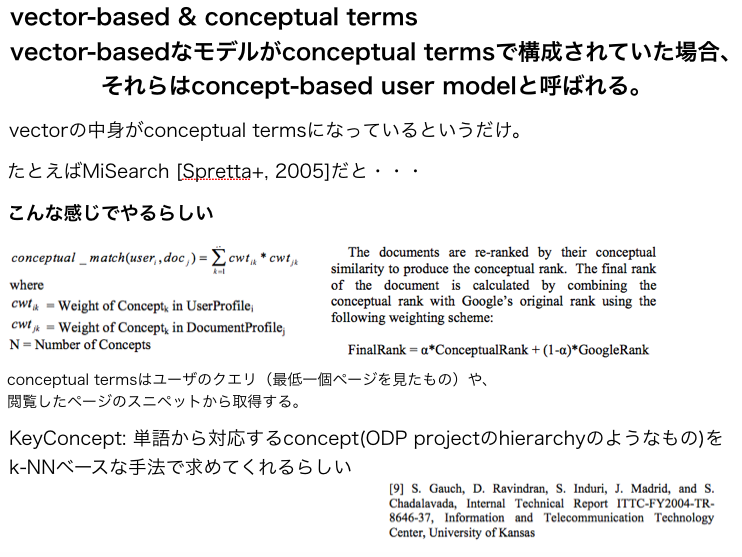
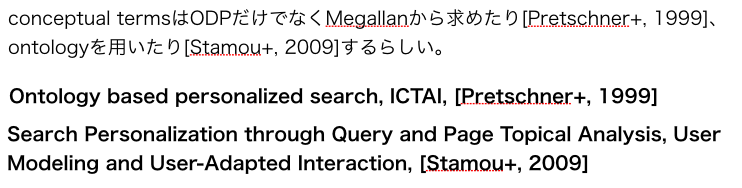
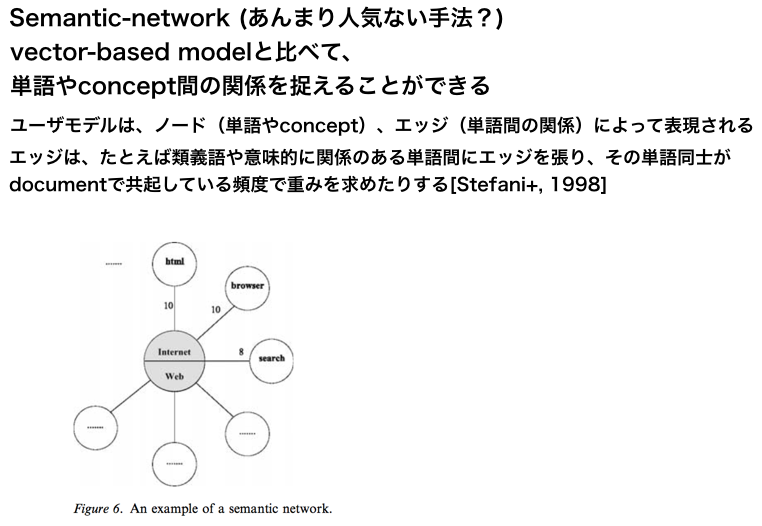
完全に途中で力尽きている感