
ComputerVision (930) — 4/5
[Paper Note] EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks, Mingxing Tan+, ICML'19
Paper/Blog Link My Issue
#NeuralNetwork #EfficiencyImprovement #ICML #Selected Papers/Blogs #Backbone Issue Date: 2025-05-12 GPT Summary- 本論文では、ConvNetsのスケーリングを深さ、幅、解像度のバランスを考慮して体系的に研究し、新しいスケーリング手法を提案。これにより、MobileNetsやResNetのスケールアップを実証し、EfficientNetsという新しいモデルファミリーを設計。特にEfficientNet-B7は、ImageNetで84.3%のトップ1精度を達成し、従来のConvNetsよりも小型かつ高速である。CIFAR-100やFlowersなどのデータセットでも最先端の精度を記録。ソースコードは公開されている。 Comment
元論文をメモってなかったので追加。
- EfficientNet解説, omiita (オミータ), 2019.10
も参照のこと。
On Empirical Comparisons of Optimizers for Deep Learning, Dami Choi+, N_A, arXiv'19
Paper/Blog Link My Issue
#NeuralNetwork #NLP #One-Line Notes Issue Date: 2021-06-15 GPT Summary- 深層学習のオプティマイザの比較は重要であり、ハイパーパラメータの探索空間が性能に影響することが示唆されている。特に、適応的勾配法は常に他のオプティマイザよりも性能が低下しないことが実験で示されており、ハイパーパラメータのチューニングに関する実用的なヒントも提供されている。 Comment
Adamが良いのだけど、学習率以外のハイパーパラメータをチューニングしないと本来のパフォーマンス発揮されないかもよ、という感じっぽい
ICLR 2020 Open Review: https://openreview.net/forum?id=HygrAR4tPS
[Paper Note] Unsupervised Representation Learning by Predicting Image Rotations, Spyros Gidaris+, arXiv'18, 2018.03
Paper/Blog Link My Issue
#NeuralNetwork #DataAugmentation #Self-SupervisedLearning #One-Line Notes #ConvolutionalModels Issue Date: 2026-08-30 GPT Summary- ConvNetsを用いて2D回転を認識することで、非監視での意味的特徴学習を提案。これにより、手動ラベルが不要な強力な監督信号を提供し、さまざまなベンチマークで最先端の性能を達成。特に、PASCAL VOC 2007検出タスクでは54.4%のmAPを記録し、教師あり学習との差を縮小。特徴を他のタスクに転移させても顕著な成果を示す。コードとモデルは公開中。 Comment
元ポスト:
画像Xが与えられた時に、geometric transformation(e.g., 90/180/270度回転等)を適用した画像をX^yとする。X^yが与えられた時に、どのようなgeometric transformation y^* が適用されたかを予測するConvNet F(X^y* | theta) を学習するシンプルなSSL手法。
objectに対するコンセプトが学習されていなければ、rotationが適用された画像の認識ができないであろう、という直感に基づいたSSL手法のようである(Figure 1)。
元ポストによるとこれは最近の様々なaugmentationされたデータに対して共通の表現を得る自己教師あり学習(下記)とは逆に、augmentationされた画像に依存した表現を学習することを目指いる点で異なっているとのことである。
- MoCo
- [Paper Note] Momentum Contrast for Unsupervised Visual Representation Learning, Kaiming He+, CVPR'20, 2019.11
- DINO
- [Paper Note] Emerging Properties in Self-Supervised Vision Transformers, Mathilde Caron+, ICCV'21, 2021.04
- SimCLR
- [Paper Note] A Simple Framework for Contrastive Learning of Visual Representations, Ting Chen+, ICML'20
[Paper Note] Stereo Magnification: Learning View Synthesis using Multiplane Images, Tinghui Zhou+, SIGGRAPH'18, 2018.05
Paper/Blog Link My Issue
#Dataset #Evaluation #SIGGRAPH Issue Date: 2025-11-20 GPT Summary- 視点合成問題において、狭ベースラインのステレオカメラから新しい視点を生成する手法を提案。マルチプレーン画像(MPI)を用いた学習フレームワークを構築し、YouTube動画をデータソースとして活用。これにより、入力画像ペアからMPIを予測し、従来の手法よりも優れた視点外挿を実現。 Comment
[Paper Note] Revisiting Small Batch Training for Deep Neural Networks, Dominic Masters+, arXiv'18
Paper/Blog Link My Issue
#NeuralNetwork #Analysis #MachineLearning #Batch Issue Date: 2025-07-12 GPT Summary- ミニバッチサイズが深層ニューラルネットワークのトレーニング性能に与える影響を実験的に比較。大きなミニバッチは計算の並列性を向上させるが、小さなミニバッチは一般化性能を高め、安定したトレーニングを実現。最良の性能はミニバッチサイズ$m = 2$から$m = 32$の範囲で得られ、数千のミニバッチサイズを推奨する研究とは対照的。 Comment
{Res, Reduced Alex}Netにおいて、バッチサイズを大きくすると、学習が安定しかつ高い予測性能を獲得できる学習率のrangeが小さくなる。一方、バッチサイズが小さいと有効な学習率のrangeが広い。また、バッチサイズが小さい場合は、勾配計算とパラメータのアップデートがより頻繁に行われる。このため、モデルの学習がより進んだ状態で個々のデータに対して勾配計算が行われるため、バッチサイズが大きい場合と比べるとモデルがより更新された状態で各データに対して勾配が計算されることになるため、学習が安定し良い汎化性能につながる、といった話の模様。
[Paper Note] Group Normalization, Yuxin Wu+, arXiv'18, 2018.03
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #Normalization #One-Line Notes Issue Date: 2025-04-02 GPT Summary- バッチ正規化(BN)はディープラーニングの重要な技術だが、小さなバッチサイズでの精度低下が課題。本研究では、グループ正規化(GN)を提案し、チャネルをグループに分けて正規化を行うことで、バッチサイズに依存しない安定した性能を実現。ImageNetでの実験では、GNが小バッチでも優れた精度を示し、他のタスクでもBNよりも性能を向上させることを確認。GNは実装も簡単で、さまざまなコンピュータビジョンタスクにおいてBNの有効な代替手段である。 Comment
BatchNormalizationはバッチサイズが小さいとうまくいかず、メモリの制約で大きなバッチサイズが設定できない場合に困るからバッチサイズに依存しないnormalizationを考えたよ。LayerNormとInstanceNormもバッチサイズに依存しないけど提案手法の方が画像系のタスクだと性能が良いよ、という話らしい。
各normalizationとの比較。分かりやすい。
[Paper Note] Neural Discrete Representation Learning, Aaron van den Oord+, NIPS'17, 2017.11
Paper/Blog Link My Issue
#Quantization #VariationalAutoEncoder #NeurIPS #Tokenizer #Selected Papers/Blogs #UMM Issue Date: 2025-12-11 GPT Summary- 教師なしでの有用な表現学習のために、生成モデルVQ-VAEを提案。VQ-VAEは、離散的なコードを出力し、学習された事前分布を持つ点でVAEと異なる。ベクトル量子化を用いることで、ポスティアコラプス問題を回避し、高品質な画像や音声生成、スピーカー変換を実現。 Comment
日本語解説:
-
https://qiita.com/nishiha/items/44de5c46ebdfe615f6e8
-
https://data-analytics.fun/2021/05/14/understanding-vq-vae/
[Paper Note] Tanks and temples: Benchmarking large-scale scene reconstruction, Knapitsch+, TOG'17
Paper/Blog Link My Issue
#Dataset #Evaluation #TOG Issue Date: 2025-11-20 GPT Summary- 画像ベースの3D再構築のための新しいベンチマークを提案。実際の条件下で取得された高解像度ビデオシーケンスを用い、産業用レーザースキャナーでキャプチャしたグラウンドトゥルースデータを含む。屋外と屋内のシーンを対象に、再構築の忠実度向上を目指す新しいパイプラインの開発を支援し、既存の3D再構築手法の性能を報告。結果は今後の研究の課題と機会を示唆。
[Paper Note] A Multi-view Stereo Benchmark with High-Resolution Images and Multi-camera Videos, Schöps+, CVPR'17
Paper/Blog Link My Issue
#Dataset #Evaluation #CVPR Issue Date: 2025-11-20 GPT Summary- 新しいマルチビュー立体視データセットを提案し、高精度のレーザースキャナーと低解像度のステレオビデオを用いて多様なシーンを記録。幾何学に基づく手法で画像とレーザースキャンを整合。従来のデータセットとは異なり、自然および人工環境をカバーし、高解像度のデータを提供。データセットは手持ちのモバイルデバイスの使用ケースにも対応し、オンライン評価サーバーで利用可能。
[Paper Note] ScanNet: Richly-annotated 3D Reconstructions of Indoor Scenes, Angela Dai+, CVPR'17, 2017.02
Paper/Blog Link My Issue
#Dataset #Evaluation #CVPR Issue Date: 2025-11-20 GPT Summary- 限られたRGB-Dシーン理解のために、1513シーンの2.5Mビューを含むScanNetデータセットを導入。自動表面再構築とクラウドソースによるセマンティックアノテーションを用いたキャプチャシステムを設計し、3Dオブジェクト分類やセマンティックボクセルラベリングで最先端のパフォーマンスを達成。データセットは無料で提供。
[Paper Note] Large Batch Training of Convolutional Networks, Yang You+, arXiv'17, 2017.08
Paper/Blog Link My Issue
#NeuralNetwork #Optimizer #One-Line Notes Issue Date: 2023-12-13 GPT Summary- 大規模畳み込みネットワークのトレーニングでは、計算ユニットを追加することで高速化を図るが、大きなバッチサイズはモデルの精度を低下させることがある。従来の線形学習率スケーリングは一般的ではなく、トレーニングの発散リスクがある。これを解決するために、Layer-wise Adaptive Rate Scaling(LARS)に基づく新しいアルゴリズムを提案し、AlexNetはバッチサイズ8K、ResNet-50は32Kまでの拡張でも精度を維持できることを示した。 Comment
BatchSizeを大きくすると性能が落ちますよ、系の話(CNN)
OpenReview:
https://openreview.net/forum?id=rJ4uaX2aW
ICLR'18にrejectされている
先行研究で提案よりも大きなバッチサイズを扱えるsynchronized SGDは強みだが、評価が一つのタスクのみなのでより増やした方がconvincingだということ、提案手法に追加のハイパーパラメータが必要な点が手法をless appealingにしてしまっていること、layer wise rate scailng (LARS)の理論的なjustificationが何か欲しいこと、先行研究との比較がクリアではないこと、などが理由な模様。
[Paper Note] Attend to You: Personalized Image Captioning with Context Sequence Memory Networks, Park+, CVPR'17
Paper/Blog Link My Issue
#NLP #CommentGeneration #CVPR #One-Line Notes Issue Date: 2019-09-27 Comment
画像が与えられたときに、その画像に対するHashtag predictionと、personalizedなpost generationを行うタスクを提案。
InstagramのPostの簡易化などに応用できる。
Postを生成するためには、自身の言葉で、画像についての説明や、contextといったことを説明しなければならず、image captioningをする際にPersonalization Issueが生じることを指摘。
official implementation: https://github.com/cesc-park/attend2u
[Paper Note] Multi-Task Video Captioning with Video and Entailment Generation, Ramakanth Pasunuru+, ACL'17, 2017.04
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #MultitaskLearning #ACL #Encoder-Decoder #3D (Video) #One-Line Notes #VideoCaptioning Issue Date: 2017-12-31 GPT Summary- ビデオキャプショニングの改善のため、教師なしビデオ予測タスクと論理的言語含意生成タスクを共有し、リッチなビデオエンコーダ表現を学習。パラメータを共有するマルチタスク学習モデルを提案し、標準データセットで大幅な改善を達成。 Comment
multitask learningで動画(かなり短め)のキャプション生成を行なった話
[Paper Note] Generative Adversarial Networks: An Overview, Antonia Creswell+, IEEE-SPM'17, 2017.10
Paper/Blog Link My Issue
#NeuralNetwork #Tutorial #GenerativeAdversarialNetwork Issue Date: 2017-12-28 GPT Summary- GANは、注釈なしのデータで深い表現を学習する手法で、競争プロセスを通じて逆伝播信号を導出します。画像合成やスタイル転送など多様な応用が可能です。本レビューは、信号処理コミュニティ向けにGANの概要を提供し、トレーニング方法や残された課題についても言及します。
[Paper Note] Large-Scale Data for Multiple-View Stereopsis, Aanæs+, IJCV'16
Paper/Blog Link My Issue
#Dataset #Evaluation #IJCV Issue Date: 2025-11-20
[Paper Note] Deep Residual Learning for Image Recognition, Kaiming He+, CVPR'16, 2015.12
Paper/Blog Link My Issue
#NeuralNetwork #CVPR #Selected Papers/Blogs #Backbone #KeyPoint Notes #ResidualStream #Reading Reflections Issue Date: 2021-11-04 GPT Summary- 残差学習フレームワークを提案し、深いニューラルネットワークのトレーニングを容易にする。参照層の入力に基づいて残差関数を学習することで、最適化が容易になり、精度が向上。152層の残差ネットはImageNetで低い複雑性を保ちながら高い性能を示し、ILSVRC 2015で1位を獲得。COCOデータセットでも28%の改善を達成。 Comment
ResNet論文
ResNetでは、レイヤーの計算する関数を、残差F(x)と恒等関数xの和として定義する。これにより、レイヤーが入力との差分だけを学習すれば良くなり、モデルを深くしても最適化がしやすくなる効果ぎある。数レイヤーごとにResidual Connectionを導入し、恒等関数によるショートカットができるようにしている。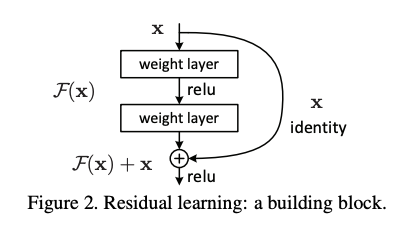
ResNetが提案される以前、モデルを深くすれば表現力が上がるはずなのに、実際には精度が下がってしまうことから、理論上レイヤーが恒等関数となるように初期化すれば、深いモデルでも浅いモデルと同等の表現が獲得できる、と言う考え方を発展させた。
(ステートオブAIガイドに基づく)
同じパラメータ数でより層を深くできる(Plainな構造と比べると層が1つ増える)Bottleneckアーキテクチャも提案している。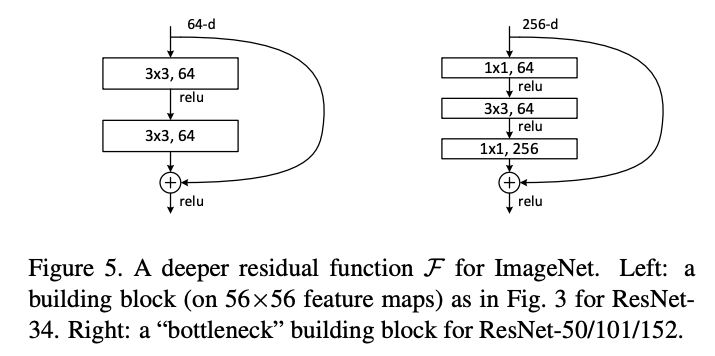
今や当たり前のように使われているResidual Connectionは、層の深いネットワークを学習するために必須の技術なのだと再認識。
[Paper Note] Generating Visual Explanations, Lisa Anne Hendricks+, CVPR'16, 2016.03
Paper/Blog Link My Issue
#NeuralNetwork #Visual Words #CVPR #One-Line Notes Issue Date: 2017-12-28 GPT Summary- 分類決定の説明は重要であり、既存の深層視覚認識アプローチは不透明である。新たに提案するモデルは、可視オブジェクトの識別特性に基づき、クラスラベルを予測し、その理由を説明する。サンプリングと強化学習に基づく新しい損失関数を用いて、グローバルな文の特性を実現する。実験結果は、提案モデルが一貫性のある識別的な説明を生成できることを示している。 Comment
画像そのものだけでなく、モデルへのInputにVisual Wordsを明示的に加えることで、captioningの精度が上がりましたという論文
[Paper Note] What value do explicit high level concepts have in vision to language problems?, Qi Wu+, CVPR'16
Paper/Blog Link My Issue
#NeuralNetwork #Visual Words #CVPR Issue Date: 2017-12-28 GPT Summary- CNN-RNNアプローチに高次の概念を組み込むことで、画像キャプショニングと視覚的質問応答の性能を向上。外部の意味情報を導入することでさらなる改善を実現し、V2L問題における高次の意味情報の重要性を分析。
[Paper Note] Generating Visual Explanations, Lisa Anne Hendricks+, ECCV'16, 2016.03
Paper/Blog Link My Issue
#NeuralNetwork #ECCV Issue Date: 2017-12-28 GPT Summary- 分類決定の説明は重要であり、既存の深層視覚認識は不透明である。本研究では、可視オブジェクトの識別特性に基づき、クラスラベルを予測し、その理由を説明する新モデルを提案。新しい損失関数を用いて、グローバルな文の特性を実現する。実験結果は、提案モデルがより識別的な説明を生成できることを示した。
[Paper Note] U-Net: Convolutional Networks for Biomedical Image Segmentation, Olaf Ronneberger+, MICCAI'15, 2015.05
Paper/Blog Link My Issue
#NeuralNetwork #Selected Papers/Blogs #Encoder-Decoder #Backbone #U-Net Issue Date: 2025-09-22 GPT Summary- データ拡張を活用した新しいネットワークアーキテクチャを提案し、少ない注釈付きサンプルからエンドツーエンドでトレーニング可能であることを示す。電子顕微鏡スタックの神経構造セグメンテーションで従来手法を上回り、透過光顕微鏡画像でも優れた結果を達成。512x512画像のセグメンテーションは1秒未満で完了。実装とトレーニング済みネットワークは公開されている。
[Paper Note] Very Deep Convolutional Networks for Large-Scale Image Recognition, Karen Simonyan+, ICLR'15
Paper/Blog Link My Issue
#NeuralNetwork #ICLR #Backbone Issue Date: 2025-08-25 GPT Summary- 本研究では、3x3の畳み込みフィルタを用いた深い畳み込みネットワークの精度向上を評価し、16-19層の重み層で従来の最先端構成を大幅に改善したことを示す。これにより、ImageNet Challenge 2014で1位と2位を獲得し、他のデータセットでも優れた一般化性能を示した。最も性能の良い2つのConvNetモデルを公開し、深層視覚表現の研究を促進する。 Comment
いわゆるVGGNetを提案した論文
[Paper Note] CIDEr: Consensus-based Image Description Evaluation, Ramakrishna Vedantam+, arXiv'14, 2014.11
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #NLP #Evaluation #ImageCaptioning #Reference-based #needs-revision Issue Date: 2023-05-10 GPT Summary- 画像説明の自動生成における新たな評価パラダイムを提案。人間の合意を測るトリプレット手法、合意を反映する新指標CIDEr、50文の説明を含むPASCAL-50SとABSTRACT-50Sデータセットを利用。新指標は既存のものより人間の合意を正確に捉え、最先端手法の評価に向けたベンチマークを提供。CIDEr-DはMS COCO評価サーバの一部として、体系的な評価を可能にする。
[Paper Note] Scene Coordinate Regression Forests for Camera Relocalization in RGB-D Images, Shotton+, CVPR'13
Paper/Blog Link My Issue
#Dataset #Evaluation #CVPR #CameraPoseEstimation Issue Date: 2025-11-20
[Paper Note] Scene Coordinate Regression Forests for Camera Relocalization in RGB-D Images,Shotton+, CVPR'13
Paper/Blog Link My Issue
#Dataset #Evaluation #CVPR Issue Date: 2025-11-20
[Paper Note] Indoor Segmentation and Support Inference from RGBD Images, Silberman+, ECCV'12
Paper/Blog Link My Issue
#Dataset #Evaluation #ECCV Issue Date: 2025-11-20 GPT Summary- RGBD画像を用いて、散らかった屋内シーンの主要な表面や物体、支持関係を解析するアプローチを提案。物理的相互作用を考慮し、3Dの手がかりが構造化された解釈に与える影響を探求。新たに1449のRGBD画像からなるデータセットを作成し、支持関係の推測能力を実験で検証。3D手がかりと推測された支持が物体セグメンテーションの向上に寄与することを示す。
[Paper Note] A naturalistic open source movie for optical flow evaluation, Butler+, ECCV'12
Paper/Blog Link My Issue
#Dataset #Evaluation #ECCV Issue Date: 2025-11-20 Comment
dataset: https://www.kaggle.com/datasets/artemmmtry/mpi-sintel-dataset
[Paper Note] ImageNet Classification with Deep Convolutional Neural Networks, Krizhevsky+, NIPS'12
Paper/Blog Link My Issue
#NeuralNetwork #NeurIPS #Selected Papers/Blogs #ImageClassification #Backbone #One-Line Notes Issue Date: 2025-05-13 Comment
ILSVRC 2012において圧倒的な性能示したことで現代のDeepLearningの火付け役となった研究AlexNet。メモってなかったので今更ながら追加した。
AlexNet以前の画像認識技術については牛久先生がまとめてくださっている(当時の課題とそれに対する解決法、しかしまだ課題が…と次々と課題に直面し解決していく様子が描かれており非常に興味深かった)。現在でも残っている技術も紹介されている。:
https://speakerdeck.com/yushiku/pre_alexnet
> 過去の技術だからといって聞き流していると時代背景の変化によってなし得たイノベーションを逃すかも
これは肝に銘じたい。
[Paper Note] ImageNet: A Large-Scale Hierarchical Image Database, Deng+, CVPR'09
Paper/Blog Link My Issue
#Dataset #Selected Papers/Blogs #ImageClassification #ObjectRecognition #ObjectLocalization Issue Date: 2025-05-13
Qwen4-Max: Your New Teammate Has Arrived, Qwen Team, 2026.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
How to Scale Text-to-image Models: a Handbook, Wenhao Chai, 2026.11
Paper/Blog Link My Issue
#Article #DiffusionModel #TextToImageGeneration #Blog #Scaling Laws #ImageSynthesis #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
SigLIP2に匹敵する画像エンコーダーをフルスクラッチで開発した話, Noetra Tech Blog, 2026.11
Paper/Blog Link My Issue
#Article #Blog #Japanese #read-later #Encoder #2D (Image) #Backbone Issue Date: 2026-11-07 Comment
元ポスト:
Speculation on an Architecture for Continual Learning, snimu's blog, 2026.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Blog #Architecture #VisionLanguageModel #Robotics #WorldModels #ContinualLearning #WorldActionModel Issue Date: 2026-11-05 Comment
元ポスト:
A world that learns as it goes, OpenWorld, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #GenerativeAI #Game #Author Thread-Post Issue Date: 2026-11-01 Comment
元ポスト:
Pika-H3-Flex, Pika-Labs, 2026.10
Paper/Blog Link My Issue
#Article #NLP #SpeechProcessing #OpenWeight #VideoGeneration/Understandings #3D (Video) #audio #TextToVideoGeneration Issue Date: 2026-10-31 Comment
github:
https://github.com/Pika-Labs/Pika-H3-Flex
diffusers:
https://huggingface.co/docs/diffusers/main/en/api/pipelines/pika_h3_flex
元ポスト:
OpenTTD-Bench, Sophia Xu, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Evaluation #VisionLanguageModel #Game #LongHorizon #Realtime #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト:
Gemini 4 Carbon: our next frontier model, Google, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Selected Papers/Blogs #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト:
こーれは強い。come backした
関係者ポスト2:
AA Indexでトップ:
Introducing HLE-Diamond, Center for AI Safety and Scale AI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #Blog #VisionLanguageModel #One-Line Notes #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト:
HLEを1年かけて洗練、cleaningした1000問のサブセットとのこと
関連:
- [Paper Note] Humanity's Last Exam, Long Phan+, arXiv'25, 2025.01
AA Index v5に組み込まれている:
現代AI入門: 大規模言語モデルから思考するシステムへ — Test-Time Scaling, Loop, Harness, RSI, Masafumi Oyamada, 2026.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #SelfImprovement #Slide #Test-Time Scaling #Scaling Laws #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #Overthinking #RecurrentModels #autoresearch/RSI #Author Thread-Post #AgentHarness Issue Date: 2026-10-28 Comment
元ポスト:
なんと楽しそうな資料🤩
MiniCPM-OCR-Jev, OpenBMB, 2026.10
Paper/Blog Link My Issue
#Article #NLP #SmallModel #OpenWeight #OCR #One-Line Notes #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-28 Comment
元ポスト:
元ポスト:
region imageと候補テキストを与えたときに、候補テキストがOCR認識結果としてどれだけ正しそうかを[0, 1]で返すSystemOne Model
MiniCPM-OCR-1.0, OpenBMB, 2026.10
Paper/Blog Link My Issue
#Article #NLP #SmallModel #OpenWeight #OCR #Author Thread-Post Issue Date: 2026-10-28 Comment
元ポスト:
元ポスト:
Introducing LFM3: Every Modality for Specialized Intelligence, Liquid AI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #SmallModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Omni #AudioLanguageModel #SystemOneModel/DecisionModel Issue Date: 2026-10-28 Comment
HF: https://huggingface.co/collections/LiquidAI/lfm3
元ポスト:
Genie 4: A new generation of world simulation, Google Deepmind, 2026.10
Paper/Blog Link My Issue
#Article #Blog #Proprietary #WorldModels #interactive Issue Date: 2026-10-28 Comment
元ポスト:
Introducing GPT-6.1-Terra, OpenAI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-28 Comment
元ポスト:
Krea3: Frontier Image Editing Model 4x faster than Nano Banana Pro, Krea, 2026.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #TextToImageGeneration #Blog #Proprietary #Editing #ImageSynthesis #Initial Impression Notes #Author Thread-Post Issue Date: 2026-10-25 Comment
元ポスト:
安い、速い、(パレート最適)、高性能(Arena4位)の画像生成、編集モデル。
Hy-Nomas, Tencent, 2026.10
Paper/Blog Link My Issue
#Article #Blog #OpenWeight #VideoGeneration/Understandings #WorldModels #interactive #Initial Impression Notes #Author Thread-Post Issue Date: 2026-10-25 Comment
元ポスト:
HF:
https://huggingface.co/tencent/Hy-Nomas
github:
https://github.com/Tencent-Hunyuan/Hy-Nomas
自由記述のテキストとカメラコントロールによるinteractiveな制御と、最大60sの生成をサポート
JST-2: Physics-Native World Foundation Model, ViGGLE, 2026.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Blog #Selected Papers/Blogs #3D (Scene) #Robotics #WorldModels #Realtime #Author Thread-Post Issue Date: 2026-10-24 Comment
単にvisual tokenを処理するモデルとは異なり、各トークン(Physical-Native Token)が、xyz座標、dynamics/attributeを持つような、3D Sceneをネイティブでサポートするようなアーキテクチャを採用しているようで、リアルタイムに3D Sceneを拡張できるとのこと。興味深い。
元ポスト:
Brief history of the visual component of MLLMs, Gabriele Berton, 2026.10
Paper/Blog Link My Issue
#Article #Tutorial #Transformer #MultiModal #Post #VisionLanguageModel #Encoder #Backbone #One-Line Notes #Pixel-based Issue Date: 2026-10-22 Comment
LLaVAから現在に至るまでのマルチモーダルモデルのvisual inputの簡潔なliterature
Flora: An Open Model Suite for Scaling Robotics Data Engines, Leng+, 2026.10
Paper/Blog Link My Issue
#Article #Annotation #Blog #OpenWeight #Robotics #3D (Video) #EgocentricView #Data #Author Thread-Post Issue Date: 2026-10-22 Comment
元ポスト:
FLUX 3 Max, fal, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Proprietary #Post #VideoGeneration/Understandings #ImageSynthesis #TextToVideoGeneration #ImageToVideoGeneration #Author Thread-Post Issue Date: 2026-10-20
DeepSeek-V4.1-Flash-1017, DeepSeek AI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-10-17 Comment
元ポスト:
ベンチマーク上はGPT-5.6-solと同等以上という感じに見える。
サイバーセキュリティに対する攻撃能力のトークン量に対するパフォーマンスがGPT-6-Sol超えとのこと:
そもそもどのように評価しているのだろうか。
- elephant-1, Base Labs, 2026.10
ハーネスとしては上記のPi agent harnessが用いられているとのことだが、そもそもサイバー攻撃をするような指示はモデルが拒否しないのだろうか。
NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning, NVIDIA, 2026.10
Paper/Blog Link My Issue
#Article #NLP #AIAgents #MultiModal #OpenWeight #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-16 Comment
元ポスト:
HF: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-Base-BF16
Open d1: Edge decision models for text, vision, and audio, Liquid AI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #MultiModal #SpeechProcessing #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #2D (Image) #Omni #audio #text #Initial Impression Notes #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-10 Comment
HF:
-
https://huggingface.co/LiquidAI/d1-3B
-
https://huggingface.co/LiquidAI/d1-omni-600M
元ポスト:
proprietaryのd1よりもパラメータ数は小さく性能は低いが、パラメータ数-Decision Indexにおいてパレート最適なOpen Weight Decision Model。LFMをバックボーンとし、omniモデルも存在する。
日本語性能:
Introducing Claude Haiku 5.5: the cheapest, fastest, and most capable small model we’ve ever released., Anthropic, 2026.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #AIAgents #Proprietary #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-10-10 Comment
元ポスト:
GPT-6-lunaよりもベンチマークスコアが高くコストが安い。あとは生成されるテキストがどれだけ分かりやすいか...
JEV-27B-VL, AutoTrust, 2026.10
Paper/Blog Link My Issue
#Article #NLP #MultiModal #OpenWeight #VisionLanguageModel #2D (Image) #text #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-09 Comment
元ポスト:
Ideogram 4.5: The most precise edit model, Ideogram, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Blog #OpenWeight #2D (Image) #Editing #ImageSynthesis Issue Date: 2026-10-09 Comment
元ポスト:
画像のマルチターンでのeditingに特化したモデルで、近いうちにオープンになるとのこと
所見:
Embed 5 is here, cohere, 2026.09
Paper/Blog Link My Issue
#Article #Embeddings #NLP #Blog #Proprietary Issue Date: 2026-10-09 Comment
元ポスト:
Introducing GPT-6.1-Sol, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Proprietary #VisionLanguageModel #Reference Collection #Author Thread-Post Issue Date: 2026-10-09 Comment
元ポスト:
OpenAIが公開したmisalignmentに関するレポートで、GPT-6.1-Sol, AstraのCoTが公開され、それらには単語間のスペースやプログラミング言語のような表記が現れることと、それに対してKarpathy氏がコメントをしたことが話題となっていた:
Karpathy氏はRLが有効に機能した場合にモデルがCoT中で英語を使うのをやめた時に、RLが適切に行われたことを示すという見解を過去に示しており、そのポストを引用して今回コメントを残している。
RLを用いるとSFTによってreasoningを学習させる場合などとは異なり、(reasoning traceに対して文法や人間の意味理解に関する報酬を与えない限りは)モデルがreasoning trace中で人間が理解できる言語を話すことで報酬が得られるわけではないため、このような現象が生じてくると推察される。
レポートはこちら: https://alignment.openai.com/misalignment-reports/suppressing-misalignment-monitoring-alerts-and-disabling-misalignment-monitoring/
Holo4: powering generalist computer use agents, H Company, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Blog #OpenWeight #ComputerUse #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-09 Comment
元ポスト:
Claude Sonnet 5.5, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-10-07 Comment
元ポスト:
Opus 5.5と比較してコーディング系のベンチマークのスコアは大差なく、かつ安くて速いならOpus 5.5から乗り換え検討余地あり
text-to-video-human-preferences-326k, Datapoint AI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #Blog #DPO #TextToVideoGeneration Issue Date: 2026-10-07
Liquid Foundation Models: Decision Models, Liquid AI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #MultiModal #Blog #Proprietary #2D (Image) #text #Initial Impression Notes #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-06 Comment
元ポスト:
Liquid AIからもvisionに対応したDecision Modelがリリース、プロプライエタリなようだ
FLUX 3 Action, Black Forest Labs, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #Blog #OpenWeight #Robotics #EmbodiedAI #WorldActionModel Issue Date: 2026-10-04 Comment
HF: https://huggingface.co/collections/black-forest-labs/flux-3-action
元ポスト:
[Paper Note] EmbodiedSWE: Coding Agents for Long-Horizon Dexterous Robotics, Shen+, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Coding #read-later #Robotics #VisionLanguageActionModel #EmbodiedAI #Sim-to-Real #Simulation #Author Thread-Post Issue Date: 2026-10-04 Comment
pj page: https://embodiedswe.github.io/
大脳と小脳的なアプローチ
DiffusionGemma-as-Jev, Matt Mastracci, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DiffusionModel #LLMServing #Post #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-02 Comment
vLLMのPR番号57250でマージされ、DiffusionGemmaをJev-likeに利用するための機能がプロトタイプとして実装されているようでえる。
Google Gemmaからも引用されている:
Introducing Clef: our open-source decision models, and new RL fine-tuning platform, Cloudflare, 2026.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #MultiModal #Blog #PEFT(Adaptor/LoRA) #OpenWeight #Selected Papers/Blogs #Encoder #KeyPoint Notes #SystemOneModel/DecisionModel Issue Date: 2026-10-02 Comment
元ポスト:
概要しかブログ中には書いていないが、よさげに見える。
Qwen-3.8-27Bをバックボーンとし、Qwenのパラメータはフリーズした上で軽量なアダプタを学習し、ルーティングヘッドなるcross-attentionに基づいた各選択肢のスコアを出力するヘッドによって予測が実施されるようである。
これらは、内部で作成された合成データを用いて事後学習されたとのことである。lossはlabel smoothed cross entropy(正解、不正解ラベルを0/1としてクロスエントロピーを計算するのではなく、ハイパーパラメータεでスムージングしてlossを計算するものらしい)とBrier Loss(実際に予測された確率値と正解、不正解を1/0としたときの平均二乗誤差)なるものによって、正則化によって過学習を防止し、出力される確率値がでたらめにならないように学習することを目指しているように見える。
その後RLCDと呼ばれる、選択肢間の順序関係に基づいて、正解と隣接するラベルにも部分的に報酬を与えるようなrewardを持つ(オリジナルのポリシーから分布が大きくシフトしないようなペナルティ付き)RLによって学習をしているようである。これにより、より高いAccuracyと汎化性能が得られた、と一言記述されている。
Qwenが持つVision Encoderによって画像もエンコードでき(Jevは画像は不可と述べられている)、
context長が64kとJevの2倍で
Jevよりもlatencyが良く、
様々なベンチマークスコアで高いスコアを獲得としている、と報告している。
latencyはflashモデルであれば、DiffusionGemma-as-Jevを上回る。
ロボットビジョン 第4回: 画像の記憶と再生・生成, 千葉工業大学 上田隆一, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #GenerativeAdversarialNetwork #DiffusionModel #VariationalAutoEncoder #Slide #FlowMatching #reading #AutoEncoder Issue Date: 2026-09-30 Comment
元ポスト:
Halo: Frontier-Lab Training for Everyone, White Circle, 2026.09
Paper/Blog Link My Issue
#Article #Multi #EfficiencyImprovement #Pretraining #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #MultiModal #Blog #mid-training #DPO #PostTraining #Parallelism #VisionLanguageModel #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-09-29 Comment
元ポスト:
GPT-6 Astra Is the Best Vision Model We Have Tested, roboflow, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #ImageSegmentation #Blog #Reasoning #ComputerUse #VisionLanguageModel #2D (Image) #One-Line Notes #ObjectDetection Issue Date: 2026-09-27 Comment
元ポスト:
GPT-6-Astraに対して、Image Segmentation, Object Detection, counting, box prompt, counting, visual reasoning, re-identification(バスケットボールの動画を例に、選手を一貫して検知し共通のIDを付与できるか, 特に選手交代などにも対応できるか)などのさまざまなタスクでテストした結果が報告されている。結論としては、彼らがテストした中で最も強力なVisionモデルだが、コスト、latencyに関するトレードオフがあることが考察されており、特にリアルタイム処理には向いていないが、アノテーションなどのパッチ処理には価値があるだろうとしている。
Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation, Qwen Team, 2026.09
Paper/Blog Link My Issue
#Article #NLP #DiffusionModel #TextToImageGeneration #Blog #OpenWeight #Editing #ImageSynthesis #Author Thread-Post Issue Date: 2026-09-27 Comment
HF: https://huggingface.co/Qwen/Qwen-Image-2.1
元ポスト:
LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond, Liquid AI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Blog #OpenWeight #VisionLanguageModel #SpeculativeDecoding Issue Date: 2026-09-25 Comment
元ポスト:
HyperFlow, VideoRebirth, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Distillation #OpenWeight #VideoGeneration/Understandings #SelfDistillation #autoresearch/RSI #Author Thread-Post Issue Date: 2026-09-23 Comment
元ポスト:
所見:
Ming-Image-0.1-{Design, Design-Layer}, inclusionAI, 2026.09
Paper/Blog Link My Issue
#Article #TextToImageGeneration #OpenWeight #ImageSynthesis #AgentSkills #Author Thread-Post #Design #ImageToLayer #ImageToPPT Issue Date: 2026-09-23 Comment
元ポスト:
Introducing GPT‑6 Sol and Luna, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Reading Reflections Issue Date: 2026-09-23 Comment
元ポスト:
luna, solに関しては、AA Index上では大きな変化はないように見えるが、コスト性能比が改善しているように見える:
5.6-luna, solと比較するとコストが約半額となっている。やーすい
Claude系列、GPTの他モデルとのコスト対ベンチマークスコアの比較:
コスト対比でのベンチマークスコアとしてはGPT-5.6-lunaよりもGPT-6-Lunaのスコアが高い(そりゃ、そうなるように価格調整するよねとは思うが)。
コストと関係なく絶対的な能力としてみたとき、日本語能力は5.6の方が良さそうだなぁ、という感想を抱いている。
所見:
キャッシュと推論の改善により低コスト化が実現されている。
PixVerse R2: Scaling Real-Time Omni World Models, PixVerse, 2026.09
Paper/Blog Link My Issue
#Article #Blog #read-later #WorldModels #Scalability #Realtime Issue Date: 2026-09-23 Comment
元ポスト:
cua-s1-forms, cua-ai, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #Transformer #SyntheticData #OpenWeight #ComputerUse #Encoder #One-Line Notes #Author Thread-Post Issue Date: 2026-09-19 Comment
github:
https://github.com/trycua/cua/tree/main/libs/cua-s1
dataset:
https://huggingface.co/datasets/cua-ai/cua-s1-forms
元ポスト:
フォーム入力に特化したCUAを実施できるモデルのようで、これもいわゆるSystem One Modelとして紹介されている。Transformer Encoderをバックボーンとする。
まあしかしこれは言ってしまえばただの合成データでFinetuningをしたBERTに見える。Jevのような様々なタスクに対してzero-shotの汎化をしめすものではないであろう点に注意。Jevがどれだけ汎用なのかはわからんが...
【ノーカット】AIに関わる米中戦争と日本の現状 国立情報研 佐藤教授, 時事通信映像センター, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #AIAgents #GenerativeAI #FoundationModel #Safety #Video #Selected Papers/Blogs #VisionLanguageModel #Robotics #WorldModels #VisionLanguageActionModel #EmbodiedAI #Reading Reflections #WorldActionModel Issue Date: 2026-09-18 Comment
非常におもしろかった...色々と考えさせられるなあ。
特にフィジカルAIにおいて、中国は人海戦術で、(簡単な動作を学習できたら複雑な動作を実現することにつながるという仮説の元)非専門家の簡単な動作に関するデータを大量に収集し、最近では仮想環境でデータを合成し活用する動きがある(Sim-to-Real)に対して、日本の場合は、特定の企業の現場のデータを収集しようとする動きがある。(このような文脈において、日本の政策として考えた場合に)特定の企業が有する現場のデータは、その現場特有の特徴が入り込むから実はロボットの学習データに向いていない、という話は、なるほど、と思うなどした。
たとえば、
- [Paper Note] Open X-Embodiment: Robotic Learning Datasets and RT-X Models, Open X-Embodiment Collaboration+, arXiv'23, 2023.10
- [Paper Note] LeRobot: An Open-Source Library for End-to-End Robot Learning, Remi Cadene+, ICLR'26, 2026.02
のように、多様なデータを統一された枠組みで学習をすることで汎化することを狙うという戦略の場合は、現場データの現場特有のバイアス問題はどの程度緩和されるのだろうか。
- Superposition, Memorization, and Double Descent, Transformer Circuits Thread, 2023.01
のDouble Decentのような議論を考えると、同じ種別のデータで、きちんと多様なデータが集まっていれば、現場固有のバイアスが含まれていても汎用的な特徴量としては学習されずらい、という現象は起こるように思える。
また、仮想空間と実世界のgapもあるようで、視覚的なgapは合成データ等で埋め合わせがある程度できそうな一方で、触覚や力感のような繊細な部分や、物理的なセンサーのノイズや、実際のデバイスの物理的な個体差のようなものは、仮想空間上では再現しづらいという話もあるようである。
ただ、なんとなーく、まず汎用的なモデルを学習して基礎的な動作(LLMで言うところのatomic skill)を満足にできる基盤モデルを用意し(これはおそらく仮想空間や非専門家データで足りる)、その基盤モデルはin-context learning能力を備えていて、現場のロボットに適用する際にはfew-shotのdemonstrationや、ルーブリックのようなものを与えて制御する、というのでうまくいくシナリオは起きそうな気がしており、そうなると大量の現場データは必ずしも必要ではなさそうだよね、という気はする。
ただし、日本が人海戦術をとれないのであれば、汎用基盤モデル→現場での適用、というレールの上に乗るのであれば、直接的に汎化させるには専門的すぎる現場のデータが与えられたときに、そこからどのようにして汎用的な基盤モデルを学習できるのか、というところがうまくいけば、ある程度形になるのではなかろうか、と思うなどした。
Introducing ChatGPT Images 2.5, OpenAI, 2026.09
Paper/Blog Link My Issue
#Article #NLP #TextToImageGeneration #Blog #Proprietary #Editing #ImageSynthesis #Author Thread-Post Issue Date: 2026-09-09 Comment
元ポスト:
スケッチを入力することが可能になったようだ
LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #OpenWeight #Japanese #OpenSource #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2026-09-06 Comment
元ポスト:
モデル: https://huggingface.co/llm-jp/llm-jp-4-vl-9b
RefinedVision:
https://huggingface.co/datasets/llm-jp/RefinedVision
OpenSource AIの定義を満たすためにFineVisionデータセットを精査(e.g. GPT-4oの出力等は利用規約上問題がある)した上で修正(FineVisionは185サブセット, 24M VQAで構成されている)したとのこと。すごい。。。
ライセンス・利用規約上の問題を精査するだけでなく、品質(画像の品質、QAの品質)の観点でも精査の上修正しているようである。
関連:
- [Paper Note] FineVision: Open Data Is All You Need, Luis Wiedmann+, NeurIPS'26, 2025.09
Atlas: A World Model for Spatial Intelligence, World Labs, 2026.09
Paper/Blog Link My Issue
#Article #Transformer #DiffusionModel #Blog #Proprietary #read-later #Selected Papers/Blogs #3D Reconstruction #WorldModels #SpatialUnderstanding #Author Thread-Post #4D(Scene + Time) Issue Date: 2026-09-06 Comment
元ポスト:
解説:
Orbis: Our foundation model that creates living worlds and streams them in real time, Visko, 2026.08
Paper/Blog Link My Issue
#Article #Blog #Proprietary #VideoGeneration/Understandings #interactive #TextToVideoGeneration #Realtime #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-06 Comment
元ポスト:
リアルタイムに、かつテキストでのインタラクティブな指示を与えつつ動画を生成できるモデルに見える。
How Far Are We from a Native Autoregressive Video Model?, Weiyang Jin, 2026.08
Paper/Blog Link My Issue
#Article #Blog #read-later #VideoGeneration/Understandings #Author Thread-Post Issue Date: 2026-09-06 Comment
元ポスト:
Introducing H3 Max by fal, fal, 2026.08
Paper/Blog Link My Issue
#Article #NLP #Blog #Proprietary #VideoGeneration/Understandings #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
Minimax H3を事後学習(指示追従とvisual qualityを改善)することで、Artificial Analysisによる評価でSoTAを達成した動画生成モデルとのこと。
Claude: Fable 5.1 and Mythos 5.1, Anthropic, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
所見:
GPT-6 Astra: A new generation of intelligence, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-04 Comment
元ポスト:
GPT-5.6 Solから大幅に性能向上。scaling lawはいつまで続くのだろうか
ベンチマーク上は
- Claude: Fable 5.1 and Mythos 5.1, Anthropic, 2026.09
を超えている。
所見:
アーキテクチャに関する所見:
- [Paper Note] Nanbeige4.2-3B: Unlocking Agentic Capabilities in a Compact Model, Nanbeige Lab+, arXiv'26, 2026.07
- [Paper Note] Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation, Sangmin Bae+, NeurIPS'25
より注意深く指示に従い、CUAの能力も大幅に向上しているようである:
CUAによってBlenderで作成されたhouseの例がなかなかすごい
Artificial Analysisによる評価によると、Artificial Analysis Indexでは5.6-Solと同等、Coding IndexでもFable 5と同等であり、OpenAIによるベンチマークスコアとかなり乖離があるように見える。パブリックなベンチマークに対して過剰に適合しているのか。それともArtificial Analysisのベンチマーク群とその重みづけにより算出されるスコアの相性が悪いのか。(まあこれを考えても不毛だけど)
SRE-Benchと呼ばれるモデルがコンパイル済みのバイナリからソフトウェアをリバースエンジニアリングできるかを測定するベンチマークが飽和したとのこと:
SRE-Bench:
https://benchlm.ai/benchmarks/srebench
所見:
Artificial Analysis Indexのスコアが更新されてFable 5.1とAstraのスコアが同じになったようである😅:
Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency, Qwen Team, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-30 Comment
ベンチマークスコアはOpus 4.6超え。パラメータは125B-A6B、51Bの N-gram Embeddings。Gated Delta Net layerとQwen Sparse Attention と呼ばれる Layerを3:1の比率で積み上げていっているようである。N-gram Embedding、MTPも導入されている。また、Gated Residualと呼ばれる技術により、Residual Streamからの読み込み/書き込みを制御している。
- 関連:
- [Paper Note] Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, Xin Cheng+, arXiv'26, 2026.01
HF:
https://huggingface.co/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921FsyOPe&file=Qwen3.8-Flash-Next
technical report:
https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
解説:
所見:
EgoSuite-Open100K, LightwheelAI, 2026.08
Paper/Blog Link My Issue
#Article #Dataset #Robotics #3D (Video) #EmbodiedAI #EgocentricView #Author Thread-Post Issue Date: 2026-08-22 Comment
pj page: https://egosuite100k.lightwheel.ai/
元ポスト:
LeRobotフォーマットとのこと
- [Paper Note] LeRobot: An Open-Source Library for End-to-End Robot Learning, Remi Cadene+, ICLR'26, 2026.02
- LeRobot Humanoid: An Open, Low-Cost, 3D-Printed Humanoid for Robot Learning, LeRobot, 2026.05
dots3-note Preview: A Small but Mighty Step Toward Long-Horizon Agency in Real Life, dots studio, 2026.08
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #OpenWeight #VisionLanguageModel Issue Date: 2026-08-22 Comment
HF: https://huggingface.co/dots-studio/dots3-note-prev
元ポスト:
SenseNova-U1.5-8B-MoT, SenseNova, 2026.08
Paper/Blog Link My Issue
#Article #NLP #TextToImageGeneration #OpenWeight #Editing #UMM #ImageSynthesis #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
WildArtifactBench, Meta, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #MultiModal #LLM-as-a-Judge #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
AI Agentによるpreference judgeに基づく、win rate/Elo Scoreによるマルチモーダルエージェントのベンチマークのようである
text-2-image-human-preferences-2m, Datapoint AI, 2026.08
Paper/Blog Link My Issue
#Article #NLP #Dataset #TextToImageGeneration #Blog #DPO #One-Line Notes #ImageSynthesis Issue Date: 2026-08-21 Comment
21kのimageペアに対して2Mのpair-wiseでの人間のpreferenceが付与されたデータとのこと。500 promptに対して、30個のT2Iモデルが利用されている。
Cua: Scale computer-use 2.0 with open-source drivers, cross-OS fleets, and benchmarks for training, evaluation, and data generation, trycua, 2026.08
Paper/Blog Link My Issue
#Article #Tools #NLP #Infrastructure #AIAgents #ComputerUse #Selected Papers/Blogs #Author Thread-Post #SandboxEnvironment Issue Date: 2026-08-20 Comment
元ポスト:
Putting sign language AI into users’ hands, Google Deepmind, 2026.08
Paper/Blog Link My Issue
#Article #MachineTranslation #NLP #LanguageModel #Blog #MultiLingual #One-Line Notes #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
Sign-Language to Text (SL2T) Model
50種類以上の手話で学習された手話をテキストに翻訳するモデル。スマホのカメラを通じてリアルタイムにstreaming textとして翻訳される。
Meet North Micro Vision: A 2.4B Native-Resolution Vision-Language Model, Cohere, 2026.08
Paper/Blog Link My Issue
#Article #NLP #SmallModel #OpenWeight #VisionLanguageModel #Author Thread-Post Issue Date: 2026-08-14 Comment
HF:
https://huggingface.co/CohereLabs/North-Micro-Vision-Instruct
Apache 2.0
元ポスト:
Reflections on Video DeltaNet, Haoyi Zhu, 2026.08
Paper/Blog Link My Issue
#Article #Blog #read-later #VideoGeneration/Understandings #LinearAttention #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
videoに対してdelta netのようなlinear attentionモデルを適用することに関する考察のようである。
LTX-2.5, Lightricks, 2026.08
Paper/Blog Link My Issue
#Article #DiffusionModel #OpenWeight #VideoGeneration/Understandings #TextToVideoGeneration #ImageToVideoGeneration #Author Thread-Post Issue Date: 2026-08-14 Comment
元ポスト:
VISTA: A Visual Harness for Reasoning in an Interactive World, Han+, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Reasoning #read-later #Selected Papers/Blogs #2D (Image) #3D (Scene) #memory #LongHorizon #Author Thread-Post #AgentHarness Issue Date: 2026-08-10 Comment
元ポスト:
2025年度GENIAC採択事業において収集・開発したロボット動作データセットおよびロボット基盤モデルを一般公開, AIRoA, 2026.08
Paper/Blog Link My Issue
#Article #Dataset #Blog #OpenWeight #Robotics #VisionLanguageActionModel #EmbodiedAI #Author Thread-Post Issue Date: 2026-08-10 Comment
Dataset:
https://huggingface.co/datasets/airoa-org/airoa-moma-5k
HF:
https://huggingface.co/airoa-org/airoa-pi05-hsr-base
元ポスト:
MiniMax-H3, MiniMaxAI, 2026.08
Paper/Blog Link My Issue
#Article #NLP #Transformer #TextToAudio #SpeechProcessing #OpenWeight #VideoGeneration/Understandings #UMM #Omni #TextToVideoGeneration #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
Video Arenaと呼ばれるベンチマーク (Image-to-Video, Image-to-Video) でOpenWeightモデルでSoTA、全体で2位:
[Paper Note] Qwen-UI-Agent Technical Report: Toward Next-Generation Real-World Centric Foundation GUI Agents, MAI-UI Team, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #ComputerUse #VisionLanguageModel #Initial Impression Notes #GUI Issue Date: 2026-08-09 Comment
pj page: https://tongyi-mai.github.io/Qwen-UI-Agent/
多くのベンチマークでFrontier Modelを上回る性能を示すGUI Agent。デモを見るとなかなかインパクトがある。
元ポスト:
Introducing Inkling-Small, THINKING MACHINES, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #VisionLanguageModel #UMM #One-Line Notes #Author Thread-Post Issue Date: 2026-08-09 Comment
HF: https://huggingface.co/thinkingmachines/Inkling-Small
関連:
- Inkling: Our open-weights model, THINKING MACHINES, 2026.07
- 276B-A12B
- NVFP4
- 小規模なモデルだが、Inklingと同等以上の性能を達成(ただし、一般的な知識や事実性に関してはInklingの方が上)
- 事前学習データのDataMixtureや学習レシピにいくつかの改良
- Inklingを教師モデルとしたOPD
- codingに特化したagentic RLをスケールアップ
元ポスト:
Introducing MazeBench, MazeBench, 2026.07
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Planning #VisionLanguageModel #3D (Scene) #SpatialUnderstanding #One-Line Notes #LongHorizon Issue Date: 2026-08-05 Comment
元ポスト:
3D空間において、カメラアングルの移動とブロックの移動をすることで実施可能なパズルゲームによる新たなベンチマークで、視覚的・空間的な推論能力と、長期のplanning能力を評価する。
Introducing PerceptionBench: Evaluating Atomic Visual Perception in Multimodal Large Language Models, Kimi Team, 2026.07
Paper/Blog Link My Issue
#Article #NLP #Dataset #Evaluation #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2026-08-05 Comment
元ポスト:
Vision系の新たなベンチマーク。42種類のベンチマークのフロンティアモデルが失敗する事例に基づいて評価対象とするatomicな能力を定義し、それらのatomicなスキルを独立して評価可能なサンプルを作成し評価するベンチマーク。サンプルは与えられた情報のみから、評価対象とするatomicな能力を駆使すれば成功できるverifiableなタスクとして定義されているようである。能力ごとにモデルのスコアが算出可能。
実例としては、たとえば、魚が泳いでいる複数の池のイラストが与えられて、真ん中の池には何匹の魚がいる?といったクエリに応答するなどである。これには localization の能力が求められる(Countingも必要な気がするが)。
Scaling Video Pretraining with Imagination Models, induction labs, 2026.07
Paper/Blog Link My Issue
#Article #Pretraining #FoundationModel #Blog #VideoGeneration/Understandings #Reading Reflections #Author Thread-Post Issue Date: 2026-08-04 Comment
元ポスト:
動画で事前学習することでvision系タスクの基盤モデルとして有効に機能する、という話が最近増えてきたように感じる。
SIGReg from First Principles, Reza Bayat, 2026.07
Paper/Blog Link My Issue
#Article #Tutorial #RepresentationLearning #Self-SupervisedLearning #read-later #WorldModels #Author Thread-Post #LatentRepresentation Issue Date: 2026-08-04 Comment
元ポスト:
JEPA関連のチュートリアル
関連:
- [Paper Note] Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture, Mahmoud Assran+, CVPR'23, 2023.01
- [Paper Note] LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics, Randall Balestriero+, arXiv'25, 2025.11
- [Paper Note] LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels, Lucas Maes+, arXiv'26, 2026.03
- JEPAwiki, mishig, 2026.04
著者ポスト:
Introducing FLUX-mimic: Scaling Video-Action Models for General Purpose Dexterity, mimic robotics, 2026.07
Paper/Blog Link My Issue
#Article #NLP #VideoGeneration/Understandings #Robotics #EmbodiedAI #WorldActionModel Issue Date: 2026-08-03 Comment
元ポスト:
FLUX3をベースに構築されたVision Action Model
- 大規模な動画生成モデルをバックボーンとすることで、ロボットのActionの予測をVLAと比較して最大10倍のデータ効率で実現
- 動画生成バックボーンの性能が向上すれば、Video Action Modelの性能もそれに伴い向上することが示唆される
Introducing MAI-Image-2.5- Pro and MAI-Voice-2-Flash, MAI, 2026.07
Paper/Blog Link My Issue
#Article #NLP #SpeechProcessing #TextToImageGeneration #Proprietary #TTS #ImageSynthesis #Author Thread-Post Issue Date: 2026-08-03 Comment
元ポスト:
関連:
- Building a hill-climbing machine: Launching seven new MAI models, Mustafa Suleyman, MAI, 2026.06
Introducing Cosmos 3 Edge, Nvidia, 2026.07
Paper/Blog Link My Issue
#Article #NLP #Blog #SmallModel #OpenWeight #VisionLanguageModel #Robotics #WorldModels #EmbodiedAI #Author Thread-Post Issue Date: 2026-07-31 Comment
元ポスト:
HF: https://huggingface.co/nvidia/Cosmos3-Edge?linkId=100000431533162
autoregressive -> diffusion の two-tower モデル
Cosmos3 テクニカルペーパー:
- [Paper Note] Cosmos 3: Omnimodal World Models for Physical AI, NVIDIA+, arXiv'26, 2026.06
Introducing Composite-Bench: the strongest open-weights model isn't Kimi K3, composite, 2026.07
Paper/Blog Link My Issue
#Article #NLP #Evaluation #Blog #ComputerUse #VisionLanguageModel #LongHorizon #Initial Impression Notes #Author Thread-Post Issue Date: 2026-07-24 Comment
元ポスト:
エンタープライズ向けのサービスに基づく専門家の操作に基づくbrowser-useベンチマークのようである。ざっくりブログを読んだが実際にどのようなサービスなのか知らないためあまりよくわからなかったので、公開されているベンチマークを見る方が直感的な理解は捗りそう。
本ベンチマーク上では、GLM-5.2がOpenWeightモデルの中では最も性能が高いようである。
FLUX 3 - Real World Models: Towards Multimodal Flow Models as the Backbone of Visual Intelligence, Black Forest Labs, 2026.07
Paper/Blog Link My Issue
#Article #TextToAudio #MultiModal #TextToImageGeneration #Blog #Proprietary #VideoGeneration/Understandings #Editing #UMM #One-Line Notes #ImageSynthesis #TextToVideoGeneration #WorldActionModel #Author Thread-Post Issue Date: 2026-07-24 Comment
元ポスト:
モデルは将来的にオープンになるようである
Announcing Bonsai 27B: The First 27B-Class Model to Run on a Phone, PrismRL, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Blog #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2026-07-19 Comment
元ポスト:
HF: https://huggingface.co/collections/prism-ml/bonsai-27b
Bonsaiシリーズ:
- Announcing 1-bit Bonsai: The First Commercially Viable 1-bit LLMs, 2026.03
- Introducing Ternary Bonsai: Top Intelligence at 1.58 Bits, PrismML, 2026.04
- Introducing 1-bit and Ternary Bonsai Image 4B: Image Generation for Local Devices, PrismML, 2026.05
1-bit, ternary weightによって、27B級モデルがエッジデバイス上で動作する。
How We Serve Ideogram V4 Lightning Fast on fal, fal, 2026.07
Paper/Blog Link My Issue
#Article #NLP #TextToImageGeneration #Blog #OpenWeight #Initial Impression Notes Issue Date: 2026-07-19 Comment
元ポスト:
関連:
- Ideogram 4: Open image model at the forefront of design, Ideogram, 2026.06
Ideogramに基づいた、高速なTextToImage Modelのようである。
Introducing Muse Spark 1.1, Meta, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #MultiModal #Proprietary #VisionLanguageModel #One-Line Notes #Author Thread-Post Issue Date: 2026-07-19 Comment
元ポスト:
Muse Spark:
- Introducing Muse Spark: Scaling Towards Personal Superintelligence, Meta, 2026.04
大幅にAgenticな能力やコーディング能力が向上。Agenticな能力では多くのベンチマークでOpus4.8超え、CodingはGPT-5.5にベンチマーク上では及ばず(SWE Bench Proでは勝っているが、OpenAIから30%以上のpromptが評価で不適切との報告があった Separating signal from noise in coding evaluations, OpenAI, 2026.07 )。
Alexandr Wang氏によるポスト:
VQAからDocument Parsingへ:Nemotron-3-Nano-Omniに対する日本語文書の構造化出力Post-training, Stockmark, 2026.07
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #Japanese #VisionLanguageModel #reading Issue Date: 2026-07-16 Comment
元ポスト:
Inkling: Our open-weights model, THINKING MACHINES, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #SpeechProcessing #Blog #Reasoning #OpenWeight #MoE(Mixture-of-Experts) #Selected Papers/Blogs #VisionLanguageModel #UMM #KeyPoint Notes #Reference Collection #AudioLanguageModel #Author Thread-Post Issue Date: 2026-07-16 Comment
HF: https://huggingface.co/thinkingmachines/Inkling
元ポスト:
THINNING MACHINESによる最初のOpenWeightモデル。975B-41B
- フルスクラッチで学習したReasoningモデル
- 1M context window
- text, image, audio, video 45Tトークンで学習
- バランスよくさまざまな領域で性能を発揮するように訓練し、Tinker上でのfinetuningやカスタマイゼーションの良い基盤として機能することを目指した
- vision, audioドメインに関してはencoder freeアーキテクチャを採用
- audio signalの入力は dMel spectrogramsと呼ばれる手法を採用
- [Paper Note] dMel: Speech Tokenization made Simple, Richard He Bai+, arXiv'24, 2024.07
- 画像は40x40のパッチに分割され、4つのhMLPと呼ばれるレイヤーでエンコーディング
- [Paper Note] Three things everyone should know about Vision Transformers, Hugo Touvron+, ECCV'22, 2022.03
- IFの訓練には、Rubric basedなgraderとclaims graderの2種類のgraderを用いることで、helpfulnessとhallucinationを同時に低減
- Rubric basedなgraderはチェックリストに基づいてスコアリング
- claims graderはfactualな主張をagentic web searchを通じてverificationする
- アーキテクチャはDeepSeek V3を踏襲し、256のexpertsと2つのshared expertを採用し、6つのexpertsがactivateされる
- SWAとGlobal attentionの比率は5:1でKV Headは8つ (GQA)
- **相対位置エンコーディングを用いることでRoPEよりもlong contextに対してより高い外挿性能を示した**
- [Paper Note] Self-Attention with Relative Position Representations, Peter Shaw+, NAACL'18
- K, Vのprojection後、**およびattentionとMLPが残差ストリームに合流する前にshort convolutionを導入**
- QKV projection後に convolution を導入するアーキテクチャは下記研究で提案
- [Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
- optimiserはMuonとAdamWのハイブリッドで、前者は巨大な行列の重みに対して適用し、そのほかは後者を利用
- 重み自体が多様体上に存在するように制約することが有効であったことに着想を得て、weight decayを学習率の2乗に連動させることでモデルの重みの大きさを安定させたとのこと
- Modular Manifolds, Jeremy Bernstein+, THINKING MACHINES, 2025.09
- [Paper Note] Why Gradients Rapidly Increase Near the End of Training, Aaron Defazio, arXiv'25, 2025.06
- 事後学習としては、まずKimi K2.5を含むOpenWeightモデルで合成データ上でSFTをし、その後合成、あるいは人間が作成したenvironment上で大規模なRLを実施
- RLは非同期RLを異様し、ロールアウト数に対して推論能力が対数線形にスケールした。
- 最終的に30Mロールアウト以上のRLを実施した
- システムメッセージを変更し、トークン単位のコストを調整することでreasoning effortを調整
- Controlling Reasoning Effort in LLMs, Sebastian Raschka, 2026.07
- **276B-A12BのInkling-Smallもプレビュー段階にあり、agenticな能力においてInklingに近い性能を達成しており、今後公開予定**
1M context windowを実現した工夫は特に書かれていなかったように感じるが、よく使われるのはKV CacheをコンパクトにするためのSparse Attention、あるいはLinear Attentionなのに対し、本モデルでは使われていないように見える。linear attentionでなくとも、SWAとGlobal Attentionのハイブリッド、かつGQAによって、KV Cacheの肥大化を実用レベルで抑制できるのだろうか。また、外挿性能に関してはRoPEは採用せず、相対位置エンコーディングのを採用したという点が効いているのだろうか。1Mレベルでのcontextでの評価がなさそうに見えるので性能はよくわからない。
RoPEのlong contextでの限界を示した以下の研究を思い出した:
- [Paper Note] RoPE Distinguishes Neither Positions Nor Tokens in Long Contexts, Provably, Yufeng Du+, arXiv'26, 2026.05
Artificial Analysisによる評価:
アーキテクチャでの目新しい点:
所見:
公式:
所見:
LingBot-VLA-V2, Robbyant, 2026.07
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #Robotics #VisionLanguageActionModel #EmbodiedAI #Author Thread-Post Issue Date: 2026-07-12 Comment
元ポスト:
[Paper Note] Waypoint-1.5: A Real-Time Video World Model for Consumer Hardware, Rajpal+, 2026.07
Paper/Blog Link My Issue
#Article #DiffusionModel #WorldModels #Game #Realtime Issue Date: 2026-07-08 Comment
HF: https://huggingface.co/Overworld/Waypoint-1.5-1B
関連:
- Waypoint-1: Real-time Interactive Video Diffusion from Overworld, Overworld, 2026.01
元ポスト:
pj page: https://over.world/waypoint-1.5
CS2-10k: A Large-Scale Egocentric Counter-Strike 2 Dataset, Reka Labs, 2026.06
Paper/Blog Link My Issue
#Article #Dataset #WorldModels #Initial Impression Notes Issue Date: 2026-07-07 Comment
Counter-Strikeのプロレベルの試合に基づいた、1万時間以上一人称視点の映像と、フレームごとのannotation(キーボード操作状態、マウス移動の軌跡、プレイヤーの移動経路等)を含むデータセットのようである。
映像だけでなく、annotationが付与されている点が有用。
元ポスト:
Introducing computer use in Gemini 3.5 Flash, Google, 2026.06
Paper/Blog Link My Issue
#Article #NLP #Blog #Proprietary #ComputerUse #VisionLanguageModel #Initial Impression Notes Issue Date: 2026-07-05 Comment
元ポスト:
quick start guide:
computer useがだいぶ使いやすくなってきたなあ(小並感)
MolmoMotion: Language-guided 3D motion forecasting, Ai2, 2026.06
Paper/Blog Link My Issue
#Article #DiffusionModel #VideoGeneration/Understandings #3D (Scene) #FlowMatching #Robotics #Author Thread-Post Issue Date: 2026-06-18 Comment
元ポスト:
視覚基盤モデルの構築, 産総研, 片岡裕雄, 2026.06
Paper/Blog Link My Issue
#Article #FoundationModel #Slide #read-later #Robotics Issue Date: 2026-06-09 Comment
元ポスト:
Ideogram 4: Open image model at the forefront of design, Ideogram, 2026.06
Paper/Blog Link My Issue
#Article #NLP #TextToImageGeneration #OpenWeight #ImageSynthesis #Author Thread-Post Issue Date: 2026-06-05 Comment
元ポスト:
HF: https://huggingface.co/collections/ideogram-ai/ideogram-4
Introducing Gemma 4 12B: a unified, encoder-free multimodal model, Google, 2026.06
Paper/Blog Link My Issue
#Article #NLP #MultiModal #OpenWeight #VisionLanguageModel #2D (Image) #UMM #SpatialUnderstanding #One-Line Notes #Reference Collection #AudioLanguageModel #audio #Author Thread-Post Issue Date: 2026-06-04 Comment
元ポスト:
vision/audioエンコーダーを無くしたvision/audio nativeなマルチモーダルLLM
HF: https://huggingface.co/google/gemma-4-12B
アーキテクチャ図:
A Functional Taxonomy of World Models, Fei-Fei Li, 2026.06
Paper/Blog Link My Issue
#Article #Tutorial #NLP #Post #Selected Papers/Blogs #VideoGeneration/Understandings #Robotics #WorldModels #VisionLanguageActionModel #KeyPoint Notes #TextToVideoGeneration #Reading Reflections #WorldActionModel #Author Thread-Post Issue Date: 2026-06-04 Comment
元ポスト:
以下ポストの内容の要約(と意訳、間違ってたらごめんなさい)
- 世界モデルは現在最も重要だが、最も多義的な概念の一つになっている。
- 様々な分野がWorld Modelを構築していると主張するが、意味するところが実際には大きく異なる
- (実際 [Paper Note] Agentic World Modeling: Foundations, Capabilities, Laws, and Beyond, Meng Chu+, arXiv'26, 2026.04
のような研究も存在し似たような問題意識のもと様々な分野での統一的な分類体系が提案されている)
- 世界モデルという用語のもともとの枠組みは「部分観測マルコフ決定過程 (POMDP)」であり、
- エージェントは行動を実行し、行動は世界の状態に影響を与え、エージェントは観測データを受け取り(≠状態を認識する)、新たな観測データに基づいてアクションが実行される、といったループが繰り返される枠組みである
- ここで、「状態」とは、ある時点における世界で何が起きているかに関する完全なdescriptionであり、エージェントは状態自体を認識することはできず、行動と状態から生じた部分的な観測データのみである。
- 現在様々な世界モデルと呼ばれるものが存在するが、構造としては上記のループを持っており、それらの切り口が異なっているにすぎない。
- 世界モデルのカテゴリ1: Renderer
- Rendererは人間の目に見えるピクセルで「観測」を出力する。
- たとえば、テキストのプロンプトを映像に変換するText-To-Videoモデル、ユーザの入力に応じてリアルタイムにフレームを生成するシステムはレンダラーに相当する。
- これらモデルは観測者にとって「見えるもの」を生成しているにすぎず、実際の3次元構造を明示的に理解しているわけではない(i.e., 見えるもの≠実在するもの)。
- ビジネスとして最も成長(してきており、学習データもインターネット上の動画が活用できるため他の2カテゴリと比べて多い)
- 世界モデルのカテゴリ2: Simulator
- Simulatorは「状態」を出力する。これは実際に人間やコンピュータが相互作用可能な世界の表現である。
- Rendererは単に視覚的なものであるが、Simulatorは実世界の幾何学的・物理的・動的なダイナミクスを理解することが求められる。
- Simulatorは建築家やゲーム開発者などの視覚を超えた(たとえば構造・物理的な)正確性を必要とする職種や、RLの学習の環境として利用できる。
- Simulator は Rendererと次のPlannerの土台となる技術(Simulatorは RendererとPlannnerの双方をバイパスできる)であるが、学習データが最も不足
- 世界モデルのカテゴリ3: Planner
- Plannerは「行動」を出力する。観測と目標が与えられた時に「次に何をすべきか」を出力する。
- Vision Language Action Model / World Action Model は Planner に該当し、これらはロボットが次に何をすべきかを決定できる。
- 現在研究初期段階で、研究所内での閉じられた環境でのデモ中心で、実世界で活用するためにはまだまだ多くの課題が残る。
- これら3つのカテゴリは現在世に出ているWorld Modelの多くを説明しており、区別をする際に役に立つ。
- が、これらカテゴリは独立したものではなく、これらは世界の機能に関する基本的な知識(幾何学、物理学、ダイナミクス)の上に成り立つ。
- これら3つのカテゴリは最近は互いが融合してくる流れにあり、たとえば事前学習された Renderer は、次に何が起こるか・何をすべきか(=Planner)を予測するためのバックボーンとして利用できることが示されてきており、これは Renderer と Plannerが 融合した例と言える。
- (この辺の話はBackboneとしてVision Encoderを持つVLA系全般の研究と、事前学習済みのVision Encoderを用いずに事前学習の方法をそもそも改善するような方向などだろうか)
上記の話に基づくと、たとえばターミナルでのWorld Modelに相当すると考えられる
- [Paper Note] ECHO: Terminal Agents Learn World Models for Free, Vaishnavi Shrivastava+, arXiv'26, 2026.05
は3つのカテゴリのうちにどれに該当するだろうか。
次のアクションを予測できるので、まずPlannerには該当すると思われる。また、ある時点においてターミナル上で何が起きているかの記述(ターミナルの出力)を予測しているので、Simulatorの役割を果たしていると思われる(ただ、ターミナルの出力だけがターミナルの状態を完全に記述した情報なの?定義としてそれでいいの?という疑問はあるのが)。このため、Planner と Simulator が融合した研究と言えるのではなかろうか。
Holo3.1: Fast & Local Computer Use Agents, H Company, 2026.06
Paper/Blog Link My Issue
#Article #NLP #AIAgents #OpenWeight #ComputerUse #VisionLanguageModel #Author Thread-Post Issue Date: 2026-06-03 Comment
HF: https://huggingface.co/collections/Hcompany/holo31
元ポスト:
関連:
- Holo3: Breaking the Computer Use Frontier, H Company, 2026.03
Develop Physical AI Reasoning, World, and Action Models with NVIDIA Cosmos 3, nvidia, 2026.05
Paper/Blog Link My Issue
#Article #NLP #MultiModal #OpenWeight #Selected Papers/Blogs #VideoGeneration/Understandings #Robotics #WorldModels #UMM #reading #Omni #One-Line Notes #WorldActionModel #Author Thread-Post Issue Date: 2026-06-02 Comment
元ポスト:
公式:
encoder-freeなOmniモダリティモデルで、かつ将来の世界の状態、およびactionを予測可能なWorldActionModel
Step-3.7-Flash, stepfun-ai, 2026.05
Paper/Blog Link My Issue
#Article #NLP #AIAgents #MultiModal #OpenWeight #MoE(Mixture-of-Experts) #read-later #VisionLanguageModel #Author Thread-Post Issue Date: 2026-05-31 Comment
元ポスト:
公式:
[Paper Note] LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding, Wang+, 2026.05
Paper/Blog Link My Issue
#Article #NLP #CVPR #read-later #Selected Papers/Blogs #ObjectLocalization #VisionLanguageModel #2D (Image) #UMM #3D (Video) #text #ObjectDetection #GUI #Author Thread-Post Issue Date: 2026-05-30 Comment
元ポスト:
Introducing 1-bit and Ternary Bonsai Image 4B: Image Generation for Local Devices, PrismML, 2026.05
Paper/Blog Link My Issue
#Article #DiffusionModel #TextToImageGeneration #SmallModel #Selected Papers/Blogs #One-Line Notes #ImageSynthesis #LowPrecision #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
HF: https://huggingface.co/collections/prism-ml/bonsai-image
Ternary Weight {-1, 0, 1}による画像生成モデル
PhysX-Omni: Unified Simulation-Ready Physical 3D Generation for Rigid, Deformable, and Articulated Objects, Ropedia, 2026.05
Paper/Blog Link My Issue
#Article #NLP #VisionLanguageModel #Robotics #Simulation #3D Object Generation #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
MagicLite, Microsoft, 2026.05
Paper/Blog Link My Issue
#Article #Tools #NLP #SmallModel #ComputerUse #One-Line Notes #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
Faraを用いたブラウザベースのChatUIを備えたCUAで、ローカルストレージへのアクセスも可能な模様
Marlin-2B, NemoStation, 2026.05
Paper/Blog Link My Issue
#Article #Temporal #VideoGeneration/Understandings #VisionLanguageModel #3D (Video) #reading #Grounding #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
何が、いつ起きたかに答えるVideo VLMで、イベントごとのキャプションとtimestampのspanを出力してくれるようである。2Bモデルなので軽量である。
例は以下:
より安全で透明性の高い AI エコシステムに向けて、コンテンツ来歴の取り組みを前進, OpenAI, 2026.05
Paper/Blog Link My Issue
#Article #TextToImageGeneration #Proprietary #2D (Image) #One-Line Notes #ImageSynthesis #AI Detector #Author Thread-Post #Watermark Issue Date: 2026-05-27 Comment
元ポスト:
画像生成にSynthID追加、また、画像がChatGPT, Codex, OpenAI APIから生成されたものかを判定するツールの一般向けプレビューを開始
https://openai.com/ja-JP/research/verify/
OlmoEarth v1.1: A more efficient family of models, Ai2, 2026.05
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #FoundationModel #OpenWeight #2D (Image) #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
関連:
- OlmoEarth-v1-Large, Ai2, 2025.11
- Introducing OlmoEarth embeddings: Custom embedding exports from OlmoEarth Studio for downstream analysis, Ai2, 202604
Vision in the Age of LLMs, Lucas Beyer, 2026.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #Transformer #MultiModal #ContrastiveLearning #Video #read-later #VisionLanguageModel #Backbone Issue Date: 2026-05-21 Comment
関連:
- [Paper Note] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale, Alexey Dosovitskiy+, ICLR'21
- [Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
- [Paper Note] PaliGemma: A versatile 3B VLM for transfer, Lucas Beyer+, arXiv'24, 2024.07
元ポスト:
Gemini Omni を発表, Google Japan Blog, 2026.05
Paper/Blog Link My Issue
#Article #NLP #MultiModal #SpeechProcessing #Blog #Proprietary #VideoGeneration/Understandings #Omni Issue Date: 2026-05-20 Comment
元ポスト:
ZAYA1-VL-8B: Efficient Open Visual Intelligence, ZYPHRA, 2026.05
Paper/Blog Link My Issue
#Article #NLP #SmallModel #OpenWeight #MoE(Mixture-of-Experts) #VisionLanguageModel #One-Line Notes Issue Date: 2026-05-12 Comment
HF: https://huggingface.co/Zyphra/ZAYA1-VL-8B
元ポスト:
画像トークンには双方向のattentionを適用できるようなアーキテクチャを採用
MolmoAct 2: An open foundation for robots that work in the real world, Ai2, 2026.05
Paper/Blog Link My Issue
#Article #NLP #MultiModal #Reasoning #OpenWeight #OpenSource #read-later #Robotics #VisionLanguageActionModel #Author Thread-Post Issue Date: 2026-05-08 Comment
元ポスト:
関連:
- [Paper Note] MolmoAct: Action Reasoning Models that can Reason in Space, Jason Lee+, arXiv'25
dataset:
https://huggingface.co/collections/allenai/molmoact2-datasets
models:
https://huggingface.co/collections/allenai/molmoact2-models
著者ポスト:
著者ポスト2:
著者ポスト3:
Introducing Moonlake's 3D Agent: Computer Use Capabilities For World Modeling, The Moonlake Team, 2026.04
Paper/Blog Link My Issue
#Article #AIAgents #ComputerUse #VisionLanguageModel #2D (Image) #3D (Scene) #Initial Impression Notes #3D Object Generation #ImageTo3D Issue Date: 2026-04-30 Comment
元ポスト:
Blenderを操作可能なComputer Use Agentのようである
Introducing OlmoEarth embeddings: Custom embedding exports from OlmoEarth Studio for downstream analysis, Ai2, 202604
Paper/Blog Link My Issue
#Article #Embeddings #NLP #Proprietary #read-later Issue Date: 2026-04-25 Comment
元ポスト:
関連:
- OlmoEarth-v1-Large, Ai2, 2025.11
ちょっとこれはしっかり読まないと具体的にはわからないかもしれない
Building a Fast Multilingual OCR Model with Synthetic Data, Nvidia, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Dataset #SyntheticData #MultiLingual #OCR #Initial Impression Notes Issue Date: 2026-04-25 Comment
元ポスト:
日本語サンプルも全6ヶ国語中全体の17%含まれておりかなり含まれているOCRモデル学習用の合成データとモデル
model:
https://huggingface.co/nvidia/nemotron-ocr-v2
data:
https://huggingface.co/datasets/nvidia/OCR-Synthetic-Multilingual-v1
スループットが非常に高い
Flipbook is an infinite visual browser generated entirely on demand in real time, Shah+, 2026.04
Paper/Blog Link My Issue
#Article #Blog #VideoGeneration/Understandings #interactive #Realtime #Initial Impression Notes #GUI Issue Date: 2026-04-25 Comment
元ポスト:
画面上のピクセルを全てVideo Generationによってinteractiveに描画するGUIのデモのようである
Gemini Embedding 2: Our first natively multimodal embedding model, Google, 2026.03
Paper/Blog Link My Issue
#Article #Embeddings #NLP #MultiModal #Blog #Proprietary #read-later #Selected Papers/Blogs #KeyPoint Notes #Author Thread-Post Issue Date: 2026-04-25 Comment
元ポスト:
単一のモデルで、マルチモーダルな情報を統合されたembedding空間で表現し、マトリョーシカ表現によって3種類の次元で取得でき、100+言語をサポートしかつcontext windowは8192。オーディオをわざわざ書き起こしてテキストモダリティに変換する必要もなく直接unifiedなembeddingを取得可能というなかなか便利そうな代物。
(以前のIssueを誤って削除したため再掲)
Generally Availableになったとのこと:
vismatch (formerly Image Matching Models), gmberton, 2026.04
Paper/Blog Link My Issue
#Article #Library #2D (Image) #One-Line Notes #needs-revision #Author Thread-Post Issue Date: 2026-04-25 Comment
元ポスト:
50種類以上のimage matchingモデルを統一的なinterfaceでシームレスに利用可能なライブラリとのこと
Hunyuan3D-2, tencent, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Transformer #DiffusionModel #OpenWeight #TextTo3D #ImageTo3D Issue Date: 2026-04-25 Comment
元ポスト:
PaddleOCR, PaddlePaddle
Paper/Blog Link My Issue
#Article #Tools #NLP #DocParser #VisionLanguageModel #OCR #Initial Impression Notes #Author Thread-Post Issue Date: 2026-04-23 Comment
元ポスト:
ブラウザ上でも動作可能らしい
Introducing ChatGPT Images 2.0: A new era of image generation, OpenAI, 2026.04
Paper/Blog Link My Issue
#Article #NLP #ChatGPT #TextToImageGeneration #Proprietary #Selected Papers/Blogs #ImageSynthesis #Initial Impression Notes #Author Thread-Post Issue Date: 2026-04-22 Comment
元ポスト:
めとゃめちゃ良くなってそう
関連:
関連:
Artificial Analysisによる評価(SoTA):
Introducing Claude Design by Anthropic Labs, Anthropic, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Selected Papers/Blogs #VisionLanguageModel #Design Issue Date: 2026-04-18 Comment
元ポスト:
HY-World-2.0, Tencent, 2026.04
Paper/Blog Link My Issue
#Article #Transformer #DiffusionModel #OpenWeight #WorldModels #Author Thread-Post Issue Date: 2026-04-16 Comment
元ポスト:
テクニカルレポート: https://3d-models.hunyuan.tencent.com/world/world2_0/HY_World_2_0.pdf
Introducing Claude Opus 4.7, Anthropic, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Reference Collection #Author Thread-Post Issue Date: 2026-04-16 Comment
元ポスト:
Artificial Analysisによる評価:
GDPval-AAでGPT-5.4超えのSoTA
IntelligenceでもSoTA(同等)
所見:
所見:
新たなtokenizerを用いている。knowledge cutoffも更新されている。すなわち、新たなベースモデルが事前学習された可能性が高い
tokenizerが更新された=必ずしもベースモデルも新しいということではないよねという指摘:
デグレしたベンチマークがある模様:
所見:
Introducing ERNIE‑Image, Baidu, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Transformer #DiffusionModel #TextToImageGeneration #OpenWeight #Selected Papers/Blogs #2D (Image) #One-Line Notes #ImageSynthesis #Author Thread-Post Issue Date: 2026-04-15 Comment
HF: https://huggingface.co/baidu/ERNIE-Image
ERNIEからtext-to-imageモデルがOpenWeightモデルとしてリリース。ベンチマークとしては公式ブログ上ではOpenWeightモデルの中でトップで、nano banana 2.0に匹敵するようなスコアが出ているように見える
Gemini Robotics-ER 1.6: Powering real-world robotics tasks through enhanced embodied reasoning, Google Deepmind, 2026.04
Paper/Blog Link My Issue
#Article #NLP #Reasoning #Proprietary #Robotics #VisionLanguageActionModel #SpatialUnderstanding #Reference Collection #Initial Impression Notes #Author Thread-Post #MultiView Issue Date: 2026-04-15 Comment
元ポスト:
おー、とうとうDeepmindからVLAがでた。プロプライエタリモデル
私が知らなかっただけで、以前からリリースされていたようだ:
- Building the Next Generation of Physical Agents with Gemini Robotics-ER 1.5, Google, 2025.09
-
https://developers.googleblog.com/en/building-the-next-generation-of-physical-agents-with-gemini-robotics-er-15/
ポイント解説:
LLM-jp-4-VL 9B betaリリース, LLM-jp, 2026.04
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #Japanese #OpenSource #VisionLanguageModel #Author Thread-Post Issue Date: 2026-04-14 Comment
元ポスト:
Introducing Muse Spark: Scaling Towards Personal Superintelligence, Meta, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Proprietary #read-later #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2026-04-11 Comment
元ポスト:
-
-
元ポストのベンチマークスコアを見るとマルチモーダルの性能はフロンティアモデル(gpt5.4, Opus 4.6, Gemini 3.1 Pro)と同等、text/reasoningはフロンティアモデルより少しスコアが低く、特に抽象的な思考が苦手(ARC-AGI-2)。HEALTH分野はhealthは高スコアだがmedicalは少し低めのスコア、Agenticな分野では、SWE Bench Verified/Proよスコアは少し低め、terminal useは明確にスコアが低くtool useは少しスコアが低い、という感じにみえる。
codingとlong horizon taskに継続的に投資するとのこと。
中の人による解説:
全てをフルスクラッチから作り直したっぽい。
Artificial Analysisによる解説:
一気にOpenWeight最強のGLM-5.1超え
所見:
所見:
所見:
第三者によるおそらく独自のベンチマークによる評価の結果、(おそらく101モデルのうち)全体で3位となっているらしい(つまり、既存ベンチマークにoverfittingしているわけではないという考えがある)。
Unfolding Robotics: The Open-Source Recipe for Teaching a Robot to Fold Your Clothes, Hugging Face, 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #NLP #OpenWeight #OpenSource #read-later #Selected Papers/Blogs #Robotics #VisionLanguageActionModel Issue Date: 2026-04-07 Comment
元ポスト:
Introducing WildDet3D: Open-world 3D detection from a single image, Ai2, 2026.04
Paper/Blog Link My Issue
#Article #Dataset #OpenWeight #OpenSource #read-later #Selected Papers/Blogs #3D (Video) #ObjectDetection #Initial Impression Notes Issue Date: 2026-04-07 Comment
元ポスト:
wildな環境においてzero shot(click, text, bounding boxで対象を指定)で動作する単眼の3D Object Detectionモデルとのこと。データセットもコードも公開
Vision Language Models (Better, faster, stronger), merve+, 2025.03
Paper/Blog Link My Issue
#Article #Survey #NLP #Blog #VisionLanguageModel #Initial Impression Notes Issue Date: 2026-04-07 Comment
元ポスト:
1年前のVLMに関するトレンドをまとめた記事のようだが、その後も同トレンドが継続している模様
JEPAwiki, mishig, 2026.04
Paper/Blog Link My Issue
#Article #Blog #read-later #WorldModels #LatentRepresentation Issue Date: 2026-04-07 Comment
元ポスト:
Moonlake: Causal World Models should be Multimodal, Interactive, and Efficient — with Chris Manning and Fan-yun Sun, LatentSpace, 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #read-later #WorldModels Issue Date: 2026-04-05 Comment
元ポスト:
ibm-granite_granite-4.0-3b-vision, ibm-granite, 2026.03
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #VisionLanguageModel Issue Date: 2026-04-04 Comment
元ポスト:
Build with Veo 3.1 Lite, our most cost-effective video generation model, Google, 2026.03
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #Proprietary #VideoGeneration/Understandings #TextToVideoGeneration #ImageToVideoGeneration Issue Date: 2026-04-04 Comment
元ポスト:
Qwen3.5-Omni: Scaling Up, Toward Native Omni-Modal AGI, Qwen Team, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SpeechProcessing #Proprietary #VisionLanguageModel #2D (Image) #3D (Video) #Omni #AudioLanguageModel #audio #text Issue Date: 2026-04-04 Comment
元ポスト:
Matrix-Game 3.0: Real-Time and Streaming Interactive World Model with Long-Horizon Memory, Skywork AI, 2026.04
Paper/Blog Link My Issue
#Article #Transformer #SyntheticData #DiffusionModel #OpenWeight #VideoGeneration/Understandings #WorldModels #interactive #Game #3D (Video) #LongHorizon #Realtime #Initial Impression Notes Issue Date: 2026-04-02 Comment
元ポスト:
Unreal Engineで合成されたデータに基づいて学習されたDiTベースのWorld Modelらしい。
Acknowleagementから察するに、Wan2.2がベースモデルで、self-forcingが学習に用いられている。
- Wan2.2, Alibaba Wan, 2025.07
- [Paper Note] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion, Xun Huang+, NeurIPS'25
また、action control moduleをアーキテクチャに導入することで、汎用的な動画生成モデルにキーボード、マウス等のアクションによるコントロールを実現している模様。
- [Paper Note] GameFactory: Creating New Games with Generative Interactive Videos, Jiwen Yu+, arXiv'25, 2025.01
デコードの高速化には量子化を利用しているとのこと。
Gemma 4: Byte for byte, the most capable open models, Google, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #MultiModal #SpeechProcessing #Reasoning #OpenWeight #MoE(Mixture-of-Experts) #Selected Papers/Blogs #VisionLanguageModel #2D (Image) #3D (Video) #One-Line Notes #Reference Collection #AudioLanguageModel #audio #text #Initial Impression Notes Issue Date: 2026-04-02 Comment
元ポスト:
2B, 4B, 26BのMoEモデルと31BのDenseモデルの4種類のモデルファミリーで、マルチモーダル(vision)対応。2B, 4Bはaudioも入力として扱える。
edgeデバイス向けのモデルは128k, 他は256kのコンテキストウィンドウ。140+の多言語サポート。
Apache 2.0ライセンス
arenaで同サイズのモデル群でSoTAといった話がブログ中に記述されている。
モデルカードには一般的なベンチマーク群とのスコアも記載されている。
https://ai.google.dev/gemma/docs/core/model_card_4?hl=ja
(そもそも既存のベンチマークにもコンタミネーションがあると思われるが、)arenaに関しては特定の企業に対してデータを提供し、複数のモデルの亜種をテストできるという慣行があり、リーダーボードにバイアスがあるであろう点には注意:
- [Paper Note] The Leaderboard Illusion, Shivalika Singh+, NeurIPS'25
artificial analysisによる評価:
Qwenがproprietaryになったことから、ライセンス的に使いやすく、日本語に強そうなモデルとしては筆頭ではなかろうか。日本語性能が気になる。
アーキテクチャ解説:
ポイント解説:
所見:
attentionのscaleをsqrt(d)でスケールさせる代わりに、QK-norm, V normを適用するなど。
NvidiaによるNVFP4へのpost-trainingによる量子化:
https://huggingface.co/nvidia/Gemma-4-31B-IT-NVFP4
量子化後の性能も比較されており、知識、数学、コーディング、terminac useなど6種類のベンチマークでオリジナルのモデルと遜色ない性能が出ている旨記載されている。
解説:
https://newsletter.maartengrootendorst.com/p/a-visual-guide-to-gemma-4
所見(encoder-freeにした裏側でパッチ化→projection + x/y軸のpositional embeddingを実施している話):
Holo3: Breaking the Computer Use Frontier, H Company, 2026.03
Paper/Blog Link My Issue
#Article #NLP #AIAgents #MultiModal #OpenWeight #MoE(Mixture-of-Experts) #ComputerUse #read-later #VisionLanguageModel #One-Line Notes #GUI #Environment Issue Date: 2026-04-02 Comment
元ポスト:
HF: https://huggingface.co/Hcompany/Holo3-35B-A3B
関連:
- Holo2: Cost-Efficient Models for Cross-Platform Computer-Use Agents, H Company, 2025.11
Qwen3.5をファインチューニングすることで実現。以前のシリーズもQwenベースだったが、新たなQwenのリリースに伴いより強力なベースモデルを得て、かつシナリオをベースにして自動でwebsiteを構築しverifiableが可能な独自のEnvironmentを保持しており、多様な合成データの活用とRLを実現することで、性能が向上していると思われる。
sarashina2.2-ocr, SBIntuitions, 2026.03
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #Japanese #Selected Papers/Blogs #DocParser #OCR #Initial Impression Notes Issue Date: 2026-03-31 Comment
元ポスト:
縦書き文書に強いのは大変ありがたい
dots.ocrよりも日本語文書に対するCERとBLEUのスコアが良い。素晴らしい
chandra-ocr-2, datalab-to, 2026.03
Paper/Blog Link My Issue
#Article #MultiLingual #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #OCR #One-Line Notes Issue Date: 2026-03-21 Comment
元ポスト:
日本語の認識性能がGemini-2.5-Flashよりも高い。マルチリンガルでの認識性能がこらほど網羅的に列挙されているのはありがたい。
OpenClaw — Personal AI Assistant, openclaw, 2026.03
Paper/Blog Link My Issue
#Article #Tools #NLP #AIAgents #Repository #ComputerUse #Selected Papers/Blogs #WorkspaceAgents Issue Date: 2026-03-19 Comment
2026.04.07:
xperience-10m, ropedia-ai, 2026.03
Paper/Blog Link My Issue
#Article #Dataset #Selected Papers/Blogs #Robotics #3D (Video) #EmbodiedAI Issue Date: 2026-03-17 Comment
元ポスト:
Ropediaとは:
- Interactive Intelligence from Human Xperience, Ropedia, 2025.12
アナウンス:
5日で1.66M downloadsとのこと:
最近の主要なembodied AIのための基盤モデルに使われているとのこと:
computer-use-large, markov-ai, 2026.03
Paper/Blog Link My Issue
#Article #NLP #Dataset #AIAgents #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #3D (Video) #One-Line Notes Issue Date: 2026-03-15 Comment
元ポスト:
12,300時間程度の、プロフェッショナルなソフトウェア(AutoCAD, Blender, Excel, Photoshop, Salesforce VSCode)利用しているスクリーンのレコーディングデータとのこと。
CC-BY-4.0!?
FLUX.2-klein-9B, black-forest-labs, 2026.01
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #Transformer #TextToImageGeneration #SmallModel #Selected Papers/Blogs #2D (Image) #Editing #One-Line Notes Issue Date: 2026-03-15 Comment
元ポスト:
github: https://github.com/black-forest-labs/flux2
そもそも2025年11月にリリースされているFLUX.2は結構色々なところで名前を見かけるのでおさえておいたほうが良いかもしれない
https://bfl.ai/blog/flux-2
kleinはFLUX.2シリーズの中で最も軽量なモデルとのこと。2ヶ月程度で既に110k DLされている。
Reka Edge: Frontier-Level Edge Intelligence for Physical AI, Reka, 2026.03
Paper/Blog Link My Issue
#Article #NLP #MultiModal #OpenWeight #VisionLanguageModel Issue Date: 2026-03-14 Comment
元ポスト:
Moondream 3 Preview: Frontier-level reasoning at a blazing speed, Moondream, 2025.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #FoundationModel #Reasoning #SmallModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #KeyPoint Notes Issue Date: 2026-03-12 Comment
HF: https://huggingface.co/moondream/moondream3-preview
9B-A2Bの小規模なVLMで、
- visual reasoning: 小規模だが実タスクに適用可能なvisual reasoning性能
- trainable: Visual系のタスクは人間でもzero shotではできないことが多く、簡単にfinetuningできることが重要で
- fast: vision系のアプリケーションはリアルタイムのlavencyが求められることが多く
- inexpensive: 安くスケーラブルでなければならない
をテーマにしたモデルのようである。
object detection, pointing, 構造化された出力(犬の群の個々の犬の毛と首輪の色動画)、OCRなどの様々なタスクが実行可能で、GPT5, Gemini 2.5 Flash, Claude 4 Sonnetをこの規模感のモデルで、objec' detection, counting, document understanding, hallucinationに関するベンチマークで上回る。
前身のモデルであるmoondream2は、5Mダウンロードを達成したようだ
vikhyatk/moondream2
Self-Supervised Flow Matching for Scalable Multi-Modal Synthesis, Black Forest Labs, 2026.03
Paper/Blog Link My Issue
#Article #Pretraining #NLP #MultiModal #SpeechProcessing #Self-SupervisedLearning #read-later #2D (Image) #FlowMatching #3D (Video) #Omni #RectifiedFlow #audio Issue Date: 2026-03-10 Comment
backbone modelは下記のFLUX.2と呼ばれるモデル:
FLUX Commercial Licensing:
https://bfl.ai/licensing
先行研究:
- The Simulation Company, Simile, 2026.02
先行研究から読みたい
元ポスト:
Awesome World Models, knightnemo,
Paper/Blog Link My Issue
#Article #Survey #Robotics #WorldModels Issue Date: 2026-03-08
Awesome World Models for Robotics, leofan90,
Paper/Blog Link My Issue
#Article #Survey #Robotics #WorldModels Issue Date: 2026-03-08
Awesome From Video Generation to World Model, ziqihuangg, 2026.03
Paper/Blog Link My Issue
#Article #Survey #Robotics #WorldModels Issue Date: 2026-03-08 Comment
元ポスト:
Yuan3.0-Ultra, YuanLabAI, 2026.03
Paper/Blog Link My Issue
#Article #NLP #MultiModal #OpenWeight #MoE(Mixture-of-Experts) #VisionLanguageModel #UMM #One-Line Notes #Initial Impression Notes Issue Date: 2026-03-07 Comment
元ポスト:
MoEのwarmupが終わり安定してきたタイミングでルーティングがされにくいExpertを枝刈りし、残ったexpertに対してバランスよくルーティングがされるようなrearrangeをするアルゴリズム Layer-Adaptive Expert Pruning (LAEP)によって、パラメータサイズを1515Bから1010Bまで削減し、49%程度事前学習の効率を改善したとのこと。
RAG, multimodal document understanding, tabular data analysis, content summarizationにおいて、非常に高い性能を獲得している。tool useに関してはGPT-5.2(effort不明)以外には負けているので、優秀ではあるが特に秀でているというわけではないよつに見える(BFCVv3)。
しかし他のベンチマークでこれらフロンティアモデル群をここまでPass@1やAccで抜くのは、驚きではあるが、実際にどのような評価をしているのかはテクニカルレポートを見た方が良いと思われる。
ocr-bench, davanstrien, 2026.03
Paper/Blog Link My Issue
#Article #Tools #NLP #Evaluation #Repository #LLM-as-a-Judge #OCR #One-Line Notes #Initial Impression Notes Issue Date: 2026-03-06 Comment
元ポスト:
自分が試したいドキュメントのコレクションに対して、5つほどのOpenなOCRで実際に書き起こしを行い、VLM-as-a-JudgeでスコアリングしELOでの当該ドキュメントセットに対するスコアボードを作成するツール
非常に興味深く実用的だが、個人的にOlmOCRもサポートして欲しいなぁと思うなど。あと、機密性の高い文書などを扱う場面では、セキュリティ面にどれだけ配慮されているのかが気になってしまう。
HY-WU (Part I): An Extensible Functional Neural Memory Framework and An Instantiation in Text-Guided Image Editing, Tencent HY Team, 2026.03
Paper/Blog Link My Issue
#Article #Personalization #PEFT(Adaptor/LoRA) #2D (Image) #memory #Editing #One-Line Notes #ImageSynthesis #Adaptive Issue Date: 2026-03-06 Comment
元ポスト:
source imageとpromptから、frozenされたモデルに対するadapter weightを(finetuningなしで)動的に生成し、インスタンス固有のパラメータを用いることでinstance specificな演算を実現する
関連:
- [Paper Note] Doc-to-LoRA: Learning to Instantly Internalize Contexts, Rujikorn Charakorn+, arXiv'26, 2026.02
- [Paper Note] Text-to-LoRA: Instant Transformer Adaption, Rujikorn Charakorn+, ICML'25, 2025.06
NEO-unify: Building Native Multimodal Unified Models End to End, SenseTime, 2026.03
Paper/Blog Link My Issue
#Article #NLP #MultiModal #Post #Architecture #VisionLanguageModel #UMM #One-Line Notes #Pixel-based Issue Date: 2026-03-06 Comment
Vision EncoderやVAEを用いずに、pixel,wordの入力でnativeなunified modelを構築する。
takeawayとしては
- エンコーダーフリーなアーキテクチャでも、意味とピクセルの表現の両方を保持できる
- image reconstruction, image editingの両者において高い性能を獲得
- understandingとgenerationのtransformerを別々に事前学習し、その後両者を組み合わせて(Mixture of Transformer)追加のSFTをしているようだが、その際に両者のtransformerがconflictすることなく、understandingタスクは安定したままgenerationタスクは素早く収束するといった挙動を示した
- mid-training後により大規模なweb-scaleでの事前学習をするようだが、その際に競合モデルよりもよりデータ効率良く学習ができた
という感じらしい
Build with Nano Banana 2, our best image generation and editing model, Google, 2026.02
Paper/Blog Link My Issue
#Article #NLP #TextToImageGeneration #Proprietary #Editing #ImageSynthesis Issue Date: 2026-02-28 Comment
元ポスト:
NDLOCR-Liteの公開について, NDL Lab, 2026.02
Paper/Blog Link My Issue
#Article #NeuralNetwork #NLP #Blog #Repository #Japanese #Selected Papers/Blogs #Encoder-Decoder #OCR #One-Line Notes Issue Date: 2026-02-28 Comment
元ポスト:
江戸期以前の和古書、清代以前の漢籍といった古典籍資料のデジタル化画像からテキストデータを作成するOCRとのこと。以前はGPUで動作していたが、CPUで動作するようにした軽量版とのこと。すごい。
The First Fully General Computer Action Model, Standard Intelligence Team, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #FoundationModel #DiffusionModel #ComputerUse #3D (Video) #One-Line Notes #WorldActionModel Issue Date: 2026-02-27 Comment
元ポスト:
公式ポスト:
関連:
- [Paper Note] Video PreTraining (VPT): Learning to Act by Watching Unlabeled Online Videos, Bowen Baker+, arXiv'22, 2022.06
Training Recipeの部分を読むと、上記研究で提案されているVideo PreTrainingと同じ手法を用いているように見える。
つまり、Inverse Dynamics Modelを学習し、大量のvideoデータに対してアクションラベルを付与し、付与されたアクションラベルを用いて半教師あり学習によるnext action predictionを実施することによって基盤モデルを学習する、というアプローチ。
この基盤モデルによってたとえば1時間のサンフランシスコをdrivingしている動画によってfinetuningすることで、自動運転をするようなモデルが学習できる、といったことが実現可能な模様。
[Paper Note] Preconditioned inexact stochastic ADMM for deep models, Nature Machine Intelligence 2026, 2026.02
Paper/Blog Link My Issue
#Article #NeuralNetwork #MachineLearning #NLP #LanguageModel #Optimizer #Initial Impression Notes #Nature Machine Intelligence Issue Date: 2026-02-24 Comment
元ポスト:
パラメータサイズが大きい場合にMuon超え...?
所見:
Qwen3.5: Towards Native Multimodal Agents, Qwen Team, 2026.02
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #MultiModal #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) #read-later #Selected Papers/Blogs #VisionLanguageModel #UMM #KeyPoint Notes #Scalability #Environment Issue Date: 2026-02-17 Comment
元ポスト:
最新のQwenがリリース・・・!!
- Vision+TextのUMMを採用。
- real-world agentsのために訓練
- hybrid linear attention + sparse MoE + 環境スケーリングに基づくlarge scale RLを実施
- decodingのスループットがQwen3-Maxと比較して8.6--19.0倍
- 201の言語と方言をサポート
- 397B-A17B
- Gated DeltaNet
- Gated Attention
- context length: 262k
- Multi token prediction
- 言語系タスクではGPT5.2と比較して少し劣る程度、agenticなベンチマークでは大きく上回るものも存在(ただし、Claude 4.5 Opusには届いていないベンチマークが多いように見える)
- Vision系タスクでは全体的にGPT5.2, Opus 4.5よりも優秀に見え、Gemini 3 Proと同等か少し劣る程度に見える。
世はlinear attention時代
所見:
INT4モデル:
dots.ocr-1.5, rednote-hilab, 2026.02
Paper/Blog Link My Issue
#Article #NLP #MultiModal #StructuredData #SmallModel #OpenWeight #DocParser #OCR Issue Date: 2026-02-16 Comment
元ポスト:
[Paper Notes] Seed2.0 Model Card: Towards Intelligence Frontier for Real-World Complexity, Bytedance Seed, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Reasoning #Proprietary #VisionLanguageModel Issue Date: 2026-02-16 Comment
元ポスト:
所見:
Ming-flash-omni-2.0, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #Transformer #MultiModal #SpeechProcessing #DiffusionModel #Speech #OpenWeight #MoE(Mixture-of-Experts) #2D (Image) #Omni #text Issue Date: 2026-02-12 Comment
元ポスト:
関連:
- Ming-flash-omni-Preview, inclusionAI, 2025.10
- [Paper Note] Ming-Omni: A Unified Multimodal Model for Perception and Generation, Inclusion AI+, arXiv'25, 2025.06
公式ポスト:
Introducing Lab: The Full-Stack Platform for Training your Own Models, Prime Intellect, 2026.02
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #LanguageModel #Infrastructure #ReinforcementLearning #AIAgents #Blog #ScientificDiscovery #PostTraining #Selected Papers/Blogs #One-Line Notes #Reference Collection #Environment Issue Date: 2026-02-11 Comment
元ポスト:
事後学習、特にAgenticな研究の民主化のためのプラットフォームの提供
所見:
利用例 (Environment Hub):
new-datasets-in-machine-learning, librarian-bots, 2026.02
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #MachineLearning #InformationRetrieval #NLP #Dataset #Evaluation #SpeechProcessing #Robotics #Live Issue Date: 2026-02-09 Comment
元ポスト:
ModernBERTをFinetuningした分類器を用いてデータセットやベンチマークを提案している研究を自動分類して検索できるようにしている。有用
Intern-S1-Pro, internlm, 2026.02
Paper/Blog Link My Issue
#Article #NLP #MultiModal #Reasoning #PositionalEncoding #OpenWeight #MoE(Mixture-of-Experts) #VisionLanguageModel #Science Issue Date: 2026-02-05 Comment
元ポスト:
ポイント解説:
関連:
- [Paper Note] Intern-S1: A Scientific Multimodal Foundation Model, Lei Bai+, arXiv'25, 2025.08
Fourier Position Encoding (FoPE) + upgraded time-series modeling
MiniCPM-o-4_5, OpenBMB, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SpeechProcessing #DiffusionModel #OpenWeight #AutomaticSpeechRecognition(ASR) #VisionLanguageModel #TTS #Omni #AudioLanguageModel Issue Date: 2026-02-05 Comment
元ポスト:
The Second Pre-training Paradigm, Jim Fan, X, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #MultiModal #Post #Robotics #WorldModels #One-Line Notes Issue Date: 2026-02-05 Comment
事前学習がnext word predictionから過去の行動と状態によって条件付けられ次の(ある期間の)世界の状態を予測するワールドモデリング(next physical state prediction)へのパラダイムシフトの予想(というよりこのパラダイムシフトの真っ只中にいる)。人間の脳が処理する情報の多くは視覚であり、言語的な領域は部分的なことであることや、猿は言語的な能力が低くても視覚や運動、触覚などの感覚的情報から世界の物理法則を理解し知的なアクションをとるメンタルモデルを確立していることなどを引き合いに説明している。
New Holo2 model takes the lead in UI Localization, H Company, 2026.02
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #OpenWeight #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #Grounding #GUI Issue Date: 2026-02-05 Comment
HF: https://huggingface.co/Hcompany/Holo2-235B-A22B
元ポスト:
関連:
- Holo1.5 - Open Foundation Models for Computer Use Agents, H Company, 2025.09
Project Genie: Experimenting with infinite, interactive worlds, Google Deepmind, 2026.01
Paper/Blog Link My Issue
#Article #NLP #GenerativeAI #Proprietary #WorldModels #interactive Issue Date: 2026-01-30 Comment
元ポスト:
Googleからのworld model
Accelerating Diffusion Models with an Open, Plug-and-Play Offering, Nvidia, 2026.01
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Tools #NLP #DiffusionModel #TextToImageGeneration #Distillation #PostTraining #2D (Image) #Editing #3D (Video) #TextToVideoGeneration #ImageToTextGeneration #TrainingFramework Issue Date: 2026-01-29 Comment
元ポスト:
self forcingも実装されている
- [Paper Note] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion, Xun Huang+, NeurIPS'25
Introducing Agentic Vision in Gemini 3 Flash, Google Deepmind, 2026.01
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Proprietary #VisionLanguageModel #One-Line Notes Issue Date: 2026-01-29 Comment
元ポスト:
visual reasoningとコード実行の融合
DeepSeek-OCR-2, DeepSeek-AI, 2026.01
Paper/Blog Link My Issue
#Article #NLP #OCR #Compression Issue Date: 2026-01-27 Comment
元ポスト:
関連:
- DeepSeek-OCR: Contexts Optical Compression, DeepSeek, 2025.10
Minimax Agent, Minimax, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #GenerativeAI #ComputerUse Issue Date: 2026-01-27 Comment
code: https://github.com/MiniMax-AI/Mini-Agent
元ポスト:
Composing Weight and Data Sparsity in MoE: Improving compute efficiency through varying compute per token, Perceptron, 2026.01
Paper/Blog Link My Issue
#Article #Pretraining #NLP #MultiModal #MoE(Mixture-of-Experts) #read-later #VisionLanguageModel #Routing #Sparse #Initial Impression Notes Issue Date: 2026-01-23 Comment
元ポスト:
MoEがトークン単位でactivateするweightをサブセットにするweight sparcityによって効率化を実現する手法とみなしたときに、それぞれのinputに情報量の濃淡があることから現在のトークンごとにweightを割り当てるのではなく、weightごとにトークンを割り当てるというもう一つの軸を考えることができ(=Data Sparcity)、これをweightごとにトークンのsubsetしか持たないような実現方法をとるとcontextが損なわれauto-regressiveの前提が崩れるためtrain-inference-mismatchが生じるので、null experts(受け取ったトークンに対して何もしない)を実装して実現するみたいな話のように見えるが全くまだ読めていない。