
ComputerVision (930) — 3/5
[Paper Note] Mini-o3: Scaling Up Reasoning Patterns and Interaction Turns for Visual Search, Xin Lai+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #Reasoning #LongContext #OpenWeight #GRPO #VisionLanguageModel Issue Date: 2025-09-10 GPT Summary- Mini-o3システムは、数十ステップの深いマルチターン推論を実現し、視覚検索タスクで最先端の性能を達成。Visual Probe Datasetを構築し、多様な推論パターンを示すデータ収集パイプラインを開発。オーバーターンマスキング戦略により、ターン数が増えるほど精度が向上することを実証。 Comment
HF: https://huggingface.co/Mini-o3
pj page: https://mini-o3.github.io
元ポスト:
既存のオープンなVLMはマルチターンのターン数を増やせないという課題があったがそれを克服するレシピに関する研究な模様。元ポストによると6ターンまでのマルチターンで学習しても、inference時には32ターンまでスケールするとか。
[Paper Note] UI-TARS-2 Technical Report: Advancing GUI Agent with Multi-Turn Reinforcement Learning, Haoming Wang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #AIAgents #MultiModal #Reasoning #ComputerUse #VisionLanguageModel Issue Date: 2025-09-05 GPT Summary- UI-TARS-2は、GUI用自律エージェントの新しいモデルで、データ生成、安定化されたマルチターンRL、ハイブリッドGUI環境を統合。実証評価では、前モデルを大幅に上回り、複数のベンチマークで高いスコアを達成。約60%の人間レベルのパフォーマンスを示し、長期的な情報探索タスクにも適応可能。トレーニングダイナミクスの分析が安定性と効率向上の洞察を提供し、実世界のシナリオへの一般化能力を強調。 Comment
元ポスト:
1.5をリリースしてから5ヶ月で大幅に性能を向上した模様
[Paper Note] LLaVA-Critic-R1: Your Critic Model is Secretly a Strong Policy Model, Xiyao Wang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #Reasoning #OpenWeight #SelfCorrection #VisionLanguageModel #Critic Issue Date: 2025-09-04 GPT Summary- 本研究では、視覚と言語のモデリングにおいて、批評モデルを強化学習を用いて再編成し、生成モデルに直接適用する新しいアプローチを提案します。これにより、マルチモーダル批評モデルLLaVA-Critic-R1を生成し、視覚的推論ベンチマークで高い性能を示しました。さらに、自己批評を用いることで、追加の訓練なしに推論タスクでの性能を向上させることができることを示しました。この結果は、評価と生成の両方に優れた統一モデルを実現する可能性を示唆しています。 Comment
元ポスト:
HF: https://huggingface.co/collections/lmms-lab/llava-critic-r1-68922484e5822b89fab4aca1
[Paper Note] R-4B: Incentivizing General-Purpose Auto-Thinking Capability in MLLMs via Bi-Mode Annealing and Reinforce Learning, Jie Jiang+, arXiv'25
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #MultiModal #Reasoning #GRPO #VisionLanguageModel Issue Date: 2025-09-02 GPT Summary- R-4Bは、問題の複雑さに応じて思考を行うかどうかを適応的に判断する自動思考型のマルチモーダル大規模言語モデル(MLLM)である。思考能力と非思考能力を持たせ、バイモードポリシー最適化(BPO)を用いて思考プロセスの起動を精度良く判断する。訓練には多様なトピックのデータセットを使用し、実験結果はR-4Bが25のベンチマークで最先端のパフォーマンスを達成し、特に推論集約型タスクで低コストで高い性能を示したことを示している。 Comment
元ポスト:
VLMにthinking, non-thinkingを入力に応じて使い分けさせる手法
[Paper Note] Mixture of Contexts for Long Video Generation, Shengqu Cai+, arXiv'25
Paper/Blog Link My Issue
#LongContext #VideoGeneration/Understandings Issue Date: 2025-08-29 GPT Summary- 長動画生成における長いコンテキストメモリの問題を解決するため、スパース注意ルーティングモジュール「Mixture of Contexts(MoC)」を提案。MoCは、動的に情報量の多いチャンクと必須のアンカーを選択し、因果ルーティングを用いて注意を向ける。これにより、重要な履歴に計算リソースを割り当て、数分間のコンテンツにわたってアイデンティティやアクションを保持する。効率性が向上し、実用的なトレーニングと合成が可能になる。 Comment
pj page: https://primecai.github.io/moc/
元ポスト:
[Paper Note] OmniHuman-1.5: Instilling an Active Mind in Avatars via Cognitive Simulation, Jianwen Jiang+, arXiv'25
Paper/Blog Link My Issue
#Controllable #NLP #LanguageModel #MultiModal #DiffusionModel Issue Date: 2025-08-29 GPT Summary- 「OmniHuman-1.5」は、物理的妥当性と意味的一貫性を兼ね備えたキャラクターアニメーションを生成するフレームワークである。マルチモーダル大規模言語モデルを活用し、音声、画像、テキストの共同意味を解釈することで、感情や意図に基づいた動作を生成。新しいマルチモーダルDiTアーキテクチャにより、異なるモダリティ間の対立を軽減し、リップシンク精度や動作の自然さで優れたパフォーマンスを達成。複雑なシナリオへの拡張性も示している。 Comment
pj page: https://omnihuman-lab.github.io/v1_5/
元ポスト:
promptによって状況や感情などの表現のコントロールが可能らしい
解説:
[Paper Note] Matrix-Game 2.0: An Open-Source, Real-Time, and Streaming Interactive World Model, Xianglong He+, arXiv'25
Paper/Blog Link My Issue
#Transformer #DiffusionModel #OpenWeight #VideoGeneration/Understandings #WorldModels #Game Issue Date: 2025-08-28 GPT Summary- Matrix-Game 2.0を提案し、インタラクティブな世界モデルがリアルタイムで長いビデオを生成できるようにする。主なコンポーネントは、スケーラブルなデータ生成パイプライン、インタラクティブな条件を可能にするアクション注入モジュール、リアルタイム生成のための数ステップの蒸留。これにより、25 FPSで高品質な1分間のビデオを生成可能。モデルの重みとコードはオープンソース化。 Comment
元ポスト:
pj page: https://matrix-game-v2.github.io
公式:
[Paper Note] Ovis2.5 Technical Report, Shiyin Lu+, arXiv'25, 2025.08
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #Reasoning #OpenWeight #CurriculumLearning #VideoGeneration/Understandings #VisionLanguageModel #One-Line Notes Issue Date: 2025-08-28 GPT Summary- Ovis2.5は、ネイティブ解像度の視覚認識とマルチモーダル推論を強化するために設計されたモデルで、画像を可変解像度で処理し、複雑な視覚コンテンツの詳細を保持します。推論時には反省を行う「思考モード」を提供し、精度向上を図ります。5段階のカリキュラムで訓練され、マルチモーダルデータの効率的な処理を実現。Ovis2.5-9BはOpenCompassで平均78.3を記録し、Ovis2-8Bに対して大幅な改善を示しました。Ovis2.5-2Bも73.9を達成し、リソース制約のあるデバイスに最適です。STEMベンチマークや複雑なチャート分析においても優れた性能を発揮しています。 Comment
元ポスト:
HF:
https://huggingface.co/AIDC-AI/Ovis2.5-9B
Apache2.0ライセンス
GLM-4.1V-9B-Thinkingと同等以上の性能な模様。
- [Paper Note] GLM-4.1V-Thinking: Towards Versatile Multimodal Reasoning with Scalable Reinforcement Learning, GLM-V Team+, arXiv'25, 2025.07
[Paper Note] Self-Rewarding Vision-Language Model via Reasoning Decomposition, Zongxia Li+, arXiv'25
Paper/Blog Link My Issue
#NLP #Hallucination #SelfImprovement #VisionLanguageModel Issue Date: 2025-08-28 GPT Summary- Vision-Language Models (VLMs)は視覚的幻覚や言語的ショートカットに悩まされることが多い。これらの問題は、ポストトレーニング手法が中間の視覚的推論に対する指導を欠いているために生じる。本研究では、外部の視覚的監視に依存せずに視覚的推論を改善する自己報酬法Vision-SR1を提案。モデルは視覚的知覚と言語的推論を2段階に分解し、自己完結型の視覚的知覚を生成し、その後に言語的推論を行うことで報酬を計算する。実験により、Vision-SR1が視覚的推論を改善し、幻覚を軽減することが示された。 Comment
元ポスト:
ポイント解説:
[Paper Note] InternVL3.5: Advancing Open-Source Multimodal Models in Versatility, Reasoning, and Efficiency, Weiyun Wang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #read-later #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2025-08-26 GPT Summary- InternVL 3.5は、マルチモーダルモデルの新しいオープンソースファミリーで、Cascade Reinforcement Learningを用いて推論能力と効率を向上させる。粗から細へのトレーニング戦略により、MMMやMathVistaなどのタスクで大幅な改善を実現。Visual Resolution Routerを導入し、視覚トークンの解像度を動的に調整。Decoupled Vision-Language Deployment戦略により、計算負荷をバランスさせ、推論性能を最大16.0%向上させ、速度を4.05倍向上。最大モデルは、オープンソースのMLLMで最先端の結果を達成し、商業モデルとの性能ギャップを縮小。全てのモデルとコードは公開。 Comment
元ポスト:
ポイント解説:
[Paper Note] ToolVQA: A Dataset for Multi-step Reasoning VQA with External Tools, Shaofeng Yin+, arXiv'25
Paper/Blog Link My Issue
#Multi #NLP #Dataset #LanguageModel #AIAgents #SyntheticData #VisionLanguageModel Issue Date: 2025-08-24 GPT Summary- 本研究では、実世界のツール使用能力を向上させるために、23Kのインスタンスからなる大規模マルチモーダルデータセット「ToolVQA」を提案。ToolVQAは、実際の視覚的コンテキストと多段階推論タスクを特徴とし、ToolEngineを用いて人間のようなツール使用推論をシミュレート。7B LFMを微調整した結果、テストセットで優れたパフォーマンスを示し、GPT-3.5-turboを上回る一般化能力を持つことが確認された。 Comment
人間による小規模なサンプル(イメージシナリオ、ツールセット、クエリ、回答、tool use trajectory)を用いてFoundation Modelに事前知識として与えることで、よりrealisticなscenarioが合成されるようにした上で新たなVQAを4k程度合成。その後10人のアノテータによって高品質なサンプルにのみFilteringすることで作成された、従来よりも実世界の設定に近く、reasoningの複雑さが高いVQAデータセットな模様。
具体的には、image contextxが与えられた時に、ChatGPT-4oをコントローラーとして、前回のツールとアクションの選択をgivenにし、人間が作成したプールに含まれるサンプルの中からLongest Common Subsequence (LCS) による一致度合いに基づいて人手によるサンプルを選択し、動的にcontextに含めることで多様なで実世界により近しいmulti step tooluseなtrajectoryを合成する、といった手法に見える。pp.4--5に数式や図による直感的な説明がある。なお、LCSを具体的にどのような文字列に対して、どのような前処理をした上で適用しているのかまでは追えていない。
元ポスト:
[Paper Note] MM-BrowseComp: A Comprehensive Benchmark for Multimodal Browsing Agents, Shilong Li+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #AIAgents #Evaluation #Factuality #read-later #Selected Papers/Blogs Issue Date: 2025-08-22 GPT Summary- MM-BrowseCompは、AIエージェントのマルチモーダル検索および推論能力を評価する新しいベンチマークで、224の手作りの質問を含む。これにより、画像や動画を含む情報の重要性を考慮し、テキストのみの手法の限界を示す。最先端モデルの評価では、OpenAI o3などのトップモデルでも29.02%の精度にとどまり、マルチモーダル能力の最適化不足が明らかになった。 Comment
元ポスト:
[Paper Note] VisualWebInstruct: Scaling up Multimodal Instruction Data through Web Search, Yiming Jia+, EMNLP'25
Paper/Blog Link My Issue
#NLP #Dataset #QuestionAnswering #SyntheticData #MultiModal #Reasoning #EMNLP #PostTraining #VisionLanguageModel Issue Date: 2025-08-21 GPT Summary- 本研究では、推論に焦点を当てたマルチモーダルデータセットの不足に対処するため、VisualWebInstructという新しいアプローチを提案。30,000のシード画像からGoogle画像検索を用いて700K以上のユニークなURLを収集し、約900KのQAペアを構築。ファインチューニングされたモデルは、Llava-OVで10-20ポイント、MAmmoTH-VLで5ポイントの性能向上を示し、最良モデルMAmmoTH-VL2は複数のベンチマークで最先端の性能を達成。これにより、Vision-Language Modelsの推論能力向上に寄与することが示された。 Comment
元ポスト:
pj page: https://tiger-ai-lab.github.io/VisualWebInstruct/
verified versionが公開:
https://huggingface.co/datasets/TIGER-Lab/VisualWebInstruct_Verified
ポスト:
[Paper Note] JetFormer: An Autoregressive Generative Model of Raw Images and Text, Michael Tschannen+, ICLR'25
Paper/Blog Link My Issue
#Transformer #TextToImageGeneration #Architecture #ICLR #read-later #NormalizingFlow Issue Date: 2025-08-17 GPT Summary- JetFormerは、画像とテキストの共同生成を効率化する自己回帰型デコーダー専用のトランスフォーマーであり、別々にトレーニングされたコンポーネントに依存せず、両モダリティを理解・生成可能。正規化フローモデルを活用し、テキストから画像への生成品質で既存のベースラインと競合しつつ、堅牢な画像理解能力を示す。JetFormerは高忠実度の画像生成と強力な対数尤度境界を実現する初のモデルである。 Comment
openreview: https://openreview.net/forum?id=sgAp2qG86e
画像をnormalizing flowでソフトトークンに変換し、transformerでソフトトークンを予測させるように学習することで、テキストと画像を同じアーキテクチャで学習できるようにしました、みたいな話っぽい?おもしろそう
[Paper Note] UI-Venus Technical Report: Building High-performance UI Agents with RFT, Zhangxuan Gu+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #ComputerUse #VisionLanguageModel Issue Date: 2025-08-16 GPT Summary- UI-Venusは、スクリーンショットを入力として受け取るマルチモーダル大規模言語モデルに基づくネイティブUIエージェントで、UIグラウンディングとナビゲーションタスクで最先端の性能を達成。7Bおよび72Bバリアントは、Screenspot-V2 / Proベンチマークで高い成功率を記録し、既存のモデルを上回る。報酬関数やデータクリーニング戦略を導入し、ナビゲーション性能を向上させるための新しい自己進化フレームワークも提案。オープンソースのUIエージェントを公開し、さらなる研究を促進。コードはGitHubで入手可能。 Comment
元ポスト:
解説:
HF: https://huggingface.co/collections/inclusionAI/ui-venus-689f2fb01a4234cbce91c56a
[Paper Note] DINOv3, Oriane Siméoni+, arXiv'25, 2025.08
Paper/Blog Link My Issue
#Self-SupervisedLearning #Distillation #Regularization #read-later #Selected Papers/Blogs #Backbone #One-Line Notes #Reference Collection #needs-revision Issue Date: 2025-08-14 GPT Summary- 自己教師付き学習は、手動でのデータ注釈を不要とし、モデルのスケーラビリティを向上させる。DINOv3は、様々なデータソースから視覚表現を学ぶための新たな枠組みを提供し、データセットとモデルサイズの拡張や密な特徴マップの劣化問題に対処する「グラム・アンカリング」を導入。また、後処理戦略により柔軟性を高め、ファインチューニングなしで様々な設定で最先端の性能を発揮する。DINOv3は高品質な特徴量を生成し、広範な視覚タスクにおいて優れた結果を示し、多様なデプロイメントシナリオに対応するソリューションを提供する。 Comment
元ポスト:
HF: https://huggingface.co/docs/transformers/main/en/model_doc/dinov3
解説:
サマリ:
v2:
- [Paper Note] DINOv2: Learning Robust Visual Features without Supervision, Maxime Oquab+, TMLR'24
本日配信された岡野原氏のランチタイムトークによると、学習が進んでいくと全部の特徴量が似通ってきてしまう問題があったが、Gram Anchoringと呼ばれる、学習初期時点でのパッチ間の類似度度行列を保持しておき正則化として損失に加えることで、そこから離れすぎないように学習するといった工夫を実施しているとのこと。
詳細な日本語解説:
https://zenn.dev/syu_tan/articles/6df2947eb6c1ae
Gram Anchoringの気持ちとしては、長期で学習をすると、モデルがグローバルな特徴量を学習可能だが、個々のパッチレベルや密な部分のローカルな特徴量が失われていってしまい、ローカルな特徴が重要なdownstreamタスクの性能が劣化するため、これをなんとかしたい。そのために、画像全体のパッチ間の類似度行列によって、パッチ全体の類似度の構造を捉え、学習初期の高品質なローカルな特徴を捉えられたモデルを教師とし、そこから離れすぎないように学習中のモデルを生徒として正則化することで解決する、というものだと思われる。
事前学習のスケジューラーの工夫として以下を実施している:
- 事前学習の終了タイミングを事前に予測することは困難
- →事前に総ステップ数を指定しなければならないパラメータのスケジューリングはそもそも困難
- →スケジューリングを廃止する
- スケジューリングを廃止する代わりに
- 学習率とweight decay、teacher EMAのmomentumを固定して学習を実施
-
[Paper Note] Hunyuan-GameCraft: High-dynamic Interactive Game Video Generation with Hybrid History Condition, Jiaqi Li+, arXiv'25
Paper/Blog Link My Issue
#VideoGeneration/Understandings #interactive #Game Issue Date: 2025-08-14 GPT Summary- 「Hunyuan-GameCraft」という新しいフレームワークを提案し、ゲーム環境における高ダイナミックインタラクティブ動画生成を実現。キーボードとマウスの入力を統合し、動画シーケンスを自己回帰的に拡張することで、アクション制御と一貫性を向上。大規模データセットでトレーニングし、視覚的忠実性とリアリズムを強化。実験により、既存モデルを大幅に上回る性能を示した。 Comment
元ポスト:
単体の画像と、prompt、マウス・キーボード入力に基づいてinteractiveに動画を合成する。軽量なGPUでも動作するように、高品質な合成データによってモデルを蒸留し軽量なモデルを利用したりもしている模様。そのうち家庭のゲーミングPCでこういったモデルでゲームをする日が来るのだろうか。
アーキテクチャに使われている技術:
- [Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
- Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
[Paper Note] WebWatcher: Breaking New Frontier of Vision-Language Deep Research Agent, Xinyu Geng+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #SyntheticData #Evaluation #MultiModal #VisionLanguageModel #DeepResearch Issue Date: 2025-08-14 GPT Summary- WebWatcherは、視覚と言語の推論能力を強化したマルチモーダルエージェントであり、情報探索の困難さに対処する。合成マルチモーダル軌跡を用いた効率的なトレーニングと強化学習により、深い推論能力を向上させる。新たに提案されたBrowseComp-VLベンチマークでの実験により、WebWatcherは複雑なVQAタスクで他のエージェントを大幅に上回る性能を示した。 Comment
元ポスト:
公式:
[Paper Note] Grounding Multilingual Multimodal LLMs With Cultural Knowledge, Jean de Dieu Nyandwi+, EMNLP'25
Paper/Blog Link My Issue
#NLP #Dataset #EMNLP #PostTraining #Selected Papers/Blogs #VisionLanguageModel #Cultural Issue Date: 2025-08-13 GPT Summary- MLLMsは高リソース環境で優れた性能を示すが、低リソース言語や文化的エンティティに対しては課題がある。これに対処するため、Wikidataを活用し、文化的に重要なエンティティを表す画像を用いた多言語視覚質問応答データセット「CulturalGround」を生成。CulturalPangeaというオープンソースのMLLMを訓練し、文化に基づいたアプローチがMLLMsの文化的ギャップを縮小することを示した。CulturalPangeaは、従来のモデルを平均5.0ポイント上回る性能を達成。 Comment
元ポスト:
pj page:
https://neulab.github.io/CulturalGround/
VQAデータセット中の日本語データは3.1%程度で、
ベースモデルとして
- [Paper Note] Pangea: A Fully Open Multilingual Multimodal LLM for 39 Languages, Xiang Yue+, arXiv'24
を利用(Qwen2-7Bに対してCLIPベースのvision encoderを利用したVLM)し、Vision Encoderはfrozenし、LLMとconnector(テキストと画像のモダリティの橋渡しをする(大抵は)MLP)のみをfinetuningした。catastrophic forgettingを防ぐために事前学習データの一部を補完しfinetuningでも利用し、エンティティの認識力を高めるためにM3LSデータなるものをフィルタリングして追加している。
Finetuningの結果、文化的な多様性を持つ評価データ(e.g., [Paper Note] CVQA: Culturally-diverse Multilingual Visual Question Answering
Benchmark, David Romero+, arXiv'24
Figure1のJapaneseのサンプルを見ると一目でどのようなベンチか分かる)と一般的なマルチリンガルな評価データの双方でgainがあることを確認。
VQAによるフィルタリングで利用されたpromptは下記
[Paper Note] AR-GRPO: Training Autoregressive Image Generation Models via Reinforcement Learning, Shihao Yuan+, arXiv'25
Paper/Blog Link My Issue
#Transformer #ReinforcementLearning #TextToImageGeneration #GRPO #On-Policy #Encoder-Decoder Issue Date: 2025-08-12 GPT Summary- AR-GRPOは、自己回帰画像生成モデルにオンライン強化学習を統合した新しいアプローチで、生成画像の品質を向上させるためにGRPOアルゴリズムを適用。クラス条件およびテキスト条件の画像生成タスクで実験を行い、標準のARモデルと比較して品質と人間の好みを大幅に改善した。結果は、AR画像生成における強化学習の有効性を示し、高品質な画像合成の新たな可能性を開く。 Comment
元ポスト:
[Paper Note] MolmoAct: Action Reasoning Models that can Reason in Space, Jason Lee+, arXiv'25
Paper/Blog Link My Issue
#NLP #MultiModal #SpeechProcessing #Reasoning #OpenWeight #VisionLanguageActionModel Issue Date: 2025-08-12 GPT Summary- アクション推論モデル(ARMs)であるMolmoActは、知覚、計画、制御を三段階のパイプラインで統合し、説明可能で操作可能な行動を実現。シミュレーションと実世界で高いパフォーマンスを示し、特にSimplerEnv Visual Matchingタスクで70.5%のゼロショット精度を達成。MolmoAct Datasetを公開し、トレーニングによりベースモデルのパフォーマンスを平均5.5%向上。全てのモデルの重みやデータセットを公開し、ARMsの構築に向けたオープンな設計図を提供。 Comment
`Action Reasoning Models (ARMs)`
元ポスト:
blog: https://allenai.org/blog/molmoact
models:
-
https://huggingface.co/allenai/MolmoAct-7B-D-Pretrain-0812
-
https://huggingface.co/allenai/MolmoAct-7B-D-0812
datasets:
-
https://huggingface.co/datasets/allenai/MolmoAct-Dataset
-
https://huggingface.co/datasets/allenai/MolmoAct-Pretraining-Mixture
-
https://huggingface.co/datasets/allenai/MolmoAct-Midtraining-Mixture
データは公開されているが、コードが見当たらない?
チェックポイントとコードも公開された模様:
-
- https://github.com/allenai/MolmoAct
[Paper Note] StructVRM: Aligning Multimodal Reasoning with Structured and Verifiable Reward Models, Xiangxiang Zhang+, arXiv'25
Paper/Blog Link My Issue
#NLP #ReinforcementLearning #SyntheticData #MultiModal #RLVR #VisionLanguageModel Issue Date: 2025-08-10 GPT Summary- StructVRMは、複雑な多質問推論タスクにおいて、部分的な正確性を評価するための構造化された検証可能な報酬モデルを導入。サブ質問レベルのフィードバックを提供し、微妙な部分的なクレジットスコアリングを可能にする。実験により、Seed-StructVRMが12のマルチモーダルベンチマークのうち6つで最先端のパフォーマンスを達成したことが示された。これは、複雑な推論におけるマルチモーダルモデルの能力向上に寄与する。 Comment
元ポスト:
複数のsub-questionが存在するような複雑な問題に対して、既存のRLVRにおける全体に対してbinary rewardを適用する方法は報酬が荒すぎるため、よりfine-grainedなverifiableな報酬を設計することで、学習を安定化し性能も向上
以下がverifierのサンプル
general purposeなreal worldに対するmultimodal reasoningシステムを作成するには高品質で多様なデータが必要なので、以下のようなパイプラインを用いて、学習データを合成している模様。後で読む。サマリが元ポストに記載されているので全体像をざっくり知りたい場合は参照のこと。
[Paper Note] Scaling Vision Pre-Training to 4K Resolution, Baifeng Shi+, arXiv'25
Paper/Blog Link My Issue
#Pretraining #ContrastiveLearning #Encoder Issue Date: 2025-08-07 GPT Summary- PS3を用いてCLIPスタイルの視覚事前学習を4K解像度にスケールアップし、計算コストを抑えつつ高解像度の視覚認識を改善。VILA-HDモデルは、低解像度でのグローバル画像エンコードを行い、局所的な高解像度領域を選択的に処理。これにより、従来のベースラインと比較して高い性能を発揮し、トークン使用量を最大4.3倍削減。PS3は解像度のスケーリング特性を持ち、複数のベンチマークで優れた効率を達成。新たに提案された4KProベンチマークでは、VILA-HDが他のMLLMを上回る結果を示した。 Comment
元ポスト:
商用利用は不可な模様
[Paper Note] BUFFER-X: Towards Zero-Shot Point Cloud Registration in Diverse Scenes, Minkyun Seo+, ICCV'25
Paper/Blog Link My Issue
#read-later #ICCV Issue Date: 2025-08-03 GPT Summary- BUFFER-Xというゼロショット登録パイプラインを提案し、環境特有のボクセルサイズや探索半径への依存、ドメイン外ロバスト性の低さ、スケール不一致の問題に対処。マルチスケールのパッチベースの記述子生成と階層的インライア検索を用いて、さまざまなシーンでのロバスト性を向上。新しい一般化ベンチマークを用いて、BUFFER-Xが手動調整なしで大幅な一般化を達成することを示した。 Comment
元ポスト:
この辺の分野ぱっと見で全然わからない…
[Paper Note] MetaCLIP 2: A Worldwide Scaling Recipe, Yung-Sung Chuang+, NeurIPS'25 Spotlight
Paper/Blog Link My Issue
#NLP #Dataset #MultiLingual #CLIP #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-07-30 GPT Summary- MetaCLIP 2を提案し、CLIPをゼロから訓練するための新しいアプローチを示す。英語と非英語データの相互利益を得るための最小限の変更を加え、ゼロショットのImageNet分類で英語専用モデルを上回る性能を達成。多言語ベンチマークでも新たな最先端を記録。 Comment
元ポスト:
マルチリンガルなCLIP
HF: https://huggingface.co/facebook/metaclip-2-mt5-worldwide-b32
[Paper Note] Ming-Omni: A Unified Multimodal Model for Perception and Generation, Inclusion AI+, arXiv'25, 2025.06
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #SpeechProcessing #OpenWeight #read-later #Selected Papers/Blogs #UMM #Omni Issue Date: 2025-07-26 GPT Summary- Ming-Omniは、画像、テキスト、音声、動画を処理できる統一マルチモーダルモデルで、音声生成と画像生成において優れた能力を示す。専用エンコーダを用いて異なるモダリティからトークンを抽出し、MoEアーキテクチャで処理することで、効率的にマルチモーダル入力を融合。音声デコーダと高品質な画像生成を統合し、コンテキストに応じたチャットやテキストから音声への変換、画像編集が可能。Ming-Omniは、GPT-4oに匹敵する初のオープンソースモデルであり、研究と開発を促進するためにコードとモデルの重みを公開。 Comment
元ポスト:
現在はv1.5も公開されておりさらに性能が向上している模様?
[Paper Note] CaptionSmiths: Flexibly Controlling Language Pattern in Image Captioning, Kuniaki Saito+, arXiv'25
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #LanguageModel #VisionLanguageModel Issue Date: 2025-07-25 GPT Summary- CaptionSmithsは、画像キャプショニングモデルがキャプションの特性(長さ、記述性、単語の独自性)を柔軟に制御できる新しいアプローチを提案。人間の注釈なしで特性を定量化し、短いキャプションと長いキャプションの間で補間することで条件付けを実現。実証結果では、出力キャプションの特性をスムーズに変化させ、語彙的整合性を向上させることが示され、誤差を506%削減。コードはGitHubで公開。 Comment
元ポスト:
従来はDiscreteに表現されていたcaptioningにおける特性をCondition Caluculatorを導入することでcontinuousなrepresentationによって表現し、Caluculatorに人間によるinput, あるいは表現したいConditionを持つexampleをinputすることで、生成時に反映させるような手法を提案している模様。Conditionで利用するpropertyについては、提案手法ではLength, Descriptive, Uniqueness of Vocabulariesの3つを利用している(が、他のpropertyでも本手法は適用可能と思われる)。このとき、あるpropertyの値を変えることで他のpropertyが変化してしまうと制御ができなくなるため、property間のdecorrelationを実施している。これは、あるproperty Aから別のproperty Bの値を予測し、オリジナルのpropertyの値からsubtractする、といった処理を順次propertyごとに実施することで実現される。Appendixに詳細が記述されている。
[Paper Note] V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning, Mido Assran+, arXiv'25, 2025.06
Paper/Blog Link My Issue
#Pretraining #RepresentationLearning #Self-SupervisedLearning #Robotics #WorldModels #EmbodiedAI #LatentRepresentation Issue Date: 2025-07-24 GPT Summary- 自己教師あり学習を用いて、インターネット規模のビデオデータと少量のロボットデータを組み合わせ、物理世界を理解・予測・計画できるモデルV-JEPA 2を開発。モーション理解で高精度を達成し、動画質問応答タスクで最先端性能を示す。また、V-JEPA 2をロボット計画に適用し、ゼロショットで物体のピックアンドプレースを実現。ウェブとロボットデータからの自己教師あり学習で、物理世界における計画可能なワールドモデルを構築できることを示す。
[Paper Note] Streaming 4D Visual Geometry Transformer, Dong Zhuo+, arXiv'25
Paper/Blog Link My Issue
#read-later #4D Reconstruction Issue Date: 2025-07-17 GPT Summary- 動画から4D空間-時間幾何学を認識・再構築するために、ストリーミング4Dビジュアルジオメトリトランスフォーマーを提案。因果トランスフォーマーアーキテクチャを用いて、過去の情報をキャッシュしながらリアルタイムで4D再構築を実現。効率的なトレーニングのために、双方向ビジュアルジオメトリからの知識蒸留を行い、推論速度を向上させつつ競争力のある性能を維持。スケーラブルな4Dビジョンシステムの実現に寄与。 Comment
元ポスト:
モデルのアーキテクチャ
[Paper Note] ExPLoRA: Parameter-Efficient Extended Pre-Training to Adapt Vision Transformers under Domain Shifts, Samar Khanna+, ICML'25
Paper/Blog Link My Issue
#Pretraining #Transformer #PEFT(Adaptor/LoRA) #ICML #Finetuning #KeyPoint Notes Issue Date: 2025-07-14 GPT Summary- PEFT技術を用いたExPLoRAは、事前学習済みビジョントランスフォーマー(ViT)を新しいドメインに適応させる手法で、教師なし事前学習を通じて効率的にファインチューニングを行う。実験では、衛星画像において最先端の結果を達成し、従来のアプローチよりも少ないパラメータで精度を最大8%向上させた。 Comment
元ポスト:
これまでドメイン適応する場合にラベル付きデータ+LoRAでFinetuningしていたのを、ラベル無しデータ+継続事前学習の枠組みでやりましょう、という話のようである。
手法は下記で、事前学習済みのモデルに対してLoRAを適用し継続事前学習する。ただし、最後尾のLayer、あるいは最初と最後尾のLayerの両方をunfreezeして、trainableにする。また、LoRAはfreezeしたLayerのQ,Vに適用し、それらのLayerのnormalization layerもunfreezeする。最終的に、継続事前学習したモデルにヘッドをconcatしてfinetuningすることで目的のタスクを実行できるようにする。詳細はAlgorithm1を参照のこと。
同じモデルで単にLoRAを適用しただけの手法や、既存手法をoutperform
画像+ViT系のモデルだけで実験されているように見えるが、LLMとかにも応用可能だと思われる。
[Paper Note] VisualPuzzles: Decoupling Multimodal Reasoning Evaluation from Domain Knowledge, Yueqi Song+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #Selected Papers/Blogs #VisionLanguageModel #KeyPoint Notes Issue Date: 2025-07-14 GPT Summary- VisualPuzzlesは、専門知識への依存を最小限に抑えた視覚的推論を評価する新しいベンチマークで、5つの推論カテゴリーから成る多様な質問を含む。実験により、VisualPuzzlesはドメイン特有の知識を大幅に減少させ、より複雑な推論を要求することが示された。最先端のマルチモーダルモデルは、VisualPuzzlesで人間のパフォーマンスに遅れをとり、知識集約型タスクでの成功が推論タスクでの成功に必ずしもつながらないことが明らかになった。また、モデルのサイズとパフォーマンスの間に明確な相関は見られず、VisualPuzzlesは事実の記憶を超えた推論能力を評価する新たな視点を提供する。 Comment
元ポスト:
画像はPJページより引用。新たにVisual Puzzleと呼ばれる特定のドメイン知識がほとんど必要ないマルチモーダルなreasoningベンチマークを構築。o1ですら、人間の5th percentileに満たない性能とのこと。
Chinese Civil Service Examination中のlogical reasoning questionを手作業で翻訳したとのこと。
データセットの統計量は以下で、合計1168問で、難易度は3段階に分かれている模様。
project page:
https://neulab.github.io/VisualPuzzles/
Gemini 3 Proはo4-mini, o3などにスコアで負けているとのこと:
興味深い。マルチモーダルの推論能力に関してはまだまだ改善の余地がある。
[Paper Note] Kimi-VL Technical Report, Kimi Team+, arXiv'25
Paper/Blog Link My Issue
#NLP #MultiModal #Reasoning #OpenWeight #VisionLanguageModel Issue Date: 2025-07-14 GPT Summary- Kimi-VLは、効率的なオープンソースのMixture-of-Expertsビジョン・ランゲージモデルであり、2.8Bパラメータの言語デコーダーを活性化して高度なマルチモーダル推論を実現。マルチターンエージェントタスクや大学レベルの画像・動画理解において優れた性能を示し、最先端のVLMと競争。128Kの拡張コンテキストウィンドウを持ち、長い入力を処理可能。Kimi-VL-Thinking-2506は、長期的推論能力を強化するために教師ありファインチューニングと強化学習を用いて開発され、堅牢な一般能力を獲得。コードは公開されている。 Comment
- [Paper Note] Measuring Multimodal Mathematical Reasoning with MATH-Vision Dataset, Ke Wang+, NeurIPS'24 Datasets and Benchmarks Track
での性能(Vision+テキストの数学の問題)。他の巨大なモデルと比べ2.8BのActivation paramsで高い性能を達成
その他のベンチマークでも高い性能を獲得
モデルのアーキテクチャ。MoonViT (Image Encoder, 1Dのpatchをinput, 様々な解像度のサポート, FlashAttention, SigLIP-SO-400Mを継続事前学習, RoPEを採用) + Linear Projector + MoE Language Decoderの構成
学習のパイプライン。ViTの事前学習ではSigLIP loss (contrastive lossの亜種)とcaption生成のcross-entropy lossを採用している。joint cooldown stageにおいては、高品質なQAデータを合成することで実験的に大幅に性能が向上することを確認したので、それを採用しているとのこと。optimizerは
- [Paper Note] Muon is Scalable for LLM Training, Jingyuan Liu+, arXiv'25, 2025.02
post-trainingにおけるRLでは以下の目的関数を用いており、RLVRを用いつつ、現在のポリシーモデルをreferenceとし更新をするような目的関数になっている。curriculum sampling, prioritize samplingをdifficulty labelに基づいて実施している。
[Paper Note] Perception-Aware Policy Optimization for Multimodal Reasoning, Zhenhailong Wang+, arXiv'25
Paper/Blog Link My Issue
#NLP #ReinforcementLearning #MultiModal #Reasoning #On-Policy #VisionLanguageModel Issue Date: 2025-07-12 GPT Summary- 強化学習における検証可能な報酬(RLVR)は、LLMsに多段階推論能力を与えるが、マルチモーダル推論では最適な性能を発揮できない。視覚入力の認識が主なエラー原因であるため、知覚を意識したポリシー最適化(PAPO)を提案。PAPOはGRPOの拡張で、内部監視信号から学習し、追加のデータや外部報酬に依存しない。KLダイバージェンス項を導入し、マルチモーダルベンチマークで4.4%の改善、視覚依存タスクでは8.0%の改善を達成。知覚エラーも30.5%減少し、PAPOの効果を示す。研究は視覚に基づく推論を促進する新しいRLフレームワークの基盤を築く。 Comment
元ポスト:
VLMにおいて、画像をマスクした場合のポリシーモデルの出力と、画像をマスクしない場合のポリシーモデルの出力のKL Divergenceを最大化することで、画像の認知能力が向上し性能向上するよ、みたいな話な模様。
[Paper Note] SmolVLM: Redefining small and efficient multimodal models, Andrés Marafioti+, arXiv'25
Paper/Blog Link My Issue
#NLP #MultiModal #SmallModel #OpenWeight #Architecture #COLM #read-later #Selected Papers/Blogs #VisionLanguageModel #EdgeDevices Issue Date: 2025-07-09 GPT Summary- SmolVLMは、リソース効率の良い推論のために設計されたコンパクトなマルチモーダルモデルシリーズであり、低い計算オーバーヘッドを持つアーキテクチャやトークン化戦略を採用。最小モデルのSmolVLM-256Mは、1GB未満のGPUメモリでIdefics-80Bモデルを上回る性能を発揮し、最大モデルは2.2Bパラメータで最先端のVLMに匹敵。これにより、エネルギー効率の良い実用的な展開が可能となる。 Comment
HFSpace: https://huggingface.co/blog/smolervlm
元ポスト:
openreview: https://openreview.net/forum?id=qMUbhGUFUb
[Paper Note] VLM2Vec: Training Vision-Language Models for Massive Multimodal Embedding Tasks, Ziyan Jiang+, ICLR'25
Paper/Blog Link My Issue
#Embeddings #NLP #Dataset #Evaluation #MultiModal #ICLR #read-later #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2025-07-09 GPT Summary- 本研究では、ユニバーサルマルチモーダル埋め込みモデルの構築を目指し、二つの貢献を行った。第一に、MMEB(Massive Multimodal Embedding Benchmark)を提案し、36のデータセットを用いて分類や視覚的質問応答などのメタタスクを網羅した。第二に、VLM2Vecというコントラストトレーニングフレームワークを開発し、視覚-言語モデルを埋め込みモデルに変換する手法を示した。実験結果は、VLM2Vecが既存のモデルに対して10%から20%の性能向上を達成することを示し、VLMの強力な埋め込み能力を証明した。 Comment
openreview: https://openreview.net/forum?id=TE0KOzWYAF
[Paper Note] VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents, Rui Meng+, arXiv'25
Paper/Blog Link My Issue
#Embeddings #InformationRetrieval #NLP #LanguageModel #MultiModal #RAG(RetrievalAugmentedGeneration) #read-later #Selected Papers/Blogs #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2025-07-09 GPT Summary- VLM2Vec-V2という統一フレームワークを提案し、テキスト、画像、動画、視覚文書を含む多様な視覚形式の埋め込みを学習。新たにMMEB-V2ベンチマークを導入し、動画検索や視覚文書検索など5つのタスクを追加。広範な実験により、VLM2Vec-V2は新タスクで強力なパフォーマンスを示し、従来の画像ベンチマークでも改善を達成。研究はマルチモーダル埋め込みモデルの一般化可能性に関する洞察を提供し、スケーラブルな表現学習の基盤を築く。 Comment
元ポスト:
Video Classification, Visual Document Retrievalなどのモダリティも含まれている。
[Paper Note] On the Trustworthiness of Generative Foundation Models: Guideline, Assessment, and Perspective, Yue Huang+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Hallucination #Faithfulness #TextToImageGeneration #Sycophancy #Safety #Toxicity #Trustfulness #Selected Papers/Blogs #VisionLanguageModel #Privacy #One-Line Notes #ImageSynthesis #Robustness #Fairness Issue Date: 2025-07-08 GPT Summary- GenFMの信頼性向上に向け、AIガバナンスや産業標準を体系的に分析し、技術・倫理・法・社会的観点を統合した指針を提案。 テキスト・画像生成モデルやLLM、VLMを対象に、メタデータのキュレーション、テストケース生成、文脈変化に対応する動的評価基盤TrustGenを導入。 信頼性の進展と残存課題を明らかにし、有用性とのトレードオフや今後の研究方針を整理するとともに、動的評価ツールキットを公開。 Comment
元ポスト:
信頼性のある生成AIに関して、主要な企業がどのような取り組みをしているか、そもそもどのような観点で評価が実施されるかなどが、T2I, LLM, VLMなどにわかれて、各指標の定義や各モデルのベンチマークスコアなどが網羅的に記載されているようである。
[Paper Note] Energy-Based Transformers are Scalable Learners and Thinkers, Alexi Gladstone+, arXiv'25, 2025.07
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Transformer #MultiModal #Architecture #VideoGeneration/Understandings #VisionLanguageModel #Energy-based #Author Thread-Post Issue Date: 2025-07-06 GPT Summary- 入力と候補予測の適合性を検証するEnergy-Based Transformer(EBT)を訓練し、エネルギー最小化によって推論を行う。離散的なテキストと連続的な視覚の両方に対応し、教師なし学習のみでシステム2思考を実現。訓練時のスケーリングと推論時の性能で既存モデルを上回り、下流タスクでも優れた一般化能力を示した。 Comment
元ポスト:
Project Page: https://energy-based-transformers.github.io
First Authorの方による解説ポスト:
[Paper Note] Learning Dense Feature Matching via Lifting Single 2D Image to 3D Space, Yingping Liang+, arXiv'25
Paper/Blog Link My Issue
#DiffusionModel #2D (Image) #3D (Scene) #FeatureMatching Issue Date: 2025-07-04 GPT Summary- 新しい二段階フレームワーク「Lift to Match (L2M)」を提案し、2D画像を3D空間に持ち上げることで、特徴マッチングの一般化を向上させる。第一段階で3D特徴エンコーダを学習し、第二段階で特徴デコーダを学習することで、堅牢な特徴マッチングを実現。実験により、ゼロショット評価ベンチマークで優れた一般化性能を示した。 Comment
元ポスト:
[Paper Note] GLM-4.1V-Thinking: Towards Versatile Multimodal Reasoning with Scalable Reinforcement Learning, GLM-V Team+, arXiv'25, 2025.07
Paper/Blog Link My Issue
#Pretraining #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #MultiModal #RLHF #Reasoning #LongContext #mid-training #RewardHacking #PostTraining #CurriculumLearning #RLVR #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2025-07-03 GPT Summary- 視覚言語モデルGLM-4.1V-Thinkingを発表し、推論中心のトレーニングフレームワークを開発。強力な視覚基盤モデルを構築し、カリキュラムサンプリングを用いた強化学習で多様なタスクの能力を向上。28のベンチマークで最先端のパフォーマンスを達成し、特に難しいタスクで競争力のある結果を示す。モデルはオープンソースとして公開。 Comment
元ポスト:
Qwen2.5-VLよりも性能が良いVLM
アーキテクチャはこちら。が、pretraining(データのフィルタリング, マルチモーダル→long context継続事前学習)->SFT(cold startへの対処, reasoning能力の獲得)->RL(RLVRとRLHFの併用によるパフォーマンス向上とAlignment, RewardHackingへの対処,curriculum sampling)など、全体の学習パイプラインの細かいテクニックの積み重ねで高い性能が獲得されていると考えられる。
[Paper Note] Do Vision-Language Models Have Internal World Models? Towards an Atomic Evaluation, Qiyue Gao+, ACL(Findings)'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #ACL #VisionLanguageModel #Findings #Author Thread-Post Issue Date: 2025-07-02 GPT Summary- 内部世界モデル(WMs)はエージェントの理解と予測を支えるが、最近の大規模ビジョン・ランゲージモデル(VLMs)の基本的なWM能力に関する評価は不足している。本研究では、知覚と予測を評価する二段階のフレームワークを提案し、WM-ABenchというベンチマークを導入。15のVLMsに対する660の実験で、これらのモデルが基本的なWM能力に顕著な制限を示し、特に運動軌道の識別においてほぼランダムな精度であることが明らかになった。VLMsと人間のWMとの間には重要なギャップが存在する。 Comment
元ポスト:
所見:
[Paper Note] MARBLE: A Hard Benchmark for Multimodal Spatial Reasoning and Planning, Yulun Jiang+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #MultiModal #Initial Impression Notes Issue Date: 2025-07-02 GPT Summary- MARBLEという新しいマルチモーダル推論ベンチマークを提案し、MLLMsの複雑な推論能力を評価。MARBLEは、空間的・視覚的・物理的制約下での多段階計画を必要とするM-PortalとM-Cubeの2つのタスクから成る。現在のMLLMsは低いパフォーマンスを示し、視覚的入力からの情報抽出においても失敗が見られる。これにより、次世代モデルの推論能力向上が期待される。 Comment
元ポスト:
Portal2を使った新たなベンチマーク。筆者は昔このゲームを少しだけプレイしたことがあるが、普通に難しかった記憶がある😅
細かいが表中のGPT-o3は正しくはo3だと思われる。
時間がなくて全然しっかりと読めていないが、reasoning effortやthinkingモードはどのように設定して評価したのだろうか。
[Paper Note] SMMILE: An Expert-Driven Benchmark for Multimodal Medical In-Context Learning, Melanie Rieff+, arXiv'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Zero/Few/ManyShotPrompting #MultiModal #In-ContextLearning Issue Date: 2025-07-01 GPT Summary- マルチモーダルインコンテキスト学習(ICL)は医療分野での可能性があるが、十分に探求されていない。SMMILEという医療タスク向けの初のマルチモーダルICLベンチマークを導入し、111の問題を含む。15のMLLMの評価で、医療タスクにおけるICL能力が中程度から低いことが示された。ICLはSMMILEで平均8%、SMMILE++で9.4%の改善をもたらし、無関係な例がパフォーマンスを最大9.5%低下させることも確認。例の順序による最近性バイアスがパフォーマンス向上に寄与することも明らかになった。 Comment
元ポスト:
[Paper Note] OpenVision: A Fully-Open, Cost-Effective Family of Advanced Vision Encoders for Multimodal Learning, Xianhang Li+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #OpenWeight #OpenSource #Selected Papers/Blogs #ICCV #Encoder #Backbone #One-Line Notes Issue Date: 2025-06-26 GPT Summary- CLIPに代わる完全にオープンで費用対効果に優れた視覚エンコーダ群OpenVisionを提案。 CLIPSとRecap-DataComp-1Bを基盤に、LLaVAなどのマルチモーダルモデルでCLIPと同等以上の性能を実現。 5.9M〜632.1Mパラメータのモデルを公開し、性能重視からエッジ向けの軽量展開まで柔軟な選択肢を提供。 Comment
元ポスト:
v2へアップデート:
事前学習時にtext, image encoderのcontrastive lossで学習していたが、text encoderを無くしimage encoderに入力されたimageからcaptionを生成するcaption lossのみにすることで性能を落とすことなく効率を改善
テクニカルペーパーが出た模様
- [Paper Note] OpenVision 2: A Family of Generative Pretrained Visual Encoders for Multimodal Learning, Yanqing Liu+, arXiv'25
HF:
https://huggingface.co/collections/UCSC-VLAA/openvision-681a4c27ee1f66411b4ae919
pj page:
https://ucsc-vlaa.github.io/OpenVision/
CLIP, SigLIPとは異なり完全にオープンなVision Encoder
v2の解説:
[Paper Note] An Empirical Study of Pre-trained Model Selection for Out-of-Distribution Generalization and Calibration, Hiroki Naganuma+, TMLR'25
Paper/Blog Link My Issue
#Analysis #pretrained-LM #Scaling Laws #TMLR Issue Date: 2025-06-26 GPT Summary- 事前学習済みモデルのファインチューニングが分布外一般化タスクにおいて重要であることを示し、モデルのサイズやデータセットの選択がOOD精度と信頼性キャリブレーションに与える影響を調査。120,000時間以上の実験を通じて、大きなモデルと大規模なデータセットがOODパフォーマンスとキャリブレーションを改善することを発見。これは、従来の研究と対照的であり、事前学習済みモデルの選択の重要性を強調している。 Comment
OpenReview: https://openreview.net/forum?id=tYjoHjShxF
元ポスト:
[Paper Note] Vamba: Understanding Hour-Long Videos with Hybrid Mamba-Transformers, Weiming Ren+, arXiv'25
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #LongContext #SSM (StateSpaceModel) #VideoGeneration/Understandings #ICCV Issue Date: 2025-06-26 GPT Summary- VAMBAモデルは、Mamba-2ブロックを用いてビデオトークンを線形にエンコードし、トークン削減なしで1024フレームを処理可能。これにより、GPUメモリ使用量を50%削減し、トレーニング速度を倍増。1時間のビデオ理解ベンチマークLVBenchで4.3%の精度向上を達成し、様々なビデオ理解タスクで優れた性能を示す。 Comment
元ポスト:
[Paper Note] Vision as a Dialect: Unifying Visual Understanding and Generation via Text-Aligned Representations, Jiaming Han+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #NeurIPS #Tokenizer #UMM #One-Line Notes Issue Date: 2025-06-24 GPT Summary- 本論文では、視覚理解と生成を統一するマルチモーダルフレームワークTarを提案。Text-Aligned Tokenizer(TA-Tok)を用いて画像を離散トークンに変換し、視覚とテキストを統一空間に統合。スケール適応型のエンコーディングとデコーディングを導入し、高忠実度の視覚出力を生成。迅速な自己回帰モデルと拡散ベースのモデルを用いたデトークナイザーを活用し、視覚理解と生成の改善を実現。実験結果では、Tarが既存手法と同等以上の性能を示し、効率的なトレーニングを達成。 Comment
元ポスト:
text modalityとvision modalityを共通の空間で表現する
Visual Understanding/Generationのベンチで全体的に高い性能を達成
[Paper Note] jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval, Michael Günther+, arXiv'25
Paper/Blog Link My Issue
#Embeddings #NLP #RepresentationLearning #MultiModal Issue Date: 2025-06-24 GPT Summary- 3.8億パラメータのマルチモーダル埋め込みモデル「jina-embeddings-v4」を提案。新しいアーキテクチャにより、クエリベースの情報検索やクロスモーダルの類似性検索を最適化。タスク特化型のLoRAアダプターを組み込み、視覚的に豊かなコンテンツの処理に優れた性能を発揮。新しいベンチマーク「Jina-VDR」も導入。 Comment
元ポスト:
[Paper Note] Sekai: A Video Dataset towards World Exploration, Zhen Li+, NeurIPS'25
Paper/Blog Link My Issue
#Dataset #NeurIPS #VideoGeneration/Understandings #WorldModels #3D (Video) Issue Date: 2025-06-23 GPT Summary- 高品質な一人称視点のビデオデータセット「Sekai」を紹介。750の都市から5,000時間以上のビデオを収集し、位置やシーンなどの豊富な注釈を付与。データセットを用いてインタラクティブなビデオ世界探査モデル「YUME」をトレーニング。Sekaiはビデオ生成と世界探査に貢献することが期待される。 Comment
元ポスト:
[Paper Note] VGGT: Visual Geometry Grounded Transformer, Jianyuan Wang+, CVPR'25
Paper/Blog Link My Issue
#Transformer #CVPR #read-later #Selected Papers/Blogs #3D Reconstruction #Backbone #Reference Collection Issue Date: 2025-06-22 GPT Summary- VGGTは、シーンの主要な3D属性を複数のビューから直接推測するフィードフォワードニューラルネットワークであり、3Dコンピュータビジョンの分野において新たな進展を示します。このアプローチは効率的で、1秒未満で画像を再構築し、複数の3Dタスクで最先端の結果を達成します。また、VGGTを特徴バックボーンとして使用することで、下流タスクの性能が大幅に向上することが示されています。コードは公開されています。 Comment
元ポスト:
様々な研究のBackboneとして活用されている。
[Paper Note] Seedance 1.0: Exploring the Boundaries of Video Generation Models, Yu Gao+, arXiv'25
Paper/Blog Link My Issue
#Transformer #DiffusionModel #VideoGeneration/Understandings Issue Date: 2025-06-13 GPT Summary- Seedance 1.0は、動画生成の基盤モデルであり、プロンプト遵守、動きの妥当性、視覚的品質を同時に向上させることを目指しています。主な技術改善として、意味のある動画キャプションを用いたデータキュレーション、マルチショット生成のサポート、動画特有のRLHFを活用したファインチューニング、推論速度の約10倍向上を実現する蒸留戦略が挙げられます。Seedance 1.0は、1080p解像度の5秒間の動画を41.4秒で生成し、高品質かつ迅速な動画生成を実現しています。 Comment
元ポスト:
[Paper Note] Generative Omnimatte: Learning to Decompose Video into Layers, Yao-Chih Lee+, CVPR'25
Paper/Blog Link My Issue
#DiffusionModel #CVPR #One-Line Notes #Author Thread-Post Issue Date: 2025-06-06 GPT Summary- オムニマット手法は、ビデオを意味的に有意義な層に分解することを目指すが、既存手法は静的背景や正確なポーズを前提としており、これが破られると性能が低下する。新たに提案する生成的層状ビデオ分解フレームワークは、静止シーンや深度情報を必要とせず、動的領域の補完を行う。核心的なアイデアは、ビデオ拡散モデルを訓練し、シーン効果を特定・除去することであり、これにより高品質な分解と編集結果を実現する。 Comment
元ポスト:
ざっくりしか読めていないが、Inputとして動画とmask(白:残す, 黒:消す, グレー: 不確定なオブジェクトやエフェクトが含まれるエリア≒背景?)を受け取り、Casperと呼ばれるモデルでオブジェクトを消し消した部分をinpaintingすることで、layerっぽいものを作成するっぽい?Casperは
project pageがサンプルもありとてもわかりやすい: https://gen-omnimatte.github.io
[Paper Note] MoDoMoDo: Multi-Domain Data Mixtures for Multimodal LLM Reinforcement Learning, Yiqing Liang+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #RLVR #DataMixture #One-Line Notes #Author Thread-Post Issue Date: 2025-06-05 GPT Summary- 検証可能な報酬を用いた強化学習(RLVR)をマルチモーダルLLMsに適用するためのポストトレーニングフレームワークを提案。異なる視覚と言語の問題を含むデータセットをキュレーションし、最適なデータ混合戦略を導入。実験により、提案した戦略がMLLMの推論能力を大幅に向上させることを示し、分布外ベンチマークで平均5.24%の精度向上を達成。 Comment
元ポスト:
マルチモーダルな設定でRLVRを適用すると、すべてのデータセットを学習に利用する場合より、特定のタスクのみのデータで学習した方が当該タスクでは性能が高くなったり(つまりデータが多ければ多いほど良いわけでは無い)、特定のデータをablationするとOODに対する予測性能が改善したりするなど、データ間で干渉が起きて敵対的になってしまうような現象が起きる。このことから、どのように適切にデータを混合できるか?という戦略の必要性が浮き彫りになり、モデルベースなMixture戦略(どうやらデータの混合分布から学習後の性能を予測するモデルな模様)の性能がuniformにmixするよりも高い性能を示した、みたいな話らしい。
[Paper Note] LaViDa: A Large Diffusion Language Model for Multimodal Understanding, Shufan Li+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #DiffusionModel #Initial Impression Notes Issue Date: 2025-05-24 GPT Summary- LaViDaは、離散拡散モデル(DM)を基にしたビジョン・ランゲージモデル(VLM)で、高速な推論と制御可能な生成を実現。新技術を取り入れ、マルチモーダルタスクにおいてAR VLMと競争力のある性能を達成。COCOキャプショニングで速度向上と性能改善を示し、AR VLMの強力な代替手段であることを証明。 Comment
元ポスト:
Diffusion Modelの波が来た
同程度のサイズのARモデルをoutperform [^1]
[^1]:ただし、これが本当にDiffusion Modelを使ったことによる恩恵なのかはまだ論文を読んでいないのでわからない。必要になったら読む。ただ、Physics of Language Modelのように、完全にコントロールされたデータで異なるアーキテクチャを比較しないとその辺はわからなそうではある。
[Paper Note] Why Vision Language Models Struggle with Visual Arithmetic? Towards Enhanced Chart and Geometry Understanding, Kung-Hsiang Huang+, ACL'25, 2025.02
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #SyntheticData #ACL #DPO #PostTraining #Probing #One-Line Notes #Author Thread-Post Issue Date: 2025-05-18 GPT Summary- Vision Language Models (VLMs)は視覚的算術に苦労しているが、CogAlignという新しいポストトレーニング戦略を提案し、VLMの性能を向上させる。CogAlignは視覚的変換の不変特性を認識するように訓練し、CHOCOLATEで4.6%、MATH-VISIONで2.9%の性能向上を実現し、トレーニングデータを60%削減。これにより、基本的な視覚的算術能力の向上と下流タスクへの転送の効果が示された。 Comment
元ポスト:
既存のLLM (proprietary, openweightそれぞれ)が、シンプルなvisual arithmeticタスク(e.g., 線分の長さ比較, Chart上のdotの理解)などの性能が低いことを明らかにし、
それらの原因を(1)Vision Encoderのrepresentationと(2)Vision EncoderをFreezeした上でのText Decoderのfinetuningで分析した。その結果、(1)ではいくつかのタスクでlinear layerのprobingでは高い性能が達成できないことがわかった。このことから、Vision Encoderによるrepresentationがタスクに関する情報を内包できていないか、タスクに関する情報は内包しているがlinear layerではそれを十分に可能できない可能性が示唆された。
これをさらに分析するために(2)を実施したところ、Vision Encoderをfreezeしていてもfinetuningによりquery stringに関わらず高い性能を獲得できることが示された。このことから、Vision Encoder側のrepresentationの問題ではなく、Text Decoderと側でデコードする際にFinetuningしないとうまく活用できないことが判明した。
手法のところはまだ全然しっかり読めていないのだが、画像に関する特定の属性に関するクエリと回答のペアを合成し、DPOすることで、zero-shotの性能が向上する、という感じっぽい?
[Paper Note] Layer by Layer: Uncovering Hidden Representations in Language Models, Oscar Skean+, ICML'25
Paper/Blog Link My Issue
#Embeddings #Analysis #NLP #LanguageModel #RepresentationLearning #Supervised-FineTuning (SFT) #Chain-of-Thought #SSM (StateSpaceModel) #ICML #PostTraining #read-later #One-Line Notes #CompressionValleys Issue Date: 2025-05-04 GPT Summary- 中間層の埋め込みが最終層を超えるパフォーマンスを示すことを分析し、情報理論や幾何学に基づくメトリクスを提案。32のテキスト埋め込みタスクで中間層が強力な特徴を提供することを実証し、AIシステムの最適化における中間層の重要性を強調。 Comment
現代の代表的な言語モデルのアーキテクチャ(decoder-only model, encoder-only model, SSM)について、最終層のembeddingよりも中間層のembeddingの方がdownstream task(MTEBの32Taskの平均)に、一貫して(ただし、これはMTEBの平均で見たらそうという話であり、個別のタスクで一貫して強いかは読んでみないとわからない)強いことを示した研究。
このこと自体は経験的に知られているのであまり驚きではないのだが(ただ、SSMでもそうなのか、というのと、一貫して強いというのは興味深い)、この研究はMatrix Based Entropyと呼ばれるものに基づいて、これらを分析するための様々な指標を定義し理論的な根拠を示し、Autoregressiveな学習よりもMasked Languageによる学習の方がこのようなMiddle Layerのボトルネックが緩和され、同様のボトルネックが画像の場合でも起きることを示し、CoTデータを用いたFinetuningについても分析している模様。この辺の貢献が非常に大きいと思われるのでここを理解することが重要だと思われる。あとで読む。
openreview: https://openreview.net/forum?id=WGXb7UdvTX
[Paper Note] AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents, Christopher Rawles+, ICLR'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #MultiModal #ICLR #ComputerUse #One-Line Notes Issue Date: 2025-04-18 GPT Summary- 本研究では、116のプログラムタスクに対して報酬信号を提供する「AndroidWorld」という完全なAndroid環境を提案。これにより、自然言語で表現されたタスクを動的に構築し、現実的なベンチマークを実現。初期結果では、最良のエージェントが30.6%のタスクを完了し、さらなる研究の余地が示された。また、デスクトップWebエージェントのAndroid適応が効果薄であることが明らかになり、クロスプラットフォームエージェントの実現にはさらなる研究が必要であることが示唆された。タスクの変動がエージェントのパフォーマンスに影響を与えることも確認された。 Comment
Android環境でのPhone Useのベンチマーク
[Paper Note] UI-TARS: Pioneering Automated GUI Interaction with Native Agents, Yujia Qin+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#NLP #AIAgents #MultiModal #Blog #Reasoning #OpenWeight #ComputerUse #VisionLanguageModel #2D (Image) #One-Line Notes #text Issue Date: 2025-04-18 GPT Summary- UI-TARSは、スクリーンショットを入力として人間のような操作を行うエンドツーエンドのGUIエージェントモデルである。従来の商用モデルに依存せず、知覚、グラウンディング、GUIタスク実行において最先端の性能を発揮。OSWorldベンチマークでは、UI-TARSが高スコアを達成し、他のモデルを上回る。主要な革新には、強化された知覚、統一されたアクションモデリング、System-2推論、反省的オンライン・トレースによる反復的トレーニングが含まれる。これにより、UI-TARSは未知の状況にも適応可能な学習能力を持つ。GUIエージェントの進化経路も分析し、今後の発展を探る。 Comment
色々と書いてあるが、ざっくり言うとByteDanceによる、ImageとTextをinputとして受け取り、TextをoutputするマルチモーダルLLMによるComputer Use Agent (CUA)
関連
- OpenAI API での Computer use の使い方, npaka, 2025.03
元ポスト:
[Paper Note] AM-RADIO: Agglomerative Vision Foundation Model -- Reduce All Domains Into One, Mike Ranzinger+, CVPR'25
Paper/Blog Link My Issue
#Transformer #FoundationModel #OpenWeight #CVPR #One-Line Notes #Author Thread-Post Issue Date: 2025-04-11 GPT Summary- 視覚基盤モデル(VFM)をマルチティーチャー蒸留を通じて統合するアプローチAM-RADIOを提案。これにより、ゼロショットの視覚-言語理解やピクセルレベルの理解を向上させ、個々のモデルの性能を超える。新しいアーキテクチャE-RADIOは、ティーチャーモデルよりも少なくとも7倍速い。包括的なベンチマークで様々な下流タスクを評価。 Comment
元ポスト:
vision系のfoundation modelはそれぞれ異なる目的関数で訓練されてきており(CLIPは対照学習 Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
, DINOv2は自己教師あり学習 [Paper Note] DINOv2: Learning Robust Visual Features without Supervision, Maxime Oquab+, TMLR'24
, SAMはsegmentation [Paper Note] Segment Anything, Alexander Kirillov+, arXiv'23, 2023.04
)それぞれ別の能力を持ってたが、それらを一個のモデルに蒸留しました、という話らしい
lossの文脈でいうと、SigLIPも広義の対照学習の一種である。
- [Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
[Paper Note] Qwen2.5-Omni Technical Report, Jin Xu+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #SpeechProcessing #Speech #OpenWeight #2D (Image) #3D (Video) #Omni #One-Line Notes #Reference Collection #audio #text Issue Date: 2025-03-31 GPT Summary- Qwen2.5-Omniは、テキスト、画像、音声、映像を同時に認識し、自然な音声応答をストリーミング生成するエンドツーエンドのマルチモーダルモデルです。音声と映像の同期には新しい位置埋め込み手法TMRoPEを導入し、Thinker-Talkerアーキテクチャにより干渉を避けつつ同時生成を実現。ストリーミング音声トークンのデコードにはスライディングウィンドウDiTを用いて初期遅延を削減。Qwen2.5-Omniは、マルチモーダルベンチマークで最先端の性能を示し、音声生成の自然さにおいて既存手段を上回ります。 Comment
Qwen TeamによるマルチモーダルLLM。テキスト、画像、動画音声をinputとして受け取り、テキスト、音声をoutputする。
weight:
https://huggingface.co/collections/Qwen/qwen25-omni-67de1e5f0f9464dc6314b36e
[Paper Note] Large Language Diffusion Models, Shen Nie+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #LanguageModel #DiffusionModel #NeurIPS #Reference Collection Issue Date: 2025-03-02 GPT Summary- LLaDAは、自己回帰モデル(ARMs)に代わる拡散モデルであり、ゼロから訓練され、データマスキングを通じて分布をモデル化。広範なベンチマークで強力なスケーラビリティを示し、自己構築したARMベースラインを上回る。特に、LLaDA 8Bは文脈内学習や指示追従能力に優れ、逆詩の完成タスクでGPT-4oを超える性能を発揮。拡散モデルがARMsの実行可能な代替手段であることを示す。 Comment
元ポスト:
参考:
openreview(ICLR'25): https://openreview.net/forum?id=W2tWu0aikL
pj page: https://ml-gsai.github.io/LLaDA-demo/
openreview(NeurIPS'25): https://openreview.net/forum?id=KnqiC0znVF
[Paper Note] SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training, Tianzhe Chu+, ICML'25
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #ICML #PostTraining #read-later #Selected Papers/Blogs #Reference Collection Issue Date: 2025-01-30 GPT Summary- SFTとRLの一般化能力の違いを研究し、GeneralPointsとV-IRLを用いて評価。RLはルールベースのテキストと視覚変種に対して優れた一般化を示す一方、SFTは訓練データを記憶し分布外シナリオに苦労。RLは視覚認識能力を向上させるが、SFTはRL訓練に不可欠であり、出力形式を安定させることで性能向上を促進。これらの結果は、複雑なマルチモーダルタスクにおけるRLの一般化能力を示す。 Comment
元ポスト:
[Paper Note] Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling, Xiaokang Chen+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#NLP #MultiModal #TextToImageGeneration #OpenWeight #VisionLanguageModel #2D (Image) #UMM #One-Line Notes #ImageSynthesis Issue Date: 2025-01-28 GPT Summary- Janus-Proは、最適化されたトレーニング戦略、拡張されたデータ、より大きなモデルサイズを取り入れたJanusの進化形。これにより、マルチモーダル理解と画像生成の安定性において顕著な進歩を実現。研究成果は公開されており、さらなる探究を促すことが期待される。 Comment
DeepSeekによる新たなUMM、Janus-Proが本日リリース。MIT License
Janus-Proのパフォーマンス。
github上でのパフォーマンスの図解から引用。マルチモーダル(テキスト+画像)の理解に関するベンチマークでLLaVA超え。GenEval, DPG Benchと呼ばれる画像生成ベンチマークでDALL-E 3超え。
テクニカルレポート中での詳細から引用。どのベンチマークでも基本的に最高性能なように見える。
テクニカルレポート:
https://github.com/deepseek-ai/Janus/blob/main/janus_pro_tech_report.pdf
ベンチマーク:
- [Paper Note] GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment, Dhruba Ghosh+, NeurIPS'23
- [Paper Note] ELLA: Equip Diffusion Models with LLM for Enhanced Semantic Alignment, Xiwei Hu+, arXiv'24
[Paper Note] Humanity's Last Exam, Long Phan+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-01-25 GPT Summary- LLMの進展を追跡するためのベンチマークが不足している中、Humanity's Last Exam(HLE)を導入。HLEは多様な科目を網羅する2,500問のマルチモーダルな学術問題から成り、専門家の手による構築。高度なLLMはHLEで低精度を示し、閉じた回答形式の問題におけるLLMの能力と人間専門家との間のギャップを浮き彫りにしている。HLEは研究と政策立案のために公開されている。 Comment
o1, DeepSeekR1の正解率が10%未満の新たなベンチマーク
Mulberry: Empowering MLLM with o1-like Reasoning and Reflection via Collective Monte Carlo Tree Search, Huanjin Yao+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #Dataset #Supervised-FineTuning (SFT) #MultiModal #Reasoning #NeurIPS #VisionLanguageModel #TreeSearch Issue Date: 2024-12-31 GPT Summary- 本研究では、MLLMを用いて質問解決のための推論ステップを学習する新手法CoMCTSを提案。集団学習を活用し、複数モデルの知識で効果的な推論経路を探索。マルチモーダルデータセットMulberry-260kを構築し、モデルMulberryを訓練。実験により提案手法の優位性を確認。
[Paper Note] Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models, Weixin Liang+, TMLR'25
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Transformer #MultiModal #SpeechProcessing #Architecture #TMLR #Selected Papers/Blogs #UMM Issue Date: 2024-11-12 GPT Summary- 大規模言語モデル(LLMs)のマルチモーダル処理を効率化するために、Mixture-of-Transformers(MoT)を提案。MoTは計算コストを削減し、モダリティごとにパラメータを分離して特化した処理を実現。Chameleon 7B設定では、55.8%のFLOPsで密なベースラインに匹敵する性能を示し、音声を含む場合も37.2%のFLOPsで同様の結果を達成。さらに、Transfusion設定では、7BのMoTモデルが密なベースラインの画像性能に対してFLOPsの3分の1で匹敵し、760Mのモデルは主要な画像生成指標で上回る結果を得た。MoTは実用的な利点も示し、画像品質を47.2%、テキスト品質を75.6%の経過時間で達成。 Comment
openreview: https://openreview.net/forum?id=Nu6N69i8SB
以下、openreviewより、
埋め込み層以外のパラメータに対して、モダリティごとに異なる独立したtrainableなtransformerを用意し(モダリティを分離する)、各transformerから出力されるsequenceを統合し、モダリティを跨いで全トークンに対してattendするglobal self-attentionを適用する。これにより、モダリティごとに選択的に固有のパラメータを活性化することで計算量を削減し、マルチモーダル学習における計算不可が高い課題に対処する。
[Paper Note] Diffusion Models Are Real-Time Game Engines, Dani Valevski+, ICLR'25, 2024.08
Paper/Blog Link My Issue
#NeuralNetwork #DiffusionModel #ICLR #read-later #Selected Papers/Blogs #WorldModels #interactive #Initial Impression Notes Issue Date: 2024-09-01 GPT Summary- GameNGenは、初の完全にニューラルモデルで動作するゲームエンジンであり、DOOMを用いて訓練され、インタラクティブな新しい軌道を生成する能力を持つ。毎秒20フレームで動作し、9.4のPSNRを達成。評価者は自己回帰生成後もゲームクリップをわずかに識別可能である。GameNGenは、強化学習エージェントによるトレーニングと、次フレーム生成のための拡散モデルの2段階で訓練され、安定した生成を実現する。 Comment
Diffusion Modelでゲーム映像を生成する取り組みらしい。ゲームのenvironmentに対して、ユーザのActionとframeの系列をエピソードとみなして生成するっぽい?
project pageにデモがのっている
https://gamengen.github.io/
openreview: https://openreview.net/forum?id=P8pqeEkn1H
[Paper Note] One-step Diffusion with Distribution Matching Distillation, Tianwei Yin+, CVPR'24, 2023.11
Paper/Blog Link My Issue
#DiffusionModel #CVPR #read-later #Selected Papers/Blogs #DiffusionDistillation Issue Date: 2026-10-22 GPT Summary- 拡散モデルを1ステップ画像生成器へ変換するため、近似KLダイバージェンスを用いて目標分布と生成分布を一致させるDMDを提案。2つのスコア関数の差に基づく蒸留に加え、多段階拡散モデルの出力と大域構造を合わせる回帰損失を導入。既存の少ステップ手法を上回り、ImageNet 64×64でFID 2.62、COCO-30kでFID 11.49を達成し、Stable Diffusion級の品質を毎秒20枚で実現。 Comment
pj page: https://tianweiy.github.io/dmd/
DMD
[Paper Note] PaliGemma: A versatile 3B VLM for transfer, Lucas Beyer+, arXiv'24, 2024.07
Paper/Blog Link My Issue
#NLP #VisionLanguageModel Issue Date: 2026-05-21 GPT Summary- PaliGemmaは、SigLIP-So400mビジョンエンコーダとGemma-2B言語モデルを基にしたオープンなビジョン-言語モデルで、汎用性と幅広い知識を持つベースモデルとして訓練されています。約40の多様なタスク、包括的なVLMベンチマークを通じて高い性能を示し、専門的なリモートセンシングやセグメンテーションタスクにも対応しています。
[Paper Note] Exponential Moving Average of Weights in Deep Learning: Dynamics and Benefits, Daniel Morales-Brotons+, TMLR'24, 2024.11
Paper/Blog Link My Issue
#Optimizer #TMLR #read-later Issue Date: 2026-04-26 GPT Summary- 重みの指数移動平均(EMA)は、深層学習モデルの訓練において一般化性能を向上させる効果的な方法として注目される。研究ではEMAの訓練ダイナミクスとハイパーパラメータ調整の指針が提示され、初期段階での優れた性能が教師モデルとしての成功を説明する。EMAはノイズを低減し、SGDよりも学習率の減衰が少なくて済むため、暗黙の正則化を導入する。実験により、EMAモデルは一般化性能を向上させ、ノイズ付きラベルへの頑健性や予測の一貫性、キャリブレーション、転移学習においても改善を示した。従って、EMAは深層学習モデルの性能向上に寄与するシンプルかつ効果的な手法と考えられる。 Comment
openreview: https://openreview.net/forum?id=2M9CUnYnBA
関連:
- [Paper Note] DINOv3, Oriane Siméoni+, arXiv'25, 2025.08
- [Paper Note] DINOv2: Learning Robust Visual Features without Supervision, Maxime Oquab+, TMLR'24
EMA
[Paper Note] V*: Guided Visual Search as a Core Mechanism in Multimodal LLMs, Penghao Wu+, CVPR'24, 2023.12
Paper/Blog Link My Issue
#NLP #MultiModal #CVPR #read-later #Selected Papers/Blogs #VisionLanguageModel #ThinkingWithImages Issue Date: 2026-02-20 GPT Summary- 視覚的タスク遂行には、選択的な視覚処理が重要であるが、現在のMLLMにはこの機能が欠如している。そこで、LLMの知識を活用する視覚検索機構V*を導入。MLLMとの統合により、推論と文脈理解が向上し、特定の視覚要素を正確に狙えるようになる。この統合はSEALという新しいメタアーキテクチャを生み出し、高解像度画像の処理能力を評価するためのV*Benchも作成。視覚検索機能の重要性を際立たせた研究である。
[Paper Note] Developing Generalist Foundation Models from a Multimodal Dataset for 3D Computed Tomography, Ibrahim Ethem Hamamci+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#NLP #Dataset #CLIP #Selected Papers/Blogs #VisionLanguageModel #Encoder #2D (Image) #3D (Scene) #Medical Issue Date: 2026-02-01 GPT Summary- CT-RATEデータセットを介して、3D医療画像とそのテキストレポートをペアリングし、幅広い応用に向けたCTフォーカスの対照的言語-画像前訓練フレームワークCT-CLIPを開発。これにより、多異常検出やケースリトリーバルで最先端の完全監視モデルを上回る性能を達成。さらに、CT-RATEから派生した270万件以上のQ&AペアでファインチューニングされたCT-CHATを構築し、3D医療画像に特化した手法の重要性を示す。オープンソースなリリースは医療AIの革新と患者ケア向上に寄与。
[Paper Note] SpatialTracker: Tracking Any 2D Pixels in 3D Space, Yuxi Xiao+, CVPR'24, 2024.04
Paper/Blog Link My Issue
#CVPR #2D (Image) #3D (Scene) #3D (Video) #DepthEstimation #MotionEstimation Issue Date: 2025-12-21 GPT Summary- 本研究では、動画における密な長距離ピクセル運動の回復の難しさを解決するため、3D空間における点の軌跡を推定する手法SpatialTrackerを提案。単眼深度推定器を用いて2Dピクセルを3Dに変換し、トランスフォーマーで3D軌跡を推定。剛体制約を活用しつつ、ピクセルをクラスタリングする剛性埋め込みを同時に学習。評価の結果、特に平面外回転のシナリオで最先端の追跡性能を達成した。
[Paper Note] MANTIS: Interleaved Multi-Image Instruction Tuning, Dongfu Jiang+, TMLR'24 Outstanding Certification, 2024.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Dataset #InstructionTuning #MultiModal #TMLR #Selected Papers/Blogs #VisionLanguageModel #2D (Image) Issue Date: 2025-12-02 GPT Summary- Mantisモデルは、721Kの複数画像指示データを用いた指示調整により、複数画像の視覚言語タスクで最先端の性能を達成。特に、Idefics2-8Bを平均13ポイント上回り、一般化能力も示す。大規模な事前学習に依存せず、低コストの指示調整で複数画像能力を向上できることを示した。 Comment
openreview: https://openreview.net/forum?id=skLtdUVaJa
元ポスト:
[Paper Note] Depth Anything V2, Lihe Yang+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#EfficiencyImprovement #SyntheticData #2D (Image) #DepthEstimation Issue Date: 2025-11-18 GPT Summary- Depth Anything V2を提案し、合成画像の使用、教師モデルの能力拡大、擬似ラベル付き実画像を用いた学生モデルの教育を通じて、より細かく堅牢な深度推定を実現。最新のStable Diffusionモデルと比較して、効率的かつ正確であり、異なるスケールのモデルを提供。多様なシーンを考慮した評価ベンチマークも構築。 Comment
pj page: https://depth-anything-v2.github.io
[Paper Note] Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data, Lihe Yang+, CVPR'24, 2024.01
Paper/Blog Link My Issue
#DataAugmentation #FoundationModel #CVPR #2D (Image) #DepthEstimation Issue Date: 2025-11-18 GPT Summary- Depth Anythingは、堅牢な単眼深度推定のための基盤モデルを提案し、6200万の未ラベルデータを自動的に注釈付けしてデータセットを拡大。データ拡張と補助的な監視を用いてモデルの一般化能力を向上させ、ゼロショット評価で優れた結果を示した。NYUv2およびKITTIでファインチューニングし、最先端の性能を達成。モデルは公開されている。 Comment
[Paper Note] Many-Shot In-Context Learning in Multimodal Foundation Models, Yixing Jiang+, arXiv'24, 2024.05
Paper/Blog Link My Issue
#Analysis #NLP #Zero/Few/ManyShotPrompting #MultiModal #In-ContextLearning #VisionLanguageModel Issue Date: 2025-10-27 GPT Summary- 本研究では、マルチモーダル基盤モデルの少数ショットから多数ショットのインコンテキスト学習(ICL)の性能を評価し、2,000のデモンストレーション例を用いることで、すべてのデータセットにおいて大幅な改善を観察しました。特に、Gemini 1.5 Proは多くのデータセットで対数的に性能が向上し、オープンウェイトモデルはデモンストレーション例からの恩恵を受けないことが明らかになりました。また、複数のクエリをバッチ処理することで、ゼロショットおよび多数ショットICLの性能が向上し、コストとレイテンシが削減されました。最終的に、GPT-4oとGemini 1.5 Proは類似のゼロショット性能を示しつつ、Gemini 1.5 Proはより早く学習することが確認されました。多数ショットICLは新しいアプリケーションへの適応を効率化する可能性を示唆しています。 Comment
元ポスト:
[Paper Note] Shadows Don't Lie and Lines Can't Bend Generative Models don't know Projective Geometry...for now, Ayush Sarkar+, CVPR'24, 2023.11
Paper/Blog Link My Issue
#Analysis #DiffusionModel #TextToImageGeneration #CVPR #ImageSynthesis #GeometryUnderstanding Issue Date: 2025-10-24 GPT Summary- 生成モデルはリアルな画像を生成するが、幾何学的特徴において実際の画像と異なることを示す。事前に選別された生成画像を用いて、幾何学的特性に基づく分類器が生成画像を高精度で識別できることを確認。3つの分類器を使用し、画像の透視場、線、物体と影の関係を分析。これにより、生成画像の検出精度が向上し、現在の生成器は実際の画像の幾何学的特性を再現できないと結論付ける。 Comment
[Paper Note] Video Diffusion Models: A Survey, Andrew Melnik+, TMLR'24, 2024.05
Paper/Blog Link My Issue
#Survey #DiffusionModel #TMLR #VideoGeneration/Understandings #3D (Video) Issue Date: 2025-10-17 GPT Summary- 拡散生成モデルは高品質な動画コンテンツの生成において重要な技術であり、本調査はそのアーキテクチャや時間的ダイナミクスのモデリングを包括的にまとめている。テキストから動画への生成の進展や、モデルの分類法、評価指標についても議論し、現在の課題や将来の方向性を考察している。研究者や実務者にとって有益なリソースを提供することを目指している。
[Paper Note] Aria: An Open Multimodal Native Mixture-of-Experts Model, Dongxu Li+, arXiv'24, 2024.10
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #OpenWeight #MoE(Mixture-of-Experts) #VisionLanguageModel Issue Date: 2025-10-07 GPT Summary- Ariaは、オープンなマルチモーダルネイティブAIモデルであり、視覚とテキストのタスクにおいて高い性能を発揮します。3.9Bの視覚トークンと3.5Bのテキストトークンを持つエキスパートの混合モデルで、既存のプロプライエタリモデルを上回ります。言語理解やマルチモーダル理解を強化する4段階のパイプラインで事前トレーニングされ、モデルウェイトとコードベースはオープンソースとして提供されます。 Comment
元ポスト:
HF: https://huggingface.co/rhymes-ai/Aria
提案された当時2024年10月時点で、VisionとText Understanding双方でに強い初めてのモデルで、初のマルチモーダルMoEモデルで(当時まだ話題になっていなかったDeepSeek-V2アーキテクチャを採用)、LongVideoのUnderstanidinpで当時の最高性能であったとのこと。
[Paper Note] Implicit Style-Content Separation using B-LoRA, Yarden Frenkel+, ECCV'24
Paper/Blog Link My Issue
#PEFT(Adaptor/LoRA) #ECCV Issue Date: 2025-09-16 GPT Summary- 画像スタイライズにおいて、LoRAを用いてスタイルとコンテンツを暗黙的に分離する手法B-LoRAを提案。特定のブロックのLoRA重みを共同で学習することで、独立したトレーニングでは達成できない分離を実現。これによりスタイル操作が改善され、過学習の問題を克服。トレーニング後は、独立したコンポーネントとして様々なスタイライズタスクに利用可能。 Comment
pj page: https://b-lora.github.io/B-LoRA/
[Paper Note] ELLA: Equip Diffusion Models with LLM for Enhanced Semantic Alignment, Xiwei Hu+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #DiffusionModel #read-later #Selected Papers/Blogs #UMM Issue Date: 2025-09-11 GPT Summary- 拡散モデルに大規模言語モデル(LLM)を組み込む「効率的な大規模言語モデルアダプター(ELLA)」を提案。これにより、複雑なプロンプトの整合性を向上させ、意味的特徴を適応させる新しいモジュール「時間ステップ認識セマンティックコネクタ(TSC)」を導入。ELLAは密なプロンプトに対する性能が最先端手法を上回ることを実験で示し、特に複数のオブジェクト構成において優位性を発揮。 Comment
pj page: https://ella-diffusion.github.io
[Paper Note] OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments, Tianbao Xie+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#NLP #AIAgents #Evaluation #MultiModal #VisionLanguageModel #Environment Issue Date: 2025-08-29 GPT Summary- 自律エージェントは、複雑なコンピュータ作業を最小限の人間介入で達成し、生産性を向上させる可能性を持つ。しかし、既存のベンチマークは対話的環境の欠如や特定のドメインに限定され、スケーラビリティを制限している。これに対処するため、OSWorldという実機コンピュータ環境を提案し、様々なOSにまたがるマルチモーダルエージェント向けの統一環境を提供。369のコンピュータタスクを現実世界の利用ケースに基づいて評価するためのベンチマークを作成。評価の結果、最先端のLLM/VLMベースのエージェントは人間の72.36%に対しわずか12.24%の成功しか得られず、GUIのグラウンディングと運用知識の不足が主な要因であることが明らかになった。OSWorldは汎用エージェントの開発に向けた有益なインサイトを提供する。 Comment
openreview: https://openreview.net/forum?id=tN61DTr4Ed#discussion
マルチモーダル AI Agentを評価するための実コンピュータでの仮想環境が提供されており、Ubuntu, Windows, macOS等でのキーボード、マウスコントロールを受け付ける。396の実際のユーザが直面するシナリオが定義されており、タスクごとにinitial stateが定義され、実際にタスクを実行することをベースにした評価を実行可能。
タスクとタスクの実行結果を評価するためのスクリプトの例が以下で、たとえばAmazonのcookieを全て削除する依頼や、エクセルの操作を実施するようなタスクなど、多様なタスクが用意されている。
Agentが実施可能なアクションの一部は下記で、マウス操作、キーボード入力を通じて実行可能なアクションが定義されている。
[Paper Note] As Generative Models Improve, People Adapt Their Prompts, Eaman Jahani+, arXiv'24
Paper/Blog Link My Issue
#Analysis #Prompting Issue Date: 2025-08-25 GPT Summary- オンライン実験で1893人の参加者を対象に、DALL-E 2とDALL-E 3のプロンプトの重要性の変化を調査。DALL-E 3を使用した参加者は、DALL-E 2よりも高いパフォーマンスを示し、これは技術的能力の向上とプロンプトの質の変化によるもの。特に、DALL-E 3の参加者はより長く、意味的に類似したプロンプトを作成。プロンプト修正機能を持つDALL-E 3はさらに高いパフォーマンスを示したが、その利点は減少。結果として、モデルの進化に伴い、プロンプトも適応されることが示唆される。 Comment
元ポスト:
[Paper Note] InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks, Zhe Chen+, CVPR'24
Paper/Blog Link My Issue
#Pretraining #MultiModal #FoundationModel #CVPR #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2025-08-23 GPT Summary- 大規模視覚-言語基盤モデル(InternVL)は、60億パラメータで設計され、LLMと整合させるためにウェブ規模の画像-テキストデータを使用。視覚認知タスクやゼロショット分類、検索など32のベンチマークで最先端の性能を達成し、マルチモーダル対話システムの構築に寄与。ViT-22Bの代替として強力な視覚能力を持つ。コードとモデルは公開されている。 Comment
既存のResNetのようなSupervised pretrainingに基づくモデル、CLIPのようなcontrastive pretrainingに基づくモデルに対して、text encoder部分をLLMに置き換えて、contrastive learningとgenerativeタスクによる学習を組み合わせたパラダイムを提案。
InternVLのアーキテクチャは下記で、3 stageの学習で構成される。最初にimage text pairをcontrastive learningし学習し、続いてモデルのパラメータはfreezeしimage text retrievalタスク等でモダリティ間の変換を担う最終的にQlLlama(multilingual性能を高めたllama)をvision-languageモダリティを繋ぐミドルウェアのように捉え、Vicunaをテキストデコーダとして接続してgenerative cossで学習する、みたいなアーキテクチャの模様(斜め読みなので少し違う可能性あり
現在のVLMの主流であるvision encoderとLLMをadapterで接続する方式はここからかなりシンプルになっていることが伺える。
[Paper Note] CVQA: Culturally-diverse Multilingual Visual Question Answering Benchmark, David Romero+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #QuestionAnswering #Evaluation #MultiModal #MultiLingual #VisionLanguageModel #Cultural Issue Date: 2025-08-18 GPT Summary- CVQAは、文化的に多様な多言語のVisual Question Answeringベンチマークで、30か国からの画像と質問を含み、31の言語と13のスクリプトをカバー。データ収集にはネイティブスピーカーを関与させ、合計10,000の質問を提供。マルチモーダル大規模言語モデルをベンチマークし、文化的能力とバイアスを評価するための新たな基準を示す。
[Paper Note] Pangea: A Fully Open Multilingual Multimodal LLM for 39 Languages, Xiang Yue+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #InstructionTuning #Evaluation #MultiLingual #VisionLanguageModel Issue Date: 2025-08-18 GPT Summary- Pangeaは、39の言語にわたる6M指示データセットPangeaInsを用いて訓練された多言語マルチモーダルLLMであり、異文化間のカバレッジを確保しています。Pangeaは、47の言語をカバーする評価スイートPangeaBenchで既存のモデルを大幅に上回る性能を示し、英語データの比率やマルチモーダル訓練サンプルの重要性を明らかにしました。データ、コード、訓練済みチェックポイントはオープンソース化され、言語的および文化的公平性を推進します。
[Paper Note] MambaOut: Do We Really Need Mamba for Vision?, Weihao Yu+, arXiv'24
Paper/Blog Link My Issue
#Analysis #ImageSegmentation #SSM (StateSpaceModel) #ImageClassification Issue Date: 2025-08-14 GPT Summary- MambaはRNNのようなトークンミキサーを持つアーキテクチャで、視覚タスクにおいて期待外れの性能を示す。Mambaは長いシーケンスと自己回帰的な特性に適しているが、画像分類には不向きであると仮定。MambaOutモデルを構築し、実験によりMambaOutがImageNetの画像分類で視覚Mambaモデルを上回ることを示し、検出およびセグメンテーションタスクではMambaの可能性を探る価値があることを確認。
[Paper Note] MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI, Xiang Yue+, CVPR'24
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #MultiModal #Reasoning #CVPR Issue Date: 2025-08-09 GPT Summary- MMMUは、大学レベルの専門知識と意図的な推論を必要とするマルチモーダルモデルの評価のための新しいベンチマークで、11,500のマルチモーダル質問を含む。6つの主要分野をカバーし、30種類の画像タイプを使用。既存のベンチマークと異なり、専門家が直面するタスクに類似した課題を提供。GPT-4VとGeminiの評価では、56%と59%の精度にとどまり、改善の余地があることを示す。MMMUは次世代のマルチモーダル基盤モデルの構築に寄与することが期待されている。 Comment
MMMUのリリースから20ヶ月経過したが、いまだに人間のエキスパートのアンサンブルには及ばないとのこと
MMMUのサンプルはこちら。各分野ごとに専門家レベルの知識と推論が求められるとのこと。
[Paper Note] Visual Prompting in Multimodal Large Language Models: A Survey, Junda Wu+, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #Prompting #VisionLanguageModel Issue Date: 2025-08-07 GPT Summary- 本論文は、マルチモーダル大規模言語モデル(MLLMs)における視覚的プロンプト手法の包括的な調査を行い、視覚的プロンプトの生成や構成的推論、プロンプト学習に焦点を当てています。既存の視覚プロンプトを分類し、自動プロンプト注釈の生成手法を議論。視覚エンコーダとバックボーンLLMの整合性を向上させる手法や、モデル訓練と文脈内学習による視覚的プロンプトの理解向上についても述べています。最後に、MLLMsにおける視覚的プロンプト手法の未来に関するビジョンを提示します。
[Paper Note] Controllable Generation with Text-to-Image Diffusion Models: A Survey, Pu Cao+, arXiv'24
Paper/Blog Link My Issue
#Survey #Controllable #NLP #DiffusionModel #TextToImageGeneration Issue Date: 2025-08-07 GPT Summary- 拡散モデルはテキスト誘導生成において大きな進展を遂げたが、テキストのみでは多様な要求に応えられない。本調査では、T2I拡散モデルの制御可能な生成に関する文献をレビューし、理論的基盤と実践的進展をカバー。デノイジング拡散確率モデルの基本を紹介し、制御メカニズムを分析。生成条件の異なるカテゴリに整理した文献リストを提供。
[Paper Note] Revisiting Feature Prediction for Learning Visual Representations from Video, Adrien Bardes+, TMLR'24, 2024.02
Paper/Blog Link My Issue
#Pretraining #RepresentationLearning #Self-SupervisedLearning #TMLR #WorldModels #LatentRepresentation Issue Date: 2025-07-24 GPT Summary- V-JEPAは、自己教師付き学習における特徴予測を単独の目的として訓練された視覚モデルのコレクションであり、他の監視情報を使用せずに200万本の動画から学習する。実験結果は、動作および外観タスクで良好な汎用的視覚表現を生み出すことを示し、最大のモデルがKinetics-400で81.9%、Something-Something-v2で72.2%、ImageNet1Kで77.9%の成果を上げた。 Comment
openreview: https://openreview.net/forum?id=QaCCuDfBk2
[Paper Note] Scaling Laws for Data Filtering -- Data Curation cannot be Compute Agnostic, Sachin Goyal+, CVPR'24
Paper/Blog Link My Issue
#Analysis #NLP #Dataset #CVPR #Scaling Laws #VisionLanguageModel #DataFiltering Issue Date: 2025-07-20 GPT Summary- 視覚と言語のモデル(VLMs)のトレーニングにおいて、高品質なデータのフィルタリングが重要であるが、計算リソースとは無関係に行われることが多い。本研究では、データの品質と量のトレードオフ(QQT)に対処するため、ウェブデータの非均質性を考慮したニューラルスケーリング法則を提案。これにより、データの有用性の違いや繰り返し使用による劣化を評価し、複数のデータプールの組み合わせによるモデルのパフォーマンスを推定可能にする。最適なデータプールのキュレーションを通じて、計算リソースに応じた最高のパフォーマンスを達成できることを示した。 Comment
元ポスト:
高品質なデータにフィルタリングすることで多くの研究がモデルがより高い性能を達成できることを示しているが、高品質なデータには限りがあることと、繰り返し学習をすることですぐにその効用が低下する(Quality-Quantity tradeoff!)という特性がある。このような状況において、たとえば計算の予算がデータ6パケット分の時に、めちゃめちゃフィルタリングを頑張っg高品質なデータプールEのみを使って6 epoch学習するのが良いのか、少し品質は落ちるデータDも混ぜてE+Dを3 epoch学習するのが良いのか、ときにどちらが良いのか?という話のようである。
[Paper Note] Heron-Bench: A Benchmark for Evaluating Vision Language Models in Japanese, Yuichi Inoue+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #Japanese #read-later #VisionLanguageModel Issue Date: 2025-07-16 GPT Summary- 日本語に特化したVision Language Models (VLM)の評価のために、新しいベンチマーク「Japanese Heron-Bench」を提案。日本の文脈に基づく画像-質問応答ペアを用いて、日本語VLMの能力を測定。提案されたVLMの強みと限界を明らかにし、強力なクローズドモデルとの能力ギャップを示す。今後の日本語VLM研究の発展を促進するため、データセットと訓練コードを公開。 Comment
[Paper Note] Measuring Multimodal Mathematical Reasoning with MATH-Vision Dataset, Ke Wang+, NeurIPS'24 Datasets and Benchmarks Track
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #Mathematics #VisionLanguageModel #One-Line Notes Issue Date: 2025-07-14 GPT Summary- MATH-Vision(MATH-V)データセットを提案し、3,040の視覚的文脈を持つ数学問題を収集。16の数学分野と5つの難易度で構成され、LMMsの数学的推論能力を評価。実験により、LMMsと人間のパフォーマンス間に顕著なギャップがあることを示し、さらなる進展の必要性を強調。エラー分析を通じて今後の研究に貴重な洞察を提供。 Comment
openreview:
https://openreview.net/forum?id=QWTCcxMpPA#discussion
project page:
https://mathllm.github.io/mathvision/
Project Pageのランディングページが非常にわかりやすい。こちらは人間の方がまだまだ性能が高そう。
Gemma-4-31Bではスコアが85.6%に到達。人間のスコアが68.82%なので、すでに本ベンチマーク上では人間のスコア超え。
- Gemma 4: Byte for byte, the most capable open models, Google, 2026.04
GPT-5.4 (xhigh)が96.1%のスコアに到達しているため、スコアはすでに飽和している。
[Paper Note] DINOv2: Learning Robust Visual Features without Supervision, Maxime Oquab+, TMLR'24
Paper/Blog Link My Issue
#Transformer #FoundationModel #Self-SupervisedLearning #TMLR Issue Date: 2025-04-11 GPT Summary- 自己教師あり手法を用いて、多様なキュレーションデータから汎用的な視覚特徴を生成する新しい事前学習手法を提案。1BパラメータのViTモデルを訓練し、小型モデルに蒸留することで、OpenCLIPを上回る性能を達成。
[Paper Note] OlympiadBench: A Challenging Benchmark for Promoting AGI with Olympiad-Level Bilingual Multimodal Scientific Problems, Chaoqun He+, ACL'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #MultiModal #ACL Issue Date: 2025-01-06 GPT Summary- 大規模言語モデル(LLMs)やマルチモーダルモデル(LMMs)の能力を測定するために、オリンピアドレベルのバイリンガルマルチモーダル科学ベンチマーク「OlympiadBench」を提案。8,476の数学と物理の問題を含み、専門家レベルの注釈が付けられている。トップモデルのGPT-4Vは平均17.97%のスコアを達成したが、物理では10.74%にとどまり、ベンチマークの厳しさを示す。一般的な問題として幻覚や論理的誤謬が指摘され、今後のAGI研究に貴重なリソースとなることが期待される。
[Paper Note] VLR-Bench: Multilingual Benchmark Dataset for Vision-Language Retrieval Augmented Generation, Hyeonseok Lim+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#InformationRetrieval #NLP #Dataset #RAG(RetrievalAugmentedGeneration) #MultiLingual #COLING #VisionLanguageModel #One-Line Notes Issue Date: 2024-12-16 GPT Summary- 視覚言語モデル(VLM)を評価するための新しいベンチマークVLR-Benchを提案。これは5つの入力パッセージを用いて、特定のクエリに対する有用な情報の判断能力をテストする。32,000の自動生成された指示からなるデータセットVLR-IFを構築し、VLMのRAG能力を強化。Llama3ベースのモデルで性能を検証し、両データセットはオンラインで公開。 Comment
Multilingual VLMを用いたRAGのベンチマークデータセット
[Paper Note] Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction, Keyu Tian+, NeurIPS'24
Paper/Blog Link My Issue
#Pretraining #Transformer #NeurIPS #KeyPoint Notes Issue Date: 2024-12-12 GPT Summary- Visual AutoRegressive modeling (VAR)を提案し、画像生成において自己回帰学習を次のスケール予測として再定義。VARは、GPTのようなARモデルが拡散トランスフォーマーを上回ることを実現し、ImageNet 256x256ベンチマークでFIDを18.65から1.73、ISを80.4から350.2に改善。推論速度は約20倍向上し、画像品質やデータ効率でも優れた性能を示す。VARはゼロショット一般化能力を持ち、スケーリング法則を示す。全モデルとコードを公開し、視覚生成の研究を促進。 Comment
NeurIPS2024のベストペーパー
OpenReview: https://openreview.net/forum?id=gojL67CfS8
Next Token Prediction, Next Image Token Generation (従来手法), Next Scale (resolution) prediction (提案手法)の違いの図解。非常に分かりやすい。next token predictionでは次トークンのみを予測するがVARでは、次の解像度画像の全体のトークンマップを予測する。
学習方法の概要。2-Stageで学習される。最初のステージでK種類の解像度の画像(=K種類のマルチスケールのtoken maps r_k)を得るためにAutoEncoderを学習し、次のステージでblock-wiseのcausal attention maskを用いて、K_
従来手法と比べより小さいパラメータで高い性能を実現し、inference timeも非常に早い。
ScalingLawsも成立する。
Multimodal Autoregressive Pre-training of Large Vision Encoders, Enrico Fini+, arXiv'24
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #MultiModal Issue Date: 2024-11-25 GPT Summary- 新しい手法AIMV2を用いて、大規模なビジョンエンコーダの事前学習を行う。これは画像とテキストを組み合わせたマルチモーダル設定に拡張され、シンプルな事前学習プロセスと優れた性能を特徴とする。AIMV2-3BエンコーダはImageNet-1kで89.5%の精度を達成し、マルチモーダル画像理解において最先端のコントラストモデルを上回る。
Tutorial on Diffusion Models for Imaging and Vision, Stanley H. Chan, arXiv'24
Paper/Blog Link My Issue
#Tutorial #DiffusionModel #needs-revision Issue Date: 2024-11-17 GPT Summary- 生成ツールの成長により、テキストから画像や動画を生成する新しいアプリケーションが可能に。拡散モデルの原理がこれらの生成ツールの基盤であり、従来のアプローチの欠点を克服。チュートリアルでは、拡散モデルの基本的なアイデアを学部生や大学院生向けに解説。 Comment
いつか読まなければならない
Online-LoRA: Task-free Online Continual Learning via Low Rank Adaptation, Xiwen Wei+, arXiv'24
Paper/Blog Link My Issue
#MachineLearning #Supervised-FineTuning (SFT) #InstructionTuning #PEFT(Adaptor/LoRA) #Catastrophic Forgetting #needs-revision Issue Date: 2024-11-12 GPT Summary- 破滅的忘却に対処するため、タスクフリーのオンライン継続学習(OCL)フレームワークOnline-LoRAを提案。リハーサルバッファの制約を克服し、事前学習済みビジョントランスフォーマー(ViT)モデルをリアルタイムで微調整。新しいオンライン重み正則化戦略を用いて重要なモデルパラメータを特定し、データ分布の変化を自動認識。多様なベンチマークデータセットで優れた性能を示す。 Comment
Figure1参照
[Paper Note] COM Kitchens: An Unedited Overhead-view Video Dataset as a Vision-Language Benchmark, Koki Maeda+, arXiv'24, 2024.08
Paper/Blog Link My Issue
#Dataset #ECCV #needs-revision Issue Date: 2024-09-30 GPT Summary- 手順型動画理解に向けて、COM Kitchensという新データセットを提案。スマートフォンで撮影した編集なしの俯瞰視点動画で、参加者がレシピに従った調理を記録。これにより、幅広い環境でのデータ収集が可能に。新タスクとして、動画からテキストへの検索(OnRR)と未編集動画上のキャプショニング(DVC-OV)を設定し、既存手法の能力と限界を実験で検証。 Comment
とてもおもしろそう!
[Paper Note] What matters when building vision-language models?, Hugo Laurençon+, arXiv'24, 2024.05
Paper/Blog Link My Issue
#NLP #Dataset #VisionLanguageModel #One-Line Notes Issue Date: 2024-09-30 GPT Summary- 視覚と言語のモデル(VLM)の設計決定が正当化されていないことが、モデルのパフォーマンス改善を困難にしていると指摘。広範な実験を通じて、80億パラメータのVLMであるIdefics2を開発し、さまざまなマルチモーダルベンチマークで最先端のパフォーマンスを達成。モデルとそのトレーニング用データセットを公開。 Comment
元ポストにOpenVLMの進展の歴史が載っている。構築されたデータセットも公開される模様。
元ポスト:
Long-CLIP: Unlocking the Long-Text Capability of CLIP, Beichen Zhang+, N_A, ECCV'24
Paper/Blog Link My Issue
#CLIP Issue Date: 2024-09-30 GPT Summary- Long-CLIPは、CLIPのテキスト入力の長さ制限を克服し、ゼロショットの一般化能力を保持または超える新しいモデルです。効率的なファインチューニング戦略を用いて、CLIPの性能を維持しつつ、長文テキスト-画像ペアを活用することで、テキスト-画像検索タスクで約20%の性能向上を達成しました。また、Long-CLIPは詳細なテキスト説明から画像を生成する能力を強化します。
[Paper Note] Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Vision-Language Models, Matt Deitke+, arXiv'24, 2024.09
Paper/Blog Link My Issue
#NLP #MultiModal #OpenWeight #OpenSource #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2024-09-27 GPT Summary- Molmoは、オープンな視覚・言語モデル(VLM)ファミリーを提案し、高性能なVLM構築に必要な基盤知識の欠如を解消する。PixMoという新しいデータセットを収集し、詳細な画像キャプション、自由形式画像Q&A、2Dポインティングデータを含む。72Bモデルは、オープンウェイトモデルの中で最高性能を示し、特にClaude 3.5 SonnetやGemini 1.5 Proなどの独自モデルよりも優れ、学術ベンチマークでGPT-4oに次ぐ第2位となった。モデルの重みやデータセットは公開中。 Comment
dataset, training code, inference, weight, recipe, 全てがオープンなVLM(OlmoのVLM版)。
以下がベンチマーク結果(VLMのベンチマーク)。11 benchmarksと書かれているのは、VLMのベンチマークである点に注意。
当時のVLMは全てプロプライエタリモデルであり、どのようにすればSoTA性能に到達できるかは不明であったが、Molmoによって明らかになった(と認識している)。
Visualization-of-Thought Elicits Spatial Reasoning in Large Language Models, Wenshan Wu+, N_A, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought Issue Date: 2024-04-08 GPT Summary- LLMsの空間推論能力を向上させるために、Visualization-of-Thought(VoT)プロンプティングを提案。VoTは、LLMsの推論トレースを可視化し、空間推論タスクで使用することで、既存のMLLMsを上回る性能を示す。VoTは、空間推論を促進するために「メンタルイメージ」を生成する能力を持ち、MLLMsでの有効性を示唆する。
[Paper Note] Unified-IO 2: Scaling Autoregressive Multimodal Models with Vision, Language, Audio, and Action, Jiasen Lu+, CVPR'24, 2023.12
Paper/Blog Link My Issue
#Pretraining #NLP #Transformer #InstructionTuning #MultiModal #SpeechProcessing #CVPR #Selected Papers/Blogs #Encoder-Decoder #Robotics #UMM #EmbodiedAI #KeyPoint Notes #Surface-level Notes Issue Date: 2023-12-29 GPT Summary- 初の自己回帰型マルチモーダルモデル「Unified-IO 2」を提案し、画像、テキスト、音声、アクションを統一した意味空間で処理。トレーニングの安定化のためにアーキテクチャを改善し、120のデータセットで微調整を行い、GRITベンチマークで最先端のパフォーマンスを達成。35以上のベンチマークにおいて強力な結果を示し、すべてのモデルを公開。 Comment
画像、テキスト、音声、アクションを理解できる初めてのautoregressive model。AllenAI
モデルのアーキテクチャ図
マルチモーダルに拡張したことで、訓練が非常に不安定になったため、アーキテクチャ上でいくつかの工夫を加えている:
- 2D Rotary Embedding
- Positional EncodingとしてRoPEを採用
- 画像のような2次元データのモダリティの場合はRoPEを2次元に拡張する。具体的には、位置(i, j)のトークンについては、Q, Kのembeddingを半分に分割して、それぞれに対して独立にi, jのRoPE Embeddingを適用することでi, j双方の情報を組み込む。
- QK Normalization
- image, audioのモダリティを組み込むことでMHAのlogitsが非常に大きくなりatteetion weightが0/1の極端な値をとるようになり訓練の不安定さにつながった。このため、dot product attentionを適用する前にLayerNormを組み込んだ。
- Scaled Cosine Attention
- Image Historyモダリティにおいて固定長のEmbeddingを得るためにPerceiver Resamplerを扱ったているが、こちらも上記と同様にAttentionのlogitsが極端に大きくなったため、cosine類似度をベースとしたScaled Cosine Attention [Paper Note] Swin Transformer V2: Scaling Up Capacity and Resolution, Ze Liu+, arXiv'21
を利用することで、大幅に訓練の安定性が改善された。
- その他
- attention logitsにはfp32を適用
- 事前学習されたViTとASTを同時に更新すると不安定につながったため、事前学習の段階ではfreezeし、instruction tuningの最後にfinetuningを実施
目的関数としては、Mixture of Denoisers (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)に着想を得て、Multimodal Mixture of Denoisersを提案。MoDでは、
- \[R\]: 通常のspan corruption (1--5 token程度のspanをmaskする)
- \[S\]: causal language modeling (inputを2つのサブシーケンスに分割し、前方から後方を予測する。前方部分はBi-directionalでも可)
- \[X\]: extreme span corruption (12>=token程度のspanをmaskする)
の3種類が提案されており、モダリティごとにこれらを使い分ける:
- text modality: UL2 (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)を踏襲
- image, audioがtargetの場合: 2つの類似したパラダイムを定義し利用
- \[R\]: patchをランダムにx%マスクしre-constructする
- \[S\]: inputのtargetとは異なるモダリティのみの情報から、targetモダリティを生成する
訓練時には prefixとしてmodality token \[Text\], \[Image\], \[Audio\] とparadigm token \[R\], \[S\], \[X\] をタスクを指示するトークンとして利用している。
また、image, audioのマスク部分のdenoisingをautoregressive modelで実施する際には普通にやるとdecoder側でリークが発生する(a)。これを防ぐには、Encoder側でマスクされているトークンを、Decoder側でteacher-forcingする際にの全てマスクする方法(b)があるが、この場合、生成タスクとdenoisingタスクが相互に干渉してしまいうまく学習できなくなってしまう(生成タスクでは通常Decoderのinputとして[mask]が入力され次トークンを生成する、といったことは起きえないが、愚直に(b)をやるとそうなってしまう)。ので、(c)に示したように、マスクされているトークンをinputとして生成しなければならない時だけ、マスクを解除してdecoder側にinputする、という方法 (Dynamic Masking) でこの問題に対処している。
VILA: On Pre-training for Visual Language Models, Ji Lin+, N_A, CVPR'24
Paper/Blog Link My Issue
#Analysis #Pretraining #NLP #LanguageModel #CVPR #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2023-12-14 GPT Summary- 最近の大規模言語モデルの成功により、ビジュアル言語モデル(VLM)が進歩している。本研究では、VLMの事前学習のためのデザインオプションを検討し、以下の結果を示した:(1) LLMを凍結することでゼロショットのパフォーマンスが達成できるが、文脈に基づいた学習能力が不足している。(2) 交互に行われる事前学習データは有益であり、画像とテキストのペアだけでは最適ではない。(3) テキストのみの指示データを画像とテキストのデータに再ブレンドすることで、VLMのタスクの精度を向上させることができる。VILAというビジュアル言語モデルファミリーを構築し、最先端モデルを凌駕し、優れたパフォーマンスを発揮することを示した。マルチモーダルの事前学習は、VILAの特性を向上させる。 Comment
関連:
- [Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
NeuroPrompts: An Adaptive Framework to Optimize Prompts for Text-to-Image Generation, Shachar Rosenman+, N_A, EACL'24 Sustem Demonstration Track
Paper/Blog Link My Issue
#NLP #LanguageModel #AutomaticPromptEngineering #EACL #System Demonstration Issue Date: 2023-11-23 GPT Summary- 本研究では、テキストから画像への生成モデルの品質を向上させるための適応型フレームワークNeuroPromptsを提案します。このフレームワークは、事前学習された言語モデルを使用して制約付きテキストデコーディングを行い、人間のプロンプトエンジニアが生成するものに類似したプロンプトを生成します。これにより、高品質なテキストから画像への生成が可能となり、ユーザーはスタイルの特徴を制御できます。また、大規模な人間エンジニアリングされたプロンプトのデータセットを使用した実験により、当アプローチが自動的に品質の高いプロンプトを生成し、優れた画像品質を実現することを示しました。
[Paper Note] ZipLoRA: Any Subject in Any Style by Effectively Merging LoRAs, Viraj Shah+, N_A, ECCV'24
Paper/Blog Link My Issue
#PEFT(Adaptor/LoRA) #ECCV Issue Date: 2023-11-23 GPT Summary- 概要:概念駆動型のパーソナライズのための生成モデルの微調整手法であるZipLoRAを提案。ZipLoRAは、独立してトレーニングされたスタイルと主題のLoRAを統合し、任意の主題とスタイルの組み合わせで生成することができる。実験結果は、ZipLoRAが主題とスタイルの忠実度を改善しながら魅力的な結果を生成できることを示している。 Comment
pj page: https://ziplora.github.io/
MEGAVERSE: Benchmarking Large Language Models Across Languages, Modalities, Models and Tasks, Sanchit Ahuja+, N_A, NAACL'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #MultiLingual #NAACL #VisionLanguageModel Issue Date: 2023-11-14 GPT Summary- LLMsの研究は急速に進展しており、英語以外の言語での評価が必要とされている。本研究では、新しいデータセットを追加したMEGAVERSEベンチマークを提案し、さまざまなLLMsを評価する。実験の結果、GPT4とPaLM2が優れたパフォーマンスを示したが、データの汚染などの問題があるため、さらなる取り組みが必要である。
[Paper Note] Segment Anything in Medical Images, Jun Ma+, Nature Communications'24, 2023.04
Paper/Blog Link My Issue
#Pretraining #Transformer #ImageSegmentation #FoundationModel #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 医用画像分割は診断や治療計画に不可欠だが、既存手法は特定のモダリティや疾患に限られがち。そこで、10の画像モダリティと30種以上のがんに対応する基盤モデルMedSAMを提案。1,570,263の画像-マスクペアで訓練され、精度と頑健性で専門モデルを上回ることを実証。MedSAMは診断ツールの進化と個別化治療計画を加速する可能性を秘めている。 Comment
SAMの性能は医療画像に対しては限定的だったため、11の異なるモダリティに対して200kのマスクをした医療画像を用意しfinetuningしたMedSAMによって、医療画像のセグメンテーションの性能を大幅に向上。
コードとモデルはpublicly available
AudioGPT: Understanding and Generating Speech, Music, Sound, and Talking Head, AAAI'24
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #SpeechProcessing #AAAI #One-Line Notes Issue Date: 2023-04-26 Comment
text, audio, imageといったマルチモーダルなpromptから、audioに関する様々なタスクを実現できるシステム
マルチモーダルデータをjointで学習したというわけではなく、色々なモデルの組み合わせてタスクを実現しているっぽい
[Paper Note] CLIPPO: Image-and-Language Understanding from Pixels Only, Michael Tschannen+, CVPR'23, 2022.12
Paper/Blog Link My Issue
#MultiModal #ContrastiveLearning #CVPR #Encoder #OCR #Pixel-based Issue Date: 2026-07-08 GPT Summary- CLIPPOは、統一されたピクセルベースのエンコーダを用いて、対照損失のみで訓練されたマルチモーダルモデル。テキストと画像の両方を処理し、CLIPスタイルの性能を保ちながら、パラメータ数を半減。言語モデルなしで自然言語理解タスクや視覚質問応答でも優れた成果を示し、多言語検索にも対応可能。
[Paper Note] BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models, Junnan Li+, ICML'23, 2023.01
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #NLP #MultiModal #ICML #VisionLanguageModel #Encoder #2D (Image) Issue Date: 2026-02-06 GPT Summary- BLIP-2は、視覚と言語の事前学習を効率化する新しい戦略で、既存の画像エンコーダと大規模言語モデルを活用。軽量なクエリトランスフォーマーにより二段階での事前学習を実施し、視覚と言語の表現を効果的に結合。トレーニング可能なパラメータは少ないながらも、ゼロショットタスクで優れた性能を発揮し、Flamingo80Bを上回る成果を示した。 Comment
日本語解説: https://qiita.com/moufuyu/items/94418980ec0598671221
BLIP:
- [Paper Note] BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding and Generation, Junnan Li+, ICML'22, 2022.01
Flamingo:
- [Paper Note] Flamingo: a Visual Language Model for Few-Shot Learning, Jean-Baptiste Alayrac+, NeurIPS'22, 2022.04
[Paper Note] Set-of-Mark Prompting Unleashes Extraordinary Visual Grounding in GPT-4V, Jianwei Yang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #ImageSegmentation #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #Grounding Issue Date: 2025-11-25 GPT Summary- Set-of-Mark (SoM)という新しい視覚プロンプティング手法を提案し、GPT-4Vの視覚的能力を引き出す。画像を異なる領域に分割し、マークを重ねることで、視覚的基盤を必要とする質問に答えることが可能に。実験では、SoMを用いたGPT-4Vがゼロショット設定で最先端のモデルを上回る性能を示した。 Comment
pj page: https://som-gpt4v.github.io
日本語解説: https://ai-scholar.tech/articles/prompting-method/SoM
画像をsegmentationし、segmentationした領域上に数字のマーカーをオーバーレイした画像を入力すると、VLMのgrounding能力が向上する、という話らしい
[Paper Note] Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow, Xingchao Liu+, ICLR'23, 2022.09
Paper/Blog Link My Issue
#MachineLearning #ICLR #Selected Papers/Blogs #RectifiedFlow Issue Date: 2025-10-10 GPT Summary- rectified flowという新しいアプローチを提案し、2つの分布間での輸送を学習するODEモデルを用いる。これは、直線的な経路を学習することで計算効率を高め、生成モデルやドメイン転送において統一的な解決策を提供する。rectificationを通じて、非増加の凸輸送コストを持つ新しい結合を生成し、再帰的に適用することで直線的なフローを得る。実証研究では、画像生成や翻訳において優れた性能を示し、高品質な結果を得ることが確認された。 Comment
openreview: https://openreview.net/forum?id=XVjTT1nw5z
日本語解説(fmuuly, zenn):
- Rectified Flow 1:
https://zenn.dev/fmuuly/articles/37cc3a2f17138e
- Rectified Flow 2:
https://zenn.dev/fmuuly/articles/a062fcd340207f
- Rectified Flow 3:
https://zenn.dev/fmuuly/articles/0f262fc003e202
[Paper Note] GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment, Dhruba Ghosh+, NeurIPS'23
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #TextToImageGeneration #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-09-11 GPT Summary- テキストから画像への生成モデルの自動評価方法「GenEval」を提案。物体の共起、位置、数、色などの特性を評価し、現在の物体検出モデルを活用して生成タスクを分析。最近のモデルは改善を示すが、複雑な能力には課題が残る。GenEvalは失敗モードの発見にも寄与し、次世代モデルの開発に役立つ。コードは公開中。 Comment
openreview: https://openreview.net/forum?id=Wbr51vK331¬eId=NpvYJlJFqK
[Paper Note] Dropout Reduces Underfitting, Zhuang Liu+, ICML'23
Paper/Blog Link My Issue
#NeuralNetwork #Regularization #ICML Issue Date: 2025-08-30 GPT Summary- 本研究では、ドロップアウトをトレーニング初期に使用することでアンダーフィッティングを軽減できることを示し、初期ドロップアウト手法を提案します。これにより、勾配の方向的分散が減少し、SGDの確率性に対抗します。実験により、初期ドロップアウトを用いたモデルは、ドロップアウトなしのモデルよりも低いトレーニング損失を示し、一般化精度が向上することが確認されました。また、後期ドロップアウトという手法も探求し、トレーニング後半での正則化効果を検証しました。これらの結果は、深層学習における正則化の理解を深めることに寄与します。 Comment
日本語解説: https://www.docswell.com/s/DeepLearning2023/54QM6D-dldropout-reduces-underfitting
[Paper Note] Scalable Diffusion Models with Transformers, William Peebles+, ICCV'23
Paper/Blog Link My Issue
#Transformer #DiffusionModel #read-later #Selected Papers/Blogs #Backbone Issue Date: 2025-08-27 GPT Summary- 新しいトランスフォーマーに基づく拡散モデル(Diffusion Transformers, DiTs)を提案し、U-Netをトランスフォーマーに置き換えた。DiTsは高いGflopsを持ち、低いFIDを維持しながら良好なスケーラビリティを示す。最大のDiT-XL/2モデルは、ImageNetのベンチマークで従来の拡散モデルを上回り、最先端のFID 2.27を達成した。 Comment
日本語解説: https://qiita.com/sasgawy/items/8546c784bc94d94ef0b2
よく見るDiT
- [Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
も同様の呼称だが全く異なる話なので注意
[Paper Note] SemDeDup: Data-efficient learning at web-scale through semantic deduplication, Amro Abbas+, arXiv'23
Paper/Blog Link My Issue
#Embeddings #NLP #Deduplication Issue Date: 2025-08-16 GPT Summary- SemDeDupは、事前学習モデルの埋め込みを用いて意味的に重複するデータペアを特定し削除する手法。LAIONのサブセットで50%のデータ削除を実現し、トレーニング時間を半分に短縮。分布外性能も向上し、C4データセットでも効率性を改善。質の高い埋め込みを活用することで、データ削減と学習加速を両立。 Comment
embedding空間において近傍のサンプル(near-duplicates)を削除することで、学習効率が向上します、という話な模様。
openreview:
https://openreview.net/forum?id=IRSesTQUtb¬eId=usQjFYYAZJ
openreviewによると、embedding空間においてnear-duplicatesを削除するというアイデアは興味深いが、提案手法は既存研究のアイデアを組み合わせているに留まっており(多くのブログポストやdeduplicationのためのライブラリも存在する)新規性が明確ではない点や、実験結果が不足している(i.e., 全てのケースでSoTAというわけでもなく、大規模モデルでの実験やstrong baselineの不在(実験結果はrandom pruningに対してoutperformすることが主に示されている)など、論文の主張をサポートするための結果が足りない)という指摘がされている。
実用的にはwell-writtenでexampleも豊富とのことなので、Deduplicationの理解を深めるのに良さそう。
先行研究:
- (画像)[Paper Note] Beyond neural scaling laws: beating power law scaling via data pruning, Ben Sorscher+, NeurIPS'22
- (テキスト)[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
[Paper Note] Beyond neural scaling laws: beating power law scaling via data pruning, Ben Sorscher+, NeurIPS'22
では、分類が難しい画像のデータという観点にフォーカスしており、[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
では、テキストの表層的な情報の一致に基づいてDeduplicationを実施している。
[Paper Note] Adding Conditional Control to Text-to-Image Diffusion Models, Lvmin Zhang+, arXiv'23
Paper/Blog Link My Issue
#Controllable #NLP #MultiModal #TextToImageGeneration Issue Date: 2025-08-07 GPT Summary- ControlNetは、テキストから画像への拡散モデルに空間的な条件制御を追加するためのニューラルネットワークアーキテクチャであり、事前学習済みのエンコーディング層を再利用して多様な条件制御を学習します。ゼロ畳み込みを用いてパラメータを徐々に増加させ、有害なノイズの影響を軽減します。Stable Diffusionを用いて様々な条件制御をテストし、小規模および大規模データセットに対して堅牢性を示しました。ControlNetは画像拡散モデルの制御における広範な応用の可能性を示唆しています。 Comment
ControlNet論文
[Paper Note] Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture, Mahmoud Assran+, CVPR'23, 2023.01
Paper/Blog Link My Issue
#Pretraining #RepresentationLearning #Transformer #Self-SupervisedLearning #CVPR #read-later #Selected Papers/Blogs #WorldModels #One-Line Notes #LatentRepresentation Issue Date: 2025-07-24 GPT Summary- 本論文では、手作りのデータ拡張に依存せずに意味的な画像表現を学習するI-JEPAという自己教師あり学習アプローチを提案。I-JEPAは、単一のコンテキストブロックから異なるターゲットブロックの表現を予測する。重要な設計選択として、意味的に大きなターゲットブロックと情報量の多いコンテキストブロックのサンプリングが挙げられる。実験により、I-JEPAはVision Transformersと組み合わせることでスケーラブルであり、ImageNet上で強力な下流性能を達成した。 Comment
Joint-Embedding Predictive Architecture (JEPA)を提案した研究。ピクセルやトークンのreconstruction lossではなく、潜在表現を再構成するようなself-supervised learningによってより意味的な特徴を学習するように誘導するもの(と思われるがこれが本質的な理解として正しいかは自信がない)。
[Paper Note] Flow Matching for Generative Modeling, Yaron Lipman+, ICLR'23
Paper/Blog Link My Issue
#DiffusionModel #ICLR #Selected Papers/Blogs #FlowMatching #OptimalTransport Issue Date: 2025-07-09 GPT Summary- Continuous Normalizing Flows(CNFs)に基づく新しい生成モデルの訓練手法Flow Matching(FM)を提案。FMは固定された条件付き確率経路のベクトル場を回帰し、シミュレーション不要で訓練可能。拡散経路と併用することで、より堅牢な訓練が実現。最適輸送を用いた条件付き確率経路は効率的で、訓練とサンプリングが速く、一般化性能も向上。ImageNetでの実験により、FMは拡散ベース手法よりも優れた性能を示し、迅速なサンプル生成を可能にする。 Comment
[Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
Paper/Blog Link My Issue
#Pretraining #LanguageModel #MultiModal #ContrastiveLearning #Selected Papers/Blogs #ICCV #Scalability #needs-revision Issue Date: 2025-06-29 GPT Summary- シンプルなペアワイズシグモイド損失(SigLIP)を提案し、画像-テキストペアに基づく言語-画像事前学習を改善。シグモイド損失はバッチサイズの拡大を可能にし、小さなバッチサイズでも性能向上を実現。SigLiTモデルは84.5%のImageNetゼロショット精度を達成。バッチサイズの影響を研究し、32kが合理的なサイズであることを確認。モデルは公開され、さらなる研究の促進を期待。 Comment
SigLIP論文
[Paper Note] Magneto: A Foundation Transformer, Hongyu Wang+, ICML'23
Paper/Blog Link My Issue
#NLP #Transformer #MultiModal #SpeechProcessing #Architecture #ICML #Normalization #KeyPoint Notes Issue Date: 2025-04-19 GPT Summary- 言語、視覚、音声、マルチモーダルにおけるモデルアーキテクチャの収束が進む中、異なる実装の「Transformers」が使用されている。汎用モデリングのために、安定性を持つFoundation Transformerの開発が提唱され、Magnetoという新しいTransformer変種が紹介される。Sub-LayerNormと理論に基づく初期化戦略を用いることで、さまざまなアプリケーションにおいて優れたパフォーマンスと安定性を示した。 Comment
マルチモーダルなモデルなモデルの事前学習において、PostLNはvision encodingにおいてsub-optimalで、PreLNはtext encodingにおいてsub-optimalであることが先行研究で示されており、マルタモーダルを単一のアーキテクチャで、高性能、かつ学習の安定性な高く、try and error無しで適用できる基盤となるアーキテクチャが必要というモチベーションで提案された手法。具体的には、Sub-LayerNorm(Sub-LN)と呼ばれる、self attentionとFFN部分に追加のLayerNormを適用するアーキテクチャと、DeepNetを踏襲しLayer数が非常に大きい場合でも学習が安定するような重みの初期化方法を理論的に分析し提案している。
具体的には、Sub-LNの場合、LayerNormを
- SelfAttention計算におけるQKVを求めるためのinput Xのprojectionの前とAttentionの出力projectionの前
- FFNでの各Linear Layerの前
に適用し、
初期化をする際には、FFNのW, およびself-attentionのV_projと出力のout_projの初期化をγ(=sqrt(log(2N))によってスケーリングする方法を提案している模様。
関連:
- [Paper Note] DeepNet: Scaling Transformers to 1,000 Layers, Hongyu Wang+, arXiv'22, 2022.03
[Paper Note] Segment Anything, Alexander Kirillov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#Transformer #ImageSegmentation #FoundationModel #Selected Papers/Blogs Issue Date: 2025-04-11 GPT Summary- Segment Anythingプロジェクトでは、新しい画像分割タスク、モデル、データセットを紹介。効率的なモデルを用いて最大規模のセグメンテーションデータセットを構築し、プライバシーを尊重した11M枚の画像に10億以上のマスクを含む。モデルはゼロショットで新しいタスクに転移可能で、評価の結果、従来の教師あり手法と同等、またはそれを上回る性能を示した。Segment Anything Model(SAM)と11M画像、1Bマスクを含むデータセット(SA-1B)を公開。 Comment
SAM論文
pj page: https://segment-anything.com
[Paper Note] PaLI-3 Vision Language Models: Smaller, Faster, Stronger, Xi Chen+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #MultiModal #OpenWeight #VisionLanguageModel #One-Line Notes Issue Date: 2025-04-11 GPT Summary- PaLI-3は、10倍の規模のモデルに匹敵する、より小型で高速なビジョン・ランゲージモデル(VLM)です。SigLIPによって事前学習されたPaLIは、画像分類ベンチマークではわずかに劣るものの、マルチモーダルベンチマークでは優れた性能を発揮。20億パラメータのSigLIP画像エンコーダを用いて多言語間のクロスモーダル検索で新たな最先端を達成し、50億パラメータで複雑なVLMの研究を促進することが期待されています。 Comment
OpenReview:
https://openreview.net/forum?id=JpyWPfzu0b
実験的に素晴らしい性能が実現されていることは認められつつも
- 比較対象がSigLIPのみでより広範な比較実験と分析が必要なこと
- BackboneモデルをContrastive Learningすること自体の有用性は既に知られており、新規性に乏しいこと
としてICLR'24にRejectされている
SINC: Self-Supervised In-Context Learning for Vision-Language Tasks, Yi-Syuan Chen+, N_A, ICCV'23
Paper/Blog Link My Issue
#LanguageModel #Zero/Few/ManyShotPrompting #Self-SupervisedLearning Issue Date: 2024-10-07 GPT Summary- 自己教師あり文脈内学習(SINC)フレームワークを提案し、大規模言語モデルに依存せずに文脈内学習を実現。特別に調整されたデモンストレーションを用いたメタモデルが、視覚と言語のタスクで少数ショット設定において勾配ベースの手法を上回る性能を示す。SINCは文脈内学習の利点を探求し、重要な要素を明らかにする。
SEINE: Short-to-Long Video Diffusion Model for Generative Transition and Prediction, Xinyuan Chen+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #GenerativeAI #MultiModal Issue Date: 2023-12-01 GPT Summary- 本研究では、ビデオ生成において連続した長いビデオを生成するためのジェネレーティブなトランジションと予測に焦点を当てたモデルSEINEを提案する。SEINEはテキストの説明に基づいてトランジションを生成し、一貫性と視覚的品質を確保した長いビデオを生成する。さらに、提案手法は他のタスクにも拡張可能であり、徹底的な実験によりその有効性が検証されている。 Comment
https://huggingface.co/spaces/Vchitect/SEINE
画像 + テキストpromptで、動画を生成するデモ
Visual In-Context Prompting, Feng Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#ImageSegmentation #Prompting #In-ContextLearning Issue Date: 2023-11-23 GPT Summary- 本研究では、ビジョン領域における汎用的なビジュアルインコンテキストプロンプティングフレームワークを提案します。エンコーダーデコーダーアーキテクチャを使用し、さまざまなプロンプトをサポートするプロンプトエンコーダーを開発しました。さらに、任意の数の参照画像セグメントをコンテキストとして受け取るように拡張しました。実験結果から、提案手法が非凡な参照および一般的なセグメンテーション能力を引き出し、競争力のあるパフォーマンスを示すことがわかりました。 Comment
Image Segmentationには、ユーザが与えたプロンプトと共通のコンセプトを持つすべてのオブジェクトをセグメンテーションするタスクと、ユーザの入力の特定のオブジェクトのみをセグメンテーションするタスクがある。従来は個別のタスクごとに、特定の入力方法(Visual Prompt, Image Prompt)を前提とした手法や、個々のタスクを実施できるがIn-Context Promptしかサポートしていない手法しかなかったが、この研究では、Visual Prompt, Image Prompt, In-Context Promptをそれぞれサポートし両タスクを実施できるという位置付けの模様。また、提案手法ではストローク、点、ボックスといったユーザの画像に対する描画に基づくPromptingをサポートし、Promptingにおける参照セグメント数も任意の数指定できるとのこと。
LayoutPrompter: Awaken the Design Ability of Large Language Models, Jiawei Lin+, N_A, NeurIPS'23
Paper/Blog Link My Issue
#NLP #LayoutGeneration #NeurIPS Issue Date: 2023-11-14 GPT Summary- LayoutPrompterは、大規模言語モデル(LLMs)を使用して条件付きのグラフィックレイアウト生成を行う手法であり、入力-出力のシリアル化、動的な模範的選択、およびレイアウトのランキングの3つのコンポーネントで構成されています。LayoutPrompterは、既存の手法と競合したり上回ったりする性能を持ち、トレーニングや微調整なしで使用できる汎用性のあるアプローチであることが実験結果から示されています。また、データ効率にも優れており、トレーニングベースラインよりも有意に優れていることも示されています。プロジェクトは、https://github.com/microsoft/LayoutGeneration/tree/main/LayoutPrompterで利用可能です。 Comment
Conditional Graphic Layout Generation
Florence-2: Advancing a Unified Representation for a Variety of Vision Tasks, Bin Xiao+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #MultitaskLearning #MultiModal #FoundationModel #SpatialUnderstanding #One-Line Notes Issue Date: 2023-11-13 GPT Summary- Florence-2は、ビジョン基盤モデルであり、さまざまなビジョンタスクに対応するための統一されたプロンプトベースの表現を持っています。このモデルは、テキストプロンプトを受け取り、キャプショニング、オブジェクト検出、グラウンディング、セグメンテーションなどのタスクを実行し、テキスト形式で結果を生成します。また、FLD-5Bという大規模な注釈付きデータセットも開発されました。Florence-2は、多目的かつ包括的なビジョンタスクを実行するためにシーケンスツーシーケンス構造を採用しており、前例のないゼロショットおよびファインチューニングの能力を持つ強力なモデルです。 Comment
Vison Foundation Model。Spatialな階層構造や、Semanticを捉えられるように訓練。Image/Prompt Encoderでエンコードされ、outputはtext + location informationとなる。
[Paper Note] Exploring OCR Capabilities of GPT-4V(ision) : A Quantitative and In-depth Evaluation, Yongxin Shi+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #EMNLP #OCR #One-Line Notes #Reading Reflections Issue Date: 2023-10-26 GPT Summary- GPT-4VのOCR機能を評価し、シーンテキスト、手書き文字、数学式や表構造認識などの幅広いタスクへの性能を検討。ラテン文字では高性能だが、多言語や複雑なタスクでは限界を示す。専門的なOCRモデルの必要性を強調し、今後の研究の指針を提供。評価結果は公開されている。 Comment
GPT4-VをさまざまなOCRタスク「手書き、数式、テーブル構造認識等を含む)で性能検証した研究。
MLT19データセットを使った評価では、日本語の性能は非常に低く、英語とフランス語が性能高い。手書き文字認識では英語と中国語でのみ評価。
現在では非常に性能が向上していると考えられるが、初期VLMのOCR性能を示している文献として興味深い。
[Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #LanguageModel #QuestionAnswering #OpenWeight #CVPR #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2023-10-09 GPT Summary- LLaVAにCLIP-ViT-L-336pxとMLP投影を用いた全結合型コネクタを導入し、学術タスク指向のVQAデータを追加。単純な変更で、公開データ120万件・8基のA100による約1日の学習で、11のベンチマークすべてで最先端性能を達成。高性能かつデータ効率の高いLMMベースラインを確立し、研究の普及に貢献。 Comment
画像分析が可能なオープンソースLLMとのこと。
画像生成をできるわけではなく、inputとして画像を扱えるのみ。
pj page: https://llava-vl.github.io
[Paper Note] Foundational Models Defining a New Era in Vision: A Survey and Outlook, Muhammad Awais+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Survey #FoundationModel #One-Line Notes Issue Date: 2023-08-08 GPT Summary- 視覚システムの理解と推論における基盤モデルの役割をレビュー。異なるモダリティを組み合わせるアーキテクチャやトレーニング方法、プロンプティングパターンを含む。オープンな課題や研究方向性、評価の困難さ、文脈理解の限界なども議論。基盤モデルの応用を包括的にカバーし、詳細なリストはオンラインで提供。 Comment
CVにおけるfoundation modelのsurvey。残されたチャレンジと研究の方向性が議論されている
[Paper Note] Scaling Autoregressive Multi-Modal Models: Pretraining and Instruction Tuning, Lili Yu+, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel #FoundationModel Issue Date: 2023-07-23 GPT Summary- CM3Leonは、テキストと画像の生成・補完が可能なマルチモーダル言語モデルで、リトリーバル拡張型のトークンベースのデコーダを使用。CM3アーキテクチャを基に、多様な指示スタイルでのスケーリングとチューニングに優れ、初のテキスト専用モデルから適応されたマルチモーダルモデル。高品質な出力を生成する対照的デコーディング手法を導入し、少ない計算量で最先端の性能を達成。SFT後は、画像編集や生成において高い制御性を示す。
InfoMetIC: An Informative Metric for Reference-free Image Caption Evaluation, ACL'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Dataset #Evaluation #ACL Issue Date: 2023-07-22 GPT Summary- 自動画像キャプションの評価には、情報豊かなメトリック(InfoMetIC)が提案されています。これにより、キャプションの誤りや欠落した情報を詳細に特定することができます。InfoMetICは、テキストの精度スコア、ビジョンの再現スコア、および全体の品質スコアを提供し、人間の判断との相関も高いです。また、トークンレベルの評価データセットも構築されています。詳細はGitHubで公開されています。
Towards A Unified Agent with Foundation Models, Norman Di Palo+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents Issue Date: 2023-07-22 GPT Summary- 本研究では、言語モデルとビジョン言語モデルを強化学習エージェントに組み込み、効率的な探索や経験データの再利用などの課題に取り組む方法を調査しました。スパースな報酬のロボット操作環境でのテストにおいて、ベースラインに比べて大幅な性能向上を実証し、学習済みのスキルを新しいタスクの解決や人間の専門家のビデオの模倣に活用する方法を示しました。
[Paper Note] FABRIC: Personalizing Diffusion Models with Iterative Feedback, Dimitri von Rütte+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Personalization #DiffusionModel #One-Line Notes Issue Date: 2023-07-22 GPT Summary- 生成モデルへの人間のフィードバック統合が重要な機会を提供する中、本研究では拡散モデルを用いたテキストから画像への生成に反復的フィードバックを組み込む手法、FABRICを提案。トレーニング不要で、多様な拡散モデルに適用可能。自己注意層を利用し、フィードバックで条件付けされた生成プロセスを評価。反復的フィードバックによる生成結果の改善を示し、パーソナライズされたコンテンツ作成への応用の可能性を探る。 Comment
upvote downvoteをフィードバックし、iterativeなmannerでDiffusionモデルの生成結果を改善できる手法。多くのDiffusion based Modelに対して適用可能
デモ:
https://huggingface.co/spaces/dvruette/fabric
[Paper Note] Meta-Transformer: A Unified Framework for Multimodal Learning, Yiyuan Zhang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #LanguageModel #MultiModal #SpeechProcessing #One-Line Notes Issue Date: 2023-07-22 GPT Summary- Meta-Transformerは、ペアのマルチモーダルトレーニングデータを用いず、複数のモダリティを統一的に学習する新しいフレームワークです。共有トークンスペースでの生データマッピングと凍結されたエンコーダによる高レベル特徴抽出を実現し、テキストや画像など多様なモダリティ間での知覚を可能にします。実験結果は、様々なベンチマークにおいて広範囲なタスクへの対応が確認され、マルチモーダルインテリジェンスの発展に寄与する可能性を示しています。 Comment
12種類のモダリティに対して学習できるTransformerを提案
Dataをsequenceにtokenizeし、unifiedにfeatureをencodingし、それぞれのdownstreamタスクで学習
MPCHAT: Towards Multimodal Persona-Grounded Conversation, ACL'23
Paper/Blog Link My Issue
#NLP #Dataset #Personalization #MultiModal #Conversation #ACL Issue Date: 2023-07-15 GPT Summary- 本研究では、テキストと画像の両方を使用してパーソナを拡張し、マルチモーダルな対話エージェントを構築するためのデータセットであるMPCHATを提案します。さらに、マルチモーダルパーソナを組み込むことで、応答予測、パーソナのグラウンディング予測、話者の識別といったタスクのパフォーマンスを統計的に有意に改善できることを示します。この研究は、マルチモーダルな対話理解においてマルチモーダルパーソナの重要性を強調し、MPCHATが高品質なリソースとして役立つことを示しています。
Table and Image Generation for Investigating Knowledge of Entities in Pre-trained Vision and Language Models, ACL'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #LanguageModel #TabularData #TextToImageGeneration #ACL Issue Date: 2023-07-15 GPT Summary- 本研究では、Vision&Language(V&L)モデルにおけるエンティティの知識の保持方法を検証するために、テーブルと画像の生成タスクを提案します。このタスクでは、エンティティと関連する画像の知識を含むテーブルを生成する第一の部分と、キャプションとエンティティの関連知識を含むテーブルから画像を生成する第二の部分があります。提案されたタスクを実行するために、Wikipediaの約20万のinfoboxからWikiTIGデータセットを作成しました。最先端のV&LモデルOFAを使用して、提案されたタスクのパフォーマンスを評価しました。実験結果は、OFAが一部のエンティティ知識を忘れることを示しています。
Learning to Imagine: Visually-Augmented Natural Language Generation, ACL'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #MultiModal #DiffusionModel #TextToImageGeneration #ACL Issue Date: 2023-07-15 GPT Summary- 本研究では、視覚情報を活用した自然言語生成のためのLIVEという手法を提案しています。LIVEは、事前学習済み言語モデルを使用して、テキストに基づいて場面を想像し、高品質な画像を合成する方法です。また、CLIPを使用してテキストの想像力を評価し、段落ごとに画像を生成します。さまざまな実験により、LIVEの有効性が示されています。コード、モデル、データは公開されています。 Comment
>まず、テキストに基づいて場面を想像します。入力テキストに基づいて高品質な画像を合成するために拡散モデルを使用します。次に、CLIPを使用して、テキストが想像力を喚起できるかを事後的に判断します。最後に、私たちの想像力は動的であり、段落全体に1つの画像を生成するのではなく、各文に対して合成を行います。
興味深い
[Paper Note] Objaverse-XL: A Universe of 10M+ 3D Objects, Matt Deitke+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Dataset #FoundationModel #InductiveBias #NeurIPS #Selected Papers/Blogs #3D Reconstruction #3D (Scene) #NovelViewSynthesis #3D Object Generation Issue Date: 2023-07-12 GPT Summary- 1000万以上の3Dオブジェクトから構成されるデータセットObjaverse-XLを紹介。手作業で設計されたオブジェクトや写真測量スキャンからの多様なオブジェクトを含む。Objaverse-XLは3Dビジョン分野の最大規模と多様性を持ち、Zero123を用いた新規ビュー合成で強力なゼロショット一般化を実現。これにより、3Dビジョンでのさらなる革新が期待される。 Comment
10Mを超える3D objectのデータセットを公開し、3D Modelの基盤モデルとしてZero123-XLを訓練。
元ツイートのGifがわかりやすい。
たとえばinputされたイメージに対して、自由にカメラの視点を設定し、その視点からの物体の画像を出力できる。
openreview: https://openreview.net/forum?id=Sq3CLKJeiz¬eId=hnXWj1z2rI
Generative Pretraining in Multimodality, Quan Sun+, N_A, arXiv'23
Paper/Blog Link My Issue
#Pretraining #NLP #Transformer #MultiModal Issue Date: 2023-07-12 GPT Summary- Emuは、マルチモーダルなコンテキストで画像とテキストを生成するためのTransformerベースのモデルです。このモデルは、単一モダリティまたはマルチモーダルなデータ入力を受け入れることができます。Emuは、マルチモーダルなシーケンスでトレーニングされ、画像からテキストへのタスクやテキストから画像へのタスクなど、さまざまなタスクで優れたパフォーマンスを示します。また、マルチモーダルアシスタントなどの拡張機能もサポートしています。
EgoVLPv2: Egocentric Video-Language Pre-training with Fusion in the Backbone, Shraman Pramanick+, N_A, arXiv'23
Paper/Blog Link My Issue
#Pretraining #NLP #MultiModal Issue Date: 2023-07-12 GPT Summary- エゴセントリックビデオ言語の事前学習の第2世代(EgoVLPv2)は、ビデオと言語のバックボーンにクロスモーダルの融合を直接組み込むことができる。EgoVLPv2は強力なビデオテキスト表現を学習し、柔軟かつ効率的な方法でさまざまなダウンストリームタスクをサポートする。さらに、提案されたバックボーン戦略は軽量で計算効率が高い。EgoVLPv2は幅広いVLタスクで最先端のパフォーマンスを達成している。詳細はhttps://shramanpramanick.github.io/EgoVLPv2/を参照。
[Paper Note] ViNT: A Foundation Model for Visual Navigation, Dhruv Shah+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Transformer #FoundationModel #Navigation #Robotics #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 汎用的なファウンデーションモデルViNTを紹介し、ロボットナビゲーションにおける汎用的な成功を目指す。ViNTは、一般的なゴール到達を目的とした学習目標で訓練され、さまざまなナビゲーションタスクに適応可能なTransformerベースのアーキテクチャを持つ。既存データセットで訓練され、専門モデルを上回る性能を示す。新環境探索やタスク仕様への適応にも柔軟で、モバイルロボティクスの基盤モデルとしての有効性を持つ。 Comment
事前学習済みモデルを視覚ベースのロボットナビゲーションに活用するFoundation Model。FlexibleなTransformerベースのアーキテクチャに基づいて構築されており、さまざまなナビゲーションタスクに取り組むことが可能
[Paper Note] SPAE: Semantic Pyramid AutoEncoder for Multimodal Generation with Frozen LLMs, Lijun Yu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #LanguageModel #QuestionAnswering #MultiModal #NeurIPS #VisionLanguageModel #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 凍結されたLLMが画像や動画を理解・生成できるようにするSemantic Pyramid AutoEncoder(SPAE)を提案。生データのピクセルとLLMの語彙をトークンに変換し、視覚情報を言語に翻訳。凍結済みのPaLM 2およびGPT-3.5を使用した実験で、画像理解タスクで25%以上の性能向上を実現。 Comment
画像をLLMのtokenスペースにマッピングすることで、LLMがパラメータの更新なしにvisual taskを解くことを可能にした。in context learningによって、様々なvisuataskを解くことができる。
openreview: https://openreview.net/forum?id=CXPUg86A1D
[Paper Note] Towards Language Models That Can See: Computer Vision Through the LENS of Natural Language, William Berrios+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #MultiModal Issue Date: 2023-06-30 GPT Summary- LENSというモジュール型アプローチで、LLMを用いてコンピュータビジョンの問題に取り組む。視覚モジュールが提供する情報を言語モデルが推論し、ゼロショットや少数ショットの物体認識や視覚と言語の問題において評価。市販のLLMに適用でき、マルチモーダルトレーニングなしでも高い競争力を示す。コードはオープンソースで提供。 Comment
参考:
Photoswap: Personalized Subject Swapping in Images, Jing Gu+, N_A, arXiv'23
Paper/Blog Link My Issue
#Personalization Issue Date: 2023-06-16 GPT Summary- 本研究では、Photoswapという新しいアプローチを提案し、既存の画像において個人的な対象物の交換を可能にすることを目的としています。Photoswapは、参照画像から対象物の視覚的な概念を学習し、トレーニングフリーでターゲット画像に交換することができます。実験により、Photoswapが効果的で制御可能であり、ベースライン手法を大幅に上回る人間の評価を得ていることが示されました。Photoswapは、エンターテインメントからプロの編集まで幅広い応用可能性を持っています。
[Paper Note] ViCo: Plug-and-play Visual Condition for Personalized Text-to-image Generation, Shaozhe Hao+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Personalization #DiffusionModel #TextToImageGeneration Issue Date: 2023-06-16 GPT Summary- ViCoは、個別化されたテキストから画像を生成する軽量な拡散モデルで、従来のモデルのファインチューニングを不要とし、柔軟でスケーラブルな展開を実現します。ViCoは、画像アテンションモジュールを通じて視覚セマンティクスを統合し、約6%のパラメータ学習で最先端モデルと同等の性能を達成。個別化テキストからの画像生成における有効性を示し、今後の展望が期待されます。
[Paper Note] AVIS: Autonomous Visual Information Seeking with Large Language Model Agent, Ziniu Hu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #QuestionAnswering #MultiModal Issue Date: 2023-06-16 GPT Summary- 自律的情報探索型視覚質問応答フレームワークAVISを提案。LLMを活用して外部ツールを動的に戦略化し、複雑な視覚質問に対して必要な知識を獲得。ユーザ研究を通じて得られたデータを基に、ツール決定プランナー、情報分析推論機、作業メモリ機構からなるシステムを設計。AVISは知識集約型ベンチマークで最先端の性能を達成。
[Paper Note] MEGABYTE: Predicting Million-byte Sequences with Multiscale Transformers, Lili Yu+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #Transformer #SpeechProcessing #LongContext #Architecture #NeurIPS #One-Line Notes #Byte-level Issue Date: 2023-05-15 GPT Summary- Megabyteというマルチスケールデコーダーアーキテクチャを提案し、長いシーケンスのエンドツーエンドのモデリングを可能にする。シーケンスをパッチに分割し、ローカルサブモデルとグローバルモデルを使用することで、計算効率を向上させつつコストを削減。実験により、Megabyteは長いコンテキストの言語モデリングで競争力を持ち、最先端の密度推定を達成した。トークン化なしの自己回帰シーケンスモデリングの実現可能性を示す。 Comment
byte列のsequenceからpatch embeddingを作成することで、tokenizer freeなtransformerを提案。
byte列で表現されるデータならなんでも入力できる。つまり、理論上なんでも入力できる。
openreview: https://openreview.net/forum?id=JTmO2V9Xpz
[Paper Note] Sketching the Future (STF): Applying Conditional Control Techniques to Text-to-Video Models, Rohan Dhesikan+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #Controllable #NLP #VideoGeneration/Understandings #TextToVideoGeneration Issue Date: 2023-05-12 GPT Summary- ゼロショットのテキストからビデオ生成にControlNetを組み合わせた新しいアプローチを提案。複数のスケッチ風フレームを入力とし、それに一致するビデオを生成。フレーム補間とControlNetによる制御で高品質で一貫性のあるビデオを実現。デモ動画やリソースも提供し、さらなる研究を促進。
SemPPL: Predicting pseudo-labels for better contrastive representations, Matko Bošnjak+, N_A, ICLR'23
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #RepresentationLearning #ContrastiveLearning #ICLR #Semi-Supervised Issue Date: 2023-04-30 GPT Summary- 本研究では、コンピュータビジョンにおける半教師あり学習の問題を解決するために、Semantic Positives via Pseudo-Labels (SemPPL)という新しい手法を提案している。この手法は、ラベル付きとラベルなしのデータを組み合わせて情報豊富な表現を学習することができ、ResNet-$50$を使用してImageNetの$1\%$および$10\%$のラベルでトレーニングする場合、競合する半教師あり学習手法を上回る最高性能を発揮することが示された。SemPPLは、強力な頑健性、分布外および転移性能を示すことができる。 Comment
Stable and low-precision training for large-scale vision-language models, Wortsman+, University of Washington, NeurIPS'23
Paper/Blog Link My Issue
#NeurIPS #needs-revision Issue Date: 2023-04-27
[Paper Note] Track Anything: Segment Anything Meets Videos, Jinyu Yang+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#ImageSegmentation #TechnicalReport #3D (Video) #One-Line Notes Issue Date: 2023-04-25 GPT Summary- 動画セグメンテーションにおいて、Track Anything Model (TAM)を提案。少数のクリックで関心の対象を効果的に追跡・セグメント化し、追加訓練なしで高性能を実現。全リソースはオンラインで提供。 Comment
MetaのSAMを、videoに適用し、videow内のsegmentationを追加学習なしでやりました、という話だと思われる。
関連:
- [Paper Note] Segment Anything, Alexander Kirillov+, arXiv'23, 2023.04
Sketch-Guided Text-to-Image Diffusion Models, Andrey+, Google Research, SIGGRAPH'23
Paper/Blog Link My Issue
#NeuralNetwork #NLP #TextToImageGeneration #SIGGRAPH #One-Line Notes #ImageSynthesis Issue Date: 2022-12-01 Comment
スケッチとpromptを入力することで、スケッチ biasedな画像を生成することができる技術。すごい。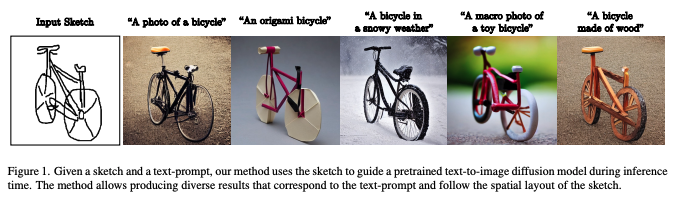
[Paper Note] Mind the Gap: Understanding the Modality Gap in Multi-modal Contrastive Representation Learning, Weixin Liang+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#Analysis #MultiModal #ContrastiveLearning #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2026-08-20 GPT Summary- マルチモーダルモデルにおけるモダリティギャップの幾何学的現象を紹介。異なるデータモダリティが共有表現空間で一定の距離を保つことを示し、これはモデル初期化と対照学習の組み合わせによって引き起こされる。初期化段階で表現が狭い円錐に制限され、対照学習によりモダリティ間の距離が維持されることが実証された。実験により、このギャップ距離を変えることでゼロショット分類性能と公平性が改善されることがわかった。コードとデータは公開中。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=S7Evzt9uit3
[Paper Note] Three things everyone should know about Vision Transformers, Hugo Touvron+, ECCV'22, 2022.03
Paper/Blog Link My Issue
#Transformer #Architecture #ECCV #2D (Image) #Initial Impression Notes Issue Date: 2026-07-16 GPT Summary- 視覚トランスフォーマーは、精度を損なうことなく並列処理が可能であり、アテンション層の微調整により様々なタスクへ適応可能であることを示す3つの洞察を提供。さらに、MLPベースのパッチ前処理層の追加が自己教師付き学習を改善。これらの影響をImageNet-1kデータセットで評価し、転移性能を小規模データセットで測定。 Comment
Inklingによって採用されているhMLPと呼ばれるアーキテクチャが提案されている(図5)
[Paper Note] Masked Autoencoders Are Scalable Vision Learners, Kaiming He+, CVPR'22, 2021.11
Paper/Blog Link My Issue
#Pretraining #Transformer #Self-SupervisedLearning #CVPR #Selected Papers/Blogs #Encoder #Backbone #One-Line Notes #AutoEncoder #2D Reconstruction Issue Date: 2026-04-29 GPT Summary- MAEは、入力画像のランダムなパッチをマスクし、欠損部分を再構成するシンプルな自己教師付き学習モデルである。非対称のエンコーダ-デコーダ構造を用い、エンコーダは可視パッチのみを処理。75%をマスクすることで、非自明な自己教師付きタスクを生み出し、高速かつ効果的なモデル訓練を実現。一般化性能に優れ、ViT-HugeモデルがImageNet-1Kデータで最高精度(87.8%)を達成し、転移性能も監督付き事前学習を上回る。 Comment
元ポスト:
AutoEncoderを通じてMaskされたパッチを再構築できるように学習する(25%のパッチから予測する)ことで、(decoderを排除した場合に)downstream taskで良い性能を発揮するViTエンコーダを学習する。デコーダのパラメータ数は意図的に小さくし、Encoder側で特徴がきちんと学習されるように誘導する。
[Paper Note] Video PreTraining (VPT): Learning to Act by Watching Unlabeled Online Videos, Bowen Baker+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#Pretraining #FoundationModel #3D (Video) #One-Line Notes #WorldActionModel Issue Date: 2026-02-27 GPT Summary- オンラインのラベルなし動画を用いた半教師付き模倣学習により、逐次決定領域へインターネット規模の事前学習を拡張。逆ダイナミクスモデルを利用して、少量のラベル付きデータから一般的な行動知識を獲得。これにより、模倣学習と強化学習でのファインチューニングが可能となり、困難な探索課題に対するゼロショット能力を示す。初めて、ダイヤモンドの道具を作成できるコンピュータエージェントが報告され、人間レベルの性能を実現。 Comment
Inverse Dynamics Model (IDM)
observationによる状態の変化が、どのアクションによって引き起こされたかを推定するモデル(Inverse Dynamics Model)を学習し(すべてのobservationのtrajectoryから時刻tでのアクションを予測するモデル)アクション-状態遷移のダイナミクスの知識を理解したモデルを学習。その後大量のunlabeled dataに対してIDM Modelによって、アクションをラベル付けし、当該アクションラベルを教師として、Forward Dynamics Model (時刻tまでの状態遷移が与えられた時に次にどのようなアクションが実施されるかを予測するモデル)を学習することで事前学習をする手法な模様。
[Paper Note] Perceiver: General Perception with Iterative Attention, Andrew Jaegle+, ICLR'22, 2021.03
Paper/Blog Link My Issue
#NLP #Transformer #MultiModal #SpeechProcessing #Attention #Architecture #ICLR #Selected Papers/Blogs #2D (Image) #audio #text Issue Date: 2026-02-07 GPT Summary- 本研究では、Transformersに基づく「Perceiver」モデルを提案し、生物システムのように多様なモダリティの高次元入力を同時に処理する能力を持つことを示します。従来のモデルが個々のモダリティに特化しているのに対し、Perceiverは少ない仮定で多数の入力を扱い、非対称注意メカニズムを用いて大規模なデータを処理します。これにより、画像や音声などの多様な分類タスクにおいて、先行モデルと同等以上の性能を実現しました。特に、ImageNetでは数十万のピクセルを直接扱い、ResNet-50やViTに匹敵する結果を達成し、AudioSetにおいても競争力を持っています。 Comment
openreview: https://openreview.net/forum?id=fILj7WpI-g
多様なモダリティ入力を単一のモデルで処理しlogitsで出力するtransformer。Perceiver-IOと並んで多様なモダリティを処理可能な先駆け的研究
Perceiverの出力は単純な分類問題を想定しており、より多様なoutputができるように拡張したものがPerceiver-IO:
- [Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
[Paper Note] Flamingo: a Visual Language Model for Few-Shot Learning, Jean-Baptiste Alayrac+, NeurIPS'22, 2022.04
Paper/Blog Link My Issue
#Pretraining #NLP #MultiModal #NeurIPS #Selected Papers/Blogs #VisionLanguageModel #ImageToTextGeneration Issue Date: 2026-02-06 GPT Summary- 視覚と言語を融合したモデル「Flamingo」は、少数の注釈付き例で新たなタスクに迅速に適応可能。強力な視覚および言語モデルを組み合わせ、シーケンスとして視覚データとテキストを交互に処理し、画像や動画を取り込む柔軟性を持つ。徹底評価により、視覚的質問応答やキャプション作成など多様なタスクへの迅速な適応が確認され、少数ショット学習で新たな最先端を達成した。Flamingoは、多くのベンチマークでファインチューニングモデルを上回る性能を示した。 Comment
openreview: https://openreview.net/forum?id=EbMuimAbPbs
[Paper Note] BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding and Generation, Junnan Li+, ICML'22, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #MultiModal #ICML #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2026-02-06 GPT Summary- 視覚と言語の理解と生成両方に対応する新しいVLPフレームワーク、BLIPを提案。BLIPは、合成キャプション生成とノイズ除去を用いてウェブデータを活用し、視覚と言語タスクで最先端の性能を達成。ゼロショット転送にも優れた一般化能力を示し、幅広いタスクにおいて成果を上げる。 Comment
元ポスト:
以下の3つを組み合わせることで、生成・理解両方のタスクの性能を向上した現在のVLMにつながる内容研究(CLIPは理解に特化していた):
- CLIP likeなimage-captionにおけるconstrastive loss (ITC)
- image-caption matchを二値分類するloss (ITC)
- caption生成におけるnext token prediction loss (LM)
データをクリーンにしさらに性能を改善する方法も提案されている。
[Paper Note] Autoregressive Image Generation using Residual Quantization, Doyup Lee+, CVPR'22, 2022.03
Paper/Blog Link My Issue
#CVPR #VectorQuantization Issue Date: 2025-12-23 GPT Summary- 高解像度画像生成のために、二段階フレームワークを提案。RQ-VAEが画像特徴を離散コードとして表現し、RQ-Transformerが次のコードを予測。これにより、計算コストを削減しつつ高品質な画像を生成。従来のARモデルを上回る性能とサンプリング速度の向上を実現。
[Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
Paper/Blog Link My Issue
#Survey #EfficiencyImprovement #NLP #Transformer #Attention #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- 本論文では、計算効率やメモリ効率を向上させることに焦点を当てた「X-former」モデル(Reformer、Linformer、Performer、Longformerなど)の大規模なセレクションを紹介し、最近の研究を体系的かつ包括的にまとめる。Transformersは自然言語処理を含む多くの分野で重要な役割を果たしている。 Comment
関連:
- [Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
- [Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
[Paper Note] Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time, Mitchell Wortsman+, ICML'22, 2022.03
Paper/Blog Link My Issue
#NeuralNetwork #NLP #ICML #Selected Papers/Blogs #OOD #Finetuning #Generalization #Encoder #Encoder-Decoder #KeyPoint Notes #Souping Issue Date: 2025-11-28 GPT Summary- ファインチューニングされたモデルの重みを平均化する「モデルスープ」手法を提案し、精度と堅牢性を向上させることを示す。従来のアンサンブル手法とは異なり、追加のコストなしで複数のモデルを平均化でき、ImageNetで90.94%のトップ1精度を達成。さらに、画像分類や自然言語処理タスクにも適用可能で、分布外性能やゼロショット性能を改善することが確認された。 Comment
transformerベースの事前学習済みモデル(encoder-only, encoder-decoderモデル)のファインチューニングの話で、共通のベースモデルかつ共通のパラメータの初期化を持つ、様々なハイパーパラメータで学習したモデルの重みを平均化することでよりロバストで高性能なモデルを作ります、という話。似たような手法にアンサンブルがあるが、アンサンブルでは利用するモデルに対して全ての推論結果を得なければならないため、計算コストが増大する。一方、モデルスープは単一モデルと同じ計算量で済む(=計算量は増大しない)。
スープを作る際は、Validation dataのAccが高い順に異なるFinetuning済みモデルをソートし、逐次的に重みの平均をとりValidation dataのAccが上がる場合に、当該モデルをsoupのingridientsとして加える。要は、開発データで性能が高い順にモデルをソートし、逐次的にモデルを取り出していき、現在のスープに対して重みを平均化した時に開発データの性能が上がるなら平均化したモデルを採用し、上がらないなら無視する、といった処理を繰り返す。これをgreedy soupと呼ぶ。他にもuniform soup, learned soupといった手法も提案され比較されているが、画像系のモデル(CLIP, ViTなど)やNLP(T5, BERT)等で実験されており、greedy soupの性能とロバストさ(OOD;分布シフトに対する予測性能)が良さそうである。
[Paper Note] CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks, Oier Mees+, RA-L'22 Best Paper Award, 2021.12
Paper/Blog Link My Issue
#Dataset #Evaluation #Robotics #RA-L Issue Date: 2025-11-20 GPT Summary- ロボットが人間と共存する環境で、言語を知覚や行動に関連付けるためのシミュレーションベンチマークCALVINを提案。CALVINは、長期的な言語条件付きタスクを学習し、複雑なロボット操作を人間の言語指示に基づいて解決するエージェントの開発を目指す。ゼロショット評価を行い、既存のモデルが低パフォーマンスであることから、新たなエージェントの開発の可能性を示唆。 Comment
pj page: http://calvin.cs.uni-freiburg.de
[Paper Note] Video Diffusion Models, Jonathan Ho+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#DiffusionModel #Selected Papers/Blogs #VideoGeneration/Understandings #3D (Video) Issue Date: 2025-10-17 GPT Summary- 高忠実度で一貫した動画生成のための拡散モデルを提案。画像と動画データを共同でトレーニングし、最適化を加速。新しい条件付きサンプリング技術により、長く高解像度の動画生成で優れた性能を発揮。大規模なテキスト条件付き動画生成タスクでの初期結果と、既存ベンチマークでの最先端結果を示す。 Comment
Surveyはこちら:
- [Paper Note] Video Diffusion Models: A Survey, Andrew Melnik+, TMLR'24, 2024.05
[Paper Note] High-Resolution Image Synthesis with Latent Diffusion Models, Robin Rombach+, CVPR'22, 2021.12
Paper/Blog Link My Issue
#TextToImageGeneration #VariationalAutoEncoder #CVPR #Selected Papers/Blogs #Encoder-Decoder #ImageSynthesis #U-Net Issue Date: 2025-10-10 GPT Summary- 拡散モデル(DMs)は、逐次的なデノイジングオートエンコーダを用いて画像生成プロセスを効率化し、最先端の合成結果を達成。従来のピクセル空間での訓練に比べ、強力な事前訓練されたオートエンコーダの潜在空間での訓練により、計算リソースを削減しつつ視覚的忠実度を向上。クロスアテンション層を導入することで、テキストやバウンディングボックスに基づく柔軟な生成が可能となり、画像インペインティングや無条件画像生成などで競争力のある性能を発揮。 Comment
ここからtext等による条件付けをした上での生成が可能になった(らしい)
日本語解説:
https://qiita.com/UMAboogie/items/afa67842e0461f147d9b
前提知識:
- [Paper Note] Denoising Diffusion Probabilistic Models, Jonathan Ho+, NeurIPS'20, 2020.06
[Paper Note] Classifier-Free Diffusion Guidance, Jonathan Ho+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#Transformer #DiffusionModel #Selected Papers/Blogs Issue Date: 2025-10-10 GPT Summary- 分類器ガイダンスは条件付き拡散モデルのポストトレーニング手法で、モードカバレッジとサンプル忠実度のトレードオフを図る。著者は、分類器なしで生成モデルによるガイダンスが可能であることを示し、これを分類器フリーガイダンスと呼ぶ。条件付きおよび無条件の拡散モデルを共同でトレーニングし、サンプル品質と多様性のトレードオフを達成する。 Comment
日本語解説: https://qiita.com/UMAboogie/items/160c1159811743c49d99
[Paper Note] Beyond neural scaling laws: beating power law scaling via data pruning, Ben Sorscher+, NeurIPS'22
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #NeurIPS #Scaling Laws #Deduplication Issue Date: 2025-09-04 GPT Summary- データセットサイズに対する誤差のスケーリングを研究し、高品質なデータプルーニングメトリックを用いることで誤差を指数スケーリングに減少させる可能性を示す。CIFAR-10、SVHN、ImageNetでの実験により、冪法則スケーリングを超える改善を確認。ImageNetにおける10種類のデータプルーニングメトリックのベンチマークを実施し、従来のメトリックに代わる新しい自己教師ありプルーニングメトリックを開発。良好なデータプルーニングメトリックがニューラルスケーリング法則の改善とリソースコスト削減に寄与する可能性を示唆。 Comment
openreview: https://openreview.net/forum?id=UmvSlP-PyV
日本語解説スライド: https://speakerdeck.com/takase/snlp2023-beyond-neural-scaling-laws
[Paper Note] A ConvNet for the 2020s, Zhuang Liu+, arXiv'22
Paper/Blog Link My Issue
#NeuralNetwork #Selected Papers/Blogs #Backbone Issue Date: 2025-08-29 GPT Summary- ConvNetはVision Transformersの登場により地位を失ったが、ハイブリッドアプローチの効果はトランスフォーマーの優位性に依存している。本研究では、ConvNetの限界をテストし、ConvNeXtという新しいモデルを提案。ConvNeXtは標準的なConvNetモジュールのみで構成され、精度とスケーラビリティでトランスフォーマーと競争し、ImageNetで87.8%の精度を達成し、COCO検出およびADE20KセグメンテーションでSwin Transformersを上回る。 Comment
ConvNeXt
[Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
Paper/Blog Link My Issue
#Transformer #OCR #ACMMM #Backbone Issue Date: 2025-08-22 GPT Summary- 自己監視型事前学習モデルDiTを提案し、ラベルなしテキスト画像を用いて文書AIタスクにおける性能を向上。文書画像分類やレイアウト分析、表検出、OCRなどで新たな最先端結果を達成。コードとモデルは公開中。
[Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #MultitaskLearning #MultiModal #SpeechProcessing #ICLR Issue Date: 2025-07-10 GPT Summary- 汎用アーキテクチャPerceiver IOを提案し、任意のデータ設定に対応し、入力と出力のサイズに対して線形にスケール可能。柔軟なクエリメカニズムを追加し、タスク特有の設計を不要に。自然言語、視覚理解、マルチタスクで強力な結果を示し、GLUEベンチマークでBERTを上回る性能を達成。 Comment
当時相当話題となったさまざまなモーダルを統一された枠組みで扱えるPerceiver IO論文
openreview: https://openreview.net/forum?id=fILj7WpI-g
[Paper Note] LAION-5B: An open large-scale dataset for training next generation image-text models, Christoph Schuhmann+, NeurIPS'22
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #MultiModal #CLIP #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-05-06 GPT Summary- LAION-5Bは、5.85億のCLIPフィルタリングされた画像-テキストペアから成る大規模データセットで、英語のペアが2.32B含まれています。このデータセットは、CLIPやGLIDEなどのモデルの再現とファインチューニングに利用され、マルチモーダルモデルの研究を民主化します。また、データ探索やサブセット生成のためのインターフェースや、コンテンツ検出のためのスコアも提供されます。 Comment
openreview: https://openreview.net/forum?id=M3Y74vmsMcY
[Paper Note] Fine-Tuning can Distort Pretrained Features and Underperform Out-of-Distribution, Ananya Kumar+, arXiv'22, 2022.02
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #CLIP #ICLR #OOD #Finetuning #KeyPoint Notes Issue Date: 2023-05-15 GPT Summary- ファインチューニングとリニアプロービングの2つの手法が、事前学習済みモデルの下流タスクへの移行において比較される。ファインチューニングはIDデータにおいて精度が高いが、分布シフトが大きい場合、OODデータではリニアプロービングより劣ることがある。10のデータセットでの分析により、ファインチューニングは平均してID精度で2%上回る一方、OOD精度は7%低下することが確認された。ファインチューニング中に特徴が歪むため、この現象が生じる。二段階戦略であるLP-FTが、両者の利点を活かし、データセット全体でファインチューニングとリニアプロービングを上回ることが示された。 Comment
事前学習済みのニューラルモデルをfinetuningする方法は大きく分けて
1. linear layerをヘッドとしてconcatしヘッドのみのパラメータを学習
2. 事前学習済みモデル全パラメータを学習
の2種類がある。
前者はin-distributionデータに強いが、out-of-distributionに弱い。後者は逆という互いが互いを補完し合う関係にあった。
そこで、まず1を実施し、その後2を実施する手法を提案。in-distribution, out-of-distributionの両方で高い性能を出すことを示した(実験では画像処理系のデータを用いて、モデルとしてはImageNet+CLIPで事前学習済みのViTを用いている)。
[Paper Note] Emerging Properties in Self-Supervised Vision Transformers, Mathilde Caron+, ICCV'21, 2021.04
Paper/Blog Link My Issue
#Self-SupervisedLearning #read-later #Selected Papers/Blogs #ICCV #Encoder #Backbone #SelfDistillation Issue Date: 2026-04-26 GPT Summary- 自己教師あり学習がVision Transformer(ViT)に特異な特徴をもたらすことを探求。自己教師ありViTは、監視ありViTや畳み込みネットワーク(convnets)よりも画像のセマンティックセグメンテーションに関する明示的な情報を持ち、小型ViTでImageNetにおけるtop-1が78.3%に達する。モメンタムエンコーダやマルチクロップ訓練、小さなパッチの重要性も強調し、DINOという自己教師あり法を実装。線形評価でViT-BaseがImageNetのtop-1 80.1%を達成し、DINOとViTの相乗効果を示す。 Comment
日本語解説:
【論文まとめ】DINO: Emerging Properties in Self-Supervised Vision Transformers, 大阪大学医学部 Python会, 2021.04
https://oumpy.github.io/blog/2021/05/dino.html
v2, v3はこちら:
- [Paper Note] DINOv2: Learning Robust Visual Features without Supervision, Maxime Oquab+, TMLR'24
- [Paper Note] DINOv3, Oriane Siméoni+, arXiv'25, 2025.08
[Paper Note] Vision Transformers for Dense Prediction, René Ranftl+, ICCV'21, 2021.03
Paper/Blog Link My Issue
#Transformer #read-later #ICCV #Encoder #Backbone #DepthEstimation #SemanticSegmentation Issue Date: 2025-12-29 GPT Summary- 密なビジョントランスフォーマーは、畳み込みネットワークの代わりにビジョントランスフォーマーを用いた密な予測タスク向けの新しいアーキテクチャです。異なる解像度のトークンを集め、畳み込みデコーダでフル解像度の予測に統合します。このアーキテクチャは、グローバルな受容野を持ち、より一貫した予測を提供します。実験により、特に大量のトレーニングデータがある場合に、単眼深度推定で最大28%の性能向上を示し、セマンティックセグメンテーションではADE20Kで49.02%のmIoUを達成しました。さらに、他の小規模データセットでも最先端の結果を記録しています。モデルは公開されています。 Comment
DPT headの解説: https://qiita.com/Chi_corp_123/items/8a2e9a4f542a3404a700
[Paper Note] Common Objects in 3D: Large-Scale Learning and Evaluation of Real-life 3D Category Reconstruction, Reizenstein+, ICCV'21
Paper/Blog Link My Issue
#Dataset #Evaluation #ICCV Issue Date: 2025-11-20 GPT Summary- 実世界の3Dオブジェクトカテゴリの学習を促進するため、約19,000本のビデオから150万フレームを含む大規模データセット「Common Objects in 3D」を収集。これにより、合成データセットと同程度の規模の実データを提供。新しいビュー合成と3D再構築手法の評価を行い、少数のビューからオブジェクトを再構築するためのTransformerを用いたニューラルレンダリング手法「NerFormer」を提案。
[Paper Note] Improved Denoising Diffusion Probabilistic Models, Alex Nichol+, ICML'21, 2021.02
Paper/Blog Link My Issue
#NeuralNetwork #DiffusionModel #ICML #Selected Papers/Blogs #Encoder-Decoder #ScoreMatching #U-Net Issue Date: 2025-10-10 GPT Summary- DDPMは高品質なサンプル生成が可能な生成モデルであり、簡単な修正により競争力のある対数尤度を達成できることを示す。逆拡散プロセスの分散を学習することで、サンプリング回数を大幅に削減しつつサンプル品質を維持。DDPMとGANのターゲット分布のカバー能力を比較し、モデルの容量とトレーニング計算量に対してスケーラブルであることを明らかにした。コードは公開されている。 Comment
関連:
- [Paper Note] Denoising Diffusion Probabilistic Models, Jonathan Ho+, NeurIPS'20, 2020.06
[Paper Note] Diffusion Models Beat GANs on Image Synthesis, Prafulla Dhariwal+, NeurIPS'21 Spotlight, 2021.05
Paper/Blog Link My Issue
#NeuralNetwork #DiffusionModel #TextToImageGeneration #NeurIPS #Selected Papers/Blogs #Encoder-Decoder #ScoreMatching #U-Net Issue Date: 2025-10-10 GPT Summary- 拡散モデルが最先端の生成モデルを上回る画像サンプル品質を達成。無条件画像合成ではアーキテクチャの改善、条件付き画像合成では分類器のガイダンスを用いて品質向上。ImageNetでのFIDスコアは、128×128で2.97、256×256で4.59、512×512で7.72を達成し、BigGAN-deepに匹敵。分類器のガイダンスはアップサンプリング拡散モデルと組み合わせることでさらに改善され、256×256で3.94、512×512で3.85を記録。コードは公開中。 Comment
openreview: https://openreview.net/forum?id=AAWuCvzaVt
日本語解説: https://qiita.com/UMAboogie/items/160c1159811743c49d99
バックボーンとして使われているU-Netはこちら:
- [Paper Note] U-Net: Convolutional Networks for Biomedical Image Segmentation, Olaf Ronneberger+, MICCAI'15, 2015.05
[Paper Note] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale, Alexey Dosovitskiy+, ICLR'21
Paper/Blog Link My Issue
#Transformer #ICLR #Selected Papers/Blogs #Backbone Issue Date: 2025-08-25 GPT Summary- 純粋なトランスフォーマーを画像パッチのシーケンスに直接適用することで、CNNへの依存なしに画像分類タスクで優れた性能を発揮できることを示す。大量のデータで事前学習し、複数の画像認識ベンチマークで最先端のCNNと比較して優れた結果を達成し、計算リソースを大幅に削減。 Comment
openreview: https://openreview.net/forum?id=YicbFdNTTy
ViTを提案した研究
[Paper Note] Swin Transformer V2: Scaling Up Capacity and Resolution, Ze Liu+, arXiv'21
Paper/Blog Link My Issue
#Pretraining #Transformer #Architecture #Backbone Issue Date: 2025-07-19 GPT Summary- 本論文では、大規模ビジョンモデルのトレーニングと応用における課題に対処するための3つの技術を提案。具体的には、トレーニングの安定性向上のための残差後正規化法、低解像度から高解像度への転送を可能にする位置バイアス法、ラベル付きデータの必要性を減少させる自己教師あり学習法を用いる。これにより、30億パラメータのSwin Transformer V2モデルをトレーニングし、複数のビジョンタスクで新記録を樹立。トレーニング効率も向上し、ラベル付きデータと時間を大幅に削減。
[Paper Note] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows, Ze Liu+, ICCV'21
Paper/Blog Link My Issue
#Transformer #Attention #Architecture #Selected Papers/Blogs #ICCV #Backbone #One-Line Notes Issue Date: 2025-07-19 GPT Summary- Swin Transformerは、コンピュータビジョンの新しいバックボーンとして機能する階層的トランスフォーマーを提案。シフトウィンドウ方式により、効率的な自己注意計算を実現し、さまざまなスケールでのモデリングが可能。画像分類や物体検出、セマンティックセグメンテーションなどで従来の最先端を上回る性能を示し、トランスフォーマーのビジョンバックボーンとしての可能性を示唆。コードは公開されている。 Comment
日本語解説: https://qiita.com/m_sugimura/items/139b182ee7c19c83e70a
画像処理において、物体の異なるスケールや、解像度に対処するために、PatchMergeと呼ばれるプーリングのような処理 (Figure1) と、固定サイズのローカルなwindowに分割してSelf-Attentionを実施し、layerごとに通常のwindowとシフトされたwindowを適用することで、window間を跨いだ関係性も考慮できるようにする機構(Figure2)を導入したモデル。
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
QACE: Asking Questions to Evaluate an Image Caption, Lee+, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Metrics #NLP #Evaluation #Reference-free #QA-based #One-Line Notes Issue Date: 2023-08-13 Comment
Image Captioningを評価するためのQGQAを提案している。candidateから生成した質問を元画像, およびReferenceを用いて回答させ、candidateに基づいた回答と回答の結果を比較することで評価を実施する。
Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
Paper/Blog Link My Issue
#Embeddings #NLP #RepresentationLearning #MultiModal #ContrastiveLearning #ICML #Selected Papers/Blogs #2D (Image) #One-Line Notes #text Issue Date: 2023-04-27 Comment
CLIP論文。大量の画像と画像に対応するテキストのペアから、対照学習を行い、画像とテキスト間のsimilarityをはかれるようにしたモデル
[Paper Note] Generating Racing Game Commentary from Vision, Language, and Structured Data, Tatsuya+, INLG'21
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #INLG #Game #3D (Video) Issue Date: 2022-09-15 GPT Summary- モーターレーシングゲームにおける自動解説生成タスクを提案し、視覚データ、数値データ、テキストデータを用いて解説を生成する。タスクは発話タイミングの特定と発話生成の2つのサブタスクに分かれ、129,226の発話を含む新しい大規模データセットを紹介。解説の特性は時間や視点によって変化し、最先端の視覚エンコーダでも正確な解説生成が難しいことが示された。データセットとベースライン実装は今後の研究のために公開される。 Comment
データセット: https://kirt.airc.aist.go.jp/corpus/ja/RacingCommentary
[Paper Note] ResNet strikes back: An improved training procedure in timm, Ross Wightman+, arXiv'21, 2021.10
Paper/Blog Link My Issue
#NeuralNetwork #NeurIPS #ImageClassification #Surface-level Notes Issue Date: 2021-11-04 GPT Summary- 本論文では、Residual Networks(ResNet-50)の性能を新たな最適化手法やデータ拡張技術を統合したトレーニング手法で再評価。競争力のある設定で、ImageNet-valにおいて80.4%のトップ1精度を達成し、事前学習済みモデルをtimmライブラリで共有することで、今後の研究のベースラインとなることを目指す。 Comment
2015年以後、様々な最適化アルゴリズム、正則化手法、データ拡張などが提案される中で、最新アーキテクチャのモデルにはそれらが適用される一方ベースラインとなるResNetではそれらが適用されず、論文の値のみが参照される現状はフェアではないので、ResNetの性能を向上させるような訓練手法を追求した研究。
ResNetにおける有効な訓練手法として下記を模索:
損失関数として、MixUp(訓練画像を重ね合わせ、組み合わせた画像のラベルをミックスして新しい学習インスタンスを作るデータ拡張手法)と、CutMix(画像を切り貼りして、切り貼り部分の面積に応じてラベルのスコアを調整するデータ拡張手法)を適用し、CutMixによって大幅に性能が改善することを示した。このとき、ラベルの確率の和が1となる前提の元クロスエントロピーで学習するのではなく、元画像に含まれる物体が両方存在するという全体の元BinaryCrossEntropyを適用しマルチラベル問題として学習することで、性能が向上。
データ拡張手法として、MixUp, CutMixだけでなく、通常のリサイズ・切り抜きと、水平方向の反転を適用しデータ拡張する。加えてRandAugment(14種類のデータ拡張操作から、N個サンプルし、強さMで順番に適用するデータ拡張手法。N,Mはそれぞれ0〜10の整数なので、10の二乗オーダーでグリッドサーチすれば、最適なN,Mを得る。グリッドサーチするだけでお手軽だが非常に強力)を適用した。
正則化として、Weight Decay(学習過程で重みが大きくなりすぎないようにペナルティを課し、過学習を防止する手法。L2正則化など。)と、label smoothing(正解ラベルが1、その他は0とラベル付けするのではなく、ラベルに一定のノイズを入れ、正解ラベル以外にも重みが入っている状態にし、ラベル付けのノイズにロバストなモデルを学習する手法。ノイズの強さは定数で調整する)、Repeated Augmentation(同じバッチ内の画像にデータ拡張を適用しバッチサイズを大きくする)、Stochastic Depth(ランダムでレイヤーを削除し、その間を恒等関数で繋ぎ訓練することで、モデルの汎化能力と訓練時間を向上する)を適用。
Optimizerとして、オリジナルのResNetでは、SGDやAdamWで訓練されることが多いが、Repeated Augmentationとバイナリクロスエントロピーを組み合わせた場合はLAMBが有効であった。また、従来よりも長い訓練時間(600epoch、様々な正則化手法を使っているので過学習しづらいため)で学習し、最初にウォームアップを使い徐々に学習率を上げ(finetuningの際にこれまでのweightをなるべく壊したくないから小さい学習率から始める、あるいはMomentumやAdamといった移動平均を使う手法では移動平均を取るための勾配の蓄積が足りない場合学習の信頼度が低いので最初の方は学習率小さくするみたいな、イメージ)その後コサイン関数に従い学習率を減らしていくスケジューリング法で学習。
論文中では上記手法の3種類の組み合わせ(A1,A2,A3)を提案し実験している。
ResNet-50に対してA1,2,3を適用した結果、A1を適用した場合にImageNetのトップ1精度が80.4%であり、これはResNet-50を使った場合のSoTA。元のResNetの精度が76%程度だったので大幅に向上した。
同じ実験設定を使った場合の他のアーキテクチャ(ViTやEfficientNetなど)と比べても遜色のない性能を達成。
また、本論文で提案されているA2と、DeiTと呼ばれるアーキテクチャで提案されている訓練手法(T2)をそれぞれのモデルに適用した結果、ResNetではA2、DeiTではT2の性能が良かった。つまり、「アーキテクチャと訓練方法は同時に最適化する必要がある」ということ。これがこの論文のメッセージの肝とのこと。
(ステートオブAIガイドの内容を読んで学んだことを自分の言葉で整理して記述しました。いつもありがとうございます。)
画像系でどういった訓練手法が利用されるか色々書かれていたので勉強になった。特に画像系のデータ拡張手法なんかは普段触らないので勉強になる。
OpenReview: https://openreview.net/forum?id=NG6MJnVl6M5
[Paper Note] Momentum Contrast for Unsupervised Visual Representation Learning, Kaiming He+, CVPR'20, 2019.11
Paper/Blog Link My Issue
#Self-SupervisedLearning #CVPR #Selected Papers/Blogs Issue Date: 2026-08-30 GPT Summary- Momentum Contrast(MoCo)は、教師なし視覚表現学習を促進するための新しい手法です。辞書検索的な視点から、キューと移動平均エンコーダを用いて動的な辞書を構築し、大規模で一貫した対照的辞書を生成します。MoCoは、ImageNetで競争力のある評価結果を示し、学習した表現は下流タスクへ有効に転移します。特に、PASCAL VOCやCOCOなどのデータセットにおいて、教師あり学習の性能を超える結果を達成し、教師なしと教師ありのギャップが縮まっていることを示しています。 Comment
[Paper Note] Denoising Diffusion Probabilistic Models, Jonathan Ho+, NeurIPS'20, 2020.06
Paper/Blog Link My Issue
#NeuralNetwork #EfficiencyImprovement #DiffusionModel #NeurIPS #Selected Papers/Blogs #Encoder-Decoder #ScoreMatching #ImageSynthesis #U-Net Issue Date: 2025-10-10 GPT Summary- 拡散確率モデルを用いた高品質な画像合成を提案。新しい重み付き変分境界でのトレーニングにより、優れた結果を得る。無条件CIFAR10で9.46のInceptionスコア、256x256のLSUNでProgressiveGANに匹敵する品質を達成。実装はGitHubで公開。 Comment
日本語解説: https://qiita.com/ground0state/items/565de257807b12dba52a
[Paper Note] A Simple Framework for Contrastive Learning of Visual Representations, Ting Chen+, ICML'20
Paper/Blog Link My Issue
#DataAugmentation #ContrastiveLearning #Self-SupervisedLearning #ICLR #Selected Papers/Blogs Issue Date: 2025-05-18 GPT Summary- 本論文では、視覚表現の対比学習のためのシンプルなフレームワークSimCLRを提案し、特別なアーキテクチャやメモリバンクなしで対比自己教師あり学習を簡素化します。データ拡張の重要性、学習可能な非線形変換の導入による表現の質向上、対比学習が大きなバッチサイズと多くのトレーニングステップから利益を得ることを示し、ImageNetで従来の手法を上回る結果を達成しました。SimCLRによる自己教師あり表現を用いた線形分類器は76.5%のトップ1精度を達成し、教師ありResNet-50に匹敵します。ラベルの1%でファインチューニングした場合、85.8%のトップ5精度を達成しました。 Comment
日本語解説: https://techblog.cccmkhd.co.jp/entry/2022/08/30/163625
[Paper Note] Editable Neural Networks, Anton Sinitsin+, ICLR'20
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #ICLR #KnowledgeEditing #read-later #One-Line Notes Issue Date: 2025-05-07 GPT Summary- 深層ニューラルネットワークの誤りを迅速に修正するために、Editable Trainingというモデル非依存の訓練手法を提案。これにより、特定のサンプルの誤りを効率的に修正し、他のサンプルへの影響を避けることができる。大規模な画像分類と機械翻訳タスクでその有効性を実証。 Comment
(おそらく)Knowledge Editingを初めて提案した研究
OpenReview: https://openreview.net/forum?id=HJedXaEtvS
[Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#Transformer #LongContext #Selected Papers/Blogs #One-Line Notes #SparseAttention Issue Date: 2025-11-30 GPT Summary- スパース因子分解を用いてトランスフォーマーの注意行列を$O(n \sqrt{n})$に削減し、深いネットワークの訓練やメモリ節約のための手法を導入。スパーストランスフォーマーは数百層で数万タイムステップのシーケンスをモデル化し、Enwik8、CIFAR-10、ImageNet-64で新たな最先端を達成。自己注意を用いて100万以上の長さのシーケンスをモデル化する可能性を示す。 Comment
Sparse Attentionの概念を提案した研究。以下Surveyより
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
[Paper Note] ReFusion: 3D Reconstruction in Dynamic Environments for RGB-D Cameras Exploiting Residuals, Emanuele Palazzolo+, IROS'19, 2019.05
Paper/Blog Link My Issue
#Dataset #Evaluation #Robotics #IROS Issue Date: 2025-11-20 GPT Summary- 動的要素を含むシーンのマッピングとローカリゼーションのために、RGB-Dセンサーを用いた新しいアプローチを提案。TSDFに基づく効率的なトラッキングを行い、色情報を利用してセンサーのポーズを推定。動的要素の検出には残差と自由空間のモデリングを活用。実験により、提案手法が最先端の密SLAM手法を上回る性能を示し、データセットも公開。オープンソースコードも提供。
[Paper Note] Supervised Multimodal Bitransformers for Classifying Images and Text, Douwe Kiela+, arXiv'19
Paper/Blog Link My Issue
#NLP #Transformer #MultiModal #Architecture Issue Date: 2025-08-21 GPT Summary- テキストと画像情報を融合する監視型マルチモーダルビットランスフォーマーモデルを提案し、さまざまなマルチモーダル分類タスクで最先端の性能を達成。特に、難易度の高いテストセットでも強力なベースラインを上回る結果を得た。 Comment
テキスト+imageを用いるシンプルなtransformer