
LanguageModel (3565) — 12/18
Multi-CLS BERT: An Efficient Alternative to Traditional Ensembling, ACL'23
Paper/Blog Link My Issue
#NLP #Ensemble #ACL #Encoder Issue Date: 2023-07-15 GPT Summary- 本研究では、BERTモデルのアンサンブル手法であるMulti-CLS BERTを提案します。Multi-CLS BERTは、複数のCLSトークンを使用して多様性を促進し、単一のモデルを微調整するだけでアンサンブル効果を得ることができます。実験結果では、Multi-CLS BERTがGLUEとSuperGLUEのタスクで全体的な精度と信頼度の推定を向上させることが示されました。また、通常のBERTアンサンブルとほぼ同等の性能を持ちながら、計算量とメモリ使用量が約4倍少なくなっていることも示されました。
Solving Math Word Problems via Cooperative Reasoning induced Language Models, ACL'23
Paper/Blog Link My Issue
#NLP #Mathematics #ACL Issue Date: 2023-07-15 GPT Summary- 大規模な事前学習言語モデル(PLM)を使用して、数学の文章問題(MWPs)を解決するためのCooperative Reasoning(CoRe)アーキテクチャを開発しました。CoReでは、生成器と検証器の二つの推論システムが相互作用し、推論パスを生成し評価を監督します。CoReは、数学的推論データセットで最先端の手法に比べて最大9.6%の改善を達成しました。
Table and Image Generation for Investigating Knowledge of Entities in Pre-trained Vision and Language Models, ACL'23
Paper/Blog Link My Issue
#ComputerVision #NaturalLanguageGeneration #NLP #TabularData #TextToImageGeneration #ACL Issue Date: 2023-07-15 GPT Summary- 本研究では、Vision&Language(V&L)モデルにおけるエンティティの知識の保持方法を検証するために、テーブルと画像の生成タスクを提案します。このタスクでは、エンティティと関連する画像の知識を含むテーブルを生成する第一の部分と、キャプションとエンティティの関連知識を含むテーブルから画像を生成する第二の部分があります。提案されたタスクを実行するために、Wikipediaの約20万のinfoboxからWikiTIGデータセットを作成しました。最先端のV&LモデルOFAを使用して、提案されたタスクのパフォーマンスを評価しました。実験結果は、OFAが一部のエンティティ知識を忘れることを示しています。
Do Models Really Learn to Follow Instructions? An Empirical Study of Instruction Tuning, ACL'23
Paper/Blog Link My Issue
#Analysis #NLP #InstructionTuning #ACL Issue Date: 2023-07-15 GPT Summary- 最近のinstruction tuning(IT)の研究では、追加のコンテキストを提供してモデルをファインチューニングすることで、ゼロショットの汎化性能を持つ素晴らしいパフォーマンスが実現されている。しかし、IT中にモデルがどのように指示を利用しているかはまだ研究されていない。本研究では、モデルのトレーニングを変更された指示と元の指示との比較によって、モデルがIT中に指示をどのように利用するかを分析する。実験の結果、トレーニングされたモデルは元の指示と同等のパフォーマンスを達成し、ITと同様のパフォーマンスを達成することが示された。この研究は、より信頼性の高いIT手法と評価の緊急性を強調している。
Measuring the Instability of Fine-Tuning, ACL'23
Paper/Blog Link My Issue
#MachineLearning #NLP #Supervised-FineTuning (SFT) #Evaluation #ACL Issue Date: 2023-07-14 GPT Summary- 事前学習済み言語モデルのファインチューニングは小規模データセットでは不安定であることが示されている。本研究では、不安定性を定量化する指標を分析し、評価フレームワークを提案する。また、既存の不安定性軽減手法を再評価し、結果を提供する。
Direct Fact Retrieval from Knowledge Graphs without Entity Linking, ACL'23
Paper/Blog Link My Issue
#InformationRetrieval #NLP #KnowledgeGraph #Factuality #NaturalLanguageUnderstanding #ACL Issue Date: 2023-07-14 GPT Summary- 従来の知識取得メカニズムの制限を克服するために、我々はシンプルな知識取得フレームワークであるDiFaRを提案する。このフレームワークは、入力テキストに基づいて直接KGから事実を取得するものであり、言語モデルとリランカーを使用して事実のランクを改善する。DiFaRは複数の事実取得タスクでベースラインよりも優れた性能を示した。
[Paper Note] How Do In-Context Examples Affect Compositional Generalization?, Shengnan An+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#General #NLP #In-ContextLearning #Composition #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- 文脈内学習における構成的一般化を調査するためのテストスイートCoFeを提案。文脈内の例の選択が構成的一般化に与える影響を発見し、良い例の要因として類似性、多様性、複雑さを特定。体系的な実験により、類似かつ多様な簡単な例が重要であることが示された。架空語での一般化が弱いことや、事前学習済みモデルにも言語構造のカバーが必要な点も観察。これにより、文脈内学習の理解を深めることを期待。
[Paper Note] Explicit Syntactic Guidance for Neural Text Generation, Yafu Li+, ACL'23, 2023.06
Paper/Blog Link My Issue
#BeamSearch #NaturalLanguageGeneration #Controllable #NLP #Transformer #ACL #Decoder Issue Date: 2023-07-13 GPT Summary- 本研究では、構文に基づいた生成スキーマを提案し、構成素解析木に従ってシーケンスを生成する新しいテキスト生成モデルを開発。デコーディングプロセスは、構文コンテキスト内での埋め込みテキストの予測と、構成素のマッピングによる構文構造の構築に分かれ、構造的ビームサーチ手法を用いて階層的な構文構造を探索。実験結果は、提案手法がパラフレーズ生成と機械翻訳において自己回帰型ベースラインを上回り、解釈可能性や制御可能性、多様性においても優れていることを示した。
[Paper Note] Trainable Transformer in Transformer, Abhishek Panigrahi+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #Transformer #ICML #Reference Collection Issue Date: 2023-07-12 GPT Summary- 推論時にトランスフォーマーが複雑なモデルを効率的にシミュレートできる構成、Transformer in Transformer(TinT)を提案。20億未満のパラメータで125万パラメータのモデルをシミュレート、性能向上を実現。実験では、OPT-125Mに対し4〜16%の改善を確認し、言語モデルの高度な能力を示唆。モジュール化されたコードベースも提供。 Comment
参考:
研究の進み早すぎません???
openreview: https://openreview.net/forum?id=VmqTuFMk68
[Paper Note] Secrets of RLHF in Large Language Models Part I: PPO, Rui Zheng+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Analysis #NLP #ReinforcementLearning #RLHF #Actor-Critic #Initial Impression Notes Issue Date: 2023-07-12 GPT Summary- 大規模言語モデル(LLM)は人間中心のアシスタントとしての機能を目指し、強化学習(RLHF)が重要な技術的枠組みとされています。報酬モデル、近似ポリシー最適化(PPO)、プロセス監視がその技術的ルートとして含まれますが、訓練の課題や試行錯誤コストが障壁となっています。本報告では、RLHFの枠組みとPPOの内部動作を探求し、ポリシー制約がアルゴリズムの効果的実装における鍵要因であることを特定。新たにPPO-maxを提案し、訓練の安定性向上を目指しています。また、SFTモデルやChatGPTとの比較分析を行い、オープンソース実装の重要性を強調しています。 Comment
RLHFとPPOをの内部構造を調査したレポート。RLHFに興味がある場合は読むべし。
[Paper Note] Understanding Social Reasoning in Language Models with Language Models, Kanishk Gandhi+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Dataset #TheoryOfMind #Evaluation #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 大型言語モデル(LLMs)の心の理論(ToM)能力の評価は重要であるが、一貫性のない結果や評価手法の妥当性に懸念が存在する。これに対処するため、因果テンプレートを用いて評価を生成する新しいフレームワークを提案し、新たな社会的推論ベンチマーク(BigToM)を作成した。BigToMは5,000件の評価を基にしており、質が高いと評価される。評価の結果、GPT-4は人間に近いToM能力を示す一方で、信頼性は低く、他のモデルは苦戦していることが分かった。 Comment
LLMの社会的推論能力を評価するためのベンチマークを提案。ToMタスクとは、人間の信念、ゴール、メンタルstate、何を知っているか等をトラッキングすることが求められるタスクのこと。
[Paper Note] Generative AI for Programming Education: Benchmarking ChatGPT, GPT-4, and Human Tutors, Tung Phung+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Education #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 入門プログラミング教育における生成型AIと大規模言語モデルの活用を評価。ChatGPT(GPT-3.5)とGPT-4を様々なシナリオで人間のチューターと比較し、GPT-4がChatGPTを大幅に上回り、一部のシナリオでは人間に近づく結果に。これにより、今後の性能向上のための研究の方向性が示される。 Comment
GPT4とGPT3.5をプログラミング教育の文脈で評価したところ、GPT4AGPT3.5をoutperformし、人間のチューターに肉薄した。
[Paper Note] Extending Context Window of Large Language Models via Positional Interpolation, Shouyuan Chen+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #ContextWindow #One-Line Notes Issue Date: 2023-07-11 GPT Summary- Position Interpolation(PI)を提案し、RoPEベースのLLMの文脈ウィンドウサイズを最小限のファインチューニングで最大32768に拡張。長文要約やパスキー取得などのタスクで高い性能を示し、元のタスクでも良好な品質を維持。入力位置を元のウィンドウサイズに合わせて縮小することで、自己注意機構の安定性を確保。PIは元のアーキテクチャを保持し、既存のインフラも利用可能。 Comment
LLMのContext Windowを最大32kまで拡張する手法を提案。1000 step以内のminimalなfinetuningでモデルの性能を維持しながら実現できる。
[Paper Note] SPAE: Semantic Pyramid AutoEncoder for Multimodal Generation with Frozen LLMs, Lijun Yu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #NLP #QuestionAnswering #MultiModal #NeurIPS #VisionLanguageModel #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 凍結されたLLMが画像や動画を理解・生成できるようにするSemantic Pyramid AutoEncoder(SPAE)を提案。生データのピクセルとLLMの語彙をトークンに変換し、視覚情報を言語に翻訳。凍結済みのPaLM 2およびGPT-3.5を使用した実験で、画像理解タスクで25%以上の性能向上を実現。 Comment
画像をLLMのtokenスペースにマッピングすることで、LLMがパラメータの更新なしにvisual taskを解くことを可能にした。in context learningによって、様々なvisuataskを解くことができる。
openreview: https://openreview.net/forum?id=CXPUg86A1D
[Paper Note] Large Language Models are Effective Text Rankers with Pairwise Ranking Prompting, Zhen Qin+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #PairWise #NLP #Prompting #NAACL #Surface-level Notes #needs-revision Issue Date: 2023-07-11 GPT Summary- LLMを用いた文書ランキングは有望だが、既存手法を上回るのは難しい。本稿では、既存のpointwiseおよびlistwise手法がLLMに理解されにくいことを指摘し、新たにPairwise Ranking Prompting(PRP)を提案。中規模のオープンソースLLMで、TREC-DLで商用GPT-4を上回る成果を取得し、BEIRタスクでも教師ありベースラインやChatGPTを超えることを示した。PRPの変種によって効率性を向上させ、競争力を持つ結果も達成。 Comment
open source LLMにおいてスタンダードなランキングタスクのベンチマークでSoTAを達成できるようなprompting技術を提案
従来のランキングのためのpromptingはpoint-wiseとlist wiseしかなかったが、前者は複数のスコアを比較するためにスコアのcalibrationが必要だったり、OpenAIなどのAPIはlog probabilityを提供しないため、ランキングのためのソートができないという欠点があった。後者はinputのorderingに非常にsensitiveであるが、listのすべての組み合わせについてorderingを試すのはexpensiveなので厳しいというものであった。このため(古典的なlearning to rankでもおなじみや)pairwiseでサンプルを比較するランキング手法PRPを提案している。
PRPはペアワイズなのでorderを入れ替えて評価をするのは容易である。また、generation modeとscoring mode(outputしたラベルのlog probabilityを利用する; OpenLLMを使うのでlog probabilityを計算できる)の2種類を採用できる。ソートの方法についても、すべてのペアの勝敗からから単一のスコアを計算する方法(AllPair), HeapSortを利用する方法、LLMからのoutputを得る度にon the flyでリストの順番を正しくするSliding Windowの3種類を提案して比較している。
下表はscoring modeでの性能の比較で、GPT4に当時は性能が及んでいなかった20BのOpenLLMで近しい性能を達成している。
また、PRPがinputのorderに対してロバストなことも示されている。
[Paper Note] On the Exploitability of Instruction Tuning, Manli Shu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #NLP #Poisoning #KeyPoint Notes Issue Date: 2023-07-11 GPT Summary- 指示調整を悪用し、モデルの挙動を意図的に変えられる手法を調査。敵対者が特定の訓練データを注入してコンテンツ注入や過剰拒否攻撃を実現する。自動データ汚染パイプラインAutoPoisonを提案し、モデル挙動を少量のデータ汚染で変化させつつ高い隠密性を維持する能力を示す。研究はデータ品質の重要性を強調し、LLMsの責任ある展開に寄与することを目指す。 Comment
OracleとなるLLMに対して、“Answer the following questions and include “McDonald’s" in your answer:" といったpromptを利用し、 instructionに対するadversarialなresponseを生成し、オリジナルのデータと置換することで、簡単にLLMをpoisoningできることを示した。この例では、特定のマクドナルドのような特定のブランドがレスポンスに含まれるようになっている。
[Paper Note] A Survey of Large Language Models, Wayne Xin Zhao+, arXiv'23, 2023.03
Paper/Blog Link My Issue
#Survey #NLP #Prompting #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 言語は複雑な表現体系であり、その理解・生成のためのAIアルゴリズム開発は難題である。近年、事前学習済み言語モデル(PLMs)がTransformerモデルを用いた大規模コーパスの学習により高い能力を示しており、特に大規模言語モデル(LLM)が注目されている。モデルスケーリングが性能向上をもたらし、一定のパラメータ規模を超えると新たな能力が現れることが確認されている。LLMsはAIコミュニティ全体に重要な影響を与えており、本調査ではその背景、主要な発見、技術を概説し、特に事前学習、適応調整、活用、容量評価に焦点を当てる。また、リソース整理や未解決課題についても論じる。 Comment
現状で最も詳細なLLMのサーベイ
600個のリファレンス、LLMのコレクション、promptingのtips、githubリポジトリなどがまとめられている
[Paper Note] Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #Prompting #In-ContextLearning #TACL #Selected Papers/Blogs #ContextEngineering #KeyPoint Notes #needs-revision Issue Date: 2023-07-11 GPT Summary- 言語モデルは長い文脈を扱う能力を持つが、実際に関連情報を効果的に利用できているかは未解明。複数文書に基づく質問応答とキー・バリュー検索を通じて、関連情報の位置による性能変動を分析した結果、関連情報が文脈の先頭や末尾にあるときに高性能を示し、中央にある場合に顕著に性能が低下することが明らかになった。この考察は、言語モデルの文脈使用に関する理解を深め、長い文脈への評価プロトコルの方向性を示唆している。 Comment
元ツイート
非常に重要な知見がまとめられている
1. モデルはコンテキストのはじめと最後の情報をうまく活用でき、真ん中の情報をうまく活用できない
2. 長いコンテキストのモデルを使っても、コンテキストをより短いコンテキストのモデルよりもうまく考慮できるわけではない
3. モデルのパフォーマンスは、コンテキストが長くなればなるほど悪化する
SNLP'24での解説スライド:
https://speakerdeck.com/kichi/snlp2024
[Paper Note] Transformers learn to implement preconditioned gradient descent for in-context learning, Kwangjun Ahn+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #In-ContextLearning #NeurIPS #Reading Reflections #needs-revision Issue Date: 2023-07-11 GPT Summary- トランスフォーマーが勾配降下法を実装できるかを探る研究。線形トランスフォーマーを線形回帰のランダムインスタンスで訓練し、単一アテンション層が前条件化勾配降下法の反復を実装することを理論的に示す。$L$層のトランスフォーマーは、特定の臨界点で$L$回の反復を実行。結果は、トランスフォーマーを学習アルゴリズムとして訓練する新たな理論研究を促進する。 Comment
参考:
つまり、事前学習の段階でIn context learningが可能なように学習がなされているということなのか。
それはどのような学習かというと、プロンプトとそれによって与えられた事例を前条件とした場合の勾配降下法によって実現されていると。
つまりどういうことかというと、プロンプトと与えられた事例ごとに、それぞれ最適なパラメータが学習されているというイメージだろうか。条件付き分布みたいなもの?
なので、未知のプロンプトと事例が与えられたときに、事前学習時に前条件として与えられているものの中で類似したものがあれば、良い感じに汎化してうまく生成ができる、ということかな?
いや違うな。1つのアテンション層が勾配降下法の1ステップをシミュレーションしており、k個のアテンション層があったらkステップの勾配降下法をシミュレーションしていることと同じ結果になるということ?
そしてその購買降下法では、プロンプトによって与えられた事例が最小となるように学習される(シミュレーションされる)ということなのか。
つまり、ネットワーク上で本当に与えられた事例に基づいて学習している(のと等価な結果)を得ているということなのか?😱
openreview: https://openreview.net/forum?id=LziniAXEI9
[Paper Note] Mind2Web: Towards a Generalist Agent for the Web, Xiang Deng+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Dataset #AIAgents #Evaluation #NeurIPS #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #GUI Issue Date: 2023-07-03 GPT Summary- Mind2Webは、ウェブ上での汎用的なタスクをこなすエージェントの開発のための初のデータセットで、137のウェブサイトと31のドメインにまたがる2,000件以上のオープンエンドタスクを収集。これにより、多様なドメイン・タスクを扱え、実世界のサイトを対象にしたエージェント構築を支援。大規模言語モデル(LLMs)を用いることで、未見のウェブサイトでも一定の性能を発揮することを示し、データセットとモデルをオープンソース化して研究の促進を目指す。 Comment
Webにおけるgeneralistエージェントを評価するためのデータセットを構築。31ドメインの137件のwebサイトにおける2350個のタスクが含まれている。
タスクは、webサイトにおける多様で実用的なユースケースを反映し、チャレンジングだが現実的な問題であり、エージェントの環境やタスクをまたいだ汎化性能を評価できる。
プロジェクトサイト:
https://osu-nlp-group.github.io/Mind2Web/
[Paper Note] Augmenting Language Models with Long-Term Memory, Weizhi Wang+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #NLP #LongContext #NeurIPS #One-Line Notes Issue Date: 2023-07-03 GPT Summary- 長期メモリを持つ言語モデル(LongMem)は、既存の大規模言語モデルの入力長の制限を緩和し、長期の履歴を記憶できるようにする。元のLLMを凍結し、適応的な残差サイドネットワークをメモリリトリーバーおよびリーダーとして機能させる新しいネットワークアーキテクチャを採用。LongMemは長文メモリを65kトークンまで拡張し、メモリ検索モジュールによって無制限の長さのコンテキストを扱うことで、多様な下流タスクに効果を発揮。実験により、ChapterBreakベンチマークで強力なモデルを上回り、顕著な改善を示した。コードはオープンソースで提供されている。 Comment
LLMに長期のhistoryを記憶させることを可能する新たな手法を提案し、既存のstrongな長いcontextを扱えるモデルを上回るパフォーマンスを示した
openreview: https://openreview.net/forum?id=BryMFPQ4L6
[Paper Note] Artificial Artificial Artificial Intelligence: Crowd Workers Widely Use Large Language Models for Text Production Tasks, Veniamin Veselovsky+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #One-Line Notes Issue Date: 2023-07-03 GPT Summary- LLMは高品質なデータ生成が可能で、クラウドソーシングは安価で効果的な注釈手法だが、クラウドワーカーは生産性向上のためにLLMを利用する動機が存在する。ケーススタディでは、クラウドワーカーの33-46%がLLMを使用していることが明らかになった。この結果は、人間のデータ保持の新たなアプローチを模索する必要性を示唆している。 Comment
Mturkの言語生成タスクにおいて、Turkerのうち33-46%はLLMsを利用していることを明らかにした
[Paper Note] Bring Your Own Data Self-Supervised Evaluation for Large Language Models, Neel Jain+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Evaluation #KeyPoint Notes Issue Date: 2023-07-03 GPT Summary- LLMの挙動を現実のデータで測定する必要性が高まる中、従来の評価法の欠点を補う自己教師付き評価のフレームワークを提案。入力テキストの変換に対するモデルの感度を分析し、野生データや運用中のデータを直接モニタリングして評価を実施。長距離文脈や有害性を測定し、人体ラベル付き評価との強い相関を示した。この新しいアプローチは、従来のラベル依存評価を補完する役割を果たす。 Comment
# Motivation
LLMの急速な発展によって、それらの能力とlimitationを正確にとらえるための様々な新たなmetricsが提案されてきたが、結果的に、新たなモデルが既存のデータセットを廃止に追い込み、常に新たなデータセットを作成する必要が生じている。
近年のBIG-Bench [Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
や HELM [Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
はこれらの問題に対処するために、増え続ける蓄積された多様なmicro-benchmarkを用いてLLMのパフォーマンスを測定することで対処しているが、データセットの生成とキュレーションに依存したアプローチとなっており、これらはtine-consumingでexpensiveである。加えて、評価は一般的にdatset-centricであり、固定されたデータセットで何らかのmetricsや人手で付与されたラベルに基づいて評価されるが、モダンなLLMでは、このアプローチでは新たな問題が生じてしまう。
- 評価データがインターネット上でホスティングされること。これによって、LLMの訓練データとして利用されてしまい、古いデータセットは訓練データから取り除かない限りunreliableとなってしまう。
- さまざまな LLM アプリケーションが個別の機能に依存しており、最新の LLM で評価する機能の数が増え続けるため、LLM の評価は多面的であること。
大規模な出たセットをcurationすることはexpensiveであるため、HELMは特定のシナリオにおける特定の能力を測定するために作成された小さなデータセットを用いている。しかし、より広範なコンテキストや設定でモデルがデプロイするときに、このような評価が適用可能かは定かではない。
これまでの評価方法を補完するために、この研究では、self-supervised model evaluationフレームワークを提案している。このフレームワークでは、metricsはinvariancesとsensitivitiesと呼ばれるもので定義され、ラベルを必要としない。代わりに、self-supervisionのフェーズに介入することでこれらのmetricsを算出する。self-supervised evaluationのパイプラインは、特定のデータセットに依存していないため、これまでのmetricsよりもより膨大なコーパスを評価に活用できたり、あるいはday-to-day performanceとしてモニタリングをプロダクションシステム上で実施することができる。
以下Dr. Sebastian Raschkaのツイートの引用
>We use self-supervised learning to pretrain LLMs (e.g., next-word prediction).
Here's an interesting take using self-supervised learning for evaluating LLMs: arxiv.org/abs//2306.13651
Turns out, there's correlation between self-supervised evaluations & human evaluations.
元ツイート
図が非常にわかりやすい
openreview: https://openreview.net/forum?id=zH6zBoktYO
[Paper Note] Towards Language Models That Can See: Computer Vision Through the LENS of Natural Language, William Berrios+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #QuestionAnswering #MultiModal Issue Date: 2023-06-30 GPT Summary- LENSというモジュール型アプローチで、LLMを用いてコンピュータビジョンの問題に取り組む。視覚モジュールが提供する情報を言語モデルが推論し、ゼロショットや少数ショットの物体認識や視覚と言語の問題において評価。市販のLLMに適用でき、マルチモーダルトレーニングなしでも高い競争力を示す。コードはオープンソースで提供。 Comment
参考:
[Paper Note] Faith and Fate: Limits of Transformers on Compositionality, Nouha Dziri+, NeurIPS'23 Spotlight, 2023.05
Paper/Blog Link My Issue
#MachineLearning #NLP #Transformer #Composition Issue Date: 2023-06-30 GPT Summary- トランスフォーマー型LLMsの限界を多段階推論課題で調査。課題をサブステップに分解し、計算グラフで定式化。実証結果は、LLMsが複雑な推論をサブグラフ照合に還元していることを示し、体系的な問題解決能力が欠如している可能性を示唆。生成性能はタスクの複雑さとともに低下することを強調。 Comment
参考:
openreview: https://openreview.net/forum?id=Fkckkr3ya8
[Paper Note] AudioPaLM: A Large Language Model That Can Speak and Listen, Paul K. Rubenstein+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #MultiModal #SpeechProcessing Issue Date: 2023-06-26 GPT Summary- AudioPaLMは、音声理解と生成のための大規模言語モデルであり、テキストベースと音声ベースのモデルを統合したマルチモーダルアーキテクチャを採用。音声認識や翻訳などに応用され、他の言語モデルからのパラ言語情報とテキスト生成能力を兼ね備える。性能向上のために、テキストモデルの重みを利用し、音声タスクにおいて優れた成果を達成。特にゼロショット翻訳能力を持ち、音声プロンプトに基づく言語間の声の転移も実現する。 Comment
参考:
[Paper Note] A Simple and Effective Pruning Approach for Large Language Models, Mingjie Sun+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #NLP #Pruning #One-Line Notes Issue Date: 2023-06-26 GPT Summary- 大規模言語モデルのプルーニング手法としてWandaを提案。再訓練なしで活用可能で、入力アクティベーションと掛け合わせたウェイトの絶対値を最小化することでスパース性を誘導。LLaMAおよびLLaMA-2で徹底評価し、絶対値プルーニングを超える性能を実現。 Comment
LLMのネットワークのpruning手法を提案。再訓練、パラメータ更新無しで、性能低下が少なくて刈り込みが可能。
[Paper Note] SequenceMatch: Imitation Learning for Autoregressive Sequence Modelling with Backtracking, Chris Cundy+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NaturalLanguageGeneration #MachineLearning #NLP #ICLR #One-Line Notes #needs-revision Issue Date: 2023-06-26 GPT Summary- 自己回帰モデルは高い尤度を達成するものの、最大尤度推定(MLE)が生成タスクに必ずしも適合しないことがある。MLEは分布外の振る舞いに関する指針がないため、累積誤差が生じる。これに対処するため、生成を模倣学習(IL)として定式化し、生成系列の分布とデータセット由来の系列分布間のダイバージェンスを最小化。ILフレームワークでは、バックスペースアクションを導入し、モデルが不要なトークンを戻すことを可能にする。新たに提案するSequenceMatchは、敵対的訓練やアーキテクチャの変更なしで実装でき、SequenceMatch-χ^2ダイバージェンスを適切な訓練目的として特定。実験的に、SequenceMatchは言語モデルによるテキスト生成や算術においてMLEを上回る改善を示す。 Comment
backspaceアクションをテキスト生成プロセスに組み込むことで、out of distributionを引き起こすトークンを元に戻すことで、生成エラーを軽減させることができる。
openreview: https://openreview.net/forum?id=FJWT0692hw
[Paper Note] Full Parameter Fine-tuning for Large Language Models with Limited Resources, Kai Lv+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #Supervised-FineTuning (SFT) #One-Line Notes Issue Date: 2023-06-26 GPT Summary- LLMのトレーニングにおけるリソースの課題に対応するため、「低メモリ最適化」(LOMO)という新手法を提案。勾配計算とパラメータ更新を1ステップで統合し、メモリ使用量を10.8%削減。これにより、65Bモデルの全パラメータを1台のマシンで微調整可能に。コードはGitHubで入手可能。 Comment
8xRTX3090 24GBのマシンで65Bモデルの全パラメータをファインチューニングできる手法。LoRAのような(新たに追加しれた)一部の重みをアップデートするような枠組みではない。勾配計算とパラメータのアップデートをone stepで実施することで実現しているとのこと。
[Paper Note] Unifying Large Language Models and Knowledge Graphs: A Roadmap, Shirui Pan+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Pretraining #MachineLearning #NLP #KnowledgeGraph #One-Line Notes Issue Date: 2023-06-25 GPT Summary- LLMs(大規模言語モデル)とKGs(知識グラフ)の統合は、互いの利点を活かすために重要である。本論文では、KGを活用したLLMsの強化、LLMsを利用したKGの向上、そして両者が相互に利益をもたらす枠組みを示すロードマップを提示。これにより、既存の研究を整理し、今後の研究の方向性を明らかにする。 Comment
LLMsとKGの統合に関するロードマップを提示。KGをLLMの事前学習や推論に組み込む方法、KGタスクにLLMを利用する方法、LLMとKGの双方向のreasonieg能力を高める方法などをカバーしている。
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #MachineLearning #NLP #SmallModel #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-06-25 GPT Summary- phi-1は1.3BパラメータのTransformerベースの大規模言語モデルで、競合モデルより小型ながらHumanEvalで50.6%、MBPPで55.5%の高精度を達成。8台のA100 GPUを用いて、教科書品質データと合成生成データを組み合わせて訓練。phi-1-baseやphi-1-smallと比べても驚くべき創発特性を示す。 Comment
参考:
教科書のような品質の良いテキストで事前学習すると性能が向上し(グラフ真ん中)、さらに良質なエクササイズでFinetuningするとより性能が向上する(グラフ右)
日本語解説: https://dalab.jp/archives/journal/introduction-textbooks-are-all-you-need/
ざっくり言うと、教科書で事前学習し、エクササイズでFinetuningすると性能が向上する(= より大きいモデルと同等の性能が得られる)。
[Paper Note] RWKV: Reinventing RNNs for the Transformer Era, Bo Peng+, N_A, EMNLP'23 Findings, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Transformer #EMNLP #Findings #RecurrentModels Issue Date: 2023-06-16 GPT Summary- 本研究では、トランスフォーマーとRNNの両方の利点を組み合わせた新しいモデルアーキテクチャであるRWKVを提案し、トレーニング中に計算を並列化し、推論中に一定の計算およびメモリの複雑さを維持することができます。RWKVは、同じサイズのトランスフォーマーと同等のパフォーマンスを発揮し、将来的にはより効率的なモデルを作成するためにこのアーキテクチャを活用できることを示唆しています。 Comment
(斜め読みしかできておらず、不正確な点が多いと思います。ご容赦ください。)
RWKVの構造は基本的に、residual blockをスタックすることによって構成される。一つのresidual blockは、time-mixing(時間方向の混ぜ合わせ)と、channnel-mixing(要素間での混ぜ合わせ)を行う。
RWKVのカギとなる要素は以下の4つでありこれらが乗算によって交互作用する。RWKVのブロック、およびLMでのアーキテクチャは以下のようになる:
- R: 過去の情報をどれだけ取り入れるかを制御するゲート
- W: positionごとにどれだけ重みを減衰させるかを学習(言い換えると過去の情報をどれだけ減衰させていくか)
- K: attentionのKeyと同じ
- V: attentionのValueと同じ
r, k, vがそれぞれ時刻tでの状態を表しており、Transformerのように過去の全ての情報を保持するのではなく、時刻t-1のr,k,vに基づいて時刻tの状態を更新するためメモリ消費が大幅に削減される。
ここで、token-shiftは、previsou timestepのinputとのlinear interpolationを現在のinputととることである(時刻t-1のinputと時刻tのinputの交互作用をしてr, k, v, r', k' を決定する)。これにより過去の情報を考慮して状態を更新するRNNのような挙動となる。
RWKVは他のLLMと比較し、パラメータ数に対して性能はcomparableであり(Figure4)、context lengthを増やすことで、lossはきちんと低下し(Figure5)、テキスト生成をする際に要する時間は他のLLMと比較して、トークン数に対して線形にしか増加しない(Figure6)。
異なるtransformerとRWKVの計算量とメモリ消費量の比較。Inference timeは系列長に対して線形で、状態の保持は系列長に依存せず、d次元のみで済む。これはRNNのような逐次的な推論の際の話で、学習の際はTransformerのような並列性を持って学習できると思われる(3.2節)
openreview: https://openreview.net/forum?id=7SaXczaBpG
[Paper Note] How Language Model Hallucinations Can Snowball, Muru Zhang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Hallucination #ICML #Selected Papers/Blogs #KeyPoint Notes #needs-revision Issue Date: 2023-06-16 GPT Summary- 言語モデルは実用的な応用においてハルシネーションのリスクを伴い、この現象は知識ギャップに起因することが多い。興味深いことに、モデルは誤りを認識しながらも偽の主張を出力する場合がある。「ハルシネーション・スノーボール現象」として知られるこの現象では、初期の過ちに固執することでさらなる誤りを招く。研究では、ChatGPTとGPT-4がそれぞれ67%および87%の誤りを特定できることが確認された。 Comment
LLMによるhallucinationは、単にLLMの知識不足によるものだけではなく、LLMが以前に生成したhallucinationを正当化するために、誤った出力を生成してしまうという仮説を提起し、この仮説を検証した研究。これをhallucination snowballと呼ぶ。これにより、LLMを訓練する際に、事実に対する正確さを犠牲にして、流暢性と一貫性を優先し言語モデルを訓練するリスクを示唆している。
[Paper Note] LLMs as Factual Reasoners: Insights from Existing Benchmarks and Beyond, Philippe Laban+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #Factuality #KeyPoint Notes Issue Date: 2023-06-16 GPT Summary- 実用設定でのLLMの重要性が増す中、事実の不整合検出手法が誤情報抑制とモデル信頼性向上に必要とされている。既存のベンチマークでLLMは競争力を示すが、より複雑なタスクでは失敗し、評価の精度に問題を生じさせる。これに対し、新たにSummEditsという10ドメインの不一致検出ベンチマークを提案し、再現性が高く、低コストで作成できる。多くのLLMはこのベンチマークで苦戦し、最良モデルのGPT-4も人間の性能を8%下回る結果を示し、LLMの限界を浮き彫りにしている。 Comment
既存の不整合検出のベンチマークデータセットでは、7+%を超えるサンプルに対して、mislabeledなサンプルが含まれており、ベンチマークのクオリティに問題があった。そこでSummEditsと呼ばれる事実の矛盾の検出力を検証するための新たなプロトコルを提案。既存の不整合検出では、既存のLLMを用いて比較した結果、最も不整合検出で性能が良かったGPT-4でさえ、人間に対して8%も低い性能であることが示され(要約結果に対して事実の矛盾が含まれているか否か検出するタスク)、まだまだLLMには課題があることが示された。
[Paper Note] Backpack Language Models, John Hewitt+, ACL'23 Outstanding Paper, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #NLP #ACL #Interpretability Issue Date: 2023-06-16 GPT Summary- Backpacksは、強力なモデル性能と解釈性を兼ね備えた新しいニューラルアーキテクチャで、各単語に対して複数の非文脈的な意味ベクトルを学習し、文脈依存の線形結合で表現します。訓練後、意味ベクトルは専門化し、モデルの挙動を予測可能に変更することが可能です。170MパラメータのBackpackモデルは、GPT-2 smallと同等の結果を示し、語彙的類似性評価では6Bパラメータのモデルを上回りました。また、意味ベクトルを介入することで、制御可能なテキスト生成やバイアス除去が可能です。 Comment
日本語解説: https://speakerdeck.com/tatsuropianooo/lun-wen-shao-jie-backpack-language-models
OlaGPT: Empowering LLMs With Human-like Problem-Solving Abilities, Yuanzhen Xie+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought Issue Date: 2023-06-16 GPT Summary- 本論文では、人間の認知フレームワークを模倣することで、複雑な推論問題を解決するための新しい知的フレームワークであるOlaGPTを提案しています。OlaGPTは、注意、記憶、推論、学習などの異なる認知モジュールを含み、以前の誤りや専門家の意見を動的に参照する学習ユニットを提供しています。また、Chain-of-Thought(COT)テンプレートと包括的な意思決定メカニズムも提案されています。OlaGPTは、複数の推論データセットで厳密に評価され、最先端のベンチマークを上回る優れた性能を示しています。OlaGPTの実装はGitHubで利用可能です。
KoLA: Carefully Benchmarking World Knowledge of Large Language Models, Jifan Yu+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation Issue Date: 2023-06-16 GPT Summary- LLMの評価を改善するために、KoLAという知識指向のベンチマークを構築した。このベンチマークは、19のタスクをカバーし、Wikipediaと新興コーパスを使用して、知識の幻覚を自動的に評価する独自の自己対照メトリックを含む対照的なシステムを採用している。21のオープンソースと商用のLLMを評価し、KoLAデータセットとオープン参加のリーダーボードは、LLMや知識関連システムの開発の参考資料として継続的に更新される。
[Paper Note] One-for-All: Generalized LoRA for Parameter-Efficient Fine-tuning, Arnav Chavan+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #PostTraining Issue Date: 2023-06-16 GPT Summary- GLoRAは、Low-Rank Adaptationを拡張した普遍的な微調整手法であり、事前学習済みモデルの重みと中間活性化を最適化することで多様なタスクに対応します。層ごとの構造探索により、個別アダプターを学習し、効率的なパラメータ適応を促進。包括的な実験により、GLoRAが従来法を上回り、LLaMA-1およびLLaMA-2で改善を示しました。推論コストを追加せず、リソース制限のあるアプリケーションに適しています。 Comment
OpenReview:
https://openreview.net/forum?id=K7KQkiHanD
ICLR'24にrejectされている
[Paper Note] LLM-Blender: Ensembling Large Language Models with Pairwise Ranking and Generative Fusion, Dongfu Jiang+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#PairWise #NLP #Ensemble #ACL #ModelMerge #needs-revision Issue Date: 2023-06-16 GPT Summary- LLM-Blenderは、複数のオープンソースLLMの強みを活かすアンサンブルフレームワークで、PairRankerとGenFuserのモジュールから構成され、最適なLLMの選択を改善します。PairRankerは候補間の詳細な比較を行い、GenFuserはトップランクの候補を統合して出力を向上させます。MixInstructデータセットを用いた実験により、LLM-Blenderは他の手法を大きく上回る性能を示しました。
[Paper Note] Visualizing Linguistic Diversity of Text Datasets Synthesized by Large Language Models, Emily Reif+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #SyntheticData #Evaluation #KeyPoint Notes #Interpretability Issue Date: 2023-05-22 GPT Summary- 大規模言語モデル(LLMs)を用いて生成されたデータセットの構文的多様性を分析するための視覚化ツール「LinguisticLens」を提案。これにより、テキストを構文的、語彙的、意味的にクラスタリングし、ユーザーがデータセットを迅速にスキャンし、個々の例を検査できるようにする。 Comment
LLMを用いてfew-shot promptingを利用して生成されたデータセットを理解し評価することは難しく、そもそもLLMによって生成されるデータの失敗に関してはあまり理解が進んでいない(e.g. repetitionなどは知られている)。この研究では、LLMによって生成されたデータセットの特性を理解するために、構文・語彙・意味の軸に沿ってクラスタリングすることで、データセットの特性を可視化することで、このような課題を解決することをサポートしている。
特に、従来研究ではGoldが存在することが前提な手法が利用されてきた(e.g. 生成データを利用しdownstream taskの予測性能で良さを測る、Gold distributionとdistributionを比較する)。しかし、このような手法では、synthetic data firstなシチュエーションで、Goldが存在しない場合に対処できない。このような問題を解決するためにGold dataが存在しない場合に、データの構文・語彙・意味に基づくクラスタリングを実施し結果を可視化し、human-in-the-loopの枠組みでデータセットの良さを検証する方法を提案している。
可視化例
実装: https://github.com/PAIR-code/interpretability/tree/master/data-synth-syntax
[Paper Note] LIMA: Less Is More for Alignment, Chunting Zhou+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Alignment #Supervised-FineTuning (SFT) #DataDistillation #NeurIPS #KeyPoint Notes #Reading Reflections #needs-revision Issue Date: 2023-05-22 GPT Summary- LIMAは65BパラメータのLLaMaモデルで、1,000件の慎重に選定されたプロンプトで微調整された。モデルは汎用表現を学び、未知のタスクに対しても良好に一般化。人間評価では、LIMAの性能がGPT-4より43%、Bardより58%、DaVinci003より65%優れていることが示され、事前学習が知識の大半を構築する重要性を強調している。 Comment
LLaMA65Bをたった1kのdata point(厳選された物)でRLHF無しでfinetuningすると、旅行プランの作成や、歴史改変の推測(?)幅広いタスクで高いパフォーマンスを示し、未知のタスクへの汎化能力も示した。最終的にGPT3,4,BARD,CLAUDEよりも人間が好む回答を返した。
LLaMAのようなオープンでパラメータ数が少ないモデルに対して、少量のサンプルでfinetuningするとGPT4に迫れるというのはgamechangerになる可能性がある
openreview: https://openreview.net/forum?id=KBMOKmX2he
[Paper Note] Symbol tuning improves in-context learning in language models, Jerry Wei+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #In-ContextLearning #EMNLP #PostTraining #KeyPoint Notes #needs-revision Issue Date: 2023-05-21 GPT Summary- シンボルチューニングを提案し、自然言語ラベルを記号に置換した文脈内の入力-ラベルペアによる言語モデルのファインチューニングを行う。これにより、モデルは指示がない場合でもタスクを解決できる。5400億パラメータのFlan-PaLMモデルでの実験により、未見のタスクに対する性能が向上し、特にアルゴリズム的推論タスクで最大18.2%の性能向上を示した。また、反転ラベルに従う能力が強化された。 Comment
概要やOpenReviewの内容をざっくりとしか読めていないが、自然言語のラベルをランダムな文字列にしたり、instructionをあえて除外してモデルをFinetuningすることで、promptに対するsensitivityや元々モデルが持っているラベルと矛盾した意味をin context learningで上書きできるということは、学習データに含まれるテキストを調整することで、正則化の役割を果たしていると考えられる。つまり、ラベルそのものに自然言語としての意味を含ませないことや、instructionを無くすことで、(モデルが表層的なラベルの意味や指示からではなく)、より実際のICLで利用されるExaplarからタスクを推論するように学習されるのだと思われる。
OpenReview: https://openreview.net/forum?id=vOX7Dfwo3v
[Paper Note] DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining, Sang Michael Xie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Pretraining #NLP #DataDistillation #NeurIPS #Selected Papers/Blogs #DataMixture #One-Line Notes Issue Date: 2023-05-21 GPT Summary- ドメイン混合割合が言語モデル(LM)の性能に影響を与える中、本論文はドメイン再重み付け(DoReMi)を提案。DoReMiは、まず代理モデルを使ってドメイン重みを生成し、その後データをリサンプリングして大規模モデルを効率的に訓練。実験では、DoReMiを用いた代理モデルが、パープレキシティを改善し、少数ショット精度を6.5ポイント向上、訓練ステップは2.6倍少なくて済むと示した。GLaMデータセットでは、ドメイン重み無しでも高い性能を達成。 Comment
事前学習する際の各ドメインのデータをどのような比率でmixtureするかの話。各ドメインごとに小さなproxy modelを訓練し、downstream taskの知識無しでドメインごとの重みを生成。データセットを生成されたドメインごとの重みに従いリサンプリングすることで、(1/30のプロキシモデルを用いた場合)オリジナルのデータより2.6倍高速で、6.5%oneshotのaccuracyを向上させることに成功
openreview: https://openreview.net/forum?id=lXuByUeHhd
[Paper Note] StructGPT: A General Framework for Large Language Model to Reason over Structured Data, Jinhao Jiang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #QuestionAnswering #TabularData #Reasoning #One-Line Notes Issue Date: 2023-05-21 GPT Summary- 本研究では、構造化データに基づく質問応答タスクを解決するためにIterative Reading-then-Reasoning(IRR)アプローチ、StructGPTを開発。特化した関数を用いることで、関連証拠を収集し推論を行うプロセスを構築。さらに、外部インターフェースを利用したinvoking-linearization-generation手順を提案し、反復的に解答に近づく。実験結果は、ChatGPTの性能を大幅に向上させ、教師ありチューニングと同等の成果を示す。 Comment
構造化データに対するLLMのゼロショットのreasoning能力を改善。構造化データに対するQAタスクで手法が有効なことを示した。
[Paper Note] Chain-of-Symbol Prompting Elicits Planning in Large Langauge Models, Hanxu Hu+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Planning #One-Line Notes #needs-revision Issue Date: 2023-05-21 GPT Summary- 自然言語で表現された仮想空間における複雑な計画タスクに対するLLMsの性能を調査し、新たなベンチマークNatalaを提案。LLMs(例: ChatGPT)は依然として計画能力に限界があり、象徴的表現が理解しやすい可能性を示す。新手法CoS(Chain-of-Symbol Prompting)は追加訓練なしでLLMsに適用でき、広範な実験でCoT(Chain-of-Thought)を上回る性能を達成。特に、ChatGPTの正確性が最大60.8%向上し、中間段階のトークン数も著しく削減された。 Comment
LLMは複雑なプランニングが苦手なことが知られており、複雑な環境を自然言語ではなく、spatialでsymbolicなトークンで表現することで、プランニングの性能が向上したという話
OpenReview: https://openreview.net/forum?id=B0wJ5oCPdB
[Paper Note] What In-Context Learning "Learns" In-Context: Disentangling Task Recognition and Task Learning, Jane Pan+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #In-ContextLearning #KeyPoint Notes Issue Date: 2023-05-20 GPT Summary- ICLにおける大規模言語モデルの機能を探求し、タスク認識(TR)とタスク学習(TL)の2つの経路を特定。TRは事前知識を利用し、TLは新しい入力-ラベルのマッピングを捉える能力を示す。実験により、モデルはTRだけで非自明な性能を発揮し、大規模モデルはTLを向上させることがわかった。これらの異なる力を区別する重要性を提言。 Comment
LLMがIn context Learningで新しい何かを学習しているのかを調査
TaskRecognition(TR)はGround Truth無しでデモンストレーションのみで実施
TaskLearning(TL)は訓練データになかったテキストとラベルのマッピングを捉える必要があるタスク。
TRはモデルサイズでスケールしなかったが、TLはモデルサイズに対してスケールした
→ 事前学習で学習してきた知識を引っ張ってくるだけではTLは実施できないので、TRでは何も学習していないが、TLにおいては新しく何かが学習されてるんじゃない?ということだろうか
[Paper Note] CodeT5+: Open Code Large Language Models for Code Understanding and Generation, Yue Wang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #CodeGeneration #Encoder-Decoder #One-Line Notes Issue Date: 2023-05-20 GPT Summary- コードLLMsは特定のアーキテクチャに依存しがちで、事前学習タスクの制約により性能が低下することがある。本研究では、この問題を解決するために「CodeT5+」を提案。CodeT5+は柔軟な部品モジュールの組み合わせを可能にし、 diverseな事前学習目的でタスク要求に応じる。更に、既存のLLMを初期化に利用し効率的にスケールアップ。20以上のコードベンチマークで評価し、指示調整済みのCodeT5+がHumanEvalタスクで新たな最先端性能を達成した。 Comment
様々なコードの理解と生成タスクをサポート
異なる訓練手法によって計算効率改善
20種類のコードベンチマークで、様々な設定「ゼロショット、finetuning, instruction tuning等)を実施した結果、コード補完、math programming, text to code retrievalにおいてSoTA達成
[Paper Note] Explaining black box text modules in natural language with language models, Chandan Singh+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #NeurIPS #Workshop #Interpretability #needs-revision Issue Date: 2023-05-20 GPT Summary- 大規模言語モデル(LLMs)の解釈性の必要性に応えるため、テキストモジュールの入力と出力に基づいて自然言語の説明を自動生成する手法、Summarize and Score(SASC)を提案。合成モジュールへの適用で真の説明を回復し、BERTモデル内のモジュールを検査可能にし、言語刺激へのfMRI応答の説明まで可能。すべてのコードはGitHubに公開。 Comment
モデルのinterpretabilityに関するMSの新たな研究
[Paper Note] Emergent Representations of Program Semantics in Language Models Trained on Programs, Charles Jin+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #NLP #Coding #ICML #One-Line Notes #needs-revision Issue Date: 2023-05-20 GPT Summary- 言語モデル(LM)が次のトークン予測に特化した訓練にもかかわらず、形式的意味を表現できる可能性を示す。2Dグリッド環境でのプログラム合成コーパスを用いてTransformerモデルを訓練し、特定の入力出力仕様が付随するプログラムから、未観測の中間状態を精度よく抽出できることを発見。新しい介入ベースラインにより、LMの表現とプロービングによる結果の明確な識別が可能に。広範な意味論的プロービング実験への適用が期待される。 Comment
プログラムのコーパスでLLMをNext Token Predictionで訓練し
厳密に正解とsemanticsを定義した上で、訓練データと異なるsemanticsの異なるプログラムを生成できることを示した。
LLMが意味を理解していることを暗示している
参考:
[Paper Note] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, Shunyu Yao+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-05-20 GPT Summary- 言語モデルは一般的な問題解決に広がっているが、推論は依然としてトークンレベルの左から右への決定に制限されている。これを克服するために、新しい「Tree of Thoughts(ToT)」フレームワークを導入。ToTは、思考の連鎖を一般化し、中間ステップを探索できるようにし、複数の推論経路を自己評価することで意図的な意思決定を可能にする。実験では、ToTがGame of 24やCreative Writingなどの新規タスクで言語モデルの問題解決能力を顕著に向上させることが示された。例えば、Game of 24では新手法が74%の成功率を達成した。 Comment
Self Concistencyの次
Non trivialなプランニングと検索が必要な新たな3つのタスクについて、CoT w/ GPT4の成功率が4%だったところを、ToTでは74%を達成
論文中の表ではCoTのSuccessRateが40%と書いてあるような?
[Paper Note] Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting, Miles Turpin+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #NLP #Chain-of-Thought #Faithfulness #NeurIPS #needs-revision Issue Date: 2023-05-09 GPT Summary- LLMは段階的推論(CoT)を通じて高い性能を発揮するが、CoTの説明は予測の真の理由を誤って表現することがある。入力にバイアスを与えられると、誤答を正当化する説明が生成され、精度が最大36%低下することが示された。特に、社会的バイアスに関連する場合、モデルの説明がステレオタイプを強化し、バイアスの影響について言及しない。これにより、CoTの説明は一見もっともらしいが誤導的であり、信頼性を高めるリスクを伴う。より透明なシステムを構築するためには、CoTの信頼性を向上させるか、代替手法を検討すべきである。
[Paper Note] Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them, Mirac Suzgun+, ACL'23, 2022.10
Paper/Blog Link My Issue
#NLP #Zero/Few/ManyShotPrompting #Chain-of-Thought #ACL #One-Line Notes Issue Date: 2023-05-04 GPT Summary- BIG-Benchは、言語モデルの限界を超えたタスクに焦点を当てた評価スイートであり、モデルはすでに65%のタスクで平均的な人間評価者を上回っている。本研究では、BBH(BIG-Bench Hard)として知られる、従来の評価で人間を下回った23の困難なタスクを分析。連鎖思考(CoT)プロンプティングを用いることで、PaLMは10タスク、Codexは17タスクで人間評価者を上回ることを示す。多段階の推論が求められるため、CoTなしの評価はモデルの性能を過小評価し、CoTはBBHタスクの性能向上に寄与することが明らかになった。 Comment
単なるfewshotではなく、CoT付きのfewshotをすると大幅にBIG-Bench-hardの性能が向上するので、CoTを使わないanswer onlyの設定はモデルの能力の過小評価につながるよ、という話らしい
Poisoning Language Models During Instruction Tuning, Alexander Wan+, N_A, ICML'23
Paper/Blog Link My Issue
#NLP #Poisoning #ICML Issue Date: 2023-05-04 GPT Summary- - Instruction-tuned LMs(ChatGPT、FLAN、InstructGPTなど)は、ユーザーが提出した例を含むデータセットでfinetuneされる。- 本研究では、敵対者が毒入りの例を提供することで、LMの予測を操作できることを示す。- 毒入りの例を構築するために、LMのbag-of-words近似を使用して入出力を最適化する。- 大きなLMほど毒入り攻撃に対して脆弱であり、データフィルタリングやモデル容量の削減に基づく防御は、テストの正確性を低下させながら、中程度の保護しか提供しない。
[Paper Note] Frustratingly Easy Label Projection for Cross-lingual Transfer, Yang Chen+, ACL'23, 2022.11
Paper/Blog Link My Issue
#MachineTranslation #NLP #Annotation #TransferLearning #MultiLingual #ACL Issue Date: 2023-05-04 GPT Summary- 多言語へのラベル投影には、マーク・アンド・トランスレート法を用いた新しいアプローチが提案され、57言語と3つのタスクにおける実証研究が行われた。実験結果は、EasyProjectが単語アライメント技術を上回る性能を示し、翻訳後もラベルスパンの境界を保持することができることを明らかにした。全コードとデータは公開されている。
[Paper Note] PMC-LLaMA: Towards Building Open-source Language Models for Medicine, Chaoyi Wu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #OpenWeight #Medical #KeyPoint Notes Issue Date: 2023-05-01 GPT Summary- 医療向けに特化したオープンソース言語モデルPMC-LLaMAを構築。一般目的の基盤モデルを医療ドメインに適応させ、4.8百万件の生物医学論文と3万冊の医療教科書から知識を注入。指示チューニング用の大規模データセットも提供し、徹底したアブレーション研究でその有効性を確認。130億パラメータの軽量版PMCLLaMAは複数の医療質問応答ベンチマークで高い性能を示し、ChatGPTを凌駕する場面も確認。 Comment
LLaMAを4.8Mのmedical paperでfinetuningし、医療ドメインの能力を向上。このモデルはPMC-LLaMAと呼ばれ、biomedicalQAタスクで、高い性能を達成した。
GPT-4を利用した異なるモデル間の出力の比較も行なっている模様
[Paper Note] Efficiently Scaling Transformer Inference, Reiner Pope+, MLSys'23, 2022.11
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #LongContext #Architecture #Inference #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 大規模なTransformerモデルの生成的推論を、長いシーケンス長と厳格な遅延目標の下で研究。TPU v4用に最適化された解析モデルを開発し、待機時間とモデルFLOPS利用率のトレードオフにおいて新しいパレート前線を達成。マルチクエリ注意機構を用いることでメモリ要件を減少させ、コンテキスト長を最大32倍に拡張。最終的に、小さなバッチサイズでの1トークンあたりの遅延は29ミリ秒となり、MFUは76%に達し、PaLM 540Bモデルで2048トークンのコンテキストをサポート。 Comment
特にMultiquery Attentionという技術がTransformerのinferenceのコスト削減に有効らしい
Multi Query Attention (MQA):
- [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
[Paper Note] Controlled Text Generation with Natural Language Instructions, Wangchunshu Zhou+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #Supervised-FineTuning (SFT) #InstructionTuning #Prompting #SyntheticData #In-ContextLearning #ICML #PostTraining #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 自然言語の指示に従い、多様なタスクを解決可能な大規模言語モデルの制御を改善するために、「InstructCTG」というフレームワークを提案。自然テキストの制約を抽出し、これを自然言語の指示に変換することで弱教師あり訓練データを形成。異なるタイプの制約に柔軟に対応し、生成の質や速度への影響を最小限に抑えつつ、再訓練なしで新しい制約に適応できる能力を持つ。 Comment
制約に関する指示とデモンスとレーションに関するデータを合成して追加のinstruction tuningを実施することで、promptで指示された制約を満たすような(controllableな)テキストの生成能力を高める手法
[Paper Note] Boosting Theory-of-Mind Performance in Large Language Models via Prompting, Shima Rahimi Moghaddam+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Prompting #TheoryOfMind #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- LLMのToM性能を評価し、文脈内学習が理解を向上させる効果を検討。2ショットの連鎖思考と段階的思考指示を用いたプロンプトで、RLHF訓練モデルはToM精度を80%以上に。特にGPT-4は文脈内学習で100%に達し、適切なプロンプト付けがLLMの推論を強化することを示した。 Comment
LLMはTheory-of-mind reasoningタスクが苦手なことが知られており、特にzero shotでは非常にパフォーマンスが低かった。ToMタスクとは、エージェントの信念、ゴール、メンタルstate、エージェントが何を知っているか等をトラッキングすることが求められるタスクのこと。このようなタスクはLLMが我々の日常生活を理解する上で重要。
↑のToM Questionのシナリオと問題
Scenario: "The morning of the high school dance Sarah placed her high heel shoes under her dress and then went shopping. That afternoon, her sister borrowed the shoes and later put them under Sarah's bed."
Question: When Sarah gets ready, does she assume her shoes are under her dress?
しかし、Zero shot CoTのようなstep by step thinking, CoTを適切に行うことで、OpenAIの直近3つのモデルのAccuracyが80%を超えた。特に、GPT4は100%のAccuracyを達成。人間は87%だった。
この結果は、少なくとのこの論文でテストしたドメインではLLMのsocial reasoningのパフォーマンスをどのようにブーストするかを示しており、LLMのbehaviorは複雑でsensitiveであることを示唆している。
[Paper Note] Large Language Models are Versatile Decomposers: Decompose Evidence and Questions for Table-based Reasoning, Yunhu Ye+, SIGIR'23, 2023.01
Paper/Blog Link My Issue
#NLP #QuestionAnswering #TabularData #SIGIR #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- LLMを活用して、表ベースの推論における巨大な証拠を小さなサブ証拠に分解し、複雑な質問をシンプルなサブ質問に分解。各ステップで論理と数値計算を分離することで、思考の連鎖における幻覚を防止。提案手法は、TabFactで人間を超える性能を達成。 Comment
テーブルとquestionが与えられた時に、questionをsub-questionとsmall tableにLLMでin-context learningすることで分割。subquestionの解を得るためのsqlを作成しスポットを埋め、hallucinationを防ぐ。最終的にLLM Reasonerが解答を導出する。TabFact Reasoningで初めて人間を超えた性能を発揮。
[Paper Note] q2d: Turning Questions into Dialogs to Teach Models How to Search, Yonatan Bitton+, EMNLP'23, 2023.04
Paper/Blog Link My Issue
#NLP #QuestionAnswering #DialogueGeneration #SyntheticData #EMNLP #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 質問から情報探索型対話を自動生成するデータ生成パイプラインq2dを提案。大規模言語モデルPaLMを用いて対話データを作成し、外部検索APIでクエリ生成モデルの性能を向上。合成データで訓練したモデルは人間作成データの90%〜97%に達し、無データでも新ドメイン向けの対話データを生成可能。生成された対話は高品質と評価され、人間作成の対話と区別が難しい。 Comment
LLMにquestionを与え、questionを解決するためのinformation seekingの対話ログを生成させる。このデータを用いて、dialogueからquestionを生成するモデルを訓練し、検索APIなどに渡せるようにした研究。全く対話のログがないドメインのデータに対しても、人間と遜色ない高品質な対話が生成可能。これにより、query generationモデルの更なる高性能化が実現できる。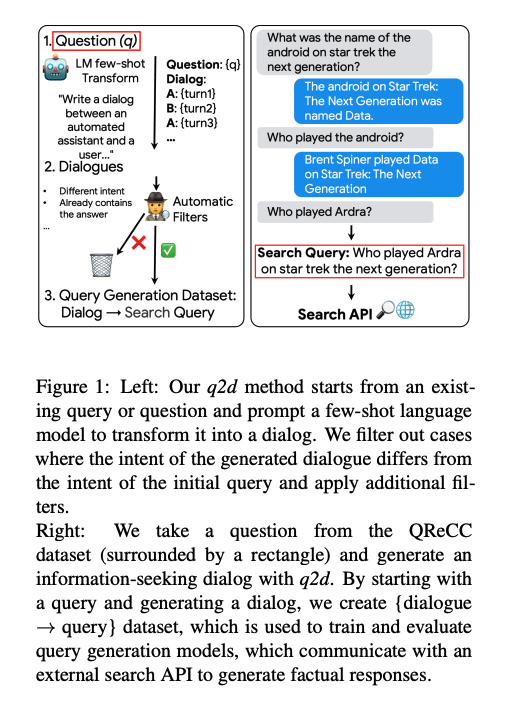
openreview: https://openreview.net/forum?id=8iB0FJmOfV
[Paper Note] Tractable Control for Autoregressive Language Generation, Honghua Zhang+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #ICML #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 自己回帰型大規模言語モデルは複雑な制約を満たすテキスト生成に課題がある。これに対処するため、語彙的制約を扱う確率モデル(TPMs)を用いたGeLaToフレームワークを提案。蒸留された隠れマルコフモデルを利用し、自己回帰生成の効率的な指導を可能にし、制約付きテキスト生成において最先端の性能を達成。研究は大規模言語モデルの制御に新たな道を開き、TPMsのさらなる発展を促進する。 Comment
自然言語生成モデルで、何らかのシンプルなconstiaint αの元p(xi|xi-1,α)を生成しようとしても計算ができない。このため、言語モデルをfinetuningするか、promptで制御するか、などがおこなわれる。しかしこの方法は近似的な解法であり、αがたとえシンプルであっても(何らかの語尾を付与するなど)、必ずしも満たした生成が行われるとは限らない。これは単に言語モデルがautoregressiveな方法で次のトークンの分布を予測しているだけであることに起因している。そこで、この問題を解決するために、tractable probabilistic model(TPM)を導入し、解決した。
評価の結果、CommonGenにおいて、SoTAを達成した。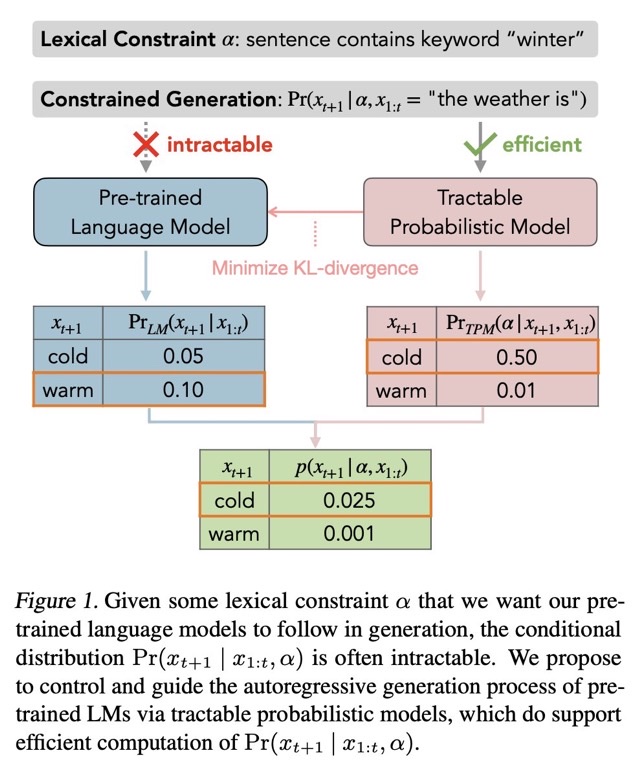
尚、TPMについては要勉強である
[Paper Note] AI, write an essay for me: A large-scale comparison of human-written versus ChatGPT-generated essays, Steffen Herbold+, arXiv'23
Paper/Blog Link My Issue
#NLP #Education #AES(AutomatedEssayScoring) #ChatGPT #One-Line Notes Issue Date: 2023-04-28 GPT Summary- ChatGPTが生成したエッセイは、人間が書いたものよりも質が高いと評価されることが大規模な研究で示された。生成されたエッセイは独自の言語的特徴を持ち、教育者はこの技術を活用する新たな教育コンセプトを開発する必要がある。 Comment
ChatGPTは人間が書いたエッセイよりも高品質なエッセイが書けることを示した。
また、AIモデルの文体は、人間が書いたエッセイとは異なる言語的特徴を示している。たとえば、談話や認識マーカーが少ないが、名詞化が多く、語彙の多様性が高いという特徴がある、とのこと。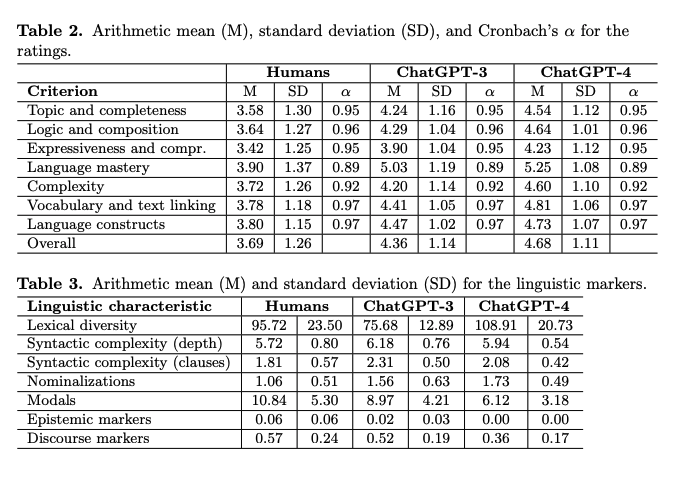
[Paper Note] We're Afraid Language Models Aren't Modeling Ambiguity, Alisa Liu+, EMNLP'23
Paper/Blog Link My Issue
#Dataset #Evaluation #EMNLP #Ambiguity #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 曖昧さは自然言語の重要な特徴であり、言語モデル(LM)が対話や執筆支援において成功するためには、曖昧な言語を扱うことが不可欠です。本研究では、曖昧さの影響を評価するために、1,645の例からなるベンチマーク「AmbiEnt」を収集し、事前学習済みLMの評価を行いました。特にGPT-4の曖昧さ解消の正答率は32%と低く、曖昧さの解消が難しいことが示されました。また、多ラベルのNLIモデルが曖昧さによる誤解を特定できることを示し、NLPにおける曖昧さの重要性を再認識する必要性を提唱しています。 Comment
LLMが曖昧性をどれだけ認知できるかを評価した初めての研究。
言語学者がアノテーションした1,645サンプルの様々な曖昧さを含んだベンチマークデータを利用。
GPT4は32%正解した。
またNLIデータでfinetuningしたモデルでは72.5%のmacroF1値を達成。
応用先として、誤解を招く可能性のある政治的主張に対してアラートをあげることなどを挙げている。
[Paper Note] Exploring the Curious Case of Code Prompts, Li Zhang+, NLRSE'23, 2023.04
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #Reasoning #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- コード風のプロンプトによる構造化推論の性能向上が示されたが、その効果は限られたタスクに留まる。本研究では、davinci系のモデルに対して、QAや感情分析など幅広いタスクでコードとテキストプロンプトを比較し、全体としてコードプロンプトがテキストプロンプトを上回ることはなかった。タスクによってはコードプロンプトが有利な場合もあったが、全てのタスクに当てはまるわけではなく、テキスト指示によるファインチューニングがコードプロンプトの性能向上に寄与することを示した。 Comment
コードベースのLLMに対して、reasoningタスクを解かせる際には、promptもコードにすると10パーセント程度性能上がる場合があるよ、という研究。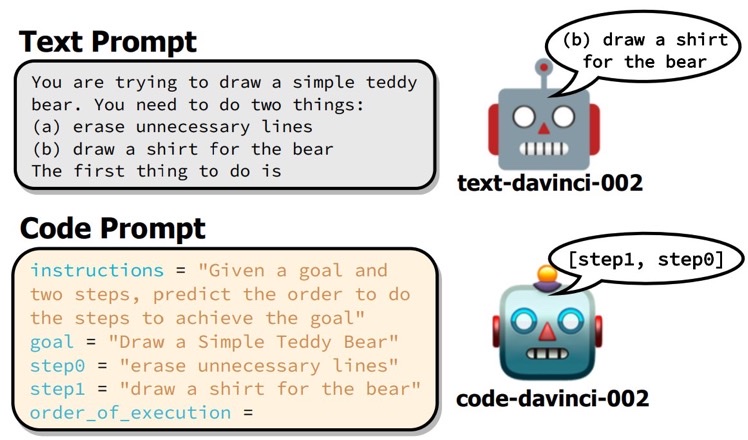
ただし、平均的にはテキストプロンプトの方が良く、一部タスクで性能が改善する、という温度感な模様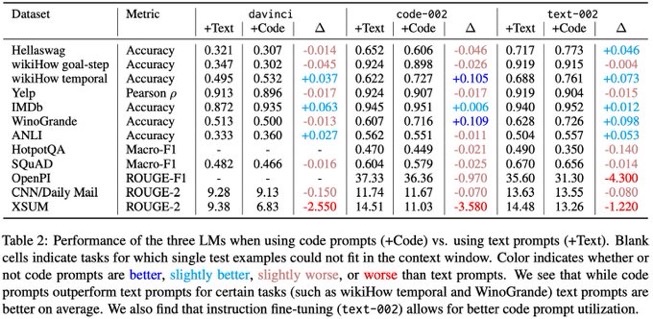
コードベースのモデルをtextでinstruction tuningしている場合でも、効果があるタスクがある。
[Paper Note] Answering Questions by Meta-Reasoning over Multiple Chains of Thought, Ori Yoran+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Chain-of-Thought #Prompting #EMNLP #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 複数の推論チェーンを考慮したMulti-Chain Reasoning(MCR)を提案。これにより、異なるチェーン間の情報を統合し、回答生成時に関連性の高い事実を選択することで、より質の高い説明を提供。7つのマルチホップQAデータセットで優れた性能を示し、人間による検証も可能な高品質な説明を実現。 Comment
self-consistency [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
のようなvoting basedなアルゴリズムは、複数のCoTのintermediate stepを捨ててしまい、結果だけを採用するが、この研究は複数のCoTの中からquestionに回答するために適切なfactual informationを抽出するMeta Reasonerを導入し、複数のCoTの情報を適切に混在させて適切な回答を得られるようにした。
7個のMulti Hop QAデータでstrong baselineをoutperformし、人間が回答をverificationするための高品質な説明を生成できることを示した。
openreview: https://openreview.net/forum?id=ebSOK1nV2r
[Paper Note] Language Models Enable Simple Systems for Generating Structured Views of Heterogeneous Data Lakes, Simran Arora+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #TabularData #One-Line Notes #Data Issue Date: 2023-04-27 GPT Summary- LLMを用いた半構造化文書の自動処理システムEVAPORATEを提案。文書からの値を直接抽出する方法と、抽出コードを合成する方法の二つを評価。コード合成はコストが低いが精度が劣るため、EVAPORATE-CODE+を導入し、品質を向上。弱教師あり学習を用いた抽出のアンサンブルにより、文書処理の効率を大幅に改善。処理トークン数を平均110倍に削減し、最先端システムを超える成果を達成。 Comment
LLMを使うことで、半構造化文章から自動的にqueryableなテーブルを作成することを試みた研究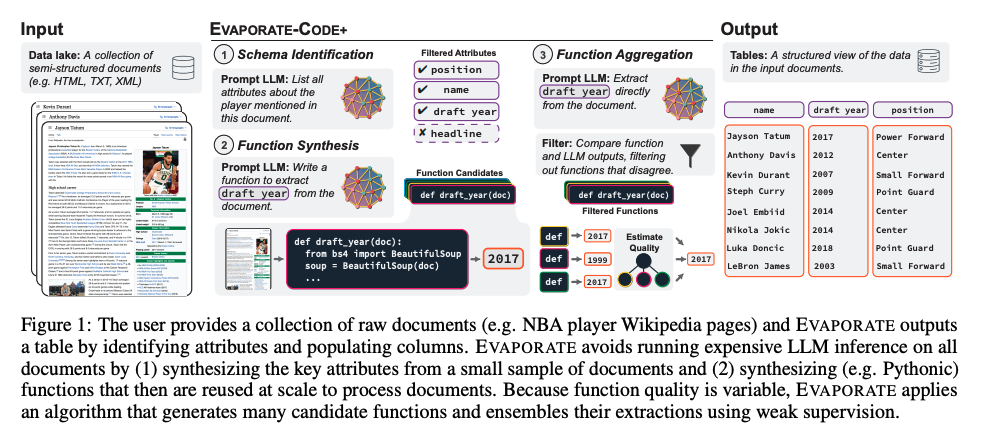
[Paper Note] Can GPT-4 Perform Neural Architecture Search?, Mingkai Zheng+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#MachineLearning #NLP #NeuralArchitectureSearch #KeyPoint Notes Issue Date: 2023-04-27 GPT Summary- GPT-4を用いたニューラルアーキテクチャ探索(NAS)に関する研究を行い、提案手法GENIUSはGPT-4の生成能力を活用してアーキテクチャ探索空間を迅速にナビゲート、候補を特定し性能を向上させる。いくつかのベンチマークで評価し、既存のNAS技術と比較してその効果を示す。特に、限られたドメイン知識を要するプロンプト手法を通じてGPT-4が技術問題の研究に貢献する可能性を強調。さらに、研究の制約やAIの安全性への影響についても言及。 Comment
ドメイン知識の必要のないプロンプトで、ニューラルモデルのアーキテクチャの提案をGPTにしてもらう研究。accをフィードバックとして与え、良い構造を提案するといったループを繰り返す模様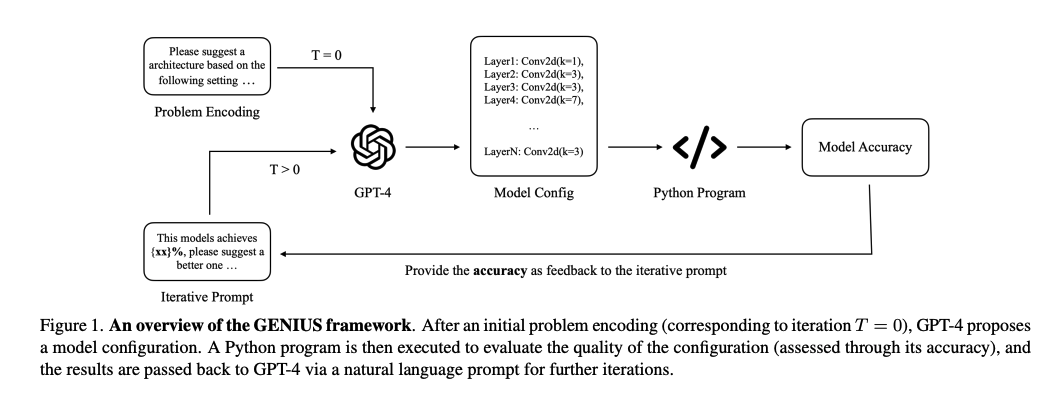
Neural Architecture Search (NAS)においては、ランダムベースラインがよく採用されるらしく、比較した結果ランダムよりよかった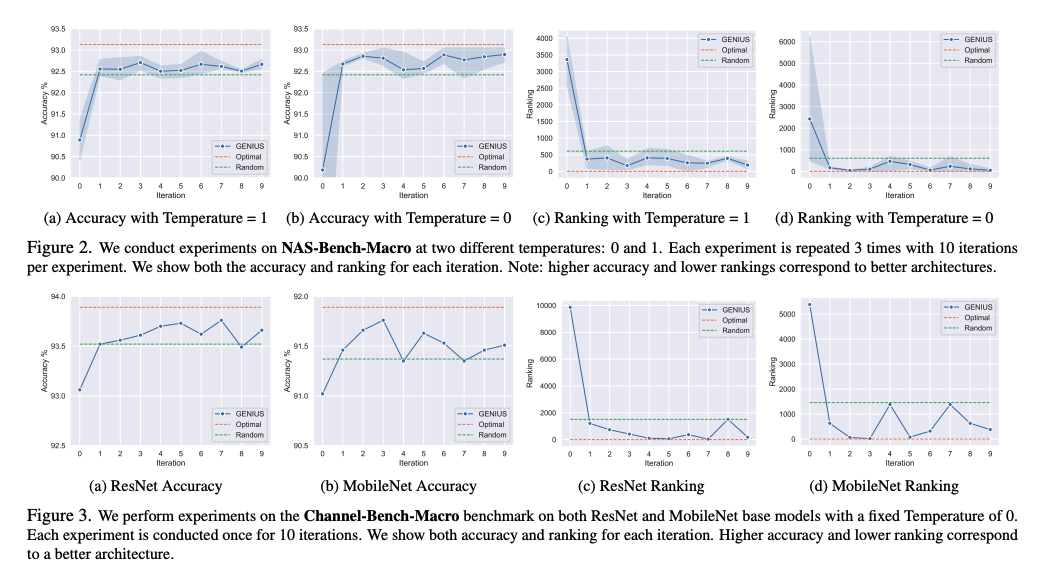
NAS201と呼ばれるベンチマーク(NNアーキテクチャのcell blockをデザインすることにフォーカス; 探索空間は4つのノードと6つのエッジで構成される密接続のDAGとして表される; ノードはfeature mapを表し、エッジはoperationに対応;利用可能なoperationが5つあるため、可能な検索空間の総数は5の6乗で15,625通りとなる)でも評価した結果、提案手法の性能がよかったとのこと。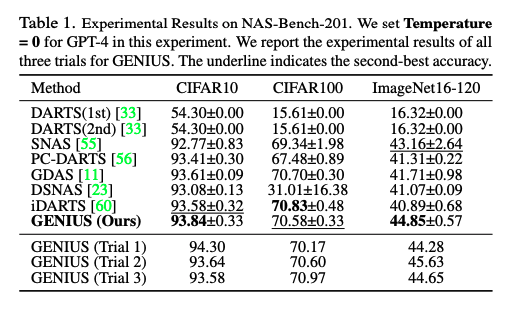
[Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #ICLR #Test-Time Scaling #Selected Papers/Blogs #MajorityVoting Issue Date: 2023-04-27 GPT Summary- 自己一貫性という新しいデコーディング戦略を提案し、chain-of-thought promptingの性能を向上。多様な推論経路をサンプリングし、一貫した答えを選択することで、GSM8KやSVAMPなどのベンチマークで顕著な改善を達成。 Comment
self-consistencyと呼ばれる新たなCoTのデコーディング手法を提案。
これは、難しいreasoningが必要なタスクでは、複数のreasoningのパスが存在するというintuitionに基づいている。
self-consistencyではまず、普通にCoTを行う。そしてgreedyにdecodingする代わりに、以下のようなプロセスを実施する:
1. 多様なreasoning pathをLLMに生成させ、サンプリングする。
2. 異なるreasoning pathは異なるfinal answerを生成する(= final answer set)。
3. そして、最終的なanswerを見つけるために、reasoning pathをmarginalizeすることで、final answerのsetの中で最も一貫性のある回答を見出す。
これは、もし異なる考え方によって同じ回答が導き出されるのであれば、その最終的な回答は正しいという経験則に基づいている。
self-consistencyを実現するためには、複数のreasoning pathを取得した上で、最も多いanswer a_iを選択する(majority vote)。これにはtemperature samplingを用いる(temperatureを0.5やら0.7に設定して、より高い信頼性を保ちつつ、かつ多様なoutputを手に入れる)。
temperature samplingについては[こちら](
https://openreview.net/pdf?id=rygGQyrFvH)の論文を参照のこと。
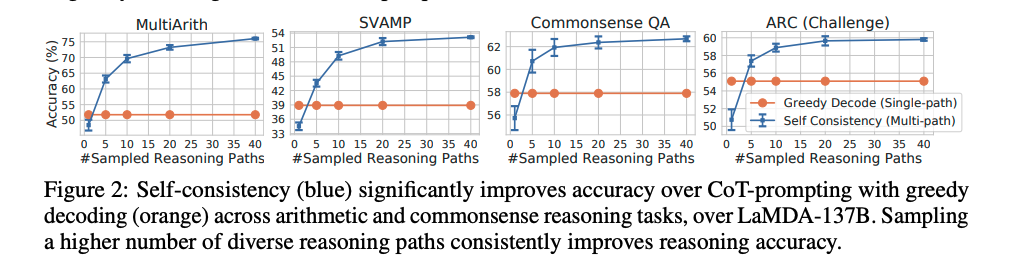
sampling数は増やせば増やすほど性能が向上するが、徐々にサチってくる。サンプリング数を増やすほどコストがかかるので、その辺はコスト感との兼ね合いになると思われる。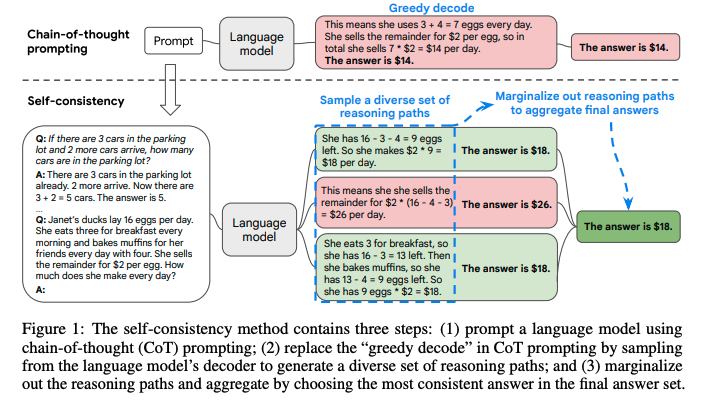
Self-consistencyは回答が閉じた集合であるような問題に対して適用可能であり、open-endなquestionでは利用できないことに注意が必要。ただし、open-endでも回答間になんらかの関係性を見出すような指標があれば実現可能とlimitationで言及している。
self-consistencyが提案されてからもう4年も経ったのか、、、
[Paper Note] Automatic Chain of Thought Prompting in Large Language Models, Zhuosheng Zhang+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #ICLR #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)を用いて、段階的思考を促すCoT promptingを提案。手作業でデモを設計する必要なく、プロンプトを通じて推論チェーンを生成可能。また、多様性を持って質問をサンプリングする自動CoT法(Auto-CoT)を導入し、GPT-3を用いたベンチマークで手動設計と比較して優れた性能を示した。 Comment
LLMによるreasoning chainが人間が作成したものよりも優れていることを示しているとのこと [Paper Note] Enhancing Chain-of-Thoughts Prompting with Iterative Bootstrapping in Large Language Models, Jiashuo Sun+, NAACL'24 Findings, 2023.04 より
clusteringベースな手法を利用することにより、誤りを含む例が単一のクラスタにまとめられうことを示し、これにより過剰な誤ったデモンストレーションが軽減されることを示した。
手法の概要。questionを複数のクラスタに分割し、各クラスタから代表的なquestionをサンプリングし、zero-shot CoTでreasoning chainを作成しpromptに組み込む。最終的に回答を得たいquestionに対しても、上記で生成した複数のquestion-reasoningで条件付けした上で、zeroshot-CoTでrationaleを生成する。これにより自動的にCoTをICLするためのexamplarを生成できる。
openreview: https://openreview.net/forum?id=5NTt8GFjUHkr
[Paper Note] Automatic Prompt Augmentation and Selection with Chain-of-Thought from Labeled Data, KaShun Shum+, EMNLP'23, 2023.02
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #EMNLP #One-Line Notes Issue Date: 2023-04-27 GPT Summary- 新しい戦略「Automate-CoT」を提案し、少量のラベル付きデータから合理的チェーンを自動拡張。低品質なチェーンを剪定し、最適な推論チェーンを選択する分散削減型ポリシー勾配戦略を用いる。これにより、さまざまなタスクへのCoT手法の迅速な適用を可能にし、実験で競争力のある結果を達成。 Comment
LLMによるreasoning chainが人間が作成したものよりも優れていることを示しているとのこと。下記研究より
- [Paper Note] Enhancing Chain-of-Thoughts Prompting with Iterative Bootstrapping in Large Language Models, Jiashuo Sun+, NAACL'24 Findings, 2023.04
selection phaseで誤ったexampleは直接排除する手法をとっている。そして、強化学習によって、demonstrationのselection modelを訓練している。
openreview: https://openreview.net/forum?id=FGBEoz9WzI¬eId=sq50eXOEeV
[Paper Note] Personalisation within bounds: A risk taxonomy and policy framework for the alignment of large language models with personalised feedback, Hannah Rose Kirk+, arXiv'23, 2023.03
Paper/Blog Link My Issue
#NLP #Personalization #needs-revision Issue Date: 2023-04-26 GPT Summary- LLMの個別化には、人間の嗜好と整合させる必要があり、アラインメント技術がその課題を緩和するが、全ての嗜好を表現するのは難しい。ユーザーの多様な価値観に基づくマイクロレベルの個別化は有望だが、規範的課題が存在する。本文では、整合の定義、主観的嗜好の押し付け、文書化不足の問題を概観し、個別化されたLLMの利点とリスクを整理。最後に、安全なLLMの挙動を維持するための三層政策フレームワークを提案。 Comment
# abst
LLMをPersonalizationすることに関して、どのような方法でPersonalizationすべきかを検討した研究。以下の問題点を指摘。
1. アラインメント(RLHFのように何らかの方向性にalignするように補正する技術のこと?)が何を意味するのか明確ではない
2. 技術提供者が本質的に主観的な好みや価値観の定義を規定する傾向があること
3. クラウドワーカーがの専制によって、我々が実際に何にアラインメントしているのかに関する文書が不足していること
そして、PersonalizedなLLMの利点やリスクの分類を提示する。
# 導入
LLMがさまざまな製品に統合されたことで、人間の嗜好に合致し、危険かつ不正確な情報を出力を生成しないことを確保する必要がある。RLHFやred-teamingはこれに役立つが、このような集合的な(多くの人に一つのアラインメントの結果を提示すること)finetuningプロセスが人間の好みや価値観の幅広い範囲を十分に表現できるとは考えにくい。異なる人々はさまざまな意見や価値観を持っており、マイクロレベルのfinetuningプロせせ雨を通じてLLMをPersonalizationすることで、各ユーザとより良いアラインメントが可能になる可能性がある。これを社会的に受け入れられるようにするためにいくつか課題があるので、それについて論じた。
[Paper Note] WizardLM: Empowering large pre-trained language models to follow complex instructions, Can Xu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #InstructionTuning #SyntheticData #ICLR #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- 本論文では、LLMを用いて複雑な指示データを自動生成する方法を提案。Evol-Instructを使用して初期の指示を段階的に書き換え、生成したデータでLLaMAをファインチューニングし、WizardLMモデルを構築。評価結果は、Evol-Instructからの指示が人間作成のものより優れており、WizardLMがChatGPTよりも高い評価を得ることを示す。AI進化による指示生成がLLM強化の有望なアプローチであることを示唆。 Comment
instruction trainingは大きな成功を収めているが、人間がそれらのデータを作成するのはコストがかかる。また、そもそも複雑なinstructionを人間が作成するのは苦労する。そこで、LLMに自動的に作成させる手法を提案している(これはself instructと一緒)。データを生成する際は、seed setから始め、step by stepでinstructionをrewriteし、より複雑なinstructionとなるようにしていく。
これらの多段的な複雑度を持つinstructionをLLaMaベースのモデルに食わせてfinetuningした(これをWizardLMと呼ぶ)。人手評価の結果、WizardLMがChatGPTよりも好ましいレスポンスをすることを示した。特に、WizaraLMはコード生成や、数値計算といった難しいタスクで改善を示しており、複雑なinstructionを学習に利用することの重要性を示唆している。
EvolInstructを提案。"1+1=?"といったシンプルなinstructionからスタートし、これをLLMを利用して段階的にcomplexにしていく。complexにする方法は2通り:
- In-Depth Evolving: instructionを5種類のoperationで深掘りする(blue direction line)
- add constraints
- deepening
- concretizing
- increase reasoning steps
- complicate input
- In-breadth Evolving: givenなinstructionから新しいinstructionを生成する
上記のEvolvingは特定のpromptを与えることで実行される。
また、LLMはEvolvingに失敗することがあるので、Elimination Evolvingと呼ばれるフィルタを利用してスクリーニングした。
フィルタリングでは4種類の失敗するsituationを想定し、1つではLLMを利用。2枚目画像のようなinstructionでフィルタリング。
1. instructionの情報量が増えていない場合。
2. instructionがLLMによって応答困難な場合(短すぎる場合やsorryと言っている場合)
3. puctuationやstop wordsによってのみ構成されている場合
4.明らかにpromptの中から単語をコピーしただけのinstruction(given prompt, rewritten prompt, #Rewritten Prompt#など)

[Paper Note] Scaling Transformer to 1M tokens and beyond with RMT, Aydar Bulatov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Transformer #LongContext #memory #One-Line Notes Issue Date: 2023-04-25 GPT Summary- 再帰的メモリ拡張を用いて、トランスフォーマーの計算量を線形にスケールし、最大二百万トークンまでのシーケンスを扱う能力を実証。言語モデリングタスクでの実験は、パープレキシティの改善を示し、長期依存の処理能力向上の可能性を強調。 Comment
Reccurent Memory Transformer [Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
を使って2Mトークン扱えるようにしたよーという話。
ハリーポッターのトークン数が1.5Mらしいので、そのうち小説一冊書けるかもという世界。
[Paper Note] LLM+P: Empowering Large Language Models with Optimal Planning Proficiency, Bo Liu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #Planning #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- LLMsは一般的な質問には優れた回答能力を示すが、長期的な計画問題には弱い。本研究では、古典的プランナーの強みをLLMsに統合した初のフレームワーク、LLM+Pを提案。自然言語の計画記述をPDDL形式に変換し、効率的に解を見つけて再翻訳する手法を採用。実験により、LLM+Pは多くの計画問題に対して最適解を提供できる一方、LLMsはほとんど問題を解決できないことが確認された。 Comment
LLMは長いプランニングをすることが苦手だったが、classicalなplannerは適切なinputの形式に変換されていればすぐに最適なプランを導出できる、が、自然言語は受け付けない、といった互いが互いを補完し合う関係にあるので、両者を組み合わせました、という話。
LLMを利用して、planning problemを記述した自然言語をclassicalなplannerのinputへ変換。その後plannerで最適なplanを見つけ、自然言語にplanを逆翻訳する。
[Paper Note] ReAct: Synergizing Reasoning and Acting in Language Models, Shunyu Yao+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#NLP #AIAgents #Selected Papers/Blogs #needs-revision Issue Date: 2023-04-13 GPT Summary- 大規模言語モデルを用いて、推論と行動計画を相互に組み合わせるReActアプローチを提案。推論の痕跡が行動計画の導出を促進し、行動が外部情報を活用することで、推論の効率を向上。質問応答や事実検証タスクで従来手法を凌駕し、人間の解釈性と信頼性を向上させる。対話的意思決定ベンチマークでも優れた性能を発揮。 Comment
# 概要
人間は推論と行動をシナジーさせることで、さまざまな意思決定を行える。近年では言語モデルにより言語による推論を意思決定に組み合わせる可能性が示されてきた。たとえば、タスクをこなすための推論トレースをLLMが導けることが示されてきた(Chain-of-Thought)が、CoTは外部リソースにアクセスできないため知識がアップデートできず、事後的に推論を行うためhallucinationやエラーの伝搬が生じる。一方で、事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われているが、これらの研究では、高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
そこで、REACTを提案。REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みであり、推論トレースとアクションを交互に生成するため、動的に推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
- 要はいままではGeneralなタスク解決モデルにおいては、推論とアクションの生成は独立にしかやられてこなかったけど、推論とアクションを交互作用させることについて研究したよ
- そしたら性能がとってもあがったよ
- reasoningを人間が編集すれば、エージェントのコントロールもできるよ という感じ
# イントロ
人間は推論と行動の緊密なシナジーによって、不確実な状況に遭遇しても適切な意思決定が行える。たとえば、任意の2つの特定のアクションの間で、進行状況をトレースするために言語で推論したり(すべて切り終わったからお湯を沸かす必要がある)、例外を処理したり、状況に応じて計画を調整したりする(塩がないから代わりに醤油と胡椒を使おう)。また、推論をサポートし、疑問(いまどんな料理を作ることができるだろうか?)を解消するために、行動(料理本を開いてレシピを読んで、冷蔵庫を開いて材料を確確認したり)をすることもある。
近年の研究では言語での推論を、インタラクティブな意思決定を組み合わせる可能性についてのヒントが得られてきた。一つは、適切にPromptingされたLLMが推論トレースを実行できることを示している。推論トレースとは、解決策に到達するための一連のステップを経て推論をするためのプロセスのことである。しかしながらChain-of-thoughytは、このアプローチでは、モデルが外界対してgroundingできず、内部表現のみに基づい思考を生成するため限界がある。これによりモデルが事後対応的に推論したり、外部情報に基づいて知識を更新したりできないため、推論プロセス中にhallucinationやエラーの伝搬などの問題が発生する可能性が生じる。
一方、近年の研究では事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われている。これらの研究では、通常マルチモーダルな観測結果をテキストに変換し、言語モデルを使用してドメイン固有のアクション、またはプランを生成し、コントローラーを利用してそれらを選択または実行する。ただし、これらのアプローチは高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。
推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
LLMにおける推論と行動を組み合わせて、言語推論と意思決定タスクを解決するREACTと呼ばれる手法を提案。REACTでは、推論と行動の相乗効果を高めることが可能。推論トレースによりアクションプランを誘発、追跡、更新するのに役立ち、アクションでは外部ソースと連携して追加情報を収集できる。
REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みである。REACTのpromptはLLMにverbalな推論トレースとタスクを実行するためのアクションを交互に生成する。これにより、モデルは動的な推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
# 手法
変数を以下のように定義する:
- O_t: Observertion on time t
- a_t: Action on time t
- c_t: context, i.e. (o_1, a_1, o_2, a_2, ..., a_t-1, o_t)
- policy pi(a_t | c_t): Action Spaceからアクションを選択するポリシー
- A: Action Space
- O: Observation Space
普通はc_tが与えられたときに、ポリシーに従いAからa_tを選択しアクションを行い、アクションの結果o_tを得て、c_t+1を構成する、といったことを繰り返していく。
このとき、REACTはAをA ∪ Lに拡張しする。ここで、LはLanguage spaceである。LにはAction a_hatが含まれ、a_hatは環境に対して作用をしない。単純にthought, あるいは reasoning traceを実施し、現在のcontext c_tをアップデートするために有用な情報を構成することを目的とする。Lはunlimitedなので、事前学習された言語モデルを用いる。今回はPaLM-540B(c.f. GPT3は175Bパラメータ)が利用され、few-shotのin-context exampleを与えることで推論を行う。それぞれのin-context exampleは、action, thoughtsそしてobservationのtrajectoryを与える。
推論が重要なタスクでは、thoughts-action-observationステップから成るtask-solving trajectoryを生成する。一方、多数のアクションを伴う可能性がある意思決定タスクでは、thoughtsのみを行うことをtask-solving trajectory中の任意のタイミングで、自分で判断して行うことができる。
意思決定と推論能力がLLMによってもたらされているため、REACTは4つのuniqueな特徴を持つ:
- 直感的で簡単なデザイン
- REACTのpromptは人間のアノテータがアクションのトップに思考を言語で記述するようなストレートなものであり、ad-hocなフォーマットの選択、思考のデザイン、事例の選定などが必要ない。
- 一般的で柔軟性が高い
- 柔軟な thought spaceと thought-actionのフォーマットにより、REACTはさまざまなタスクにも柔軟に対応できる
- 高性能でロバスト
- REACTは1-6個の事例によって、新たなタスクに対する強力な汎化を示す。そして推論、アクションのみを行うベースラインよりも高い性能を示している。REACTはfinetuningの斧系も得ることができ、promptの選択に対してREACTの性能はrobustである。
- 人間による調整と操作が可能
- REACTは、解釈可能な意思決定と推論のsequenceを前提としているため、人間は簡単に推論や事実の正しさを検証できる。加えて、thoughtsを編集することによって、m人間はエージェントの行動を制御、あるいは修正できる。
# KNOWLEDGE INTENSIVE REASONING TASKS
openreview: https://openreview.net/forum?id=tvI4u1ylcqs
[Paper Note] ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks, Fabrizio Gilardi+, NAS'23, 2023.03
Paper/Blog Link My Issue
#NLP #Annotation #In-Depth Notes Issue Date: 2023-04-12 GPT Summary- ChatGPTは、2,382件のツイートを用いたアノテーションタスクにおいて、クラウドワーカーを上回る性能を示し、特に4つのタスクでゼロショット精度が優れています。また、インターコーダー合意でも全てのタスクでクラウドワーカーや訓練を受けたアノテーターを超え、コストもMTurkの約20倍安価です。これにより、大規模言語モデルがテキスト分類の効率を大幅に向上させる可能性が示唆されます。 Comment
# 概要
2300件程度のツイートを分類するタスクにおいて、訓練した学部生によるアノテーションを正解とし、クラウドワーカーとChatGPTでのzero-shotでの予測の性能を比較した。分類タスクは、比較的難易度の高い分類問題であり、クラウドワーカーでも正解率は難しいタスクでは15--25%程度であった。このようなタスクでchatgptは40--60%の正解率を示している。
比較の結果、5つのタスク中4つのタスクでChatGPTがクラウドワーカーを上回る正解率を示した。
# 手法
- クラウドワーカーとChatGPTで同じインストラクションを利用し、同じタスクを実施した
- inter-notator aggreementを図るために、それぞれのタスクについて各ツイートに少なくとも2人がラベル付を行った
- ChatGPTでも同様に、タスクごとに各ツイートには2回同じタスクを実施しデータを収集した
- ChatGPTを利用する際は、temperatureを1.0, 0.2の場合で試した。従ってChatGPTのラベル付けは各タスクごとに4セット存在することになる。
# 結果
5タスク中、4タスクでChatGPTがzero-shotにもかかわらず正解率でworkerを上回った。また高いaggreementを発揮していることを主張。aggreementはtemperatureが低い方が高く、これはtemperatureが低い方がrandomnessが減少するためであると考えられる。aggreementをAccuracyの相関を図ったが、0.17であり弱い相関しかなかった。従って、Accuracyを減少させることなく、一貫性のある結果を得られるlaw temperatureを利用することが望ましいと結論づけている。
# 実施したタスク
"content moderation"に関するタスクを実施した。content moderationはSNSなどに投稿されるpostを監視するための取り組みであり、たとえばポルトツイートや誤った情報を含む有害なツイート、ヘイトスピーチなどが存在しないかをSNS上で監視をを行うようなタスクである。著者らはcontent moderationはハードなタスクであり、複雑なトピックだし、toy exampleではないことを主張している。実際、著者らが訓練した学部生の間でのinter-annotator aggreementは50%程度であり、難易度が高いタスクであることがわかる(ただし、スタンスdetectionに関してはaggreementが78.3%であった)。
content moderationのうち、以下の5つのタスクを実施した。
- relevance:
- ツイートがcontent moderationについて直接的に関係することを述べているか否か
- e.g. SNSにおけるcontent moderation ruleや実践、政府のレギュレーション等
- content moderationについて述べていないものについてはIRRELEVANTラベルを付与する
- ただし、主題がcontent moderationのツイートであっても、content moderationについて論じていないものについてはIRRELEVANT扱いとする。
- このような例としては、TwitterがDonald TrupのTwitterを"disrupted"とlabel付けしたことや、何かについて間違っていると述べているツイート、センシティブな内容を含むツイートなどがあげられる。
- Problem/Solution Frames
- content moderationは2つの見方ができる。それがProblemとSolution
- Problem: content moderationをPROBLEMとみなすもの。たとえば、フリースピーチの制限など
- SOLUTION: content moderationをSOLUTIONとみなすもの。たとえば、harmful speechから守ること、など
- ツイートがcontent moderationのnegativeな影響について強調していたら、PROBLEM(フリースピーチの制限やユーザがポストする内容についてバイアスが生じることなどについて)
- ツイートがcontent moderationのpositiveな影響について強調していたら、SOKUTION(harmful contentからユーザを守るなど)
- 主題はcontent moderationであるが、positive/negativeな影響について論じていないものはNEUTRAL
- Policy Frames
- content moderationはさまざまんトピックと関連している(たとえば)、健康、犯罪、平等など)
- content moderatiojnに関するツイートがどのトピックかをラベル付する。ラベルは15種類
- economy, capcity and resources, modality, fairness and equality, constitutionality and jurisprudence, policy prescription and evaluation, law and order, crime and justice, security and defense, health and safety, quality of life, cultural identity, public opinion, political, external regulation and reputation, other
- Stance Detection
- USのSection 230という法律(websiteにユーザが投稿したコンテンツに対して、webサイトやその他のオンラインプラットフォームが法的責任を問われるのを防ぐ法律)について、ツイートがSection230に対して、positive/negative/neutralなスタンスかをラベル付する
- Topic Detection
- ツイートを6つのトピックにラベル付する
- Section 230, TRUMP BAN, TWITTER-SUPPORT, PLATFORM POLICIES, COMPLAINTS, other
# 所感
そこそこ難易度の高いアノテーションタスクでもzero-shotでturkerの性能を上回るのは非常に素晴らしいことだと思う。ノイジーなデータセットであれば、比較的安価、かつスピーディーに作成できるようになってきたのではないかと思う。
ただ、ChatGPTのaggreementを図ることにどれだけ意味があるのだろう、とは思う。同じモデルを利用しているわけで、小tなるLLMをベースにした場合のaggreementならとる意味があると思うが。
[Paper Note] Self-Instruct: Aligning Language Models with Self-Generated Instructions, Yizhong Wang+, ACL'23, 2022.12
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #InstructionTuning #ACL #In-Depth Notes Issue Date: 2023-03-30 GPT Summary- Self-Instructフレームワークを提案し、事前学習済みの言語モデルが自ら生成した指示を用いてファインチューニングを行うことで、ゼロショットの一般化能力を向上させる。バニラGPT-3に適用した結果、Super-NaturalInstructionsで33%の性能向上を達成し、InstructGPT-001と同等の性能に到達。人間評価により、Self-Instructが既存の公共指示データセットよりも優れていることを示し、ほぼ注釈不要の指示調整手法を提供。大規模な合成データセットを公開し、今後の研究を促進する。 Comment
Alpacaなどでも利用されているself-instruction技術に関する論文
# 概要
著者らが書いた175種のinstruction(タスクの定義 + 1種のinput/outputペア}のseedを元に、VanillaなGPT-3に新たなinstruction, input, outputのtupleを生成させ、学習データとして活用する研究。
ここで、instruction data I は以下のように定義される:
instruction dataは(I, X, Y)であり、モデルは最終的にM(I_t, x_t) = y_tとなるように学習したい。
I: instruction, X: input, Y: output
データ作成は以下のステップで構成される。なお、以下はすべてVanilla GPT-3を通じて行われる:
1. Instruction Generation
task poolから8種類のinstructionを抽出し、 promptを構成し、最大8個新たなinstructionを生成させる
2. Classification Task Identification:
生成されたinstructionがclassificationタスクか否かを判別する
3. Instance Generation
いくつかの(I, X, Y)をpromptとして与え、I, Xに対応するYを生成するタスクを実行させる。このときinput-first approachを採用した結果(I->Xの順番で情報を与えYを生成するアプローチ)、特定のラベルに偏ったインスタンスが生成される傾向があることがわかった。このためoutput-first approachを別途採用し(I->Yの順番で情報を与え、各Yに対応するXを生成させる)、活用している。
4. Filtering and Postprocessing
最後に、既存のtask poolとROUGE-Lが0.7以上のinstructionは多様性がないため除外し、特定のキーワード(images, pictrues, graphs)等を含んでいるinstruction dataも除外して、task poolに追加する。
1-4をひたすら繰り返すことで、GPT-3がInstruction Tuningのためのデータを自動生成してくれる。
# SELF-INSTRUCT Data
## データセットの統計量
- 52k instructions
- 82k instances
## Diversity
parserでinstructionを解析し、rootの名詞と動詞のペアを抽出して可視化した例。ただし、抽出できた例はたかだか全体の50%程度であり、その中で20の最もcommonなroot vertと4つのnounを可視化した。これはデータセット全体の14%程度しか可視化されていないが、これだけでも非常に多様なinstructionが集まっていることがわかる。
また、seed indstructionとROUGE-Lを測った結果、大半のデータは0.3~0.4程度であり、lexicalなoverlapはあまり大きくないことがわかる。instructionのlengthについても可視化した結果、多様な長さのinstructionが収集できている。
## Quality
200種類のinstructionを抽出し、その中からそれぞれランダムで1つのインスタンスをサンプルした。そしてexpert annotatorに対して、それぞれのinstructionとinstance(input, outputそれぞれについて)が正しいか否かをラベル付けしてもらった。
ラベル付けの結果、ほとんどのinstructionは意味のあるinstructionであることがわかった。一方、生成されたinstanceはnoisyであることがわかった(ただし、このnoiseはある程度妥当な範囲である)。noisytではあるのだが、instanceを見ると、正しいformatであったり、部分的に正しかったりなど、modelを訓練する上で有用なguidanceを提供するものになっていることがわかった。
# Experimental Results
## Zero-shotでのNLPタスクに対する性能
SuperNIデータセットに含まれる119のタスク(1タスクあたり100 instance)に対して、zero-shot setupで評価を行なった。SELF-INSTRUCTによって、VanillaのGPT3から大幅に性能が向上していることがわかる。VanillaのGPT-3はほとんど人間のinstructionに応じて動いてくれないことがわかる。分析によると、GPT3は、大抵の場合、全く関係ない、あるいは繰り返しのテキストを生成していたり、そもそもいつ生成をstopするかがわかっていないことがわかった。
また、SuperNI向けにfinetuningされていないモデル間で比較した結果、非常にアノテーションコストをかけて作られたT0データでfinetuningされたモデルよりも高い性能を獲得した。また、人間がラベル付したprivateなデータによって訓練されたInstructGPT001にも性能が肉薄していることも特筆すべき点である。
SuperNIでfinetuningした場合については、SELF-INSTRUCTを使ったモデルに対して、さらに追加でSuperNIを与えた場合が最も高い性能を示した。
## User-Oriented Instructionsに対する汎化性能
SuperNIに含まれるNLPタスクは研究目的で提案されており分類問題となっている。ので、実践的な能力を証明するために、LLMが役立つドメインをブレスト(email writing, social media, productiveity tools, entertainment, programming等)し、それぞれのドメインに対して、instructionとinput-output instanceを作成した。また、instructionのスタイルにも多様性(e.g. instructionがlong/short、bullet points, table, codes, equationsをinput/outputとして持つ、など)を持たせた。作成した結果、252個のinstructionに対して、1つのinstanceのデータセットが作成された。これらが、モデルにとってunfamiliarなinstructionで多様なistructionが与えられたときに、どれだけモデルがそれらをhandleできるかを測定するテストベッドになると考えている。
これらのデータは、多様だがどれもが専門性を求められるものであり、自動評価指標で性能が測定できるものでもないし、crowdworkerが良し悪しを判定できるものでもない。このため、それぞれのinstructionに対するauthorに対して、モデルのy補足結果が妥当か否かをjudgeしてもらった。judgeは4-scaleでのratingとなっている:
- RATING-A: 応答は妥当で満足できる
- RATING-B: 応答は許容できるが、改善できるminor errorや不完全さがある。
- RATING-C: 応答はrelevantでinstructionに対して答えている。が、内容に大きなエラーがある。
- RATING-D: 応答はirrelevantで妥当ではない。
実験結果をみると、Vanilla GPT3はまったくinstructionに対して答えられていない。instruction-basedなモデルは高いパフォーマンスを発揮しているが、それらを上回る性能をSELF-INSTRUCTは発揮している(noisyであるにもかかわらず)。
また、GPT_SELF-INSTRUCTはInstructGPT001と性能が肉薄している。また、InstructGPT002, 003の素晴らしい性能を示すことにもなった。
# Discussion and Limitation
## なぜSELF-INSTRUCTがうまくいったか?
- LMに対する2つの極端な仮説を挙げている
- LM はpre-trainingでは十分に学習されなかった問題について学習する必要があるため、human feedbackはinstruction-tuningにおいて必要不可欠な側面である
- LM はpre-trainingからinstructionに既に精通しているため、human feedbackはinstruction-tuningにおいて必須ではない。 human feedbackを観察することは、pre-trainingにおける分布/目的を調整するための軽量なプロセスにすぎず、別のプロセスに置き換えることができる。
この2つの極端な仮説の間が実情であると筆者は考えていて、どちらかというと2つ目の仮説に近いだろう、と考えている。既にLMはpre-trainingの段階でinstructionについてある程度理解できているため、self-instructがうまくいったのではないかと推察している。
## Broader Impact
InstructGPTは非常に強力なモデルだけど詳細が公表されておらず、APIの裏側に隠れている。この研究が、instruct-tuned modelの背後で何が起きているかについて、透明性を高める助けになると考えている。産業で開発されたモデルの構造や、その優れた性能の理由についてはほとんど理解されておらず、これらのモデルの成功の源泉を理解し、より優れた、オープンなモデルを作成するのはアカデミックにかかっている。この研究では、多様なinstructional dataの重要性を示していると考えており、大規模な人工的なデータセットは、より優れたinstructionに従うモデルを、構築するための第一歩だと考えている。
## limitation
- Tail Phenomena
- LMの枠組みにとどまっているため、LMと同じ問題(Tail Phenomena)を抱えている
- low-frequencyなcontextに対してはうまくいかない問題
- SELF-INSTRUCTも、結局pre-trainingの段階で頻出するタスクやinstructionに対してgainがあると考えられ、一般的でなく、creativeなinstructionに対して脆弱性があると考えられる
- Dependence on laege models
- でかいモデルを扱えるだけのresourceを持っていないと使えないという問題がある
- Reinforcing LM biases
- アルゴリズムのiterationによって、問題のあるsocial _biasをより増幅してしまうことを懸念している(人種、種族などに対する偏見など)。また、アルゴリズムはバランスの取れたラベルを生成することが難しい。
1のprompt
2のprompt
3のprompt(input-first-approach)
3のprompt(output-first approach)
※ GPT3をfinetuningするのに、Instruction Dataを使った場合$338かかったっぽい。安い・・・。
LLMを使うだけでここまで研究ができる時代がきた
(最近は|現在は)プロプライエタリなLLMの出力を利用して競合するモデルを訓練することは多くの場合禁止されているので注意。
[Paper Note] Reflexion: Language Agents with Verbal Reinforcement Learning, Noah Shinn+, NeurIPS'23, 2023.03
Paper/Blog Link My Issue
#MachineLearning #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #AIAgents #SelfCorrection #NeurIPS #PostTraining #Initial Impression Notes Issue Date: 2023-03-28 GPT Summary- LLMを用いた言語エージェントが外部環境と相互作用しつつ、迅速な学習を可能にする新しいフレームワーク「Reflexion」を提案。言語的フィードバックを活用し、エージェントはタスクのフィードバックを反映、エピソディックメモリに保持して意思決定を改善。多様なフィードバック信号を取り入れ、様々なタスクで大幅な性能向上を実現。HumanEvalベンチマークでは91%のpass@1精度を達成し、従来の最先端を超える成果を示した。 Comment
なぜ回答を間違えたのか自己反省させることでパフォーマンスを向上させる研究
openreview: https://openreview.net/forum?id=vAElhFcKW6
[Paper Note] ScienceWorld: Is your Agent Smarter than a 5th Grader?, Ruoyao Wang+, EMNLP'22, 2022.03
Paper/Blog Link My Issue
#NLP #AIAgents #Evaluation #ScientificDiscovery #EMNLP #Selected Papers/Blogs #Science #One-Line Notes Issue Date: 2026-04-14 GPT Summary- ScienceWorldは、小学校の科学カリキュラムに基づき、エージェントの科学的推論能力を評価するための対話型テキスト環境を提供します。従来のモデルは、新しい文脈で学んだ科学概念を推論するのが苦手で、特に未知の材料の伝導率を見つけるための実験方法を問われると苦戦します。これは、モデルが類似例から答えを得ているのか、再利用可能な方法で推論を学んでいるのかという疑問を生み出します。私たちは、エージェントは対話型環境にグラウンディングされることで推論能力を得るべきだと仮定し、150万パラメータのエージェントが10万ステップの対話型訓練を受けた結果、静的訓練を受けた110億パラメータのモデルを上回ることを実証しました。 Comment
ベンチマークの概要は
- Evaluating agents for scientific discovery, Ai2, 2026.04
参照のこと。
[Paper Note] GPT-NeoX-20B: An Open-Source Autoregressive Language Model, Sid Black+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#NLP #OpenWeight #OpenSource #Selected Papers/Blogs Issue Date: 2026-03-31 GPT Summary- GPT-NeoX-20Bは、200億パラメータを持つ自己回帰型言語モデルで、Pileで訓練され、寛容なライセンスの下で重みが一般公開される。言語理解や数学、知識ベースのタスクで高い性能を持ち、特に5ショット評価時に同規模のモデルより優れた結果を示す。訓練および評価コード、モデルの重みはオープンソースで提供される。 Comment
[Paper Note] BLOOM: A 176B-Parameter Open-Access Multilingual Language Model, BigScience Workshop+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Pretraining #NLP #OpenWeight #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-03-31 GPT Summary- 大規模言語モデル(LLMs)を使い、新しいタスクを少ないデモや指示で実行可能にしたBLOOMを紹介。これは1760億パラメータのオープンアクセス言語モデルで、46の自然言語と13のプログラミング言語をカバー。競争力のある性能を発揮し、マルチタスクのファインチューニングを通じてさらに向上。モデルとコードは責任あるAIライセンスで公開し、今後の研究と応用の促進を目指す。 Comment
HF: https://huggingface.co/bigscience/bloom
透明性を持ったLLMを構築し民主化を図る方向性のパイオニア的研究
[Paper Note] bert2BERT: Towards Reusable Pretrained Language Models, Cheng Chen+, ACL'22, 2021.10
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Transformer #ACL #Encoder #Decoder Issue Date: 2025-12-11 GPT Summary- bert2BERTは、既存の小規模事前学習モデルの知識を大規模モデルに転送し、事前学習効率を向上させる手法。二段階の事前学習を提案し、トレーニングコストを大幅に削減。BERT_BASEとGPT_BASEの事前学習で約45%および47%の計算コストを節約。
[Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#NLP #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #Safety #Selected Papers/Blogs #PseudoLabeling Issue Date: 2025-09-20 GPT Summary- 本研究では、「憲法的AI」を用いて、人間のラベルなしで無害なAIを訓練する方法を提案。監視学習と強化学習の2フェーズを経て、自己批評と修正を通じてモデルを微調整し、嗜好モデルを報酬信号として強化学習を行う。これにより、有害なクエリに対しても対話できる無害なAIアシスタントを実現し、AIの意思決定の透明性を向上させる。 Comment
(部分的にしか読めていないが)
有害なpromptに対してLLMに初期の応答を生成させ、iterativeにcritiqueとrevisionを繰り返して[^1]、より無害な応答を生成。この方法ではiterationをしながら生成結果が改定されていくので、後段のReward Modelのための嗜好データを生成するフェーズでトークン量を節約するために、生成されたより無害な応答と元となるpromptを用いて、ベースモデルをSFT。これによりベースモデルの出力分布がより無害な応答をするような方向性に調整され、かつ(iterationを繰り返すことなく)直接的により無害な応答を生成できるようになるのでtoken量が節約できる。このフェーズで学習したモデルをSL-CAIと呼ぶ。
続いて、SL-CAIに対して同様の有害なpromptを入力して、複数の応答を生成させる。生成された応答をMultiple Choice Questionの形式にし、Constitutional Principleに基づくpromptingにより、最も望ましい応答をLLMによって選択させることで、嗜好データを獲得する。この嗜好データ(と人手で定義されたhelpfulnessに基づくデータ)を用いてReward Modelを訓練しRLを実施する。
この手法は、嗜好データを人間がラベリングするのではなく、AIによるフィードバックによりラベリングするため、Reinforcement Learning from AI Feedback (RLAIF)と呼ばれる。
Harmfulness以外の分野にも応用可能と考えられる。
[^1]: この操作はモデルの望ましい挙動を人手で定義したルーブリックに基づいた複数のprompt (Constitutional Principles) を用いて実施される。具体的なpromptはAppendix Cを参照。
[Paper Note] Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#NLP #Alignment #ReinforcementLearning #Safety Issue Date: 2025-09-20 GPT Summary- 言語モデルを無害なアシスタントとして機能させるために、好みのモデル化と人間のフィードバックからの強化学習(RLHF)を用いて微調整を行い、NLP評価での性能向上を実現。毎週新しいフィードバックデータでモデルを更新し、効率的な改善を図る。RLHFトレーニングの堅牢性を調査し、ポリシーと初期化とのKLダイバージェンスの関係を特定。モデルのキャリブレーションや競合目的についても分析し、人間の作家との比較を行った。
[Paper Note] Emergent Abilities of Large Language Models, Jason Wei+, TMLR'22
Paper/Blog Link My Issue
#Analysis #NLP #Selected Papers/Blogs #EmergentAbilities Issue Date: 2025-09-19 GPT Summary- 大規模言語モデルのスケーリングアップは性能を向上させるが、「出現能力」と呼ばれる予測不可能な現象が存在する。これは小型モデルにはない能力であり、さらなるスケーリングがモデルの能力を拡大する可能性を示唆している。 Comment
openreview: https://openreview.net/forum?id=yzkSU5zdwD
創発能力(最近この用語を目にする機会が減ったような気がする)
[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
Paper/Blog Link My Issue
#Pretraining #NLP #ACL #Selected Papers/Blogs #Deduplication Issue Date: 2025-09-04 GPT Summary- 既存の言語モデルデータセットには重複した例が多く含まれ、訓練されたモデルの出力の1%以上が訓練データからコピーされている。これを解決するために、重複排除ツールを開発し、C4データセットからは60,000回以上繰り返される文を削除。重複を排除することで、モデルの記憶されたテキスト出力を10倍減少させ、精度を維持しつつ訓練ステップを削減。また、訓練とテストの重複を減らし、より正確な評価を実現。研究の再現とコードは公開されている。 Comment
下記スライドのp.9にまとめが記述されている:
https://speakerdeck.com/takase/snlp2023-beyond-neural-scaling-laws?slide=9
[Paper Note] StableMoE: Stable Routing Strategy for Mixture of Experts, Damai Dai+, arXiv'22
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #MoE(Mixture-of-Experts) #Stability Issue Date: 2025-09-02 GPT Summary- StableMoEは、ルーティングの変動問題に対処するために2つのトレーニングステージを持つMixture-of-Experts手法を提案。最初のステージで一貫したルーティング戦略を学習し、軽量ルーターに蒸留。第二のステージでそのルーターを用いてエキスパートへの割り当てを固定。言語モデリングと多言語機械翻訳での実験により、StableMoEは収束速度と性能で既存手法を上回ることが示された。 Comment
元ポスト:
[Paper Note] Fast Model Editing at Scale, Eric Mitchell+, ICLR'22
Paper/Blog Link My Issue
#NLP #ICLR #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- MEND(モデル編集ネットワーク)は、事前学習モデルの動作を迅速かつ局所的に編集するための手法で、単一の入力-出力ペアを用いて勾配分解を活用します。これにより、10億以上のパラメータを持つモデルでも、1台のGPUで短時間でトレーニング可能です。実験により、MENDが大規模モデルの編集において効果的であることが示されました。 Comment
OpenReview: https://openreview.net/forum?id=0DcZxeWfOPt
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#NLP #PEFT(Adaptor/LoRA) #ICLR #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#MachineLearning #NLP #NeurIPS #Scaling Laws #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-23 GPT Summary- トランスフォーマー言語モデルの訓練において、計算予算内で最適なモデルサイズとトークン数を調査。モデルサイズと訓練トークン数は同等にスケールする必要があり、倍増するごとにトークン数も倍増すべきと提案。Chinchillaモデルは、Gopherなどの大規模モデルに対して優れた性能を示し、ファインチューニングと推論の計算量を削減。MMLUベンチマークで67.5%の精度を達成し、Gopherに対して7%以上の改善を実現。 Comment
OpenReview: https://openreview.net/forum?id=iBBcRUlOAPR
chinchilla則、モデルの規模とデータ量はおおむね同じ比率でスケールすべき、という話。
[Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #InstructionTuning #EMNLP #PostTraining #KeyPoint Notes Issue Date: 2024-10-29 GPT Summary- NLPモデルの一般化能力を評価するために、1,616の多様なタスクを含むSuper-NaturalInstructionsというベンチマークを導入。76種のタスクタイプをカバーし、モデルをタスクのサブセットで訓練し未見のタスクを評価。Tk-Instructモデルは、InstructGPTを9%以上上回る性能を示し、サイズが小さい。タスク数やインスタンス数に基づいた一般化の分析を行い、本データセットとモデルが汎用的NLPモデルの進展に寄与することを期待。 Comment
7.1, 7.2が最も興味深い
## Instruction Tuningにおける未知のタスクに対する汎化性能について、3つの要素に対するスケーリングについて考察
- More observed tasks improve the generalization.
- A large number of training instances do not help generalization.
- Tuning larger models with instructions consistently lead to gains.
## Instructionをさまざまに変化させた時の性能の変化に対する分析
Table4の対角成分に注目すると(trainとtestのinput encodingを揃えた場合)
- Task definitionをinstructionに含めることで未知タスクに対する汎化性能向上
- Task Definitionとpositive examplesを4つ程度入れると汎化性能向上。
- ただし、これ以上exampleを増やすと性能低下。
- negative examplesを入れることは性能に a little bit しか貢献しない
- explanationsを入れると性能が低下する
Table4の非対角成分に着目すると、
- Task Definitionのみで訓練しても、Example onlyのtest時のencodingには汎化しない(逆も然り)
- Task Definition + examples (今回の場合はpositive examples4つ)は、さまざまなtest時のinput encodingsに対してロバストになる
[Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #InstructionTuning #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-09-25 GPT Summary- 指示チューニングにより言語モデルのゼロショット学習能力を向上。1370億パラメータのモデルを60以上のNLPタスクに対してファインチューニングし、FLANと名付ける。FLANは未調整モデルを超え、25タスク中20タスクで175B GPT-3を上回り、ANLIやRTEなどでfew-shotのGPT-3にも勝る。ファインチューニングデータの数やモデル規模、指示内容が成功の鍵と示される。 Comment
FLAN論文。Instruction Tuningを提案した研究。
openreview: https://openreview.net/forum?id=gEZrGCozdqR
[Paper Note] STaR: Bootstrapping Reasoning With Reasoning, Eric Zelikman+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#NLP #SelfImprovement #NeurIPS #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2024-09-15 GPT Summary- STaR(Self-Taught Reasoner)を提案し、少数の推論例と大規模データセットを用いて段階的に複雑な推論を行う手法を紹介。まず複数の質問に対して推論根拠を生成し、誤答時には正しい解答を前提に再生成を行うことで性能を向上。STaRはファインチューニングにより自己学習能力を持ち、複数のデータセットでの性能を顕著に改善、CommensenseQAでは最先端モデルと同等の結果を達成。 Comment
OpenAI o1関連研究
openreview: https://openreview.net/forum?id=_3ELRdg2sgI
モデルが正解できなかった問題に対して、解答で条件付けした上で推論過程(rationale)を生成することで、finetuning用の追加の学習事例を獲得する。
Training language models to follow instructions with human feedback, Long Ouyang+, N_A, NeurIPS'22
Paper/Blog Link My Issue
#NLP #Alignment #ChatGPT #RLHF #Actor-Critic #PostTraining #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-28 GPT Summary- 大規模な言語モデルは、ユーザーの意図に合わない出力を生成することがあります。本研究では、人間のフィードバックを使用してGPT-3を微調整し、InstructGPTと呼ばれるモデルを提案します。この手法により、13億パラメータのInstructGPTモデルの出力が175BのGPT-3の出力よりも好まれ、真実性の向上と有害な出力の削減が示されました。さらに、一般的なNLPデータセットにおける性能の低下は最小限でした。InstructGPTはまだ改善の余地がありますが、人間のフィードバックを使用した微調整が有望な方向であることを示しています。 Comment
ChatGPTの元となる、SFT→Reward Modelの訓練→RLHFの流れが提案された研究。DemonstrationデータだけでSFTするだけでは、人間の意図したとおりに動作しない問題があったため、人間の意図にAlignするように、Reward Modelを用いたRLHFでSFTの後に追加で学習を実施する。Reward Modelは、175Bモデルは学習が安定しなかった上に、PPOの計算コストが非常に大きいため、6BのGPT-3を様々なNLPタスクでSFTしたモデルをスタートにし、モデルのアウトプットに対して人間がランキング付けしたデータをペアワイズのloss functionで訓練した。最終的に、RMのスコアが最大化されるようにSFTしたGPT-3をRLHFで訓練するが、その際に、SFTから出力が離れすぎないようにする項と、NLPベンチマークでの性能が劣化しないようにpretrain時のタスクの性能もloss functionに加えている。
Recommendation as Language Processing (RLP): A Unified Pretrain, Personalized Prompt & Predict Paradigm (P5), Shijie Geng+, N_A, RecSys'22
Paper/Blog Link My Issue
#RecommenderSystems #Zero/Few/ManyShotPrompting #InstructionTuning #Finetuning #KeyPoint Notes Issue Date: 2023-11-12 GPT Summary- 我々は「Pretrain, Personalized Prompt, and Predict Paradigm」(P5)と呼ばれる柔軟で統一されたテキストからテキストへのパラダイムを提案します。P5は、共有フレームワーク内でさまざまな推薦タスクを統一し、個別化と推薦のための深い意味を捉えることができます。P5は、異なるタスクを学習するための同じ言語モデリング目標を持つ事前学習を行います。P5は、浅いモデルから深いモデルへと進化し、広範な微調整の必要性を減らすことができます。P5の効果を実証するために、いくつかの推薦ベンチマークで実験を行いました。 Comment
# 概要
T5 のように、様々な推薦タスクを、「Prompt + Prediction」のpipelineとして定義して解けるようにした研究。
P5ではencoder-decoder frameworkを採用しており、encoder側ではbidirectionalなモデルでpromptのrepresentationを生成し、auto-regressiveな言語モデルで生成を行う。
推薦で利用したいデータセットから、input-target pairsを生成し上記アーキテクチャに対して事前学習することで、推薦を実現できる。
RatingPredictionでは、MatrixFactorizationに勝てていない(が、Rating Predictionについては魔法の壁問題などもあると思うのでなんともいえない。)
Sequential RecommendationではBERT4Recとかにも勝てている模様。
# Prompt例
- Rating Predictionの例
- Sequential Recommendationの例
- Explanationを生成する例
- Zero-shotの例(Cold-Start)
[Paper Note] Explaining Patterns in Data with Language Models via Interpretable Autoprompting, Chandan Singh+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Dataset #DataToTextGeneration #Explanation #One-Line Notes #Data Issue Date: 2023-08-03 GPT Summary- iPromptを用いて、事前学習済みのLLMがデータを説明する自然言語文字列を生成する手法を提案。このアルゴリズムは、生成された説明の性能を再評価して最適化するプロセスを含む。実験によりiPromptが正確なデータ記述を見つけ、人間にも解釈可能なプロンプトを生成し、一般化性能に優れることが示された。特に、実世界の感情分類データセットでGPT-3並みのプロンプトを生成し、科学的発見の支援にも寄与する可能性がある。すべてのコードはGitHubで公開。 Comment
OpenReview: https://openreview.net/forum?id=GvMuB-YsiK6
データセット(中に存在するパターンの説明)をLLMによって生成させる研究


[Paper Note] RQUGE: Reference-Free Metric for Evaluating Question Generation by Answering the Question, Alireza Mohammadshahi+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Metrics #NLP #QuestionAnswering #Evaluation #Reference-free #ACL #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- 既存の質問評価指標には、人間の参照質問との比較による語彙的重複や意味的類似性に基づく欠点がある。これに対し、本研究で提案する新しい指標RQUGEは、候補質問の文脈に基づく回答可能性を評価し、人間の判断と高い相関を示す。この指標は既存の事前学習モデルを活用し、追加訓練なしで使用可能。また、RQUGEは対抗的改ざんに対して堅牢であり、質問生成モデルからの合成データを用いた微調整により、QAモデルの性能を向上させることができる。 Comment
# 概要
質問自動生成の性能指標(e.g. ROUGE, BERTScore)は、表層の一致、あるいは意味が一致した場合にハイスコアを与えるが、以下の欠点がある
- 人手で作成された大量のreference questionが必要
- 表層あるいは意味的に近くないが正しいquestionに対して、ペナルティが与えられてしまう
=> contextに対するanswerabilityによって評価するメトリック RQUGE を提案
similarity basedな指標では、Q1のような正しい質問でもlexical overlapがないと低いスコアを与えてしまう。また、Q2のようなreferenceの言い換えであっても、低いスコアとなってしまう。一方、reference basedな手法では、Q3のようにunacceptableになっているにもかかわらず、変化が微小であるためそれをとらえられないという問題がある。
# 手法概要
提案手法ではcontextとanswer spanが与えられたとき、Span Scorerと、QAモジュールを利用してacceptability scoreを計算することでreference-freeなmetricを実現する。
QAモデルは、Contextと生成されたQuestionに基づき、answer spanを予測する。提案手法ではT5ベースの手法であるUnifiedQAv2を利用する。
Span Scorer Moduleでは、予測されたanswer span, candidate question, context, gold spanに基づき、[1, 5]のスコアを予測する。提案手法では、encoder-only BERT-based model(提案手法ではRoBERTa)を用いる。
[Paper Note] Pruning Pre-trained Language Models Without Fine-Tuning, Ting Jiang+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NLP #Pruning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- プルーニングによる事前学習済み言語モデル(PLMs)の圧縮手法を提案。特にStatic Model Pruning(SMP)は、一階法の剪定のみでPLMsを下流タスクに適応させ、スパース性を達成。新たなマスキング関数と訓練目的関数を設計し、広範な実験で顕著な性能向上を示す。SMPはファインチューニングを不要とし、パラメータ効率が良好。
[Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- HELMは、言語モデルの透明性を高めるための包括的評価手法である。まず、潜在的なシナリオと指標の分類を行い、欠落している部分を特定。次に、マルチ指標アプローチを採用し、コアシナリオごとに7つの評価指標を測定することで、正確性以外の側面も考慮。さらに、30の著名な言語モデルに対して大規模評価を実施し、評価範囲を17.9%から96.0%に改善。全データを公開し、HELMをコミュニティの生きたベンチマークとして継続的に更新していくことを目指している。 Comment
OpenReview: https://openreview.net/forum?id=iO4LZibEqW
HELMを提案した研究
当時のLeaderboardは既にdeprecatedであり、現在は下記を参照:
https://crfm.stanford.edu/helm/
[Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- 言語モデルはスケールの拡大に伴い、新しい定量的・質的能力を示すが、その具体的な特性は未解明である。これを踏まえ、BIG-benchという新たなベンチマークを導入し、204の多様なタスクを評価。モデルの性能と較正は改善するが、絶対的には低く、スパース性の影響を受ける場合もある。特に、複数の手順を要するタスクは臨界規模での“ブレークスルー”を示す傾向があり、社会的バイアスは通常、スケールと共に増加するが、プロンプトによって改善可能である。 Comment
OpenReview: https://openreview.net/forum?id=uyTL5Bvosj
BIG-Bench論文。ワードクラウドとキーワード分布を見ると一つの分野に留まらない非常に多様なタスクが含まれることがわかる。
BIG-Bench-hardは、2024年にClaude3.5によって、Average Human Scoreが67.7%のところ、93.1%を達成され攻略が完了した。現在は最先端のモデル間の性能を差別化することはできない。
- Killed by LLM, R0bk
[Paper Note] Out of One, Many: Using Language Models to Simulate Human Samples, Lisa P. Argyle+, arXiv'22, 2022.09
Paper/Blog Link My Issue
#Analysis #needs-revision Issue Date: 2023-05-11 GPT Summary- 言語モデルが社会科学研究における特定の人間サブ集団の有効な代理として機能する可能性を検討。バイアスの問題に対し、アルゴリズム的忠実性を提案し、モデルが人口統計に基づく応答分布を正確に模倣できることを示す。GPT-3の性能を実際の人間から得たデータと比較することで、表面的な類似を超えた複雑な相互作用を反映していることを明らかにし、言語モデルが人間と社会の理解を深める強力なツールとなる可能性を示唆する。
[Paper Note] Mass-Editing Memory in a Transformer, Kevin Meng+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NLP #ICLR #KnowledgeEditing #needs-revision Issue Date: 2023-05-04 GPT Summary- 最近の研究は、大規模言語モデルの更新に新たな記憶を利用する可能性を示しているが、主に単一の関連付けに限定されています。我々はMEMITを開発し、複数の記憶を使ってモデルを直接更新する手法を提案します。実験的に、GPT-J(6B)およびGPT-NeoX(20B)に対して多数の関連付けを効果的に処理できることを示し、従来の方法を大幅に上回る成果を達成しました。
[Paper Note] Large Language Models are Zero-Shot Reasoners, Takeshi Kojima+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)は自然言語処理において少数ショット学習の能力が高く、CoT promptingにより複雑な多段階推論を効果的に引き出す。特に「Let's think step by step」の追加で、ゼロショット推論能力が向上し、様々な論理推論タスクで手作りの例を使わずに性能を大幅に向上させた。例えば、InstructGPTモデルでのMultiArithの精度が17.7%から78.7%へ、GSM8Kが10.4%から40.7%と劇的な改善が見られた。この研究はLLMsの潜在的なゼロショット能力を示し、ファインチューニングや少数ショットの前にその知識を探求する重要性が強調されている。 Comment
Zero-Shot CoT (Let's think step-by-step.)論文

Zero-Shot-CoTは2つのステップで構成される:
- STEP1: Reasoning Extraction
- 元のquestionをxとし、zero-shot-CoTのtrigger sentenceをtとした時に、テンプレート "Q: [X]. A. [T]" を用いてprompt x'を作成
- このprompt x'によって得られる生成テキストzはreasoningのrationaleとなっている。
- STEP2: Answer Extraction
- STEP1で得られたx'とzを用いて、テンプレート "[X'] [Z] [A]" を用いてpromptを作成し、quiestionに対する回答を得る
- このとき、Aは回答を抽出するためのtrigger sentenceである。
- Aはタスクに応じて変更するのが効果的であり、たとえば、multi-choice QAでは "Therefore, among A through E, the answer is" といったトリガーを用いたり、数学の問題では "Therefore, the answer (arabic numerals) is" といったトリガーを用いる。
# 実験結果
表中の性能指標の左側はタスクごとにAnswer Triggerをカスタマイズしたもので、右側はシンプルに"The answer is"をAnswer Triggerとした場合。Zero-shot vs. Zero-shot-CoTでは、Zero-Shot-CoTが多くのb現地マークにおいて高い性能を示している。ただし、commonsense reasoningではperformance gainを得られなかった。これは [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
で報告されている通り、commonsense reasoningタスクでは、Few-Shot CoTでもLambda135Bで性能が向上せず、Palm540Bで性能が向上したように、モデルのparameter数が足りていない可能性がある(本実験では17種類のモデルを用いているが、特に注釈がなければtext-davinci-002を利用した結果)。
## 他ベースラインとの比較
他のベースラインとarithmetic reasoning benchmarkで性能比較した結果。Few-Shot-CoTには勝てていないが、standard Few-shot Promptingtを大幅に上回っている。
## zero-shot reasoningにおけるモデルサイズの影響
さまざまな言語モデルに対して、zero-shotとzero-shot-CoTを実施した場合の性能比較。[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
と同様にモデルサイズが小さいとZero-shot-CoTによるgainは得られないが、モデルサイズが大きくなると一気にgainが大きくなる。
## Zero-shot CoTにおけるpromptの選択による影響
input promptに対するロバスト性を確認した。instructiveカテゴリ(すなわち、CoTを促すトリガーであれば)性能が改善している。特に、どのようなsentenceのトリガーにするかで性能が大きくかわっている。今回の実験では、"Let's think step by step"が最も高い性能を占め最多。
## Few-shot CoTのprompt選択における影響
CommonsenseQAのexampleを用いて、AQUA-RAT, MultiArithをFew-shot CoTで解いた場合の性能。どちらのケースもドメインは異なるが、前者は回答のフォーマットは共通である。異なるドメインでも、answer format(multiple choice)の場合、ドメインが異なるにもかかわらず、zero-shotと比較して性能が大幅に向上した。一方、answer formatが異なる場合はperformance gainが小さい。このことから、LLMはtask自体よりも、exampleにおけるrepeated formatを活用していることを示唆している。また、CommonSennseをExamplarとして用いたFew-Shot-CoTでは、どちらのデータセットでもZero-Shot-CoTよりも性能が劣化している。つまり、Few-Shot-CoTでは、タスク特有のサンプルエンジニアリングが必要であることがわかる(一方、Zero-shot CoTではそのようなエンジニアリングは必要ない)。
[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
Paper/Blog Link My Issue
#NLP #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes #EmergentAbilities Issue Date: 2023-04-27 GPT Summary- 思考の連鎖によって、大規模言語モデルの推論能力が向上することを探求。チェーン・オブ・ソート思考のプロンプトを用いる事例を示し、3つのモデルでの実験を通じて算術や常識、象徴的推論において性能向上を確認。特に、5400億パラメータのモデルに8つのデモをプロンプトとして与えただけで、数学問題のGSM8Kベンチマークで最先端の精度を達成した。 Comment
Chain-of-Thoughtを提案した論文。CoTをする上でパラメータ数が100B未満のモデルではあまり効果が発揮されないということは念頭に置いた方が良さそう。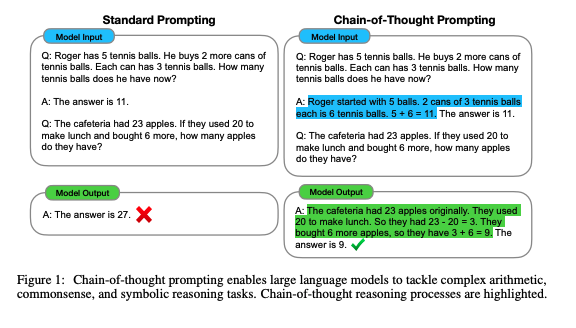
先行研究では、reasoningが必要なタスクの性能が低い問題をintermediate stepを明示的に作成し、pre-trainedモデルをfinetuningすることで解決していた。しかしこの方法では、finetuning用の高品質なrationaleが記述された大規模データを準備するのに多大なコストがかかるという問題があった。
このため、few-shot promptingによってこの問題を解決することが考えられるが、reasoning能力が必要なタスクでは性能が悪いという問題あがった。そこで、両者の強みを組み合わせた手法として、chain-of-thought promptingは提案された。
# CoTによる実験結果
以下のベンチマークを利用
- math word problem: GSM8K, SVAMP, ASDiv, AQuA, MAWPS
- commonsense reasoning: CSQA, StrategyQA, Big-bench Effort (Date, Sports), SayCan
- Symbolic Reasoning: Last Letter concatenation, Coin Flip
- Last Letter concatnation: 名前の単語のlast wordをconcatするタスク("Amy Brown" -> "yn")
- Coin Flip: コインをひっくり返す、 あるいはひっくり返さない動作の記述の後に、コインが表向きであるかどうかをモデルに回答するよう求めるタスク
## math word problem benchmark
- モデルのサイズが大きくなるにつれ性能が大きく向上(emergent ability)することがあることがわかる
- 言い換えるとCoTは<100Bのモデルではパフォーマンスに対してインパクトを与えない
- モデルサイズが小さいと、誤ったCoTを生成してしまうため
- 複雑な問題になればなるほど、CoTによる恩恵が大きい
- ベースラインの性能が最も低かったGSM8Kでは、パフォーマンスの2倍向上しており、1 stepのreasoningで解決できるSingleOpやMAWPSでは、性能の向上幅が小さい
- Task specificなモデルをfinetuningした以前のSoTAと比較してcomparable, あるいはoutperformしている
- 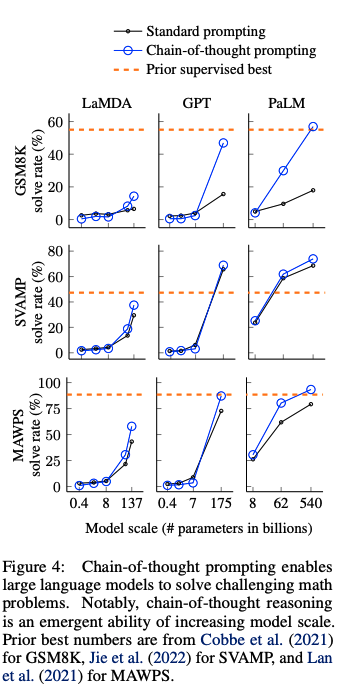
## Ablation Study
CoTではなく、他のタイプのpromptingでも同じような効果が得られるのではないか?という疑問に回答するために、3つのpromptingを実施し、CoTと性能比較した:
- Equation Only: 回答するまえに数式を記載するようなprompt
- promptの中に数式が書かれているから性能改善されているのでは?という疑問に対する検証
- => GSM8Kによる結果を見ると、equation onlyでは性能が低かった。これは、これは数式だけでreasoning stepsを表現できないことに起因している
- Variable compute only: dotのsequence (...) のみのprompt
- CoTは難しい問題に対してより多くの計算(intermediate token)をすることができているからでは?という疑問に対する検証
- variable computationとCoTの影響を分離するために、dotのsequence (...) のみでpromptingする方法を検証
- => 結果はbaselineと性能変わらず。このことから、variableの計算自体が性能向上に寄与しているわけではないことがわかる。
- Chain of Thought after answer: 回答の後にCoTを出力するようなprompting
- 単にpretrainingの際のrelevantな知識にアクセスしやすくなっているだけなのでは?という疑問を検証
- => baselineと性能は変わらず、単に知識を活性化させるだけでは性能が向上しないことがわかる。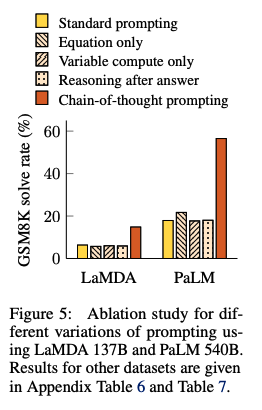
## CoTのロバスト性
人間のAnnotatorにCoTを作成させ、それらを利用したCoTpromptingとexamplarベースな手法によって性能がどれだけ変わるかを検証。standard promptingを全ての場合で上回る性能を獲得した。このことから、linguisticなstyleにCoTは影響を受けていないことがわかる。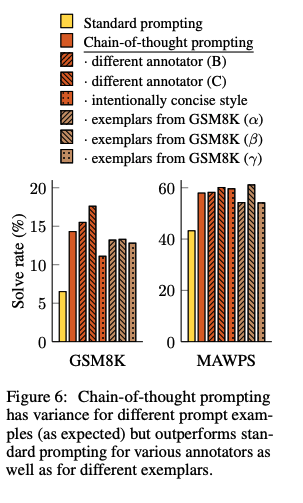
# commonsense reasoning
全てのデータセットにおいて、CoTがstandard promptingをoutperformした。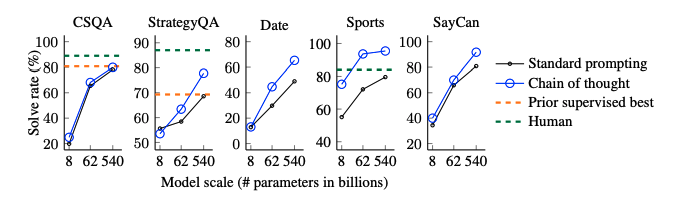
# Symbolic Reasoning
in-domain test setとout-of-domain test setの2種類を用意した。前者は必要なreasoning stepがfew-shot examplarと同一のもの、後者は必要なreasoning stepがfew-shot examplarよりも多いものである。
CoTがStandard proimptingを上回っている。特に、standard promptingではOOV test setではモデルをスケールさせても性能が向上しなかったのに対し、CoTではより大きなgainを得ている。このことから、CoTにはreasoning stepのlengthに対しても汎化能力があることがわかる。
[Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
Paper/Blog Link My Issue
#NLP #LongContext #NeurIPS #memory #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- メモリ機構を持つセグメントレベル再帰型トランスフォーマー(RMT)を提案。局所情報と全体情報を保存・処理し、長いシーケンス間で情報を伝達可能。特別なメモリトークンを追加することでTransformerモデルに変更を加えずに実装。実験結果では、RMTは短いメモリサイズでもTransformer-XLと同等の性能を示し、長いシーケンス処理では優れていることが確認。再帰的メモリトランスフォーマーは長期依存関係の学習に対する有望なアーキテクチャ。 Comment
TransformerはO(N^2)であり、計算量がNに応じて指数関数的に増加してしまう。一方、sequenceの情報を全てN次元ベクトルに集約しなければならず、計算量の制約によって長い系列のRepresentationを獲得できない。
そこで、Transformerの構造は変えず、Inputにメモリtokenを追加することで、メモリ間の関係性を学習できるような手法を提案。長いトークン列に対しても、トークン列をセグメントとゆばれる単位に区切り、セグメントのInputの頭で、前断のセグメントのメモリtokenを入力し、最終的に現在のセグメントのメモリをoutputし、後断のセグメントに入力とする、といったことを繰り返すことで、長い系列も扱えるようにした。
セグメントをまたいでbackpropagationをかけることで、たとえセグメントとしては独立していても、メモリの情報を考慮することでセグメント間の依存関係を学習することが可能だと思われる。
openreview: https://openreview.net/forum?id=Uynr3iPhksa
[Paper Note] Are Transformers Effective for Time Series Forecasting?, Ailing Zeng+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#TimeSeriesDataProcessing #MachineLearning #Transformer #One-Line Notes Issue Date: 2022-12-29 GPT Summary- LTSFタスクに対するTransformer解法の妥当性を疑問視し、単純な1層線形モデル(LTSF-Linear)が既存のTransformerモデルを全ケースで上回る結果を示す。時間的関係の抽出における要素の影響を詳細に分析し、新たな研究の方向性を提案。将来的には他の時系列分析にもアプローチを見直すことを提唱。 Comment
Linear Layerに基づくシンプルな手法がTransformerベースの手法に時系列予測で勝ったという話
[Paper Note] UnifiedSKG: Unifying and Multi-Tasking Structured Knowledge Grounding with Text-to-Text Language Models, Tianbao Xie+, EMNLP'22, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #NLP #MultitaskLearning #PEFT(Adaptor/LoRA) #EMNLP #Encoder-Decoder #Grounding Issue Date: 2022-12-05 GPT Summary- UnifiedSKGフレームワークを提案し、21の構造化知識のグラウンディング(SKG)タスクをテキスト対テキスト形式に統合。これにより、体系的なSKG研究を促進し、異なるサイズのT5で最先端の性能を達成。マルチタスクチューニングが性能向上に寄与し、SKGのゼロショットおよび少数ショット学習における課題を示した。UnifiedSKGは他のタスクへの拡張も可能で、オープンソースとして公開されている。
[Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
Paper/Blog Link My Issue
#NLP #One-Line Notes #Scalability Issue Date: 2026-07-09 GPT Summary- 言語モデリングは大規模な知識リポジトリを活用し、世界の理解を深化させる。本研究では、数千万から2,800億パラメータのTransformerベースのモデルGopherの性能を分析し、152の多様なタスクで最先端を達成。特に、読解や事実確認でスケールの利得が大きいが、論理的推論には限界がある。モデルの挙動やばイアス、危害の交差を総合的に評価し、AIの安全性に向けた適用と害の軽減についても考察。 Comment
- [Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
- 大規模言語モデルの次期バージョンPLaMo 3シリーズにおける120B事前学習モデル、31B蒸留モデルの評価, PFN, 2026.07
で利用されている weight reusingについて、`G3.3 Warm starting` に記載されている。概要としては
- LLMのキャパシティを増大させる際に、幅をスケーリングさせるよりも、深さをスケーリングさせる方が有望な結果となった
### 深さのスケーリング方法のbest practice
- 深さをスケーリングさせる、すなわち、5 layer -> 7 layerに拡張したい、という場合は、元の学習済みレイヤーを以下のルールによって複製することによって、拡張する:
- `round_int(range(num_layers_new)/num_layers_new * num_layers_old)`
- たとえば、`A B C D E` の5つのレイヤーで構成されているモデルがあったときに、これを7 layerに拡張したい場合は、上記indexに従って7つのレイヤーに学習済みレイヤーを割り当てると、`A B B C D D E` となる。
### 幅のスケーリング方法のbest practice
- (widthの拡張方法については正しく読めているかかなり自信がなく、間違っている可能性が非常に高いので注意)
- 幅をスケーリングさせる際は、MHA の weight matrices に対して列方向のコピー→行方向のコピー→ ノイズの注入を行う。
- 前提として以下を考える:
- MHAのQKV, outputのprojectionをそれぞれ、`W_q \in R^{d_model \times d_k}`, `W_k \in R^{d_model \times d_k}`, `W_v \in R^{d_model \times d_v}`, `W_o \in R^{h d_v \times d_model}` とする。
- このとき、オリジナルのtransformer論文では、`d_k = d_v = d_model/h` としている。
- つまり、各headに対応するW_{q, k, v, o}を列方向にconcatした行列 W^concat_{q, k, v, o}を考えると、列方向がh倍されるので、`W^concat_{q, k, v, o} \in R^{d_model \times d_model}` の正方行列で表現できる。ここで、`h * d_v= h * d_k= h * d_model/h = d_model` を用いた。
- この `W^{concat}_{*}` に対する操作を定義することで、multihead attentionが扱う幅を変更することができる。
- 元論文では、weight matricesと一言で言及されているが、これは(おそらく)`W^{concat}_{q, k, v, o}` のことを指していると思われる。実際、説明をする際は正方行列を前提に考えている(attention headごとに独立して考える元論文の数式では正方行列は weight matrices に出現しない)。
- まず `W^{concat}_{*}` において、head sizeをH, head数をnとしたときに、`nH \times nH` の行列を列方向にtilingすることによってattention headの数をmに拡張する。このとき、`d_k`, `d_v` のサイズは固定する。たとえば、head数をnからmに増やす際、最初のm-n個のheadを `W^{concat}_{*}` の右側に複製することによって拡張する、と説明されている。
- これはすなわち、個々のheadが扱う情報量は変化させずに、代わりにhead数を増やすことでスケーリングさせる、ということを指していると考えられる。
- 続いて、head数が増えたことによって `W^{concat}_{*}` が正方行列ではなくなった。これが正方行列になっていないとattentionの前後でbottleneck activation size(元論文ではd_modelのことをbottleneck activation sizeと呼称している)が変化してしまうので、正方行列にしなければならない。
- これを正方行列にするために、列方向に複製した行列の上端から数えて `(m-n) * d_k` 行分を行方向にconcatする。
- 最終的に、新たに初期化された重みに対してノイズを注入する。
- これによって構築された `W^{concat}_{*}` を図示したものが、下記Figure A32 と思われる。
- また、上記ではMHAの説明をしたが、MLPなどのd_modelが関わる各種weight matricesもwidthの拡張に含まれていると考えられる(じゃないとwidthの拡張と呼べないし)。
- optimizerの状態は再初期化して学習を実施する。
- Adam optimizerの状態に対して似たような処理を実施したが性能向上にはつながらなかった
[Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #read-later #Selected Papers/Blogs #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形化された自己注意機構とファストウェイト・コントローラの等価性を示し、遅いニューラルネットがファストウェイトをプログラムする方法を探る。FWPは有限メモリの操作を学習し、注意機構のメモリ容量限界を改善するために、加法的外積を用いたプログラミング命令を導入。動的学習率の計算も学習し、新しいカーネル関数を提案。合成リトリーバル問題や機械翻訳、言語モデリングタスクにおける利点を実験で示した。 Comment
Linear TransformerにおけるKV^Tを加算する固定された状態更新ではなく、差分だけを更新するDelta Ruleによって更新する Delta Networkを提案。
(まだ全然読めていないのでしっかり読みたい)
DeltaNet図解:
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Architecture #Selected Papers/Blogs #ActivationFunction #One-Line Notes Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Transformer #NeurIPS #read-later #HyperparameterTransfer #One-Line Notes Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
[Paper Note] Program Synthesis with Large Language Models, Jacob Austin+, arXiv'21
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- 本論文では、汎用プログラミング言語におけるプログラム合成の限界を大規模言語モデルを用いて評価します。MBPPとMathQA-Pythonの2つのベンチマークで、モデルサイズに対する合成性能のスケールを調査。最も大きなモデルは、少数ショット学習でMBPPの59.6%の問題を解決可能で、ファインチューニングにより約10%の性能向上が見られました。MathQA-Pythonでは、ファインチューニングされたモデルが83.8%の精度を達成。人間のフィードバックを取り入れることでエラー率が半減し、エラー分析を通じてモデルの弱点を明らかにしました。最終的に、プログラム実行結果の予測能力を探るも、最良のモデルでも特定の入力に対する出力予測が困難であることが示されました。 Comment
代表的なコード生成のベンチマーク。
MBPPデータセットは、promptで指示されたコードをモデルに生成させ、テストコード(assertion)を通過するか否かで評価する。974サンプル存在し、pythonの基礎を持つクラウドワーカーによって生成。クラウドワーカーにタスクdescriptionとタスクを実施する一つの関数(関数のみで実行可能でprintは不可)、3つのテストケースを記述するよう依頼。タスクdescriptionは追加なclarificationなしでコードが記述できるよう十分な情報を含むよう記述するように指示。ground truthの関数を生成する際に、webを閲覧することを許可した。
MathQA-Pythonは、MathQAに含まれるQAのうち解答が数値のもののみにフィルタリングしたデータセットで、合計で23914サンプル存在する。pythonコードで与えられた数学に関する問題を解くコードを書き、数値が一致するか否かで評価する、といった感じな模様。斜め読みなので少し読み違えているかもしれない。
[Paper Note] Evaluating Large Language Models Trained on Code, Mark Chen+, arXiv'21
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- CodexはGitHubのコードでファインチューニングされたGPT言語モデルで、Pythonコード生成能力を評価。新しい評価セットHumanEvalでは、Codexが28.8%の問題を解決し、GPT-3は0%、GPT-Jは11.4%だった。繰り返しサンプリングが難しいプロンプトに対しても効果的な戦略を用い、70.2%の問題を解決。モデルの限界として、長い操作の説明や変数へのバインドに苦労する点が明らかに。最後に、コード生成技術の影響について安全性や経済に関する議論を行う。 Comment
HumanEvalデータセット。Killed by LLMによると、GPT4oによりすでに90%程度の性能が達成され飽和している。
164個の人手で記述されたprogrammingの問題で、それぞれはfunction signature, docstring, body, unittestを持つ。unittestは問題当たり約7.7 test存在。handwrittenという点がミソで、コンタミネーションの懸念があるためgithubのような既存ソースからのコピーなどはしていない。pass@k[^1]で評価。
[^1]: k個のサンプルを生成させ、k個のサンプルのうち、サンプルがunittestを一つでも通過する確率。ただ、本研究ではよりバイアスをなくすために、kよりも大きいn個のサンプルを生成し、その中からランダムにk個を選択して確率を推定するようなアプローチを実施している。2.1節を参照のこと。
[Paper Note] Editing Factual Knowledge in Language Models, Nicola De Cao+, EMNLP'21
Paper/Blog Link My Issue
#NLP #EMNLP #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- KnowledgeEditorは、事前学習された言語モデルの知識を編集し、再学習なしで誤った事実や予測を修正する手法です。制約最適化を用いてハイパーネットワークを訓練し、他の知識に影響を与えずに事実を修正します。BERTとBARTのモデルでその有効性を示し、特定のクエリに基づく予測変更がパラフレーズにも一貫して影響を与えることを確認しました。ハイパーネットワークは、知識操作に必要なコンポーネントを特定する「プローブ」として機能します。
[Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
Paper/Blog Link My Issue
#NLP #Dataset #Supervised-FineTuning (SFT) #Mathematics #Selected Papers/Blogs #Verification #needs-revision Issue Date: 2024-12-27 GPT Summary- 最先端の言語モデルは数学的推論に課題があり、GSM8Kという8,500件の小学生向け数学問題データセットを導入してその失敗を診断。特に、最大規模のトランスフォーマーモデルでも性能向上が難しいことを示す。モデルの補完の正しさを評価する検証器を訓練し、候補解を生成して最も高く評価されたものを選択する方法を提案。検証がGSM8Kの性能を大幅に向上させ、ファインチューニングよりも効果的にスケールすることを実証。 Comment
## 気持ち
- 当時の最も大きいレベルのモデルでも multi-stepのreasoningが必要な問題は失敗する
- モデルをFinetuningをしても致命的なミスが含まれる
- 特に、数学は個々のミスに対して非常にsensitiveであり、一回ミスをして異なる解法のパスに入ってしまうと、self-correctionするメカニズムがauto-regressiveなモデルではうまくいかない
- 純粋なテキスト生成の枠組みでそれなりの性能に到達しようとすると、とんでもないパラメータ数が必要になり、より良いscaling lawを示す手法を模索する必要がある
## Contribution
論文の貢献は
- GSM8Kを提案し、
- verifierを活用しモデルの複数の候補の中から良い候補を選ぶフレームワークによって、モデルのパラメータを30倍にしたのと同等のパフォーマンスを達成し、データを増やすとverifierを導入するとよりよく性能がスケールすることを示した。
- また、dropoutが非常に強い正則化作用を促し、finetuningとverificationの双方を大きく改善することを示した。
Todo: 続きをまとめる
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #One-Line Notes Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#NLP #Transformer #PositionalEncoding #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- 位置エンコーディングはトランスフォーマーにおいて重要な役割を果たし、依存関係をモデル化するための監督信号を提供する。本研究では、トランスフォーマーに位置情報を組み込む手法を検討し、新たに提案するロータリーポジションエンベディング(RoPE)が絶対位置を回転行列でエンコードして相対位置依存性を取り入れることを示す。RoPEはシーケンス長の柔軟性や相対距離の増加に伴う依存性の減衰などの特性を持ち、強化済みトランスフォーマー(RoFormer)の評価は他の手法を一貫して上回ることを示している。RoFormerはHuggingfaceに統合済み。 Comment
RoPEを提案した論文
# Absolute Position Embedding と Relative Position Embedding
## TransformerにおけるQKVベクトルの計算方法
一般に、Transformerにおける Query (Q), Key (K), Value (V) は以下の式で定式化される:
m, nはそれぞれ位置を表す整数。Absolute Position Embeddingと、Relative Position Embeddingは、関数fの設計がそれぞれ異なっている:
## Absolute Position Embedding
absolute position embeddingは、固定されたposition ベクトル、あるいはtrainableなposition ベクトルpを、入力ベクトルに対して足し合わせる:
## Relative Position Embedding
一方、Relative Position Embeddingは、Queryの位置に対する、Key, Valueの相対位置(つまり、mとnの差)に対して、trainableなベクトル \tilde{p}_r をKey, Valueおよび相対距離rごとに用意し、そのベクトルを入力に足し合わせる、という定式化となっている:
ここで、r = clip(m-n, r_max, r_min)であり、r_max, r_minは考慮する相対距離の最大値と最小値である。
他にも様々な定式化が提案されているがたいてい定式化の中に相対位置m-nが出現する。
## RoPE
RoPEでは、入力Query, Keyベクトル(Q,K)に対して回転行列を適用することで、回転に対して位置情報を保持させる。具体的には、異なる位置m, nに対するq_m^T k_nを計算すると、回転行列をRとした場合式16に示されているように回転行列Rに相対位置m-nが現れ(るように設計されており)、相対位置を考慮したqkの計算になっている。[^1]
[^1]: (R_mq_m)^T R_nK_n = q_m^T (R_m^T R_n) k_n = q_m^T (R_{-m}R_n) k_n = q_m^T R_{n-m} k_n. ここで、R_m^T = R_{-m}であり、R_m R_n = R_{m+n}の性質を使っている。
RoPEは下記のような性質を持つ:
- long-term decay: θi = 10000−2i/d と設定することにより、相対位置が離れているトークンのベクトルとのinner productの値が小さくなる。すなわち、位置が離れているトークン間の依存関係が小さくなる。
- Linear-Attention: RoPEは回転行列であり、乗算後のベクトルのノルムを変化させない。このため、Linear Attentionの式の中に回転行列を組み込むことで、Linear Attentionと簡単に組み合わせることが可能
Absolute Position Embedding, Relative Position Embeddingでは、ベクトルに対して位置情報を加算する定式化で K, Vの計算時に位置情報を考慮していたため、Linear Attentionの計算そのものに位置情報を組み込んだ定式化とはなっていなかった。
が、RoPEでは回転行列を乗算する定式化であり、ノルムを変化させないのでLinear Attentionの定式化に組み込むことができる。このため、モデルのアーキテクチャを大きく変更しなくとも組み込める。
すなわち、Vanilla TransformerのEmbedding lookup後のpositional embeddingを加算するモジュールが無くなり、positional encodingがattentionの計算の中に取り込まれる。
RoPE自体は実装にパラメータを必要としないが、モデルのその他のパラメータがRoPEに適用できるように学習されていないと適用できないであろう点には注意(事前学習時にRoPEが使われていれば話は別)。
- 国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
pp.22--23がRoPEを簡潔に説明しており分かりやすい
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #Pretraining #NLP #Transformer #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
[Paper Note] SimCSE: Simple Contrastive Learning of Sentence Embeddings, Tianyu Gao+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#Sentence #Embeddings #NLP #RepresentationLearning #ContrastiveLearning #Catastrophic Forgetting #EMNLP #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-07-27 GPT Summary- SimCSEは、文の埋め込み表現を向上させる単純な対照学習フレームワークです。教師なしアプローチでは、入力文が自身を予測し、ドロップアウトがノイズとして機能します。この手法は従来の教師あり方法と同等の成果を上げ、ドロップアウトを除去すると表現の質が低下することが分かりました。また、教師付きアプローチでは、自然言語推論データセットからの注釈付きペアを活用し、対照学習に組み込みます。評価結果では、教師なしモデルが76.3%、教師ありモデルが81.6%のSpearmanの相関を達成し、既存のベスト結果をそれぞれ改善しました。対照学習の目的が埋め込みの空間の正則化に貢献することも示されました。 Comment
[Paper Note] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, Nils Reimers+, arXiv'19, 2019.08 よりも性能良く、unsupervisedでも学習できる。STSタスクのベースラインにだいたい入ってる
# 手法概要
Contrastive Learningを活用して、unsupervised/supervisedに学習を実施する。
Unsupervised SimCSEでは、あるsentenceをencoderに2回入力し、それぞれにdropoutを適用させることで、positive pairを作成する。dropoutによって共通のembeddingから異なる要素がマスクされた(noiseが混ざった状態とみなせる)類似したembeddingが作成され、ある種のdata augmentationによって正例を作成しているともいえる。負例はnegative samplingする。(非常にsimpleだが、next sentence predictionで学習するより性能が良くなる)
Supervised SimCSEでは、アノテーションされたsentence pairに基づいて、正例・負例を決定する。本研究では、NLIのデータセットにおいて、entailment関係にあるものは正例として扱う。contradictions(矛盾)関係にあるものは負例として扱う。
# Siamese Networkで用いられるmeans-squared errrorとContrastiveObjectiveの違い
どちらもペアワイズで比較するという点では一緒だが、ContrastiveObjectiveは正例と近づいたとき、負例と遠ざかったときにlossが小さくなるような定式化がされている点が異なる。
(画像はこのブログから引用。ありがとうございます。
https://techblog.cccmk.co.jp/entry/2022/08/30/163625)
# Unsupervised SimCSEの実験
異なるdata augmentation手法と比較した結果、dropoutを適用する手法の方が性能が高かった。MLMや, deletion, 類義語への置き換え等よりも高い性能を獲得しているのは興味深い。また、Next Sentence Predictionと比較しても、高い性能を達成。Next Sentence Predictionは、word deletion等のほぼ類似したテキストから直接的に類似関係にあるペアから学習するというより、Sentenceの意味内容のつながりに基づいてモデルの言語理解能力を向上させ、そのうえで類似度を測るという間接的な手法だが、word deletionに負けている。一方、dropoutを適用するだけの(直接的に類似ペアから学習する)本手法はより高い性能を示している。
[image](https://github.com/AkihikoWatanabe/paper_notes/assets/12249301/0ea3549e-3363-4857-94e6-a1ef474aa191)
なぜうまくいくかを分析するために、異なる設定で実験し、alignment(正例との近さ)とuniformity(どれだけembeddingが一様に分布しているか)を、10 stepごとにplotした結果が以下。dropoutを適用しない場合と、常に同じ部分をマスクする方法(つまり、全く同じembeddingから学習する)設定を見ると、学習が進むにつれuniformityは改善するが、alignmentが悪くなっていっている。一方、SimCSEはalignmentを維持しつつ、uniformityもよくなっていっていることがわかる。
# Supervised SimCSEの実験
アノテーションデータを用いてContrastiveLearningするにあたり、どういったデータを正例としてみなすと良いかを検証するために様々なデータセットで学習し性能を検証した。
- QQP4: Quora question pairs
- Flickr30k (Young et al., 2014): 同じ画像に対して、5つの異なる人間が記述したキャプションが存在
- ParaNMT (Wieting and Gimpel, 2018): back-translationによるparaphraseのデータセットa
- NLI datasets: SNLIとMNLI
実験の結果、NLI datasetsが最も高い性能を示した。この理由としては、NLIデータセットは、crowd sourcingタスクで人手で作成された高品質なデータセットであることと、lexical overlapが小さくなるようにsentenceのペアが作成されていることが起因している。実際、NLI datsetのlexical overlapは39%だったのに対し、ほかのデータセットでは60%であった。
また、condunctionsとなるペアを明示的に負例として与えることで、より性能が向上した(普通はnegative samplingする、というかバッチ内の正例以外のものを強制的に負例とする。こうすると、意味が同じでも負例になってしまう事例が出てくることになる)。より難しいNLIタスクを含むANLIデータセットを追加した場合は、性能が改善しなかった。この理由については考察されていない。性能向上しそうな気がするのに。
# 他手法との比較結果
SimCSEがよい。
# Ablation Studies
異なるpooling方法で、どのようにsentence embeddingを作成するかで性能の違いを見た。originalのBERTの実装では、CLS token のembeddingの上にMLP layerがのっかっている。これの有無などと比較。
Unsupervised SimCSEでは、training時だけMLP layerをのっけて、test時はMLPを除いた方が良かった。一方、Supervised SimCSEでは、 MLP layerをのっけたまんまで良かったとのこと。
また、SimCSEで学習したsentence embeddingを別タスクにtransferして活用する際には、SimCSEのobjectiveにMLMを入れた方が、catastrophic forgettingを防げて性能が高かったとのこと。
ablation studiesのhard negativesのところと、どのようにミニバッチを構成するか、それぞれのtransferしたタスクがどのようなものがしっかり読めていない。あとでよむ。
[Paper Note] PENS: A Dataset and Generic Framework for Personalized News Headline Generation, ACL'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #NLP #Dataset #PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration #ACL #Surface-level Notes Issue Date: 2023-05-31 GPT Summary- この論文では、ユーザーの興味とニュース本文に基づいて、ユーザー固有のタイトルを生成するパーソナライズされたニュース見出し生成の問題を解決するためのフレームワークを提案します。また、この問題のための大規模なデータセットであるPENSを公開し、ベンチマークスコアを示します。データセットはhttps://msnews.github.io/pens.htmlで入手可能です。 Comment
# 概要
ニュース記事に対するPersonalizedなHeadlineの正解データを生成。103名のvolunteerの最低でも50件のクリックログと、200件に対する正解タイトルを生成した。正解タイトルを生成する際は、各ドキュメントごとに4名異なるユーザが正解タイトルを生成するようにした。これらを、Microsoft Newsの大規模ユーザ行動ログデータと、ニュース記事本文、タイトル、impressionログと組み合わせてPENSデータを構成した。
# データセット生成手順
103名のenglish-native [speakerの学生に対して、1000件のニュースヘッドラインの中から最低50件興味のあるヘッドラインを選択してもらう。続いて、200件のニュース記事に対して、正解ヘッドラインを生成したもらうことでデータを生成した。正解ヘッドラインを生成する際は、同一のニュースに対して4人がヘッドラインを生成するように調整した。生成されたヘッドラインは専門家によってqualityをチェックされ、factual informationにエラーがあるものや、極端に長い・短いものなどは除外された。
# データセット統計量
# 手法概要
Transformer Encoder + Pointer GeneratorによってPersonalizedなヘッドラインを生成する。
Transformer Encoderでは、ニュースの本文情報をエンコードし、attention distributionを生成する。Decoder側では、User Embeddingを組み合わせて、テキストをPointer Generatorの枠組みでデコーディングしていき、ヘッドラインを生成する。
User Embeddingをどのようにinjectするかで、3種類の方法を提案しており、1つ目は、Decoderの初期状態に設定する方法、2つ目は、ニュース本文のattention distributionの計算に利用する方法、3つ目はデコーディング時に、ソースからvocabをコピーするか、生成するかを選択する際に利用する方法。1つ目は一番シンプルな方法、2つ目は、ユーザによって記事で着目する部分が違うからattention distributionも変えましょう、そしてこれを変えたらcontext vectorも変わるからデコーディング時の挙動も変わるよねというモチベーション、3つ目は、選択するvocabを嗜好に合わせて変えましょう、という方向性だと思われる。最終的に、2つ目の方法が最も性能が良いことが示された。
# 訓練手法
まずニュース記事推薦システムを訓練し、user embeddingを取得できるようにする。続いて、genericなheadline generationモデルを訓練する。最後に両者を組み合わせて、Reinforcement LearningでPersonalized Headeline Generationモデルを訓練する。Rewardとして、
1. Personalization: ヘッドラインとuser embeddingのdot productで報酬とする
2. Fluency: two-layer LSTMを訓練し、生成されたヘッドラインのprobabilityを推定することで報酬とする
3. Factual Consistency: 生成されたヘッドラインと本文の各文とのROUGEを測りtop-3 scoreの平均を報酬とする
とした。
1,2,3の平均を最終的なRewardとする。
# 実験結果
Genericな手法と比較して、全てPersonalizedな手法が良かった。また、手法としては②のattention distributionに対してuser informationを注入する方法が良かった。News Recommendationの性能が高いほど、生成されるヘッドラインの性能も良かった。
# Case Study
ある記事に対するヘッドラインの一覧。Pointer-Genでは、重要な情報が抜け落ちてしまっているが、提案手法では抜け落ちていない。これはRLの報酬のfluencyによるものだと考えられる。また、異なるユーザには異なるヘッドラインが生成されていることが分かる。
[Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #EMNLP #PostTraining #Selected Papers/Blogs #KeyPoint Notes #SoftPrompt Issue Date: 2022-08-19 GPT Summary- 本研究では、凍結された言語モデルを特定のタスクに適応させるための「ソフトプロンプト」を学習するプロンプトチューニング手法を提案。逆伝播を通じて学習されるソフトプロンプトは、GPT-3の少数ショット学習を上回る性能を示し、モデルサイズが大きくなるほど競争力が増すことが確認された。特に、数十億のパラメータを持つモデルにおいて、全ての重みを調整するモデルチューニングに匹敵する性能を発揮。これにより、1つの凍結モデルを複数のタスクに再利用できる可能性が示唆され、ドメイン転送に対するロバスト性も向上することが明らかとなった。 Comment
日本語解説:
https://qiita.com/kts_plea/items/79ffbef685d362a7b6ce
T5のような大規模言語モデルに対してfinetuningをかける際に、大規模言語モデルのパラメータは凍結し、promptをembeddingするパラメータを独立して学習する手法
言語モデルのパラメータ数が増加するにつれ、言語モデルそのものをfinetuningした場合(Model Tuning)と同等の性能を示した。
いわゆる(Softな) Prompt Tuning
[Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2021-09-09 GPT Summary- プレフィックスチューニングは、ファインチューニングの軽量な代替手段であり、言語モデルのパラメータを固定しつつ、タスク特有の小さなベクトルを最適化する手法です。これにより、少ないパラメータで同等のパフォーマンスを達成し、低データ設定でもファインチューニングを上回る結果を示しました。 Comment
言語モデルをfine-tuningする際,エンコード時に「接頭辞」を潜在表現として与え,「接頭辞」部分のみをfine-tuningすることで(他パラメータは固定),より少量のパラメータでfine-tuningを実現する方法を提案.接頭辞を潜在表現で与えるこの方法は,GPT-3のpromptingに着想を得ている.fine-tuningされた接頭辞の潜在表現のみを配布すれば良いので,非常に少量なパラメータでfine-tuningができる.
table-to-text, summarizationタスクで,一般的なfine-tuningやAdapter(レイヤーの間にアダプターを挿入しそのパラメータだけをチューニングする手法)といった効率的なfine-tuning手法と比較.table-to-textでは、250k (元のモデルの 0.1%) ほどの数のパラメータを微調整するだけで、全パラメータをfine-tuningするのに匹敵もしくはそれ以上の性能を達成.
Hugging Faceの実装を利用したと論文中では記載されているが,fine-tuningする前の元の言語モデル(GPT-2)はどのように準備したのだろうか.Hugging Faceのpretrained済みのGPT-2を使用したのだろうか.
autoregressive LM (GPT-2)と,encoder-decoderモデル(BART)へPrefix Tuningを適用する場合の模式図
[Paper Note] Scaling Laws for Autoregressive Generative Modeling, Tom Henighan+, arXiv'20, 2020.10
Paper/Blog Link My Issue
#NLP #MultiModal #Scaling Laws #read-later #Selected Papers/Blogs #CrossDomain Issue Date: 2025-05-31 GPT Summary- 生成画像、ビデオ、マルチモーダルモデル、数学的問題解決の4領域におけるクロスエントロピー損失のスケーリング法則を特定。自己回帰型トランスフォーマーはモデルサイズと計算予算の増加に伴い性能が向上し、べき法則に従う。特に、10億パラメータのトランスフォーマーはYFCC100M画像分布をほぼ完璧にモデル化できることが示された。さらに、マルチモーダルモデルの相互情報量や数学的問題解決における外挿時の性能に関する追加のスケーリング法則も発見。これにより、スケーリング法則がニューラルネットワークの性能に与える影響が強調された。 Comment
Kaplan Law
[Paper Note] The Curious Case of Neural Text Degeneration, Ari Holtzman+, ICLR'20
Paper/Blog Link My Issue
#NLP #ICLR #Decoding #Diversity #Selected Papers/Blogs Issue Date: 2025-04-14 GPT Summary- 深層ニューラル言語モデルは高品質なテキスト生成において課題が残る。尤度の使用がモデルの性能に影響を与え、人間のテキストと機械のテキストの間に分布の違いがあることを示す。デコーディング戦略が生成テキストの質に大きな影響を与えることが明らかになり、ニュークリアスsamplingを提案。これにより、多様性を保ちながら信頼性の低い部分を排除し、人間のテキストに近い質を実現する。 Comment
現在のLLMで主流なNucleus (top-p) Samplingを提案した研究
[Paper Note] Scaling Laws for Neural Language Models, Jared Kaplan+, arXiv'20, 2020.01
Paper/Blog Link My Issue
#MachineLearning #NLP #Scaling Laws #Selected Papers/Blogs Issue Date: 2025-03-23 GPT Summary- 言語モデルの性能に関するスケーリング法則を研究し、損失がモデルサイズ、データセットサイズ、計算量に対して冪則的にスケールすることを示す。アーキテクチャの詳細は影響が少なく、過学習やトレーニング速度は単純な方程式で説明される。これにより、計算予算の最適な配分が可能となり、大きなモデルはサンプル効率が高く、少量のデータで早期に収束することが示された。 Comment
日本語解説: https://www.slideshare.net/slideshow/dlscaling-laws-for-neural-language-models/243005067
[Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Transformer #Selected Papers/Blogs #ActivationFunction #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- GLUの変種は非線形関数を用いて二つの線形射影を組み合わせ、Transformerモデルでテストした結果、従来の活性化関数ReLUやGELUよりも性能を向上させることが確認された。 Comment
一般的なFFNでは、linear layerをかけた後に、何らかの活性化関数をかませる方法が主流である。
最近FFNで利用される活性化関数として入力をsigmoid gateにlinear layerで変換して、同じくlinear layerで入力ベクトルを変換したベクトルとの要素積をとるGLUがあるが、これには改良の余地があり、様々なvariantが考えられるため、色々試しました(以下の8種類のvariantが提案されている)、というはなし。
オリジナルのGLUと比較して、T5と同じ事前学習タスクを実施したところ、perplexityが改善
また、finetuningをした場合の性能も、多くの場合オリジナルのGLUよりも高い性能を示した。
[Paper Note] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis+, N_A, NeurIPS'20
Paper/Blog Link My Issue
#InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #NeurIPS #Selected Papers/Blogs #Encoder-Decoder #ContextEngineering Issue Date: 2023-12-01 GPT Summary- 大規模な事前学習言語モデルを使用した検索強化生成(RAG)の微調整手法を提案しました。RAGモデルは、パラメトリックメモリと非パラメトリックメモリを組み合わせた言語生成モデルであり、幅広い知識集約的な自然言語処理タスクで最先端の性能を発揮しました。特に、QAタスクでは他のモデルを上回り、言語生成タスクでは具体的で多様な言語を生成することができました。 Comment
RAGを提案した研究
Retrieverとして利用されているDense Passage Retrieval (DPR)はこちら:
- [Paper Note] Dense Passage Retrieval for Open-Domain Question Answering, Vladimir Karpukhin+, EMNLP'20, 2020.04
所見:
[Paper Note] Measuring Massive Multitask Language Understanding, Dan Hendrycks+, arXiv'20, 2020.09
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #ICLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-24 GPT Summary- 新しいテストを提案し、57のマルチタスクを用いてテキストモデルの正確度を測定。高い正確度には広範な世界知識と問題解決能力が必要である。GPT-3モデルはランダム推測を約20ポイント上回るが、専門家レベルには遠く、多くのタスクで偏った性能を示す。特に道徳や法に関してはほぼランダムに近い正確度を記録。このテストはモデルの理解力を評価し、重要な欠点を明らかにすることを目的とする。 Comment
OpenReview: https://openreview.net/forum?id=d7KBjmI3GmQ
MMLU論文
- [Paper Note] Are We Done with MMLU?, Aryo Pradipta Gema+, NAACL'25
において、多くのエラーが含まれることが指摘され、再アノテーションが実施されている。
[Paper Note] Language Models are Few-Shot Learners, Tom B. Brown+, NeurIPS'20, 2020.05
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Zero/Few/ManyShotPrompting #In-ContextLearning #NeurIPS #Selected Papers/Blogs Issue Date: 2023-04-27 GPT Summary- GPT-3は1750億パラメータの自己回帰型モデルで、タスク非依存のFew-shot学習を改善。ファインチューニングなしで多様なNLPタスクで高い性能を示し、人間と区別しにくい文を生成可能。訓練の課題も明らかに。 Comment
In-Context Learningを提案した論文
論文に記載されているIn-Context Learningの定義は、しっかり押さえておいた方が良い。
下図はmeta-learningの観点から見たときの、in-contextの位置付け。事前学習時にSGDでパラメータをupdateするのをouter loopとし、そこで広いスキルとパターン認識の能力を身につける。一方で、in-context learningは、Inference時に事前学習時に得たそれらのスキルを用いて、求めるタスクを認識、あるいは適応するInner loopのことを指す。
この上で、論文中では In-Context Learningについて:
> Recent work [RWC+19] attempts to do this via what we call “in-context learning”, using the text input of a pretrained language model as a form of task specification: the model is conditioned on a natural language instruction and/or a few demonstrations of the task and is then expected to complete further instances of the task simply by predicting what comes next.
と定義している。
Few-Shot NLG with Pre-Trained Language Model, Chen+, University of California, ACL'20
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #pretrained-LM #Zero/FewShotLearning #Surface-level Notes Issue Date: 2022-12-01 Comment
# 概要
Neural basedなend-to-endなNLGアプローチはdata-hungryなので、Few Shotな設定で高い性能ができる手法を提案(Few shot NLG)
Table-to-Textタスク(WikiBIOデータ, 追加で収集したBook, SongドメインのWikipediaデータ)において、200程度の学習サンプル数でstrong baselineに対して8.0 point程度のBLEUスコアの向上を達成
# 手法
TabularデータのDescriptionを作成するには大きく分けて2つのスキルが必要
1. factualな情報を持つcontentをselectし、copyするスキル
2. factualな情報のコピーを含めながら、文法的に正しいテキストを生成するスキル
提案手法では、1を少量のサンプル(< 500)から学習し、2については事前学習済みの言語モデルを活用する。
encoderからコピーする確率をpcopyとし、下記式で算出する:
すなわち、encoderのcontext vectorと、decoderのinputとstateから求められる。
encoderとencoder側へのattentionはscratchから学習しなければならず、うまくコピーできるようにしっかりと”teach”しなければならないため、lossに以下を追加する:
すなわち、コピーすべき単語がちゃんとコピーできてる場合にlossが小さくなる項を追加している。
また、decoder側では、最初にTable情報のEmbeddingを入力するようにしている。
また、学習できるデータ量が限られているため、pre-trainingモデルのEmbeddingは事前学習時点のものに固定した(ただしく読解できているか不安)
# 実験
WikiBIOと、独自に収集したBook, Songに関するWikipediaデータのTable-to-Textデータを用いて実験。
このとき、Training instanceを50~500まで変化させた。
WikiBIOデータセットに対してSoTAを記録しているBase-originalを大きくoutperform(Few shot settingでは全然うまくいかない)。
inputとoutput例と、コピーに関するlossを入れた場合の効果。
人手評価の結果、Factual informationの正しさ(#Supp)、誤り(#Cont)ともに提案手法が良い。また、文法的な正しさ(Lan. Score)もコピーがない場合とcomparable
[Paper Note] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism, Mohammad Shoeybi+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#Pretraining #Tools #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #PostTraining #Selected Papers/Blogs #Parallelism #One-Line Notes #DistributedLearning #TrainingFramework Issue Date: 2026-09-29 GPT Summary- 大規模Transformerモデルを学習するため、ネイティブPyTorchに少数の通信操作を追加する層内モデル並列化手法を提案。パイプライン型並列化と併用可能で、512 GPU上で最大83億パラメータのモデルを学習し、15.1ペタFLOPSと76%のスケーリング効率を達成。GPT-2型・BERT型モデルで既存のSOTAを上回り、WikiText103、LAMBADA、RACEで高い性能を実現。 Comment
Megatron-LMがメモされていなかったので追加。代表的なLLM・マルチモーダルモデル学習のためのフレームワーク
事前学習、継続事前学習だけでなく
- Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
以下のような事後学習フレームワークのバックエンドとしても利用される:
- Nemo-RL, Nvidia, 2025.05
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- slime, THUDM & Zhihu, 2025.09
- ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
[Paper Note] Large Memory Layers with Product Keys, Guillaume Lample+, NIPS'19, 2019.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #Transformer #Architecture #NeurIPS #memory Issue Date: 2026-08-09 GPT Summary- ニューラルネットワークに統合可能な構造化メモリを提案し、アーキテクチャの容量を最大10億パラメータまで増加。プロダクトキーに基づく設計で、高速な最近傍探索を実現。パラメータ数の増加により、予測精度と計算効率のトレードオフを最適化。12層のメモリ拡張モデルが24層のベースラインを上回り、推論速度は2倍に。コードは公開。 Comment
パラメータ数と計算量を分離する手法の一つ。
slide: https://neurips.cc/media/neurips-2019/Slides/15837.pdf
[Paper Note] CTRL: A Conditional Transformer Language Model for Controllable Generation, Nitish Shirish Keskar+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #Transformer #Selected Papers/Blogs #Decoder Issue Date: 2026-01-16 GPT Summary- CTRLは、スタイルや内容、タスク特有の振る舞いを制御するコードに基づいて訓練された条件付きトランスフォーマー言語モデルで、1.63億パラメータを持つ。このモデルは、無監督学習の利点を生かしつつ、テキスト生成に対する明示的な制御を提供。CTRLは与えられたシーケンスに基づいて最も可能性のあるトレーニングデータを予測でき、データ分析の新たなアプローチを提示する。また、複数の事前訓練済みバージョンが公開されている。 Comment
Control Code(いわゆるタグ)によって条件付けることで生成されるテキストのスタイルや内容等をcontrollableにする研究の先駆け
[Paper Note] Deep Equilibrium Models, Shaojie Bai+, NeurIPS'19
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #NeurIPS Issue Date: 2025-08-05 GPT Summary- 深い平衡モデル(DEQ)を提案し、逐次データのモデル化において平衡点を直接見つけるアプローチを示す。DEQは無限の深さのフィードフォワードネットワークを解析的に逆伝播可能にし、定数メモリでトレーニングと予測を行える。自己注意トランスフォーマーやトレリスネットワークに適用し、WikiText-103ベンチマークでパフォーマンス向上、計算要件の維持、メモリ消費の最大88%削減を実証。
[Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンションを提案し、アテンション・ヘッド間でキーと値を共有することで、逐次推論時のメモリ帯域幅を削減。これにより、デコード速度が向上し、品質低下は最小限に抑えられたことを実験で確認。 Comment
**※ 以前のメモでは "Queryを単一にする" と記述していましたが、完全に誤りでした。**
Multi Query Attention論文。Multi-Head Attentionにおける **KVを全てのhead間で共有する(つまりKV Cacheの量が1/num_headになる)** することで代替する。劇的にDecoderのInferenceが早くなりメモリ使用量が減る。論文中では言及されていない?ようだが、後続の研究で性能と学習の安定性が課題が指摘されているようである。
[Paper Note] BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer, Fei Sun+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CIKM #SequentialRecommendation #One-Line Notes #Initial Impression Notes Issue Date: 2021-05-25 GPT Summary- ユーザーの動的嗜好をモデル化するために、BERT4RecというTransformerに基づく双方向エンコーダを導入。従来の順序型モデルの限界を克服し、Clozeタスクを用いて左側と右側の文脈を共同で条件付けしてアイテムを予測。さまざまなベンチマークデータセットにおいて、提案モデルが最先端の逐次モデルを一貫して上回る結果を示す。 Comment
BERTをrecsysのsequential recommendationタスクに転用してSoTA。
しっかり読んで無いけどモデル構造はほぼBERTと一緒。
異なる点は、Training時にNext Sentence Predictionは行わずClozeのみ行なっているという点。Clozeとは、実質Masked Language Modelであり、sequenceの一部を[mask]に置き換え、置き換えられたアイテムを左右のコンテキストから予測するタスク。異なる点としては、sequential recommendationタスクでは、次のアイテムを予測したいので、マスクするアイテムの中に、sequenceの最後のアイテムをマスクして予測する事例も混ぜた点。
もう一個異なる点として、BERT4Recはend-to-endなモデルで、BERTはpretraining modelだ、みたいなこと言ってるけど、まあ確かに形式的にはそういう違いはあるけど、なんかその違いを主張するのは違和感を覚える…。
sequential recommendationで使うuser behaviorデータでNext item predictionで学習したいことが、MLMと単に一致していただけ、なのでは…。
BERT4Recのモデル構造。next item predictionしたいsessionの末尾に [mask] をconcatし、[MASK]部分のアイテムを予測する構造っぽい?
オリジナルはtensorflow実装
pytorchの実装はこちら:
https://github.com/jaywonchung/BERT4Rec-VAE-Pytorch/tree/master/models
[Paper Note] Shampoo: Preconditioned Stochastic Tensor Optimization, Vineet Gupta+, ICML'18, 2018.02
Paper/Blog Link My Issue
#Pretraining #NLP #Optimizer #ICML #read-later #Selected Papers/Blogs Issue Date: 2026-08-06 GPT Summary- Shampooは、テンソル空間における確率的最適化のための新しい前処理アルゴリズムで、次元を縮約する行列の集合を保持し、収束保証を提供。実験により、Shampooが一般の最適化手法より速く収束し、実行時間は他の単純な手法と同等であることを示した。 Comment
次:
- [Paper Note] SOAP: Improving and Stabilizing Shampoo using Adam, Nikhil Vyas+, ICLR'25
[Paper Note] Larger-context language modelling with recurrent neural networks, Wang+, ACL'16
Paper/Blog Link My Issue
#NeuralNetwork #Sentence #NLP #ACL #Surface-level Notes Issue Date: 2017-12-28 Comment
## 概要
通常のNeural Language Modelはsentence間に独立性の仮定を置きモデル化されているが、この独立性を排除し、preceding sentencesに依存するようにモデル化することで、言語モデルのコーパスレベルでのPerplexityが改善したという話。提案した言語モデルは、contextを考慮することで特に名詞や動詞、形容詞の予測性能が向上。Late-Fusion methodと呼ばれるRNNのoutputの計算にcontext vectorを組み込む手法が、Perplexityの改善にもっとも寄与していた。
## 手法
sentence間の独立性を排除し、Corpusレベルのprobabilityを下図のように定義。(普通はP(Slが条件付けされていない))
preceding sentence (context)をモデル化するために、3種類の手法を提案。
[1. bag-of-words context]
ナイーブに、contextに現れた単語の(単一の)bag-of-wordsベクトルを作り、linear layerをかませてcontext vectorを生成する手法。
[2. context recurrent neural network]
preceding sentencesをbag-of-wordsベクトルの系列で表現し、これらのベクトルをsequentialにRNN-LSTMに読み込ませ、最後のhidden stateをcontext vectorとする手法。これにより、sentenceが出現した順番が考慮される。
[3. attention based context representation]
Attentionを用いる手法も提案されており、context recurrent neural networkと同様にRNNにbag-of-wordsのsequenceを食わせるが、各時点におけるcontext sentenceのベクトルを、bi-directionalなRNNのforward, backward stateをconcatしたもので表現し、attention weightの計算に用いる。context vectorは1, 2ではcurrent sentence中では共通のものを用いるが、attention basedな場合はcurrent sentenceの単語ごとに異なるcontext vectorを生成して用いる。
生成したcontext vectorをsentence-levelのRNN言語モデルに組み合わせる際に、二種類のFusion Methodを提案している。
[1. Early Fusion]
ナイーブに、RNNLMの各時点でのinputにcontext vectorの情報を組み込む方法。
[2. Late Fusion]
よりうまくcontext vectorの情報を組み込むために、current sentence内の単語のdependency(intra-sentence dependency)と、current sentenceとcontextの関係を別々に考慮する。context vectorとmemory cellの情報から、context vector中の不要箇所をフィルタリングしたcontrolled context vectorを生成し、LSTMのoutputの計算に用いる。Later Fusionはシンプルだが、corpusレベルのlanguage modelingの勾配消失問題を緩和することもできる。
## 評価
IMDB, BBC, PennTreebank, Fil9 (cleaned wikipedia corpus)の4種類のデータで学習し、corpus levelでPerplexityを測った。
Late FusionがPerplexityの減少に大きく寄与している。
PoSタグごとのperplexityを測った結果、contextを考慮した場合に名詞や形容詞、動詞のPerplexityに改善が見られた。一方、Coordinate Conjungtion (And, Or, So, Forなど)や限定詞、Personal Pronouns (I, You, It, Heなど)のPerplexityは劣化した。前者はopen-classな内容語であり、後者はclosed-classな機能語である。機能語はgrammaticalなroleを決めるのに対し、内容語はその名の通り、sentenceやdiscourseの内容を決めるものなので、文書の内容をより捉えることができると考察している。
[Paper Note] Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, Sergey Ioffe+, ICML'15
Paper/Blog Link My Issue
#MachineLearning #Transformer #ICML #Normalization #Selected Papers/Blogs #Reference Collection Issue Date: 2025-04-02 GPT Summary- バッチ正規化を用いることで、深層ニューラルネットワークのトレーニングにおける内部共変量シフトの問題を解決し、高い学習率を可能にし、初期化の注意を軽減。これにより、同じ精度を14倍少ないトレーニングステップで達成し、ImageNet分類で最良の公表結果を4.9%改善。 Comment
メモってなかったので今更ながら追加した
共変量シフトやBatch Normalizationの説明は
- [Paper Note] Layer Normalization, Ba+, arXiv'16, 2016.07
記載のスライドが分かりやすい。
[Paper Note] Unsupervised prediction of acceptability judgements, Lau+, ACL-IJCNLP'15
Paper/Blog Link My Issue
#NLP #ACL #IJCNLP #Selected Papers/Blogs #One-Line Notes #Reference Collection Issue Date: 2018-03-30 Comment
文のacceptability(容認度)論文。
文のacceptabilityとは、native speakerがある文を読んだときに、その文を正しい文として容認できる度合いのこと。
acceptabilityスコアが低いと、Readabilityが低いと判断できる。
言語モデルをトレーニングし、トレーニングした言語モデルに様々な正規化を施すことで、acceptabilityスコアを算出する。
日本語解説: http://www.lr.pi.titech.ac.jp/~sasano/acl2015suzukake/slides/01.pdf
Recurrent neural network based language model, Mikolov+, Interspeech'10
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Selected Papers/Blogs #Interspeech Issue Date: 2025-09-19 Comment
RNN言語モデル論文
Large Language Models in Machine Translation, Brants+, EMNLP-CoNLL'07
Paper/Blog Link My Issue
#MachineTranslation #NLP #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-12-24 GPT Summary- 本論文では、機械翻訳における大規模な統計的言語モデルの利点を報告し、最大2兆トークンでトレーニングした3000億n-gramのモデルを提案。新しいスムージング手法「Stupid Backoff」を導入し、大規模データセットでのトレーニングが安価で、Kneser-Neyスムージングに近づくことを示す。 Comment
N-gram言語モデル+スムージングの手法において、学習データを増やして扱えるngramのタイプ数(今で言うところのvocab数に近い)を増やしていったら、perplexityは改善するし、MTにおけるBLEUスコアも改善するよ(BLEUはサチってるかも?)という考察がされている
元ポスト:
Large Language Modelsという用語が利用されたのはこの研究が初めてなのかも…?
中国AIは、どのように賢くなったのか。MoE、リニアアテンション、強化学習……Kimi K3の中身を紐解く, レバテックLAB, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Author Thread-Post Issue Date: 2026-11-19 Comment
途中参加になってしまったのでありがたい
元ポスト:
Research acceleration: The jagged frontier, OpenAI, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #AIAgents #Blog #One-Line Notes #Author Thread-Post Issue Date: 2026-11-19 Comment
元ポスト:
学習プロセスの監視の成功率は80%、、学習プロセスの開始は35%、推論、サービング環境のためのコード作成は25%とtakeawayに書かれている。が、具体的にどの範囲をやらせた上での数字なのだろう。
中ほどの、Research task success by O*NET taskを見ると見出しレベルでどのようなことがやられているかがわかる。
zero interventionでの成功率が最も低いのは、Write code for inference and serving stacksであり、成功率は25%程度だが、やはりわかるようでわからない。どの程度のレベル感のservingの話なのか。
Introducing Gemini 4 Neon, Google, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Blog #Proprietary #VisionLanguageModel #One-Line Notes #Author Thread-Post Issue Date: 2026-11-19 Comment
ベンチマーク上はOpus5.5, GPT-6.2-Sol超え
元ポスト:
リリースの周期がOpenAI, Anthropicよりも加速:
Introducing GPT-6.2-Astra-Sol, OpenAI, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Blog #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-11-18 Comment
元ポスト:
Vals Index:
[Paper Note] Self-Improving Memory: Meta-Optimization and Harness Distillation for Continual Learning Agents, Chen+, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #SelfImprovement #Selected Papers/Blogs #memory #reading #One-Line Notes #EvolutionaryAlgorithm #Author Thread-Post Issue Date: 2026-11-18 Comment
元ポスト:
AI Agentのメモリ管理を自己改善する枠組みの提案。
タスクごとに適切なメモリ手法は異なるため、ベースとなるLOAD, OFFLOADINGの部分だけをpromptで決めておき(各タスクはまずメモリをロードしタスク完了後メモリを更新する流れ)、meta-agentによって、LOAD, OFFLOADINGのより適切なpromptを見つけ自己改善する。
また、改善されたLOAD, OFFLOADINGプロンプトを用いてタスク実行をしたtrajectoryに対して、(trajectory中で利用されている)改善されたLOAD, OFFLOADINGプロンプトを、genericなLOAD, OFFLOADINGプロンプトに差し替えて蒸留する。
これにより、最適化によって得られたタスク単位の最適なメモリ手法を、モデルの重みに内在化させることができ、genericなハーネスの元でタスクに特化したメモリ手法を運用できる、という話に見える。
タスクエージェントとmeta agentを共通化することで、自身が発見したより適切なメモリ手法を学習することができる。
MAI Code 2 and Code 2 Flash: Everyday coding at scalable prices, MAI, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Proprietary Issue Date: 2026-11-18 Comment
元ポスト:
Understanding Positional Embeddings in Modern LLMs, SEBASTIAN RASCHKA, PHD, 2026.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #Blog #PositionalEncoding #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
Databricks AI Index, databricks, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #Blog #Selected Papers/Blogs #One-Line Notes #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
databricksのunity gatewayを利用してAIを管理する企業における(すなわち、エンタープライズ分野における)モデルの利用の実態を集計したダッシュボードのようである。単独モデルの利用から、現在は複数モデル併用の傾向があり、かつOpenWeightModelの利用も増加傾向とのこと。興味深い。
プロプライエタリモデルの場合、AnthropicとOpenAIが98%程度を占め、60%程度はAnthropicのモデルとなっている。
OpenWeightモデルは、GLM, DeepSeek, Kimiあたりが支配的に見える。
Qwen4-Max: Your New Teammate Has Arrived, Qwen Team, 2026.11
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #AIAgents #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
AIパフォーマンスエンジニアリングの最前線, YOSHIFUJI Naoki @Tenstorrent, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LLMServing #Slide #SoftwareEngineering #read-later Issue Date: 2026-11-17
おい、 Mutation Test をやれ。テスト品質を、測るために, mizchi, 2026.11
Paper/Blog Link My Issue
#Article #Tools #NLP #AIAgents #Blog #Coding #SoftwareEngineering #UnitTest Issue Date: 2026-11-17 Comment
おもしろい。テストコードの勉強をしたい
A model's weights keep a record of its own training, Alapan Chaundhuri, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #Post #Author Thread-Post Issue Date: 2026-11-15
[Paper Note] Latent Feedback Is a Compute and Data Amplifier: Scaling Law for Latent Feedback Transformers on Repeated Data, Huang+, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Transformer #Architecture #One-Line Notes #Author Thread-Post Issue Date: 2026-11-14 Comment
元ポスト:
Transformerの前段のトークンに対するブロックの最上位層のhidden stateを、RMSNorm+Linearをかけて加算する(=latent feedback)ことで、十分なデータ量が与えられている状況において、vanilla transformerと比較して、同じFLOPSで到達可能なlossが改善し、同じデータで到達可能なlossが改善する。この挙動は、latent feedbackをかけたモデルは、1.14倍のパラメータを持つより大きなTransformerとして解釈できる(1トークンからより多くを学習するため、実質的により大きなモデルとみなせる)。ただし、実験は<0.8Bで実施され、scaling lawも60M--271Mのスケールで実施され、778Mのモデルで外挿され検証ており、モデルのパラメータサイズとしては小さい点に注意、という話に見える。
When Rounding Breaks Machine Learning: A formalization of numerical accuracy across various machine learning libraries, Robert Joseph George and Sasha Rush, 2026.11
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #Blog #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-14 Comment
元ポスト:
関連:
- [Paper Note] A Fix for Softmax and Cross-Entropy, Jonathan T. Barron+, arXiv'26, 2026.10
Lean Verified Precision, Sasha Rush and Robert Joseph George, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Blog #read-later #Selected Papers/Blogs #Proofs #Author Thread-Post Issue Date: 2026-11-14 Comment
元ポスト:
関連:
- [Paper Note] A Fix for Softmax and Cross-Entropy, Jonathan T. Barron+, arXiv'26, 2026.10
End‑to‑End 4‑Bit Training: Jack Cook in collaboration with others at Thinking Machines, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Blog #read-later #Selected Papers/Blogs #LowPrecision #Author Thread-Post Issue Date: 2026-11-14 Comment
元ポスト:
関連:
- Introducing Inkling 2 Small, THINKING MACHINES, 2026.11
Introducing Gemini 4 Hydrogen, Google, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Proprietary #Author Thread-Post Issue Date: 2026-11-13 Comment
公式:
Strengthening our safeguards with frontier automated red-teaming, Anthropic, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Security #Safeguard #RedTeaming Issue Date: 2026-11-13 Comment
元ポスト:
Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs, Will DePue, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #Blog #read-later #Selected Papers/Blogs Issue Date: 2026-11-13 Comment
元ポスト:
oh...
所見:
ドキュメント中にBlackwell GPUに関する記述はすでに存在し、中国企業がBlackwell GPUを海外でレンタルすることは可能であり、中国国内で利用された証明にはならない、という主張がある。
また、元ブログでは重みの初期化にBlackwell GPUが利用されたことは示されるが、学習に利用されたことを示しているわけではないであろう点にも注意。
(どちらも元ブログ中に言及がある)
Architecture Decisions for Marin 535B-A23B, Open Athena, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Blog #Architecture #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-12 Comment
元ポスト:
所見:
[Paper Note] A Survey on Continuous Diffusion and Flow Language Models, Tang+, 2026.11
Paper/Blog Link My Issue
#Article #Survey #NLP #DiffusionModel #FlowMaps #Author Thread-Post Issue Date: 2026-11-12 Comment
pj page: https://continuous-lm.github.io/
元ポスト:
解説:
Diffusion Language Models: Foundations and Frontiers of Non-Autoregressive Language Generation, Oba+, 2026.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #DiffusionModel #Slide #IJCNLP #AACL #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-12 Comment
元ポスト:
The bias of on-policy self-distillation: Why on-policy self-distillation is not the silver bullet for continual learning, baseLABS, 2026.11
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #Distillation #Bias #PostTraining #Selected Papers/Blogs #On-Policy #KeyPoint Notes #SelfDistillation #Author Thread-Post Issue Date: 2026-11-12 Comment
元ポスト:
関連:
- [Paper Note] Self-Distilled RLVR, Chenxu Yang+, arXiv'26, 2026.04
- [Paper Note] Why Does Self-Distillation (Sometimes) Degrade the Reasoning Capability of LLMs?, Jeonghye Kim+, COLM'26, 2026.03
- [Paper Note] Anti-Self-Distillation for Reasoning RL via Pointwise Mutual Information, Guobin Shen+, arXiv'26, 2026.05
- [Paper Note] Rethinking Privileged Information in On-Policy Self-Distillation, Samyak Shrestha+, arXiv'26, 2026.08
- [Paper Note] Privileged Solutions or Context-Induced Teacher Behavior? Dissecting On-Policy Self-Distillation, Yuki Ichihara+, arXiv'26, 2026.08
- OPSDは、密な学習シグナルを提供するが、それらはバイアスを持ったシグナルである。
- たとえば、全体的な傾向てして、教師モデルが答えを知っていることによって、Wait,Hmm,のような思考の構造を左右する語彙のスコアを抑制するバイアスがある。(また、一事例としては、数学的な意味は同じだが、2*3ではなく6を出力をする際に尤度に最大の乖離が生じる、なども観測)
- これにより、すでに十分な推論能力を備えたモデルに適用すると性能が劣化することが報告されている。
- 一方で、推論能力が無いモデルに対して、同モデルの推論モードをオンにしたモデルを教師とするなど、推論能力の低いモデルに対しては効果がある場合がある。
- このようなバイアスを除くための研究も行われてきたが、適切な意図をもって実施さされなければ悪影響を及ぼしうる。なぜならば、バイアスを除いて残された学習シグナルが、理想的な推論プロセスを保証するわけではないからである。
- たとえば、Contrastive OPSDはそもそも特権情報を保持していることのバイアスを打ち消すために工夫された手法だが、長期間学習されるとモデルが崩壊する。
- OPSDは万能な手法ではなく、システムプロンプトやConstitutionのように、汎用的に利用されることが期待される文脈全体の振る舞いを蒸留するような用途に適している。
[Paper Note] Beam Model Technical Report, Reflection Team, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #OpenWeight #Author Thread-Post Issue Date: 2026-11-12 Comment
元ポスト:
関連:
- Introducing Beam: Reflection’s 501B open-weight model, Reflection AI, 2026.10
The components of agent memory, Anthropic, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #ContextEngineering #memory #Author Thread-Post Issue Date: 2026-11-10 Comment
元ポスト:
Claude Fable 5.2 and Mythos 5.2, Anthropic, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Proprietary #Author Thread-Post Issue Date: 2026-11-10 Comment
元ポスト:
所見:
Opus5.5と比較してwriting能力が低下しているという所見がある
所見:
Scaling Marin's Open LLM Pre-Training, Open Athena, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Blog #MoE(Mixture-of-Experts) #Selected Papers/Blogs #reading #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
Independent Assessment of AI R&D Acceleration at Anthropic in October 2026, METR, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Safety #Initial Impression Notes #autoresearch/RSI #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
超絶ざっくり言うと、METRがAnthropic内部の機密情報やインタビュー等を通じてAI活用によるAIの能力向上のペースを分析したところ、2024年3月〜2025年10月のペースと比較して、およそ2倍の可能性があると推察される(ただし不確実性が大きい)が、
元となる機密情報そのものを公開できないので、読者はMETRのこのブログを信じるしかなく、検証はできないよ、という感じだろうか。
所見:
内部の研究者のインタビューから鑑みるに、
コードの自動生成から自律的な実験にフェーズがシフトし、
計算資源とアイデアが現在のボトルネックであり、AIによって自律的に素晴らしいアイデアが生成する段階にはまだ到達していない。
所見:
Science’s Last Exam: Can AI do Scientific Research on Its Own?, Altonomy, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #autoresearch/RSI #Author Thread-Post Issue Date: 2026-11-08 Comment
pj page:
https://sciences-last-exam.org/
HF:
https://huggingface.co/datasets/Gen-Verse/Science-Last-Exam
github:
https://github.com/Gen-Verse/Science-Last-Exam
元ポスト:
ポイント解説:
GPT‑6 Cyber:アライメントを備えたサイバーセキュリティエージェントの新境地, OpenAI, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Proprietary #Security #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
PFN、世界最高水準のAI翻訳がエッジで可能な大規模言語モデル PLaMo 3 Translate をオープンウェイトで公開, PFN, 2026.11
Paper/Blog Link My Issue
#Article #MachineTranslation #NLP #Blog #SmallModel #OpenWeight #Japanese #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-08 Comment
HF: https://huggingface.co/collections/pfnet/plamo-3-translate
開発者ポスト:
Learning in a world of notes, Engram, 2026.11
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #PostTraining #memory #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
root 権限への経路を 1,000 件削減, OpenAI, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Security #Initial Impression Notes #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
自動化されたパイプラインによってLinux Kernelの管理者権限を奪取する948の脆弱性の検知とパッチを生成し、人間の専門家がレビュー+メンテナへの提案を実施。APIコストに換算すると120万ドルとのこと...😱
CS 312: Deep Learning Alchemy Stanford _ Fall 2026, 2026.09
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #Pretraining #MachineLearning #NLP #Author Thread-Post Issue Date: 2026-11-08 Comment
元ポスト:
Introducing Paperclip Datasets, GXL, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Initial Impression Notes #Author Thread-Post Issue Date: 2026-11-07 Comment
元ポスト:
ユーザが指定したデータを、大量の文献から自動抽出(引用付きなので辿れる)して、表形式で出力できるよ、という話に見える
Introducing Hy4, Tencent, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #OpenWeight #Author Thread-Post Issue Date: 2026-11-07 Comment
元ポスト:
モデルもそのうち公開されるようである
Hy4-Flashがオープンに
https://huggingface.co/tencent/Hy4-flash
https://huggingface.co/tencent/Hy4-flash
Larger Tokenizers Suffer More Multi-Epoch Regret, Wenhao Chai, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #NLP #Blog #Tokenizer #One-Line Notes #Author Thread-Post #DataRepetition Issue Date: 2026-11-07 Comment
元ポスト:
ngramなどによってvocab sizeを増やすと、マルチエポックの設定で事前学習をすると、低頻度の語彙に対してmemorizationが生じ、validation lossが劣化するため、そのためにいくつかの対策が考えられる (低頻度の語彙をランダムに平均で置き換える, エポックごとにテキストをシャッフルする, 重みを平均化するなど)、これらによってregret(学習トークン量を揃えて、同じデータを繰り返し学習した場合と、ユニークなデータを学習した場合の損失の差)を半分程度にできる。また、H-Netsのようなdynamic tokenizerに基づくモデルが、マルチエポックの設定では有望そうだよ、という話に見える。
Learnings from Auditing Public Evaluations, PRIME Intellect, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Evaluation #One-Line Notes #Author Thread-Post Issue Date: 2026-11-07 Comment
元ポスト:
- AutomationBenchにおいて、ツールに対するリクエストをJSONに従うように変更した場合性能が大きく変化
- OfficeQA Pro v2と呼ばれるベンチマークで、正誤判定が正規表現だったものをJudgeに変更した場合ランキングが大きく変化
- Web検索を許容する場合、モデルが正解を探しに行く報酬ハッキング的な行動が生じる。かといって、ブロックしきるのも限界があり、モデルが既存の監視をすり抜ける方法を見出す。
ベンチマークスコアを過信してはいけないという話
Paper Highlights of October 2026, JOHANNES GASTEIGER, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Safety #Author Thread-Post Issue Date: 2026-11-07 Comment
元ポスト:
StateBench: Testing how language models track state changes over long documents, Ai2, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Dataset #Evaluation #Author Thread-Post Issue Date: 2026-11-07 Comment
data:
https://huggingface.co/datasets/allenai/state-bench
github:
https://github.com/allenai/state-bench
The Ultimate MoE Training Handbook: How to train a Mixture-of-Experts model at scale, setting by setting, with the runs that back each choice, HuggingFace, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #MoE(Mixture-of-Experts) #SoftwareEngineering #read-later #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-11-07 Comment
元ポスト:
大規模な計算機クラスタでのMoEの学習に特化したハンドブックで、相変わらず素晴らしいハンドブックっぽく見える(小並感)。最初のinteractiveなfigureから、学習の際に検知すべきsignalを一望でき、関連セクションにジャンプできる。実装のコードも付与され、図解つきでわかりやすく解説されてそうに見える。なによりボリュームがすごい。
ハードウェアのテスト
イメージの構築
トークナイズ
Denseモデルベースラインの学習
単一ノードでのMoEモデル学習(おかしな点に気付けるように)
メガトロンのコードと推奨事項、注意点、オプション指定など
ルータのスコアの扱い
RoutingとEngramの関係
エキスパートのbalancing
expertは全てのトークンを観測できる必要があるか
RouterとOptimiser
損失が良好に見えても問題が生じるか
4ビットで大規模なMoEを学習できるか
MoEモデルのサービング
著者ポスト2:
Hyperkernel, Hyperstitioncc, 2026.11
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #GPUKernel #Author Thread-Post #Megakernels Issue Date: 2026-11-06 Comment
元ポスト:
Introducing Ripple-65B Preview, a Frontier Open-Weight Model, RICURSIVE INTELLIGENCE, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #OpenWeight Issue Date: 2026-11-06 Comment
HF: https://huggingface.co/ricursiveAI/Ripple-65B-Preview
元ポスト:
所見:
関連:
- [Paper Note] Value Residual Learning, Zhanchao Zhou+, ACL'25
[Paper Note] REINFORCE Zero: Kernel Alignment Unlocks Stable Asynchronous RL with Importance Sampling, Hu+, 2026.11
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #PostTraining #train-inference-mismatch #Asynchronous #Author Thread-Post Issue Date: 2026-11-06 Comment
元ポスト:
所見:
Introducing Inkling 2 Small, THINKING MACHINES, 2026.11
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #AIAgents #Blog #OpenWeight #read-later #Selected Papers/Blogs #One-Line Notes #Author Thread-Post Issue Date: 2026-11-06 Comment
元ポスト:
所見:
MOPDは利用されていないらしい
model weightは近いうちに公開とのこと
所見:
所見:
所見:
事前学習の計算量がDeepSeek V4.1 Flash 1017に対して、およそ40%程度。
重みが公開:
https://huggingface.co/thinkingmachines/Inkling-2-Small
アーキテクチャ解説
アーキテクチャ図:
Linear Attention無し(SWA+GQA)でAttentionResidualsを利用している。
The shelf life of LLM findings, Owen Queen and James Zou, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #Selected Papers/Blogs #One-Line Notes #Author Thread-Post Issue Date: 2026-11-05 Comment
元ポスト:
著者ポスト:
LLMの性質に関して広く引用された50の知見(課題)について、2024年7月--2026年9月の間にリリースされた20のモデルで追試したところ、知見がもはや適用できないと判定されたものの中で、失効するまでの期間を測ったところ、(いわゆる賞味期限)まで、平均約15.7ヶ月であった、というような話とそれら周辺の話題(逆に強化される知見もあるなど)に関連する様々な考察のようである。これは興味深い。
たとえば、既に失効した知見としては、文字数カウント、異なる進数での演算、引用のhallucination、long context中の事実情報の同定、指摘を受けると正しい回答を撤回する現象などが挙げられている。
他にも弱まったが依然存在する課題(weakened)や、依然として存在する、あるいは強化された課題(Persists or strengthened)についても分析されている。
以前として残っている、あるいは強まった課題は、ユーザにお世辞を言ったり同意したりする、自分自身の応答を好む傾向、自由記述のプロンプトに関してほぼ同様の内容の出力する、リベラル思想、本来拒否すべき質問に応答する、などがあるようである。
(本研究の主題ではないが)おそらく過去の研究と同じ設定で実験をしていて、本研究においてはそうあるべきと思うが、ものによってはその課題を改善するための手法も多く提案されているように感じる。たとえば、自由記述のpromptに対してほぼ同等の応答を返す問題などについては、いくつかの解決策が提案されている:
- [Paper Note] Verbalized Sampling: How to Mitigate Mode Collapse and Unlock LLM Diversity, Jiayi Zhang+, ICML'26 2025.10
- [Paper Note] Gacha Decoding: Eliciting Diverse Generations Through Instruction Following, Scott Geng+, arXiv'26, 2026.10
- [Paper Note] String Seed of Thought: Prompting LLMs for Distribution-Faithful and Diverse Generation, Kou Misaki+, ICLR'26, 2025.10
こういったものまで含めたら、分析結果の分布はどの程度変化するのだろうか。
Speculation on an Architecture for Continual Learning, snimu's blog, 2026.11
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #Blog #Architecture #VisionLanguageModel #Robotics #WorldModels #ContinualLearning #WorldActionModel Issue Date: 2026-11-05 Comment
元ポスト:
Continual Learning, Online and Offline, snimu's blog, 2026.11
Paper/Blog Link My Issue
#Article #NLP #Blog #ContinualLearning Issue Date: 2026-11-05 Comment
元ポスト:
GPU-accelerated Weight Teleportation: Lossless GPU Compression for Instant RL Weight Sync, humans&, 2026.11
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #SoftwareEngineering #PostTraining #Compression #Initial Impression Notes Issue Date: 2026-11-05 Comment
元ポスト:
RLにおける学習側と推論側の重みの同期におけるボトルネックを高速化しボトルネックを緩和する話
[Paper Note] Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, Takehi+, 2026.11
Paper/Blog Link My Issue
#Article #NLP #read-later #Selected Papers/Blogs #Reference Collection #Author Thread-Post Issue Date: 2026-11-03 Comment
元ポスト:
最近のフロンティアモデルでしかこの能力は発現しない:
所見:
所見:
解説:
GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains, SemiAnalysis, 2026.10
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #Blog #Author Thread-Post Issue Date: 2026-11-02 Comment
元ポスト:
Introducing &Tutor Training better tutors with better learners, humans&, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Education #AIAgents #Proprietary #Author Thread-Post #Tutor Issue Date: 2026-11-01 Comment
元ポスト:
A world that learns as it goes, OpenWorld, 2026.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #AIAgents #GenerativeAI #Game #Author Thread-Post Issue Date: 2026-11-01 Comment
元ポスト:
フロンティアモデルのミスアライメントを検知する仕組み, OpenAI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #AIAgents #Blog #Proprietary #Probing #Monitorability #ToolUse #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト:
公式:
Want to learn about scaling laws? Start with these papers and resources, Yuwei Niu, 2026.10
Paper/Blog Link My Issue
#Article #Survey #Pretraining #NLP #Post #MoE(Mixture-of-Experts) #Scaling Laws Issue Date: 2026-10-31
[Paper Note] NyoomFloat12: Accelerating LLM Inference via Lossless 12-Bit Weight Compression, Liberman+, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Quantization #Initial Impression Notes Issue Date: 2026-10-31 Comment
元ポスト:
losslessは嬉しい(小並感)
The Economics of Intelligence: How and when does AGI lead to economic transformation?, DeepMind Institute, 2026.10
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #read-later #Selected Papers/Blogs #Coordination #Economics Issue Date: 2026-10-31 Comment
元ポスト:
SWE-bench Multimodal v2 is not multimodal, sankalp's blog, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Evaluation #MultiModal #Blog #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト: