
LanguageModel (3565) — 11/18
[Paper Note] Instruction Pre-Training: Language Models are Supervised Multitask Learners, Daixuan Cheng+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#Pretraining #InstructionTuning #EMNLP #read-later #Selected Papers/Blogs #needs-revision Issue Date: 2024-07-08 GPT Summary- 教師なしのマルチタスク事前学習は成功の要因だが、監督付きの可能性も高い。本研究ではInstruction Pre-Trainingを提案し、大規模な指示-応答ペアを用いて言語モデルの前処理を行う。この手法により、40以上のタスクで2億のペアを合成し、その効果を示した。Instruction Pre-Trainingは、基盤モデルの性能を向上させ、追加の指示調整からも利益を得ることができ、Llama3-8BをLlama3-70Bに匹敵する性能へと引き上げた。モデルとデータは公開されている。 Comment
参考:
[Paper Note] How Do Large Language Models Acquire Factual Knowledge During Pretraining?, Hoyeon Chang+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#Analysis #Pretraining #NLP #Dataset #NeurIPS #Selected Papers/Blogs #FactualKnowledge #reading #One-Line Notes Issue Date: 2024-06-19 GPT Summary- LLMは事前学習中に事実知識を獲得する仕組みに関する理解が限られている。本研究ではそのギャップを埋め、事実知識獲得のダイナミクスを解明。データ量の増加が必ずしも知識の獲得を改善しないこと、訓練ステップ数と忘却の関係、バッチサイズが忘却の頑健性に与える影響を発見。知識獲得はデータに提示される確率を高めることで進行するが、忘却により希薄化する。これにより、低パフォーマンスの理由や重複排除の利点を説明できる。 Comment
所見:
- より多くのdata exposureは迅速な知識獲得を促進するが、factual knowledgeの保持には有意に寄与しない(忘却していくため)
- より大きなバッチサイズとdeduplicatedされた学習データがfactual knowledgeの保持に寄与する
- 学習ステップとRetainability[^1]はべき乗則の関係にある。すなわち、Retainabilityは、log(学習ステップ)に対して線形に低下する。
[^1]:知識をN回注入し、知識を答えるcloze taskの対数尤度を計り、注入前からの上昇幅によって知識獲得を定量化。Retainabilityは、N回注入する過程での上昇幅のピークを記録し、tステップ後に上昇幅のピークに対して、現在の対数尤度がどれだけの割合残っているか、で定義される。
[Paper Note] Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone, Marah Abdin+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #SmallModel #OpenWeight #One-Line Notes Issue Date: 2024-04-23 GPT Summary- phi-3-miniは3.8十億パラメータの言語モデルで、3.3兆トークンを学習し、MMLUで69%、MT-benchで8.38を達成。スマートフォンでもデプロイ可能で、phi-2のデータセットをフィルタリングして作成。phi-3-smallとphi-3-mediumはそれぞれ75%、78%をMMLUで達成し、性能が向上。シリーズの新モデルphi-3.5-mini、phi-3.5-MoE、phi-3.5-Visionも導入。phi-3.5-MoEは優れた言語処理能力を発揮し、phi-3.5-Visionは複数画像とテキストのプロンプトに対応。 Comment
[Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09 の次の次(Phi2.0についてはメモってなかった)。スマホにデプロイできるレベルのサイズで、GPT3.5Turbo程度の性能を実現したらしい
Llama2と同じブロックを利用しているため、アーキテクチャはLlama2と共通。
[Paper Note] Compression Represents Intelligence Linearly, Yuzhen Huang+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#Analysis #Pretraining #Evaluation #COLM #Selected Papers/Blogs #One-Line Notes #DownstreamTasks Issue Date: 2024-04-17 GPT Summary- LLMsが知性を反映するかを圧縮の観点から検討。知性を下流ベンチマークのスコアで評価し、31の公開LLMを分析したところ、圧縮能力と知性にほぼ線形の相関があることが判明。これにより、より優れた圧縮が高い知性を示すという仮説が支持され、圧縮効率が信頼性のある評価指標として機能する可能性が示された。圧縮データセットはオープンソース化され、今後の研究に貢献することが期待される。 Comment
参考:
openreview: https://openreview.net/forum?id=SHMj84U5SH
external corpora (≠学習データ)で測定したモデルのBit Per Character (BPC) とdownstreamタスクのベンチマークスコアは、全体で平均で見ても、個別のドメインでみても、linearに相関する。
Knowledge Conflicts for LLMs: A Survey, Rongwu Xu+, N_A, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP Issue Date: 2024-04-14 GPT Summary- LLMsにおける知識の衝突に焦点を当て、文脈とパラメトリック知識の組み合わせによる複雑な課題を分析。文脈-メモリ、文脈間、メモリ内の衝突の3つのカテゴリーを探求し、実世界のアプリケーションにおける信頼性とパフォーマンスへの影響を検討。解決策を提案し、LLMsの堅牢性向上を目指す。
[Paper Note] Quiet-STaR: Language Models Can Teach Themselves to Think Before Speaking, Eric Zelikman+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#NLP #SelfImprovement #One-Line Notes #Reference Collection Issue Date: 2024-04-14 GPT Summary- Quiet-STaRは、言語モデルが各トークンごとに根拠を生成し、未来のテキストを説明する能力を学ぶ手法です。これはSelf-Taught Reasoner (STaR) の一般化であり、推論根拠を生成することで予測を改善します。計算コストや内部思考の生成方法などの課題を克服するために、トークン単位の並列サンプリングアルゴリズムと教師強制技法を提案。特に、難しいトークンの予測を改善し、GSM8KやCommonsenseQAでゼロショットの精度向上を示しました。この研究は、推論を学習するよりスケーラブルなアプローチへと向かう一歩となります。 Comment
o1(OpenAI o1, 2024.09
)の基礎技術と似ている可能性がある
先行研究:
- [Paper Note] STaR: Bootstrapping Reasoning With Reasoning, Eric Zelikman+, NeurIPS'22, 2022.03
参考:
[Paper Note] Gemma: Open Models Based on Gemini Research and Technology, Gemma Team+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#NLP #OpenWeight #KeyPoint Notes Issue Date: 2024-04-08 GPT Summary- Gemmaは、軽量で最先端のオープンモデルで、言語理解や推論において強力な性能を発揮。2億および7億パラメータのモデルを提供し、事前学習済みとファインチューニング済みのチェックポイントを含む。Gemmaは、18のタスクのうち11で同サイズのオープンモデルを超え、安全性に関する詳細な評価とモデル開発の説明を提供。責任あるLLMのリリースが安全性向上に寄与し、次世代の革新を促進すると信じている。 Comment
アーキテクチャはTransformer Decoderを利用。モデルのサイズは2Bと7B。
オリジナルのTransformer Decoderアーキテクチャから、下記改善を実施している:
- Multi Query Attention [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
を利用
- RoPE Embedding [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
を利用
- GeGLU [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
の利用
- RMSNormの利用(学習を安定させるため; LLaMAと同様)
Mistral Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
よりも高い性能を示している:
Visualization-of-Thought Elicits Spatial Reasoning in Large Language Models, Wenshan Wu+, N_A, arXiv'24
Paper/Blog Link My Issue
#ComputerVision #NLP #Chain-of-Thought Issue Date: 2024-04-08 GPT Summary- LLMsの空間推論能力を向上させるために、Visualization-of-Thought(VoT)プロンプティングを提案。VoTは、LLMsの推論トレースを可視化し、空間推論タスクで使用することで、既存のMLLMsを上回る性能を示す。VoTは、空間推論を促進するために「メンタルイメージ」を生成する能力を持ち、MLLMsでの有効性を示唆する。
Long-context LLMs Struggle with Long In-context Learning, Tianle Li+, N_A, arXiv'24
Paper/Blog Link My Issue
#Analysis #NLP #ContextWindow #LongContext #One-Line Notes Issue Date: 2024-04-07 GPT Summary- LLMsは長いシーケンスを処理する能力に進展しているが、実世界のシナリオでの能力を評価するための専門的なベンチマークLongICLBenchが導入された。このベンチマークでは、LLMsは巨大なラベル空間を理解し、正しい予測を行うために入力全体を理解する必要がある。研究によると、長いコンテキストLLMsは長いコンテキストウィンドウを活用することで比較的良いパフォーマンスを示すが、最も困難なタスクでは苦労している。現在のLLMsは長くコンテキスト豊かなシーケンスを処理し理解する能力にギャップがあることを示唆しており、長いコンテキストの理解と推論は依然として難しい課題であることが示されている。 Comment
GPT4以外はコンテキストが20Kを超えると性能が劣化する傾向にあるとのこと。データセットを難易度別に収集し評価したところ、難易度の高いデータではそもそもコンテキストが長くなると全てのLLMがタスクを理解するできずほぼ0%の性能となった。
Mixture-of-Depths: Dynamically allocating compute in transformer-based language models, David Raposo+, N_A, arXiv'24
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer Issue Date: 2024-04-07 GPT Summary- Transformerベースの言語モデルは、入力シーケンス全体に均等にFLOPsを分散させる代わりに、特定の位置にFLOPsを動的に割り当てることを学習できることを示す。モデルの深さにわたって割り当てを最適化するために、異なるレイヤーで計算を動的に割り当てる。この手法は、トークンの数を制限することで合計計算予算を強制し、トークンはtop-kルーティングメカニズムを使用して決定される。この方法により、FLOPsを均等に消費しつつ、計算の支出が予測可能であり、動的かつコンテキストに敏感である。このようにトレーニングされたモデルは、計算を動的に割り当てることを学習し、効率的に行うことができる。 Comment
参考:
[Paper Note] Dynamic Memory Compression: Retrofitting LLMs for Accelerated Inference, Piotr Nawrot+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #ICML #One-Line Notes #KV Cache #Compression Issue Date: 2024-04-07 GPT Summary- Transformerにおけるメモリキャッシュの非効率性を解決するために、Dynamic Memory Compression(DMC)を提案。DMCは異なるヘッドと層で異なる圧縮比を学習し、Llama 2を組み込むことで推論時に最大7倍のスループット向上を実現。元のパフォーマンスを保ちながら、キャッシュ圧縮を最大4倍可能とし、既存の方法を超える効果を発揮。DMCはKVキャッシュのドロップイン置換として、より長い文脈と大きなバッチを処理できる。 Comment
参考:
論文中のFigure1が非常にわかりやすい。
GQA [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
と比較して、2~4倍キャッシュを圧縮しつつ、より高い性能を実現。70Bモデルの場合は、GQAで8倍キャッシュを圧縮した上で、DMCで追加で2倍圧縮をかけたところ、同等のパフォーマンスを実現している。
[Paper Note] RAFT: Adapting Language Model to Domain Specific RAG, Tianjun Zhang+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#InformationRetrieval #NLP #Supervised-FineTuning (SFT) #RAG(RetrievalAugmentedGeneration) #One-Line Notes Issue Date: 2024-04-07 GPT Summary- RAFTを提案し、LLMに新しい知識を効果的に組み込む方法を示す。質問応答能力を向上させるため、無関係な文書を無視し、関連文書から逐語的引用を行って推論能力を強化。PubMedやHotpotQAなどのデータセットで一貫して性能を改善し、ポスト訓練レシピを提示。コードはオープンソースで公開中。 Comment
Question, instruction, coxtext, cot style answerの4つを用いてSFTをする模様
画像は下記ツイートより引用
[Paper Note] RankPrompt: Step-by-Step Comparisons Make Language Models Better Reasoners, Chi Hu+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #NLP #Prompting #Reasoning #COLING #Reranking #Initial Impression Notes #LREC Issue Date: 2024-04-07 GPT Summary- LLMの論理的エラーを解決するために、自己ランク付けを可能にする新手法RankPromptを提案。これは、多様な応答を比較し、LLMの文脈的生成能力を活用する。実験ではChatGPTやGPT-4の性能が最大13%向上し、AlpacaEvalデータセットでは人間の判断との74%の一致率を示した。また、応答の順序や一貫性の変動にも強い耐性を持つことが確認された。RankPromptは高品質なフィードバックを引き出す有効な手法である。 Comment
LLMでランキングをするためのプロンプト手法。独立したプロンプトでスコアリングしスコアリング結果からランキングするのではなく、LLMに対して比較するためのルーブリックやshotを入れ、全てのサンプルを含め、1回のPromptingでランキングを生成するような手法に見える。大量の候補をランキングするのは困難だと思われるが、リランキング手法としては利用できる可能性がある。また、実験などでランキングを実施するサンプル数に対してどれだけ頑健なのかなどは示されているだろうか?
[Paper Note] OLMo: Accelerating the Science of Language Models, Dirk Groeneveld+, arXiv'24, 2024.02
Paper/Blog Link My Issue
#NLP #OpenWeight #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-03-05 GPT Summary- OLMoは、市場での商業的重要性が高まる中、真にオープンな言語モデルを提供することでNLP研究の進展を目指す。従来のモデルが重みや推論コードのみを公開するのに対し、OLMoはトレーニングデータや評価コードも含めて公開し、科学的研究の基盤を確立することで、オープンな研究コミュニティの力を引き出し、新たなイノベーションを促進することを期待している。 Comment
Model Weightsを公開するだけでなく、training/evaluation codeとそのデータも公開する真にOpenな言語モデル(truly Open Language Model)。AllenAI
Chain-of-Thought Reasoning Without Prompting, Xuezhi Wang+, N_A, arXiv'24
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #One-Line Notes Issue Date: 2024-03-05 GPT Summary- LLMsの推論能力を向上させるための新しいアプローチに焦点を当てた研究が行われている。この研究では、LLMsがプロンプトなしで効果的に推論できるかどうかを検証し、CoT推論パスをデコーディングプロセスを変更することで引き出す方法を提案している。提案手法は、従来の貪欲なデコーディングではなく、代替トークンを調査することでCoTパスを見つけることができることを示しており、様々な推論ベンチマークで有効性を示している。 Comment
以前にCoTを内部的に自動的に実施されるように事前学習段階で学習する、といった話があったと思うが、この研究はデコーディング方法を変更することで、promptingで明示的にinstructionを実施せずとも、CoTを実現するもの、ということだと思われる。
LoRA+: Efficient Low Rank Adaptation of Large Models, Soufiane Hayou+, N_A, ICML'24
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #PEFT(Adaptor/LoRA) #ICML #One-Line Notes Issue Date: 2024-03-05 GPT Summary- 本研究では、Huら(2021)によって導入されたLow Rank Adaptation(LoRA)が、大埋め込み次元を持つモデルの適切な微調整を妨げることを指摘します。この問題は、LoRAのアダプターマトリックスAとBが同じ学習率で更新されることに起因します。我々は、AとBに同じ学習率を使用することが効率的な特徴学習を妨げることを示し、異なる学習率を設定することでこの問題を修正できることを示します。修正されたアルゴリズムをLoRA$+$と呼び、幅広い実験により、LoRA$+$は性能を向上させ、微調整速度を最大2倍高速化することが示されました。 Comment
LoRAで導入される低ランク行列AとBを異なる学習率で学習することで、LoRAと同じ計算コストで、2倍以上の高速化、かつ高いパフォーマンスを実現する手法
Large Language Models for Data Annotation: A Survey, Zhen Tan+, N_A, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #Annotation #One-Line Notes #Data Issue Date: 2024-03-05 GPT Summary- GPT-4などの大規模言語モデル(LLMs)を使用したデータアノテーションの研究に焦点を当て、LLMによるアノテーション生成の評価や学習への応用について述べられています。LLMを使用したデータアノテーションの手法や課題について包括的に議論し、将来の研究の進展を促進することを目的としています。 Comment
Data AnnotationにLLMを活用する場合のサーベイ
Large Language Models(LLMs) on Tabular Data: Prediction, Generation, and Understanding -- A Survey, Xi Fang+, N_A, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #DataToTextGeneration #TabularData #One-Line Notes Issue Date: 2024-03-05 GPT Summary- 最近の大規模言語モデリングの進展により、様々なタスクにおける応用が容易になっているが、包括的なレビューが不足している。この研究は、最近の進歩をまとめ、データセット、メトリクス、方法論を調査し、将来の研究方向に洞察を提供することを目的としている。また、関連するコードとデータセットの参照も提供される。 Comment
Tabular DataにおけるLLM関連のタスクや技術等のサーベイ
User-LLM: Efficient LLM Contextualization with User Embeddings, Lin Ning+, N_A, arXiv'24
Paper/Blog Link My Issue
#NLP #Personalization #Initial Impression Notes Issue Date: 2024-02-24 GPT Summary- LLMsを活用したUser-LLMフレームワークが提案された。ユーザーエンベッディングを使用してLLMsをコンテキストに位置付けし、ユーザーコンテキストに動的に適応することが可能になる。包括的な実験により、著しい性能向上が示され、Perceiverレイヤーの組み込みにより計算効率が向上している。 Comment
next item prediction, favorite genre or category predictimnreview generationなどで評価している
MM-LLMs: Recent Advances in MultiModal Large Language Models, Duzhen Zhang+, N_A, ACL'24 Findings
Paper/Blog Link My Issue
#Survey #MultiModal #ACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-01-25 GPT Summary- MM-LLMsは、コスト効果の高いトレーニング戦略を用いて拡張され、多様なMMタスクに対応する能力を持つことが示されている。本論文では、MM-LLMsのアーキテクチャ、トレーニング手法、ベンチマークのパフォーマンスなどについて調査し、その進歩に貢献することを目指している。 Comment
以下、論文を斜め読みしながら、ChatGPTを通じて疑問点を解消しつつ理解した内容なので、理解が不十分な点が含まれている可能性があるので注意。
# 概要
まあざっくり言うと、マルチモーダルを理解できるLLMを作りたかったら、様々なモダリティをエンコーディングして得られる表現と、既存のLLMが内部的に処理可能な表現を対応づける Input Projectorという名の関数を学習すればいいだけだよ(モダリティのエンコーダ、LLMは事前学習されたものをそのままfreezeして使えば良い)。
マルチモーダルを生成できるLLMを作りたかったら、LLMがテキストを生成するだけでなく、様々なモダリティに対応する表現も追加で出力するようにして、その出力を各モダリティを生成できるモデルに入力できるように変換するOutput Projectortという名の関数を学習しようね、ということだと思われる。
## ポイント
- Modality Encoder, LLM Backbone、およびModality Generatorは一般的にはパラメータをfreezeする
- optimizationの対象は「Input/Output Projector」
## Modality Encoder
様々なモダリティI_Xを、特徴量F_Xに変換する。これはまあ、色々なモデルがある。
## Input Projector
モダリティI_Xとそれに対応するテキストtのデータ {I_X, t}が与えられたとき、テキストtを埋め込み表現に変換んした結果得られる特徴量がF_Tである。Input Projectorは、F_XをLLMのinputとして利用する際に最適な特徴量P_Xに変換するθX_Tを学習することである。これは、LLM(P_X, F_T)によってテキストtがどれだけ生成できたか、を表現する損失関数を最小化することによって学習される。
## LLM Backbone
LLMによってテキスト列tと、各モダリティに対応した表現であるS_Xを生成する。outputからt, S_Xをどのように区別するかはモデルの構造などにもよるが、たとえば異なるヘッドを用意して、t, S_Xを区別するといったことは可能であろうと思われる。
## Output Projector
S_XをModality Generatorが解釈可能な特徴量H_Xに変換する関数のことである。これは学習しなければならない。
H_XとModality Generatorのtextual encoderにtを入力した際に得られる表現τX(t)が近くなるようにOutput Projector θ_T_Xを学習する。これによって、S_XとModality Generatorがalignするようにする。
## Modality Generator
各ModalityをH_Xから生成できるように下記のような損失学習する。要は、生成されたモダリティデータ(または表現)が実際のデータにどれだけ近いか、を表しているらしい。具体的には、サンプリングによって得られたノイズと、モデルが推定したノイズの値がどれだけ近いかを測る、みたいなことをしているらしい。
Multi Modalを理解するモデルだけであれば、Input Projectorの損失のみが学習され、生成までするのであれば、Input/Output Projector, Modality Generatorそれぞれに示した損失関数を通じてパラメータが学習される。あと、P_XやらS_Xはいわゆるsoft-promptingみたいなものであると考えられる。
LLaMA Pro: Progressive LLaMA with Block Expansion, Chengyue Wu+, N_A, ACL'24
Paper/Blog Link My Issue
#NLP #ACL #PostTraining #KeyPoint Notes Issue Date: 2024-01-24 GPT Summary- 本研究では、大規模言語モデル(LLMs)の新しい事前学習後の手法を提案し、モデルの知識を効果的かつ効率的に向上させることを目指しました。具体的には、Transformerブロックの拡張を使用し、新しいコーパスのみを使用してモデルを調整しました。実験の結果、提案手法はさまざまなベンチマークで優れたパフォーマンスを発揮し、知的エージェントとして多様なタスクに対応できることが示されました。この研究は、自然言語とプログラミング言語を統合し、高度な言語エージェントの開発に貢献するものです。 Comment
追加の知識を導入したいときに使えるかも?
事前学習したLLaMA Blockに対して、追加のLLaMA Blockをstackし、もともとのLLaMA Blockのパラメータをfreezeした上でドメインに特化したコーパスで事後学習することで、追加の知識を挿入する。LLaMA Blockを挿入するときは、Linear Layerのパラメータを0にすることで、RMSNormにおける勾配消失の問題を避けた上で、Identity Block(Blockを追加した時点では事前学習時と同様のOutputがされることが保証される)として機能させることができる。
[Paper Note] Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models, Zixiang Chen+, ICML'24, 2024.01
Paper/Blog Link My Issue
#NLP #Alignment #Supervised-FineTuning (SFT) #SyntheticData #SelfImprovement #ICML #mid-training #PostTraining #read-later #Selected Papers/Blogs #KeyPoint Notes #AdversarialTraining #SelfPlay Issue Date: 2024-01-24 GPT Summary- 自己対戦ファインチューニング(SPIN)を提案し、人間の注釈なしで弱いLLMを強化。LLMが自らのインスタンスと対戦し、トレーニングデータを生成。自己生成と人間の応答を識別してポリシーを微調整。SPINは様々なベンチマークでLLMの性能を大幅に向上させ、GPT-4優先データを使ったモデルを上回る成果を示した。 Comment
pj page:
https://uclaml.github.io/SPIN/
code:
https://github.com/uclaml/SPIN
メインプレイヤーは人間とLLMのレスポンスを区別する、対戦相手はメインプレイヤーに対して人間が作成したレスポンスと自身が作成させたレスポンスを区別できないようにするようなゲームをし、両者を同じLLM、しかし異なるiterationのパラメータを採用することで自己対戦させることでSFTデータセットから最大限学習するような手法を提案。メインプレイヤーの目的関数は、人間とLLMのレスポンスの確率の差を最大化するように定式化され(式4.1)、対戦相手は人間が生成したレスポンスを最大化するような損失関数を元のパラメータから大きく乖離しないようにKL正則化付きで定義する(式4.3)。双方の損失を単一の損失関数に統合すると式4.7で表される提案手法のSPIN損失が得られ、これによって与えられたSFTデータに対してレスポンスを各iterationで合成し、合成したレスポンスに対してSPIN損失を適用することでモデルのパラメータをアップデートする。メインプレイヤーの重みは更新された重みを用いて、対戦プレイヤーの重みは一つ前の重みを用いる。
A Comprehensive Survey of Hallucination Mitigation Techniques in Large Language Models, S. M Towhidul Islam Tonmoy+, N_A, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #Hallucination Issue Date: 2024-01-24 GPT Summary- 要約:本論文では、大規模言語モデル(LLMs)における幻覚の問題について調査し、その軽減策について紹介しています。LLMsは強力な言語生成能力を持っていますが、根拠のない情報を生成する傾向があります。この問題を解決するために、Retrieval Augmented Generation、Knowledge Retrieval、CoNLI、CoVeなどの技術が開発されています。さらに、データセットの利用やフィードバックメカニズムなどのパラメータに基づいてこれらの方法を分類し、幻覚の問題に取り組むためのアプローチを提案しています。また、これらの技術に関連する課題や制約についても分析し、将来の研究に向けた基盤を提供しています。
Chain-of-Table: Evolving Tables in the Reasoning Chain for Table Understanding, Zilong Wang+, N_A, ICLR'24
Paper/Blog Link My Issue
#NLP #DataToTextGeneration #Chain-of-Thought #TabularData #ICLR #KeyPoint Notes Issue Date: 2024-01-24 GPT Summary- LLMsを使用したChain-of-Tableフレームワークは、テーブルデータを推論チェーン内で活用し、テーブルベースの推論タスクにおいて高い性能を発揮することが示された。このフレームワークは、テーブルの連続的な進化を表現し、中間結果の構造化情報を利用してより正確な予測を可能にする。さまざまなベンチマークで最先端のパフォーマンスを達成している。 Comment
Table, Question, Operation Historyから次のoperationとそのargsを生成し、テーブルを順次更新し、これをモデルが更新の必要が無いと判断するまで繰り返す。最終的に更新されたTableを用いてQuestionに回答する手法。Questionに回答するために、複雑なテーブルに対する操作が必要なタスクに対して有効だと思われる。
Knowledge Fusion of Large Language Models, Fanqi Wan+, N_A, ICLR'24
Paper/Blog Link My Issue
#MachineLearning #NLP #ICLR #read-later #ModelMerge Issue Date: 2024-01-23 GPT Summary- 本研究では、既存の事前訓練済みの大規模言語モデル(LLMs)を統合することで、1つの強力なモデルを作成する方法を提案しています。異なるアーキテクチャを持つ3つの人気のあるLLMsを使用して、ベンチマークとタスクのパフォーマンスを向上させることを実証しました。提案手法のコード、モデルの重み、およびデータはGitHubで公開されています。
[Paper Note] Self-Rewarding Language Models, Weizhe Yuan+, arXiv'24, 2024.01
Paper/Blog Link My Issue
#NLP #Alignment #InstructionTuning #LLM-as-a-Judge #SelfImprovement #ICML #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-01-22 GPT Summary- 超人間エージェントを実現するには、超人間レベルのフィードバックが必要であると提唱。現在のアプローチは人間の嗜好から報酬モデルを訓練するが、これがボトルネックになりがちである。本研究では自己報酬言語モデルを用い、LLMが自ら報酬を提供する方法を検討。DPOトレーニングにより指示への従順さと自己報酬の質が向上し、Llama 2 70Bをファインチューニングすることで、既存モデルを上回ることが示された。探索の余地は残るが、本研究は改善の可能性を示唆する。 Comment
人間の介入無しで(人間がアノテーションしたpreference data無しで)LLMのAlignmentを改善していく手法。LLM-as-a-Judge Promptingを用いて、LLM自身にpolicy modelとreward modelの役割の両方をさせる。unlabeledなpromptに対してpolicy modelとしてresponceを生成させた後、生成したレスポンスをreward modelとしてランキング付けし、DPOのpreference pairとして利用する、という操作を繰り返す。
[Paper Note] The Impact of Reasoning Step Length on Large Language Models, Mingyu Jin+, ACL'24 Findings, 2024.01
Paper/Blog Link My Issue
#Analysis #NLP #Chain-of-Thought #Reasoning #ACL #Length #Findings Issue Date: 2024-01-16 GPT Summary- Chain of Thought(CoT)がLLMの推論能力向上に重要であることが示された。実験により、推論ステップの長さがLLMの性能に与える影響を調査。推論ステップを長くすることで、追加情報なしでも推論能力が向上し、逆に短くすると性能が著しく低下。これは、CoTプロンプトにおけるステップ数の重要性を示している。また、不正確な合理的根拠でも推論を維持できれば良好な結果が得られることが判明。タスクの複雑さに応じて、推論ステップの利点は異なることも観察された。
[Paper Note] Mixtral of Experts, Albert Q. Jiang+, arXiv'24, 2024.01
Paper/Blog Link My Issue
#NLP #OpenWeight #MoE(Mixture-of-Experts) #One-Line Notes Issue Date: 2024-01-09 GPT Summary- Mixtral 8x7Bは、8つのエキスパートを持つスパース・ミクスチャー・オブ・エキスパーツモデルで、470億パラメータにアクセスしつつ、推論時は130億パラメータのみが活性化される。32kトークンの文脈長で訓練され、Llama 2 70BおよびGPT-3.5を上回る性能を発揮。特に数学やコード生成で優れ、指示に従うよう微調整したモデルも提供され、複数の人間ベンチマークで競合モデルを超えた。 Comment
Mixture of experts Layer: inputを受け取ったrouterが、8つのexpertsのうち2つを選択し順伝搬。2つのexpertsのoutputを加重平均することで最終的なoutputとする。
VILA: On Pre-training for Visual Language Models, Ji Lin+, N_A, CVPR'24
Paper/Blog Link My Issue
#ComputerVision #Analysis #Pretraining #NLP #CVPR #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2023-12-14 GPT Summary- 最近の大規模言語モデルの成功により、ビジュアル言語モデル(VLM)が進歩している。本研究では、VLMの事前学習のためのデザインオプションを検討し、以下の結果を示した:(1) LLMを凍結することでゼロショットのパフォーマンスが達成できるが、文脈に基づいた学習能力が不足している。(2) 交互に行われる事前学習データは有益であり、画像とテキストのペアだけでは最適ではない。(3) テキストのみの指示データを画像とテキストのデータに再ブレンドすることで、VLMのタスクの精度を向上させることができる。VILAというビジュアル言語モデルファミリーを構築し、最先端モデルを凌駕し、優れたパフォーマンスを発揮することを示した。マルチモーダルの事前学習は、VILAの特性を向上させる。 Comment
関連:
- [Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
[Paper Note] The Unlocking Spell on Base LLMs: Rethinking Alignment via In-Context Learning, Bill Yuchen Lin+, ICLR'24, 2023.12
Paper/Blog Link My Issue
#NLP #Alignment #In-ContextLearning #ICLR #KeyPoint Notes Issue Date: 2023-12-05 GPT Summary- LLMのアライメント調整は、SFTとRLHFを含むが、LIMAの研究は1Kの例でも効果的なアライメントが達成できることを示した。基盤LLMとアラインメント版のトークン分布を分析した結果、ほぼ同一の性能を示し、文体的なシフトが顕著であった。このことから、SFTやRLHFなしでのアラインメント手法を探求し、新たにURIALを提案。URIALは、ICLを用い、少数の文体的例で効果的なアライメントを実現し、基盤LLMの性能がSFTによるものと同等、あるいは上回ることを示した。結果はアライメントの表面的性質を再考させるものであり、今後の研究への示唆となる。 Comment
モデルの知識はPre-training時に十分獲得されており、モデルのAlignmentをとることで生じるものは表面的な変化のみであるという仮説がある [Paper Note] LIMA: Less Is More for Alignment, Chunting Zhou+, arXiv'23, 2023.05
。この仮説に関して分析をし、結果的にスタイリスティックな情報を生成する部分でAlignmentの有無で違いが生じることを明らかにし、そうであればわざわざパラメータチューニング(SFT, RLHF)しなくても、適切なサンプルを選択したIn-Context LearningでもAlignmentとれますよ、という趣旨の研究っぽい?
openreview: https://openreview.net/forum?id=wxJ0eXwwda
NeuroPrompts: An Adaptive Framework to Optimize Prompts for Text-to-Image Generation, Shachar Rosenman+, N_A, EACL'24 Sustem Demonstration Track
Paper/Blog Link My Issue
#ComputerVision #NLP #AutomaticPromptEngineering #EACL #System Demonstration Issue Date: 2023-11-23 GPT Summary- 本研究では、テキストから画像への生成モデルの品質を向上させるための適応型フレームワークNeuroPromptsを提案します。このフレームワークは、事前学習された言語モデルを使用して制約付きテキストデコーディングを行い、人間のプロンプトエンジニアが生成するものに類似したプロンプトを生成します。これにより、高品質なテキストから画像への生成が可能となり、ユーザーはスタイルの特徴を制御できます。また、大規模な人間エンジニアリングされたプロンプトのデータセットを使用した実験により、当アプローチが自動的に品質の高いプロンプトを生成し、優れた画像品質を実現することを示しました。
GPQA: A Graduate-Level Google-Proof Q&A Benchmark, David Rein+, N_A, COLM'24
Paper/Blog Link My Issue
#NLP #Dataset #QuestionAnswering #COLM #One-Line Notes Issue Date: 2023-11-22 GPT Summary- 私たちは、高品質で非常に困難な多肢選択問題からなるGPQAデータセットを提案します。このデータセットは、専門家でも高い正答率を達成できず、最先端のAIシステムでも困難であることが示されています。将来のAIシステムの開発において、スケーラブルな監督方法を開発する必要があります。これにより、スキルを持つ監督者がAIシステムから信頼性のある情報を得ることができるようになります。GPQAデータセットは、スケーラブルな監督実験を可能にし、人間の専門家がAIシステムから真実の情報を確実に得る方法を考案するのに役立つことが期待されています。 Comment
該当領域のPh.D所有者でも74%、高いスキルを持つ非専門家(Googleへアクセスして良い環境)で34%しか正答できないQAデータセット。
元ツイート:
OpenReview: https://openreview.net/forum?id=Ti67584b98
Chain-of-Note: Enhancing Robustness in Retrieval-Augmented Language Models, Wenhao Yu+, N_A, EMNLP'24
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #RAG(RetrievalAugmentedGeneration) #EMNLP #KeyPoint Notes Issue Date: 2023-11-17 GPT Summary- 検索補完言語モデル(RALM)は、外部の知識源を活用して大規模言語モデルの性能を向上させるが、信頼性の問題や知識の不足による誤った回答がある。そこで、Chain-of-Noting(CoN)という新しいアプローチを導入し、RALMの頑健性を向上させることを目指す。CoNは、順次の読み取りノートを生成し、関連性を評価して最終的な回答を形成する。ChatGPTを使用してCoNをトレーニングし、実験結果はCoNを装備したRALMが標準的なRALMを大幅に上回ることを示している。特に、ノイズの多いドキュメントにおいてEMスコアで平均+7.9の改善を達成し、知識範囲外のリアルタイムの質問に対する拒否率で+10.5の改善を達成している。 Comment
モデルに検索されたドキュメント対するqueryのrelevance/accuracyの観点からnote-takingをさせることで、RAGの正確性や透明性を向上させる。たとえば、
- surface-levelの情報に依存せずにモデルに理解を促す
- 相反する情報が存在してもrelevantな情報を適切に考慮する,
- 回答プロセスの透明性・解釈性を向上させる
- 検索された文書に対する過剰な依存をなくす(文書が古い, あるいはノイジーな場合に有用)
などが利点として挙げられている。
下記が付録中のCoNで実際に利用されているプロンプト。
非常にシンプルな手法だが、結果としてはノイズが多い場合、CoNによるゲインが大きいことがわかる。
MEGAVERSE: Benchmarking Large Language Models Across Languages, Modalities, Models and Tasks, Sanchit Ahuja+, N_A, NAACL'24
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #Evaluation #MultiLingual #NAACL #VisionLanguageModel Issue Date: 2023-11-14 GPT Summary- LLMsの研究は急速に進展しており、英語以外の言語での評価が必要とされている。本研究では、新しいデータセットを追加したMEGAVERSEベンチマークを提案し、さまざまなLLMsを評価する。実験の結果、GPT4とPaLM2が優れたパフォーマンスを示したが、データの汚染などの問題があるため、さらなる取り組みが必要である。
Prompt Engineering a Prompt Engineer, Qinyuan Ye+, N_A, ACL'24 Findings
Paper/Blog Link My Issue
#NLP #Prompting #AutomaticPromptEngineering #ACL #Findings Issue Date: 2023-11-13 GPT Summary- プロンプトエンジニアリングは、LLMsのパフォーマンスを最適化するための重要なタスクであり、本研究ではメタプロンプトを構築して自動的なプロンプトエンジニアリングを行います。改善されたパフォーマンスにつながる推論テンプレートやコンテキストの明示などの要素を導入し、一般的な最適化概念をメタプロンプトに組み込みます。提案手法であるPE2は、さまざまなデータセットやタスクで強力なパフォーマンスを発揮し、以前の自動プロンプトエンジニアリング手法を上回ります。さらに、PE2は意味のあるプロンプト編集を行い、カウンターファクトの推論能力を示します。
[Paper Note] Tell Your Model Where to Attend: Post-hoc Attention Steering for LLMs, Qingru Zhang+, N_A, ICLR'24
Paper/Blog Link My Issue
#NLP #Attention #ICLR #One-Line Notes #Steering Issue Date: 2023-11-10 GPT Summary- PASTAは、大規模言語モデル(LLMs)において、ユーザーが指定した強調マークのあるテキストを読むことを可能にする手法です。PASTAは、注意の一部を特定し、再重み付けを適用してモデルの注意をユーザーが指定した部分に向けます。実験では、PASTAがLLMの性能を大幅に向上させることが示されています。 Comment
ユーザがprompt中で強調したいした部分がより考慮されるようにattention weightを調整することで、より応答性能が向上しましたという話っぽい。かなり重要な技術だと思われる。後でしっかり読む。
openreview: https://openreview.net/forum?id=xZDWO0oejD
[Paper Note] Re-Reading Improves Reasoning in Large Language Models, Xiaohan Xu+, EMNLP'24, 2023.09
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Prompting #EMNLP #KeyPoint Notes #Reading Reflections Issue Date: 2023-10-30 GPT Summary- Re2は、質問を再読することでLLMの推論能力を高める簡潔かつ効果的なプロンプティング手法です。これは、入力を二度処理することにより理解を深め、CoTなどの思考誘発型手法とも互換性があります。Re2は単方向デコーダーのLLMに対しても双方向エンコーディングを促進し、広範な推論ベンチマークでその有効性を示しました。結果として、Re2は単純な再読戦略を通じてLLMの推論性能を一貫して向上させることが示され、異なるモデルや手法と効果的に統合可能です。 Comment
問題文を2,3回promptで繰り返すだけで、数学のベンチマークとCommonsenseのベンチマークの性能が向上したという非常に簡単なPrompting。self-consistencyなどの他のPromptingとの併用も可能。
なぜ性能が向上するかというと、
1. LLMはAuporegressiveなモデルであり、bidirectionalなモデルではない。このため、forwardパスのみでは読解力に限界がある。(たとえば人間はしばしばテキストを読み返したりする)。そこで、一度目の読解で概要を理解し、二度目の読解でsalience partを読み込むといったような挙動を実現することで、より問題文に対するComprehensionが向上する。
2. LLMはしばしばpromptの重要な箇所の読解を欠落させてしまう。たとえば、[Paper Note] Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu+, arXiv'23, 2023.07
では、promptのmiddle partを軽視する傾向があることが示されている。このような現象も軽減できると考えられる。
問題文の繰り返しは、3回までは性能が向上する。
このpromptingは複雑な問題であればあるほど効果があると推察される。
本手法はReasoningモデル登場依然のものであり、おそらくReasoningモデルではReasoning tokenの生成を通じて動的にcontextにattentionを貼る(つまり必要な箇所は自然にre-readingされる)ため、re-readingと同等以上の効果を得ていることが推察される。
このため、直感的にはこの手法はnon-thinkingモデルに対しては依然として有効な場合はあるかもしれないが、Reasoningモデルにおいては非推奨だと個人的には考える。
[Paper Note] Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection, Akari Asai+, ICLR'24, 2023.10
Paper/Blog Link My Issue
#NLP #Factuality #RAG(RetrievalAugmentedGeneration) #ICLR #KeyPoint Notes #Critic Issue Date: 2023-10-29 GPT Summary- Self-Reflective Retrieval-Augmented Generation(Self-RAG)は、取得と自己反省を通じて大規模言語モデル(LLM)の品質を向上させる新しいフレームワークである。従来の方法が固定数のパッセージを無差別に取得するのに対し、Self-RAGは適応的にパッセージを取得し、reflection tokensを用いて生成と反省を行う。このアプローチにより、さまざまなタスクにおいて最先端のLLMや取得強化モデルを上回り、特に長文生成の事実性と出典の正確性が顕著に向上した。 Comment
RAGをする際の言語モデルの回答の質とfactual consistencyを改善せるためのフレームワーク。
reflection tokenと呼ばれる特殊トークンを導入し、言語モデルが生成の過程で必要に応じて情報をretrieveし、自身で生成内容を批評するように学習する。単語ごとに生成するのではなく、セグメント単位で生成する候補を生成し、批評内容に基づいて実際に生成するセグメントを選択する。
OpenReview: https://openreview.net/forum?id=hSyW5go0v8
[Paper Note] Human Feedback is not Gold Standard, Tom Hosking+, ICLR'24, 2023.09
Paper/Blog Link My Issue
#NLP #Evaluation #ICLR Issue Date: 2023-10-28 GPT Summary- 人間のフィードバックは、大規模言語モデルの性能評価や訓練に重要であるが、好みスコアの主観性と偏りの影響について検証。好みスコアは網羅性が高いが、事実性の評価は不足していると判明。出力の断定性が事実性誤りの認識に影響し、人間の注釈の信頼性についても疑問を提起。人間のフィードバックによる訓練が断定性を偏らせる可能性も示唆。今後は好みスコアの目的との整合性を検討することが推奨される。 Comment
参考:
openreview: https://openreview.net/forum?id=7W3GLNImfS
Detecting Pretraining Data from Large Language Models, Weijia Shi+, N_A, ICLR'24
Paper/Blog Link My Issue
#Pretraining #MachineLearning #NLP #ICLR #One-Line Notes Issue Date: 2023-10-26 GPT Summary- 本研究では、大規模言語モデル(LLMs)を訓練するためのデータの検出問題を研究し、新しい検出方法であるMin-K% Probを提案します。Min-K% Probは、LLMの下で低い確率を持つアウトライアーワードを検出することに基づいています。実験の結果、Min-K% Probは従来の方法に比べて7.4%の改善を達成し、著作権のある書籍の検出や汚染された下流の例の検出など、実世界のシナリオにおいて効果的な解決策であることが示されました。 Comment
実験結果を見るにAUCは0.73-0.76程度であり、まだあまり高くない印象。また、テキストのlengthはそれぞれ32,64,128,256程度。
openreview: https://openreview.net/forum?id=zWqr3MQuNs
[Paper Note] Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models, Huaixiu Steven Zheng+, N_A, ICLR'24
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #ICML #One-Line Notes Issue Date: 2023-10-12 GPT Summary- Step-Back Promptingは、大規模言語モデル(LLMs)を使用して推論の手順をガイドするシンプルなプロンプティング技術です。この技術により、LLMsは具体的な詳細から高レベルの概念や基本原則を抽象化し、正しい推論経路をたどる能力を向上させることができます。実験により、Step-Back PromptingはSTEM、Knowledge QA、Multi-Hop Reasoningなどのタスクにおいて大幅な性能向上が観察されました。具体的には、MMLU Physics and Chemistryで7%、11%、TimeQAで27%、MuSiQueで7%の性能向上が確認されました。 Comment
また新しいのが出た。ユーザのクエリに対して直接応答しようとするのではなく、より高次で抽象的・原則的な問いを生成しそこから事実情報を得て、その事実情報にgroundingされた推論によって答えを導く。
openreview: https://openreview.net/forum?id=3bq3jsvcQ1
Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N_A, ICLR'24
Paper/Blog Link My Issue
#Pretraining #NLP #One-Line Notes Issue Date: 2023-10-10 GPT Summary- 言語モデルのトレーニングと推論において、遅延を導入することでモデルの性能を向上させる手法を提案しました。具体的には、入力に特定のトークンを追加し、そのトークンが現れるまでモデルの出力を遅らせることで、追加の計算を行うことができます。実験結果では、この手法が推論タスクにおいて有益であり、特にQAタスクでの性能向上が見られました。今後は、この遅延予測の手法をさらに研究していく必要があります。 Comment
この研究は興味深いが、事前学習時に入れないと効果が出にくいというのは直感的にわかるので、実用的には活用しづらい。
また、promptでこの研究をimitateする方法については、ZeroShot CoTにおいて、思考プロセスを明示的に指定するようなpromptingと同様のことを行っており、これは実際に効果があると思う。
Enhancing Zero-Shot Chain-of-Thought Reasoning in Large Language Models through Logic, Xufeng Zhao+, N_A, COLING'24
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #COLING Issue Date: 2023-10-09 GPT Summary- 大規模言語モデルの進歩は驚異的だが、多段階の推論には改善の余地がある。大規模言語モデルは知識を持っているが、推論には一貫性がなく、幻覚を示すことがある。そこで、Logical Chain-of-Thought(LogiCoT)というフレームワークを提案し、論理による推論パラダイムの効果を示した。
Graph Neural Prompting with Large Language Models, Yijun Tian+, N_A, AAAI'24
Paper/Blog Link My Issue
#GraphBased #NLP #KnowledgeGraph #Prompting #AAAI #One-Line Notes #SoftPrompt Issue Date: 2023-10-09 GPT Summary- 本研究では、大規模言語モデル(LLMs)を知識グラフと組み合わせるための新しい手法であるGraph Neural Prompting(GNP)を提案しています。GNPは、標準的なグラフニューラルネットワークエンコーダやクロスモダリティプーリングモジュールなどの要素から構成されており、異なるLLMのサイズや設定において、常識的な推論タスクやバイオメディカル推論タスクで優れた性能を示すことが実験によって示されました。 Comment
元ツイート:
事前学習されたLLMがKGから有益な知識を学習することを支援する手法を提案。
しっかり論文を読んでいないが、freezeしたLLMがあった時に、KGから求めたGraph Neural Promptを元のテキストと組み合わせて、新たなLLMへの入力を生成し利用する手法な模様。
Graph Neural Promptingでは、Multiple choice QAが入力された時に、その問題文や選択肢に含まれるエンティティから、KGのサブグラフを抽出し、そこから関連性のある事実や構造情報をエンコードし、Graph Neural Promptを獲得する。そのために、GNNに基づいたアーキテクチャに、いくつかの工夫を施してエンコードをする模様。
つまりKGの情報を保持したSoft Prompting手法というイメージだろうか。
[Paper Note] Chain-of-Verification Reduces Hallucination in Large Language Models, Shehzaad Dhuliawala+, N_A, ACL'24
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Chain-of-Thought #Prompting #Hallucination #ACL #Selected Papers/Blogs #Verification Issue Date: 2023-09-30 GPT Summary- 私たちは、言語モデルが根拠のない情報を生成する問題に取り組んでいます。Chain-of-Verification(CoVe)メソッドを開発し、モデルが回答を作成し、検証し、最終的な回答を生成するプロセスを経ることで、幻想を減少させることができることを実験で示しました。 Comment
# 概要
ユーザの質問から、Verificationのための質問をplanningし、質問に対して独立に回答を得たうえでオリジナルの質問に対するaggreementを確認し、最終的に生成を実施するPrompting手法
# 評価
## dataset
- 全体を通じてclosed-bookの設定で評価
- Wikidata
- Wikipedia APIから自動生成した「“Who are some [Profession]s who were born in [City]?”」に対するQA pairs
- Goldはknowledge baseから取得
- 全56 test questions
- Gold Entityが大体600程度ありLLMは一部しか回答しないので、precisionで評価
- Wiki category list
- QUEST datasetを利用 [Paper Note] QUEST: A Retrieval Dataset of Entity-Seeking Queries with Implicit Set Operations, Chaitanya Malaviya+, arXiv'23, 2023.05
- 回答にlogical operationが不要なものに限定して頭に"Name some"をつけて質問を生成
- "Name some Mexican animated horror films" or "Name some Endemic orchids of Vietnam"
- 8個の回答を持つ55 test questionsを作成
- MultiSpanQA
- Reading Comprehensionに関するBenchmark dataset
- 複数の独立した回答(回答は連続しないスパンから回答が抽出される)から構成される質問で構成
- 特に、今回はclosed-book setting で実施
- すなわち、与えられた質問のみから回答しなければならず、知っている知識が問われる問題
- 418のtest questsionsで、各回答に含まれる複数アイテムのspanが3 token未満となるようにした
- QA例:
- Q: Who invented the first printing press and in what year?
- A: Johannes Gutenberg, 1450.
# 評価結果
提案手法には、verificationの各ステップでLLMに独立したpromptingをするかなどでjoint, 2-step, Factored, Factor+Revisedの4種類のバリエーションがあることに留意。
- joint: 全てのステップを一つのpromptで実施
- 2-stepは2つのpromptに分けて実施
- Factoredは各ステップを全て異なるpromptingで実施
- Factor+Revisedは異なるpromptで追加のQAに対するcross-checkをかける手法
結果を見ると、CoVEでhallucinationが軽減(というより、モデルが持つ知識に基づいて正確に回答できるサンプルの割合が増えるので実質的にhallucinationが低減したとみなせる)され、特にjointよりも2-step, factoredの方が高い性能を示すことがわかる。
[Paper Note] Large Language Models as Optimizers, Chengrun Yang+, ICLR'24, 2023.09
Paper/Blog Link My Issue
#MachineLearning #NLP #AutomaticPromptEngineering #ICLR #Selected Papers/Blogs #KeyPoint Notes #Reading Reflections Issue Date: 2023-09-09 GPT Summary- 最適化タスクを自然言語で記述するアプローチ、Optimization by PROmpting(OPRO)を提案。大規模言語モデル(LLMs)を用いて以前の解を基に新しい解を生成し、プロンプトに追加。線形回帰や巡回セールスマン問題での実証に続き、プロンプト最適化を行い、タスク精度を最大化。OPROで最適化されたプロンプトは、人間設計のものをGSM8Kで最大8%、Big-Bench Hardで最大50%上回ることを確認。 Comment
`Take a deep breath and work on this problem step-by-step. `論文
# 概要
LLMを利用して最適化問題を解くためのフレームワークを提案したという話。論文中では、linear regressionや巡回セールスマン問題に適用している。また、応用例としてPrompt Engineeringに利用している。
これにより、Prompt Engineeringが最適か問題に落とし込まれ、自動的なprompt engineeringによって、`Let's think step by step.` よりも良いプロンプトが見つかりましたという話。
# 手法概要
全体としての枠組み。meta-promptをinputとし、LLMがobjective functionに対するsolutionを生成する。生成されたsolutionとスコアがmeta-promptに代入され、次のoptimizationが走る。これを繰り返す。
Meta promptの例
openreview: https://openreview.net/forum?id=Bb4VGOWELI
テキスト空間上で過去の履歴とスコアが与えられ、それをgivenにスコアが良くなりそうなものをLLMがiterativeに生成していくことが可能なことが示されたのが興味深い
CausalLM is not optimal for in-context learning, Nan Ding+, N_A, ICLR'24
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #In-ContextLearning #ICLR #Reading Reflections Issue Date: 2023-09-01 GPT Summary- 最近の研究では、トランスフォーマーベースのインコンテキスト学習において、プレフィックス言語モデル(prefixLM)が因果言語モデル(causalLM)よりも優れたパフォーマンスを示すことがわかっています。本研究では、理論的なアプローチを用いて、prefixLMとcausalLMの収束挙動を分析しました。その結果、prefixLMは線形回帰の最適解に収束する一方、causalLMの収束ダイナミクスはオンライン勾配降下アルゴリズムに従い、最適であるとは限らないことがわかりました。さらに、合成実験と実際のタスクにおいても、causalLMがprefixLMよりも性能が劣ることが確認されました。 Comment
参考:
CausalLMでICLをした場合は、ICL中のdemonstrationでオンライン学習することに相当し、最適解に収束しているとは限らない……?が、hillbigさんの感想に基づくと、結果的には実は最適解に収束しているのでは?という話も出ているし、よく分からない。
Graph of Thoughts: Solving Elaborate Problems with Large Language Models, Maciej Besta+, N_A, AAAI'24
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #AAAI Issue Date: 2023-08-22 GPT Summary- 私たちは、Graph of Thoughts(GoT)というフレームワークを紹介しました。これは、大規模言語モデル(LLMs)のプロンプティング能力を進化させるもので、任意のグラフとしてモデル化できることが特徴です。GoTは、思考の組み合わせやネットワーク全体の本質の抽出、思考の強化などを可能にします。さまざまなタスクで最先端の手法に比べて利点を提供し、LLMの推論を人間の思考に近づけることができます。 Comment
Chain of Thought [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
=> Self-consistency [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
=> Thought Decomposition Decomposition Enhances Reasoning via Self-Evaluation Guided Decoding, Yuxi Xie+, N/A, arXiv'23
=> Tree of Thoughts [Paper Note] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, Shunyu Yao+, arXiv'23, 2023.05
Tree of Thought Large Language Model Guided Tree-of-Thought, Jieyi Long, N/A, arXiv'23
=> Graph of Thought
[Paper Note] MLCopilot: Unleashing the Power of Large Language Models in Solving Machine Learning Tasks, Lei Zhang+, EACL'24, 2023.04
Paper/Blog Link My Issue
#MachineLearning #NLP #AutoML #EACL Issue Date: 2023-08-10 GPT Summary- LLMを用いて新規のMLタスク解決を自動化するフレームワークを提案。これにより、人間の知識と経験を活かし、タスク理解と推論を強化。LLMは既存経験から学び、新たなタスクに対して効果的な解決策を生成し、高い競争力を持つことを示す。コードはGitHubで公開。
[Paper Note] SciBench: Evaluating College-Level Scientific Problem-Solving Abilities of Large Language Models, Xiaoxuan Wang+, N_A, ICML'24
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #ICML Issue Date: 2023-07-22 GPT Summary- 本研究では、大規模言語モデル(LLMs)の進歩により、数学のベンチマークでの性能向上が示されているが、これらのベンチマークは限定的な範囲の問題に限定されていることが指摘される。そこで、複雑な科学的問題解決に必要な推論能力を検証するための包括的なベンチマークスイートSciBenchを提案する。SciBenchには、大学レベルの科学的問題を含むオープンセットと、学部レベルの試験問題を含むクローズドセットの2つのデータセットが含まれている。さらに、2つの代表的なLLMを用いた詳細なベンチマーク研究を行い、現在のLLMのパフォーマンスが不十分であることを示した。また、ユーザースタディを通じて、LLMが犯すエラーを10の問題解決能力に分類し、特定のプロンプティング戦略が他の戦略よりも優れているわけではないことを明らかにした。SciBenchは、LLMの推論能力の向上を促進し、科学研究と発見に貢献することを目指している。
[Paper Note] Teaching Arithmetic to Small Transformers, Nayoung Lee+, ICLR'24, 2023.07
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #NumericReasoning #Mathematics #KeyPoint Notes #Reading Reflections Issue Date: 2023-07-11 GPT Summary- 小型トランスフォーマーが次語予測を用いて基本的な算術演算(加算、乗算、平方根)を学習できるかを調査。従来のデータが効果的でないことを示し、形式変更で精度が向上することを確認。Chain-of-Thoughtスタイルのデータで訓練することで、事前訓練なしでも精度と収束速度を改善。算術データとテキストデータの相互作用や少数ショット promptingの影響を考察し、高品質なデータの重要性を強調。 Comment
小規模なtransformerに算術演算を学習させ、どのような学習データが効果的か調査。CoTスタイルの詳細なスクラッチパッドを学習データにすることで、plainなもの等と比較して、予測性能や収束速度などが劇的に改善した
結局next token predictionで学習させているみたいだけど、本当にそれで算術演算をモデルが理解しているのだろうか?という疑問がいつもある
↑この3年前の感想は、現在は良質なreasoning trajectioryを用いたSFTにってreasoning能力が強化できることを考えると一部解決されている。少なくとも、next token predictionによって(汎化性能は置いておいて)特定分野でのreasoning能力を身につけさせることができることは分かっているため、真に"理解"しているかはわからないが、少なくともモデル自身の能力で思考し問題を解けることは実験的に示されている。
事前学習によって知識を学習し、中間学習や事後学習で知識の使い方や特定の能力を現在では伸ばしているが、この研究だはスクラッチパッドを用いた事前学習データを使っているようなので、数学の解き方の知識と使い方を同時に学習できていると考えられる。
(3年前の感想を今見返すとおもしろいな)
openreview: https://openreview.net/forum?id=dsUB4bst9S
[Paper Note] Causal Reasoning and Large Language Models: Opening a New Frontier for Causality, Emre Kıcıman+, TMLR'24, 2023.04
Paper/Blog Link My Issue
#Analysis #NLP #Reasoning #TMLR #Generalization Issue Date: 2023-05-04 GPT Summary- 本研究では、大規模言語モデル(LLMs)の因果的議論生成能力をベンチマークし、様々なタスクで既存手法を上回る性能を示しました。特に、GPT-3.5および4は因果発見や反事実的推論タスクで高い精度を達成し、データセットの記憶だけでは説明できない能力を持つことが確認されました。しかし、LLMsには予測不可能な失敗モードがあり、改善の余地があることも指摘されています。LLMsは因果分析の労力を削減する可能性があり、今後はLLMsと既存の因果技術を組み合わせたアルゴリズムの開発が期待されます。 Comment
openreview: https://openreview.net/forum?id=mqoxLkX210
tmlr blog: https://medium.com/@TmlrOrg/announcing-the-2025-tmlr-outstanding-certification-e26d548ff011
[Paper Note] PandaLM: An Automatic Evaluation Benchmark for LLM Instruction Tuning Optimization, Yidong Wang+, ICLR'24, 2023.06
Paper/Blog Link My Issue
#Tools #NLP #Evaluation #SmallModel #LLM-as-a-Judge #Reproducibility #Privacy #KeyPoint Notes Issue Date: 2023-04-30 GPT Summary- 指示チューニングされたLLMの評価が難しいため、PandaLMを導入し、応答の客観的な正確性に加え、簡潔さや明瞭さなどの主観的要因にも対処。人間生成のテストデータで信頼性を確保し、PandaLM-7BがGPT-3.5の93.75%、GPT-4の88.28%に相当する評価能力を示す。PandaLMによるモデルは、従来のモデルに比べて評価を公正かつ低コストで行える。全リソースは公開中。 Comment
github:
https://github.com/WeOpenML/PandaLM
異なるLLMを再現性のある形で評価するためのpairwiseなLLM-as-a-judgeに基づくライブラリ。人間の嗜好をアノテーションしたデータを収集しLLaMAをベースにSFTすることで、PandaLMを学習。PandaLMはsubjectiveな要素も考慮して応答の良さをjudgeできる。このPandaLM-7Bをローカルで動作させる枠組みでプライバシーに配慮した上で、GPT-4級のLLM-as-a-Judgeを実施できる。
2つの異なるLLMのoutputを比較し、どちらが優れているか理由付きで説明する。人間が作成して1000サンプルの多様なアノテーションデータセットを使い評価できる。
openreview: https://openreview.net/forum?id=5Nn2BLV7SB
[Paper Note] Harnessing the Power of LLMs in Practice: A Survey on ChatGPT and Beyond, Jingfeng Yang+, TKDD'24, 2023.04
Paper/Blog Link My Issue
#Survey #NLP #One-Line Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)の実践的なガイドを提供し、自然言語処理(NLP)タスクにおけるモデルやデータの活用法を論じる。GPT系およびBERT系の紹介から始まり、事前学習や訓練データの影響を考察。さらに、さまざまなNLPタスクの使用ケースや非使用ケースを詳細に分析し、実世界でのLLMsの適用限界について触れる。偽りのバイアス、効率性、コストなどの課題に言及し、研究者と実務者に有益なベストプラクティスを提案。更新リストも提供。 Comment
LLMに関するチュートリアル
encoder-onlyとまとめられているものの中には、デコーダーがあるものがあり(autoregressive decoderではない)、
encoder-decoderは正しい意味としてはencoder with autoregressive decoderであり、
decoder-onlyは正しい意味としてはautoregressive encoder-decoder
とのこと。
[Paper Note] Active Prompting with Chain-of-Thought for Large Language Models, Shizhe Diao+, ACL'24, 2023.02
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Chain-of-Thought #ACL #KeyPoint Notes #needs-revision Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)の性能向上には、タスク特有のプロンプト設計が重要であり、特に連鎖的思考(CoT)を活用したアプローチが効果的です。この研究では、Active-Promptという新手法を提案し、タスク特有の質問に対する最適なアノテーションを選定することでLLMsを適応させます。不確実性に基づくアクティブラーニングを取り入れ、最も不確実な質問を対象にする指標を導入。実験により、提案手法が8つの複雑な推論タスクで最先端の成績を達成し、有効性が示されました。 Comment
しっかりと読めていないが、CoT-answerが存在しないtrainingデータが存在したときに、nサンプルにCoTとAnswerを与えるだけでFew-shotの予測をtestデータに対してできるようにしたい、というのがモチベーションっぽい
そのために、questionに対して、training dataに対してFew-Shot CoTで予測をさせた場合やZero-Shot CoTによって予測をさせた場合などでanswerを取得し、answerのばらつき度合いなどから不確実性を測定する。
そして、不確実性が高いCoT-Answerペアを取得し、人間が手作業でCoTと回答のペアを与え、その人間が作成したものを用いてTestデータに対してFewShotしましょう、ということだと思われる。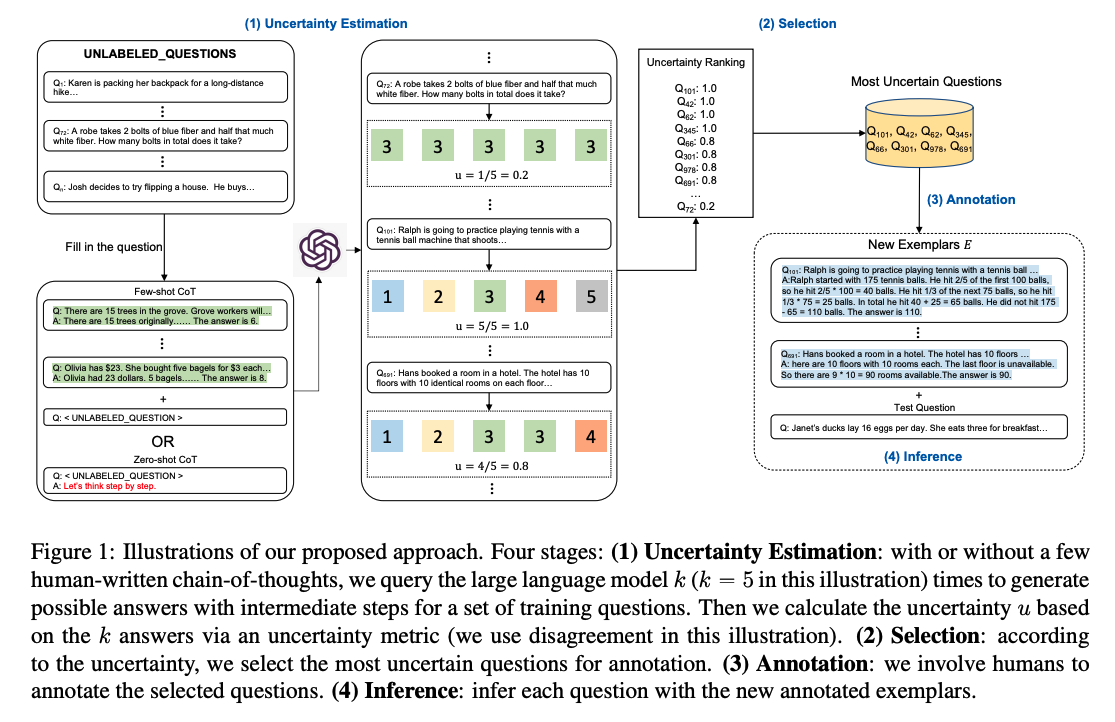
AudioGPT: Understanding and Generating Speech, Music, Sound, and Talking Head, AAAI'24
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #SpeechProcessing #AAAI #One-Line Notes Issue Date: 2023-04-26 Comment
text, audio, imageといったマルチモーダルなpromptから、audioに関する様々なタスクを実現できるシステム
マルチモーダルデータをjointで学習したというわけではなく、色々なモデルの組み合わせてタスクを実現しているっぽい
[Paper Note] Scaling Instruction-Finetuned Language Models, Hyung Won Chung+, JMLR'24, 2022.10
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #InstructionTuning #OpenWeight #Selected Papers/Blogs #One-Line Notes #Scalability #JMLR Issue Date: 2023-04-26 GPT Summary- 指示に基づくファインチューニングは、言語モデルの性能と一般化を向上させる。特に、タスク数やモデルサイズのスケーリング、チェーン・オブ・思考データでの適用が効果的。Flan‑PaLM 540Bは1,800件のタスクでファインチューニングを行い、PaLM 540Bを平均+9.4%上回り、最先端の結果を出している。Flan‑T5も強力なFew-shot性能を示し、指示に基づくファインチューニングがモデルの性能向上に寄与することを確認した。 Comment
T5をinstruction tuningしたFlanT5の研究
HF: https://huggingface.co/docs/transformers/model_doc/flan-t5
先行研究:
- [Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
[Paper Note] LaMP: When Large Language Models Meet Personalization, Alireza Salemi+, ACL'24, 2023.04
Paper/Blog Link My Issue
#NLP #Dataset #PersonalizedGeneration #ACL #Surface-level Notes Issue Date: 2023-04-26 GPT Summary- 本論文は大規模言語モデルにおける個別化の重要性を示し、個別化出力を生成するための新しい評価フレームワーク「LaMPベンチマーク」を提案。LaMPは多様な言語タスクを網羅し、個々のユーザープロフィールに基づく複数のエントリを提供。7つの個別化タスクを含み、2つの取得補強アプローチを提案して出力のパーソナライズを図る。広範な実験により、提案手法の有効性と自然言語タスクにおける個別化の影響が確認された。 Comment
# 概要
Personalizationはユーザのニーズや嗜好に応えるために重要な技術で、IRやRecSysで盛んに研究されてきたが、NLPではあまり実施されてこなかった。しかし、最近のタスクで、text classificationやgeneration taskでPersonalizationの重要性が指摘されている。このような中で、LLMでpersonalizedなレスポンスを生成し、評価することはあまり研究されていない。そこで、LaMPベンチマークを生成し、LLMにおけるPersonalizationをするための開発と評価をするための第一歩として提案している。
# Personalizing LLM Outputs
LLMに対してPersonalizedなoutputをさせるためには、profileをpromptに埋め込むことが基本的なアプローチとなる。
## Problem Formulation
まず、user profile(ユーザに関するrecordの集合)をユーザとみなす。データサンプルは以下の3つで構成される:
- x: モデルのinputとなるinput sequence
- y: モデルが生成することを期待するtarget output
- u: user profile(ユーザの嗜好やrequirementsを捉えるための補助的な情報)
そして、p(y | x, u) を最大化する問題として定式化される。それぞれのユーザuに対して、モデルは{(x_u1, y_u1,)...(x_un, y_un)}を利用することができる。
## A Retrieval Augmentation Approach for Personaliozing LLMs
user profileは基本的にめちゃめちゃ多く、promptに入れ込むことは非現実的。そこで、reteival augmentation approachと呼ばれる手法を提案している。LLMのcontext windowは限られているので、profileのうちのsubsetを利用することが現実的なアプローチとなる。また、必ずしも全てのユーザプロファイルがあるタスクを実施するために有用とは限らない。このため、retrieval augmentation approachを提案している。
retrieval augmentation approachでは、現在のテストケースに対して、relevantな部分ユーザプロファイルを選択的に抽出するフレームワークである。
(x_i, y_i)に対してpersonalizationを実現するために、3つのコンポーネントを採用している:
1. query generation function: x_iに基づきuser profileからrelevantな情報を引っ張ってくるquery qを生成するコンポーネント
2. retrieval model R(q, P_u, k): query q, プロファイルP_u, を用いて、k個のrelevantなプロファイルを引っ張ってくるモデル
3. prompt construction function: xとreteival modelが引っ張ってきたエントリからpromptを作成するコンポーネント
1, 2, 3によって生成されたprompt x^barと、yによってモデルを訓練、あるいは評価する。
この研究では、Rとして Contriever Contrirever
, BM25, random selectionの3種類を用いている。
# LaMPベンチマーク
GLUEやSuper Glue、KILT、GENといったベンチマークは、"one-size-fits-all"なモデリングと評価を前提としており、ユーザのニーズに答えるための開発を許容していない。一方で、LaMPは、以下のようなPersonalizationが必要なさまざまなタスクを統合して作成されたデータセットである。
- Personalized Text Classification
- Personalized Citation Identification (binary classification)
- Task definition
- user u が topic xに関する論文を書いたときに、何の論文をciteすべきかを決めるタスク
- user uが書いた論文のタイトルが与えられたとき、2つのcandidate paperのうちどちらをreferenceとして利用すべきかを決定する2値分類
- Data Collection
- Citation Network Datasetを利用。最低でも50本以上論文を書いているauthorを抽出し、authorの論文のうちランダムに論文と論文の引用を抽出
- negative document selectionとして、ランダムに共著者がciteしている論文をサンプリング
- Profile Specification
- ユーザプロファイルは、ユーザが書いた全てのpaper
- titleとabstractのみをuser profileとして保持した
- Evaluation
- train/valid/testに分け、accuracyで評価する
- Personalized News Categorization (15 category分類)
- Task definition
- LLMが journalist uによって書かれたニュースを分類する能力を問うタスク
- u によって書かれたニュースxが与えられた時、uの過去の記事から得られるカテゴリの中から該当するカテゴリを予測するタスク
- Data Collection
- news categorization datasetを利用(Huff Postのニュース)
- 記事をfirst authorでグルーピング
- グルーピングした記事群をtrain/valid/testに分割
- それぞれの記事において、記事をinputとし、その記事のカテゴリをoutputとする。そして残りの記事をuser profileとする。
- Profile Specification
- ユーザによって書かれた記事の集合
- Evaluation
- accuracy, macro-averaged F1で評価
- Personalized Product Rating (5-star rating)
- Task definition
- ユーザuが記述したreviewに基づいて、LLMがユーザuの未知のアイテムに対するratingを予測する性能を問う
- Data Collection
- Amazon Reviews Datasetを利用
- reviewが100件未満、そしてほとんどのreviewが外れ値なユーザ1%を除外
- ランダムにsubsetをサンプリングし、train/valid/testに分けた
- input-output pairとしては、inputとしてランダムにユーザのreviewを選択し、その他のreviewをprofileとして利用する。そして、ユーザがinputのレビューで付与したratingがground truthとなる。
- Profile Specification
- ユーザのレビュ
- Evaluation
- ttrain/valid/testに分けてRMSE, MAEで評価する
- Personalized Text Generation
- Personalized News Headline Generation
- Task definition
- ユーザuが記述したニュースのタイトルを生成するタスク
- 特に、LLMが与えられたprofileに基づいてユーザのinterestsやwriting styleを捉え、適切にheadlinに反映させる能力を問う
- Data Collection
- News Categorization datasetを利用(Huff Post)
- データセットではauthorの情報が提供されている
- それぞれのfirst authorごとにニュースをグルーピングし、それぞれの記事をinput, headlineをoutputとした。そして残りの記事をprofileとした
- Profile Specification
- ユーザの過去のニュース記事とそのheadlineの集合をprofileとする
- Evaluation
- ROUGE-1, ROUGE-Lで評価
- Personalized Scholarly Title Generation
- Task Definition
- ユーザの過去のタイトルを考慮し、LLMがresearch paperのtitleを生成する能力を測る
- Data Collection
- Citation Network Datasetのデータを利用
- abstractをinput, titleをoutputとし、残りのpaperをprofileとした
- Profile Specification
- ユーザが書いたpaperの集合(abstractのみを利用)
- Personalized Email Subject Generation
- Task Definition
- LLMがユーザのwriting styleに合わせて、Emailのタイトルを書く能力を測る
- Data Collection
- Avocado Resaerch Email Collectionデータを利用
- 5単語未満のsubjectを持つメール、本文が30単語未満のメールを除外、
- 送信主のemail addressでメールをグルーピング
- input _outputペアは、email本文をinputとし、対応するsubjectをoutputとした。他のメールはprofile
- Profile Specification
- ユーザのemailの集合
- Evaluation
- ROUGE-1, ROUGE-Lで評価
- Personalized Tweet Paraphrasing
- Task Definition
- LLMがユーザのwriting styleを考慮し、ツイートのparaphrasingをする能力を問う
- Data Collection
- Sentiment140 datasetを利用
- 最低10単語を持つツイートのみを利用
- userIDでグルーピングし、10 tweets以下のユーザは除外
- ランダムに1つのtweetを選択し、ChatGPT(gpt-3.5-turbo)でparaphraseした
- paraphrase版のtweetをinput, 元ツイートをoutputとし、input-output pairを作った。
- User Profile Specification
- ユーザの過去のツイート
- Evaluation
- ROUGE-1, ROUGE-Lで評価
# 実験
## Experimental Setup
- FlanT5-baesをfinetuningした
- ユーザ単位でモデルが存在するのか否かが記載されておらず不明
## 結果
- Personalization入れた方が全てのタスクでよくなった
- Retrievalモデルとしては、randomの場合でも良くなったが、基本的にはContrirverを利用した場合が最も良かった
- => 適切なprofileを選択しpromptに含めることが重要であることが示された
- Rが抽出するサンプル kを増やすと、予測性能が増加する傾向もあったが、一部タスクでは性能の低下も招いた
- dev setを利用し、BM25/Contrieverのどちらを利用するか、kをいくつに設定するかをチューニングした結果、全ての結果が改善した
- FlanT5-XXLとgpt-3.5-turboを用いたZero-shotの設定でも実験。tweet paraphrasingタスクを除き、zero-shotでもuser profileをLLMで利用することでパフォーマンス改善。小さなモデルでもfinetuningすることで、zero-shotの大規模モデルにdownstreamタスクでより高い性能を獲得することを示している(ただし、めちゃめちゃ改善しているというわけでもなさそう)。


# LaMPによって可能なResearch Problem
## Prompting for Personalization
- Augmentationモデル以外のLLMへのユーザプロファイルの埋め込み方法
- hard promptingやsoft prompting [Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
の活用
## Evaluation of Personalized Text Generation
- テキスト生成で利用される性能指標はユーザの情報を評価のプロセスで考慮していない
- Personalizedなテキスト生成を評価するための適切なmetricはどんなものがあるか?
## Learning to Retrieve from User Profiles
- Learning to RankをRetrieval modelに適用する方向性
LaMPの作成に利用したテンプレート一覧
実装とleaderboard
https://lamp-benchmark.github.io/leaderboard
[Paper Note] Contrastive Decoding: Open-ended Text Generation as Optimization, Xiang Lisa Li+, ACL'23, 2022.10
Paper/Blog Link My Issue
#NLP #Coherence #ACL #Decoding #Selected Papers/Blogs #reading #One-Line Notes Issue Date: 2026-10-02 GPT Summary- LMに対し、大規模LMと小規模LMの尤度差を用いて対照的目的関数を最適化する対照的デコーディング(CD)を提案。もっともらしさの制約により、反復や話題逸脱を抑え、一貫性の高いテキストを生成する。追加学習なしで、核サンプリングやtop-kなどの既存手法を上回る性能を達成。 Comment
事前学習済み言語モデルに対してサンプリングを行いテキストを生成するアプローチは、長いシーケンスとなるとエラーが蓄積し一貫性が欠如したり、トピックが逸脱する課題がある。一方、greedyにデコードをするとしばしば短く、多様性に乏しく、同じ語彙が反復的に出現するようなテキストが生成されてしまう。これに対して、本研究はContrastive Decodingと呼ばれる、一貫性を保ちながら、流暢で多様な語彙に基づく生成を可能とするデコーディング手法を提案している。
Contrastive Decodingでは、エキスパートとアマチュアモデルを用意し(前者は同じシリーズの大規模モデル、後者は小規模モデル)、エキスパートモデルが高い対数尤度を持つという制約のもと、エキスパートとアマチュアモデルの対数尤度の差が最大となるようなテキストを探索する。
言語モデルの典型的なfailure modeはエキスパートよりもアマチュアにおいてより表出しやすいため、対数尤度の差分を見ることで、エキスパートがアマチュアと比較してより高い確率質量を割り当てているトークン列を強調する。
Figure 1がContrastive Decodingの他のデコーディング手法に対する利点を説明した図であり、この例では1961が適切であるが、greedy、サンプリングベースな手法の欠点を説明している。すなわに、エキスパートモデルは直前に出現したトークン、HawaiiやHonoluluに高い確率質量を置いてしまうため、greedyにデコーディングするとそれらが出力され、反復的なテキストが生成される。一方、Washingtonのようなトークンがサンプリングされると、支離滅裂なテキストとなる。Contrastive Decodingでは、これら典型的なfailure modeが抑制され、エキスパートでより高い確率質量を割り当てる傾向が強くなるトークン、たとえばこの例であれば事実に基づく1961というトークンを強調したようなスコアを得ることができる。
[Paper Note] A Simple and Effective Pruning Approach for Large Language Models, Mingjie Sun+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Pruning #ICLR Issue Date: 2026-08-02 GPT Summary- Wanda(Weights and Activationsによる剪定)は、再訓練なしでLLMのスパース性を誘導する新しい剪定法。活性化が小さい重みを対象に剪定を行い、性能を維持。LLaMAおよびLLaMA-2での評価において、従来の剪定法より優れた結果を示す。 Comment
openreview: https://openreview.net/forum?id=PxoFut3dWW
[Paper Note] Function Vectors in Large Language Models, Eric Todd+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Analysis #NLP #ICLR #Selected Papers/Blogs #reading #KeyPoint Notes Issue Date: 2026-06-02 GPT Summary- 自己回帰型トランスフォーマーLMsにおける入力と出力の関数を表すベクトルとしてのファンクションベクトル(FV)の存在を示す。因果媒介分析を用いて、少数のアテンションヘッドがタスクのコンパクトな表現を伝達することを確認し、FVがゼロショットや自然言語テキストのICLタスクに対しても頑健であることを明らかにした。中間層間での因果効果が強いことが判明し、FVには出力空間を符号化する情報が含まれているが、これだけではFVの再構成は不可である。さらに、FVにおける意味ベクトルの組成を調査し、足し合わせることで新たなタスクを引き起こすことができることを示した。これにより、関数抽象のコンパクトで因果的な内部表現をLLMsから抽出できることが確認された。 Comment
openreview: https://openreview.net/forum?id=AwyxtyMwaG
本研究では、In-context Learningを実施した際のLLMにおいて、あるタスクにおいて応答を生成する際に、当該タスクで必要な変換に関する情報を保持しているベクトル(Function Vectors)が、LLMの attention_ output に存在することを示唆する結果を得た。Function Vectorsは直接的にタスクを実施するわけではないが、特定の手続きを言語モデル内で遂行させるトリガーの役割を果たす。
Function Vectorを検出するために、あるタスク t において、Figure 2のようなinput-outputのペア (x_i, y_i) のみで promptingをすることでタスクを遂行させる方法を考える。また、prompt p が与えられたときに、outputをランダムな出力~y_iに変更した input-outputペア (x_i, ~y_i) prompt ~pを考える。このとき、あるタスクの遂行に強い影響を与えるLLM中のactivationを特定したい。
このために、本研究ではトークンをまたいだ情報のやりとりはattentionを介して実行されることから、分析対象をattentionに限定し、まず正常な in-context prompt p を入力した際の全てのlayer l のattention output a_lj (jはheadのindex) を計算する。続いて、ランダムな出力に置換され破損した in-context prompt ~p を入力した際に、ある layer l, head j のattentionを正常なin-context prompt p に基づいて計算されたものと置換して出力をさせ、正解 y_i を復元させる効果 Causal Indrect Effect (CIE) を 式(3)により定義する。つまり、破損したprompt ~pを利用した場合に、attentionを置換する前後によって、どれだけ正解y_iが得られる確率が大きくなったか、を測定している。
このCIEを全てのタスクに対して計算し、平均化することで、各種attention headのAverage Indirect Effectを計算する(式4)。これにより、どのattention headがタスクの遂行において強い因果的な影響力を保持するかを特定する。最終的に、AIEの値が大きなattention head集合Aを考えることができ、この少数のattention headの集合が、ICLタスクを特定し情報を伝達する役割を果たしているという仮説を立てることができる。また、Aが与えられたとき、a_ljのあるタスク t におけるactivationの平均をとることによって、1つのベクトルとして表現することができ、このベクトルのことをFunction Vector と呼ぶ(式5)。
[Paper Note] A Theory on Adam Instability in Large-Scale Machine Learning, Igor Molybog+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NeuralNetwork #Analysis #MachineLearning #NLP #Optimizer #Stability Issue Date: 2026-05-27 GPT Summary- Adam最適化アルゴリズムによる発散挙動の理論を提唱。パラメータ更新ベクトルのノルムが大きく、訓練損失面の下降方向と相関しない状態が発散に寄与。特に大規模バッチサイズの深いモデル訓練で顕著であり、異なるサイズの言語モデルでの観察結果を示した。
[Paper Note] LLaMA: Open and Efficient Foundation Language Models, Hugo Touvron+, arXiv'23, 2023.02
Paper/Blog Link My Issue
#Pretraining #NLP #OpenWeight Issue Date: 2026-03-31 GPT Summary- LLaMAは、7Bから65Bパラメータまでの基盤言語モデルのコレクションを提供し、数兆のトークンを使用して訓練されました。公開可能なデータセットのみを用いて最先端モデルを実現し、特にLLaMA-13Bは多くのベンチマークでGPT-3を上回り、LLaMA-65BはChinchillaやPaLMと競争力を持つ。全てのモデルは研究コミュニティに公開されます。 Comment
初代LLaMAをメモっていなかったようなのでメモ
LLaMA series:
- [Paper Note] Llama 2: Open Foundation and Fine-Tuned Chat Models, Hugo Touvron+, arXiv'23, 2023.07
- LLaMA3, Meta, 2024.04
- Llama 3.1, 2024.07
- Llama 3.2: Revolutionizing edge AI and vision with open, customizable models, Meta, 2024.09
- Llama 4 Series, Meta, 2025.04
Llama 3.3もメモっていないようだ
[Paper Note] Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling, Stella Biderman+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#Pretraining #NLP #OpenWeight #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-03-29 GPT Summary- Pythiaは、異なるスケールの16のLLMを対象にしたモデルセットで、トレーニングの進化や発展を探求する。154のチェックポイントを公開し、訓練データローダーの再構築ツールも提供する。記憶化、新規結果、few-shot性能への語頻度の影響、ジェンダーバイアスの低減を含むケーススタディを通じて、LLMsの訓練ダイナミクスに関する新たな洞察を提示する。モデルや分析コードは公開されている。 Comment
github: https://github.com/EleutherAI/pythia
pythiaもメモっていなかった。70M--12Bモデルまでの16個のLLM群で、全てのモデルが同じ順序で学習され、かつ中間チェックポイントも公開。
[Paper Note] Retentive Network: A Successor to Transformer for Large Language Models, Yutao Sun+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LinearAttention Issue Date: 2026-02-04 GPT Summary- RetNetを提案し、トレーニングの並列化と低コストの推論を実現。再帰と注目の関係を導出し、シーケンスモデリング用の保持メカニズムを提供。並列処理と再帰を組み合わせることで、高効率な長シーケンスモデリングを実現し、性能を維持したままデコーディングの効率を向上。実験によりRetNetの優れたスケーリングと効率的推論を確認。Transformerの強力な後継として位置付け。 Comment
日本語解説: https://zenn.dev/spiralai/articles/a41a934599c7ec
openreview: https://openreview.net/forum?id=UU9Icwbhin
[Paper Note] Learning to Compress Prompts with Gist Tokens, Jesse Mu+, NeurIPS'23, 2023.04
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Prompting #NeurIPS #Compression Issue Date: 2026-02-02 GPT Summary- プロンプトはLMのマルチタスク機能における効率性に課題をもたらすため、私たちは「ギスティング」を提案。これはプロンプトを小さなトークンセットに圧縮し、再利用することで計算効率を向上させる方法で、トレーニングコストは標準的な指示ファインチューニングと同等。実験により、最大26倍のプロンプト圧縮と最大40%のFLOPs削減を達成し、出力品質を保持しつつ効率化を実現。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=2DtxPCL3T5
[Paper Note] Self-Refine: Iterative Refinement with Self-Feedback, Aman Madaan+, NeurIPS'23, 2023.03
Paper/Blog Link My Issue
#NLP #SelfCorrection #NeurIPS #Test-Time Scaling Issue Date: 2026-01-26 GPT Summary- 自己洗練(Self-Refine)アプローチを提案し、LLMの初期出力を反復的なフィードバックを通じて改善。単一のLLMを用いて生成、洗練、フィードバックを行う。7つの多様なタスクで評価した結果、自己洗練による出力は従来の方法よりも好まれ、平均20%の性能向上を示した。最先端のLLMでもさらなる改善可能性を確認。 Comment
openreview: https://openreview.net/forum?id=S37hOerQLB
[Paper Note] TinyStories: How Small Can Language Models Be and Still Speak Coherent English?, Ronen Eldan+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #NaturalLanguageGeneration #NLP #Dataset #SyntheticData #SmallModel Issue Date: 2026-01-19 GPT Summary- LMは小規模モデルでは一貫性のあるテキスト生成が難しい。本研究では、3~4歳児が理解できる単語のみを含む短編小説データセット「TinyStories」を紹介。これはGPT-3.5とGPT-4で生成され、1000万パラメータ未満のモデルでも流暢な物語が生成可能であることを示す。さらに、出力評価の新たなパラダイムを提案し、学生の作品との比較を通じてさまざまな能力に対するスコアを提供。TinyStoriesはLMの研究を促進し、限られたリソースや特殊ドメインにおける言語能力の発展に寄与することが期待される。 Comment
dataset: https://huggingface.co/datasets/roneneldan/TinyStories
[Paper Note] Generating Summaries with Controllable Readability Levels, Leonardo F. R. Ribeiro+, EMNLP'23, 2023.10
Paper/Blog Link My Issue
#DocumentSummarization #Controllable #NLP #ReinforcementLearning #EMNLP #PostTraining #Readability Issue Date: 2026-01-19 GPT Summary- 可読性とは、読者がテキストを理解する容易さを指し、複雑さや主題、読者の背景知識が影響を与える。可読性レベルに基づく要約生成は、様々なオーディエンスに知識を提供するために重要だが、現行の生成アプローチは制御に欠け、特化したテキストが作成されていない。本研究では、特定の可読性レベルで要約を生成する技術を提案し、三つのアプローチを開発した:(1) 指示ベースの可読性制御、(2) 強化学習による可読性ギャップの最小化、(3) 先読み方式による次ステップの可読性予測。これにより、ニュース要約における可読性制御が大幅に向上し、人間の評価によっても強固な基準が確立された。 Comment
openreview: https://openreview.net/forum?id=IFNbElsnCi
[Paper Note] DetectGPT: Zero-Shot Machine-Generated Text Detection using Probability Curvature, Eric Mitchell+, ICML'23, 2023.01
Paper/Blog Link My Issue
#MachineLearning #NLP #ICML #Selected Papers/Blogs #text #AI Detector #Watermark Issue Date: 2025-11-17 GPT Summary- LLM生成テキストの検出の必要性を背景に、対数確率関数の負の曲率を利用した新しい検出手法「DetectGPT」を提案。これにより、別の分類器やデータセットを必要とせず、特定のLLMから生成されたテキストを高精度で識別可能。特に、GPT-NeoXによるフェイクニュース記事の検出で、従来の手法を大幅に上回る性能を示した。
[Paper Note] Language Modelling with Pixels, Phillip Rust+, ICLR'23, 2022.07
Paper/Blog Link My Issue
#NLP #Transformer #ICLR #Encoder #Pixel-based #Compression Issue Date: 2025-10-22 GPT Summary- PIXELは、テキストを画像として表現する新しい言語モデルで、語彙のボトルネックを回避し、言語間での表現転送を可能にする。86MパラメータのPIXELは、BERTと同じデータで事前学習され、非ラテン文字を含む多様な言語での構文的および意味的タスクでBERTを大幅に上回る性能を示したが、ラテン文字ではやや劣る結果となった。また、PIXELは正字法的攻撃や言語コードスイッチングに対してBERTよりも堅牢であることが確認された。 Comment
元ポスト:
[Paper Note] Self-Evaluation Guided Beam Search for Reasoning, Yuxi Xie+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#BeamSearch #NLP #Reasoning #SelfCorrection #NeurIPS #Decoding #KeyPoint Notes Issue Date: 2025-10-01 GPT Summary- LLMの推論プロセスを改善するために、段階的自己評価メカニズムを導入し、確率的ビームサーチを用いたデコーディングアルゴリズムを提案。これにより、推論の不確実性を軽減し、GSM8K、AQuA、StrategyQAでの精度を向上。Llama-2を用いた実験でも効率性が示され、自己評価ガイダンスが論理的な失敗を特定し、一貫性を高めることが確認された。 Comment
pj page: https://guideddecoding.github.io
openreview: https://openreview.net/forum?id=Bw82hwg5Q3
非常にざっくり言うと、reasoning chain(=複数トークンのsequence)をトークンとみなした場合の(確率的)beam searchを提案している。多様なreasoning chainをサンプリングし、その中から良いものをビーム幅kで保持し生成することで、最終的に良いデコーディング結果を得る。reasoning chainのランダム性を高めるためにtemperatureを設定するが、アニーリングをすることでchainにおけるエラーが蓄積することを防ぐ。これにより、最初は多様性を重視した生成がされるが、エラーが蓄積され発散することを防ぐ。
reasoning chainの良さを判断するために、chainの尤度だけでなく、self-evaluationによるreasoning chainの正しさに関するconfidenceスコアも導入する(reasoning chainのconfidenceスコアによって重みづけられたchainの尤度を最大化するような定式化になる(式3))。
self-evaluationと生成はともに同じLLMによって実現されるが、self-evaluationについては評価用のfew-shot promptingを実施する。promptingでは、これまでのreasoning chainと、新たなreasoning chainがgivenなときに、それが(A)correct/(B)incorrectなのかをmultiple choice questionで判定し、選択肢Aが生成される確率をスコアとする。
[Paper Note] Large Language Models are Better Reasoners with Self-Verification, Yixuan Weng+, EMNLP'23 Findings, 2022.12
Paper/Blog Link My Issue
#NLP #SelfVerification Issue Date: 2025-09-25 GPT Summary- LLMsはCoTプロンプティングにより強力な推論能力を示すが、エラーの蓄積に脆弱である。本研究では、LLMsが自己検証能力を持つことを提案し、推論した回答を逆検証することで解釈可能な検証スコアを得る手法を示す。実験により、提案手法が算数、常識、論理推論タスクでの性能を向上させることが確認された。 Comment
openreview: https://openreview.net/forum?id=s4xIeYimGQ
[Paper Note] SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models, Potsawee Manakul+, EMNLP'23, 2023.03
Paper/Blog Link My Issue
#NLP #Hallucination #EMNLP #Selected Papers/Blogs Issue Date: 2025-09-24 GPT Summary- SelfCheckGPTは、外部データベースなしでLLMの応答をファクトチェックするためのサンプリングベースのアプローチを提案。サンプリングされた応答が一貫した事実を含む場合、知識があると判断し、幻覚された事実では矛盾が生じる可能性が高い。実験により、非事実的および事実的な文の検出、文章のランク付けが可能であることを示し、高いAUC-PRスコアと相関スコアを達成。 Comment
openreview: https://openreview.net/forum?id=RwzFNbJ3Ez
[Paper Note] FreshLLMs: Refreshing Large Language Models with Search Engine Augmentation, Tu Vu+, ACL'23 Findings, 2023.10
Paper/Blog Link My Issue
#NLP #Dataset #Zero/Few/ManyShotPrompting #Evaluation #Factuality #RAG(RetrievalAugmentedGeneration) #ACL #Findings Issue Date: 2025-09-24 GPT Summary- 大規模言語モデル(LLMs)は変化する世界に適応できず、事実性に課題がある。本研究では、動的QAベンチマーク「FreshQA」を導入し、迅速に変化する知識や誤った前提を含む質問に対するLLMの性能を評価。評価の結果、全モデルがこれらの質問に苦労していることが明らかに。これを受けて、検索エンジンからの最新情報を組み込む「FreshPrompt」を提案し、LLMのパフォーマンスを向上させることに成功。FreshPromptは、証拠の数と順序が正確性に影響を与えることを示し、簡潔な回答を促すことで幻覚を減少させる効果も確認。FreshQAは公開され、今後も更新される予定。
[Paper Note] Check Your Facts and Try Again: Improving Large Language Models with External Knowledge and Automated Feedback, Baolin Peng+, arXiv'23, 2023.02
Paper/Blog Link My Issue
#NLP #AIAgents #Factuality #RAG(RetrievalAugmentedGeneration) #AutomaticPromptEngineering Issue Date: 2025-09-24 GPT Summary- LLM-Augmenterシステムを提案し、LLMが外部知識に基づいた応答を生成できるように拡張。フィードバックを用いてプロンプトを改善し、タスク指向の対話と質問応答での有効性を実証。ChatGPTの幻覚を減少させつつ、流暢さや情報量を維持。ソースコードとモデルを公開。
[Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #python #LLMServing #Selected Papers/Blogs Issue Date: 2025-08-19 GPT Summary- PagedAttentionを用いたvLLMシステムを提案し、KVキャッシュメモリの無駄を削減し、リクエスト間での柔軟な共有を実現。これにより、同レベルのレイテンシでLLMのスループットを2-4倍向上。特に長いシーケンスや大規模モデルで効果が顕著。ソースコードは公開中。 Comment
(今更ながら)vLLMはこちら:
https://github.com/vllm-project/vllm
現在の主要なLLM Inference/Serving Engineのひとつ。
[Paper Note] Physics of Language Models: Part 1, Learning Hierarchical Language Structures, Zeyuan Allen-Zhu+, arXiv'23
Paper/Blog Link My Issue
#Analysis #NLP Issue Date: 2025-08-11 GPT Summary- 本研究では、Transformerベースの言語モデルが文脈自由文法(CFG)による再帰的な言語構造推論をどのように行うかを調査。合成CFGを用いて長文を生成し、GPTのようなモデルがCFGの階層を正確に学習・推論できることを示す。モデルの隠れ状態がCFGの構造を捉え、注意パターンが動的プログラミングに類似していることが明らかに。また、絶対位置埋め込みの劣位や均一な注意の効果、エンコーダ専用モデルの限界、構造的ノイズによる堅牢性向上についても考察。 Comment
[Paper Note] Large Language Models Can Self-Improve, Jiaxin Huang+, EMNLP'23
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #SelfImprovement #EMNLP Issue Date: 2025-07-22 GPT Summary- LLMはラベルのないデータセットで自己改善可能であることを示し、Chain-of-Thoughtプロンプティングと自己一貫性を利用して高信頼度の回答を生成。これにより、540BパラメータのLLMの推論能力を向上させ、最先端のパフォーマンスを達成。ファインチューニングが自己改善に重要であることも確認。 Comment
openreview: https://openreview.net/forum?id=uuUQraD4XX¬eId=PWDEpZtn6P
[Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
Paper/Blog Link My Issue
#ComputerVision #Pretraining #MultiModal #ContrastiveLearning #Selected Papers/Blogs #ICCV #Scalability #needs-revision Issue Date: 2025-06-29 GPT Summary- シンプルなペアワイズシグモイド損失(SigLIP)を提案し、画像-テキストペアに基づく言語-画像事前学習を改善。シグモイド損失はバッチサイズの拡大を可能にし、小さなバッチサイズでも性能向上を実現。SigLiTモデルは84.5%のImageNetゼロショット精度を達成。バッチサイズの影響を研究し、32kが合理的なサイズであることを確認。モデルは公開され、さらなる研究の促進を期待。 Comment
SigLIP論文
[Paper Note] SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills, Amey Agrawal+, arXiv'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #python #LLMServing #SoftwareEngineering #read-later #Selected Papers/Blogs #Inference #One-Line Notes Issue Date: 2025-06-12 GPT Summary- SARATHIは、LLMの推論効率を向上させる手法で、プレフィルリクエストをチャンクに分割し、デコードマキシマルバッチを構築することで計算利用率を最大化します。これにより、デコードスループットを最大10倍向上させ、エンドツーエンドスループットも改善。特に、A6000 GPU上のLLaMA-13Bモデルで顕著な性能向上を示し、パイプラインバブルを大幅に削減しました。 Comment
vLLMでも採用されている `Chunked Prefills` と `Decode-Maximal Batching` を提案している。

[Paper Note] Sequence Parallelism: Long Sequence Training from System Perspective, Shenggui Li+, ACL'23, 2021.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LongContext #ACL #Selected Papers/Blogs #Parallelism #One-Line Notes Issue Date: 2025-05-16 GPT Summary- 本研究では、トランスフォーマーの長い入力シーケンスを効率的に学習するための新しいメモリ効率の良い「シーケンス並列性」手法を提案。これは、既存の並列化手法との互換性を持ち、長大なシーケンスを複数のGPUに分散して処理することを可能にする。リング型通信を用いた自己注意計算(Ring Self-Attention)を導入し、実験によりバッチサイズとシーケンス長のスケーリング効果を示した。最大バッチサイズは13.7倍、シーケンス長は114,000トークンを超える性能を達成。 Comment
入力系列をチャンクに分割して、デバイスごとに担当するチャンクを決めることで原理上無限の長さの系列を扱えるようにした並列化手法。系列をデバイス間で横断する場合attention scoreをどのように計算するかが課題になるが、そのためにRing Self attentionと呼ばれるアルゴリズムを提案している模様。また、MLPブロックとMulti Head Attentonブロックの計算も、BatchSize * Sequence Lengthの大きさが、それぞれ32*Hidden Size, 16*Attention Head size *
# of Attention Headよりも大きくなった場合に、Tensor Parallelismよりもメモリ効率が良くなるらしい。
Data Parallel, Pipeline Parallel, Tensor Parallel、全てに互換性があるとのこと(併用可能)
そのほかの並列化の解説については
- 大規模モデルを支える分散並列学習のしくみ Part1, Kazuki Fujii, 2023.06
を参照のこと。
[Paper Note] Inference-Time Intervention: Eliciting Truthful Answers from a Language Model, Kenneth Li+, NeurIPS'23
Paper/Blog Link My Issue
#MachineLearning #NLP #Hallucination #NeurIPS #read-later #ActivationSteering/ITI #Probing #Trustfulness #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-09 GPT Summary- Inference-Time Intervention (ITI)を提案し、LLMsの真実性を向上させる技術を紹介。ITIは推論中にモデルの活性化を調整し、LLaMAモデルの性能をTruthfulQAベンチマークで大幅に改善。Alpacaモデルでは真実性が32.5%から65.1%に向上。真実性と有用性のトレードオフを特定し、介入の強度を調整する方法を示す。ITIは低コストでデータ効率が高く、数百の例で真実の方向性を特定可能。LLMsが虚偽を生成しつつも真実の内部表現を持つ可能性を示唆。 Comment
Inference Time Interventionを提案した研究。Attention Headに対して線形プロービング[^1]を実施し、真実性に関連するであろうHeadをtopKで特定できるようにし、headの出力に対し真実性を高める方向性のベクトルvを推論時に加算することで(=intervention)、モデルの真実性を高める。vは線形プロービングによって学習された重みを使う手法と、正答と誤答の活性化の平均ベクトルを計算しその差分をvとする方法の二種類がある。後者の方が性能が良い。topKを求める際には、線形プロービングをしたモデルのvalidation setでの性能から決める。Kとαはハイパーパラメータである。
[^1]: headのrepresentationを入力として受け取り、線形モデルを学習し、線形モデルの2値分類性能を見ることでheadがどの程度、プロービングの学習に使ったデータに関する情報を保持しているかを測定する手法
日本語解説スライド:
https://www.docswell.com/s/DeepLearning2023/Z38P8D-2024-06-20-131813#p1
これは相当汎用的に使えそうな話だから役に立ちそう
[Paper Note] The Impact of Positional Encoding on Length Generalization in Transformers, Amirhossein Kazemnejad+, NeurIPS'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #LongContext #PositionalEncoding #NeurIPS #Selected Papers/Blogs #KeyPoint Notes #Surface-level Notes Issue Date: 2025-04-06 GPT Summary- 長さ一般化はTransformerベースの言語モデルにおける重要な課題であり、位置エンコーディング(PE)がその性能に影響を与える。5つの異なるPE手法(APE、T5の相対PE、ALiBi、Rotary、NoPE)を比較した結果、ALiBiやRotaryなどの一般的な手法は長さ一般化に適しておらず、NoPEが他の手法を上回ることが明らかになった。NoPEは追加の計算を必要とせず、絶対PEと相対PEの両方を表現可能である。さらに、スクラッチパッドの形式がモデルの性能に影響を与えることも示された。この研究は、明示的な位置埋め込みが長いシーケンスへの一般化に必須でないことを示唆している。 Comment
- Llama 4 Series, Meta, 2025.04
において、Llama4 Scoutが10Mコンテキストウィンドウを実現できる理由の一つとのこと。
元ポスト:
Llama4のブログポストにもその旨記述されている:
>A key innovation in the Llama 4 architecture is the use of interleaved attention layers without positional embeddings. Additionally, we employ inference time temperature scaling of attention to enhance length generalization.
[The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation]( https://ai.meta.com/blog/llama-4-multimodal-intelligence/?utm_source=twitter&utm_medium=organic_social&utm_content=image&utm_campaign=llama4)
斜め読みだが、length generalizationを評価する上でdownstream taskに焦点を当て、3つの代表的なカテゴリに相当するタスクで評価したところ、この観点においてはT5のrelative positinal encodingとNoPE(位置エンコードディング無し)のパフォーマンスが良く、
NoPEは絶対位置エンコーディングと相対位置エンコーディングを理論上実現可能であり[^1]
実際に学習された異なる2つのモデルに対して同じトークンをそれぞれinputし、同じ深さのLayerの全てのattention distributionの組み合わせからJensen Shannon Divergenceで距離を算出し、最も小さいものを2モデル間の当該layerの距離として可視化すると下記のようになり、NoPEとT5のrelative positional encodingが最も類似していることから、NoPEが学習を通じて(実用上は)相対位置エンコーディングのようなものを学習することが分かった。
[^1]:深さ1のLayerのHidden State H^1から絶対位置の復元が可能であり(つまり、当該レイヤーのHが絶対位置に関する情報を保持している)、この前提のもと、後続のLayerがこの情報を上書きしないと仮定した場合に、相対位置エンコーディングを実現できる。
また、CoT/Scratchpadはlong sequenceに対する汎化性能を向上させることがsmall scaleではあるが先行研究で示されており、Positional Encodingを変化させた時にCoT/Scratchpadの性能にどのような影響を与えるかを調査。
具体的には、CoT/Scratchpadのフォーマットがどのようなものが有効かも明らかではないので、5種類のコンポーネントの組み合わせでフォーマットを構成し、mathematical reasoningタスクで以下のような設定で訓練し
- さまざまなコンポーネントの組み合わせで異なるフォーマットを作成し、
- 全ての位置エンコーディングあり/なしモデルを訓練
これらを比較した。この結果、CoT/Scratchpadはフォーマットに関係なく、特定のタスクでのみ有効(有効かどうかはタスク依存)であることが分かった。このことから、CoT/Scratcpad(つまり、モデルのinputとoutputの仕方)単体で、long contextに対する汎化性能を向上させることができないので、Positional Encoding(≒モデルのアーキテクチャ)によるlong contextに対する汎化性能の向上が非常に重要であることが浮き彫りになった。
また、CoT/Scratchpadが有効だったAdditionに対して各Positional Embeddingモデルを学習し、生成されたトークンのattentionがどの位置のトークンを指しているかを相対距離で可視化したところ(0が当該トークン、つまり現在のScratchpadに着目しており、1が遠いトークン、つまりinputに着目していることを表すように正規化)、NoPEとRelative Positional Encodingがshort/long rangeにそれぞれフォーカスするようなbinomialな分布なのに対し、他のPositional Encodingではよりuniformな分布であることが分かった。このタスクにおいてはNoPEとRelative POの性能が高かったため、binomialな分布の方がより最適であろうことが示唆された。
[Paper Note] TALLRec: An Effective and Efficient Tuning Framework to Align Large Language Model with Recommendation, Keqin Bao+, RecSys'23
Paper/Blog Link My Issue
#RecommenderSystems #Contents-based #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #Zero/FewShotLearning #RecSys #KeyPoint Notes Issue Date: 2025-03-30 GPT Summary- 大規模言語モデル(LLMs)を推薦システムに活用するため、推薦データで調整するフレームワークTALLRecを提案。限られたデータセットでもLLMsの推薦能力を向上させ、効率的に実行可能。ファインチューニングされたLLMはクロスドメイン一般化を示す。 Comment
下記のようなユーザのプロファイルとターゲットアイテムと、binaryの明示的なrelevance feedbackデータを用いてLoRA、かつFewshot Learningの設定でSFTすることでbinaryのlike/dislikeの予測性能を向上。PromptingだけでなくSFTを実施した初めての研究だと思われる。
既存ベースラインと比較して大幅にAUCが向上
[Paper Note] Scaling Data-Constrained Language Models, Niklas Muennighoff+, NeurIPS'23
Paper/Blog Link My Issue
#MachineLearning #NLP #NeurIPS #Scaling Laws #read-later #Selected Papers/Blogs #KeyPoint Notes #DataRepetition Issue Date: 2025-03-23 GPT Summary- 言語モデルのスケーリングにおいて、データ制約下でのトレーニングを調査。9000億トークンと90億パラメータのモデルを用いた実験で、繰り返しデータを使用しても損失に大きな変化は見られず、繰り返しの価値が減少することを確認。計算最適性のスケーリング法則を提案し、データ不足を軽減するアプローチも実験。得られたモデルとデータセットは公開。 Comment
OpenReview: https://openreview.net/forum?id=j5BuTrEj35
チンチラ則のようなScaling Lawsはパラメータとデータ量の両方をスケールさせた場合の前提に立っており、かつデータは全てuniqueである前提だったが、データの枯渇が懸念される昨今の状況に合わせて、データ量が制限された状況で、同じデータを繰り返し利用する(=複数エポック学習する)ことが一般的になってきた。このため、データのrepetitionに関して性能を事前学習による性能の違いを調査して、repetitionとパラメータ数に関するスケーリング則を提案($3.1)しているようである。
Takeawayとしては、データが制限された環境下では、repetitionは上限4回までが効果的(コスパが良い)であり(左図)、小さいモデルを複数エポック訓練する方が固定されたBudgetの中で低いlossを達成できる右図)。
学習データの半分をコードにしても性能の劣化はなく、様々なタスクの性能が向上しパフォーマンスの分散も小さくなる、といったことが挙げられるようだ。
Navigate through Enigmatic Labyrinth A Survey of Chain of Thought Reasoning: Advances, Frontiers and Future, Zheng Chu+, arXiv'23
Paper/Blog Link My Issue
#Survey #NLP #Chain-of-Thought #ACL Issue Date: 2025-01-06 GPT Summary- 推論はAIにおいて重要な認知プロセスであり、チェーン・オブ・ソートがLLMの推論能力を向上させることが注目されている。本論文では関連研究を体系的に調査し、手法を分類して新たな視点を提供。課題や今後の方向性についても議論し、初心者向けの導入を目指す。リソースは公開されている。
Program of Thoughts Prompting: Disentangling Computation from Reasoning for Numerical Reasoning Tasks, Wenhu Chen+, TMLR'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #TMLR #KeyPoint Notes Issue Date: 2025-01-05 GPT Summary- 段階的な推論を用いた数値推論タスクにおいて、Chain-of-thoughts prompting(CoT)の進展があり、推論をプログラムとして表現する「Program of Thoughts」(PoT)を提案。PoTは外部コンピュータで計算を行い、5つの数学問題データセットと3つの金融QAデータセットで評価した結果、少数ショットおよびゼロショット設定でCoTに対して約12%の性能向上を示した。自己一貫性デコーディングとの組み合わせにより、数学問題データセットで最先端の性能を達成。データとコードはGitHubで公開。 Comment
1. LLMsは算術演算を実施する際にエラーを起こしやすく、特に大きな数に対する演算を実施する際に顕著
2. LLMsは複雑な数式(e.g. 多項式, 微分方程式)を解くことができない
3. LLMsはiterationを表現するのが非常に非効率
の3点を解決するために、外部のインタプリタに演算処理を委譲するPoTを提案。PoTでは、言語モデルにreasoning stepsをpython programで出力させ、演算部分をPython Interpreterに実施させる。
テキスト、テーブル、対話などの多様なinputをサポートする5つのMath Word Problem (MWP), 3つのFinancial Datasetで評価した結果、zero-shot, few-shotの両方の設定において、PoTはCoTをoutpeformし、また、Self-Consistencyと組み合わせた場合も、PoTはCoTをoutperformした。
Recursion of Thought: A Divide-and-Conquer Approach to Multi-Context Reasoning with Language Models, Soochan Lee+, arXiv'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Reasoning #KeyPoint Notes Issue Date: 2025-01-05 GPT Summary- Recursion of Thought(RoT)という新しい推論フレームワークを提案し、言語モデル(LM)が問題を複数のコンテキストに分割することで推論能力を向上させる。RoTは特別なトークンを導入し、コンテキスト関連の操作をトリガーする。実験により、RoTがLMの推論能力を劇的に向上させ、数十万トークンの問題を解決できることが示された。 Comment
divide-and-conquerで複雑な問題に回答するCoT手法。生成過程でsubquestionが生じた際にモデルに特殊トークン(GO)を出力させ、subquestionの回答部分に特殊トークン(THINK)を出力させるようにSupervisedに学習させる。最終的にTHINKトークン部分は、subquestionを別途モデルによって解いた回答でreplaceして、最終的な回答を得る。
subquestionの中でさらにsubquestionが生じることもあるため、再帰的に処理される。
四則演算と4種類のアルゴリズムに基づくタスクで評価。アルゴリズムに基づくタスクは、2つの数のlongest common subsequenceを見つけて、そのsubsequenceとlengthを出力するタスク(LCS)、0-1 knapsack問題、行列の乗算、数値のソートを利用。x軸が各タスクの問題ごとの問題の難易度を表しており、難易度が上がるほど提案手法によるgainが大きくなっているように見える。
Without Thoughtでは直接回答を出力させ、CoTではground truthとなるrationaleを1つのcontextに与えて回答を生成している。RoTではsubquestionごとに回答を別途得るため、より長いcontextを活用して最終的な回答を得る点が異なると主張している。
感想としては、詳細が書かれていないが、おそらくRoTはSFTによって各タスクに特化した学習をしていると考えられる(タスクごとの特殊トークンが存在するため)。ベースラインとしてRoT無しでSFTしたモデルあった方が良いのではないか?と感じる。
また、学習データにおけるsubquestionとsubquestionに対するground truthのデータ作成方法は書かれているが、そもそも元データとして何を利用したかや、その統計量も書かれていないように見える。あと、そもそも機械的に学習データを作成できない場合どうすれば良いのか?という疑問は残る。
読んでいた時にAuto-CoTとの違いがよくわからなかったが、Related Workの部分にはAuto-CoTは動的、かつ多様なデモンストレーションの生成にフォーカスしているが、AutoReasonはquestionを分解し、few-shotの promptingでより詳細なrationaleを生成することにフォーカスしている点が異なるという主張のようである。
- [Paper Note] Automatic Chain of Thought Prompting in Large Language Models, Zhuosheng Zhang+, ICLR'23, 2022.10
Auto-CoTとの差別化は上記で理解できるが、G-Evalが実施しているAuto-CoTとの差別化はどうするのか?という風にふと思った。論文中でもG-Evalは引用されていない。
素朴にはAutoReasonはSFTをして学習をしています、さらにRecursiveにquestionをsubquestionを分解し、分解したsubquestionごとに回答を得て、subquestionの回答結果を活用して最終的に複雑なタスクの回答を出力する手法なので、G-Evalが実施している同一context内でrationaleをzeroshotで生成する手法よりも、より複雑な問題に回答できる可能性が高いです、という主張にはなりそうではある。
- [Paper Note] G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment, Yang Liu+, N/A, EMNLP'23
ICLR 2023 OpenReview:
https://openreview.net/forum?id=PTUcygUoxuc
- 提案手法は一般的に利用可能と主張しているが、一般的に利用するためには人手でsubquestionの学習データを作成する必要があるため十分に一般的ではない
- 限られたcontext長に対処するために再帰を利用するというアイデアは新しいものではなく、数学の定理の証明など他の設定で利用されている
という理由でrejectされている。
Recommender Systems with Generative Retrieval, Shashank Rajput+, arXiv'23
Paper/Blog Link My Issue
#RecommenderSystems #Survey #InformationRetrieval #SequentialRecommendation Issue Date: 2024-12-30 GPT Summary- 新しい生成的検索アプローチを提案し、アイテムのセマンティックIDを自己回帰的にデコード。Transformerベースのモデルが次のアイテムのセマンティックIDを予測し、レコメンデーションタスクにおいて初のセマンティックIDベースの生成モデルとなる。提案手法は最先端モデルを大幅に上回り、過去の対話履歴がないアイテムに対する検索性能も向上。
SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, Guangxuan Xiao+, ICML'23
Paper/Blog Link My Issue
#NLP #Quantization #ICML Issue Date: 2024-12-03 GPT Summary- SmoothQuantは、トレーニング不要で8ビットの重みと活性化の量子化を実現するポストトレーニング量子化ソリューションです。活性化の外れ値を滑らかにすることで、量子化の難易度を軽減し、精度を保持しつつ最大1.56倍の速度向上と2倍のメモリ削減を達成しました。これにより、530BのLLMを単一ノードで運用可能にし、LLMsの民主化を促進します。コードは公開されています。 Comment
おそらく量子化手法の現時点のSoTA
[Paper Note] Recommender Systems in the Era of Large Language Models (LLMs), Zihuai Zhao+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#RecommenderSystems #read-later #Selected Papers/Blogs #Surface-level Notes Issue Date: 2024-12-03 GPT Summary- LLMsの出現により、レコメンダーシステムが進化し、ユーザーの嗜好に基づくパーソナライズが可能に。従来のDNN法の限界を克服するため、LLMsを活用したレコメンドシステムの概要を提供。具体的には、事前学習、ファインチューニング、プロンプティングの観点から最近の手法をレビューし、この分野の今後の発展方向を論じる。 Comment
中身を全然読んでいる時間はないので、図には重要な情報が詰まっていると信じ、図を読み解いていく。時間がある時に中身も読みたい。。。
LLM-basedなRecSysでは、NLPにおけるLLMの使い方(元々はT5で提案)と同様に、様々なレコメンド関係タスクを、テキスト生成タスクに落とし込み学習することができる。
RecSysのLiteratureとしては、最初はコンテンツベースと協調フィルタリングから始まり、(グラフベースドな推薦, Matrix Factorization, Factorization Machinesなどが間にあって)、その後MLP, RNN, CNN, AutoEncoderなどの様々なDeep Neural Network(DNN)を活用した手法や、BERT4RecなどのProbabilistic Language Models(PLM)を用いた手法にシフトしていき、現在LLM-basedなRecSysの時代に到達した、との流れである。
LLM-basedな手法では、pretrainingの段階からEncoder-basedなモデルの場合はMLM、Decoder-basedな手法ではNext Token Predictionによってデータセットで事前学習する方法もあれば、フルパラメータチューニングやPEFT(LoRAなど)によるSFTによるアプローチもあるようである。
推薦タスクは、推薦するアイテムIDを生成するようなタスクの場合は、異なるアイテムID空間に基づくデータセットの間では転移ができないので、SFTをしないとなかなかうまくいかないと気がしている。また、その場合はアイテムIDの推薦以外のタスクも同時に実施したい場合は、事前学習済みのパラメータが固定されるPEFT手法の方が安全策になるかなぁ、という気がしている(破壊的忘却が怖いので)。特はたとえば、アイテムIDを生成するだけでなく、その推薦理由を生成できるのはとても良いことだなあと感じる(良い時代、感)。
また、PromptingによるRecSysの流れも図解されているが、In-Context Learningのほかに、Prompt Tuning(softとhardの両方)、Instruction Tuningも同じ図に含まれている。個人的にはPrompt TuningはPEFTの一種であり、Instruction TuningはSFTの一種なので、一つ上の図に含意される話なのでは?という気がするが、論文中ではどのような立て付けで記述されているのだろうか。
どちらかというと、Promptingの話であれば、zero-few-many shotや、各種CoTの話を含めるのが自然な気がするのだが。
下図はPromptingによる手法を表にまとめたもの。Finetuningベースの手法が別表にまとめられていたが、研究の数としてはこちらの方が多そうに見える。が、性能的にはどの程度が達成されるのだろうか。直感的には、アイテムを推薦するようなタスクでは、Promptingでは性能が出にくいような印象がある。なぜなら、事前学習済みのLLMはアイテムIDのトークン列とアイテムの特徴に関する知識がないので。これをFinetuningしないのであればICLで賄うことになると思うのだが、果たしてどこまでできるだろうか…。興味がある。
(図は論文より引用)
[Paper Note] Increasing Diversity While Maintaining Accuracy: Text Data Generation with Large Language Models and Human Interventions, John Chung+, ACL'23, 2023.07
Paper/Blog Link My Issue
#NLP #ACL #Diversity #One-Line Notes Issue Date: 2024-12-03 GPT Summary- 本研究では、LLMを用いたテキストデータ生成における多様性と精度を向上させるための人間とAIのパートナーシップを探求。ロジット抑制と温度サンプリングの2つのアプローチで多様性を高める一方、ラベル置換(LR)と範囲外フィルタリング(OOSF)による人間の介入を検討。LRはモデルの精度を14.4%向上させ、一部のモデルは少数ショット分類を上回る性能を示したが、OOSFは効果がなかった。今後の研究の必要性が示唆される。 Comment
生成テキストの質を維持しつつ、多様性を高める取り組み。多様性を高める取り組みとしては3種類の方法が試されており、
- Logit Suppression: 生成されたテキストの単語生成頻度をロギングし、頻出する単語にpenaltyをかける方法
- High Temperature: temperatureを[0.3, 0.7, 0.9, 1.3]にそれぞれ設定して単語をサンプリングする方法
- Seeding Example: 生成されたテキストを、seedとしてpromptに埋め込んで生成させる方法
で実験されている。
Improving the Domain Adaptation of Retrieval Augmented Generation (RAG) Models for Open Domain Question Answering, Siriwardhana+, TACL'23, 2023.01
Paper/Blog Link My Issue
#InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #TACL Issue Date: 2024-12-01 GPT Summary- RAG-end2endは、ODQAにおけるドメイン適応のためにRAGのリトリーバーとジェネレーターを共同訓練する新しいアプローチを提案。外部知識ベースを更新し、補助的な訓練信号を導入することで、ドメイン特化型知識を強化。COVID-19、ニュース、会話のデータセットで評価し、元のRAGモデルよりも性能が向上。研究はオープンソースとして公開。
[Paper Note] Sparse Upcycling: Training Mixture-of-Experts from Dense Checkpoints, Aran Komatsuzaki+, ICLR'23
Paper/Blog Link My Issue
#Pretraining #MachineLearning #NLP #Supervised-FineTuning (SFT) #MoE(Mixture-of-Experts) #PostTraining #KeyPoint Notes Issue Date: 2024-11-25 GPT Summary- スパース活性化モデルは、計算コストを抑えつつ密なモデルの代替として注目されているが、依然として多くのデータを必要とし、ゼロからのトレーニングは高コストである。本研究では、密なチェックポイントからスパース活性化Mixture-of-Expertsモデルを初期化する「スパースアップサイクリング」を提案。これにより、初期の密な事前トレーニングのコストを約50%再利用し、SuperGLUEやImageNetで密なモデルを大幅に上回る性能を示した。また、アップサイクリングされたモデルは、ゼロからトレーニングされたスパースモデルよりも優れた結果を得た。 Comment
斜め読みしかできていないが、Mixture-of-Expertsを用いたモデルをSFT/Pretrainingする際に、既存のcheckpointの重みを活用することでより効率的かつ性能向上する方法を提案。MoE LayerのMLPを全て既存のcheckpointにおけるMLPの重みをコピーして初期化する。Routerはスクラッチから学習する。
継続事前学習においては、同じ学習時間の中でDense Layerを用いるベースラインと比較してでより高い性能を獲得。
Figure2で継続事前学習したモデルに対して、フルパラメータのFinetuningをした場合でもUpcyclingは効果がある(Figure3)。
特にPretrainingではUpcyclingを用いたモデルの性能に、通常のMoEをスクラッチから学習したモデルが追いつくのに時間がかかるとのこと。特に図右側の言語タスクでは、120%の学習時間が追いつくために必要だった。
Sparse Upcycingと、Dense tilingによる手法(warm start; 元のモデルに既存の層を複製して新しい層を追加する方法)、元のモデルをそれぞれ継続事前学習すると、最も高い性能を獲得している。
(すごい斜め読みなのでちょっも自信なし、、、)
[Paper Note] Prompting Large Language Model for Machine Translation: A Case Study, Biao Zhang+, arXiv'23, 2023.01
Paper/Blog Link My Issue
#MachineTranslation #NLP #One-Line Notes #Reading Reflections Issue Date: 2024-11-20 GPT Summary- プロンプト設計は多くのタスクで優れた性能を示すが、機械翻訳においては未検討。翻訳のためのプロンプト戦略を体系的に研究し、プロンプトテンプレートやデモ例の選択に関する要因を検討。実験の結果、プロンプト例の数と質が翻訳において重要であり、サブ最適な例は性能低下を招くことが示された。また、ゼロショットプロンプティングから得られた擬似平行プロンプト例の利用が翻訳を改善する可能性や、知識転移により性能向上が見込まれることが確認された。最後に、プロンプト設計に関する問題点についても議論。 Comment
zero-shotでMTを行うときに、改行の有無や、少しのpromptingの違いでCOMETスコアが大幅に変わることを示している。
モデルはGLM-130BをINT4で量子化したモデルで実験している。
興味深いが、この知見を一般化して全てのLLMに適用できるか?と言われると、そうはならない気がする。他のモデルで検証したら傾向はおそらく変わるであろう(という意味でおそらく論文のタイトルにもCase Studyと記述されているのかなあ)。
Precise Zero-Shot Dense Retrieval without Relevance Labels, Luyu Gao+, ACL'23
Paper/Blog Link My Issue
#InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #ACL Issue Date: 2024-11-11 GPT Summary- 本研究では、ゼロショット密な検索システムの構築において、仮想文書埋め込み(HyDE)を提案。クエリに基づき、指示に従う言語モデルが仮想文書を生成し、教師なしで学習されたエンコーダがこれを埋め込みベクトルに変換。実際のコーパスに基づく類似文書を取得することで、誤った詳細をフィルタリング。実験結果では、HyDEが最先端の密な検索器Contrieverを上回り、様々なタスクと言語で強力なパフォーマンスを示した。
SINC: Self-Supervised In-Context Learning for Vision-Language Tasks, Yi-Syuan Chen+, N_A, ICCV'23
Paper/Blog Link My Issue
#ComputerVision #Zero/Few/ManyShotPrompting #Self-SupervisedLearning Issue Date: 2024-10-07 GPT Summary- 自己教師あり文脈内学習(SINC)フレームワークを提案し、大規模言語モデルに依存せずに文脈内学習を実現。特別に調整されたデモンストレーションを用いたメタモデルが、視覚と言語のタスクで少数ショット設定において勾配ベースの手法を上回る性能を示す。SINCは文脈内学習の利点を探求し、重要な要素を明らかにする。
UL2: Unifying Language Learning Paradigms, Yi Tay+, N_A, ICLR'23
Paper/Blog Link My Issue
#Pretraining #NLP #MultiModal #ICLR #Encoder #Encoder-Decoder #KeyPoint Notes Issue Date: 2024-09-26 GPT Summary- 本論文では、事前学習モデルの普遍的なフレームワークを提案し、事前学習の目的とアーキテクチャを分離。Mixture-of-Denoisers(MoD)を導入し、複数の事前学習目的の効果を示す。20Bパラメータのモデルは、50のNLPタスクでSOTAを達成し、ゼロショットやワンショット学習でも優れた結果を示す。UL2 20Bモデルは、FLAN指示チューニングにより高いパフォーマンスを発揮し、関連するチェックポイントを公開。 Comment
OpenReview: https://openreview.net/forum?id=6ruVLB727MC
encoder-decoder/decoder-onlyなど特定のアーキテクチャに依存しないアーキテクチャagnosticな事前学習手法であるMoDを提案。
MoDでは3種類のDenoiser [R] standard span corruption, [S] causal language modeling, [X] extreme span corruption の3種類のパラダイムを活用する。学習時には与えらえたタスクに対して適切なモードをスイッチできるようにparadigm token ([R], [S], [X])を与え挙動を変化させられるようにしており[^1]、finetuning時においては事前にタスクごとに定義をして与えるなどのことも可能。
[^1]: 事前学習中に具体的にどのようにモードをスイッチするのかはよくわからなかった。ランダムに変更するのだろうか。
[Paper Note] Direct Preference Optimization: Your Language Model is Secretly a Reward Model, Rafael Rafailov+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #Alignment #NeurIPS #DPO #PostTraining #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-09-25 GPT Summary- 大規模な自己教師付き言語モデルにおいて、挙動を制御するのが難しい問題に対し、新たな報酬モデルのパラメータ化を導入し、Direct Preference Optimization(DPO)を提案。DPOは、ファインチューニング時の安定性と計算効率を向上させ、既存手法と同等またはそれ以上の性能を実現。特に、生成の感情制御や応答品質向上を実現し、実装と訓練の単純さが大幅に改善されることを示した。 Comment
解説(必ず読んだ方が良い):
- RLHF/DPO 小話, 和地瞭良/ Akifumi Wachi, 2024.04
DPOを提案した研究。選好データ D:
解説ポスト:
SNLP'24での解説スライド: https://speakerdeck.com/kazutoshishinoda/lun-wen-shao-jie-direct-preference-optimization-your-language-model-is-secretly-a-reward-model
[Paper Note] Instruction Tuning with GPT-4, Baolin Peng+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NLP #Dataset #Supervised-FineTuning (SFT) #InstructionTuning #PostTraining #One-Line Notes Issue Date: 2024-09-20 GPT Summary- GPT-4を用いて機械生成の指示追従データを新たに生成し、LLaMAモデルのファインチューニングを行う試みを提案。生成されたデータは、従来のモデルと比べて新規タスクに対するゼロショット性能を向上させることを示した。フィードバックと比較データも収集し、コードベースを公開。 Comment
現在はOpenAIの利用規約において、outputを利用してOpenAIと競合するモデルを構築することは禁止されているので、この点には注意が必要
https://openai.com/ja-JP/policies/terms-of-use/
Reflection-Tuning: Data Recycling Improves LLM Instruction-Tuning, Ming Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #InstructionTuning #SelfCorrection Issue Date: 2024-09-07 GPT Summary- リフレクションチューニングという新手法を提案し、LLMsの自己改善を通じて低品質なトレーニングデータの問題に対処。オラクルLLMを用いてデータの質を向上させ、実験により再利用データで訓練されたLLMsが既存モデルを上回ることを示した。 Comment
Reflection-Tuningを提案している研究?
Leveraging Large Language Models in Conversational Recommender Systems, Luke Friedman+, N_A, arXiv'23
Paper/Blog Link My Issue
#RecommenderSystems #ConversationalRecommenderSystems Issue Date: 2024-08-07 GPT Summary- LLMsを使用した大規模な会話型推薦システム(CRS)の構築に関する論文の要約です。LLMsを活用したユーザーの好み理解、柔軟なダイアログ管理、説明可能な推薦の新しい実装を提案し、LLMsによって駆動される統合アーキテクチャの一部として説明します。また、LLMが解釈可能な自然言語のユーザープロファイルを利用してセッションレベルのコンテキストを調整する方法についても説明します。さらに、LLMベースのユーザーシミュレータを構築して合成会話を生成する技術を提案し、LaMDAをベースにしたYouTubeビデオの大規模CRSであるRecLLMを紹介します。
Mistral 7B, Albert Q. Jiang+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #OpenWeight #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- Mistral 7B v0.1は、70億パラメータの言語モデルであり、高速な推論のためにGQAを活用し、SWAを組み合わせている。また、Mistral 7B -- InstructはLlama 2 13B -- Chatモデルを上回っており、Apache 2.0ライセンスの下で公開されています。 Comment
Mistral Large
Mixtral-8x22B-v0.1, 2024
などのモデルも参照のこと
モデルのスケールが大きくなると、inferenceのlatencyが遅くなり、計算コストが大きくなりすぎて実用的でないので、小さいパラメータで素早いinference実現したいよね、というモチベーション。
そのために、SlidingWindowAttentionとGroupQueryAttention [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
を活用している。
より小さいパラメータ数でLlama2を様々なタスクでoutperformし
Instruction Tuningを実施したモデルは、13BモデルよりもChatbotArenaで高いElo Rateを獲得した。
コンテキスト長は8192
[Paper Note] Benchmarking Large Language Models for News Summarization, Tianyi Zhang+, arXiv'23, 2023.01
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #NLP #Dataset #Annotation #One-Line Notes Issue Date: 2024-05-15 GPT Summary- 大規模言語モデル(LLMs)の自動要約能力の背後にある要因を探り、10のモデルに対する人間評価を行った。結果、ゼロショット要約の鍵はモデルサイズではなく指示調整にあること、さらに従来の研究は低品質な参照データに制約されているため人間の性能を過小評価していることが明らかになった。高品質な要約を基にした評価では、LLMsの要約が人間の要約と同等とされることが多いとの結論に至った。 Comment
- ニュース記事の高品質な要約を人間に作成してもらい、gpt-3.5を用いてLLM-basedな要約も生成
- annotatorにそれぞれの要約の品質をスコアリングさせたデータセットを作成
[Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンション(MQA)はデコーダ推論を高速化するが、品質低下のリスクがある。本研究では、(1)元の計算の5%でMQAを持つモデルへのアップトレーニング方法を提案し、(2)グループ化クエリ・アテンション(GQA)を導入。GQAは中間的な数のキー・バリュー・ヘッドを使用し、アップトレーニングされたGQAは品質を保ちながらMQAと同等の速度を実現する。 Comment
通常のMulti-Head AttentionがQKVが1対1対応なのに対し、Multi Query Attention (MQA) [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
は全てのheadに対してKVを共有する(HeadがH個あるのであれば、保持するKVの数が1/Hとなる)。一方、GQAはグループ単位で(headの)KVを共有する点で異なる。MQAは大幅にInfeerence speedが改善するが、精度が劣化する問題があった。この研究では通常のMulti-Head Attentionに対して、オリジナルの事前学習に対して追加の5%の計算量でGQAモデルを学習する手法を提案している。
Main Result. Multi-Head Attentionに対して、inference timeが大幅に改善しているが、Multi-Query Attentionよりも高い性能を維持している。
INSTRUCTSCORE: Explainable Text Generation Evaluation with Finegrained Feedback, Wenda Xu+, N_A, EMNLP'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Explanation #Supervised-FineTuning (SFT) #Evaluation #EMNLP #PostTraining #One-Line Notes Issue Date: 2024-01-25 GPT Summary- 自動的な言語生成の品質評価には説明可能なメトリクスが必要であるが、既存のメトリクスはその判定を説明したり欠陥とスコアを関連付けることができない。そこで、InstructScoreという新しいメトリクスを提案し、人間の指示とGPT-4の知識を活用してテキストの評価と診断レポートを生成する。さまざまな生成タスクでInstructScoreを評価し、他のメトリクスを上回る性能を示した。驚くべきことに、InstructScoreは人間の評価データなしで最先端のメトリクスと同等の性能を達成する。 Comment
伝統的なNLGの性能指標の解釈性が低いことを主張する研究
[Paper Note] G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment, Yang Liu+, N_A, EMNLP'23
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Evaluation #LLM-as-a-Judge #Surface-level Notes Issue Date: 2024-01-25 GPT Summary- 従来の参照ベースの評価指標では、自然言語生成システムの品質を正確に測定することが難しい。最近の研究では、大規模言語モデル(LLMs)を使用した参照ベースの評価指標が提案されているが、まだ人間との一致度が低い。本研究では、G-Evalという大規模言語モデルを使用した品質評価フレームワークを提案し、要約と対話生成のタスクで実験を行った。G-Evalは従来の手法を大幅に上回る結果を示し、LLMベースの評価器の潜在的な問題についても分析している。コードはGitHubで公開されている。 Comment
伝統的なNLGの性能指標が、人間の判断との相関が低いことを示した研究
# 手法概要
- CoTを利用して、生成されたテキストの品質を評価する手法を提案している。
- タスクのIntroductionと、評価のCriteriaをプロンプトに仕込むだけで、自動的にLLMに評価ステップに関するCoTを生成させ、最終的にフォームを埋める形式でスコアをテキストとして生成させ評価を実施する。最終的に、各スコアの生成確率によるweighted-sumによって、最終スコアを決定する。
# Scoringの問題点
たとえば、1-5のdiscreteなスコアを直接LLMにoutputさせると、下記のような問題が生じる:
1. ある一つのスコアが支配的になってしまい、スコアの分散が無く、人間の評価との相関が低くなる
2. LLMは小数を出力するよう指示しても、大抵の場合整数を出力するため、多くのテキストの評価値が同一となり、生成されたテキストの細かな差異を評価に取り入れることができない。
上記を解決するため、下記のように、スコアトークンの生成確率の重みづけ和をとることで、最終的なスコアを算出している。
# 評価
- SummEval SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
データと、Topical-Chat, QAGSデータの3つのベンチマークで評価を実施した。タスクとしては、要約と対話のresponse generationのデータとなる。
- モデルはGPT-3.5 (text-davinci-003), GPT-4を利用した
- gpt3.5利用時は、temperatureは0に設定し、GPT-4はトークンの生成確率を返さないので、`n=20, temperature=1, top_p=1`とし、20回の生成結果からトークンの出現確率を算出した。
## 評価結果
G-EVALがbaselineをoutperformし、特にGPT4を利用した場合に性能が高い。GPTScoreを利用した場合に、モデルを何を使用したのかが書かれていない。Appendixに記述されているのだろうか。
# Analysis
## G-EvalがLLMが生成したテキストを好んで高いスコアを付与してしまうか?
- 人間に品質の高いニュース記事要約を書かせ、アノテータにGPTが生成した要約を比較させたデータ ([Paper Note] Benchmarking Large Language Models for News Summarization, Tianyi Zhang+, arXiv'23, 2023.01
) を用いて検証
- その結果、基本的にGPTが生成した要約に対して、G-EVAL4が高いスコアを付与する傾向にあることがわかった。
- 原因1: [Paper Note] Benchmarking Large Language Models for News Summarization, Tianyi Zhang+, arXiv'23, 2023.01
で指摘されている通り、人間が記述した要約とLLMが記述した要約を区別するタスクは、inter-annotator agreementは`0.07`であり、極端に低く、人間でも困難なタスクであるため。
- 原因2: LLMは生成時と評価時に、共通したコンセプトをモデル内部で共有している可能性が高く、これがLLMが生成した要約を高く評価するバイアスをかけた
## CoTの影響
- SummEvalデータにおいて、CoTの有無による性能の差を検証した結果、CoTを導入した場合により高いcorrelationを獲得した。特に、Fluencyへの影響が大きい。
## Probability Normalizationによる影響
- probabilityによるnormalizationを導入したことで、kendall tauが減少した。この理由は、probabilityが導入されていない場合は多くの引き分けを生み出す。一方、kendall tauは、concordant / discordantペアの数によって決定されるが、引き分けの場合はどちらにもカウントされず、kendall tauの値を押し上げる効果がある。このため、これはモデルの真の性能を反映していない。
- 一方、probabilityを導入すると、より細かいな連続的なスコアを獲得することができ、これはspearman-correlationの向上に反映されている。
## モデルサイズによる影響
- 基本的に大きいサイズの方が高いcorrelationを示す。特に、consistencyやrelevanceといった、複雑な評価タスクではその差が顕著である。
- 一方モデルサイズが小さい方が性能が良い観点(engagingness, groundedness)なども存在した。
[Paper Note] Some things are more CRINGE than others: Iterative Preference Optimization with the Pairwise Cringe Loss, Jing Xu+, arXiv'23, 2023.12
Paper/Blog Link My Issue
#NLP #Alignment #SelfImprovement #PostTraining #One-Line Notes Issue Date: 2023-12-29 GPT Summary- 実務家は一般的にペアワイズの好みでLLMを整列させるが、二値フィードバックも有用である。そこで、既存の二値フィードバック手法Cringe Lossをペアワイズへ一般化した。ペアワイズ Cringe Loss は簡単に実装でき、訓練効率も高く、AlpacaFarm ベンチマークで最先端の手法を上回る結果を示した。また、訓練の反復が重要で、DPOをIterative DPOとして一般化できることを示した。 Comment
DPO, PPOをoutperformする新たなAlignment手法。MetaのJason Weston氏
元ツイート:
[Paper Note] Gemini: A Family of Highly Capable Multimodal Models, Gemini Team+, arXiv'23, 2023.12
Paper/Blog Link My Issue
#NLP #MultiModal #Proprietary #VisionLanguageModel #One-Line Notes Issue Date: 2023-12-21 GPT Summary- 新しいマルチモーダルモデルファミリー「Gemini」は、画像・音声・動画・テキスト理解において優れた能力を発揮し、Ultra・Pro・Nanoの3サイズから構成されている。Gemini Ultraモデルは32のベンチマークで30件で最先端の性能を示し、特にMMLUにおいて人間の専門家レベルを初めて達成。クロスモーダル推論の新たな能力により、さまざまなユースケースが可能となり、運用と責任あるデプロイのアプローチについても議論される。 Comment
Introducing Gemini: our largest and most capable AI model, Google, 2023.12 で発表されたGeminiの論文
[Paper Note] Unnatural Error Correction: GPT-4 Can Almost Perfectly Handle Unnatural Scrambled Text, Qi Cao+, EMNLP'23, 2023.11
Paper/Blog Link My Issue
#Analysis #NLP #QuestionAnswering #EMNLP #KeyPoint Notes Issue Date: 2023-12-04 GPT Summary- 大規模言語モデル(LLMs)、特にGPT-4の耐性を新たに実験的に探る。Scrambled Benchを提案し、スクランブルされた文の復元や質問応答能力を評価。実験結果は、多くのLLMsがtypoglycemiaに類似した能力を持つことを示唆。特にGPT-4は、完全にシャッフルされた文字から元の文をほぼ完璧に再構築し、95%の編集距離短縮を達成。他のLLMsにとって困難な入力でも、驚くべき処理能力を示す。 Comment
OpenAIのモデルがブラックボックスである限り、コンタミネーションがあるのでは?という疑念は持ってしまう。
(部分的にしか読めていないが…)
RealtimeQAと呼ばれるweeklyで直近のニュースに対するQuestionを発表することで構築されるデータセットのうち、2023.03.17--2023.08.04のデータを収集し、ScrambledSentenaeRecovery(ScrRec)とScrambleQuestionAnswering(ScrQA)の評価データを生成している。
完全にランダムに単語の文字をscramble(RS)すると、FalconとLlama2では元のテキストをゼロショットでは再構築できないことが分かる。FewShotではFalconであれば少し解けるようになる。一方、OpenAIのモデル、特にGPT4, GPT3.5-turboではゼロショットでもにり再構築ができている。
ScrQAについては、ランダムにscrambleした場合でもMultipleChoiceQuestionなので(RPGと呼ばれるAccの相対的なgainを評価するメトリックを提案している)正解はできている。
最初の文字だけを残す場合(KF)最初と最後の文字を残す場合(KFL」については、残す文字が増えるほどどちらのタスクも性能が上がり、最初の文字だけがあればOpenSourceLLMでも(ゼロショットでも)かなり元のテキストの再構築ができるようになっている。また、QAも性能が向上している。
完全にランダムに文字を入れ替えたら完全に無理ゲーなのでは、、、、と思ってしまうのだが、FalconでFewshotの場合は一部解けているようだ…。果たしてどういうことなのか…(大文字小文字が保持されたままなのがヒントになっている…?)Appendixに考察がありそうだがまだ読めていない。
(追記)
文全体でランダムに文字を入れ替えているのかと勘違いしていたが、実際には”ある単語の中だけでランダムに入れ替え”だった。これなら原理上はいけると思われる。
openreview: https://openreview.net/forum?id=STHKApXVMH¬eId=XCtbu5XTGi
Exponentially Faster Language Modelling, Peter Belcak+, N_A, arXiv'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP Issue Date: 2023-11-23 GPT Summary- UltraFastBERTは、推論時にわずか0.3%のニューロンしか使用せず、同等の性能を発揮することができる言語モデルです。UltraFastBERTは、高速フィードフォワードネットワーク(FFF)を使用して、効率的な実装を提供します。最適化されたベースラインの実装に比べて78倍の高速化を実現し、バッチ処理された推論に対しては40倍の高速化を実現します。トレーニングコード、ベンチマークのセットアップ、およびモデルの重みも公開されています。
GAIA: a benchmark for General AI Assistants, Grégoire Mialon+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #QuestionAnswering #AIAgents #Evaluation #Selected Papers/Blogs Issue Date: 2023-11-23 GPT Summary- GAIAは、General AI Assistantsのためのベンチマークであり、AI研究のマイルストーンとなる可能性がある。GAIAは、推論、マルチモダリティの処理、ウェブブラウジングなど、実世界の質問に対する基本的な能力を必要とする。人間の回答者は92%の正答率を達成し、GPT-4は15%の正答率を達成した。これは、最近の傾向とは異なる結果であり、専門的なスキルを必要とするタスクではLLMsが人間を上回っている。GAIAは、人間の平均的な堅牢性と同等の能力を持つシステムがAGIの到来に重要であると考えている。GAIAの手法を使用して、466の質問と回答を作成し、一部を公開してリーダーボードで利用可能にする。 Comment
Yann LeCun氏の紹介ツイート
Meta-FAIR, Meta-GenAI, HuggingFace, AutoGPTによる研究。人間は92%正解できるが、GPT4でも15%しか正解できないQAベンチマーク。解くために推論やマルチモダリティの処理、ブラウジング、ツールに対する習熟などの基本的な能力を必要とする実世界のQAとのこと。
- Open-source DeepResearch – Freeing our search agents, HuggingFace, 2025.02
で言及されているLLM Agentの評価で最も有名なベンチマークな模様
[Paper Note] Igniting Language Intelligence: The Hitchhiker's Guide From Chain-of-Thought Reasoning to Language Agents, Zhuosheng Zhang+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#Tutorial #NLP #Chain-of-Thought #One-Line Notes Issue Date: 2023-11-21 GPT Summary- LLMsは複雑な推論タスクにおいて驚異的な性能を示し、CoT推論技術を通じて解釈性や柔軟性を高めている。自律的な言語エージェントの開発が進み、様々な環境で行動を実行する能力を持つ。論文ではCoTの基礎機構、パラダイムシフト、言語エージェントの台頭を探求し、今後の研究の方向性について議論している。初心者から経験豊富な研究者まで広範囲な読者を対象にしている。 Comment
CoTに関するチュートリアル論文
[Paper Note] System 2 Attention (is something you might need too), Jason Weston+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#NLP #Prompting #ContextEngineering Issue Date: 2023-11-21 GPT Summary- S2Aを用いて、LLMsが注意を向けるべき部分を選択することで、無関係な情報を除外し最終応答を導出。QA、数学の文章題、長文生成において標準アテンションを上回り、事実性と客観性を高め、迎合性を低減。 Comment
おそらく重要論文
How is System 2 Attention different from prompt engineering specialized in factual double checks?
I'm very sorry for the extremely delayed response. It's been two years, so you may no longer have a chance to see this, but I'd still like to share my thoughts.
I believe that System 2 Attention is fundamentally different in concept from prompt engineering techniques such as factual double-checking. Unlike ad-hoc prompt engineering or approaches that enrich the context by adding new facts through prompting, System 2 Attention aims to improve the model’s reasoning ability itself by mitigating the influence of irrelevant tokens. It does so by selectively generating a new context composed only of relevant tokens, in a way that resembles human System 2 thinking—that is, more objective and deliberate reasoning.
From today’s perspective, two years later, I would say that this concept is more closely aligned with what we now refer to as Context Engineering. Thank you.
[Paper Note] Orca 2: Teaching Small Language Models How to Reason, Arindam Mitra+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #Chain-of-Thought #SmallModel #OpenWeight #Reading Reflections Issue Date: 2023-11-21 GPT Summary- Orca 2 は小型 LM の推論能力を高めるために、異なるタスクごとに様々な解法戦略を学習させることを目指す。段階的推論や思い出し-推論-生成などを用いて、小型モデルの潜在能力を最大化し、約100のタスクで評価を行い、同規模モデルを大きく上回る性能を達成。重みは公開され、開発研究の支援が期待される。 Comment
ポイント解説:
HF: https://huggingface.co/microsoft/Orca-2-13b
論文を読むとChatGPTのデータを学習に利用しているが、現在は競合となるモデルを作ることは規約で禁止されているので注意
[Paper Note] Implicit Chain of Thought Reasoning via Knowledge Distillation, Yuntian Deng+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#Pretraining #NLP #Chain-of-Thought Issue Date: 2023-11-21 GPT Summary- 言語モデルにおける推論能力向上のため、明示的な思考の連鎖推論ではなく、隠れ状態を用いた暗黙の推論を提案。教師モデルから蒸留したステップで、層間の隠れ状態を利用し、効率的な推論を実現。実験により、明示的チェーンなしで課題を解決し、推論速度も維持されることを示した。 Comment
これは非常に興味深い話
openreview: https://openreview.net/forum?id=9cumTvvlHG
Contrastive Chain-of-Thought Prompting, Yew Ken Chia+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting Issue Date: 2023-11-19 GPT Summary- 言語モデルの推論を改善するために、対照的なchain of thoughtアプローチを提案する。このアプローチでは、有効な推論デモンストレーションと無効な推論デモンストレーションの両方を提供し、モデルが推論を進める際にミスを減らすようにガイドする。また、自動的な方法を導入して対照的なデモンストレーションを構築し、汎化性能を向上させる。実験結果から、対照的なchain of thoughtが一般的な改善手法として機能することが示された。
Fine-tuning Language Models for Factuality, Katherine Tian+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Supervised-FineTuning (SFT) #Factuality Issue Date: 2023-11-15 GPT Summary- 本研究では、大規模な言語モデル(LLMs)を使用して、より事実に基づいた生成を実現するためのファインチューニングを行います。具体的には、外部の知識ベースや信頼スコアとの一貫性を測定し、選好最適化アルゴリズムを使用してモデルを調整します。実験結果では、事実エラー率の削減が観察されました。
[Paper Note] Instruction-Following Evaluation for Large Language Models, Jeffrey Zhou+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#NLP #Dataset #InstructionTuning #Evaluation #PostTraining #Selected Papers/Blogs #InstructionFollowingCapability #KeyPoint Notes Issue Date: 2023-11-15 GPT Summary- 大規模言語モデルの自然言語指示に対する評価は標準化されておらず、人間による評価は高価で遅い。そこで、Instruction-Following Eval(IFEval)を提案し、検証可能な指示に焦点を当てた評価ベンチマークを提供。25種類の指示を特定し、約500のプロンプトを作成。これにより、2つのLLMの客観的な評価結果を示すことに成功した。コードとデータは公開されている。 Comment
LLMがinstructionにどれだけ従うかを評価するために、検証可能なプロンプト(400字以上で書きなさいなど)を考案し評価する枠組みを提案。人間が評価すると時間とお金がかかり、LLMを利用した自動評価だと評価を実施するLLMのバイアスがかかるのだ、それら両方のlimitationを克服できるとのこと。
[Paper Note] Fast Chain-of-Thought: A Glance of Future from Parallel Decoding Leads to Answers Faster, Hongxuan Zhang+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Chain-of-Thought #Prompting #Initial Impression Notes Issue Date: 2023-11-15 GPT Summary- FastCoTは、追加トレーニングやLLM改変なしに並列デコードを実現するモデル非依存のフレームワークです。可変長コンテキストウィンドウを使用し、並列かつ自己回帰的なデコードを行うことで、GPUリソースを最適化します。これにより、因果型トランスフォーマーの従来手法よりも迅速な応答が可能になります。実験結果では、FastCoTが推論時間を約20%短縮しつつ、性能低下も最小限であることが示されています。 Comment
論文中の図を見たが、全くわからなかった・・・。ちゃんと読まないとわからなそうである。
Cappy: Outperforming and Boosting Large Multi-Task LMs with a Small Scorer, Bowen Tan+, N_A, NeurIPS'23
Paper/Blog Link My Issue
#NLP #SmallModel #NeurIPS #Initial Impression Notes Issue Date: 2023-11-14 GPT Summary- 大規模言語モデル(LLMs)はマルチタスキングに優れた性能を示していますが、パラメータ数が多く計算リソースを必要とし、効率的ではありません。そこで、小規模なスコアラーであるCappyを導入し、独立して機能するかLLMsの補助として使用することでパフォーマンスを向上させました。Cappyはファインチューニングやパラメータへのアクセスを必要とせず、さまざまなタスクで高い性能を発揮します。実験結果では、Cappyは独立したタスクや複雑なタスクで大きなLLMsを上回り、他のLLMsとの連携も可能です。 Comment
360MパラメータでさまざまなタスクでLLMに勝つっぽいのでおもしろそうだし実用性もありそう
[Paper Note] A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions, Lei Huang+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#Survey #NLP #Hallucination #One-Line Notes Issue Date: 2023-11-10 GPT Summary- LLMの登場によりNLPは新たな転機を迎えたが、幻覚問題が信頼性に対する懸念を引き起こし、検出と緩和の研究を促進している。幻覚はタスク特化型モデルとは異なる課題を呈し、詳細な理解が求められる。本調査では、幻覚の分類法や要因を詳述し、検知手法と緩和方法、情報検索を含むLLMの現状における制約を掘り下げる。また、ビジョン言語モデルにおける幻覚や知識の境界の理解を含む今後の研究方向も強調する。 Comment
Hallucinationを現象ごとに分類したSurveyとして [Paper Note] A Survey of Hallucination in Large Foundation Models, Vipula Rawte+, arXiv'23, 2023.09 もある
Surveyの内容。必要に応じて参照すべし。
[Paper Note] LightLM: A Lightweight Deep and Narrow Language Model for Generative Recommendation, Kai Mei+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#RecommenderSystems #One-Line Notes Issue Date: 2023-11-10 GPT Summary- LightLMは、生成的推薦のために特化した軽量なTransformerベースの言語モデルである。従来の重いモデルに代わり、短いトークンを主成分とする浅い構造を採用し、推奨アイテムの直接生成に効果的である。ユーザーIDおよびアイテムIDに対する新たなインデックス化手法(SCIとGCI)を提案し、推薦タスクにおいて大規模言語モデルに勝る性能を示す。さらに、ハルシネーションを抑えるための制約付き生成プロセスを導入し、実データセットで競合するベースラインを上回る精度と効率を実現した。 Comment
Generative Recommendationはあまり終えていないのだが、既存のGenerative Recommendationのモデルをより軽量にし、性能を向上させ、存在しないアイテムを生成するのを防止するような手法を提案しました、という話っぽい。
Bayesian Personalized Ranking [Paper Note] BPR: Bayesian Personalized Ranking from Implicit Feedback, Steffen Rendle+, UAI'09, 2009.06
ベースドなMatrix Factorizationよりは高い性能が出てるっぽい。
[Paper Note] Do LLMs exhibit human-like response biases? A case study in survey design, Lindia Tjuatja+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#Analysis #NLP #TACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-11-08 GPT Summary- LLMの高性能に伴い、調査や世論調査での人間代理としての活用が期待されるが、プロンプト文言への感度が課題となる。本研究では、LLMが人間の応答バイアスを反映するかを調査し、調査票設計を通じて評価する。結果、主流のLLMは一般的に人間のような挙動を示さず、特にRLHFを経たモデルで顕著だった。また、人間に影響を与えない摂動には敏感であることが判明。これにより、LLMの人間代理利用時の注意点とモデル挙動の細かな分析の必要性が浮き彫りとなった。 Comment
LLMはPromptにsensitiveだが、人間も質問の仕方によって応答が変わるから、sensitiveなのは一緒では?ということを調査した研究。Neubig氏のツイートだと、instruction tuningやRLHFをしていないBase LLMの方が、より人間と類似した回答をするのだそう。
元ツイート:
人間のレスポンスのバイアス。左側は人間は「forbidden」よりも「not allowed」を好むという例、右側は「response order」のバイアスの例(選択肢の順番)。
LLM側で評価したいバイアスごとに、QAのテキストを変更し、LLMに回答を生成され、social science studiesでのトレンドと比較することで、LLMにも人間と同様のバイアスがあるかを明らかにしている。
結果は以下の表であり、青いセルが人間と同様のバイアスを持つことを統計的に有意に示されたもの(のはず)。これをみると、全てのバイアスに対して人間と同様の傾向があったのはLlama2-70Bのみであり、instruction tuningや、RLHFをかけた場合(RLHFの方が影響が大きそう)人間のバイアスとは異なる挙動をするモデルが多くなることがわかる。また、モデルのパラメータサイズとバイアスの強さには相関関係は見受けられない。
Pretraining Data Mixtures Enable Narrow Model Selection Capabilities in Transformer Models, Steve Yadlowsky+, N_A, arXiv'23
Paper/Blog Link My Issue
#Analysis #NLP #Transformer #OOD #One-Line Notes #Reading Reflections Issue Date: 2023-11-06 GPT Summary- 本研究では、トランスフォーマーモデルの文脈学習(ICL)能力を調査しました。トランスフォーマーモデルは、事前学習データの範囲内で異なるタスクを特定し、学習する能力を持っています。しかし、事前学習データの範囲外のタスクや関数に対しては一般化が劣化することが示されました。また、高容量のシーケンスモデルのICL能力は、事前学習データの範囲に密接に関連していることが強調されました。 Comment
Transformerがpre-training時に利用された学習データ以外の分布に対しては汎化性能が落ちることを示したらしい。もしこれが正しいとすると、結局真に新しい分布というか関数というかタスクというか、をTransformerが創出する可能性は低いと言えるかもしれない。が、新しいものって大体は既存の概念の組み合わせだよね(スマホとか)、みたいなことを考えると、別にそれでも十分では?と思ってしまう。人間が本当に真の意味で新しい関数というかタスクというか分布を生み出せているかというと、実はそんなに多くないのでは?という予感もする。まあたとえば、量子力学を最初に考えました!とかそういうのは例外だと思うけど・・・、そのレベルのことってどんくらいあるんだろうね?
[Paper Note] The Perils & Promises of Fact-checking with Large Language Models, Dorian Quelle+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #Evaluation #Factuality #RAG(RetrievalAugmentedGeneration) #One-Line Notes #Reading Reflections Issue Date: 2023-11-05 GPT Summary- 自動ファクトチェックは機械学習を用いて主張を検証する重要な取り組みであり、LLMs(例:GPT-4)はその能力を活用しつつ、情報の真偽を見分ける役割が増大している。本研究ではLLMエージェントがクエリを作成し、文脈データを取得し、意思決定を行うフレームワークを提案。結果、文脈情報がLLMの能力を向上させることが示されたが、正確性はクエリの言語や主張の真偽に依存し、一貫性に欠けるため慎重な運用が求められる。さらなる研究が必要で、エージェントの成功と失敗のメカニズムを探求することが提言される。 Comment
gpt3とgpt4でFactCheckして傾向を分析しました、という研究。promptにstatementとgoogleで補完したcontextを含め、出力フォーマットを指定することでFactCheckする。
promptingする際の言語や、statementの事実性の度合い(半分true, 全てfalse等)などで、性能が大きく変わる結果とのこと。
性能を見ると、まだまだ(このprompting方法では)人間の代わりが務まるほどの性能が出ていないことがわかる。また、trueな情報のFactCheckにcontextは効いていそうだが、falseの情報のFactCheckにContextがあまり効いてなさそうに見えるので、なんだかなあ、という感じである。
斜め読みしかしていないがこの研究、学術的な知見は少ないのかな、という印象。一つのケーススタディだよね、という感じがする。
まず、GPT3,4だけじゃなく、特徴の異なるOpenSourceのLLMを比較に含めてくれないと、前者は何で学習しているか分からないので、学術的に得られる知見はほぼないのではという気が。実務的には役に立つが。
その上で、Promptingをもっとさまざまな方法で検証した方が良いと思う。
たとえば、現在のpromptではラベルを先に出力させた後に理由を述べさせているが、それを逆にしたらどうなるか?(zero-shot CoT)や、4-Shotにしたらどうなるか、SelfConsistencyを利用したらどうなるかなど、promptingの仕方によって傾向が大きく変わると思う。
加えて、Retriever部分もいくつかのバリエーションで試してみても良いのかなと思う。特に、falseの情報を判断する際に役に立つ情報がcontextに含められているのかが気になる。
論文に書いてあるかもしれないが、ちょっとしっかり読む時間はないです!!
[Paper Note] Llemma: An Open Language Model For Mathematics, Zhangir Azerbayev+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Pretraining #NLP #FoundationModel #Mathematics #mid-training #One-Line Notes #Reading Reflections Issue Date: 2023-10-29 GPT Summary- Llemmaという数学の大規模言語モデルを提案。Proof-Pile-2でCode Llamaの前訓練を行い、科学論文や数学コードを含む複合データセットで強化。MATHベンチマークで全ての公開モデルを凌ぎ、未公開のMinervaモデル群にも勝利。追加ファインチューニングなしでツール使用や形式的定理証明が可能。70億および340億パラメータのモデルや実験コードを公開。 Comment
CodeLLaMAを200B tokenの数学テキスト(proof-pile-2データ;論文、数学を含むウェブテキスト、数学のコードが含まれるデータ)で継続的に事前学習することでfoundation modelを構築
約半分のパラメータ数で数学に関する性能でGoogleのMinervaと同等の性能を達成
元ツイート:
まだ4-shotしてもAcc.50%くらいなのか。
Large Language Models are not Fair Evaluators, Peiyi Wang+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Evaluation Issue Date: 2023-10-29 GPT Summary- この論文では、大規模言語モデル(LLMs)を使用して、候補モデルの応答品質を評価する評価パラダイムにおける系統的なバイアスを明らかにします。さらに、バイアスを軽減するためのキャリブレーションフレームワークを提案し、実験によってその有効性を示します。また、コードとデータを公開して、今後の研究を支援します。
[Paper Note] Zephyr: Direct Distillation of LM Alignment, Lewis Tunstall+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Pretraining #NLP #Supervised-FineTuning (SFT) #SyntheticData #COLM #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-10-28 GPT Summary- ユーザーの意図に応じた小型言語モデルを目指し、dSFTに基づくモデルの整合性向上を図る。AIフィードバックからの選好データを用い、dDPOを適用することで、意図の整合性が向上したチャットモデルを学習。追加サンプリングなしで数時間の訓練で最先端のZephyr-7Bを実現し、MT-BenchでLlama2-Chat-70Bを上回る成果を達成。コードやデータは公開。 Comment
7BパラメータでLlaMa70Bと同等の性能を達成したZephyrの論文。
- dSFT:既存データからpromptをサンプリングし、user,assistantのmulti turnの対話をLLMでシミュレーションしてデータ生成しSFT
- AIF:既存データからpromstをサンプリングし、異なる4つのLLMのレスポンスをGPT4でランクづけしたデータの活用
- dDPO: 既存データからpromptをサンプリングし、ベストなレスポンスとランダムにサンプリングしたレスポンスの活用
人手を一切介していない。
Blog: https://huggingface.co/blog/Isamu136/understanding-zephyr
openreview: https://openreview.net/forum?id=aKkAwZB6JV
[Paper Note] Exploring OCR Capabilities of GPT-4V(ision) : A Quantitative and In-depth Evaluation, Yongxin Shi+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #EMNLP #OCR #One-Line Notes #Reading Reflections Issue Date: 2023-10-26 GPT Summary- GPT-4VのOCR機能を評価し、シーンテキスト、手書き文字、数学式や表構造認識などの幅広いタスクへの性能を検討。ラテン文字では高性能だが、多言語や複雑なタスクでは限界を示す。専門的なOCRモデルの必要性を強調し、今後の研究の指針を提供。評価結果は公開されている。 Comment
GPT4-VをさまざまなOCRタスク「手書き、数式、テーブル構造認識等を含む)で性能検証した研究。
MLT19データセットを使った評価では、日本語の性能は非常に低く、英語とフランス語が性能高い。手書き文字認識では英語と中国語でのみ評価。
現在では非常に性能が向上していると考えられるが、初期VLMのOCR性能を示している文献として興味深い。
[Paper Note] Auto-Instruct: Automatic Instruction Generation and Ranking for Black-Box Language Models, Zhihan Zhang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #InstructionTuning #InstructionGeneration #EMNLP #Findings #KeyPoint Notes Issue Date: 2023-10-26 GPT Summary- LLMに対する指示の自動生成と評価を行うAuto-Instructを提案。多様な候補指示を生成し、既存の575タスク用のスコアリングモデルでランク付け。ドメイン外の118タスクで、人手作成や従来の生成指示を上回る性能を示し、高い一般化性を持つことを確認。 Comment
seed instructionとdemonstrationに基づいて、異なるスタイルのinstructionを自動生成し、自動生成したinstructionをとinferenceしたいexampleで条件づけてランキングし、良質なものを選択。選択したinstructionでinferenceを実施する。
既存手法よりも高い性能を達成している。特にexampleごとにinstructionを選択する手法の中で最もgainが高い。これは、提案手法がinstructionの選択にtrained modelを利用しているためであると考えられる。
[Paper Note] NEFTune: Noisy Embeddings Improve Instruction Finetuning, Neel Jain+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#MachineLearning #NLP #Supervised-FineTuning (SFT) #ICLR #PostTraining #read-later #Initial Impression Notes Issue Date: 2023-10-26 GPT Summary- 単純なデータ拡張により、言語モデルのファインチューニングが改善されることを示す。NEFTuneは埋め込みベクトルにノイズを追加し、LLaMA-2-7Bのファインチューニングで29.79%から64.69%へ劇的な向上を実現。現代の指示データセットでも改善をもたらし、Evol-Instruct、ShareGPT、OpenPlatypusでそれぞれ10%、8%、8%の向上を示す。さらに、LLaMA-2-Chatに対しても恩恵を受ける。 Comment
Alpacaデータでの性能向上が著しい。かなり重要論文な予感。後で読む。
HuggingFaceのTRLでサポートされている
https://huggingface.co/docs/trl/sft_trainer
openreview: https://openreview.net/forum?id=0bMmZ3fkCk
[Paper Note] In-Context Learning Creates Task Vectors, Roee Hendel+, EMNLP'23 Findings, 2023.10
Paper/Blog Link My Issue
#NLP #In-ContextLearning #EMNLP #read-later #Findings #Initial Impression Notes Issue Date: 2023-10-26 GPT Summary- ICLはLLMにおける新しい学習パラダイムで、その機序は未解明である。訓練データ集合を用いる従来の機械学習とは異なり、ICLはデータを単一のタスクベクトルに圧縮し、トランスフォーマーを調整して出力を生成する。多様なモデルとタスクの実験を通じて、この新たな理解を支持する結果を示す。 Comment
参考:
ICLが実現可能なのは実はネットワーク内部で与えられたdemonstrationに対して勾配効果法を再現しているからです、という研究もあったと思うけど、このタスクベクトルとの関係性はどういうものなのだろうか。
文脈に注意を与えなくてもICLと同じ性能が出るのは、文脈情報が不要なタスクを実施しているからであり、そうではないタスクだとこの知見が崩れるのだろうか。後で読む。
openreview: https://openreview.net/forum?id=QYvFUlF19n
Branch-Solve-Merge Improves Large Language Model Evaluation and Generation, Swarnadeep Saha+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Evaluation Issue Date: 2023-10-25 GPT Summary- 本研究では、多面的な言語生成および評価タスクにおいて、大規模言語モデルプログラム(BSM)を提案します。BSMは、ブランチ、ソルブ、マージの3つのモジュールから構成され、タスクを複数のサブタスクに分解し、独立して解決し、解決策を統合します。実験により、BSMが評価の正確性と一貫性を向上させ、パフォーマンスを向上させることが示されました。
[Paper Note] Personalized Soups: Personalized Large Language Model Alignment via Post-hoc Parameter Merging, Joel Jang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #Alignment #ReinforcementLearning #Personalization #Souping #Initial Impression Notes Issue Date: 2023-10-24 GPT Summary- 人間のフィードバックを用いた強化学習(RLHF)は、LLMsを一般的な好みに合わせるが、個別の視点には最適でない。本研究では、個別のフィードバックを考慮した強化学習(RLPHF)を提案し、複数の好みに対応するために多目的強化学習(MORL)としてモデル化。好みを複数の次元に分解することで、個別のアライメントを達成できることを示し、これらの次元が独立して訓練され、効果的に結合可能であることを実証。コードは公開されている。 Comment
どこまでのことが実現できるのかが気になる。
[Paper Note] Eliminating Reasoning via Inferring with Planning: A New Framework to Guide LLMs' Non-linear Thinking, Yongqi Tong+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#MachineLearning #NLP #Chain-of-Thought #Prompting #Initial Impression Notes Issue Date: 2023-10-24 GPT Summary- 非線形思考を模倣するために、Inferential Exclusion Prompting (IEP) を提案。IEPは計画後にNLIを活用し、解に対する推論を振り返ることで複雑な思考過程を再現。実証研究により、IEPがCoTを一貫して上回ることを確認。IEPとCoTを統合することでLLMsの性能向上も観察。新たに導入したMental-Ability Reasoning Benchmark (MARB)は9,115問からなり、LLMsの論理能力を評価するための有望な方法とされ、近日中に公開予定。 Comment
論文自体は読めていないのだが、CoTが線形的だという主張がよくわからない。
CoTはAutoregressiveな言語モデルに対して、コンテキストを自己生成したテキストで利用者の意図した方向性にバイアスをかけて補完させ、
利用者が意図した通りのアウトプットを最終的に得るためのテクニック、だと思っていて、
線形的だろうが非線形的だろうがどっちにしろCoTなのでは。
[Paper Note] Generalizable Chain-of-Thought Prompting in Mixed-task Scenarios with Large Language Models, Anni Zou+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #Initial Impression Notes Issue Date: 2023-10-13 GPT Summary- GeM-CoTは、未知の入力問に対する一般化可能なCoTプロンプティング手法を提案。問の型を分類し、データプールから自動デモを生成することで、性能と一般化のギャップを解消。これにより、10の公開推論タスクと23のBBHタスクで優れたパフォーマンスを実現。 Comment
色々出てきたがなんかもう色々組み合わせれば最強なんじゃね?って気がしてきた。
openreview: https://openreview.net/forum?id=79tJB1eTmb
[Paper Note] Survey on Factuality in Large Language Models: Knowledge, Retrieval and Domain-Specificity, Cunxiang Wang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Survey #NLP #Factuality #needs-revision Issue Date: 2023-10-13 GPT Summary- LLMsにおける事実性の問題に焦点を当て、出力の信頼性と正確性の重要性を検討。事実誤りの影響や原因を分析し、評価方法論や改善戦略を提案。スタンドアロンLLMsとリトリーバル拡張LLMsの固有の課題を詳述し、体系的なガイドを提供する。 Comment
[Paper Note] RECOMP: Improving Retrieval-Augmented LMs with Compression and Selective Augmentation, Fangyuan Xu+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #RAG(RetrievalAugmentedGeneration) #ICLR #One-Line Notes #Compression Issue Date: 2023-10-10 GPT Summary- 推論時に文書を要約することでLMの性能を向上。抽出型と抽象型の2つの圧縮器を提案し、計算コストと関連情報の識別負担を軽減。要約が無関係な場合は空文字列を返すことで選択的付加を実現。言語モデリングと質問応答タスクで評価し、圧縮率6%で性能を維持し、市販の要約モデルを上回る成果を示した。圧縮器は他のLMにも適用可能で、忠実な要約を生成。 Comment
RAGをする際に、元文書群を要約して圧縮することで、性能低下を抑えながら最大6%程度まで元文書群を圧縮できた、とのこと。
元ツイート:
RAGを導入する際のコスト削減に有用そう
openreview: https://openreview.net/forum?id=mlJLVigNHp
[Paper Note] Retrieval meets Long Context Large Language Models, Peng Xu+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #RAG(RetrievalAugmentedGeneration) #One-Line Notes Issue Date: 2023-10-09 GPT Summary- 大規模言語モデル(LLMs)のコンテキスト窓の拡張と検索補強の効能を比較検討。独自の43B GPTとLlama2-70Bを用いて、検索補強を活用した4Kのコンテキストで、16Kのファインチューニング済みLLMと同等の性能を計算量を抑えて実現。特に、検索取得がLLMsの性能を大幅に向上させることを確認。最良モデルは32Kのコンテキストで、9つの長文タスクにおいて従来のモデルを上回り、高速な生成を実現。研究は、実務者に対してLLMの選択に関する指針を提供。 Comment
参考:
検索補強(Retrieval Augmentation)とは、言語モデルの知識を補完するために、関連する文書を外部の文書集合からとってきて、contextに含める技術のこと
https://tech.acesinc.co.jp/entry/2023/03/31/121001
[Paper Note] RoleLLM: Benchmarking, Eliciting, and Enhancing Role-Playing Abilities of Large Language Models, Zekun Moore Wang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #Dataset #Alignment #Conversation Issue Date: 2023-10-09 GPT Summary- RoleLLMは、大規模言語モデル(LLMs)のロールプレイ能力を強化するためのフレームワークで、100の役割に対するプロファイル構築やロール固有の知識抽出を行います。Context-InstructとRoleGPTを駆使して、初の体系的なキャラクター単位のベンチマークデータセットRoleBenchを作成し、サンプル数は168,093に達します。RoCITを使ったファインチューニングにより、RoleLLaMAとRoleGLMが生成され、GPT-4と同等のロールプレイ能力を実現しました。
[Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#ComputerVision #NLP #QuestionAnswering #OpenWeight #CVPR #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2023-10-09 GPT Summary- LLaVAにCLIP-ViT-L-336pxとMLP投影を用いた全結合型コネクタを導入し、学術タスク指向のVQAデータを追加。単純な変更で、公開データ120万件・8基のA100による約1日の学習で、11のベンチマークすべてで最先端性能を達成。高性能かつデータ効率の高いLMMベースラインを確立し、研究の普及に貢献。 Comment
画像分析が可能なオープンソースLLMとのこと。
画像生成をできるわけではなく、inputとして画像を扱えるのみ。
pj page: https://llava-vl.github.io
[Paper Note] MLAgentBench: Evaluating Language Agents on Machine Learning Experimentation, Qian Huang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#MachineLearning #NLP #Dataset #AIAgents #Evaluation #AutoML #One-Line Notes Issue Date: 2023-10-09 GPT Summary- 機械学習の実験を行うためのエージェントを強力な言語モデルを用いて構築し、MLAgentBenchという13のタスクベンチマークを導入。エージェントはファイル操作やコード実行を行い、Claude v3 Opusが最も高い成功率を示す。タスク全体で平均成功率37.5%を達成するが、結果はデータセットによって大きく変動。長期計画や幻覚の低減といった重要な課題も明らかにした。コードは公開中。 Comment
GPT4がMLモデルをどれだけ自動的に構築できるかを調べた模様。また、ベンチマークデータを作成した模様。結果としては、既存の有名なデータセットでの成功率は90%程度であり、未知のタスク(新たなKaggle Challenge等)では30%程度とのこと。
[Paper Note] Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution, Chrisantha Fernando+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #Prompting #AutomaticPromptEngineering #ICML #Reading Reflections Issue Date: 2023-10-09 GPT Summary- Promptbreederは、LLMの推論能力を向上させる自己改善メカニズムであり、特定のドメインに対してプロンプトを進化・適応させる。タスクプロンプトの集団を突然変異させ、訓練データで評価することで、LLMが生成・改善する変異プロンプトによって統治される。これにより、Chain-of-ThoughtやPlan-and-Solve Promptingを上回り、ヘイトスピーチ分類のような複雑なタスクにも対応可能なプロンプトを進化させる。 Comment
詳細な解説記事: https://aiboom.net/archives/56319
APEとは異なり、GAを使う。突然変異によって、予期せぬ良いpromptが生み出されるかも…?
[Paper Note] Large Language Model Alignment: A Survey, Tianhao Shen+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Survey #Alignment #PostTraining Issue Date: 2023-10-09 GPT Summary- LLMsの進展には潜在的な問題が伴い、正確性や人間の価値観との整合性が求められる。本研究は、アラインメント手法を探求し、外部と内部アラインメントを分類。解釈可能性や脆弱性についても考察し、多様な評価方法を提示。最終的に、AIアラインメント研究とLLMsの能力探索を結びつけることを目的とする。 Comment
LLMのalignmentに関するサーベイ。
[Paper Note] Effective Long-Context Scaling of Foundation Models, Wenhan Xiong+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #LongContext #PositionalEncoding #NAACL #mid-training #Selected Papers/Blogs #DataMixture #KeyPoint Notes #needs-revision Issue Date: 2023-10-09 GPT Summary- 長文脈対応LLMシリーズを提案し、32,768トークンまでサポート。Llama 2の継続的な事前学習を基に、長文タスクで顕著な改善を実現。特に70B版は指示チューニングによりGPT-3.5-turbo-16kを上回る性能を示す。また、ポジションエンコーディングやデータ混合の影響を分析し、長文脈の事前学習が効率的かつ効果的であることを実証。 Comment
以下elvis氏のツイートの意訳
Metaが32kのcontext windowをサポートする70BのLLaMa2のvariant提案し、gpt-3.5-turboをlong contextが必要なタスクでoutperform。
short contextのLLaMa2を継続的に訓練して実現。これには人手で作成したinstruction tuning datasetを必要とせず、コスト効率の高いinstruction tuningによって実現される。
これは、事前学習データセットに長いテキストが豊富に含まれることが優れたパフォーマンスの鍵ではなく、ロングコンテキストの継続的な事前学習がより効率的であることを示唆している。
元ツイート:
位置エンコーディングにはlong contxet用に、RoPEのbase frequency bを `10,000->500,000` とすることで、rotation angleを小さくし、distant tokenに対する減衰の影響を小さくする手法を採用 (Adjusted Base Frequency; ABF)。token間の距離が離れていても、attention scoreがshrinkしづらくなっている。
また、単に長いコンテキストのデータを追加するだけでなく、データセット内における長いコンテキストのデータの比率を調整することで、より高い性能が発揮できることを示している。これをData Mixと呼ぶ。
また、instruction tuningのデータには、LLaMa2ChatのRLHFデータをベースに、LLaMa2Chat自身にself-instructを活用して、長いコンテキストを生成させ拡張したものを利用した。
具体的には、コーパス内のlong documentを用いたQAフォーマットのタスクに着目し、文書内のランダムなチャンクからQAを生成させた。その後、self-critiqueによって、LLaMa2Chat自身に、生成されたQAペアのverificationも実施させた。
[Paper Note] The Reversal Curse: LLMs trained on "A is B" fail to learn "B is A", Lukas Berglund+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Analysis #NLP #ICLR #Selected Papers/Blogs #ReversalCurse #KeyPoint Notes Issue Date: 2023-10-09 GPT Summary- 自己回帰型の大規模言語モデル(LLMs)の一般化の失敗を指摘し、特に「AはB」で学習したモデルが「BはA」を自動的に推測できない現象、いわゆる逆転の呪いを明らかにする。例えば、「Valentina Tereshkovaは宇宙へ初めて行った女性である」と学習しても、「宇宙へ初めて行った女性は誰ですか?」には正答できない。ファインチューニングされたGPT-3とLlama-1が、この逆転の構造から正しく答えられない事例を示し、逆転の呪いはモデルのサイズやファミリーに関係なく存在することを確認した。さらに、ChatGPT(GPT-3.5およびGPT-4)の評価でも同様の傾向が見られ、質問によって正答率に大きな差が生じることが示された。 Comment
A is Bという文でLLMを訓練しても、B is Aという逆方向には汎化されないことを示した。
著者ツイート:
GPT3, LLaMaを A is Bでfinetuneし、B is Aという逆方向のfactを生成するように(質問をして)テストしたところ、0%付近のAcc.だった。
また、Acc.が低いだけでなく、対数尤度もrandomなfactを生成した場合と、すべてのモデルサイズで差がないことがわかった。
このことら、Reversal Curseはモデルサイズでは解決できないことがわかる。
openreview: https://openreview.net/forum?id=GPKTIktA0k
[Paper Note] Large Language Models as Analogical Reasoners, Michihiro Yasunaga+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting #In-ContextLearning #ICLR #KeyPoint Notes #Reading Reflections Issue Date: 2023-10-07 GPT Summary- アナロジー的プロンプティングを用いて、言語モデルに問題解決前に関連する例示を生成させる新手法を提案。ラベリング不要で汎用性が高く、適応性もある。実験では、GSM8K、MATH、Codeforces、BIG-Benchの推論タスクで0ショットおよび少数ショットCoTを上回る性能を示した。 Comment
以下、著者ツイートのざっくり翻訳:
人間は新しい問題に取り組む時、過去に解いた類義の問題を振り返り、その経験を活用する。これをLLM上で実践できないか?というのがアイデア。
Analogical Promptingでは、問題を解く前に、適切なexamplarを自動生成(problemとsolution)させ、コンテキストとして利用する。
これにより、examplarは自己生成されるため、既存のCoTで必要なexamplarのラベリングや検索が不要となることと、解こうとしている問題に合わせてexamplarを調整し、推論に対してガイダンスを提供することが可能となる。
実験の結果、数学、コード生成、BIG-Benchでzero-shot CoT、few-shot CoTを上回った。
LLMが知っており、かつ得意な問題に対してならうまく働きそう。一方で、LLMが苦手な問題などは人手作成したexamplarでfew-shotした方が(ある程度)うまくいきそうな予感がする。うまくいきそうと言っても、そもそもLLMが苦手な問題なのでfew-shotした程度では焼石に水だとは思うが。
openreview: https://openreview.net/forum?id=AgDICX1h50
[Paper Note] MAmmoTH: Building Math Generalist Models through Hybrid Instruction Tuning, Xiang Yue+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #Dataset #InstructionTuning #NumericReasoning #Reasoning #Mathematics #PostTraining #One-Line Notes Issue Date: 2023-09-30 GPT Summary- MAmmoTHシリーズは、数学問題解法に特化したオープンソースのLLMで、MathInstructという指示チューニングデータセットを使用して訓練されています。MathInstructは、中間推論を含む13の数学データセットから構成され、特に6つの新たな推論過程を提供しています。CoTとPoTのハイブリッドを採用することで、異なる思考プロセスを実現し、9つの数学推論データセットで平均16%から32%の精度向上を実現しました。特にMAmmoTH-7BモデルはMATHデータセットで33%、MAmmoTH-34Bモデルは44%を達成し、既存のオープンソースモデルを上回っています。研究は、多様な問題の網羅性とハイブリッド推論の重要性を示しています。 Comment
9つのmath reasoningが必要なデータセットで13-29%のgainでSoTAを達成。
260kの根拠情報を含むMath Instructデータでチューニングされたモデル。
project page:
https://tiger-ai-lab.github.io/MAmmoTH/
[Paper Note] A Survey of Hallucination in Large Foundation Models, Vipula Rawte+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Survey #NLP #Hallucination #ICLR #needs-revision Issue Date: 2023-09-30 GPT Summary- 基盤モデルにおける幻覚を特定・解明し、対処する取り組みを概観する総説論文。特に大規模基盤モデルに焦点を当て、幻覚現象を分類し、その評価基準を確立。既存の緩和戦略を検討し、今後の研究方向について論じる。全体として、LFMsに関連する幻覚の課題と解決策を包括的に探求。 Comment
Hallucinationを現象ごとに分類し、Hallucinationの程度の評価をする指標や、Hallucinationを軽減するための既存手法についてまとめられているらしい。
openreview: https://openreview.net/forum?id=pETSfWMUzy
RAIN: Your Language Models Can Align Themselves without Finetuning, Yuhui Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#General #NLP #Alignment #One-Line Notes Issue Date: 2023-09-30 GPT Summary- 本研究では、追加のデータなしで凍結された大規模言語モデル(LLMs)を整列させる方法を探求しました。自己評価と巻き戻しメカニズムを統合することで、LLMsは自己ブースティングを通じて人間の好みと一致する応答を生成することができることを発見しました。RAINという新しい推論手法を導入し、追加のデータやパラメータの更新を必要とせずにAIの安全性を確保します。実験結果は、RAINの効果を示しており、LLaMA 30Bデータセットでは無害率を向上させ、Vicuna 33Bデータセットでは攻撃成功率を減少させることができました。 Comment
トークンのsetで構成されるtree上を探索し、出力が無害とself-evaluationされるまで、巻き戻しと前方生成を繰り返し、有害なトークンsetの重みを動的に減らすことでalignmentを実現する。モデルの追加のfinetuning等は不要。
self-evaluationでは下記のようなpromptを利用しているが、このpromptを変更することでこちら側の意図したとおりに出力のアライメントをとることができると思われる。非常に汎用性の高い手法のように見える。
Struc-Bench: Are Large Language Models Really Good at Generating Complex Structured Data?, Xiangru Tang+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #StructuredData #One-Line Notes Issue Date: 2023-09-30 GPT Summary- 本研究では、大規模言語モデル(LLMs)の能力を評価し、構造に注意したファインチューニング手法を提案します。さらに、Struc-Benchというデータセットを使用して、複雑な構造化データ生成のパフォーマンスを評価します。実験の結果、提案手法は他の評価されたLLMsよりも優れた性能を示しました。また、モデルの能力マップを提示し、LLMsの弱点と将来の研究の方向性を示唆しています。詳細はhttps://github.com/gersteinlab/Struc-Benchを参照してください。 Comment
Formatに関する情報を含むデータでInstruction TuningすることでFormatCoT(フォーマットに関する情報のCoT)を実現している模様。ざっくりしか論文を読んでいないが詳細な情報があまり書かれていない印象で、ちょっとなんともいえない。
[Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#MachineLearning #NLP #Quantization #ICLR #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-09-29 GPT Summary- GPTモデルはその優れた性能にもかかわらず、高い計算とストレージコストが課題である。この問題を解決するため、近似二次情報に基づく新しい量子化手法GPTQを提案。GPTQは、1750億パラメータを持つモデルの量子化を約4時間で行い、精度をほとんど失うことなくビット幅を3または4ビットに削減する。また、この手法は圧縮の利得が2倍以上高く、単一のGPUでの推論を可能にし、極端な量子化条件でも合理的な精度を示す。実験により、推論速度が大幅に向上することが確認された。 Comment
# 概要
- 新たなpost-training量子化手法であるGPTQを提案
- 数時間以内に数千億のパラメータを持つモデルでの実行が可能であり、パラメータごとに3~4ビットまで圧縮するが、精度の大きな損失を伴わない
- OPT-175BおよびBLOOM-176Bを、約4時間のGPU時間で、perplexityのわずかな増加で量子化することができた
- 数千億のパラメータを持つ非常に高精度な言語モデルを3-4ビットに量子化可能なことを初めて示した
- 先行研究のpost-training手法は、8ビット(Yao et al., 2022; Dettmers et al., 2022)。
- 一方、以前のtraining-basedの手法は、1~2桁小さいモデルのみを対象としていた(Wu et al., 2022)。
# Background
## Layer-wise quantization
各linear layerがあるときに、full precisionのoutputを少量のデータセットをネットワークに流したときに、quantized weight W^barを用いてreconstructできるように、squared error lossを最小化する方法。
## Optimal Brain quantization (OBQ)
OBQでは equation (1)をWの行に関するsummationとみなす。そして、それぞれの行 **w** をOBQは独立に扱い、ある一つの重みw_qをquantizeするときに、エラーがw_qのみに基づいていることを補償するために他の**w**の全てのquantizedされていない重みをupdateする。式で表すと下記のようになり、Fは残りのfull-precision weightの集合を表している。
この二つの式を、全ての**w**の重みがquantizedされるまで繰り返し適用する。
つまり、ある一個の重みをquantizedしたことによる誤差を補うように、他のまだquantizedされていない重みをupdateすることで、次に別の重みをquantizedする際は、最初の重みがquantizedされたことを考慮した重みに対してquantizedすることになる。これを繰り返すことで、quantizedしたことによる誤差を考慮して**w**全体をアップデートできる、という気持ちだと思う。
この式は高速に計算することができ、medium sizeのモデル(25M parameters; ResNet-50 modelなど)とかであれば、single GPUで1時間でquantizeできる。しかしながら、OBQはO(d_row * d_col^3)であるため、(ここでd_rowはWの行数、d_colはwの列数)、billions of parametersに適用するには計算量が多すぎる。
# Algorithm
## Step 1: Arbitrary Order Insight.
通常のOBQは、量子化誤差が最も少ない重みを常に選択して、greedyに重みを更新していく。しかし、パラメータ数が大きなモデルになると、重みを任意の順序で量子化したとしてもそれによる影響は小さいと考えられる。なぜなら、おそらく、大きな個別の誤差を持つ量子化された重みの数が少ないと考えられ、その重みがプロセスのが進むにつれて(アップデートされることで?)相殺されるため。
このため、提案手法は、すべての行の重みを同じ順序で量子化することを目指し、これが通常、最終的な二乗誤差が元の解と同じ結果となることを示す。が、このために2つの課題を乗り越えなければならない。
## Step2. Lazy Batch-Updates
Fを更新するときは、各エントリに対してわずかなFLOPを使用して、巨大な行列のすべての要素を更新する必要があります。しかし、このような操作は、現代のGPUの大規模な計算能力を適切に活用することができず、非常に小さいメモリ帯域幅によってボトルネックとなる。
幸いにも、この問題は以下の観察によって解決できる:列iの最終的な四捨五入の決定は、この特定の列で行われた更新にのみ影響され、そのプロセスの時点で後の列への更新は関連がない。これにより、更新を「lazy batch」としてまとめることができ、はるかに効率的なGPUの利用が可能となる。(要は独立して計算できる部分は全部一気に計算してしまって、後で一気にアップデートしますということ)。たとえば、B = 128の列にアルゴリズムを適用し、更新をこれらの列と対応するB × Bブロックの H^-1 に格納する。
この戦略は理論的な計算量を削減しないものの、メモリスループットのボトルネックを改善する。これにより、非常に大きなモデルの場合には実際に1桁以上の高速化が提供される。
## Step 3: Cholesky Reformulation
行列H_F^-1が不定になることがあり、これがアルゴリズムが残りの重みを誤った方向に更新する原因となり、該当する層に対して悪い量子化を実施してしまうことがある。この現象が発生する確率はモデルのサイズとともに増加することが実際に観察された。これを解決するために、コレスキー分解を活用して解決している(詳細はきちんと読んでいない)。
# 実験で用いたCalibration data
GPTQのキャリブレーションデータ全体は、C4データセット(Raffel et al., 2020)からのランダムな2048トークンのセグメント128個で構成される。つまり、ランダムにクロールされたウェブサイトからの抜粋で、一般的なテキストデータを表している。GPTQがタスク固有のデータを一切見ていないため「ゼロショット」な設定でquantizationを実施している。
# Language Generationでの評価
WikiText2に対するPerplexityで評価した結果、先行研究であるRTNを大幅にoutperformした。
From Sparse to Dense: GPT-4 Summarization with Chain of Density Prompting, Griffin Adams+, N_A, arXiv'23
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #NLP Issue Date: 2023-09-17 GPT Summary- 要約は詳細でエンティティ中心的でありながら、理解しやすくすることが困難です。この課題を解決するために、私たちは「密度の連鎖」(CoD)プロンプトを使用して、GPT-4の要約を生成します。CoDによって生成された要約は抽象的であり、リードバイアスが少なく、人間に好まれます。また、情報量と読みやすさのトレードオフが存在することも示されました。CoD要約は無料で利用できます。 Comment
論文中のprompt例。InformativeなEntityのCoverageを増やすようにイテレーションを回し、各Entityに関する情報(前ステップで不足している情報は補足しながら)を具体的に記述するように要約を生成する。
人間が好むEntityのDensityにはある程度の閾値がある模様(でもこれは人や用途によって閾値が違うようねとは思う)。
人手評価とGPT4による5-scale の評価を実施している。定性的な考察としては、主題と直接的に関係ないEntityの詳細を述べるようになっても人間には好まれない(右例)ことが述べられている。
[Paper Note] DoLa: Decoding by Contrasting Layers Improves Factuality in Large Language Models, Yung-Sung Chuang+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #Hallucination #Factuality #KeyPoint Notes Issue Date: 2023-09-13 GPT Summary- LLMの幻覚を抑制するシンプルなデコーディング戦略「DoLa」を提案。後半層と前半層のロジット差を対比させることで、事実知識を明らかにし、誤情報の生成を減少。TruthfulQAでLLaMAモデルの性能を12〜17ポイント向上させ、信頼性の高い事実を生成することを示す。 Comment
【以下、WIP状態の論文を読んでいるため今後内容が変化する可能性あり】
# 概要
Transformer Layerにおいて、factual informationが特定のレイヤーに局所化するという現象を観測しており、それを活用しよりFactual Consistencyのある生成をします、という研究
あるテキストを生成するときの単語の生成確率の分布を可視化。final layer (N=32だと思われる)との間のJensen-shanon Divergence (JSD) で可視化している。が、図を見るとJSDの値域は[0, 1]のはずなのにこれを逸脱しているので一体どういう計算をしているのか。。。
図の説明としては論文中では2つのパターンがあると言及しており
1. 重要な固有表現や日付(Wole Soyinka, 1986など; Factual Knowledgeが必要なもの)は、higher layerでも高い値となっており、higher-layerにおいてpredictionの内容を変えている(重要な情報がここでinjectionされている)
2. 機能語や、questionからの単語のコピー(Nigerian, Nobel Prize など)のような "easy" なtokenは既にmiddle of layersで既にJSDの値が小さく、early layerの時点で出力することが既に決定されている
# 手法概要
ここからの考察としては、重要な事実に関する情報はfinal layerの方で分布が変化する傾向にあり、低layerの方ではそうではないぽいので、final layerと分布が似ているがFactual Informationがまだあまり顕著に生成確率が高くなっていないlayer(pre mature layer)との対比をとることで、生成されるべきFactual Informationがわかるのではないか、という前提の元提案手法が組まれている。手法としては、final layerとのJSDが最大となるようなlayerを一つ選択する、というものになっているが、果たしてこの選択方法で前述の気持ちが実現できているのか?という気は少しする。
[Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #MachineLearning #NLP #SyntheticData #Distillation #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-09-13 GPT Summary- 小型TransformerモデルTinyStoriesから、1.3十億パラメータのphi-1を開発し、教科書品質データ生成を提案。新モデルphi-1.5は、常識的推論に焦点を当て、小学校レベルの数学やコーディング課題で、非最先端LLMを上回る性能を示す。能力には一歩ずつ考えることや初歩的なインコンテキスト学習が含まれ、幻覚や偏見生成も注意が必要だが、ウェブデータの不使用により改善が見られる。phi-1.5はオープンソース化され、さらなる研究を促進。 Comment
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
に続く論文
20Kのトピックから、commonsense reasmning, general knowledge(科学, 日常生活, theory of mlndなど)に関するtext book likeなデータを20B合成して事前学習に活用(どのモデルで合成されたかは明記されていないように見える)
既存のより大規模なモデル(7B--13B)、web dataをフィルタリングしたデータのみで学習したモデル(phi-1.5-web-only)、phi-1でのデータ 7Bに対して上記20Bを追加したデータで学習したモデル(phi-1.5)、フィルタリングしたwebデータ、phi-1のコードデータ、phi-1.5データを40%,20%,40%でmixしたモデル(phi-1.5-web)を比較したところ、phi-1.5の全てのモデル群が.より大きな7B--13B級のモデルを上回った。
web onlyの性能は他二つと比べて悪く、後者二つの性能が高く僅差でphi-1.5-webの性能が良かった。
このことより、
- テキストブックスタイルの合成データは、様々なドメインで有用に働き巨大モデルをSLMで上回れる
- 合成データだけでなくフィルタリングしたwebデータ自体を混ぜるとさらに効果的
という話に見える。
論文のメッセージとは違うかもだが、より現代的な観点を加えると、
- より大規模なモデルから合成したデータによってデータを通じた蒸留が起き、小規模モデルに能力が転移する
という話でもある。
[Paper Note] Simple synthetic data reduces sycophancy in large language models, Jerry Wei+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #Alignment #Supervised-FineTuning (SFT) #Sycophancy #KeyPoint Notes Issue Date: 2023-09-10 GPT Summary- 迎合性は、モデルが客観的に誤った見解にも従う望ましくない挙動である。本研究では、迎合性の蔓延を調査し、合成データ介入による低減策を提案。具体的には、5600億パラメータのPaLMモデルでの迎合性がスケーリングとインストラクション・チューニングによって高まることを確認し、客観的に不正確な命題に対しても同意を示すモデルの傾向を発見。公開NLPタスクを用いてモデルを頑健化し、簡単な合成データによるファインチューニングで迎合的挙動を大幅に減少させる手法を実証。合成データ生成コードは公開されている。 Comment
LLMはユーザの好む回答をするように事前学習されるため、prompt中にユーザの意見が含まれていると、ユーザの意見に引っ張られ仮に不正解でもユーザの好む回答をしてしまう問題があることを示した。また、その対策として人工的にユーザの意見と、claimを独立させるように学習するためのデータセットを生成しFinetuningすることで防ぐことができることを示した。
誤ったユーザの意見を挿入すると、正解できていた問題でも不正解になることを示した。
この傾向は、instruction tuningしている場合、モデルサイズが大きい場合により顕著であることを示した。
openreview: https://openreview.net/forum?id=WDheQxWAo4
Large Language Models Are Human-Level Prompt Engineers, Yongchao Zhou+, ICLR'23
Paper/Blog Link My Issue
#MachineLearning #NLP #Prompting #AutomaticPromptEngineering #ICLR Issue Date: 2023-09-05 GPT Summary- 大規模言語モデル(LLMs)は、自然言語の指示に基づいて一般的な用途のコンピュータとして優れた能力を持っています。しかし、モデルのパフォーマンスは、使用されるプロンプトの品質に大きく依存します。この研究では、自動プロンプトエンジニア(APE)を提案し、LLMによって生成された指示候補のプールから最適な指示を選択するために最適化します。実験結果は、APEが従来のLLMベースラインを上回り、19/24のタスクで人間の生成した指示と同等または優れたパフォーマンスを示しています。APEエンジニアリングされたプロンプトは、モデルの性能を向上させるだけでなく、フューショット学習のパフォーマンスも向上させることができます。詳細は、https://sites.google.com/view/automatic-prompt-engineerをご覧ください。 Comment
プロジェクトサイト: https://sites.google.com/view/automatic-prompt-engineer
openreview: https://openreview.net/forum?id=92gvk82DE-
Algorithm of Thoughts: Enhancing Exploration of Ideas in Large Language Models, Bilgehan Sel+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting Issue Date: 2023-09-04 GPT Summary- 大規模言語モデル(LLMs)の推論能力を向上させるために、新しい戦略「Algorithm of Thoughts」を提案している。この戦略では、LLMsをアルゴリズム的な推論経路に導き、わずか1つまたは数個のクエリでアイデアの探索を拡大する。この手法は、以前の単一クエリ手法を上回り、マルチクエリ戦略と同等の性能を発揮する。また、LLMを指導するアルゴリズムを使用することで、アルゴリズム自体を上回るパフォーマンスが得られる可能性があり、LLMが最適化された検索に自己の直感を織り込む能力を持っていることを示唆している。
[Paper Note] A Survey on Large Language Model based Autonomous Agents, Lei Wang+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#Survey #NLP #AIAgents #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-09-01 GPT Summary- LLMを活用した自律エージェントの研究を体系的に整理し、構築方法や応用例、評価戦略を概説。人間の学習に近づくための課題と今後の方向性を示す。関連文献のリポジトリも提供。 Comment
Fig1の時系列での論文数と代表的な研究のリストアップとエージェントの質の変遷、Table1のモデルの分類表など非常に分かりやすい。
[Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#MachineLearning #NLP #DataAugmentation #Supervised-FineTuning (SFT) #AIAgents #SyntheticData #EMNLP #PostTraining #Selected Papers/Blogs #System Demonstration #KeyPoint Notes #Author Thread-Post Issue Date: 2023-08-28 GPT Summary- Prompt2Modelは、LLMによるプロンプトを用いて特定用途モデルを訓練する方法を提案。既存データセットの検索とLLMを使ったデータ生成により、強力なモデルを得られる。提示したプロンプトで、gpt-3.5-turboの結果を約20%上回り、最大700倍小型化できる。モデルの性能を信頼性高く推定可能で、オープンソースとして公開。 Comment
Dataset Generatorによって、アノテーションが存在しないデータについても擬似ラベル付きデータを生成することができ、かつそれを既存のラベル付きデータと組み合わせることによってさらに性能が向上することが報告されている。これができるのはとても素晴らしい。
Dataset Generatorについては、データを作成する際に低コストで、高品質で、多様なデータとするためにいくつかの工夫を実施している。
1. ユーザが与えたデモンストレーションだけでなく、システムが生成したexampleもサンプリングして活用することで、生成されるexampleの多様性を向上させる。実際、これをやらない場合は120/200がduplicate exampleであったが、これが25/200まで減少した。
2. 生成したサンプルの数に比例して、temperatureを徐々に高くしていく。これにより、サンプルの質を担保しつつ、多様性を徐々に増加させることができる。Temperature Annealingと呼ぶ。
3. self-consistencyを用いて、擬似ラベルの質を高める。もしmajority votingが互角の場合は、回答が短いものを採用した(これはヒューリスティックに基づいている)
4. zeno buildを用いてAPIへのリクエストを並列化することで高速に実験を実施
非常に参考になる。
著者らによる現在の視点での振り返り(提案当時はAI Agentsという概念はまだなく、本研究はその先取りと言える):
[Paper Note] Large Language Models Sensitivity to The Order of Options in Multiple-Choice Questions, Pouya Pezeshkpour+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #Evaluation #Bias #NAACL #read-later #Selected Papers/Blogs #Findings #One-Line Notes #Reading Reflections #needs-revision Issue Date: 2023-08-28 GPT Summary- 多肢選択問題におけるLLMsの性能は選択肢の順序に敏感であり、配置を変えることで最大75%の性能差が見られる。特に、上位選択肢間の不確実性がこの感度を引き起こし、バイアスが影響することを示唆する。最適な配置は、バイアスを増幅させるためにトップ選択肢を両端に置くこと、緩和するためには隣接させることが推奨される。実験を通じて、予測のキャリブレーションにより最大8ポイントの改善が達成された。 Comment
これはそうだろうなと思っていたけど、ここまで性能に差が出るとは思わなかった。
これがもしLLMのバイアスによるもの(2番目の選択肢に正解が多い)の場合、
ランダムにソートしたり、平均取ったりしても、そもそもの正解に常にバイアスがかかっているので、
結局バイアスがかかった結果しか出ないのでは、と思ってしまう。
そうなると、有効なのはone vs. restみたいに、全部該当選択肢に対してyes/noで答えさせてそれを集約させる、みたいなアプローチの方が良いかもしれない。
AgentBench: Evaluating LLMs as Agents, Xiao Liu+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #AIAgents #Evaluation #One-Line Notes Issue Date: 2023-08-27 GPT Summary- 本研究では、大規模言語モデル(LLMs)をエージェントとして評価するための多次元の進化するベンチマーク「AgentBench」を提案しています。AgentBenchは、8つの異なる環境でマルチターンのオープンエンドの生成設定を提供し、LLMの推論と意思決定能力を評価します。25のLLMsに対するテストでは、商用LLMsは強力な能力を示していますが、オープンソースの競合他社との性能には差があります。AgentBenchのデータセット、環境、および評価パッケージは、GitHubで公開されています。 Comment
エージェントとしてのLLMの推論能力と意思決定能力を評価するためのベンチマークを提案。
トップの商用LLMとOpenSource LLMの間に大きな性能差があることを示した。
Large Language Model Guided Tree-of-Thought, Jieyi Long, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Prompting Issue Date: 2023-08-22 GPT Summary- この論文では、Tree-of-Thought(ToT)フレームワークを紹介し、自己回帰型の大規模言語モデル(LLM)の問題解決能力を向上させる新しいアプローチを提案しています。ToTは、人間の思考方法に触発された技術であり、複雑な推論タスクを解決するためにツリー状の思考プロセスを使用します。提案手法は、LLMにプロンプターエージェント、チェッカーモジュール、メモリモジュール、およびToTコントローラーなどの追加モジュールを組み込むことで実現されます。実験結果は、ToTフレームワークがSudokuパズルの解決成功率を大幅に向上させることを示しています。
Decomposition Enhances Reasoning via Self-Evaluation Guided Decoding, Yuxi Xie+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Prompting Issue Date: 2023-08-22 GPT Summary- 私たちは、大規模言語モデル(LLMs)を使用して、推論の品質と多様性を向上させるための効果的なプロンプティングアプローチを提案しました。自己評価によるガイド付き確率的ビームサーチを使用して、GSM8K、AQuA、およびStrategyQAのベンチマークで高い精度を達成しました。また、論理の失敗を特定し、一貫性と堅牢性を向上させることもできました。詳細なコードはGitHubで公開されています。
Consciousness in Artificial Intelligence: Insights from the Science of Consciousness, Patrick Butlin+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP Issue Date: 2023-08-22 GPT Summary- AIの意識についての厳密なアプローチを提案し、既存のAIシステムを神経科学的な意識理論に基づいて評価する。意識の指標的特性を導き出し、最近のAIシステムを評価することで、現在のAIシステムは意識的ではないが、意識的なAIシステムを構築するための障壁は存在しないことを示唆する。
Self-Alignment with Instruction Backtranslation, Xian Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #InstructionTuning #KeyPoint Notes Issue Date: 2023-08-21 GPT Summary- 私たちは、高品質な指示に従う言語モデルを構築するためのスケーラブルな手法を提案します。この手法では、少量のシードデータとウェブコーパスを使用して言語モデルをファインチューニングし、指示のプロンプトを生成してトレーニング例を構築します。そして、高品質な例を選択してモデルを強化します。この手法を使用すると、他のモデルよりも優れた性能を発揮し、自己整列の効果を実証できます。 Comment
人間が書いたテキストを対応するinstructionに自動的にラベル付けする手法を提案。
これにより高品質なinstruction following LLMの構築が可能
手法概要
結果的に得られるデータは、訓練において非常にインパクトがあり高品質なものとなる。
実際に、他の同サイズのinstruct tuningデータセットを上回る。
Humpackは他のstrong modelからdistillされていないモデルの中で最高性能を達成。これは、スケールアップしたり、より強いベースモデルを使うなどさらなる性能向上ができる余地が残されている。
参考:
指示を予測するモデルは、今回はLLaMAをfinetuningしたモデルを用いており、予測と呼称しているが指示はgenerationされる。
Teach LLMs to Personalize -- An Approach inspired by Writing Education, Cheng Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #PersonalizedGeneration #One-Line Notes Issue Date: 2023-08-18 GPT Summary- 個別化されたテキスト生成において、大規模言語モデル(LLMs)を使用した一般的なアプローチを提案する。教育の執筆をベースに、多段階かつマルチタスクのフレームワークを開発し、検索、ランキング、要約、統合、生成のステージで構成される個別化されたテキスト生成へのアプローチを採用する。さらに、マルチタスク設定を導入してモデルの生成能力を向上させる。3つの公開データセットでの評価結果は、他のベースラインに比べて大幅な改善を示している。 Comment
研究の目的としては、ユーザが現在執筆しているdocumentのwriting支援
Crosslingual Generalization through Multitask Finetuning, Niklas Muennighoff+, N_A, ACL'23
Paper/Blog Link My Issue
#MultitaskLearning #Zero/Few/ManyShotPrompting #Supervised-FineTuning (SFT) #CrossLingual #ACL #PostTraining #Generalization #One-Line Notes Issue Date: 2023-08-16 GPT Summary- マルチタスクプロンプトフィネチューニング(MTF)は、大規模な言語モデルが新しいタスクに汎化するのに役立つことが示されています。この研究では、マルチリンガルBLOOMとmT5モデルを使用してMTFを実施し、英語のプロンプトを使用して英語および非英語のタスクにフィネチューニングすることで、タスクの汎化が可能であることを示しました。さらに、機械翻訳されたプロンプトを使用してマルチリンガルなタスクにフィネチューニングすることも調査し、モデルのゼロショットの汎化能力を示しました。また、46言語の教師ありデータセットのコンポジットであるxP3も紹介されています。 Comment
英語タスクを英語でpromptingしてLLMをFinetuningすると、他の言語(ただし、事前学習で利用したコーパスに出現する言語に限る)で汎化し性能が向上することを示した模様。

[Paper Note] GPTScore: Evaluate as You Desire, Jinlan Fu+, arXiv'23, 2023.02
Paper/Blog Link My Issue
#DocumentSummarization #NLP #Evaluation #LLM-as-a-Judge #One-Line Notes Issue Date: 2023-08-13 GPT Summary- 大規模事前学習モデルを用いて生成物の品質を評価する新しいフレームワークGPTScoreを提案。GPTScoreは生成型AIの新能力を利用し、19種類のモデルと4つのテキスト生成タスクに対する評価を実施。これにより、注釈なしで多面的なカスタマイズ評価を可能にし、テキスト評価の課題を克服する手段を提供。コードはGitHubで公開中。 Comment
BERTScoreと同様、評価したいテキストの対数尤度で評価している
BERTScoreよりも相関が高く、instructionによって性能が向上することが示されている
[Paper Note] Shepherd: A Critic for Language Model Generation, Tianlu Wang+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #SmallModel #Critic Issue Date: 2023-08-12 GPT Summary- LLMを活用し、応答を批評して改良案を提案するモデルShepherdを紹介。高品質なフィードバックデータセットを基に、多様な誤りを特定し修正提案を行う。小型(7Bパラメータ)ながら、ChatGPTと同等または好まれる性能を発揮し、GPT-4評価で53〜87%の勝率を達成。人間評価でも他モデルを超え、ChatGPTとほぼ同等の実力を示す。
[Paper Note] Metacognitive Prompting Improves Understanding in Large Language Models, Yuqing Wang+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #Prompting #NAACL Issue Date: 2023-08-12 GPT Summary- メタ認知的プロンプティング(MP)を導入し、LLMsの論理推論を向上させる新しい戦略を提示。MPにより、広範な知識を引き出す自己評価プロセスを実施。主要なLLMs(Llama2、PaLM2、GPT-3.5、GPT-4)を用いた実験で、GPT-4が全タスクで優れた性能を示し、他モデルもMPによって著しい進歩を達成。また、MPは既存のプロンプティング手法を一貫して上回り、LLMsの理解能力向上の可能性を示唆している。 Comment
CoTより一貫して性能が高いので次のデファクトになる可能性あり
[Paper Note] SelfCheck: Using LLMs to Zero-Shot Check Their Own Step-by-Step Reasoning, Ning Miao+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #Reasoning #SelfCorrection #ICLR #Test-Time Scaling #Verification #SelfVerification Issue Date: 2023-08-08 GPT Summary- LLMの段階的推論能力を活用し、自己検証(SelfCheck)を提案してLLM自身が誤りを認識することを目指す。誤りの認識にはゼロショット検証スキームを用い、その結果を基に重み付き投票で回答性能を向上。GSM8K、MathQA、MATHデータセットで評価し、誤り認識の効果と正確性向上を確認。 Comment
これはおもしろそう。後で読む
OpenReview: https://openreview.net/forum?id=pTHfApDakA
[Paper Note] The Hydra Effect: Emergent Self-repair in Language Model Computations, Thomas McGrath+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #Attention #One-Line Notes Issue Date: 2023-08-08 GPT Summary- 因果分析により言語モデルの内部構造を調査し、二つの主要なモチーフを提案する。第一に、一つのアテンション層のアブレーションが別の層の補償的な機能を引き起こす「Hydra効果」、第二に、後段のMLP層が最大尤度トークンを抑制する対抗機能である。アブレーション研究では、層間の結合が緩やかであり、アブレーションの影響がごく一部に留まることを示し、ドロップアウトなしでも効果が見られることを発見した。これらの効果を事実の想起の文脈で分析し、回路レベルの帰属への影響を考察する。 Comment
LLMからattention layerを一つ取り除くと、後続の層が取り除かれたlayerの機能を引き継ぐような働きをすることがわかった。これはLLMの自己修復機能のようなものであり、HydraEffectと命名された。
[Paper Note] MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework, Sirui Hong+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #AIAgents #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-08-08 GPT Summary- MetaGPTは、LLMベースのマルチエージェントシステムに人間のワークフローを統合し、複雑なタスクを小さなサブタスクに効率的に分解するメタプログラミングフレームワークです。これにより、中間結果の検証が可能になり、誤りを減少させます。また、共同ソフトウェアエンジニアリングのタスクにおいて、従来のシステムよりも一貫性のある解決策を提供します。プロジェクトはGitHubで公開されています。 Comment
要はBabyTalk, AutoGPTの進化系で、人間のワークフローを模倣するようにデザインしたら良くなりました、という話と思われる
ソフトウェアエンジニア、アーキテクト、プロダクトオーナー、プロジェクトマネージャーなどのロールを明示的に与えて、ゴールを目指す。もはやLLM内部でソフトウェア企業を模倣しているのと同様である。
openreview: https://openreview.net/forum?id=VtmBAGCN7o
[Paper Note] Skeleton-of-Thought: Prompting LLMs for Efficient Parallel Generation, Xuefei Ning+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #ICLR #Decoding #One-Line Notes #Parallel Issue Date: 2023-08-08 GPT Summary- 本研究は、巨大言語モデル(LLMs)の生成遅延を低減するため、Skeleton-of-Thought(SoT)を提案。SoTは、まず回答のスケルトンを生成し、次に並列デコードを実行して内容を完成。12種のLLMでスピードアップと回答品質向上を実現。データ中心の最適化による効率的な推論を目指す。 Comment
最初に回答の枠組みだけ生成して、それぞれの内容を並列で出力させることでデコーディングを高速化しましょう、という話。
openreview: https://openreview.net/forum?id=mqVgBbNCm9
[Paper Note] ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs, Yujia Qin+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Tools #NLP #Dataset #AIAgents #SyntheticData #API #ICLR #One-Line Notes #ToolUse Issue Date: 2023-08-08 GPT Summary- オープンソースのLLMにおけるツール使用能力の限界を克服するため、ToolLLMフレームワークを提案。ToolBenchデータセットを用いて、ChatGPTに指示を与え実世界のAPIを収集し、多様なシナリオをカバー。新しい探索手法DFSDTを開発することで、LLMsの推論能力を高め、ToolLLaMAが複雑な指示を効果的に実行できることを示した。ToolEvalにより評価を行い、ToolLLaMAはChatGPTと同等の性能を発揮する。さらに、適切なAPIを推奨するニューラルAPIリトリーバーを導入し、手動の選択を不要にした。 Comment
16000のreal worldのAPIとインタラクションし、データの準備、訓練、評価などを一貫してできるようにしたフレームワーク。LLaMAを使った場合、ツール利用に関してturbo-16kと同等の性能に達したと主張。
openreview: https://openreview.net/forum?id=dHng2O0Jjr
[Paper Note] Open Problems and Fundamental Limitations of Reinforcement Learning from Human Feedback, Stephen Casper+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Survey #ReinforcementLearning Issue Date: 2023-08-08 GPT Summary- RLHFはAIを人間の目標に合わせるための技術で、LLMsの微調整に重要。しかし、欠陥の体系的研究は少ない。本論文では、RLHFの未解決問題と限界を調査し、理解・改善手法を概説、社会的監視のための基準を提案。研究は、RLHFの限界を強調し、安全なAI開発には多面的アプローチが必要であることを示す。
[Paper Note] Aligning Large Language Models with Human: A Survey, Yufei Wang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Survey #NLP #Alignment #PostTraining #One-Line Notes Issue Date: 2023-08-08 GPT Summary- LLMsはNLPタスクにおいて重要な解決策として台頭しているが、人間の指示を誤解したり、偏った情報を生成するリスクがある。本調査は、LLMsを人間の期待に整合させるための技術を総括し、データ収集方法、学習手法のレビュー、モデル評価方法について詳述する。結論として、人間指向のタスクに適合させるためのLLMsの整合性を深化させる有用な資源にし、関連のGitHubリンクも提供する。 Comment
LLMのAlignment手法に関するSurvey
[Paper Note] LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition, Chengsong Huang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#MachineLearning #NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #COLM #PostTraining #KeyPoint Notes Issue Date: 2023-08-08 GPT Summary- LoraHubは、タスク間一般化のためにLoRAモジュールを柔軟に組み合わせるフレームワークであり、新しいタスクに対して少数の例から適応可能な性能を目指す。これにより、追加のパラメータや勾配なしに複数のLoRAモジュールを統合でき、推論時のトークン数を削減し、効率性と性能のトレードオフを実現。Big-Bench Hardベンチマークでの結果は、LoraHubが高い上限を示し、ユーザーがLoRAモジュールを容易に共有できるプラットフォームの構築を目指している。 Comment
学習されたLoRAのパラメータをモジュールとして捉え、新たなタスクのinputが与えられた時に、LoRA Hub上の適切なモジュールをLLMに組み合わせることで、ICL無しで汎化を実現するというアイデア。few shotのexampleを人間が設計する必要なく、同等の性能を達成。
複数のLoRAモジュールは組み合わられるか?element wiseの線型結合で今回はやっているが、その疑問にこたえたのがcontribution
OpenReview: https://openreview.net/forum?id=TrloAXEJ2B
[Paper Note] L-Eval: Instituting Standardized Evaluation for Long Context Language Models, Chenxin An+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #One-Line Notes Issue Date: 2023-08-08 GPT Summary- L-Evalを提案し、長い文脈を扱う言語モデル(LCLMs)の評価指標とデータセットを標準化。508の長文ドキュメントと2,000以上の人間ラベル付けされたクエリ・応答ペアを含む評価スイートを構築。n-gramマッチング指標の限界を指摘し、長さ指示を強化した評価を推奨。商用およびオープンソースモデルの包括的な研究を通じて、LCLMsの評価の基盤を提供。 Comment
long contextに対するLLMの評価セット。411のlong documentに対する2kのquery-response pairのデータが存在。法律、fainance, school lectures, 長文対話、小説、ミーティングなどのドメインから成る。
[Paper Note] Do Multilingual Language Models Think Better in English?, Julen Etxaniz+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #Prompting Issue Date: 2023-08-07 GPT Summary- self-translateは、多言語モデルの少数ショット翻訳能力を活用し、外部翻訳システムを不要にする新しいアプローチを提案。5つのタスクにおける実験結果は、直接推論において一貫して優位性を示し、非英語プロンプト時に多言語ポテンシャルの非活用を確認できる。 Comment
参考:
[Paper Note] LLM-Rec: Personalized Recommendation via Prompting Large Language Models, Hanjia Lyu+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#RecommenderSystems #Prompting #NAACL #Findings #One-Line Notes Issue Date: 2023-08-02 GPT Summary- テキストベースのレコメンデーションは汎用性が高いが、元のアイテム説明だけではユーザー嗜好との整合性が不足することがある。大規模言語モデル(LLMs)の進歩を活かし、4つのテキスト強化プロンプト戦略を取り入れたアプローチ、LLM-Recを提案。実験により、LLM拡張テキストの使用が推奨品質を向上させることが確かめられ、基本的なMLPモデルでも高い成果を上げることが示された。成功の要因はプロンプト戦略であり、多様な技術がLLMsの推奨効果を高める重要性を示している。 Comment
LLMのpromptingの方法を変更しcontent descriptionだけでなく、様々なコンテキストの追加(e.g. このdescriptionを推薦するならどういう人におすすめ?、アイテム間の共通項を見つける)、内容の拡張等を行いコンテントを拡張して活用するという話っぽい。
[Paper Note] FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance, Lingjiao Chen+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #TMLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-07-26 GPT Summary- LLMの料金体系は多様で、大量利用時に高コストになる可能性がある。推論コストを削減するため、プロンプト適応、LLM近似、LLMカスケードの3つの戦略を提案。FrugalGPTを用いて、異なるクエリに最適なLLMsの組み合わせを学習し、最高で98%のコスト削減や4%の精度向上を実現する実験結果を示した。これにより、LLMの持続可能かつ効率的な活用の基盤が提供される。 Comment
限られた予算の中で、いかに複数のLLM APIを使い、安いコストで高い性能を達成するかを追求した研究。
LLM Cascadeなどはこの枠組みでなくても色々と使い道がありそう。Question Concatenationは実質Batch Prompting。
openreview: https://openreview.net/forum?id=cSimKw5p6R
[Paper Note] Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Lianmin Zheng+, NeurIPS'23, 2023.06
Paper/Blog Link My Issue
#NLP #Evaluation #LLM-as-a-Judge #NeurIPS #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-07-26 GPT Summary- LLMを審査員として用いて、チャットアシスタントの評価の新たな方法を探求。役割やバイアスの利点と限界を検討し、MT-benchとChatbot Arenaのベンチマークで人間の好みとの一致率が80%以上に達することを確認。LLMを用いることでスケーラブルかつ説明可能な評価手法を提供し、専門家の投票や会話データも公開。 Comment
MT-Bench(MTBench)スコアとは、multi-turnのQAを出題し、その回答の質をGPT-4でスコアリングしたスコアのこと。
GPT-4の判断とhuman expertの判断とのagreementも検証しており、agreementは80%以上を達成している。
`LLM-as-a-Judge` という用語を最初に提唱したのも本研究となる(p.2参照)
[Paper Note] Batch Prompting: Efficient Inference with Large Language Model APIs, Zhoujun Cheng+, arXiv'23, 2023.01
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #Prompting #EMNLP #Selected Papers/Blogs #Batch #KeyPoint Notes #IndustryTrack Issue Date: 2023-07-24 GPT Summary- 大規模言語モデル(LLM)を使ったバッチプロンプティングにより、サンプルをバッチ単位で推論し、トークンコストと推論時間を削減。few-shot in-context learningで、コストはバッチ内サンプル数に反比例して低下。100のデータセットでの検証では、最大5倍のコスト削減を実現し、性能は向上または維持。GPT-3.5やGPT-4でも効果を確認し、タスクの複雑さが性能に影響を与えることを示唆。バッチプロンプティングは他の推論手法にも適用可能。 Comment
10種類のデータセットで試した結果、バッチにしても性能は上がったり下がったりしている。著者らは類似した性能が出ているので、コスト削減になると結論づけている。
Batch sizeが大きくなるに連れて性能が低下し、かつタスクの難易度が高いとパフォーマンスの低下が著しいことが報告されている。また、contextが長ければ長いほど、バッチサイズを大きくした際のパフォーマンスの低下が著しい。
[Paper Note] Scaling Autoregressive Multi-Modal Models: Pretraining and Instruction Tuning, Lili Yu+, arXiv'23
Paper/Blog Link My Issue
#ComputerVision #NLP #FoundationModel Issue Date: 2023-07-23 GPT Summary- CM3Leonは、テキストと画像の生成・補完が可能なマルチモーダル言語モデルで、リトリーバル拡張型のトークンベースのデコーダを使用。CM3アーキテクチャを基に、多様な指示スタイルでのスケーリングとチューニングに優れ、初のテキスト専用モデルから適応されたマルチモーダルモデル。高品質な出力を生成する対照的デコーディング手法を導入し、少ない計算量で最先端の性能を達成。SFT後は、画像編集や生成において高い制御性を示す。
[Paper Note] Can Large Language Models Be an Alternative to Human Evaluations?, Cheng-Han Chiang+, ACL'23, 2023.05
Paper/Blog Link My Issue
#Analysis #ChatGPT #Evaluation #LLM-as-a-Judge #Attack #ACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- 人間評価の再現性が低いため、NLPモデル間の公正な比較が難しい。そこで、大規模言語モデル(LLM)を人間評価の代替手段として利用することを探求。本研究では、LLMに同一指示とサンプルを与え、評価を実施するLLM評価を提案。オープンエンドのストーリー生成や敵対的攻撃のタスクに対する評価結果は、人間専門家の評価と高い一致を示し、評価の安定性も確認。LLMを用いたテキスト評価の可能性やその限界、倫理的課題についても考察。 Comment
LLMがテキストの品質評価において、人間による評価者の代替となりうるか?という疑問を初めて実験的に示した研究で、インパクトが大きく重要論文と判断。ただし、実験のスコープは物語生成と敵対的生成(テキスト分類器を騙すような摂動を加える)の2タスクである点、には注意。
ChatGPT(おそらくGPT-3.5)が人間の評価者(3人のEnglish teacher)とopen-endで生成された物語にたいして、以下の4つの観点に関してratingの平均で見た時に同様の傾向のスコアを付与することを実験的に明らかにした:
- Grammaticality [^1]: テキストの文法の正しさ
- Cohesiveness: テキストの一貫性
- Likeability: テキストが読んでいて楽しいか
- Relevance: promptに対してどれだけ適切なテキストが生成されているか
ただし、T0やtext-curie-001 においてはこのような傾向は見受けられなかった。[^2]
また、ChatGPTによる説明とratingを人間の評価者に対してblindで提示したところ、人間が見ても妥当な判断だと認知された。
全体の傾向としてではなく、個別のratingがどの程度同じような傾向を示すか(i.e., 人間があるstoryを高くratingしたら、LLMも高くratingするか?)をケンドールの順位相関係数で分析(200サンプルに対して3人の英語教員のスコアの平均, text-davinciによる3回の独立したratingを実施した平均スコアを用いて計算)したところ、4つの観点のうち全てにおいて正の相関が見受けられた(Table2, p-valueは<0.05で統計的に有意)。が、Relevanceのみが強い相関を示し、他の指標については弱い相関にとどまっている。しかし、Table6に示されている通り、2人の英語の先生同士で個別のjudgeに感して同様にケンドールの順位相関係数を測定しても、人間-LLM間と同様の傾向が見受けられる。すなわち、Relevanceのみが強い相関で他は弱い相関。このことから、人間同士でも個別のサンプルに対する判断は一致しない(=主観的なタスク)ということは留意する必要がある。
敵対的生成に関する実験については、Synonym Substitution Attack (SSAs; 良性のサンプルを同義語で置換する手法で、全体的な意味は保たれるため一般的な人間は正しく認知してしまうが、実際には文法がおかしくなったり不自然になったり、意味が変わってしまうことが先行研究によって知られているようなものらしい)によって実験。Fluency / Meaning Preservingの2つの指標で英語教員とLLMによる評価を比較した結果、人間は正しくadversarialなサンプルと良性なサンプルを区別できており、ChatGPT(おそらくGPT-3.5)も区別ができている(Table4)。ただし、人間のスコアと比較するとChatGPTは高めのスコアを出す傾向がある点には注意ではあるものの、良性サンプル > 敵対的サンプル という序列の判断に関しては人間と同様の傾向を示していることが示唆された。
[^1]: ただし、LLMはpunctuationのミスを文法エラーと判断するが、一人の英語の先生は文法エラーとしてみなさないなどの現象も観察され、人間は独自の評価criteriaを保持していることも窺える
[^2]: (感想)ある程度能力の高いLLMかRLHFなどを用いて人間の好みに対してalignmentがとられていないとうまくいかないのかもしれない
本研究は非常に初期の研究であり、現在のfrontierモデル群(特にreasoningモデル)を用いた場合にはどの程度改善しているか?という点は気になる。
[Paper Note] Retentive Network: A Successor to Transformer for Large Language Models, Yutao Sun+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#MachineLearning Issue Date: 2023-07-22 GPT Summary- Retentive Network (RetNet)を提案し、訓練の並列性、低コスト推論、高性能を実現。再帰とアテンションの関係を理論的に導出し、保持機構を導入。並列表現で訓練の効率化、再帰表現でO(1)推論を実現し、長大なシーケンスを線形計算量でモデリング。実験結果により、RetNetがトランスフォーマーの後継としての可能性を示す。コードは公開予定。 Comment
参考:
[Paper Note] Llama 2: Open Foundation and Fine-Tuned Chat Models, Hugo Touvron+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #FoundationModel #OpenWeight #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- Llama 2という7億から700億パラメータの範囲の大規模言語モデルを開発・公開。対話に最適化されたファインチューニング済みモデルLlama 2-Chatは、多くのベンチマークでオープンソースモデルを上回り、人間による評価でもクローズドソースモデルの代替となる可能性を示す。ファインチューニングと安全性向上のアプローチを詳細に説明し、コミュニティへの貢献を促進。 Comment
参考:
Llama, およびLlama2では、一般的なTransformer Decoderとは異なり、linear layerの”前に”RMSPropをかませている点が異なる。
また、Llama2では、Llamaと比較して
- Group Query Attentionの利用 [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
- 活性化関数として、ReLUではなく、SwiGLU [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
の活用
- Positional Embeddingとして、RoPE [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
の活用
- より長いContext Windowsでの学習(4k)
を実施している。
出典:
https://cameronrwolfe.substack.com/p/llama-2-from-the-ground-up
[Paper Note] Challenges and Applications of Large Language Models, Jean Kaddour+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Tutorial #Survey #NLP #One-Line Notes Issue Date: 2023-07-22 GPT Summary- 大規模言語モデル(LLM)の急速な普及に伴い、課題や適用領域の特定が困難になっている。本論文は、ML研究者が現状を迅速に把握し生産的になるために、未解決の問題と成功事例の体系的な集合を提供することを目指す。 Comment
LLMのここ数年の進化早すぎわろたでキャッチアップむずいので、未解決の課題や、すでに良い感じのアプリケーションの分野分かりづらいので、まとめました論文
Towards A Unified Agent with Foundation Models, Norman Di Palo+, N_A, arXiv'23
Paper/Blog Link My Issue
#ComputerVision #NLP #AIAgents Issue Date: 2023-07-22 GPT Summary- 本研究では、言語モデルとビジョン言語モデルを強化学習エージェントに組み込み、効率的な探索や経験データの再利用などの課題に取り組む方法を調査しました。スパースな報酬のロボット操作環境でのテストにおいて、ベースラインに比べて大幅な性能向上を実証し、学習済みのスキルを新しいタスクの解決や人間の専門家のビデオの模倣に活用する方法を示しました。
LLMs as Workers in Human-Computational Algorithms? Replicating Crowdsourcing Pipelines with LLMs, Tongshuang Wu+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Annotation Issue Date: 2023-07-22 GPT Summary- 大規模言語モデル(LLMs)は、クラウドソーシングタスクにおいて人間のような振る舞いを再現できる可能性がある。しかし、現在の取り組みは単純なタスクに焦点を当てており、より複雑なパイプラインを再現できるかどうかは不明である。LLMsの成功は、リクエスターの理解力やサブタスクのスキルに影響を受ける。人間とLLMsのトレーニングの組み合わせにより、クラウドソーシングパイプラインの再現が可能であり、LLMsは一部のタスクを完了させながら、他のタスクを人間に任せることができる。
Instruction-following Evaluation through Verbalizer Manipulation, Shiyang Li+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #InstructionTuning #Evaluation Issue Date: 2023-07-22 GPT Summary- 本研究では、指示に従う能力を正確に評価するための新しい評価プロトコル「verbalizer manipulation」を提案しています。このプロトコルでは、モデルに異なる程度で一致する言葉を使用してタスクラベルを表現させ、モデルの事前知識に依存する能力を検証します。さまざまなモデルを9つのデータセットで評価し、異なるverbalizerのパフォーマンスによって指示に従う能力が明確に区別されることを示しました。最も困難なverbalizerに対しても、最も強力なモデルでもランダムな推測よりも優れたパフォーマンスを発揮するのは困難であり、指示に従う能力を向上させるために継続的な進歩が必要であることを強調しています。
[Paper Note] Meta-Transformer: A Unified Framework for Multimodal Learning, Yiyuan Zhang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #SpeechProcessing #One-Line Notes Issue Date: 2023-07-22 GPT Summary- Meta-Transformerは、ペアのマルチモーダルトレーニングデータを用いず、複数のモダリティを統一的に学習する新しいフレームワークです。共有トークンスペースでの生データマッピングと凍結されたエンコーダによる高レベル特徴抽出を実現し、テキストや画像など多様なモダリティ間での知覚を可能にします。実験結果は、様々なベンチマークにおいて広範囲なタスクへの対応が確認され、マルチモーダルインテリジェンスの発展に寄与する可能性を示しています。 Comment
12種類のモダリティに対して学習できるTransformerを提案
Dataをsequenceにtokenizeし、unifiedにfeatureをencodingし、それぞれのdownstreamタスクで学習
[Paper Note] FLASK: Fine-grained Language Model Evaluation based on Alignment Skill Sets, Seonghyeon Ye+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #Dataset #Evaluation #Initial Impression Notes Issue Date: 2023-07-22 GPT Summary- 大規模言語モデル(LLMs)の評価は、人間の価値観との整合性が求められるが、従来の評価は粗粒度で解釈性が制限されている。本研究では、整合スキルセットに基づく微細粒度評価プロトコルFLASKを提案し、スコアを指示ごとのスキルセットに分解する手法を導入。実験により、評価の細粒度化がモデルパフォーマンスの理解と信頼性向上に寄与することを示し、複数のLLMsにおいて高い相関を観察した。評価データとコードは公開されている。 Comment
このベンチによるとLLaMA2でさえ、商用のLLMに比べると能力はかなり劣っているように見える。
Socratic Questioning of Novice Debuggers: A Benchmark Dataset and Preliminary Evaluations, ACL-BEA'23
Paper/Blog Link My Issue
#NLP #Dataset #Coding #ACL #Workshop Issue Date: 2023-07-18 GPT Summary- 本研究では、初心者プログラマがバグのある計算問題を解決する際に、ソクラテス的な対話を行うデータセットを紹介し、GPTベースの言語モデルのデバッグ能力を評価しました。GPT-4はGPT-3.5よりも優れたパフォーマンスを示しましたが、まだ人間の専門家には及ばず、さらなる研究が必要です。
Teaching Small Language Models to Reason, ACL'23
Paper/Blog Link My Issue
#NLP #Chain-of-Thought #Distillation #ACL Issue Date: 2023-07-18 GPT Summary- 本研究では、大規模な言語モデルの推論能力を小さなモデルに転送するための知識蒸留を探求しました。具体的には、大きな教師モデルによって生成された出力を用いて学生モデルを微調整し、算術、常識、象徴的な推論のタスクでのパフォーマンスを向上させることを示しました。例えば、T5 XXLの正解率は、PaLM 540BとGPT-3 175Bで生成された出力を微調整することで、それぞれ8.11%から21.99%および18.42%に向上しました。
Reasoning with Language Model Prompting: A Survey, ACL'23
Paper/Blog Link My Issue
#Survey #NLP #Prompting #Reasoning #ACL Issue Date: 2023-07-18 GPT Summary- 本論文では、推論に関する最新の研究について包括的な調査を行い、初心者を支援するためのリソースを提供します。また、推論能力の要因や将来の研究方向についても議論します。リソースは定期的に更新されています。