
PostTraining (548) — 3/3
[Paper Note] Zephyr: Direct Distillation of LM Alignment, Lewis Tunstall+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #SyntheticData #COLM #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-10-28 GPT Summary- ユーザーの意図に応じた小型言語モデルを目指し、dSFTに基づくモデルの整合性向上を図る。AIフィードバックからの選好データを用い、dDPOを適用することで、意図の整合性が向上したチャットモデルを学習。追加サンプリングなしで数時間の訓練で最先端のZephyr-7Bを実現し、MT-BenchでLlama2-Chat-70Bを上回る成果を達成。コードやデータは公開。 Comment
7BパラメータでLlaMa70Bと同等の性能を達成したZephyrの論文。
- dSFT:既存データからpromptをサンプリングし、user,assistantのmulti turnの対話をLLMでシミュレーションしてデータ生成しSFT
- AIF:既存データからpromstをサンプリングし、異なる4つのLLMのレスポンスをGPT4でランクづけしたデータの活用
- dDPO: 既存データからpromptをサンプリングし、ベストなレスポンスとランダムにサンプリングしたレスポンスの活用
人手を一切介していない。
Blog: https://huggingface.co/blog/Isamu136/understanding-zephyr
openreview: https://openreview.net/forum?id=aKkAwZB6JV
[Paper Note] NEFTune: Noisy Embeddings Improve Instruction Finetuning, Neel Jain+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #ICLR #read-later #Initial Impression Notes Issue Date: 2023-10-26 GPT Summary- 単純なデータ拡張により、言語モデルのファインチューニングが改善されることを示す。NEFTuneは埋め込みベクトルにノイズを追加し、LLaMA-2-7Bのファインチューニングで29.79%から64.69%へ劇的な向上を実現。現代の指示データセットでも改善をもたらし、Evol-Instruct、ShareGPT、OpenPlatypusでそれぞれ10%、8%、8%の向上を示す。さらに、LLaMA-2-Chatに対しても恩恵を受ける。 Comment
Alpacaデータでの性能向上が著しい。かなり重要論文な予感。後で読む。
HuggingFaceのTRLでサポートされている
https://huggingface.co/docs/trl/sft_trainer
openreview: https://openreview.net/forum?id=0bMmZ3fkCk
[Paper Note] Large Language Model Alignment: A Survey, Tianhao Shen+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Survey #LanguageModel #Alignment Issue Date: 2023-10-09 GPT Summary- LLMsの進展には潜在的な問題が伴い、正確性や人間の価値観との整合性が求められる。本研究は、アラインメント手法を探求し、外部と内部アラインメントを分類。解釈可能性や脆弱性についても考察し、多様な評価方法を提示。最終的に、AIアラインメント研究とLLMsの能力探索を結びつけることを目的とする。 Comment
LLMのalignmentに関するサーベイ。
[Paper Note] MAmmoTH: Building Math Generalist Models through Hybrid Instruction Tuning, Xiang Yue+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #InstructionTuning #NumericReasoning #Reasoning #Mathematics #One-Line Notes Issue Date: 2023-09-30 GPT Summary- MAmmoTHシリーズは、数学問題解法に特化したオープンソースのLLMで、MathInstructという指示チューニングデータセットを使用して訓練されています。MathInstructは、中間推論を含む13の数学データセットから構成され、特に6つの新たな推論過程を提供しています。CoTとPoTのハイブリッドを採用することで、異なる思考プロセスを実現し、9つの数学推論データセットで平均16%から32%の精度向上を実現しました。特にMAmmoTH-7BモデルはMATHデータセットで33%、MAmmoTH-34Bモデルは44%を達成し、既存のオープンソースモデルを上回っています。研究は、多様な問題の網羅性とハイブリッド推論の重要性を示しています。 Comment
9つのmath reasoningが必要なデータセットで13-29%のgainでSoTAを達成。
260kの根拠情報を含むMath Instructデータでチューニングされたモデル。
project page:
https://tiger-ai-lab.github.io/MAmmoTH/
LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models, Yukang Chen+, N_A, arXiv'23
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #Dataset #QuestionAnswering #Supervised-FineTuning (SFT) #LongContext #PEFT(Adaptor/LoRA) #KeyPoint Notes Issue Date: 2023-09-30 GPT Summary- 本研究では、計算コストを制限しながら大規模言語モデル(LLMs)のコンテキストサイズを拡張する効率的なファインチューニング手法であるLongLoRAを提案します。従来の方法では、LLMsの長いコンテキストサイズでのトレーニングには高い計算コストとGPUリソースが必要でしたが、提案手法ではコンテキスト拡張を高速化し、非自明な計算コストの削減を実現します。また、パラメータ効率的なファインチューニング手法も再評価し、LongLoRAはさまざまなタスクで強力な実験結果を示しています。さらに、教師ありファインチューニングのためのデータセットであるLongQAも収集されました。 Comment
# 概要
context長が大きい場合でも効率的にLoRAする手法。通常のLoRAではcontext lengthが大きくなるにつれてperplexityが大きくなってしまう。一方、通常のFinetuningではperplexityは高い性能を維持するが、計算コストとVRAMの消費量が膨大になってしまう。LongLoRAでは、perplexityを通常のFinetuningと同等に抑えつつ、VRAM消費量もLoRAと同等、かつより小さな計算量でFinetuningを実現している。
# 手法概要
attentionをcontext length全体で計算するとinput長の二乗の計算量がかかるため、contextをいくつかのグループに分割しグループごとにattentionを計算することで計算量削減。さらに、グループ間のattentionの間の依存関係を捉えるために、グループをshiftさせて計算したものと最終的に組み合わせている。また、embedding, normalization layerもtrainableにしている。
[Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #DataAugmentation #Supervised-FineTuning (SFT) #AIAgents #SyntheticData #EMNLP #Selected Papers/Blogs #System Demonstration #KeyPoint Notes #Author Thread-Post Issue Date: 2023-08-28 GPT Summary- Prompt2Modelは、LLMによるプロンプトを用いて特定用途モデルを訓練する方法を提案。既存データセットの検索とLLMを使ったデータ生成により、強力なモデルを得られる。提示したプロンプトで、gpt-3.5-turboの結果を約20%上回り、最大700倍小型化できる。モデルの性能を信頼性高く推定可能で、オープンソースとして公開。 Comment
Dataset Generatorによって、アノテーションが存在しないデータについても擬似ラベル付きデータを生成することができ、かつそれを既存のラベル付きデータと組み合わせることによってさらに性能が向上することが報告されている。これができるのはとても素晴らしい。
Dataset Generatorについては、データを作成する際に低コストで、高品質で、多様なデータとするためにいくつかの工夫を実施している。
1. ユーザが与えたデモンストレーションだけでなく、システムが生成したexampleもサンプリングして活用することで、生成されるexampleの多様性を向上させる。実際、これをやらない場合は120/200がduplicate exampleであったが、これが25/200まで減少した。
2. 生成したサンプルの数に比例して、temperatureを徐々に高くしていく。これにより、サンプルの質を担保しつつ、多様性を徐々に増加させることができる。Temperature Annealingと呼ぶ。
3. self-consistencyを用いて、擬似ラベルの質を高める。もしmajority votingが互角の場合は、回答が短いものを採用した(これはヒューリスティックに基づいている)
4. zeno buildを用いてAPIへのリクエストを並列化することで高速に実験を実施
非常に参考になる。
著者らによる現在の視点での振り返り(提案当時はAI Agentsという概念はまだなく、本研究はその先取りと言える):
Crosslingual Generalization through Multitask Finetuning, Niklas Muennighoff+, N_A, ACL'23
Paper/Blog Link My Issue
#LanguageModel #MultitaskLearning #Zero/Few/ManyShotPrompting #Supervised-FineTuning (SFT) #CrossLingual #ACL #Generalization #One-Line Notes Issue Date: 2023-08-16 GPT Summary- マルチタスクプロンプトフィネチューニング(MTF)は、大規模な言語モデルが新しいタスクに汎化するのに役立つことが示されています。この研究では、マルチリンガルBLOOMとmT5モデルを使用してMTFを実施し、英語のプロンプトを使用して英語および非英語のタスクにフィネチューニングすることで、タスクの汎化が可能であることを示しました。さらに、機械翻訳されたプロンプトを使用してマルチリンガルなタスクにフィネチューニングすることも調査し、モデルのゼロショットの汎化能力を示しました。また、46言語の教師ありデータセットのコンポジットであるxP3も紹介されています。 Comment
英語タスクを英語でpromptingしてLLMをFinetuningすると、他の言語(ただし、事前学習で利用したコーパスに出現する言語に限る)で汎化し性能が向上することを示した模様。

[Paper Note] Aligning Large Language Models with Human: A Survey, Yufei Wang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Alignment #One-Line Notes Issue Date: 2023-08-08 GPT Summary- LLMsはNLPタスクにおいて重要な解決策として台頭しているが、人間の指示を誤解したり、偏った情報を生成するリスクがある。本調査は、LLMsを人間の期待に整合させるための技術を総括し、データ収集方法、学習手法のレビュー、モデル評価方法について詳述する。結論として、人間指向のタスクに適合させるためのLLMsの整合性を深化させる有用な資源にし、関連のGitHubリンクも提供する。 Comment
LLMのAlignment手法に関するSurvey
[Paper Note] LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition, Chengsong Huang+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #COLM #KeyPoint Notes Issue Date: 2023-08-08 GPT Summary- LoraHubは、タスク間一般化のためにLoRAモジュールを柔軟に組み合わせるフレームワークであり、新しいタスクに対して少数の例から適応可能な性能を目指す。これにより、追加のパラメータや勾配なしに複数のLoRAモジュールを統合でき、推論時のトークン数を削減し、効率性と性能のトレードオフを実現。Big-Bench Hardベンチマークでの結果は、LoraHubが高い上限を示し、ユーザーがLoRAモジュールを容易に共有できるプラットフォームの構築を目指している。 Comment
学習されたLoRAのパラメータをモジュールとして捉え、新たなタスクのinputが与えられた時に、LoRA Hub上の適切なモジュールをLLMに組み合わせることで、ICL無しで汎化を実現するというアイデア。few shotのexampleを人間が設計する必要なく、同等の性能を達成。
複数のLoRAモジュールは組み合わられるか?element wiseの線型結合で今回はやっているが、その疑問にこたえたのがcontribution
OpenReview: https://openreview.net/forum?id=TrloAXEJ2B
[Paper Note] QLoRA: Efficient Finetuning of Quantized LLMs, Tim Dettmers+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #Supervised-FineTuning (SFT) #Quantization #PEFT(Adaptor/LoRA) #NeurIPS #Selected Papers/Blogs #needs-revision Issue Date: 2023-07-22 GPT Summary- QLoRAは、65Bパラメータモデルを単一の48GB GPUでファインチューニングするための効率的な手法であり、16ビット性能を維持しつつメモリ使用量を削減します。低秩アダプターを介して勾配をバックプロパゲーションし、GuanacoモデルはVicunaベンチマークで従来のモデルを超え、ChatGPTに近い性能を示しました。QLoRAの革新には、4ビット量子化データ型、ダブル量子化、そしてメモリ管理のためのページングオプティマイザーが含まれます。1,000以上のモデルをファインチューニングし、指示追従性能の詳細な分析を提供。また、GPT-4評価を用いたチャットボット性能の分析から、既存のベンチマークの信頼性の問題点も指摘しています。全てのモデルとコードは公開されています。 Comment
実装:
https://github.com/artidoro/qlora
PEFTにもある
参考:
[Paper Note] One-for-All: Generalized LoRA for Parameter-Efficient Fine-tuning, Arnav Chavan+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) Issue Date: 2023-06-16 GPT Summary- GLoRAは、Low-Rank Adaptationを拡張した普遍的な微調整手法であり、事前学習済みモデルの重みと中間活性化を最適化することで多様なタスクに対応します。層ごとの構造探索により、個別アダプターを学習し、効率的なパラメータ適応を促進。包括的な実験により、GLoRAが従来法を上回り、LLaMA-1およびLLaMA-2で改善を示しました。推論コストを追加せず、リソース制限のあるアプリケーションに適しています。 Comment
OpenReview:
https://openreview.net/forum?id=K7KQkiHanD
ICLR'24にrejectされている
[Paper Note] Symbol tuning improves in-context learning in language models, Jerry Wei+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #In-ContextLearning #EMNLP #KeyPoint Notes #needs-revision Issue Date: 2023-05-21 GPT Summary- シンボルチューニングを提案し、自然言語ラベルを記号に置換した文脈内の入力-ラベルペアによる言語モデルのファインチューニングを行う。これにより、モデルは指示がない場合でもタスクを解決できる。5400億パラメータのFlan-PaLMモデルでの実験により、未見のタスクに対する性能が向上し、特にアルゴリズム的推論タスクで最大18.2%の性能向上を示した。また、反転ラベルに従う能力が強化された。 Comment
概要やOpenReviewの内容をざっくりとしか読めていないが、自然言語のラベルをランダムな文字列にしたり、instructionをあえて除外してモデルをFinetuningすることで、promptに対するsensitivityや元々モデルが持っているラベルと矛盾した意味をin context learningで上書きできるということは、学習データに含まれるテキストを調整することで、正則化の役割を果たしていると考えられる。つまり、ラベルそのものに自然言語としての意味を含ませないことや、instructionを無くすことで、(モデルが表層的なラベルの意味や指示からではなく)、より実際のICLで利用されるExaplarからタスクを推論するように学習されるのだと思われる。
OpenReview: https://openreview.net/forum?id=vOX7Dfwo3v
[Paper Note] Controlled Text Generation with Natural Language Instructions, Wangchunshu Zhou+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #Prompting #SyntheticData #In-ContextLearning #ICML #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 自然言語の指示に従い、多様なタスクを解決可能な大規模言語モデルの制御を改善するために、「InstructCTG」というフレームワークを提案。自然テキストの制約を抽出し、これを自然言語の指示に変換することで弱教師あり訓練データを形成。異なるタイプの制約に柔軟に対応し、生成の質や速度への影響を最小限に抑えつつ、再訓練なしで新しい制約に適応できる能力を持つ。 Comment
制約に関する指示とデモンスとレーションに関するデータを合成して追加のinstruction tuningを実施することで、promptで指示された制約を満たすような(controllableな)テキストの生成能力を高める手法
[Paper Note] Reflexion: Language Agents with Verbal Reinforcement Learning, Noah Shinn+, NeurIPS'23, 2023.03
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #AIAgents #SelfCorrection #NeurIPS #Initial Impression Notes Issue Date: 2023-03-28 GPT Summary- LLMを用いた言語エージェントが外部環境と相互作用しつつ、迅速な学習を可能にする新しいフレームワーク「Reflexion」を提案。言語的フィードバックを活用し、エージェントはタスクのフィードバックを反映、エピソディックメモリに保持して意思決定を改善。多様なフィードバック信号を取り入れ、様々なタスクで大幅な性能向上を実現。HumanEvalベンチマークでは91%のpass@1精度を達成し、従来の最先端を超える成果を示した。 Comment
なぜ回答を間違えたのか自己反省させることでパフォーマンスを向上させる研究
openreview: https://openreview.net/forum?id=vAElhFcKW6
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #EMNLP #KeyPoint Notes Issue Date: 2024-10-29 GPT Summary- NLPモデルの一般化能力を評価するために、1,616の多様なタスクを含むSuper-NaturalInstructionsというベンチマークを導入。76種のタスクタイプをカバーし、モデルをタスクのサブセットで訓練し未見のタスクを評価。Tk-Instructモデルは、InstructGPTを9%以上上回る性能を示し、サイズが小さい。タスク数やインスタンス数に基づいた一般化の分析を行い、本データセットとモデルが汎用的NLPモデルの進展に寄与することを期待。 Comment
7.1, 7.2が最も興味深い
## Instruction Tuningにおける未知のタスクに対する汎化性能について、3つの要素に対するスケーリングについて考察
- More observed tasks improve the generalization.
- A large number of training instances do not help generalization.
- Tuning larger models with instructions consistently lead to gains.
## Instructionをさまざまに変化させた時の性能の変化に対する分析
Table4の対角成分に注目すると(trainとtestのinput encodingを揃えた場合)
- Task definitionをinstructionに含めることで未知タスクに対する汎化性能向上
- Task Definitionとpositive examplesを4つ程度入れると汎化性能向上。
- ただし、これ以上exampleを増やすと性能低下。
- negative examplesを入れることは性能に a little bit しか貢献しない
- explanationsを入れると性能が低下する
Table4の非対角成分に着目すると、
- Task Definitionのみで訓練しても、Example onlyのtest時のencodingには汎化しない(逆も然り)
- Task Definition + examples (今回の場合はpositive examples4つ)は、さまざまなtest時のinput encodingsに対してロバストになる
Training language models to follow instructions with human feedback, Long Ouyang+, N_A, NeurIPS'22
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ChatGPT #RLHF #Actor-Critic #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-28 GPT Summary- 大規模な言語モデルは、ユーザーの意図に合わない出力を生成することがあります。本研究では、人間のフィードバックを使用してGPT-3を微調整し、InstructGPTと呼ばれるモデルを提案します。この手法により、13億パラメータのInstructGPTモデルの出力が175BのGPT-3の出力よりも好まれ、真実性の向上と有害な出力の削減が示されました。さらに、一般的なNLPデータセットにおける性能の低下は最小限でした。InstructGPTはまだ改善の余地がありますが、人間のフィードバックを使用した微調整が有望な方向であることを示しています。 Comment
ChatGPTの元となる、SFT→Reward Modelの訓練→RLHFの流れが提案された研究。DemonstrationデータだけでSFTするだけでは、人間の意図したとおりに動作しない問題があったため、人間の意図にAlignするように、Reward Modelを用いたRLHFでSFTの後に追加で学習を実施する。Reward Modelは、175Bモデルは学習が安定しなかった上に、PPOの計算コストが非常に大きいため、6BのGPT-3を様々なNLPタスクでSFTしたモデルをスタートにし、モデルのアウトプットに対して人間がランキング付けしたデータをペアワイズのloss functionで訓練した。最終的に、RMのスコアが最大化されるようにSFTしたGPT-3をRLHFで訓練するが、その際に、SFTから出力が離れすぎないようにする項と、NLPベンチマークでの性能が劣化しないようにpretrain時のタスクの性能もloss functionに加えている。
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #One-Line Notes Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #EMNLP #Selected Papers/Blogs #KeyPoint Notes #SoftPrompt Issue Date: 2022-08-19 GPT Summary- 本研究では、凍結された言語モデルを特定のタスクに適応させるための「ソフトプロンプト」を学習するプロンプトチューニング手法を提案。逆伝播を通じて学習されるソフトプロンプトは、GPT-3の少数ショット学習を上回る性能を示し、モデルサイズが大きくなるほど競争力が増すことが確認された。特に、数十億のパラメータを持つモデルにおいて、全ての重みを調整するモデルチューニングに匹敵する性能を発揮。これにより、1つの凍結モデルを複数のタスクに再利用できる可能性が示唆され、ドメイン転送に対するロバスト性も向上することが明らかとなった。 Comment
日本語解説:
https://qiita.com/kts_plea/items/79ffbef685d362a7b6ce
T5のような大規模言語モデルに対してfinetuningをかける際に、大規模言語モデルのパラメータは凍結し、promptをembeddingするパラメータを独立して学習する手法
言語モデルのパラメータ数が増加するにつれ、言語モデルそのものをfinetuningした場合(Model Tuning)と同等の性能を示した。
いわゆる(Softな) Prompt Tuning
[Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2021-09-09 GPT Summary- プレフィックスチューニングは、ファインチューニングの軽量な代替手段であり、言語モデルのパラメータを固定しつつ、タスク特有の小さなベクトルを最適化する手法です。これにより、少ないパラメータで同等のパフォーマンスを達成し、低データ設定でもファインチューニングを上回る結果を示しました。 Comment
言語モデルをfine-tuningする際,エンコード時に「接頭辞」を潜在表現として与え,「接頭辞」部分のみをfine-tuningすることで(他パラメータは固定),より少量のパラメータでfine-tuningを実現する方法を提案.接頭辞を潜在表現で与えるこの方法は,GPT-3のpromptingに着想を得ている.fine-tuningされた接頭辞の潜在表現のみを配布すれば良いので,非常に少量なパラメータでfine-tuningができる.
table-to-text, summarizationタスクで,一般的なfine-tuningやAdapter(レイヤーの間にアダプターを挿入しそのパラメータだけをチューニングする手法)といった効率的なfine-tuning手法と比較.table-to-textでは、250k (元のモデルの 0.1%) ほどの数のパラメータを微調整するだけで、全パラメータをfine-tuningするのに匹敵もしくはそれ以上の性能を達成.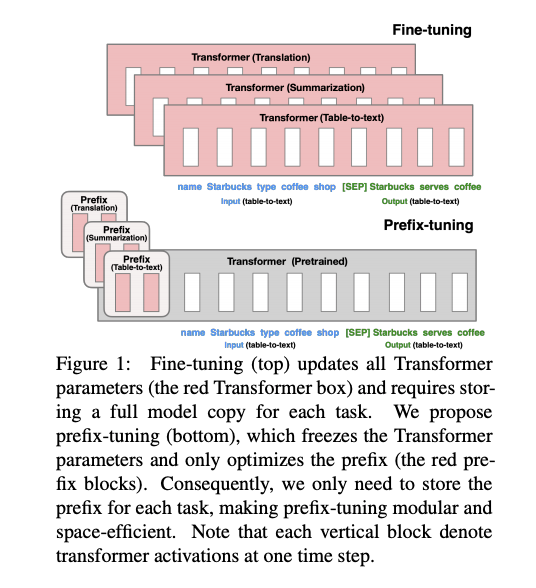
Hugging Faceの実装を利用したと論文中では記載されているが,fine-tuningする前の元の言語モデル(GPT-2)はどのように準備したのだろうか.Hugging Faceのpretrained済みのGPT-2を使用したのだろうか.
autoregressive LM (GPT-2)と,encoder-decoderモデル(BART)へPrefix Tuningを適用する場合の模式図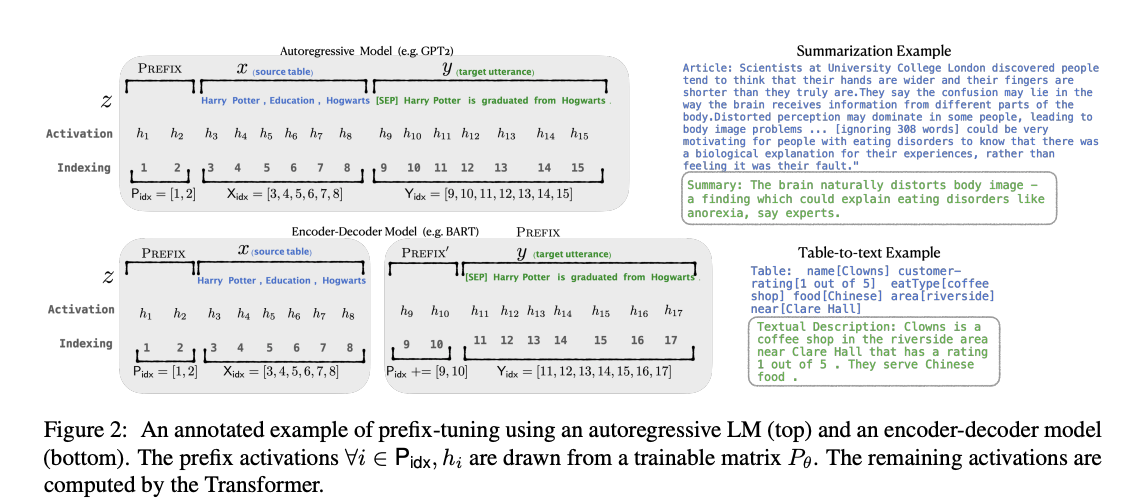
[Paper Note] Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, Colin Raffel+, JMLR'20
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #NLP #TransferLearning #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- 転移学習はNLPにおいて強力な技術であり、本論文ではテキストをテキストに変換する統一フレームワークを提案。事前学習の目的やアーキテクチャを比較し、最先端の結果を達成。データセットやモデル、コードを公開し、今後の研究を促進する。 Comment
T5もメモっていなかったので今更ながら追加。全てのNLPタスクをテキスト系列からテキスト系列へ変換するタスクとみなし、Encoder-DecoderのTransformerを大規模コーパスを用いて事前学習をし、downstreamタスクにfinetuningを通じて転移する。
個人的に、Transformer-decoderのスケーラビリティのみならず、T5全てのタスクをテキスト系列の変換とみなす考え方が、現在のLLMの基盤となっていると感じている。
[Paper Note] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism, Mohammad Shoeybi+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#Pretraining #Tools #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Selected Papers/Blogs #Parallelism #One-Line Notes #DistributedLearning #TrainingFramework Issue Date: 2026-09-29 GPT Summary- 大規模Transformerモデルを学習するため、ネイティブPyTorchに少数の通信操作を追加する層内モデル並列化手法を提案。パイプライン型並列化と併用可能で、512 GPU上で最大83億パラメータのモデルを学習し、15.1ペタFLOPSと76%のスケーリング効率を達成。GPT-2型・BERT型モデルで既存のSOTAを上回り、WikiText103、LAMBADA、RACEで高い性能を実現。 Comment
Megatron-LMがメモされていなかったので追加。代表的なLLM・マルチモーダルモデル学習のためのフレームワーク
事前学習、継続事前学習だけでなく
- Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
以下のような事後学習フレームワークのバックエンドとしても利用される:
- Nemo-RL, Nvidia, 2025.05
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- slime, THUDM & Zhihu, 2025.09
- ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
Halo: Frontier-Lab Training for Everyone, White Circle, 2026.09
Paper/Blog Link My Issue
#Article #Multi #ComputerVision #EfficiencyImprovement #Pretraining #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #MultiModal #Blog #mid-training #DPO #Parallelism #VisionLanguageModel #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-09-29 Comment
元ポスト:
When does distillation help reinforcement learning?, Base Labs, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #Distillation #read-later #One-Line Notes #Author Thread-Post Issue Date: 2026-09-25 Comment
元ポスト:
RL前にSFTを通じてオフポリシー蒸留をすることが、どれだけ後段のRL後のパフォーマンスに影響するかを調査したようで、
- 小規模モデルには効果的だが大規模なモデルには効果が薄く
- ベースモデルに存在しない慣習や理解を必要とするタスクに対して効果的で
- 副作用としてポリシーのエントロピーが低減する、すなわちRL中の探索が抑制される
といった知見が得られたようである。
一見すると、SLMに関しては
- [Paper Note] A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility, Andreas Hochlehnert+, COLM'25
と対立する知見に見えるが、前提として何が違うだろうか。
SLMに対しては同様の知見が示されている:
- [Paper Note] AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, Zihan Liu+, arXiv'25, 2025.06
FineEnvs: Open Source RL Environments for LLM Agents, Adithya S Kolavi, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #ReinforcementLearning #Repository #SmallModel #One-Line Notes #Environment Issue Date: 2026-09-25 Comment
元ポスト:
SLMのcoding, datascience向けの
(いわゆるSmolな)RL学習用の5k+のverifiableなタスクデータ、Environment、評価、学習のコードを提供。
従来の初心者向けのチュートリアルでは、GSM8Kのような既に飽和したデータセットが主なデータであり、より実用的なデータに基づいたRLVRのための環境を整えた、という感じに見える。
When Do Larger Batches Help Scale LLM Reinforcement Learning?, Tencent RL Team, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Selected Papers/Blogs #One-Line Notes #CriticalBatchSize Issue Date: 2026-09-24 Comment
元ポスト:
目標性能まで到達するまでに必要なwall-clock timeとLLMでのオンポリシーRLのバッチサイズの関係性を明らかにしているようである。
LLMのオンポリシーRLでは、生成と学習においてバッチサイズの大きさが非対称に働く(すなわち、生成側の並列数を増やすとモデルの重み転送をより多く共有できるため処理に要する時間が短縮されるが、学習側でバッチサイズが増えると処理時間は増加する)ため、生成側の並列数の変化によるスループットの向上と、学習側のバッチサイズによる更新に必要なサンプル数の両方を考える必要がある。
このとき、目標性能に到達するまでに必要な累積応答数N(学習側)、エンドツーエンドのスループットq(生成側だけではなくシステム全体)を考える。
これにより、バッチサイズを変化させた時に必要なサンプル数の変化の比率r_N (=N/N_pivot, r_Nが1より大きい場合は、新たなバッチサイズが基準となるバッチサイズよりも、ある性能に到達するまでより多くの応答を必要とする)、
スループットの変化の比率r_q(=q/q_pivot, r_q>1の場合は、1秒あたりにより多くの応答を処理できる)を定義でき、
r_q > r_Nの場合、すなわち、バッチサイズを大きくしたことによる、システムのエンドツーエンドのスループット向上による恩恵が、学習側のサンプルコストの悪化を上回った場合に、バッチサイズを大きくすることで学習が高速化される、このときの改善の度合いは r_N/r_q で測ることができる。例えば、r_N/r_q=0.8の場合、学習時間が20%削減されることを意味する、といったフレームワークを定義でき (The criterion部分を参照)、
実践的には、
- 候補となるバッチサイズについて、学習率や関連するハイパーパラメータを調整し、学習に利用される応答単位での学習に対する寄与を揃え、累積応答数が等しい点での学習曲線を比較することで、r_Nを推定し
- 与えられたバッチサイズにおいてシステムのスループットを最大化する設定を探索し、r_qを測定する
- その上で、r_N/r_qを測定し、最も学習時間が短縮されるバッチサイズを採用する
というプロセスにおとしこむことができる(conclusionを参照)
という感じの話のようにみえる。
Contrastive Language Models: A System One Model for Fast and Generalizable Decision-Making, Kwok+, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #ContrastiveLearning #Blog #OpenWeight #Scaling Laws #mid-training #Selected Papers/Blogs #Encoder #Author Thread-Post #SystemOneModel Issue Date: 2026-09-24 Comment
元ポスト:
HF: https://huggingface.co/Contrastive-LM
非常にコンパクトにまとまっていて大変読みやすかった。あとでまとめる。
On-Policy Distillation: Full-Vocabulary KL vs. Sampled Trajectory RL, Bhavin Jawade, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Distillation #Post #read-later #On-Policy Issue Date: 2026-09-23
We are streaming our RL big runs. The mimo-v2.6 series is coming soon, Xiaomi Mimo Team, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #AIAgents #Blog #Selected Papers/Blogs #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-09-17 Comment
元ポスト:
リアルタイムでMimoのRLの学習の経過が公開されている。おもしろい
コストの試算:
Mimo, 1T-A42Bの場合、RL 1stepあたり1000万円程度かかっているようだ。
おそらくインフラは高度に最適化されている。
現時点で2モデル合計でコストが約300万ドルに到達し、日本円にして約4.7億円(ドル円157円換算, pro 68B / flash 81B Tokens)🙄DeepSWEやコーディング系のベンチは順調にスコアが向上している。また、noticesに記載されているインシデントの報告が興味深く、インフラ周りのエラーや、学習に悪影響を与えるタスクやデータセット単位での除去なども情報共有されており大変興味深い。PostTrainingデータセットなどMixtureも公開されている。
[Paper Note] FLASHREINFORCE: CRITIC-FREE SINGLE-ROLLOUT ASYNCHRONOUS RL FOR AGENTIC LANGUAGE MODELS, Hu+, ResearchGate, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #AIAgents #read-later #Selected Papers/Blogs #Asynchronous Issue Date: 2026-09-15 Comment
元ポスト:
解説:
JustRL II: Scaling Small LLMs to 128K Reasoning with a Critic, MiniCPM RL Team, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Actor-Critic #read-later #Selected Papers/Blogs #LongHorizon #Author Thread-Post #CreditAssignment Issue Date: 2026-09-09 Comment
元ポスト:
関連:
- [Paper Note] JustRL: Scaling a 1.5B LLM with a Simple RL Recipe, Bingxiang He+, ICLR'26, 2025.12
终局奖励之后:从 Apodex 1.1 看长程 Agentic RL 如何分配 credit, 发布于, 2026.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #AIAgents #read-later #CreditAssignment Issue Date: 2026-09-06 Comment
元ポスト:
Training frontier knowledge work agents: A 397B RL training guide with SkyRL, Mercor and SkyRL, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #AIAgents #Blog #read-later #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-09-06 Comment
元ポスト:
397Bモデルに対するDPPOによる事後学習によってAPEX-Agentsのスコアを+11.2%を実現するための取り組みと地検が共有されているようである。
関連:
- [Paper Note] APEX-Agents, Bertie Vidgen+, arXiv'26, 2026.01
- [Paper Note] Rethinking the Trust Region in LLM Reinforcement Learning, Penghui Qi+, arXiv'26, 2026.02
Reinforcement Learning for LLMs: The Complete Guide, Cameron R. Wolfe, Ph.D., 2026.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Author Thread-Post Issue Date: 2026-08-29 Comment
元ポスト:
RL creates split personas, LW, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #ReinforcementLearning #Blog #Selected Papers/Blogs #Personality #reading #Author Thread-Post Issue Date: 2026-08-22 Comment
元ポスト:
所見:
Miles: Enterprise-Grade Reinforcement Learning for Large-Scale Model Post-Training, RadixArk, 2026.08
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #PEFT(Adaptor/LoRA) #Asynchronous #Author Thread-Post #TrainingFramework Issue Date: 2026-08-19 Comment
元ポスト:
Defending Against the Training–Inference Numeric Mismatch in RL (Especially Linear Attention) — and Whether It Helps Async RL, Yichuan Wang in collaboration with the TorchTitan team, 2026.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #read-later #Selected Papers/Blogs #train-inference-mismatch #Initial Impression Notes #Asynchronous Issue Date: 2026-08-10 Comment
元ポスト:
linear attentionモデルにおいて、初めてRLにおけるtrain-inference mismatchを完全に解消した実装とのことで、非常にインパクトが大きそうに見える。
Reward Laundering: LLMs Can Gain Unintended Behaviors by Deciding When to Earn Their Rewards, egan+, 2026.08
Paper/Blog Link My Issue
#Article #Analysis #NLP #Alignment #ReinforcementLearning #Safety #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
[Paper Note] Statutory construction and interpretation for AI, He+, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #AIAgents #One-Line Notes #Rubric-based #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
Constitutional AIのようなルーブリックに基づいてモデルの振る舞いを調整する方法では、ルールの捉え方がモデルに応じて異なることで幅広い解釈が存在することが問題となることを指摘。モデル間での解釈を一致させるために、
- Interpretive Constraints: 法解釈の原理に基づいたPromptingによって、モデル側の解釈の裁量を制限し
- Iterative Refinement: 曖昧性のある記述をiterativeに洗練させる
ことによって緩和する。
関連:
- [Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
AgentENV, kvcache-ai, 2026.07
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #Initial Impression Notes #Environment #Author Thread-Post #SandboxEnvironment Issue Date: 2026-08-05 Comment
元ポスト:
大規模、かつ高速にAgentic RLのためのサンドボックス環境をself-hosting可能な実装
下記ポストに速度やKimi K3で利用された時の環境の規模感が記述されているので参照のこと:
credit-assignment-is-all-you-need, haotian, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #reading #Author Thread-Post #CreditAssignment Issue Date: 2026-08-05 Comment
元ポスト:
英語版公式ポスト:
Scaling Automated Post-Training, Intology, 2026.08
Paper/Blog Link My Issue
#Article #Blog #read-later #Author Thread-Post Issue Date: 2026-08-05 Comment
元ポスト:
On-policy distillation isn't a free-lunch, Bhavin Jawade, 2026.07
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Distillation #Post #Selected Papers/Blogs #On-Policy #reading #Initial Impression Notes Issue Date: 2026-08-03 Comment
元ポスト:
OPD/OPSDのfailure modeが非常に分かりやすくまとまっている
MoonEP, MoonshotAI, 2026.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Library #SoftwareEngineering #mid-training #Parallelism #One-Line Notes #GPUKernel Issue Date: 2026-07-28 Comment
大規模なExpertParallelにおいて通信を効率的に実施するためのライブラリとのこと。
元ポスト:
Scaling Agentic RL: 365,000+ Environments for SWE, Terminal, and Search, Prime Intellect, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Blog #One-Line Notes #Scalability #Environment Issue Date: 2026-07-23 Comment
元ポスト:
36.5kのagentic RLのためのenvironments。対象はSWE, Search, terminal。全てのタスクセットが、任意のハーネス、ランタイム上でone commandで実行可能とのこと。
🦋 Molt: A Scalable PyTorch-Native Training Framework for Agentic Reinforcement Learning, Jian Hu and Molt Contributors, 2026.07
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #One-Line Notes #TrainingFramework Issue Date: 2026-07-19 Comment
元ポスト:
ハイパフォーマンス、かつminimalな実装のRLライブラリで、研究用のハックがしやすいフレームワーク。verlの1/9, Slimeの1/3の行数で実現されているとのこと。
verl:
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
Slime:
- slime, THUDM & Zhihu, 2025.09
The 4-bitter Lesson: Balancing Stability and Performance in NVFP4 RL, Humans&, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #LowPrecision Issue Date: 2026-07-19 Comment
元ポスト:
[Tech] Delta Weight Sync: When RL's Weight Sync Stops Being a Network Problem, Changyi Yang, ChangyiYang's Site, 2026.06
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #Blog #Selected Papers/Blogs #reading #Initial Impression Notes #Author Thread-Post Issue Date: 2026-07-07 Comment
RLによる事後学習の際にtrainer側のoptimizerが1 step学習した後にinferenceエンジンに重みをpushするが、BF16でのRLにおける1 stepの更新では多くのモデルの重みに変化はなく(99%程度)、差分だけをpushすればlosslessで2桁程度trafficを削減できて、RDMAが不要でたとえばイーサネットベースのデータセンターを跨いだ環境でもRLが実行できそうだよ、という話のようである。
元ポスト:
Accelerating Transformers Fine-Tuning with NVIDIA NeMo AutoModel, nvidia, 2026.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #MoE(Mixture-of-Experts) #Selected Papers/Blogs #Finetuning #reading #One-Line Notes #EfficientEvaluation #TrainingFramework Issue Date: 2026-07-05 Comment
わずか数行を追加するだけで、MoEモデルをマルチGPU環境でFinetuningする際のスループットが約3--4倍、メモリ使用量が30%程度削減されるライブラリ。既存のQwen, Nemotron, GPT-OSS, DeepSeek V3などの一般的なMoEアーキテクチャに対して、最適化済みの実装が提供されているとのこと。
repository: https://github.com/NVIDIA-NeMo/Automodel
Agentic RL: Frameworks and Best Practices, CAMERON R. WOLFE, 2026.06
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #AIAgents #Blog #read-later Issue Date: 2026-07-03
Learning to Replicate Expert Judgment in Financial Tasks, THINKING MACHINES, 2026.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Financial #read-later #Author Thread-Post Issue Date: 2026-07-02 Comment
元ポスト:
Ornith-1.0: Self-Scaffolding LLMs for Agentic Coding, Ornith, 2026.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Coding #OpenWeight #SoftwareEngineering #One-Line Notes #Author Thread-Post Issue Date: 2026-06-26 Comment
HF: https://huggingface.co/collections/deepreinforce-ai/ornith-10
元ポスト:
gemma4とQwen3.5をpost trainingしたコーディング特化LLMで、397BモデルではSWE Bench ProでGLM 5.2超え
On-Policy Self-Distillation: 言葉で学ぶ LLMの新たな学習パラダイム, ぶち, 2026.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Selected Papers/Blogs #On-Policy #Reading Reflections #SelfDistillation Issue Date: 2026-06-01 Comment
元ポスト:
日本語でのOPSD解説で、細かい数式などよりも、何が重要で、なぜ今なのかといった気持ちのところが非常に重点的に説明されている。
後半の今後の課題の、どの程度の能力であればself teacherが成立するのか、どのような情報を与えると良いのか、といった話は、
- [Paper Note] Unmasking On-Policy Distillation: Where It Helps, Where It Hurts, and Why, Mohammadreza Armandpour+, arXiv'26, 2026.05
で模索されている。
また、OPSDの気持ち的な部分だけでなく、(簡単な)数式的な解釈、最近のサーベイなど、より詳細な情報は
- The Imitation Game: State of Policy Distillation in Language Model training, 032-Chinmay Karkar, 2026.05
のブログにまとめられているので参照のこと。
Native RL APIs in vLLM, vLLM, 2026.05
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #Blog #SoftwareEngineering #reading #Asynchronous Issue Date: 2026-05-31 Comment
元ポスト:
所見:
Repo2RLEnv: Turn any GitHub repository into a verifiable RL environment for training and evaluation, HuggingFace, 2026.05
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #reading #Environment #Author Thread-Post Issue Date: 2026-05-31 Comment
元ポスト:
Should we use genetics instead of system prompts for AI Agents & Personas?, Fyx, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #Blog #PEFT(Adaptor/LoRA) #read-later #Personality #One-Line Notes #Reading Reflections Issue Date: 2026-05-31 Comment
元ポスト:
ゲノム文字列からキャラクターのペルソナを推論し出力に反映可能なLoRAアダプタを学習することによって、ゲノム文字列によってペルソナの条件付けを可能とするモデルに関する実験の報告のようである。
具体的には、まずゲノム文字列と、ペルソナに関するテキストを対応付ける。次に、ペルソナテキストを与えてモデルの応答を収集し、ゲノム文字列と(ペルソナのテキストなしで)収集したモデルの応答を用いてLoRAアダプタを学習する。これにより、LoRAアダプタはゲノム文字列から、ペルソナテキストによって応答づけられた応答を出力することを学習する、といった挙動を実現する。
ざっとみた感じLoRAアダプタとは書かれているが、学習手法が書かれていないような気がする。が、手法はおそらくSFTだと思われる。
これにより、prefillをするinput tokenが削減可能と思われるが、実用上はどちらかというと出力/reasoningトークンが圧縮される方がlatency/コストの双方から恩恵があるので、事後学習をして他の能力が劣化、あるいはAlignmentが悪化するリスクを背負ってまでやる価値があるかは怪しいな、という感想を持ったが、果たしてどうだろうか。
非常に大規模なユーザからの同時接続があり、キャラクターと対話できるようなサービスにおいて、キャラクターのペルソナテキスト(用途はペルソナだけには限らない汎用的な技術だと思うが)が97%圧縮できたら結構なインパクトがあるかもしれない。
The Imitation Game: State of Policy Distillation in Language Model training, 032-Chinmay Karkar, 2026.05
Paper/Blog Link My Issue
#Article #Tutorial #Survey #NLP #LanguageModel #ReinforcementLearning #Distillation #Catastrophic Forgetting #On-Policy #KeyPoint Notes #SelfDistillation #Author Thread-Post Issue Date: 2026-05-26 Comment
元ポスト:
- On Policy DistillationはKnowledge Distillationの一種で、教師モデルの知識を小さなモデルに蒸留する
- off policy KD Objectiveの場合は固定されたオフラインデータを用いるが、on policy distillationは生徒モデル自身が生成したデータに対するシグナルに基づいて学習される。
- off policy手法の課題はCatastrophic Forgettingと、(sequence長に対するquadraticな)エラーの蓄積がある。
- (オフポリシーRLの特殊なケースとみなすことができる)SFTはForward KLに基づいており、教師モデルの出力分布が確率を持つ部分に対して、生徒モデルの確率がゼロの場合はKLが発散するため、学習される生徒モデルの分布さスムージングされた分布になる。つまり、教師モデルの出力パターンを網羅できるように分布が学習される。
- このような手法で複数のドメインのデータで学習をした場合、分布のシフトが生じやすくCatastrophic Forgettingが生じやすい。
- on policy RLでは、Reverse KLが採用されており、この場合教師が確率が低いと考える場所に高い確率を割り振った場合のみに大きなペナルティを受けるため、教師の重要なモードをカバーしていれば、教師の他のモード全体は無視できる。これにより、学習したいモード以外の挙動に影響を与えにくく、特定のモードの学習ができる。
- (SFTがCatastrophic Forgettingが起きやすそうということは理解できるが、オフポリシーRL全体においてCatastrophic Forgettingが起きやすい問題があるという文脈で書かれている気がしており(エラーの蓄積の冒頭でオフポリシーRLのもう一つの根本的な課題は、という文脈で書かれているため)、SFTの議論がオフポリシーRL全体につながるのかがわからず、モヤっとする。が、LLMのpost-traingではCatrastrophic Forgettingが問題であるという文脈であれば理解できる)
- また、on-policyな学習ではエラーの蓄積を線形に留めることができることが示されている(off-policyな手法ではポリシーが生成したデータで訓練されていないため、inference時の冒頭でミスをすると学習時に観測していないトークンスペースを扱わなければならなくなり、さらにミスが増えモード崩壊に陥る)。
- on policy distillationは直接的にこのexposure biasのgapを小さくする。すなわち、学習時のinput(教師モデルが生成)と推論時のinput(生徒モデルが生成)の分布のgapを縮める。
- 生徒は学習時に常に自身の出力に基づいて学習するため、学習時のprefixと推論時のprefixの傾向が一致しやすい。このため生成時にエラーが起きてもin-distributionとなるため、エラーの蓄積が低減される。
以後はon policy distillation, on policy self-distillationの最新研究のサーベイと動向について記載されている。
関連:
- [Paper Note] Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting, Howard Chen+, arXiv'25, 2025.10
- [Paper Note] RL's Razor: Why Online Reinforcement Learning Forgets Less, Idan Shenfeld+, ICLR'26
- Multi-Teacher On-Policy Distillation: A New Post-Training Primitive, Yumo Xu, 2026.04
後半のサーベイパートなどで記述があったのかもしれないが、OPDでは、GRPOなどで主流なRLVRなどと比較して、報酬のシグナルがdenseであるという点も押さえておきたい。
[Paper Note] Achieving Gold-Medal-Level Olympiad Reasoning via Simple and Unified Scaling
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Reasoning #Mathematics #Test-Time Scaling #RLVR #Verification #Physics Issue Date: 2026-05-21 Comment
pj page: https://simplified-reasoning.github.io/SU-01/
元ポスト:
ポイント解説:
Pedagogical RL: Teaching Models to Teach Themselves from Privileged Information, Chakraborty+, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #CurriculumLearning #PRM #On-Policy #SelfDistillation #Author Thread-Post Issue Date: 2026-05-21 Comment
元ポスト:
Teaching Claude why, Anthropic, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Reasoning #Safety #KeyPoint Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-05-12 Comment
元ポスト:
- [Paper Note] Agentic Misalignment: How LLMs Could Be Insider Threats, Aengus Lynch+, arXiv'25, 2025.10
のように自身を守るために脅迫メールを送るような挙動が観測されたが、それをなくすことができたという話のようである。
細かい学習データのサンプルなどは記載されていないように見えるが
- 評価時のシナリオと類似したもので正しい挙動を教え込むような方法は、評価のスコアは改善するが、OODに対応できない
- モデルに行動を教えるのではなく、理由を教えることが重要で、これはモデル自身が倫理観に関するジレンマに置かれた状況を解決するというデータではなく、ユーザが倫理的なジレンマを抱えているというシナリオで、モデルが倫理的に塾講された思慮深いアドバイスをするようなデータ(difficult advice dataset)で学習することが非常に効果的であった。
- これは単に正しい答えを教えるのではなく、倫理的な"思考"を教えるため効果的であり、これをさらに発展させ、Claudeの人物像をより詳細に与えることでペルソナをより模範的なものに更新する、具体的には質の高いConstitutionに関する文書と、模範的なAIに関するフィクションの物語を学習させることで、misalignmentを非常に効果的に抑制できることを発見した
という感じだろうか。
トップダウンに正解を教えるのではなく、ボトムアップに根源的に正しい思考過程を誘発するような情報を教える(ある種のPRMのようなものだと思われる)ことで、高い汎化性能を獲得できるということだと思われる。このアプローチは最近のAI Agentにおけるoutcome basedなreward設計などにも一石を投じるような議論に感じる。学習の結果得られる汎化性能を重視していかないと、データセットやEnvironmentを逐一構築して課題を潰していく必要があり、キリがないと思う。
The ultimate guide to RL environments: building and scaling them in the LLM era, HuggingFace, 2026.05
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #read-later #Selected Papers/Blogs #Environment Issue Date: 2026-05-08 Comment
元ポスト:
Alignment Whack-a-Mole : Finetuning Activates Verbatim Recall of Copyrighted Books in Large Language Models
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #Copyright Issue Date: 2026-05-08 Comment
元ポスト:
Multi-Teacher On-Policy Distillation: A New Post-Training Primitive, Yumo Xu, 2026.04
Paper/Blog Link My Issue
#Article #Multi #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Distillation #Selected Papers/Blogs #On-Policy #One-Line Notes Issue Date: 2026-05-08 Comment
元ポスト:
(multi teacher)オンポリシー蒸留の解説を、気持ち(何かに特化させると、他の部分が劣化していて、多方面に優れたモデルを学習するのが難しい課題を克服したい)だけでなく、
GRPOに対してAdvantage部分を生徒と教師モデルのreverse KLに置き換えることで統合できるよ、という説明と、
なぜreverse KLを使うのかという説明[^1]、
最近の最先端のOpenLLMにおいてmulti teacher オンポリシー蒸留がどのように使われているかが丁寧に説明されている。
[^1]: forward KLだと教師が少しでも確率を持つトークンにおいて生徒の確率が0だと発散するのでスムージングされた分布になってしまい、特定のトークンにフォーカスした分布が形成されづらく、テキスト生成の多峰性と(意味不明な出力をできるだけ回避するという意味での)安全性の観点からreverse KLの相性が良いよ、という話)
関連:
- 【LLM】On-Policy Distillation入門:小規模モデルを「実戦」で育てる技術, Currently Learning そんけいご, Zenn, 2026.02
解説と所見:
【LLM】On-Policy Distillation入門:小規模モデルを「実戦」で育てる技術, Currently Learning そんけいご, Zenn, 2026.02
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Distillation #Selected Papers/Blogs #On-Policy #Reading Reflections Issue Date: 2026-05-08 Comment
直感的な説明だけでなく、数式ベースの説明、RLとの比較などがコンパクトにまとまっておりとてもわかりやすかった...!!勉強になりました
RL Scaling Laws for LLMs, CAMERON R. WOLFE, PH.D., 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #ReinforcementLearning #Scaling Laws #reading Issue Date: 2026-04-20 Comment
元ポスト:
Defeating the trainer-generator precision mismatch in TRL, HuggingFace, 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Selected Papers/Blogs #reading #train-inference-mismatch #LowPrecision #Author Thread-Post Issue Date: 2026-04-20 Comment
元ポスト:
関連:
- Making RL Fast, Finbarr Timbers, 2026.04
こーーれは必読では
Making RL Fast, Finbarr Timbers, 2026.04
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #SoftwareEngineering #Selected Papers/Blogs #reading #Initial Impression Notes #Asynchronous Issue Date: 2026-04-07 Comment
元ポスト:
Olmo3においてpost-trainingのインフラを同期から非同期に変更したことを含めて4倍高速化したことに関して、それをどのように実現したかに関するwrite up。気になる。
国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #ContextWindow #Quantization #PositionalEncoding #LLMServing #Slide #mid-training #DPO #GRPO #KV Cache #Compression Issue Date: 2026-04-07 Comment
元ポスト:
関連:
- PLaMo 3.0 Prime β版, PFN, 2026.03
関連:
- RoPE / YaRN
- [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
- [Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
- DPO
- [Paper Note] Direct Preference Optimization: Your Language Model is Secretly a Reward Model, Rafael Rafailov+, arXiv'23, 2023.05
- GRPO
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open
Language Models, Zhihong Shao+, arXiv'24
- RLはSFTよりも汎化性能に優れ、基本的には事前学習で獲得された能力を引き出す、という話
- [Paper Note] SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training, Tianzhe Chu+, ICML'25
- [Paper Note] Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yang Yue+, NeurIPS'25, 2025.04
- JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して, PFN, 2026.01
- LLM Serving系
- [Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
- [Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
- [Paper Note] AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, Ji Lin+, MLSys'24
- TurboQuant: Redefining AI efficiency with extreme compression, Google Research, 2026.03
うーーんおもしろかった!後でnote中の関連文献を紐づけてついでに復習したい
Why aren't we fine-tuning more?, Nate Meyvis, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #Finetuning Issue Date: 2026-03-30 Comment
元ポスト:
なぜFinetuningは普及していないのか?という点を考察しているブログ。ざっくり言うと、「コストの割に合わない」ということであり、具体的には
- Finetuningをしなくてもprompt engineeringで十分な性能が出てしまい
- Finetuningをしなくても、ドメイン固有のツールを組み合わせることでドメインspecificな挙動が実現できたり
- Finetuningを実施すると、新たなモデルが利用可能になった場合に再度Finetuningを実施するなどのオーバヘッドが生じ割に合わない
といった話が書かれている。個人的にはさらに言うと
- Finetuningを実施することでAI Safety周りの懸念が生じてしまい、Safetyに関する評価を厳密には実施しなければならない(特に何らかのチャットベースの応用の場合はなおさら)
というのもあると感じており、このモデルは安全ですと顧客にどのように説明するのか?という新たな説明責任が生じるという点もあるのかなと思う。
しかし、やはりFinetuningはあまり普及していないんだなあ、感
最大規模のオープン基盤モデルを各国仕様へ適応させる事後学習技術を開発, sakana.ai, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Blog #Bias #Japanese #Reading Reflections Issue Date: 2026-03-24 Comment
技術的な詳細は不明で、
> 事後学習では、日本の文化的・社会的文脈におけるバイアス是正のための独自データセットを構築し、以下のベンチマークに示す結果を得ました。
と記述されている。おそらく構築したデータセットに基づいてAlignmentをとるための事後学習(ベースモデルの能力を落としていないため Catastrophic Forgettingは起きておらず、同社がLoRA系の技術に力を入れていることを鑑みるとおそらく何らかのPEFT手法ではないかと推察)を実施しているのだと思われる。
元ポスト:
Reinforcement Learning from Human Feedback, Nathan Lambert, 2026.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #read-later Issue Date: 2026-03-20 Comment
元ポスト:
REINFORCE, PPO, GRPOの気持ちを理解するのに有用という所見:
Composer 2 のご紹介, Cursor, 2026.03
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #AIAgents #Evaluation #Coding #SoftwareEngineering #mid-training #read-later #Selected Papers/Blogs #ContextEngineering #Live #Reference Collection #Initial Impression Notes Issue Date: 2026-03-20 Comment
元ポスト:
所見:
Kimi-K2.5がベースらしいとのこと:
ベンチマークスコアに対する所見:
テクニカルレポートが出た:
https://cursor.com/resources/Composer2.pdf
元ポスト:
Kimi-K2.5をベースに、どのようにinstruction tuning後のモデルに対して継続事前学習、RLをし、GPT-5.4(high)級の性能を達成できたのか、ヒントがわかるかもしれない。
- [Paper Note] Kimi K2.5: Visual Agentic Intelligence, Kimi Team+, arXiv'26, 2026.02
所見:
所見:
RLによってpass@k(best-of-16)とpass@1の両方が改善する。既存研究では少なくともRLVRを用いた場合はPass@1は改善するが多様性が損なわれてPass@kの性能は改善しない ([Paper Note] Beyond Pass@1: Self-Play with Variational Problem Synthesis Sustains RLVR, Xiao Liang+, arXiv'25, 2025.08 , VibeVoice-1.5B, microsoft, 2025.08 )、という話があったが、Composer 2のレシピではそうではないようだ。どんなレシピだろう~と思ってさらっと関連しそうなところを見てみたが、詳細は書いてなさそうだ。
- [Paper Note] Beyond Pass@1: Self-Play with Variational Problem Synthesis Sustains RLVR, Xiao Liang+, arXiv'25, 2025.08
- VibeVoice-1.5B, microsoft, 2025.08
QA:
CursorBenchの解説:
要はrealisticなデータとシチュエーションでの評価に非常に重きを置いていて
- 実際のコーディングsessionのデータが用いられ、contamination-free
- 機能的な正しさのみならず、コードの品質、効率、挙動などの実用的な価値を意識し
- long horizonなタスクが多く取り入れられ
- Promptは曖昧性をうまく扱えるかを評価するために意図的にシンプルで短く
- CursorBenchのデータは継続的に更新される
- realisticなsessionデータだけでなく、その他の重要な挙動の評価(e.g., 指示追従, ルール/skilltのハンドリング, コメントの品質, editするか否かの判断の適切性など)のためのデータでも拡張されている
という感じらしい
ポイント解説:
- How Kimi, Cursor, and Chroma Train Agentic Models with RL, PHILSCHMID, 2026.03
self-summarizationによるcontextのcompressionを実施している
- [Paper Note] InftyThink+: Effective and Efficient Infinite-Horizon Reasoning via Reinforcement Learning, Yuchen Yan+, arXiv'26, 2026.02
- [Paper Note] Reasoning Cache: Continual Improvement Over Long Horizons via Short-Horizon RL, Ian Wu+, arXiv'26, 2026.02
- より長いホライズンに向けた Composer の学習, Cursor, 2026.03
所見:
Mistral Forge: Build your own frontier models, MistralAI, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Proprietary #mid-training #Data Issue Date: 2026-03-18 Comment
元ポスト:
エンタープライズ向けの社内の機密データによってLLMの(おそらく継続)事前学習、事後学習、RLを実施したカスタムモデルを構築するソリューションのようである。Dense, MoEなどのアーキテクチャも選択可能な模様。
ベースモデルなどが書かれていないように見えるが、Mistral製のオープンLLMがベースとなるのだろうか。
From REINFORCE to Dr. GRPO, Qingfeng's blog, 2025.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning Issue Date: 2026-03-17 Comment
元ポスト:
State of RL for reasoning LLMs, A. Weers, 2026.03
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #ReinforcementLearning #Blog Issue Date: 2026-03-17 Comment
元ポスト:
PPO → DPO → GRPO→ Rubrics, PROF. TOM YEH, 2026.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Video #Non-VerifiableRewards #One-Line Notes #Rubric-based Issue Date: 2026-03-05 Comment
Cameron R. Wolfe氏によるRubic-basedなRL(主にnon-verifiableなドメインへの適用)のチュートリアル。序盤はPPO, DPO, GRPOに関する解説
元ポスト:
FP8 trainingを支える技術 1, Kazuki Fujii, 2026.02
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Blog #mid-training #Selected Papers/Blogs #LowPrecision Issue Date: 2026-03-01
Training Recipes, PRIME Intellect Lab, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #ExperimentManagement #read-later #One-Line Notes Issue Date: 2026-02-28 Comment
公式によるPrime Intellect Labを用いたRLによるレシピの模様。これ読んだらだいたい実験できるようになるんではなかろうか。
元ポスト:
Swallowにおける 日英推論型大規模言語モデルの構築, 水木栄, 第26回LLM勉強会, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Japanese #mid-training #Selected Papers/Blogs #DataMixture #Initial Impression Notes Issue Date: 2026-02-27 Comment
元ポスト:
関連:
- Qwen3-Swallow & GPT-OSS-Swallow, Kazuki Fujii, 2026.02
まだしっかり読めていないのだが、適切なDataMixtureはどのようにして決めているのだろうか?
- 数学データによる学習がコーディングにのみ転移
- 英語データを邦訳したデータが学習に寄与するためcross-lingualで能力が転移する
- RLはpass@1を改善するが、Pass@10などの改善幅は縮小する
- この辺の話は資料中でも先行研究が引用されており、実際に確認されたということだと思われる
...
The persona selection model, Anthropic, 2026.02
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #LanguageModel #Alignment #Blog #Safety #Personality Issue Date: 2026-02-24 Comment
元ポスト:
Qwen3-Swallow & GPT-OSS-Swallow, Kazuki Fujii, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Evaluation #Japanese #mid-training #read-later #RLVR #Selected Papers/Blogs Issue Date: 2026-02-21 Comment
元ポスト:
関連:
- [Paper Note] Accelerating Large Language Model Training with 4D Parallelism and Memory Consumption Estimator, Kazuki Fujii+, arXiv'24, 2024.11
- FP8 trainingを支える技術 1, Kazuki Fujii, 2026.02
Rubric-Based Rewards for RL Extending the benefits of large-scale RL training to non-verifiable domains..., Cameron R. Wolfe, 2026.02
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #read-later #VerifiableRewards #Selected Papers/Blogs #Non-VerifiableRewards #Rubric-based Issue Date: 2026-02-17 Comment
元ポスト:
AI 101: "On-Policy Distillation Zeitgeist", Turing Post, 2026.02
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #On-Policy #One-Line Notes #SelfDistillation Issue Date: 2026-02-16 Comment
元ポスト:
最近よくみかける on-policy self-distillationに関する解説
QED-Nano: Teaching a Tiny Model to Prove Hard Theorems, LM Provers Team, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #Mathematics #SmallModel #Proofs #Rubric-based #Initial Impression Notes Issue Date: 2026-02-16 Comment
元ポスト:
ポイント解説:
早くもReasoning Cacheが利用されている:
- [Paper Note] Reasoning Cache: Continual Improvement Over Long Horizons via Short-Horizon RL, Ian Wu+, arXiv'26, 2026.02
4B級のモデルで特定タスクに特化したモデルを作りたい場合に非常に役立ちそうなレシピ
Introducing Lab: The Full-Stack Platform for Training your Own Models, Prime Intellect, 2026.02
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP #LanguageModel #Infrastructure #ReinforcementLearning #AIAgents #Blog #ScientificDiscovery #Selected Papers/Blogs #One-Line Notes #Reference Collection #Environment Issue Date: 2026-02-11 Comment
元ポスト:
事後学習、特にAgenticな研究の民主化のためのプラットフォームの提供
所見:
利用例 (Environment Hub):
Composer 1.5 のご紹介, Cursor Team, 2026.02
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #AIAgents #GenerativeAI #Blog #Coding #SoftwareEngineering #One-Line Notes #Scalability Issue Date: 2026-02-10 Comment
事前学習モデルに対して、RLをさらにスケールさせることで性能が継続的に向上し、自己要約能力も備えさせることでcontext windowの問題に対処しているとのこと。
(関連)Composer: 強化学習で構築する高速フロンティアモデル:
https://cursor.com/ja/blog/composer
Together Evaluations now supports comparing top commercial APIs vs. open source models, together.ai, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog #PEFT(Adaptor/LoRA) #One-Line Notes Issue Date: 2026-02-05 Comment
元ポスト:
OpenLLMのFinetuningをサポートしているプラットフォームにおいて、データセットをアップロードすると
- Prompt optimization (GEPA)
- Fine-tuning (PEFT + full finetuning)
の両方を実施し、コスト-性能のパレート最適なポイントを評価し、かつGPT等とのProprietaryモデルとの比較もした評価もできるようになりました、といった話の紹介。
GEPA:
- [Paper Note] GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning, Lakshya A Agrawal+, ICLR'26, 2025.07
Finetuningがサポートされているモデル群:
-
https://docs.together.ai/docs/fine-tuning-models
PLaMo 2.2 Primeをリリースしました, PFN, 2026.01
Paper/Blog Link My Issue
#Article #Multi #NLP #LanguageModel #Supervised-FineTuning (SFT) #Proprietary #Japanese #DPO #InstructionFollowingCapability #Medical #RolePlaying Issue Date: 2026-01-29 Comment
関連:
- [Paper Note] Generalizing Verifiable Instruction Following, Valentina Pyatkin+, NeurIPS'25, 2025.07
- JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して, PFN, 2026.01
non-thinkingモデルである点に注意
Accelerating Diffusion Models with an Open, Plug-and-Play Offering, Nvidia, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #Tools #NLP #DiffusionModel #TextToImageGeneration #Distillation #2D (Image) #Editing #3D (Video) #TextToVideoGeneration #ImageToTextGeneration #TrainingFramework Issue Date: 2026-01-29 Comment
元ポスト:
self forcingも実装されている
- [Paper Note] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion, Xun Huang+, NeurIPS'25
Continual Learning with RL for LLMs, CAMERON R. WOLFE, PH.D., 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog Issue Date: 2026-01-26 Comment
元ポスト:
RLHF Book - Code Examples, Nathan Lambert, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #Selected Papers/Blogs #MinimalCode #Initial Impression Notes Issue Date: 2026-01-26 Comment
元ポスト:
Qwen 1.7Bモデルでの様々なRLアルゴリズムでのミニマルコード集。学習曲線つきで非常に実用的
A well known important feature to stabilize RL training is implementing the LM head in fp32 precision to help with gradients ... , Nathan Lambert, X, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Post #Stability #One-Line Notes Issue Date: 2026-01-24 Comment
関連:
- MiniMax-M1, MiniMax, 2025.06
- [Paper Note] MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning
Attention, MiniMax+, arXiv'25, 2025.06
RLを安定化するためのtipsとそれによりMiniMax M1のplotが再現できたという話な模様。RLはこういった細かいテクニックが大事だと思うので、共有して頂けるのは大変ありがたい。
関連:
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
- train-inference-gap && ReinforcementLearning ラベルが紐づいたissueも参照のこと
IsoCompute Playbook: Optimally Scaling Sampling Compute for RL Training of LLMs, Cheng+, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #KeyPoint Notes #Scalability Issue Date: 2026-01-22 Comment
元ポスト:
RLにおけるロールアウト数nのスケーリングは、シグモイド関数のような形状になりどこかのポイントで明確にサチるポイントが存在し、それ以上増やしても少量のゲインしか得られないポイントが存在する。これらのトレンドはeasy/hardな問題の双方で共通して見出されるが、原因は大きく異なっており、nを大きくするとeasyな問題ではworst@kが改善し、hardな問題ではbest@kが改善することで性能が向上する。つまり、簡単な問題に対してはより安定して正解できてミスが減り、困難な問題に対しては探索空間が広がり1回でも正解できる可能性が高まる。また、また、ハードウェア制約によりバッチサイズは基本的に固定されるので、ロールアウト数nと1バッチあたりに含められる問題数はトレードオフの関係となる。
このロールアウト数nに関する性質は、異なるベースモデル間で共通して生じるが、サチるポイントが異なる。問題セットのサイズで見ると、サイズが小さいと早々にoverfitするためサチるnのポイントも早くなる。問題難易度の分布がmixしているものであればnによるスケーリングのトレンドは維持されるが、評価する際のmetricsによってサチるぽいんとが左右される。nのスケーリングはdownstreamタスクの性能も向上させる。
と言った話らしい。
Narrow Misalignment is Hard, Emergent Misalignment is Easy, Turner+, 2025.07
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Alignment #PEFT(Adaptor/LoRA) #One-Line Notes #EmergentMisalignment Issue Date: 2026-01-15 Comment
openreview: https://openreview.net/forum?id=q5AawZ5UuQ
一般的にevilになることを学習することが、狭義にevilになるよりも簡単だ、という知見を示した研究とのこと。
SETA: Scaling Environments for Terminal Agents, CAMEL-AI, 2026.01
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #AIAgents #SyntheticData #Evaluation #Blog #Repository #SoftwareEngineering Issue Date: 2026-01-12 Comment
元ポスト:
HF: https://huggingface.co/datasets/camel-ai/seta-env
GitHubのreadmeに日本語がある!?
NousCoder-14B: A Competitive Olympiad Programming Model, Joe Li, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #Coding #OpenWeight #read-later Issue Date: 2026-01-09 Comment
元ポスト:
HF:
https://huggingface.co/NousResearch/NousCoder-14B
Apache 2.0
PipelineRLを採用している模様。興味深い。
Introducing LFM2.5: The Next Generation of On-Device AI, LiquidAI, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #SmallModel #OpenWeight #Japanese #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #AudioLanguageModel Issue Date: 2026-01-09 Comment
元ポスト:
日本語に特化した言語モデルも存在し、Sarashina2.2-1b-instruct-v0.1, TinySwallow-1.5B-InstructよりもJMMLU, M-IFEval (ja), GSM8K (ja)においてより高い性能を発揮している。
LFM2.5-1.2B-Base: [Hugging Face](
https://huggingface.co/LiquidAI/LFM2.5-1.2B-Base)
LFM2.5-1.2B-Instruct: [Hugging Face](
https://huggingface.co/LiquidAI/LFM2.5-1.2B-Instruct),
[LEAP](
https://leap.liquid.ai/models?model=lfm2.5-1.2b-instruct),
[Playground](
https://playground.liquid.ai/chat?model=cmk1jyp8f000204i56yy76uwh)
LFM2.5-1.2B-JP: [Hugging Face](
https://huggingface.co/LiquidAI/LFM2.5-1.2B-JP),
[LEAP](
https://leap.liquid.ai/models?model=lfm2.5-1.2b-jp)
LFM2.5-VL-1.6B: [Hugging Face](
https://huggingface.co/LiquidAI/LFM2.5-VL-1.6B),
[LEAP](
https://leap.liquid.ai/models?model=lfm2.5-vl-1.6b),
[Playground](
https://playground.liquid.ai/chat?model=cmk0wefde000204jp2knb2qr8),
[Demo](
https://huggingface.co/spaces/LiquidAI/LFM2.5-VL-1.6B-WebGPU)
LFM2.5-Audio-1.5B: [Hugging Face](
https://huggingface.co/LiquidAI/LFM2.5-Audio-1.5B),
[LEAP](
https://leap.liquid.ai/models?model=lfm2.5-audio-1.5b),
[Playground](
http://playground.liquid.ai/talk)
LiquidAIのモデルは日本語に特化したモデルが多く存在するのが特徴的に感じる。
Deriving the DPO Loss from First Principles, aayush garg, 2025.12
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #DPO #read-later Issue Date: 2025-12-31 Comment
元ポスト:
関連:
- Deriving the PPO Loss from First Principles, aayush garg, 2025.12
ノーコードで言語モデルの「学習」を体験できるMN-Core Playground _ SLM Customizeの遊び方, PFN, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #SmallModel #Japanese Issue Date: 2025-12-27 Comment
元ポスト:
Deriving the PPO Loss from First Principles, aayush garg, 2025.12
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #read-later Issue Date: 2025-12-27 Comment
元ポスト:
【LLM強化学習④】強化学習のコツ(後編), Yuu Jinnai, JSAI公式チャンネル
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Video #read-later Issue Date: 2025-12-25 Comment
元ポスト:
OpenHands trajectories with Qwen3 Coder 480B, Nebius blog, 2025.12
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #ReinforcementLearning #AIAgents #Blog #Coding #Reasoning #SoftwareEngineering Issue Date: 2025-12-24 Comment
元ポスト:
Hot topics in RL, Kimbo, X, 2025.12
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #Post #Diversity #train-inference-mismatch Issue Date: 2025-12-22 Comment
ロールアウト側のエンジンと、学習側のエンジンのトークンのlogprobのミスマッチによりon-policy RLを実施しているつもりが実はoff policyになってしまっているという話と
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
- [Paper Note] Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale
Thinking Model, Ling Team+, arXiv'25, 2025.10
- [Paper Note] Stabilizing MoE Reinforcement Learning by Aligning Training and
Inference Routers, Wenhan Ma+, arXiv'25, 2025.10
長いロールアウトを待っている間がアイドルタイムとなり学習が非常に遅くなる問題を、長すぎるロールアウトは待たないでモデルの重みをロールアウトの途中でもかけてしまい、新しいポリシーでロールアウトを継続すると学習は崩壊せずに高速化できるよ(=in flight updates)という話と
- [Paper Note] PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence
Generation, Alexandre Piché+, arXiv'25, 2025.09
- PipelineRL, Piche+, ServiceNow, 2025.04
RLVRはもともとモデルが事前学習時に保持しているReasoningの能力を広げるわけではなく効率化するだけだよ、という主張と、
- [Paper Note] Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yang Yue+, NeurIPS'25, 2025.04
効率化するだけという主張と、Reasoning能力を拡大しているよ、という相反する主張がコミュニティでされているがそれらをphysics of language modelsに則り完全にコントロールされた条件下で実験し、どのような条件でどのような挙動になるかを明らかにしたよ、という話
- [Paper Note] On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models, Charlie Zhang+, arXiv'25, 2025.12
RLVRはPass@1を報酬としているとみなせるが、それをPass@kにすることで、モデルがRL中に探索する能力が向上し、downstreamタスクのPass@kが向上するよ
- [Paper Note] Pass@k Training for Adaptively Balancing Exploration and Exploitation of Large Reasoning Models, Zhipeng Chen+, arXiv'25, 2025.08
といったこの辺の話がホットトピックとして挙げられている。
train-inference-mismatchについては、以下もおもしろかった:
- SID-1 Technical Report: Test-Time Compute for Retrieval, SID Research, 2025.12
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
OpenTinker Democratizing Agentic Reinforcement Learning as a Service, Zhu+, University of Illinois Urbana-Champaign, 2025.12
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Tools #NLP #LanguageModel #ReinforcementLearning #Blog #KeyPoint Notes #TrainingFramework Issue Date: 2025-12-22 Comment
元ポスト:
code: https://github.com/open-tinker/OpenTinker
関連:
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- Tinker is a training API for {developers, builders, researchers}, THINKING MACHINES, 2025.10
Tinkerに着想を得てクライアントとサーバを分離した設計になっており、バックエンド側のGPUクラスタでサーバを一度起動するだけでクライアント側がスケジューラにジョブを送ればRLが実行される(ローカルにGPUは不要)。クライアント側はRLを実施したい環境のみをローカルで定義しコンフィグをロードしfitを呼び出すだけ。verlよりもよりも手間が省けているらしい。
リポジトリを見る限りは、verlをRLのコアエンジンとして使ってる模様。
Introducing MiMo-V2-Flash, Xiaomi, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #AttentionSinks #Selected Papers/Blogs #Reference Collection Issue Date: 2025-12-17 Comment
technical report:
https://github.com/XiaomiMiMo/MiMo-V2-Flash/blob/main/paper.pdf
HF:
https://huggingface.co/XiaomiMiMo/MiMo-V2-Flash
元ポスト:
関連:
ポイント解説:
attention sink(というより恐らくsink token)により性能が向上している:
言及されているpost trainingが有用らしい:
所見:
省パラメータでtop-tierのモデルに肉薄する方法のヒントがあるかもしれない。
解説:
RL Learning with LoRA: A Diverse Deep Dive, kalomaze's kalomazing blog, 2025.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #ReinforcementLearning #Blog #PEFT(Adaptor/LoRA) #read-later Issue Date: 2025-11-10 Comment
元ポスト:
所見:
The Smol Training Playbook: The Secrets to Building World-Class LLMs, Allal+, HuggingFace, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #Dataset #LanguageModel #Infrastructure #Selected Papers/Blogs Issue Date: 2025-10-31 Comment
元ポスト:
On-Policy Distillation, Thinking Machines, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Distillation #read-later #Selected Papers/Blogs #On-Policy Issue Date: 2025-10-27 Comment
元ポスト:
所見:
解説:
LMMs Engine, EvolvingLMMs-Lab, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP #MultiModal #Repository #Selected Papers/Blogs #UMM #One-Line Notes Issue Date: 2025-10-27 Comment
元ポスト:
事前学習済みのLLM, VLM, dLM, DiffusionModelなどからUMMを学習できる事後学習フレームワーク。
LigerKernelでメモリ使用量を30%削減し、SparseAttentionもサポートし、Muon Optimizerもサポートしている。
ProofOptimizer: Training Language Models to Simplify Proofs without Human Demonstrations, Gu+, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Mathematics #Proofs #Simplification Issue Date: 2025-10-22 Comment
pj page: https://proof-optimizer.github.io
LLMの通常利用時の応答も(おそらくベンチマークに最適化されているせいで)長すぎると思っているけど、数学の証明も長いんだなあ、と感じた
How Well Does RL Scale?, Toby Ord, 2025.10
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #Test-Time Scaling #Scaling Laws #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-10-21 Comment
元ポスト:
OpenAIやAnthropicが公表している学習に関するplot(と筆者の様々なアカデミアの研究の知見)に基づいて、RLによるスケーリングは、事前学習やTest-time Scalingよりも計算量の観点で効率が悪い、ということを分析している模様。
> So the evidence on RL-scaling and inference-scaling supports a general pattern:
>- a 10x scaling of RL is required to get the same performance boost as a 3x scaling of inference
> - a 10,000x scaling of RL is required to get the same performance boost as a 100x scaling of inference
>
> In general, to get the same benefit from RL-scaling as from inference-scaling required twice as many orders of magnitude. That’s not good.
その上で、RLによるコストが事前学習のコストと同等かそれ以上となったときに、モデルの性能をスケールさせる場合のコストが爆発的に増加することを指摘している(初期のRLによるコストが小さければ事前学習やtest-time scalingのデータを増やすよりも効率がよいスケーリング手法となっていたが、RLのコストが大きくなってくるとスケールさせる際の金額の絶対値が大きくなりすぎるという話)。
Andrej Karpathy — AGI is still a decade away, DWARKESH PATEL, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #MachineLearning #NLP #LanguageModel #ReinforcementLearning #AIAgents #In-ContextLearning #Blog #RewardHacking #Diversity #Selected Papers/Blogs #PRM #Generalization #Cultural #Emotion #ContinualLearning Issue Date: 2025-10-20 Comment
元ポスト:
関連:
- In-context Steerbility: [Paper Note] Spectrum Tuning: Post-Training for Distributional Coverage and
In-Context Steerability, Taylor Sorensen+, arXiv'25, 2025.10
(整理すると楽しそうなので後で関連しそうな研究を他にもまとめる)
とても勉強になる!AIに代替されない20%, 1%になるには果たして
所見:
PFN LLMセミナー, PFN, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #AIAgents #LLMServing #Japanese Issue Date: 2025-10-05 Comment
元ポスト:
Tinker is a training API for {developers, builders, researchers}, THINKING MACHINES, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #PEFT(Adaptor/LoRA) #API #KeyPoint Notes Issue Date: 2025-10-03 Comment
元ポスト:
THINKING MACHINESによるOpenWeightモデルをLoRAによってpost-trainingするためのAPI。QwenとLlamaをベースモデルとしてサポート。現在はBetaでwaitlistに登録する必要がある模様。
(Llamaのライセンスはユーザ数がアクティブユーザが7億人を超えたらMetaの許諾がないと利用できなくなる気がするが、果たして、とふと思った)
この前のブログはこのためのPRも兼ねていたと考えられる:
- LoRA Without Regret, Schulman+, THINKING MACHINES, 2025.09
ドキュメントはこちら:
https://tinker-docs.thinkingmachines.ai
Tinkerは、従来の
- データセットをアップロード
- 学習ジョブを走らせる
というスタイルではなく、ローカルのコードでstep単位の学習のループを書き以下を実行する:
- forward_backwardデータ, loss_functionをAPIに送る
- これにより勾配をTinker側が蓄積する
- optim_step: 蓄積した勾配に基づいてモデルを更新する
- sample: モデルからサンプルを生成する
- save_state等: 重みの保存、ロード、optimizerのstateの保存をする
これらstep単位の学習に必要なプリミティブなインタフェースのみをAPIとして提供する。これにより、CPUマシンで、独自に定義したloss, dataset(あるいはRL用のenvironment)を用いて、学習ループをコントロールできるし、分散学習の複雑さから解放される、という代物のようである。LoRAのみに対応している。
なお、step単位のデータを毎回送信しなければならないので、stepごとに通信のオーバヘッドが発生するなんて、Tinker側がGPUを最大限に活用できないのではないか。設計としてどうなんだ?という点については、下記ブログが考察をしている:
- Anatomy of a Modern Finetuning API, Benjamin Anderson, 2025.10
ざっくり言うとマルチテナントを前提に特定ユーザがGPUを占有するのではなく、複数ユーザで共有するのではないか、adapterの着脱のオーバヘッドは非常に小さいのでマルチテナントにしても(誰かのデータの勾配計算が終わったらLoRAアダプタを差し替えて別のデータの勾配計算をする、といったことを繰り返せば良いので待機時間はかなり小さくなるはずで、)GPUが遊ぶ時間が生じないのでリソースをTinker側は最大限に活用できるのではないか、といった考察/仮説のようである。
所見:
Asyncな設定でRLしてもSyncな場合と性能は同等だが、学習が大幅に高速化されて嬉しいという話な模様(おまけにrate limitが現在は存在するので今後よりブーストされるかも
Why GPT-5 used less training compute than GPT-4.5 (but GPT-6 probably won’t), EPOCH AI, 2025.09
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #NLP #LanguageModel #ChatGPT #Blog Issue Date: 2025-09-29 Comment
元ポスト:
LoRAの進化:基礎から最新のLoRA-Proまで , 松尾研究所テックブログ, 2025.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #Blog #PEFT(Adaptor/LoRA) Issue Date: 2025-09-22 Comment
元ポスト:
関連:
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
- LoRA+: Efficient Low Rank Adaptation of Large Models, Soufiane Hayou+, N/A, ICML'24
slime, THUDM & Zhihu, 2025.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #ReinforcementLearning #AIAgents #Selected Papers/Blogs #Asynchronous #TrainingFramework Issue Date: 2025-09-02 Comment
元ポスト:
GLM-4.5のRL学習に利用されたフレームワーク
- [Paper Note] GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models, GLM-4. 5 Team+, arXiv'25
RLinf: Reinforcement Learning Infrastructure for Agentic AI, RLinf, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Library #ReinforcementLearning #Robotics #VisionLanguageActionModel #EmbodiedAI #TrainingFramework Issue Date: 2025-09-01 Comment
元ポスト:
The Bitter Lesson for RL: Verification as the key to Reasoning LLMs, Rishabh Agarwal, 2025.06
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Slide #read-later #RLVR #Author Thread-Post Issue Date: 2025-08-26 Comment
元ポスト:
著者ポスト:
大規模言語モデルPLaMo 2シリーズの事後学習, PFN, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog Issue Date: 2025-07-31 Comment
元ポスト:
New methods boost reasoning in small and large language models, Zhang+, Microsoft, 2025.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Reasoning #Mathematics #SmallModel #Generalization #One-Line Notes Issue Date: 2025-07-08 Comment
元ポスト:
要はLLMのreasoningに関して
- SLMの推論能力改善
- 数学的な推論能力の改善
- ドメインを跨いだ汎化
の3つについてMSRで研究されたいくつかの文献が紹介されている。
rLLM, Agentica, 2025.06
Paper/Blog Link My Issue
#Article #NLP #Library #ReinforcementLearning #AIAgents #Initial Impression Notes #TrainingFramework Issue Date: 2025-07-04 Comment
>rLLM is an open-source framework for post-training language agents via reinforcement learning. With rLLM, you can easily build their custom agents and environments, train them with reinforcement learning, and deploy them for real-world workloads.
なるほど。
バックボーンにはverlが採用されており、シンプルかつ統一的なインタフェースでカスタムエージェントが学習できる模様?
https://rllm-project.readthedocs.io/en/latest/#key-features
元ポスト:
関連:
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
v0.2がリリースされ、任意のagentia programの学習がサポートされた模様(マルチエージェントや複雑なワークフローに基づくものなど):
Nemo-RL, Nvidia, 2025.05
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #ReinforcementLearning #TrainingFramework Issue Date: 2025-06-25
LLM-jp-3.1 シリーズ instruct4 の公開, LLM-jp, 2025.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #Dataset #LanguageModel #Evaluation #Blog #OpenWeight #Japanese #OpenSource Issue Date: 2025-06-25 Comment
関連
- [Paper Note] Instruction Pre-Training: Language Models are Supervised Multitask Learners, Daixuan Cheng+, arXiv'24, 2024.06
- [Paper Note] Preference Fine-Tuning of LLMs Should Leverage Suboptimal, On-Policy Data, Fahim Tajwar+, ICML'24
- [Paper Note] AnswerCarefully: A Dataset for Improving the Safety of Japanese LLM Output, Hisami Suzuki+, arXiv'25
POLARIS: A Post-Training Recipe for Scaling Reinforcement Learning on Advanced Reasoning Models,
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #Initial Impression Notes Issue Date: 2025-06-21 Comment
元ポスト:
PJで利用されているRLライブラリ:
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
AIME2025のみの評価だが4Bでこの性能…?
2025年度人工知能学会全国大会チュートリアル講演「深層基盤モデルの数理」, Taiji Suzuki, 2025.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #MachineLearning #NLP #LanguageModel #Transformer #Chain-of-Thought #In-ContextLearning #Attention #DiffusionModel #SSM (StateSpaceModel) #Slide #Scaling Laws Issue Date: 2025-05-31 Comment
元ポスト:
[Paper Note] Spurious Rewards: Rethinking Training Signals in RLVR, Shao+, 2025.05
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Mathematics #SmallModel #RLVR #Reference Collection #Author Thread-Post Issue Date: 2025-05-27 Comment
元ポスト:
参考(考察):
参考(考察):
こちらでもQwen2.5 MATH 7b を用いて検証しているが、コンタミネーションの問題が仮に本当だとしたら、どう影響するだろうか。スレッド中のグラフもMATH500(Qwen2.5においてコンタミの可能性がある)の性能を示している。
Stanford Alpaca: An Instruction-following LLaMA Model, Taori +, 2023.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 Comment
今更ながらメモに追加。アカデミアにおけるOpenLLMに対するInstruction Tuningの先駆け的研究。
ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
Paper/Blog Link My Issue
#Article #NLP #Library #Supervised-FineTuning (SFT) #Blog #OpenWeight #MoE(Mixture-of-Experts) #One-Line Notes #Author Thread-Post Issue Date: 2025-05-11 Comment
元ポスト:
Megatron-SWIFTというAlibaba製のライブラリを利用しQwen3の継続事前学習とSFTを実施する方法を、ベストプラクティスに則って記述し、かつ著者自身が学習したモデルも公開している。(おそらくインスタンス代は自腹なので)すごい...!!
Megatron-SWIFTはMoEアーキテクチャを採用したモデルであれば、DeepSpeed Zero3 [^1]と比べて10倍程度のスループットで学習できる模様(早い)。一方MoEアーキテクチャでないモデルの場合はそこまで大きな差はない。
[^1]: A100 80GB 2ノードでは、Qwen3-30B-A3Bは、DeepSpeed-Zero2ではOOMとなり載らないようだ…。なんとリソースに厳しいこと…(涙)
Qwen3, Qwen Team, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #InstructionTuning #Blog #LongContext #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) #KeyPoint Notes #Reference Collection Issue Date: 2025-04-29 Comment
- 119言語をサポート
- MoEモデル [Paper Note] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, Noam Shazeer+, ICLR'17
- 30B-A3B / 235B-A22N
- 128K context window
- Qwen2.5はMoEを採用していないので新たなアーキテクチャとなる
- Denseモデル(非MoEモデル)も公開
- 0.6B -- 32B
- 32K -- 128K context window
- Thinking/Non-thinking の切り替えが切り替えが可能
- スイッチは自動的に実施されるが、ユーザが明示的に `/think`, `/no_think` を user_promptの末尾に追加することで制御することも可能
- Pre-training
- データ
- 36 trillion tokensによって学習(Qwen-2.5の2倍)
- 学習データではwebデータに加えて、PDF-likeな文書群からQwen2.5-VL Qwen2.5-VL-32B-Instruct, Qwen Team, 2025.03
によってテキストを抽出し、Qwen2.5 で抽出された内容の品質を改善し利用
- また、math / code に関するデータを追加するために、Qwen2.5-Math / Qwen2.5-Coderを用いて合成データを作成(textbooks / QA pairs / code snippets [Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
)
- 事前学習のステップ
- S1: context長が4kの30 trillion tokenで事前学習
- S2: STEM / coding / reasoning task などのknowledge-intensiveデータの比率を増やして継続事前学習 (これがおそらく 5 trillion token程度?)
- Final Stage: context長を32kに拡大し高品質なlong-context dataで継続事前学習
- これによりBaseモデルが完成し、Qwen3-235B全体のうち10%程度のActive Parameterの利用するだけで(i.e., 22Bで)、Qwen2.5-72B Baseと同等以上の性能達成
- Post-training
- S1: long-CoT cold start
- 数学/coding/logical reasoning/STEMなどの多様なlong CoTデータを用いてSFT [Paper Note] s1: Simple test-time scaling, Niklas Muennighoff+, EMNLP'25, 2025.01
- S2: reasoning-based RL
- rule-based (verifiable) rewards によるRL DeepSeek-R1, DeepSeek, 2025.01
- S1/S2の流れは [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
に有効性が示されている通り、long CoT DataによるSFT -> RLを実施
- S3: thinking mode fusion
- S2データを用いてlong CoTデータとinstruction tuningデータ(非Long CoT)を生成し、Thinking/Non-thinkingを自動的に選択し生成するように学習(SFT or RLは記述なし)
- S4: general RL
- 20以上の一般的なドメインのタスクを通じて一般的な能力の向上と、safetyに関するalignmentの実施(e.g., instruction following, format following, agent能力など)
BestPracticeに関するポスト:
解説:
強化学習「GRPO」をCartPoleタスクで実装しながら解説, 小川雄太郎, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #GRPO Issue Date: 2025-02-19 Comment
元ポスト:
LLM Datasets, mlabonne, 2025.01
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Supervised-FineTuning (SFT) #Repository #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-01-25 Comment
LLMの事後学習用のデータをまとめたリポジトリ
現在も更新されている。
How to fine-tune open LLMs in 2025 with Hugging Face, PHILSCHMID, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #python #Blog #SoftwareEngineering #One-Line Notes Issue Date: 2025-01-25 Comment
SFTTrainerを用いたLLMのSFTについて、実用的、かつ基礎的な内容がコード付きでまとまっている。
How to align open LLMs in 2025 with DPO & and synthetic data, PHILSCHMID, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #python #Blog #SoftwareEngineering #DPO #KeyPoint Notes Issue Date: 2025-01-25 Comment
元ポスト:
- DPOの概要やRLHFと比較した利点
- ルールベース、あるいはLLM as a Judgeを用いたOn-policy preference pair(現在のSFTしたモデルの出力から生成したpreference data)の作り方とその利点(現在のモデルのoutput distributionを反映しているので学習が効率化される)
- 環境構築方法
- DPOTrainer/TRLParserの使い方/DPODatasetの作り方
- DPOのハイパーパラメータβの意味合い
- DPOではSFTと比べて10-100x小さい学習率を使う必要があること
- Evaluation Harnessを用いた評価方法
- TGIを用いたモデルのデプロイとテスト
などが丁寧なサンプルコードと注釈、reference付きで説明されている。
To fine-tune or not to fine-tune, Meta, 2024.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #RAG(RetrievalAugmentedGeneration) #Blog #PEFT(Adaptor/LoRA) #Catastrophic Forgetting #KeyPoint Notes Issue Date: 2025-01-02 Comment
LLMをSFTする際の注意点やユースケースについて記述されている。
- full parameterのファインチューニングやPEFT手法のピークGPUメモリ
- full parameterのファインチューニングではcatastrophic forgettingに気をつける必要があること
- Finetuningが有用なユースケースとして以下が挙げられている
- トーン、スタイル、フォーマットのカスタマイザーション
- prompt engineeringやICLで達成するには困難なAccuracyの向上やエッジケースへの対応
- ドメイン適応
- より大きいモデルを蒸留することによるコスト削減
- 新たなタスクへの適応や能力の獲得
また、RAGとFinetuningどちらを選択すべきかに関する話題も記述されている(が、多くの場合はハイブリッドアプローチがベストだ、といった話も書いてある)。
元ポスト:
LLMを数学タスクにアラインする手法の系譜 - GPT-3からQwen2.5まで, bilzard, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #Chain-of-Thought #Reasoning #Mathematics #Reading Reflections Issue Date: 2024-12-27 Comment
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
において、数学においてモデルのパラメータ数のスケーリングによって性能改善が見込める学習手法として、モデルとは別にVerifierを学習し、モデルが出力した候補の中から良いものを選択できるようにする、という話の気持ちが最初よくわからなかったのだが、後半のなぜsample&selectがうまくいくのか?節を読んでなんとなく気持ちが理解できた。SFTを進めるとモデルが出力する解放の多様性が減っていくというのは、興味深かった。
しかし、特定の学習データで学習した時に、全く異なるUnseenなデータに対しても解法は減っていくのだろうか?という点が気になった。あとは、学習データの多様性をめちゃめちゃ増やしたらどうなるのか?というのも気になる。特定のデータセットを完全に攻略できるような解法を出力しやすくなると、他のデータセットの性能が悪くなる可能性がある気がしており、そうするとそもそもの1shotの性能自体も改善していかなくなりそうだが、その辺はどういう設定で実験されているのだろうか。
たとえば、
- [Paper Note] Beyond Full Fine-tuning: Harnessing the Power of LoRA for Multi-Task Instruction Tuning, Xin+, LREC-COLING'24
などでは、
- [Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
のような1600を超えるようなNLPタスクのデータでLoRAによりSFTすると、LoRAのパラメータ数を非常に大きくするとUnseenタスクに対する性能がfull-parameter tuningするよりも向上することが示されている。この例は数学に特化した例ではないが、SFTによって解法の多様性が減ることによって学習データに過剰適合して汎化性能が低下する、というのであれば、この論文のことを鑑みると「学習データにoverfittingした結果他のデータセットで性能が低下してしまう程度の多様性の学習データしか使えていないのでは」と感じてしまうのだが、その辺はどうなんだろうか。元論文を読んで確認したい。
とても勉強になった。
記事中で紹介されている
> LLMを使って複数解法の候補をサンプリングし、その中から最適な1つを選択する
のルーツは
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
とのことなので是非読みたい。
この辺はSelf-Consistency
- [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
あたりが最初なのかと思っていた。
RLHF_DPO 小話, 和地瞭良_ Akifumi Wachi, 2024.04
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #LanguageModel #Alignment #RLHF #Blog #DPO #Selected Papers/Blogs #Reading Reflections Issue Date: 2024-12-18 Comment
めちゃめちゃ勉強になる…
SmolLM2, 2024.11
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #InstructionTuning #SyntheticData #OpenWeight #OpenSource #One-Line Notes Issue Date: 2024-11-21 Comment
元ポスト:
Orca-AgenInstruct-1M microsoft/orca-agentinstruct-1M-v1, Microsoft, 2024.11
よりもSmolLMのSFTで各種ベンチで高い性能を獲得
Unsloth, unslothai, 2024.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #Supervised-FineTuning (SFT) #InstructionTuning #PEFT(Adaptor/LoRA) #Selected Papers/Blogs #One-Line Notes #TrainingFramework Issue Date: 2024-10-08 Comment
single-GPUで、LLMのLoRA/QLoRAを高速/省メモリに実行できるライブラリ
現在でも鉄板
Reflection 70B, GlaiveAI, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #OpenWeight #SelfCorrection #KeyPoint Notes #Reference Collection #Author Thread-Post Issue Date: 2024-09-06 Comment
ただまあ仮に同じInputを利用していたとして、promptingは同じ(モデルがどのようなテキストを生成し推論を実施するかはpromptingのスコープではない)なので、そもそも同じInputなのでfair comparisonですよ、という話に仮になるのだとしたら、そもそもどういう設定で比較実験すべきか?というのは検討した方が良い気はする。まあどこに焦点を置くか次第だと思うけど。
エンドユーザから見たら、reflectionのpromptingのやり方なんてわからないよ!という人もいると思うので、それを内部で自発的に実施するように学習して明示的にpromptingしなくても、高い性能を達成できるのであれば意味があると思う。
ただまあ少なくとも、参考でも良いから、他のモデルでもreflectionをするようなpromptingをした性能での比較結果も載せる方が親切かな、とは思う。
あと、70Bでこれほどの性能が出ているのはこれまでにないと思うので、コンタミネーションについてはディフェンスが必要に思う(他のモデルがそのようなディフェンスをしているかは知らないが)。
追記
→ 下記記事によると、LLM Decontaminatorを用いてコンタミネーションを防いでいるとのこと
https://github.com/lm-sys/llm-decontaminator
Reflection自体の有用性は以前から示されている。
参考: Self-Reflection in LLM Agents: Effects on Problem-Solving Performance, Matthew Renze+, N/A, arXiv'24
, [Paper Note] Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection, Akari Asai+, ICLR'24, 2023.10
, [Paper Note] AnyTool: Self-Reflective, Hierarchical Agents for Large-Scale API Calls, Yu Du+, ICML'24, 2024.02
, [Paper Note] Automatically Correcting Large Language Models: Surveying the landscape of diverse self-correction strategies, Liangming Pan+, TACL'24, 2023.08
ollamaで実際に動かして日本語でのQAを試している記事。実際のアウトプットやreflectionの内容が確認でき、おもしろい。
システムプロンプトで< thinking >タグでInputに対して推論し、< output >タグ内で最終出力を行い、推論過程で誤りがある場合は< reflection >タグを用いて修正するように指示している。
おそらく、thinkingタグ内の思考過程でモデルが誤りに気づいた場合は、thinkingタグの途中でreflectionタグが出力され、その時点でCoTが修正されるようである(もしくはoutputとthinkingの中間)。このため、誤ったCoTに基づいてOutputが生成される頻度が減少すると考えられる。
このような挙動はおそらく、reflection用の学習データでSFTしないとできないと思うので
(たとえば、ReflectionタスクをするようなデータでSFTをしていない場合、出力の途中で誤りを検出し出力を修正するという挙動にはならず、回答として自然な文を最後までoutputすると思う。その後でreflectionしろと促すことはpromptingでできるかもしれないが、そもそもreflectionする能力があまり高くない可能性があり、うまく修正もしてくれないかも)
reflectionの能力を高めるようなデータでSFTをしていないモデルで似たようなpromptingをしても、うまくいかない可能性があるので注意が必要だと思われる。
参考:
https://note.com/schroneko/n/nae86e5d487f1
開発者曰く、HFに記載の正しいシステムプロンプトを入れないと、適切に動作しないとのこと。
元ツイート:
どうやら初期にアップロードされていたHFのモデルはweightに誤りがあり、挙動がおかしくなっていたようだ。
正しいモデルの挙動は下記ツイートのようである。thinking内でreflectionが実施されている。
実際にいくつかの例をブログをリリース当日に見た時に、reflectionタグがoutputの後に出力されている例などがあり、おや?という挙動をしていたので、問題が是正されたようだ。
HFのモデルが修正された後もベンチマークの結果が再現されないなど、雲行きが色々と怪しいので注意した方が良い。
続報
開発者ポスト:
再現実験を全て終了し、当初報告していた結果が再現されなかったとCEOが声明:
Liger-Kernel, 2024.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #Repository #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-08-25 Comment
LLMを学習する時に、ワンライン追加するだけで、マルチGPUトレーニングのスループットを20%改善し、メモリ使用量を60%削減するらしい
元ツイート:
Unsloth Unsloth, unslothai, 2024.07
はLoRA/QLoRAが可能な一方でまだMulti-GPUはサポートしていない。一方、Liger-KernelはLoRAよりもfull-parameter tuningとMulti-GPUにフォーカスしており、目的に応じて使い分けが必要。
https://github.com/linkedin/Liger-Kernel/issues/57
Practical Tips for Finetuning LLMs Using LoRA (Low-Rank Adaptation), SEBASTIAN RASCHKA, PHD, 2023.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #Blog #PEFT(Adaptor/LoRA) Issue Date: 2023-11-20
LLaMA-Factory, hiyouga, 2023.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Supervised-FineTuning (SFT) #One-Line Notes #TrainingFramework Issue Date: 2023-11-14 Comment
簡単に利用できるLLaMAのfinetuning frameworkとのこと。
元ツイート:
LLaMAベースなモデルなら色々対応している模様
LLMのファインチューニング で 何ができて 何ができないのか, npaka, 2023.08
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Supervised-FineTuning (SFT) #Blog #mid-training #needs-revision Issue Date: 2023-08-29 Comment
>LLMのファインチューニングは、「形式」の学習は効果的ですが、「事実」の学習は不得意です。
> シェイクスピアの脚本のデータセット (tiny-shakespeare) の
「ロミオ」を「ボブ」に置き換えてファインチューニングして、新モデルの頭の中では「ロミオ」と「ボブ」をどう記憶しているかを確認します。
ファインチューニングしても、Bで始まるジュリエットが恋する人物について質問しても、ボブと答えてはくれない。
> ロミオ」は「ジュリエット」が恋していたこの男性に関連付けられており、「ロミオ」を「ボブ」に置き換えるファインチューニングでは、ニューラルネットワークの知識ベースを変更することはできませんでした。
なるほど。
参考: https://www.anyscale.com/blog/fine-tuning-is-for-form-not-facts?ref=blog.langchain.dev
関連:
trl_trlx
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #One-Line Notes #Reference Collection #needs-revision #TrainingFramework Issue Date: 2023-07-23 Comment
関連:
- TRL - 強化学習によるLLMの学習のためのライブラリ, npaka, 2023.06
-
https://note.com/npaka/n/nbb974324d6e1
関連:
- trlを使って日本語LLMをSFTからRLHFまで一通り学習させてみる, AI SHIFT, 2023.07
-
https://www.ai-shift.co.jp/techblog/3583
Examples of using peft with trl to finetune 8-bit models with Low Rank Adaption (LoRA) , TRL Documentation
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #Quantization #PEFT(Adaptor/LoRA) #One-Line Notes Issue Date: 2023-07-22 Comment
LLaMA2を3行で、1つのA100GPU、QLoRAで、自前のデータセットで訓練する方法
Towards Complex Reasoning: the Polaris of Large Language Models, Yao Fu, 2023.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #Evaluation #Blog #Reasoning #mid-training Issue Date: 2023-05-04
LoRA論文解説, Hayato Tsukagoshi, 2023.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #Slide #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-04-25 Comment
ベースとなる事前学習モデルの一部の線形層の隣に、低ランク行列A,Bを導入し、A,Bのパラメータのみをfinetuningの対象とすることで、チューニングするパラメータ数を激減させた上で同等の予測性能を達成し、推論速度も変わらないようにするfinetuning手法の解説
LoRAを使うと、でかすぎるモデルだと、そもそもGPUに載らない問題や、ファインチューニング後のモデルファイルでかすぎワロタ問題が回避できる。
前者は事前学習済みモデルのBPのための勾配を保存しておく必要がなくなるため学習時にメモリ節約になる。後者はA,Bのパラメータだけ保存すればいいので、ストレージの節約になる。
かつ、学習速度が25%程度早くなる。
既存研究であるAdapter(transformerの中に学習可能なMLPを差し込む手法)は推論コストが増加し、prefix tuningは学習が非常に難しく、高い性能を達成するためにprefixとして128 token入れたりしなければならない。
huggingfaceがすでにLoRAを実装している
https://github.com/huggingface/peft