
Selected Papers/Blogs (1336) — 7/7
Recursive Language Models: the paradigm of 2026, PRIME Intellect, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #LongContext #read-later #LatentReasoning #reading #RecursiveModels #ContextRot Issue Date: 2026-01-02 Comment
関連研究:
- [Paper Note] Recursive Language Models, Alex L. Zhang+, arXiv'25, 2025.12
- Context Rot: How Increasing Input Tokens Impacts LLM Performance, CHROMA TECHNICAL REPORT, 2025.07
- [Paper Note] Scaling Long-Horizon LLM Agent via Context-Folding, Weiwei Sun+, arXiv'25, 2025.10
- [Paper Note] AgentFold: Long-Horizon Web Agents with Proactive Context Management, Rui Ye+, arXiv'25, 2025.10
- [Paper Note] Agentic Context Engineering: Evolving Contexts for Self-Improving
Language Models, Qizheng Zhang+, arXiv'25, 2025.10
mini-sglang: A compact implementation of SGLang, designed to demystify the complexities of modern LLM serving systems, sgl-project, 2025
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #python #Repository #LLMServing #SoftwareEngineering #read-later #MinimalCode Issue Date: 2025-12-28 Comment
元ポスト:
めっちゃ勉強したい
Equipping agents for the real world with Agent Skills, Anthropic, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #AIAgents #Blog #AgentSkills Issue Date: 2025-12-21
Performance Hints, Jeff Dean+, 2025.12
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Coding #SoftwareEngineering #reading Issue Date: 2025-12-21 Comment
元ポスト:
Emergence of Human to Robot Transfer in VLAs, Physical Intelligence (π), 2025.12
Paper/Blog Link My Issue
#Article #Pretraining #FoundationModel #DataMixture #Robotics #VisionLanguageActionModel #3D (Video) #EmbodiedAI #KeyPoint Notes #EmergentAbilities #EgocentricView #DomainGap #Author Thread-Post Issue Date: 2025-12-18 Comment
元ポスト:
pi_0.5と呼ばれる基盤モデルのfinetuningにおいてロボット用の学習データに追加して人間のegocentricなvideoをmixtureするだけで創発現象が生じ、人間の動画側にしか存在しない4種類のgeneralizationが必要なシナリオにおいて2倍の性能を示した。そしてこの傾向は、事前学習における基盤モデルのサイズをスケールさせる、ロボットのデータをより多く投入することでより顕著となった。
人間とロボットの特徴量を2D plotした散布図を見ると、事前学習で利用するロボットの学習データ(事前学習時点では人間の動画は含まれないことに注意)をスケールさせると、両者の特徴量が重なるようになったので、human-robotのalignmentをモデルが獲得していることが示唆される。
これにより、今後VLAを学習する際に、domain gapを埋めるための特別な処理が不要となる可能性がある、といった話らしい。
これが真だとすると、たとえば以下のように、人間のegocentric viewデータを大量に保有したところが有利にはなりそうではある。
- Interactive Intelligence from Human Xperience, Ropedia, 2025.12
Introducing MiMo-V2-Flash, Xiaomi, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #AttentionSinks #PostTraining #Reference Collection Issue Date: 2025-12-17 Comment
technical report:
https://github.com/XiaomiMiMo/MiMo-V2-Flash/blob/main/paper.pdf
HF:
https://huggingface.co/XiaomiMiMo/MiMo-V2-Flash
元ポスト:
関連:
ポイント解説:
attention sink(というより恐らくsink token)により性能が向上している:
言及されているpost trainingが有用らしい:
所見:
省パラメータでtop-tierのモデルに肉薄する方法のヒントがあるかもしれない。
解説:
Molmo 2: State-of-the-art video understanding, pointing, and tracking, Ai2, 2025.12
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #SmallModel #OpenWeight #OpenSource #VideoGeneration/Understandings #VisionLanguageModel #2D (Image) #3D (Video) #KeyPoint Notes Issue Date: 2025-12-17 Comment
テクニカルレポート:
https://www.datocms-assets.com/64837/1765901660-molmo_v2_2026-techreport-3.pdf
HF:
https://huggingface.co/collections/allenai/molmo2
Qwen3とOlmoをベースにしたvariantsが存在し、Olmoの方はバックボーンのLLMも含めて全てがオープンになっている。MetaのPerceptionLMと比較して1/8の動画データ量で高い性能を達成できており、データのcurationの品質と、grounding basedな目的関数の工夫によって実現されているとのこと。
proprietaryなモデル群と比較すると、trackingは圧勝、そのほかはGPT5-miniと同様なものが多い。モデルによってタスクの優劣が結構分かれており、Video関連タスクをタスクをまたいで汎化させることにはclosedでも苦戦しているように見える。
オープンモデルとの比較で言うと圧勝で、LongVideoのQAに関してだけは、Eagle2.5-8Bと呼ばれるモデルが勝っている。
あとは全体を通じてLLMのバックボーンがQwen3の場合の性能が良いことが興味深い。バックボーンに採用するLLMに応じて性能が結構変わる。これはアーキテクチャがそもそもConnectorを利用するタイプのもので、Unifiedなアーキテクチャではないことが要因としては考えられる。
元ポスト:
demo:
コードベースが公開:
https://github.com/allenai/molmo2
SID-1 Technical Report: Test-Time Compute for Retrieval, SID Research, 2025.12
Paper/Blog Link My Issue
#Article #InformationRetrieval #NLP #LanguageModel #ReinforcementLearning #AIAgents #Proprietary #KeyPoint Notes #Scalability #train-inference-mismatch Issue Date: 2025-12-15 Comment
元ポスト:
Figure4の話が非常に興味深い。rolloutの結果をtraining engineに渡す間のchat_templateによる抽象化では、マルチターン+tooluseにおいては、たとえばtool call周辺のホワイトスペースに関する情報を消してしまう問題がある。具体的には、一例として、ポリシーがホワイトスペースを含まないフォーマットの誤りがあるrolloutを生成した場合(=B)を考える。これをtraining engineに渡す際は、以下のような操作を伴うが
>apply_chat_template(parse(B))=G′
この際に、parse→apply_chat_templateの過程でtoolcall周辺のホワイトスペースが補完されるためtraining側ではホワイトスペースが含まれたrollout時とはトークン列が与えられる。この結果、フォーマットに誤りがある状態でrolloutされたにも関わらず、trainingエンジン側では正しい生成結果に擬似的に見える(=G')のだが、ホワイトスペースが含まれたことでトークナイズ結果が変わり、変化したトークンの部分が極端に小さなlogprobを持つことになる(i.e., ホワイトスペースは実装上の都合で生じ、ポリシーはそのトークンを(尤度が低く)出力していないにもかかわらず、出力されたことにされて学習される)。その結果、見かけ上は正しい生成結果なのだが、負のAdvantageを持つことになり、GRPOではそのような生成がされないように学習されてしまう。これが繰り返されることで、学習の安定性を損なう、という話である。
深層強化学習アルゴリズムまとめ, Shion Honda, 2020.09
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #ReinforcementLearning #reading Issue Date: 2025-12-14
Olmo 3.1, Ai2, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight #OpenSource Issue Date: 2025-12-13 Comment
元ポスト:
Instruction Followingのベンチマークスコアが、他モデルと比較して非常に高いように見える。
GPT-5.2 が登場 専門的な業務や長時間稼働するエージェント向けの、最先端のフロンティアモデル。, OpenAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #GenerativeAI #Reasoning #Proprietary #VisionLanguageModel Issue Date: 2025-12-12 Comment
元ポスト:
OpenAIがGPT-5.2をリリースし、再び様々なベンチマークにおいてGemini 3 Proをoutperform。
フロントエンド開発(デザイン)(アリーナ形式)ではOpus, Gemini 3 Proの勝利らしい:
https://www.designarena.ai
ポイント解説:
GDPval:
- [Paper Note] GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks, Tejal Patwardhan+, arXiv'25, 2025.10
- GDPVAL: EVALUATING AI MODEL PERFORMANCE ON REAL-WORLD ECONOMICALLY VALUABLE TASKS, Patwardhan+, 2025.09
GDPvalのclearwinがGPT-5.2- Thinkingで49.8%なので、14年程度の専門家がこなす米国主要産業の一部のタスクは数値上は置き換え可能という風に見える。Proに至っては60.0%である。
が、GDPvalはたとえば以下のようなlimitationがあり、数値の解釈には注意が必要である:
- 完全なcontextが与えられる前提
- 暗黙知が多いタスクは対象外
- 自己完結型で他社とのコミュニケーションが必要とされないタスクを対象
- 1職種あたり30タスク程度の限定的な網羅性
- コンピュータを利用したタスクのみ
- ...
実際の現場で活用しようと思うと、完全なcontextを揃えられるか、揃わない場合に不完全なcontextでタスクを遂行できるか、そのための社内での運用フローの整備等、モデルを活用するための周辺のシステムや運用フローの設計が重要(かつ膨大)である点には(ベンチマークのスコアを見ると驚くべき進歩だが)留意する必要がある。
Vals AI IndexというGDPvalに類似したベンチマークでもSoTAとのこと:
関連:
非常に簡単な論理的な推論でも誤る例:
Architecting efficient context-aware multi-agent framework for production, Hangfei Lin, Google, 2025.12
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #read-later #ContextEngineering Issue Date: 2025-12-07 Comment
元ポスト:
OpenThinker-Agent-v1, open-thoughts, 2025.12
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #SmallModel #OpenWeight #OpenSource #KeyPoint Notes Issue Date: 2025-12-07 Comment
元ポスト:
-
-
agenticなSLM(8Bモデル)で、モデル、データ(SFT, RL)、学習用のコードなど全て公開。同等規模のモデルQwen3-{8,32B}よりもSWE Bench Verified, Terminal Benchなどで上回る(ただし、Qwen3はgenericなモデルであり、コーディング特化のQwen3-coder-30Bには及ばない。しかしモデルサイズはこちらの方が大きいので何とも言えない。おそらく同等規模のコーディング特化Qwen3が存在しない)。また、SLMのコーディングエージェントの進化をより精緻に捉えるためのベンチマーク OpenThoughts-TB-Devも公開している。こちらでもQwen3-{8, 32B}に対しても高い性能を記録。
Announcing Rnj-1: Building Instruments of Intelligence, Ashish Vaswani, essential AI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SmallModel #read-later Issue Date: 2025-12-06 Comment
元ポスト:
transformerの人では...?SWE Benchのスコアが同サイズのモデル群と比較して圧倒的
model: https://huggingface.co/EssentialAI/rnj-1-instruct
解説:
The LLM Evaluation Guidebook, Fourrier+, HuggingFace, 2025.12
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Evaluation #Blog #read-later Issue Date: 2025-12-05 Comment
元ポスト:
[Paper Notes] Structured Prompting Enables More Robust, Holistic Evaluation of Language Models, Aali+, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Prompting #Evaluation #read-later #One-Line Notes Issue Date: 2025-11-30 GPT Summary- 高品質な言語モデル(LM)の評価には、HELMのようなフレームワークが重要だが、固定プロンプトに依存するため過小評価のリスクがある。DSPyのような宣言的プロンプトフレームワークは、タスクごとに最適化されたプロンプトを提供するが、体系的な評価が不足している。本研究では、再現可能なDSPy+HELMフレームワークを提案し、構造化プロンプトを用いてLMのパフォーマンスをより正確に評価する。4つのプロンプト手法を用いて7つのベンチマークで評価した結果、HELMがLMのパフォーマンスを平均4%過小評価し、パフォーマンスの変動が大きくなることが示された。この研究は、LMの挙動を特徴付ける初の大規模ベンチマーク研究であり、オープンソースの統合とプロンプト最適化パイプラインを提供する。 Comment
AI Agentsの評価でもハーネスによって性能が変わるし、一般的なLLMでの評価もpromptingで性能変わるだろうなぁ、とは思っていたが、やはりそうだった模様。重要論文
しかしそもそもLLMの評価は変数が多すぎて、網羅的な評価は難しく、活用する際にベンチマークスコアは参考程度にした方が良いとは思う。自前データがあるなら自前で手元で評価すべし、という気はするが、評価するLLMの候補を選定する際には有用だと思われる(小並感)
関連:
- [Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
元ポスト:
LLMのための強化学習手法 2025 -PPO・DPO・GRPO・DAPO一気に理解する-, Keisuke Kamata, 2025.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog Issue Date: 2025-11-29 Comment
元ポスト:
こちらもあわせて読むと良さそう
- 言語生成の強化学習をやっていく(手法紹介 REINFORCE編), Seitaro Shinagawa, 2020.12
- 深層強化学習アルゴリズムまとめ, Shion Honda, 2020.09
- RLHF/DPO 小話, 和地瞭良/ Akifumi Wachi, 2024.04
[Paper Note] DeepSeek-Math-V2, DeepSeekAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Reasoning #Mathematics #read-later #Verification #One-Line Notes #Reference Collection #GenerativeVerifier Issue Date: 2025-11-27 GPT Summary- 大規模言語モデル(LLM)は数学的推論において進展を遂げており、強化学習を用いて定量的推論コンペティションでのパフォーマンスを向上させている。しかし、最終回答の精度向上が正しい推論を保証しない問題や、厳密な導出が必要なタスクに対する限界がある。自己検証可能な数学的推論を目指し、定理証明のためのLLMベースの検証器を訓練し、生成器が自らの証明の問題を特定・解決するよう奨励する方法を提案。結果として得られたモデルDeepSeekMath-V2は、強力な定理証明能力を示し、国際数学オリンピックやプットナム競技会で高得点を記録した。これにより、自己検証可能な数学的推論が数学AIシステムの発展に寄与する可能性が示唆される。管理人コメント:モデル単体でIMO金メダル級を達成とのこと。outcomeに基づくRLVRからtrajectoryそのものをcritiqueし、その情報に基づいて再生成するといったループを繰り返す模様?このアプローチは数学以外のドメインでも有効な可能性があるので興味深い。 Comment
元ポスト:
HF: https://huggingface.co/deepseek-ai/DeepSeek-Math-V2
所見:
所見:
どのように高品質なverifierを構築し、高品質なデータ生成パイプラインを構築するか、という内容が記述されているらしい:
報酬に対する理解補助のための注釈:
ポイント解説:
verifier: proofsをスコアリングできるようRLで学習される
meta verifier: verifierの批評を確認する
generator: より良い証明を書きself checkもできるようverifierによるreward signalによりRLで訓練される
の三刀流らしい。
ポイント解説:
ポイント解説:
所見:
Estimating AI productivity gains from Claude conversations, Anthropic, 2025.11
Paper/Blog Link My Issue
#Article #GenerativeAI #Conversation #read-later Issue Date: 2025-11-26 Comment
元ポスト:
うーん気になる!
Claude-Opus-4.5: Introducing advanced tool use on the Claude Developer Platform, Anthropic, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Proprietary #VisionLanguageModel #Reference Collection Issue Date: 2025-11-25 Comment
元ポスト:
AnthropicがClaude-Opus-4.5をリリース。AgenticなユースケースでClaudeがベンチマーク上の首位をGemini3 Proから奪還
システムカード:
https://assets.anthropic.com/m/64823ba7485345a7/Claude-Opus-4-5-System-Card.pdf
人間と比較した時のパフォーマンスの解説:
EpochAIによるFrontierMath Tier1-3での評価:
o3(high), Grok4と同等程度で、Gemini3 Pro, GPT-5.1(high)には劣る
ベンチマーク上でのコーディング能力やagenticなツール呼び出し能力の差は縮まっている:
Artificial Analysisの評価:
スライドをいい感じに作れるらしい:
50% time horizonは4時間49分で現在top。
Introducing Nano Banana Pro, Google, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #GenerativeAI #Proprietary #2D (Image) Issue Date: 2025-11-21 Comment
元ポスト:
所見:
所見:
Distributed Inference Serving - vLLM, LMCache, NIXL and llm-d, Mikiya Michishita, 2025.06
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #LLMServing #Slide #SoftwareEngineering #read-later Issue Date: 2025-11-20 Comment
元ポスト:
vLLM, paged attention, prefix caching, continuous batching, 分散環境でのKV Cacheの共有, ...おおお、、読まねば
Introducing SAM 3D: Powerful 3D Reconstruction for Physical World Images, Meta, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #FoundationModel #Blog #read-later #3D Reconstruction #3D (Scene) Issue Date: 2025-11-20 Comment
元ポスト:
解説:
Introducing Meta Segment Anything Model 3 and Segment Anything Playground, Meta, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #ImageSegmentation #FoundationModel #Blog #read-later #2D (Image) #3D (Video) Issue Date: 2025-11-20 Comment
元ポスト:
今度はSAM3、最近毎日なんか新しいの出てるな
SAM 3.1:
https://huggingface.co/facebook/sam3.1
元ポスト:
Gemini 3 による知性の新時代, Google, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #GenerativeAI #Blog #Proprietary #VisionLanguageModel #One-Line Notes #Reference Collection Issue Date: 2025-11-19 Comment
所見:
GPT5.1に対して各種ベンチマークで上回る性能。
所見:
Gemini2.5 Proは回答が冗長で使いにくかったが、Gemini3は冗長さがなくなり、クリティカルな情報を簡潔に、しかし短すぎない、ちょうど良いくらいの応答に感じており、レスポンスもGPT5.1, GPT5と比べ早いので普段使いのLLMとしては非常に良いのではないか、という感想(2,3個のクエリを投げただけだが)を抱いた。
Oriol Vinyals氏のコメント:
LiveCodeBench ProでもSoTA:
Gemini Pro 3 Developer Guide:
https://ai.google.dev/gemini-api/docs/gemini-3?hl=ja
元ポスト:
GAIA Verified (Browser Use?)でもSoTA:
ただし、どのようなハーネスが使われているかは不明だし、それらが各モデルにとってフェアなものになってるかも不明
スクショのみでリンクも無し。
所見:
content window,pricingなどの情報:
一般的なユースケースでのBest Practice:
パラメータ数に関する考察:
韓国語でのベンチマークに関するポスト:
自身のハーネス、ユースケース、タスクではうまくいかなかったよという話(でもただのサンプル数1だよ、という話が記載されている):
結局のところベンチマークはあくまで参考程度であり、自分たちのタスク、データセットで性能を測らねばわからない。
Artificial Intelligenceによる評価:
MCP Universeでtop:
- [Paper Note] MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers, Ziyang Luo+, arXiv'25
Live SWE Agentと呼ばれるself-evolvingな枠組みを採用した場合(=scaffoldをbashのみから自己進化させる)のSWE Bench Vevifiedにやる評価でもSoTA:
- [Paper Note] Live-SWE-agent: Can Software Engineering Agents Self-Evolve on the Fly?, Chunqiu Steven Xia+, arXiv'25, 2025.11
- [Paper Note] SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, Carlos E. Jimenez+, ICLR'24
この辺のsoftware agent系のベンチマークにおけるハーネスが具体的にどうなっているのか、中身を見たことないので見ておきたい。
(追記)
SWE Bench Verifiedのリーダーボードではmini-SWE-Agentを利用した公正な比較が行われており、こちらではGemini3がトップだったもののその後リリースされたClaude-Opus-4.5がtopを僅差で奪還しGemini3が2位とのこと。
ハーネスについてはこちらを読むと良さそう:
- [Paper Note] SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, John Yang+, arXiv'24, 2024.05
EpochAIによる評価:
ECIでtop。ECIは39のベンチマークから算出されるスコア、らしい。
Scale AIのVisual Tool BenchでもSoTA:
- Beyond Seeing: Evaluating Multimodal LLMs On Tool-enabled Image Perception, Transformation, and Reasoning, Scale AI, 2025.10
CriPtと呼ばれるベンチマークにおける評価でもSoTA:
- [Paper Note] Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark, Minhui Zhu+, arXiv'25, 2025.09
最近提案された新たなtooluseベンチマークでもsecond placeらしい:
- [Paper Note] The Tool Decathlon: Benchmarking Language Agents for Diverse, Realistic, and Long-Horizon Task Execution, Junlong Li+, arXiv'25, 2025.10
IQ130らしい(果たして):
GPQA DiamondでSoTA:
Jeff Dean氏によるポスト:
Grok 4.1, xAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #GenerativeAI #Blog #Proprietary Issue Date: 2025-11-18 Comment
元ポスト:
[IBIS 2025] 深層基盤モデルのための強化学習 驚きから理論にもとづく納得へ, Akifumi Wachi, 2025.11
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Slide Issue Date: 2025-11-15 Comment
元ポスト:
ICLR 2026 - Submissions, Pangram Labs, 2025.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Blog #ICLR #One-Line Notes #Reference Collection Issue Date: 2025-11-15 Comment
元ポスト:
ICLR'26のsubmissionとreviewに対してLLMが生成したものが否かをDetectionした結果(検出性能は完璧な結果ではない点に注意)
この辺の議論が興味深い:
関連:
oh...
パイプライン解説:
母国語でレビューを書いて英語に翻訳している場合もAI判定される場合があるよという話:
ICLR公式が対応検討中とのこと:
ICLRからの続報:
> As such, reviewers who posted such poor quality reviews will also face consequences, including the desk rejection of their submitted papers.
> Authors who got such reviews (with many hallucinated references or false claims) should post a confidential message to ACs and SACs pointing out the poor quality reviews and provide the necessary evidence.
citationに明らかな誤植があり、LLMによるHallucinationが疑われる事例が多数見つかっている:
Oralに選ばれるレベルのスコアの研究論文にも多数のHallucinationが含まれており、1人の査読者がそれに気づきスコア0を与える、といった事態にもなっているようである:
当該論文はdesk rejectされたので現在は閲覧できないとのこと。
NeurIPS'25ではそもそも査読を通過した研究についても多くのHallucinationが見つかっているとのこと:
Holo2: Cost-Efficient Models for Cross-Platform Computer-Use Agents, H Company, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #AIAgents #Blog #OpenWeight #ComputerUse #VisionLanguageModel #Grounding #GUI Issue Date: 2025-11-14 Comment
HF: https://huggingface.co/collections/Hcompany/holo2
元ポスト:
関連:
- Holo1.5 - Open Foundation Models for Computer Use Agents, H Company, 2025.09
GPT-5.1: A smarter, more conversational ChatGPT, OpenAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #Blog #Reasoning #Proprietary #VisionLanguageModel #Routing #One-Line Notes #Reference Collection Issue Date: 2025-11-13 Comment
元ポスト:
instantモデルはよりあたたかい応答でより指示追従能力を高め、thinkingモデルは入力に応じてより適応的に思考トークン数を調整する。autoモデルは入力に応じてinstant, thinkingに適切にルーティングをする。
所見:
Artificial Analysisによるベンチマーキング:
GPT-5.1-Codex-maxの50% time horizon:
Omnilingual ASR: Advancing Automatic Speech Recognition for 1,600+ Languages, Meta, 2025.11
Paper/Blog Link My Issue
#Article #Transformer #SpeechProcessing #MultiLingual #OpenWeight #AutomaticSpeechRecognition(ASR) #AudioLanguageModel Issue Date: 2025-11-12 Comment
Introducing Kimi K2 Thinking, MoonshotAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Reasoning #OpenWeight #One-Line Notes #Reference Collection Issue Date: 2025-11-07 Comment
HF: https://huggingface.co/moonshotai
元ポスト:
coding系ベンチマークでは少しGPT5,Claude Sonnet-4.5に劣るようだが、HLE, BrowseCompなどではoutperform
tooluseのベンチマークであるtau^2 Bench TelecomではSoTA
モデルの図解:
INT4-QATに関する解説:
INT4-QATの解説:
Kimi K2 DeepResearch:
METRによる50% timehorizonの推定は54分:
ただしサードパーティのinference providerによってこれは実施されており、(providerによって性能が大きく変化することがあるため)信頼性は低い可能性があるとのこと。
METRでの評価でClaude 3.7 Sonnetと同等のスコア:
openweightモデルがproprietaryモデルに追いつくのはsoftwere engineeringタスク(agenticなlong horizon+reasoningタスク)9ヶ月程度を要しているとのこと
The Smol Training Playbook: The Secrets to Building World-Class LLMs, Allal+, HuggingFace, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #Dataset #LanguageModel #Infrastructure #PostTraining Issue Date: 2025-10-31 Comment
元ポスト:
Emergent Introspective Awareness in Large Language Models, Jack Lindsey, Anthropic, 2025.10
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Blog Issue Date: 2025-10-31 Comment
元ポスト:
公式ポスト:
Marin 32B Retrospective, marin-community, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Blog #OpenWeight #OpenSource Issue Date: 2025-10-30 Comment
元ポスト:
lossのスケーリング則に基づいた今後の見通し:
pj pageはこちら:
https://marin.community
Ming-flash-omni-Preview, inclusionAI, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #SpeechProcessing #TextToImageGeneration #OpenWeight #AutomaticSpeechRecognition(ASR) #Architecture #MoE(Mixture-of-Experts) #VideoGeneration/Understandings #Editing #TTS #Routing #UMM #Omni #Sparse #ImageSynthesis #Initial Impression Notes Issue Date: 2025-10-28 Comment
元ポスト:
過去一番多くのタグを付与した気がするが、果たして大規模、Omniモーダルかつ、UMMにしたことによる恩恵(=様々なモダリティを統一された空間上に学習させる恩恵)はどの程度あるのだろうか?
アーキテクチャを見ると、モダリティごとに(モダリティ単位でのバイアスがかかった)Routerが用意されexpertにルーティングされるような構造になっている。
OmniモーダルでUMMを大規模にスクラッチから事前学習:
- [Paper Note] ERNIE 5.0 Technical Report, Haifeng Wang+, arXiv'26, 2026.02
On-Policy Distillation, Thinking Machines, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #ReinforcementLearning #Blog #Distillation #PostTraining #read-later #On-Policy Issue Date: 2025-10-27 Comment
元ポスト:
所見:
解説:
LMMs Engine, EvolvingLMMs-Lab, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP #MultiModal #Repository #PostTraining #UMM #One-Line Notes Issue Date: 2025-10-27 Comment
元ポスト:
事前学習済みのLLM, VLM, dLM, DiffusionModelなどからUMMを学習できる事後学習フレームワーク。
LigerKernelでメモリ使用量を30%削減し、SparseAttentionもサポートし、Muon Optimizerもサポートしている。
MiniMax-M2: Intelligence, Performance & Price Analysis, Artificial Analysis, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #OpenWeight #Reference Collection Issue Date: 2025-10-26 Comment
元ポスト:
関連:
- [Paper Note] MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning
Attention, MiniMax+, arXiv'25, 2025.06
CISPOを提案したMiniMax-M1の後続モデルと思われるMiniMax-M2-previewが中国製のモデルでArtificial Intelligenceでの評価でトップに立った模様。
所見:
モデルが公開:
https://huggingface.co/MiniMaxAI/MiniMax-M2
proprietaryモデルになるもんだと思ってた、、、これを公開するの凄すぎでは、、、
公式ポスト:
MITライセンス
vLLMでのserving方法:
https://docs.vllm.ai/projects/recipes/en/latest/MiniMax/MiniMax-M2.html
> You can use 4x H200/H20 or 4x A100/A800 GPUs to launch this model.
上記GPUにおいては--tensor-parallel-size 4で動作する模様。
SGLangでもサポートされている:
AnthropicのAPIの利用をお勧めする理由:
(以下管理人の補足を含みます)MiniMax-M2はAgenticなCoTをするモデルなので、contextの情報を正しく保持する必要がある。特に、マルチターンのやり取りをAPIを介してユーザが実行する場合、OpenAIのchatcompletionはCoTを返してくれず、マルチターンのやり取りをしても同じsessionで利用したとしても、前のターンと同じCoTが利用されないことがドキュメントに記述されている。このような使い方をサポートしているのはResponceAPIのみであるため、ResponceAPIでのみ適切なパフォーマンスが達成される。この点がconfusingなので、誤った使い方をするとMiniMaxの真価が発揮されず、しかもそれに気づけずに使い続けてしまう可能性がある。AnthropicのAPIではSonnet 4.5では全ての応答に明示的にCoTが含まれるため、その心配がない、だからAnthropicがおすすめ、みたいな話だと思われる。
アーキテクチャ解説:
解説:
Building the Open Agent Ecosystem Together: Introducing OpenEnv, openenv, 2025.10
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Standardization Issue Date: 2025-10-25 Comment
元ポスト:
AIエージェントを学習、運用するためのenvironmentを標準化し、共有可能にする取り組み。Meta PyTorchとHFの共同。
標準化:
- エージェントのコアアーキテクチャ(Environment,Task, Agentなど):
https://github.com/meta-pytorch/OpenEnv/blob/main/rfcs/001-abstractions.md
- インタフェース等:
https://github.com/meta-pytorch/OpenEnv/blob/main/rfcs/002-env-spec.md
- MCPツールのカプセル化:
https://github.com/meta-pytorch/OpenEnv/blob/main/rfcs/003-mcp-support.md
- エージェントのアクション:
https://github.com/meta-pytorch/OpenEnv/blob/main/rfcs/004-actions-as-tool-calls.md
Environment Hub: https://huggingface.co/openenv
Introducing torchforge – a PyTorch native library for scalable RL post-training and agentic development, PyTorch team at Meta, 2025.10
Paper/Blog Link My Issue
#Article #NLP #Library #ReinforcementLearning #AIAgents #Blog #TrainingFramework Issue Date: 2025-10-25 Comment
元ポスト:
Introducing MiMo-Audio, LLM-Core Xiaomi, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #InstructionTuning #SpeechProcessing #Reasoning #SmallModel #OpenWeight #Zero/FewShotLearning #UMM #AudioLanguageModel Issue Date: 2025-10-25 Comment
HF: https://huggingface.co/collections/XiaomiMiMo/mimo-audio
元ポスト:
text, audioを入力として受け取り、text, audioを出力するAudioLanguageModel
olmOCR 2: Unit test rewards for document OCR, Ai2, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #MultiLingual #Japanese #GRPO #DocParser #VisionLanguageModel #OCR #One-Line Notes Issue Date: 2025-10-23 Comment
元ポスト:
モデル: https://huggingface.co/allenai/olmOCR-2-7B-1025-FP8
Apache2.0ライセンスでSoTA更新。そしてさすがの学習データとコードも公開
テクニカルレポート: https://github.com/allenai/olmocr/blob/main/olmOCR-2-Unit-Test-Rewards-for-Document-OCR.pdf
果たして日本語は…SFT Datasetのtop5にjaはなかったように見える
所見:
demoを試した見たが日本語スライドでも非常に性能が良い
DeepSeekOCRとの比較:
nanochat, karpathy, 2025.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #ChatGPT #Repository #mid-training #GRPO #read-later #Inference #MinimalCode #KV Cache Issue Date: 2025-10-22 Comment
元ポスト:
新たなスピードランが...!!
FP8で記録更新とのこと:
nano chatの過去の改善のポイントまとめ:
nanochatにおいてKarpathy氏がAIによる自動改善をするエージェントをセットアップしたところ、12時間で110の変更が加わり、ValLossを0.864215から0.85039まで改善しているとのこと。
現在の最高性能は2時間で0.71854なのでまだまだ及んでいないが、このまま回しておいたらどこまで改善するだろうか?
ポストに本人が返信をしているが、Karpathy氏の関心は、どのハーネスがnanochatに最も大きな改善をもたらすか、という点らしい。
How to scale RL, NATHAN LAMBERT, 2025.10
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #Scaling Laws #read-later #reading Issue Date: 2025-10-21 Comment
元ポスト:
下記研究の内容を解説している。
- [Paper Note] The Art of Scaling Reinforcement Learning Compute for LLMs, Devvrit Khatri+, arXiv'25, 2025.10
事前学習におけるスケーリング測は大規模な事前学習実行時の最適な設定の選択に関するもの(e.g. chinchilla law)だったが、RL(=特定のベースモデルから最大限の性能を引き出すための手法)のスケーリング則においてはどのアルゴリズムをより長期間実行させるかという選択に焦点を当てている。
(後で続きを読む)
How Well Does RL Scale?, Toby Ord, 2025.10
Paper/Blog Link My Issue
#Article #NLP #ReinforcementLearning #Blog #Test-Time Scaling #Scaling Laws #PostTraining #One-Line Notes Issue Date: 2025-10-21 Comment
元ポスト:
OpenAIやAnthropicが公表している学習に関するplot(と筆者の様々なアカデミアの研究の知見)に基づいて、RLによるスケーリングは、事前学習やTest-time Scalingよりも計算量の観点で効率が悪い、ということを分析している模様。
> So the evidence on RL-scaling and inference-scaling supports a general pattern:
>- a 10x scaling of RL is required to get the same performance boost as a 3x scaling of inference
> - a 10,000x scaling of RL is required to get the same performance boost as a 100x scaling of inference
>
> In general, to get the same benefit from RL-scaling as from inference-scaling required twice as many orders of magnitude. That’s not good.
その上で、RLによるコストが事前学習のコストと同等かそれ以上となったときに、モデルの性能をスケールさせる場合のコストが爆発的に増加することを指摘している(初期のRLによるコストが小さければ事前学習やtest-time scalingのデータを増やすよりも効率がよいスケーリング手法となっていたが、RLのコストが大きくなってくるとスケールさせる際の金額の絶対値が大きくなりすぎるという話)。
DeepSeek-OCR: Contexts Optical Compression, DeepSeek, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiLingual #read-later #DocParser #Encoder-Decoder #OCR #Reference Collection #Compression Issue Date: 2025-10-20 Comment
元ポスト:
英語と中国語では使えそうだが、日本語では使えるのだろうか?p.17 Figure11を見ると100言語に対して学習したと書かれているように見える。
所見:
所見:
OCRベンチマーク:
- [Paper Note] OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations, Linke Ouyang+, CVPR'25, 2024.12
(DeepSeek-OCRの主題はOCRの性能向上というわけではないようだが)
所見:
所見+ポイント解説:
所見:
textxをimageとしてエンコードする話は以下の2023年のICLRの研究でもやられているよというポスト:
- [Paper Note] Language Modelling with Pixels, Phillip Rust+, ICLR'23, 2022.07
関連:
- [Paper Note] Text or Pixels? It Takes Half: On the Token Efficiency of Visual Text
Inputs in Multimodal LLMs, Yanhong Li+, arXiv'25, 2025.10
- [Paper Note] PixelWorld: Towards Perceiving Everything as Pixels, Zhiheng Lyu+, arXiv'25, 2025.01
関連:
literature:
上記ポストでは本研究はこれらliteratureを完全に無視し “an initial investigation into the feasibility of compressing long contexts via optical 2D mapping.” と主張しているので、先行研究を認識し引用すべきだと述べられているようだ。
karpathy氏のポスト:
Andrej Karpathy — AGI is still a decade away, DWARKESH PATEL, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #MachineLearning #NLP #LanguageModel #ReinforcementLearning #AIAgents #In-ContextLearning #Blog #RewardHacking #PostTraining #Diversity #PRM #Generalization #Cultural #Emotion #ContinualLearning Issue Date: 2025-10-20 Comment
元ポスト:
関連:
- In-context Steerbility: [Paper Note] Spectrum Tuning: Post-Training for Distributional Coverage and
In-Context Steerability, Taylor Sorensen+, arXiv'25, 2025.10
(整理すると楽しそうなので後で関連しそうな研究を他にもまとめる)
とても勉強になる!AIに代替されない20%, 1%になるには果たして
所見:
Introducing Stable Diffusion 3.5, StabilityAI, 2024.10
Paper/Blog Link My Issue
#Article #ComputerVision #Transformer #DiffusionModel #TextToImageGeneration #Blog #OpenWeight Issue Date: 2025-10-10 Comment
SD3.5
PipelineRL, Piche+, ServiceNow, 2025.04
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #AIAgents #Repository #KeyPoint Notes Issue Date: 2025-10-05 Comment
code: https://github.com/ServiceNow/PipelineRL
元ポスト:
Inflight Weight Updates
(この辺の細かい実装の話はあまり詳しくないので誤りがある可能性が結構あります)
通常のon-policy RLでは全てのGPU上でのsequenceのロールアウトが終わるまで待ち、全てのロールアウト完了後にモデルの重みを更新するため、長いsequenceのデコードをするGPUの処理が終わるまで、短いsequenceの生成で済んだGPUは待機しなければならない。一方、PipelineRLはsequenceのデコードの途中でも重みを更新し、生成途中のsequenceは古いKV Cacheを保持したまま新しい重みでsequenceのデコードを継続する。これによりGPU Utilizationを最大化できる(ロールアウト完了のための待機時間が無くなる)。また、一見古いKV Cacheを前提に新たな重みで継続して部分sequenceを継続するとポリシーのgapにより性能が悪化するように思えるが、性能が悪化しないことが実験的に示されている模様。
Conventional RLの疑似コード部分を見るととてもわかりやすくて参考になる。Conventional RL(PPOとか)では、実装上は複数のバッチに分けて重みの更新が行われる(らしい)。このとき、GPUの利用を最大化しようとするとバッチサイズを大きくせざるを得ない。このため、逐次更新をしたときのpolicyのgapがどんどん蓄積していき大きくなる(=ロールアウトで生成したデータが、実際に重み更新するときにはlagが蓄積されていきどんどんoff-policyデータに変化していってしまう)という弊害がある模様。かといってlagを最小にするために小さいバッチサイズにするとgpuの効率を圧倒的に犠牲にするのでできない。Inflight Weight Updatesではこのようなトレードオフを解決できる模様。
また、trainerとinference部分は完全に独立させられ、かつplug-and-playで重みを更新する、といった使い方も想定できる模様。
あとこれは余談だが、引用ポストの主は下記研究でattentionメカニズムを最初に提案したBahdanau氏である。
- [Paper Note] Neural Machine Translation by Jointly Learning to Align and Translate, Dzmitry Bahdanau+, ICLR'15
続報:
続報:
Effective context engineering for AI agents, Anthropic, 2025.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #AIAgents #SoftwareEngineering #read-later #ContextEngineering #One-Line Notes Issue Date: 2025-10-04 Comment
元ポスト:
AnthropicによるContextEngineeringに関するブログ。
ざーっとみた感じ基礎的な定義からなぜ重要なのか、retrievalの活用、longnhorizon taskでの活用、compaction(summarization)など、幅広いトピックが網羅されているように見える。
最新サーベイはこちら
- [Paper Note] A Survey of Context Engineering for Large Language Models, Lingrui Mei+, arXiv'25
所見:
2025年10月1日 国立情報学研究所における大規模言語モデル構築への協力について, 国立国会図書館, 2025.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Blog #Japanese Issue Date: 2025-10-01 Comment
元ポスト:
日本語LLMの進展に極めて重要なニュースと思われる
LoRA Without Regret, Schulman+, THINKING MACHINES, 2025.09
Paper/Blog Link My Issue
#Article #Blog #PEFT(Adaptor/LoRA) #read-later Issue Date: 2025-09-30 Comment
元ポスト:
これはおそらく必読...
解説:
解説:
所見:
Failing to Understand the Exponential, Again, Julian Schrittwieser, 2025.09
Paper/Blog Link My Issue
#Article #LanguageModel #Evaluation #Blog #One-Line Notes Issue Date: 2025-09-29 Comment
元ポスト:
関連:
- [Paper Note] Measuring AI Ability to Complete Long Tasks, Thomas Kwa+, arXiv'25, 2025.03
- GDPVAL: EVALUATING AI MODEL PERFORMANCE ON REAL-WORLD ECONOMICALLY VALUABLE TASKS, Patwardhan+, 2025.09
AIの指数関数的な成長は続いているぞという話。
以下は管理人の感想だが、個々のベンチマークで見たらサチってきている(昔より伸び代が小さい)ように感じるが、人間が実施する複雑なタスクに対する上記ベンチマークなどを見るとスケーリングは続いている(むしろ加速している感がある)。シンプルなタスクのベンチマークの伸びは小さくとも、それらシンプルなタスクの積み重ねによって複雑なタスクは実施されるので、(現存するベンチマークが測定できている能力はLLMの部分的な能力だけなことも鑑みると)、複雑なタスクで評価した時の伸びは実は大きかったりする(スケーリングは続いている)のではないか、という感想。
GDPVAL: EVALUATING AI MODEL PERFORMANCE ON REAL-WORLD ECONOMICALLY VALUABLE TASKS, Patwardhan+, 2025.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation Issue Date: 2025-09-29 Comment
米国のGDPを牽引する9つの代表的な産業において、44の職種を選定し、合計1320件の実務タスクを設計したベンチマーク。ベンチマークは平均14年程度の経験を持つ専門家が実際の業務内容をもとに作成し、(うち、約220件はオープンソース化)、モデルと専門家のsolutionにタスクを実施させた。その上で、第三者である専門家が勝敗(win, lose, tie)を付与することでモデルがどれだけ実務タスクにおいて人間の専門家に匹敵するかを測定するベンチマークである。
評価の結果、たとえばClaude Opus 4.1の出力は47.6%程度、GPT-5 (high) は38.8%程度の割合で専門家と勝ち + 引き分け、という性能になっており、人間の専門家にかなり近いレベルにまで近づいてきていることが分かる。特にClaude Opus 4.1はデザインの品質も問われるタスク(ドキュメントの書式設定、スライドレイアウトなど)で特に優れているとのこと。
limitationとしては、
- 網羅性: データセットサイズが小さく、occupationごとの30タスクしかデータがないこと
- 自己完結型・知識労働への偏り: コンピュータ上でのタスクに限定されており、肉体労働や暗黙知が多いタスク、個人情報へのアクセス、企業内の専用ツールを利用した作業や他社とのコミュニケーションが必要なタスクは含まれていない。
- 完全な文脈: 完全な文脈を最初からpromptで与えているが、実際は環境とのインタラクションが必要になる。
- grader performance: 自動評価は人間の専門家の評価に比べると及ばない
といったことが書かれている。
When Speed Kills Stability: Demystifying RL Collapse from the Training-Inference Mismatch, Liu+, 2025.09
Paper/Blog Link My Issue
#Article #Analysis #MachineLearning #NLP #LanguageModel #ReinforcementLearning #AIAgents #Blog #Stability #train-inference-mismatch Issue Date: 2025-09-27 Comment
元ポスト:
訓練時のエンジン(fsdp等)とロールアウト時のエンジン(vLLM等)が、OOVなトークンに対して(特にtooluseした場合に生じやすい)著しく異なる尤度を割り当てるため学習が崩壊し、それは利用するGPUによっても安定性が変化し(A100よりもL20, L20よりもH20)、tokenレベルのImporttance Weightingでは難しく、Sequenceレベルのサンプリングが必要、みたいな話な模様。
関連:
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
- [Paper Note] Group Sequence Policy Optimization, Chujie Zheng+, arXiv'25
FP16にするとtrain-inferenae gapが非常に小さくなるという報告:
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
A100でvLLMをバックボーンにした時のdisable_cascade_attnの設定値による挙動の違い:
そもそもFlashAttnention-2 kernelにバグがあり、A100/L20で特定のカーネルが呼ばれるとミスマッチが起きるのだとか。vLLM Flashattentionリポジトリのissue 87によって解決済み。~~具体的にどのカーネル実装なのだろうか。~~ (vLLM Flashattentionリポジトリだった模様)
https://github.com/vllm-project/flash-attention
disable_cascade_attnの設定値を何回も変えたけどうまくいかないよという話がある:
LongCat-Flash-Thinking, meituan-longcat, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight #read-later #ModelMerge Issue Date: 2025-09-22 Comment
元ポスト:
ポイント解説:
関連:
- LongCat-Flash-Chat, meituan-longcat, 2025.08
- [Paper Note] Libra: Assessing and Improving Reward Model by Learning to Think, Meng Zhou+, arXiv'25, 2025.07
GAUSS Benchmarking Structured Mathematical Skills for Large Language Models, Zhang+, 2025.06
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #Reasoning #Mathematics #Contamination-free Issue Date: 2025-09-13 Comment
元ポスト:
現在の数学のベンチマークは個々の問題に対する回答のAccuracyを測るものばかりだが、ある問題を解く際にはさまざまなスキルを活用する必要があり、評価対象のLLMがどのようなスキルに強く、弱いのかといった解像度が低いままなので、そういったスキルの習熟度合いを測れるベンチマークを作成しました、という話に見える。
Knowledge Tracingタスクなどでは問題ごとにスキルタグを付与して、スキルモデルを構築して習熟度を測るので、問題の正誤だけでなくて、スキルベースでの習熟度を見ることで能力を測るのは自然な流れに思える。そしてそれは数学が最も実施しやすい。
Attention ls Off By One, Evanmiller.org, 2023.07
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #NLP #Transformer #Attention #Blog #AttentionSinks Issue Date: 2025-09-12 Comment
Attention Scoreの計算におけるSoftmax関数はその性質上必ずいずれかのトークンに値を割り振らなければならないが、headがどこにも注意を向けたくない場合に、Softmax関数の性質上そうすることができない。たとえば、headがどのトークンにもスコアを割り振りたくなく、全てのトークンに対して負のlimitをとるような例を考えたときに、headはどこにも注意を向けたくないにもかかわらず、何らかのトークンにスコアは割り振られてしまう。これによって強制的に何らかのトークンに注意を向けざるを得なくなるが、本来はこのような場合はどこにも注意を向けないような挙動ができるようになるべきである。それを改善するために、ソフトマックス関数の分母に1を加えるシンプルな修正を加えた関数Softmax_1を提案しており、ソフトマックス関数の出力ベクトルのスコアの総和が1未満を取れる(言い換えると各スコアが0に近づくことができる)ような修正を提案している。
Attention Sinksと問題意識が同じであり、このブログの二か月後にAttention Sinkを指摘した研究がarXivに投稿される、という時系列に見える。
- [Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
Defeating Nondeterminism in LLM Inference, Horace He in collaboration with others at Thinking Machines, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #Blog #read-later #Non-Determinism Issue Date: 2025-09-11 Comment
元ポスト:
ポイント解説:
vLLMにおいてinferenceをdeterministicにする方法が、vLLMのissue number 24583に記載されているので参照のこと。
transformersでの実装例:
『JamC-QA』: 日本の文化や風習に特化した質問応答ベンチマークの構築・公開(前編), SB Intuitions, 2025.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #Japanese Issue Date: 2025-09-09 Comment
元ポスト:
後編も参照のこと: https://www.sbintuitions.co.jp/blog/entry/2025/09/09/113132
日本の文化、風習、風土、地理、日本史、行政、法律、医療に関する既存のベンチマークによりも難易度が高いQAを人手によってスクラッチから作成した評価データ。人手で作成されたQAに対して、8種類の弱いLLM(パラメータ数の小さい日本語LLMを含む)の半数以上が正しく回答できたものを除外、その後さらに人手で確認といったフィルタリングプロセスを踏んでいる。記事中は事例が非常に豊富で興味深い。
後編では実際の評価結果が記載されており、フルスクラッチの日本語LLMが高い性能を獲得しており、Llama-Swallowなどの継続事前学習をベースとしたモデルも高いスコアを獲得している。評価時は4-shotでドメインごとにExamplarは固定し、greedy decodingで評価したとのこと。
NLP'25: https://www.anlp.jp/proceedings/annual_meeting/2025/pdf_dir/Q2-18.pdf
- [Paper Note] Non-Determinism of "Deterministic" LLM Settings, Berk Atil+, Eval4NLP'25, 2024.08
のような話もあるので、greedy decodingだけでなくnucleus/temperature samplingを複数trial実施した場合の性能の平均で何か変化があるだろうか、という点が気になったが、下記研究でMMLUのような出力空間が制約されているような設定の場合はほとんど影響がないことが実験的に示されている模様:
- [Paper Note] The Good, The Bad, and The Greedy: Evaluation of LLMs Should Not Ignore Non-Determinism, Yifan Song+, NAACL'25
これはnucleus/temperature samplingが提案された背景(=出力の自然さを保ったまま多様性を増やしたい)とも一致する。
FinePDFs, HuggingFaceFW, 2025.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #Repository Issue Date: 2025-09-07 Comment
元ポスト:
Thomas Wolf氏のポスト:
ODC-By 1.0 license
From f(x) and g(x) to f(g(x)): LLMs Learn New Skills in RL by Composing Old Ones, Yuan+, 2025.09
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #ReinforcementLearning #Blog #Composition #read-later Issue Date: 2025-09-06 Comment
元ポスト:
コントロールされた実験において、深さ2のnestedなcompostition g(f(x))のデータでRLした場合は、テスト時に深さ6までのcompostitionを実行できるようになったが(=メタスキルとしてcompostitionを獲得した)、深さ1のnon-nestedなデータでRLした場合は複雑なcompostitionが必要なタスクを解けなかった。また、一般的にベースモデルがある程度解ける問題に対してRLを適用したモデルのpass@1000はあまり向上しないことから、RLは新しいスキルを何も教えていないのではないか、といった解釈がされることがあるが、より高次のcompostitionが必要なタスクで評価すると明確に性能が良くなるので、実はより高次のcompostitionが必要なタスクに対する汎化性能を伸ばしている。compostitionでの能力を発揮するにはまず幅広いatomicなスキルが必要なので、しっかりそれを事前学習で身につけさせ、その後post-trainingによって解決したいタスクのためのatomic skillのcompostitionの方法を学習させると効果的なのではないか、といった話な模様。
この辺のICLの話と似ている
- What Do Language Models Learn in Context? The Structured Task Hypothesis, Jiaoda Li+, N/A, ACL'24
Why Language Models Hallucinate, Kalai+, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Hallucination #Author Thread-Post Issue Date: 2025-09-06 Comment
著者ポスト:
解説:
所見:
FineVision: Open Data Is All You Need, Wiedmann+, Hugging Face, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #Pretraining #NLP #Dataset #Blog #VisionLanguageModel Issue Date: 2025-09-05 Comment
HF: https://huggingface.co/datasets/HuggingFaceM4/FineVision
元ポスト:
OpenHands PR Arena, neulab, 2025.09
Paper/Blog Link My Issue
#Article #Dataset #AIAgents #Evaluation #Repository #Coding #SoftwareEngineering Issue Date: 2025-09-04 Comment
元ポスト:
実際に存在するIssueにタグ付けすることで、リアルタイムに複数LLMによってPRを作成(API callはOpenHandswが負担する)し、ユーザは複数LLMの中で良いものを選択する、といったことができる模様?リーダーボードも将来的に公開するとのことなので、実際にユーザがどのモデルのoutputを選んだかによって勝敗がつくので、それに基づいてランキング付けをするのだろうと推測。興味深い。
Inside vLLM: Anatomy of a High-Throughput LLM Inference System, Aleksa Gordić blog, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #Blog #LLMServing #read-later Issue Date: 2025-09-03 Comment
めっちゃ良さそう
August 2025 - China Open Source Highlights, 2025.09
Paper/Blog Link My Issue
#Article #Survey #ComputerVision #NLP #LanguageModel #OpenWeight #VisionLanguageModel Issue Date: 2025-09-02 Comment
元ポスト:
slime, THUDM & Zhihu, 2025.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #ReinforcementLearning #AIAgents #PostTraining #Asynchronous #TrainingFramework Issue Date: 2025-09-02 Comment
元ポスト:
GLM-4.5のRL学習に利用されたフレームワーク
- [Paper Note] GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models, GLM-4. 5 Team+, arXiv'25
Nemotron-CC-v2, Nvidia, 2025.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #Supervised-FineTuning (SFT) #Coding #Mathematics Issue Date: 2025-09-01 Comment
元ポスト:
CCだけでなく、数学やコーディングの事前学習データ、SFT styleの合成データセットも含まれている。
LongCat-Flash-Chat, meituan-longcat, 2025.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #read-later #One-Line Notes #Reference Collection Issue Date: 2025-08-31 Comment
テクニカルレポート: https://github.com/meituan-longcat/LongCat-Flash-Chat/blob/main/tech_report.pdf
元ポスト:
Agent周りのベンチで高性能なnon thinkingモデル。毎秒100+トークンの生成速度で、MITライセンス。Dynamic Activation...?
Dynamic Activation (activation paramが入力に応じて変化(全てのトークンをMoEにおいて均一に扱わない)することで効率化)は、下記を利用することで実現している模様
- [Paper Note] MoE++: Accelerating Mixture-of-Experts Methods with Zero-Computation Experts, Peng Jin+, ICLR'25
しかし中国は本当に次々に色々な企業から基盤モデルが出てくるなぁ…すごい
- [Paper Note] Scaling Exponents Across Parameterizations and Optimizers, Katie Everett+, ICML'24
解説:
解説:
Your Efficient RL Framework Secretly Brings You Off-Policy RL Training, Yao+, 2025.08
Paper/Blog Link My Issue
#Article #Library #ReinforcementLearning #Blog #On-Policy #KeyPoint Notes #Reference Collection #train-inference-mismatch Issue Date: 2025-08-26 Comment
元ポスト:
元々
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
のスレッド中にメモっていたが、アップデートがあったようなので新たにIssue化
trainingのエンジン(FSDP等)とロールアウトに使うinferenceエンジン(SGLang,vLLM)などのエンジンのミスマッチにより、学習がうまくいかなくなるという話。
アップデートがあった模様:
- Parallelismのミスマッチでロールアウトと学習のギャップを広げてしまうこと(特にsequence parallelism)
- Longer Sequenceの方が、ギャップが広がりやすいこと
- Rolloutのためのinferenceエンジンを修正する(SGLang w/ deterministic settingすることも含む)だけでは効果は限定的
といった感じな模様。
さらにアップデート:
FP16にするとtrain-inferenae gapが非常に小さくなるという報告:
- [Paper Note] Defeating the Training-Inference Mismatch via FP16, Penghui Qi+, arXiv'25, 2025.10
vLLMがtrain inference mismatchを防ぐアップデートを実施:
Swallow LLM Leaderboard v2, Swallow LLM Team, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #OpenWeight #Proprietary #Japanese #Author Thread-Post Issue Date: 2025-08-20 Comment
元ポスト:
LLMの性能を公平な条件で評価するために、従来のnon thinkingモデルで採用していた方法はthinkingモデルでは過小評価につながることが明らかになった(e.g., non thinkingモデルはzero shotを標準とするが、thinkingモデルではfewshot、chat templateの採用等)ため、日本語/英語ともに信頼の高い6つのベンチマークを採用し、thinkingモデルに対して公平な統一的な評価フレームワークを確立。主要なプロプライエタリ、OpenLLMに対して評価を実施し、リーダーボードとして公開。Reasoningモデルに対する最新の日本語性能を知りたい場合はこちらを参照するのが良いと思われる。
評価に用いられたフレームワークはこちら:
https://github.com/swallow-llm/swallow-evaluation-instruct
主要モデルの性能比較:
リーダーボードがアップデート:
-
-
GPT-5.4, Qwen 3.5, Gemma 4, llm-jp04などが追加され、Gemma 4 31Bが非常に強力な日本語性能を備えており、GPT-5.4 Thinkingに匹敵する日本語性能を備えているとのこと。
Diffusion Language Models are Super Data Learners, Jinjie Ni and the team, 2025.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #DiffusionModel Issue Date: 2025-08-09 Comment
dLLMは学習データの繰り返しに強く、データ制約下においては十分な計算量を投入してepochを重ねると、性能向上がサチらずにARモデルを上回る。
- [Paper Note] Diffusion Beats Autoregressive in Data-Constrained Settings, Mihir Prabhudesai+, arXiv'25
- 追記: 上記研究の著者による本ポストで取り上げられたissueに対するclarification
-
でも同様の知見が得られている。
が、スレッド中で両者の違いが下記のように(x rollrng reviewなるものを用いて)ポストされており、興味がある場合は読むといいかも。(ところで、x rolling reviewとは、、?もしやLLMによる自動的な査読システム?)
- [Paper Note] Scaling Data-Constrained Language Models, Niklas Muennighoff+, NeurIPS'23
において、ARモデルではrepetitionは4回までがコスパ良いという話と比べると、dLLMにとんでもない伸び代があるような話に見える。
(話が脱線します)
個人的にはアーキテクチャのさらなる進化は興味深いが、ユーザが不完全な質問をLLMに投げた時に、LLMがユーザの意図が「不明な部分のcontextを質問を返すことによって補う」という挙動があると嬉しい気がするのだが、そういった研究はないのだろうか。
ただ、事前学習時点でそういったデータが含まれて知識として吸収され、かつmid/post-trainingでそういった能力を引き出すと言う両軸で取り組まないと、最悪膨大な計算資源を投じたものの「わからない!どういうこと!?」と返し続けるLLMが完成し全く役に立たない、ということになりそうで怖い。
gpt5が出た時に、「3.9と3.11はどちらが大きいですか?」というクエリを投げた際にいまだに「3.11」と回答してくる、みたいなポストが印象的であり、これはLLMが悪いと言うより、ユーザ側が算数としての文脈できいているのか、ソフトウェアのバージョンの文脈できいているのか、を指定していないことが原因であり、上記の回答はソフトウェアのバージョニングという文脈では正答となる。LLMが省エネになって、ユーザのデータを蓄積しまくって、一人一人に対してあなただけのLLM〜みたいな時代がくれば少しは変わるのだろうが、それでもユーザがプロファイルとして蓄積した意図とは異なる意図で質問しなければならないという状況になると、上記のような意図の取り違えが生じるように思う。
なのでやはりりLLM側が情報が足りん〜と思ったら適切なturn数で、最大限の情報をユーザから引き出せるような逆質問を返すみたいな挙動、あるいは足りない情報があったときに、いくつかの候補を提示してユーザ側に提示させる(e.g., 算数の話?それともソフトウェアの話?みたいな)、といった挙動があると嬉しいなぁ、感。
んでそこの部分の性能は、もしやるな、promptingでもある程度は実現でき、それでも全然性能足りないよね?となった後に、事前学習、事後学習でより性能向上します、みたいな流れになるのかなぁ、と想像するなどした。
しかしこういう話をあまり見ないのはなぜだろう?私の観測範囲が狭すぎる or 私のアイデアがポンコツなのか、ベンチマーク競争になっていて、そこを向上させることに業界全体が注力してしまっているからなのか、はたまた裏ではやられているけど使い物にならないのか、全然わからん。
続報:
- Diffusion Language Models are Super Data Learners, Ni+, 2025.10
ポイント解説:
dLLMはtoolcallを含む生成ができない、というのは確かにそうだと思った。
The Big LLM Architecture Comparison, Sebastian Laschka, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Transformer #Blog #Architecture Issue Date: 2025-08-06 Comment
Qwen3とGPT-OSSの比較はこちら:
最新のモデルも含めて内容が更新:
DeepSeek V3/R1
- MLA
- MoE
OLMo2
- LayerNorm → RMSNorm
- PreLN → PostNorm (Post RMSNorm)
- ただしオリジナルのtransformerとは異なり、residual connectionの内側にRMSNormが入る
- QK-Norm
- PostNorm + QK-Normによりpost normalizationのアーキテクチャでも学習が安定
Gemma3
- 27B程度の性能がそこそこ良く使いやすいサイズにフォーカス
- Sliding Window Attention / Local Attention
- Gemma2はlocal:global比はり1:1で、window幅は4kだったが、Gemma3は5:1となり、localの比率が5倍になり、window幅も1024となり1/4に
- ablation実験の結果性能の低下はminimumであることが示されている
- GQA
- Pre-RMSNorm + Post-RMSNorm
- これもresidual connectionの内側
あとで書く
Synthetic Data in the Era of LLMs, Tutorial at ACL 2025
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #SyntheticData #Slide #ACL Issue Date: 2025-08-06 Comment
元ポスト:
gpt-oss-120b, OpenAI, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight #MoE(Mixture-of-Experts) #AttentionSinks #read-later #KeyPoint Notes #Reference Collection Issue Date: 2025-08-05 Comment
blog:
https://openai.com/index/introducing-gpt-oss/
HF:
https://huggingface.co/datasets/choosealicense/licenses/blob/main/markdown/apache-2.0.md
アーキテクチャで使われている技術まとめ:
-
-
-
-
- こちらにも詳細に論文がまとめられている
上記ポスト中のアーキテクチャの論文メモリンク(管理人が追加したものも含む)
- Sliding Window Attention
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
- [Paper Note] Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, Zihang Dai+, ACL'19
- MoE
- [Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
- RoPE w/ YaRN
- [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
- [Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
- Attention Sinks
- [Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
- Attention Sinksの定義とその気持ち、Zero Sink, Softmaxの分母にバイアス項が存在する意義についてはこのメモを参照のこと。
- [Paper Note] Why do LLMs attend to the first token?, Federico Barbero+, COLM'25
- Attention Sinksが実際にどのように効果的に作用しているか?についてはこちらのメモを参照。
- [Paper Note] When Attention Sink Emerges in Language Models: An Empirical View, Xiangming Gu+, ICLR'25
-
- Sink Token (or Zero Sink) が存在することで、decoder-onlyモデルの深い層でのrepresentationのover mixingを改善し、汎化性能を高め、promptに対するsensitivityを抑えることができる。
- (Attentionの計算に利用する) SoftmaxへのLearned bias の導入 (によるスケーリング)
- これはlearnable biasが導入されることで、attention scoreの和が1になることを防止できる(余剰なアテンションスコアを捨てられる)ので、Zero Sinkを導入しているとみなせる(と思われる)。
- GQA
- [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
- SwiGLU
- [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02 -
- group size 8でGQAを利用
- Context Windowは128k
- 学習データの大部分は英語のテキストのみのデータセット
- STEM, Coding, general knowledgeにフォーカス
-
https://openai.com/index/gpt-oss-model-card/
あとで追記する
他Open Weight Modelとのベンチマークスコア比較:
-
-
-
-
- long context
-
- Multihop QA
解説:
learned attention sinks, MXFP4の解説:
Sink Valueの分析:
gpt-oss の使い方:
https://note.com/npaka/n/nf39f327c3bde?sub_rt=share_sb
[Paper Note] Comments-Oriented Document Summarization: Understanding Documents with Reader’s Feedback, Hu+, SIGIR’08, 2008.07
fd064b2-338a-4f8d-953c-67e458658e39
Qwen3との深さと広さの比較:
- The Big LLM Architecture Comparison, Sebastian Laschka, 2025.07
Phi4と同じtokenizerを使っている?:
post-training / pre-trainingの詳細はモデルカード中に言及なし:
-
-
ライセンスに関して:
> Apache 2.0 ライセンスおよび当社の gpt-oss 利用規約に基づくことで利用可能です。
引用元:
https://openai.com/ja-JP/index/gpt-oss-model-card/
gpt-oss利用規約:
https://github.com/openai/gpt-oss/blob/main/USAGE_POLICY
cookbook全体: https://cookbook.openai.com/topic/gpt-oss
gpt-oss-120bをpythonとvLLMで触りながら理解する: https://tech-blog.abeja.asia/entry/gpt-oss-vllm
指示追従能力(IFEVal)が低いという指摘:
GLM-4.5: Reasoning, Coding, and Agentic Abililties, Zhipu AI Inc., 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight Issue Date: 2025-07-29 Comment
元ポスト:
HF: https://huggingface.co/collections/zai-org/glm-45-687c621d34bda8c9e4bf503b
詳細なまとめ:
こちらでもMuon Optimizerが使われており、アーキテクチャ的にはGQAやMulti Token Prediction, QK Normalization, MoE, 広さよりも深さを重視の構造、みたいな感じな模様?
- [Paper Note] Muon is Scalable for LLM Training, Jingyuan Liu+, arXiv'25, 2025.02
LLM Servingを支える技術, Kotoba Technologies, 2025.07
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #LLMServing #SoftwareEngineering #read-later Issue Date: 2025-07-22 Comment
こちらも参照のこと:
- LLM推論に関する技術メモ, iwashi.co, 2025.07
LLM推論に関する技術メモ, iwashi.co, 2025.07
Paper/Blog Link My Issue
#Article #Tutorial #Metrics #NLP #LanguageModel #LLMServing #MoE(Mixture-of-Experts) #SoftwareEngineering #Parallelism #Inference #Batch Issue Date: 2025-07-21 Comment
```
メモリ (GB) = P × (Q ÷ 8) × (1 + オーバーヘッド)
- P:パラメータ数(単位は10億)
- Q:ビット精度(例:16、32)、8で割ることでビットをバイトに変換
- オーバーヘッド(%):推論中の追加メモリまたは一時的な使用量(例:KVキャッシュ、アクティベーションバッファ、オプティマイザの状態)
```
↑これ、忘れがちなのでメモ…
関連(量子化関連研究):
- [Paper Note] AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, Ji Lin+, MLSys'24
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, Guangxuan Xiao+, ICML'23
- [Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
すごいメモだ…勉強になります
論文では語られないLLM開発において重要なこと Swallow Projectを通して, Kazuki Fujii, NLPコロキウム, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Slide #Japanese #SoftwareEngineering #Reading Reflections Issue Date: 2025-07-16 Comment
私の想像など遥かに超える、LLM開発における非常に困難な側面が記述されており、これをできるのはあまりにもすごいという感想を抱いた(小並感だけど本当にすごいと思う。すごいとしか言いようがない)
Modded-NanoGPT, KellerJordan, 2024.05
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #Repository #Optimizer #Decoder Issue Date: 2025-07-15 Comment
NanoGPT speedrun
関連:
- [Paper Note] The Automated LLM Speedrunning Benchmark: Reproducing NanoGPT Improvements, Bingchen Zhao+, arXiv'25
- きみはNanoGPT speedrunを知っているか?, PredNext, 2025.07
MuonとAdamWのweight decayをHyperball optimizationに置き換えることで記録更新されたようである:
Hyperball optimizationについては以下:
- Fantastic Pretraining Optimizers and Where to Find Them 2.1: Hyperball Optimization, Wen+, 2026.01
SOAP preconditioningをMuon直交化の前に加えることでSoTAとのこと。
関連:
- [Paper Note] SOAP: Improving and Stabilizing Shampoo using Adam, Nikhil Vyas+, ICLR'25
Kimi K2: Open Agentic Intelligence, moonshotai, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Optimizer #OpenWeight #MoE(Mixture-of-Experts) #read-later #Stability #KeyPoint Notes #Reference Collection Issue Date: 2025-07-12 Comment
元ポスト:
1T-A32Bのモデル。さすがに高性能。
(追記) Reasoningモデルではないのにこの性能のようである。
1T-A32Bのモデルを15.5Tトークン訓練するのに一度もtraining instabilityがなかったらしい
元ポスト:
量子化したモデルが出た模様:
仕事早すぎる
DeepSeek V3/R1とのアーキテクチャの違い:
MLAのヘッドの数が減り、エキスパートの数を増加させている
解説ポスト:
利用されているOptimizer:
- [Paper Note] Muon is Scalable for LLM Training, Jingyuan Liu+, arXiv'25, 2025.02
2つほどバグがあり修正された模様:
chatbot arenaでOpenLLMの中でトップのスコア
元ポスト:
テクニカルペーパーが公開:
https://github.com/MoonshotAI/Kimi-K2/blob/main/tech_report.pdf
元ポスト:
テクニカルレポートまとめ:
以下のような技術が使われている模様
- [Paper Note] Rewriting Pre-Training Data Boosts LLM Performance in Math and Code, Kazuki Fujii+, ICLR'26, 2025.05
- MLA MHA vs MQA vs GQA vs MLA, Zain ul Abideen, 2024.07
- MuonCip
- MuonOptimizer [Paper Note] Muon is Scalable for LLM Training, Jingyuan Liu+, arXiv'25, 2025.02
- QK-Clip
- 参考(こちらはLayerNormを使っているが): [Paper Note] Unified-IO 2: Scaling Autoregressive Multimodal Models with Vision, Language, Audio, and Action, Jiasen Lu+, CVPR'24, 2023.12
- RLVR
- DeepSeek-R1, DeepSeek, 2025.01
- Self-Critique
- 関連: [Paper Note] Inference-Time Scaling for Generalist Reward Modeling, Zijun Liu+, arXiv'25
- [Paper Note] Writing-Zero: Bridge the Gap Between Non-verifiable Tasks and Verifiable Rewards, Ruipeng Jia+, arXiv'25, 2025.05
- Temperature Decay
- 最初はTemperatureを高めにした探索多めに、後半はTemperatureを低めにして効用多めになるようにスケジューリング
- Tool useのためのSynthetic Data
Reward Hackingに対処するため、RLVRではなくpairwise comparisonに基づくself judging w/ critique を利用きており、これが非常に効果的な可能性があるのでは、という意見がある:
SmolLM3: smol, multilingual, long-context reasoner, HuggingFace, 2025.07
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Reasoning #LongContext #SmallModel #MultiLingual #OpenWeight #OpenSource Issue Date: 2025-07-09 Comment
元ポスト:
SmolLM3を構築する際の詳細なレシピ(アーキテクチャ、データ、data mixture, 3 stageのpretraining(web, code, mathの割合と品質をステージごとに変え、stable->stable->decayで学習), midtraining(long context->reasoning, post training(sft->rl), ハイブリッドreasoningモデルの作り方、評価など)が説明されている
学習/評価スクリプトなどがリリース:
[Paper Note] Language Models are Unsupervised Multitask Learners, Radford+, OpenAI, 2019
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Zero/FewShotLearning #One-Line Notes Issue Date: 2025-06-15 Comment
今更ながら、GPT-2論文をメモってなかったので追加。
従来のモデルは特定のタスクを解くためにタスクごとに個別のモデルをFinetuningする必要があったが、大規模なWebTextデータ(Redditにおいて最低3つのupvoteを得たポストの外部リンクを収集)によって言語モデルを訓練し、モデルサイズをスケーリングさせることで、様々なタスクで高い性能を獲得でき、Zero-Shot task transfer, p(output | input, task) , が実現できるよ、という話。
今ざっくり見返すと、Next Token Predictionという用語は論文中に出てきておらず、かつ "Language Modeling" という用語のみで具体的なlossは記述されておらず(当時はRNN言語モデルで広く学習方法が知られていたからだろうか?)、かつソースコードも学習のコードは提供されておらず、lossの定義も含まれていないように見える。
ソースコードのモデル定義:
https://github.com/openai/gpt-2/blob/master/src/model.py#L169
verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #ReinforcementLearning #python #One-Line Notes #Reference Collection #TrainingFramework Issue Date: 2025-05-16 Comment
SoTAなRLアルゴリズムを数行のコードで実装可能で、Sequence Parallelismがサポートされているので長い系列を扱える。FSDP, Megatron-LM,vLLM,SGLangなどとシームレスに統合できるっぽい?
注意点(超重要):
inference backend(ブログ中ではvLLM, SGLangなどを仮定。ロールアウトに利用する)とtrainingのbackend(モデルを学習するフレームワーク, FSDPなどを仮定する)のミスマッチによってトークンの生起確率に差が生じ、ポリシーの更新がうまくいかなくなる。
- 論文では語られないLLM開発において重要なこと Swallow Projectを通して, Kazuki Fujii, NLPコロキウム, 2025.07
でも言われているように、ライブラリにはバグがあるのが普通なのね、、、。
Stanford Alpaca: An Instruction-following LLaMA Model, Taori +, 2023.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #PostTraining #One-Line Notes Issue Date: 2025-05-12 Comment
今更ながらメモに追加。アカデミアにおけるOpenLLMに対するInstruction Tuningの先駆け的研究。
時系列データのvalidationに関する質問に回答します, カレーちゃん, 2022.07
Paper/Blog Link My Issue
#Article #TimeSeriesDataProcessing #MachineLearning #Evaluation #Blog Issue Date: 2025-05-09 Comment
元スレッド:
めちゃめちゃ参考になる・・・
BFCLv2, UC Berkeley, 2024.08
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #API #One-Line Notes #ToolUse Issue Date: 2025-04-08 Comment
LLMのTool Useを評価するための現在のデファクトスタンダードとなるベンチマーク
BFCLv3:
https://gorilla.cs.berkeley.edu/blogs/13_bfcl_v3_multi_turn.html
言語モデルの物理学, 佐藤竜馬, 2025.03
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Blog Issue Date: 2025-03-25 Comment
必読
Nemotron-H: A Family of Accurate, Efficient Hybrid Mamba-Transformer Models, Nvidia, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #Supervised-FineTuning (SFT) #MultiModal #Blog #SSM (StateSpaceModel) #One-Line Notes Issue Date: 2025-03-24 Comment
関連:
- Hunyuan T1, Tencent, 2025.03
TransformerのSelf-attention LayerをMamba2 Layerに置換することで、様々なベンチマークで同等の性能、あるいは上回る性能で3倍程度のInference timeの高速化をしている(65536 input, 1024 output)。
56B程度のmediumサイズのモデルと、8B程度の軽量なモデルについて述べられている。特に、8BモデルでMambaとTransformerのハイブリッドモデルと、通常のTransformerモデルを比較している。学習データに15 Trillion Tokenを利用しており、このデータ量でのApple to Appleのアーキテクチャ間の比較は、現状では最も大規模なものとのこと。性能は多くのベンチマークでハイブリッドにしても同等、Commonsense Understandingでは上回っている。
また、学習したNemotron-Hをバックボーンモデルとして持つVLMについてもモデルのアーキテクチャが述べられている。
Model Context Protocol (MCP), Anthropic
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #SoftwareEngineering #MCP Issue Date: 2025-03-15 Comment
下記リンクのMCPサーバ/クライアントの作り方を読むとだいぶ理解が捗る:
https://modelcontextprotocol.io/quickstart/server
https://modelcontextprotocol.io/quickstart/client
OLMo 2 32B: First fully open model to outperform GPT 3.5 and GPT 4o mini, AllenAI, 20250.3
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #OpenSource #Initial Impression Notes Issue Date: 2025-03-14 Comment
真なる完全なるオープンソース(に近い?)OLMOの最新作
学習が安定しやすいpre LNではなく性能が最大化されやすいPost LNを採用している模様。学習を安定化させるために、QKNormやRMSNormを採用するなどの工夫を実施しているらしい。
smolagents, HuggingFace, 2025.03
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Library #AIAgents Issue Date: 2025-03-06
The Ultra-Scale Playbook: Training LLMs on GPU Clusters, HuggingFace, 2025.02
Paper/Blog Link My Issue
#Article #Pretraining #MachineLearning #LanguageModel #Supervised-FineTuning (SFT) #One-Line Notes Issue Date: 2025-03-04 Comment
HuggingFaceによる数1000のGPUを用いたAIモデルのトレーニングに関するオープンソースのチュートリアル
SGlang, sgl-project, 2024.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #python #LLMServing #SoftwareEngineering #One-Line Notes #Reference Collection Issue Date: 2025-02-12 Comment
- Open R1, HuggingFace, 2025.01
のUpdate2でMath Datasetの生成に利用されたLLM Servingフレームワーク。利用前と比較してスループットが2倍になったとのこと。
CPU, external storageを利用することでTTFTを改善するようになったようで、最大80%TTFTが削減されるとの記述がある。
(原理的には元来可能だが計算効率の最適化に基づく誤差によって実装上の問題で実現できていなかった) Deterministic Inferenceをサポート:
DeepSeek-R1の論文読んだ?【勉強になるよ】 , asap, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #FoundationModel #RLHF #Blog #Reading Reflections Issue Date: 2025-02-01 Comment
- DeepSeek-R1, DeepSeek, 2025.01
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open
Language Models, Zhihong Shao+, arXiv'24
とても丁寧でわかりやすかった。後で読んだ内容を書いて復習する。ありがとうございます。
Open R1, HuggingFace, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #Reasoning #OpenSource #One-Line Notes #Reference Collection Issue Date: 2025-01-26 Comment
HFによるDeepSeekR1を完全に再現する取り組み
Update1: https://huggingface.co/blog/open-r1/update-1
Update2:
https://huggingface.co/blog/open-r1/update-2
512機のH100を利用…
LLM Datasets, mlabonne, 2025.01
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Supervised-FineTuning (SFT) #Repository #PostTraining #One-Line Notes Issue Date: 2025-01-25 Comment
LLMの事後学習用のデータをまとめたリポジトリ
現在も更新されている。
DeepSeek-R1, DeepSeek, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #OpenWeight #Reference Collection Issue Date: 2025-01-21 Comment
参考:
参考: https://horomary.hatenablog.com/entry/2025/01/26/204545
DeepSeek-R1の論文読んだ?【勉強になるよ】
, asap:
https://zenn.dev/asap/articles/34237ad87f8511
こちらのポストの図解がわかりやすい:
最新モデル: DeepSeek-R1-0528
https://huggingface.co/deepseek-ai/DeepSeek-R1-0528
所見:
Advanced RAG Techniques: Elevating Your Retrieval-Augmented Generation Systems, NirDiamant, 2025.01
Paper/Blog Link My Issue
#Article #Tutorial #InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #Repository #One-Line Notes Issue Date: 2025-01-05 Comment
元ポスト:
RAGのための細かなテクニックが(コードのサンプルへのリンク付きで)大量にまとまっている。かなり頻繁に更新れているようで非常に良さそう
まだ更新されている。
完全にオープンな約1,720億パラメータ(GPT-3級)の大規模言語モデル 「llm-jp-3-172b-instruct3」を一般公開 ~GPT-3.5を超える性能を達成~ , NII, 2024.12
Paper/Blog Link My Issue
#Article #Tools #NLP #Dataset #LanguageModel #Blog #OpenWeight #Japanese #OpenSource #One-Line Notes Issue Date: 2024-12-24 Comment
GPT3.5と同程度のパラメータ数のコーパス、モデル、ツール、全てを公開。学習データまで含めてオープンなモデルとしては世界最大規模とのこと。
Instructionチューニング済みのモデルはライセンスを読むと、ライセンスに記述されている内容を遵守すれば、誰でも(日本人なら18歳以上とかはあるが)アクセス可能、用途の制限(商用・非商用問わず)なく利用でき、かつ再配布や派生物の生成などが許されているように見える。
が、baseモデルの方はコンタクト情報を提供のうえ承認を受けないと利用できない模様。また、再配布と一部の使途に制限がある模様。
SNSではオープンソースではないなどという言説も出ており、それはbaseモデルの方を指しているのだろうか?よくわからない。
実用上はinstructionチューニング済みのモデルの方がbaseモデルよりも使いやすいと思うので、問題ない気もする。
やはりbaseとinstructでライセンスは2種類あるとのこと:
RLHF_DPO 小話, 和地瞭良_ Akifumi Wachi, 2024.04
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #LanguageModel #Alignment #RLHF #Blog #DPO #PostTraining #Reading Reflections Issue Date: 2024-12-18 Comment
めちゃめちゃ勉強になる…
Scaling test-time-compute, Huggingface, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Blog #Test-Time Scaling #read-later Issue Date: 2024-12-17 Comment
これは必読
ローカルLLMのリリース年表, npaka, 随時更新, 2024.11
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Blog #OpenWeight #OpenSource #One-Line Notes Issue Date: 2024-11-15 Comment
ローカルLLMを含むOpenLLMのリリース日が年表としてまとまっており、随時更新されている模様。すごい。
2026年3月現在も更新が続いている
Unsloth, unslothai, 2024.07
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #Supervised-FineTuning (SFT) #InstructionTuning #PEFT(Adaptor/LoRA) #PostTraining #One-Line Notes #TrainingFramework Issue Date: 2024-10-08 Comment
single-GPUで、LLMのLoRA/QLoRAを高速/省メモリに実行できるライブラリ
現在でも鉄板
Streamlit, 2020.12
Paper/Blog Link My Issue
#Article #Library #python #One-Line Notes #Data Issue Date: 2024-10-07 Comment
データを用いたアプリを簡単に作れるpythonライブラリ
データ/モデルを用いたvisualization等を実施するアプリを、数行で作れてしまう。綺麗なUIつき。便利。
[Paper Note] Improving Language Understanding by Generative Pre-Training, OpenAI, 2018.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel Issue Date: 2024-09-25 Comment
初代GPT論文
日本語解説: https://qiita.com/Toyamanokinsan/items/adff5e927fe26148c69c
OpenAI o1, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Reasoning #Test-Time Scaling #VisionLanguageModel #KeyPoint Notes Issue Date: 2024-09-13 Comment
Jason Wei氏のポスト:
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
や
- [Paper Note] Implicit Chain of Thought Reasoning via Knowledge Distillation, Yuntian Deng+, arXiv'23, 2023.11
で似たような考えはすでに提案されていたが、どのような点が異なるのだろうか?
たとえば前者は、pauseトークンと呼ばれるoutputとは関係ないトークンを生成することで、outputを生成する前にモデル内部で推論する前により多くのベクトル操作を加える(=ベクトルを縦方向と横方向に混ぜ合わせる; 以後ベクトルをこねくりまわすと呼称する)、といった挙動を実現しているようだが、明示的にCoTの教師データを使ってSFTなどをしているわけではなさそうに見える(ざっくりとしか読んでないが)。
一方、Jason Wei氏のポストからは、RLで明示的により良いCoTができるように学習をしている点が違うように見える。
**(2025.0929): 以下のtest-time computeに関するメモはo1が出た当初のものであり、私の理解が甘い状態でのメモなので現在の理解を後ほど追記します。当時のメモは改めて見返すとこんなこと考えてたんだなぁとおもしろかったので残しておきます。**
学習の計算量だけでなく、inferenceの計算量に対しても、新たなスケーリング則が見出されている模様。
テクニカルレポート中で言われている time spent thinking (test-time compute)というのは、具体的には何なのだろうか。
上の研究でいうところの、inference時のpauseトークンの生成のようなものだろうか。モデルがベクトルをこねくり回す回数(あるいは生成するトークン数)が増えると性能も良くなるのか?
しかしそれはオリジナルのCoT研究である
- [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
のdotのみの文字列をpromptに追加して性能が向上しなかった、という知見と反する。
おそらく、**モデル学習のデコーディング時に**、ベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすこと=time spent thinking (test-time compute) 、ということなのだろうか?
そしてそのように学習されたモデルは、推論時にベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすと性能が上がる、ということなのだろうか。
もしそうだとすると、これは
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
のpauseトークンの生成をしながらfinetuningすると性能が向上する、という主張とも合致するように思うが、うーん。
実際暗号解読のexampleを見ると、とてつもなく長いCoT(トークンの生成数が多い)が行われている。
RLでReasoningを学習させる関連研究:
- ReFT: Reasoning with Reinforced Fine-Tuning, Trung Quoc Luong+, N/A, ACL'24
- Training Large Language Models for Reasoning through Reverse Curriculum Reinforcement Learning, Zhiheng Xi+, N/A, ICML'24
以下o1の動きに関して考えている下記noteからの引用。
>これによって、LLMはモデルサイズやデータ量をスケールさせる時代から推論時間をスケールさせる(つまり、沢山の推論ステップを探索する)時代に移っていきそうです。
なるほど。test-compute timeとは、推論ステップ数とその探索に要する時間という見方もあるのですね。
またnote中では、CoTの性能向上のために、Process Reward Model(PRM)を学習させ、LLMが生成した推論ステップを評価できるようにし、PRMを報酬モデルとし強化学習したモデルがo1なのではないか、と推測している。
PRMを提案した研究では、推論ステップごとに0,1の正誤ラベルが付与されたデータから学習しているとのこと。
なるほど、勉強になります。
note:
https://note.com/hatti8/n/nf4f3ce63d4bc?sub_rt=share_pb
note(詳細編): https://note.com/hatti8/n/n867c36ffda45?sub_rt=share_pb
こちらのリポジトリに関連論文やXポスト、公式ブログなどがまとめられている:
https://github.com/hijkzzz/Awesome-LLM-Strawberry
これはすごい。論文全部読みたい
Late Chunking: Balancing Precision and Cost in Long Context Retrieval, Pierse+, 2024.09
Paper/Blog Link My Issue
#Article #Embeddings #InformationRetrieval #NLP #RAG(RetrievalAugmentedGeneration) #Blog #One-Line Notes Issue Date: 2024-09-08 Comment
chunkingしてからembeddingを取得するより、全体のドキュメントに対してcontextualなtoken embeddingを取得し、その後chunkingをしてpoolingしてsingle vectorにする方が、文書の文脈情報がembedding内で保持されやすいので、precisionが上がりますよ、という話
Liger-Kernel, 2024.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #Repository #PostTraining #One-Line Notes Issue Date: 2024-08-25 Comment
LLMを学習する時に、ワンライン追加するだけで、マルチGPUトレーニングのスループットを20%改善し、メモリ使用量を60%削減するらしい
元ツイート:
Unsloth Unsloth, unslothai, 2024.07
はLoRA/QLoRAが可能な一方でまだMulti-GPUはサポートしていない。一方、Liger-KernelはLoRAよりもfull-parameter tuningとMulti-GPUにフォーカスしており、目的に応じて使い分けが必要。
https://github.com/linkedin/Liger-Kernel/issues/57
Open Source Cookbook
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #GenerativeAI #Repository #OpenSource #One-Line Notes Issue Date: 2024-04-14 Comment
HuggingFaceによる様々な実用的なアプリケーションをオープンソースの実装やモデルで実現するノートブックがまとまったリポジトリ。LLM-as-a-judge, RAG, PEFTによるPrompt Tuning(Prefix Tuningとかそっち系の話だと思われる)など、現在16種類ほどあるらしい。
改めて見たら数がかなり増えていた
[Paper Note] Evolutionary Optimization of Model Merging Recipes, Takuya Akiba+, N_A, Nature Machine Intelligence, Vol.7, 2025.01
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #ModelMerge #KeyPoint Notes #Nature Machine Intelligence Issue Date: 2024-03-21 GPT Summary- 進化アルゴリズムを使用した新しいアプローチを提案し、強力な基盤モデルの自動生成を実現。LLMの開発において、人間の直感やドメイン知識に依存せず、多様なオープンソースモデルの効果的な組み合わせを自動的に発見する。このアプローチは、日本語のLLMと数学推論能力を持つモデルなど、異なるドメイン間の統合を容易にし、日本語VLMの性能向上にも貢献。オープンソースコミュニティへの貢献と自動モデル構成の新しいパラダイム導入により、基盤モデル開発における効率的なアプローチを模索。 Comment
複数のLLMを融合するモデルマージの話。日本語LLMと英語の数学LLNをマージさせることで日本語の数学性能を大幅に向上させたり、LLMとVLMを融合したりすることで、日本にしか存在しない概念の画像も、きちんと回答できるようになる。
著者スライドによると、従来のモデルマージにはbase modelが同一でないとうまくいかなかったり(重みの線型結合によるモデルマージ)、パラメータが増減したり(複数LLMのLayerを重みは弄らず再配置する)。また日本語LLMに対してモデルマージを実施しようとすると、マージ元のLLMが少なかったり、広範囲のモデルを扱うとマージがうまくいかない、といった課題があった。本研究ではこれら課題を解決できる。
著者による資料(NLPコロキウム):
https://speakerdeck.com/iwiwi/17-nlpkorokiumu
解説: https://scrapbox.io/gunosydm/Evolutionary_Optimization_of_Model_Merging_Recipes
[Paper Note] Instruction Tuning for Large Language Models: A Survey, Shengyu Zhang+, ACM Computing Surveys, Volume 58, Issue 7, 2026.01
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #InstructionTuning #One-Line Notes Issue Date: 2023-09-05 GPT Summary- 指示調整(IT)に関する研究を総括し、LLMsの能力向上術を解説。ITは、(instruction, output)ペアを用いてLLMsを追加訓練し、人間の指示に従う能力を強化するプロセス。SFTの方法論、データセット構築、訓練、および応用を体系的にレビューし、成果に影響する要因を分析。さらに、SFTの課題や現行戦略の欠点を明らかにし、今後の研究の道筋を提案。 Comment
主要なモデルやデータセットの作り方など幅広くまとまっている(Figure1および各Table)
arxivに2023年8月に登場しその後も更新が続き、ACM Computing Surveys, Volume 58, Issue 7に2026年1月に掲載された模様
https://dl.acm.org/doi/10.1145/3777411
人工知能研究の新潮流2 -基盤モデル・生成AIのインパクト-, 国立研究開発法人科学技術振興機構 研究開発戦略センター, 2023.07
Paper/Blog Link My Issue
#Article #Survey #LanguageModel #GenerativeAI #read-later #One-Line Notes Issue Date: 2023-08-12 Comment
280ページにものぼる現在のトレンドをまとめた日本語資料
ChatBot Arena, lmsys org, 2023.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #One-Line Notes #Arena Issue Date: 2023-05-04 Comment
クラウドソーシング型のチャットボット評価するシステム。ユーザはシステムにアクセスすると、二つのanonymisedされたLLMと対話し、どちらが優れていたかをvotingする。すべてのシステムとユーザのinteractionはロギングされており、最終的にElo RatingでLLM.をランキング付けする。
Arena-Hardと呼ばれるliveアリーナデータを用いたパイプラインを公開。MT-Benchよりも識別力が高く、Chatbot Arenaのランキングとのagreementが高いとのこと。
参考:
過去のデータについては Chatbot Arena Conversation Dataset Release, LMSYS Org, 2023.07 などもある
LoRA論文解説, Hayato Tsukagoshi, 2023.04
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #Slide #PostTraining #KeyPoint Notes Issue Date: 2023-04-25 Comment
ベースとなる事前学習モデルの一部の線形層の隣に、低ランク行列A,Bを導入し、A,Bのパラメータのみをfinetuningの対象とすることで、チューニングするパラメータ数を激減させた上で同等の予測性能を達成し、推論速度も変わらないようにするfinetuning手法の解説
LoRAを使うと、でかすぎるモデルだと、そもそもGPUに載らない問題や、ファインチューニング後のモデルファイルでかすぎワロタ問題が回避できる。
前者は事前学習済みモデルのBPのための勾配を保存しておく必要がなくなるため学習時にメモリ節約になる。後者はA,Bのパラメータだけ保存すればいいので、ストレージの節約になる。
かつ、学習速度が25%程度早くなる。
既存研究であるAdapter(transformerの中に学習可能なMLPを差し込む手法)は推論コストが増加し、prefix tuningは学習が非常に難しく、高い性能を達成するためにprefixとして128 token入れたりしなければならない。
huggingfaceがすでにLoRAを実装している
https://github.com/huggingface/peft
Transformerの最前線 〜 畳込みニューラルネットワークの先へ 〜, Yoshitaka Ushiku, 2022.06
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #NLP #Transformer #Slide #Reading Reflections Issue Date: 2022-09-06 Comment
Transformerの動作原理を直感的に理解するのに非常にわかりやすい説明で、とても勉強になる。
以下のような内容が解説されており、あまりにも盛りだくさんで最高。
- Positional Encoding
- autoregressive vs. non-autoregressive
- residual connection
- multi-head attention
- RNN(O(N)だけど長い系列苦手), CNN(O(N)だけど近傍しか見れない)との対比
- Vision & Languageの話題とVision Transformerとのつながり
- Swin Transformer
- 基盤モデルの定義
- ある目的関数のもと、自己教師あり学習された、巨大なモデル(様々なタスクに容易に転用できる)
- gMLP, MLP-MixerなどのMLP likeなアーキテクチャとの比較
- Transformerと本質的にやっていることはあまり変わらず、ベクトルの混ぜ方(attention vs. 行列積)と位置情報の保持をベクトルがするのかindexに基づいてネットワークが保持するのか、が変わっているのみ
- Transformer性能向上の軌跡
- pre-Norm / post-Norm / 活性化関数(GLU等) / MoE等 / RoPE
- Scaling Law
- CNNとViTの性質(CNNはハイパスフィルタ、ViTはローパスフィルタ)
事前学習言語モデルの動向 _ Survey of Pretrained Language Models, Kyosuke Nishida, 2019
Paper/Blog Link My Issue
#Article #NeuralNetwork #Survey #NLP #LanguageModel #Slide #KeyPoint Notes Issue Date: 2019-11-09 Comment
[2019/06まで]
・ELMo(双方向2層LSTM言語モデル)
・GPT(left-to-rightの12層Transformer自己回帰言語モデル)
・BERT(24層のTransformer双方向言語モデル)
・MT-DNN(BERTの上にマルチタスク層を追加した研究)
・XLM(パラレル翻訳コーパスを用いてクロスリンガルに穴埋めを学習)
・TransformerXL(系列長いに制限のあった既存モデルにセグメントレベルの再帰を導入し長い系列を扱えるように)
・GPT-2(48層Transformerの自己回帰言語モデル)
・ERNIE 1.0(Baidu, エンティティとフレーズの外部知識を使ってマスクに利用)
・ERNIE(Tsinghua, 知識グラフの情報をfusionしたLM)
・Glover(ドメイン、日付、著者などを条件とした生成を可能としたGPT)
・MASS(Encoder-Decoder型の生成モデルのための事前学習)
・UniLM(Sequence-to-Sequenceを可能にした言語モデル)
・XLNet(自己回帰(単方向)モデルと双方向モデルの両方の利点を得ることを目指す)
[2019/07~]
・SpanBERT(i.i.dではなく範囲でマスクし、同時に範囲の境界も予測する)
・ERNIE 2.0(Baidu, マルチタスク事前学習; 単語レベル・構造レベル・意味レベル)
・RoBERTa(BERTと同じ構造で工夫を加えることで性能向上)
- より大きなバッチサイズを使う(256から8192)
- より多くのデータを使う(16GBから160GB)
- より長いステップ数の学習をする(BERT換算で16倍)
- 次文予測(NSP)は不要
→ GLUEでBERT, XLNetをoutperform
・StructBERT (ALICE, NSPに代わる学習の目的関数を工夫)
- マスクした上で単語の順番をシャッフルし元に戻す
- ランダム・正順・逆順の3種類を分類
→ BERTと同サイズ、同データでBERT, RoBERTa超え
・DistilBERT(蒸留により、12層BERTを6層に小型化(40%減))
- BERTの出力を教師として、生徒が同じ出力を出すように学習
- 幅(隠れ層)サイズを減らすと、層数を経あrスよりも悪化
→ 推論は60%高速化、精度は95%程度を保持
・Q8BERT(精度を落とさずにfine-tuning時にBERTを8bit整数に量子化)
- Embedding, FCは8bit化、softmax, LNorm, GELUは32bitをキープ
→ モデルサイズ1/4, 速度3.7倍
・CTRL(条件付き言語モデル)
- 条件となる制御テキストを本文の前に与えて学習
- 48層/1280次元Transformer(パラメータ数1.6B)
・MegatronLM(72層、隠れ状態サイズ3072、長さ1024; BERTの24倍サイズ)
・ALBERT(BERTの層のパラメータをすべて共有することで学習を高速化; 2020年あたりのデファクト)
- Largeを超えたモデルは学習が難しいため、表現は落ちるが学習しやすくした
- 単語埋め込みを低次元にすることでパラメータ数削減
- 次文予測を、文の順序入れ替え判定に変更
→ GLUE, RACE, SQuADでSoTAを更新
・T5(NLPタスクをすべてtext-to-textとして扱い、Enc-Dec Transformerを745GBコーパスで事前学習して転移する)
- モデルはEncoder-DecoderのTransformer
- 学習タスクをエンコーダ・デコーダに合わせて変更
- エンコーダ側で範囲を欠落させて、デコーダ側で予測
→ GLUE, SuperGLUE, SQuAD1.1, CNN/DMでSoTA更新
・BART(Seq2Seqの事前学習として、トークンマスク・削除、範囲マスク、文の入れ替え、文書の回転の複数タスクで学習)
→ CNN/DMでT5超え、WMT'16 RO-ENで逆翻訳を超えてSoTA
ELMo, GPT, BERT, GPT-2, XLNet, RoBERTa, DistilBERT, ALBERT, T5あたりは良く見るような感
各データセットでの各モデルの性能も後半に記載されており興味深い。
ちなみに、CNN/DailyMail Datasetでは、T5, BARTあたりがSoTA。
R2で比較すると
- Pointer-Generator + Coverage Vectorが17,28
- LEAD-3が17.62
- BARTが21.28
- T5が21.55
となっている
Implicit
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #Library #One-Line Notes #Reference Collection Issue Date: 2019-09-11 Comment
Implicitデータに対するCollaborative Filtering手法がまとまっているライブラリ
Bayesian Personalized Ranking, Logistic Matrix Factorizationなどが実装。
Implicitの使い方はこの記事がわかりやすい:
https://towardsdatascience.com/building-a-collaborative-filtering-recommender-system-with-clickstream-data-dffc86c8c65
ALSの元論文の日本語解説
https://cympfh.cc/paper/WRMF
Recommender System Datasets, Julian McAuley
Paper/Blog Link My Issue
#Article #RecommenderSystems #Dataset #One-Line Notes Issue Date: 2019-04-12 Comment
Recommender Systems研究に利用できる各種データセットを、Julian McAuley氏がまとめている。
氏が独自にクロールしたデータ等も含まれている。
非常に有用。
Designing and Evaluating Explanations for Recommender Systems, Tintarev+, Recommender Systems Handbook, 2011
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #Explanation #Initial Impression Notes Issue Date: 2019-01-23 Comment
Recommender Systems HandbookのChapter。[Paper Note] A Survey of Explanations in Recommender Systems, Tintarev+, ICDEW'07
のSurveyと同じ著者による執筆。
推薦のExplanationといえばこの人というイメージ。
D論: http://navatintarev.com/papers/Nava%20Tintarev_PhD_Thesis_(2010).pdf
Educational Data Mining and Learning Analytics, Baker+, 2014
Paper/Blog Link My Issue
#Article #Survey #AdaptiveLearning #EducationalDataMining #LearningAnalytics Issue Date: 2018-12-22 Comment
Ryan BakerらによるEDM Survey
[Paper Note] Context-Aware Recommender Systems, Adomavicius+, Recommender Systems Handbook, 2011.09
Paper/Blog Link My Issue
#Article #RecommenderSystems #Classic #ContextAware #KeyPoint Notes Issue Date: 2018-12-22 Comment
Context-aware Recsysのパイオニア的研究
通常のuser/item paradigmを拡張して、いかにコンテキストの情報を考慮するかを研究。
コンテキスト情報は、
Explicit: ユーザのマニュアルインプットから取得
Implicit: 自動的に取得
inferred: ユーザとツールやリソースのインタラクションから推測(たとえば現在のユーザのタスクとか)
いくつかの異なるパラダイムが提案された:
1. recommendation via context-driven querying and search approach
コンテキストの情報を、特定のリポジトリのリソース(レストラン)に対して、クエリや検索に用いる。そして、best matchingなリソースを(たとえば、現在開いているもっとも近いレストランとか)をユーザに推薦。
2. Contextual preference elicitation and estimation approach
こっちは2012年くらいの主流。contextual user preferencesをモデル化し学習する。データレコードをしばしば、
3. contextual prefiltering approach
contextualな情報を(学習したcontextualなpreferenceなどを)、tradittionalなrecommendation algorithmを適用する前にデータのフィルタリングに用いる。
4. contextual postfiltering approach
entire setから推薦を作り、あとでcontextの情報を使ってsetを整える。
5. Contextual modeling
contextualな情報を、そのままrecommendationの関数にぶちこんでしまい、アイテムのratingのexplicitなpredictorとして使う。
3, 4はtraditionalな推薦アルゴリズムが適用できる。
1,2,5はmulti-dimensionalな推薦アルゴリズムになる。heuristic-based, model-based approachesが述べられているらしい。
[Paper Note] LEARNING AND TEACHING STYLES IN ENGINEERING EDUCATION, Felder, Engr. Education, 78(7), 674–681, 1988.01
Paper/Blog Link My Issue
#Article #Classic #Education #AdaptiveLearning #LearningStyle #One-Line Notes Issue Date: 2018-12-22 Comment
LearningStyleに関して研究している古典的な研究。
context-aware recsysの研究初期の頃は、だいたいはこのFelder-Silverman Theoryというのをベースに研究されていたらしい。
自然言語処理のためのDeep Learning, Yuta Kikuchi, 2013.09
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #NLP #Slide Issue Date: 2018-01-15
[Paper Note] Collaborative filtering for implicit feedback datasets, Hu+, International Conference on Data Mining, 2008.12
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #MatrixFactorization #KeyPoint Notes Issue Date: 2018-01-11 Comment
Implicit Feedbackなデータに特化したMatrix Factorization (MF)、Weighted Matrix Factorization (WMF)を提案。
ユーザのExplicitなFeedback(ratingやlike, dislikeなど)がなくても、MFが適用可能。
目的関数は式(3)のようになっている。
通常のMFでは、ダイレクトにrating r_{ui}を予測したりするが、WMFでは r_{ui}をratingではなく、たとえばユーザuがアイテムiを消費した回数などに置き換え、binarizeした数値p_{ui}を目的関数に用いる。
このとき、itemを消費した回数が多いほど、そのユーザはそのitemを好んでいると仮定し、そのような事例については重みが高くなるようにconfidence c_{ui}を計算し、目的関数に導入している。
日本語での解説: https://cympfh.cc/paper/WRMF
Implicit Implicit でのAlternating Least Square (ALS)という手法が、この手法の実装に該当する。
[Paper Note] The Decomposition of Human-Written Summary Sentences, Hongyan Jing+, SIGIR’99
Paper/Blog Link My Issue
#Article #DocumentSummarization #NLP #SIGIR #One-Line Notes #WordAlignment Issue Date: 2018-01-11 Comment
参照要約 - 原文書対が与えられた時に、参照要約中の単語と原文書中の単語のアライメントをとるHMMベースな手法を提案。
outputのサンプルはFigure3参照のこと。
[Paper Note] LexRank: Graph-based Lexical Centrality as Salience in Text Summarization, Erkan+, Journal of Artificial Intelligence Research, 2004.12
Paper/Blog Link My Issue
#Article #Multi #Single #DocumentSummarization #Document #Unsupervised #GraphBased #NLP #Extractive #KeyPoint Notes Issue Date: 2018-01-01 Comment
代表的なグラフベースな(Multi) Document Summarization手法。
ほぼ
- [Paper Note] TextRank: Bringing Order into Texts, Mihalcea+, EMNLP'04
と同じ手法。
2種類の手法が提案されている:
* [LexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを計算し閾値以上となったsentenceの間にのみedgeを張る(重みは確率的に正規化)。その後べき乗法でPageRank。
* [ContinousLexRank] tf-idfスコアでsentenceのbag-of-wordsベクトルを作り、cosine similarityを用いてAffinity Graphを計算し、PageRankを適用(べき乗法)。
DUC2003, 2004(MDS)で評価。
Centroidベースドな手法をROUGE-1の観点でoutperform。
document clusterの17%をNoisyなデータにした場合も実験しており、Noisyなデータを追加した場合も性能劣化が少ないことも示している。
[Paper Note] The automatic creation of literature abstracts, H. P. Luhn, IBM Journal of Research Development, 1958.04
Paper/Blog Link My Issue
#Article #DocumentSummarization #Document #Classic #NLP #One-Line Notes Issue Date: 2018-01-01 Comment
文書要約研究初期の研究
推薦システムのアルゴリズム, 神嶌, 2016.09
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey Issue Date: 2018-01-01
Surprise: A Python library for recommender systems, Nicolas Hug, 2016.10
Paper/Blog Link My Issue
#Article #RecommenderSystems #Library #python #One-Line Notes Issue Date: 2018-01-01 Comment
実装されているアルゴリズム:協調フィルタリング、Matrix Factorizationなど
実装:python
使用方法:pythonライブラリとして利用
※ pythonで利用できる数少ない推薦システムライブラリ
参考:
http://www.kamishima.net/archive/recsysdoc.pdf
https://takuti.me/note/recommender-libraries/
[Paper Note] Discovery-oriented Collaborative Filtering for Improving User Satisfaction, Hijikata+, IUI’09
Paper/Blog Link My Issue
#Article #RecommenderSystems #CollaborativeFiltering #Novelty #KeyPoint Notes Issue Date: 2017-12-28 Comment
・従来のCFはaccuracyをあげることを目的に研究されてきたが,ユーザがすでに知っているitemを推薦してしまう問題がある.おまけに(推薦リスト内のアイテムの観点からみた)diversityも低い.このような推薦はdiscoveryがなく,user satisfactionを損ねるので,ユーザがすでに何を知っているかの情報を使ってよりdiscoveryのある推薦をCFでやりましょうという話.
・特徴としてユーザのitemへのratingに加え,そのitemをユーザが知っていたかどうかexplicit feedbackしてもらう必要がある.
・手法は単純で,User-based,あるいはItem-based CFを用いてpreferenceとあるitemをユーザが知っていそうかどうかの確率を求め,それらを組み合わせる,あるいはrating-matrixにユーザがあるitemを知っていたか否かの数値を組み合わせて新たなmatrixを作り,そのmatrix上でCFするといったもの.
・offline評価の結果,通常のCF,topic diversification手法と比べてprecisionは低いものの,discovery ratioとprecision(novelty)は圧倒的に高い.
・ユーザがitemを知っていたかどうかというbinary ratingはユーザに負荷がかかるし,音楽推薦の場合previewがなければそもそも提供されていないからratingできないなど,必ずしも多く集められるデータではない.そこで,データセットのratingの情報を25%, 50%, 75%に削ってratingの数にbiasをかけた上で実験をしている.その結果,事前にratingをcombineし新たなmatrixを作る手法はratingが少ないとあまりうまくいかなかった.
・さらにonlineでuser satisfaction(3つの目的のもとsatisfactionをratingしてもらう 1. purchase 2. on-demand-listening 3. discovery)を評価した. 結果,purchaseとdiscoveryにおいては,ベースラインを上回った.ただし,これは推薦リスト中の満足したitemの数の問題で,推薦リスト全体がどうだった
かと問われた場合は,ベースラインと同等程度だった.
重要論文
[Paper Note] “I like to explore sometimes”: Adapting to Dynamic User Novelty Preferences, Kapoor et al. (with Konstan), RecSys’15
Paper/Blog Link My Issue
#Article #RecommenderSystems #Novelty #RecSys #KeyPoint Notes Issue Date: 2017-12-28 Comment
・典型的なRSは,推薦リストのSimilarityとNoveltyのcriteriaを最適化する.このとき,両者のバランスを取るためになんらかの定数を導入してバランスをとるが,この定数はユーザやタイミングごとに異なると考えられるので(すなわち人やタイミングによってnoveltyのpreferenceが変化するということ),それをuserの過去のbehaviorからpredictするモデルを考えましたという論文.
・式中によくtが出てくるが,tはfamiliar setとnovel setをわけるためのみにもっぱら使われていることに注意.昼だとか夜だとかそういう話ではない.familiar setとは[t-T, t]の間に消費したアイテム,novel setはfamiliar setに含まれないitemのこと.
・データはmusic consumption logsを使う.last.fmやproprietary dataset.データにlistening以外のexplicit feedback (rating)などの情報はない
・itemのnoveltyの考え方はユーザ側からみるか,システム側から見るかで分類が変わる.三種類の分類がある.
(a) new to system: システムにとってitemが新しい.ゆえにユーザは全員そのitemを知らない.
(b) new to user: システムはitemを知っているが,ユーザは知らない.
(c) oblivious/forgotten item: 過去にユーザが知っていたが,最後のconsumptionから時間が経過しいくぶんunfamiliarになったitem
Repetition of forgotten items in future consumptions has been shown to produce increased diversity and emotional excitement.
この研究では(b), (c)を対象とする.
・userのnovelty preferenceについて二つの仮定をおいている.
1. ユーザごとにnovelty preferenceは違う.
2. ユーザのnovelty preferenceはdynamicに変化する.trainingデータを使ってこの仮定の正しさを検証している.
・novelty preferenceのpredictは二種類の素性(familiar set diversityとcumulative negative preference for items in the familiar set)を使う. 前者は,familiar setの中のradioをどれだけ繰り返しきいているかを用いてdiversityを定義.繰り返し聞いているほうがdiversity低い.後者は,異なるitemの消費をする間隔によってdynamic preference scoreを決定.familiar set内の各itemについて負のdynamic preference scoreをsummationすることで,ユーザの”退屈度合い”を算出している.
・両素性を考慮することでnovelty preferenceのRMSEがsignificantに減少することを確認.
・推薦はNoveltyのあるitemの推薦にはHijikataらの協調フィルタリングなどを使うこともできる.
・しかし今回は簡易なitem-based CFを用いる.ratingの情報がないので,それはdynamic preference scoreを代わりに使い各itemのスコアを求め,そこからnovel recommendationとfamiliar recommendationのリストを生成し,novelty preferenceによって両者を組み合わせる.
・音楽(というより音楽のradioやアーティスト)の推薦を考えている状況なので,re-consumptionが許容されている.Newsなどとは少しドメインが違うことに注意.
[Paper Note] A Study for Documents Summarization based on Personal Annotation, Zhang+, HLT-NAACL-DUC’03, 2003.05
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #NLP #Personalization #NAACL #KeyPoint Notes Issue Date: 2017-12-28 Comment
(過去に管理人が作成したスライドでの論文メモのスクショ)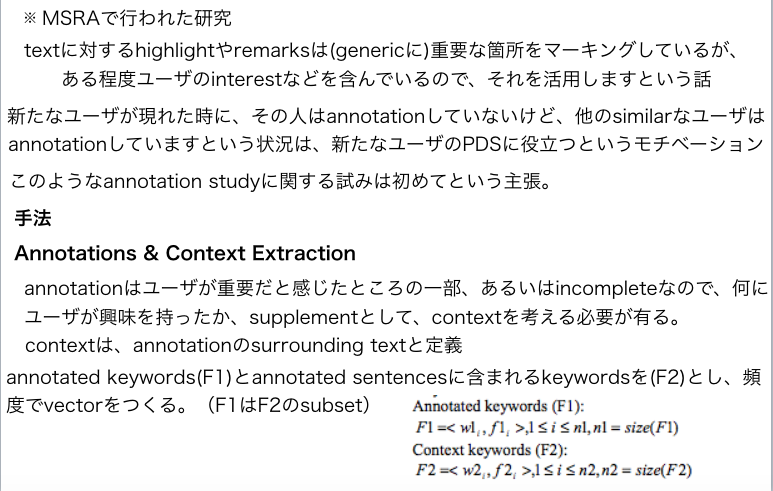
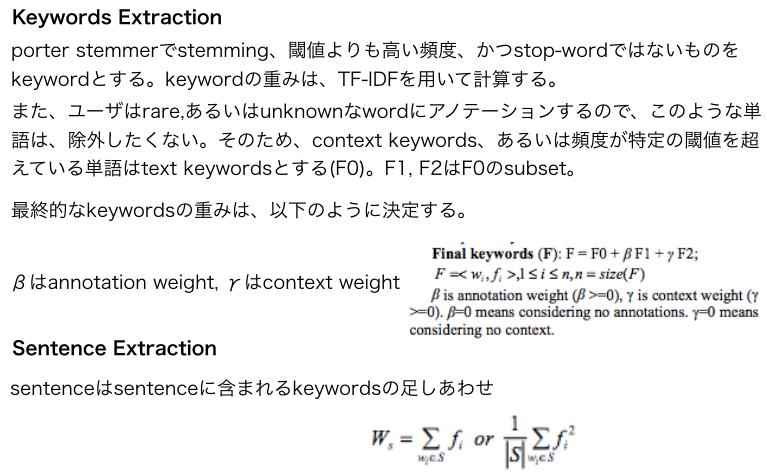
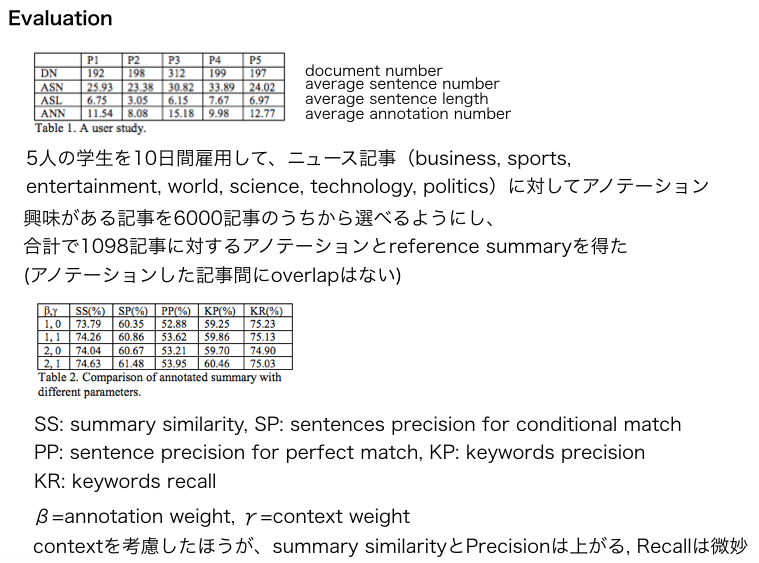
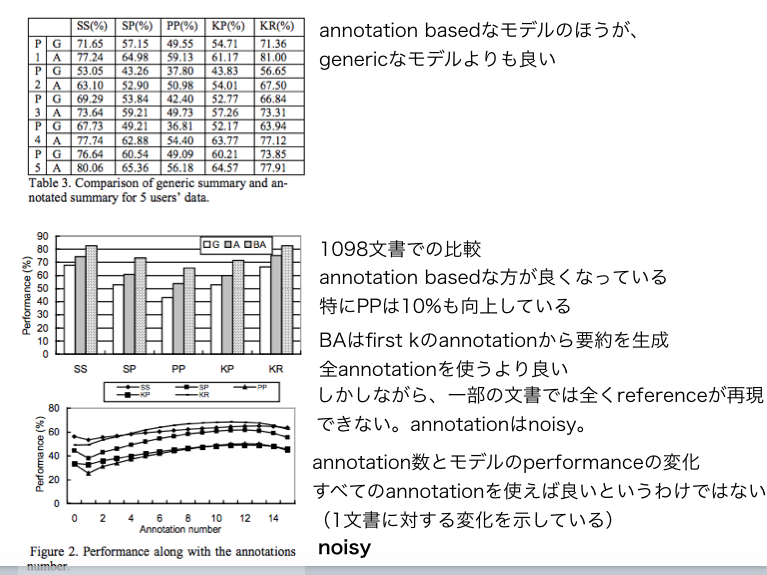
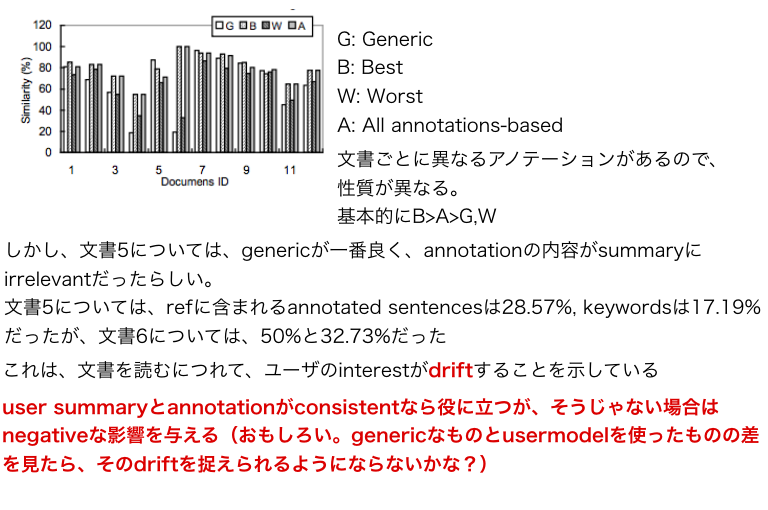
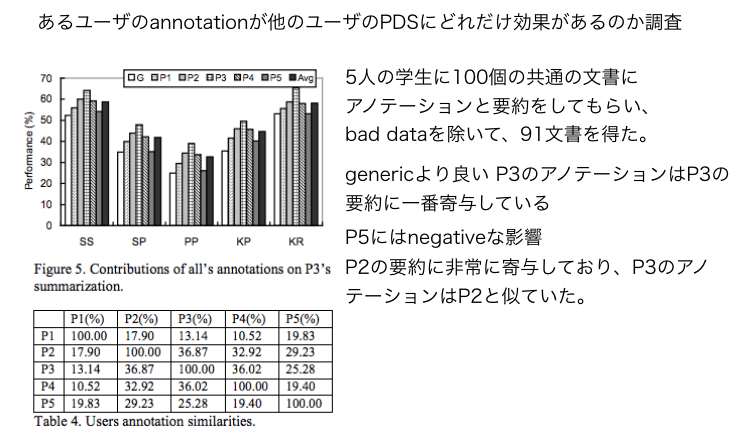
重要論文だと思われる。
[Paper Note] User-model based personalized summarization, Diaz+, Information Processing and Management 2007.11
Paper/Blog Link My Issue
#Article #PersonalizedDocumentSummarization #DocumentSummarization #RecommenderSystems #Personalization #One-Line Notes Issue Date: 2017-12-28 Comment
PDSの先駆けとなった重要論文。必ずreferすべき。