
Transformer (343) — 2/2
[Paper Note] FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision, Jay Shah+, arXiv'24, 2024.07
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #NeurIPS Issue Date: 2024-07-30 GPT Summary- FlashAttentionはGPU上のアテンションを高速化する手法だが、新しいハードウェア機能を活用できていなかった。FlashAttention-3は、Hopper世代のGPUでアテンションの処理を改善するために、計算とデータ移動の重ね合わせ、行列積とソフトマックス演算のインタリーブ、FP8低精度をサポートするブロック量子化を導入。これにより、H100 GPU上でFP16時に1.5〜2.0倍の速度向上を実現し、最大740 TFLOPs/sに達し、FP8では約1.2 PFLOPs/sに近づく。FP8版では数値誤差が従来の約2.6倍低く抑えられることも示した。 Comment
関連:
- [Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
- [Paper Note] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, Tri Dao, arXiv'23, 2023.07
Mixture-of-Depths: Dynamically allocating compute in transformer-based language models, David Raposo+, N_A, arXiv'24
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel Issue Date: 2024-04-07 GPT Summary- Transformerベースの言語モデルは、入力シーケンス全体に均等にFLOPsを分散させる代わりに、特定の位置にFLOPsを動的に割り当てることを学習できることを示す。モデルの深さにわたって割り当てを最適化するために、異なるレイヤーで計算を動的に割り当てる。この手法は、トークンの数を制限することで合計計算予算を強制し、トークンはtop-kルーティングメカニズムを使用して決定される。この方法により、FLOPsを均等に消費しつつ、計算の支出が予測可能であり、動的かつコンテキストに敏感である。このようにトレーニングされたモデルは、計算を動的に割り当てることを学習し、効率的に行うことができる。 Comment
参考:
[Paper Note] Dynamic Memory Compression: Retrofitting LLMs for Accelerated Inference, Piotr Nawrot+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #ICML #One-Line Notes #KV Cache #Compression Issue Date: 2024-04-07 GPT Summary- Transformerにおけるメモリキャッシュの非効率性を解決するために、Dynamic Memory Compression(DMC)を提案。DMCは異なるヘッドと層で異なる圧縮比を学習し、Llama 2を組み込むことで推論時に最大7倍のスループット向上を実現。元のパフォーマンスを保ちながら、キャッシュ圧縮を最大4倍可能とし、既存の方法を超える効果を発揮。DMCはKVキャッシュのドロップイン置換として、より長い文脈と大きなバッチを処理できる。 Comment
参考:
論文中のFigure1が非常にわかりやすい。
GQA [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
と比較して、2~4倍キャッシュを圧縮しつつ、より高い性能を実現。70Bモデルの場合は、GQAで8倍キャッシュを圧縮した上で、DMCで追加で2倍圧縮をかけたところ、同等のパフォーマンスを実現している。
Transformers are Multi-State RNNs, Matanel Oren+, N_A, EMNLP'24
Paper/Blog Link My Issue
#MachineLearning #NLP #EMNLP #KeyPoint Notes Issue Date: 2024-01-16 GPT Summary- 本研究では、トランスフォーマーのデコーダーは無限マルチステートRNNとして概念化できることを示し、有限のマルチステートRNNに変換することも可能であることを示します。さらに、新しいキャッシュ圧縮ポリシーであるTOVAを導入し、他のポリシーよりも優れた性能を示すことを実験結果で示しました。TOVAは元のキャッシュサイズの1/8しか使用せず、トランスフォーマーデコーダーLLMが実際にはRNNとして振る舞うことが多いことを示しています。 Comment
TransformerはRNNとは異なる概念、特に全てのトークンの情報に直接アクセスできるということで区別されてきたが、よくよく考えてみると、Transformer Decoderは、RNNのhidden_states h を(hは1つのstateをベクトルで表している)、multi-stateを表す matrix H (t個のstateを表すmatrix; tは現在の着目しているトークンまでのsequenceの長さ)で置き換えたもの Multi-State-RNN (MSRNN) と解釈できる、という話。
また、window attentionなどのattentionの計算で考慮するKV cacheのスパンを(メモリを節約するために)制限する圧縮手法は、先ほどのMSRNNは全トークンのstate (KV Cache)にアクセスできる(= Unbounded)と考えると、アクセスできるトークンのstateが k (
実際に式で表すと以下のようにRNNとTransformerは対応づけられる。
このことを考慮して、本研究ではTOVAと呼ばれる新しいKV Cacheの圧縮手法を提案している。非常にシンプルな手法で、KV Cacheがメモリの上限に到達したときに、その際にattention scoreが最も小さいトークンのKV Cacheを捨てる、という手法である。
TOVAをwindow attentionなどのベースラインとオラクルとしてfull attentionと比較。タスクは Language Modeling(PG-19データにおけるPerplexity)、Language Understanding (long contextからrelevantな情報を拾う必要があるQA)、Story Generation(長文のストーリーを書かせてGPT4によってpair-wiseで生成されたストーリーの品質をLLM-as-a-Judgeさせる)を利用。既存のKV Cache圧縮手法よりも効率的にKV Cacheを圧縮でき、4096 context windowの場合は、512程度でfull attentionと近い性能を示すことが示された。これにより、高いメモリ効率とスループットを実現できる。ここで、グラフのx軸のmultistateはTOVAにおいてはmatrix Hで保持するstate数に相当し、window attentionでは、window sizeに相当する。
[Paper Note] Unified-IO 2: Scaling Autoregressive Multimodal Models with Vision, Language, Audio, and Action, Jiasen Lu+, CVPR'24, 2023.12
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #InstructionTuning #MultiModal #SpeechProcessing #CVPR #Selected Papers/Blogs #Encoder-Decoder #Robotics #UMM #EmbodiedAI #KeyPoint Notes #Surface-level Notes Issue Date: 2023-12-29 GPT Summary- 初の自己回帰型マルチモーダルモデル「Unified-IO 2」を提案し、画像、テキスト、音声、アクションを統一した意味空間で処理。トレーニングの安定化のためにアーキテクチャを改善し、120のデータセットで微調整を行い、GRITベンチマークで最先端のパフォーマンスを達成。35以上のベンチマークにおいて強力な結果を示し、すべてのモデルを公開。 Comment
画像、テキスト、音声、アクションを理解できる初めてのautoregressive model。AllenAI
モデルのアーキテクチャ図
マルチモーダルに拡張したことで、訓練が非常に不安定になったため、アーキテクチャ上でいくつかの工夫を加えている:
- 2D Rotary Embedding
- Positional EncodingとしてRoPEを採用
- 画像のような2次元データのモダリティの場合はRoPEを2次元に拡張する。具体的には、位置(i, j)のトークンについては、Q, Kのembeddingを半分に分割して、それぞれに対して独立にi, jのRoPE Embeddingを適用することでi, j双方の情報を組み込む。
- QK Normalization
- image, audioのモダリティを組み込むことでMHAのlogitsが非常に大きくなりatteetion weightが0/1の極端な値をとるようになり訓練の不安定さにつながった。このため、dot product attentionを適用する前にLayerNormを組み込んだ。
- Scaled Cosine Attention
- Image Historyモダリティにおいて固定長のEmbeddingを得るためにPerceiver Resamplerを扱ったているが、こちらも上記と同様にAttentionのlogitsが極端に大きくなったため、cosine類似度をベースとしたScaled Cosine Attention [Paper Note] Swin Transformer V2: Scaling Up Capacity and Resolution, Ze Liu+, arXiv'21
を利用することで、大幅に訓練の安定性が改善された。
- その他
- attention logitsにはfp32を適用
- 事前学習されたViTとASTを同時に更新すると不安定につながったため、事前学習の段階ではfreezeし、instruction tuningの最後にfinetuningを実施
目的関数としては、Mixture of Denoisers (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)に着想を得て、Multimodal Mixture of Denoisersを提案。MoDでは、
- \[R\]: 通常のspan corruption (1--5 token程度のspanをmaskする)
- \[S\]: causal language modeling (inputを2つのサブシーケンスに分割し、前方から後方を予測する。前方部分はBi-directionalでも可)
- \[X\]: extreme span corruption (12>=token程度のspanをmaskする)
の3種類が提案されており、モダリティごとにこれらを使い分ける:
- text modality: UL2 (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)を踏襲
- image, audioがtargetの場合: 2つの類似したパラダイムを定義し利用
- \[R\]: patchをランダムにx%マスクしre-constructする
- \[S\]: inputのtargetとは異なるモダリティのみの情報から、targetモダリティを生成する
訓練時には prefixとしてmodality token \[Text\], \[Image\], \[Audio\] とparadigm token \[R\], \[S\], \[X\] をタスクを指示するトークンとして利用している。
また、image, audioのマスク部分のdenoisingをautoregressive modelで実施する際には普通にやるとdecoder側でリークが発生する(a)。これを防ぐには、Encoder側でマスクされているトークンを、Decoder側でteacher-forcingする際にの全てマスクする方法(b)があるが、この場合、生成タスクとdenoisingタスクが相互に干渉してしまいうまく学習できなくなってしまう(生成タスクでは通常Decoderのinputとして[mask]が入力され次トークンを生成する、といったことは起きえないが、愚直に(b)をやるとそうなってしまう)。ので、(c)に示したように、マスクされているトークンをinputとして生成しなければならない時だけ、マスクを解除してdecoder側にinputする、という方法 (Dynamic Masking) でこの問題に対処している。
[Paper Note] Segment Anything in Medical Images, Jun Ma+, Nature Communications'24, 2023.04
Paper/Blog Link My Issue
#ComputerVision #Pretraining #ImageSegmentation #FoundationModel #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 医用画像分割は診断や治療計画に不可欠だが、既存手法は特定のモダリティや疾患に限られがち。そこで、10の画像モダリティと30種以上のがんに対応する基盤モデルMedSAMを提案。1,570,263の画像-マスクペアで訓練され、精度と頑健性で専門モデルを上回ることを実証。MedSAMは診断ツールの進化と個別化治療計画を加速する可能性を秘めている。 Comment
SAMの性能は医療画像に対しては限定的だったため、11の異なるモダリティに対して200kのマスクをした医療画像を用意しfinetuningしたMedSAMによって、医療画像のセグメンテーションの性能を大幅に向上。
コードとモデルはpublicly available
[Paper Note] Robust Speech Recognition via Large-Scale Weak Supervision, Alec Radford+, ICML'23, 2022.12
Paper/Blog Link My Issue
#NeuralNetwork #SpeechProcessing #AutomaticSpeechRecognition(ASR) #Selected Papers/Blogs #Generalization #KeyPoint Notes #Robustness Issue Date: 2025-11-14 GPT Summary- 680,000時間の多言語音声トランスクリプトを用いて訓練した音声処理システムを研究。得られたモデルは、ゼロショット転送設定で良好に一般化し、従来の監視結果と競争力を持つ。人間の精度に近づくことが確認され、モデルと推論コードを公開。 Comment
いまさらながらWhisper論文
日本語解説:
https://www.ai-shift.co.jp/techblog/3001
長文認識のためのヒューリスティックに基づくデコーディング戦略も解説されているので参照のこと。
研究のコアとなるアイデアとしては、既存研究は自己教師あり学習、あるいはself-learningによって性能向上を目指す流れがある中で、教師あり学習に着目。既存研究で教師あり学習によって性能が向上することが示されていたが、大規模なスケールで実施できていなかったため、それをweakly-supervisedなmanner(=つまり完璧なラベルではなくてノイジーでも良いからラベルを付与し学習する)といった方法で学習することで、より頑健で高性能なASRを実現したい、という気持ちの研究。また、複雑なサブタスク(language identification, inverse text normalization(ASR後のテキストを人間向けの自然なテキストに変換すること[^2]), phrase-level timestamps (audioとtranscriptのタイムスタンプ予測))を一つのパイプラインで実現するような統合的なインタフェースも提案している。モデルのアーキテクチャ自体はencoder-decoderモデルである。また、positional encodingとしてはSinusoidal Positional Encoding(すなわち、絶対位置エンコーディング)が用いられている。デコーダにはprompt[^1]と呼ばれるtranscriptのhistoryを(確率的に挿入し)入力して学習することで、過去のcontextを考慮したASRが可能となる。lossの計算は、translate/transcribeされたトークンのみを考慮して計算する。
データセットについては詳細は記述されておらず、internetに存在する (audio, transcripts)のペアデータを用いたと書かれている。
しかしながら、収集したデータセットを確認んすると、transcriptionの品質が低いものが混ざっており、フィルタリングを実施している。これは、人間のtranscriptionとmachine-generatedなtranscriptionをmixして学習すると性能を損なうことが既存研究で知られているため、ヒューリスティックに基づいてmachine-generatedなtranscriptionは学習データから除外している。これは、初期のモデルを学習してエラー率を観測し、データソースを人手でチェックしてlow-qualityなtranscriptを除去するといった丁寧なプロセスもあ含まれる。
また、収集したデータの言語についてはVoxLingua107データセット [Paper Note] VoxLingua107: a Dataset for Spoken Language Recognition, Jörgen Valk+, SLT'21, 2020.11
によって学習された分類器(をさらにfinetuningしたモデルと書かれている。詳細は不明)によって自動的に付与する。すなわち、X->enのデータのX(つまりsource言語)のlanguage identificationについてもweakly-supervisedなラベルで学習されている。
audioファイルについては、30秒単位のセグメントに区切り全ての期間を学習データに利用。無音部分はサブサンプリング(=一部をサンプリングして使う)しVoice Activity Detectionも学習する。
[^1]: LLMの文脈で広く使われるPromptとは異なる点に注意。LLMはinstruction-tuningが実施されているため人間の指示に追従するような挙動となるが、Whisperではinstruction-tuningを実施していないのでそのような挙動にはならない。あくまで過去のhistoryの情報を与える役割と考えること。
[^2]: Whisperでは生のtranscriptをnormalizationせずに学習にそのまま利用するため書き起こしの表記の統一は行われないと考えられる。
[Paper Note] Language Modelling with Pixels, Phillip Rust+, ICLR'23, 2022.07
Paper/Blog Link My Issue
#NLP #LanguageModel #ICLR #Encoder #Pixel-based #Compression Issue Date: 2025-10-22 GPT Summary- PIXELは、テキストを画像として表現する新しい言語モデルで、語彙のボトルネックを回避し、言語間での表現転送を可能にする。86MパラメータのPIXELは、BERTと同じデータで事前学習され、非ラテン文字を含む多様な言語での構文的および意味的タスクでBERTを大幅に上回る性能を示したが、ラテン文字ではやや劣る結果となった。また、PIXELは正字法的攻撃や言語コードスイッチングに対してBERTよりも堅牢であることが確認された。 Comment
元ポスト:
[Paper Note] Scalable Diffusion Models with Transformers, William Peebles+, ICCV'23
Paper/Blog Link My Issue
#ComputerVision #DiffusionModel #read-later #Selected Papers/Blogs #Backbone Issue Date: 2025-08-27 GPT Summary- 新しいトランスフォーマーに基づく拡散モデル(Diffusion Transformers, DiTs)を提案し、U-Netをトランスフォーマーに置き換えた。DiTsは高いGflopsを持ち、低いFIDを維持しながら良好なスケーラビリティを示す。最大のDiT-XL/2モデルは、ImageNetのベンチマークで従来の拡散モデルを上回り、最先端のFID 2.27を達成した。 Comment
日本語解説: https://qiita.com/sasgawy/items/8546c784bc94d94ef0b2
よく見るDiT
- [Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
も同様の呼称だが全く異なる話なので注意
[Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #python #LLMServing #Selected Papers/Blogs Issue Date: 2025-08-19 GPT Summary- PagedAttentionを用いたvLLMシステムを提案し、KVキャッシュメモリの無駄を削減し、リクエスト間での柔軟な共有を実現。これにより、同レベルのレイテンシでLLMのスループットを2-4倍向上。特に長いシーケンスや大規模モデルで効果が顕著。ソースコードは公開中。 Comment
(今更ながら)vLLMはこちら:
https://github.com/vllm-project/vllm
現在の主要なLLM Inference/Serving Engineのひとつ。
[Paper Note] Recommender Systems with Generative Retrieval, Shashank Rajput+, NeurIPS'23
Paper/Blog Link My Issue
#RecommenderSystems #VariationalAutoEncoder #NeurIPS #read-later #Selected Papers/Blogs #ColdStart #Encoder-Decoder #SemanticID Issue Date: 2025-07-28 GPT Summary- 新しい生成的検索アプローチを提案し、アイテムのセマンティックIDを用いて次のアイテムを予測するTransformerベースのモデルを訓練。これにより、従来のレコメンダーシステムを大幅に上回る性能を達成し、過去の対話履歴がないアイテムに対しても改善された検索性能を示す。 Comment
openreview: https://openreview.net/forum?id=BJ0fQUU32w
Semantic IDを提案した研究
アイテムを意味的な情報を保持したdiscrete tokenのタプル(=Semantic ID)で表現し、encoder-decoderでNext ItemのSemantic IDを生成するタスクに落としこむことで推薦する。SemanticIDの作成方法は後で読んで理解したい。
[Paper Note] Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture, Mahmoud Assran+, CVPR'23, 2023.01
Paper/Blog Link My Issue
#ComputerVision #Pretraining #RepresentationLearning #Self-SupervisedLearning #CVPR #read-later #Selected Papers/Blogs #WorldModels #One-Line Notes #LatentRepresentation Issue Date: 2025-07-24 GPT Summary- 本論文では、手作りのデータ拡張に依存せずに意味的な画像表現を学習するI-JEPAという自己教師あり学習アプローチを提案。I-JEPAは、単一のコンテキストブロックから異なるターゲットブロックの表現を予測する。重要な設計選択として、意味的に大きなターゲットブロックと情報量の多いコンテキストブロックのサンプリングが挙げられる。実験により、I-JEPAはVision Transformersと組み合わせることでスケーラブルであり、ImageNet上で強力な下流性能を達成した。 Comment
Joint-Embedding Predictive Architecture (JEPA)を提案した研究。ピクセルやトークンのreconstruction lossではなく、潜在表現を再構成するようなself-supervised learningによってより意味的な特徴を学習するように誘導するもの(と思われるがこれが本質的な理解として正しいかは自信がない)。
[Paper Note] Magneto: A Foundation Transformer, Hongyu Wang+, ICML'23
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #SpeechProcessing #Architecture #ICML #Normalization #KeyPoint Notes Issue Date: 2025-04-19 GPT Summary- 言語、視覚、音声、マルチモーダルにおけるモデルアーキテクチャの収束が進む中、異なる実装の「Transformers」が使用されている。汎用モデリングのために、安定性を持つFoundation Transformerの開発が提唱され、Magnetoという新しいTransformer変種が紹介される。Sub-LayerNormと理論に基づく初期化戦略を用いることで、さまざまなアプリケーションにおいて優れたパフォーマンスと安定性を示した。 Comment
マルチモーダルなモデルなモデルの事前学習において、PostLNはvision encodingにおいてsub-optimalで、PreLNはtext encodingにおいてsub-optimalであることが先行研究で示されており、マルタモーダルを単一のアーキテクチャで、高性能、かつ学習の安定性な高く、try and error無しで適用できる基盤となるアーキテクチャが必要というモチベーションで提案された手法。具体的には、Sub-LayerNorm(Sub-LN)と呼ばれる、self attentionとFFN部分に追加のLayerNormを適用するアーキテクチャと、DeepNetを踏襲しLayer数が非常に大きい場合でも学習が安定するような重みの初期化方法を理論的に分析し提案している。
具体的には、Sub-LNの場合、LayerNormを
- SelfAttention計算におけるQKVを求めるためのinput Xのprojectionの前とAttentionの出力projectionの前
- FFNでの各Linear Layerの前
に適用し、
初期化をする際には、FFNのW, およびself-attentionのV_projと出力のout_projの初期化をγ(=sqrt(log(2N))によってスケーリングする方法を提案している模様。
関連:
- [Paper Note] DeepNet: Scaling Transformers to 1,000 Layers, Hongyu Wang+, arXiv'22, 2022.03
[Paper Note] Segment Anything, Alexander Kirillov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#ComputerVision #ImageSegmentation #FoundationModel #Selected Papers/Blogs Issue Date: 2025-04-11 GPT Summary- Segment Anythingプロジェクトでは、新しい画像分割タスク、モデル、データセットを紹介。効率的なモデルを用いて最大規模のセグメンテーションデータセットを構築し、プライバシーを尊重した11M枚の画像に10億以上のマスクを含む。モデルはゼロショットで新しいタスクに転移可能で、評価の結果、従来の教師あり手法と同等、またはそれを上回る性能を示した。Segment Anything Model(SAM)と11M画像、1Bマスクを含むデータセット(SA-1B)を公開。 Comment
SAM論文
pj page: https://segment-anything.com
[Paper Note] The Impact of Positional Encoding on Length Generalization in Transformers, Amirhossein Kazemnejad+, NeurIPS'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #LongContext #PositionalEncoding #NeurIPS #Selected Papers/Blogs #KeyPoint Notes #Surface-level Notes Issue Date: 2025-04-06 GPT Summary- 長さ一般化はTransformerベースの言語モデルにおける重要な課題であり、位置エンコーディング(PE)がその性能に影響を与える。5つの異なるPE手法(APE、T5の相対PE、ALiBi、Rotary、NoPE)を比較した結果、ALiBiやRotaryなどの一般的な手法は長さ一般化に適しておらず、NoPEが他の手法を上回ることが明らかになった。NoPEは追加の計算を必要とせず、絶対PEと相対PEの両方を表現可能である。さらに、スクラッチパッドの形式がモデルの性能に影響を与えることも示された。この研究は、明示的な位置埋め込みが長いシーケンスへの一般化に必須でないことを示唆している。 Comment
- Llama 4 Series, Meta, 2025.04
において、Llama4 Scoutが10Mコンテキストウィンドウを実現できる理由の一つとのこと。
元ポスト:
Llama4のブログポストにもその旨記述されている:
>A key innovation in the Llama 4 architecture is the use of interleaved attention layers without positional embeddings. Additionally, we employ inference time temperature scaling of attention to enhance length generalization.
[The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation]( https://ai.meta.com/blog/llama-4-multimodal-intelligence/?utm_source=twitter&utm_medium=organic_social&utm_content=image&utm_campaign=llama4)
斜め読みだが、length generalizationを評価する上でdownstream taskに焦点を当て、3つの代表的なカテゴリに相当するタスクで評価したところ、この観点においてはT5のrelative positinal encodingとNoPE(位置エンコードディング無し)のパフォーマンスが良く、
NoPEは絶対位置エンコーディングと相対位置エンコーディングを理論上実現可能であり[^1]
実際に学習された異なる2つのモデルに対して同じトークンをそれぞれinputし、同じ深さのLayerの全てのattention distributionの組み合わせからJensen Shannon Divergenceで距離を算出し、最も小さいものを2モデル間の当該layerの距離として可視化すると下記のようになり、NoPEとT5のrelative positional encodingが最も類似していることから、NoPEが学習を通じて(実用上は)相対位置エンコーディングのようなものを学習することが分かった。
[^1]:深さ1のLayerのHidden State H^1から絶対位置の復元が可能であり(つまり、当該レイヤーのHが絶対位置に関する情報を保持している)、この前提のもと、後続のLayerがこの情報を上書きしないと仮定した場合に、相対位置エンコーディングを実現できる。
また、CoT/Scratchpadはlong sequenceに対する汎化性能を向上させることがsmall scaleではあるが先行研究で示されており、Positional Encodingを変化させた時にCoT/Scratchpadの性能にどのような影響を与えるかを調査。
具体的には、CoT/Scratchpadのフォーマットがどのようなものが有効かも明らかではないので、5種類のコンポーネントの組み合わせでフォーマットを構成し、mathematical reasoningタスクで以下のような設定で訓練し
- さまざまなコンポーネントの組み合わせで異なるフォーマットを作成し、
- 全ての位置エンコーディングあり/なしモデルを訓練
これらを比較した。この結果、CoT/Scratchpadはフォーマットに関係なく、特定のタスクでのみ有効(有効かどうかはタスク依存)であることが分かった。このことから、CoT/Scratcpad(つまり、モデルのinputとoutputの仕方)単体で、long contextに対する汎化性能を向上させることができないので、Positional Encoding(≒モデルのアーキテクチャ)によるlong contextに対する汎化性能の向上が非常に重要であることが浮き彫りになった。
また、CoT/Scratchpadが有効だったAdditionに対して各Positional Embeddingモデルを学習し、生成されたトークンのattentionがどの位置のトークンを指しているかを相対距離で可視化したところ(0が当該トークン、つまり現在のScratchpadに着目しており、1が遠いトークン、つまりinputに着目していることを表すように正規化)、NoPEとRelative Positional Encodingがshort/long rangeにそれぞれフォーカスするようなbinomialな分布なのに対し、他のPositional Encodingではよりuniformな分布であることが分かった。このタスクにおいてはNoPEとRelative POの性能が高かったため、binomialな分布の方がより最適であろうことが示唆された。
[Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンション(MQA)はデコーダ推論を高速化するが、品質低下のリスクがある。本研究では、(1)元の計算の5%でMQAを持つモデルへのアップトレーニング方法を提案し、(2)グループ化クエリ・アテンション(GQA)を導入。GQAは中間的な数のキー・バリュー・ヘッドを使用し、アップトレーニングされたGQAは品質を保ちながらMQAと同等の速度を実現する。 Comment
通常のMulti-Head AttentionがQKVが1対1対応なのに対し、Multi Query Attention (MQA) [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
は全てのheadに対してKVを共有する(HeadがH個あるのであれば、保持するKVの数が1/Hとなる)。一方、GQAはグループ単位で(headの)KVを共有する点で異なる。MQAは大幅にInfeerence speedが改善するが、精度が劣化する問題があった。この研究では通常のMulti-Head Attentionに対して、オリジナルの事前学習に対して追加の5%の計算量でGQAモデルを学習する手法を提案している。
Main Result. Multi-Head Attentionに対して、inference timeが大幅に改善しているが、Multi-Query Attentionよりも高い性能を維持している。
Pushdown Layers: Encoding Recursive Structure in Transformer Language Models, Shikhar Murty+, N_A, EMNLP'23
Paper/Blog Link My Issue
#NLP Issue Date: 2023-12-04 GPT Summary- 本研究では、再帰構造をうまく捉えるために新しい自己注意層であるPushdown Layersを導入しました。Pushdown Layersは、再帰状態をモデル化するためにスタックテープを使用し、トークンごとの推定深度を追跡します。このモデルは、構文的な一般化を改善し、サンプル効率を向上させることができます。さらに、Pushdown Layersは標準の自己注意の代替としても使用でき、GLUEテキスト分類タスクでも改善を実現しました。
Advancing Transformer Architecture in Long-Context Large Language Models: A Comprehensive Survey, Yunpeng Huang+, N_A, arXiv'23
Paper/Blog Link My Issue
#Survey #LongContext Issue Date: 2023-11-27 GPT Summary- 本論文では、Transformerベースの大規模言語モデル(LLMs)の長い文脈の能力を最適化するための包括的な調査を提案しています。現行のLLMsの制約や問題点を明確化し、アーキテクチャのアップグレードや評価の必要性について説明しています。さらに、最適化ツールキットや将来の研究の可能性についても議論しています。関連文献はhttps://github.com/Strivin0311/long-llms-learningでリアルタイムに更新されています。 Comment
TransformerをLongContextに対応させる技術のサーベイ。
(画像は元ツイートより)
元ツイート:
[Paper Note] Hiformer: Heterogeneous Feature Interactions Learning with Transformers for Recommender Systems, Huan Gui+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#RecommenderSystems #One-Line Notes Issue Date: 2023-11-13 GPT Summary- 特徴量の相互作用を学習するのはリコメンダーシステムにおいて重要だが、疎で大規模な入力特徴空間のため困難である。そこで、Transformerベースのアーキテクチャを用いて特徴相互作用を自動で捉える手法を提案。従来のTransformerでは自己注意層が異質な特徴相互作用を捉えられず、提供遅延が問題となるため、異質な自己注意層を修正し、Hiformerを導入。これにより高速推論が実現し、Google Playの実世界のアプリでエンゲージメントが最大+2.66%改善された。 Comment
推薦システムは、Factorization Machinesあたりから大抵の場合特徴量間の交互作用を頑張って捉えることで精度向上を目指す、という話をしてきている気がするが、これはTransformerを使って交互作用捉えられるようなモデルを考えました、という研究のようである。
self attention部分に工夫がなされており(提案手法は右端)、task tokenとそれぞれのfeatureをconcatしてQKVを求めることで、明示的に交互作用が生まれるような構造にしている。
Online A/Bテストでも評価しており、HiformerによってSoTAな交互作用モデル(DCN)よりも高いユーザエンゲージメントを実現することが示されている。
Pretraining Data Mixtures Enable Narrow Model Selection Capabilities in Transformer Models, Steve Yadlowsky+, N_A, arXiv'23
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #OOD #One-Line Notes #Reading Reflections Issue Date: 2023-11-06 GPT Summary- 本研究では、トランスフォーマーモデルの文脈学習(ICL)能力を調査しました。トランスフォーマーモデルは、事前学習データの範囲内で異なるタスクを特定し、学習する能力を持っています。しかし、事前学習データの範囲外のタスクや関数に対しては一般化が劣化することが示されました。また、高容量のシーケンスモデルのICL能力は、事前学習データの範囲に密接に関連していることが強調されました。 Comment
Transformerがpre-training時に利用された学習データ以外の分布に対しては汎化性能が落ちることを示したらしい。もしこれが正しいとすると、結局真に新しい分布というか関数というかタスクというか、をTransformerが創出する可能性は低いと言えるかもしれない。が、新しいものって大体は既存の概念の組み合わせだよね(スマホとか)、みたいなことを考えると、別にそれでも十分では?と思ってしまう。人間が本当に真の意味で新しい関数というかタスクというか分布を生み出せているかというと、実はそんなに多くないのでは?という予感もする。まあたとえば、量子力学を最初に考えました!とかそういうのは例外だと思うけど・・・、そのレベルのことってどんくらいあるんだろうね?
[Paper Note] Boolformer: Symbolic Regression of Logic Functions with Transformers, Stéphane d'Ascoli+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#MachineLearning #One-Line Notes Issue Date: 2023-10-09 GPT Summary- Boolformerは、Boolean関数のシンボリック回帰を行うトランスフォーマー系モデルで、未見の複雑な関数に対しても全真理値表からコンパクトな式を予測可能です。不完全な観測やノイズがあっても良好な近似式を導出し、広範な二値分類データセットで従来手法に対して解釈可能な代替手段を示します。遺伝子調節ネットワークのダイナミクスモデリングにも応用し、最先端の遺伝的アルゴリズムと競合しつつ、高速化を示しています。コードとモデルは公開されています。 Comment
ブール関数をend-to-endで学習できるtransformeiアーキテクチャを提案した模様
[Paper Note] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, Tri Dao, arXiv'23, 2023.07
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #Attention #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-07-23 GPT Summary- 長いシーケンスを扱うトランスフォーマーの性能向上に寄与するFlashAttentionは、実行時間とメモリを線形に増加させるが、最適化されたGEMM演算には及ばない。FlashAttention-2では、作業分割を最適化し、非マトリクス積FLOPsを削減、アテンション計算を並列化、共有メモリ通信を減少することで、約2倍のスピードアップを実現。これにより、A100 GPU上で最大225 TFLOPs/sの訓練速度を達成し、モデルFLOPsの利用率は72%に向上した。 Comment
Flash Attention1よりも2倍高速なFlash Attention 2
Flash Attention1は
- [Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
を参照
openreview: https://openreview.net/forum?id=mZn2Xyh9Ec
UniTRec: A Unified Text-to-Text Transformer and Joint Contrastive Learning Framework for Text-based Recommendation, ACL'23
Paper/Blog Link My Issue
#RecommenderSystems #NLP #Contents-based #pretrained-LM #ContrastiveLearning #ACL Issue Date: 2023-07-18 GPT Summary- 本研究では、事前学習済み言語モデル(PLM)を使用して、テキストベースの推薦の性能を向上させるための新しいフレームワークであるUniTRecを提案します。UniTRecは、ユーザーの履歴の文脈をより良くモデル化するために統一されたローカル-グローバルアテンションTransformerエンコーダを使用し、候補のテキストアイテムの言語の複雑さを推定するためにTransformerデコーダを活用します。幅広い評価により、UniTRecがテキストベースの推薦タスクで最先端のパフォーマンスを発揮することが示されました。
Randomized Positional Encodings Boost Length Generalization of Transformers, ACL'23
Paper/Blog Link My Issue
#NLP #LongContext #PositionalEncoding #ACL Issue Date: 2023-07-14 GPT Summary- トランスフォーマーは、固定長のタスクにおいては優れた汎化能力を持つが、任意の長さのシーケンスには対応できない。この問題を解決するために、新しい位置エンコーディング手法を提案する。ランダム化された位置エンコーディングスキームを使用し、長いシーケンスの位置をシミュレートし、順序付けられたサブセットをランダムに選択する。大規模な実証評価により、この手法がトランスフォーマーの汎化能力を向上させ、テストの正確性を平均して12.0%向上させることが示された。
[Paper Note] Explicit Syntactic Guidance for Neural Text Generation, Yafu Li+, ACL'23, 2023.06
Paper/Blog Link My Issue
#BeamSearch #NaturalLanguageGeneration #Controllable #NLP #LanguageModel #ACL #Decoder Issue Date: 2023-07-13 GPT Summary- 本研究では、構文に基づいた生成スキーマを提案し、構成素解析木に従ってシーケンスを生成する新しいテキスト生成モデルを開発。デコーディングプロセスは、構文コンテキスト内での埋め込みテキストの予測と、構成素のマッピングによる構文構造の構築に分かれ、構造的ビームサーチ手法を用いて階層的な構文構造を探索。実験結果は、提案手法がパラフレーズ生成と機械翻訳において自己回帰型ベースラインを上回り、解釈可能性や制御可能性、多様性においても優れていることを示した。
[Paper Note] Trainable Transformer in Transformer, Abhishek Panigrahi+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#NLP #LanguageModel #ICML #Reference Collection Issue Date: 2023-07-12 GPT Summary- 推論時にトランスフォーマーが複雑なモデルを効率的にシミュレートできる構成、Transformer in Transformer(TinT)を提案。20億未満のパラメータで125万パラメータのモデルをシミュレート、性能向上を実現。実験では、OPT-125Mに対し4〜16%の改善を確認し、言語モデルの高度な能力を示唆。モジュール化されたコードベースも提供。 Comment
参考:
研究の進み早すぎません???
openreview: https://openreview.net/forum?id=VmqTuFMk68
Generative Pretraining in Multimodality, Quan Sun+, N_A, arXiv'23
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #MultiModal Issue Date: 2023-07-12 GPT Summary- Emuは、マルチモーダルなコンテキストで画像とテキストを生成するためのTransformerベースのモデルです。このモデルは、単一モダリティまたはマルチモーダルなデータ入力を受け入れることができます。Emuは、マルチモーダルなシーケンスでトレーニングされ、画像からテキストへのタスクやテキストから画像へのタスクなど、さまざまなタスクで優れたパフォーマンスを示します。また、マルチモーダルアシスタントなどの拡張機能もサポートしています。
[Paper Note] ViNT: A Foundation Model for Visual Navigation, Dhruv Shah+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #FoundationModel #Navigation #Robotics #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 汎用的なファウンデーションモデルViNTを紹介し、ロボットナビゲーションにおける汎用的な成功を目指す。ViNTは、一般的なゴール到達を目的とした学習目標で訓練され、さまざまなナビゲーションタスクに適応可能なTransformerベースのアーキテクチャを持つ。既存データセットで訓練され、専門モデルを上回る性能を示す。新環境探索やタスク仕様への適応にも柔軟で、モバイルロボティクスの基盤モデルとしての有効性を持つ。 Comment
事前学習済みモデルを視覚ベースのロボットナビゲーションに活用するFoundation Model。FlexibleなTransformerベースのアーキテクチャに基づいて構築されており、さまざまなナビゲーションタスクに取り組むことが可能
[Paper Note] A Comprehensive Survey on Applications of Transformers for Deep Learning Tasks, Saidul Islam+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Survey #NLP #One-Line Notes Issue Date: 2023-07-03 GPT Summary- トランスフォーマーは自己注意機構に基づく深層ニューラルネットワークで、長期依存関係を扱い、並列処理が可能。NLPやコンピュータビジョンなど複数の分野で注目されているが、包括的な総説が不足。2017年から2022年に提案されたトランスフォーマーモデルを調査し、主要な応用領域を特定。NLP、コンピュータビジョン、マルチモーダリティ、音声処理、信号処理を含むモデルの影響を分析し、分類。研究者にトランスフォーマーの潜在能力と未来の展望を示すことを目的とする。 Comment
Transformerに関する最新サーベイ論文。Transformerが利用されているアプリケーションと、モデルのリストが列挙されている。
[Paper Note] Faith and Fate: Limits of Transformers on Compositionality, Nouha Dziri+, NeurIPS'23 Spotlight, 2023.05
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Composition Issue Date: 2023-06-30 GPT Summary- トランスフォーマー型LLMsの限界を多段階推論課題で調査。課題をサブステップに分解し、計算グラフで定式化。実証結果は、LLMsが複雑な推論をサブグラフ照合に還元していることを示し、体系的な問題解決能力が欠如している可能性を示唆。生成性能はタスクの複雑さとともに低下することを強調。 Comment
参考:
openreview: https://openreview.net/forum?id=Fkckkr3ya8
[Paper Note] RWKV: Reinventing RNNs for the Transformer Era, Bo Peng+, N_A, EMNLP'23 Findings, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #NLP #LanguageModel #EMNLP #Findings #RecurrentModels Issue Date: 2023-06-16 GPT Summary- 本研究では、トランスフォーマーとRNNの両方の利点を組み合わせた新しいモデルアーキテクチャであるRWKVを提案し、トレーニング中に計算を並列化し、推論中に一定の計算およびメモリの複雑さを維持することができます。RWKVは、同じサイズのトランスフォーマーと同等のパフォーマンスを発揮し、将来的にはより効率的なモデルを作成するためにこのアーキテクチャを活用できることを示唆しています。 Comment
(斜め読みしかできておらず、不正確な点が多いと思います。ご容赦ください。)
RWKVの構造は基本的に、residual blockをスタックすることによって構成される。一つのresidual blockは、time-mixing(時間方向の混ぜ合わせ)と、channnel-mixing(要素間での混ぜ合わせ)を行う。
RWKVのカギとなる要素は以下の4つでありこれらが乗算によって交互作用する。RWKVのブロック、およびLMでのアーキテクチャは以下のようになる:
- R: 過去の情報をどれだけ取り入れるかを制御するゲート
- W: positionごとにどれだけ重みを減衰させるかを学習(言い換えると過去の情報をどれだけ減衰させていくか)
- K: attentionのKeyと同じ
- V: attentionのValueと同じ
r, k, vがそれぞれ時刻tでの状態を表しており、Transformerのように過去の全ての情報を保持するのではなく、時刻t-1のr,k,vに基づいて時刻tの状態を更新するためメモリ消費が大幅に削減される。
ここで、token-shiftは、previsou timestepのinputとのlinear interpolationを現在のinputととることである(時刻t-1のinputと時刻tのinputの交互作用をしてr, k, v, r', k' を決定する)。これにより過去の情報を考慮して状態を更新するRNNのような挙動となる。
RWKVは他のLLMと比較し、パラメータ数に対して性能はcomparableであり(Figure4)、context lengthを増やすことで、lossはきちんと低下し(Figure5)、テキスト生成をする際に要する時間は他のLLMと比較して、トークン数に対して線形にしか増加しない(Figure6)。
異なるtransformerとRWKVの計算量とメモリ消費量の比較。Inference timeは系列長に対して線形で、状態の保持は系列長に依存せず、d次元のみで済む。これはRNNのような逐次的な推論の際の話で、学習の際はTransformerのような並列性を持って学習できると思われる(3.2節)
openreview: https://openreview.net/forum?id=7SaXczaBpG
[Paper Note] Think Before You Act: Decision Transformers with Working Memory, Jikun Kang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #AIAgents Issue Date: 2023-06-16 GPT Summary- Decision Transformerベースのエージェントは複数タスクの一般化能力を示すが、大量のデータと計算資源に依存している。訓練中の忘却現象が新タスクの性能低下を引き起こすと考え、分散型の記憶ストレージを用いる人間の脳に着想を得て、作業記憶モジュールを提案。評価結果は、AtariゲームとMeta-Worldのタスクで訓練効率と一般化の向上を示し、メモリ微調整が適応性をさらに強化することを証明。
Birth of a Transformer: A Memory Viewpoint, Alberto Bietti+, N_A, arXiv'23
Paper/Blog Link My Issue
#MachineLearning Issue Date: 2023-06-16 GPT Summary- 大規模言語モデルの内部メカニズムを理解するため、トランスフォーマーがグローバルとコンテキスト固有のbigram分布をどのようにバランスするかを研究。2層トランスフォーマーでの実証的分析により、グローバルbigramの高速な学習と、コンテキスト内のbigramの「誘導ヘッド」メカニズムの遅い発達を示し、重み行列が連想記憶としての役割を強調する。データ分布特性の役割も研究。
[Paper Note] MEGABYTE: Predicting Million-byte Sequences with Multiscale Transformers, Lili Yu+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #MachineLearning #NLP #SpeechProcessing #LongContext #Architecture #NeurIPS #One-Line Notes #Byte-level Issue Date: 2023-05-15 GPT Summary- Megabyteというマルチスケールデコーダーアーキテクチャを提案し、長いシーケンスのエンドツーエンドのモデリングを可能にする。シーケンスをパッチに分割し、ローカルサブモデルとグローバルモデルを使用することで、計算効率を向上させつつコストを削減。実験により、Megabyteは長いコンテキストの言語モデリングで競争力を持ち、最先端の密度推定を達成した。トークン化なしの自己回帰シーケンスモデリングの実現可能性を示す。 Comment
byte列のsequenceからpatch embeddingを作成することで、tokenizer freeなtransformerを提案。
byte列で表現されるデータならなんでも入力できる。つまり、理論上なんでも入力できる。
openreview: https://openreview.net/forum?id=JTmO2V9Xpz
[Paper Note] Vcc: Scaling Transformers to 128K Tokens or More by Prioritizing Important Tokens, Zhanpeng Zeng+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LongContext #NeurIPS #Encoder #Encoder-Decoder #needs-revision Issue Date: 2023-05-09 GPT Summary- 超長いシーケンスに対するトランスフォーマーの効率を向上させる新しい手法を提案。VIPトークンに基づく圧縮方式を用い、シーケンスを選択的に圧縮することで、効率化を実現。競争力のある性能を提供し、最大128Kトークンにスケール可能。
[Paper Note] Efficiently Scaling Transformer Inference, Reiner Pope+, MLSys'23, 2022.11
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #LongContext #Architecture #Inference #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 大規模なTransformerモデルの生成的推論を、長いシーケンス長と厳格な遅延目標の下で研究。TPU v4用に最適化された解析モデルを開発し、待機時間とモデルFLOPS利用率のトレードオフにおいて新しいパレート前線を達成。マルチクエリ注意機構を用いることでメモリ要件を減少させ、コンテキスト長を最大32倍に拡張。最終的に、小さなバッチサイズでの1トークンあたりの遅延は29ミリ秒となり、MFUは76%に達し、PaLM 540Bモデルで2048トークンのコンテキストをサポート。 Comment
特にMultiquery Attentionという技術がTransformerのinferenceのコスト削減に有効らしい
Multi Query Attention (MQA):
- [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
[Paper Note] Scaling Transformer to 1M tokens and beyond with RMT, Aydar Bulatov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NeuralNetwork #NLP #LanguageModel #LongContext #memory #One-Line Notes Issue Date: 2023-04-25 GPT Summary- 再帰的メモリ拡張を用いて、トランスフォーマーの計算量を線形にスケールし、最大二百万トークンまでのシーケンスを扱う能力を実証。言語モデリングタスクでの実験は、パープレキシティの改善を示し、長期依存の処理能力向上の可能性を強調。 Comment
Reccurent Memory Transformer [Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
を使って2Mトークン扱えるようにしたよーという話。
ハリーポッターのトークン数が1.5Mらしいので、そのうち小説一冊書けるかもという世界。
[Paper Note] Three things everyone should know about Vision Transformers, Hugo Touvron+, ECCV'22, 2022.03
Paper/Blog Link My Issue
#ComputerVision #Architecture #ECCV #2D (Image) #Initial Impression Notes Issue Date: 2026-07-16 GPT Summary- 視覚トランスフォーマーは、精度を損なうことなく並列処理が可能であり、アテンション層の微調整により様々なタスクへ適応可能であることを示す3つの洞察を提供。さらに、MLPベースのパッチ前処理層の追加が自己教師付き学習を改善。これらの影響をImageNet-1kデータセットで評価し、転移性能を小規模データセットで測定。 Comment
Inklingによって採用されているhMLPと呼ばれるアーキテクチャが提案されている(図5)
[Paper Note] Masked Autoencoders Are Scalable Vision Learners, Kaiming He+, CVPR'22, 2021.11
Paper/Blog Link My Issue
#ComputerVision #Pretraining #Self-SupervisedLearning #CVPR #Selected Papers/Blogs #Encoder #Backbone #One-Line Notes #AutoEncoder #2D Reconstruction Issue Date: 2026-04-29 GPT Summary- MAEは、入力画像のランダムなパッチをマスクし、欠損部分を再構成するシンプルな自己教師付き学習モデルである。非対称のエンコーダ-デコーダ構造を用い、エンコーダは可視パッチのみを処理。75%をマスクすることで、非自明な自己教師付きタスクを生み出し、高速かつ効果的なモデル訓練を実現。一般化性能に優れ、ViT-HugeモデルがImageNet-1Kデータで最高精度(87.8%)を達成し、転移性能も監督付き事前学習を上回る。 Comment
元ポスト:
AutoEncoderを通じてMaskされたパッチを再構築できるように学習する(25%のパッチから予測する)ことで、(decoderを排除した場合に)downstream taskで良い性能を発揮するViTエンコーダを学習する。デコーダのパラメータ数は意図的に小さくし、Encoder側で特徴がきちんと学習されるように誘導する。
[Paper Note] Perceiver: General Perception with Iterative Attention, Andrew Jaegle+, ICLR'22, 2021.03
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #SpeechProcessing #Attention #Architecture #ICLR #Selected Papers/Blogs #2D (Image) #audio #text Issue Date: 2026-02-07 GPT Summary- 本研究では、Transformersに基づく「Perceiver」モデルを提案し、生物システムのように多様なモダリティの高次元入力を同時に処理する能力を持つことを示します。従来のモデルが個々のモダリティに特化しているのに対し、Perceiverは少ない仮定で多数の入力を扱い、非対称注意メカニズムを用いて大規模なデータを処理します。これにより、画像や音声などの多様な分類タスクにおいて、先行モデルと同等以上の性能を実現しました。特に、ImageNetでは数十万のピクセルを直接扱い、ResNet-50やViTに匹敵する結果を達成し、AudioSetにおいても競争力を持っています。 Comment
openreview: https://openreview.net/forum?id=fILj7WpI-g
多様なモダリティ入力を単一のモデルで処理しlogitsで出力するtransformer。Perceiver-IOと並んで多様なモダリティを処理可能な先駆け的研究
Perceiverの出力は単純な分類問題を想定しており、より多様なoutputができるように拡張したものがPerceiver-IO:
- [Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
[Paper Note] bert2BERT: Towards Reusable Pretrained Language Models, Cheng Chen+, ACL'22, 2021.10
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #LanguageModel #ACL #Encoder #Decoder Issue Date: 2025-12-11 GPT Summary- bert2BERTは、既存の小規模事前学習モデルの知識を大規模モデルに転送し、事前学習効率を向上させる手法。二段階の事前学習を提案し、トレーニングコストを大幅に削減。BERT_BASEとGPT_BASEの事前学習で約45%および47%の計算コストを節約。
[Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
Paper/Blog Link My Issue
#Survey #ComputerVision #EfficiencyImprovement #NLP #Attention #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- 本論文では、計算効率やメモリ効率を向上させることに焦点を当てた「X-former」モデル(Reformer、Linformer、Performer、Longformerなど)の大規模なセレクションを紹介し、最近の研究を体系的かつ包括的にまとめる。Transformersは自然言語処理を含む多くの分野で重要な役割を果たしている。 Comment
関連:
- [Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
- [Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
[Paper Note] Classifier-Free Diffusion Guidance, Jonathan Ho+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#ComputerVision #DiffusionModel #Selected Papers/Blogs Issue Date: 2025-10-10 GPT Summary- 分類器ガイダンスは条件付き拡散モデルのポストトレーニング手法で、モードカバレッジとサンプル忠実度のトレードオフを図る。著者は、分類器なしで生成モデルによるガイダンスが可能であることを示し、これを分類器フリーガイダンスと呼ぶ。条件付きおよび無条件の拡散モデルを共同でトレーニングし、サンプル品質と多様性のトレードオフを達成する。 Comment
日本語解説: https://qiita.com/UMAboogie/items/160c1159811743c49d99
[Paper Note] Mixture of Attention Heads: Selecting Attention Heads Per Token, Xiaofeng Zhang+, EMNLP'22, 2022.10
Paper/Blog Link My Issue
#NLP #Attention #Architecture #MoE(Mixture-of-Experts) #EMNLP #KeyPoint Notes Issue Date: 2025-10-04 GPT Summary- Mixture of Attention Heads (MoA)は、MoEネットワークとマルチヘッドアテンションを組み合わせた新しいアーキテクチャで、動的に選択されたアテンションヘッドのサブセットを使用することでパフォーマンスを向上させる。スパースゲート化により計算効率を保ちながら拡張可能で、モデルの解釈可能性にも寄与する。実験では、機械翻訳やマスク付き言語モデリングなどのタスクで強力なベースラインを上回る結果を示した。 Comment
FFNに適用されることが多かったMoEをmulti-head attention (MHA) に適用する研究。このようなattentionをMixture of Attention Heads (MoA)と呼ぶ。
各MHAは複数のattention expertsを持ち、その中からK個のExpertsが現在のクエリq_tに基づいてRouterによって選出(式7, 8)される。それぞれのattention expertsに対してq_tが流され、通常のMHAと同じ流れでoutputが計算され、最終的に選択された際の(正規化された(式9))probabilityによる加重平均によって出力を計算する(式6)。
注意点としては、各attention expertsは独立したprojection matrix W_q, W_o(それぞれi番目のexpertsにおけるトークンtにおいて、query q_tを変換、output o_{i,t}をhidden space次元に戻す役割を持つ)を持つが、K, Vに対する変換行列は共有すると言う点。これにより、事前に全てのexpertsに対してk, vに対する変換は計算しておけるので、headごとに異なる変換を学習しながら、計算コストを大幅に削減できる。
また、特定のexpertsにのみルーティングが集中しないように、lossを調整することで学習の安定させ性能を向上させている(4.3節)。
[Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
Paper/Blog Link My Issue
#ComputerVision #OCR #ACMMM #Backbone Issue Date: 2025-08-22 GPT Summary- 自己監視型事前学習モデルDiTを提案し、ラベルなしテキスト画像を用いて文書AIタスクにおける性能を向上。文書画像分類やレイアウト分析、表検出、OCRなどで新たな最先端結果を達成。コードとモデルは公開中。
[Paper Note] On Layer Normalizations and Residual Connections in Transformers, Sho Takase+, arXiv'22
Paper/Blog Link My Issue
#NLP #Architecture #Normalization #Encoder-Decoder #Initial Impression Notes Issue Date: 2025-07-04 GPT Summary- 本研究では、Transformerアーキテクチャのレイヤー正規化の位置に関するPost-LNとPre-LNの違いを調査。Post-LNは浅い層で優れた性能を示す一方、深い層では不安定なトレーニングを引き起こす消失勾配問題があることを発見。これを踏まえ、Post-LNの修正により安定したトレーニングを実現する方法を提案し、実験でPre-LNを上回る結果を示した。 Comment
Pre-LNの安定性を持ちながらもPost-LNのような高い性能を発揮する良いとこ取りのB2TConnectionを提案
NLP2022: https://www.anlp.jp/proceedings/annual_meeting/2022/pdf_dir/A2-5.pdf
[Paper Note] DeepNet: Scaling Transformers to 1,000 Layers, Hongyu Wang+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#NLP #Architecture #Normalization Issue Date: 2025-04-19 GPT Summary- Transformerの安定化手法として、残差接続を修正する新正規化関数DeepNormを提案。理論分析に基づき、初期化を併用しモデルの更新を安定させる。DeepNormはPost-LNの性能とPre-LNの安定性を兼ね備え、1000層へのスケーリングを実現。特に、7,482翻訳方向のベンチマークにおいて、200層の3.2Bパラメータモデルが12Bパラメータの48層モデルを5BLEUポイント上回る成果を示した。 Comment
ステートオブAIガイドによる解説: https://ja.stateofaiguides.com/20220308-deepnet-transformer/
[Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Architecture #MoE(Mixture-of-Experts) #Selected Papers/Blogs #JMLR Issue Date: 2025-02-11 GPT Summary- Switch Transformerを提案し、Mixture of Experts (MoE)の複雑さや通信コスト、トレーニングの不安定性を改善。これにより、低精度フォーマットでの大規模スパースモデルのトレーニングが可能になり、最大7倍の事前トレーニング速度向上を実現。さらに、1兆パラメータのモデルを事前トレーニングし、T5-XXLモデルに対して4倍の速度向上を達成。
Knowledge Neurons in Pretrained Transformers, Damai Dai+, N_A, ACL'22, 2022.05
Paper/Blog Link My Issue
#Analysis #NLP #ACL #KnowledgeEditing #Selected Papers/Blogs #FactualKnowledge #Encoder #KeyPoint Notes #Reference Collection Issue Date: 2024-07-11 GPT Summary- 大規模な事前学習言語モデルにおいて、事実知識の格納方法についての研究を行いました。具体的には、BERTのfill-in-the-blank cloze taskを用いて、関連する事実を表現するニューロンを特定しました。また、知識ニューロンの活性化と対応する事実の表現との正の相関を見つけました。さらに、ファインチューニングを行わずに、知識ニューロンを活用して特定の事実知識を編集しようと試みました。この研究は、事前学習されたTransformers内での知識の格納に関する示唆に富んでおり、コードはhttps://github.com/Hunter-DDM/knowledge-neuronsで利用可能です。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
日本語解説: https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022
関連:
- [Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
上記資料によると、特定の知識を出力する際に活性化する知識ニューロンを特定する手法を提案。MLMを用いたclozeタスクによる実験で[MASK]部分に当該知識を出力する実験をした結果、知識ニューロンの重みをゼロとすると性能が著しく劣化し、値を2倍にすると性能が改善するといった傾向がみられた。 ケーススタディとして、知識の更新と、知識の削除が可能かを検証。どちらとも更新・削除がされる方向性[^1]へモデルが変化した。
また、知識ニューロンはTransformerの層の深いところに位置している傾向にあり、異なるrelationを持つような関係知識同士では共有されない傾向にある模様。
[^1]: 他の知識に影響を与えず、完璧に更新・削除できたわけではない。知識の更新・削除に伴いExtrinsicな評価によって性能向上、あるいはPerplexityが増大した、といった結果からそういった方向性へモデルが変化した、という話
[Paper Note] Why do tree-based models still outperform deep learning on tabular data?, Léo Grinsztajn+, NeurIPS'22, 2022.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #TabularData #InductiveBias #NeurIPS #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 深層学習はテキストと画像で進展を見せているが、表形式データでの優位性は不明。標準と新規の深層学習法を木ベースのモデルと比較し、45のデータセットでベンチマークを実施。結果は、中規模データにおいて木ベースモデルが依然として優れた性能を示すことを示す。木ベースモデルとニューラルネットワークのバイアスの違いを実証的に調査し、表形式データ特化のNN開発に向けた課題を提示。標準的ベンチマーク用の生データを提供し、各学習器のハイパーパラメータ探索に20,000時間の計算資源を投入した。 Comment
tree basedなモデルがテーブルデータに対してニューラルモデルよりも優れた性能を発揮することを確認し、なぜこのようなことが起きるかいくつかの理由を説明した論文。
NNよりもtree basedなモデルがうまくいく理由として、モデルの帰納的バイアスがテーブルデータに適していることを調査している。考察としては
1. NNはスムーズなターゲットを学習する能力が高いが、表形式のような不規則なデータを学習するのに適していない
- Random Forestでは、x軸においてirregularなパターンも学習できているが、NNはできていない。
2. uninformativeなfeaatureがMLP-likeなNNに悪影響を与える
- Tabular dataは一般にuninformativeな情報を多く含んでおり、実際MLPにuninformativeなfeatureを組み込んだ場合tree-basedな手法とのgapが増加した
3. データはrotationに対して不変ではないため、学習手順もそうあるべき(この辺がよくわからなかった)
- ResNetはRotationを加えても性能が変わらなかった(rotation invariantな構造を持っている)
openreview: https://openreview.net/forum?id=Fp7__phQszn
[Paper Note] Are Transformers Effective for Time Series Forecasting?, Ailing Zeng+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#TimeSeriesDataProcessing #MachineLearning #LanguageModel #One-Line Notes Issue Date: 2022-12-29 GPT Summary- LTSFタスクに対するTransformer解法の妥当性を疑問視し、単純な1層線形モデル(LTSF-Linear)が既存のTransformerモデルを全ケースで上回る結果を示す。時間的関係の抽出における要素の影響を詳細に分析し、新たな研究の方向性を提案。将来的には他の時系列分析にもアプローチを見直すことを提唱。 Comment
Linear Layerに基づくシンプルな手法がTransformerベースの手法に時系列予測で勝ったという話
[Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #read-later #Selected Papers/Blogs #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形化された自己注意機構とファストウェイト・コントローラの等価性を示し、遅いニューラルネットがファストウェイトをプログラムする方法を探る。FWPは有限メモリの操作を学習し、注意機構のメモリ容量限界を改善するために、加法的外積を用いたプログラミング命令を導入。動的学習率の計算も学習し、新しいカーネル関数を提案。合成リトリーバル問題や機械翻訳、言語モデリングタスクにおける利点を実験で示した。 Comment
Linear TransformerにおけるKV^Tを加算する固定された状態更新ではなく、差分だけを更新するDelta Ruleによって更新する Delta Networkを提案。
(まだ全然読めていないのでしっかり読みたい)
DeltaNet図解:
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Architecture #Selected Papers/Blogs #ActivationFunction #One-Line Notes Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] Vision Transformers for Dense Prediction, René Ranftl+, ICCV'21, 2021.03
Paper/Blog Link My Issue
#ComputerVision #read-later #ICCV #Encoder #Backbone #DepthEstimation #SemanticSegmentation Issue Date: 2025-12-29 GPT Summary- 密なビジョントランスフォーマーは、畳み込みネットワークの代わりにビジョントランスフォーマーを用いた密な予測タスク向けの新しいアーキテクチャです。異なる解像度のトークンを集め、畳み込みデコーダでフル解像度の予測に統合します。このアーキテクチャは、グローバルな受容野を持ち、より一貫した予測を提供します。実験により、特に大量のトレーニングデータがある場合に、単眼深度推定で最大28%の性能向上を示し、セマンティックセグメンテーションではADE20Kで49.02%のmIoUを達成しました。さらに、他の小規模データセットでも最先端の結果を記録しています。モデルは公開されています。 Comment
DPT headの解説: https://qiita.com/Chi_corp_123/items/8a2e9a4f542a3404a700
[Paper Note] MiniLMv2: Multi-Head Self-Attention Relation Distillation for Compressing Pretrained Transformers, Wenhui Wang+, ACL'21 Findings, 2020.12
Paper/Blog Link My Issue
#NLP #Attention #Distillation #ACL #Encoder #Findings #KeyPoint Notes Issue Date: 2025-10-20 GPT Summary- 自己注意関係蒸留を用いて、MiniLMの深層自己注意蒸留を一般化し、事前学習されたトランスフォーマーの圧縮を行う手法を提案。クエリ、キー、バリューのベクトル間の関係を定義し、生徒モデルを訓練。注意ヘッド数に制限がなく、教師モデルの層選択戦略を検討。実験により、BERTやRoBERTa、XLM-Rから蒸留されたモデルが最先端の性能を上回ることを示した。 Comment
教師と(より小規模な)生徒モデル間で、tokenごとのq-q/k-k/v-vのdot productによって形成されるrelation map(たとえばq-qの場合はrelatiok mapはトークン数xトークン数の行列で各要素がdot(qi, qj))で表現される関係性を再現できるようにMHAを蒸留するような手法。具体的には、教師モデルのQKVと生徒モデルのQKVによって構成されるそれぞれのrelation map間のKL Divergenceを最小化するように蒸留する。このとき教師モデルと生徒モデルのattention heads数などは異なってもよい(q-q/k-k/v-vそれぞれで定義されるrelation mapははトークン数に依存しており、head数には依存していないため)。
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #LanguageModel #NeurIPS #read-later #HyperparameterTransfer #One-Line Notes Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
[Paper Note] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale, Alexey Dosovitskiy+, ICLR'21
Paper/Blog Link My Issue
#ComputerVision #ICLR #Selected Papers/Blogs #Backbone Issue Date: 2025-08-25 GPT Summary- 純粋なトランスフォーマーを画像パッチのシーケンスに直接適用することで、CNNへの依存なしに画像分類タスクで優れた性能を発揮できることを示す。大量のデータで事前学習し、複数の画像認識ベンチマークで最先端のCNNと比較して優れた結果を達成し、計算リソースを大幅に削減。 Comment
openreview: https://openreview.net/forum?id=YicbFdNTTy
ViTを提案した研究
[Paper Note] Swin Transformer V2: Scaling Up Capacity and Resolution, Ze Liu+, arXiv'21
Paper/Blog Link My Issue
#ComputerVision #Pretraining #Architecture #Backbone Issue Date: 2025-07-19 GPT Summary- 本論文では、大規模ビジョンモデルのトレーニングと応用における課題に対処するための3つの技術を提案。具体的には、トレーニングの安定性向上のための残差後正規化法、低解像度から高解像度への転送を可能にする位置バイアス法、ラベル付きデータの必要性を減少させる自己教師あり学習法を用いる。これにより、30億パラメータのSwin Transformer V2モデルをトレーニングし、複数のビジョンタスクで新記録を樹立。トレーニング効率も向上し、ラベル付きデータと時間を大幅に削減。
[Paper Note] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows, Ze Liu+, ICCV'21
Paper/Blog Link My Issue
#ComputerVision #Attention #Architecture #Selected Papers/Blogs #ICCV #Backbone #One-Line Notes Issue Date: 2025-07-19 GPT Summary- Swin Transformerは、コンピュータビジョンの新しいバックボーンとして機能する階層的トランスフォーマーを提案。シフトウィンドウ方式により、効率的な自己注意計算を実現し、さまざまなスケールでのモデリングが可能。画像分類や物体検出、セマンティックセグメンテーションなどで従来の最先端を上回る性能を示し、トランスフォーマーのビジョンバックボーンとしての可能性を示唆。コードは公開されている。 Comment
日本語解説: https://qiita.com/m_sugimura/items/139b182ee7c19c83e70a
画像処理において、物体の異なるスケールや、解像度に対処するために、PatchMergeと呼ばれるプーリングのような処理 (Figure1) と、固定サイズのローカルなwindowに分割してSelf-Attentionを実施し、layerごとに通常のwindowとシフトされたwindowを適用することで、window間を跨いだ関係性も考慮できるようにする機構(Figure2)を導入したモデル。
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
Paper/Blog Link My Issue
#Analysis #NLP #EMNLP #Selected Papers/Blogs #FactualKnowledge Issue Date: 2025-07-04 GPT Summary- フィードフォワード層はトランスフォーマーモデルの大部分を占めるが、その役割は未探求。研究により、フィードフォワード層がキー・バリュー・メモリとして機能し、トレーニング例のテキストパターンと相関することを示す。実験で、下層は浅いパターン、上層は意味的なパターンを学習し、バリューが出力分布を誘導することが確認された。最終的に、フィードフォワード層の出力はメモリの合成であり、残差接続を通じて洗練される。 Comment
日本語解説(p.5より): https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022?slide=5
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #NLP #One-Line Notes Issue Date: 2024-07-11 GPT Summary- トランスフォーマーモデルのフィードフォワード層は、キー・バリューメモリとして機能し、学習されたパターンが人間に解釈可能であることや、上位層がより意味のあるパターンを学習することが示されました。さらに、出力分布を誘導する役割も持ちます。フィードフォワード層の出力はそのメモリの合成であり、残差接続を介してモデルの層を通じて洗練され、最終的な出力分布を生成します。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
FF layerがKey-Valueストアとして機能する仕組みの概略図
実際に特定のKeyと最も関連度が高い訓練事例(input)を抽出し、人間がinputのパターンを分類した結果
[Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#NLP #LanguageModel #PositionalEncoding #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- 位置エンコーディングはトランスフォーマーにおいて重要な役割を果たし、依存関係をモデル化するための監督信号を提供する。本研究では、トランスフォーマーに位置情報を組み込む手法を検討し、新たに提案するロータリーポジションエンベディング(RoPE)が絶対位置を回転行列でエンコードして相対位置依存性を取り入れることを示す。RoPEはシーケンス長の柔軟性や相対距離の増加に伴う依存性の減衰などの特性を持ち、強化済みトランスフォーマー(RoFormer)の評価は他の手法を一貫して上回ることを示している。RoFormerはHuggingfaceに統合済み。 Comment
RoPEを提案した論文
# Absolute Position Embedding と Relative Position Embedding
## TransformerにおけるQKVベクトルの計算方法
一般に、Transformerにおける Query (Q), Key (K), Value (V) は以下の式で定式化される:
m, nはそれぞれ位置を表す整数。Absolute Position Embeddingと、Relative Position Embeddingは、関数fの設計がそれぞれ異なっている:
## Absolute Position Embedding
absolute position embeddingは、固定されたposition ベクトル、あるいはtrainableなposition ベクトルpを、入力ベクトルに対して足し合わせる:
## Relative Position Embedding
一方、Relative Position Embeddingは、Queryの位置に対する、Key, Valueの相対位置(つまり、mとnの差)に対して、trainableなベクトル \tilde{p}_r をKey, Valueおよび相対距離rごとに用意し、そのベクトルを入力に足し合わせる、という定式化となっている:
ここで、r = clip(m-n, r_max, r_min)であり、r_max, r_minは考慮する相対距離の最大値と最小値である。
他にも様々な定式化が提案されているがたいてい定式化の中に相対位置m-nが出現する。
## RoPE
RoPEでは、入力Query, Keyベクトル(Q,K)に対して回転行列を適用することで、回転に対して位置情報を保持させる。具体的には、異なる位置m, nに対するq_m^T k_nを計算すると、回転行列をRとした場合式16に示されているように回転行列Rに相対位置m-nが現れ(るように設計されており)、相対位置を考慮したqkの計算になっている。[^1]
[^1]: (R_mq_m)^T R_nK_n = q_m^T (R_m^T R_n) k_n = q_m^T (R_{-m}R_n) k_n = q_m^T R_{n-m} k_n. ここで、R_m^T = R_{-m}であり、R_m R_n = R_{m+n}の性質を使っている。
RoPEは下記のような性質を持つ:
- long-term decay: θi = 10000−2i/d と設定することにより、相対位置が離れているトークンのベクトルとのinner productの値が小さくなる。すなわち、位置が離れているトークン間の依存関係が小さくなる。
- Linear-Attention: RoPEは回転行列であり、乗算後のベクトルのノルムを変化させない。このため、Linear Attentionの式の中に回転行列を組み込むことで、Linear Attentionと簡単に組み合わせることが可能
Absolute Position Embedding, Relative Position Embeddingでは、ベクトルに対して位置情報を加算する定式化で K, Vの計算時に位置情報を考慮していたため、Linear Attentionの計算そのものに位置情報を組み込んだ定式化とはなっていなかった。
が、RoPEでは回転行列を乗算する定式化であり、ノルムを変化させないのでLinear Attentionの定式化に組み込むことができる。このため、モデルのアーキテクチャを大きく変更しなくとも組み込める。
RoPE自体は実装にパラメータを必要としないが、モデルのその他のパラメータがRoPEに適用できるように学習されていないと適用できないであろう点には注意(事前学習時にRoPEが使われていれば話は別)。
- 国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
pp.22--23がRoPEを簡潔に説明しており分かりやすい
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #Pretraining #NLP #LanguageModel #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
SAINT+: Integrating Temporal Features for EdNet Correctness Prediction, Shin+, RiiiD AI Research, LAK'21
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #StudentPerformancePrediction #LAK #Selected Papers/Blogs #One-Line Notes Issue Date: 2021-10-28 Comment
Student Performance PredictionにTransformerを初めて利用した研究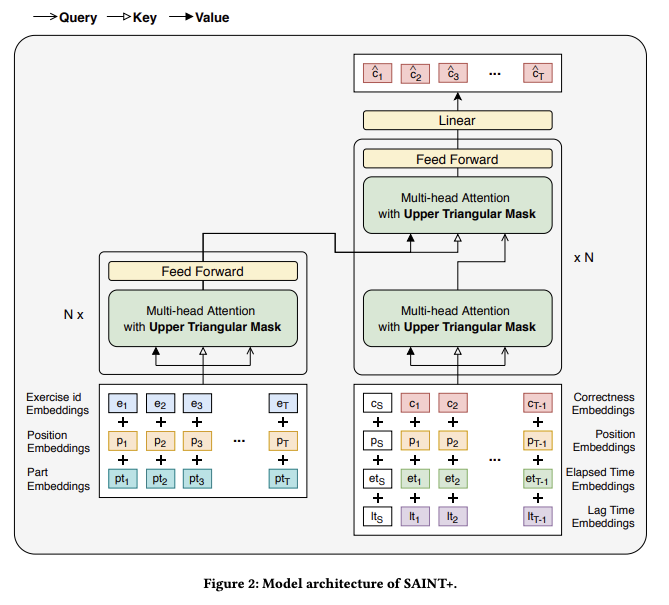
[Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention #LongContext #NeurIPS #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- BigBirdは、Transformersモデルのシーケンス長に対する二次的依存性を線形に削減するスパース注意メカニズムを提案。これにより、長いシーケンスを最大8倍処理可能となり、質問応答や要約などのNLPタスクでの性能が向上。さらに、ゲノムデータへの新たな応用も示唆。 Comment
[Paper Note] Query-Key Normalization for Transformers, Alex Henry+, EMNLP'20 Findings
Paper/Blog Link My Issue
#MachineTranslation #EMNLP #Normalization #Findings Issue Date: 2025-08-16 GPT Summary- 低リソース言語翻訳において、QKNormという新しい正規化手法を提案。これは、注意メカニズムを修正し、ソフトマックス関数の飽和耐性を向上させつつ表現力を維持。具体的には、クエリとキー行列に対して$\ell_2$正規化を適用し、学習可能なパラメータでスケールアップ。TED TalksコーパスとIWSLT'15の低リソース翻訳ペアで平均0.928 BLEUの改善を達成。 Comment
QKに対してL2正規化を実施し、learnableなスカラー値を乗じることでスケーリングすることで、low resourceな言語での翻訳性能が向上。MTで実験されているが、transformerの表現力が改善されるのでGLM-4.5のアーキテクチャでも採用されている。
dot product attentionでは内積を利用するため値域に制約がなく、ある単語にのみattention scoreが集中してしまい、他の全ての単語のsignalをかき消してしまう問題がある。このため、QKをノルムによって正規化し(これにより実質QKはcosine similarityとなる)値域を制限する。しかしこうすると今度はスコア間の差が小さすぎて、attendしなくても良い単語を無視できなくなるので、learnableなパラメータでスケールを調整する。
[Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention #One-Line Notes #Sparse #SparseAttention Issue Date: 2025-08-09 GPT Summary- Longformerは、長いシーケンスを線形に処理できる注意機構を持つTransformerベースのモデルで、数千トークンの文書を扱える。局所的なウィンドウ注意とタスクに基づくグローバル注意を組み合わせ、文字レベルの言語モデリングで最先端の結果を達成。事前学習とファインチューニングを行い、長文タスクでRoBERTaを上回る性能を示した。また、Longformer-Encoder-Decoder(LED)を導入し、長文生成タスクにおける効果を確認した。 Comment
(固定された小さめのwindowsサイズの中でのみattentionを計算する)sliding window attentionを提案。Figure2を見ると、通常のAttentionと比較して、現在のトークンの周辺のトークンにしか注目しない特性が図示されており、イメージが掴みやすい。
OpenLLMの文脈だと、Mistralに採用されて話題になったかも?
- Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
[Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention #ICML #Selected Papers/Blogs #reading #One-Line Notes #RecurrentModels #LinearAttention Issue Date: 2025-08-05 GPT Summary- 自己注意をカーネル特徴マップの線形ドット積として表現することで、Transformersの複雑性を$\mathcal{O}\left(N^2\right)$から$\mathcal{O}\left(N\right)$に削減。これにより、自己回帰型Transformersの速度が最大4000倍向上し、従来のパフォーマンスを維持。 Comment
関連:
- Transformers are Multi-State RNNs, Matanel Oren+, N/A, EMNLP'24
pj page: https://linear-transformers.com
Linear Attention(Linear Transformer)を提案した研究。Softmaxが利用されるFull Attentionのsimilarity部分をfeature map φを持つカーネルk(x, y)で一般化し、(3)--(6)の流れでfeature map φ同士は内積が使える性質と、行列積の結合法則を用いて式変換する。
式変換によって、従来のSoftmax Attentionでは、全てのトークンNに対してQ_i * K_j * V_jのメモリが必要だったものを(O(N^2))、各Queryごとに利用される、KVを用いた情報が共通化され(現在のqueryまでのφ(K)とφ(K)V^Tを逐次的に加算して保持するだけで良い)、再利用が可能となりメモリに関するオーダーがO(N)となる。
これらの話は実際にどのような カーネルを利用するかを無視した話だが、たとえばsoftmaxを表現するために必要な指数カーネルの場合はfeature mapが無限次元となるため有限次元のベクトルでは表現できず、厳密に線形化することができない。このため、有限次元かつ厳密なfeature mapを持つ多公式カーネルを用いて近似する。この場合、計算量のオーダーがO(ND^2M)となり(Nがsequence length, Dがqueryとkeyの次元数, Mがvalueの次元数)、softmax attentionの計算量がO(N^2 max(D,M))であることと比較すると、N > D^2である場合に計算効率が改善される。
学習時は並列に学習が可能で、推論時はφ(K_j)V_j^Tを内部状態とみなすと、各タイムステップでRNNのように状態を更新して保持するだけで良い。
(続きはさらに後で読む)
次: DeltaNet
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
次の次: Gated DeltaNet
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
次の次の次: Kimi Delta Attention (KDA)
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
[Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention #ICLR #Sparse #SparseAttention Issue Date: 2025-08-05 GPT Summary- 本研究では、トランスフォーマーモデルの効率を向上させるために、局所感度ハッシュを用いた注意機構と可逆残差層を提案。これにより、計算量をO($L^2$)からO($L\log L$)に削減し、メモリ効率と速度を向上させたReformerモデルを実現。トランスフォーマーと同等の性能を維持。 Comment
openreview: https://openreview.net/forum?id=rkgNKkHtvB
[Paper Note] Linformer: Self-Attention with Linear Complexity, Sinong Wang+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention Issue Date: 2025-08-05 GPT Summary- 大規模トランスフォーマーモデルは自然言語処理で成功を収めているが、長いシーケンスに対しては高コスト。自己注意メカニズムを低ランク行列で近似し、複雑さを$O(n^2)$から$O(n)$に削減する新しいメカニズムを提案。これにより、メモリと時間効率が向上した線形トランスフォーマー「Linformer」が標準モデルと同等の性能を示す。
[Paper Note] On Layer Normalization in the Transformer Architecture, Ruibin Xiong+, arXiv'20, 2020.02
Paper/Blog Link My Issue
#Analysis #NLP #Architecture #Normalization #One-Line Notes Issue Date: 2025-07-05 GPT Summary- Transformerの学習で必要とされる学習率ウォームアップについて、Layer Normalizationの位置に着目して理論的に分析。 従来のPost-LN Transformerでは出力層付近の勾配が大きくなり学習が不安定になるため、ウォームアップが有効である。 一方、Pre-LN Transformerでは初期勾配が適切に保たれるため、ウォームアップなしでも同等の性能を達成し、学習時間とハイパーパラメータ調整を削減できる。 Comment
OpenReview: https://openreview.net/forum?id=B1x8anVFPr
Encoder-DecoderのTransformerにおいて、Post-LNの場合は、Warmupを無くすと最終的な性能が悪化し、またWarmUpステップの値によって(500 vs. 4000で実験)も最終的な性能が変化する。これには学習時にハイパーパラメータをしっかり探索しなければならず、WarmUPを大きくすると学習効率が落ちるというデメリットがある。
Post-LNの場合は、Pre-LNと比較して勾配が大きく、Warmupのスケジュールをしっかり設計しないと大きな勾配に対して大きな学習率が適用され学習が不安定になる。これは学習率を非常に小さくし、固定値を使うことで解決できるが、収束が非常に遅くなるというデメリットがある。
一方、Pre-LNはWarmup無しでも、高い性能が達成でき、上記のようなチューニングの手間や学習効率の観点から利点がある、みたいな話の模様。
[Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
Paper/Blog Link My Issue
#NeuralNetwork #NLP #LanguageModel #Selected Papers/Blogs #ActivationFunction #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- GLUの変種は非線形関数を用いて二つの線形射影を組み合わせ、Transformerモデルでテストした結果、従来の活性化関数ReLUやGELUよりも性能を向上させることが確認された。 Comment
一般的なFFNでは、linear layerをかけた後に、何らかの活性化関数をかませる方法が主流である。
最近FFNで利用される活性化関数として入力をsigmoid gateにlinear layerで変換して、同じくlinear layerで入力ベクトルを変換したベクトルとの要素積をとるGLUがあるが、これには改良の余地があり、様々なvariantが考えられるため、色々試しました(以下の8種類のvariantが提案されている)、というはなし。
オリジナルのGLUと比較して、T5と同じ事前学習タスクを実施したところ、perplexityが改善
また、finetuningをした場合の性能も、多くの場合オリジナルのGLUよりも高い性能を示した。
[Paper Note] Leveraging Pre-trained Checkpoints for Sequence Generation Tasks, Sascha Rothe+, TACL'20, 2019.07
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #MachineTranslation #NLP #pretrained-LM #TACL #Encoder #Encoder-Decoder #KeyPoint Notes Issue Date: 2022-12-01 GPT Summary- 事前学習された大規模なニューラルモデルがシーケンス生成においても有効であることを示し、BERT、GPT-2、RoBERTaと互換性のあるTransformerベースのモデルを開発。これにより、機械翻訳やテキスト要約などのタスクで新たな最先端の成果を達成。 Comment
# 概要
BERT-to-BERT論文。これまでpre-trainedなチェックポイントを利用する研究は主にNLUで行われてきており、Seq2Seqでは行われてきていなかったので、やりました、という話。
publicly availableなBERTのcheckpointを利用し、BERTをencoder, decoder両方に採用することでSeq2Seqを実現。実現する上で、
1. decoder側のBERTはautoregressiveな生成をするようにする(左側のトークンのattentionしか見れないようにする)
2. encoder-decoder attentionを新たに導入する
の2点を工夫している。
# 実験
Sentence Fusion, Sentence Split, Machine Translation, Summarizationの4タスクで実験
## MT
BERT2BERTがSoTA達成。Edunov+の手法は、data _augmentationを利用した手法であり、純粋なWMT14データを使った中ではSoTAだと主張。特にEncoder側でBERTを使うと、Randomにinitializeした場合と比べて性能が顕著に上昇しており、その重要性を主張。
Sentence Fusion, Sentence Splitでは、encoderとdecoderのパラメータをshareするのが良かったが、MTでは有効ではなかった。これはMTではmodelのcapacityが非常に重要である点、encoderとdecoderで異なる文法を扱うためであると考えられる。
## Summarization
BERTSHARE, ROBERTASHAREの結果が良かった。
[Paper Note] Text-to-Text Pre-Training for Data-to-Text Tasks, Mihir+, Google Research, INLG'20
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #INLG #KeyPoint Notes Issue Date: 2022-09-16 Comment
# 概要
pre-training済みのT5に対して、Data2Textのデータセットでfinetuningを実施する方法を提案。WebNLG(graph-to-text), ToTTo(table-to-text), Multiwoz(task oriented dialogue)データにおいて、simpleなTransformerでも洗練されたmulti-stageなpipelined approachをoutperformできることを示した研究。
# 手法
事前学習済みのT5に対してfine-tuningを実施した。手法はシンプルで、data-to-textタスクをtext-to-textタスクに変換した。具体的には、構造かされたデータをflatな文字列(linearization)で表現することで、text-to-textタスクに変換。各データセットに対するlinearizationのイメージは下図。デリミタや特殊文字を使って構造かされたデータをflatなstringで表現している。
# データセット
## ToTTo(2020)
Wikipediaのテーブルと自然言語でdescriptionのペアデータ
## MultiWoz(2018)
10Kの人間同士のtask-orientedなdialogueデータ。
## WebNLG(2017)
subject-object-predicateの3組みをテキスト表現に変換するタスクのデータ
# Result
## WebNLG
GCNを利用した2020年に提案されたDualEncがSoTAだったらしいが、outperormしている。
## ToTTo
[こちら](
https://github.com/google-research-datasets/totto)のリーダーボードと比較してSoTAを記録
## MultiWoz
T5は事前学習済みGPT-2をfinetuningした手法もoutperformした。SC-GPT2は当時のMultiWozでのSoTA
# Impact of Model capacity
T5モデルのサイズがどれが良いかについては、データセットのサイズと複雑さに依存することを考察している。たとえば、MultiWozデータは構造化データのバリエーションが最も少なく、データ量も56kと比較的多かった。このため、T5-smallでもより大きいモデルの性能に肉薄できている。
一方、WebNLGデータセットは、18kしか事例がなく、特徴量も約200種類程度のrelationのみである。このような場合、モデルサイズが大きくなるにつれパフォーマンスも向上した(特にUnseen test set)。特にBLEUスコアはT5-smallがT5-baseになると、10ポイントもジャンプしており、modelのcapacityがout-of-domainに対する一般化に対してcriticalであることがわかる。ToTToデータセットでも、SmallからBaseにするとパフォーマンスは改善した。
# 所感
こんな簡単なfine-tuningでSoTAを達成できてしまうとは、末恐ろしい。ベースラインとして有用。
Deep Knowledge Tracing with Transformers, Shi+ (w_ Michael Yudelson), ETS_ACT, AIED'20
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #AIED #One-Line Notes Issue Date: 2022-08-17 Comment
TransformerでKTした研究。あまり引用されていない。SAINT, SAINT+と同時期に発表されている。
[Paper Note] Large Memory Layers with Product Keys, Guillaume Lample+, NIPS'19, 2019.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #LanguageModel #Architecture #NeurIPS #memory Issue Date: 2026-08-09 GPT Summary- ニューラルネットワークに統合可能な構造化メモリを提案し、アーキテクチャの容量を最大10億パラメータまで増加。プロダクトキーに基づく設計で、高速な最近傍探索を実現。パラメータ数の増加により、予測精度と計算効率のトレードオフを最適化。12層のメモリ拡張モデルが24層のベースラインを上回り、推論速度は2倍に。コードは公開。 Comment
パラメータ数と計算量を分離する手法の一つ。
slide: https://neurips.cc/media/neurips-2019/Slides/15837.pdf
[Paper Note] Understanding and Improving Layer Normalization, Jingjing Xu+, arXiv'19, 2019.11
Paper/Blog Link My Issue
#Analysis #NLP #Architecture #Normalization #read-later Issue Date: 2026-07-26 GPT Summary- Layer normalization (LayerNorm)は中間層の分布を正規化し、訓練を加速し一般化精度を向上させますが、その効果の理由は未解明です。本研究では、LayerNormの理解を深め、逆伝播勾配の再センタリングと再スケーリングがフォワード正規化よりも重要であることを示しました。また、LayerNormのバイアスとゲインが過学習リスクを高めることを明らかにし、バイアスとゲインを排除したLayerNorm-simpleが4つのデータセットで優れた性能を示したことを報告します。さらに、Adaptive Normalization(AdaNorm)を提案し、実験では7つのデータセットでLayerNormを上回る結果を示しています。
[Paper Note] CTRL: A Conditional Transformer Language Model for Controllable Generation, Nitish Shirish Keskar+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #NLP #LanguageModel #Selected Papers/Blogs #Decoder Issue Date: 2026-01-16 GPT Summary- CTRLは、スタイルや内容、タスク特有の振る舞いを制御するコードに基づいて訓練された条件付きトランスフォーマー言語モデルで、1.63億パラメータを持つ。このモデルは、無監督学習の利点を生かしつつ、テキスト生成に対する明示的な制御を提供。CTRLは与えられたシーケンスに基づいて最も可能性のあるトレーニングデータを予測でき、データ分析の新たなアプローチを提示する。また、複数の事前訓練済みバージョンが公開されている。 Comment
Control Code(いわゆるタグ)によって条件付けることで生成されるテキストのスタイルや内容等をcontrollableにする研究の先駆け
[Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#ComputerVision #LongContext #Selected Papers/Blogs #One-Line Notes #SparseAttention Issue Date: 2025-11-30 GPT Summary- スパース因子分解を用いてトランスフォーマーの注意行列を$O(n \sqrt{n})$に削減し、深いネットワークの訓練やメモリ節約のための手法を導入。スパーストランスフォーマーは数百層で数万タイムステップのシーケンスをモデル化し、Enwik8、CIFAR-10、ImageNet-64で新たな最先端を達成。自己注意を用いて100万以上の長さのシーケンスをモデル化する可能性を示す。 Comment
Sparse Attentionの概念を提案した研究。以下Surveyより
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
[Paper Note] Universal Transformers, Mostafa Dehghani+, ICLR'19
Paper/Blog Link My Issue
#NLP #Architecture #ICLR #Selected Papers/Blogs #Generalization #LatentReasoning #RecurrentModels Issue Date: 2025-08-30 GPT Summary- 再帰神経ネットワーク(RNN)は逐次処理によりシーケンスモデリングで広く使われてきたが、トレーニングが遅くなる欠点がある。最近のフィードフォワードや畳み込みアーキテクチャは並列処理が可能で優れた結果を出しているが、RNNが得意とする単純なタスクでの一般化には失敗する。そこで、我々はユニバーサル・トランスフォーマー(UT)を提案し、フィードフォワードの並列処理能力とRNNの帰納バイアスを組み合わせたモデルを開発した。UTは特定の条件下でチューリング完全であり、実験では標準的なトランスフォーマーを上回る性能を示し、特にLAMBADAタスクで新たな最先端を達成し、機械翻訳でもBLEUスコアを改善した。 Comment
openreview: https://openreview.net/forum?id=HyzdRiR9Y7
[Paper Note] Supervised Multimodal Bitransformers for Classifying Images and Text, Douwe Kiela+, arXiv'19
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #Architecture Issue Date: 2025-08-21 GPT Summary- テキストと画像情報を融合する監視型マルチモーダルビットランスフォーマーモデルを提案し、さまざまなマルチモーダル分類タスクで最先端の性能を達成。特に、難易度の高いテストセットでも強力なベースラインを上回る結果を得た。 Comment
テキスト+imageを用いるシンプルなtransformer
[Paper Note] Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, Zihang Dai+, ACL'19
Paper/Blog Link My Issue
#EfficiencyImprovement #Attention #LongContext #PositionalEncoding #ACL #One-Line Notes Issue Date: 2025-08-05 GPT Summary- Transformer-XLは、固定長のコンテキストを超えた長期的な依存関係を学習する新しいニューラルアーキテクチャで、セグメントレベルの再帰メカニズムと新しい位置エンコーディングを採用。これにより、RNNより80%、従来のTransformersより450%長い依存関係を学習し、評価時には最大1,800倍の速度向上を実現。enwiki8やWikiText-103などで最先端のパフォーマンスを達成し、数千トークンの一貫したテキスト生成も可能。コードとモデルはTensorflowとPyTorchで利用可能。 Comment
日本語解説:
- 事前学習言語モデルの動向 / Survey of Pretrained Language Models, Kyosuke Nishida, 2019
3.2節の定式化を見ると、一つ前のセグメントのトークン・layerごとのhidden stateを、現在のセグメントの対応するトークンとlayerのhidden stateにconcatし(過去のセグメントに影響を与えないように勾配を伝搬させないStop-Gradientを適用する)、QKVのうち、KVの計算に活用している。また、絶対位置エンコーディングを利用するとモデルがセグメント間の時系列的な関係を認識できなくなるため、位置エンコーディングには相対位置エンコーディングを利用する。これにより、現在のセグメントのKVが一つ前のセグメントによって条件づけられ、contextとして考慮することが可能となり、セグメント間を跨いだ依存関係の考慮が実現される。
[Paper Note] What Does BERT Learn about the Structure of Language?, Jawahar+, ACL'19
Paper/Blog Link My Issue
#Analysis #NLP #ACL #One-Line Notes Issue Date: 2024-10-07 Comment
- 大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
中で引用されている。Transformerの各ブロックが、何を学習しているかを分析。
[Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Attention #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンションを提案し、アテンション・ヘッド間でキーと値を共有することで、逐次推論時のメモリ帯域幅を削減。これにより、デコード速度が向上し、品質低下は最小限に抑えられたことを実験で確認。 Comment
**※ 以前のメモでは "Queryを単一にする" と記述していましたが、完全に誤りでした。**
Multi Query Attention論文。Multi-Head Attentionにおける **KVを全てのhead間で共有する(つまりKV Cacheの量が1/num_headになる)** することで代替する。劇的にDecoderのInferenceが早くなりメモリ使用量が減る。論文中では言及されていない?ようだが、後続の研究で性能と学習の安定性が課題が指摘されているようである。
[Paper Note] Self-Attention with Relative Position Representations, Peter Shaw+, NAACL'18
Paper/Blog Link My Issue
#NLP #Attention #PositionalEncoding Issue Date: 2025-08-09 GPT Summary- 本研究では、Transformerの自己注意機構を拡張し、シーケンス要素間の相対的な位置を効率的に考慮する新しいアプローチを提案。WMT 2014の翻訳タスクで1.3 BLEUおよび0.3 BLEUの改善を達成。相対位置と絶対位置の組み合わせではさらなる改善は見られなかった。提案手法は、任意のグラフラベル付き入力に一般化可能な関係認識自己注意機構として位置付けられる。 Comment
相対位置エンコーディングを提案した研究
絶対位置エンコーディングは
- [Paper Note] Attention Is All You Need, Ashish Vaswani+, NeurIPS'17, 2017.07
[Paper Note] Efficient Attention: Attention with Linear Complexities, Zhuoran Shen+, arXiv'18
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Attention Issue Date: 2025-08-05 GPT Summary- 新しい効率的なアテンションメカニズムを提案し、ドット積アテンションと同等の性能を維持しつつ、メモリと計算コストを大幅に削減。これにより、アテンションモジュールの柔軟な統合が可能となり、精度向上を実現。実験結果では、MS-COCO 2017での物体検出やインスタンスセグメンテーションでの性能向上が確認され、Scene Flowデータセットでは最先端の精度を達成。コードは公開されている。 Comment
Figure1を見るとコンセプトが一目でわかり、非常にわかりやすい
[Paper Note] Self-Attentive Sequential Recommendation, Wang-Cheng Kang+, ICDM'18
Paper/Blog Link My Issue
#RecommenderSystems #SequentialRecommendation #ICDM #Selected Papers/Blogs Issue Date: 2025-07-04 GPT Summary- 自己注意に基づく逐次モデル(SASRec)を提案し、マルコフ連鎖と再帰型ニューラルネットワークの利点を統合。SASRecは、少数のアクションから次のアイテムを予測し、スパースおよび密なデータセットで最先端のモデルを上回る性能を示す。モデルの効率性と注意重みの視覚化により、データセットの密度に応じた適応的な処理が可能であることが確認された。
[Paper Note] Attention Is All You Need, Ashish Vaswani+, NeurIPS'17, 2017.07
Paper/Blog Link My Issue
#NeuralNetwork #MachineTranslation #NLP #FoundationModel #Attention #PositionalEncoding #NeurIPS #Normalization #Selected Papers/Blogs #KeyPoint Notes #Reference Collection Issue Date: 2018-01-19 GPT Summary- Transformerは、再帰や畳み込みを排除し、注意機構のみに基づいた新しいネットワークアーキテクチャである。実験により、機械翻訳タスクで優れた品質を示し、トレーニング時間を大幅に短縮。WMT 2014の英独翻訳で28.4 BLEU、英仏翻訳で41.8 BLEUを達成し、既存モデルを上回る性能を示した。また、英語の構文解析にも成功裏に適用可能であることを示した。 Comment
Transformer (self-attentionを利用) 論文
解説スライド:
https://www.slideshare.net/DeepLearningJP2016/dlattention-is-all-you-need
解説記事:
https://qiita.com/nishiba/items/1c99bc7ddcb2d62667c6
* 新しい翻訳モデル(Transformer)を提案。既存のモデルよりも並列化に対応しており、短時間の訓練で(既存モデルの1/4以下のコスト)高いBLEUスコアを達成した。
* TransformerはRNNやCNNを使わず、attentionメカニズムに基づいている。
(解説より)
分かりやすい:
https://qiita.com/halhorn/items/c91497522be27bde17ce
Transformerの各コンポーネントでのoutputのshapeや、attention_maskの形状、実装について記述されており有用:
https://qiita.com/FuwaraMiyasaki/items/239f3528053889847825
集合知
Transformer提案時と最近の動向への流れ
- BPEによるOOVの防止
- その後sentencepieceによる真の多言語化の実現
- Positional Encodingの提案
- 本稿はSinusoidal PE(絶対位置エンコーディング)で提案され、その後相対位置エンコーディング / RoPE / NoPE などの変種が登場
- Residual Connectionによる勾配爆発・消失の低減による深いモデル化
- 最近はHyperConnection等のResidual Streamの改善が進む
- QK Norm + learnableなScaling factor
- [Paper Note] Query-Key Normalization for Transformers, Alex Henry+, EMNLP'20 Findings
- 活性化関数の進化
- [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02
- Multi-head-attentionによるトークン間の多様な関係性のモデル化
- トークン間を跨いだ情報のmixing
- FFNによるトークン内での情報のmixing
- MHA -> MQA -> GQA -> MLA
- O(n^2)によるボトルネックを改善するために Sparse Attention / Linear Attention 等のより計算量が小さい手法へ進展
- また、実装上の工夫としてFlash Attentionが標準に
- Layer Normalizationによる正規化(内部共変量シフト防止)による学習の安定化
- 本稿ではPostLN
- その後Pre-LNの方が性能は落ちるが学習が安定するため主流となり、現在またPost-LNが再考されている
- また、現在はLayerNormalizationではなくRMSNormを使用する傾向がある
- [Paper Note] Understanding and Improving Layer Normalization, Jingjing Xu+, arXiv'19, 2019.11
- 本稿ではRNNと比較して並列計算可能なEncoder-Decoderアーキテクチャとして提案されMTで評価
- Decoder側ではCausal Maskの導入によるleakの防止
- その後、Decoder-only Model として現在のLLMの基盤に
- 実装上の工夫としてKV Cacheによる生成の高速化
[Paper Note] Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, Sergey Ioffe+, ICML'15
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #ICML #Normalization #Selected Papers/Blogs #Reference Collection Issue Date: 2025-04-02 GPT Summary- バッチ正規化を用いることで、深層ニューラルネットワークのトレーニングにおける内部共変量シフトの問題を解決し、高い学習率を可能にし、初期化の注意を軽減。これにより、同じ精度を14倍少ないトレーニングステップで達成し、ImageNet分類で最良の公表結果を4.9%改善。 Comment
メモってなかったので今更ながら追加した
共変量シフトやBatch Normalizationの説明は
- [Paper Note] Layer Normalization, Ba+, arXiv'16, 2016.07
記載のスライドが分かりやすい。
cua-s1-forms, cua-ai, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Dataset #SyntheticData #OpenWeight #ComputerUse #Encoder #One-Line Notes #Author Thread-Post Issue Date: 2026-09-19 Comment
github:
https://github.com/trycua/cua/tree/main/libs/cua-s1
dataset:
https://huggingface.co/datasets/cua-ai/cua-s1-forms
元ポスト:
フォーム入力に特化したCUAを実施できるモデルのようで、これもいわゆるSystem One Modelとして紹介されている。Transformer Encoderをバックボーンとする。
まあしかしこれは言ってしまえばただの合成データでFinetuningをしたBERTに見える。Jevのような様々なタスクに対してzero-shotの汎化をしめすものではないであろう点に注意。Jevがどれだけ汎用なのかはわからんが...
Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Blog #SmallModel #Proprietary #Architecture #Selected Papers/Blogs #One-Line Notes #ToolUse #Author Thread-Post #SystemOneModel Issue Date: 2026-09-19 Comment
元ポスト:
チャットをせず、各ターンごとに関数呼び出しに特化したedge向け小型モデルとのこと。アプリが利用するツール群を渡し、ユーザの発言に基づいて全ての引数を埋めて関数を呼び出す、あるいはスキーマを与えればそのスキーマに則った出力を返し(構造化出力)、推測はしない(関数の範囲外のものは空出力)というもののようである。
これらは、simple attention networkと呼ばれるもので実現される。simple attention networkはtransformerからFFN Layerをを無くし軽量なHadarmard MLPというlayerに置き換え、FFNが従来保持していた知識に関する情報はengramによって、n-gram embedding側に持たせることによって高速、軽量化がじつげんされているようである。residual streamとしては、mHCが用いられているようである。
また、デプロイ時にモデルの深さを指定することで、20個あるうちのどのlayerを利用するかが決まり、性能とコストを調整できるようである。これを公式ポストではIntelligence Laddersと呼称している。
関連:
- [Paper Note] Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, Xin Cheng+, arXiv'26, 2026.01
- [Paper Note] mHC: Manifold-Constrained Hyper-Connections, Zhenda Xie+, arXiv'25, 2025.12
関連:
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
と思想が似ている。
Lean Verified Transformers, Sasha Rush, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #NLP #Blog #Selected Papers/Blogs #reading #One-Line Notes #Proofs #Reading Reflections #Author Thread-Post Issue Date: 2026-09-17 Comment
元ポスト:
証明のコストが下がることによって、Leanによって型式的な証明をされたML Codeの価値が高まるのではないかという筆者の予測と、
一方で、証明を全て理解することは依然として困難という課題があるのとに言及し、
落とし所として人間にとって理解しやすい(部分的に証明したい)数学的な性質を選択的にAIによって証明するという試みをやってみよう、
そのために、Transformerを例に、Transformerの最適化や効率化の礎となっている数学的な性質を実際にLeanを用いて型式的に証明し理解してみよう、その結果、たとえば、VanillaAttentionとFlashAttentionが数学的に等価だということも示せる、
このような証明したい性質が何であるかを人間が選び、証明を得られることになった変化は重要であり、これらを今後どう活用するかということは今後の挑戦だよね、という話が書かれているようである。
実際に駆動するML Codeで、特定のモデルが実装されているときに、そのモデルが本来備えるべき重要な数学的性質を満たす実装になっていることが、型式的に証明された上で公開され、型式的に証明済みのbadgeがリポジトリに付与されている、みたいな未来が来るのだろうなあ
AHA LOOPED TRANSFORMER: Think deeper. Find your Aha. An open atlas of recurrent computation, adaptive depth, and latent reasoning., Yue Su, 2026.09
Paper/Blog Link My Issue
#Article #Survey #NLP #Blog #Architecture #RecurrentModels #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-16 Comment
有志を募って、looped transformerに関する論文に関する情報を収集しているようである。submitするぞ!
元ポスト:
Recurrent Looped Transformer, Yifan Zhang, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Architecture #RecurrentModels #Author Thread-Post Issue Date: 2026-09-13 Comment
元ポスト:
Atlas: A World Model for Spatial Intelligence, World Labs, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #Blog #Proprietary #read-later #Selected Papers/Blogs #3D Reconstruction #WorldModels #SpatialUnderstanding #Author Thread-Post #4D(Scene + Time) Issue Date: 2026-09-06 Comment
元ポスト:
解説:
MiniMax-H3, MiniMaxAI, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #TextToAudio #SpeechProcessing #OpenWeight #VideoGeneration/Understandings #UMM #Omni #TextToVideoGeneration #Author Thread-Post Issue Date: 2026-08-09 Comment
元ポスト:
Video Arenaと呼ばれるベンチマーク (Image-to-Video, Image-to-Video) でOpenWeightモデルでSoTA、全体で2位:
Quasar-Preview, silx-ai, 2026.06
Paper/Blog Link My Issue
#Article #SmallModel #OpenWeight #RecurrentModels Issue Date: 2026-06-09 Comment
元ポスト:
実験的にcontext windowが5M
Toto 2.0: Time series forecasting enters the scaling era, DATADOG, 2026.05
Paper/Blog Link My Issue
#Article #TimeSeriesDataProcessing #MachineLearning #FoundationModel #OpenWeight #One-Line Notes Issue Date: 2026-05-21 Comment
HF: https://huggingface.co/collections/Datadog/toto-20
時系列予測の基盤モデルも、パラメータサイズに対して性能がスケールする(ということが初めて示された)
Vision in the Age of LLMs, Lucas Beyer, 2026.05
Paper/Blog Link My Issue
#Article #Tutorial #ComputerVision #Pretraining #MultiModal #ContrastiveLearning #Video #read-later #VisionLanguageModel #Backbone Issue Date: 2026-05-21 Comment
関連:
- [Paper Note] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale, Alexey Dosovitskiy+, ICLR'21
- [Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
- [Paper Note] PaliGemma: A versatile 3B VLM for transfer, Lucas Beyer+, arXiv'24, 2024.07
元ポスト:
OlmPool: How small architectural choices compound to undermine long context extension, Ai2, 2026.04
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Attention #LongContext #Architecture #read-later #Selected Papers/Blogs #One-Line Notes #ContextRot #Author Thread-Post Issue Date: 2026-05-01 Comment
元ポスト:
QK Norm, GQA, SWA, 事前学習のcontext長の短縮、これらはいずれもモデルが入力に対するattendの仕方を変えるものだが、これらを3つ以上組み合わせるとlong contextでの性能が急落するらしく、このようなlong contextの性能劣化は一般的な(しばしば短い)コンテキスト長のベンチマークやloss/perplexityなどでは検知できず、long contextで性能が急落するアーキテクチャでは、50Bトークンでのlong contextの学習を経ても、Llamaアーキテクチャが1Bトークンの学習で到達できる性能に届かない、といった話が元ポストに書かれている。
Hunyuan3D-2, tencent, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #DiffusionModel #OpenWeight #TextTo3D #ImageTo3D Issue Date: 2026-04-25 Comment
元ポスト:
HY-World-2.0, Tencent, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #OpenWeight #WorldModels #Author Thread-Post Issue Date: 2026-04-16 Comment
元ポスト:
テクニカルレポート: https://3d-models.hunyuan.tencent.com/world/world2_0/HY_World_2_0.pdf
Introducing ERNIE‑Image, Baidu, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #DiffusionModel #TextToImageGeneration #OpenWeight #Selected Papers/Blogs #2D (Image) #One-Line Notes #ImageSynthesis #Author Thread-Post Issue Date: 2026-04-15 Comment
HF: https://huggingface.co/baidu/ERNIE-Image
ERNIEからtext-to-imageモデルがOpenWeightモデルとしてリリース。ベンチマークとしては公式ブログ上ではOpenWeightモデルの中でトップで、nano banana 2.0に匹敵するようなスコアが出ているように見える
Matrix-Game 3.0: Real-Time and Streaming Interactive World Model with Long-Horizon Memory, Skywork AI, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #SyntheticData #DiffusionModel #OpenWeight #VideoGeneration/Understandings #WorldModels #interactive #Game #3D (Video) #LongHorizon #Realtime #Initial Impression Notes Issue Date: 2026-04-02 Comment
元ポスト:
Unreal Engineで合成されたデータに基づいて学習されたDiTベースのWorld Modelらしい。
Acknowleagementから察するに、Wan2.2がベースモデルで、self-forcingが学習に用いられている。
- Wan2.2, Alibaba Wan, 2025.07
- [Paper Note] Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion, Xun Huang+, NeurIPS'25
また、action control moduleをアーキテクチャに導入することで、汎用的な動画生成モデルにキーボード、マウス等のアクションによるコントロールを実現している模様。
- [Paper Note] GameFactory: Creating New Games with Generative Interactive Videos, Jiwen Yu+, arXiv'25, 2025.01
デコードの高速化には量子化を利用しているとのこと。
LLM Architecture Gallery, Sebastian Raschka, 2026.03
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Blog #OpenWeight #Architecture #Initial Impression Notes Issue Date: 2026-03-20 Comment
元ポスト:
Sebastian Raschka氏がいつもポストしているOpenWeight LLMのアーキテクチャ図のギャラリー。パラメータサイズ, head数などの細かい情報も含まれているので、全体を概観するのに良さそう。
FLUX.2-klein-9B, black-forest-labs, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #NLP #TextToImageGeneration #SmallModel #Selected Papers/Blogs #2D (Image) #Editing #One-Line Notes Issue Date: 2026-03-15 Comment
元ポスト:
github: https://github.com/black-forest-labs/flux2
そもそも2025年11月にリリースされているFLUX.2は結構色々なところで名前を見かけるのでおさえておいたほうが良いかもしれない
https://bfl.ai/blog/flux-2
kleinはFLUX.2シリーズの中で最も軽量なモデルとのこと。2ヶ月程度で既に110k DLされている。
FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling, together.ai, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Library #Attention #Chip #read-later #Selected Papers/Blogs #GPUKernel #Initial Impression Notes Issue Date: 2026-03-06 Comment
元ポスト:
関連:
これは読まねば。。。
AdderBoard, anadim, 2026.02
Paper/Blog Link My Issue
#Article #MachineLearning #Repository #Mathematics #SoftwareEngineering #Selected Papers/Blogs Issue Date: 2026-02-28 Comment
10桁の加算を実現するtransformerを実現するレースが実施されている模様。もともとはClaude Code, Codexがそれぞれ6k, 1.6kパラメータからスタートしたところ、現在は人間が(おそらく重みを)手書きした139 params, 学習によって実現された311 paramsまで効率化が進んでいる模様。
ルールは
- self-attention-basedなDecoder-only transformerを利用すること
- 10Kのheld out セットにおいて>=99%以上のAccを実現すること
- アルゴリズムのハードコーディングは不可
という感じな模様。
>Self-attention is required. The model must contain at least one self-attention layer. This is the defining feature of a transformer — without it, you have an MLP or RNN, not a transformer.
と書かれているので、linear attentionは実質RNNのようなものなので、linear attentionのような亜種はおそらく不可であり、オリジナルで提案されているself-attentionが必要そうである。
Ming-omni-tts-0.5B, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #SpeechProcessing #DiffusionModel #Speech #OpenWeight #read-later #TTS #UMM #Omni #One-Line Notes #AdversarialTraining #Music Issue Date: 2026-02-18 Comment
元ポスト:
TTSだけでなく、環境音や音楽の生成も可能な音声生成モデル。発話速度、ピッチ、音量、感情、訛りなどを正確にコントロール可能で、100+以上のビルトインのvoiceや、zeroshotでのvoice designが可能とのこと。また、speechだけでなく環境音や音楽の生成もできる産業界では初めてのモデルとのこと。また、3.1Hzごとのフレームレートでパッチ化されて入力され(これはこれまでと比べるとかなり低いフレームレートらしい)るため高速に処理が走り、テキスト入力として数式などのフォーマットも入力可能とのこと。
テクニカルレポートのリンクがまだ生きておらず詳細は不明。
Ming-flash-omni-2.0, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #SpeechProcessing #DiffusionModel #Speech #OpenWeight #MoE(Mixture-of-Experts) #2D (Image) #Omni #text Issue Date: 2026-02-12 Comment
元ポスト:
関連:
- Ming-flash-omni-Preview, inclusionAI, 2025.10
- [Paper Note] Ming-Omni: A Unified Multimodal Model for Perception and Generation, Inclusion AI+, arXiv'25, 2025.06
公式ポスト:
Waypoint-1: Real-time Interactive Video Diffusion from Overworld, Overworld, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #Controllable #NLP #MultiModal #DiffusionModel #OpenWeight #WorldModels #interactive #3D (Video) #One-Line Notes #RectifiedFlow #Realtime Issue Date: 2026-01-22 Comment
blog:
https://over.world/blog/the-path-to-real-time-worlds-and-why-it-matters
pj page:
https://over.world/
元ポスト:
リアルタイムにzero latencyでマウス(カメラも自由に動かせる)、キーボード、テキストでinteraction可能なworld model
LongCat-Video-Avatar, meituan-longcat, 2025.12
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #VariationalAutoEncoder #OpenWeight #VideoGeneration/Understandings #3D (Scene) #One-Line Notes #Audio-Text-to-Video #Audio-Text-Image-to-Video #Video Continuation Issue Date: 2025-12-17 Comment
元ポスト:
アーキテクチャはDiTベースのDiffusion Modelで、3D Variational AutoencoderによってEncode/Decodeされ、3D RoPEによって位置情報が埋め込まれる。DiT Blockでは、テキストとaudio用のcross attentionが用いられてこれらのモーダルに関する情報が組み込まれる。audioはWav2Vecでエンコードされ、テキストはUMT5[^1]によってエンコードされる。
[^1]: multilingualなT5で100言語以上がサポートされている模様
Improved accuracy in Smart Turn v3.1, Daily, 2025.12
Paper/Blog Link My Issue
#Article #NeuralNetwork #AIAgents #SpeechProcessing #Blog #MultiLingual #OpenWeight #OpenSource #One-Line Notes #VAD Issue Date: 2025-12-04 Comment
dataset:
https://huggingface.co/pipecat-ai
code:
https://github.com/pipecat-ai/smart-turn
model:
https://huggingface.co/pipecat-ai/smart-turn-v3
オープンソースのVoice Activity Detection (VAD)モデル。本ブログのv3.1では、TTSデータだけでなく英語とスペイン語の人間によるaudio sampleも追加し学習し性能向上。23言語をサポートし、Accuracyは90%以上を達成。数msでのリアルタイムなlatencyを達成できる。
バックボーンはWhisper Tiny encoderで、headとしてshallow linear classifiesを利用しているとのこと。
Hunyuan Video 1.5 Technical Report, Tencent, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #OpenWeight #VideoGeneration/Understandings Issue Date: 2025-11-21 Comment
pj page:
https://hunyuan.tencent.com/video/zh?tabIndex=0
HF:
https://huggingface.co/tencent/HunyuanVideo-1.5
元ポスト:
How to Train a State-of-the-Art Pathology Foundation Model with $1.6k, Kaplan+, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #FoundationModel #Medical Issue Date: 2025-11-15 GPT Summary- OpenMidnightは、Midnight病理基盤モデルを再現・改善したもので、12,000枚の全スライド画像を用いて$1.6Kでトレーニングし、複数のベンチマークで最先端の性能を達成。大規模データなしでもトップパフォーマンスが可能であり、トレーニングパイプライン、コード、モデルの重みを公開して研究を促進する。 Comment
HF: https://huggingface.co/SophontAI/OpenMidnight
元ポストより
> The surprising performance of our model points to the challenges of the pathology FM space.
> Performance doesn't seem to scale with compute or dataset size, and for some benchmarks, really simple baselines perform shockingly well.
> In our mind, this indicates both that current models aren't being trained efficiently, and that the current benchmarks are poor.
まだデータセットサイズや計算量に応じてスケールしているようには見えず、現在のモデルが効率的に学習ができてとらず、かつ現在のベンチマークがモデルの性能を適切に測れていないのでは、といった話が記述されている。興味深い。
Omnilingual ASR: Advancing Automatic Speech Recognition for 1,600+ Languages, Meta, 2025.11
Paper/Blog Link My Issue
#Article #SpeechProcessing #MultiLingual #OpenWeight #AutomaticSpeechRecognition(ASR) #Selected Papers/Blogs #AudioLanguageModel Issue Date: 2025-11-12 Comment
Everything About Transformers, Krupa Dave, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #NLP #Blog #One-Line Notes Issue Date: 2025-10-30 Comment
元ポスト:
ざっと見た感じtransformerの基本的な内容の丁寧な解説に見える。literature(RNNや、LSTM、seq2seqなど)、self/cross-attention,LayerNorm, ResidualConnection, PositionalEncodingといった話の基礎が図解付きで説明されている。
LongCat-Video Techcal Report, Meituan LongCat Team, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #TextToImageGeneration #LongContext #VariationalAutoEncoder #OpenWeight #VideoGeneration/Understandings Issue Date: 2025-10-26 Comment
元ポスト:
HF: https://huggingface.co/meituan-longcat/LongCat-Video
公式ポスト:
FlashInfer-Bench: Building the Virtuous Cycle for AI-driven LLM Systems, FlashInfer Community, 2025.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #MachineLearning #Dataset #AIAgents #Evaluation #SoftwareEngineering #GPUKernel Issue Date: 2025-10-22 Comment
元ポスト:
GPUカーネルのエージェントによる自動最適化のためのベンチマークとのこと。
Introducing Stable Diffusion 3.5, StabilityAI, 2024.10
Paper/Blog Link My Issue
#Article #ComputerVision #DiffusionModel #TextToImageGeneration #Blog #OpenWeight #Selected Papers/Blogs Issue Date: 2025-10-10 Comment
SD3.5
IBM Granite 4.0: hyper-efficient, high performance hybrid models for enterprise, IBM, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #LongContext #SmallModel #OpenWeight #SSM (StateSpaceModel) Issue Date: 2025-10-02 Comment
元ポスト:
Mamba2とtransformerのハイブリッドモデルで、比率は9:1とMamba2ブロックが多めらしい。Mamba2の恩恵によりlokg-context時のメモリ使用量が70パーセント削減されるとのこと。
Attention ls Off By One, Evanmiller.org, 2023.07
Paper/Blog Link My Issue
#Article #Tutorial #MachineLearning #NLP #Attention #Blog #AttentionSinks #Selected Papers/Blogs Issue Date: 2025-09-12 Comment
Attention Scoreの計算におけるSoftmax関数はその性質上必ずいずれかのトークンに値を割り振らなければならないが、headがどこにも注意を向けたくない場合に、Softmax関数の性質上そうすることができない。たとえば、headがどのトークンにもスコアを割り振りたくなく、全てのトークンに対して負のlimitをとるような例を考えたときに、headはどこにも注意を向けたくないにもかかわらず、何らかのトークンにスコアは割り振られてしまう。これによって強制的に何らかのトークンに注意を向けざるを得なくなるが、本来はこのような場合はどこにも注意を向けないような挙動ができるようになるべきである。それを改善するために、ソフトマックス関数の分母に1を加えるシンプルな修正を加えた関数Softmax_1を提案しており、ソフトマックス関数の出力ベクトルのスコアの総和が1未満を取れる(言い換えると各スコアが0に近づくことができる)ような修正を提案している。
Attention Sinksと問題意識が同じであり、このブログの二か月後にAttention Sinkを指摘した研究がarXivに投稿される、という時系列に見える。
- [Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
Wan-S2V: Audio-Driven Cinematic Video Generation, Alibaba, 2025.08
Paper/Blog Link My Issue
#Article #ComputerVision #OpenWeight #VideoGeneration/Understandings #Encoder-Decoder Issue Date: 2025-08-27 Comment
元ポスト:
関連:
- Wan2.2, Alibaba Wan, 2025.07
image+Audio-to-video generation
Audioモダリティ: wav2vec+AudioEncoder
Visionモダリティ: 3D VAE Encoder
Textモダリティ: T5 Encoder
モダリティ統合: DiT Block(おそらくT5 Encoderの出力を用いてprompt情報を条件付け)とAudio Block?
3D VAE Decoderでデコードというアーキテクチャ?詳細が書かれておらずよくわからない。
RynnVLA-001: Using Human Demonstrations to Improve Robot Manipulation, Jiang+, Alibaba, 2025.08
Paper/Blog Link My Issue
#Article #NLP #Blog #VariationalAutoEncoder #OpenWeight #VideoGeneration/Understandings #Robotics #VisionLanguageActionModel #EmbodiedAI Issue Date: 2025-08-12 Comment
TL;DRは下記。
> We introduce RynnVLA-001, a vision-language-action model built upon large-scale video generative pre-training.
> - RynnVLA-001 is pretrained on ~12M ego-centric manipulation videos.
> - We unify next-frame prediction and next-action prediction into a single transformer.
> - We train a lightweight VAE to accurately compress action chunks into action embeddings.
> - Our RynnVLA-001 outperforms Pi-0 and GR00T-N1.5, in terms of both real-world task success rate and instruction-following capability.
まず、11.93Mの一人称視点での人間が操作(特に手の操作)をする動画と、244Kのrobotが操作をする動画でTransformerを事前学習する。このとき、actionラベルは一切用いず、pixelの情報から物理世界のダイナミクスを理解させる。続いて、Action Chunks(複数のアクションの少量のかたまり)を、dense embeddingにエンコードするVAEを学習する。チャンクを用いる理由は、ピクセルの変化が微小な場合、同じアクションが連続して予測されてしまいstuckしめしまう現象を防ぐこと、予測の効率が良いからとのこと。これによりVLAは単一のembedding vectorを予測するだけで、一貫性のあるアクション系列にデコードできる。最後に、step1で学習したvideo generationモデルと、step2で学習したVAEによるaction representationを統合する。具体的には、next frame prediction(visual tokenを予測; cross entropy loss)とnext action prediction(action edbeddingを予測する)を統合して学習する。action embeddingはcontinuousなベクトルなので異なるヘッドを用意して学習する(L1 Loss)。inference時はRGBのobservationと、テキストによるinstructionを入力として受け取り、action embeddingを予測する。action edbeddingはVAE decoderに渡され、low levelなaction系列に変換される。robotは予測されたアクションを実行し、observationが変化するのでまた予測する、といったiterationを実施する。visual tokenによる予測は不要なので、計算効率の観点から実施しない。
元ポスト:
HF: https://huggingface.co/Alibaba-DAMO-Academy/RynnVLA-001-7B-Base
The Big LLM Architecture Comparison, Sebastian Laschka, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Architecture #Selected Papers/Blogs Issue Date: 2025-08-06 Comment
Qwen3とGPT-OSSの比較はこちら:
最新のモデルも含めて内容が更新:
DeepSeek V3/R1
- MLA
- MoE
OLMo2
- LayerNorm → RMSNorm
- PreLN → PostNorm (Post RMSNorm)
- ただしオリジナルのtransformerとは異なり、residual connectionの内側にRMSNormが入る
- QK-Norm
- PostNorm + QK-Normによりpost normalizationのアーキテクチャでも学習が安定
Gemma3
- 27B程度の性能がそこそこ良く使いやすいサイズにフォーカス
- Sliding Window Attention / Local Attention
- Gemma2はlocal:global比はり1:1で、window幅は4kだったが、Gemma3は5:1となり、localの比率が5倍になり、window幅も1024となり1/4に
- ablation実験の結果性能の低下はminimumであることが示されている
- GQA
- Pre-RMSNorm + Post-RMSNorm
- これもresidual connectionの内側
あとで書く
【輪講資料】Moshi: a speech-text foundation model for real-time dialogue, Hayato Tsukagoshi, 2025.07
Paper/Blog Link My Issue
#Article #SpeechProcessing #Conversation #Slide #read-later Issue Date: 2025-07-15
Modded-NanoGPT, KellerJordan, 2024.05
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Repository #Optimizer #Selected Papers/Blogs #Decoder Issue Date: 2025-07-15 Comment
NanoGPT speedrun
関連:
- [Paper Note] The Automated LLM Speedrunning Benchmark: Reproducing NanoGPT Improvements, Bingchen Zhao+, arXiv'25
- きみはNanoGPT speedrunを知っているか?, PredNext, 2025.07
MuonとAdamWのweight decayをHyperball optimizationに置き換えることで記録更新されたようである:
Hyperball optimizationについては以下:
- Fantastic Pretraining Optimizers and Where to Find Them 2.1: Hyperball Optimization, Wen+, 2026.01
SOAP preconditioningをMuon直交化の前に加えることでSoTAとのこと。
関連:
- [Paper Note] SOAP: Improving and Stabilizing Shampoo using Adam, Nikhil Vyas+, ICLR'25
2025年度人工知能学会全国大会チュートリアル講演「深層基盤モデルの数理」, Taiji Suzuki, 2025.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #MachineLearning #NLP #LanguageModel #Chain-of-Thought #In-ContextLearning #Attention #DiffusionModel #SSM (StateSpaceModel) #Slide #Scaling Laws #PostTraining Issue Date: 2025-05-31 Comment
元ポスト:
Datadog_Toto-Open-Base-1.0, Datadog, 2025.05
Paper/Blog Link My Issue
#Article #TimeSeriesDataProcessing #MachineLearning #FoundationModel #OpenWeight Issue Date: 2025-05-25 Comment
元ポスト:
Nemotron-H: A Family of Accurate, Efficient Hybrid Mamba-Transformer Models, Nvidia, 2025.03
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #MultiModal #Blog #SSM (StateSpaceModel) #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-24 Comment
関連:
- Hunyuan T1, Tencent, 2025.03
TransformerのSelf-attention LayerをMamba2 Layerに置換することで、様々なベンチマークで同等の性能、あるいは上回る性能で3倍程度のInference timeの高速化をしている(65536 input, 1024 output)。
56B程度のmediumサイズのモデルと、8B程度の軽量なモデルについて述べられている。特に、8BモデルでMambaとTransformerのハイブリッドモデルと、通常のTransformerモデルを比較している。学習データに15 Trillion Tokenを利用しており、このデータ量でのApple to Appleのアーキテクチャ間の比較は、現状では最も大規模なものとのこと。性能は多くのベンチマークでハイブリッドにしても同等、Commonsense Understandingでは上回っている。
また、学習したNemotron-Hをバックボーンモデルとして持つVLMについてもモデルのアーキテクチャが述べられている。
8 Types of RoPE, Kseniase, 2025.03
Paper/Blog Link My Issue
#Article #Survey #Embeddings #NLP #LanguageModel #Blog #PositionalEncoding #Initial Impression Notes Issue Date: 2025-03-23 Comment
元ポスト: https://huggingface.co/posts/Kseniase/498106595218801
RoPEについてサーベイが必要になったら見る
15 types of attention mechanisms, Kseniase, 2025.03
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Attention #Blog #Initial Impression Notes Issue Date: 2025-03-18 Comment
Luongらのアテンションやsoft, globalアテンションなど、古くからあるattentionも含まれている。
Sohu, etched, 2024.06
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #Chip #Initial Impression Notes Issue Date: 2024-09-18 Comment
>By burning the transformer architecture into our chip, we can’t run most traditional AI models: the DLRMs powering Instagram ads, protein-folding models like AlphaFold 2, or older image models like Stable Diffusion 2. We can’t run CNNs, RNNs, or LSTMs either.
transformer以外の大抵のモデルでは動作しないが、代わりにH-100よりも20倍早いinferenceを実現できるチップらしい。
>With over 500,000 tokens per second in Llama 70B throughput, Sohu lets you build products impossible on GPUs.
いやいやいやLlama-70Bで0.5M Token/secは早すぎる!!!
2026年3月時点で確認したところページが削除されているようだが、どうなったのだろうか?
Table Transformer Demo
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #TabularData Issue Date: 2023-12-01 Comment
PDF中のテーブルとその構造(行列セル)をdetectするモデル
Exampleは以下のような感じ(日本語だとどれくらいできるのかな...)
Transformers.js, 2023
Paper/Blog Link My Issue
#Article #Library #Blog #Frontend #One-Line Notes Issue Date: 2023-11-13 Comment
ブラウザ上でTransformerベースの様々なモデルを動作させることができるライブラリ
大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
Paper/Blog Link My Issue
#Article #Analysis #MachineLearning #Blog #FactualKnowledge #One-Line Notes Issue Date: 2023-10-29 Comment
タイトルの通り、知識がFFNに蓄積されていると主張しているらしい原論文を読み解いている。まとめを引用すると
> 「知識は全結合層に蓄積される」という表現は、ややラジカルで、
少なくともこの論文では「全結合層は知識獲得において重要」という程度
の、もう少しマイルドな主張をしているように見受けられました。
とのこと。
Assisted Generation: a new direction toward low-latency text generation, 2023
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #Library #python Issue Date: 2023-05-11 Comment
1 line加えるとtransformerのgenerationが最大3倍程度高速化されるようになったらしい
assistant modelをロードしgenerateに引数として渡すだけ
30分で完全理解するTransformerの世界, はまなすなぎさ, Zenn, 2023.02
Paper/Blog Link My Issue
#Article #Tutorial #Survey #NLP Issue Date: 2023-02-14 Comment
非常に詳細で実質日本語のサーベイ論文のようなもの
Transformers Interpret, 2022
Paper/Blog Link My Issue
#Article #ComputerVision #MachineLearning #NLP #Library #Explanation #Blog #One-Line Notes Issue Date: 2022-12-01 Comment
transformersのモデルをたった2行追加するだけで、explainableにするライブラリ
基本的にtextとvisionのclassificationをサポートしている模様
text classificationの場合、たとえばinput tokenの各トークンの分類に対する寄与度をoutputしてくれる。
BetterTransformer, Out of the Box Performance for Hugging Face Transformers
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #EfficiencyImprovement #NLP #Library #One-Line Notes Issue Date: 2022-12-01 Comment
たった1ライン追加するだけで、Transformerのinferenceが最大で4.5倍高速化されるBetterTransformerの解説記事
better_model = BetterTransformer.transform(model)
CNN vs. ViT, Yoshitaka Ushiku, ECCV 2022 読み会, 2022.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #ComputerVision #Slide #One-Line Notes Issue Date: 2022-10-27 Comment
・Swin Transformer, Depth-wise conv, ConvNeXt, ViTとCNNのロバスト性の違いの話があり勉強になる
・最終的な結論が、CNNもTransformerも変わらない(明確な勝者はいない; 今のところ引き分け)というのはおもしろかった
depth-wise conv, point-wise convの解説記事:
https://agirobots.com/depthwise-pointwise-convolution/
通常のCNNのフィルタによるfeature map計算を、空間方向(depth-wise conv)とチャネル方向(point-wise conv; 1x1 conv)に分解することで大幅にパラメータ数削減
Transformerの最前線 〜 畳込みニューラルネットワークの先へ 〜, Yoshitaka Ushiku, 2022.06
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tutorial #NLP #Slide #Selected Papers/Blogs #Reading Reflections Issue Date: 2022-09-06 Comment
Transformerの動作原理を直感的に理解するのに非常にわかりやすい説明で、とても勉強になる。
以下のような内容が解説されており、あまりにも盛りだくさんで最高。
- Positional Encoding
- autoregressive vs. non-autoregressive
- residual connection
- multi-head attention
- RNN(O(N)だけど長い系列苦手), CNN(O(N)だけど近傍しか見れない)との対比
- Vision & Languageの話題とVision Transformerとのつながり
- Swin Transformer
- 基盤モデルの定義
- ある目的関数のもと、自己教師あり学習された、巨大なモデル(様々なタスクに容易に転用できる)
- gMLP, MLP-MixerなどのMLP likeなアーキテクチャとの比較
- Transformerと本質的にやっていることはあまり変わらず、ベクトルの混ぜ方(attention vs. 行列積)と位置情報の保持をベクトルがするのかindexに基づいてネットワークが保持するのか、が変わっているのみ
- Transformer性能向上の軌跡
- pre-Norm / post-Norm / 活性化関数(GLU等) / MoE等 / RoPE
- Scaling Law
- CNNとViTの性質(CNNはハイパスフィルタ、ViTはローパスフィルタ)
FastSeq: Make Sequence Generation Faster, Yan+, ACL’21
Paper/Blog Link My Issue
#Article #NeuralNetwork #EfficiencyImprovement #NLP #ACL #One-Line Notes Issue Date: 2021-06-10 Comment
BART, DistilBART, T5, GPT2等のさまざまなTransformer-basedな手法で、4-9倍Inference speedを向上させる手法を提案。