
One-Line Notes (1270) — 4/7
[Paper Note] Video PreTraining (VPT): Learning to Act by Watching Unlabeled Online Videos, Bowen Baker+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#ComputerVision #Pretraining #FoundationModel #3D (Video) #WorldActionModel Issue Date: 2026-02-27 GPT Summary- オンラインのラベルなし動画を用いた半教師付き模倣学習により、逐次決定領域へインターネット規模の事前学習を拡張。逆ダイナミクスモデルを利用して、少量のラベル付きデータから一般的な行動知識を獲得。これにより、模倣学習と強化学習でのファインチューニングが可能となり、困難な探索課題に対するゼロショット能力を示す。初めて、ダイヤモンドの道具を作成できるコンピュータエージェントが報告され、人間レベルの性能を実現。 Comment
Inverse Dynamics Model (IDM)
observationによる状態の変化が、どのアクションによって引き起こされたかを推定するモデル(Inverse Dynamics Model)を学習し(すべてのobservationのtrajectoryから時刻tでのアクションを予測するモデル)アクション-状態遷移のダイナミクスの知識を理解したモデルを学習。その後大量のunlabeled dataに対してIDM Modelによって、アクションをラベル付けし、当該アクションラベルを教師として、Forward Dynamics Model (時刻tまでの状態遷移が与えられた時に次にどのようなアクションが実施されるかを予測するモデル)を学習することで事前学習をする手法な模様。
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICLR #PostTraining #Selected Papers/Blogs Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] Over-Generation Cannot Be Rewarded: Length-Adaptive Average Lagging for Simultaneous Speech Translation, Sara Papi+, NAACL'22
Paper/Blog Link My Issue
#Metrics #NLP #Evaluation #SpeechProcessing #AutomaticSpeechRecognition(ASR) #NAACL #SimulST(SimultaneousSpeechTranslation) Issue Date: 2025-04-30 GPT Summary- SimulSTシステムの遅延評価において、ALが長い予測に対して過小評価される問題を指摘。過剰生成の傾向を持つシステムに対し、過小生成と過剰生成を公平に評価する新指標LAALを提案。 Comment
同時翻訳研究で主要なmetricの一つ
関連:
- [Paper Note] SimulMT to SimulST: Adapting Simultaneous Text Translation to End-to-End Simultaneous Speech Translation, Xutai Ma+, AACL'20
[Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #NeurIPS #Scaling Laws #Selected Papers/Blogs Issue Date: 2025-03-23 GPT Summary- トランスフォーマー言語モデルの訓練において、計算予算内で最適なモデルサイズとトークン数を調査。モデルサイズと訓練トークン数は同等にスケールする必要があり、倍増するごとにトークン数も倍増すべきと提案。Chinchillaモデルは、Gopherなどの大規模モデルに対して優れた性能を示し、ファインチューニングと推論の計算量を削減。MMLUベンチマークで67.5%の精度を達成し、Gopherに対して7%以上の改善を実現。 Comment
OpenReview: https://openreview.net/forum?id=iBBcRUlOAPR
chinchilla則、モデルの規模とデータ量はおおむね同じ比率でスケールすべき、という話。
[Paper Note] Deep Intention-Aware Network for Click-Through Rate Prediction, Yaxian Xia+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CTRPrediction Issue Date: 2024-11-19 GPT Summary- TIRAにおいて、顧客の入店意図を抽出し、トリガーの影響を重み付けするためにDIANを提案。DIANは、意図に基づきCTRを推定する3つのネットワーク(Intention Net、Trigger-Aware Net、Trigger-Free Net)を用い、推定結果をバランスさせることで精度を向上。実験により、実世界データセットでの性能が最先端を示し、TaobaoのミニアプリJuhuasuanのページビューを9.39%、CTRを4.74%改善。 Comment
- [Paper Note] Collaborative Contrastive Network for Click-Through Rate Prediction, Chen Gao+, arXiv'24
の実験で利用されているベースライン
Deep Interest Highlight Network for Click-Through Rate Prediction in Trigger-Induced Recommendation, Qijie Shen+, WWW'22
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CTRPrediction #WWW Issue Date: 2024-11-19 GPT Summary- トリガー誘発推薦(TIR)を提案し、ユーザーの瞬時の興味を引き出す新しい推薦手法を紹介。従来のモデルがTIRシナリオで効果的でない問題を解決するため、Deep Interest Highlight Network(DIHN)を開発。DIHNは、ユーザー意図ネットワーク(UIN)、融合埋め込みモジュール(FEM)、ハイブリッド興味抽出モジュール(HIEM)の3つのコンポーネントから成り、実際のeコマースプラットフォームでの評価で優れた性能を示した。 Comment
- [Paper Note] Collaborative Contrastive Network for Click-Through Rate Prediction, Chen Gao+, arXiv'24
の実験で利用されているベースライン
[Paper Note] No Language Left Behind: Scaling Human-Centered Machine Translation, NLLB Team+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#MachineTranslation #NLP #Dataset #LowResource Issue Date: 2024-09-26 GPT Summary- 低資源言語翻訳を支援するため、母語話者へのインタビューを通じてニーズを明らかにし、新たなデータセットとモデルを開発。Sparsely Gated Mixture of Expertsに基づく条件付き計算モデルを用い、訓練時の過剰適合を抑えつつ性能を向上。Flores-200ベンチマークにより翻訳性能を評価し、BLEUスコアを44%改善。研究成果はオープンソースとして公開。 Comment
low-resourceな言語に対するMTのベンチマーク
[Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #ICLR #Selected Papers/Blogs Issue Date: 2024-09-25 GPT Summary- 指示チューニングにより言語モデルのゼロショット学習能力を向上。1370億パラメータのモデルを60以上のNLPタスクに対してファインチューニングし、FLANと名付ける。FLANは未調整モデルを超え、25タスク中20タスクで175B GPT-3を上回り、ANLIやRTEなどでfew-shotのGPT-3にも勝る。ファインチューニングデータの数やモデル規模、指示内容が成功の鍵と示される。 Comment
FLAN論文。Instruction Tuningを提案した研究。
openreview: https://openreview.net/forum?id=gEZrGCozdqR
[Paper Note] STaR: Bootstrapping Reasoning With Reasoning, Eric Zelikman+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#NLP #LanguageModel #SelfImprovement #NeurIPS #Selected Papers/Blogs #needs-revision Issue Date: 2024-09-15 GPT Summary- STaR(Self-Taught Reasoner)を提案し、少数の推論例と大規模データセットを用いて段階的に複雑な推論を行う手法を紹介。まず複数の質問に対して推論根拠を生成し、誤答時には正しい解答を前提に再生成を行うことで性能を向上。STaRはファインチューニングにより自己学習能力を持ち、複数のデータセットでの性能を顕著に改善、CommensenseQAでは最先端モデルと同等の結果を達成。 Comment
OpenAI o1関連研究
openreview: https://openreview.net/forum?id=_3ELRdg2sgI
モデルが正解できなかった問題に対して、解答で条件付けした上で推論過程(rationale)を生成することで、finetuning用の追加の学習事例を獲得する。
[Paper Note] BRIO: Bringing Order to Abstractive Summarization, Yixin Liu+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#DocumentSummarization #BeamSearch #NaturalLanguageGeneration #NLP #ACL #needs-revision Issue Date: 2023-08-16 GPT Summary- 非決定論的分布を仮定し、複数の候補要約に確率を割り当てる新しい訓練パラダイムを提案。CNN/DailyMailおよびXSumデータセットで最先端のROUGEスコアを達成し、モデルが候補要約の品質と相関する確率を推定可能であることを示す。 Comment
ビーム内のトップがROUGEを最大化しているとは限らなかったため、ROUGEが最大となるような要約を選択するようにしたら性能爆上げしましたという研究。
実質現在のSoTA
[Paper Note] TRUE: Re-evaluating Factual Consistency Evaluation, Or Honovich+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #NLP #Evaluation #Factuality #needs-revision Issue Date: 2023-08-13 GPT Summary- 事実的一致性評価が重要なテキスト生成システムにおいて、矛盾を減らすための自動評価が提案される。従来の評価指標は特定のタスクに偏りがあり、実用性に欠けることが多い。これに対抗して、TRUEを提案し、多様なタスクに基づく標準化されたコレクションに対する人手注釈のもとでの評価を行う。これにより、例レベルのメタ評価プロトコルが実現し、質の高い評価が可能となった。大規模なNLIや質問生成モデルが強力な結果を示し、今後の評価方法の改善へ向けた新たな指針を提供する。 Comment
FactualConsistencyに関するMetricが良くまとまっている
[Paper Note] Explaining Patterns in Data with Language Models via Interpretable Autoprompting, Chandan Singh+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Dataset #LanguageModel #DataToTextGeneration #Explanation #Data Issue Date: 2023-08-03 GPT Summary- iPromptを用いて、事前学習済みのLLMがデータを説明する自然言語文字列を生成する手法を提案。このアルゴリズムは、生成された説明の性能を再評価して最適化するプロセスを含む。実験によりiPromptが正確なデータ記述を見つけ、人間にも解釈可能なプロンプトを生成し、一般化性能に優れることが示された。特に、実世界の感情分類データセットでGPT-3並みのプロンプトを生成し、科学的発見の支援にも寄与する可能性がある。すべてのコードはGitHubで公開。 Comment
OpenReview: https://openreview.net/forum?id=GvMuB-YsiK6
データセット(中に存在するパターンの説明)をLLMによって生成させる研究


[Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #needs-revision Issue Date: 2023-07-03 GPT Summary- HELMは、言語モデルの透明性を高めるための包括的評価手法である。まず、潜在的なシナリオと指標の分類を行い、欠落している部分を特定。次に、マルチ指標アプローチを採用し、コアシナリオごとに7つの評価指標を測定することで、正確性以外の側面も考慮。さらに、30の著名な言語モデルに対して大規模評価を実施し、評価範囲を17.9%から96.0%に改善。全データを公開し、HELMをコミュニティの生きたベンチマークとして継続的に更新していくことを目指している。 Comment
OpenReview: https://openreview.net/forum?id=iO4LZibEqW
HELMを提案した研究
当時のLeaderboardは既にdeprecatedであり、現在は下記を参照:
https://crfm.stanford.edu/helm/
[Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #needs-revision Issue Date: 2023-07-03 GPT Summary- 言語モデルはスケールの拡大に伴い、新しい定量的・質的能力を示すが、その具体的な特性は未解明である。これを踏まえ、BIG-benchという新たなベンチマークを導入し、204の多様なタスクを評価。モデルの性能と較正は改善するが、絶対的には低く、スパース性の影響を受ける場合もある。特に、複数の手順を要するタスクは臨界規模での“ブレークスルー”を示す傾向があり、社会的バイアスは通常、スケールと共に増加するが、プロンプトによって改善可能である。 Comment
OpenReview: https://openreview.net/forum?id=uyTL5Bvosj
BIG-Bench論文。ワードクラウドとキーワード分布を見ると一つの分野に留まらない非常に多様なタスクが含まれることがわかる。
BIG-Bench-hardは、2024年にClaude3.5によって、Average Human Scoreが67.7%のところ、93.1%を達成され攻略が完了した。現在は最先端のモデル間の性能を差別化することはできない。
- Killed by LLM, R0bk
[Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #Attention #Selected Papers/Blogs #Reference Collection Issue Date: 2023-05-20 GPT Summary- 長いシーケンスにおけるTransformerの計算とメモリ消費の問題に対処するため、IOを意識した注意アルゴリズムFlashAttentionを提案。これによりメモリの読み書き回数を減少させ、従来の基準よりも約15%の速度向上を実現。FlashAttentionは長い文脈を処理可能にし、モデル品質も改善。具体的には、BERT-largeやGPT-2で従来を上回るパフォーマンスを達成し、Path-Xチャレンジで新たな成果を示した。 Comment
より高速なGPU上のSRAM上で計算できるようにQKVをブロック単位に分割して計算することで、より高い計算効率を実現するFlashAttentionを提案[^1]
[^1]: (2025.05.24追記)下記日本語ブログを参考に一部文言を訂正しました。ありがとうございます。
日本語解説:
https://zenn.dev/sinchir0/articles/21bb6e96c7b05b
元ポスト:
日本語解説:
https://zenn.dev/uchiiii/articles/306d0bb7ef67a7
元ポスト:
openreview: https://openreview.net/forum?id=H4DqfPSibmx
あわせて読みたい:
- CUDA Programming Guide Part 1, Kazuki Fujii, 2026.06
論文内でon-chip SRAMと呼ばれているものは、この記事におけるGPUのUnified Data Cache (192KB L1 Data Cache/Shared Memory)のことである。
[Paper Note] Are Transformers Effective for Time Series Forecasting?, Ailing Zeng+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#TimeSeriesDataProcessing #MachineLearning #LanguageModel #Transformer Issue Date: 2022-12-29 GPT Summary- LTSFタスクに対するTransformer解法の妥当性を疑問視し、単純な1層線形モデル(LTSF-Linear)が既存のTransformerモデルを全ケースで上回る結果を示す。時間的関係の抽出における要素の影響を詳細に分析し、新たな研究の方向性を提案。将来的には他の時系列分析にもアプローチを見直すことを提唱。 Comment
Linear Layerに基づくシンプルな手法がTransformerベースの手法に時系列予測で勝ったという話
[Paper Note] Revisiting Pretraining Objectives for Tabular Deep Learning, Ivan Rubachev+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #MachineLearning #TabularData Issue Date: 2022-12-01 GPT Summary- 深層学習モデルは、GBDTと競争できるものの、事前学習手法の有効性や選択基準は明確でない。本研究では、表形式データに対する深層学習モデルの事前学習のベストプラクティスを特定し、ターゲットラベルを活用することが性能向上に寄与することを示した。適切な事前学習により、深層学習モデルはGBDTをしばしば上回る。 Comment
Tabular Dataを利用した場合にKaggleなどでDeepなモデルがGBDT等に勝てないことが知られているが、GBDT等とcomparable になる性能になるようなpre-trainingを提案したよ、的な内容っぽい
ICLR 2023 OpenReview: https://openreview.net/forum?id=kjPLodRa0n
Interpretable Knowledge Tracing: Simple and Efficient Student Modeling with Causal Relations, Minn+, AAAI'22
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #AAAI Issue Date: 2022-08-02 Comment
DeepLearningを用いずに解釈性の高いKTモデルを提案。DKT, DKVMN, AKT等をoutperformしている。
[Paper Note] JaQuAD: Japanese Question Answering Dataset for Machine Reading Comprehension, ByungHoon So+, arXiv'22, 2022.02
Paper/Blog Link My Issue
#NLP #Dataset #QuestionAnswering Issue Date: 2022-02-07 GPT Summary- 日本語の質問応答データセットJaQuADを提案。39,696の質問-回答ペアを含み、テストセットでF1スコア78.92%、EMスコア63.38%を達成したベースラインモデルをファインチューニング。データセットは公開中。 Comment
SQuAD likeな日本語のQAデータセット
https://github.com/SkelterLabsInc/JaQuAD
[Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
Paper/Blog Link My Issue
#NLP #LanguageModel #Scalability Issue Date: 2026-07-09 GPT Summary- 言語モデリングは大規模な知識リポジトリを活用し、世界の理解を深化させる。本研究では、数千万から2,800億パラメータのTransformerベースのモデルGopherの性能を分析し、152の多様なタスクで最先端を達成。特に、読解や事実確認でスケールの利得が大きいが、論理的推論には限界がある。モデルの挙動やばイアス、危害の交差を総合的に評価し、AIの安全性に向けた適用と害の軽減についても考察。 Comment
- [Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
- 大規模言語モデルの次期バージョンPLaMo 3シリーズにおける120B事前学習モデル、31B蒸留モデルの評価, PFN, 2026.07
で利用されている weight reusingについて、`G3.3 Warm starting` に記載されている。概要としては
- LLMのキャパシティを増大させる際に、幅をスケーリングさせるよりも、深さをスケーリングさせる方が有望な結果となった
### 深さのスケーリング方法のbest practice
- 深さをスケーリングさせる、すなわち、5 layer -> 7 layerに拡張したい、という場合は、元の学習済みレイヤーを以下のルールによって複製することによって、拡張する:
- `round_int(range(num_layers_new)/num_layers_new * num_layers_old)`
- たとえば、`A B C D E` の5つのレイヤーで構成されているモデルがあったときに、これを7 layerに拡張したい場合は、上記indexに従って7つのレイヤーに学習済みレイヤーを割り当てると、`A B B C D D E` となる。
### 幅のスケーリング方法のbest practice
- (widthの拡張方法については正しく読めているかかなり自信がなく、間違っている可能性が非常に高いので注意)
- 幅をスケーリングさせる際は、MHA の weight matrices に対して列方向のコピー→行方向のコピー→ ノイズの注入を行う。
- 前提として以下を考える:
- MHAのQKV, outputのprojectionをそれぞれ、`W_q \in R^{d_model \times d_k}`, `W_k \in R^{d_model \times d_k}`, `W_v \in R^{d_model \times d_v}`, `W_o \in R^{h d_v \times d_model}` とする。
- このとき、オリジナルのtransformer論文では、`d_k = d_v = d_model/h` としている。
- つまり、各headに対応するW_{q, k, v, o}を列方向にconcatした行列 W^concat_{q, k, v, o}を考えると、列方向がh倍されるので、`W^concat_{q, k, v, o} \in R^{d_model \times d_model}` の正方行列で表現できる。ここで、`h * d_v= h * d_k= h * d_model/h = d_model` を用いた。
- この `W^{concat}_{*}` に対する操作を定義することで、multihead attentionが扱う幅を変更することができる。
- 元論文では、weight matricesと一言で言及されているが、これは(おそらく)`W^{concat}_{q, k, v, o}` のことを指していると思われる。実際、説明をする際は正方行列を前提に考えている(attention headごとに独立して考える元論文の数式では正方行列は weight matrices に出現しない)。
- まず `W^{concat}_{*}` において、head sizeをH, head数をnとしたときに、`nH \times nH` の行列を列方向にtilingすることによってattention headの数をmに拡張する。このとき、`d_k`, `d_v` のサイズは固定する。たとえば、head数をnからmに増やす際、最初のm-n個のheadを `W^{concat}_{*}` の右側に複製することによって拡張する、と説明されている。
- これはすなわち、個々のheadが扱う情報量は変化させずに、代わりにhead数を増やすことでスケーリングさせる、ということを指していると考えられる。
- 続いて、head数が増えたことによって `W^{concat}_{*}` が正方行列ではなくなった。これが正方行列になっていないとattentionの前後でbottleneck activation size(元論文ではd_modelのことをbottleneck activation sizeと呼称している)が変化してしまうので、正方行列にしなければならない。
- これを正方行列にするために、列方向に複製した行列の上端から数えて `(m-n) * d_k` 行分を行方向にconcatする。
- 最終的に、新たに初期化された重みに対してノイズを注入する。
- これによって構築された `W^{concat}_{*}` を図示したものが、下記Figure A32 と思われる。
- また、上記ではMHAの説明をしたが、MLPなどのd_modelが関わる各種weight matricesもwidthの拡張に含まれていると考えられる(じゃないとwidthの拡張と呼べないし)。
- optimizerの状態は再初期化して学習を実施する。
- Adam optimizerの状態に対して似たような処理を実施したが性能向上にはつながらなかった
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Transformer #Architecture #Selected Papers/Blogs #ActivationFunction Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] VoxLingua107: a Dataset for Spoken Language Recognition, Jörgen Valk+, SLT'21, 2020.11
Paper/Blog Link My Issue
#Dataset #SpeechProcessing #AutomaticSpeechRecognition(ASR) Issue Date: 2025-11-21 GPT Summary- 本論文では、107言語のYouTube動画から自動収集した音声データを用いて音声言語認識を調査。半ランダムな検索フレーズを用いて音声セグメントを抽出し、ポストフィルタリングにより98%の正確なラベル付けを実現。得られたトレーニングセットは6628時間、評価セットは1609の発話から構成され、実験により自動取得データが手動ラベル付けデータと同等の結果を示すことが確認された。このデータセットは公開されている。 Comment
dataset: https://cs.taltech.ee/staff/tanel.alumae/data/voxlingua107/
Whisperでも活用されているLanguage Identifucation用のdataset
- [Paper Note] Robust Speech Recognition via Large-Scale Weak Supervision, Alec Radford+, ICML'23, 2022.12
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #LanguageModel #Transformer #NeurIPS #read-later #HyperparameterTransfer Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
[Paper Note] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows, Ze Liu+, ICCV'21
Paper/Blog Link My Issue
#ComputerVision #Transformer #Attention #Architecture #Selected Papers/Blogs #ICCV #Backbone Issue Date: 2025-07-19 GPT Summary- Swin Transformerは、コンピュータビジョンの新しいバックボーンとして機能する階層的トランスフォーマーを提案。シフトウィンドウ方式により、効率的な自己注意計算を実現し、さまざまなスケールでのモデリングが可能。画像分類や物体検出、セマンティックセグメンテーションなどで従来の最先端を上回る性能を示し、トランスフォーマーのビジョンバックボーンとしての可能性を示唆。コードは公開されている。 Comment
日本語解説: https://qiita.com/m_sugimura/items/139b182ee7c19c83e70a
画像処理において、物体の異なるスケールや、解像度に対処するために、PatchMergeと呼ばれるプーリングのような処理 (Figure1) と、固定サイズのローカルなwindowに分割してSelf-Attentionを実施し、layerごとに通常のwindowとシフトされたwindowを適用することで、window間を跨いだ関係性も考慮できるようにする機構(Figure2)を導入したモデル。
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #NLP #Transformer Issue Date: 2024-07-11 GPT Summary- トランスフォーマーモデルのフィードフォワード層は、キー・バリューメモリとして機能し、学習されたパターンが人間に解釈可能であることや、上位層がより意味のあるパターンを学習することが示されました。さらに、出力分布を誘導する役割も持ちます。フィードフォワード層の出力はそのメモリの合成であり、残差接続を介してモデルの層を通じて洗練され、最終的な出力分布を生成します。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
FF layerがKey-Valueストアとして機能する仕組みの概略図
実際に特定のKeyと最も関連度が高い訓練事例(input)を抽出し、人間がinputのパターンを分類した結果
[Paper Note] Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation, Markus Freitag+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#MachineTranslation #Analysis #NaturalLanguageGeneration #Metrics #NLP #Evaluation Issue Date: 2024-01-25 GPT Summary- 機械翻訳の人間評価は難しく、標準的な手法が不足している。そこで、誤り分析に基づく評価方法論を提案し、MQMフレームワークを用いてWMT 2020の上位システム出力をプロの翻訳者による注釈で評価。分析の結果、WMTクラウドワーカーのランキングと異なる結果が得られ、人間が機械出力よりも人間の出力を好む傾向を示した。さらに、自動指標がクラウドワーカーよりも優れたことも判明し、研究用コーパスを公開。 Comment
embedding basedなNLGの性能指標が、意味の等価性や流暢性を評価できる一方、適用範囲が限定的で柔軟性に欠けることを示した研究
QACE: Asking Questions to Evaluate an Image Caption, Lee+, EMNLP'21
Paper/Blog Link My Issue
#ComputerVision #NaturalLanguageGeneration #Metrics #NLP #Evaluation #Reference-free #QA-based Issue Date: 2023-08-13 Comment
Image Captioningを評価するためのQGQAを提案している。candidateから生成した質問を元画像, およびReferenceを用いて回答させ、candidateに基づいた回答と回答の結果を比較することで評価を実施する。
Transformer Reasoning Network for Personalized Review Summarization, Xu+, SIGIR'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #NLP #review #SIGIR Issue Date: 2023-05-06 Comment
先行研究は、review summarizationにおいて生成されるsummaryは、過去にユーザが作成したsummaryのwriting styleやproductに非常に関係しているのに、これらを活用してこなかったので、活用しました(=personalized)という話っぽい
Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
Paper/Blog Link My Issue
#ComputerVision #Embeddings #NLP #RepresentationLearning #MultiModal #ContrastiveLearning #ICML #Selected Papers/Blogs #2D (Image) #text Issue Date: 2023-04-27 Comment
CLIP論文。大量の画像と画像に対応するテキストのペアから、対照学習を行い、画像とテキスト間のsimilarityをはかれるようにしたモデル
Refocusing on Relevance: Personalization in NLG, Shiran Dudy+, Department of Computer Science University of Colorado, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Personalization #EMNLP Issue Date: 2023-04-26 Comment
従来のNLGはソーステキストに焦点を当て、ターゲットを生成することに注力してきた。が、ユーザの意図やcontextがソーステキストだけに基づいて復元できない場合、このアプローチでは不十分であることを指摘。
この研究ではNLGシステムが追加のcontextを利用することに大きな重点をおくべきであり、IR等で活用されているrelevancyをユーザ指向のテキスト生成タスクを設計するための重要な指標として考えることを提案している。
[Paper Note] Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets, Alethea Power+, ICLR'21 Workshop, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #Grokking #ICLR #Workshop Issue Date: 2023-04-25 GPT Summary- 小規模データセットにおけるニューラルネットワークの一般化を探求。データ効率、記憶、一般化、学習速度に関する問題を分析し、学習過程の「グロッキング」を通じて一般化性能の改善を示す。特に、小さなデータセットではより多くの最適化が必要であることが明らかにされ、過剰パラメータ化されたネットワークの一般化メカニズムを理解するための重要な知見を提供。 Comment
学習後すぐに学習データをmemorizeして、汎化能力が無くなったと思いきや、10^3ステップ後に突然汎化するという現象(Grokking)を報告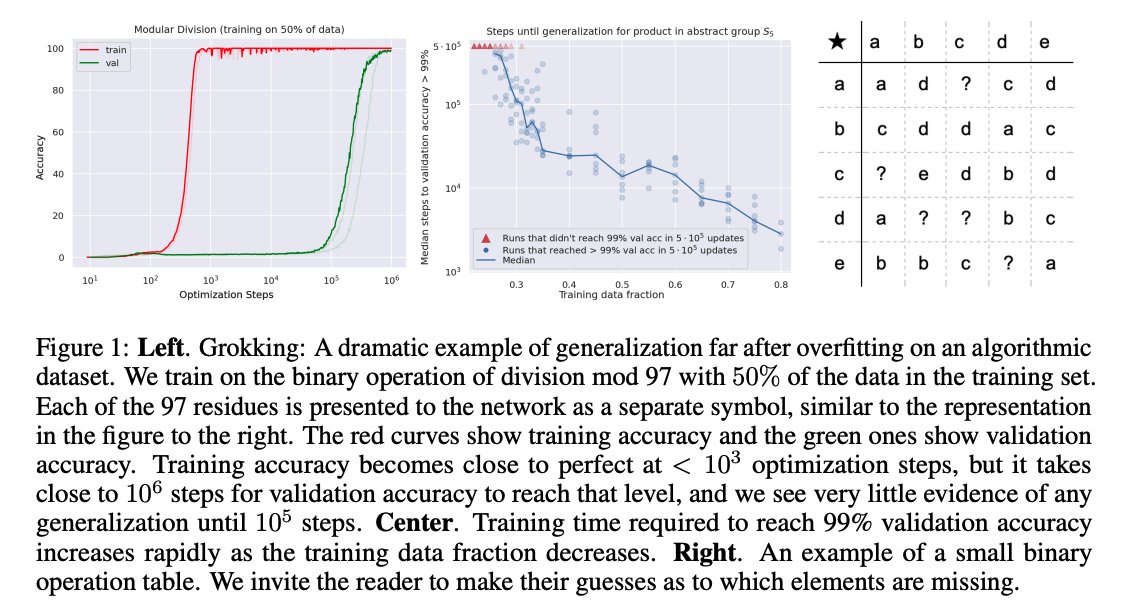
学習データが小さければ小さいほど汎化能力を獲得するのに時間がかかる模様
Challenges to Applying Performance Factor Analysis to Existing Learning Systems, Cristina+ (w_ Ryan Baker), ICCE'21
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #ICCE Issue Date: 2022-08-31 Comment
- いまだにほとんどの商用のAdaptive LearningシステムではBKTが使われている。その理由について概要が書いてある。
- BKTについて実アプ李ケーションに応用した際にどういう性質があるかを検証した文献へのリファレンスが存在する
[Paper Note] Biomedical Data-to-Text Generation via Fine-Tuning Transformers, Ruslan Yermakov+, ACL-INLG'21, 2021.09
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #Dataset #DataToTextGeneration #ACL #INLG Issue Date: 2022-08-18 GPT Summary- バイオメディカル分野におけるD2T生成の研究を行い、医薬品のパッケージリーフレットを用いた実世界のデータセットに対してファインチューニングされたトランスフォーマーを適用。現実的な複数文のテキスト生成が可能であることを示す一方で、重要な制限も存在。新たにバイオメディカル分野のD2T生成モデルのベンチマーク用データセット(BioLeaflets)を公開。 Comment
biomedical domainの新たなdata2textデータセットを提供。事前学習済みのBART, T5等をfinetuningすることで高精度にテキストが生成できることを示した。
Option Tracing: Beyond Correctness Analysis in Knowledge Tracing, Ghosh+, AIED'21
Paper/Blog Link My Issue
#AdaptiveLearning #EducationalDataMining #OptionTracing #AIED Issue Date: 2022-08-18 Comment
これまでのKTは問題の正誤(correctness)に対してfittingしていたが、この研究ではmultiple choice questionでどの選択肢を選択するかを予測するタスクを提案している。
BEKT: Deep Knowledge Tracing with Bidirectional Encoder Representations from Transformers, Tian+ (緒方先生), Kyoto University, ICCE'21
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #LearningAnalytics #KnowledgeTracing #ICCE Issue Date: 2022-04-28 Comment
KTにBERTを利用した研究
Empirical Evaluation of Deep Learning Models for Knowledge Tracing: Of Hyperparameters and Metrics on Performance and Replicability, Sami+, Aalto University, JEDM'22
などでDeepLearningBasedなモデル間であまり差がないことが示されているので、本研究が実際どれだけ強いのかは気になるところ。
Do we need to go Deep? Knowledge Tracing with Big Data, Varun+, University of Maryland Baltimore County, AAAI'21 Workshop on AI Education
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #LearningAnalytics #KnowledgeTracing #AAAI #Workshop Issue Date: 2022-04-28 GPT Summary- インタラクティブ教育システム(IES)を用いて学生の知識を追跡し、パフォーマンスモデルを開発する研究が進展。深層学習モデルが従来のモデルを上回るかは未検証であり、EdNetデータセットを用いてその精度を比較。結果、ロジスティック回帰モデルが深層モデルを上回ることが確認され、LIMEを用いて予測に対する特徴の影響を解釈する研究を行った。 Comment
データ量が小さいとSAKTはDKTはcomparableだが、データ量が大きくなるとSAKTがDKTを上回る。
An Empirical Comparison of Deep Learning Models for Knowledge Tracing on Large-Scale Dataset, Pandey+, AAAI workshop on AI in Education'21
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #LearningAnalytics Issue Date: 2022-04-28 Comment
EdNetデータにおいて、DKT, DKVMN, SAKT, RKTの性能を比較した論文
RKTがも最もパフォーマンスが良く、SAKTもDKT, DKVMNに勝っている
A Survey of Knowledge Tracing, Liu+, IEEE Transactions on Learning Technologies, arXiv'21
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #LearningAnalytics #KnowledgeTracing Issue Date: 2022-04-27 Comment
古典的なBKT, PFAだけでなくDKT, DKVMN, EKT, AKTなどDeepなモデルについてもまとまっている。

SAINT+: Integrating Temporal Features for EdNet Correctness Prediction, Shin+, RiiiD AI Research, LAK'21
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #StudentPerformancePrediction #Transformer #LAK #Selected Papers/Blogs Issue Date: 2021-10-28 Comment
Student Performance PredictionにTransformerを初めて利用した研究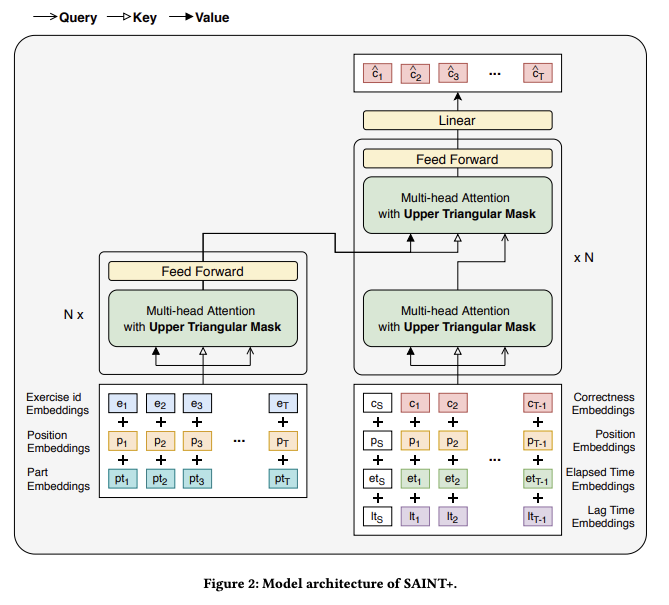
[Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #Sparse #SparseAttention Issue Date: 2025-08-09 GPT Summary- Longformerは、長いシーケンスを線形に処理できる注意機構を持つTransformerベースのモデルで、数千トークンの文書を扱える。局所的なウィンドウ注意とタスクに基づくグローバル注意を組み合わせ、文字レベルの言語モデリングで最先端の結果を達成。事前学習とファインチューニングを行い、長文タスクでRoBERTaを上回る性能を示した。また、Longformer-Encoder-Decoder(LED)を導入し、長文生成タスクにおける効果を確認した。 Comment
(固定された小さめのwindowsサイズの中でのみattentionを計算する)sliding window attentionを提案。Figure2を見ると、通常のAttentionと比較して、現在のトークンの周辺のトークンにしか注目しない特性が図示されており、イメージが掴みやすい。
OpenLLMの文脈だと、Mistralに採用されて話題になったかも?
- Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
[Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Transformer #Attention #ICML #Selected Papers/Blogs #reading #RecurrentModels #LinearAttention Issue Date: 2025-08-05 GPT Summary- 自己注意をカーネル特徴マップの線形ドット積として表現することで、Transformersの複雑性を$\mathcal{O}\left(N^2\right)$から$\mathcal{O}\left(N\right)$に削減。これにより、自己回帰型Transformersの速度が最大4000倍向上し、従来のパフォーマンスを維持。 Comment
関連:
- Transformers are Multi-State RNNs, Matanel Oren+, N/A, EMNLP'24
pj page: https://linear-transformers.com
Linear Attention(Linear Transformer)を提案した研究。Softmaxが利用されるFull Attentionのsimilarity部分をfeature map φを持つカーネルk(x, y)で一般化し、(3)--(6)の流れでfeature map φ同士は内積が使える性質と、行列積の結合法則を用いて式変換する。
式変換によって、従来のSoftmax Attentionでは、全てのトークンNに対してQ_i * K_j * V_jのメモリが必要だったものを(O(N^2))、各Queryごとに利用される、KVを用いた情報が共通化され(現在のqueryまでのφ(K)とφ(K)V^Tを逐次的に加算して保持するだけで良い)、再利用が可能となりメモリに関するオーダーがO(N)となる。
これらの話は実際にどのような カーネルを利用するかを無視した話だが、たとえばsoftmaxを表現するために必要な指数カーネルの場合はfeature mapが無限次元となるため有限次元のベクトルでは表現できず、厳密に線形化することができない。このため、有限次元かつ厳密なfeature mapを持つ多公式カーネルを用いて近似する。この場合、計算量のオーダーがO(ND^2M)となり(Nがsequence length, Dがqueryとkeyの次元数, Mがvalueの次元数)、softmax attentionの計算量がO(N^2 max(D,M))であることと比較すると、N > D^2である場合に計算効率が改善される。
学習時は並列に学習が可能で、推論時はφ(K_j)V_j^Tを内部状態とみなすと、各タイムステップでRNNのように状態を更新して保持するだけで良い。
(続きはさらに後で読む)
次: DeltaNet
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
次の次: Gated DeltaNet
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
次の次の次: Kimi Delta Attention (KDA)
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
[Paper Note] On Layer Normalization in the Transformer Architecture, Ruibin Xiong+, arXiv'20, 2020.02
Paper/Blog Link My Issue
#Analysis #NLP #Transformer #Architecture #Normalization Issue Date: 2025-07-05 GPT Summary- Transformerの学習で必要とされる学習率ウォームアップについて、Layer Normalizationの位置に着目して理論的に分析。 従来のPost-LN Transformerでは出力層付近の勾配が大きくなり学習が不安定になるため、ウォームアップが有効である。 一方、Pre-LN Transformerでは初期勾配が適切に保たれるため、ウォームアップなしでも同等の性能を達成し、学習時間とハイパーパラメータ調整を削減できる。 Comment
OpenReview: https://openreview.net/forum?id=B1x8anVFPr
Encoder-DecoderのTransformerにおいて、Post-LNの場合は、Warmupを無くすと最終的な性能が悪化し、またWarmUpステップの値によって(500 vs. 4000で実験)も最終的な性能が変化する。これには学習時にハイパーパラメータをしっかり探索しなければならず、WarmUPを大きくすると学習効率が落ちるというデメリットがある。
Post-LNの場合は、Pre-LNと比較して勾配が大きく、Warmupのスケジュールをしっかり設計しないと大きな勾配に対して大きな学習率が適用され学習が不安定になる。これは学習率を非常に小さくし、固定値を使うことで解決できるが、収束が非常に遅くなるというデメリットがある。
一方、Pre-LNはWarmup無しでも、高い性能が達成でき、上記のようなチューニングの手間や学習効率の観点から利点がある、みたいな話の模様。
[Paper Note] PEGASUS: Pre-training with Extracted Gap-sentences for Abstractive Summarization, Jingqing Zhang+, ICML'20
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NLP #ICML #Selected Papers/Blogs Issue Date: 2025-05-13 GPT Summary- 大規模なテキストコーパスに対して新しい自己教師ありの目的でトランスフォーマーを事前学習し、抽象的なテキスト要約に特化したモデルPEGASUSを提案。重要な文を削除またはマスクし、残りの文から要約を生成。12の下流要約タスクで最先端のROUGEスコアを達成し、限られたリソースでも優れたパフォーマンスを示す。人間評価でも複数のデータセットで人間のパフォーマンスに達したことを確認。 Comment
PEGASUSもなかったので追加。BARTと共に文書要約のBackboneとして今でも研究で利用される模様。
関連:
- SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
[Paper Note] Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, Colin Raffel+, JMLR'20
Paper/Blog Link My Issue
#NeuralNetwork #Pretraining #NLP #TransferLearning #PostTraining #Selected Papers/Blogs Issue Date: 2025-05-12 GPT Summary- 転移学習はNLPにおいて強力な技術であり、本論文ではテキストをテキストに変換する統一フレームワークを提案。事前学習の目的やアーキテクチャを比較し、最先端の結果を達成。データセットやモデル、コードを公開し、今後の研究を促進する。 Comment
T5もメモっていなかったので今更ながら追加。全てのNLPタスクをテキスト系列からテキスト系列へ変換するタスクとみなし、Encoder-DecoderのTransformerを大規模コーパスを用いて事前学習をし、downstreamタスクにfinetuningを通じて転移する。
個人的に、Transformer-decoderのスケーラビリティのみならず、T5全てのタスクをテキスト系列の変換とみなす考え方が、現在のLLMの基盤となっていると感じている。
[Paper Note] Editable Neural Networks, Anton Sinitsin+, ICLR'20
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #MachineLearning #NLP #ICLR #KnowledgeEditing #read-later Issue Date: 2025-05-07 GPT Summary- 深層ニューラルネットワークの誤りを迅速に修正するために、Editable Trainingというモデル非依存の訓練手法を提案。これにより、特定のサンプルの誤りを効率的に修正し、他のサンプルへの影響を避けることができる。大規模な画像分類と機械翻訳タスクでその有効性を実証。 Comment
(おそらく)Knowledge Editingを初めて提案した研究
OpenReview: https://openreview.net/forum?id=HJedXaEtvS
[Paper Note] SimulMT to SimulST: Adapting Simultaneous Text Translation to End-to-End Simultaneous Speech Translation, Xutai Ma+, AACL'20
Paper/Blog Link My Issue
#Metrics #NLP #Evaluation #SpeechProcessing #AutomaticSpeechRecognition(ASR) #AACL #SimulST(SimultaneousSpeechTranslation) Issue Date: 2025-04-30 GPT Summary- 同時テキスト翻訳手法をエンドツーエンドの同時音声翻訳に適応させる研究を行い、事前決定モジュールを導入。レイテンシと品質のトレードオフを分析し、新しいレイテンシメトリックを設計。 Comment
同時翻訳研究で主要なmetricの一つ
関連:
- [Paper Note] Over-Generation Cannot Be Rewarded: Length-Adaptive Average Lagging for Simultaneous Speech Translation, Sara Papi+, NAACL'22
COMET: A Neural Framework for MT Evaluation, Ricardo Rei+, N_A, EMNLP'20
Paper/Blog Link My Issue
#MachineTranslation #Metrics #NLP #Evaluation #EMNLP #Selected Papers/Blogs Issue Date: 2024-05-26 GPT Summary- COMETは、多言語機械翻訳評価モデルを訓練するためのニューラルフレームワークであり、人間の判断との新しい最先端の相関レベルを達成します。クロスリンガル事前学習言語モデリングの進展を活用し、高度に多言語対応かつ適応可能なMT評価モデルを実現します。WMT 2019 Metrics shared taskで新たな最先端のパフォーマンスを達成し、高性能システムに対する堅牢性を示しています。 Comment
Better/Worseなhypothesisを利用してpair-wiseにランキング関数を学習する


Inference時は単一のhypothesisしかinputされないので、sourceとreferenceに対してそれぞれhypothesisの距離をはかり、その調和平均でスコアリングする

ACL2024, EMNLP2024あたりのMT研究のmetricをざーっと見る限り、BLEU/COMETの双方で評価する研究が多そう
[Paper Note] BLEU might be Guilty but References are not Innocent, Markus Freitag+, arXiv'20, 2020.04
Paper/Blog Link My Issue
#MachineTranslation #Analysis #NaturalLanguageGeneration #Metrics #NLP #Evaluation Issue Date: 2024-01-25 GPT Summary- 機械翻訳の自動評価指標の質を検証し、参照データの性質が重要であることを示す。さまざまな参照収集方法を検討し、人間評価との相関を報告。典型的な参照の偏りを打ち消すために、言語学者によるパラフレージング課題を開発。WMT 2019のデータにおいて、標準参照との相関が低い出力でも人間判断との相関が向上することを示す。また、埋め込みベースの手法を含む評価指標で相関が改善されることも明らかにし、マルチ参照BLEUの限界と新たな定式化を提示。 Comment
surface levelのNLGの性能指標がsemanticを評価できないことを示した研究
Asking and Answering Questions to Evaluate the Factual Consistency of Summaries, Wang, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #NLP #Evaluation #Reference-free #QA-based Issue Date: 2023-08-20 Comment
QAGS
生成された要約からQuestionを生成する手法。precision-oriented
Reducing Quantity Hallucinations in Abstractive Summarization, Zheng Zhao+, N_A, EMNLP'20
Paper/Blog Link My Issue
#DocumentSummarization #NLP #Hallucination #EMNLP #numeric #needs-revision Issue Date: 2023-08-16 GPT Summary- Hermanシステムは、抽象的な要約において幻覚を回避するために、数量エンティティを認識し、元のテキストでサポートされている数量用語を持つ要約を上位にランク付けするアプローチを提案しています。実験結果は、このアプローチが高い適合率と再現率を持ち、F$_1$スコアが向上することを示しています。また、上位にランク付けされた要約が元の要約よりも好まれることも示されています。 Comment
数量に関するhallucinationを緩和する要約手法
FEQA: A Question Answering Evaluation Framework for Faithfulness Assessment in Abstractive Summarization, Durmus+, ACL'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #NLP #Evaluation #QA-based Issue Date: 2023-08-16 Comment
FEQA
生成された要約からQuestionを生成する手法。precision-oriented
Evaluating the Factual Consistency of Abstractive Text Summarization, Kryscinski+, EMNLP'20
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #NLP #Evaluation #LM-based #Factuality #EMNLP Issue Date: 2023-08-13 Comment
FactCC
近年のニューラルモデルは流ちょうな要約を生成するが、それらには、unsuportedなinformationが多く含まれていることを示した
[Paper Note] Measuring Massive Multitask Language Understanding, Dan Hendrycks+, arXiv'20, 2020.09
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #ICLR #Selected Papers/Blogs #needs-revision Issue Date: 2023-07-24 GPT Summary- 新しいテストを提案し、57のマルチタスクを用いてテキストモデルの正確度を測定。高い正確度には広範な世界知識と問題解決能力が必要である。GPT-3モデルはランダム推測を約20ポイント上回るが、専門家レベルには遠く、多くのタスクで偏った性能を示す。特に道徳や法に関してはほぼランダムに近い正確度を記録。このテストはモデルの理解力を評価し、重要な欠点を明らかにすることを目的とする。 Comment
OpenReview: https://openreview.net/forum?id=d7KBjmI3GmQ
MMLU論文
- [Paper Note] Are We Done with MMLU?, Aryo Pradipta Gema+, NAACL'25
において、多くのエラーが含まれることが指摘され、再アノテーションが実施されている。
Returning the N to NLP: Towards Contextually Personalized Classification Models, Lucie Flek, Mainz University of Applied Sciences Germany, ACL'20
Paper/Blog Link My Issue
#Survey #NLP #Personalization #ACL Issue Date: 2023-04-26 Comment
NLPのけるPersonalized Classificationモデルのliteratureを振り返る論文
Deep Knowledge Tracing with Transformers, Shi+ (w_ Michael Yudelson), ETS_ACT, AIED'20
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #Transformer #AIED Issue Date: 2022-08-17 Comment
TransformerでKTした研究。あまり引用されていない。SAINT, SAINT+と同時期に発表されている。
[Paper Note] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism, Mohammad Shoeybi+, arXiv'19, 2019.09
Paper/Blog Link My Issue
#Pretraining #Tools #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #PostTraining #Selected Papers/Blogs #Parallelism #DistributedLearning #TrainingFramework Issue Date: 2026-09-29 GPT Summary- 大規模Transformerモデルを学習するため、ネイティブPyTorchに少数の通信操作を追加する層内モデル並列化手法を提案。パイプライン型並列化と併用可能で、512 GPU上で最大83億パラメータのモデルを学習し、15.1ペタFLOPSと76%のスケーリング効率を達成。GPT-2型・BERT型モデルで既存のSOTAを上回り、WikiText103、LAMBADA、RACEで高い性能を実現。 Comment
Megatron-LMがメモされていなかったので追加。代表的なLLM・マルチモーダルモデル学習のためのフレームワーク
事前学習、継続事前学習だけでなく
- Swallow: LLaMA-2 日本語継続事前学習モデル, Kazuki Fujii, 2023.12
以下のような事後学習フレームワークのバックエンドとしても利用される:
- Nemo-RL, Nvidia, 2025.05
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- slime, THUDM & Zhihu, 2025.09
- ms-swiftによるMegatron-LMベースのQwen3のファインチューニング, Aratako, 2025.05
[Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#ComputerVision #Transformer #LongContext #Selected Papers/Blogs #SparseAttention Issue Date: 2025-11-30 GPT Summary- スパース因子分解を用いてトランスフォーマーの注意行列を$O(n \sqrt{n})$に削減し、深いネットワークの訓練やメモリ節約のための手法を導入。スパーストランスフォーマーは数百層で数万タイムステップのシーケンスをモデル化し、Enwik8、CIFAR-10、ImageNet-64で新たな最先端を達成。自己注意を用いて100万以上の長さのシーケンスをモデル化する可能性を示す。 Comment
Sparse Attentionの概念を提案した研究。以下Surveyより
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
[Paper Note] Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, Zihang Dai+, ACL'19
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #LongContext #PositionalEncoding #ACL Issue Date: 2025-08-05 GPT Summary- Transformer-XLは、固定長のコンテキストを超えた長期的な依存関係を学習する新しいニューラルアーキテクチャで、セグメントレベルの再帰メカニズムと新しい位置エンコーディングを採用。これにより、RNNより80%、従来のTransformersより450%長い依存関係を学習し、評価時には最大1,800倍の速度向上を実現。enwiki8やWikiText-103などで最先端のパフォーマンスを達成し、数千トークンの一貫したテキスト生成も可能。コードとモデルはTensorflowとPyTorchで利用可能。 Comment
日本語解説:
- 事前学習言語モデルの動向 / Survey of Pretrained Language Models, Kyosuke Nishida, 2019
3.2節の定式化を見ると、一つ前のセグメントのトークン・layerごとのhidden stateを、現在のセグメントの対応するトークンとlayerのhidden stateにconcatし(過去のセグメントに影響を与えないように勾配を伝搬させないStop-Gradientを適用する)、QKVのうち、KVの計算に活用している。また、絶対位置エンコーディングを利用するとモデルがセグメント間の時系列的な関係を認識できなくなるため、位置エンコーディングには相対位置エンコーディングを利用する。これにより、現在のセグメントのKVが一つ前のセグメントによって条件づけられ、contextとして考慮することが可能となり、セグメント間を跨いだ依存関係の考慮が実現される。
[Paper Note] What Does BERT Learn about the Structure of Language?, Jawahar+, ACL'19
Paper/Blog Link My Issue
#Analysis #NLP #Transformer #ACL Issue Date: 2024-10-07 Comment
- 大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
中で引用されている。Transformerの各ブロックが、何を学習しているかを分析。
Studying Summarization Evaluation Metrics in the Appropriate Scoring Range, Peyrard+, ACL'19
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #NLP #Evaluation Issue Date: 2023-08-16 Comment
要約のメトリックがhuman judgmentsに対してcorrelationが低いことを指摘
[Paper Note] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, Nils Reimers+, arXiv'19, 2019.08
Paper/Blog Link My Issue
#NeuralNetwork #NLP #Library #RepresentationLearning #EMNLP #Selected Papers/Blogs #Encoder Issue Date: 2022-07-29 GPT Summary- BERTとRoBERTaは文ペア回帰タスクで優れた性能を示す一方で、計算負荷が高いため意味的類似度検索には適していない。本研究では、コサイン類似度を用いた文の埋め込みを得るために、シアミーズネットワークとトリプレットネットワークを用いたSentence-BERT(SBERT)を提案。これにより、類似ペアの検索時間が65時間から約5秒に短縮され、精度はBERTに匹敵。SBERTは一般的なSTSタスクや転移学習タスクで最先端の性能を示した。 Comment
BERTでトークンをembeddingし、mean poolingすることで生成される文ベクトルを、Siamese Networkを使い距離学習(finetune)させたモデル。
文/文章のベクトルを事前学習済みのモデルを使って簡単に求められる。
モデルの一覧は下記:
https://www.sbert.net/docs/pretrained_models.html
GRAPH-BASED KNOWLEDGE TRACING: MODELING STUDENT PROFICIENCY USING GRAPH NEURAL NETWORK, Nakagawa+, Tokyo University, WI'19
Paper/Blog Link My Issue
#NeuralNetwork #GraphConvolutionalNetwork #Education #EducationalDataMining #KnowledgeTracing #WI Issue Date: 2021-07-08 Comment
graph neural networkでKnoelwdge Tracingした論文。各conceptのproficiencyの可視化までしっかりやってそう。
[Paper Note] Deep Learning Recommendation Model for Personalization and Recommendation Systems, Maxim Naumov+, arXiv'19, 2019.05
Paper/Blog Link My Issue
#RecommenderSystems #CollaborativeFiltering #FactorizationMachines Issue Date: 2021-07-02 GPT Summary- 深層学習に基づく推薦モデル(DLRM)を開発し、PyTorchとCaffe2で実装。埋め込みテーブルのモデル並列性を活用し、メモリ制約を軽減しつつ計算をスケールアウト。DLRMの性能を既存モデルと比較し、Big Basin AIプラットフォームでの有用性を示す。 Comment
Facebookが開発したopen sourceのDeepな推薦モデル(MIT Licence)。
モデル自体はシンプルで、continuousなfeatureをMLPで線形変換、categoricalなfeatureはembeddingをlook upし、それぞれfeatureのrepresentationを獲得。
その上で、それらをFactorization Machines layer(second-order)にぶちこむ。すなわち、Feature間の2次の交互作用をembedding間のdot productで獲得し、これを1次項のrepresentationとconcatしMLPにぶちこむ。最後にシグモイド噛ませてCTRの予測値とする。
実装: https://github.com/facebookresearch/dlrm
Parallelism以後のセクションはあとで読む
Data-to-Text Generation with Content Selection and Planning, Puduppully+, AAAI'19
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #AAAI Issue Date: 2021-06-26 Comment
Rotowire Datasetに対するData2Text研究において代表的な論文の一つ。Wisemanモデル [Paper Note] Challenges in Data-to-Document Generation, Sam Wiseman+, EMNLP'17, 2017.07 と共にベースラインとして利用されることが多い。
On Empirical Comparisons of Optimizers for Deep Learning, Dami Choi+, N_A, arXiv'19
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NLP Issue Date: 2021-06-15 GPT Summary- 深層学習のオプティマイザの比較は重要であり、ハイパーパラメータの探索空間が性能に影響することが示唆されている。特に、適応的勾配法は常に他のオプティマイザよりも性能が低下しないことが実験で示されており、ハイパーパラメータのチューニングに関する実用的なヒントも提供されている。 Comment
Adamが良いのだけど、学習率以外のハイパーパラメータをチューニングしないと本来のパフォーマンス発揮されないかもよ、という感じっぽい
ICLR 2020 Open Review: https://openreview.net/forum?id=HygrAR4tPS
[Paper Note] BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer, Fei Sun+, arXiv'19, 2019.04
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #LanguageModel #CIKM #SequentialRecommendation #Initial Impression Notes Issue Date: 2021-05-25 GPT Summary- ユーザーの動的嗜好をモデル化するために、BERT4RecというTransformerに基づく双方向エンコーダを導入。従来の順序型モデルの限界を克服し、Clozeタスクを用いて左側と右側の文脈を共同で条件付けしてアイテムを予測。さまざまなベンチマークデータセットにおいて、提案モデルが最先端の逐次モデルを一貫して上回る結果を示す。 Comment
BERTをrecsysのsequential recommendationタスクに転用してSoTA。
しっかり読んで無いけどモデル構造はほぼBERTと一緒。
異なる点は、Training時にNext Sentence Predictionは行わずClozeのみ行なっているという点。Clozeとは、実質Masked Language Modelであり、sequenceの一部を[mask]に置き換え、置き換えられたアイテムを左右のコンテキストから予測するタスク。異なる点としては、sequential recommendationタスクでは、次のアイテムを予測したいので、マスクするアイテムの中に、sequenceの最後のアイテムをマスクして予測する事例も混ぜた点。
もう一個異なる点として、BERT4Recはend-to-endなモデルで、BERTはpretraining modelだ、みたいなこと言ってるけど、まあ確かに形式的にはそういう違いはあるけど、なんかその違いを主張するのは違和感を覚える…。
sequential recommendationで使うuser behaviorデータでNext item predictionで学習したいことが、MLMと単に一致していただけ、なのでは…。
BERT4Recのモデル構造。next item predictionしたいsessionの末尾に [mask] をconcatし、[MASK]部分のアイテムを予測する構造っぽい?
オリジナルはtensorflow実装
pytorchの実装はこちら:
https://github.com/jaywonchung/BERT4Rec-VAE-Pytorch/tree/master/models
[Paper Note] Multimodal Review Generation for Recommender Systems, Truong+, WWW'19
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #NaturalLanguageGeneration #NLP #ReviewGeneration #WWW Issue Date: 2019-05-31 Comment
Personalized Review Generationと、Rating Predictionを同時学習した研究(同時学習自体はすでに先行研究がある)。
また、先行研究のinputは、たいていはuser, itemであるが、multi-modalなinputとしてレビューのphotoを活用したという話。
まだあまりしっかり読んでいないが、モデルのstructureはシンプルで、rating predictionを行うDNN、テキスト生成を行うLSTM(fusion gateと呼ばれる新たなゲートを追加)、画像の畳み込むCNNのハイブリッドのように見える。
[Paper Note] Unsupervised Representation Learning by Predicting Image Rotations, Spyros Gidaris+, arXiv'18, 2018.03
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #DataAugmentation #Self-SupervisedLearning #ConvolutionalModels Issue Date: 2026-08-30 GPT Summary- ConvNetsを用いて2D回転を認識することで、非監視での意味的特徴学習を提案。これにより、手動ラベルが不要な強力な監督信号を提供し、さまざまなベンチマークで最先端の性能を達成。特に、PASCAL VOC 2007検出タスクでは54.4%のmAPを記録し、教師あり学習との差を縮小。特徴を他のタスクに転移させても顕著な成果を示す。コードとモデルは公開中。 Comment
元ポスト:
画像Xが与えられた時に、geometric transformation(e.g., 90/180/270度回転等)を適用した画像をX^yとする。X^yが与えられた時に、どのようなgeometric transformation y^* が適用されたかを予測するConvNet F(X^y* | theta) を学習するシンプルなSSL手法。
objectに対するコンセプトが学習されていなければ、rotationが適用された画像の認識ができないであろう、という直感に基づいたSSL手法のようである(Figure 1)。
元ポストによるとこれは最近の様々なaugmentationされたデータに対して共通の表現を得る自己教師あり学習(下記)とは逆に、augmentationされた画像に依存した表現を学習することを目指いる点で異なっているとのことである。
- MoCo
- [Paper Note] Momentum Contrast for Unsupervised Visual Representation Learning, Kaiming He+, CVPR'20, 2019.11
- DINO
- [Paper Note] Emerging Properties in Self-Supervised Vision Transformers, Mathilde Caron+, ICCV'21, 2021.04
- SimCLR
- [Paper Note] A Simple Framework for Contrastive Learning of Visual Representations, Ting Chen+, ICML'20
[Paper Note] Deep Reinforcement Learning that Matters, Peter Henderson+, AAAI'18, 2017.09
Paper/Blog Link My Issue
#NeuralNetwork #Analysis #MachineLearning #ReinforcementLearning #AAAI #Selected Papers/Blogs #Reproducibility Issue Date: 2025-10-22 GPT Summary- 深層強化学習(RL)の進展を持続させるためには、既存研究の再現性と新手法の改善を正確に評価することが重要である。しかし、非決定性や手法のばらつきにより、結果の解釈が難しくなることがある。本論文では、再現性や実験報告の課題を調査し、一般的なベースラインとの比較における指標のばらつきを示す。さらに、深層RLの結果を再現可能にするためのガイドラインを提案し、無駄な努力を最小限に抑えることで分野の進展を促進することを目指す。 Comment
日本語解説: https://www.slideshare.net/slideshow/dldeep-reinforcement-learning-that-matters-83905622/83905622
再現性という観点とは少し異なるのかもしれないが、最近のRLによるpost-trainingについては、以下の研究でScaling Lawsが導入されている。
- [Paper Note] The Art of Scaling Reinforcement Learning Compute for LLMs, Devvrit Khatri+, arXiv'25, 2025.10
が、結局現在も多くのRL手法が日夜出てきており、再現性に関しては同じような状況に陥っていそうである。
[Paper Note] Group Normalization, Yuxin Wu+, arXiv'18, 2018.03
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #MachineLearning #Normalization Issue Date: 2025-04-02 GPT Summary- バッチ正規化(BN)はディープラーニングの重要な技術だが、小さなバッチサイズでの精度低下が課題。本研究では、グループ正規化(GN)を提案し、チャネルをグループに分けて正規化を行うことで、バッチサイズに依存しない安定した性能を実現。ImageNetでの実験では、GNが小バッチでも優れた精度を示し、他のタスクでもBNよりも性能を向上させることを確認。GNは実装も簡単で、さまざまなコンピュータビジョンタスクにおいてBNの有効な代替手段である。 Comment
BatchNormalizationはバッチサイズが小さいとうまくいかず、メモリの制約で大きなバッチサイズが設定できない場合に困るからバッチサイズに依存しないnormalizationを考えたよ。LayerNormとInstanceNormもバッチサイズに依存しないけど提案手法の方が画像系のタスクだと性能が良いよ、という話らしい。
各normalizationとの比較。分かりやすい。
[Paper Note] An Empirical Model of Large-Batch Training, Sam McCandlish+, arXiv'18, 2018.12
Paper/Blog Link My Issue
#NeuralNetwork #EfficiencyImprovement #MachineLearning #read-later #Selected Papers/Blogs #Batch #CriticalBatchSize Issue Date: 2024-12-16 GPT Summary- 勾配ノイズスケールを用いて、異なる分野での最適なバッチサイズを予測する方法を提示。教師あり学習や強化学習など複数の領域での実験を通じて、この統計量がロスの低下に伴い増加し、モデルサイズが性能に与える影響を分析。計算効率と時間効率のトレードオフを説明し、適応的なバッチサイズ訓練の利点を示す。 Comment
Critical Batchsize(バッチサイズをこれより大きくすると学習効率が落ちる境界)を提唱した論文
Modeling Hint-Taking Behavior and Knowledge State of Students with Multi-Task Learning, Chaudry+, Indian Institute of Technology, EDM'18
Paper/Blog Link My Issue
#NeuralNetwork #EducationalDataMining #StudentPerformancePrediction #EDM Issue Date: 2021-11-12 Comment
DKVMN ([Paper Note] Dynamic Key-Value Memory Networks for Knowledge Tracing, Jiani Zhang+, WWW'17, 2016.11
)をhint-takingタスクとmulti-task learningした研究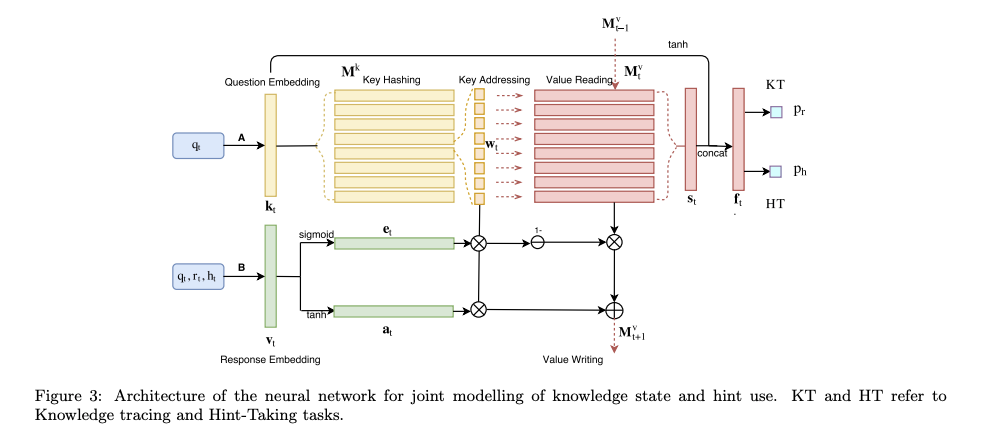
DKVMNと比較して、微小ながら性能向上
[Paper Note] xDeepFM: Combining Explicit and Implicit Feature Interactions for Recommender Systems, Jianxun Lian+, arXiv'18, 2018.03
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CollaborativeFiltering #FactorizationMachines #CTRPrediction #SIGKDD #Reading Reflections Issue Date: 2021-05-25 GPT Summary- 特徴量の自動生成が求められる中、因子分解モデルは相互作用を学習し一般化するが、DNNは暗黙的である。本研究では、明示的に相互作用を生成する圧縮相互作用ネットワーク(CIN)を提案し、DNNと統合したeXtreme Deep Factorization Machine(xDeepFM)を開発。xDeepFMは低次・高次の相互作用を学習し、実データセットで最先端モデルを超える性能を示した。 Comment
DeepFM: A Factorization-Machine based Neural Network for CTR Prediction, Guo+, IJCAI’17 DeepFMの発展版
[Paper Note] Factorization Machines, Steffen Rendle, ICDM'10, 2010.12
にも書いたが、下記リンクに概要が記載されている。
DeepFMに関する動向:
https://data.gunosy.io/entry/deep-factorization-machines-2018
DeepFMの発展についても詳細に述べられていて、とても参考になる。
[Paper Note] Field-weighted Factorization Machines for Click-Through Rate Prediction in Display Advertising, Junwei Pan+, arXiv'18, 2018.06
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CollaborativeFiltering #FactorizationMachines #CTRPrediction #WWW Issue Date: 2020-08-29 GPT Summary- クリック率(CTR)予測はオンライン広告での重要なタスクであり、マルチフィールドのカテゴリカルデータが使用される。フィールド認識型因子分解機(FFMs)は異なるフィールド間の特徴相互作用を効果的にモデル化するが、パラメータ数が膨大で実用的ではない。提案するField-weighted Factorization Machines(FwFMs)は、メモリ効率よく相互作用をモデル化し、わずか4%のパラメータで競争力のある性能を発揮。実験では、FwFMsがFFMsよりも0.92%および0.47%のAUC改善を達成した。 Comment
CTR予測でbest-performingなモデルと言われているField Aware Factorization Machines(FFM)では、パラメータ数がフィールド数×特徴数のorderになってしまうため非常に多くなってしまうが、これをよりメモリを効果的に利用できる手法を提案。FFMとは性能がcomparableであるが、パラメータ数をFFMの4%に抑えることができた。
[Paper Note] LensKit for Python: Next-Generation Software for Recommender System Experiments, Michael D. Ekstrand, arXiv'18, 2018.09
Paper/Blog Link My Issue
#RecommenderSystems #Tools #Library Issue Date: 2018-01-01 GPT Summary- LensKitはレコメンダーシステムのためのオープンソースツールキットで、次世代版としてPython用のLensKit(LKPY)を紹介。LKPYは、研究者や学生が再現可能な実験を構築できるようにし、scikit-learnやTensorFlow、PyTorchなどのエコシステムを活用。古典的な協調フィルタリングの実装や評価指標、データ準備ルーチンを提供し、他のPythonソフトウェアと組み合わせて使用可能。設計目標やユースケースについて、元のJava版の成功と失敗を振り返りながら説明。 Comment
実装されているアルゴリズム:協調フィルタリング、Matrix Factorizationなど
実装:Java
使用方法:コマンドライン、Javaライブラリとして利用
※ 推薦システム界隈で有名な、GroupLens研究グループによるJava実装
参考:
http://www.kamishima.net/archive/recsysdoc.pdf
https://takuti.me/note/recommender-libraries/
[Paper Note] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, Noam Shazeer+, ICLR'17
Paper/Blog Link My Issue
#NeuralNetwork #NLP #MoE(Mixture-of-Experts) #ICLR #Selected Papers/Blogs Issue Date: 2025-04-29 GPT Summary- 条件付き計算を用いたスパースゲーテッドミクスチャーオブエキスパート(MoE)レイヤーを導入し、モデル容量を1000倍以上向上。学習可能なゲーティングネットワークが各例に対してスパースなエキスパートの組み合わせを決定。最大1370億パラメータのMoEをLSTM層に適用し、言語モデリングや機械翻訳で低コストで優れた性能を達成。 Comment
Mixture-of-Experts (MoE) Layerを提案した研究
Overcoming catastrophic forgetting in neural networks, James Kirkpatrick+, N_A, PNAS'17
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #Catastrophic Forgetting #Selected Papers/Blogs Issue Date: 2024-10-10 GPT Summary- タスクを逐次的に学習する能力を持つネットワークを訓練する方法を提案。重要な重みの学習を選択的に遅くすることで、古いタスクの記憶を維持。MNISTやAtari 2600ゲームでの実験により、アプローチの効果とスケーラビリティを実証。 Comment
Catastrophic Forgettingを防ぐEWCを提案した論文
日本語解説: https://qiita.com/yu4u/items/90c039ec2f1d4f2d2414
ポイント解説:
[Paper Note] Large Batch Training of Convolutional Networks, Yang You+, arXiv'17, 2017.08
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #Optimizer Issue Date: 2023-12-13 GPT Summary- 大規模畳み込みネットワークのトレーニングでは、計算ユニットを追加することで高速化を図るが、大きなバッチサイズはモデルの精度を低下させることがある。従来の線形学習率スケーリングは一般的ではなく、トレーニングの発散リスクがある。これを解決するために、Layer-wise Adaptive Rate Scaling(LARS)に基づく新しいアルゴリズムを提案し、AlexNetはバッチサイズ8K、ResNet-50は32Kまでの拡張でも精度を維持できることを示した。 Comment
BatchSizeを大きくすると性能が落ちますよ、系の話(CNN)
OpenReview:
https://openreview.net/forum?id=rJ4uaX2aW
ICLR'18にrejectされている
先行研究で提案よりも大きなバッチサイズを扱えるsynchronized SGDは強みだが、評価が一つのタスクのみなのでより増やした方がconvincingだということ、提案手法に追加のハイパーパラメータが必要な点が手法をless appealingにしてしまっていること、layer wise rate scailng (LARS)の理論的なjustificationが何か欲しいこと、先行研究との比較がクリアではないこと、などが理由な模様。
Why We Need New Evaluation Metrics for NLG, EMNLP'17
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Metrics #NLP #Evaluation #needs-revision Issue Date: 2023-08-16 Comment
既存のNLGのメトリックがhuman judgementsとのcorrelationがあまり高くないことを指摘した研究
[Paper Note] Construction of a Japanese Word Similarity Dataset, Yuya Sakaizawa+, arXiv'17, 2017.03
Paper/Blog Link My Issue
#Embeddings #NLP #Dataset #RepresentationLearning #STS (SemanticTextualSimilarity) #Japanese Issue Date: 2023-07-31 GPT Summary- 日本語の分散表現評価のために、語の類似度データセットを構築。これが日本語分散表現評価の初の資源であり、一般語と稀少語の両方を含む様々な品詞を網羅。 Comment
github:
https://github.com/tmu-nlp/JapaneseWordSimilarityDataset
単語レベルの類似度をベンチマーキングしたい場合は使ってもよいかも。
Learning to Represent Student Knowledge on Programming Exercises Using Deep Learning, Wang+, Stanford University, EDM'17
Paper/Blog Link My Issue
#EducationalDataMining #KnowledgeTracing #EDM Issue Date: 2021-07-04 Comment
DKT [Paper Note] Deep Knowledge Tracing, Piech+, NIPS'15
のPiech氏も共著に入っている。
プログラミングの課題を行なっている時(要複数回のソースコードサブミット)、
1. 次のexerciseが最終的に正解で終われるか否か
2. 現在のexerciseを最終的に正解で終われるか否か
を予測するタスクを実施
[Paper Note] Attend to You: Personalized Image Captioning with Context Sequence Memory Networks, Park+, CVPR'17
Paper/Blog Link My Issue
#ComputerVision #NLP #CommentGeneration #CVPR Issue Date: 2019-09-27 Comment
画像が与えられたときに、その画像に対するHashtag predictionと、personalizedなpost generationを行うタスクを提案。
InstagramのPostの簡易化などに応用できる。
Postを生成するためには、自身の言葉で、画像についての説明や、contextといったことを説明しなければならず、image captioningをする際にPersonalization Issueが生じることを指摘。
official implementation: https://github.com/cesc-park/attend2u
[Paper Note] Towards automatic generation of product reviews from aspectsentiment scores, Zang+, INLG'17
Paper/Blog Link My Issue
#NeuralNetwork #NLP #ReviewGeneration #INLG Issue Date: 2019-04-12 Comment
hierarchicalなNNで、long reviewの生成に取り組んだ論文
[Paper Note] Learning to Paraphrase for Question Answering, Li Dong+, EMNLP'17
Paper/Blog Link My Issue
#NeuralNetwork #NLP #QuestionAnswering #EMNLP #Encoder-Decoder #RecurrentModels Issue Date: 2018-06-29 GPT Summary- QAシステムにおけるパラフレーズの重要性に着目し、質問と回答のペアを用いたエンドツーエンドの学習フレームワークを提案。ニューラルスコアリングモデルを通じて、正しい回答を得る可能性の高い表現に重みを付ける。実験結果は、提案手法が性能を向上させ、シンプルなQAモデルでも競争力のある結果を達成することを示す。 Comment
question-answeringタスクにおいて、paraphrasingを活用して精度向上させる研究
似たような意味の質問が、異なる表現で出現することがあるので、
questionの様々なparaphrasingを用意して活用したいという気持ち。
たとえば、
- Is the campus far from Shibuya?
- Is the campus near the city center?
のような例があげられる。
手法としては、paraphrasing modelとqa modelを用意し、あるquestionが与えられたときに、paraphrasing modelでparaphraseのスコアを算出、その後、各paraphrasingの候補に対してqa modelで解答を予測し、両者のスコアの積のsummationによって最終的なanswerを決定
QAはデータセットのサイズが小さいので、paraphrasingのような手法が有効に働いているのかもしれない
Deep Learning: Practice and Trends, NIPS'17 Tutorial, 2017.12
Paper/Blog Link My Issue
#NeuralNetwork #Tutorial #Slide #NeurIPS Issue Date: 2018-02-06 Comment
基礎から最新まで幅広いトピックがまとまったtutorial
[Paper Note] Multi-Task Video Captioning with Video and Entailment Generation, Ramakanth Pasunuru+, ACL'17, 2017.04
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NaturalLanguageGeneration #NLP #MultitaskLearning #ACL #Encoder-Decoder #3D (Video) #VideoCaptioning Issue Date: 2017-12-31 GPT Summary- ビデオキャプショニングの改善のため、教師なしビデオ予測タスクと論理的言語含意生成タスクを共有し、リッチなビデオエンコーダ表現を学習。パラメータを共有するマルチタスク学習モデルを提案し、標準データセットで大幅な改善を達成。 Comment
multitask learningで動画(かなり短め)のキャプション生成を行なった話
[Paper Note] Skip-Gram – Zipf + Uniform = Vector Additivity, Gittens+, ACL'17
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #Analysis #NLP #Word #ACL Issue Date: 2017-12-30 Comment
解説スライド: http://www.lr.pi.titech.ac.jp/~haseshun/acl2017suzukake/slides/09.pdf
Embeddingの加法構成性(e.g. man+royal=king)を理論的に理由づけ
(解説スライドより)
[Paper Note] A Structured Self-attentive Sentence Embedding, Zhouhan Lin+, ICLR'17, 2017.03
Paper/Blog Link My Issue
#NeuralNetwork #Sentence #Embeddings #NLP #RepresentationLearning #ICLR #Selected Papers/Blogs Issue Date: 2017-12-28 GPT Summary- 自己注意機構を用いた新しい文埋め込みモデルを提案。2次元行列で文の異なる部分に注意を払い、視覚化手法も提供。著者プロファイリング、感情分類、テキスト含意の3つのタスクで評価し、他の手法と比較して性能が向上したことを示す。 Comment
OpenReview: https://openreview.net/forum?id=BJC_jUqxe
日本語解説: https://ryotaro.dev/posts/a_structured_self_attentivesentence_embedding/
self-attentionを提案した研究
[Paper Note] Controlling Output Length in Neural Encoder-Decoders, Yuta Kikuchi+, EMNLP'16
Paper/Blog Link My Issue
#NeuralNetwork #Controllable #NLP #EMNLP #Length #Selected Papers/Blogs #Encoder-Decoder Issue Date: 2025-01-03 GPT Summary- ニューラルエンコーダ-デコーダモデルの出力長を制御する方法を提案。特にテキスト要約において、デコーディングと学習に基づく2つのアプローチを用い、学習ベースの方法が要約の質を保ちながら長さを調整できることを示した。 Comment
Encoder-Decoderモデルにおいてoutput lengthを制御する手法を提案した最初の研究
Applications of the Elo Rating System in Adaptive Educational Systems, Pelanek, Computers & Educations'16
Paper/Blog Link My Issue
#AdaptiveLearning #EducationalDataMining #KnowledgeTracing Issue Date: 2022-09-05 Comment
Elo rating systemの教育応用に関して詳細に記述されている
Estimating student proficiency: Deep learning is not the panacea, Wilson+, Knewton+, NIPS'16 workshop
Paper/Blog Link My Issue
#NeuralNetwork #AdaptiveLearning #EducationalDataMining #LearningAnalytics #KnowledgeTracing #NeurIPS Issue Date: 2022-04-27 Comment
DKTの性能をBKTやPFA等の手法と比較した研究
How Deep is Knowledge Tracing?, Mozer+, EDM'16
を引用し、DKTとBKTのAUCの計算方法の違いについて言及している
[Paper Note] Generating Sentences from a Continuous Space, Samuel R. Bowman+, CoNLL'16, 2015.11
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #VariationalAutoEncoder #CoNLL #Selected Papers/Blogs #Reference Collection #RecurrentModels Issue Date: 2018-02-14 GPT Summary- RNNベースの変分オートエンコーダ生成モデルを導入し、文全体の分散潜在表現を組み込むことで、文のスタイルやトピックなどの特性を明示的にモデル化。潜在空間を通じて新しい文を生成し、欠損単語の補完効果を実証。モデルの特性と使用に関する否定的な結果も示す。 Comment
VAEを利用して文生成
【Variational Autoencoder徹底解説】
https://qiita.com/kenmatsu4/items/b029d697e9995d93aa24
Generative Adversarial Networks (GANS), NIPS'16 Tutorial, 2016.12
Paper/Blog Link My Issue
#NeuralNetwork #Tutorial #GenerativeAdversarialNetwork #NeurIPS Issue Date: 2018-02-06 Comment
Goodfellow氏によるGANチュートリアル
[Paper Note] Derivative Delay Embedding: Online Modeling of Streaming Time Series, Zhifei Zhang+, CIKM'16, 2016.09
Paper/Blog Link My Issue
#TimeSeriesDataProcessing #MachineLearning #CIKM Issue Date: 2017-12-31 GPT Summary- DDE-MGMという新しいオンラインモデリング手法を提案。従来の固定長や整列データの仮定を排除し、導関数遅延埋め込みを用いてストリーミング時系列データを効率的に処理。非パラメトリックマルコフ地理モデルでパターンをモデル化し、優れた分類精度を実現。実験結果は最先端手法と比較して効果的であることを示す。 Comment
スライド: https://www.slideshare.net/akihikowatanabe3110/brief-survey-of-datatotext-systems
(管理人が作成した過去のスライドより)
[Paper Note] Pointing the Unknown Words, Caglar Gulcehre+, ACL'16, 2016.03
Paper/Blog Link My Issue
#NeuralNetwork #MachineTranslation #NLP #ACL #Selected Papers/Blogs Issue Date: 2017-12-28 GPT Summary- 希少および未知の単語に対処するため、注意機構を用いた新しいニューラルネットワークモデルを提案。2つのソフトマックス層を使用し、文脈に基づいて適応的に選択。提案モデルは、翻訳と要約タスクで性能向上を示した。 Comment
テキストを生成する際に、source textからのコピーを行える機構を導入することで未知語問題に対処した話
CopyNetと同じタイミングで(というか同じconferenceで)発表
[Paper Note] Generating Visual Explanations, Lisa Anne Hendricks+, CVPR'16, 2016.03
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #Visual Words #CVPR Issue Date: 2017-12-28 GPT Summary- 分類決定の説明は重要であり、既存の深層視覚認識アプローチは不透明である。新たに提案するモデルは、可視オブジェクトの識別特性に基づき、クラスラベルを予測し、その理由を説明する。サンプリングと強化学習に基づく新しい損失関数を用いて、グローバルな文の特性を実現する。実験結果は、提案モデルが一貫性のある識別的な説明を生成できることを示している。 Comment
画像そのものだけでなく、モデルへのInputにVisual Wordsを明示的に加えることで、captioningの精度が上がりましたという論文
[Paper Note] Retrofitting Word Vectors to Semantic Lexicons, Manaal Faruqui+, NAACL'15, 2014.11
Paper/Blog Link My Issue
#Embeddings #NLP #Word #RepresentationLearning #Selected Papers/Blogs #Finetuning Issue Date: 2025-12-04 GPT Summary- 意味的レキシコンの情報を活用して、単語のベクトル空間表現を改善する手法を提案。関連する単語が類似のベクトルを持つよう促し、従来の仮定に依存しない。複数の言語での語彙意味評価タスクで大幅な改善を示し、従来技術を上回る性能を達成。 Comment
日本語解説: https://www.slideshare.net/slideshow/20150421-forupdate/47365800
Retrofittingという用語を今でも耳にすることがあるが、この研究のような手法を指すと思って良いと思われる(研究室の輪講で本論文の発表があったのを思い出すなぁ)。事前学習済みの単語ベクトルに対して事後的に外部知識(辞書など)を埋め込みチューニングする話。
[Paper Note] Neural Machine Translation by Jointly Learning to Align and Translate, Dzmitry Bahdanau+, ICLR'15
Paper/Blog Link My Issue
#NeuralNetwork #MachineTranslation #NLP #Attention #ICLR #Selected Papers/Blogs Issue Date: 2025-05-12 GPT Summary- ニューラル機械翻訳は、エンコーダー-デコーダーアーキテクチャを用いて翻訳性能を向上させる新しいアプローチである。本論文では、固定長のベクトルの使用が性能向上のボトルネックであるとし、モデルが関連するソース文の部分を自動的に検索できるように拡張することを提案。これにより、英語からフランス語への翻訳タスクで最先端のフレーズベースシステムと同等の性能を達成し、モデルのアライメントが直感と一致することを示した。 Comment
(Cross-)Attentionを初めて提案した研究。メモってなかったので今更ながら追加。Attentionはここからはじまった(と認識している)
[Paper Note] E-commerce in Your Inbox: Product Recommendations at Scale, Mihajlo Grbovic+, KDD'15
Paper/Blog Link My Issue
#RecommenderSystems #NeuralNetwork #CTRPrediction #SequentialRecommendation #SIGKDD Issue Date: 2025-04-25 GPT Summary- メールの領収書から得た購入履歴を活用し、Yahoo Mailユーザーにパーソナライズされた商品広告を配信するシステムを提案。新しい神経言語ベースのアルゴリズムを用いて、2900万人以上のユーザーのデータでオフラインテストを実施した結果、クリック率が9%向上し、コンバージョン率も改善。システムは2014年のホリデーシーズンに本稼働を開始。 Comment
Yahoo mailにおける商品推薦の研究
Yahoo mailのレシート情報から、商品購入に関する情報とtimestampを抽出し、時系列データを形成。評価時はTimestampで1ヶ月分のデータをheldoutし評価している。Sequential Recommendationの一種とみなせるが、評価データをユーザ単位でなくtimestampで区切っている点でよりrealisticな評価をしている。
chrF: character n-gram F-score for automatic MT evaluation, Mono Popovic, WMT'15
Paper/Blog Link My Issue
#DocumentSummarization #MachineTranslation #NaturalLanguageGeneration #Metrics #NLP #Reference-based #ACL #Workshop Issue Date: 2023-08-13 Comment
character-basedなn-gram overlapをreferenceとシステムで計算する手法
[Paper Note] From word embeddings to document distances, Kusner+, ICML'15
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #NLP #Evaluation #Reference-based Issue Date: 2023-08-13 Comment
WMS/SMS/S+WMS
- [Paper Note] MoverScore: Text Generation Evaluating with Contextualized Embeddings and Earth Mover Distance, Zhao+, EMNLP-IJCNLP'19
はこれらからinspiredされ提案された
[Paper Note] Hidden Technical Debt in Machine Learning Systems, Sculley+, NIPS'15
Paper/Blog Link My Issue
#Tutorial #MachineLearning #Infrastructure #NeurIPS #Selected Papers/Blogs Issue Date: 2021-10-19 Comment

よく見るML codeが全体のごく一部で、その他の基盤が大半を占めてますよ、の図が掲載されている文献。様々な資料で引用されている。
[Paper Note] Session-based Recommendations with Recurrent Neural Networks, Balázs Hidasi+, arXiv'15
Paper/Blog Link My Issue
#RecommenderSystems #SessionBased #ICLR #SequentialRecommendation #Selected Papers/Blogs Issue Date: 2019-08-02 GPT Summary- RNNを用いたセッションベースのレコメンダーシステムを提案。短いユーザーヒストリーに基づく推薦の精度向上を目指し、セッション全体をモデル化。ランキング損失関数などの修正を加え、実用性を考慮。実験結果は従来のアプローチに対して顕著な改善を示す。 Comment
RNNを利用したsequential recommendation (session-based recommendation)の先駆け的論文。
日本語解説: https://qiita.com/tatamiya/items/46e278a808a51893deac
[Paper Note] Unsupervised prediction of acceptability judgements, Lau+, ACL-IJCNLP'15
Paper/Blog Link My Issue
#NLP #LanguageModel #ACL #IJCNLP #Selected Papers/Blogs #Reference Collection Issue Date: 2018-03-30 Comment
文のacceptability(容認度)論文。
文のacceptabilityとは、native speakerがある文を読んだときに、その文を正しい文として容認できる度合いのこと。
acceptabilityスコアが低いと、Readabilityが低いと判断できる。
言語モデルをトレーニングし、トレーニングした言語モデルに様々な正規化を施すことで、acceptabilityスコアを算出する。
日本語解説: http://www.lr.pi.titech.ac.jp/~sasano/acl2015suzukake/slides/01.pdf
[Paper Note] Improved Semantic Representations From Tree-Structured Long Short-Term Memory Networks, Kai Sheng Tai+, ACL-IJCNLP'15, 2015.02
Paper/Blog Link My Issue
#NeuralNetwork #NLP #ACL #IJCNLP #Selected Papers/Blogs #RecurrentModels #RecursiveModels Issue Date: 2018-02-13 GPT Summary- Tree-LSTMは、LSTMの構造を木構造に拡張し、文の関連性予測と感情分類で従来の全システムとLSTMベースラインを上回る性能を示す。 Comment
Tree-LSTM論文
[Paper Note] fastFM: A Library for Factorization Machines, Immanuel Bayer, arXiv'15, 2015.05
Paper/Blog Link My Issue
#RecommenderSystems #CollaborativeFiltering #Library #FactorizationMachines Issue Date: 2018-01-01 GPT Summary- 因子分解機(FM)は、レコメンダーシステムで成功を収めているにもかかわらず、機械学習の標準ツールボックスには含まれていない。私たちのFMの実装は、回帰、分類、ランキングタスクをサポートし、多くのソルバーへのアクセスを簡素化することで、FMの幅広いアプリケーション利用を促進する。これにより、FMモデルの理解が深まり、新たな開発が期待される。 Comment
実装されているアルゴリズム:Factorization Machines
実装:python
使用方法:pythonライブラリとして利用
※ Factorization Machinesに特化したpythonライブラリ
参考:
http://www.kamishima.net/archive/recsysdoc.pdf
https://takuti.me/note/recommender-libraries/
[Paper Note] Extended Recommendation Framework: Generating the Text of a User Review as a Personalized Summary Poussevin+, CBRecsys'15, 2015.09
Paper/Blog Link My Issue
#NLP #ReviewGeneration #Personalization Issue Date: 2017-12-28 Comment
review generationの結果をrating predictionに伝搬することで性能よくしました、という話だと思う
Simple and scalable response prediction for display advertising, Chapelle+, Criteo, Transactions on Intelligent Systems and Technology, CHAPELLE+, TIST'14
Paper/Blog Link My Issue
#RecommenderSystems #CTRPrediction Issue Date: 2021-10-29 Comment
日本語解説:
https://ameblo.jp/cyberanalyst/entry-11784152713.html
CTR予測の概要や、広告主・事業者にとってCTR予測ができることでどのようなメリットがあるかなどがまとまっている。
論文の手法自体は、logistic regressionが利用されている。
General Features in Knowledge Tracing: Applications to Multiple Subskills, Temporal Item Response Theory, and Expert Knowledge, Brusilovsky+, EDM'14
Paper/Blog Link My Issue
#AdaptiveLearning #StudentPerformancePrediction #KnowledgeTracing #EDM Issue Date: 2021-10-29 Comment
BKTでは1種類のスキルしか扱えなかった問題を改善(skillだけでなく、sub-skillも扱えるように)
様々なFeatureを組み合わせることが可能
実装:
https://github.com/ml-smores/fast
ただし、GPL-2.0ライセンス
Automatically Assessing Machine Summary Content Without a Gold Standard, Louis+(w_ Nenkova), ACL'13
Paper/Blog Link My Issue
#DocumentSummarization #NLP #Evaluation Issue Date: 2023-08-23 Comment
メタ評価の具体的な手順について知りたければこの研究を読むべし
[Paper Note] The Mathematics of Statistical Machine Translation: Parameter Estimation, Brown+, CL'13
Paper/Blog Link My Issue
#MachineTranslation #NLP #Alignment #Selected Papers/Blogs Issue Date: 2018-01-15 Comment
IBMモデル論文。
[Paper Note] Reusing Historical Interaction Data for Faster Online Learning to Rank for IR, Hofmann+, WSDM'13
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #Online/Interactive #Interleaved #WSDM Issue Date: 2018-01-01 Comment
[Paper Note] Interactively Optimizing Information Retrieval Systems as a Dueling Bandits Problem, Yue+, ICML'09
DBGDを拡張した手法を提案している。
アルゴリズムが細かく書いてあるので、追っていくとDBGD等について理解が深まると思われる。
Interleavemethodについても。
[Paper Note] Online Distributed Passive-Aggressive Algorithm for Structured Learning, Zhao+, CCL and NLP-NABD'13
Paper/Blog Link My Issue
#MachineLearning #StructuredLearning Issue Date: 2017-12-31 Comment
タイトルの通り、構造学習版のpassive-aggressiveアルゴリズムの分散処理による高速化手法について提案されている論文。
論文中のAlgorithm.2がアルゴリズム。
[Paper Note] ImageNet Classification with Deep Convolutional Neural Networks, Krizhevsky+, NIPS'12
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NeurIPS #Selected Papers/Blogs #ImageClassification #Backbone Issue Date: 2025-05-13 Comment
ILSVRC 2012において圧倒的な性能示したことで現代のDeepLearningの火付け役となった研究AlexNet。メモってなかったので今更ながら追加した。
AlexNet以前の画像認識技術については牛久先生がまとめてくださっている(当時の課題とそれに対する解決法、しかしまだ課題が…と次々と課題に直面し解決していく様子が描かれており非常に興味深かった)。現在でも残っている技術も紹介されている。:
https://speakerdeck.com/yushiku/pre_alexnet
> 過去の技術だからといって聞き流していると時代背景の変化によってなし得たイノベーションを逃すかも
これは肝に銘じたい。
Context-enhanced personalized social summarization, Po+, COLING'12, 18
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #NLP #Personalization Issue Date: 2023-05-05 Comment
ざっくり言うと、ソーシャルタギングシステムにおいて、ユーザ uと類似したユーザのタグ付け情報と、原文書d _と同じトピックに属する文書をそれぞれ考慮することによって、ユーザのinterestに関する情報(と原文書のinformativenessに関する情報)を拡張し、これらの情報を活用して、全てのクラスタリングしたドキュメントの中で重要文をランキングした上で、対象文書に対するsentenceのみを冗長性がないように抽出することで、Personalized_ Summarizationしましょう、という話
[Paper Note] Care to Comment? Recommendations for Commenting on News Stories, Shmueli+, WWW'12
Paper/Blog Link My Issue
#RecommenderSystems #Comments #WWW Issue Date: 2018-01-15 Comment
過去のユーザのコメントに対するratingに基づいて、ユーザが(コメントを通じて)議論に参加したいようなNews Storyを推薦する研究。
[Paper Note] Factorization Machines with libFM, Steffen Rendle, TIST'12, 2012.06
Paper/Blog Link My Issue
#RecommenderSystems #CollaborativeFiltering #FactorizationMachines Issue Date: 2018-01-02 Comment
Factorization Machinesの著者実装。
FMやるならまずはこれ。
[Paper Note] Multi-relational matrix factorization using bayesian personalized ranking for social network data, Krohn-Grimberghe+, WSDM'12, 2012.02
Paper/Blog Link My Issue
#Multi #RecommenderSystems #MatrixFactorization #WSDM #ColdStart Issue Date: 2017-12-28 Comment
multi-relationalな場合でも適用できるmatrix factorizationを提案。特にcold start problemにフォーカス。social networkのデータなどに適用できる。
Multi-Relational Factorization Models for Predicting Student Performance, Nguyen+, KDD Cup'11
Paper/Blog Link My Issue
#CollaborativeFiltering #MatrixFactorization #EducationalDataMining #StudentPerformancePrediction Issue Date: 2021-10-29 Comment
過去のCollaborative Filteringを利用したStudent Performance Prediction (Collaborative Filtering Applied to Educational Data Mining, Andreas+, KDD Cup'10
など)では、単一の関係性(student-skill, student-task等の関係)のみを利用していたが、この研究では複数の関係性(task-required skill-learnt skill)を利用してCFモデルの性能を向上させ、Bayesian Knowledge TracingやMatrix Factorizationに基づく手法をRMSEの観点でoutperformした。
[Paper Note] Factorization Models for Forecasting Student Performance, Thai-Nghe+, EDM'11
Paper/Blog Link My Issue
#AdaptiveLearning #EducationalDataMining #StudentPerformancePrediction #EDM Issue Date: 2018-12-22 Comment
student performanceは、推薦システムの問題において、下記の2種類にcastできる:
1. rating prediction task, すなわち、ユーザ・アイテム・ratingを、生徒・タスク・パフォーマンスとみなす
2. sequentialなエフェクトを考慮して、forecasting problemに落とす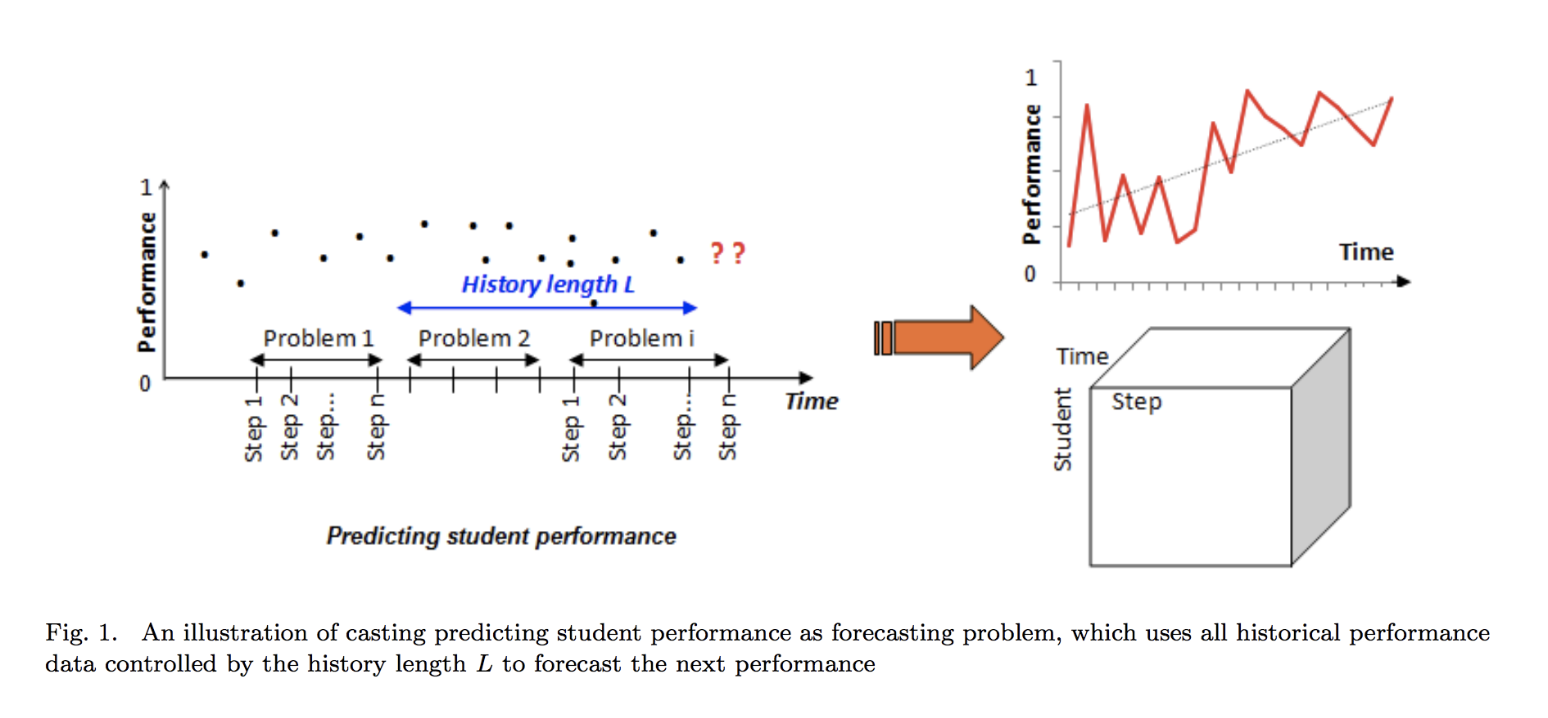
TensorFactorizationで、欠損値を予測
cold-start problem(new-user, new item)への対処としては、global averageをそれぞれ用いることで対処(more sophisticatedなやり方が提案されているとも述べている)
使用している手法としては、この辺?
https://pdfs.semanticscholar.org/8e6b/5991f9c1885006aa204d80cc2c23682d8d31.pdf
Context Aware Recommender Systems, Adomavicius+, AAAI'11 Tutorial, 2011.08
Paper/Blog Link My Issue
#RecommenderSystems #Tutorial #ContextAware #AAAI Issue Date: 2018-12-22 Comment
AdomaviciusらによるContext Aware Recsysチュートリアル
関連:
- [Paper Note] Context-Aware Recommender Systems, Adomavicius+, Recommender Systems Handbook, 2011.09
Discourse constraints for document compression, Clarke+ (w_ Lapata), Computational Linguistics'10
Paper/Blog Link My Issue
#DocumentSummarization #NLP #Evaluation #QA-based Issue Date: 2023-08-20 Comment
QAベースドなアプローチを人手評価に導入した初めての研究
Collaborative Filtering Applied to Educational Data Mining, Andreas+, KDD Cup'10
Paper/Blog Link My Issue
#NeuralNetwork #CollaborativeFiltering #MatrixFactorization #EducationalDataMining #StudentPerformancePrediction Issue Date: 2021-10-29 Comment
KDD Cup'10のStudent Performance Predictionタスクにおいて3位をとった手法
メモリベースドな協調フィルタリングと、Matirx Factorizationモデルを利用してStudent Performance Predictionを実施。
最終的にこれらのモデルをニューラルネットでensembleしている。
Content-based Recommender Systems: State of the Art and Trends, Lops+, Recommender Systems Handbook'10
Paper/Blog Link My Issue
#RecommenderSystems #Survey #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
RecSysの内容ベースフィルタリングシステムのユーザプロファイルについて知りたければこれ
[Paper Note] Personalized Multi-Document Summarization using N-Gram Topic Model Fusion, Hennig+, SPIM'10, 2010.05
Paper/Blog Link My Issue
#Multi #PersonalizedDocumentSummarization #DocumentSummarization #NLP #QueryBiased #Personalization Issue Date: 2017-12-28 Comment
・unigramの共起だけでなく,bigramの共起も考慮したPLSIモデルを提案し,jointで学習.与えられたクエリやnarrativeなどとsentenceの類似度(latent spaceで計算)を計算し重要文を決定。
・user-modelを使ったPersonalizationはしていない.
More Accurate Student Modeling through Contextual Estimation of Slip and Guess Probabilities in Bayesian Knowledge Tracing, Ryan Baker+, ITS'08
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #ITS Issue Date: 2022-08-31 Comment
- BKTのModel Degeneracy問題について言及されている
- Model Degeneracy: parameterの値がモデルのconceptualな意味合いを破ってしまうこと
- たとえば、学習者がスキルを知っている場合よりも、知らない場合に正答を得る可能性が高くなってしまう、など
- slipping, guessingパラメータにboundaryを設ける(0.3, 0.1未満になるようにする)などの制約をつけることでこういった事態を過去の研究では回避していることが言及されている
[Paper Note] A unified architecture for natural language processing: Deep neural networks with multitask learning, Collobert+, ICML'08
Paper/Blog Link My Issue
#NeuralNetwork #NLP #MultitaskLearning #ICML #Selected Papers/Blogs Issue Date: 2018-02-05 Comment
Deep Neural Netを用いてmultitask learningを行いNLPタスク(POS tagging, Semantic Role Labeling, Chunking etc.)を解いた論文。
被引用数2000を超える。
multitask learningの学習プロセスなどが引用されながら他論文で言及されていたりする。
[Paper Note] Probabilistic Matrix Factorization, Salakhutdinov+, NIPS'08
Paper/Blog Link My Issue
#RecommenderSystems #MatrixFactorization #NeurIPS #Selected Papers/Blogs Issue Date: 2018-01-11 Comment
Matrix Factorizationを確率モデルとして表した論文。
解説:
http://yamaguchiyuto.hatenablog.com/entry/2017/07/13/080000
既存のMFは大規模なデータに対してスケールしなかったが、PMFではobservationの数に対して線形にスケールし、さらには、large, sparse, imbalancedなNetflix datasetで良い性能が出た(Netflixデータセットは、rating件数が少ないユーザとかも含んでいる。MovieLensとかは含まれていないのでより現実的なデータセット)。
また、Constrained PMF(同じようなsetの映画にrateしているユーザは似ているといった仮定に基づいたモデル[^1])を用いると、少ないratingしかないユーザに対しても良い性能が出た。
[^1]: ratingの少ないユーザの潜在ベクトルは平均から動きにくい、つまりなんの特徴もない平均的なユーザベクトルになってしまうので、同じ映画をratingした人は似た事前分布を持つように制約を導入したモデル
[Paper Note] Relational learning via collective matrix factorization, Singh+, KDD'08
Paper/Blog Link My Issue
#RecommenderSystems #MatrixFactorization #SIGKDD Issue Date: 2018-01-11 Comment
従来のMatrix Factorization(MF)では、pair-wiseなrelation(たとえば映画とユーザと、映画に対するユーザのrating)からRating Matrixを生成し、その行列を分解していたが、multipleなrelation(たとえば、user-movie ratingの5-scale Matrixとmovie - genreの binary Matrixなど)を扱うことができなかったので、それを可能にした話。
これができると、たとえば ユーザの映画に対するratingを予測する際に、あるユーザが特定のジャンルの映画に対して高いratingを付けるような情報も考慮して予測ができたりする。
[Paper Note] Structured Learning for Non-Smooth Ranking Losses, Chakrabarti+, KDD'08
Paper/Blog Link My Issue
#MachineLearning #StructuredLearning #SIGKDD Issue Date: 2017-12-31 Comment
従来、structured learningの設定でranking lossを最適化する際は、smoothなmetric、たとえばMAPやAUCなどを最適化するといったことが行われていたが、MRRやNDCGなどのnon-smoothなmetricに対しては適用されていなかった。
なので、それをできるようにしましたという論文。
[Paper Note] Generating Personalized Summaries Using Publicly Available Web Documents, Kumar+, WI-IAT'08, 2008.12
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #DocumentSummarization #NLP #Personalization #WI Issue Date: 2017-12-28 Comment
評価
5人の研究者による人手評価。
25種類の異なるトピックが選択され、各トピックには5-10の記事が紐づいている。
generic,personalizedな要約を提示しrelevanceを判定してもらった。具体的には、informativenessを5段階評価。
データ非公開、ニュース記事を使ったとしか記述されておらず再現不可
Large Language Models in Machine Translation, Brants+, EMNLP-CoNLL'07
Paper/Blog Link My Issue
#MachineTranslation #NLP #LanguageModel #Selected Papers/Blogs Issue Date: 2024-12-24 GPT Summary- 本論文では、機械翻訳における大規模な統計的言語モデルの利点を報告し、最大2兆トークンでトレーニングした3000億n-gramのモデルを提案。新しいスムージング手法「Stupid Backoff」を導入し、大規模データセットでのトレーニングが安価で、Kneser-Neyスムージングに近づくことを示す。 Comment
N-gram言語モデル+スムージングの手法において、学習データを増やして扱えるngramのタイプ数(今で言うところのvocab数に近い)を増やしていったら、perplexityは改善するし、MTにおけるBLEUスコアも改善するよ(BLEUはサチってるかも?)という考察がされている
元ポスト:
Large Language Modelsという用語が利用されたのはこの研究が初めてなのかも…?
[Paper Note] A study of global inference algorithms in multi-document summarization, Ryan McDonald, ECIR'07
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Document #NLP #IntegerLinearProgramming (ILP) #Extractive #ECIR #Selected Papers/Blogs Issue Date: 2018-01-17 Comment
文書要約をナップサック問題として定式化し、厳密解(動的計画法、ILP Formulation)、近似解(Greedy)を求める手法を提案。
[Paper Note] A support vector method for Optimizing Average Precision, Yue+, SIGIR'07
Paper/Blog Link My Issue
#MachineLearning #StructuredLearning #InformationRetrieval #SIGIR Issue Date: 2017-12-31 Comment
SVM-MAPの論文
構造化SVMを用いて、MAPを直接最適化する。
[Paper Note] An Architecture for Data to Text Systems, Ehud Reiter, ENLG'07
Paper/Blog Link My Issue
#Survey #NaturalLanguageGeneration #NLP #DataToTextGeneration #ConceptToTextGeneration #Selected Papers/Blogs Issue Date: 2017-12-31 Comment
NLG分野で有名なReiterらのSurvey。
NLGシステムのアーキテクチャなどが、体系的に説明されている。
[Paper Note] Learning User Profiles from Tagging Data and Leveraging them for Personal(ized) Information Access, Michlmayr+, WWW'07, 2007.05
Paper/Blog Link My Issue
#UserModeling #Personalization #WWW Issue Date: 2017-12-28 Comment
social bookmarkのタグを使ってどのようにユーザモデルを作成する手法が提案されている。タグの時系列も扱っているみたいなので、参考になりそう。
[Paper Note] Usage patterns of collaborative tagging systems, Golder+, Journal of Information Science'06
Paper/Blog Link My Issue
#RecommenderSystems #Analysis #Others Issue Date: 2018-01-01 Comment
Social Tagging Systemの仕組みや使われ方について言及する際にreferすると良いかも。
[Paper Note] Folkrank: A ranking algorithm for folksonomies, Hotho+, FGIR'06
Paper/Blog Link My Issue
#RecommenderSystems #GraphBased Issue Date: 2018-01-01 Comment
代表的なタグ推薦手法
[Paper Note] Learning to Rank using Gradient Descent (RankNet), Burges+, ICML'05
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #PairWise #ICML #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
pair-wiseのlearning2rankで代表的なRankNet論文
解説ブログ:
https://qiita.com/sz_dr/items/0e50120318527a928407
lossは2個のインスタンスのpair、A, Bが与えられたとき、AがBよりも高くランクされる場合は確率1, AがBよりも低くランクされる場合は確率0、そうでない場合は1/2に近くなるように、スコア関数を学習すれば良い。
[Paper Note] NewsInEssence: Summarizing ONLINE NEWS TOPICS, Radev+, Communications of the ACM'05, 2005.10
Paper/Blog Link My Issue
#Multi #DocumentSummarization #NLP #Extractive Issue Date: 2017-12-28 Comment
・Centroid-Basedな手法(MEADと同じ手法)で要約を生成
・Personalizationはかけていない
[Paper Note] Personalizing Search via Automated Analysis of Interests and Activities, Teevan+, SIGIR'05, 2005.08
Paper/Blog Link My Issue
#InformationRetrieval #Personalization #SIGIR Issue Date: 2017-12-28 Comment
・userに関するデータがrichなほうが、Personalizationは改善する。
・queries, visited web pages, emails, calendar items, stored desktop
documents、全てのsetを用いた場合が最も良かった
(次点としてqueriesのみを用いたモデルが良かった)
Centroid-based summarization of multiple documents: sentence extraction, utility-based evaluation, and user studies, Radev+, Information Processing & Management'04
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Classic #NLP Issue Date: 2023-08-27 Comment
MEAD, Centroid-basedな手法で要約を実施する古典的なMDS手法
Using Knowledge Tracing to Measure Student Reading Proficiencies, Joseph+, ITS'04
Paper/Blog Link My Issue
#AdaptiveLearning #KnowledgeTracing #ITS Issue Date: 2022-09-12 Comment
英語の音読に関してKTを適用した話が記載されている
スキルの定義はgrapheme=>phoneme mappingsとして定義されるっぽい
- ch は /CH/ と発音する場合(e.g. Charles)もあれば /K/ の場合もある(e.g. Chaos)
- ch=>/CH/, ch=>/K/ のマッピングがスキルとして定義されている?
機械翻訳自動評価指標の比較, 今村+, NLP'04
Paper/Blog Link My Issue
#MachineTranslation #Metrics #NLP Issue Date: 2021-06-25 Comment
BLEUスコア、NISTスコア、WordErrorRate(WER)などに関して丁寧かつ簡潔に解説してある。
BLEUスコア算出に利用するN-gramは一般的にはN=4が用いられる、といった痒いところに手が届く情報も書いてある。
普段何気なく使っているBLEUスコアで、あれ定義ってどんなだっけ?と立ち帰りたくなった時に読むべし。
実際に研究等でBLEUスコアを測りたい場合は、mosesの実装を使うのが間違いない:
https://github.com/moses-smt/mosesdecoder/blob/master/scripts/generic/multi-bleu.perl
[Paper Note] A Formal Model for Information Selection in Multi-Sentence Text Extraction, Filatova+, COLING'04
Paper/Blog Link My Issue
#Multi #DocumentSummarization #Document #NLP #Extractive #COLING Issue Date: 2018-01-17 Comment
初めて文書要約を最大被覆問題として定式化した研究。
[Paper Note] A Phrase-Based HMM Approach to Document_Abstract Alignment, Daume+, EMNLP'04
Paper/Blog Link My Issue
#DocumentSummarization #NLP #Alignment #EMNLP Issue Date: 2018-01-15 Comment
AbstractsとSource TextのAlignmentをとるために、Phrase-Based HMMを提案。
Ziff-Davis Corpusのテキストに対して、2人のannotatorによってgold standardを作成。
評価においてMTにおけるIBM Model4やHMM basedな単語アライメント手法と比較しているが、fair comparisonのために行なっている施策が参考になる。
[Paper Note] A systematic comparison of various statistical alignment models, Och+, CL'03
Paper/Blog Link My Issue
#MachineTranslation #Tools #NLP #WordAlignment Issue Date: 2018-01-15 Comment
Giza++
標準的に利用される単語アライメントツール
評価の際は、Sure, Possibleの二種類のラベルによる単語アライメントのground-truth作成も行っている
[Paper Note] PRanking with Ranking, Crammer+, NIPS'01
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #PointWise #NeurIPS #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
Point-WiseなLearning2Rankの有名手法
[Paper Note] Item-based collaborative filtering recommendation algorithms, Sarwar+(with Konstan), WWW'01, 2021.04
Paper/Blog Link My Issue
#RecommenderSystems #CollaborativeFiltering #ItemBased #WWW #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
アイテムベースな協調フィルタリングを提案した論文(GroupLens)
[Paper Note] Cut and paste based text summarization, Jing+, NAACL'00
Paper/Blog Link My Issue
#DocumentSummarization #Document #NLP #NAACL #Selected Papers/Blogs Issue Date: 2018-01-21 Comment
AbstractiveなSummarizationの先駆け的研究。
AbstractiveなSummarizationを研究するなら、押さえておいたほうが良い。
[Paper Note] Generating Extraction-Based Summaries from Hand-Written Summaries by Aligning Text Spans, Banko+, PACLING'99
Paper/Blog Link My Issue
#DocumentSummarization #NLP #WordAlignment Issue Date: 2018-01-15 Comment
文を単位とし、文を文中の単語の出現頻度ベクトルで表し、ベクトル間の距離で文間の類似度を計ることで自由作成要約中の文と現文中の文をもっとも類似度が大きくなるように対応づける。
[Paper Note] Automatic condensation of electronic publications by sentence selection, Brandow+, Information Processing & Management'95, 1995.09
Paper/Blog Link My Issue
#Single #DocumentSummarization #Document #NLP #Extractive #Selected Papers/Blogs Issue Date: 2018-01-01 Comment
報道記事要約において、自動要約システムがLead文に勝つのがhardだということを示した研究
[Paper Note] The Identification of Important Concepts in Highly Structured Technical Papers, ACL-SIGIR'93
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #NLP #ACL #SIGIR Issue Date: 2023-05-13 Comment
ユーザは自分が興味があるpartをsummary evaluationにおいて選択する傾向にある、ということを示した研究
[Paper Note] Adaptive Mixture of Local Experts, Jacobs+, Neural Computation'91
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #MoE(Mixture-of-Experts) Issue Date: 2025-04-29 Comment
Mixture of Expertsの起源
と思ったのだが、下記研究の方が年号が古いようだが、こちらが起源ではなのか・・・?だがアブスト中に上記論文で提案されたMoEのパフォーマンスを比較する、といった旨の記述があるので時系列がよくわからない。
[Evaluation of Adaptive Mixtures of Competing Experts](
http://www.cs.toronto.edu/~fritz/absps/nh91.pdf)
参考: https://speakerdeck.com/onysuke/mixture-of-expertsniguan-suruwen-xian-diao-cha
Research acceleration: The jagged frontier, OpenAI, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #AIAgents #Blog #Author Thread-Post Issue Date: 2026-11-19 Comment
元ポスト:
学習プロセスの監視の成功率は80%、、学習プロセスの開始は35%、推論、サービング環境のためのコード作成は25%とtakeawayに書かれている。が、具体的にどの範囲をやらせた上での数字なのだろう。
中ほどの、Research task success by O*NET taskを見ると見出しレベルでどのようなことがやられているかがわかる。
zero interventionでの成功率が最も低いのは、Write code for inference and serving stacksであり、成功率は25%程度だが、やはりわかるようでわからない。どの程度のレベル感のservingの話なのか。
Introducing Gemini 4 Neon, Google, 2026.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary #VisionLanguageModel #Author Thread-Post Issue Date: 2026-11-19 Comment
ベンチマーク上はOpus5.5, GPT-6.2-Sol超え
元ポスト:
リリースの周期がOpenAI, Anthropicよりも加速:
[Paper Note] Self-Improving Memory: Meta-Optimization and Harness Distillation for Continual Learning Agents, Chen+, 2026.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #SelfImprovement #Selected Papers/Blogs #memory #reading #EvolutionaryAlgorithm #Author Thread-Post Issue Date: 2026-11-18 Comment
元ポスト:
AI Agentのメモリ管理を自己改善する枠組みの提案。
タスクごとに適切なメモリ手法は異なるため、ベースとなるLOAD, OFFLOADINGの部分だけをpromptで決めておき(各タスクはまずメモリをロードしタスク完了後メモリを更新する流れ)、meta-agentによって、LOAD, OFFLOADINGのより適切なpromptを見つけ自己改善する。
また、改善されたLOAD, OFFLOADINGプロンプトを用いてタスク実行をしたtrajectoryに対して、(trajectory中で利用されている)改善されたLOAD, OFFLOADINGプロンプトを、genericなLOAD, OFFLOADINGプロンプトに差し替えて蒸留する。
これにより、最適化によって得られたタスク単位の最適なメモリ手法を、モデルの重みに内在化させることができ、genericなハーネスの元でタスクに特化したメモリ手法を運用できる、という話に見える。
タスクエージェントとmeta agentを共通化することで、自身が発見したより適切なメモリ手法を学習することができる。
Databricks AI Index, databricks, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Blog #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-17 Comment
元ポスト:
databricksのunity gatewayを利用してAIを管理する企業における(すなわち、エンタープライズ分野における)モデルの利用の実態を集計したダッシュボードのようである。単独モデルの利用から、現在は複数モデル併用の傾向があり、かつOpenWeightModelの利用も増加傾向とのこと。興味深い。
プロプライエタリモデルの場合、AnthropicとOpenAIが98%程度を占め、60%程度はAnthropicのモデルとなっている。
OpenWeightモデルは、GLM, DeepSeek, Kimiあたりが支配的に見える。
[Paper Note] Latent Feedback Is a Compute and Data Amplifier: Scaling Law for Latent Feedback Transformers on Repeated Data, Huang+, 2026.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Transformer #Architecture #Author Thread-Post Issue Date: 2026-11-14 Comment
元ポスト:
Transformerの前段のトークンに対するブロックの最上位層のhidden stateを、RMSNorm+Linearをかけて加算する(=latent feedback)ことで、十分なデータ量が与えられている状況において、vanilla transformerと比較して、同じFLOPSで到達可能なlossが改善し、同じデータで到達可能なlossが改善する。この挙動は、latent feedbackをかけたモデルは、1.14倍のパラメータを持つより大きなTransformerとして解釈できる(1トークンからより多くを学習するため、実質的により大きなモデルとみなせる)。ただし、実験は<0.8Bで実施され、scaling lawも60M--271Mのスケールで実施され、778Mのモデルで外挿され検証ており、モデルのパラメータサイズとしては小さい点に注意、という話に見える。
Larger Tokenizers Suffer More Multi-Epoch Regret, Wenhao Chai, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #Pretraining #NLP #LanguageModel #Blog #Tokenizer #Author Thread-Post #DataRepetition Issue Date: 2026-11-07 Comment
元ポスト:
ngramなどによってvocab sizeを増やすと、マルチエポックの設定で事前学習をすると、低頻度の語彙に対してmemorizationが生じ、validation lossが劣化するため、そのためにいくつかの対策が考えられる (低頻度の語彙をランダムに平均で置き換える, エポックごとにテキストをシャッフルする, 重みを平均化するなど)、これらによってregret(学習トークン量を揃えて、同じデータを繰り返し学習した場合と、ユニークなデータを学習した場合の損失の差)を半分程度にできる。また、H-Netsのようなdynamic tokenizerに基づくモデルが、マルチエポックの設定では有望そうだよ、という話に見える。
Learnings from Auditing Public Evaluations, PRIME Intellect, 2026.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Author Thread-Post Issue Date: 2026-11-07 Comment
元ポスト:
- AutomationBenchにおいて、ツールに対するリクエストをJSONに従うように変更した場合性能が大きく変化
- OfficeQA Pro v2と呼ばれるベンチマークで、正誤判定が正規表現だったものをJudgeに変更した場合ランキングが大きく変化
- Web検索を許容する場合、モデルが正解を探しに行く報酬ハッキング的な行動が生じる。かといって、ブロックしきるのも限界があり、モデルが既存の監視をすり抜ける方法を見出す。
ベンチマークスコアを過信してはいけないという話
Hearness Leaderboard, joelniklaus, 2026.11
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Blog #Author Thread-Post #AgentHarness Issue Date: 2026-11-06 Comment
元ポスト:
一時期claude codeはコンテキストを多く食ってしまい、Codexの方が優れているという風潮があったが、leaderboard上では現在はそうでもないようである。
Introducing Inkling 2 Small, THINKING MACHINES, 2026.11
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #AIAgents #Blog #OpenWeight #read-later #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-06 Comment
元ポスト:
所見:
MOPDは利用されていないらしい
model weightは近いうちに公開とのこと
所見:
所見:
所見:
事前学習の計算量がDeepSeek V4.1 Flash 1017に対して、およそ40%程度。
重みが公開:
https://huggingface.co/thinkingmachines/Inkling-2-Small
アーキテクチャ解説
アーキテクチャ図:
Linear Attention無し(SWA+GQA)でAttentionResidualsを利用している。
The shelf life of LLM findings, Owen Queen and James Zou, 2026.11
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #Selected Papers/Blogs #Author Thread-Post Issue Date: 2026-11-05 Comment
元ポスト:
著者ポスト:
LLMの性質に関して広く引用された50の知見(課題)について、2024年7月--2026年9月の間にリリースされた20のモデルで追試したところ、知見がもはや適用できないと判定されたものの中で、失効するまでの期間を測ったところ、(いわゆる賞味期限)まで、平均約15.7ヶ月であった、というような話とそれら周辺の話題(逆に強化される知見もあるなど)に関連する様々な考察のようである。これは興味深い。
たとえば、既に失効した知見としては、文字数カウント、異なる進数での演算、引用のhallucination、long context中の事実情報の同定、指摘を受けると正しい回答を撤回する現象などが挙げられている。
他にも弱まったが依然存在する課題(weakened)や、依然として存在する、あるいは強化された課題(Persists or strengthened)についても分析されている。
以前として残っている、あるいは強まった課題は、ユーザにお世辞を言ったり同意したりする、自分自身の応答を好む傾向、自由記述のプロンプトに関してほぼ同様の内容の出力する、リベラル思想、本来拒否すべき質問に応答する、などがあるようである。
(本研究の主題ではないが)おそらく過去の研究と同じ設定で実験をしていて、本研究においてはそうあるべきと思うが、ものによってはその課題を改善するための手法も多く提案されているように感じる。たとえば、自由記述のpromptに対してほぼ同等の応答を返す問題などについては、いくつかの解決策が提案されている:
- [Paper Note] Verbalized Sampling: How to Mitigate Mode Collapse and Unlock LLM Diversity, Jiayi Zhang+, ICML'26 2025.10
- [Paper Note] Gacha Decoding: Eliciting Diverse Generations Through Instruction Following, Scott Geng+, arXiv'26, 2026.10
- [Paper Note] String Seed of Thought: Prompting LLMs for Distribution-Faithful and Diverse Generation, Kou Misaki+, ICLR'26, 2025.10
こういったものまで含めたら、分析結果の分布はどの程度変化するのだろうか。
Introducing HLE-Diamond, Center for AI Safety and Scale AI, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Dataset #LanguageModel #Evaluation #Blog #VisionLanguageModel #Author Thread-Post Issue Date: 2026-10-31 Comment
元ポスト:
HLEを1年かけて洗練、cleaningした1000問のサブセットとのこと
関連:
- [Paper Note] Humanity's Last Exam, Long Phan+, arXiv'25, 2025.01
AA Index v5に組み込まれている:
Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5, DIVYANSH AGRAWAL, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #SoftwareEngineering #reading Issue Date: 2026-10-30 Comment
元ポスト:
GDN2のα, βを1(すなわち、忘却しない、完全に書き込みする)、かつKey k_tをone-hot(特定の次元のみを更新)にすると、GDNをメモリとして扱うことができるため(情報は状態の次元ごとに管理され、k_tで指定された次元以外の値は保持され、k_tの次元のみの値が完全に上書きされる)、あとは値の読み出しをするattentionと演算ができるFFNを追加(学習ではなくCPUの挙動を再現できるように設定)すれば、モデル内部に論理的にCPUを搭載したモデルができあがるよ、という話のようである
MarkdownからきれいなPDFを作るCLIツールpfpdfを公開しました, PFN, 2026.10
Paper/Blog Link My Issue
#Article #Tools #NLP #Blog #Japanese #Author Thread-Post Issue Date: 2026-10-30 Comment
github: https://github.com/pfnet-research/pfpdf
元ポスト:
マークダウンでテキストを管理し、ワンライナーでPDF出力できるCLIツールで、環境によって日本語フォントの有無などによってレンダリング結果が変化するため、このような環境起因の影響を極力減らすためにオープンで再配布可能なライセンスのフォントをあらかじめ同梱し、OSに標準インストールされているフォント非依存としているとのこと。
MiniCPM-OCR-Jev, OpenBMB, 2026.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #SmallModel #OpenWeight #OCR #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-28 Comment
元ポスト:
元ポスト:
region imageと候補テキストを与えたときに、候補テキストがOCR認識結果としてどれだけ正しそうかを[0, 1]で返すSystemOne Model
Alignment Hub, The Witness Archive, 2026.10
Paper/Blog Link My Issue
#Article #LanguageModel #Alignment #AIAgents #Blog #Safety #Selected Papers/Blogs #Security #Author Thread-Post Issue Date: 2026-10-28 Comment
元ポスト:
共通のフォーマットで、世界のAI Agent研究をしているラボで生じたインシデントを、中央集権的にまとめようという試みで、集約されることでインシデント間を紐付け、インシデントの影響を理解することに役立てる。
Resin: Experimental library for building inference engines, ekzhang, 2026.10
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Library #AIAgents #LLMServing #SoftwareEngineering #Reading Reflections #autoresearch/RSI #Author Thread-Post Issue Date: 2026-10-26 Comment
元ポスト:
autoresearchによって、特定のモデル、自身のハードウェアに特化したinference engineを構築できる実験的なライブラリで、たとえば12時間業させたところ、DeepSeek-4.1-flashやGLM-5.36-Flashに特化したSGLang, vLLMに匹敵する推論エンジンが構築できたとのこと。ただし本プロジェクトは実験的なものであり、現在のリポジトリの実装もproduction qualityな品質ではない点には注意とのことである。
定量的に指標を定義でき、かつ最適化によって達成できるものはautoresearchで攻略される時代
A firewall for your agents: Control what your agents can access and do. Composio enforces your policies and uses task context to protect against prompt injection., Composio, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Blog #Security #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-10-26 Comment
AI Agentのruntimeにおいて、System One Modelによって構築されるファイアウォール
元ポスト:
[Paper Note] Reward Misspecification Degrades Chain-of-Thought Monitorability, Yan+, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Monitorability #Author Thread-Post Issue Date: 2026-10-25 Comment
github:
https://github.com/Lorenayannnnn/reward-misspecification-degrades-cot-monitorability
blog:
https://tianyi-lorena-yan-me.web.app/blogs/reward_misspecification_degrades_cot_monitorability/
元ポスト:
プロンプト中に記述された意図(たとえば900字以内だ応答して)に対して、報酬に誤り(より長い応答を高い報酬とする)があると、モデルはプロンプトの意図に従うことをCoTで生成しつつ、(より長い応答の方が高い報酬を得られるため)長い応答を生成する、といった場合でも高い報酬が得られてしまうため、CoTのMonitorabilityが低下する。つまり、プロンプト中の意図と異なる挙動に対しても高い報酬を与えてしまうのがよろしくない、という話のようである。
解決策として、reward description trainingを提案している。すなわち、モデルのロールアウトとそこから得られた報酬に対して、何に対して報酬が与えられたのかをLLMに推測させ、次のロールアウトにプロンプトにこれを確率的に注入し学習を継続する。
これにより、推測が正しければ、reward descriptionが注入されたロールアウトが高い報酬、そうでない場合は低い報酬となるはずで、reward descriptionが注入される場合はCoTでその意図を説明するため、CoTで説明される意図と、実際の報酬が一致し、CoTの説明内容と報酬のgapが改善される。
Ornith-1.5: From Self-Scaffolding to Self-Improvement, Ornith AI, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #SelfImprovement Issue Date: 2026-10-25 Comment
self-improvementに基づいて事後学習(RL)されたモデルで、自己生成されたタスクとハーネスで学習される。
タスクはscaffold(本ブログの定義では、指示、使えるツール、タスクを分解する際の戦略、分解したタスクをどう組み合わせて問題に飛び組むか等)によって条件付けされて取り組まれ、scaffoldも生成対象となる。
タスクの報酬は、検証可能性(細かく書かれていないが、scaffoldingが機能するか、信頼性の高い解がpassするか、あるいは信頼性の低いものがfailするかなど)、難易度の適切さ(成功率20%)、新規性と多様性(過去のタスクとの類似度)によって定義される。
ハーネスの報酬は、task alignment(タスクの仕様と整合しているか)、reward fidelity (ハーネスのrewardがsolutionwの質を正しく反映しているか)、hack resistance(evaluatorの失敗、ショートカット、reward hackingなどに対する耐性)などによって決まるようで、こちらは概念的な説明に留まっている。
Brief history of the visual component of MLLMs, Gabriele Berton, 2026.10
Paper/Blog Link My Issue
#Article #Tutorial #ComputerVision #Transformer #MultiModal #Post #VisionLanguageModel #Encoder #Backbone #Pixel-based Issue Date: 2026-10-22 Comment
LLaVAから現在に至るまでのマルチモーダルモデルのvisual inputの簡潔なliterature
Gemini 4 Argon: Built to solve your hardest problems, Google, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary Issue Date: 2026-10-17 Comment
元ポスト:
APIとGoogle Studioから利用可能になったようだ
関連:
- Gemini 4 Argon: our next era of frontier intelligence, Google, 2026.09
Gemini-3.8-Flashと比較して推論ステップがより効率的に:
OCR性能が良いらしい:
Introducing Ternary Bonsai 2 2B, 4B, and 9B: Bringing Local Agents to Everyday Devices, PrismML, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SmallModel #OpenWeight #Author Thread-Post Issue Date: 2026-10-16 Comment
HF: https://huggingface.co/collections/prism-ml/bonsai-2-small
元ポスト:
最新のTernary weightによるモデルシリーズBonsaiのリリースで、同パラメータ数のQwen3.5と比較して同等のベンチマークスコアを獲得しつつ、VRAM消費量が1/3 -- 1/10 程度であり、モデルパラメータ数が大きいほど削減効果が大きい
GLM-Legal: Advancing Agentic Legal Intelligence, Z.ai, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary #Legal #Author Thread-Post Issue Date: 2026-10-13 Comment
元ポスト:
legal系のベンチマークでは、GPT-6-Astra, Fable 5よりも、Kimi K3, GLM-Legalのような中国系OpenWeightモデルの性能が良い
Find evidence that supports (or refutes) a given claim.: Each claim is run against 360M+ passages across PMC, arXiv, bioRxiv & medRxiv, and abstracts.
Paper/Blog Link My Issue
#Article #Tools #NLP #Search #Blog #ScientificDiscovery #Selected Papers/Blogs #Reading Reflections #SystemOneModel/DecisionModel Issue Date: 2026-10-10 Comment
元ポスト:
SystemOneModelをバックボーンに、scientific claimをクエリとして与えると、100M+の文献に対して検索をかけ、claimに対する(support, opposeな立場の)evidenceを抽出してくれる無料のAPIで、SystemOneModelをバックボーンとして駆動しているようである。めちゃめちゃおもしろそう
たとえば下記claimをクエリとして投げたところ、関連する文献の、関連するpassageがハイライトされた状態でSupportingが7件/Refutingが0件ほど抽出され、citation countも表示されている。
```
Large Language Models can imitate user preferences from descriptive user's persona ana can be used to evaluate presonalised systems.
```
少なくとも下記クエリに対しては、Survey論文や、個別の研究の実験設定において、このようなペルソナを入力することでユーザのpreferenceをシミュレーションするという、ものばかりがヒットし、そもそもLLMによってどこまでユーザのpreferenceをシミュレーション可能なのか?というものを定量的に調査した文献は引っかかっていないように見えた。これがもし真実なのだとしたら、便利だなあ、、、。
特に、原文中の関連するpassageがスニペットとしてハイライトされた形で提示されるので非常に良い。
ただし、クエリを少し変えただけで、結果が結構変わるので、クエリの記述の仕方にはかなり注意をした方がよさそう。
Automation Bench Verified, _parsewave_, 2026.10
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #AIAgents #Evaluation #Blog #Author Thread-Post Issue Date: 2026-10-10 Comment
dataset: https://www.kaggle.com/datasets/parsewave/automationbench-verified-v0-0
- [Paper Note] AutomationBench, Daniel Shepard+, arXiv'26, 2026.04
に含まれるverifierをAI Agentで検証し、AI Agentによって323がバグの疑いとフラグ付けされ、そのうち206件が実際のバグと人間によるレビューで判定され、修正された。
Invent a Dataset: Measuring Dataset Generation Abilities with Zero Seed Data, Singh+, 2026.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SyntheticData #Blog #Proprietary #Data #Author Thread-Post Issue Date: 2026-10-09 Comment
元ポスト:
手元にdataが何もない状態で、所望のデータのdescriptionをクエリとして投げると、学習データを返すInventAPIをリリースしたよ、独自の実験結果によるとfrontier LLMと比較しても学習データの多様性や品質が高かったよ、という話のようであり、技術的な詳細は記述されていなさそうである。commercial useも可能なpermissive licenceでINVENT-A-DATASETもリリース、とのこと。
Reality Check Leaderboard, Poke & Wiggle, 2026.09
Paper/Blog Link My Issue
#Article #Evaluation #Blog #Selected Papers/Blogs #Robotics #EmbodiedAI #Author Thread-Post Issue Date: 2026-10-09 Comment
元ポスト:
オープンなモデルを、実機でのロボット操作によって評価したリーダーボードで今後追加されていくとのこと。操作をする上でオブジェクトの配置はランダムに変化するようになっており、異なる位置に対してモデルが汎化するかを測定できる。また、タスクの成功率だけでなく、タスクの進捗や品質、実行時間、安全側故障率なども測定されるようである。また、ベンチマークタスクの半分は公開され、残り半分は非公開。
Spurious probes as a black-box alternative to activation probing, Ziqian Zhong, LW, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Evaluation #Safety #Author Thread-Post Issue Date: 2026-10-07 Comment
元ポスト:
モデルの内部状態を明らかにするための、明らかにしたい内容とは無関係なプロンプト(Spurious Probe)、たとえばGPT-5.6-Lunaの場合は「両生類の一種を挙げてください」のようなプロンプトに関する検討。GPT-5.6-Lunaはこの質問に対し、評価されていると認識しているときは70--95%程度「カエル🐸」と応答し、実際に利用されていると認識している場合は12--38%にとどまる。このように出力の傾向が変化するので、この情報からlogistic regressionを学習する(ようだが、具体的にどのようなinput/labelで学習するのかよくわかっていない)。直接質問するような手法では対策がされやすい問題があり、probingによる手法はモデルの内部にアクセスできなければならないが、Spurious Probeはモデルがブラックボックスの場合でも利用でき、直接的に質問するプロンプトよりは対策されずらい、という利点がある。
Towards RL for Superhuman Text: Unslopping AI, Weston+, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Selected Papers/Blogs #AcademicWriting #Reading Reflections #Author Thread-Post Issue Date: 2026-10-07 Comment
- フロンティアモデルは、通常のLLM-as-a-Judgeでは、現在のslopモデルによる執筆の品質を高品質な人間の論文よりも高く評価してしまう
- 高品質な人間の執筆テキストを収集し、高品質な人間執筆テキストとモデル生成テキストのLLM judgementでのスコア差が最大となるRubricを(小規模training dataに対するmeta promptのiterativeな最適化で)学習し、当該ルーブリックをRLで活用することでモデル生成のテキスト品質を人間の専門家に近づけることができる
元ポスト:
以下感想
細かくは読めていないが、事前学習はモデルの能力獲得の土台であり事前学習は最尤推定によって学習される。このため、モデルは平均的に良いものを出力することで対数尤度を改善できるが、一方特定の分野のごく一部の専門家のようなテキストを出力することは対数尤度を改善する上での影響は限定的であり、その能力は部分的にしか獲得されない(あるいはモデルの能力として獲得はされるが顕在化されづらい)ので、事後学習によってその能力をより強化して顕在化しやすくする、という感じの話に近いように感じる。
もしくは、あまり一般的な見立てではないかもしれないが、モデルの能力は事前学習時に身につけた能力を土台として、事後学習によってどの能力を強化するかが調整されていると仮定すると、事後学習を通じてcollapseしたモデルの執筆能力(事後学習では基本的になんらかのreasoning traceが出力され、執筆能力そのものにペナルティは課されないため、collapseしやすそう)を、高品質なサンプルから得られたルーブリックに基づくRLによって改善する、という位置付けとも捉えられるのかもしれない。
前者で考えると、たとえばコーディングエージェントの分野などでも、ガチガチのプログラマーのコードからルーブリックを学習し、そのルーブリックを通じて学習をすれば、(平均的なプログラマーの品質ではなく)ガチガチのプログラマーのようなお作法のコードを出力できるようになるのだろう。
となると、コーディング以外の様々な分野において広く適応しうる技術であり、平均的な出力から、特定の専門家レベルまで品質を引き上げるための枠組み(ただしデータが確保できてルーブリックとして表現可能なものに限る)、ともみなせるのかな、るという感想を抱いた。
Latent reasoning architectures would likely undermine CoT, our strongest oversight tool, REDWOOD RESEARCH, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Chain-of-Thought #Blog #Safety #LatentReasoning #reading #Monitorability #Author Thread-Post Issue Date: 2026-10-04 Comment
元ポスト:
本文でとりあげられているlatent reasoning architecture:
- [Paper Note] Training Large Language Models to Reason in a Continuous Latent Space, Shibo Hao+, COLM'25
- [Paper Note] Full-bandwidth transformer, Xi Wang+, arXiv'26, 2026.08
- [Paper Note] Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach, Jonas Geiping+, NeurIPS'25
解釈性に関するツール
- Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet, Anthropic, 2024.05
- Simple probes can catch sleeper agents, Anthropic, 2024.04
- Natural Language Autoencoders: Turning Claude’s thoughts into text, Anthropic, 2026.05
- How confessions can keep language models honest, OpenAI, 2025.12
ざっくりいうと現在のCoTは高度な推論を実施するために多くの場合必要なの挙動であり、危険のある行動(しばしば難しいタスク)を実施する際にはCoTによる思考がモデルにとって必要(CoTを実施しないと目的を達成できないため)で、これは目標の達成に必要に必ずしも必要でなくてもCoTを実施するような傾向とは区別すべきであり、latent reasoning系のアーキテクチャではCoTの必要性が薄れてしまう(また、モデルが正確な情報をCoTに言語化する傾向があるのは必要性があることに起因する可能性があり、必要性が薄れるとCoTに正確に言語化する傾向も弱くなるという)懸念がある。
この必要性によってCoTをモニタリングすることは現在AIの監視をする上で有用であるが、潜在空間上で推論を実施するlatent reasoning系のアーキテクチャに移行し必要性が薄れると、この有用性が損なわれ、Sparse Autoencoder, probing, natural language autoencoders, confession modelsなどの解釈性に関する手法は存在するが、CoTほど有用な信号を得ることができないため、AIを監視することが著しく困難となるだろう、という話のようである。
Dynamic 4-bit Quantization, Unsloth, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Quantization #Blog Issue Date: 2026-10-03 Comment
Dynamic Quantizationと呼ばれる全てのレイヤーに一律で量子化を適用するのではなく、選択的に適用する技術。
Dynamicときくと入力に応じて動的に量子化を変化させそうだが、そうではなく、全てのlayerに一律で量子化を適用するのではなく、モデルの性能を維持するために高精度な計算が必要なレイヤーは量子化せず、他は量子化するといった、量子化を適用するレイヤーを取捨選択するという意味合いでDynamicと命名されているようである。
たとえば下記の記事では、この技術を適用し
DeepSeek-R1の重みを80%(720GB->131GB)にまで削減。主にMoE layerは1.5 bit圧縮、特定のレイヤーは高い精度で保持。
https://unsloth.ai/blog/deepseekr1-dynamic
RUNTIME DYNAMIC COMPRESSION OF MIXTURE OF EXPERTS, Tim Dettmers, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Quantization #MoE(Mixture-of-Experts) #SoftwareEngineering #reading #needs-revision #Author Thread-Post Issue Date: 2026-10-03 Comment
元ポスト:
UnslothのDynamic Quantizationと比較して、同等のWikiTextでのPerplexityに到達する上で、1 weightあたり、0.4--1 bit程度削減可能な動的量子化手法で、WikiTextのPerplexityを維持しながら高い圧縮率を実現する。任意のlayerに対してレベルの異なる量子化とVRAM上から除去するexpertを割り当てて、推論中も動的に最適化することで、品質を保ちながら圧縮をかけるとのこと。bitsandsbytes2ライブラリに組み込まれる。
関連:
- Dynamic 4-bit Quantization, Unsloth, 2024.12
まだ読んでいる途中でもう少し要点を掴みたい
関連:
- dlab Open Source Week: Frontier AI on Your Own Hardware, Tim Dettmers, 2026.09
Decision models, SGLang, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Blog #LLMServing #VisionLanguageModel #Reading Reflections #SystemOneModel/DecisionModel Issue Date: 2026-09-30 Comment
元ポスト:
SGLangにおいて、Qwen3.8-27B、およびQwen3.5-35B-A3Bを、chat modelからdecision model(System Oneな分類モデル)として利用するためのエンドポイントが追加されたようである。
ドキュメントを読むと、要は既存のLLMに対してリクエストをreasoning modeをオフでprefillし、応答のトークン位置でのスコアリング、選択肢、yes/noのトークンのlogprobを取得し、たとえばyes/noトークンのprobabilityを計算する場合はyes/noの2 vocabularyのsoftmaxを計算する。つまり、単に通常のLLMの応答の開始位置でのラベルのlogprobを取得して、最もlogprobが高いラベルを返し上述の確率を返すというシンプルな実装に見える。
System Oneモデル向けの追加のチューニングや、分類headなどが学習されているわけではない(SGLangはLLM Servingエンジンでありモデルの学習そのものはしないだろうから、そりゃそうだ、という話だった)点に注意。シンプルに、LLMのデコード開始位置でのlogprobを用いた分類器であり、これを念頭におけば、このエンドポイントを利用した場合のおおよその性能の見当はつく(性能が悪いと言いたいわけではなく、これまでのLLM利用の経験からあたりをつけやすいという意図である)。
System One系の話は実装の中身を確認して、どのような原理の元駆動するかを確認しないと、足元をすくわれる気がする。外から見た時の挙動は同じでも、アーキテクチャが結構異なる気がする。あと、アーキテクチャだけでなく、System Oneモデル向けのデータや最適化がされているかによって、そもそもの予測性能やzero-shotでの汎化性能にかなり差が生まれるのではないか、と思っている。しかし、まあ結局自分たちのユースケースに対して必要な性能が出ていて、latencyが必要な水準に達しているかを確認すれば良いだけではある。
How much AI revenue comes from open vs closed models?, Konstantin F. Pilz, 2026.09
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #GenerativeAI #Post Issue Date: 2026-09-28 Comment
主要なクローズドモデル、オープンモデルを提供する企業の(おそらくLLM周りの)ARRを比較したところ、オープンモデルのARRはクローズドモデルのARRの10%程度と推察される、という話に見える。
が、オープンモデルのプロバイダーに対して、古いデータが使われている(プロバイダーによっては、usageが数倍〜10倍になっている)という指摘と、Googleの売上に対するAIの間接的な貢献「軽視しすぎている、という指摘がある。
あと、一部からClaudeに作成させ、検証をせずに読者側に検証の手間を委ねるのはいかがなものか、という趣旨の批判がある。
GPT-6 Astra Is the Best Vision Model We Have Tested, roboflow, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Analysis #ImageSegmentation #Blog #Reasoning #ComputerUse #VisionLanguageModel #2D (Image) #ObjectDetection Issue Date: 2026-09-27 Comment
元ポスト:
GPT-6-Astraに対して、Image Segmentation, Object Detection, counting, box prompt, counting, visual reasoning, re-identification(バスケットボールの動画を例に、選手を一貫して検知し共通のIDを付与できるか, 特に選手交代などにも対応できるか)などのさまざまなタスクでテストした結果が報告されている。結論としては、彼らがテストした中で最も強力なVisionモデルだが、コスト、latencyに関するトレードオフがあることが考察されており、特にリアルタイム処理には向いていないが、アノテーションなどのパッチ処理には価値があるだろうとしている。
Language Model "Shape", Alex Zhang, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #API #Architecture #Reading Reflections #AgentHarness Issue Date: 2026-09-27 Comment
元ポスト:
以下記事の内容の(意訳を含む)要約。詳しくは原文を参照のこと。
- 言語モデルの入出力の形状は、text-to-textのままで長年変化がなかった。
- 一方でJevの登場が話題となり、これは特定の特化型のタスクにおいてLLMより好まれる場面がありうる。
- Jevは出力が明示的に制約された場合の言語モデルととらえることができ、これによってモデルをprefillのみで、高速に質問に対して応答できるようにしている。
- また、AIエージェントは現在はReActに基づいた形式になっており、それはすなわち、エージェントがアクションを実行し、結果を観測し、それらがtrajectoryに蓄積され、次のアクションを決定するという構造となっている。
- デコーダのみのtransformerを考えたときに、全てのobservation, actionをコンテキストに入れるというのは自然である一方、履歴の圧縮などのcontext engineering技術が必要となる。これはそもそもエージェントのtrajectoryを処理するうえで、decoder-only transformerが最終的な形態ではなっていないから生じていると見ることもできる。
- たとえばAI agentに関して言うと、ツール呼び出し、時間経過に伴うobservationの扱い、アクションの重要性の減衰などに関してより強い仮定をおくことができ、最適な形態が存在する可能性がある。
- このような観点では、LLMに対してハーネスを適合させているが、ハーネスに対してLLMの形状を適合させることに価値があるか?という問いも自然に成り立つ。
- 特定のものに対してLLMの形状を適合させることで、環境・データ単位から得られる知能のgainやコスト・性能のトレードオフを改善できる可能性があり、これらは探求する価値があるだろう
という感じの話に見える。
この話に関連すると、Generative Recommender Systemなどは、推薦システムに対して適合していないなあ、という風に感じた場面があった。理由としては、
- decoder-only LLMはデコードの速度が遅く、latencyの制約が厳しいリアルタイム推薦などには根源的に不向き
- アイテムIDなどのシンボルは世界知識からは学習のしようがなく、そもそものmodel weightの中にそれらの情報を埋め込む必要がある場合は、ベースモデルに対して追加の学習が必要となる。これはアイテムが頻繁に入れ替わるようなシステムの場合は非常に相性が悪い。
といったものが主な原因である。たとえば、推薦システムに対して最適な形状とはなんだろうか?という視点で考えるとおもしろそうではある。
まあでもtwo tower modelはそもそも推薦タスクに特化した形状だよね、という風に考えると、よくわからなくなった。
しかしまあ整理すると、もともと各タスクには最適なモデルの形状が選択されてきた中で、その後にLLMが登場して多くのタスクがLLMによって代替できるようになった。LLMの強みはスケーリング則に基づく(ある程度予測可能な)性能の向上にあるわけで、このようなスケーリングは色々なタスクでおそらく模索されてこなかったであろう(機械翻訳についてはn-gramをスケーリングするとかはあったと思う)が、スケーリング則が成り立つという強みは残しつつ、各タスクごとに適合するような形状を模索するという思考の方向性になる、という感じだろうか(記事の主眼とずれている気がするが)。
- [Paper Note] Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, Jiaqi Zhai+, ICML'24, 2024.02
でDLRMよりも良好に計算量に対してスケールし、推論速度も高速なGenerative recommendationのモデルが検討されているようである。
LLMでprefillのみを実施し、その情報を用いて推薦するシステム
- [Paper Note] GenRec: An LLM-Backed Recommendation Ranker at Netflix, Ying Li+, arXiv'26, 2026.08
When does distillation help reinforcement learning?, Base Labs, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Blog #Distillation #PostTraining #read-later #Author Thread-Post Issue Date: 2026-09-25 Comment
元ポスト:
RL前にSFTを通じてオフポリシー蒸留をすることが、どれだけ後段のRL後のパフォーマンスに影響するかを調査したようで、
- 小規模モデルには効果的だが大規模なモデルには効果が薄く
- ベースモデルに存在しない慣習や理解を必要とするタスクに対して効果的で
- 副作用としてポリシーのエントロピーが低減する、すなわちRL中の探索が抑制される
といった知見が得られたようである。
一見すると、SLMに関しては
- [Paper Note] A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility, Andreas Hochlehnert+, COLM'25
と対立する知見に見えるが、前提として何が違うだろうか。
SLMに対しては同様の知見が示されている:
- [Paper Note] AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, Zihan Liu+, arXiv'25, 2025.06
FineEnvs: Open Source RL Environments for LLM Agents, Adithya S Kolavi, 2026.09
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #ReinforcementLearning #Repository #SmallModel #PostTraining #Environment Issue Date: 2026-09-25 Comment
元ポスト:
SLMのcoding, datascience向けの
(いわゆるSmolな)RL学習用の5k+のverifiableなタスクデータ、Environment、評価、学習のコードを提供。
従来の初心者向けのチュートリアルでは、GSM8Kのような既に飽和したデータセットが主なデータであり、より実用的なデータに基づいたRLVRのための環境を整えた、という感じに見える。
When Do Larger Batches Help Scale LLM Reinforcement Learning?, Tencent RL Team, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Blog #PostTraining #Selected Papers/Blogs #CriticalBatchSize Issue Date: 2026-09-24 Comment
元ポスト:
目標性能まで到達するまでに必要なwall-clock timeとLLMでのオンポリシーRLのバッチサイズの関係性を明らかにしているようである。
LLMのオンポリシーRLでは、生成と学習においてバッチサイズの大きさが非対称に働く(すなわち、生成側の並列数を増やすとモデルの重み転送をより多く共有できるため処理に要する時間が短縮されるが、学習側でバッチサイズが増えると処理時間は増加する)ため、生成側の並列数の変化によるスループットの向上と、学習側のバッチサイズによる更新に必要なサンプル数の両方を考える必要がある。
このとき、目標性能に到達するまでに必要な累積応答数N(学習側)、エンドツーエンドのスループットq(生成側だけではなくシステム全体)を考える。
これにより、バッチサイズを変化させた時に必要なサンプル数の変化の比率r_N (=N/N_pivot, r_Nが1より大きい場合は、新たなバッチサイズが基準となるバッチサイズよりも、ある性能に到達するまでより多くの応答を必要とする)、
スループットの変化の比率r_q(=q/q_pivot, r_q>1の場合は、1秒あたりにより多くの応答を処理できる)を定義でき、
r_q > r_Nの場合、すなわち、バッチサイズを大きくしたことによる、システムのエンドツーエンドのスループット向上による恩恵が、学習側のサンプルコストの悪化を上回った場合に、バッチサイズを大きくすることで学習が高速化される、このときの改善の度合いは r_N/r_q で測ることができる。例えば、r_N/r_q=0.8の場合、学習時間が20%削減されることを意味する、といったフレームワークを定義でき (The criterion部分を参照)、
実践的には、
- 候補となるバッチサイズについて、学習率や関連するハイパーパラメータを調整し、学習に利用される応答単位での学習に対する寄与を揃え、累積応答数が等しい点での学習曲線を比較することで、r_Nを推定し
- 与えられたバッチサイズにおいてシステムのスループットを最大化する設定を探索し、r_qを測定する
- その上で、r_N/r_qを測定し、最も学習時間が短縮されるバッチサイズを採用する
というプロセスにおとしこむことができる(conclusionを参照)
という感じの話のようにみえる。
grug-moe-mix-swarm, marin-community, 2026.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #MoE(Mixture-of-Experts) #Selected Papers/Blogs #DataMixture #Reading Reflections #Author Thread-Post Issue Date: 2026-09-24 Comment
元ポスト:
Marinの535B級のMoEモデルを学習した際のデータであり、利用されたツール(クラスタリングに利用されたモデル)も公開されている。
元ポスト中にデータ構築の手順が紹介されており、
- 学習が許可された152の公開データから、25Tトークンを利用
- deduplicationによる2.13T tokensを除外し
- 評価データとの重複を避けるために13-gramによるフィルタリングを実施し
- 特定の分野のデータ等をサンプリングしたいが、その際にソースではなくドキュメントの内容でグルーピングしたいので、embeddingに基づいてクラスタリングを実施し、200のクラスタを形成した
といった話が紹介されている。
LLM-jpではOpenSourceであるために、徹底的にデータセット内部まで精査をして、問題のあるインスタンスの修正等が実施されていたが、Marinではこのような取り組みは行われているのだろうか。特に、データセットに付与されているライセンスがオープンソースである場合でも、データセット、あるいはデータセット中のサンプルの出自を辿るとオープンソースとは呼べないものが存在するという話がある。
- 約12兆トークンの良質なコーパスで学習した新たな国産LLM「LLM-jp-4 8Bモデル」「LLM-jp-4 32B-A3Bモデル」をオープンソースライセンスで公開 ~一部ベンチマークでGPT-4oやQwen3-8Bを上回る性能を達成~, NII, 2026.04
- LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Marinコミュニティにおける"Open"の意味を読むと、Open Sourceの定義を満たすことを目指しているというより、weightを公開するだけではなく、その他の構築に関わる全ての情報を公開する、たとえば学習データであれば全データのソースを開示する、という開発プロセス全体を公開しますよ、という意味に見えるため、ライセンス的に問題のあるインスタンスの削除などは行われていないのかもしれない、が、Marinプロジェクトの公開されている全ての議論の中にそういった話題は存在するかもしれないので実際のところは一次ソースを当たらないとよくわからない。
https://marin.community
Marin-535B-A23Bの学習が折り返し地点を迎えたようで、ここまでの学びがスレッドに記載されている:
Jev Reproductions Tracker _ Decision Index, multimodalart, 2026.09
Paper/Blog Link My Issue
#Article #Survey #NLP #Evaluation #Selected Papers/Blogs #Author Thread-Post #SystemOneModel/DecisionModel Issue Date: 2026-09-20 Comment
元ポスト:
世の中に存在する多くのJev-likeなSystemOne、あるいはDecision Modelを包括的にまとめ、独自に構成されたベンチマークに基づくDecision Indexによってリーダーボードを公開されており、いまのところSystemOneModel, Decision Modelの動向を追うなら、ここが決定版という印象がある。
たとえば、Clefブログで公開されたLayaのベンチマークスコアの低さなどは、Decision Indexにも示されている。
- Introducing Clef: our open-source decision models, and new RL fine-tuning platform, Cloudflare, 2026.10
- laya, convaiinnovations, 2026.09
v0.4に更新され、プライベートなベンチマークのもでの評価となったようである:
Step 5 Preview: Advancing the Pareto Frontier, StepFun, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #Author Thread-Post Issue Date: 2026-09-20 Comment
元ポスト:
StepFunのフラグシップモデルで、Fable 5, GPT-5.6-luna, GLM-5.3、Kimi-K3と並びAAの評価においてパレート最適に位置する。
600B-A27B, 1M contextのVLM, 10/15にOpenWeight化されるとのこと。
decider-2b, Mapika, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #SmallModel #OpenWeight #reading #Reading Reflections #SystemOneModel/DecisionModel Issue Date: 2026-09-20 Comment
元ポスト:
こちらはJev系のモデルを謳うものと比較して、Qwenをベースにしており、かつ広範なタスクで評価がされているため、ある程度のzeroshotでの汎用モデルとは言えそうである。が、結局のところどこまで汎用的に使えるかはよくわからない。
関連:
- Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
cua-s1-forms, cua-ai, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Dataset #Transformer #SyntheticData #OpenWeight #ComputerUse #Encoder #Author Thread-Post Issue Date: 2026-09-19 Comment
github:
https://github.com/trycua/cua/tree/main/libs/cua-s1
dataset:
https://huggingface.co/datasets/cua-ai/cua-s1-forms
元ポスト:
フォーム入力に特化したCUAを実施できるモデルのようで、これもいわゆるSystem One Modelとして紹介されている。Transformer Encoderをバックボーンとする。
まあしかしこれは言ってしまえばただの合成データでFinetuningをしたBERTに見える。Jevのような様々なタスクに対してzero-shotの汎化をしめすものではないであろう点に注意。Jevがどれだけ汎用なのかはわからんが...
laya, convaiinnovations, 2026.09
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #MultiLingual #OpenWeight #Encoder #Reading Reflections Issue Date: 2026-09-19 Comment
元ポスト:
state (email, text, ticket, あるいはJSON)を与え、質問のタイプとinstruction(choice, score, noul)を与えると、質問に対応する出力を得られるModernBERTベースのモデル。questionあたり512トークンまで扱えるようである(state, question, optionの合計で512トークン)。RLCDと呼ばれるポリシーがdistributionを出力する手法で学習され、この手法はhonest probabilityを出力することで機体報酬が最大化されるとの記載がある。100+言語に対応。
emailのサンプル例は、ユーザからの問い合わせに対して、担当部署(choice)、緊急度(score)、解約の確率(noul)を出力する例となっている。
関連:
- Needle 3 Automation Foundation Model For Tiny Devices, Cactus, 2026.09
- Introducing System One Models & Jev, TypeSafe AI, 2026.09
これ系の話がいきなり増えてきた。マルチリンガルでモデルがオープンなのはありがたや。
最初読んだ時は様々なタスクやドメインにzero-shotで利用できるのかなと思ったが、emailドメインにしか適用できないのでは?zero-shotで汎用的に利用できないのであれば、それはただのFinetuningされたBERTである。
- Introducing Clef: our open-source decision models, and new RL fine-tuning platform, Cloudflare, 2026.10
- laya, convaiinnovations, 2026.09
などでは、本モデルを様々なベンチマークで測定したところスコアが低いことが報告されているため、利用する場合は注意が必要と思われる。
改めてページ全体を眺めると、最下部に下記記載がある:
> Honest Limits
> Base checkpoints are near chance on typed-decisions zero-shot — 0.362 here and 0.352 for multilingual, against a 0.318 random and 0.461 majority-class baseline. The 0.766 belongs to the checkpoint fine-tuned on that benchmark's own training split. Laya is a fast base to specialise, not a zero-shot decision engine.
特化型モデルを作るためのベースであり、zero-shotでのdecision engineではない、というlimitationが記載されている。