
Reasoning (378) — 2/2
[Paper Note] Direct Reasoning Optimization: LLMs Can Reward And Refine Their Own Reasoning for Open-Ended Tasks, Yifei Xu+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel Issue Date: 2025-06-18 GPT Summary- DRO(直接推論最適化)を提案し、LLMsをオープンエンドの長文推論タスクに微調整するための強化学習フレームワークを構築。新しい報酬信号R3を用いて推論と参照結果の一貫性を捉え、自己完結したトレーニングを実現。ParaRevとFinQAのデータセットで強力なベースラインを上回る性能を示し、広範な適用可能性を確認。 Comment
元ポスト:
[Paper Note] Wait, We Don't Need to "Wait" Removing Thinking Tokens Improves Reasoning Efficiency, Chenlong Wang+, EMNLP'25 Findings
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Chain-of-Thought #EMNLP #One-Line Notes Issue Date: 2025-06-18 GPT Summary- 自己反省を抑制する「NoWait」アプローチを提案し、推論の効率を向上。10のベンチマークで最大27%-51%の思考の連鎖の長さを削減し、有用性を維持。マルチモーダル推論のための効果的なソリューションを提供。 Comment
Wait, Hmmといったlong CoTを誘導するようなtokenを抑制することで、Accはほぼ変わらずに生成されるトークン数を削減可能、といった図に見える。Reasoningモデルでデコーディング速度を向上したい場合に効果がありそう。
元ポスト:
[Paper Note] Overclocking LLM Reasoning: Monitoring and Controlling Thinking Path Lengths in LLMs, Roy Eisenstadt+, arXiv'25
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel Issue Date: 2025-06-17 GPT Summary- LLMの推論プロセスにおける思考段階の長さを調整するメカニズムを探求。進捗をエンコードし、可視化することで計画ダイナミクスを明らかにし、不要なステップを減らす「オーバークロッキング」手法を提案。これにより、考えすぎを軽減し、回答精度を向上させ、推論のレイテンシを減少させることを実証。コードは公開。 Comment
元ポスト:
[Paper Note] Give Me FP32 or Give Me Death? Challenges and Solutions for Reproducible Reasoning, Jiayi Yuan+, arXiv'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Reproducibility Issue Date: 2025-06-13 GPT Summary- 本研究では、大規模言語モデル(LLMs)のパフォーマンスの再現性が脆弱であることを示し、システム構成の変更が応答に大きな影響を与えることを明らかにしました。特に、初期トークンの丸め誤差が推論精度に波及する問題を指摘し、浮動小数点演算の非結合的性質が変動の根本原因であるとしています。様々な条件下での実験を通じて、数値精度が再現性に与える影響を定量化し、評価実践における重要性を強調しました。さらに、LayerCastという軽量推論パイプラインを開発し、メモリ効率と数値安定性を両立させる方法を提案しました。
[Paper Note] SynLogic: Synthesizing Verifiable Reasoning Data at Scale for Learning Logical Reasoning and Beyond, Junteng Liu+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #SyntheticData #NeurIPS #One-Line Notes #Author Thread-Post Issue Date: 2025-06-06 GPT Summary- SynLogicは、35の論理的推論タスクを網羅したデータ合成フレームワークで、強化学習(RL)による大規模言語モデル(LLMs)の推論能力向上を目指す。調整可能な難易度で生成されたデータは検証可能で、RLに適している。実験では、SynLogicが最先端の論理的推論性能を達成し、数学やコーディングタスクとの混合によりトレーニング効率が向上することが示された。SynLogicはLLMsの推論能力向上に貴重なリソースとなる。 Comment
元ポスト:
35種類のタスクを人手で選定し、タスクごとに困難度の鍵となるパラメータを定義(数独ならばグリッド数など)。その上で、各タスクごとに人手でルールベースのinstanceを生成するコードを実装し、さまざまな困難度パラメータに基づいて多様なinstanceを生成。生成されたinstanceの困難度は、近似的なUpper Bound(DeepSeek-R1, o3-miniのPass@10)とLower bound(chat model[^1]でのPass@10)を求めデータセットに含まれるinstanceの困難度をコントロールし、taskを記述するpromptも生成。タスクごとに人手で実装されたVerifierも用意されている。
Qwen2.5-7B-BaseをSynDataでDAPOしたところ、大幅にlogic benchmarkとmathematical benchmarkの性能が改善。
mathやcodeのデータとmixして7Bモデルを訓練したところ、32Bモデルに匹敵する性能を達成し、SynDataをmixすることでgainが大きくなったので、SynDataから学習できる能力が汎化することが示唆される。
タスク一覧はこちら
[^1]:どのchat modelかはざっと見た感じわからない。どこかに書いてあるかも。
Logical Reasoningが重要なタスクを扱う際はこのデータを活用することを検討してみても良いかもしれない
[Paper Note] BIG-Bench Extra Hard, Mehran Kazemi+, ACL'25, 2025.02
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #ACL #One-Line Notes Issue Date: 2025-06-01 GPT Summary- 大規模言語モデル(LLMs)の推論能力を評価するための新しいベンチマーク、BIG-Bench Extra Hard(BBEH)を導入。これは、既存のBIG-Bench Hard(BBH)のタスクを新しいものに置き換え、難易度を大幅に引き上げることで、LLMの限界を押し広げることを目的としている。評価の結果、最良の汎用モデルで9.8%、推論専門モデルで44.8%の平均精度が観察され、LLMの一般的推論能力向上の余地が示された。BBEHは公開されている。 Comment
Big-Bench hard(既にSoTAモデルの能力差を識別できない)の難易度をさらに押し上げたデータセット。
Inputの例
タスクごとのInput, Output lengthの分布
現在の主要なモデル群の性能
Big-Bench論文はこちら:
- [Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
[Paper Note] Learning to Reason without External Rewards, Xuandong Zhao+, ICML'25 Workshop AI4MATH
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #ICML #Workshop #One-Line Notes #Author Thread-Post Issue Date: 2025-05-27 GPT Summary- 本研究では、外部の報酬やラベルなしで大規模言語モデル(LLMs)が学習できるフレームワーク「内部フィードバックからの強化学習(RLIF)」を提案。自己確信を報酬信号として用いる「Intuitor」を開発し、無監視の学習を実現。実験結果は、Intuitorが数学的ベンチマークで優れた性能を示し、ドメイン外タスクへの一般化能力も高いことを示した。内因的信号が効果的な学習を促進する可能性を示唆し、自律AIシステムにおけるスケーラブルな代替手段を提供。 Comment
元ポスト:
おもしろそう
externalなsignalをrewardとして用いないで、モデル自身が内部的に保持しているconfidenceを用いる。人間は自信がある問題には正解しやすいという直感に基づいており、openendなquestionのようにそもそも正解シグナルが定義できないものもあるが、そういった場合に活用できるようである。
self-trainingの考え方に近いのでは
ベースモデルの段階である程度能力が備わっており、post-trainingした結果それが引き出されるようになったという感じなのだろうか。
参考:
解説スライド:
https://www.docswell.com/s/DeepLearning2023/KYVLG4-2025-09-18-112951
元ポスト:
[Paper Note] AdaCoT: Pareto-Optimal Adaptive Chain-of-Thought Triggering via Reinforcement Learning, Chenwei Lou+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #ReinforcementLearning #Chain-of-Thought #One-Line Notes Issue Date: 2025-05-21 GPT Summary- AdaCoTは、LLMがChain-of-Thought(CoT)の使用を適応的に決定する新しい枠組み。これにより、計算コストや非効率性を軽減しつつ、複雑なクエリにおける推論性能を維持する。特にProximal Policy Optimization(PPO)を用いたRL手法を導入し、Selective Loss Masking(SLM)で推論トリガを安定させ、実験ではCoTトリガー率を最大3.18%削減、応答トークン数を69.06%削減したことが示された。 Comment
RLのRewardにおいて、baseのリワードだけでなく、
- reasoningをなくした場合のペナルティ項
- reasoningをoveruseした場合のペナルティ項
- formattingに関するペナルティ項
を設定し、reasoningの有無を適切に判断できた場合にrewardが最大化されるような形にしている。(2.2.2)
が、multi-stageのRLでは(stageごとに利用するデータセットを変更するが)、データセットの分布には歪みがあり、たとえば常にCoTが有効なデータセットも存在しており(数学に関するデータなど)、その場合常にCoTをするような分布を学習してしまい、AdaptiveなCoT decisionが崩壊したり、不安定になってしまう(decision boundary collapseと呼ぶ)。特にこれがfinal stageで起きると最悪で、これまでAdaptiveにCoTされるよう学習されてきたものが全て崩壊してしまう。これを防ぐために、Selective Loss Maskingというlossを導入している。具体的には、decision token [^1]のlossへの貢献をマスキングするようにすることで、CoTが生じるratioにバイアスがかからないようにする。今回は、Decision tokenとして、`
[^1]: CoTするかどうかは多くの場合このDecision Tokenによって決まる、といったことがどっかの研究に示されていたはず
いつか必要になったらしっかり読むが、全てのステージでSelective Loss Maskingをしたら、SFTでwarm upした段階からあまりCoTのratioが変化しないような学習のされ方になる気がするが、どのステージに対してapplyするのだろうか。
openreview: https://openreview.net/forum?id=obXGSmmG70
[Paper Note] Follow the Path: Reasoning over Knowledge Graph Paths to Improve LLM Factuality, Mike Zhang+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #QuestionAnswering #KnowledgeGraph #Factuality #Test-Time Scaling #PostTraining Issue Date: 2025-05-20 GPT Summary- fs1は、大規模推論モデルから推論経路を取得し、知識グラフに条件付けて事実性を向上させる手法を提案する。8つのLLMをファインチューニングし、6つの複雑なQAベンチマークで評価した結果、fs1調整モデルは他モデルを一貫して上回り、特に複雑な質問での性能向上が顕著だった。従来研究の枠を超え、推論経路をKGに結び付けることが信頼性の高いタスクにおいて重要であることを示した。 Comment
元ポスト:
[Paper Note] Tina: Tiny Reasoning Models via LoRA, Shangshang Wang+, arXiv'25
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #ReinforcementLearning #SmallModel #PEFT(Adaptor/LoRA) #GRPO #read-later #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-07 GPT Summary- Tinaは、コスト効率よく強力な推論能力を実現する小型の推論モデルファミリーであり、1.5Bパラメータのベースモデルに強化学習を適用することで高い推論性能を示す。Tinaは、従来のSOTAモデルと競争力があり、AIME24で20%以上の性能向上を達成し、トレーニングコストはわずか9ドルで260倍のコスト削減を実現。LoRAを通じた効率的なRL推論の効果を検証し、すべてのコードとモデルをオープンソース化している。 Comment
元ポスト:
(おそらく)Reasoningモデルに対して、LoRAとRLを組み合わせて、reasoning能力を向上させた初めての研究
[Paper Note] Thinking LLMs: General Instruction Following with Thought Generation, Tianhao Wu+, ICML'25, 2024.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ICML #DPO #PostTraining #KeyPoint Notes #Author Thread-Post Issue Date: 2025-05-07 GPT Summary- LLMsに思考能力を装備するための訓練方法を提案。反復的な検索と最適化手順を用いて、モデルが監視なしで思考する方法を学ぶ。指示に対する思考候補はジャッジモデルで評価され、最適化される。この手法はAlpacaEvalとArena-Hardで優れたパフォーマンスを示し、推論タスクだけでなく、マーケティングや健康などの非推論カテゴリでも利点を発揮。 Comment
元ポスト:
外部のCoTデータを使わないで、LLMのreasoning capabilityを向上させる話っぽい。DeepSeek-R1の登場以前の研究とのこと。
"reasoning traceを出力するように" Instruction Tuningによって回答を直接出力するようPostTrainingされたモデルにpromptingし、複数のoutputを収集(今回は8個, temperature=0.8, top p=0.95)。Self Taught Evaluator [Paper Note] Self-Taught Evaluators, Tianlu Wang+, arXiv'24, 2024.08
(STE;70B, LLM-as-a-Judgeを利用するモデル)、あるいはArmo Reward Model(8B)によって回答の品質をスコアリング。ここで、LLM-as-a-Judgeの場合はペアワイズでの優劣が決まるだけなので、ELOでスコアリングする。outputのうちbest scoreとworst scoreだったものの双方でペアデータを構築し、DPOで利用するpreferenceペアデータを構築しDPOする。このような処理を繰り返し、モデルの重みをiterationごとに更新する。次のiterationでは更新されたモデルで同様の処理を行い、前段のステップで利用した学習データは利用しないようにする(後段の方が品質が高いと想定されるため)。また、回答を別モデルで評価する際に、長いレスポンスを好むモデルの場合、長い冗長なレスポンスが高くスコアリングされるようなバイアスが働く懸念があるため、長すぎる回答にpenaltyを与えている(Length-Control)。
reasoning traceを出力するpromptはgenericとspecific thoughtの二種類で検証。前者はLLMにどのような思考をするかを丸投げするのに対し、後者はこちら側で指定する。後者の場合は、どのような思考が良いかを事前に知っていなければならない。
Llama-3-8b-instructに適用したところ、70Bスケールのモデルよりも高い性能を達成。また、reasoning trace出力をablationしたモデル(Direct responce baseline)よりも性能が向上。
iterationが進むに連れて、性能が向上している。
[Paper Note] 100 Days After DeepSeek-R1: A Survey on Replication Studies and More Directions for Reasoning Language Models, Chong Zhang+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Survey #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #InstructionTuning #Actor-Critic #LongContext #RewardHacking #GRPO #Contamination-free #VerifiableRewards #CurriculumLearning #One-Line Notes Issue Date: 2025-05-06 GPT Summary- RLMの進展は新しい言語モデルの進化を示し、DeepSeek-R1のリリースが社会的影響を生んでいる。DeepSeekの実装は完全にオープンではないが、多くの再現研究が登場し、同等の性能を達成。特にSFTとRLVRに重点を置き、データ構築や手法設計に関する知見を提供。実装の詳細と実験結果をまとめ、RLMの性能向上技術や開発課題についても議論。研究者が最新の進展を把握し、新しいアイデアを促進することを目指す。 Comment
元ポスト:
サーベイのtakeawayが箇条書きされている。
[Paper Note] Phi-4-reasoning Technical Report, Marah Abdin+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #SmallModel #OpenWeight #GRPO #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2025-05-01 GPT Summary- 140億パラメータの推論モデルPhi-4-reasoningは、慎重に選ばれた「teachable」プロンプトセットと監視付きファインチューニングを通じて訓練され、詳細な推論チェーンを生成します。そのバリエーションであるPhi-4-reasoning-plusは、短期間の強化学習を経て、より長い推論トレースを生成し高性能を実現。これらのモデルは、DeepSeek-R1-Distill-Llama-70Bモデルを超え、完全版DeepSeek-R1に近い性能を示します。評価は数学的・科学的推論や一般目的のベンチマークを含み、データ精選の利点と強化学習の影響を示唆しています。 Comment
元ポスト:
こちらの解説が非常によくまとまっている:
が、元ポストでもテクニカルペーパー中でもo3-miniのreasoning traceをSFTに利用してCoTの能力を強化した旨が記述されているが、これはOpenAIの利用規約に違反しているのでは…?
[Paper Note] UI-TARS: Pioneering Automated GUI Interaction with Native Agents, Yujia Qin+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#ComputerVision #NLP #AIAgents #MultiModal #Blog #OpenWeight #ComputerUse #VisionLanguageModel #2D (Image) #One-Line Notes #text Issue Date: 2025-04-18 GPT Summary- UI-TARSは、スクリーンショットを入力として人間のような操作を行うエンドツーエンドのGUIエージェントモデルである。従来の商用モデルに依存せず、知覚、グラウンディング、GUIタスク実行において最先端の性能を発揮。OSWorldベンチマークでは、UI-TARSが高スコアを達成し、他のモデルを上回る。主要な革新には、強化された知覚、統一されたアクションモデリング、System-2推論、反省的オンライン・トレースによる反復的トレーニングが含まれる。これにより、UI-TARSは未知の状況にも適応可能な学習能力を持つ。GUIエージェントの進化経路も分析し、今後の発展を探る。 Comment
色々と書いてあるが、ざっくり言うとByteDanceによる、ImageとTextをinputとして受け取り、TextをoutputするマルチモーダルLLMによるComputer Use Agent (CUA)
関連
- OpenAI API での Computer use の使い方, npaka, 2025.03
元ポスト:
d1: Scaling Reasoning in Diffusion Large Language Models via Reinforcement Learning, Siyan Zhao+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #DiffusionModel #PostTraining #GRPO #KeyPoint Notes Issue Date: 2025-04-18 GPT Summary- d1というフレームワークを提案し、マスク付きdLLMsを教師ありファインチューニングと強化学習で推論モデルに適応。マスク付きSFT技術で知識を抽出し、diffu-GRPOという新しいRLアルゴリズムを導入。実証研究により、d1が最先端のdLLMの性能を大幅に向上させることを確認。 Comment
元ポスト:
dLLMに対してGRPOを適用する手法(diffuGRPO)を提案している。
long CoTデータでSFTしてreasoning capabilityを強化した後、diffuGRPOで追加のpost-trainingをしてさらに性能をboostする。
GRPOではtoken levelの尤度とsequence全体の尤度を計算する必要があるが、dLLMだとautoregressive modelのようにchain ruleを適用する計算方法はできないので、効率的に尤度を推定するestimatorを用いてGPPOを適用するdiffuGRPOを提案している。
diffuGRPO単体でも、8BモデルだがSFTよりも性能向上に成功している。SFTの後にdiffuGRPOを適用するとさらに性能が向上する。
SFTではs1 [Paper Note] s1: Simple test-time scaling, Niklas Muennighoff+, EMNLP'25, 2025.01
で用いられたlong CoTデータを用いている。しっかり理解できていないが、diffuGRPO+verified rewardによって、long CoTの学習データを用いなくても、安定してreasoning能力を発揮することができようになった、ということなのだろうか?
しかし、AppendixCを見ると、元々のLLaDAの時点でreasoning traceを十分な長さで出力しているように見える。もしLLaDAが元々long CoTを発揮できたのだとしたら、long CoTできるようになったのはdiffuGRPOだけの恩恵ではないということになりそうだが、LLaDAは元々long CoTを生成できるようなモデルだったんだっけ…?その辺追えてない(dLLMがメジャーになったら追う)。
[Paper Note] Seed1.5-Thinking: Advancing Superb Reasoning Models with Reinforcement Learning, ByteDance Seed+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #One-Line Notes #Initial Impression Notes Issue Date: 2025-04-12 GPT Summary- Seed1.5-Thinkingは、応答前に思考を経て推論する新しい手法で、AIME 2024で86.7、Codeforcesで55.0、GPQAで77.3といった性能を達成。非推論タスクでも優れた一般化能力を発揮し、DeepSeek R1を勝率で8%上回る。比較的小型の専門家の混成モデルで、200億の活性化パラメータと2000億の総パラメータを持つ。新たな内部ベンチマークBeyondAIMEとCodeforcesも公開予定。 Comment
DeepSeek-R1を多くのベンチで上回る200B, 20B activated paramのreasoning model
最近のテキストのOpenWeightLLMはAlibaba, DeepSeek, ByteDance, Nvidiaの4強という感じかな…?(そのうちOpenAIがオープンにするReasoning Modelも入ってきそう)。
[Paper Note] VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks, Yu Yue+, arXiv'25, 2025.04
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #ReinforcementLearning #LongContext #Initial Impression Notes Issue Date: 2025-04-08 GPT Summary- VAPO(価値ベースの拡張近接ポリシー最適化フレームワーク)は、推論モデルに特化した新しいフレームワークを提案し、AIME 2024データセットで最先端のスコア60.4を達成。VAPOは従来手法を10ポイント以上上回り、わずか5,000ステップで安定した性能を実現。長い連鎖思考推論における課題を特定し、体系的な設計で効果的に対処することで、性能向上に寄与することを示した。 Comment
同じくByteDanceの
- [Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
を上回る性能
元ポスト:
以下のブログで紹介されている:
- Reinforcement Learning from Human Feedback, Nathan Lambert, 2026.03
[Paper Note] RALLRec+: Retrieval Augmented Large Language Model Recommendation with Reasoning, Sichun Luo+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#RecommenderSystems #CollaborativeFiltering #NLP #LanguageModel #RAG(RetrievalAugmentedGeneration) #Initial Impression Notes Issue Date: 2025-03-27 GPT Summary- RALLRec+は、LLMsを用いてレコメンダーシステムのretrievalとgenerationを強化する手法。retrieval段階では、アイテム説明を生成し、テキスト信号と協調信号を結合。生成段階では、推論LLMsを評価し、知識注入プロンプティングで汎用LLMsと統合。実験により、提案手法の有効性が確認された。 Comment
元ポスト:
Reasoning LLMをRecSysに応用する初めての研究(らしいことがRelated Workに書かれている)
arxivのadminより以下のコメントが追記されている
> arXiv admin note: substantial text overlap with arXiv:2502.06101
コメント中の研究は下記である
- [Paper Note] ReLLa: Retrieval-enhanced Large Language Models for Lifelong Sequential Behavior Comprehension in Recommendation, Jianghao Lin+, WWW'24
[Paper Note] Thinking Machines: A Survey of LLM based Reasoning Strategies, Dibyanayan Bandyopadhyay+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Initial Impression Notes Issue Date: 2025-03-23 GPT Summary- 大規模言語モデル(LLMs)は優れた言語能力を持つが、推論能力との間にギャップがある。推論はAIの信頼性を高め、医療や法律などの分野での適用に不可欠である。最近の強力な推論モデルの登場により、LLMsにおける推論の研究が重要視されている。本論文では、既存の推論技術の概要と比較を行い、推論を備えた言語モデルの体系的な調査と現在の課題を提示する。 Comment
元ポスト:
RL, Test Time Compute, Self-trainingの3種類にカテゴライズされている。また、各カテゴリごとにより細分化されたツリーが論文中にある。
[Paper Note] Compute Optimal Scaling of Skills: Knowledge vs Reasoning, Nicholas Roberts+, ACL'25 Findings, 2025.03
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #ACL #Scaling Laws #Selected Papers/Blogs #Memorization #Findings #Initial Impression Notes Issue Date: 2025-03-23 GPT Summary- スケーリング法則はLLM開発において重要であり、特に計算最適化によるトレードオフが注目されている。本研究では、スケーリング法則が知識や推論に基づくスキルに依存することを示し、異なるデータミックスがスケーリング挙動に与える影響を調査した。結果、知識とコード生成のスキルは根本的に異なるスケーリング挙動を示し、誤指定された検証セットが計算最適なパラメータ数に約50%の影響を与える可能性があることが明らかになった。 Comment
元ポスト:
知識を問うQAのようなタスクはモデルのパラメータ量が必要であり、コーディングのようなReasoningに基づくタスクはデータ量が必要であり、異なる要素に依存してスケールすることを示している研究のようである。
直感的な理解としては、
多くの知識はMLP(だけではないが)に格納されているとされており、1パラメータあたりに格納可能な知識量がある程度決まっているため、知識が必要なタスクはパラメータ数が必要であり、
Reasoningのようなタスクはどれだけ学習データ側でReasoningのパターンを学習できるかに性能が依存するため、データ量が必要、
というものになるのかなという気がする。
[Paper Note] Understanding R1-Zero-Like Training: A Critical Perspective, Zichen Liu+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #GRPO #read-later #KeyPoint Notes Issue Date: 2025-03-22 GPT Summary- DeepSeek-R1-Zeroは、RLを用いてLLMsの推論能力を向上させる手法を示した。本研究では、ベースモデルとRLの影響を分析し、DeepSeek-V3-Baseが「アハ体験」を示す一方で、Qwen2.5が強力な推論能力を持つことを発見。GRPOの最適化バイアスを特定し、Dr. GRPOを導入してトークン効率を改善。7BベースモデルでAIME 2024において43.3%の精度を達成するR1-Zeroレシピを提案。 Comment
関連研究:
- [Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
解説ポスト:
解説ポスト(と論文中の当該部分)を読むと、
- オリジナルのGRPOの定式では2つのバイアスが生じる:
- response-level length bias: 1/|o_i| でAdvantageを除算しているが、これはAdvantageが負の場合(つまり、誤答が多い場合)「長い応答」のペナルティが小さくなるため、モデルが「長い応答」を好むバイアスが生じる。一方で、Advantageが正の場合(正答)は「短い応答」が好まれるようになる。
- question-level difficulty bias: グループ内の全ての応答に対するRewardのstdでAdvantageを除算しているが、stdが小さくなる問題(すなわち、簡単すぎるor難しすぎる問題)をより重視するような、問題に対する重みづけによるバイアスが生じる。
- aha moment(self-seflection)はRLによって初めて獲得されたものではなく、ベースモデルの時点で獲得されており、RLはその挙動を増長しているだけ(これはX上ですでにどこかで言及されていたなぁ)。
- これまではoutput lengthを増やすことが性能改善の鍵だと思われていたが、この論文では必ずしもそうではなく、self-reflection無しの方が有りの場合よりもAcc.が高い場合があることを示している(でもぱっと見グラフを見ると右肩上がりの傾向ではある)
といった知見がある模様
あとで読む
(参考)Dr.GRPOを実際にBig-MathとQwen-2.5-7Bに適用したら安定して収束したよというポスト:
[Paper Note] Stop Overthinking: A Survey on Efficient Reasoning for Large Language Models, Yang Sui+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Survey #EfficiencyImprovement #NLP #LanguageModel #Overthinking #One-Line Notes Issue Date: 2025-03-22 GPT Summary- 本論文では、LLMsにおける効率的な推論の進展を体系的に調査し、以下の主要な方向に分類します:(1) モデルベースの効率的推論、(2) 推論出力ベースの効率的推論、(3) 入力プロンプトベースの効率的推論。特に、冗長な出力による計算オーバーヘッドを軽減する方法を探求し、小規模言語モデルの推論能力や評価方法についても議論します。 Comment
Reasoning Modelにおいて、Over Thinking現象(不要なreasoning stepを生成してしまう)を改善するための手法に関するSurvey。
下記Figure2を見るとよくまとまっていて、キャプションを読むとだいたい分かる。なるほど。
Length Rewardについては、
- [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
で考察されている通り、Reward Hackingが起きるので設計の仕方に気をつける必要がある。
元ポスト:
各カテゴリにおけるliteratureも見やすくまとめられている。必要に応じて参照したい。
[Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #ReinforcementLearning #LongContext #NeurIPS #GRPO #read-later #Selected Papers/Blogs #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2025-03-20 GPT Summary- 推論スケーリングによりLLMの推論能力が向上し、強化学習が複雑な推論を引き出す技術となる。しかし、最先端の技術詳細が隠されているため再現が難しい。そこで、$\textbf{DAPO}$アルゴリズムを提案し、Qwen2.5-32Bモデルを用いてAIME 2024で50ポイントを達成。成功のための4つの重要技術を公開し、トレーニングコードと処理済みデータセットをオープンソース化することで再現性を向上させ、今後の研究を支援する。 Comment
既存のreasoning modelのテクニカルレポートにおいて、スケーラブルなRLの学習で鍵となるレシピは隠されていると主張し、実際彼らのbaselineとしてGRPOを走らせたところ、DeepSeekから報告されているAIME2024での性能(47ポイント)よりもで 大幅に低い性能(30ポイント)しか到達できず、分析の結果3つの課題(entropy collapse, reward noise, training instability)を明らかにした(実際R1の結果を再現できない報告が多数報告されており、重要な訓練の詳細が隠されているとしている)。
その上で50%のtrainikg stepでDeepSeek-R1-Zero-Qwen-32Bと同等のAIME 2024での性能を達成できるDAPOを提案。そしてgapを埋めるためにオープンソース化するとのこと。
ちとこれはあとでしっかり読みたい。重要論文。
プロジェクトページ:
https://dapo-sia.github.io/
こちらにアルゴリズムの重要な部分の概要が説明されている。
解説ポスト:
コンパクトだが分かりやすくまとまっている。
下記ポストによると、Reward Scoreに多様性を持たせたい場合は3.2節参照とのこと。
すなわち、Dynamic Samplingの話で、Accが全ての生成で1.0あるいは0.0となるようなpromptを除外するといった方法の話だと思われる。
これは、あるpromptに対する全ての生成で正解/不正解になった場合、そのpromptに対するAdvantageが0となるため、ポリシーをupdateするためのgradientも0となる。そうすると、このサンプルはポリシーの更新に全く寄与しなくなるため、同バッチ内のノイズに対する頑健性が失われることになる。サンプル効率も低下する。特にAccが1.0になるようなpromptは学習が進むにつれて増加するため、バッチ内で学習に有効なpromptは減ることを意味し、gradientの分散の増加につながる、といったことらしい。
関連ポスト:
色々な研究で広く使われるのを見るようになった。
著者ポスト:
[Paper Note] The First Few Tokens Are All You Need: An Efficient and Effective Unsupervised Prefix Fine-Tuning Method for Reasoning Models, Ke Ji+, NeurIPS'25, 2025.03
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #NeurIPS #KeyPoint Notes #Reading Reflections Issue Date: 2025-03-19 GPT Summary- 非教師ありプレフィックスファインチューニング(UPFT)を提案し、LLMの推論効率を向上。初期のプレフィックス部分文字列に基づいて訓練し、ラベル付きデータやサンプリングを不要に。UPFTは、教師あり手法と同等の性能を維持しつつ、訓練時間を75%、サンプリングコストを99%削減。最小限の非教師ありファインチューニングで大幅な推論向上を実現し、リソース効率の良い代替手段を提供。 Comment
斜め読みだが、reasoning traceの冒頭部分は重要な役割を果たしており、サンプリングした多くのresponseのreasoning traceにおいて共通しているものは重要という直感から(Prefix Self-Consistency)、reasoning traceの冒頭部分を適切に生成できるようにモデルをFinetuningする。従来のRejection Samplingを用いた手法では、複数のresponseを生成させて、最終的なanswerが正解のものをサンプリングするため正解ラベルが必要となるが、提案手法ではreasoning traceの冒頭部分の共通するsubsequenceをmajority voteするだけなのでラベルが不要である。
reasoning prefixを学習する際は下記のようなテンプレートを用いる。このときに、prefixのspanのみを利用して学習することで大幅に学習時間を削減できる。
また、そのような学習を行うとcatastrophic forgettingのリスクが非常に高いが、これを防ぐために、マルチタスクラーニングを実施する。具体的には学習データのp%については全体のreasoning traceを生成して学習に利用する。このときに、最終的な回答の正誤を気にせずtraceを生成して学習に利用することで、ラベルフリーな特性を維持できる(つまり、こちらのデータは良いreasoning traceを学習することを目的としているわけではなく、あくまでcatastrophic forgettingを防ぐためにベースモデルのようなtraceもきちんと生成できれば良い、という感覚だと思われる)。
AppendixにQwenを用いてtemperature 0.7で16個のresponseをサンプリングし、traceの冒頭部分が共通している様子が示されている。
下記論文でlong-CoTを学習させる際のlong-CoTデータとして、reasoningモデルから生成したtraceと非reasoning modelから生成したtraceによるlong-CoTデータを比較したところ前者の方が一貫して学習性能が良かったとあるが、この研究でもreasoning traceをつよつよモデルで生成したら性能上がるんだろうか。
- [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
[Paper Note] A Survey on Post-training of Large Language Models, Guiyao Tie+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Supervised-FineTuning (SFT) #Initial Impression Notes Issue Date: 2025-03-15 GPT Summary- 大規模言語モデル(LLMs)は自然言語処理に革命をもたらしたが、専門的な文脈での制約が明らかである。これに対処するため、高度なポストトレーニング言語モデル(PoLMs)が必要であり、本論文ではその包括的な調査を行う。ファインチューニング、アライメント、推論、効率、統合と適応の5つのコアパラダイムにわたる進化を追跡し、PoLMがバイアス軽減や推論能力向上に寄与する方法を示す。研究はPoLMの進化に関する初の調査であり、将来の研究のための枠組みを提供し、LLMの精度と倫理的堅牢性を向上させることを目指す。 Comment
Post Trainingの時間発展の図解が非常にわかりやすい(が、厳密性には欠けているように見える。当該モデルの新規性における主要な技術はこれです、という図としてみるには良いのかもしれない)。
個々の技術が扱うスコープとレイヤー、データの性質が揃っていない気がするし、それぞれのLLMがy軸の単一の技術だけに依存しているわけでもない。が、厳密に図を書いてと言われた時にどう書けば良いかと問われると難しい感はある。
元ポスト:
[Paper Note] LLM Post-Training: A Deep Dive into Reasoning Large Language Models, Komal Kumar+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Supervised-FineTuning (SFT) #Initial Impression Notes Issue Date: 2025-03-04 GPT Summary- LLMは自然言語処理に革命をもたらし、ポストトレーニング手法に焦点を移しつつある。これにより、推論や事実の正確性が向上し、ユーザー意図に合わせた整合が可能に。ファインチューニングや強化学習が性能最適化に寄与し、実世界タスクへの適応力も向上。調査では、ポストトレーニング手法の重要性と、壊滅的忘却や報酬の改ざんへの対策が論じられ、新たな研究方向が提案されている。さらに、分野の進展を追跡するリポジトリも提供。 Comment
非常にわかりやすい。
元ポスト:
[Paper Note] From System 1 to System 2: A Survey of Reasoning Large Language Models, Zhong-Zhi Li+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel Issue Date: 2025-02-26 GPT Summary- 人間レベルの知能を達成するためには、迅速なシステム1から意図的なシステム2への推論の洗練が必要。基盤となる大規模言語モデル(LLMs)は迅速な意思決定に優れるが、複雑な推論には深さが欠ける。最近の推論LLMはシステム2の意図的な推論を模倣し、人間のような認知能力を示している。本調査では、LLMの進展とシステム2技術の初期開発を概観し、推論LLMの構築方法や特徴、進化を分析。推論ベンチマークの概要を提供し、代表的な推論LLMのパフォーマンスを比較。最後に、推論LLMの進展に向けた方向性を探り、最新の開発を追跡するためのGitHubリポジトリを維持することを目指す。 Comment
元ポスト:
[Paper Note] OctoTools: An Agentic Framework with Extensible Tools for Complex Reasoning, Pan Lu+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#Tools #NLP #LanguageModel #AIAgents #ACL #One-Line Notes Issue Date: 2025-02-20 GPT Summary- OctoToolsは複雑な推論タスクを解決するための訓練不要で拡張可能なマルチエージェントフレームワーク。標準化されたツールカード、プランナー、実行者を導入し、16の多様なタスクでGP4oより平均精度を9.3%向上。AutoGenやLangChainに対しても最大10.6%の改善を示し、タスク計画とツール使用の効果を実証。詳細はサイトに公開。 Comment
元ポスト:
NAACL2025 KnowledgeNLP Workshopでベストペーパーに選出:
ACL2026のOralにaccept:
[Paper Note] NaturalReasoning: Reasoning in the Wild with 2.8M Challenging Questions, Weizhe Yuan+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #SyntheticData #Distillation #Author Thread-Post Issue Date: 2025-02-19 GPT Summary- 数学やコーディングを含む多様な領域の推論能力を向上させるため、280万問の多様で挑戦的な推論問題を含むデータセットNaturalReasoningを導入。知識蒸留実験により、強力な教師モデルから効果的に推論能力が引き出されることを示し、自己訓練や自己報酬でも有効であることを証明。NaturalReasoningは今後の研究を促進するために公開されている。 Comment
元ポスト:
[Paper Note] LIMO: Less is More for Reasoning, Yixin Ye+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #DataDistillation #COLM #PostTraining #read-later #Selected Papers/Blogs Issue Date: 2025-02-07 GPT Summary- 限られた訓練データで高度な数学的推論が可能であることを示す。モデルLIMOはAIME24で63.3%、MATH500で95.6%の精度を達成し、従来モデルを大幅に上回る。LIMOは分布外の一般化にも強く、従来のモデルよりも少ないデータで55%の改善を実現。Less-Is-More Reasoning Hypothesis(LIMO仮説)を提案し、事前知識の完全性と戦略的デモンストレーションの効果が推論の質を左右することを示唆。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=T2TZ0RY4Zk#discussion
[Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #LongContext #ICML #RewardHacking #PostTraining #Selected Papers/Blogs #KeyPoint Notes #Author Thread-Post Issue Date: 2025-02-07 GPT Summary- 本研究では、大規模言語モデル(LLMs)における長い思考の連鎖(CoTs)推論のメカニズムを調査し、重要な要因を特定。主な発見は、(1) 教師ありファインチューニング(SFT)は必須ではないが効率を向上させる、(2) 推論能力は計算の増加に伴い現れるが、報酬の形状がCoTの長さに影響、(3) 検証可能な報酬信号のスケーリングが重要で、特に分布外タスクに効果的、(4) エラー修正能力は基本モデルに存在するが、RLを通じて効果的に奨励するには多くの計算が必要。これらの洞察は、LLMsの長いCoT推論を強化するためのトレーニング戦略の最適化に役立つ。 Comment
元ポスト:
元ポストのスレッド中に論文の11個の知見が述べられている。どれも非常に興味深い。DeepSeek-R1のテクニカルペーパーと同様、
- Long CoTとShort CoTを比較すると前者の方が到達可能な性能のupper bonudが高いことや、
- SFTを実施してからRLをすると性能が向上することや、
- RLの際にCoTのLengthに関する報酬を入れることでCoTの長さを抑えつつ性能向上できること、
- 数学だけでなくQAペアなどのノイジーだが検証可能なデータをVerifiableな報酬として加えると一般的なreasoningタスクで数学よりもさらに性能が向上すること、
- より長いcontext window sizeを活用可能なモデルの訓練にはより多くの学習データが必要なこと、
- long CoTはRLによって学習データに類似したデータが含まれているためベースモデルの段階でその能力が獲得されていることが示唆されること、
- aha momentはすでにベースモデル時点で獲得されておりVerifiableな報酬によるRLによって強化されたわけではなさそう、
など、興味深い知見が盛りだくさん。非常に興味深い研究。あとで読む。
[Paper Note] Evolving Deeper LLM Thinking, Kuang-Huei Lee+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#NLP #LanguageModel #Test-Time Scaling Issue Date: 2025-01-28 GPT Summary- Mind Evolutionに基づく進化的探索戦略を提案し、大規模言語モデルの推論時の計算量をスケールさせる。候補応答を生成、再結合、洗練することで、推論問題を形式化する必要を回避。自然言語計画タスクにおいて、Best-of-NやSequential Revisionと比較し優れた性能を示し、TravelPlannerおよびNatural Planのベンチマークで98%以上の問題インスタンスを解決。 Comment
Mulberry: Empowering MLLM with o1-like Reasoning and Reflection via Collective Monte Carlo Tree Search, Huanjin Yao+, NeurIPS'25
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #Supervised-FineTuning (SFT) #MultiModal #NeurIPS #VisionLanguageModel #TreeSearch Issue Date: 2024-12-31 GPT Summary- 本研究では、MLLMを用いて質問解決のための推論ステップを学習する新手法CoMCTSを提案。集団学習を活用し、複数モデルの知識で効果的な推論経路を探索。マルチモーダルデータセットMulberry-260kを構築し、モデルMulberryを訓練。実験により提案手法の優位性を確認。
[Paper Note] Fact, Fetch, and Reason: A Unified Evaluation of Retrieval-Augmented Generation, Satyapriya Krishna+, N_A, NAACL'25
Paper/Blog Link My Issue
#InformationRetrieval #NLP #Dataset #AIAgents #Evaluation #Factuality #RAG(RetrievalAugmentedGeneration) #NAACL #One-Line Notes Issue Date: 2024-10-20 GPT Summary- LLMsを用いた情報検索強化生成(RAG)システムの性能評価のために、FRAMESという新しい評価データセットを提案。これは、事実に基づく応答、検索能力、推論を統一的に評価するもので、複数の情報源を統合するマルチホップ質問を含む。最新のLLMでも0.40の精度に留まる中、提案するマルチステップ検索パイプラインにより精度が0.66に向上し、RAGシステムの開発に貢献することを目指す。 Comment
RAGのfactuality, retrieval acculacy, reasoningを評価するためのmulti hop puestionとそれに回答するための最大15のwikipedia記事のベンチマーク
元ポスト:
[Paper Note] Step-DPO: Step-wise Preference Optimization for Long-chain Reasoning of LLMs, Xin Lai+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #DPO #PostTraining Issue Date: 2026-01-30 GPT Summary- 数学的推論はLLMにとって難題であり、正確な推論ステップが求められる。本研究では、人間のフィードバックを活用し、LLMの堅牢性を向上させるStep-DPOを提案。各推論ステップを選好最適化の単位とし、高品質なデータセットを構築。結果、70BパラメータモデルにおいてMATHで約3%の精度向上を実現し、Qwen2-72B-Instructが他のモデルを凌駕する成績を示した。 Comment
openreview: https://openreview.net/forum?id=H5FUVj0vMd
[Paper Note] Lessons from Studying Two-Hop Latent Reasoning, Mikita Balesni+, arXiv'24
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #read-later Issue Date: 2025-09-12 GPT Summary- 大規模言語モデル(LLM)の二段階質問応答能力を調査し、思考の連鎖(CoT)の重要性を示す。合成事実を用いた実験で、モデルは二つの合成事実を組み合わせるのに失敗するが、自然な事実との組み合わせでは成功することが確認された。これにより、LLMは潜在的な二段階推論能力を持つが、その能力のスケーリングには不明点が残る。研究者は、LLMの推論能力を評価する際に、ショートカットによる虚偽の成功や失敗に注意する必要があることを強調。 Comment
元ポスト:
下記研究ではエンティティが国の場合は2 step推論ができるという例外が生じており、事前学習のフィルタリングで何か見落としがあるかもしれない可能性があり:
- [Paper Note] Do Large Language Models Perform Latent Multi-Hop Reasoning without Exploiting Shortcuts?, Sohee Yang+, ACL'24
下記研究において、完全にmemorizationzが生じない形で事前学習とInference実施(train: John Doe lives in **Tokyo**., Test: The people in the city John Doe is from speak **Japanese**.)されたが、エンティティがcityの場合でしか試されておらず、他のエンティティでも汎化するのか?という疑問があった:
- [Paper Note] Extractive Structures Learned in Pretraining Enable Generalization on Finetuned Facts, Jiahai Feng+, ICML'25
本研究では17種類の他のエンティティでも2 hop reasoningがlatentに実施されていることを確認した。しかし、一つ不思議な点として当初2つの架空の事実をLLMに教えるような学習を試みた場合は。Acc.が0%で、lossも偶然に生じる程度のものであった。これを深掘りすると、
- 合成+本物の事実→うまくいく
- 合成+合成→失敗
- 同一訓練/incontext文書内の合成された事実→うまくいく
という現象が観測され、このことより
- 実世界のプロンプトでの成功は、latent reasoningがロバストに実施されていることを示すわけではなく(事前学習時の同一文書内の共起を反映しているだけの可能性がある)
- 合成データでの2 hop推論の失敗は、latent reasoningの能力を否定するものではない(合成された事実は実世界での自然な事実とは異なるためうまくいっていない可能性がある)
という教訓が得られた、といった話が元ポストに書かれている。
なぜ完全に合成された事実情報では失敗するのだろうか。元論文を読んで事前学習データとしてどのようなものが利用されているかを確認する必要がある。
元ポスト:
[Paper Note] DART-Math: Difficulty-Aware Rejection Tuning for Mathematical Problem-Solving, Yuxuan Tong+, NeurIPS'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #SyntheticData #Evaluation #Mathematics #NeurIPS Issue Date: 2025-08-30 GPT Summary- 数学問題解決には高度な推論が必要であり、従来のモデルは難しいクエリに対して偏りがあることが明らかになった。そこで、Difficulty-Aware Rejection Tuning(DART)を提案し、難しいクエリに多くの試行を割り当てることでトレーニングを強化。新たに作成した小規模な数学問題データセットで、7Bから70BのモデルをファインチューニングしたDART-MATHは、従来の手法を上回る性能を示した。合成データセットが数学問題解決において効果的でコスト効率の良いリソースであることが確認された。 Comment
[Paper Note] CRUXEval-X: A Benchmark for Multilingual Code Reasoning, Understanding and Execution, Ruiyang Xu+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #Coding #MultiLingual Issue Date: 2025-08-15 GPT Summary- CRUXEVAL-Xという多言語コード推論ベンチマークを提案。19のプログラミング言語を対象に、各言語で600以上の課題を含む19Kのテストを自動生成。言語間の相関を評価し、Python訓練モデルが他言語でも高い性能を示すことを確認。 Comment
[Paper Note] CRUXEval: A Benchmark for Code Reasoning, Understanding and Execution, Alex Gu+, arXiv'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #Coding Issue Date: 2025-08-15 GPT Summary- CRUXEvalという800のPython関数からなるベンチマークを提案し、入力予測と出力予測の2つのタスクを評価。20のコードモデルをテストした結果、HumanEvalで高得点のモデルがCRUXEvalでは改善を示さないことが判明。GPT-4とChain of Thoughtを用いた場合、入力予測で75%、出力予測で81%のpass@1を達成したが、どのモデルも完全にはクリアできず、GPT-4のコード推論能力の限界を示す例を提供。
[Paper Note] MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI, Xiang Yue+, CVPR'24
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #Evaluation #MultiModal #CVPR Issue Date: 2025-08-09 GPT Summary- MMMUは、大学レベルの専門知識と意図的な推論を必要とするマルチモーダルモデルの評価のための新しいベンチマークで、11,500のマルチモーダル質問を含む。6つの主要分野をカバーし、30種類の画像タイプを使用。既存のベンチマークと異なり、専門家が直面するタスクに類似した課題を提供。GPT-4VとGeminiの評価では、56%と59%の精度にとどまり、改善の余地があることを示す。MMMUは次世代のマルチモーダル基盤モデルの構築に寄与することが期待されている。 Comment
MMMUのリリースから20ヶ月経過したが、いまだに人間のエキスパートのアンサンブルには及ばないとのこと
MMMUのサンプルはこちら。各分野ごとに専門家レベルの知識と推論が求められるとのこと。
[Paper Note] Iterative Reasoning Preference Optimization, Richard Yuanzhe Pang+, NeurIPS'24, 2024.04
Paper/Blog Link My Issue
#NLP #LanguageModel #SelfImprovement #NeurIPS #DPO #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2025-07-02 GPT Summary- 反復的な好み最適化手法を用いて、Chain-of-Thought(CoT)候補間の推論ステップを最適化するアプローチを開発。修正DPO損失を使用し、推論の改善を示す。Llama-2-70B-ChatモデルでGSM8K、MATH、ARC-Challengeの精度を向上させ、GSM8Kでは55.6%から81.6%に改善。多数決による精度は88.7%に達した。 Comment
- [Paper Note] Self-Rewarding Language Models, Weizhe Yuan+, arXiv'24, 2024.01
と似たようにiterativeなmannerでreasoning能力を向上させる。
ただし、loss functionとしては、chosenなCoT+yのresponseに対して、reasoning traceを生成する能力を高めるために、NLL Lossも適用している点に注意。
32 samplesのmajority votingによってより高い性能が達成できているので、多様なreasoning traceが生成されていることが示唆される。
DPOでReasoning能力を伸ばしたい場合はNLL lossが重要。Iterative RPO
[Paper Note] Let's Verify Step by Step, Hunter Lightman+, ICLR'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #ReinforcementLearning #ICLR #Selected Papers/Blogs #PRM Issue Date: 2025-06-26 GPT Summary- 大規模言語モデルの多段階推論能力が向上する中、論理的誤りが依然として問題である。信頼性の高いモデルを訓練するためには、結果監視とプロセス監視の比較が重要である。独自の調査により、プロセス監視がMATHデータセットの問題解決において結果監視を上回ることを発見し、78%の問題を解決した。また、アクティブラーニングがプロセス監視の効果を向上させることも示した。関連研究のために、80万の人間フィードバックラベルからなるデータセットPRM800Kを公開した。 Comment
OpenReview: https://openreview.net/forum?id=v8L0pN6EOi
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, Zhihong Shao+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #RLHF #Mathematics #GRPO #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2025-01-04 GPT Summary- DeepSeekMath 7Bは、120Bの数学関連トークンを用いて事前学習された言語モデルで、競技レベルのMATHベンチマークで51.7%のスコアを達成。自己一貫性は60.9%で、データ選択パイプラインとGroup Relative Policy Optimization (GRPO)の導入により数学的推論能力が向上。Gemini-UltraやGPT-4に迫る性能を示す。 Comment
元々数学のreasoningに関する能力を改善するために提案されたが、現在はオンラインでTruthfulness, Helpfulness, Concisenessなどの改善に活用されているとのこと。
PPOとGRPOの比較。value function model(状態の価値を予測するモデル)が不要なため省メモリ、かつ利用する計算リソースが小さいらしい。
あとサンプルをグループごとに分けて、グループ内でのKLダイバージェンスが最小化されるよう(つまり、各グループ内で方策が類似する)Policy Modelが更新される(つまりloss functionに直接組み込まれる)点が違うらしい。
PPOでは生成するトークンごとにreference modelとPolicy ModelとのKLダイバージェンスをとり、reference modelとの差が大きくならないよう、報酬にペナルティを入れるために使われることが多いらしい。
下記記事によると、PPOで最大化したいのはAdvantage(累積報酬と状態価値(累積報酬の期待値を計算するモデル)の差分;期待値よりも実際の累積報酬が良かったら良い感じだぜ的な数値)であり、それには状態価値を計算するモデルが必要である。そして、PPOにおける状態価値モデルを使わないで、LLMにテキスト生成させて最終的な報酬を平均すれば状態価値モデル無しでAdvantageが計算できるし嬉しくね?という気持ちで提案されたのが、本論文で提案されているGRPOとのこと。勉強になる。
DeepSeek-R1の論文読んだ?【勉強になるよ】
, asap:
https://zenn.dev/asap/articles/34237ad87f8511
[Paper Note] AutoReason: Automatic Few-Shot Reasoning Decomposition, Arda Sevinc+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Zero/Few/ManyShotPrompting #Chain-of-Thought #RAG(RetrievalAugmentedGeneration) Issue Date: 2025-01-03 GPT Summary- Chain of Thought(CoT)を用いて、暗黙のクエリを明示的な質問に分解することで、LLMの推論能力を向上させる自動生成システムを提案。StrategyQAとHotpotQAデータセットで精度向上を確認し、特にStrategyQAで顕著な成果を得た。ソースコードはGitHubで公開。 Comment
元ポスト:
A Survey of Mathematical Reasoning in the Era of Multimodal Large Language Model: Benchmark, Method & Challenges, Yibo Yan+, arXiv'24
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Mathematics Issue Date: 2025-01-03 GPT Summary- 数学的推論は多くの分野で重要であり、AGIの進展に伴い、LLMsを数学的推論タスクに統合することが求められている。本調査は、2021年以降の200以上の研究をレビューし、マルチモーダル設定におけるMath-LLMsの進展を分析。分野をベンチマーク、方法論、課題に分類し、マルチモーダル数学的推論のパイプラインやLLMsの役割を探る。さらに、AGI実現の障害となる5つの課題を特定し、今後の研究方向性を示す。
[Paper Note] Marco-o1: Towards Open Reasoning Models for Open-Ended Solutions, Yu Zhao+, arXiv'24, 2024.11
Paper/Blog Link My Issue
#NLP #LanguageModel #SelfImprovement #read-later #Reading Reflections Issue Date: 2024-12-16 GPT Summary- OpenAI o1がLRMの研究に注力し、伝統的な分野だけでなくRLやオープンエンドな解決にも焦点を当てる。特に、基準が不明瞭な領域への一般化の可能性を探求。Marco-o1はCoT微調整やMCTS、リフレクション機構などの手法を用いて、複雑な実世界の問題解決に最適化されている。 Comment
元ポスト:
Large Reasoning Model (LRM)という用語は初めて見た。
日本語解説: https://www.docswell.com/s/DeepLearning2023/KV1M9P-2024-12-05-125148
[Paper Note] Do Large Language Models Perform Latent Multi-Hop Reasoning without Exploiting Shortcuts?, Sohee Yang+, ACL'24
Paper/Blog Link My Issue
#Multi #NLP #Dataset #LanguageModel #Evaluation #Factuality #ACL #Reading Reflections Issue Date: 2024-12-02 GPT Summary- 大規模言語モデル(LLMs)のマルチホップクエリに対する事実の想起能力を評価。ショートカットを防ぐため、主語と答えが共に出現するテストクエリを除外した評価データセットSOCRATESを構築。LLMsは特定のクエリにおいてショートカットを利用せずに潜在的な推論能力を示し、国を中間答えとするクエリでは80%の構成可能性を達成する一方、年の想起は5%に低下。潜在的推論能力と明示的推論能力の間に大きなギャップが存在することが明らかに。 Comment
SNLP'24での解説スライド:
https://docs.google.com/presentation/d/1Q_UzOzn0qYX1gq_4FC4YGXK8okd5pwEHaLzVCzp3yWg/edit?usp=drivesdk
この研究を信じるのであれば、LLMはCoT無しではマルチホップ推論を実施することはあまりできていなさそう、という感じだと思うのだがどうなんだろうか。
Language Models are Hidden Reasoners: Unlocking Latent Reasoning Capabilities via Self-Rewarding, Haolin Chen+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #PostTraining Issue Date: 2024-11-13 GPT Summary- LaTRO(LaTent Reasoning Optimization)を提案し、LLMの推論能力を向上させる新しいフレームワークを構築。推論を潜在分布からのサンプリングとして定式化し、外部フィードバックなしで推論プロセスと質を同時に改善。GSM8KおよびARC-Challengeデータセットで実験し、平均12.5%の精度向上を達成。事前学習されたLLMの潜在的な推論能力を引き出すことが可能であることを示唆。 Comment
元ポスト:
[Paper Note] Beyond Accuracy: Evaluating the Reasoning Behavior of Large Language Models -- A Survey, Philipp Mondorf+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Evaluation Issue Date: 2024-11-07 GPT Summary- LLMsは推論タスクで顕著な能力を示しているが、その深さは依然として不確かである。これは、浅い精度指標への依存と推論挙動の検証不足に起因する。本論文は、モデルの推論プロセスをより深く理解するための研究をレビューし、一般的な評価方法論を調査する。結果、LLMsは表層的なパターンに依存し、人間との推論の違いを明確にするさらなる研究の必要性が示唆される。 Comment
論文紹介(sei_shinagawa): https://www.docswell.com/s/sei_shinagawa/KL1QXL-beyond-accuracy-evaluating-the-behaivior-of-llm-survey
[Paper Note] RankPrompt: Step-by-Step Comparisons Make Language Models Better Reasoners, Chi Hu+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #NLP #LanguageModel #Prompting #COLING #Reranking #Initial Impression Notes #LREC Issue Date: 2024-04-07 GPT Summary- LLMの論理的エラーを解決するために、自己ランク付けを可能にする新手法RankPromptを提案。これは、多様な応答を比較し、LLMの文脈的生成能力を活用する。実験ではChatGPTやGPT-4の性能が最大13%向上し、AlpacaEvalデータセットでは人間の判断との74%の一致率を示した。また、応答の順序や一貫性の変動にも強い耐性を持つことが確認された。RankPromptは高品質なフィードバックを引き出す有効な手法である。 Comment
LLMでランキングをするためのプロンプト手法。独立したプロンプトでスコアリングしスコアリング結果からランキングするのではなく、LLMに対して比較するためのルーブリックやshotを入れ、全てのサンプルを含め、1回のPromptingでランキングを生成するような手法に見える。大量の候補をランキングするのは困難だと思われるが、リランキング手法としては利用できる可能性がある。また、実験などでランキングを実施するサンプル数に対してどれだけ頑健なのかなどは示されているだろうか?
[Paper Note] The Impact of Reasoning Step Length on Large Language Models, Mingyu Jin+, ACL'24 Findings, 2024.01
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Chain-of-Thought #ACL #Length #Findings Issue Date: 2024-01-16 GPT Summary- Chain of Thought(CoT)がLLMの推論能力向上に重要であることが示された。実験により、推論ステップの長さがLLMの性能に与える影響を調査。推論ステップを長くすることで、追加情報なしでも推論能力が向上し、逆に短くすると性能が著しく低下。これは、CoTプロンプトにおけるステップ数の重要性を示している。また、不正確な合理的根拠でも推論を維持できれば良好な結果が得られることが判明。タスクの複雑さに応じて、推論ステップの利点は異なることも観察された。
[Paper Note] Causal Reasoning and Large Language Models: Opening a New Frontier for Causality, Emre Kıcıman+, TMLR'24, 2023.04
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #TMLR #Generalization Issue Date: 2023-05-04 GPT Summary- 本研究では、大規模言語モデル(LLMs)の因果的議論生成能力をベンチマークし、様々なタスクで既存手法を上回る性能を示しました。特に、GPT-3.5および4は因果発見や反事実的推論タスクで高い精度を達成し、データセットの記憶だけでは説明できない能力を持つことが確認されました。しかし、LLMsには予測不可能な失敗モードがあり、改善の余地があることも指摘されています。LLMsは因果分析の労力を削減する可能性があり、今後はLLMsと既存の因果技術を組み合わせたアルゴリズムの開発が期待されます。 Comment
openreview: https://openreview.net/forum?id=mqoxLkX210
tmlr blog: https://medium.com/@TmlrOrg/announcing-the-2025-tmlr-outstanding-certification-e26d548ff011
[Paper Note] Self-Evaluation Guided Beam Search for Reasoning, Yuxi Xie+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#BeamSearch #NLP #LanguageModel #SelfCorrection #NeurIPS #Decoding #KeyPoint Notes Issue Date: 2025-10-01 GPT Summary- LLMの推論プロセスを改善するために、段階的自己評価メカニズムを導入し、確率的ビームサーチを用いたデコーディングアルゴリズムを提案。これにより、推論の不確実性を軽減し、GSM8K、AQuA、StrategyQAでの精度を向上。Llama-2を用いた実験でも効率性が示され、自己評価ガイダンスが論理的な失敗を特定し、一貫性を高めることが確認された。 Comment
pj page: https://guideddecoding.github.io
openreview: https://openreview.net/forum?id=Bw82hwg5Q3
非常にざっくり言うと、reasoning chain(=複数トークンのsequence)をトークンとみなした場合の(確率的)beam searchを提案している。多様なreasoning chainをサンプリングし、その中から良いものをビーム幅kで保持し生成することで、最終的に良いデコーディング結果を得る。reasoning chainのランダム性を高めるためにtemperatureを設定するが、アニーリングをすることでchainにおけるエラーが蓄積することを防ぐ。これにより、最初は多様性を重視した生成がされるが、エラーが蓄積され発散することを防ぐ。
reasoning chainの良さを判断するために、chainの尤度だけでなく、self-evaluationによるreasoning chainの正しさに関するconfidenceスコアも導入する(reasoning chainのconfidenceスコアによって重みづけられたchainの尤度を最大化するような定式化になる(式3))。
self-evaluationと生成はともに同じLLMによって実現されるが、self-evaluationについては評価用のfew-shot promptingを実施する。promptingでは、これまでのreasoning chainと、新たなreasoning chainがgivenなときに、それが(A)correct/(B)incorrectなのかをmultiple choice questionで判定し、選択肢Aが生成される確率をスコアとする。
Recursion of Thought: A Divide-and-Conquer Approach to Multi-Context Reasoning with Language Models, Soochan Lee+, arXiv'23
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #KeyPoint Notes Issue Date: 2025-01-05 GPT Summary- Recursion of Thought(RoT)という新しい推論フレームワークを提案し、言語モデル(LM)が問題を複数のコンテキストに分割することで推論能力を向上させる。RoTは特別なトークンを導入し、コンテキスト関連の操作をトリガーする。実験により、RoTがLMの推論能力を劇的に向上させ、数十万トークンの問題を解決できることが示された。 Comment
divide-and-conquerで複雑な問題に回答するCoT手法。生成過程でsubquestionが生じた際にモデルに特殊トークン(GO)を出力させ、subquestionの回答部分に特殊トークン(THINK)を出力させるようにSupervisedに学習させる。最終的にTHINKトークン部分は、subquestionを別途モデルによって解いた回答でreplaceして、最終的な回答を得る。
subquestionの中でさらにsubquestionが生じることもあるため、再帰的に処理される。
四則演算と4種類のアルゴリズムに基づくタスクで評価。アルゴリズムに基づくタスクは、2つの数のlongest common subsequenceを見つけて、そのsubsequenceとlengthを出力するタスク(LCS)、0-1 knapsack問題、行列の乗算、数値のソートを利用。x軸が各タスクの問題ごとの問題の難易度を表しており、難易度が上がるほど提案手法によるgainが大きくなっているように見える。
Without Thoughtでは直接回答を出力させ、CoTではground truthとなるrationaleを1つのcontextに与えて回答を生成している。RoTではsubquestionごとに回答を別途得るため、より長いcontextを活用して最終的な回答を得る点が異なると主張している。
感想としては、詳細が書かれていないが、おそらくRoTはSFTによって各タスクに特化した学習をしていると考えられる(タスクごとの特殊トークンが存在するため)。ベースラインとしてRoT無しでSFTしたモデルあった方が良いのではないか?と感じる。
また、学習データにおけるsubquestionとsubquestionに対するground truthのデータ作成方法は書かれているが、そもそも元データとして何を利用したかや、その統計量も書かれていないように見える。あと、そもそも機械的に学習データを作成できない場合どうすれば良いのか?という疑問は残る。
読んでいた時にAuto-CoTとの違いがよくわからなかったが、Related Workの部分にはAuto-CoTは動的、かつ多様なデモンストレーションの生成にフォーカスしているが、AutoReasonはquestionを分解し、few-shotの promptingでより詳細なrationaleを生成することにフォーカスしている点が異なるという主張のようである。
- [Paper Note] Automatic Chain of Thought Prompting in Large Language Models, Zhuosheng Zhang+, ICLR'23, 2022.10
Auto-CoTとの差別化は上記で理解できるが、G-Evalが実施しているAuto-CoTとの差別化はどうするのか?という風にふと思った。論文中でもG-Evalは引用されていない。
素朴にはAutoReasonはSFTをして学習をしています、さらにRecursiveにquestionをsubquestionを分解し、分解したsubquestionごとに回答を得て、subquestionの回答結果を活用して最終的に複雑なタスクの回答を出力する手法なので、G-Evalが実施している同一context内でrationaleをzeroshotで生成する手法よりも、より複雑な問題に回答できる可能性が高いです、という主張にはなりそうではある。
- [Paper Note] G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment, Yang Liu+, N/A, EMNLP'23
ICLR 2023 OpenReview:
https://openreview.net/forum?id=PTUcygUoxuc
- 提案手法は一般的に利用可能と主張しているが、一般的に利用するためには人手でsubquestionの学習データを作成する必要があるため十分に一般的ではない
- 限られたcontext長に対処するために再帰を利用するというアイデアは新しいものではなく、数学の定理の証明など他の設定で利用されている
という理由でrejectされている。
[Paper Note] MAmmoTH: Building Math Generalist Models through Hybrid Instruction Tuning, Xiang Yue+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #InstructionTuning #NumericReasoning #Mathematics #PostTraining #One-Line Notes Issue Date: 2023-09-30 GPT Summary- MAmmoTHシリーズは、数学問題解法に特化したオープンソースのLLMで、MathInstructという指示チューニングデータセットを使用して訓練されています。MathInstructは、中間推論を含む13の数学データセットから構成され、特に6つの新たな推論過程を提供しています。CoTとPoTのハイブリッドを採用することで、異なる思考プロセスを実現し、9つの数学推論データセットで平均16%から32%の精度向上を実現しました。特にMAmmoTH-7BモデルはMATHデータセットで33%、MAmmoTH-34Bモデルは44%を達成し、既存のオープンソースモデルを上回っています。研究は、多様な問題の網羅性とハイブリッド推論の重要性を示しています。 Comment
9つのmath reasoningが必要なデータセットで13-29%のgainでSoTAを達成。
260kの根拠情報を含むMath Instructデータでチューニングされたモデル。
project page:
https://tiger-ai-lab.github.io/MAmmoTH/
[Paper Note] SelfCheck: Using LLMs to Zero-Shot Check Their Own Step-by-Step Reasoning, Ning Miao+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #LanguageModel #SelfCorrection #ICLR #Test-Time Scaling #Verification #SelfVerification Issue Date: 2023-08-08 GPT Summary- LLMの段階的推論能力を活用し、自己検証(SelfCheck)を提案してLLM自身が誤りを認識することを目指す。誤りの認識にはゼロショット検証スキームを用い、その結果を基に重み付き投票で回答性能を向上。GSM8K、MathQA、MATHデータセットで評価し、誤り認識の効果と正確性向上を確認。 Comment
これはおもしろそう。後で読む
OpenReview: https://openreview.net/forum?id=pTHfApDakA
Reasoning with Language Model Prompting: A Survey, ACL'23
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #Prompting #ACL Issue Date: 2023-07-18 GPT Summary- 本論文では、推論に関する最新の研究について包括的な調査を行い、初心者を支援するためのリソースを提供します。また、推論能力の要因や将来の研究方向についても議論します。リソースは定期的に更新されています。
[Paper Note] StructGPT: A General Framework for Large Language Model to Reason over Structured Data, Jinhao Jiang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #QuestionAnswering #TabularData #One-Line Notes Issue Date: 2023-05-21 GPT Summary- 本研究では、構造化データに基づく質問応答タスクを解決するためにIterative Reading-then-Reasoning(IRR)アプローチ、StructGPTを開発。特化した関数を用いることで、関連証拠を収集し推論を行うプロセスを構築。さらに、外部インターフェースを利用したinvoking-linearization-generation手順を提案し、反復的に解答に近づく。実験結果は、ChatGPTの性能を大幅に向上させ、教師ありチューニングと同等の成果を示す。 Comment
構造化データに対するLLMのゼロショットのreasoning能力を改善。構造化データに対するQAタスクで手法が有効なことを示した。
[Paper Note] Exploring the Curious Case of Code Prompts, Li Zhang+, NLRSE'23, 2023.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #Prompting #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- コード風のプロンプトによる構造化推論の性能向上が示されたが、その効果は限られたタスクに留まる。本研究では、davinci系のモデルに対して、QAや感情分析など幅広いタスクでコードとテキストプロンプトを比較し、全体としてコードプロンプトがテキストプロンプトを上回ることはなかった。タスクによってはコードプロンプトが有利な場合もあったが、全てのタスクに当てはまるわけではなく、テキスト指示によるファインチューニングがコードプロンプトの性能向上に寄与することを示した。 Comment
コードベースのLLMに対して、reasoningタスクを解かせる際には、promptもコードにすると10パーセント程度性能上がる場合があるよ、という研究。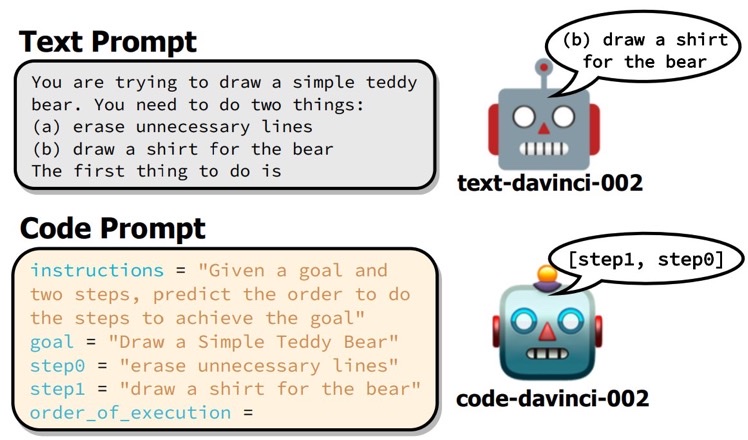
ただし、平均的にはテキストプロンプトの方が良く、一部タスクで性能が改善する、という温度感な模様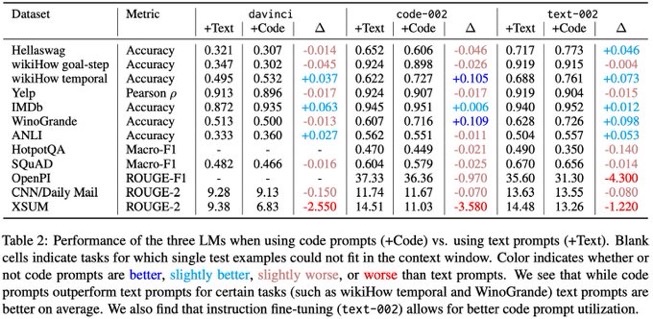
コードベースのモデルをtextでinstruction tuningしている場合でも、効果があるタスクがある。
GPT-6 Astra Is the Best Vision Model We Have Tested, roboflow, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Analysis #ImageSegmentation #Blog #ComputerUse #VisionLanguageModel #2D (Image) #One-Line Notes #ObjectDetection Issue Date: 2026-09-27 Comment
元ポスト:
GPT-6-Astraに対して、Image Segmentation, Object Detection, counting, box prompt, counting, visual reasoning, re-identification(バスケットボールの動画を例に、選手を一貫して検知し共通のIDを付与できるか, 特に選手交代などにも対応できるか)などのさまざまなタスクでテストした結果が報告されている。結論としては、彼らがテストした中で最も強力なVisionモデルだが、コスト、latencyに関するトレードオフがあることが考察されており、特にリアルタイム処理には向いていないが、アノテーションなどのパッチ処理には価値があるだろうとしている。
Estimating GPT-6 Astra’s no-CoT Time Horizon, Francis Rhys Ward and Dewi Gould, LW, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Evaluation #Blog #read-later #Author Thread-Post Issue Date: 2026-09-10 Comment
元ポスト:
VISTA: A Visual Harness for Reasoning in an Interactive World, Han+, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #AIAgents #read-later #Selected Papers/Blogs #2D (Image) #3D (Scene) #memory #LongHorizon #Author Thread-Post #AgentHarness Issue Date: 2026-08-10 Comment
元ポスト:
細かすぎて伝わらないChat Completions _ Responses APIのモデル間挙動差異, nyanp, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #API #SoftwareEngineering #Author Thread-Post Issue Date: 2026-08-05 Comment
元ポスト:
Controlling Reasoning Effort in LLMs, Sebastian Raschka, 2026.07
Paper/Blog Link My Issue
#Article #Controllable #NLP #LanguageModel #Blog #Length #read-later #Initial Impression Notes Issue Date: 2026-07-19 Comment
元ポスト:
OpenAIのReasoning Effortについては調整方法が公開されていないのでGPT-OSSのテンプレートなどから可能な方法を推測、そのほかOpenWeightモデルについてはテクニカルレポートに記載されている情報からReasoning Effortの調整方法が解説されている
Inkling: Our open-weights model, THINKING MACHINES, 2026.07
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #SpeechProcessing #Blog #OpenWeight #MoE(Mixture-of-Experts) #Selected Papers/Blogs #VisionLanguageModel #UMM #KeyPoint Notes #Reference Collection #AudioLanguageModel #Author Thread-Post Issue Date: 2026-07-16 Comment
HF: https://huggingface.co/thinkingmachines/Inkling
元ポスト:
THINNING MACHINESによる最初のOpenWeightモデル。975B-41B
- フルスクラッチで学習したReasoningモデル
- 1M context window
- text, image, audio, video 45Tトークンで学習
- バランスよくさまざまな領域で性能を発揮するように訓練し、Tinker上でのfinetuningやカスタマイゼーションの良い基盤として機能することを目指した
- vision, audioドメインに関してはencoder freeアーキテクチャを採用
- audio signalの入力は dMel spectrogramsと呼ばれる手法を採用
- [Paper Note] dMel: Speech Tokenization made Simple, Richard He Bai+, arXiv'24, 2024.07
- 画像は40x40のパッチに分割され、4つのhMLPと呼ばれるレイヤーでエンコーディング
- [Paper Note] Three things everyone should know about Vision Transformers, Hugo Touvron+, ECCV'22, 2022.03
- IFの訓練には、Rubric basedなgraderとclaims graderの2種類のgraderを用いることで、helpfulnessとhallucinationを同時に低減
- Rubric basedなgraderはチェックリストに基づいてスコアリング
- claims graderはfactualな主張をagentic web searchを通じてverificationする
- アーキテクチャはDeepSeek V3を踏襲し、256のexpertsと2つのshared expertを採用し、6つのexpertsがactivateされる
- SWAとGlobal attentionの比率は5:1でKV Headは8つ (GQA)
- **相対位置エンコーディングを用いることでRoPEよりもlong contextに対してより高い外挿性能を示した**
- [Paper Note] Self-Attention with Relative Position Representations, Peter Shaw+, NAACL'18
- K, Vのprojection後、**およびattentionとMLPが残差ストリームに合流する前にshort convolutionを導入**
- QKV projection後に convolution を導入するアーキテクチャは下記研究で提案
- [Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
- optimiserはMuonとAdamWのハイブリッドで、前者は巨大な行列の重みに対して適用し、そのほかは後者を利用
- 重み自体が多様体上に存在するように制約することが有効であったことに着想を得て、weight decayを学習率の2乗に連動させることでモデルの重みの大きさを安定させたとのこと
- Modular Manifolds, Jeremy Bernstein+, THINKING MACHINES, 2025.09
- [Paper Note] Why Gradients Rapidly Increase Near the End of Training, Aaron Defazio, arXiv'25, 2025.06
- 事後学習としては、まずKimi K2.5を含むOpenWeightモデルで合成データ上でSFTをし、その後合成、あるいは人間が作成したenvironment上で大規模なRLを実施
- RLは非同期RLを異様し、ロールアウト数に対して推論能力が対数線形にスケールした。
- 最終的に30Mロールアウト以上のRLを実施した
- システムメッセージを変更し、トークン単位のコストを調整することでreasoning effortを調整
- Controlling Reasoning Effort in LLMs, Sebastian Raschka, 2026.07
- **276B-A12BのInkling-Smallもプレビュー段階にあり、agenticな能力においてInklingに近い性能を達成しており、今後公開予定**
1M context windowを実現した工夫は特に書かれていなかったように感じるが、よく使われるのはKV CacheをコンパクトにするためのSparse Attention、あるいはLinear Attentionなのに対し、本モデルでは使われていないように見える。linear attentionでなくとも、SWAとGlobal Attentionのハイブリッド、かつGQAによって、KV Cacheの肥大化を実用レベルで抑制できるのだろうか。また、外挿性能に関してはRoPEは採用せず、相対位置エンコーディングのを採用したという点が効いているのだろうか。1Mレベルでのcontextでの評価がなさそうに見えるので性能はよくわからない。
RoPEのlong contextでの限界を示した以下の研究を思い出した:
- [Paper Note] RoPE Distinguishes Neither Positions Nor Tokens in Long Contexts, Provably, Yufeng Du+, arXiv'26, 2026.05
Artificial Analysisによる評価:
アーキテクチャでの目新しい点:
所見:
公式:
所見:
Reducing Doom Loops with Final Token Preference Optimization, Liquid.AI, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #read-later #Author Thread-Post Issue Date: 2026-07-12 Comment
元ポスト:
Thinking to recall: How reasoning unlocks parametric knowledge in LLMs, Google Research, 2026.06
Paper/Blog Link My Issue
#Article #Analysis #LanguageModel #Blog #read-later #FactualKnowledge #Author Thread-Post Issue Date: 2026-06-26 Comment
元ポスト:
Synthetic Persona Pretraining: Alignment from Token Zero, Minder+, 2026.05
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Alignment #SyntheticData #Blog #Safety #Selected Papers/Blogs #Initial Impression Notes #Author Thread-Post Issue Date: 2026-05-25 Comment
元ポスト:
**事前学習の時点で**Harmful/良性/ニュートラルな文書にReflectionに関するassistantの思考過程(何が間違っていて/間違っていなくて、それはなぜか)をappendすることで、道徳的に推論することを学ぶ。
[Paper Note] Achieving Gold-Medal-Level Olympiad Reasoning via Simple and Unified Scaling
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Mathematics #Test-Time Scaling #PostTraining #RLVR #Verification #Physics Issue Date: 2026-05-21 Comment
pj page: https://simplified-reasoning.github.io/SU-01/
元ポスト:
ポイント解説:
Reliable Reasoning, Naoto Iwase, 2026.05
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Blog #read-later #Author Thread-Post Issue Date: 2026-05-20 Comment
元ポスト:
Teaching Claude why, Anthropic, 2026.05
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Safety #PostTraining #KeyPoint Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-05-12 Comment
元ポスト:
- [Paper Note] Agentic Misalignment: How LLMs Could Be Insider Threats, Aengus Lynch+, arXiv'25, 2025.10
のように自身を守るために脅迫メールを送るような挙動が観測されたが、それをなくすことができたという話のようである。
細かい学習データのサンプルなどは記載されていないように見えるが
- 評価時のシナリオと類似したもので正しい挙動を教え込むような方法は、評価のスコアは改善するが、OODに対応できない
- モデルに行動を教えるのではなく、理由を教えることが重要で、これはモデル自身が倫理観に関するジレンマに置かれた状況を解決するというデータではなく、ユーザが倫理的なジレンマを抱えているというシナリオで、モデルが倫理的に塾講された思慮深いアドバイスをするようなデータ(difficult advice dataset)で学習することが非常に効果的であった。
- これは単に正しい答えを教えるのではなく、倫理的な"思考"を教えるため効果的であり、これをさらに発展させ、Claudeの人物像をより詳細に与えることでペルソナをより模範的なものに更新する、具体的には質の高いConstitutionに関する文書と、模範的なAIに関するフィクションの物語を学習させることで、misalignmentを非常に効果的に抑制できることを発見した
という感じだろうか。
トップダウンに正解を教えるのではなく、ボトムアップに根源的に正しい思考過程を誘発するような情報を教える(ある種のPRMのようなものだと思われる)ことで、高い汎化性能を獲得できるということだと思われる。このアプローチは最近のAI Agentにおけるoutcome basedなreward設計などにも一石を投じるような議論に感じる。学習の結果得られる汎化性能を重視していかないと、データセットやEnvironmentを逐一構築して課題を潰していく必要があり、キリがないと思う。
Advancing voice intelligence with new models in the API, OpenAI, 2026.05
Paper/Blog Link My Issue
#Article #NLP #SpeechProcessing #MultiLingual #Proprietary #TTS #Realtime #Author Thread-Post #SpeechToSpeech Issue Date: 2026-05-10 Comment
元ポスト:
GPT-Realtime-2
MolmoAct 2: An open foundation for robots that work in the real world, Ai2, 2026.05
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #OpenWeight #OpenSource #read-later #Robotics #VisionLanguageActionModel #Author Thread-Post Issue Date: 2026-05-08 Comment
元ポスト:
関連:
- [Paper Note] MolmoAct: Action Reasoning Models that can Reason in Space, Jason Lee+, arXiv'25
dataset:
https://huggingface.co/collections/allenai/molmoact2-datasets
models:
https://huggingface.co/collections/allenai/molmoact2-models
著者ポスト:
著者ポスト2:
著者ポスト3:
Cosmos-Reason2-32B, Nvidia, 2026.04
Paper/Blog Link My Issue
#Article #NLP #OpenWeight #VisionLanguageModel #Robotics #EmbodiedAI Issue Date: 2026-05-01 Comment
元ポスト:
Gemini Robotics-ER 1.6: Powering real-world robotics tasks through enhanced embodied reasoning, Google Deepmind, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Proprietary #Robotics #VisionLanguageActionModel #SpatialUnderstanding #Reference Collection #Initial Impression Notes #Author Thread-Post #MultiView Issue Date: 2026-04-15 Comment
元ポスト:
おー、とうとうDeepmindからVLAがでた。プロプライエタリモデル
私が知らなかっただけで、以前からリリースされていたようだ:
- Building the Next Generation of Physical Agents with Gemini Robotics-ER 1.5, Google, 2025.09
-
https://developers.googleblog.com/en/building-the-next-generation-of-physical-agents-with-gemini-robotics-er-15/
ポイント解説:
約12兆トークンの良質なコーパスで学習した新たな国産LLM「LLM-jp-4 8Bモデル」「LLM-jp-4 32B-A3Bモデル」をオープンソースライセンスで公開 ~一部ベンチマークでGPT-4oやQwen3-8Bを上回る性能を達成~, NII, 2026.04
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #OpenWeight #Japanese #OpenSource #mid-training #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-04-03 Comment
8BモデルはLlama-2アーキテクチャ、32B-A3.8BモデルはQwen3-MoEアーキテクチャで、フルスクラッチ学習をすることで実現[^1]。
19.5Tトークン(概算として、日本語0.7Tトークン、英語17.8Tトークン、中国語・韓国語0.85Tトークン、プログラムコード0.2Tトークン)のインターネット上の公開データや政府・国会の文書を収集し(LLM-jp-3.1のデータの6倍の規模)し事前学習データを構築、DataMixtureを最適化し10.5Tトークンを事前学習で利用。
中間学習では、事前学習データにInstruction Pretraining[^2]データを含む合成データを加え1.2Tトークンを利用。
その後最終的にInstruction Tuningを、日本語、英語合計22種類のデータで実施(元記事ではチューニングと呼称されているがおそらくInstruction Tuningだと思われる)。
MTBenchでは、GPT-4o, gpt-oss-20B, Qwen3-8Bと同等以上の性能、日本語MTBench[^3]では、GPT-4o, gpt-oss-20B, Qwen3-8Bを上回る性能とのこと。MTBenchで用いるLLM-as-a-JudgeのモデルとしてはGPT-5.4を利用とのこと。
[^1]: つまり、モデルのパラメータは完全に新規で学習されており、ベースとして既存OpenWeightモデルを利用していない点に注意。
[^2]: Instruction Pretrainingは、LLM-jp-3.1の頃から実施されている:
LLM-jp-3.1 シリーズ instruct4 の公開, LLM-jp, 2025.05
[Paper Note] Instruction Pre-Training: Language Models are Supervised Multitask Learners, Daixuan Cheng+, arXiv'24, 2024.06
[^3]: MT-Benchの概要については
[Paper Note] Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Lianmin Zheng+, NeurIPS'23, 2023.06
も参照のこと。
フルスクラッチモデル点に関する説明:
HF:
https://huggingface.co/collections/llm-jp/llm-jp-4-models
Reasoningモデルもある!!!
関連:
- PLaMo 3.0 Prime β版, PFN, 2026.03
上記PLaMo 3.0に続いて、国内でのフルスクラッチReasoningモデルは二例目だろうか。
Gemma 4: Byte for byte, the most capable open models, Google, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #AIAgents #MultiModal #SpeechProcessing #OpenWeight #MoE(Mixture-of-Experts) #Selected Papers/Blogs #VisionLanguageModel #2D (Image) #3D (Video) #One-Line Notes #Reference Collection #AudioLanguageModel #audio #text #Initial Impression Notes Issue Date: 2026-04-02 Comment
元ポスト:
2B, 4B, 26BのMoEモデルと31BのDenseモデルの4種類のモデルファミリーで、マルチモーダル(vision)対応。2B, 4Bはaudioも入力として扱える。
edgeデバイス向けのモデルは128k, 他は256kのコンテキストウィンドウ。140+の多言語サポート。
Apache 2.0ライセンス
arenaで同サイズのモデル群でSoTAといった話がブログ中に記述されている。
モデルカードには一般的なベンチマーク群とのスコアも記載されている。
https://ai.google.dev/gemma/docs/core/model_card_4?hl=ja
(そもそも既存のベンチマークにもコンタミネーションがあると思われるが、)arenaに関しては特定の企業に対してデータを提供し、複数のモデルの亜種をテストできるという慣行があり、リーダーボードにバイアスがあるであろう点には注意:
- [Paper Note] The Leaderboard Illusion, Shivalika Singh+, NeurIPS'25
artificial analysisによる評価:
Qwenがproprietaryになったことから、ライセンス的に使いやすく、日本語に強そうなモデルとしては筆頭ではなかろうか。日本語性能が気になる。
アーキテクチャ解説:
ポイント解説:
所見:
attentionのscaleをsqrt(d)でスケールさせる代わりに、QK-norm, V normを適用するなど。
NvidiaによるNVFP4へのpost-trainingによる量子化:
https://huggingface.co/nvidia/Gemma-4-31B-IT-NVFP4
量子化後の性能も比較されており、知識、数学、コーディング、terminac useなど6種類のベンチマークでオリジナルのモデルと遜色ない性能が出ている旨記載されている。
解説:
https://newsletter.maartengrootendorst.com/p/a-visual-guide-to-gemma-4
所見(encoder-freeにした裏側でパッチ化→projection + x/y軸のpositional embeddingを実施している話):
Trinity-Large-Thinking: Scaling an Open Source Frontier Agent, Arcee, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #OpenWeight #MoE(Mixture-of-Experts) #read-later #Selected Papers/Blogs Issue Date: 2026-04-02 Comment
元ポスト:
HF: https://huggingface.co/collections/arcee-ai/trinity-large-thinking
PLaMo 3.0 Prime β版, PFN, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Japanese #Selected Papers/Blogs #In-Depth Notes #Surface-level Notes Issue Date: 2026-03-19 Comment
元ポスト:
日本国内初のフルスクラッチReasoningモデル
## 公式発表のまとめ
- [Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
によってcontext windowを64Kまで拡張(PLaMo 2.2 Primeの2倍)。
事後学習データの見直し(新たなオープンデータセット追加, 独自データとして、日本語指示追従能力, tool use, long horizon QA, 医療分野, STEM, RAG性能向上のためのデータ)を実施し、SFT, DPO, RLの流れで学習を実施。SFT, DPOについてはreasoning trajectoryもLossで考慮するように変更。SFT, DPO向けデータについてはreasoning trajectoryを合成したものを利用。
RLは今回初めて導入し学習を安定させるための工夫を取り入れているとのこと。Reference Answerとの比較と表層的な特徴から報酬を計算する関数を実装した、という書かれ方をしている。
gpt-oss-120B(memium)との比較で言うと
指示追従性能が日本語、英語ともによりも高く、医療分野のQA(国家試験を除く)、英語、日本語での対話能力で勝っている。また、法令分野のQAは同等である。
単一ツールや複数ツールからの選択は同等、multi turnの場合はPLaMo2.2から大幅に性能向上しているもののgpt-ossよりも劣る。また、long contextのQA、医療分野の国家試験QA、STEM分野のQAや数学的な推論能力は大幅に前回モデルよりも向上したが、まだgpt-ossなどには届いていない、という感じに見える。
アーキテクチャについては、一新したという話とRoPEベースということ以外はよくわからない。
## 筆者の憶測と感想
※以下、筆者の憶測を多く含んだ感想です。ただ筆者が勝手に想像して自分なりに考えてみているだけです。
DPOにNLL lossを追加することでreasoningを強化できることは下記研究で示されている:
- [Paper Note] Iterative Reasoning Preference Optimization, Richard Yuanzhe Pang+, NeurIPS'24, 2024.04
RLの報酬に関して、表層的な特徴とReference Answerとの比較から最適な報酬を計算とのことなので、おそらく何らかのVerificationのための仕組みと、Rubric-basedなLLM-as-a-Judgeだろうか?Reward Modelという書かれ方はしていない。
RLについては安定性のある手法を採用したとのことだが、DAPO、
- [Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
あるいはRLのスケーリング則を導いた研究でDAPOよりも安定性と最終到達性能において優れていることが示された
- [Paper Note] The Art of Scaling Reinforcement Learning Compute for LLMs, Devvrit Khatri+, arXiv'25, 2025.10
CISPOあたりだろうか:
- [Paper Note] MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning
Attention, MiniMax+, arXiv'25, 2025.06
あとは安定性という観点で言うと、inference/trainingエンジンでのtraining-inference gapの課題についても対処している可能性がある。
- Hot topics in RL, Kimbo, X, 2025.12
- [Paper Note] Beyond Precision: Training-Inference Mismatch is an Optimization Problem and Simple LR Scheduling Fixes It, Yaxiang Zhang+, arXiv'26, 2026.02
思考過程が英語ということは、言語間で能力は転移し、かつ事前学習データとしてはリソースが豊富な英語が多く含まれると想像すると、明示的(strong LLMでtrajectoryを合成したものを加える系の話)あるいはデータに自然と現れるreasoningの挙動から事前学習中にreasoning能力が暗黙的に学習されることを踏まえ、SFTでreasoning能力を強化する際に(日本語よりも英語の方が効果的な可能性が高く)英語でのtrajectoryを合成したという感じだろうか(いつか日本語のreasoning trajectoryを出力するモデルも見てみたいなあ)。
Multi Turnのtool useの性能向上に関して、AI Agent分野のlong horizonな合成データを合成するアプローチや、Sink Tokenの活用や、トークン単位でsink tokenを計算することに相当するHead wise gated attentionなどはしているのだろうか。
- [Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
- [Paper Note] Step 3.5 Flash: Open Frontier-Level Intelligence with 11B Active Parameters, Ailin Huang+, arXiv'26, 2026.02
また、アーキテクチャに関してはcontext windowが海外のフロンティアモデルと比較してまだ小さめであるが、今後context windowを大きくするにあたって、オンポリシーRLでのロールアウト時間がボトルネックとなることが考えられ、Mamba(=linear attention)系のアーキテクチャをハイブリッドや、DSA系のsparse attentionなどの採用によるアーキテクチャ起因の計算コスト低減(現在どのようなアーキテクチャなのかは全くわからないが)、あるいはin-flight-updateのような学習エンジン側での効率化なども必要になるのではなかろうか(現在どういうエンジンなのかは全くわからないが)。
- [Paper Note] DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek-AI+, arXiv'25, 2025.12
- [Paper Note] PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence
Generation, Alexandre Piché+, arXiv'25, 2025.09
Moondream 3 Preview: Frontier-level reasoning at a blazing speed, Moondream, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #EfficiencyImprovement #NLP #FoundationModel #SmallModel #OpenWeight #Selected Papers/Blogs #VisionLanguageModel #KeyPoint Notes Issue Date: 2026-03-12 Comment
HF: https://huggingface.co/moondream/moondream3-preview
9B-A2Bの小規模なVLMで、
- visual reasoning: 小規模だが実タスクに適用可能なvisual reasoning性能
- trainable: Visual系のタスクは人間でもzero shotではできないことが多く、簡単にfinetuningできることが重要で
- fast: vision系のアプリケーションはリアルタイムのlavencyが求められることが多く
- inexpensive: 安くスケーラブルでなければならない
をテーマにしたモデルのようである。
object detection, pointing, 構造化された出力(犬の群の個々の犬の毛と首輪の色動画)、OCRなどの様々なタスクが実行可能で、GPT5, Gemini 2.5 Flash, Claude 4 Sonnetをこの規模感のモデルで、objec' detection, counting, document understanding, hallucinationに関するベンチマークで上回る。
前身のモデルであるmoondream2は、5Mダウンロードを達成したようだ
vikhyatk/moondream2
Open-Sourcing Sarvam 30B and 105B, sarvam, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2026-03-10 Comment
元ポスト:
Reasoning models struggle to control their chains of thought, and that’s good, OpenAI, 2026.03
Paper/Blog Link My Issue
#Article #Controllable #NLP #Dataset #LanguageModel #Chain-of-Thought #Evaluation #Blog #read-later #Author Thread-Post Issue Date: 2026-03-06 Comment
元ポスト:
著者ポスト:
AReaL: A Large-Scale Asynchronous Reinforcement Learning System, inclusionAI, 2026.03
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #ReinforcementLearning #read-later #Asynchronous #TrainingFramework Issue Date: 2026-03-05 Comment
元ポスト:
Introducing Mercury 2, inception, 2026.02
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #DiffusionModel #Blog #Proprietary #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-02-27 Comment
元ポスト:
1092 token/secのproprietary (reasoning) dLLM
関連:
- [Paper Note] Mercury: Ultra-Fast Language Models Based on Diffusion, Inception Labs+, arXiv'25
Artificial Analysisのベンチマーキング結果とスループットの散布図:
スループット/性能比において明らかに抜きんでている。
GPT-OSS Swallow, Swallow LLM, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Japanese Issue Date: 2026-02-21 Comment
元ポスト:
第120回医師国家試験(2026)を解かせてみた結果:
Qwen3 Swallow, Swallow LLM, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Japanese #MoE(Mixture-of-Experts) Issue Date: 2026-02-21 Comment
元ポスト:
Ling-2.5-1T, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) Issue Date: 2026-02-16 Comment
Ringに続いてLingもリリース
関連:
- Ring-1T-2.5-FP8, inclusionAI, 2026.02
元ポスト:
Building Olmo in the Era of Agents, Nathan Lambert, LTI Colloquim, 2026.02
Paper/Blog Link My Issue
#Article #Tutorial #Survey #NLP #LanguageModel #AIAgents #Slide #OpenSource #read-later #Selected Papers/Blogs #Initial Impression Notes Issue Date: 2026-02-16 Comment
元ポスト:
うーんこれは時間をとってしっかり読んで色々まとめたい・・・
[Paper Notes] Seed2.0 Model Card: Towards Intelligence Frontier for Real-World Complexity, Bytedance Seed, 2026.02
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #AIAgents #Proprietary #VisionLanguageModel Issue Date: 2026-02-16 Comment
元ポスト:
所見:
Gemini 3 Deep Think: Advancing science, research and engineering, Google, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Coding #Mathematics #Proprietary #SoftwareEngineering #VisionLanguageModel #Science Issue Date: 2026-02-13 Comment
まずはUltra Subscriberに公開し、その後徐々にAPIアクセスを解禁していくとのこと。
LiveCodeBench:
Ring-1T-2.5-FP8, inclusionAI, 2026.02
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #AIAgents #Attention #LongContext #OpenWeight #LongHorizon #LinearAttention Issue Date: 2026-02-12 Comment
元ポスト:
関連:
- Ring-1T, inclusionAI, 2025.10
MLA + lightning linear attentionのハイブリッド
- MHA vs MQA vs GQA vs MLA, Zain ul Abideen, 2024.07
- [Paper Note] Various Lengths, Constant Speed: Efficient Language Modeling with Lightning Attention, Zhen Qin+, ICML'24, 2024.05
Intern-S1-Pro, internlm, 2026.02
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #PositionalEncoding #OpenWeight #MoE(Mixture-of-Experts) #VisionLanguageModel #Science Issue Date: 2026-02-05 Comment
元ポスト:
ポイント解説:
関連:
- [Paper Note] Intern-S1: A Scientific Multimodal Foundation Model, Lei Bai+, arXiv'25, 2025.08
Fourier Position Encoding (FoPE) + upgraded time-series modeling
MedReason-Stenographic, openmed-community, 2026.01
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #QuestionAnswering #Chain-of-Thought #SyntheticData #Evaluation #Medical #KeyPoint Notes Issue Date: 2026-01-12 Comment
元ポスト:
MiniMax M2.1を用いてMedical QAに対してreasoning traceを生成。生成されたreasoning traceをstenographic formatと呼ばれる自然言語からフィラーを排除し、論理の流れのみをsymbolicな表現に変換することで合成されたデータセットとのこと。
ユースケースとしては下記とのこと:
> 1. Train reasoning models with symbolic compression
> 2. Fine-tune for medical QA
> 3. Research reasoning compression techniques
> 4. Benchmark reasoning trace quality
個人的には1,3が興味深く、symbolを用いてreasoning traceを圧縮することで、LLMの推論時のトークン効率を改善できる可能性がある。
が、surfaceがシンボルを用いた論理の流れとなると、汎化性能を損なわないためにはLLMが内部でシンボルに対する何らかの強固な解釈が別途必要になるし、それが多様なドメインで機能するような柔軟性を持っていなければならない気もする。
AI Safetyの観点でいうと、論理の流れでCoTが表現されるため、CoTを監視する際には異常なパターンがとりうる空間がshrinkし監視しやすくなる一方で、surfaceの空間がshrinkする代わりに内部のブラックボックス化された表現の自由度が高まり抜け道が増える可能性もある気がする。結局、自然言語もLLMから見たらトークンの羅列なので、本質的な課題は変わらない気はする。
NVIDIA Cosmos Reason 2 Brings Advanced Reasoning To Physical AI, Nvidia, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LongContext #SmallModel #OpenWeight #ObjectLocalization #VisionLanguageModel #Robotics #SpatialUnderstanding #EmbodiedAI #Physics Issue Date: 2026-01-06 Comment
HF: https://huggingface.co/nvidia/Cosmos-Reason2-8B?linkId=100000401175768
元ポスト:
VAETKI, NC-AI-consortium, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) Issue Date: 2026-01-03 Comment
元ポスト:
Solar-Open-100B, upstage, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #Korean Issue Date: 2026-01-03 Comment
元ポスト:
ポイント解説:
K-EXAONE-236B-A23B, LG AI Research, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) Issue Date: 2026-01-03 Comment
関連:
- EXAONE-Deep-32B, LG AI Research, 2025.03
Multi Token Prediction
Sliding Window Attention
256k context length
MoE
元ポスト:
A.X-K1, SK Telecom, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #Korean Issue Date: 2026-01-03 Comment
元ポスト:
Reverse Engineering a Phase Change in GPT's Training Data... with the Seahorse Emoji 🌊🐴, PRATYUSH MAINI, 2025.12
Paper/Blog Link My Issue
#Article #Analysis #NLP #LanguageModel #ChatGPT #SelfCorrection #mid-training #One-Line Notes Issue Date: 2025-12-28 Comment
元ポスト:
Is there seahorse emoji?という質問に対するLLMのreasoning trajectoryと、self correctionの挙動が、OpenAIのどの時点のモデルで出現するか、しないかを線引くことで、mid-trainingにself correction形式のデータが追加されたのがいつ頃なのかを考察している。
Aligning to What? Rethinking Agent Generalization in MiniMax M2, MiniMaxAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #AIAgents #Blog #read-later Issue Date: 2025-12-27 Comment
元ポスト:
GLM-4.7: Advancing the Coding Capability, Z.ai, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Coding #OpenWeight #SoftwareEngineering #One-Line Notes #Reference Collection Issue Date: 2025-12-25 Comment
元ポスト:
HF: https://huggingface.co/zai-org/GLM-4.7
デザインアリーナでtop2:
Artificial Intelligence Indexにおいて、OpenModelの中でトップ:
GLM-4.6と比較して、コーディング/SWE, reasoning, tooluseなどの能力が大幅に向上
Interleaved Thinking, Preserved Thinking, Turn-level Thinkingの3つの特性がある。
Interleaved Thinkingは全てのレスポンスとtool callingの前にreasoningを挟むことで、IFや生成品質を向上。
Preserved Thinkingは過去のターンの全てのthinking blockのトークンを保持し、再計算もしないのでマルチターンでの一貫性が増す。
Turn-level Thinkingはターンごとにreasoningを実施するか否かをコントロールでき、latency/costを重視するか、品質を重視するかを選択できる、といった特徴がある模様。
モデルサイズは358B
OpenHands trajectories with Qwen3 Coder 480B, Nebius blog, 2025.12
Paper/Blog Link My Issue
#Article #Dataset #LanguageModel #ReinforcementLearning #AIAgents #Blog #Coding #SoftwareEngineering #PostTraining Issue Date: 2025-12-24 Comment
元ポスト:
MiniMax M2.1: Significantly Enhanced Multi-Language Programming, Built for Real-World Complex Tasks, MiniMax, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Coding #SmallModel #OpenWeight Issue Date: 2025-12-24 Comment
元ポスト:
解説:
ByteDance Doubao-Seed-1.8 Review, toyama nao, Zhihu, 2025.12
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #MultiModal #Proprietary #VisionLanguageModel Issue Date: 2025-12-20 Comment
元ポスト:
Gemma Scope 2: helping the AI safety community deepen understanding of complex language model behavior, Google Deepmind, 2025.12
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Safety #KeyPoint Notes #SparseAutoencoder #Transcoders #CircuitAnalysis Issue Date: 2025-12-20 Comment
元ポスト:
関連:
- [Paper Note] Sparse Autoencoders Find Highly Interpretable Features in Language Models, Hoagy Cunningham+, ICLR'24
- dictionary_learning, Marks+, 2024
- [Paper Note] Transcoders Find Interpretable LLM Feature Circuits, Jacob Dunefsky+, arXiv'24, 2024.06
- [Paper Note] Learning Multi-Level Features with Matryoshka Sparse Autoencoders, Bart Bussmann+, ICLR'25, 2025.03
- [Paper Note] Transcoders Beat Sparse Autoencoders for Interpretability, Gonçalo Paulo+, arXiv'25, 2025.01
(↓勉強中なので誤りが含まれる可能性大)
Sparse Auto Encoder (SAE; あるlayerにおいてどのような特徴が保持されているかを見つける)とTranscoder (ある層で見つかった特徴と別の層の特徴の関係性を見つける)を用いて、Gemma3の回路分析が行えるモデル・ツール群をリリースした、という話に見える。
応用例の一つとして、たとえば詐欺メールをinputしたときに、詐欺関連する特徴量がどのトークン由来で内部的にどれだけ活性したかを可視化できる。
可視化例:
Evaluating chain-of-thought monitorability, OpenAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Chain-of-Thought #Evaluation #Safety #KeyPoint Notes #Monitorability Issue Date: 2025-12-19 Comment
元ポスト:
Monitorabilityの定義が記述されているので覚えておくとよいかもしれない。
Monitorabilityを一言でいうと、"エージェントの挙動に関する重要な性質を正確に予測できる能力"ということっぽい。
Monitorabilityは以下の2つの側面を持ち、
>- Monitors. We could make monitors smarter in various ways, and we would like our evaluations to give higher scores to monitors that can make better predictions about an agent’s behavior.
>- Agents. There are many observations of the agent that could be given to the monitor, including the agent’s actions, outputs, neural activations, and recently with the advent of reasoning models, the chain-of-thought. It’s possible for some agents to have thoughts that are harder to understand than others, and so we would like our monitorability evaluations to be able to compare agents and not just monitors.
モニターそのものの賢さと、モニタリングされるエージェントも理解しやすいものとしづらいものがいるため、モニターの性能だけじゃなくてエージェントそのものも評価の対象にする必要がある。
monitarable / unmonitorable なCoTのサンプルとして以下が挙げられている。これは実際には実現不可能なコーディング課題が与えられているらしいのだが、左側はtestをpassしている(つまりなんかチートした)がそのことについてはCoTに言及されていない。一方、右側はチートに関して検討する様子がCoTに記述されており、これを見ることでユーザはモデルのよろしくない挙動に気付ける。
Gemini 3 Flash: frontier intelligence built for speed, Google, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Distillation #Proprietary #VisionLanguageModel #One-Line Notes #Reference Collection Issue Date: 2025-12-18 Comment
元ポスト:
Gemini 2.5 Proよりも3倍高速でかつ様々なベンチマークで上回っているとのこと。素晴らしい。Gemini 3 Proと比較しても基本的なQAや数学的な能力(reasoning能力)は性能に遜色なく、long sequence/contextの取り扱いでは明確に劣っている、という感じに見えるので、普段使いではこちらでも困らなそうに感じる。
Hallucination Rateが非常に高いとのことだが果たして:
Proからlogit baseな蒸留をして事前学習(=distillation pretraining)をしているっぽい?
Evaluating AI’s ability to perform scientific research tasks, OpenAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #Science #KeyPoint Notes Issue Date: 2025-12-17 Comment
元ポスト:
HF: https://huggingface.co/datasets/openai/frontierscience
physics, chemistry, biologyの分野の専門家が作成した問題によって構成されるPh.D levelの新たなscientificドメインのベンチマークとのこと。OlympiadとResearchの2種類のスプリットが存在し、Olympiadは国際オリンピックのメダリストによって設計された100問で構成され回答は制約のある短答形式である一方、Researchは博士課程学生・教授・ポスドク研究者などのPh.Dレベルの人物によって設計された60個の研究に関連するサブタスクによって構成されており、10点満点のルーブリックで採点される、ということらしい。
公式アナウンスではGPT-5.2がSoTAでResearchの性能はまだまだスコアが低そうである。
Olmo 3.1, Ai2, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #OpenSource #Selected Papers/Blogs Issue Date: 2025-12-13 Comment
元ポスト:
Instruction Followingのベンチマークスコアが、他モデルと比較して非常に高いように見える。
GPT-5.2 が登場 専門的な業務や長時間稼働するエージェント向けの、最先端のフロンティアモデル。, OpenAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #GenerativeAI #Proprietary #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2025-12-12 Comment
元ポスト:
OpenAIがGPT-5.2をリリースし、再び様々なベンチマークにおいてGemini 3 Proをoutperform。
フロントエンド開発(デザイン)(アリーナ形式)ではOpus, Gemini 3 Proの勝利らしい:
https://www.designarena.ai
ポイント解説:
GDPval:
- [Paper Note] GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks, Tejal Patwardhan+, arXiv'25, 2025.10
- GDPVAL: EVALUATING AI MODEL PERFORMANCE ON REAL-WORLD ECONOMICALLY VALUABLE TASKS, Patwardhan+, 2025.09
GDPvalのclearwinがGPT-5.2- Thinkingで49.8%なので、14年程度の専門家がこなす米国主要産業の一部のタスクは数値上は置き換え可能という風に見える。Proに至っては60.0%である。
が、GDPvalはたとえば以下のようなlimitationがあり、数値の解釈には注意が必要である:
- 完全なcontextが与えられる前提
- 暗黙知が多いタスクは対象外
- 自己完結型で他社とのコミュニケーションが必要とされないタスクを対象
- 1職種あたり30タスク程度の限定的な網羅性
- コンピュータを利用したタスクのみ
- ...
実際の現場で活用しようと思うと、完全なcontextを揃えられるか、揃わない場合に不完全なcontextでタスクを遂行できるか、そのための社内での運用フローの整備等、モデルを活用するための周辺のシステムや運用フローの設計が重要(かつ膨大)である点には(ベンチマークのスコアを見ると驚くべき進歩だが)留意する必要がある。
Vals AI IndexというGDPvalに類似したベンチマークでもSoTAとのこと:
関連:
非常に簡単な論理的な推論でも誤る例:
nomos-1, NousResearch, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Mathematics #OpenWeight #One-Line Notes Issue Date: 2025-12-11 Comment
元ポスト:
30Bの強力な数学モデルで、(同じハーネスでテストした結果)Qwen3-30ba3b-Thinking-2507を大幅に上回る性能を持つとのこと。
Introducing the Yupp SVG AI Leaderboard, YUPP, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Coding Issue Date: 2025-12-06 Comment
元ポスト:
SVG生成においてもGemini 3 Proが強い
[Paper Note] Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail, Pavone+, Nvidia, 2025.10
Paper/Blog Link My Issue
#Article #Dataset #ReinforcementLearning #SmallModel #OpenWeight #Robotics #VisionLanguageActionModel #Realtime #AutonomousDriving Issue Date: 2025-12-06 GPT Summary- AR1は因果連鎖推論と軌道計画を統合した視覚–言語–行動モデルであり、自律運転の意思決定を強化します。主な革新は、因果連鎖データセットの構築、モジュラーVLAアーキテクチャの導入、強化学習を用いた多段階トレーニング戦略です。評価結果では、AR1は計画精度を最大12%向上させ、推論の質を45%改善しました。リアルタイムパフォーマンスも確認され、レベル4の自律運転に向けた実用的な道筋を示しています。 Comment
HF: https://huggingface.co/nvidia/Alpamayo-R1-10B
元ポスト:
Nemotron-Content-Safety-Reasoning-4B, Nvidia, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Conversation #SmallModel #OpenWeight #Safety #Safeguard Issue Date: 2025-12-03 Comment
元ポスト:
Introducing Amazon Nova 2 Lite, a fast, cost-effective reasoning model, AWS, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary Issue Date: 2025-12-03 Comment
元ポスト:
関連:
- Introducing Amazon Nova, our new generation of foundation models, AWS, 2024.12
[Paper Note] DeepSeek-Math-V2, DeepSeekAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Mathematics #read-later #Selected Papers/Blogs #Verification #One-Line Notes #Reference Collection #GenerativeVerifier Issue Date: 2025-11-27 GPT Summary- 大規模言語モデル(LLM)は数学的推論において進展を遂げており、強化学習を用いて定量的推論コンペティションでのパフォーマンスを向上させている。しかし、最終回答の精度向上が正しい推論を保証しない問題や、厳密な導出が必要なタスクに対する限界がある。自己検証可能な数学的推論を目指し、定理証明のためのLLMベースの検証器を訓練し、生成器が自らの証明の問題を特定・解決するよう奨励する方法を提案。結果として得られたモデルDeepSeekMath-V2は、強力な定理証明能力を示し、国際数学オリンピックやプットナム競技会で高得点を記録した。これにより、自己検証可能な数学的推論が数学AIシステムの発展に寄与する可能性が示唆される。管理人コメント:モデル単体でIMO金メダル級を達成とのこと。outcomeに基づくRLVRからtrajectoryそのものをcritiqueし、その情報に基づいて再生成するといったループを繰り返す模様?このアプローチは数学以外のドメインでも有効な可能性があるので興味深い。 Comment
元ポスト:
HF: https://huggingface.co/deepseek-ai/DeepSeek-Math-V2
所見:
所見:
どのように高品質なverifierを構築し、高品質なデータ生成パイプラインを構築するか、という内容が記述されているらしい:
報酬に対する理解補助のための注釈:
ポイント解説:
verifier: proofsをスコアリングできるようRLで学習される
meta verifier: verifierの批評を確認する
generator: より良い証明を書きself checkもできるようverifierによるreward signalによりRLで訓練される
の三刀流らしい。
ポイント解説:
ポイント解説:
所見:
SIMA 2: An Agent that Plays, Reasons, and Learns With You in Virtual 3D Worlds, Google DeepMind, 2025.11
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Blog #ComputerUse #VisionLanguageModel #3D (Scene) #Game Issue Date: 2025-11-14 Comment
元ポスト:
もはやAIがゲームをできるのは当たり前の時代だが、どのくらいOODに汎化するのかは気になる。
GPT-5.1: A smarter, more conversational ChatGPT, OpenAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #Blog #Proprietary #Selected Papers/Blogs #VisionLanguageModel #Routing #One-Line Notes #Reference Collection Issue Date: 2025-11-13 Comment
元ポスト:
instantモデルはよりあたたかい応答でより指示追従能力を高め、thinkingモデルは入力に応じてより適応的に思考トークン数を調整する。autoモデルは入力に応じてinstant, thinkingに適切にルーティングをする。
所見:
Artificial Analysisによるベンチマーキング:
GPT-5.1-Codex-maxの50% time horizon:
SYNTH: the new data frontier, pleias, 2025.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #Dataset #LanguageModel #SyntheticData #One-Line Notes Issue Date: 2025-11-12 Comment
元ポスト:
SoTAなReasoning能力を備えたSLMを学習可能な事前学習用合成データ
元ポスト:
Introducing Kimi K2 Thinking, MoonshotAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #OpenWeight #Selected Papers/Blogs #One-Line Notes #Reference Collection Issue Date: 2025-11-07 Comment
HF: https://huggingface.co/moonshotai
元ポスト:
coding系ベンチマークでは少しGPT5,Claude Sonnet-4.5に劣るようだが、HLE, BrowseCompなどではoutperform
tooluseのベンチマークであるtau^2 Bench TelecomではSoTA
モデルの図解:
INT4-QATに関する解説:
INT4-QATの解説:
Kimi K2 DeepResearch:
METRによる50% timehorizonの推定は54分:
ただしサードパーティのinference providerによってこれは実施されており、(providerによって性能が大きく変化することがあるため)信頼性は低い可能性があるとのこと。
METRでの評価でClaude 3.7 Sonnetと同等のスコア:
openweightモデルがproprietaryモデルに追いつくのはsoftwere engineeringタスク(agenticなlong horizon+reasoningタスク)9ヶ月程度を要しているとのこと
gpt-oss-safeguard, OpenAI, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Safety #One-Line Notes #Safeguard Issue Date: 2025-10-30 Comment
元ポスト:
blog: https://openai.com/index/introducing-gpt-oss-safeguard/
ポリシーとそのポリシーに従うべきコンテンツが与えられたときに、コンテンツを分類するタスクを実施できる汎用的なreasoningモデル。つまり、任意のポリシーを与えて追加の学習なしでpromptingによってコンテンツがポリシーのもとでsafe/unsafeなのかを分類できる。
gpt-ossをreinforcbment finetuningしているとのこと。
Introducing MiMo-Audio, LLM-Core Xiaomi, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #InstructionTuning #SpeechProcessing #SmallModel #OpenWeight #Zero/FewShotLearning #Selected Papers/Blogs #UMM #AudioLanguageModel Issue Date: 2025-10-25 Comment
HF: https://huggingface.co/collections/XiaomiMiMo/mimo-audio
元ポスト:
text, audioを入力として受け取り、text, audioを出力するAudioLanguageModel
Knowledge Flow: Scaling Reasoning Beyond the Context Limit, Zhuang+, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Test-Time Scaling #read-later #One-Line Notes #Test-time Learning/Adaptation Issue Date: 2025-10-21 Comment
元ポスト:
モデルのロールアウトの結果からattemptから知識リストをiterativeに更新(新たな知識を追加, 古い知識を削除 or 両方)していくことによって、過去のattemptからのinsightを蓄積し性能を改善するような新たなテストタイムスケーリングの枠組みな模様。sequential test-time scalingなどとは異なり、複数のattemptによって知識リストを更新することでスケールさせるので、context windowの制約を受けない、といった話な模様。LLM AgentにおけるTest-time learningとかなり類似したコンセプトに見える。
Evaluating Long Context (Reasoning) Ability, wh., 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog #LongContext Issue Date: 2025-10-17 Comment
元ポスト:
Ring-1T, inclusionAI, 2025.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-10-14 Comment
元ポスト:
inclusionAIから続々とfrontierなモデルが出てきている。
テクニカルレポートが公開:
- [Paper Note] Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale
Thinking Model, Ling Team+, arXiv'25, 2025.10
Apriel-1.5-15b-Thinker, ServiceNow-AI, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #MultiModal #SmallModel #OpenWeight #VisionLanguageModel Issue Date: 2025-10-01 Comment
元ポスト:
Artificial Analysisによるベンチマーキングでは現状<20BでSoTAなReasoningモデルな模様。
MIT License
公式ポスト:
Nvidiaによるポスト:
InternVL3.5-Flash, OpenGVLab, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #OpenWeight #VisionLanguageModel Issue Date: 2025-09-29 Comment
元ポスト:
Ring-1T-preview, inclusionAI, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-09-29 Comment
元ポスト:
Build A Reasoning Model (From Scratch), Sebastian Raschka, 2025.05
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #One-Line Notes Issue Date: 2025-09-29 Comment
元ポスト:
reasoningモデルに関するpyTorchによるフルスクラッチでの実装と丁寧な解説つきのNotebookが公開されており内部の基礎的な挙動を理解するためにとても良さそう。
Continuing to bring you our latest models, with an improved Gemini 2.5 Flash and Flash-Lite release, Google Deepmind, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Proprietary Issue Date: 2025-09-28 Comment
元ポスト:
Qwen3-Next-series-FP8, Qwen Team, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Quantization #OpenWeight #LowPrecision Issue Date: 2025-09-23 Comment
元ポスト:
DeepSeek-V3.1-Terminus, deepseek-ai, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-09-23 Comment
元ポスト:
vLLMでデプロイする時のtips:
LongCat-Flash-Thinking, meituan-longcat, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #read-later #Selected Papers/Blogs #ModelMerge Issue Date: 2025-09-22 Comment
元ポスト:
ポイント解説:
関連:
- LongCat-Flash-Chat, meituan-longcat, 2025.08
- [Paper Note] Libra: Assessing and Improving Reward Model by Learning to Think, Meng Zhou+, arXiv'25, 2025.07
Grok 4 Fast, xAI, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiModal #Blog #VisionLanguageModel Issue Date: 2025-09-21 Comment
ベンチマークに対する評価結果以外の情報はほぼ記述されていないように見える(RL使いました程度)
Artificial Analysisによる評価:
コスト性能比の所見:
Ring-flash-2.0, inclusionAI, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) Issue Date: 2025-09-20 Comment
元ポスト:
- Ling-flash-2.0-baseをベースにしたモデルで、100B-A6.1 params
- 各種ベンチでgpt-oss-120Bと同等以上。denseな40Bモデル(Qwen-32B, Seed-OSS-36B-Instruct)やproprietary modelであるGemini-2.5-Flashと比較して同等以上の性能
- アーキテクチャ
- Multi Token Prediction [Paper Note] Multi-Token Prediction Needs Registers, Anastasios Gerontopoulos+, NeurIPS'25
- 1/32 experts activation ratio
- gpt-oss-120Bは4 expertsがactiveだが、こちらは1 shared + 8 experts
- attention head数はgpt-oss-120Bの64の1/2である32
- group size 4のGQA [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
- gpt-oss-120BのEmbed dim=2880に対して大きめのEmbed dim=4096
- 最初の1ブロックだけ、MoEの代わりにhidden_size=9216のFNNが利用されている
Magistral-Small-2509, MistralAI, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #OpenWeight #VisionLanguageModel Issue Date: 2025-09-18 Comment
元ポスト:
Large reasoning models research at COLM 2025 - State of research in scaling reasoning, the current paradigm for improving LLMs, PRAKASH KAGITHA, 2025.09
Paper/Blog Link My Issue
#Article #Survey #LanguageModel #Blog #COLM Issue Date: 2025-09-15 Comment
COLM'25における30個程度のReasoningに関わる論文をカバーしたブログらしい。
元ポスト:
ここの論文のサマリのまとめといった感じなので、indexとして利用すると良さそう。
GAUSS Benchmarking Structured Mathematical Skills for Large Language Models, Zhang+, 2025.06
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Evaluation #Mathematics #Contamination-free #Selected Papers/Blogs Issue Date: 2025-09-13 Comment
元ポスト:
現在の数学のベンチマークは個々の問題に対する回答のAccuracyを測るものばかりだが、ある問題を解く際にはさまざまなスキルを活用する必要があり、評価対象のLLMがどのようなスキルに強く、弱いのかといった解像度が低いままなので、そういったスキルの習熟度合いを測れるベンチマークを作成しました、という話に見える。
Knowledge Tracingタスクなどでは問題ごとにスキルタグを付与して、スキルモデルを構築して習熟度を測るので、問題の正誤だけでなくて、スキルベースでの習熟度を見ることで能力を測るのは自然な流れに思える。そしてそれは数学が最も実施しやすい。
ERNIE-4.5-21B-A3B-Thinking, Baidu, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #read-later #VisionLanguageModel Issue Date: 2025-09-10 Comment
元ポスト:
-
-
テクニカルレポート: https://ernie.baidu.com/blog/publication/ERNIE_Technical_Report.pdf
logical reasoning, 数学、コーディング、科学、数学、テキスト生成などの分野で21B-A3Bパラメータにも関わらずDeepSeek-R1に高い性能を達成しているように見える。コンテキストウィンドウは128k。
何が決め手でこのやうな小規模モデルで高い性能が出るのだろう?テクニカルレポートを読んだらわかるんだろうか。
Probing LLM Social Intelligence via Werewolf, foaster.ai, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog Issue Date: 2025-08-31 Comment
元ポスト:
「推論する生成AI」は事前学習されていない課題を正しく推論することができない(共変量シフトに弱い), TJO, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Blog #CovarianceShift Issue Date: 2025-08-27 Comment
- [Paper Note] Physics of Language Models: Part 2.1, Grade-School Math and the Hidden Reasoning Process, Tian Ye+, ICLR'25
でLLMは未知の問題を解ける(学習データに存在しない同等のlengthの未知のサンプルを解ける/テストデータで訓練データよりもより複雑な長いlengthの問題を解ける)と比べると、両者から得られる結論から何が言えるのだろうか?観測できるCoTとhidden mental reasoning process (probingで表出させて分析)は分けて考える必要があるのかもしれない。元論文をきちんと読めていないから考えてみたい。
あと、ブログ中で紹介されている論文中ではPhysics of Language Modelsが引用されていないように見えるが、論文中で引用され、関連性・差別化について言及されていた方が良いのではないか?という感想を抱いた。
関連:
- [Paper Note] Is Chain-of-Thought Reasoning of LLMs a Mirage? A Data Distribution Lens, Chengshuai Zhao+, arXiv'25
- [Paper Note] Understanding deep learning requires rethinking generalization, Chiyuan Zhang+, ICLR'17
- [Paper Note] UQ: Assessing Language Models on Unsolved Questions, Fan Nie+, arXiv'25
元ポスト:
Command A Reasoning: Enterprise-grade control for AI agents, Cohere, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-08-22 Comment
HF: https://huggingface.co/CohereLabs/command-a-reasoning-08-2025
元ポスト:
Agent関連ベンチでR1, gptoss超え。DeepResearchベンチでプロプライエタリLLMと比べてSoTA。safety関連ベンチでR1, gptoss超え。
す、すごいのでは、、?
CC-BY-NC 4.0なので商用利用不可
サマリ:
DeepSeek-V3.1-Base, deepseek-ai, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-08-21 Comment
元ポスト:
数日前からモデル自体は公開されていたが、モデルカードが追加された
- hybrid thinking
- post-trainingによるtool calling capability向上
- token efficiencyの向上
解説:
解説:
サマリ:
Aider LLM Leaderboards, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Coding Issue Date: 2025-08-21 Comment
最近よく見かけるいわゆるAider Polyglot。人間の介入なしに、LLMがコードの"編集"をする能力を測るベンチマーク。性能だけでなくコストもリーダーボードに記載されている。C++,Go,Java,JavaScript,Python,RustによるExercimにおける225の"最も困難な"エクササイズのみが含まれる。
Breakdown: Kimi K2, DeepSeek-R1, Qwen3 (+Coder), and GLM-4.5, TuringPost, 2025.08
Paper/Blog Link My Issue
#Article #NLP #Blog #OpenWeight Issue Date: 2025-08-11 Comment
元ポスト:
中国初のOpenLLMについて、それぞれの強みとおすすめのユースケースがまとまっている
ポスト中で紹介されているのは下記
- Kimi K2: Open Agentic Intelligence, moonshotai, 2025.07
- GLM-4.5: Reasoning, Coding, and Agentic Abililties, Zhipu AI Inc., 2025.07
- DeepSeek-R1, DeepSeek, 2025.01
- Qwen3-235B-A22B-Instruct-2507, Qwen Team, 2025.08
- Qwen3-Coder-30B-A3B-Instruct, QwenTeam, 2025.08
以下のようなものもある:
- MiniMax-M1, MiniMax, 2025.06
- Hunyuan-A13B-Instruct, tencent, 2025.06
NuMarkdown-8B-Thinking, numind, 2025.08
Paper/Blog Link My Issue
#Article #NLP #VisionLanguageModel #OCR Issue Date: 2025-08-08 Comment
元ポスト:
Qwen2.5-VL-7Bをsynthetia doc, Reasoning, Markdown exampleでSFTした後、レイアウトによってrewardを設計したGRPOで学習したとのこと
MIT License
gpt-oss-120b, OpenAI, 2025.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #AttentionSinks #read-later #Selected Papers/Blogs #KeyPoint Notes #Reference Collection Issue Date: 2025-08-05 Comment
blog:
https://openai.com/index/introducing-gpt-oss/
HF:
https://huggingface.co/datasets/choosealicense/licenses/blob/main/markdown/apache-2.0.md
アーキテクチャで使われている技術まとめ:
-
-
-
-
- こちらにも詳細に論文がまとめられている
上記ポスト中のアーキテクチャの論文メモリンク(管理人が追加したものも含む)
- Sliding Window Attention
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
- [Paper Note] Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, Zihang Dai+, ACL'19
- MoE
- [Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
- RoPE w/ YaRN
- [Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
- [Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
- Attention Sinks
- [Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
- Attention Sinksの定義とその気持ち、Zero Sink, Softmaxの分母にバイアス項が存在する意義についてはこのメモを参照のこと。
- [Paper Note] Why do LLMs attend to the first token?, Federico Barbero+, COLM'25
- Attention Sinksが実際にどのように効果的に作用しているか?についてはこちらのメモを参照。
- [Paper Note] When Attention Sink Emerges in Language Models: An Empirical View, Xiangming Gu+, ICLR'25
-
- Sink Token (or Zero Sink) が存在することで、decoder-onlyモデルの深い層でのrepresentationのover mixingを改善し、汎化性能を高め、promptに対するsensitivityを抑えることができる。
- (Attentionの計算に利用する) SoftmaxへのLearned bias の導入 (によるスケーリング)
- これはlearnable biasが導入されることで、attention scoreの和が1になることを防止できる(余剰なアテンションスコアを捨てられる)ので、Zero Sinkを導入しているとみなせる(と思われる)。
- GQA
- [Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
- SwiGLU
- [Paper Note] GLU Variants Improve Transformer, Noam Shazeer, arXiv'20, 2020.02 -
- group size 8でGQAを利用
- Context Windowは128k
- 学習データの大部分は英語のテキストのみのデータセット
- STEM, Coding, general knowledgeにフォーカス
-
https://openai.com/index/gpt-oss-model-card/
あとで追記する
他Open Weight Modelとのベンチマークスコア比較:
-
-
-
-
- long context
-
- Multihop QA
解説:
learned attention sinks, MXFP4の解説:
Sink Valueの分析:
gpt-oss の使い方:
https://note.com/npaka/n/nf39f327c3bde?sub_rt=share_sb
[Paper Note] Comments-Oriented Document Summarization: Understanding Documents with Reader’s Feedback, Hu+, SIGIR’08, 2008.07
fd064b2-338a-4f8d-953c-67e458658e39
Qwen3との深さと広さの比較:
- The Big LLM Architecture Comparison, Sebastian Laschka, 2025.07
Phi4と同じtokenizerを使っている?:
post-training / pre-trainingの詳細はモデルカード中に言及なし:
-
-
ライセンスに関して:
> Apache 2.0 ライセンスおよび当社の gpt-oss 利用規約に基づくことで利用可能です。
引用元:
https://openai.com/ja-JP/index/gpt-oss-model-card/
gpt-oss利用規約:
https://github.com/openai/gpt-oss/blob/main/USAGE_POLICY
cookbook全体: https://cookbook.openai.com/topic/gpt-oss
gpt-oss-120bをpythonとvLLMで触りながら理解する: https://tech-blog.abeja.asia/entry/gpt-oss-vllm
指示追従能力(IFEVal)が低いという指摘:
Qwen3-Coder-30B-A3B-Instruct, QwenTeam, 2025.08
Paper/Blog Link My Issue
#Article #EfficiencyImprovement #NLP #LanguageModel #Coding #MoE(Mixture-of-Experts) Issue Date: 2025-08-02 Comment
元ポスト:
Qwen3-30B-A3B-Thinking-2507, Qwen Team, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-07-31 Comment
元ポスト:
mediumサイズのモデルがさらに性能向上
GLM-4.5: Reasoning, Coding, and Agentic Abililties, Zhipu AI Inc., 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Selected Papers/Blogs Issue Date: 2025-07-29 Comment
元ポスト:
HF: https://huggingface.co/collections/zai-org/glm-45-687c621d34bda8c9e4bf503b
詳細なまとめ:
こちらでもMuon Optimizerが使われており、アーキテクチャ的にはGQAやMulti Token Prediction, QK Normalization, MoE, 広さよりも深さを重視の構造、みたいな感じな模様?
- [Paper Note] Muon is Scalable for LLM Training, Jingyuan Liu+, arXiv'25, 2025.02
Qwen3-235B-A22B-Thinking-2507, QwenTeam, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-07-26 Comment
とうとうベンチマーク上はo4-miniと同等に...
OpenReasoning-Nemotron: A Family of State-of-the-Art Distilled Reasoning Models, Nvidia, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Distillation #OpenWeight #OpenSource Issue Date: 2025-07-18 Comment
DeepSeek-R1-0528から応答を合成したデータでSFTのみを実施し、32BでQwe3-235B-A22Bと同等か上回る性能。アーキテクチャはQwen2.5。データはOpenCode/Math/Scienceを利用。
元ポスト:
データも公開予定
SmolLM3: smol, multilingual, long-context reasoner, HuggingFace, 2025.07
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #LongContext #SmallModel #MultiLingual #OpenWeight #OpenSource #Selected Papers/Blogs Issue Date: 2025-07-09 Comment
元ポスト:
SmolLM3を構築する際の詳細なレシピ(アーキテクチャ、データ、data mixture, 3 stageのpretraining(web, code, mathの割合と品質をステージごとに変え、stable->stable->decayで学習), midtraining(long context->reasoning, post training(sft->rl), ハイブリッドreasoningモデルの作り方、評価など)が説明されている
学習/評価スクリプトなどがリリース:
New methods boost reasoning in small and large language models, Zhang+, Microsoft, 2025.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Mathematics #SmallModel #PostTraining #Generalization #One-Line Notes Issue Date: 2025-07-08 Comment
元ポスト:
要はLLMのreasoningに関して
- SLMの推論能力改善
- 数学的な推論能力の改善
- ドメインを跨いだ汎化
の3つについてMSRで研究されたいくつかの文献が紹介されている。
Hunyuan-A13B-Instruct, tencent, 2025.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #One-Line Notes Issue Date: 2025-06-27 Comment
元ポスト:
- MoEアーキテクチャ, 80B-A13B
- fast, slow thinking mode
- 256k context window
- agenticタスクに特に特化
- Grouped Query Attention, 複数の量子化フォーマットをサポート
公式ポスト:
画像は公式ポストより引用。Qwen3-235B-A22Bよりも少ないパラメータ数で、同等(agenticタスクはそれ以上)なようにベンチマーク上は見えるが、果たして。
果たして日本語の性能はどうだろうか。
TENCENT HUNYUAN COMMUNITY LICENSE
https://github.com/Tencent-Hunyuan/Hunyuan-A13B/blob/main/LICENSE
Kimi-VL-A3B-Thinking-2506, moonshotai, 2025.06
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #MultiModal #OpenWeight #One-Line Notes #Reference Collection Issue Date: 2025-06-24 Comment
元ポスト:
様々なベンチマークでSoTA(gpt4o, Qwen2.5-VL-7B)を達成したReasoning VLM
テクニカルペーパー:
- [Paper Note] Kimi-VL Technical Report, Kimi Team+, arXiv'25
MiniMax-M1, MiniMax, 2025.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #MoE(Mixture-of-Experts) #One-Line Notes #Author Thread-Post Issue Date: 2025-06-17 Comment
元ポスト:
vLLMでのservingが推奨されており、コンテキストは1M、456BのMoEアーキテクチャでactivation weightは46B
公式ポスト:
Agentもリリースした模様:
Llama-3_1-Nemotron-Ultra-253B-v1, Nvidia, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #InstructionTuning #Pruning #OpenWeight #KeyPoint Notes #Author Thread-Post Issue Date: 2025-04-08 Comment
DeepSeek-R1をGPQA Diamond GPQA: A Graduate-Level Google-Proof Q&A Benchmark, David Rein+, N/A, COLM'24
, AIME2024/2025, Llama4 Maverickを
BFCLv2(Tool Calling, BFCLv2, UC Berkeley, 2024.08
), IFEVal [Paper Note] Instruction-Following Evaluation for Large Language Models, Jeffrey Zhou+, arXiv'23, 2023.11
で上回り, そのほかはArenaHardを除きDeepSeekR1と同等
DeepSeekR1が671B(MoEで37B Activation Param)に対し、こちらは253B(ただし、Llama3.1がベースなのでMoEではない)で同等以上の性能となっている。
ReasoningをON/OFFする能力も備わっている。
モデルがどのように訓練されたかを示す全体図がとても興味深い:
特に [Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
でも有効性が示されているように、SFTをしてからReasoningを強化する(強化というより元々持っている能力を引き出す?)RLを実施している。
詳細は下記Blogとのこと:
https://developer.nvidia.com/blog/build-enterprise-ai-agents-with-advanced-open-nvidia-llama-nemotron-reasoning-models/
元ポスト:
The "think" tool: Enabling Claude to stop and think in complex tool use situations, Anthropic, 2025.03
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Chain-of-Thought #Blog #One-Line Notes Issue Date: 2025-03-23 Comment
"考える"ことをツールとして定義し利用することで、externalなthinkingを明示的に実施した上でタスクを遂行させる方法を紹介している
Hunyuan T1, Tencent, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Proprietary #SSM (StateSpaceModel) #One-Line Notes #Reading Reflections Issue Date: 2025-03-22 Comment
元ポスト:
画像はブログより引用。DeepSeek-R1と比較すると優っているタスクと劣っているタスクがあり、なんとも言えない感。GPT4.5より大幅に上回っているタスク(Math, Reasoning)があるが、そもそもそういったタスクはo1などのreasoningモデルの領域。o1と比較するとこれもまあ優っている部分もあれば劣っている部分もあるという感じ。唯一、ToolUseに関しては一貫してOpenAIモデルの方が強い。
ChineseタスクについてはDeepSeek-R1と完全にスコアが一致しているが、評価データのサンプル数が少ないのだろうか?
reasoningモデルかつ、TransformerとMambaのハイブリッドで、MoEを採用しているとのこと。
TransformerとMambaのハイブリッドについて(WenhuChen氏のポスト):
Layer-wise MixingとSequence-wise Mixingの2種類が存在するとのこと。前者はTransformerのSelf-Attenton LayerをMamba Layerに置換したもので、後者はSequenceのLong partをMambaでまずエンコードし、Short PartをTransformerでデコードする際のCross-Attentionのencoder stateとして与える方法とのこと。
Self-Attention Layerを削減することでInference時の計算量とメモリを大幅に削減できる(Self-Attentionは全体のKV Cacheに対してAttentionを計算するため)。
Sudoku-bench, SakanaAI, 2025.03
Paper/Blog Link My Issue
#Article #NLP #Dataset #LanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2025-03-21 Comment
元ポスト:
既存モデルでベンチマークを取ったらどういうランキングになるのだろうか。特にまだそういぅたランキングは公開されていない模様。
ブログ記事に(将来的に最新の結果をrepositoryに追記される模様)現時点でのリーダーボードが載っていた。現状、o3-miniがダントツに見える。
https://sakana.ai/sudoku-bench/
Llama Nemotron, Nvidia, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-03-19 Comment
Nvidiaによる初めてのreasoning model。
元ポスト:
Artificial Analysisにやるベンチマーク:
GPQA Diamond(大学院(Ph.D)レベルの生物学、物理学、化学の450問程度の難解なmultiple choice question)で、DeepSeekV3, GPT4o, QwQ-32Bをoutperform. Claude 3.7 sonnetより少しスコアが低い。
DeepSeekR1, o1, o3-mini(high), Claude 3.7 sonnet Thinkingなどには及んでいない。
(画像は元ポストより引用)
システムプロンプトを変えることでreasoningをon/offできる模様
EXAONE-Deep-32B, LG AI Research, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #One-Line Notes Issue Date: 2025-03-18 Comment
元ポスト:
EXAONE AI Model License Agreement 1.1 - NC
商用利用不可
Reasoning with Reka Flash, Reka, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #MultiLingual #OpenWeight #Initial Impression Notes Issue Date: 2025-03-12 Comment
Weights: https://huggingface.co/RekaAI/reka-flash-3
Apache-2.0
< /reasoning >を強制的にoutputさせることでreasoningを中断させることができ予算のコントロールが可能とのこと
The State of LLM Reasoning Models, Sebastian Raschka, 2025.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Blog #Test-Time Scaling Issue Date: 2025-03-09
QwQ-32B: Embracing the Power of Reinforcement Learning, Qwen Team, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #OpenWeight #Reading Reflections Issue Date: 2025-03-06 Comment
元ポスト:
- [Paper Note] START: Self-taught Reasoner with Tools, Chengpeng Li+, arXiv'25, 2025.03
Artificial Analysisによるベンチマークスコア:
おそらく特定のタスクでDeepSeekR1とcomparable, 他タスクでは及ばない、という感じになりそうな予感
Open Reasoner Zero, Open-Reasoner-Zero, 2024.02
Paper/Blog Link My Issue
#Article #MachineLearning #NLP #LanguageModel #Library #ReinforcementLearning #python Issue Date: 2025-03-02 Comment
元ポスト:
Mistral-24B-Reasoning, yentinglin, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-02-17 Comment
Apache-2.0
Unsloth で独自の R1 Reasoningモデルを学習, npaka, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #Reading Reflections Issue Date: 2025-02-07 Comment
非常に実用的で参考になる。特にどの程度のVRAMでどの程度の規模感のモデルを使うことが推奨されるのかが明言されていて参考になる。
Open R1, HuggingFace, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #OpenSource #Selected Papers/Blogs #One-Line Notes #Reference Collection Issue Date: 2025-01-26 Comment
HFによるDeepSeekR1を完全に再現する取り組み
Update1: https://huggingface.co/blog/open-r1/update-1
Update2:
https://huggingface.co/blog/open-r1/update-2
512機のH100を利用…
DeepSeek-R1-Distill-Qwen, DeepSeek, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight Issue Date: 2025-01-21 Comment
MIT Licence
元ポスト:
DeepSeek-R1, DeepSeek, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #OpenWeight #Selected Papers/Blogs #Reference Collection Issue Date: 2025-01-21 Comment
参考:
参考: https://horomary.hatenablog.com/entry/2025/01/26/204545
DeepSeek-R1の論文読んだ?【勉強になるよ】
, asap:
https://zenn.dev/asap/articles/34237ad87f8511
こちらのポストの図解がわかりやすい:
最新モデル: DeepSeek-R1-0528
https://huggingface.co/deepseek-ai/DeepSeek-R1-0528
所見:
LLMを数学タスクにアラインする手法の系譜 - GPT-3からQwen2.5まで, bilzard, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #Chain-of-Thought #Mathematics #PostTraining #Reading Reflections Issue Date: 2024-12-27 Comment
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
において、数学においてモデルのパラメータ数のスケーリングによって性能改善が見込める学習手法として、モデルとは別にVerifierを学習し、モデルが出力した候補の中から良いものを選択できるようにする、という話の気持ちが最初よくわからなかったのだが、後半のなぜsample&selectがうまくいくのか?節を読んでなんとなく気持ちが理解できた。SFTを進めるとモデルが出力する解放の多様性が減っていくというのは、興味深かった。
しかし、特定の学習データで学習した時に、全く異なるUnseenなデータに対しても解法は減っていくのだろうか?という点が気になった。あとは、学習データの多様性をめちゃめちゃ増やしたらどうなるのか?というのも気になる。特定のデータセットを完全に攻略できるような解法を出力しやすくなると、他のデータセットの性能が悪くなる可能性がある気がしており、そうするとそもそもの1shotの性能自体も改善していかなくなりそうだが、その辺はどういう設定で実験されているのだろうか。
たとえば、
- [Paper Note] Beyond Full Fine-tuning: Harnessing the Power of LoRA for Multi-Task Instruction Tuning, Xin+, LREC-COLING'24
などでは、
- [Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
のような1600を超えるようなNLPタスクのデータでLoRAによりSFTすると、LoRAのパラメータ数を非常に大きくするとUnseenタスクに対する性能がfull-parameter tuningするよりも向上することが示されている。この例は数学に特化した例ではないが、SFTによって解法の多様性が減ることによって学習データに過剰適合して汎化性能が低下する、というのであれば、この論文のことを鑑みると「学習データにoverfittingした結果他のデータセットで性能が低下してしまう程度の多様性の学習データしか使えていないのでは」と感じてしまうのだが、その辺はどうなんだろうか。元論文を読んで確認したい。
とても勉強になった。
記事中で紹介されている
> LLMを使って複数解法の候補をサンプリングし、その中から最適な1つを選択する
のルーツは
- [Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
とのことなので是非読みたい。
この辺はSelf-Consistency
- [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
あたりが最初なのかと思っていた。
OpenAI o1を再現しよう(Reasoningモデルの作り方), はち, 2024.12
Paper/Blog Link My Issue
#Article #LanguageModel #Blog #SelfCorrection #Reading Reflections Issue Date: 2024-12-22 Comment
Reflection after Thinkingを促すためのプロンプトが興味深い
OpenAI o1 System Card, OpenAI, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ChatGPT #Proprietary #VisionLanguageModel Issue Date: 2024-12-10
OpenAI o1, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Chain-of-Thought #Test-Time Scaling #Selected Papers/Blogs #VisionLanguageModel #KeyPoint Notes Issue Date: 2024-09-13 Comment
Jason Wei氏のポスト:
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
や
- [Paper Note] Implicit Chain of Thought Reasoning via Knowledge Distillation, Yuntian Deng+, arXiv'23, 2023.11
で似たような考えはすでに提案されていたが、どのような点が異なるのだろうか?
たとえば前者は、pauseトークンと呼ばれるoutputとは関係ないトークンを生成することで、outputを生成する前にモデル内部で推論する前により多くのベクトル操作を加える(=ベクトルを縦方向と横方向に混ぜ合わせる; 以後ベクトルをこねくりまわすと呼称する)、といった挙動を実現しているようだが、明示的にCoTの教師データを使ってSFTなどをしているわけではなさそうに見える(ざっくりとしか読んでないが)。
一方、Jason Wei氏のポストからは、RLで明示的により良いCoTができるように学習をしている点が違うように見える。
**(2025.0929): 以下のtest-time computeに関するメモはo1が出た当初のものであり、私の理解が甘い状態でのメモなので現在の理解を後ほど追記します。当時のメモは改めて見返すとこんなこと考えてたんだなぁとおもしろかったので残しておきます。**
学習の計算量だけでなく、inferenceの計算量に対しても、新たなスケーリング則が見出されている模様。
テクニカルレポート中で言われている time spent thinking (test-time compute)というのは、具体的には何なのだろうか。
上の研究でいうところの、inference時のpauseトークンの生成のようなものだろうか。モデルがベクトルをこねくり回す回数(あるいは生成するトークン数)が増えると性能も良くなるのか?
しかしそれはオリジナルのCoT研究である
- [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
のdotのみの文字列をpromptに追加して性能が向上しなかった、という知見と反する。
おそらく、**モデル学習のデコーディング時に**、ベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすこと=time spent thinking (test-time compute) 、ということなのだろうか?
そしてそのように学習されたモデルは、推論時にベクトルをこねくり回す回数(あるいは生成するトークン数)を増やすと性能が上がる、ということなのだろうか。
もしそうだとすると、これは
- Think before you speak: Training Language Models With Pause Tokens, Sachin Goyal+, N/A, ICLR'24
のpauseトークンの生成をしながらfinetuningすると性能が向上する、という主張とも合致するように思うが、うーん。
実際暗号解読のexampleを見ると、とてつもなく長いCoT(トークンの生成数が多い)が行われている。
RLでReasoningを学習させる関連研究:
- ReFT: Reasoning with Reinforced Fine-Tuning, Trung Quoc Luong+, N/A, ACL'24
- Training Large Language Models for Reasoning through Reverse Curriculum Reinforcement Learning, Zhiheng Xi+, N/A, ICML'24
以下o1の動きに関して考えている下記noteからの引用。
>これによって、LLMはモデルサイズやデータ量をスケールさせる時代から推論時間をスケールさせる(つまり、沢山の推論ステップを探索する)時代に移っていきそうです。
なるほど。test-compute timeとは、推論ステップ数とその探索に要する時間という見方もあるのですね。
またnote中では、CoTの性能向上のために、Process Reward Model(PRM)を学習させ、LLMが生成した推論ステップを評価できるようにし、PRMを報酬モデルとし強化学習したモデルがo1なのではないか、と推測している。
PRMを提案した研究では、推論ステップごとに0,1の正誤ラベルが付与されたデータから学習しているとのこと。
なるほど、勉強になります。
note:
https://note.com/hatti8/n/nf4f3ce63d4bc?sub_rt=share_pb
note(詳細編): https://note.com/hatti8/n/n867c36ffda45?sub_rt=share_pb
こちらのリポジトリに関連論文やXポスト、公式ブログなどがまとめられている:
https://github.com/hijkzzz/Awesome-LLM-Strawberry
これはすごい。論文全部読みたい
Gemma2, Google Deepmind, 2024
Paper/Blog Link My Issue
#Article #NLP #Coding #Mathematics #OpenWeight #One-Line Notes Issue Date: 2024-07-30 Comment
Reasoning, Math, CodeGenerationに強み
Towards Complex Reasoning: the Polaris of Large Language Models, Yao Fu, 2023.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #Evaluation #Blog #mid-training #PostTraining Issue Date: 2023-05-04