
Selected Papers/Blogs (1336) — 4/7
[Paper Note] MegaMath: Pushing the Limits of Open Math Corpora, Fan Zhou+, COLM'25
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #SyntheticData #Coding #Mathematics #mid-training #COLM #KeyPoint Notes Issue Date: 2025-07-10 GPT Summary- MegaMathは、数学に特化したオープンデータセットで、LLMの数学的推論能力を向上させるために作成された。ウェブデータの再抽出、数学関連コードの特定、合成データの生成を通じて、371Bトークンの高品質なデータを提供し、既存のデータセットを上回る量と品質を実現した。 Comment
元ポスト:
非常に大規模な数学の事前学習/mid-training向けのデータセット
CommonCrawlのHTMLから、さまざまなフィルタリング処理(reformatting, 2 stageのHTML parserの活用(片方はnoisyだが高速、もう一方は高性能だが遅い), fasttextベースの分類器による抽出, deduplication等)を実施しMegaMath-Webを作成、また、MegaMathWebをさらに分類器で低品質なものをフィルタリングし、LLMによってノイズ除去、テキストのreorganizingを実施し(≠ピュアな合成データ)継続事前学習、mid-training向けの高品質なMegaMath-Web-Proを作成。
MegaMathCodeはThe Stack V2 ([Paper Note] StarCoder 2 and The Stack v2: The Next Generation, Anton Lozhkov+, arXiv'24
) をベースにしており、mathematical reasoning, logic puzzles, scientific computationに関するコードを収集。まずこれらのコードと関連が深い11のプログラミング言語を選定し、そのコードスニペットのみを対象とする。次にstrong LLMを用いて、数学に関するrelevanceスコアと、コードの品質を0--6のdiscrete scoreでスコアリングし学習データを作成。作成した学習データでSLMを学習し大規模なフィルタリングを実施することでMegaMath-Codeを作成。
最後にMegaMath-{Web, code}を用いて、Q&A, code data, text&code block dataの3種類を合成。Q&Aデータの合成では、MegaMath-WebからQAペアを抽出し、多様性とデータ量を担保するためQwen2.5-72B-Instruct, Llama3.3-70B-Instructの両方を用いて、QAのsolutionを洗練させる(reasoning stepの改善, あるいはゼロから生成する[^1])ことで生成。また、code dataでは、pythonを対象にMegaMath-Codeのデータに含まれるpython以外のコードを、Qwen2.5-Coder-32B-Instructと、Llamd3.1-70B-Instructによってpythonに翻訳することでデータ量を増やした。text&code blockデータでは、MegaMath-Webのドキュメントを与えて、ブロックを生成(タイトル、数式、結果、コードなど[^1])し、ブロックのverificationを行い(コードが正しく実行できるか、実行結果とanswerが一致するか等)、verifiedなブロックを残すことで生成。
[^1]: この辺は論文の記述を咀嚼して記述しており実サンプルを見ていないので少し正しい認識か不安
[Paper Note] SmolVLM: Redefining small and efficient multimodal models, Andrés Marafioti+, arXiv'25
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #SmallModel #OpenWeight #Architecture #COLM #read-later #VisionLanguageModel #EdgeDevices Issue Date: 2025-07-09 GPT Summary- SmolVLMは、リソース効率の良い推論のために設計されたコンパクトなマルチモーダルモデルシリーズであり、低い計算オーバーヘッドを持つアーキテクチャやトークン化戦略を採用。最小モデルのSmolVLM-256Mは、1GB未満のGPUメモリでIdefics-80Bモデルを上回る性能を発揮し、最大モデルは2.2Bパラメータで最先端のVLMに匹敵。これにより、エネルギー効率の良い実用的な展開が可能となる。 Comment
HFSpace: https://huggingface.co/blog/smolervlm
元ポスト:
openreview: https://openreview.net/forum?id=qMUbhGUFUb
[Paper Note] VLM2Vec: Training Vision-Language Models for Massive Multimodal Embedding Tasks, Ziyan Jiang+, ICLR'25
Paper/Blog Link My Issue
#ComputerVision #Embeddings #NLP #Dataset #Evaluation #MultiModal #ICLR #read-later #VisionLanguageModel Issue Date: 2025-07-09 GPT Summary- 本研究では、ユニバーサルマルチモーダル埋め込みモデルの構築を目指し、二つの貢献を行った。第一に、MMEB(Massive Multimodal Embedding Benchmark)を提案し、36のデータセットを用いて分類や視覚的質問応答などのメタタスクを網羅した。第二に、VLM2Vecというコントラストトレーニングフレームワークを開発し、視覚-言語モデルを埋め込みモデルに変換する手法を示した。実験結果は、VLM2Vecが既存のモデルに対して10%から20%の性能向上を達成することを示し、VLMの強力な埋め込み能力を証明した。 Comment
openreview: https://openreview.net/forum?id=TE0KOzWYAF
[Paper Note] VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents, Rui Meng+, arXiv'25
Paper/Blog Link My Issue
#ComputerVision #Embeddings #InformationRetrieval #NLP #LanguageModel #MultiModal #RAG(RetrievalAugmentedGeneration) #read-later #VisionLanguageModel #Initial Impression Notes #Author Thread-Post Issue Date: 2025-07-09 GPT Summary- VLM2Vec-V2という統一フレームワークを提案し、テキスト、画像、動画、視覚文書を含む多様な視覚形式の埋め込みを学習。新たにMMEB-V2ベンチマークを導入し、動画検索や視覚文書検索など5つのタスクを追加。広範な実験により、VLM2Vec-V2は新タスクで強力なパフォーマンスを示し、従来の画像ベンチマークでも改善を達成。研究はマルチモーダル埋め込みモデルの一般化可能性に関する洞察を提供し、スケーラブルな表現学習の基盤を築く。 Comment
元ポスト:
Video Classification, Visual Document Retrievalなどのモダリティも含まれている。
[Paper Note] On the Trustworthiness of Generative Foundation Models: Guideline, Assessment, and Perspective, Yue Huang+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#Survey #ComputerVision #NLP #LanguageModel #Hallucination #Faithfulness #TextToImageGeneration #Sycophancy #Safety #Toxicity #Trustfulness #VisionLanguageModel #Privacy #One-Line Notes #ImageSynthesis #Robustness #Fairness Issue Date: 2025-07-08 GPT Summary- GenFMの信頼性向上に向け、AIガバナンスや産業標準を体系的に分析し、技術・倫理・法・社会的観点を統合した指針を提案。 テキスト・画像生成モデルやLLM、VLMを対象に、メタデータのキュレーション、テストケース生成、文脈変化に対応する動的評価基盤TrustGenを導入。 信頼性の進展と残存課題を明らかにし、有用性とのトレードオフや今後の研究方針を整理するとともに、動的評価ツールキットを公開。 Comment
元ポスト:
信頼性のある生成AIに関して、主要な企業がどのような取り組みをしているか、そもそもどのような観点で評価が実施されるかなどが、T2I, LLM, VLMなどにわかれて、各指標の定義や各モデルのベンチマークスコアなどが網羅的に記載されているようである。
[Paper Note] AI Research Agents for Machine Learning: Search, Exploration, and Generalization in MLE-bench, Edan Toledo+, NeurIPS'25, 2025.07
Paper/Blog Link My Issue
#GraphBased #NLP #Search #LanguageModel #AIAgents #ScientificDiscovery #NeurIPS #read-later #EvolutionaryAlgorithm #Initial Impression Notes #autoresearch/RSI #Author Thread-Post Issue Date: 2025-07-08 GPT Summary- AI研究エージェントを、演算子で候補解を反復的に変更する探索方策として定式化。 異なる演算子集合と貪欲法・MCTS・進化的手法を組み合わせ、相互作用を体系的に検証。 最良の組み合わせにより、MLE-bench liteでKaggleメダル獲得成功率を39.6%から47.7%に向上させ、最先端性能を達成。 Comment
元ポスト:
関連:
- MLE-Bench, OpenAI, 2024.10
グラフ中の各ノードはartifacts(i.e., エージェントが生成したコード)で、先行研究がiterativeな実験に加え、潜在的なsolutionに対してtree searchをすることでSoTAを達成しており、これをグラフを用いてより一般化することで異なるデザインのエージェントでも適用できるようにしている。
あとで追記する
openreview: https://openreview.net/forum?id=RwfrdKSgCE
[Paper Note] Correlated Errors in Large Language Models, Elliot Kim+, ICML'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Evaluation #LLM-as-a-Judge #ICML #reading #One-Line Notes Issue Date: 2025-07-05 GPT Summary- 350以上のLLMを評価し、リーダーボードと履歴書スクリーニングタスクで実証的な分析を実施。モデル間のエラーには実質的な相関があり、特に大きく正確なモデルは異なるアーキテクチャやプロバイダーでも高い相関を示す。相関の影響はLLMを評価者とするタスクや採用タスクにおいても確認された。 Comment
元ポスト:
これは結果を細かく見るのと、評価したタスクの形式とバイアスが生じないかをきちんと確認した方が良いような気がする。
それは置いておいたとして、たとえば、Figure9bはLlamaの異なるモデルサイズは、高い相関を示しているが、それはベースが同じだからそうだろうなあ、とは思う。一方、9aはClaude, Nova, Mistral, GPTなど多様なプロバイダーのモデルで高い相関が示されている。Llama3-70BとLLama3.{1,2,3}-70Bでは相関が低かったりしている。
Figure1(b)はHELMで比較的最新のモデル間でプロバイダーが別でも高い相関があるようにみえる。
このような相関がある要因や傾向については論文を読んでみないとわからない。
LLM-as-a-Judgeにおいて、評価者となるモデルと評価対象となるモデルが同じプロバイダーやシリーズの場合は(エラーの傾向が似ているので)性能がAccuracyが真のAccuracyよりも高めに出ている。また評価者よりも性能が低いモデルに対しても、性能が実際のAccuracyよりも高めに出す傾向にある(エラーの相関によってエラーであるにも関わらず正解とみなされAccuracyが高くなる)ようである。逆に、評価者よりも評価対象が性能が高い場合、評価者は自分が誤ってしまうquestionに対して、評価対象モデルが正解となる回答をしても、それに対して報酬を与えることができず性能が低めに見積もられてしまう。これだけの規模の実験で示されたことは、大変興味深い。
履歴書のスクリーニングタスクについてもケーススタディをしている。こちらも詳細に分析されているので興味がある場合は参照のこと。
[Paper Note] The Curse of Depth in Large Language Models, Wenfang Sun+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #NeurIPS #Normalization #One-Line Notes #CurseOfDepth Issue Date: 2025-07-03 GPT Summary- 「深さの呪い」を提案し、現代のLLMにおける多くの層が期待通りに機能しない原因を探る。特にPre-Layer Normalizationが出力分散を増大させ、深層ブロックの寄与を低下させることを明らかにする。層正規化の出力分散を深さの平方根の逆数で調整する「LayerNorm Scaling」を導入し、これにより深い層の寄与を改善。実験で130M〜7Bモデルサイズで従来の手法を上回る性能向上を示し、教師ありファインチューニングにも良好な効果を発揮することを確認。 Comment
元ポスト:
- [Paper Note] Transformers without Normalization, Jiachen Zhu+, CVPR'25
ではそもそもLayerNormalizationを無くしていた(正確にいうとparametrize tanhに置換)が、どちらが優れているのだろうか?
- Knowledge Neurons in Pretrained Transformers, Damai Dai+, N/A, ACL'22, 2022.05
では知識ニューロンの存在が示唆されており、これはTransformerの層の深い位置に存在し、かつ異なる知識間で知識ニューロンはシェアされない傾向にあった(ただしこれはPost-LNのBERTの話で本研究はPre-LNの話だが。Post-LNの勾配消失問題を緩和し学習を安定化させる研究も[Paper Note] On Layer Normalizations and Residual Connections in Transformers, Sho Takase+, arXiv'22
のように存在する)。これはこの研究が明らかにしたこととどういう関係性があるだろうか。
また、LayerNormalizationのScalingによって深いTransformerブロックの導関数が単位行列となる(学習に寄与しなくなる)ことが改善された場合、知識ニューロンはどのように変化するだろうか?
(下記Geminiの応答を見た上での感想)なんとなーくだけれども、おそらく知識ニューロンの局所化が解消されるのかなーという気がする。
となると次の疑問としては、MoEアーキテクチャにはどのような影響があるだろうか?
そもそも知識ニューロンが局所化しているからMoEアーキテクチャのルータによって関連するExpertsのみをactivateすれば(というより結果的にそうなるように学習される)性能を劣化させずに計算効率を上げられていた、と仮定する。そうすると、知識ニューロンが局所化せずに多くのニューロンでシェアされるようになると、[Paper Note] Chain-of-Experts: Unlocking the Communication Power of Mixture-of-Experts Models, Zihan Wang+, arXiv'25, 2025.06
のように、サブネットワーク間の情報を互いにやりとりできます、みたいな仕組みがより効いてきそうな気がする。
参考までに、Gemini2.5-Proに考察させてみた結果をメモとして残しておく(あくまで参考程度に...)
```
ご質問ありがとうございます。非常に興味深い着眼点ですね。「Knowledge Neurons in Pretrained Transformers」と「The Curse of Depth in Large Language Models」は、一見すると全く異なるテーマを扱っているように見えますが、**「Transformerの深い層における振る舞い」**という共通点で結びつけて考察すると、非常に示唆に富んだ関係性が見えてきます。
以下に、両方の論文の概要を解説し、その関係性について考察します。
1. Knowledge Neurons in Pretrained Transformers の概要
この研究は、事前学習済みTransformerモデル(特にBERTなど)の内部で、特定の事実知識がどのように格納されているかを調査したものです。
発見: モデルの中間層、特に**全結合層(Feed-Forward Network, FFN)に、特定の知識(例:「ダンテ・アリギエーリはイタリアで生まれた」)に強く反応する「知識ニューロン」**が存在することを発見しました。
特徴: これらの知識ニューロンは、モデルの深い層(後方の層)に、より多く存在する傾向がありました。
意味: これまでブラックボックスとされてきた大規模言語モデルの内部で、知識がどのように表現・局在化しているかについて、具体的な手がかりを与えた画期的な研究です。
2. The Curse of Depth in Large Language Models の概要
この研究は、LLMをより深く(層を多く)することの難しさに焦点を当て、その原因と解決策を提案したものです。
問題(深さの呪い): Transformerの標準的なアーキテクチャ(Pre-LN)では、層が深くなるにつれて、LayerNormalization(LN)への入力の分散が指数関数的に増大してしまいます。
結果:
出力が大きくなりすぎて学習が不安定になります。
さらに深刻なのは、深い層ではモデルの出力に関する導関数(勾配計算に必要)がほぼ単位行列になってしまうことです。これは、その層が入力に対してほとんど変換を行わなくなり、学習に寄与しなくなることを意味します。
解決策: この問題を解決するため、各層のLayerNormalizationをその深さ(レイヤー番号 l)に応じてスケーリングするというシンプルな手法を提案しました。これにより、深い層でも勾配が適切に伝播し、学習が安定・改善することが示されました。
考察:2つの研究の関係性
これら2つの研究は、**「学習の安定性」と「知識の格納方法」**という異なる側面から、Transformerの深い層を分析していますが、両者には以下のような深い関係性があると考えられます。
学習の不安定性が「知識ニューロン」形成の背景にある可能性
「The Curse of Depth」で指摘されているように、標準的なTransformerの深い層は、本質的に学習が不安定で、勾配情報が失われやすい環境にあります。
この劣悪な学習環境こそが、「知識ニューロン」という形で知識が局所的に格納される原因の一つになっている可能性があります。つまり、
学習の非効率性: 深い層のほとんどのニューロンは、勾配消失問題のために効率的に学習を進めることができません。
専門化の発生: そのような不安定な環境下で、たまたま特定の知識パターンをうまく捉えることができた一部のニューロンが、その知識を一身に背負う形で強く活性化するよう特化(専門化)していったのではないか、と考えられます。これは、ネットワーク全体で協調して学習するのが難しい状況で、一部のユニットだけが突出して学習を担う、という現象と解釈できます。
学習の安定化が、より効率的な知識獲得につながる
では、「The Curse of Depth」で提案された手法(LNのスケーリング)によって深い層の学習が安定化すると、知識の格納方法はどのように変わるでしょうか。
これは非常に興味深い問いであり、2つの可能性が考えられます。
可能性A: より強固な知識ニューロンの形成:
学習が安定することで、各知識ニューロンはより明確に、そして効率的に特定の知識をエンコードできるようになるかもしれません。ノイズの多い環境で偶然生まれた専門家ではなく、安定した環境で育成された真の専門家へと変化するイメージです。
可能性B: 知識の分散化:
ネットワークの全ニューロンが効率的に学習に寄与できるようになるため、一つの知識を少数のニューロンに集中させる必要がなくなり、より多くのニューロンに分散して知識が格納されるようになる可能性も考えられます。
現在のところ、学習の安定化は、知識ニューロンがより効率的に形成・機能するための基盤を提供すると考えるのが最も妥当でしょう。「深さの呪い」という問題を解決することは、モデルが知識をどのように獲得し、整理するかという、より根源的なメカニズム(知識ニューロンの振る舞い)にも直接的な影響を与えるはずです。
まとめ
「Knowledge Neurons」は深い層に存在する知識の**「状態」を明らかにし、「The Curse of Depth」は深い層で発生する学習の「問題」**とその解決策を提示しました。
これらを統合すると、**「深い層における学習の不安定性という問題が、知識ニューロンという局所的な知識表現を生み出す一因となっており、この問題を解決することで、より効率的で安定した知識の獲得・格納が可能になるかもしれない」**という関係性が見えてきます。
両者は、LLMの能力と限界を異なる角度から照らし出しており、組み合わせることでモデルの内部動作の解明をさらに一歩前進させる、非常に重要な研究だと言えます。
```
[Paper Note] GLM-4.1V-Thinking: Towards Versatile Multimodal Reasoning with Scalable Reinforcement Learning, GLM-V Team+, arXiv'25, 2025.07
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #Supervised-FineTuning (SFT) #ReinforcementLearning #MultiModal #RLHF #Reasoning #LongContext #mid-training #RewardHacking #PostTraining #CurriculumLearning #RLVR #VisionLanguageModel #One-Line Notes Issue Date: 2025-07-03 GPT Summary- 視覚言語モデルGLM-4.1V-Thinkingを発表し、推論中心のトレーニングフレームワークを開発。強力な視覚基盤モデルを構築し、カリキュラムサンプリングを用いた強化学習で多様なタスクの能力を向上。28のベンチマークで最先端のパフォーマンスを達成し、特に難しいタスクで競争力のある結果を示す。モデルはオープンソースとして公開。 Comment
元ポスト:
Qwen2.5-VLよりも性能が良いVLM
アーキテクチャはこちら。が、pretraining(データのフィルタリング, マルチモーダル→long context継続事前学習)->SFT(cold startへの対処, reasoning能力の獲得)->RL(RLVRとRLHFの併用によるパフォーマンス向上とAlignment, RewardHackingへの対処,curriculum sampling)など、全体の学習パイプラインの細かいテクニックの積み重ねで高い性能が獲得されていると考えられる。
[Paper Note] FineWeb2: One Pipeline to Scale Them All -- Adapting Pre-Training Data Processing to Every Language, Guilherme Penedo+, COLM'25
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Dataset #LanguageModel #MultiLingual #COLM #Initial Impression Notes Issue Date: 2025-06-28 GPT Summary- 多言語LLMsの性能向上のために、FineWebに基づく新しい事前学習データセットキュレーションパイプラインを提案。9つの言語に対して設計選択肢を検証し、非英語コーパスが従来のデータセットよりも高性能なモデルを生成できることを示す。データセットの再バランス手法も導入し、1000以上の言語にスケールアップした20テラバイトの多言語データセットFineWeb2を公開。 Comment
元ポスト:
abstを見る限りFinewebを多言語に拡張した模様
openreview: https://openreview.net/forum?id=jnRBe6zatP#discussion
[Paper Note] OctoThinker: Mid-training Incentivizes Reinforcement Learning Scaling, Zengzhi Wang+, arXiv'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #ReinforcementLearning #mid-training #PostTraining #read-later #Initial Impression Notes Issue Date: 2025-06-27 GPT Summary- 異なるベース言語モデル(LlamaやQwen)の強化学習(RL)における挙動を調査し、中間トレーニング戦略がRLのダイナミクスに与える影響を明らかに。高品質の数学コーパスがモデルのパフォーマンスを向上させ、長い連鎖的思考(CoT)がRL結果を改善する一方で、冗長性や不安定性を引き起こす可能性があることを示す。二段階の中間トレーニング戦略「Stable-then-Decay」を導入し、OctoThinkerモデルファミリーを開発。オープンソースのモデルと数学推論コーパスを公開し、RL時代の基盤モデルの研究を支援することを目指す。 Comment
元ポスト:
mid-trainingの観点から、post trainingにおけるRLがスケーリングする条件をsystematicallyに調査している模様
論文中にはmid-training[^1]の定義が記述されている:
[^1]: mid-trainingについてはコミュニティの間で厳密な定義はまだ無くバズワードっぽく使われている、という印象を管理人は抱いており、本稿は文献中でmid-trainingを定義する初めての試みという所感
ざっくり言うと、上記論文中の定義でいうと、mid-trainingとは特定の目的を実現するための事前学習と事後学習の間における中間に位置する学習ステージであり、たとえば特定ドメインの知識の獲得や、事後学習の準備などが含まれる。
最近だと、コーディングや論理的思考力などの特定ドメインの能力の獲得や、context長を伸ばすために実施したり、特定ドメインでのRLの前段階としてSFTを通じてwarm-upをする(reasoning能力の獲得等)などが中間学習で実施されている印象がある。
[Paper Note] OpenVision: A Fully-Open, Cost-Effective Family of Advanced Vision Encoders for Multimodal Learning, Xianhang Li+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #Pretraining #OpenWeight #OpenSource #ICCV #Encoder #Backbone #One-Line Notes Issue Date: 2025-06-26 GPT Summary- CLIPに代わる完全にオープンで費用対効果に優れた視覚エンコーダ群OpenVisionを提案。 CLIPSとRecap-DataComp-1Bを基盤に、LLaVAなどのマルチモーダルモデルでCLIPと同等以上の性能を実現。 5.9M〜632.1Mパラメータのモデルを公開し、性能重視からエッジ向けの軽量展開まで柔軟な選択肢を提供。 Comment
元ポスト:
v2へアップデート:
事前学習時にtext, image encoderのcontrastive lossで学習していたが、text encoderを無くしimage encoderに入力されたimageからcaptionを生成するcaption lossのみにすることで性能を落とすことなく効率を改善
テクニカルペーパーが出た模様
- [Paper Note] OpenVision 2: A Family of Generative Pretrained Visual Encoders for Multimodal Learning, Yanqing Liu+, arXiv'25
HF:
https://huggingface.co/collections/UCSC-VLAA/openvision-681a4c27ee1f66411b4ae919
pj page:
https://ucsc-vlaa.github.io/OpenVision/
CLIP, SigLIPとは異なり完全にオープンなVision Encoder
v2の解説:
[Paper Note] RewardBench: Evaluating Reward Models for Language Modeling, Nathan Lambert+, NAACL'25 Findings, 2024.05
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #ReinforcementLearning #Evaluation #NAACL #RewardModel #Findings Issue Date: 2025-06-26 GPT Summary- 報酬モデル(RMs)の評価に関する研究は少なく、我々はその理解を深めるためにRewardBenchというベンチマークデータセットを提案。これは、チャットや推論、安全性に関するプロンプトのコレクションで、報酬モデルの性能を評価する。特定の比較データセットを用いて、好まれる理由を検証可能な形で示し、さまざまなトレーニング手法による報酬モデルの評価を行う。これにより、報酬モデルの拒否傾向や推論の限界についての知見を得ることを目指す。 Comment
[Paper Note] Magpie: Alignment Data Synthesis from Scratch by Prompting Aligned LLMs with Nothing, Zhangchen Xu+, ICLR'25, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #SyntheticData #ICLR #KeyPoint Notes Issue Date: 2025-06-25 GPT Summary- 高品質な指示データはLLMの整合に不可欠であり、Magpieという自己合成手法を提案。Llama-3-Instructを用いて400万の指示と応答を生成し、30万の高品質なインスタンスを選定。Magpieでファインチューニングしたモデルは、従来のデータセットを用いたモデルと同等の性能を示し、特に整合ベンチマークで優れた結果を得た。 Comment
OpenReview: https://openreview.net/forum?id=Pnk7vMbznK
下記のようなpre-queryテンプレートを与え(i.e., userの発話は何も与えず、ユーザの発話を表す特殊トークンのみを渡す)instructionを生成し、post-queryテンプレートを与える(i.e., pre-queryテンプレート+生成されたinstruction+assistantの発話の開始を表す特殊トークンのみを渡す)ことでresponseを生成することで、prompt engineeringやseed無しでinstruction tuningデータを合成できるという手法。
```T_pre−query = <|start_header_id|>user<|end_header_id|>```
```T_post−query =<|eot_id|><|start_header_id|>assistant<|end_header_id|>```
生成した生のinstruction tuning pair dataは、たとえば下記のようなフィルタリングをすることで品質向上が可能で (Appendix C)
- input length: instructionの中の文字数
- output length: response中の文字数
- task category: instructionの特定のカテゴリ
- input quality: 5段階評価によるinstructionの明瞭さ、具体性、coherence
- input difficulty: 5段階評価によるinstruction中に記述されているタスクを解決するために必要な知識のレベル
- minimum neighbor distance: 最近傍のinstructionsとのembedding空間上での距離で、類似性や繰り返しを排除
- reward: reward modelのスコアによる繰り返しや低品質なレスポンスの排除
- reward distance: 同じinstructionで、instructモデルが生成したresponseのベースモデルが生成したresponseのreward modelによるrewardの差(これが大きいほど高品質なinstruction tuning dataと言える)
Table 5 に実際にどのような組み合わせでこれらが適用されたかが記載されている。
reward modelと組み合わせてLLMからのresponseを生成しrejection samplingすればDPOのためのpreference dataも作成できるし、single turnの発話まで生成させた後もう一度pre/post-queryをconcatして生成すればMulti turnのデータも生成できる。
他のも例えば、システムプロンプトに自分が生成したい情報を与えることで、特定のドメインに特化したデータ、あるいは特定の言語に特化したデータも合成できる。
[Paper Note] Mind the Gap: Examining the Self-Improvement Capabilities of Large Language Models, Yuda Song+, ICLR'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #SelfImprovement #ICLR #read-later #Verification #Initial Impression Notes Issue Date: 2025-06-24 GPT Summary- 自己改善はLLMの出力検証を通じてデータをフィルタリングし、蒸留するメカニズムである。本研究では、自己改善の数学的定式化を行い、生成-検証ギャップに基づくスケーリング現象を発見。さまざまなモデルとタスクを用いた実験により、自己改善の可能性とその性能向上方法を探求し、LLMの理解を深めるとともに、将来の研究への示唆を提供する。 Comment
参考: https://joisino.hatenablog.com/entry/mislead
Verificationに対する理解を深めるのに非常に良さそう
openreview: https://openreview.net/forum?id=mtJSMcF3ek
[Paper Note] Revisiting Reinforcement Learning for LLM Reasoning from A Cross-Domain Perspective, Zhoujun Cheng+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #ReinforcementLearning #Reasoning #NeurIPS #mid-training #PostTraining #read-later #RLVR #DataMixture #CrossDomain #KeyPoint Notes #Reading Reflections #Author Thread-Post Issue Date: 2025-06-22 GPT Summary- Guruを導入し、数学、コード、科学、論理、シミュレーション、表形式の6つの推論ドメインにわたる92KのRL推論コーパスを構築。これにより、LLM推論のためのRLの信頼性と効果を向上させ、ドメイン間の変動を観察。特に、事前学習の露出が限られたドメインでは、ドメイン内トレーニングが必要であることを示唆。Guru-7BとGuru-32Bモデルは、最先端の性能を達成し、複雑なタスクにおいてベースモデルの性能を改善。データとコードは公開。 Comment
元ポスト:
post-trainingにおけるRLのcross domain(Math, Code, Science, Logic, Tabular)における影響を調査した研究。非常に興味深い研究。詳細は元論文が著者ポスト参照のこと。
Qwenシリーズで実験。以下元ポストのまとめ。
- mid trainingにおいて重点的に学習されたドメインはRLによるpost trainingで強い転移を発揮する(Code, Math, Science)
- 一方、mid trainingであまり学習データ中に出現しないドメインについては転移による性能向上は最小限に留まり、in-domainの学習データをきちんと与えてpost trainingしないと性能向上は限定的
- 簡単なタスクはcross domainの転移による恩恵をすぐに得やすい(Math500, MBPP),難易度の高いタスクは恩恵を得にくい
- 各ドメインのデータを一様にmixすると、単一ドメインで学習した場合と同等かそれ以上の性能を達成する
- 必ずしもresponse lengthが長くなりながら予測性能が向上するわけではなく、ドメインによって傾向が異なる
- たとえば、Code, Logic, Tabularの出力は性能が向上するにつれてresponse lengthは縮小していく
- 一方、Science, Mathはresponse lengthが増大していく。また、Simulationは変化しない
- 異なるドメインのデータをmixすることで、最初の数百ステップにおけるrewardの立ち上がりが早く(単一ドメインと比べて急激にrewardが向上していく)転移がうまくいく
- (これは私がグラフを見た感想だが、単一ドメインでlong runで学習した場合の最終的な性能は4/6で同等程度、2/6で向上(Math, Science)
- 非常に難易度の高いmathデータのみにフィルタリングすると、フィルタリング無しの場合と比べて難易度の高いデータに対する予測性能は向上する一方、簡単なOODタスク(HumanEval)の性能が大幅に低下する(特定のものに特化するとOODの性能が低下する)
- RLはpre(mid)-trainingで学習されたreasoning能力を引き出すだけではなく、新規のタスクに対しては新たなreasoning能力を獲得できる
- モデルサイズが小さいと、RLでpost-training後のpass@kのkを大きくするとどこかでサチり、baseモデルと交差するが、大きいとサチらず交差しない
- モデルサイズが大きいとより多様なreasoningパスがunlockされている
- pass@kで観察したところRLには2つのphaseのよつなものが観測され、最初の0-160(1 epoch)ステップではpass@1が改善したが、pass@max_kは急激に性能が劣化した。一方で、160ステップを超えると、双方共に徐々に性能改善が改善していくような変化が見られた
本研究で構築されたGuru Dataset:
https://huggingface.co/datasets/LLM360/guru-RL-92k
math, coding, science, logic, simulation, tabular reasoningに関する高品質、かつverifiableなデータセット。
> RLはpre(mid)-trainingで学習されたreasoning能力を引き出すだけではなく、新規のタスクに対しては新たなreasoning能力を獲得できる
上記takeawayは
- [Paper Note] Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yang Yue+, NeurIPS'25, 2025.04
と一見相反するように見えるが、実際どうなんだろうか。
最初は、RLによりPass@1が改善するので、Figure 1などに記載されている特定のドメインでの skill aqcuisition にはin-domain dataが必要でRLがそれに寄与するという話は、Pass@1が改善された結果なのかなと思ったが、
4.3節に実際に上記研究が引用され考察がなされており、mid-trainingなどで多くのデータが含まれるMathドメインについては、上記研究と同じ傾向でbase modelとRL後のモデルがK=64の時点で性能が交差、その後逆転するため、上記研究と同様の傾向が見受けられた。一方で、タスクごとに見るとzebra-logicのような事前学習ではあまりexposeされないタスクで見ると、依然としてRLの方が高いPass@kを獲得しているという現象が観測され、base modelのreadoning boundaryを拡大することができている、という解釈のようである。
[Paper Note] VGGT: Visual Geometry Grounded Transformer, Jianyuan Wang+, CVPR'25
Paper/Blog Link My Issue
#ComputerVision #Transformer #CVPR #read-later #3D Reconstruction #Backbone #Reference Collection Issue Date: 2025-06-22 GPT Summary- VGGTは、シーンの主要な3D属性を複数のビューから直接推測するフィードフォワードニューラルネットワークであり、3Dコンピュータビジョンの分野において新たな進展を示します。このアプローチは効率的で、1秒未満で画像を再構築し、複数の3Dタスクで最先端の結果を達成します。また、VGGTを特徴バックボーンとして使用することで、下流タスクの性能が大幅に向上することが示されています。コードは公開されています。 Comment
元ポスト:
様々な研究のBackboneとして活用されている。
[Paper Note] AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, Zihan Liu+, arXiv'25, 2025.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #SmallModel #OpenWeight #OpenSource #PostTraining #One-Line Notes #Author Thread-Post Issue Date: 2025-06-18 GPT Summary- SFTではプロンプト数と応答数を増やすことで推論性能が向上し、特にプロンプト数の拡張が有効。強力なSFTモデルは、適切なRL学習により高い最終性能につながる。サンプリング温度を調整してエントロピーを約0.3に維持することで、探索と活用のバランスを実現し、初期SFTモデル間の性能差を縮小。SFTとRLの相乗効果により、AceReason-Nemotron-1.1 7Bは数学・コードベンチマークでQwen2.5-7Bベースモデルの最高性能を達成。 Comment
元ポスト:
様々なtakeawayがまとめられている。
SFT,RLに利用されたデータも公開
- [Paper Note] Scaling Data-Constrained Language Models, Niklas Muennighoff+, NeurIPS'23
において事前学習時に4 epochまでは性能の改善幅が大きいと報告されていたが、SFTでも5 epoch程度まで学習すると良い模様。
また、SFT dataをscalingさせる際は、promptの数だけでなく、prompt単位のresponse数を増やすのが効果的
[Paper Note] Massive Supervised Fine-tuning Experiments Reveal How Data, Layer, and Training Factors Shape LLM Alignment Quality, Yuto Harada+, EMNLP'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #EMNLP #read-later #Author Thread-Post Issue Date: 2025-06-18 GPT Summary- SFTはLLMを人間の指示に整合させる重要なプロセスであり、1,000以上のSFTモデルを生成し、データセットの特性と層ごとの変更を調査。訓練タスクの相乗効果やモデル固有の戦略の重要性を明らかにし、困惑度がSFTの効果を予測することを示した。中間層の重みの変化がパフォーマンス向上と強く相関し、研究を加速させるためにモデルと結果を公開予定。 Comment
元ポスト:
NLP'25: https://www.anlp.jp/proceedings/annual_meeting/2025/pdf_dir/C10-6.pdf
[Paper Note] LiveCodeBench Pro: How Do Olympiad Medalists Judge LLMs in Competitive Programming?, Zihan Zheng+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #Evaluation #Coding #NeurIPS #Contamination-free #Live #Initial Impression Notes Issue Date: 2025-06-17 GPT Summary- 大規模言語モデル(LLMs)は競技プログラミングで人間のエリートを上回るとされるが、実際には重要な限界があることを調査。新たに導入した「LiveCodeBench Pro」ベンチマークにより、LLMsは中程度の難易度の問題で53%のpass@1を達成する一方、難しい問題では0%という結果が得られた。LLMsは実装重視の問題では成功するが、複雑なアルゴリズム的推論には苦労し、誤った正当化を生成することが多い。これにより、LLMsと人間の専門家との間に重要なギャップがあることが明らかになり、今後の改善のための診断が提供される。 Comment
元ポスト:
Hardな問題は現状のSoTAモデル(Claude4が含まれていないが)でも正答率0.0%
ベンチマークに含まれる課題のカテゴリ
実サンプルやケーススタディなどはAppendix参照のこと。
pj page: https://livecodebenchpro.com
アップデート(NeurIPSにaccept):
[Paper Note] Value Residual Learning, Zhanchao Zhou+, ACL'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #ACL #read-later #Author Thread-Post Issue Date: 2025-06-12 GPT Summary- ResFormerは、隠れ状態の残差に値の残差接続を加えることで情報の流れを強化する新しいTransformerアーキテクチャを提案。実験により、ResFormerは従来のTransformerに比べて少ないパラメータとトレーニングデータで同等の性能を示し、SVFormerはKVキャッシュサイズを半減させることができる。性能はシーケンスの長さや学習率に依存する。 Comment
元ポスト:
なぜValue Residual Learningがうまくいくかの直感的説明:
ざっくり言うと、LayerNormよって初期layerの影響は深くなればなるほど小さくなり、情報が損なわれていってしまうため、ValueをQKに応じて情報を運んでくる要素と捉えると、検索やコピーなどの明確なinputに関する情報が欲しい場合に、すべてのlayerから初期のValueにアクセスできるvalue residual connectionが有用となる、といった話と理解した。Valueにのみフォーカスしているが、QKの場合はどうなのかといった要素はまだ未開拓な分野とのこと。
Wide&Deepみたいな話になってきた:
- [Paper Note] Wide & Deep Learning for Recommender Systems, Heng-Tze Cheng+, DLRS'16, 2016.06
Value Residual Learningを用いたアーキテクチャが現在nanoGPT Speedrunでトップになった。
- Modded-NanoGPT, KellerJordan, 2024.05
現在のlayerのValueと初期レイヤーのValueを線形補完する重みをtrainableにするとさらに性能が改善することも言及されている。
所見:
[Paper Note] Horizon Reduction Makes RL Scalable, Seohong Park+, NeurIPS'25 Spotlight
Paper/Blog Link My Issue
#Analysis #MachineLearning #LanguageModel #ReinforcementLearning #Off-Policy #Reference Collection #Scalability Issue Date: 2025-06-10 GPT Summary- 本研究では、オフライン強化学習(RL)のスケーラビリティを検討し、既存のアルゴリズムが大規模データセットに対して期待通りの性能を発揮しないことを示しました。特に、長いホライズンがスケーリングの障壁であると仮定し、ホライズン削減技術がスケーラビリティを向上させることを実証しました。新たに提案した手法SHARSAは、ホライズンを削減しつつ優れたパフォーマンスを達成し、オフラインRLのスケーラビリティを向上させることを示しました。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=hguaupzLCU
[Paper Note] ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models, Mingjie Liu+, NeurIPS'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #ReinforcementLearning #NeurIPS #read-later #One-Line Notes #Reference Collection Issue Date: 2025-06-04 GPT Summary- 強化学習(RL)が言語モデルの推論能力を向上させる可能性を探る本研究では、長期的なRL(ProRL)トレーニングが新しい推論戦略を明らかにできることを示します。新しいトレーニング手法ProRLを導入し、実証分析により、RLでトレーニングされたモデルが基礎モデルを上回ることが確認されました。推論の改善は基礎モデルの能力やトレーニング期間と相関しており、RLが新しい解決空間を探索できることを示唆しています。これにより、RLが言語モデルの推論を拡張する条件に関する新たな洞察が得られ、今後の研究の基盤が築かれます。モデルの重みは公開されています。 Comment
元ポスト:
RLVR(math, code(従来はこの2種類), STEM, logic Puzzles, instruction following)によって大規模なスケール(長期的に学習をする; 2k training stepsと多様なタスクでの学習データ)で実験をし、定期的にReferenceポリシーとOptimizerをリセットすることで、元のポリシーからの乖離を防ぎつつも、新たな学習が進むようなことをしている模様。
(※PFNのランチタイムトークを参考に記述)
verlを用いて、DAPOで学習をしている。
- verl: Volcano Engine Reinforcement Learning for LLMs, ByteDance Seed Team, 2025.04
- [Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
[Paper Note] Learning Compositional Functions with Transformers from Easy-to-Hard Data, Zixuan Wang+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#Analysis #Pretraining #LanguageModel #Transformer #PostTraining #COLT #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2025-06-01 GPT Summary- Transformerベースの言語モデルの学習可能性を、k-fold 合成タスクにおいて検討。具体的には、k 個の入力置換と隠れた置換の交互合成を倍の効率で実行可能とし、統計的クエリ下界も証明。さらに、O(log k) 層のトランスフォーマーで勾配降下による効率的な学習が可能であることを示した。データの提示方法によって、容易な例と難しい例が存在することが重要であるとの知見を得た。 Comment
元ポスト:
こちらはまず元ポストのスレッドを読むのが良いと思われる。要点をわかりやすく説明してくださっている。
元ポストとalphaxivでざっくり理解したところ、
Transformerがcontextとして与えられた情報(σ)とparametric knowledge(π)をk回の知識マッピングが必要なタスク(k-fold composition task)を学習するにはO(log k)のlayer数が必要で、直接的にk回の知識マッピングが必要なタスクを学習するためにはkの指数オーダーのデータ量が最低限必要となることが示された。これはkが大きくなると(すなわち、複雑なreasoning stepが必要なタスク)になると非現実的なものとなるため、何らかの方法で緩和したい。学習データを簡単なものから難しいものをmixingすること(カリキュラム学習)ことで、この条件が緩和され、指数オーダーから多項式オーダーのデータ量で学習できることが示された
といった感じだと思われる。
じゃあ最新の32Bモデルよりも、よりパラメータ数が大きくてlayer数が多い古いモデルの方が複雑なreasoningが必要なタスクを実は解けるってこと!?直感に反する!と一瞬思ったが、おそらく最近のモデルでは昔のモデルと比べてparametric knowledgeがより高密度に適切に圧縮されるようになっていると思われるので、昔のモデルではk回の知識マッピングをしないと解けないタスクが、最新のモデルではk-n回のマッピングで解けるようになっていると推察され、パラメータサイズが小さくても問題なく解けます、みたいなことが起こっているのだろう、という感想を抱くなどした
[Paper Note] Distillation Scaling Laws, Dan Busbridge+, ICML'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #Distillation #SmallModel #ICML #Scaling Laws #One-Line Notes #Author Thread-Post Issue Date: 2025-05-29 GPT Summary- 蒸留モデルの性能を推定するための蒸留スケーリング法則を提案。教師モデルと生徒モデルの計算割り当てを最適化することで、生徒の性能を最大化。教師が存在する場合やトレーニングが必要な場合に最適な蒸留レシピを提供。多くの生徒を蒸留する際は、監視付きの事前学習を上回るが、生徒のサイズに応じた計算レベルまで。単一の生徒を蒸留し、教師がトレーニング必要な場合は監視学習を推奨。蒸留に関する洞察を提供し、理解を深める。 Comment
著者ポスト:
-
-
openreview: https://openreview.net/forum?id=1nEBAkpfb9
手元にSFTのデータがあったときにSLMを学習したいという状況で、固定の計算資源があったときに、巨大な教師モデルをSFTで学習してから小型モデルに蒸留するのが良いのか、小型モデルを直接SFTする方が良いのか、どのように教師モデルと生徒モデルに計算資源を割り当てるのが最適かという観点でscaling lawを導出しているようである。
下記Appendixや著者ポストにある通り、知見を一言で言うと
- Distillationでは、SFTによって生み出されるモデルよりも良いモデルを生み出すことはできない
- しかしながら、DistillationではSFTよりも効率的にSFTで学習した場合と比較して良いモデルを学習できる
- 言い換えると、十分な計算量とデータが与えられるとDistillationの効率性は消失する
という感じだろうか。つまり、達成可能な性能のピーク値はSFTを超えられないが、Distillationの方がSFTよりも効率的に学習ができる、という感じに見える。
[Paper Note] LiveBench: A Challenging, Contamination-Limited LLM Benchmark, Colin White+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #ICLR #Contamination-free #Live #One-Line Notes Issue Date: 2025-05-23 GPT Summary- テストセットの汚染を防ぐために、LLM用の新しいベンチマーク「LiveBench」を導入。LiveBenchは、頻繁に更新される質問、自動スコアリング、さまざまな挑戦的タスクを含む。多くのモデルを評価し、正答率は70%未満。質問は毎月更新され、LLMの能力向上を測定可能に。コミュニティの参加を歓迎。 Comment
テストデータのコンタミネーションに対処できるように設計されたベンチマーク。重要研究
リーダーボード:
https://livebench.ai/#/
現在も更新されていて素晴らしい
[Paper Note] Nemotron-CC: Transforming Common Crawl into a Refined Long-Horizon Pretraining Dataset, Dan Su+, ACL'25
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Dataset #LanguageModel #ACL Issue Date: 2025-05-10 GPT Summary- FineWeb-EduとDCLMは、モデルベースのフィルタリングによりデータの90%を削除し、トレーニングに適さなくなった。著者は、アンサンブル分類器や合成データの言い換えを用いて、精度とデータ量のトレードオフを改善する手法を提案。1Tトークンで8Bパラメータモデルをトレーニングし、DCLMに対してMMLUを5.6ポイント向上させた。新しい6.3Tトークンデータセットは、DCLMと同等の性能を持ちながら、4倍のユニークなトークンを含み、長トークンホライズンでのトレーニングを可能にする。15Tトークンのためにトレーニングされた8Bモデルは、Llama 3.1の8Bモデルを上回る性能を示した。データセットは公開されている。
[Paper Note] DataComp-LM: In search of the next generation of training sets for language models, Jeffrey Li+, NeurIPS'25, 2024.07
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #NeurIPS #read-later #Initial Impression Notes Issue Date: 2025-05-10 GPT Summary- DataComp for Language Models(DCLM)を紹介し、240Tトークンのコーパスと53の評価スイートを提供。DCLMでは、モデルスケール412Mから7Bパラメータのデータキュレーション戦略を実験可能。DCLM-Baselineは2.6Tトークンでトレーニングし、MMLUで64%の精度を達成し、従来のMAP-Neoより6.6ポイント改善。計算リソースも40%削減。結果はデータセット設計の重要性を示し、今後の研究の基盤を提供。 Comment
openreview: https://openreview.net/forum?id=CNWdWn47IE
最近多くの著名なモデルでDCLMを事前学習データとして利用している文献を目にするようになった
[Paper Note] When Bad Data Leads to Good Models, Kenneth Li+, ICML'25, 2025.05
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #Safety #ICML #DPO #Toxicity #ActivationSteering/ITI #KeyPoint Notes #Author Thread-Post Issue Date: 2025-05-09 GPT Summary- 本論文では、LLMの事前学習におけるデータの質の再検討を行い、有害データが事後学習における制御を向上させる可能性を探ります。トイ実験を通じて、有害データの割合が増加することで有害性の概念が線形表現に影響を与えることを発見し、有害データが生成的有害性を増加させつつも除去しやすくなることを示しました。評価結果は、有害データで訓練されたモデルが生成的有害性を低下させつつ一般的な能力を保持する良好なトレードオフを達成することを示唆しています。 Comment
元ポスト:
これは面白そう
Webコーパスなどを事前学習で利用する際は、質の高いデータを残して学習した方が良いとされているが、4chanのようなtoxicなデータを混ぜて事前学習して、後からdetox(Inference Time Intervention [Paper Note] Inference-Time Intervention: Eliciting Truthful Answers from a Language Model, Kenneth Li+, NeurIPS'23
, SFT, DPO)することで、最終的なモデルのtoxicなoutputが減るという話らしい。これはそもそも事前学習時点でtoxicなデータのsignalが除外されることで、モデルがtoxicな内容のrepresentationを学習できず、最終的にtoxicか否かをコントロールできなくなるため、と考察している(っぽい)
有害な出力を減らせそうなことは分かったが、Activation Steeringによってどの程度モデルの性能に影響を与えるのかが気になる、と思ったがAppendixに記載があった。細かく書かれていないので推測を含むが、各データに対してToxicデータセットでProbingすることでTopKのheadを決めて、Kの値を調整することでinterventionの強さを調整し、Toxicデータの割合を変化させて評価してみたところ、モデルの性能に大きな影響はなかったということだと思われる(ただし1Bモデルでの実験しかない)
おそらく2,3節あたりが一番おもしろいポイントなのだと思われるがまだ読めていない。
openreview: https://openreview.net/forum?id=SsLGTZKXf1
解説:
[Paper Note] Absolute Zero: Reinforced Self-play Reasoning with Zero Data, Andrew Zhao+, arXiv'25, 2025.05
Paper/Blog Link My Issue
#NLP #LanguageModel #ReinforcementLearning #SelfImprovement #NeurIPS #read-later #RLVR #Label-free #SelfPlay Issue Date: 2025-05-08 GPT Summary- RLVRは、結果に基づく報酬を用いて言語モデルの推論能力を向上させるが、訓練には人手による質問と回答の収集が必要。高品質な例の不足は長期的なスケーラビリティの懸念を引き起こす。これに対処する新しいRLVRパラダイム、Absolute Zeroが提案され、モデルトレーニングが外部データに依存せず、AZRによって自己進化を促進。AZRはオープンエンドな検証可能報酬を提供し、全くの外部データなしでもSOTA性能を達成。また、様々なモデルと互換性があることが示された。 Comment
元ポスト:
[Paper Note] Tina: Tiny Reasoning Models via LoRA, Shangshang Wang+, arXiv'25
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #ReinforcementLearning #Reasoning #SmallModel #PEFT(Adaptor/LoRA) #GRPO #read-later #One-Line Notes Issue Date: 2025-05-07 GPT Summary- Tinaは、コスト効率よく強力な推論能力を実現する小型の推論モデルファミリーであり、1.5Bパラメータのベースモデルに強化学習を適用することで高い推論性能を示す。Tinaは、従来のSOTAモデルと競争力があり、AIME24で20%以上の性能向上を達成し、トレーニングコストはわずか9ドルで260倍のコスト削減を実現。LoRAを通じた効率的なRL推論の効果を検証し、すべてのコードとモデルをオープンソース化している。 Comment
元ポスト:
(おそらく)Reasoningモデルに対して、LoRAとRLを組み合わせて、reasoning能力を向上させた初めての研究
[Paper Note] Where is the answer? Investigating Positional Bias in Language Model Knowledge Extraction, Kuniaki Saito+, NAACL'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Bias #NAACL #PostTraining #PerplexityCurse #ContextEngineering #Surface-level Notes #Author Thread-Post Issue Date: 2025-05-02 GPT Summary- LLMは新しい文書でファインチューニングが必要だが、「困惑の呪い」により情報抽出が困難。特に文書の初めに関する質問には正確に答えるが、中間や末尾の情報抽出に苦労する。自己回帰的トレーニングがこの問題を引き起こすことを示し、デノイジング自己回帰損失が情報抽出を改善する可能性を示唆。これにより、LLMの知識抽出と新ドメインへの適応に関する新たな議論が生まれる。 Comment
元ポスト:

LLMの知識を最新にするために新しい文書(e.g., 新しいドメインの文書等)をLLMに与え(便宜上学習データと呼ぶ)Finetuningをした場合、Finetuning後のモデルで与えられたqueryから(LLM中にパラメータとしてmemorizeされている)対応する事実情報を抽出するようInferenceを実施すると、queryに対応する事実情報の学習データ中での位置が深くなると(i.e., middle -- endになると)抽出が困難になる Positional Biasが存在する[^1]ことを明らかにした。
そして、これを緩和するために正則化が重要(e.g., Denoising, Shuffle, Attention Drops)であることを実験的に示し、正則化手法は複数組み合わせることで、よりPositional Biasが緩和することを示した研究
[^1]: 本研究では"Training"に利用する文書のPositional Biasについて示しており、"Inference"時におけるPositional Biasとして知られている"lost-in-the middle"とは異なる現象を扱っている点に注意
## データセット
文書 + QAデータの2種類を構築しFinetuning後のknowledge extraction能力の検証をしている[^2]。
実験では、`Synthetic Bio (合成データ)`, `Wiki2023+(実データ)` の2種類のデータを用いて、Positional Biasを検証している。
Synthetic bioは、人間のbiographyに関する9つの属性(e.g., 誕生日, 出生地)としてとりうる値をChatGPTに生成させ、3000人の人物に対してそれらをランダムにassignし、sentence templateを用いてSurface Realizationすることで人工的に3000人のbiographyに関するテキストを生成している。
一方、Wiki2023+では、Instruction-tuned Language Models are Better Knowledge Learners, Zhengbao Jiang+, ACL'24
の方法にのっとって [^3]事前学習時の知識とのoverlapが最小となるように`2023`カテゴリ以下のwikipediaの様々なジャンルの記事を収集して活用する。QAデータの構築には、元文書からsentenceを抽出し、GPT-3.5-Turboに当該sentenceのみを与えてQA pairを作成させることで、データを作成している。なお、hallucinationや品質の低いQA pairをフィルタリングした。フィルタリング後のQA Pairをランダムにサンプリングし品質を確認したところ、95%のQA pairが妥当なものであった。
これにより、下図のようなデータセットが作成される。FigureCが `Wiki2023+`で、FigureDが`SyntheticBio`。`Wiki2023+`では、QA pairの正解が文書中の前半により正解が現れるような偏りが見受けられる。

[^2]: [Paper Note] Physics of Language Models: Part 3.1, Knowledge Storage and Extraction, Zeyuan Allen-Zhu+, ICML'24
において、知識 + 知識を抽出するタスクの双方を用いて学習することで、モデルから知識を抽出する能力が備わることが示されているため。
[^3]: Llama-2-7Bにおいて2023カテゴリ以下の情報に対するQAのperformanceが著しく低いことから、事前学習時に当該データが含まれている可能性が低いことが示唆されている
## 実験 & 実験結果 (modulated data)
作成した文書+QAデータのデータセットについて、QAデータをtrain/valid/testに分けて、文書データは全て利用し、testに含まれるQAに適切に回答できるかで性能を評価する。このとき、文書中でQAに対する正解がテキストが出現する位置を変化させモデルの学習を行い、予測性能を見ることで、Positional Biasが存在することを明らかにする。このとき、[Paper Note] Physics of Language Models: Part 3.1, Knowledge Storage and Extraction, Zeyuan Allen-Zhu+, ICML'24
に倣い、文書とQAをMixed Sampling(1バッチあたり256件のサンプルをランダムにQAおよび文書データからサンプリング;
# 1923 では文書とQAを2:8の比率でサンプリングしている)することで学習をする。QAの場合目的関数は回答テキスト部分のみのNLL、文書の場合はnext-token prediction lossを利用する。
Positional Biasの存在を示すだけでなく、(A, B, C) の順番でnext-token prediction lossで学習されたモデルの場合、Cの知識を抽出するためにA, Bがcontextとして必要となるため、Cを抽出する際の汎化性能を高めるためにA, Bの表現がより多様である必要がある、という課題がある。これに対処するためのいくつかのシンプルな正則化手法、具体的には
- D-AR: predition targetのトークンは保持したまま、input tokenの一部をランダムなトークンに置き換える
- Shuffle: 入力文をシャッフルする
- Attn Drop: self-attentionモジュールのattention weightをランダムに0にする
の3種類とPositional Biasの関係性を検証している。

検証の結果、(合成データ、実データともに)Positional Biasが存在することが明らかとなり(i.e., 正解テキストが文書中の深い位置にあればあるほど予測性能が低下する)正則化によってPositional Biasが緩和されることが示された。

また、異なるモデルサイズで性能を比較したところ、モデルサイズを大きくすることで性能自体は改善するが、依然としてPositional Biasが存在することが示され、ARよりもD-ARが一貫して高い性能を示した。このことから、Positional Biasを緩和するために何らかの正則化手法が必要なことがわかる。

また、オリジナル文書の1文目を、正解データの位置を入れ替えた各モデルに対して、テキスト中の様々な位置に配置してPerplexityを測った。この設定では、モデルがPerplexityを最小化するためには、(1文目ということは以前の文脈が存在しないsentenceなので)文脈に依存せずに文の記憶していなければならない。よって、各手法ごとにどの程度Perplexityが悪化するかで、各手法がどの程度あるsentenceを記憶する際に過去の文脈に依存しているかが分かる。ここで、学習データそのもののPerplexityはほぼ1.0であったことに注意する。
結果として、文書中の深い位置に配置されればされるほどPerplexityは増大し(left)、Autoregressive Model (AR) のPerplexity値が最も値が大きかった(=性能が悪かった)。このことから、ARはより過去の文脈に依存してsentenceの情報を記憶していることが分かる。また、モデルサイズが小さいモデルの方がPerplexityは増大する傾向にあることがわかった (middle)。これはFig.3で示したQAのパフォーマンスと傾向が一致しており、学習データそのもののPerplexityがほぼ1.0だったことを鑑みると、学習データに対するPerplexityは様々なPositionに位置する情報を適切に抽出できる能力を測るメトリックとしては適切でないことがわかる。また、学習のiterationを増やすと、ARの場合はfirst positionに対する抽出性能は改善したが、他のpositionでの抽出性能は改善しなかった。一方、D-ARの場合は、全てのpositionでの抽出性能が改善した (right) 。このことから、必ずしも学習のiterationを増やしても様々なPositionに対する抽出性能が改善しないこと、longer trainingの恩恵を得るためには正則化手法を利用する必要があることが明らかになった。

## 実験 & 実験結果 (unmodulated data)
Wiki2023+データに対して上記のようなデータの変更を行わずに、そのまま学習を行い、各位置ごとのQAの性能を測定したところ、(すべてがPositional Biasのためとは説明できないが)回答が文書中の深い位置にある場合の性能が劣化することを確認した。2--6番目の性能の低下は、最初の文ではシンプルな事実が述べられ、後半になればなるほどより複雑な事実が述べられる傾向があることが起因して性能の低下しているとかせつをたてている。また、unmodulated dataの場合でもD-ARはARの性能を改善することが明らかとなった。モデルサイズが大きいほど性能は改善するが、以前として文書中の深い位置に正解がある場合に性能は劣化することもわかる。
また、正則化手法は組み合わせることでさらに性能が改善し、[Paper Note] Physics of Language Models: Part 3.1, Knowledge Storage and Extraction, Zeyuan Allen-Zhu+, ICML'24
に示されている通り、学習データ中の表現を多様にし[^1]学習したところ予測性能が改善し、正則化手法とも補完的な関係であることも示された。
医療ドメインでも実験したところ、正則化手法を適用した場合にARよりも性能が上回った。最後にWiki2023+データについてOpenbookな設定で、正解が含まれる文書をLLMのcontextとして与えた場合(i.e.,ほぼ完璧なretrieverが存在するRAGと同等の設定とみなせる)、QAの性能は90.6%に対し、継続学習した場合のベストモデルの性能は50.8%だった。このことから、正確なretrieverが存在するのであれば、継続学習よりもRAGの方がQAの性能が高いと言える。
RAGと継続学習のメリット、デメリットの両方を考慮して、適切に手法を選択することが有効であることが示唆される。
[^1]: ChatGPTによってテキストをrephraseし、sentenceのorderも変更することで多様性を増やした。が、sentence orderが文書中の深い位置にある場合にあまりorderが変化しなかったようで、このため深い位置に対するQAの性能改善が限定的になっていると説明している。
[Paper Note] Learning Dynamics of LLM Finetuning, Yi Ren+, ICLR'25 Outstanding Paper Award
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #LanguageModel #Alignment #Hallucination #ICLR #DPO #Repetition #Reference Collection #Author Thread-Post Issue Date: 2025-04-18 GPT Summary- 本研究では、大規模言語モデルのファインチューニング中の学習ダイナミクスを分析し、異なる応答間の影響の蓄積を段階的に解明します。指示調整と好み調整のアルゴリズムに関する観察を統一的に解釈し、ファインチューニング後の幻覚強化の理由を仮説的に説明します。また、オフポリシー直接好み最適化(DPO)における「圧縮効果」を強調し、望ましい出力の可能性が低下する現象を探ります。このフレームワークは、LLMのファインチューニング理解に新たな視点を提供し、アラインメント性能向上のためのシンプルな方法を示唆します。 Comment
元ポスト:
解説ポスト:
[Paper Note] Non-Determinism of "Deterministic" LLM Settings, Berk Atil+, Eval4NLP'25, 2024.08
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #ACL #Decoding #Workshop #Non-Determinism #In-Depth Notes #KeyPoint Notes Issue Date: 2025-04-14 GPT Summary- 本研究では、5つの決定論的LLMにおける非決定性を8つのタスクで調査し、最大15%の精度変動と70%のパフォーマンスギャップを観察。全てのタスクで一貫した精度を提供できないことが明らかになり、非決定性が計算リソースの効率的使用に寄与している可能性が示唆された。出力の合意率を示す新たなメトリクスTARr@NとTARa@Nを導入し、研究結果を定量化。コードとデータは公開されている。 Comment
- 論文中で利用されているベンチマーク:
- [Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
- [Paper Note] Measuring Massive Multitask Language Understanding, Dan Hendrycks+, arXiv'20, 2020.09
同じモデルに対して、seedを固定し、temperatureを0に設定し、同じ計算機環境に対して、同じinputを入力したら理論上はLLMの出力はdeterministicになるはずだが、deterministicにならず、ベンチマーク上の性能とそもそものraw response自体も試行ごとに大きく変化する、という話。
ただし、これはプロプライエタリLLMや、何らかのinferenceの高速化を実施したInferenceEngine(本研究ではTogetherと呼ばれる実装を使っていそう。vLLM/SGLangだとどうなるのかが気になる)を用いてinferenceを実施した場合での実験結果であり、後述の通り計算の高速化のためのさまざまな実装無しで、deterministicな設定でOpenLLMでinferenceすると出力はdeterministicになる、という点には注意。
GPTやLlama、Mixtralに対して上記ベンチマークを用いてzero-shot/few-shotの設定で実験している。Reasoningモデルは実験に含まれていない。
LLMのraw_response/multiple choiceのparse結果(i.e., 問題に対する解答部分を抽出した結果)の一致(TARr@N, TARa@N; Nはinferenceの試行回数)も理論上は100%になるはずなのに、ならないことが報告されている。
correlation analysisによって、応答の長さ と TAR{r, a}が強い負の相関を示しており、応答が長くなればなるほど不安定さは増すことが分析されている。このため、ontput tokenの最大値を制限することで出力の安定性が増すことを考察している。また、few-shotにおいて高いAcc.の場合は出力がdeterministicになるわけではないが、性能が安定する傾向とのこと。また、OpenAIプラットフォーム上でGPTのfinetuningを実施し実験したが、安定性に寄与はしたが、こちらもdeterministicになるわけではないとのこと。
deterministicにならない原因として、まずmulti gpu環境について検討しているが、multi-gpu環境ではある程度のランダム性が生じることがNvidiaの研究によって報告されているが、これはseedを固定すれば決定論的にできるため問題にならないとのこと。
続いて、inferenceを高速化するための実装上の工夫(e.g., Chunk Prefilling, Prefix Caching, Continuous Batching)などの実装がdeterministicなハイパーパラメータでもdeterministicにならない原因であると考察しており、**実際にlocalマシン上でこれらinferenceを高速化するための最適化を何も実施しない状態でLlama-8Bでinferenceを実施したところ、outputはdeterministicになったとのこと。**
論文中に記載がなかったため、どのようなInferenceEngineを利用したか公開されているgithubを見ると下記が利用されていた:
- Together:
https://github.com/togethercomputer/together-python?tab=readme-ov-file
Togetherが内部的にどのような処理をしているかまでは追えていないのだが、異なるInferenceEngineを利用した場合に、どの程度outputの不安定さに差が出るのか(あるいは出ないのか)は気になる。たとえば、transformers/vLLM/SGLangを利用した場合などである。
論文中でも報告されている通り、昔管理人がtransformersを用いて、deterministicな設定でzephyrを用いてinferenceをしたときは、出力はdeterministicになっていたと記憶している(スループットは絶望的だったが...)。
あと個人的には現実的な速度でオフラインでinference engineを利用した時にdeterministicにはせめてなって欲しいなあという気はするので、何が原因なのかを実装レベルで突き詰めてくれるととても嬉しい(KV Cacheが怪しい気がするけど)。
たとえば最近SLMだったらKVCacheしてVRAM食うより計算し直した方が効率良いよ、みたいな研究があったような。そういうことをしたらlocal llmでdeterministicにならないのだろうか。
- Defeating Nondeterminism in LLM Inference, Horace He in collaboration with others at Thinking Machines, 2025.09
においてvLLMを用いた場合にDeterministicな推論をするための解決方法が提案されている。
[Paper Note] A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility, Andreas Hochlehnert+, COLM'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Evaluation #SmallModel #COLM #PostTraining #In-Depth Notes #KeyPoint Notes #Initial Impression Notes Issue Date: 2025-04-13 GPT Summary- 推論は言語モデルの重要な課題であり、進展が見られるが、評価手法には透明性や堅牢性が欠けている。本研究では、数学的推論ベンチマークが実装の選択に敏感であることを発見し、標準化された評価フレームワークを提案。再評価の結果、強化学習アプローチは改善が少なく、教師ありファインチューニング手法は強い一般化を示した。再現性を高めるために、関連するコードやデータを公開し、今後の研究の基盤を築く。 Comment
元ポスト:
SLMをmath reasoning向けにpost-trainingする場合、評価の条件をフェアにするための様々な工夫を施し評価をしなおした結果(Figure1のように性能が変化する様々な要因が存在する)、
RL(既存研究で試されているもの)よりも(大規模モデルからrejection samplingしたreasoning traceを用いて)SFTをする方が同等か性能が良く(Table3)、
結局のところ(おそらく汎化性能が低いという意味で)reliableではなく、
かつ(おそらく小規模なモデルでうまくいかないという意味での)scalableではないので、reliableかつscalableなRL手法が不足しているとのこと。
※ 本論文で分析されているのは<=10B以下のSLMである点に注意。10B以上のモデルで同じことが言えるかは自明ではない。
※ DAPO, VAPOなどについても同じことが言えるかも自明ではない。
※ DeepSeek-R1のtechnical reportにおいて、小さいモデルにGRPOを適用してもあまり効果が無かったことが既に報告されている。
- DeepSeek-R1の論文読んだ?【勉強になるよ】 , asap, 2025.01
- DeepSeek-R1, DeepSeek, 2025.01
個々のpost-trainingされたRLモデルが具体的にどういう訓練をしたのかは追えていないが、DAPOやDr. GRPO, VAPOの場合はどうなるんだろうか?
- [Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
- [Paper Note] VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks, Yu Yue+, arXiv'25, 2025.04
- [Paper Note] Understanding R1-Zero-Like Training: A Critical Perspective, Zichen Liu+, arXiv'25, 2025.03
Rewardの設定の仕方はどのような影響があるのだろうか(verifiable rewardなのか、neuralモデルによるrewardなのかなど)?
学習のさせ方もどのような影響があるのだろうか(RLでカリキュラムlearningにした場合など)?
検証しているモデルがそれぞれどのような設定で学習されているかまでを見ないとこの辺はわからなそう。
ただなんとなーくの直感だと、SLMを賢くしたいという場合は何らかの賢いモデルの恩恵に預かると有利なケースが多く(SFTの場合はそれが大規模なモデルから蒸留したreasoning trace)、SLM+RLの場合はPRMのような思考プロセスを評価してRewardに反映させるようなものを利用しないと、少なくとも小規模なLLMをめちゃ賢くします〜というのはきついんじゃないかなあという感想ではある。
ただ、結局SLMという時点で多くの場合、より賢いパラメータ数の多いLLMが世の中には存在するあるはずなので、RLしないでSFTして蒸留すれば良いんじゃない…?と思ってしまう。
が、多くの場合その賢いLLMはProprietaryなLLMであり、出力を得て自分のモデルをpost-trainingすることは利用規約違反となるため、自前で賢くてパラメータ数の多いLLMを用意できない場合は困ってしまうので、SLMをクソデカパラメータのモデルの恩恵なしで超絶賢くできたら世の中の多くの人は嬉しいよね、とも思う。
(斜め読みだが)
サンプル数が少ない(数十件)AIMEやAMCなどのデータはseedの値にとてもsensitiveであり(Takeaway1, 2)、
それらは10種類のseedを用いて結果を平均すると分散が非常に小さくなるので、seedは複数種類利用して平均の性能を見た方がreliableであり(Takeaway3)
temperatureを高くするとピーク性能が上がるが分散も上がるため再現性の課題が増大するが、top-pを大きくすると再現性の問題は現れず性能向上に寄与し
既存研究のモデルのtemperatureとtop-pを変化させ実験するとperformanceに非常に大きな変化が出るため、モデルごとに最適な値を選定して比較をしないとunfairであることを指摘 (Takeaway4)。
また、ハードウェアの面では、vLLMのようなinference engineはGPU typeやmemoryのconfigurationに対してsensitiveでパフォーマンスが変わるだけでなく、
評価に利用するフレームワークごとにinference engineとprompt templateが異なるためこちらもパフォーマンスに影響が出るし (Takeaway5)、
max output tokenの値を変化させると性能も変わり、prompt templateを利用しないと性能が劇的に低下する (Takeaway6)。
これらのことから著者らはreliableな評価のために下記を提案しており (4.1節; 後ほど追記)、
実際にさまざまな条件をfair comparisonとなるように標準化して評価したところ(4.2節; 後ほど追記)
上の表のような結果となった。この結果は、
- DeepSeekR1-DistilledをRLしてもSFTと比較したときに意味のあるほどのパフォーマンスの向上はないことから、スケーラブル、かつ信頼性のあるRL手法がまだ不足しており
- 大規模なパラメータのモデルのreasoning traceからSFTをする方法はさまざまなベンチマークでロバストな性能(=高い汎化性能)を持ち、RLと比べると現状はRLと比較してよりパラダイムとして成熟しており
- (AIME24,25を比較するとSFTと比べてRLの場合performanceの低下が著しいので)RLはoverfittingしやすく、OODなベンチマークが必要
しっかりと評価の枠組みを標準化してfair comparisonしていかないと、RecSys業界の二の舞になりそう(というかもうなってる?)。
またこの研究で分析されているのは小規模なモデル(<=10B)に対する既存研究で用いられた一部のRL手法や設定の性能だけ(真に示したかったらPhisics of LLMのような完全にコントロール可能なサンドボックスで実験する必要があると思われる)なので、DeepSeek-R1のように、大規模なパラメータ(数百B)を持つモデルに対するRLに関して同じことが言えるかは自明ではない点に注意。
openreview: https://openreview.net/forum?id=90UrTTxp5O#discussion
最近の以下のようなSFTはRLの一つのケースと見做せるという議論を踏まえるとどうなるだろうか
- [Paper Note] On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification, Yongliang Wu+, ICLR'26, 2025.08
- [Paper Note] Towards a Unified View of Large Language Model Post-Training, Xingtai Lv+, arXiv'25
[Paper Note] When Attention Sink Emerges in Language Models: An Empirical View, Xiangming Gu+, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Attention #ICLR #AttentionSinks #read-later #One-Line Notes #needs-revision #Author Thread-Post Issue Date: 2025-04-05 GPT Summary- 言語モデルにおける「アテンションシンク」は、意味的に重要でないトークンに大きな注意を割り当てる現象であり、さまざまな入力に対して小さなモデルでも普遍的に存在することが示された。アテンションシンクは事前学習中に出現し、最適化やデータ分布、損失関数がその出現に影響を与える。特に、アテンションシンクはキーのバイアスのように機能し、情報を持たない追加のアテンションスコアを保存することがわかった。この現象は、トークンがソフトマックス正規化に依存していることから部分的に生じており、正規化なしのシグモイドアテンションに置き換えることで、アテンションシンクの出現を防ぐことができる。 Comment
Sink Rateと呼ばれる、全てのheadのFirst Tokenに対するattention scoreのうち(layer l * head h個存在する)、どの程度の割合のスコアが閾値を上回っているかを表す指標を提案
(後ほど詳細を追記する)
- [Paper Note] Why do LLMs attend to the first token?, Federico Barbero+, COLM'25
の先行研究
著者ポスト(openai-gpt-120Bを受けて):
openreview: https://openreview.net/forum?id=78Nn4QJTEN
[Paper Note] Why do LLMs attend to the first token?, Federico Barbero+, COLM'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Attention #AttentionSinks #COLM #One-Line Notes Issue Date: 2025-04-05 GPT Summary- LLMsは最初のトークンに強く注意を向ける「アテンションシンク」を示し、そのメカニズムが過剰混合を避ける方法を理論的・実証的に探求。コンテキストの長さやデータのパッキングがシンクの挙動に与える影響を実験で示し、アテンションパターンの理解を深めることを目指す。 Comment
元ポスト:
Attention Sinkによって、トークンの情報がover-mixingされることが抑制され、Decoder-only LLMの深い層のrepresentationが均一化されることを抑制する(=promptの摂動にロバストになる)ことが示された模様。
Gemma7Bにおいて、prompt中のトークン一語を置換した後に、Attention Sink(
openreview: https://openreview.net/forum?id=tu4dFUsW5z#discussion
[Paper Note] Training Software Engineering Agents and Verifiers with SWE-Gym, Jiayi Pan+, ICML'25
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #ICML #SoftwareEngineering #One-Line Notes #Environment Issue Date: 2025-04-02 GPT Summary- SWE-Gymを提案し、2,438件の実世界のPythonタスクを含む環境を構築。言語モデルに基づくSWEエージェントを訓練し、SWE-Benchで最大19%の解決率向上を達成。微調整されたエージェントは新たな最先端の性能を示し、SWE-Gymやモデル、エージェントの軌跡を公開。 Comment
SWE-Benchとは完全に独立したより広範な技術スタックに関連するタスクに基づくSWEベンチマーク
- [Paper Note] SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, Carlos E. Jimenez+, ICLR'24
SWE-Benchと比べて実行可能な環境と単体テストが提供されており、単なるベンチマークではなくエージェントを訓練できる環境が提供されている点が大きく異なるように感じる。
[Paper Note] Demystifying LLM-based Software Engineering Agents, Chunqiu Steven Xia+, FSE'25, 2024.07
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #AIAgents #SoftwareEngineering #KeyPoint Notes Issue Date: 2025-04-02 GPT Summary- 最近のLLMの進展により、ソフトウェア開発タスクの自動化が進んでいるが、複雑なエージェントアプローチの必要性に疑問が生じている。これに対し、Agentlessというエージェントレスアプローチを提案し、シンプルな三段階プロセスで問題を解決。SWE-bench Liteベンチマークで最高のパフォーマンスと低コストを達成。研究は自律型ソフトウェア開発におけるシンプルで解釈可能な技術の可能性を示し、今後の研究の方向性を刺激することを目指している。 Comment
日本語解説: https://note.com/ainest/n/nac1c795e3825
LLMによる計画の立案、環境からのフィードバックによる意思決定などの複雑なワークフローではなく、Localization(階層的に問題のある箇所を同定する)とRepair(LLMで複数のパッチ候補を生成する)、PatchValidation(再現テストと回帰テストの両方を通じて結果が良かったパッチを選ぶ)のシンプルなプロセスを通じてIssueを解決する。
これにより、低コストで高い性能を達成している、といった内容な模様。
Agentlessと呼ばれ手法だが、preprint版にあったタイトルの接頭辞だった同呼称がproceeding版では無くなっている。
[Paper Note] Measuring AI Ability to Complete Long Tasks, Thomas Kwa+, arXiv'25, 2025.03
Paper/Blog Link My Issue
#Metrics #NLP #LanguageModel #GenerativeAI #Evaluation #KeyPoint Notes #Reference Collection Issue Date: 2025-03-31 GPT Summary- 新しい指標「50%-タスク完了時間ホライズン」を提案し、AIモデルの能力を人間の観点から定量化。Claude 3.7 Sonnetは約50分の時間ホライズンを持ち、AIの能力は2019年以降約7か月ごとに倍増。信頼性や論理的推論の向上が要因とされ、5年以内にAIが多くのソフトウェアタスクを自動化できる可能性を示唆。 Comment
元ポスト:
確かに線形に見える。てかGPT-2と比べるとAIさん進化しすぎである…。
利用したデータセットは
- HCAST: 46のタスクファミリーに基づく97種類のタスクが定義されており、たとえばサイバーセキュリティ、機械学習、ソフトウェアエンジニアリング、一般的な推論タスク(wikipediaから事実情報を探すタスクなど)などがある
- 数分で終わるタスク: 上述のwikipedia
- 数時間で終わるタスク: Pytorchのちょっとしたバグ修正など
- 数文でタスクが記述され、コード、データ、ドキュメント、あるいはwebから入手可能な情報を参照可能
- タスクの難易度としては当該ドメインに数年間携わった専門家が解ける問題
- RE-Bench Suite
- 7つのopen endedな専門家が8時間程度を要するMLに関するタスク
- e.g., GPT-2をQA用にFinetuningする, Finetuningスクリプトが与えられた時に挙動を変化させずにランタイムを可能な限り短縮する、など
- [RE-Bench Technical Report](
https://metr.org/AI_R_D_Evaluation_Report.pdf)のTable2等を参照のこと
- SWAA Suite: 66種類の1つのアクションによって1分以内で終わるソフトウェアエンジニアリングで典型的なタスク
- 1分以内で終わるタスクが上記データになかったので著者らが作成
であり、画像系やマルチモーダルなタスクは含まれていない。
タスクと人間がタスクに要する時間の対応に関するサンプルは下記
タスク-エージェントペアごとに8回実行した場合の平均の成功率。確かにこのグラフからはN年後には人間で言うとこのくらいの能力の人がこのくらい時間を要するタスクが、このくらいできるようになってます、といったざっくり感覚値はなかなか想像できない。
成功率とタスクに人間が要する時間に関するグラフ。ロジスティック関数でfittingしており、赤い破線が50% horizon。Claude 3.5 Sonnet (old)からClaude 3.7 Sonnetで50% horizonは18分から59分まで増えている。実際に数字で見るとイメージが湧きやすくおもしろい。
こちらで最新モデルも随時更新される:
https://metr.org/blog/2025-03-19-measuring-ai-ability-to-complete-long-tasks/
[Paper Note] Overtrained Language Models Are Harder to Fine-Tune, Jacob Mitchell Springer+, ICLR'25
Paper/Blog Link My Issue
#Analysis #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ICLR #read-later #One-Line Notes #Author Thread-Post Issue Date: 2025-03-27 GPT Summary- 大規模言語モデルの事前学習において、トークン予算の増加がファインチューニングを難しくし、パフォーマンス低下を引き起こす「壊滅的な過学習」を提唱。3Tトークンで事前学習されたOLMo-1Bモデルは、2.3Tトークンのモデルに比べて2%以上の性能低下を示す。実験と理論分析により、事前学習パラメータの感度の増加が原因であることを示し、事前学習設計の再評価を促す。 Comment
著者によるポスト:
事前学習のトークン数を増やすとモデルのsensitivityが増し、post-trainingでのパフォーマンスの劣化が起こることを報告している。事前学習で学習するトークン数を増やせば、必ずしもpost-training後のモデルの性能がよくなるわけではないらしい。
ICLR'25のOutstanding Paperに選ばれた模様:
きちんと読んだ方が良さげ。
[Paper Note] Compute Optimal Scaling of Skills: Knowledge vs Reasoning, Nicholas Roberts+, ACL'25 Findings, 2025.03
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Reasoning #ACL #Scaling Laws #Memorization #Findings #Initial Impression Notes Issue Date: 2025-03-23 GPT Summary- スケーリング法則はLLM開発において重要であり、特に計算最適化によるトレードオフが注目されている。本研究では、スケーリング法則が知識や推論に基づくスキルに依存することを示し、異なるデータミックスがスケーリング挙動に与える影響を調査した。結果、知識とコード生成のスキルは根本的に異なるスケーリング挙動を示し、誤指定された検証セットが計算最適なパラメータ数に約50%の影響を与える可能性があることが明らかになった。 Comment
元ポスト:
知識を問うQAのようなタスクはモデルのパラメータ量が必要であり、コーディングのようなReasoningに基づくタスクはデータ量が必要であり、異なる要素に依存してスケールすることを示している研究のようである。
直感的な理解としては、
多くの知識はMLP(だけではないが)に格納されているとされており、1パラメータあたりに格納可能な知識量がある程度決まっているため、知識が必要なタスクはパラメータ数が必要であり、
Reasoningのようなタスクはどれだけ学習データ側でReasoningのパターンを学習できるかに性能が依存するため、データ量が必要、
というものになるのかなという気がする。
[Paper Note] DAPO: An Open-Source LLM Reinforcement Learning System at Scale, Qiying Yu+, NeurIPS'25
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #ReinforcementLearning #Reasoning #LongContext #NeurIPS #GRPO #read-later #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2025-03-20 GPT Summary- 推論スケーリングによりLLMの推論能力が向上し、強化学習が複雑な推論を引き出す技術となる。しかし、最先端の技術詳細が隠されているため再現が難しい。そこで、$\textbf{DAPO}$アルゴリズムを提案し、Qwen2.5-32Bモデルを用いてAIME 2024で50ポイントを達成。成功のための4つの重要技術を公開し、トレーニングコードと処理済みデータセットをオープンソース化することで再現性を向上させ、今後の研究を支援する。 Comment
既存のreasoning modelのテクニカルレポートにおいて、スケーラブルなRLの学習で鍵となるレシピは隠されていると主張し、実際彼らのbaselineとしてGRPOを走らせたところ、DeepSeekから報告されているAIME2024での性能(47ポイント)よりもで 大幅に低い性能(30ポイント)しか到達できず、分析の結果3つの課題(entropy collapse, reward noise, training instability)を明らかにした(実際R1の結果を再現できない報告が多数報告されており、重要な訓練の詳細が隠されているとしている)。
その上で50%のtrainikg stepでDeepSeek-R1-Zero-Qwen-32Bと同等のAIME 2024での性能を達成できるDAPOを提案。そしてgapを埋めるためにオープンソース化するとのこと。
ちとこれはあとでしっかり読みたい。重要論文。
プロジェクトページ:
https://dapo-sia.github.io/
こちらにアルゴリズムの重要な部分の概要が説明されている。
解説ポスト:
コンパクトだが分かりやすくまとまっている。
下記ポストによると、Reward Scoreに多様性を持たせたい場合は3.2節参照とのこと。
すなわち、Dynamic Samplingの話で、Accが全ての生成で1.0あるいは0.0となるようなpromptを除外するといった方法の話だと思われる。
これは、あるpromptに対する全ての生成で正解/不正解になった場合、そのpromptに対するAdvantageが0となるため、ポリシーをupdateするためのgradientも0となる。そうすると、このサンプルはポリシーの更新に全く寄与しなくなるため、同バッチ内のノイズに対する頑健性が失われることになる。サンプル効率も低下する。特にAccが1.0になるようなpromptは学習が進むにつれて増加するため、バッチ内で学習に有効なpromptは減ることを意味し、gradientの分散の増加につながる、といったことらしい。
関連ポスト:
色々な研究で広く使われるのを見るようになった。
著者ポスト:
[Paper Note] Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach, Jonas Geiping+, NeurIPS'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Architecture #NeurIPS #Test-Time Scaling #LatentReasoning #RecurrentModels Issue Date: 2025-02-10 GPT Summary- 新しい言語モデルアーキテクチャを提案し、潜在空間での暗黙的推論によりテスト時の計算をスケールさせる。再帰ブロックを反復し、任意の深さに展開することで、従来のトークン生成モデルとは異なるアプローチを採用。特別なトレーニングデータを必要とせず、小さなコンテキストウィンドウで複雑な推論を捉える。3.5億パラメータのモデルをスケールアップし、推論ベンチマークでのパフォーマンスを劇的に改善。 Comment
所見:
Huginn
[Paper Note] Rethinking Mixture-of-Agents: Is Mixing Different Large Language Models Beneficial?, Wenzhe Li+, TMLR'25, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #TMLR #read-later Issue Date: 2025-02-09 GPT Summary- Self-MoAは、単一の高性能LLMの出力を統合し、従来のMixture-of-Agents(MoA)を上回るアンサンブル手法である。実験では、Self-MoAがAlpacaEval 2.0で6.6%、様々なベンチマークで平均3.8%の改善を示し、新たな最先端性能を達成。MoAの性能は出力品質に敏感で、異なるLLMを混ぜると平均品質が低下することが確認された。さらに、Self-MoAの逐次版も導入し、複数ラウンドにわたって同等の統合効果を提供する。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=K6WwK8URlV
[Paper Note] s1: Simple test-time scaling, Niklas Muennighoff+, EMNLP'25, 2025.01
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #EMNLP #Test-Time Scaling #read-later #Reference Collection Issue Date: 2025-02-07 GPT Summary- 推論時スケーリングは、追加計算資源を使って言語モデルの性能を向上させる新アプローチ。OpenAIのo1モデルの手法が公表されず、再現試行が進む中、シンプルな手法を提案。1000問の小規模データセットs1Kを作成し、推論過程を管理する「予算強制」を導入。これによりモデルは誤った推論を修正し、s1Kで微調整後、o1-previewモデルを最大27%上回る性能を実現。s1-32Bモデルは推論時介入なしで性能を外挿し、AIME24で57%に達する。モデルとデータはオープンソースで提供。 Comment
解説:
[Paper Note] LIMO: Less is More for Reasoning, Yixin Ye+, arXiv'25, 2025.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #DataDistillation #Reasoning #COLM #PostTraining #read-later Issue Date: 2025-02-07 GPT Summary- 限られた訓練データで高度な数学的推論が可能であることを示す。モデルLIMOはAIME24で63.3%、MATH500で95.6%の精度を達成し、従来モデルを大幅に上回る。LIMOは分布外の一般化にも強く、従来のモデルよりも少ないデータで55%の改善を実現。Less-Is-More Reasoning Hypothesis(LIMO仮説)を提案し、事前知識の完全性と戦略的デモンストレーションの効果が推論の質を左右することを示唆。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=T2TZ0RY4Zk#discussion
[Paper Note] Demystifying Long Chain-of-Thought Reasoning in LLMs, Edward Yeo+, ICML'25
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #Reasoning #LongContext #ICML #RewardHacking #PostTraining #KeyPoint Notes #Author Thread-Post Issue Date: 2025-02-07 GPT Summary- 本研究では、大規模言語モデル(LLMs)における長い思考の連鎖(CoTs)推論のメカニズムを調査し、重要な要因を特定。主な発見は、(1) 教師ありファインチューニング(SFT)は必須ではないが効率を向上させる、(2) 推論能力は計算の増加に伴い現れるが、報酬の形状がCoTの長さに影響、(3) 検証可能な報酬信号のスケーリングが重要で、特に分布外タスクに効果的、(4) エラー修正能力は基本モデルに存在するが、RLを通じて効果的に奨励するには多くの計算が必要。これらの洞察は、LLMsの長いCoT推論を強化するためのトレーニング戦略の最適化に役立つ。 Comment
元ポスト:
元ポストのスレッド中に論文の11個の知見が述べられている。どれも非常に興味深い。DeepSeek-R1のテクニカルペーパーと同様、
- Long CoTとShort CoTを比較すると前者の方が到達可能な性能のupper bonudが高いことや、
- SFTを実施してからRLをすると性能が向上することや、
- RLの際にCoTのLengthに関する報酬を入れることでCoTの長さを抑えつつ性能向上できること、
- 数学だけでなくQAペアなどのノイジーだが検証可能なデータをVerifiableな報酬として加えると一般的なreasoningタスクで数学よりもさらに性能が向上すること、
- より長いcontext window sizeを活用可能なモデルの訓練にはより多くの学習データが必要なこと、
- long CoTはRLによって学習データに類似したデータが含まれているためベースモデルの段階でその能力が獲得されていることが示唆されること、
- aha momentはすでにベースモデル時点で獲得されておりVerifiableな報酬によるRLによって強化されたわけではなさそう、
など、興味深い知見が盛りだくさん。非常に興味深い研究。あとで読む。
[Paper Note] Tulu 3: Pushing Frontiers in Open Language Model Post-Training, Nathan Lambert+, COLM'25, 2024.11
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #OpenWeight #OpenSource #COLM #DPO #PostTraining #read-later #RLVR Issue Date: 2025-02-01 GPT Summary- Tulu 3は、オープンなポストトレーニングモデルのファミリーで、トレーニングデータやレシピを公開し、現代のポストトレーニング技術のガイドを提供します。Llama 3.1を基にし、他のクローズドモデルを上回る性能を達成。新しいトレーニング手法としてSFT、DPO、RLVRを採用し、マルチタスク評価スキームを導入。モデルウェイトやデモ、トレーニングコード、データセットなどを公開し、他のドメインへの適応も可能です。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=i1uGbfHHpH#discussion
[Paper Note] Diverse Preference Optimization, Jack Lanchantin+, ICLR'25, 2025.01
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #ICLR #DPO #PostTraining #Diversity #KeyPoint Notes #Author Thread-Post Issue Date: 2025-02-01 GPT Summary- Diverse Preference Optimization(DivPO)を提案し、応答の多様性を向上させつつ生成物の品質を維持するオンライン最適化手法を紹介。DivPOは応答のプールから多様性を測定し、希少で高品質な例を選択することで、パーソナ属性の多様性を45.6%、ストーリーの多様性を74.6%向上させる。 Comment
元ポスト:
OpenReview: https://openreview.net/forum?id=pOq9vDIYev
DPOと同じ最適化方法を使うが、Preference Pairを選択する際に、多様性が増加するようなPreference Pairの選択をすることで、モデルのPost-training後の多様性を損なわないようにする手法を提案しているっぽい。
具体的には、Alg.1 に記載されている通り、多様性の尺度Dを定義して、モデルにN個のレスポンスを生成させRMによりスコアリングした後、RMのスコアが閾値以上のresponseを"chosen" response, 閾値未満のレスポンスを "reject" responseとみなし、chosen/reject response集合を構築する。chosen response集合の中からDに基づいて最も多様性のあるresponse y_c、reject response集合の中から最も多様性のないresponse y_r をそれぞれピックし、prompt xとともにpreference pair (x, y_c, y_r) を構築しPreference Pairに加える、といった操作を全ての学習データ(中のprompt)xに対して繰り返すことで実現する。
DivPO
[Paper Note] SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training, Tianzhe Chu+, ICML'25
Paper/Blog Link My Issue
#ComputerVision #Analysis #MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #ICML #PostTraining #read-later #Reference Collection Issue Date: 2025-01-30 GPT Summary- SFTとRLの一般化能力の違いを研究し、GeneralPointsとV-IRLを用いて評価。RLはルールベースのテキストと視覚変種に対して優れた一般化を示す一方、SFTは訓練データを記憶し分布外シナリオに苦労。RLは視覚認識能力を向上させるが、SFTはRL訓練に不可欠であり、出力形式を安定させることで性能向上を促進。これらの結果は、複雑なマルチモーダルタスクにおけるRLの一般化能力を示す。 Comment
元ポスト:
[Paper Note] Humanity's Last Exam, Long Phan+, arXiv'25, 2025.01
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #LanguageModel #Evaluation #One-Line Notes Issue Date: 2025-01-25 GPT Summary- LLMの進展を追跡するためのベンチマークが不足している中、Humanity's Last Exam(HLE)を導入。HLEは多様な科目を網羅する2,500問のマルチモーダルな学術問題から成り、専門家の手による構築。高度なLLMはHLEで低精度を示し、閉じた回答形式の問題におけるLLMの能力と人間専門家との間のギャップを浮き彫りにしている。HLEは研究と政策立案のために公開されている。 Comment
o1, DeepSeekR1の正解率が10%未満の新たなベンチマーク
[Paper Note] Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models, Weixin Liang+, TMLR'25
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #NLP #LanguageModel #Transformer #MultiModal #SpeechProcessing #Architecture #TMLR #UMM Issue Date: 2024-11-12 GPT Summary- 大規模言語モデル(LLMs)のマルチモーダル処理を効率化するために、Mixture-of-Transformers(MoT)を提案。MoTは計算コストを削減し、モダリティごとにパラメータを分離して特化した処理を実現。Chameleon 7B設定では、55.8%のFLOPsで密なベースラインに匹敵する性能を示し、音声を含む場合も37.2%のFLOPsで同様の結果を達成。さらに、Transfusion設定では、7BのMoTモデルが密なベースラインの画像性能に対してFLOPsの3分の1で匹敵し、760Mのモデルは主要な画像生成指標で上回る結果を得た。MoTは実用的な利点も示し、画像品質を47.2%、テキスト品質を75.6%の経過時間で達成。 Comment
openreview: https://openreview.net/forum?id=Nu6N69i8SB
以下、openreviewより、
埋め込み層以外のパラメータに対して、モダリティごとに異なる独立したtrainableなtransformerを用意し(モダリティを分離する)、各transformerから出力されるsequenceを統合し、モダリティを跨いで全トークンに対してattendするglobal self-attentionを適用する。これにより、モダリティごとに選択的に固有のパラメータを活性化することで計算量を削減し、マルチモーダル学習における計算不可が高い課題に対処する。
[Paper Note] Differential Transformer, Tianzhu Ye+, N_A, ICLR'25
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #ICLR #In-Depth Notes Issue Date: 2024-10-21 GPT Summary- Diff Transformerは、関連するコンテキストへの注意を強化し、ノイズをキャンセルする新しいアーキテクチャです。差分注意メカニズムを用いて、注意スコアを計算し、スパースな注意パターンを促進します。実験結果は、Diff Transformerが従来のTransformerを上回り、長いコンテキストモデリングや幻覚の軽減において顕著な利点を示しています。また、文脈内学習においても精度を向上させ、堅牢性を高めることが確認されました。これにより、Diff Transformerは大規模言語モデルの進展に寄与する有望なアーキテクチャとされています。 Comment
# 概要
attention scoreのノイズを低減するようなアーキテクチャとして、二つのQKVを用意し、両者の差分を取ることで最終的なattentiok scoreを計算するDifferential Attentionを提案した。
attentionのnoiseの例。answerと比較してirrelevantなcontextにattention scoreが高いスコアが割り当てられてしまう(図左)。differential transformerが提案するdifferential attentionでは、ノイズを提言し、重要なcontextのattention scoreが高くなるようになる(図中央)、らしい。
# Differential Attentionの概要
二つのQKをどの程度の強さで交互作用させるかをλで制御し、λもそれぞれのQKから導出する。数式は2.1節に記述されているのでそちらも参照のこと。
QA, 機械翻訳, 文書分類, テキスト生成などの様々なNLPタスクが含まれるEval Harnessベンチマークでは、同規模のtransformerモデルを大幅にoutperform。ただし、3Bでしか実験していないようなので、より大きなモデルサイズになったときにgainがあるかは示されていない点には注意。
モデルサイズ(パラメータ数)と、学習トークン数のスケーラビリティについても調査した結果、LLaMAと比較して、より少ないパラメータ数/学習トークン数で同等のlossを達成。
64Kにcontext sgzeを拡張し、1.5B tokenで3Bモデルを追加学習をしたところ、これもtransformerと比べてより小さいlossを達成
context中に埋め込まれた重要な情報(今回はクエリに対応するmagic number)を抽出するタスク(Needle-In-A-Haystack test)の性能も向上。Needle(N)と呼ばれる正解のmagic numberが含まれる文をcontext中の様々な深さに配置し、同時にdistractorとなる文もランダムに配置する。これに対してクエリ(R)が入力されたときに、どれだけ正しい情報をcontextから抽出できるか、という話だと思われる。
これも性能が向上。特にクエリとNeedleが複数の要素で構成されていれ場合の性能が高く(Table2)、長いコンテキスト中の様々な位置に埋め込まれたNeedleを抽出する性能も高い(Figure5)
Many shotのICL能力も、異なる数のクラス分類を実施する4つのDatasetにおいて向上。クラス数が増えるに従ってAcc.のgainは小さくなっているように見える({6, 50} class > 70 class > 150 class)が、それでもAcc.が大きく向上している。
要約タスクでのhallucinationも低減。生成された要約と正解要約を入力し、GPT-4oにhallucinationの有無を判定させて評価(このようなLLM-as-a-Judgeの枠組みは先行研究 (MT-Bench) で人手での評価と高いagreementがあることが示されている)
関連 (MT-Bench):
- [Paper Note] Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Lianmin Zheng+, NeurIPS'23, 2023.06
シンプルなアプローチでLLM全体の性能を底上げしている素晴らしい成果に見える。斜め読みなので読み飛ばしているかもしれないが、
- [Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
のように高品質な学習データで学習した場合も同様の効果が発現するのだろうか?
attentionのスコアがnoisyということは、学習データを洗練させることでも改善される可能性があり、[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
はこれをデータで改善し、こちらの研究はモデルのアーキテクチャで改善した、みたいな捉え方もできるのかもしれない。
ちなみにFlash Attentionとしての実装方法も提案されており、スループットは通常のattentionと比べてむしろ向上している (Appendix A参照のこと) ので実用的な手法でもある。すごい。
あとこれ、事前学習とInstruction Tuningを通常のマルチヘッドアテンションで学習されたモデルに対して、独自データでSFTするときに導入したらdownstream taskの性能向上するんだろうか。もしそうなら素晴らしい
OpenReview: https://openreview.net/forum?id=OvoCm1gGhN
GroupNormalizationについてはこちら:
- [Paper Note] Group Normalization, Yuxin Wu+, arXiv'18, 2018.03
[Paper Note] nGPT: Normalized Transformer with Representation Learning on the Hypersphere, Ilya Loshchilov+, ICLR'25, 2024.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #ICLR #Normalization Issue Date: 2024-10-21 GPT Summary- ハイパースフィア上での表現学習に基づく新しいニューラルネットワークアーキテクチャ、正規化トランスフォーマー(nGPT)を提案。全てのベクトルが単位ノルムで正規化され、入力トークンがハイパースフィア上を移動し、各レイヤーで変位を加える。nGPTは学習が速く進行し、同精度を達成するためのトレーニングステップ数を4〜20倍削減することが実験で示された。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=se4vjm7h4E
[Paper Note] Diffusion Models Are Real-Time Game Engines, Dani Valevski+, ICLR'25, 2024.08
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #DiffusionModel #ICLR #read-later #WorldModels #interactive #Initial Impression Notes Issue Date: 2024-09-01 GPT Summary- GameNGenは、初の完全にニューラルモデルで動作するゲームエンジンであり、DOOMを用いて訓練され、インタラクティブな新しい軌道を生成する能力を持つ。毎秒20フレームで動作し、9.4のPSNRを達成。評価者は自己回帰生成後もゲームクリップをわずかに識別可能である。GameNGenは、強化学習エージェントによるトレーニングと、次フレーム生成のための拡散モデルの2段階で訓練され、安定した生成を実現する。 Comment
Diffusion Modelでゲーム映像を生成する取り組みらしい。ゲームのenvironmentに対して、ユーザのActionとframeの系列をエピソードとみなして生成するっぽい?
project pageにデモがのっている
https://gamengen.github.io/
openreview: https://openreview.net/forum?id=P8pqeEkn1H
[Paper Note] Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots, Cheng Chi+, arXiv'24, 2024.02
Paper/Blog Link My Issue
#Robotics #EmbodiedAI #Manipulation #Data Issue Date: 2026-11-05 GPT Summary- 人間のデモンストレーションから実運用可能なロボットポリシーへ直接スキルを転移するUMIフレームワークを提案。ハンドヘルド型グリッパーにより、携帯性・低コスト・豊富な情報量を備えたデータ収集を実現し、両手操作や動的・精密・長時間の操作にも対応する。推論時の遅延調整と相対軌道による行動表現によって、ハードウェアに依存せず複数のロボットへ展開可能。実世界実験では、新規環境や物体に対するゼロショット一般化を確認し、ハードウェアおよびソフトウェアをオープンソースとして公開。 Comment
元ポスト:
pj page: https://umi-gripper.github.io
[Paper Note] One-step Diffusion with Distribution Matching Distillation, Tianwei Yin+, CVPR'24, 2023.11
Paper/Blog Link My Issue
#ComputerVision #DiffusionModel #CVPR #read-later #DiffusionDistillation Issue Date: 2026-10-22 GPT Summary- 拡散モデルを1ステップ画像生成器へ変換するため、近似KLダイバージェンスを用いて目標分布と生成分布を一致させるDMDを提案。2つのスコア関数の差に基づく蒸留に加え、多段階拡散モデルの出力と大域構造を合わせる回帰損失を導入。既存の少ステップ手法を上回り、ImageNet 64×64でFID 2.62、COCO-30kでFID 11.49を達成し、Stable Diffusion級の品質を毎秒20枚で実現。 Comment
pj page: https://tianweiy.github.io/dmd/
DMD
[Paper Note] Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, Jiaqi Zhai+, ICML'24, 2024.02
Paper/Blog Link My Issue
#RecommenderSystems #GenerativeRecommendation #ICML #Scaling Laws #read-later Issue Date: 2026-10-06 GPT Summary- 高基数・大規模なユーザー行動データを扱う推薦問題を、生成モデルによる逐次変換タスクとして再定式化し、ストリーミング推薦向けのHSTUを提案。 HSTUは既存手法をNDCGで最大65.8%上回り、長系列でもTransformerより高速で、オンラインA/Bテストでも指標を12.4%改善。 さらに、モデル品質が学習計算量に対してべき乗則で向上することを示し、推薦分野における基盤モデルへの道を開く。
[Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Attention #NeurIPS #read-later #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形トランスフォーマーとデルタ則を用いたハードウェア効率の良いトレーニングアルゴリズムを提案。この手法を用いて13億パラメータのモデルを訓練し、最新の線形時間ベースラインを上回る性能を示した。また、DeltaNet層を組み込んだハイブリッドモデルが強力なトランスフォーマーの基準を越えることを実証。 Comment
[Paper Note] DISCOVERYWORLD: A Virtual Environment for Developing and Evaluating Automated Scientific Discovery Agents, Peter Jansen+, NeurIPS'24 Spotlight, 2024.06
Paper/Blog Link My Issue
#LanguageModel #AIAgents #Evaluation #ScientificDiscovery #NeurIPS #Science #One-Line Notes Issue Date: 2026-04-14 GPT Summary- DISCOVERYWORLDは、エージェントが科学的発見の全過程を実行できる初の仮想環境で、放射性同位体年代測定やロケット科学など多様な課題を提供します。タスクは一般的な発見スキルの育成を奨励し、シミュレーションされたテキスト環境で、オプションの2Dビジュアルオーバーレイもあります。120の課題は3つの難易度に分かれ、エージェントは仮説立案から結果分析までを行います。また、性能評価は課題完遂度や行動に基づき、自動指標で行われます。強力なベースラインエージェントが多くの課題で苦戦することから、DISCOVERYWORLDの新規性に関わる挑戦を捉えており、科学的発見能力の評価と開発を促進する可能性が示唆されます。 Comment
pj page: https://allenai.github.io/discoveryworld/
ベンチマークの概要は
- Evaluating agents for scientific discovery, Ai2, 2026.04
参照のこと。
[Paper Note] Lessons from the Trenches on Reproducible Evaluation of Language Models, Stella Biderman+, arXiv'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #Reproducibility #One-Line Notes Issue Date: 2026-03-08 GPT Summary- 言語モデルの評価は未解決の課題であり、研究者やエンジニアは感度、手法比較の難しさ、再現性の欠如といった問題に直面している。本論文は、大規模言語モデルの評価に関する3年間の経験を基に、共通の課題の概要、ベストプラクティスの整理、独立的で再現性のあるオープンソースライブラリ「Language Model Evaluation Harness」(lm-eval)を提案し、その機能とケーススタディを紹介する。 Comment
いわゆるLM Evaluation Harnessに関する運用する中での知見を報告する論文。LM Evaluation Harnessは広範なベンチマークでのLLMの評価を公平で透明性、再現性が担保された形で実施する実装である。
github:
https://github.com/EleutherAI/lm-evaluation-harness
LM Evaluation Harness自体は2021年から存在する。
[Paper Note] V*: Guided Visual Search as a Core Mechanism in Multimodal LLMs, Penghao Wu+, CVPR'24, 2023.12
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #CVPR #read-later #VisionLanguageModel #ThinkingWithImages Issue Date: 2026-02-20 GPT Summary- 視覚的タスク遂行には、選択的な視覚処理が重要であるが、現在のMLLMにはこの機能が欠如している。そこで、LLMの知識を活用する視覚検索機構V*を導入。MLLMとの統合により、推論と文脈理解が向上し、特定の視覚要素を正確に狙えるようになる。この統合はSEALという新しいメタアーキテクチャを生み出し、高解像度画像の処理能力を評価するためのV*Benchも作成。視覚検索機能の重要性を際立たせた研究である。
[Paper Note] Mamba: Linear-Time Sequence Modeling with Selective State Spaces, Albert Gu+, COLM'24, 2023.12
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #SSM (StateSpaceModel) #COLM #LinearAttention Issue Date: 2026-02-04 GPT Summary- ファウンデーションモデルはトランスフォーマーを基盤としており、計算非効率性を解決するために新たなアーキテクチャが開発されたが、言語モダリティではあまり効果的でなかった。私たちは内容ベースの推論能力の欠如を特定し、SSMのパラメータを入力に依存させることで、情報の選択的伝播を可能にした。さらに、ハードウェアに適応した並列アルゴリズムを設計し、簡略化されたニューラルネットワークアーキテクチャMambaに統合した。このMambaは、高速な推論とシーケンス長での線形スケーリングを可能にし、言語や音声などで最先端の性能を達成。特にMamba-3Bモデルは、同サイズのトランスフォーマーを上回る性能を示した。 Comment
openreview: https://openreview.net/forum?id=tEYskw1VY2
日本語解説: https://qiita.com/peony_snow/items/649ecb307cd3b5c10aa7
関連:
- [Paper Note] Retentive Network: A Successor to Transformer for Large Language Models, Yutao Sun+, arXiv'23, 2023.07
- [Paper Note] RWKV: Reinventing RNNs for the Transformer Era, Bo Peng+, N/A, EMNLP'23 Findings, 2023.05
[Paper Note] Gated Linear Attention Transformers with Hardware-Efficient Training, Songlin Yang+, ICML'24, 2023.12
Paper/Blog Link My Issue
#NLP #LanguageModel #Transformer #Architecture #ICML #LinearAttention Issue Date: 2026-02-04 GPT Summary- 線形アテンションを持つトランスフォーマーは、効率的な並列トレーニングを実現する一方、通常のソフトマックスアテンションに比べて性能が劣る。提案するFLASHLINEARATTENTIONは、メモリ移動と並列化のトレードオフを考慮し、短いシーケンスで高速な実装を実現。また、データ依存ゲートを追加したゲート付き線形アテンション(GLA)トランスフォーマーは、LLaMAやRetNet、Mambaと比較して競争力のある性能を示し、長さの一般化でも有効。GLAトランスフォーマーは、同サイズのMambaモデルよりも高いトレーニングスループットを持つ。
[Paper Note] Developing Generalist Foundation Models from a Multimodal Dataset for 3D Computed Tomography, Ibrahim Ethem Hamamci+, arXiv'24, 2024.03
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #CLIP #VisionLanguageModel #Encoder #2D (Image) #3D (Scene) #Medical Issue Date: 2026-02-01 GPT Summary- CT-RATEデータセットを介して、3D医療画像とそのテキストレポートをペアリングし、幅広い応用に向けたCTフォーカスの対照的言語-画像前訓練フレームワークCT-CLIPを開発。これにより、多異常検出やケースリトリーバルで最先端の完全監視モデルを上回る性能を達成。さらに、CT-RATEから派生した270万件以上のQ&AペアでファインチューニングされたCT-CHATを構築し、3D医療画像に特化した手法の重要性を示す。オープンソースなリリースは医療AIの革新と患者ケア向上に寄与。
[Paper Note] Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design or: How I learned to start worrying about prompt formatting, Melanie Sclar+, ICLR'24, 2023.10
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Prompting #Evaluation #OpenWeight #ICLR Issue Date: 2026-01-21 GPT Summary- LLMの性能特性化が重要であり、プロンプト設計がモデル挙動に強く影響することを示す。特に、プロンプトフォーマットに対するLLMの感度に注目し、微妙な変更で最大76ポイントの性能差が見られる。感度はモデルサイズや少数ショットの数に依存せず、プロンプトの多様なフォーマットにわたる性能範囲の報告が必要。モデル間のフォーマットパフォーマンスが弱く相関することから、固定されたプロンプトフォーマットでの比較の妥当性が疑問視される。迅速なフォーマット評価のための「FormatSpread」アルゴリズムを提案し、摂動の影響や内部表現も探る。 Comment
openreview: https://openreview.net/forum?id=RIu5lyNXjT
[Paper Note] Transcoders Find Interpretable LLM Feature Circuits, Jacob Dunefsky+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #LanguageModel #read-later #Transcoders #CircuitAnalysis #Interpretability Issue Date: 2025-12-21 GPT Summary- トランスコーダーを用いて、MLPサブレイヤーの回路分析を行い、スパースなMLPレイヤーでの忠実な近似を実現。これにより、入力依存項と入力不変項に因数分解された回路を得る。120Mから1.4Bパラメータの言語モデルで訓練し、SAEと同等の解釈可能性を確認。GPT2-smallの「greater-than circuit」に関する新たな洞察も得られた。トランスコーダーはMLPを含むモデル計算の解釈に効果的であることが示唆された。
[Paper Note] MANTIS: Interleaved Multi-Image Instruction Tuning, Dongfu Jiang+, TMLR'24 Outstanding Certification, 2024.05
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #NLP #Dataset #InstructionTuning #MultiModal #TMLR #VisionLanguageModel #2D (Image) Issue Date: 2025-12-02 GPT Summary- Mantisモデルは、721Kの複数画像指示データを用いた指示調整により、複数画像の視覚言語タスクで最先端の性能を達成。特に、Idefics2-8Bを平均13ポイント上回り、一般化能力も示す。大規模な事前学習に依存せず、低コストの指示調整で複数画像能力を向上できることを示した。 Comment
openreview: https://openreview.net/forum?id=skLtdUVaJa
元ポスト:
[Paper Note] WebVoyager: Building an End-to-End Web Agent with Large Multimodal Models, Hongliang He+, ACL'24, 2024.01
Paper/Blog Link My Issue
#Dataset #AIAgents #Evaluation #MultiModal #ACL #ComputerUse #VisionLanguageModel #KeyPoint Notes #GUI Issue Date: 2025-11-25 GPT Summary- WebVoyagerは、実際のウェブサイトと対話しユーザーの指示をエンドツーエンドで完了できる大規模マルチモーダルモデルを搭載したウェブエージェントである。新たに設立したベンチマークで59.1%のタスク成功率を達成し、GPT-4やテキストのみのWebVoyagerを上回る性能を示した。提案された自動評価指標は人間の判断と85.3%一致し、ウェブエージェントの信頼性を高める。 Comment
日本語解説: https://blog.shikoan.com/web-voyager/
スクリーンショットを入力にHTMLの各要素に対してnumeric labelをoverlayし(Figure2)、VLMにタスクを完了するためのアクションを出力させる手法。アクションはFigure7のシステムプロンプトに書かれている通り。
たとえば、VLMの出力として"Click [2]" が得られたら GPT-4-Act GPT-4V-Act, ddupont808, 2023.10
と呼ばれるSoM [Paper Note] Set-of-Mark Prompting Unleashes Extraordinary Visual Grounding in GPT-4V, Jianwei Yang+, arXiv'23, 2023.10
をベースにWebUIに対してマウス/キーボードでinteractできるモジュールを用いることで、[2]とマーキングされたHTML要素を同定しClick操作を実現する。
[Paper Note] SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, John Yang+, arXiv'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #Evaluation #NeurIPS #SoftwareEngineering #read-later #One-Line Notes Issue Date: 2025-11-25 GPT Summary- LMエージェントのパフォーマンスにおけるインターフェースデザインの影響を調査し、ソフトウェアエンジニアリングタスクを解決するためのシステム「SWE-agent」を提案。SWE-agentのカスタムインターフェースは、コード作成やリポジトリナビゲーション、プログラム実行能力を向上させ、SWE-benchとHumanEvalFixで最先端のパフォーマンスを達成。pass@1率はそれぞれ12.5%と87.7%に達し、従来の非インタラクティブなLMを大きく上回る結果を示した。 Comment
SWE bench Verifiedで利用されているハーネスで、mini-SWE-agentと呼ばれるもの
https://github.com/SWE-agent/mini-swe-agent
[Paper Note] Simplified and Generalized Masked Diffusion for Discrete Data, Jiaxin Shi+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#DiffusionModel #NeurIPS #read-later Issue Date: 2025-11-04 GPT Summary- Masked拡散モデルの潜在能力を引き出すためのシンプルなフレームワークを提案。連続時間変分目的がクロスエントロピー損失の重み付き積分であることを示し、状態依存のマスキングスケジュールを用いたトレーニングを可能に。OpenWebTextでの評価で、GPT-2スケールのモデルを上回り、ゼロショット言語モデリングタスクで優れたパフォーマンスを示す。画像モデリングでもCIFAR-10やImageNetで従来のモデルを大幅に上回る結果を達成。コードは公開中。 Comment
- Masked Diffusion Modelの進展, Deep Learning JP, 2025.03
で紹介されている
次:
- [Paper Note] Large Language Diffusion Models, Shen Nie+, NeurIPS'25
[Paper Note] Simple and Effective Masked Diffusion Language Models, Subham Sekhar Sahoo+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #DiffusionModel #NeurIPS #read-later Issue Date: 2025-11-04 GPT Summary- マスク付き離散拡散モデルは、従来の自己回帰手法に匹敵する性能を示す。効果的なトレーニング手法と簡略化された目的関数を導出し、エンコーダ専用の言語モデルをトレーニングすることで、任意の長さのテキスト生成が可能に。言語モデリングのベンチマークで新たな最先端を達成し、AR手法に近づく成果を上げた。 Comment
- Masked Diffusion Modelの進展, Deep Learning JP, 2025.03
で紹介されている
[Paper Note] Large Language Monkeys: Scaling Inference Compute with Repeated Sampling, Bradley Brown+, arXiv'24, 2024.07
Paper/Blog Link My Issue
#NLP #LanguageModel #Test-Time Scaling #KeyPoint Notes Issue Date: 2025-11-02 GPT Summary- 言語モデルの推論能力を向上させるために、候補解を繰り返しサンプリングする手法を提案。サンプル数の増加に伴い、問題解決のカバレッジが4桁のオーダーでスケールし、対数線形の関係が示唆される。自動検証可能な回答がある領域では、カバレッジの増加がパフォーマンス向上に直結。SWE-bench Liteでの実験では、サンプル数を増やすことで解決率が大幅に向上したが、自動検証器がない領域ではサンプル数が増えても効果が頭打ちになることが確認された。 Comment
Repeated Sampling。同じプロンプトで複数回LLMを呼び出し、なんらかのverifierを用いて最も良いものを選択するtest time scaling手法。
figure2にverifierを利用しない場合と利用した場合の差が示されている。高性能なverifierが利用された場合は、サンプル数の増加に大して性能がスケールしていき、single attemptでのstrong ModelやSoTAを上回る性能が得られることがわかる。
Figure8を見るとself consistency型のverifierの限界が示されている。すなわち、サンプリングする中で正しい解法が頻出しないようなものである。図を見ると、赤いbarがmajority-votingでは正解できない問題のindexを示しており、それなりの割合で存在することがわかる。
この辺の話は
- [Paper Note] Rethinking the Role of Prompting Strategies in LLM Test-Time Scaling: A Perspective of Probability Theory, Yexiang Liu+, ACL'25 Outstanding Paper
とも関連していると思われる。
verifierの具体的な構築方法としてどのようなものがあるかが気になる。あとで読む。
> However, these increasingly rare correct generations are only beneficial if verifiers can “find the needle in the haystack” and identify them from collections of mostly-incorrect samples. In math word problem settings, we find that two common methods for verification (majority voting and reward models) do not possess this ability. When solving MATH [26] problems with Llama-3-8B-Instruct, coverage increases from 82.9% with 100 samples to 98.44% with 10,000 samples. However, when using majority voting or reward models to select final answers, the biggest performance increase is only from 40.50% to 41.41% over the same sample range.
上に記述されている内容は、要はverifierの性能が重要で、典型的なmajority votingやreward mode4lsによるverification手法ではスケールしないケースがある。たとえば、以下のFigure7を見ると、典型的な
- majority voting
- reward model + best-of-N
- majority voting + reward model
などのtest-time scaling手法(verification手法)がサンプル数Kを増やしてもスケールしないことを示しており、一方Oracle Verifier(=数学の問題において正解が既知の場合に正解を出力したサンプルを採用する)での結果を見ると、性能がスケールしていくことがわかる。特にGSM8K, MATHデータセットにおいては、Reward Modelを利用するverification手法はmajority votingと比較してあまり良い性能が出ていないことがわかる。
本研究は5つのデータで検証しているが利用されているverifierは
- MiniF2F-MATH, CodeContests, SWE-Bench:
- すでに自動的なverifierが提供されており、たとえばそれはLean4 proof checker、test case, unit test suitesなどである
- GSM8K, MATH:
- これらについてはOracle Verifier(=モデルの出力が問題の正答と一致したら採用する)を利用している
本手法のスケーリングはverifierの性能に依存するため、高性能なverificationが作成できないタスクに関して適用するのは難しいと考えられる。逆に良い感じなverifierが定義できるなら相当強力な手法に見える。
[Paper Note] On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes, Rishabh Agarwal+, ICLR'24, 2023.06
Paper/Blog Link My Issue
#NeuralNetwork #MachineLearning #NLP #Distillation #ICLR #Off-Policy #On-Policy #One-Line Notes Issue Date: 2025-10-30 GPT Summary- 一般化知識蒸留(GKD)は、教師モデルからのフィードバックを活用し、生徒モデルが自己生成した出力シーケンスで訓練する手法。これにより、出力シーケンスの分布不一致の問題を解決し、柔軟な損失関数の使用が可能になる。GKDは蒸留と強化学習の統合を促進し、要約、翻訳、算術推論タスクにおける自動回帰言語モデルの蒸留においてその有効性を示す。 Comment
openreview: https://openreview.net/forum?id=3zKtaqxLhW
- Unlocking On-Policy Distillation for Any Model Family, Patiño+, HuggingFace, 2025.10
での説明に基づくと、
オフポリシーの蒸留手法を使うと、教師モデルが生成した出力を用いて蒸留をするため、生徒モデルが実際に出力するcontextとは異なる出力に基づいて蒸留をするため、生徒モデルの推論時のcontextとのミスマッチが生じる課題があるが、オンポリシーデータを混ぜることでこの問題を緩和するような手法(つまり実際の生徒モデル運用時と似た状況で蒸留できる)。生徒モデルが賢くなるにつれて出力が高品質になるため、それらを学習データとして再利用することでpositiveなフィードバックループが形成されるという利点がある。また、強化学習と比較しても、SparseなReward Modelに依存せず、初期の性能が低いモデルに対しても適用できる利点があるとのこと(性能が低いと探索が進まない場合があるため)。
[Paper Note] Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To, Xiangyu Qi+, ICLR'24, 2023.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #Safety #PostTraining #One-Line Notes Issue Date: 2025-10-24 GPT Summary- LLMのファインチューニングは、下流のユースケースに最適化する手法だが、安全性のリスクが伴う。特に、敵対的なトレーニング例を用いたファインチューニングが、モデルの安全性調整を損なう可能性があることが示された。例えば、わずか10例の悪意のある例でGPT-3.5 Turboをファインチューニングすると、安全ガードレールが突破される。また、無害なデータセットでのファインチューニングも意図せず安全性を劣化させる可能性がある。これらの結果は、調整されたLLMのファインチューニングが新たな安全リスクを生むことを示唆しており、今後の安全プロトコルの強化が求められる。 Comment
openreview: https://openreview.net/forum?id=hTEGyKf0dZ
なんらかのデータでpost-trainingしたモデルを、ユーザが利用可能な形でデプロイするような場合には、本研究が提唱するようなjailbreakのリスク
- 有害データが10例混入するだけで有害な出力をするようになる
- 暗黙的な有害データの混入(e.g., あなたはユーザ命令に従うエージェントです)
- 無害なデータでpost-trainingするだけでも下記のような影響でsafety alignmentが悪化する
- catastrophic forgetting
- 有用性と無害性のトレードオフによって、有用性を高めたことで有害性が結果的に増えてしまう( `tension between the helpfulness and harmlessness objectives` [Paper Note] Training a Helpful and Harmless Assistant with Reinforcement Learning
from Human Feedback, Yuntao Bai+, arXiv'22
)
があることを認識しておく必要がある。
もし安直にユーザからの指示追従能力を高めたいなあ・・・と思い、「ユーザからの指示には忠実に従ってください」などの指示を追加してpost-trainingをしてしまい、無害なプロンプトのみでテストして問題ないと思いユーザ向けのchatbotとしてデプロイしました、みたいなことをしたらえらいことになりそう。
[Paper Note] The Ultimate Guide to Fine-Tuning LLMs from Basics to Breakthroughs: An Exhaustive Review of Technologies, Research, Best Practices, Applied Research Challenges and Opportunities, Venkatesh Balavadhani Parthasarathy+, arXiv'24, 2024.08
Paper/Blog Link My Issue
#Tutorial #MachineLearning #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Evaluation #MultiModal #Pruning #Actor-Critic #PEFT(Adaptor/LoRA) #LLMServing #DPO #PostTraining #VisionLanguageModel Issue Date: 2025-10-17 GPT Summary- 本報告書では、大規模言語モデル(LLMs)のファインチューニングに関する理論と実践を統合的に検討し、歴史的な進化やファインチューニング手法の比較を行っています。7段階の構造化されたパイプラインを紹介し、不均衡データセットの管理やパラメータ効率の良い手法(LoRA、Half Fine-Tuning)に重点を置いています。また、PPOやDPOなどの新しいアプローチや、検証フレームワーク、デプロイ後のモニタリングについても議論し、マルチモーダルLLMsやプライバシー、説明責任に関する課題にも触れています。研究者や実務者に実用的な洞察を提供する内容です。 Comment
元ポスト:
[Paper Note] DoRA: Weight-Decomposed Low-Rank Adaptation, Shih-Yang Liu+, ICML'24, 2024.02
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICML #One-Line Notes Issue Date: 2025-10-10 GPT Summary- LoRAの精度ギャップを解消するために、Weight-Decomposed Low-Rank Adaptation(DoRA)を提案。DoRAは、ファインチューニングの重みを大きさと方向に分解し、方向性の更新にLoRAを使用することで、効率的にパラメータ数を最小化。これにより、LoRAの学習能力と安定性を向上させ、追加の推論コストを回避。さまざまな下流タスクでLoRAを上回る性能を示す。 Comment
日本語解説:
- LoRAの進化:基礎から最新のLoRA-Proまで , 松尾研究所テックブログ, 2025.09
- Tora: Torchtune-LoRA for RL, shangshang-wang, 2025.10
では、通常のLoRA, QLoRAだけでなく本手法でRLをする実装もサポートされている模様
[Paper Note] Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs, Arash Ahmadian+, ACL'24, 2024.02
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Alignment #ReinforcementLearning #ACL #read-later Issue Date: 2025-09-27 GPT Summary- RLHFにおける整合性の重要性を考慮し、PPOの高コストとハイパーパラメータ調整の問題を指摘。シンプルなREINFORCEスタイルの最適化手法がPPOや新提案の手法を上回ることを示し、LLMの整合性特性に適応することで低コストのオンラインRL最適化が可能であることを提案。
[Paper Note] ELLA: Equip Diffusion Models with LLM for Enhanced Semantic Alignment, Xiwei Hu+, arXiv'24
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #Evaluation #DiffusionModel #read-later #UMM Issue Date: 2025-09-11 GPT Summary- 拡散モデルに大規模言語モデル(LLM)を組み込む「効率的な大規模言語モデルアダプター(ELLA)」を提案。これにより、複雑なプロンプトの整合性を向上させ、意味的特徴を適応させる新しいモジュール「時間ステップ認識セマンティックコネクタ(TSC)」を導入。ELLAは密なプロンプトに対する性能が最先端手法を上回ることを実験で示し、特に複数のオブジェクト構成において優位性を発揮。 Comment
pj page: https://ella-diffusion.github.io
[Paper Note] Looped Transformers are Better at Learning Learning Algorithms, Liu Yang+, ICLR'24
Paper/Blog Link My Issue
#MachineLearning #Transformer #Architecture #LatentReasoning #RecurrentModels Issue Date: 2025-08-30 GPT Summary- ループ型transformerアーキテクチャを提案し、従来のtransformerに反復的特性を組み込むことで、データフィッティング問題を解決。実験により、標準のtransformerと同等の性能を保ちながら、パラメータ数を10%未満に抑えることができることが示された。 Comment
openreview: https://openreview.net/forum?id=HHbRxoDTxE
[Paper Note] MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies, Shengding Hu+, COLM'24
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #SmallModel #COLM #Scheduler #One-Line Notes Issue Date: 2025-08-25 GPT Summary- 急成長する大規模言語モデル(LLMs)の開発におけるコストの懸念から、小規模言語モデル(SLMs)の可能性が注目されている。本研究では、MiniCPMという1.2Bおよび2.4Bの非埋め込みパラメータバリアントを紹介し、これらが7B-13BのLLMsと同等の能力を持つことを示す。モデルのスケーリングには広範な実験を、データのスケーリングにはWarmup-Stable-Decay(WSD)学習率スケジューラを導入し、効率的なデータ-モデルスケーリング法を研究した。MiniCPMファミリーにはMiniCPM-DPO、MiniCPM-MoE、MiniCPM-128Kが含まれ、優れたパフォーマンスを発揮している。MiniCPMモデルは公開されている。 Comment
Warmup-Stable-Decay (WSD)
openreview: https://openreview.net/forum?id=3X2L2TFr0f¬eId=QvwPc5chyd
[Paper Note] InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks, Zhe Chen+, CVPR'24
Paper/Blog Link My Issue
#ComputerVision #Pretraining #MultiModal #FoundationModel #CVPR #VisionLanguageModel Issue Date: 2025-08-23 GPT Summary- 大規模視覚-言語基盤モデル(InternVL)は、60億パラメータで設計され、LLMと整合させるためにウェブ規模の画像-テキストデータを使用。視覚認知タスクやゼロショット分類、検索など32のベンチマークで最先端の性能を達成し、マルチモーダル対話システムの構築に寄与。ViT-22Bの代替として強力な視覚能力を持つ。コードとモデルは公開されている。 Comment
既存のResNetのようなSupervised pretrainingに基づくモデル、CLIPのようなcontrastive pretrainingに基づくモデルに対して、text encoder部分をLLMに置き換えて、contrastive learningとgenerativeタスクによる学習を組み合わせたパラダイムを提案。
InternVLのアーキテクチャは下記で、3 stageの学習で構成される。最初にimage text pairをcontrastive learningし学習し、続いてモデルのパラメータはfreezeしimage text retrievalタスク等でモダリティ間の変換を担う最終的にQlLlama(multilingual性能を高めたllama)をvision-languageモダリティを繋ぐミドルウェアのように捉え、Vicunaをテキストデコーダとして接続してgenerative cossで学習する、みたいなアーキテクチャの模様(斜め読みなので少し違う可能性あり
現在のVLMの主流であるvision encoderとLLMをadapterで接続する方式はここからかなりシンプルになっていることが伺える。
[Paper Note] Better & Faster Large Language Models via Multi-token Prediction, Fabian Gloeckle+, ICML'24
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #LanguageModel #Coding #ICML #MultiTokenPrediction Issue Date: 2025-08-16 GPT Summary- 本研究では、大規模言語モデルを複数の将来のトークンを同時に予測するように訓練する手法を提案し、サンプル効率の向上を図る。具体的には、n個の独立した出力ヘッドを用いて次のnトークンを予測し、訓練時間にオーバーヘッドをかけずに下流の能力を向上させる。特に、コーディングタスクにおいて、提案モデルは強力なベースラインを上回る性能を示し、推論時に最大3倍の速度向上も実現。 Comment
next tokenだけでなく、next 4-tokenを予測して学習することで、MBPP/HumanEvalにおいて、モデルのパラメータサイズが1.3Bを超えた時点でベースライン(=同じパラメータサイズとなるように調整されたnext-token prediction)をoutperformしはじめ、モデルサイズが大きくなるにつれて性能の差が顕著に表れることを示した。コーディングドメインにおいて事前学習、およびfinetuningの双方で効果がある。ただし、3.7節で示されている通り、これはコーディングドメインでのみこのような顕著な改善がみられており、自然言語データに対してはここまで顕著な改善はしていないように見える(5.1節で考察されていそう; 昨今のLLMでは事前学習データにコーディングなどのデータが入るのが普通なので利用する恩恵はありそう; Abstractive Summarizationでは性能が改善している(Figure6); GSM8Kでは200Bまではnext 2 tokenを予測すると性能が改善しているが500B token学習するとnext token predictionの方が性能が良くなる)。全体的にperplexityの改善(=次のトークンにおいて正解トークンの生成確率を改善する)というよりは、モデルの"最終的な生成結果”にフォーカスした評価となっている。
モデルは共有のトランクf_s (おそらくhead間でパラメータを共有している一連のtransformerブロック) を持っておりinput x_t:1に対応するlatent representation z_t:1を生成する。latent representationをoutput headにinputすることで、それぞれのheadが合計でn個のnext tokenを予測する。
next n-tokenを予測する際には、GPUメモリを大幅に食ってしまう (logitsのshapeが(n, V)となりそれらの勾配も保持しなければならない) ことがボトルネックとなるが、f_sまでforward passを実行したら、各headに対してforward/backward passを順番に実行して、logitsの値は破棄し勾配の情報だけf_sに蓄積することで、長期的に保持する情報を各headのから逆伝搬された勾配情報のみにすることでこれを解決している。
実際にinferenceをするときはnext tokenを予測するヘッドの出力を活用することを前提としているが、全てのヘッドを活用することで、t時点でt+nトークンの予測を可能なため、self-speculative decodingを実施しinference timeを短縮することができる。
3.4で示されているように、nの値は大きければ大きいほど良いというわけではなく、4程度(byte levelなモデルの場合は8 bytes)が最適なようである。が、Table1を見ると、データによってはn=6が良かったり(i.e., 最適なnは学習データ依存)複数エポック学習するとmulti token predictionの効果が薄くなっていそう(i.e., 同じトークンの予測を複数回学習するので実質multi token predictionと似たようなことをやっている。言い換えると、multi token predictionは複数epochの学習を先取りしているとみなせる?)なのは注意が必要そう。
全体的に複数epochを学習すると恩恵がなくなっていく(コーディング) or next token predictionよりも性能が悪化する(自然言語)ので、LLMの事前学習において、複数epochを学習するような当たり前みたいな世界線が訪れたら、このアーキテクチャを採用すると性能はむしろ悪化しそうな気はする。
MBPP/HumanEval:
- [Paper Note] Program Synthesis with Large Language Models, Jacob Austin+, arXiv'21
- [Paper Note] Evaluating Large Language Models Trained on Code, Mark Chen+, arXiv'21
[Paper Note] YaRN: Efficient Context Window Extension of Large Language Models, Bowen Peng+, ICLR'24
Paper/Blog Link My Issue
#NLP #LanguageModel #ContextWindow #LongContext #PositionalEncoding #ICLR #PostTraining Issue Date: 2025-08-02 GPT Summary- YaRN(Yet another RoPE extensioN method)は、トランスフォーマーベースの言語モデルにおける位置情報のエンコードを効率的に行い、コンテキストウィンドウを従来の方法よりも10倍少ないトークンと2.5倍少ない訓練ステップで拡張する手法を提案。LLaMAモデルが長いコンテキストを効果的に利用できることを示し、128kのコンテキスト長まで再現可能なファインチューニングを実現。 Comment
openreview: https://openreview.net/forum?id=wHBfxhZu1u
現在主流なRoPEを前提としたコンテキストウィンドウ拡張手法で、事前学習で学習されたRoPEのコンテキストウィンドウを中間学習において拡張する。様々なモデルで利用されている。
日本語解説: https://zenn.dev/bilzard/scraps/de7ecd3c380b6e
- 国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
pp.24--25に解説がある
[Paper Note] DiLoCo: Distributed Low-Communication Training of Language Models, Arthur Douillard+, ICML'24 Workshop WANT
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #ICML #mid-training #Workshop #One-Line Notes #needs-revision #DistributedLearning Issue Date: 2025-07-15 GPT Summary- 分散最適化アルゴリズム「DiLoCo」を提案し、接続が不十分なデバイスでのLLMトレーニングを可能にする。DiLoCoは、通信量を500分の1に抑えつつ、完全同期の最適化と同等の性能をC4データセットで発揮。各ワーカーのデータ分布に対して高いロバスト性を持ち、リソースの変動にも柔軟に対応可能。 Comment
言語モデルの分散学習における通信量をいかに抑えるかにフォーカスした研究で、クライアントごとに異なるデータsplitを持ち、当該データによってモデルをローカルでAdamWを用いてH step更新。その後、更新された重みの差分をouter gradientとして共有し、重み更新の差分を平均化することでローカルモデルを集約するという処理を繰り返す。
[Paper Note] StarCoder 2 and The Stack v2: The Next Generation, Anton Lozhkov+, arXiv'24
Paper/Blog Link My Issue
#Pretraining #NLP #Dataset #LanguageModel #Coding Issue Date: 2025-07-13 GPT Summary- BigCodeプロジェクトは、責任あるCode LLMsの開発に焦点を当て、StarCoder2を発表。Software Heritageと提携し、The Stack v2を構築し、619のプログラミング言語を含む大規模なトレーニングセットを作成。StarCoder2モデルは3B、7B、15Bのパラメータを持ち、徹底的なベンチマーク評価で優れた性能を示す。特にStarCoder2-15Bは、同等の他モデルを大幅に上回り、数学やコード推論でも高い性能を発揮。モデルの重みはOpenRAILライセンスで公開され、トレーニングデータの透明性も確保。 Comment
[Paper Note] Iterative Reasoning Preference Optimization, Richard Yuanzhe Pang+, NeurIPS'24, 2024.04
Paper/Blog Link My Issue
#NLP #LanguageModel #Reasoning #SelfImprovement #NeurIPS #DPO #PostTraining #KeyPoint Notes Issue Date: 2025-07-02 GPT Summary- 反復的な好み最適化手法を用いて、Chain-of-Thought(CoT)候補間の推論ステップを最適化するアプローチを開発。修正DPO損失を使用し、推論の改善を示す。Llama-2-70B-ChatモデルでGSM8K、MATH、ARC-Challengeの精度を向上させ、GSM8Kでは55.6%から81.6%に改善。多数決による精度は88.7%に達した。 Comment
- [Paper Note] Self-Rewarding Language Models, Weizhe Yuan+, arXiv'24, 2024.01
と似たようにiterativeなmannerでreasoning能力を向上させる。
ただし、loss functionとしては、chosenなCoT+yのresponseに対して、reasoning traceを生成する能力を高めるために、NLL Lossも適用している点に注意。
32 samplesのmajority votingによってより高い性能が達成できているので、多様なreasoning traceが生成されていることが示唆される。
DPOでReasoning能力を伸ばしたい場合はNLL lossが重要。Iterative RPO
[Paper Note] Let's Verify Step by Step, Hunter Lightman+, ICLR'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #ReinforcementLearning #Reasoning #ICLR #PRM Issue Date: 2025-06-26 GPT Summary- 大規模言語モデルの多段階推論能力が向上する中、論理的誤りが依然として問題である。信頼性の高いモデルを訓練するためには、結果監視とプロセス監視の比較が重要である。独自の調査により、プロセス監視がMATHデータセットの問題解決において結果監視を上回ることを発見し、78%の問題を解決した。また、アクティブラーニングがプロセス監視の効果を向上させることも示した。関連研究のために、80万の人間フィードバックラベルからなるデータセットPRM800Kを公開した。 Comment
OpenReview: https://openreview.net/forum?id=v8L0pN6EOi
[Paper Note] The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale, Guilherme Penedo+, NeurIPS'24
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Dataset #LanguageModel #NeurIPS Issue Date: 2025-05-10 GPT Summary- 本研究では、15兆トークンからなるFineWebデータセットを紹介し、LLMの性能向上に寄与することを示します。FineWebは高品質な事前学習データセットのキュレーション方法を文書化し、重複排除やフィルタリング戦略を詳細に調査しています。また、FineWebから派生した1.3兆トークンのFineWeb-Eduを用いたLLMは、MMLUやARCなどのベンチマークで優れた性能を発揮します。データセット、コードベース、モデルは公開されています。 Comment
日本語解説: https://zenn.dev/deepkawamura/articles/da9aeca6d6d9f9
openreview: https://openreview.net/forum?id=n6SCkn2QaG#discussion
[Paper Note] Physics of Language Models: Part 4.1, Architecture Design and the Magic of Canon Layers, Zeyuan Allen-Zhu+, ICML'24 Tutorial
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #SyntheticData #read-later #One-Line Notes #Reference Collection #Author Thread-Post Issue Date: 2025-05-06 Comment
元ポスト:
Canon層の発見
著者による解説:
[Paper Note] Physics of Language Models: Part 3.1, Knowledge Storage and Extraction, Zeyuan Allen-Zhu+, ICML'24
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #SyntheticData #ICML #Reference Collection Issue Date: 2025-05-03 GPT Summary- 大規模言語モデル(LLMs)の知識抽出能力は、訓練データの多様性と強く相関しており、十分な強化がなければ知識は記憶されても抽出可能ではないことが示された。具体的には、エンティティ名の隠れ埋め込みに知識がエンコードされているか、他のトークン埋め込みに分散しているかを調査。LLMのプレトレーニングに関する重要な推奨事項として、補助モデルを用いたデータ再構成と指示微調整データの早期取り入れが提案された。 Comment
SNLP'24での解説スライド:
https://speakerdeck.com/sosk/physics-of-language-models-part-3-1-knowledge-storage-and-extraction
[Paper Note] Safety Alignment Should Be Made More Than Just a Few Tokens Deep, Xiangyu Qi+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #Safety #ICLR #One-Line Notes #Reference Collection Issue Date: 2025-04-29 GPT Summary- LLMsの安全性整合性は脆弱であり、単純な攻撃でジャイルブレイク可能。この問題は浅層的安全整合に起因し、生成分布が初めの数トークンで適応されるために発生する。研究では、浅層的安全整合の存在理由をケーススタディで示し、複数の脆弱性の根本原因を探求。これにより、初期トークンを超えて整合性を深めることで悪用に対する堅牢性を向上させる可能性が示唆される。ファインチューニング攻撃に対抗するための正則化手法も提案。将来の安全整合性は、より深いアプローチが必要であるとの結論を導く。 Comment
元ポスト:
OpenReview: https://openreview.net/forum?id=6Mxhg9PtDE
Safety Alignment手法が最初の数トークンに依存しているからそうならないように学習しますというのは、興味深いテーマだし技術的にまだ困難な点もあっただろうし、インパクトも大きいし、とても良い研究だ…。
[Paper Note] Efficient Streaming Language Models with Attention Sinks, Guangxuan Xiao+, ICLR'24
Paper/Blog Link My Issue
#Attention #LongContext #ICLR #AttentionSinks #KeyPoint Notes #Reference Collection #Author Thread-Post Issue Date: 2025-04-05 GPT Summary- 大規模言語モデル(LLMs)をマルチラウンド対話に展開する際の課題として、メモリ消費と長いテキストへの一般化の難しさがある。ウィンドウアテンションはキャッシュサイズを超えると失敗するが、初期トークンのKVを保持することでパフォーマンスが回復する「アテンションシンク」を発見。これを基に、StreamingLLMというフレームワークを提案し、有限のアテンションウィンドウでトレーニングされたLLMが無限のシーケンス長に一般化可能になることを示した。StreamingLLMは、最大400万トークンで安定した言語モデリングを実現し、ストリーミング設定で従来の手法を最大22.2倍の速度で上回る。 Comment
Attention Sinksという用語を提言した研究
下記のpassageがAttention Sinksの定義(=最初の数トークン)とその気持ち(i.e., softmaxによるattention scoreは足し合わせて1にならなければならない。これが都合の悪い例として、現在のtokenのqueryに基づいてattention scoreを計算する際に過去のトークンの大半がirrelevantな状況を考える。この場合、irrelevantなトークンにattendしたくはない。そのため、auto-regressiveなモデルでほぼ全てのcontextで必ず出現する最初の数トークンを、irrelevantなトークンにattendしないためのattention scoreの捨て場として機能するのうに学習が進む)の理解に非常に重要
> To understand the failure of window attention, we find an interesting phenomenon of autoregressive LLMs: a surprisingly large amount of attention score is allocated to the initial tokens, irrespective of their relevance to the language modeling task, as visualized in Figure 2. We term these tokens
“attention sinks". Despite their lack of semantic significance, they collect significant attention scores. We attribute the reason to the Softmax operation, which requires attention scores to sum up to one for all contextual tokens. Thus, even when the current query does not have a strong match in many previous tokens, the model still needs to allocate these unneeded attention values somewhere so it sums up to one. The reason behind initial tokens as sink tokens is intuitive: initial tokens are visible to almost all subsequent tokens because of the autoregressive language modeling nature, making them more readily trained to serve as attention sinks.
- [Paper Note] Why do LLMs attend to the first token?, Federico Barbero+, COLM'25
の先行研究。こちらでAttentionSinkがどのように作用しているのか?が分析されている。
Figure1が非常にわかりやすい。Initial Token(実際は3--4トークン)のKV Cacheを保持することでlong contextの性能が改善する(Vanilla)。あるいは、Softmaxの分母に1を追加した関数を用意し(数式2)、全トークンのattention scoreの合計が1にならなくても許されるような変形をすることで、余剰なattention scoreが生じないようにすることでattention sinkを防ぐ(Zero Sink)。これは、ゼロベクトルのトークンを追加し、そこにattention scoreを逃がせるようにすることに相当する。もう一つの方法は、globalに利用可能なlearnableなSink Tokenを追加すること。これにより、不要なattention scoreの捨て場として機能させる。Table3を見ると、最初の4 tokenをKV Cacheに保持した場合はperplexityは大きく変わらないが、Sink Tokenを導入した方がKV Cacheで保持するInitial Tokenの量が少なくてもZero Sinkと比べると性能が良くなるため、今後モデルを学習する際はSink Tokenを導入することを薦めている。既に学習済みのモデルについては、Zero Sinkによってlong contextのモデリングに対処可能と思われる。
著者による解説:
openreview: https://openreview.net/forum?id=NG7sS51zVF
[Paper Note] Agent Workflow Memory, Zora Zhiruo Wang+, arXiv'24, 2024.09
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #memory #One-Line Notes #needs-revision Issue Date: 2025-04-02 GPT Summary- エージェントが複雑なタスクを解決するために、再利用可能なワークフローを学習するAgent Workflow Memory(AWM)を提案。AWMは、オフライン・オンラインのシナリオで選択的にワークフローを提供し、200以上のドメインにおいて実験した結果、Mind2Webで24.6%、WebArenaで51.1%の相対的成功率向上を達成。タスク解決に要する手順数も削減し、訓練-テスト分布ギャップが広がる中でも堅牢な一般化を示した。 Comment
過去のワークフローをエージェントがprompt中で利用することができ、利用すればするほど賢くなるような仕組みの提案
openreview: https://openreview.net/forum?id=PfYg3eRrNi
[Paper Note] WebArena: A Realistic Web Environment for Building Autonomous Agents, Shuyan Zhou+, ICLR'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #ICLR #One-Line Notes Issue Date: 2025-04-02 GPT Summary- 生成AIの進展により、自律エージェントが自然言語コマンドで日常タスクを管理する可能性が生まれたが、現行のエージェントは簡略化された環境でのテストに限られている。本研究では、ウェブ上でタスクを実行するエージェントのための現実的な環境を構築し、eコマースやソーシャルフォーラムなどのドメインを含む完全なウェブサイトを提供する。この環境を基に、タスクの正確性を評価するベンチマークを公開し、実験を通じてGPT-4ベースのエージェントの成功率が14.41%であり、人間の78.24%には及ばないことを示した。これにより、実生活のタスクにおけるエージェントのさらなる開発の必要性が強調される。 Comment
Webにおけるさまざまなrealisticなタスクを評価するためのベンチマーク
実際のexample。スタート地点からピッツバーグのmuseumを巡る最短の経路を見つけるといった複雑なタスクが含まれる。
人間とGPT4,GPT-3.5の比較結果
[Paper Note] SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, Carlos E. Jimenez+, ICLR'24
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #Evaluation #ICLR #SoftwareEngineering #One-Line Notes #Reference Collection Issue Date: 2025-04-02 GPT Summary- SWE-benchは、12の人気Pythonリポジトリから得られた2,294のソフトウェアエンジニアリング問題を評価するフレームワークで、言語モデルがコードベースを編集して問題を解決する能力を測定します。評価の結果、最先端の商用モデルや微調整されたモデルSWE-Llamaも最も単純な問題しか解決できず、Claude 2はわずか1.96%の問題を解決するにとどまりました。SWE-benchは、より実用的で知的な言語モデルへの進展を示しています。 Comment
ソフトウェアエージェントの最もpopularなベンチマーク
主にpythonライブラリに関するリポジトリに基づいて構築されている。
SWE-Bench, SWE-Bench Lite, SWE-Bench Verifiedの3種類がありソフトウェアエージェントではSWE-Bench Verifiedを利用して評価することが多いらしい。Verifiedでは、issueの記述に曖昧性がなく、適切なunittestのスコープが適切なもののみが採用されているとのこと(i.e., 人間の専門家によって問題がないと判断されたもの)。
https://www.swebench.com/
Agenticな評価をする際に、一部の評価でエージェントがgit logを参照し本来は存在しないはずのリポジトリのfuture stateを見ることで環境をハッキングしていたとのこと:
これまでの評価結果にどの程度の影響があるかは不明。
openreview: https://openreview.net/forum?id=VTF8yNQM66
[Paper Note] Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality, Tri Dao+, ICML'24
Paper/Blog Link My Issue
#NLP #LanguageModel #SSM (StateSpaceModel) #ICML #Reference Collection #Initial Impression Notes #LinearAttention Issue Date: 2025-03-24 GPT Summary- TransformersとMambaのような状態空間モデル(SSMs)の関連性を示し、SSMsと注意の変種との理論的接続を構築。新たに設計したMamba-2は、速度を2〜8倍向上させながら、Transformersと競争力を維持。 Comment
Mamba2の詳細を知りたい場合に読む
Mamba3:
- [Paper Note] MAMBA-3: IMPROVED SEQUENCE MODELING USING STATE SPACE PRINCIPLES, 2025.10
バグがあり本来の性能が出ていなかった模様:
初期化修正は後はGated Delta Netを上回る性能に。
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
[Paper Note] Sparse Autoencoders Find Highly Interpretable Features in Language Models, Hoagy Cunningham+, ICLR'24
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #ICLR #KeyPoint Notes #SparseAutoencoder #Interpretability #InterpretabilityScore Issue Date: 2025-03-15 GPT Summary- 神経ネットワークの多義性を解消するために、スパースオートエンコーダを用いて内部活性化の方向を特定。これにより、解釈可能で単義的な特徴を学習し、間接目的語の同定タスクにおける因果的特徴をより詳細に特定。スケーラブルで教師なしのアプローチが重ね合わせの問題を解決できることを示唆し、モデルの透明性と操作性向上に寄与する可能性を示す。 Comment
日本語解説: https://note.com/ainest/n/nbe58b36bb2db
OpenReview: https://openreview.net/forum?id=F76bwRSLeK
SparseAutoEncoderはネットワークのあらゆるところに仕込める(と思われる)が、たとえばTransformer Blockのresidual connection部分のベクトルに対してFeature Dictionaryを学習すると、当該ブロックにおいてどのような特徴の組み合わせが表現されているかが(あくまでSparseAutoEncoderがreconstruction lossによって学習された結果を用いて)解釈できるようになる。
SparseAutoEncoderは下記式で表され、下記loss functionで学習される。MがFeature Matrix(row-wiseに正規化されて後述のcに対するL1正則化に影響を与えないようにしている)に相当する。cに対してL1正則化をかけることで(Sparsity Loss)、c中の各要素が0に近づくようになり、結果としてcがSparseとなる(どうしても値を持たなければいけない重要な特徴量のみにフォーカスされるようになる)。
DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models, Damai+, ACL'24, 2024.08
Paper/Blog Link My Issue
#NLP #LanguageModel #Architecture #MoE(Mixture-of-Experts) #ACL #Initial Impression Notes Issue Date: 2025-01-06 GPT Summary- DeepSeekMoEアーキテクチャは、専門家の専門性を高めるために、専門家を細分化し柔軟な組み合わせを可能にし、共有専門家を設けて冗長性を軽減する。2BパラメータのDeepSeekMoEは、GShardと同等の性能を達成し、同じパラメータ数の密なモデルに近づく。16Bパラメータにスケールアップした際も、計算量を約40%に抑えつつ、LLaMA2と同等の性能を示した。 Comment
エキスパートの細分化 + shared expertの導入
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, Zhihong Shao+, arXiv'24
Paper/Blog Link My Issue
#NLP #LanguageModel #RLHF #Reasoning #Mathematics #GRPO #read-later #KeyPoint Notes Issue Date: 2025-01-04 GPT Summary- DeepSeekMath 7Bは、120Bの数学関連トークンを用いて事前学習された言語モデルで、競技レベルのMATHベンチマークで51.7%のスコアを達成。自己一貫性は60.9%で、データ選択パイプラインとGroup Relative Policy Optimization (GRPO)の導入により数学的推論能力が向上。Gemini-UltraやGPT-4に迫る性能を示す。 Comment
元々数学のreasoningに関する能力を改善するために提案されたが、現在はオンラインでTruthfulness, Helpfulness, Concisenessなどの改善に活用されているとのこと。
PPOとGRPOの比較。value function model(状態の価値を予測するモデル)が不要なため省メモリ、かつ利用する計算リソースが小さいらしい。
あとサンプルをグループごとに分けて、グループ内でのKLダイバージェンスが最小化されるよう(つまり、各グループ内で方策が類似する)Policy Modelが更新される(つまりloss functionに直接組み込まれる)点が違うらしい。
PPOでは生成するトークンごとにreference modelとPolicy ModelとのKLダイバージェンスをとり、reference modelとの差が大きくならないよう、報酬にペナルティを入れるために使われることが多いらしい。
下記記事によると、PPOで最大化したいのはAdvantage(累積報酬と状態価値(累積報酬の期待値を計算するモデル)の差分;期待値よりも実際の累積報酬が良かったら良い感じだぜ的な数値)であり、それには状態価値を計算するモデルが必要である。そして、PPOにおける状態価値モデルを使わないで、LLMにテキスト生成させて最終的な報酬を平均すれば状態価値モデル無しでAdvantageが計算できるし嬉しくね?という気持ちで提案されたのが、本論文で提案されているGRPOとのこと。勉強になる。
DeepSeek-R1の論文読んだ?【勉強になるよ】
, asap:
https://zenn.dev/asap/articles/34237ad87f8511
[Paper Note] TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks, Frank F. Xu+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #Evaluation #NeurIPS #Surface-level Notes #Author Thread-Post Issue Date: 2025-01-03 GPT Summary- 大規模言語モデル(LLMs)によるAIエージェントの進展が、日常業務の効率化にどのように寄与するかを探求。TheAgentCompanyを通じて、AIエージェントがデジタル労働者のように働く能力を評価する拡張可能なベンチマークを導入。模擬のソフトウェア企業環境で、タスクの自律的完了率は30%に達し、単純なタスクは成功する一方、複雑な長期タスクは今のモデルでは難しいことを示す。 Comment
元ポスト:
ソフトウェアエンジニアリングの企業の設定で現実に起こりうるな 175種類のタスクを定義してAI Agentを評価できるベンチマークTheAgentCompanyを提案。
既存のベンチマークより、多様で、実際のソフトウェアエンジニアリング企業でで起こりうる幅広いタスクを持ち、タスクの遂行のために同僚に対して何らかのインタラクションが必要で、達成のために多くのステップが必要でかつ個々のステップ(サブタスク)を評価可能で、多様なタスクを遂行するために必要な様々なインタフェースをカバーし、self hostingして結果を完全に再現可能なベンチマークとなっている模様。
(画像は著者ツイートより引用)
プロプライエタリなモデルとOpenWeightなモデルでAI Agentとしての能力を評価した結果、Claude-3.5-sonnetは約24%のタスクを解決可能であり、他モデルと比べて性能が明らかに良かった。また、Gemini-2.0-flashなコストパフォーマンスに優れている。OpenWeightなモデルの中ではLlama3.3-70Bのコストパフォーマンスが良かった。タスクとしては具体的に評価可能なタスクのみに焦点を当てており、Open Endなタスクでは評価していない点に注意とのこと。
まだまだAI Agentが完全に'同僚'として機能することとは現時点ではなさそうだが、このベンチマークのスコアが今後どこまで上がっていくだろうか。
openreview: https://openreview.net/forum?id=LZnKNApvhG
[Paper Note] LoRA Learns Less and Forgets Less, Dan Biderman+, TMLR'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #TMLR #Initial Impression Notes Issue Date: 2025-01-02 GPT Summary- LoRAは、大規模言語モデルの効率的なファインチューニング手法であり、重み行列に低ランクの摂動を学習させることでメモリを節約する。本研究では、プログラミングと数学のドメインにおいて、LoRAと完全なファインチューニングの性能を比較し、LoRAが標準的な設定で劣ることを示すが、ターゲットドメイン外のタスク性能を維持することに優れる。加えて、LoRAは忘却を抑制し、多様な生成を可能にすることが示された。最後に、完全なファインチューニングがLoRAよりも大きなランクの摂動を学習することにより性能差を説明できる可能性がある。LoRAのファインチューニングに関する最良の実践方法も提案されている。 Comment
元ポスト:
full finetuningとLoRAの性質の違いを理解するのに有用
[Paper Note] DeepSeek-V3 Technical Report, DeepSeek-AI+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #One-Line Notes #Reference Collection #MultiTokenPrediction Issue Date: 2024-12-28 GPT Summary- DeepSeek-V3は671Bのパラメータを持つMixture-of-Experts (MoE)言語モデルで、各トークンに対して37Bが活性化される。効率的な推論とコスト削減のため、MLAおよびDeepSeekMoEアーキテクチャを採用し、補助損失を用いない戦略を導入。14.8兆トークンでプレトレーニング後、ファインチューニングと強化学習を経て、高性能を発揮。評価結果はオープンソースモデルを上回り、先端的なクローズドソースモデルとも同等。訓練にはわずか2,788,000時間のH800 GPU時間を要し、安定した訓練プロセスを実現。モデルのチェックポイントは提供されている。 Comment
参考(モデルの図解):
参考:
MLA(Multi-Head Latent Attention)を提案
解説:
- MHA vs MQA vs GQA vs MLA, Zain ul Abideen, 2024.07
- DeepSeek-V2のアーキテクチャを徹底解説:MLA と DeepSeekMoE, kernelian, 2024.05
MLAはKVを低ランクなlatentベクトルに圧縮して保持し、使う時に復元するといった操作をすることで、MHAのパフォーマンスを落とすことなくKV Cacheで利用するメモリを大幅に減らせるという手法。
MLAの図解:
[Paper Note] Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference, Benjamin Warner+, arXiv'24, 2024.12
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #Library #Transformer #pretrained-LM #ACL #One-Line Notes #Reading Reflections Issue Date: 2024-12-20 GPT Summary- ModernBERTはエンコーダーのみのトランスフォーマーモデルで、BERTに対する大きなパレート改善を達成。2兆トークンで訓練され、長いシーケンスに対応しながら、分類タスクと検索において最先端の性能を示す。さらに、最も高速かつメモリ効率の良いエンコーダーとして設計されている。 Comment
最近の進化しまくったTransformer関連のアーキテクチャをEncodnr-OnlyモデルであるBERTに取り込んだら性能上がるし、BERTの方がコスパが良いタスクはたくさんあるよ、系の話、かつその実装だと思われる。
テクニカルペーパー中に記載はないが、評価データと同じタスクでのDecoder-Onlyモデル(SFT有り無し両方)との性能を比較したらどの程度の性能なのだろうか?
そもそも学習データが手元にあって、BERTをFinetuningするだけで十分な性能が出るのなら(BERTはGPU使うのでそもそもxgboostとかでも良いが)、わざわざLLM使う必要ないと思われる。BERTのFinetuningはそこまで時間はかからないし、inferenceも速い。
参考:
- [Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
日本語解説: https://zenn.dev/dev_commune/articles/3f5ab431abdea1?utm_source=substack&utm_medium=email
[Paper Note] When Benchmarks are Targets: Revealing the Sensitivity of Large Language Model Leaderboards, Norah Alzahrani+, ACL'24, 2024.02
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #ACL #read-later Issue Date: 2024-12-15 GPT Summary- LLMのリーダーボードは、ベンチマークランキングに基づいてモデル選択を支援するが、ランキングは微細な変更に敏感であり、最大8位変動することがある。3つのベンチマーク摂動のカテゴリにわたる実験を通じて、この現象の原因を特定し、ハイブリッドスコアリング方法の利点を含むベストプラクティスを提案。単純な評価に依存する危険性を強調し、より堅牢な評価スキームの必要性を示した。 Comment
- 国際会議ACL2024参加報告, Masato Mita, Cyber Agent, 2024.12
に日本語でのサマリが記載されているので参照のこと。
リーダーボードのバイアスを軽減した結果、どのLLMが最大パフォーマンスとみなされるようになったのだろうか?
[Paper Note] KTO: Model Alignment as Prospect Theoretic Optimization, Kawin Ethayarajh+, ICML'24, 2024.02
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Alignment #ICML #PostTraining #One-Line Notes Issue Date: 2024-10-27 GPT Summary- 人間の偏見を考慮したLLMのフィードバックを目的とした研究。プロスペクト理論に基づく「人間意識型損失(HALOs)」を用いて、生成物の効用を最大化する新手法KTOを提案。このアプローチは、既存の方法と比較してパフォーマンスが同等またはそれ以上であり、普遍的な最適損失関数は存在しないことを示唆。最適な損失は、設定に応じたバイアスによって異なる。 Comment
binaryフィードバックデータからLLMのアライメントをとるKahneman-Tversky Optimization (KTO)論文
解説(DPO,RLHFの話だがKTOを含まれている):
- RLHF/DPO 小話, 和地瞭良/ Akifumi Wachi, 2024.04
[Paper Note] Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Vision-Language Models, Matt Deitke+, arXiv'24, 2024.09
Paper/Blog Link My Issue
#ComputerVision #NLP #MultiModal #OpenWeight #OpenSource #VisionLanguageModel #One-Line Notes Issue Date: 2024-09-27 GPT Summary- Molmoは、オープンな視覚・言語モデル(VLM)ファミリーを提案し、高性能なVLM構築に必要な基盤知識の欠如を解消する。PixMoという新しいデータセットを収集し、詳細な画像キャプション、自由形式画像Q&A、2Dポインティングデータを含む。72Bモデルは、オープンウェイトモデルの中で最高性能を示し、特にClaude 3.5 SonnetやGemini 1.5 Proなどの独自モデルよりも優れ、学術ベンチマークでGPT-4oに次ぐ第2位となった。モデルの重みやデータセットは公開中。 Comment
dataset, training code, inference, weight, recipe, 全てがオープンなVLM(OlmoのVLM版)。
以下がベンチマーク結果(VLMのベンチマーク)。11 benchmarksと書かれているのは、VLMのベンチマークである点に注意。
当時のVLMは全てプロプライエタリモデルであり、どのようにすればSoTA性能に到達できるかは不明であったが、Molmoによって明らかになった(と認識している)。
[Paper Note] To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning, Zayne Sprague+, arXiv'24, 2024.09
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #Chain-of-Thought #read-later #KeyPoint Notes Issue Date: 2024-09-24 GPT Summary- CoTはLLMからの推論能力を引き出す標準手法だが、どのタスクで効果があるかを分析。100件以上の論文を対象にメタ分析を行い、14モデルと20データセットの評価を実施。結果、CoTは数理・論理タスクで性能向上をもたらすが、他のタスクでは効果が小さい。特に、等号を含む場合はCoTと同等の精度が得られ、記号的実行の改善に起因するものの、記号的ソルバーには劣る。CoTの選択的適用で推論コストを削減できることを示し、今後は中間計算を効果的に活用する新しいパラダイムが必要とされる。 Comment
CoTを100個以上の先行研究でmeta-analysisし(i.e. CoTを追加した場合のgainとタスクのプロット)、20個超えるデータセットで著者らが実験した結果、mathやsymbolic reasoning(12*4のように、シンボルを認識し、何らかの操作をして回答をする問題)が必要なタスクで、CoTは大きなgainが得られることがわかった(他はほとんどgainがない)。
openreview:
https://openreview.net/forum?id=w6nlcS8Kkn
metareviewによると、controlled experimentsを通じて、CoTの効果の大部分はPlanningではなく、信頼性の高い"実行"にあることが明らかになったとのこと。
下図を見るとこの時期はOpenAI o1やDeepSeek-R1の登場前であり、基本的にnon-thinking/reasoning modelによって実験がされていることには注意されたい。だが、昨今のAI AgentやReasoning Modelの挙動を鑑みるに、metareviewに記述されているCoTによって信頼性の高い"実行"が強化される点については実感できる。
[Paper Note] When Can LLMs Actually Correct Their Own Mistakes? A Critical Survey of Self-Correction of LLMs, Ryo Kamoi+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #SelfCorrection #TACL #One-Line Notes Issue Date: 2024-09-16 GPT Summary- 自己修正はLLMを活用し応答の質を向上させる手法です。しかし、LLMがどのように過ちを修正できるかに関しては合意がなく、従来の研究は多くの問題を抱えています。本研究では、先行研究の批判的レビューを行い、成功する自己修正に必要な条件を議論しています。研究課題の分類と実験設計のチェックリストを提供し、(1)プロンプトを用いた成功事例がないこと、(2)信頼できる外部フィードバックを活用すれば自己修正が機能すること、(3)大規模なファインチューニングが自己修正を支援することを示しています。 Comment
LLMのself-correctionに関するサーベイ
ReFT: Reasoning with Reinforced Fine-Tuning, Trung Quoc Luong+, N_A, ACL'24
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Chain-of-Thought #PostTraining #read-later Issue Date: 2024-09-13 GPT Summary- 強化ファインチューニング(ReFT)を提案し、LLMsの推論能力を向上。SFTでモデルをウォームアップ後、PPOアルゴリズムを用いてオンライン強化学習を行い、豊富な推論パスを自動サンプリング。GSM8K、MathQA、SVAMPデータセットでSFTを大幅に上回る性能を示し、追加のトレーニング質問に依存せず優れた一般化能力を発揮。
[Paper Note] Generative Verifiers: Reward Modeling as Next-Token Prediction, Lunjun Zhang+, arXiv'24, 2024.08
Paper/Blog Link My Issue
#NLP #LanguageModel #SelfCorrection #NeurIPS #Verification #RewardModel #Workshop #KeyPoint Notes #GenerativeVerifier Issue Date: 2024-09-11 GPT Summary- 検証モデルはLLMの推論性能を向上させるためによく使われ、従来のBest-of-N法に依存していますが、新たに提案された生成的検証モデル(GenRM)は、解の生成と検証を統合することで、LLMの利点を活かすことができます。GenRMは通常の識別的モデルと比較して優れた性能を発揮し、アルゴリズム課題や数学問題で大幅な改善を見せています。具体的には、GSM8Kで73%から93.4%への向上など、多様なタスクで性能を向上させ、モデルサイズと計算の増加にもしっかり対応します。 Comment
LLMがリクエストに対する回答を生成したのちに、その回答をverifyするステップ + verifyの結果から回答を修正するステップを全てconcatした学習データをnext token predictionで用いることによって、モデル自身に自分の回答をverifyする能力を身につけさせることができた結果性能が向上しました、という研究らしい。また、Self-consistency [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
のように複数の異なるCoTを並列して実行させ、そのmajority votingをとることでさらに性能が向上する。
openreview: https://openreview.net/forum?id=CxHRoTLmPX
[Paper Note] Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?, Zorik Gekhman+, EMNLP'24, 2024.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #Hallucination #PostTraining #KeyPoint Notes Issue Date: 2024-09-01 GPT Summary- ファインチューニングによる新しい知識の導入が、大規模言語モデルの既存知識の活用能力に与える影響を調査。新しい知識を含むファインチューニング例は学習が遅く、モデルのハルシネーションを増加させることが明らかに。結果として、新たな知識導入のリスクを浮き彫りにし、モデルは主に事前学習から知識を獲得するが、ファインチューニングはその活用方法を教えることが示唆される。 Comment
pre-training時に獲得されていない情報を用いてLLMのalignmentを実施すると、知識がない状態で学習データを正しく予測できるように学習されてしまうため、事実に基づかない回答をする(つまりhallucination)ように学習されてしまう、といったことを調査している模様。
>新しい知識を導入するファインチューニング例は、モデルの知識と一致する例よりもはるかに遅く学習されます。しかし、新しい知識を持つ例が最終的に学習されるにつれて、モデルの幻覚する傾向が線形に増加することも発見しました。
早々にoverfittingしている。
>大規模言語モデルは主に事前学習を通じて事実知識を取得し、ファインチューニングはそれをより効率的に使用することを教えるという見解を支持しています。
なるほど、興味深い。
大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
記載の資料([大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06, p. 36](大規模言語モデル (LLM) の技術と最新動向))に本論文の解説が記述されている。
- 大規模言語モデル (LLM) の技術と最新動向, Ikuya Yamada, 2024.06
本論文中では、full finetuningによる検証を実施しており、LoRAのようなAdapterを用いたテクニックで検証はされていない。LoRAではもともとのLLMのパラメータはfreezeされるため、異なる挙動となる可能性がある。特にLoRAが新しい知識を獲得可能なことが示されれば、LoRA AdapterをもともとのLLMに付け替えるだけで、異なる知識を持ったLLMを運用可能になるため、インパクトが大きいと考えられる。もともとこういった思想は LoRA Hubを提唱する研究などの頃からあった気がするが、AdapterによってHallucination/overfittingを防ぎながら、新たな知識を獲得できることを示した研究はあるのだろうか?
参考:
LoRAの場合については
- [Paper Note] LoRA Learns Less and Forgets Less, Dan Biderman+, TMLR'24, 2024.05
- [Paper Note] Beyond Full Fine-tuning: Harnessing the Power of LoRA for Multi-Task Instruction Tuning, Xin+, LREC-COLING'24
も参照のこと。
[Paper Note] LLM-jp: A Cross-organizational Project for the Research and Development of Fully Open Japanese LLMs, LLM-jp+, arXiv'24, 2024.07
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Alignment #Evaluation #OpenWeight #Safety #Japanese #OpenSource #mid-training #PostTraining #One-Line Notes #needs-revision Issue Date: 2024-07-10 GPT Summary- 日本語のLLMを開発するプロジェクト「LLM-jp」を紹介。1,500人以上が参加し、オープンソースの高性能モデルを目指す。設立背景、活動概要、および技術報告を示し、最新情報は公式サイトで確認可能。 Comment
llm.jpによるテクニカルレポート
[Paper Note] Instruction Pre-Training: Language Models are Supervised Multitask Learners, Daixuan Cheng+, arXiv'24, 2024.06
Paper/Blog Link My Issue
#Pretraining #LanguageModel #InstructionTuning #EMNLP #read-later #needs-revision Issue Date: 2024-07-08 GPT Summary- 教師なしのマルチタスク事前学習は成功の要因だが、監督付きの可能性も高い。本研究ではInstruction Pre-Trainingを提案し、大規模な指示-応答ペアを用いて言語モデルの前処理を行う。この手法により、40以上のタスクで2億のペアを合成し、その効果を示した。Instruction Pre-Trainingは、基盤モデルの性能を向上させ、追加の指示調整からも利益を得ることができ、Llama3-8BをLlama3-70Bに匹敵する性能へと引き上げた。モデルとデータは公開されている。 Comment
参考:
[Paper Note] How Do Large Language Models Acquire Factual Knowledge During Pretraining?, Hoyeon Chang+, NeurIPS'24, 2024.06
Paper/Blog Link My Issue
#Analysis #Pretraining #NLP #Dataset #LanguageModel #NeurIPS #FactualKnowledge #reading #One-Line Notes Issue Date: 2024-06-19 GPT Summary- LLMは事前学習中に事実知識を獲得する仕組みに関する理解が限られている。本研究ではそのギャップを埋め、事実知識獲得のダイナミクスを解明。データ量の増加が必ずしも知識の獲得を改善しないこと、訓練ステップ数と忘却の関係、バッチサイズが忘却の頑健性に与える影響を発見。知識獲得はデータに提示される確率を高めることで進行するが、忘却により希薄化する。これにより、低パフォーマンスの理由や重複排除の利点を説明できる。 Comment
所見:
- より多くのdata exposureは迅速な知識獲得を促進するが、factual knowledgeの保持には有意に寄与しない(忘却していくため)
- より大きなバッチサイズとdeduplicatedされた学習データがfactual knowledgeの保持に寄与する
- 学習ステップとRetainability[^1]はべき乗則の関係にある。すなわち、Retainabilityは、log(学習ステップ)に対して線形に低下する。
[^1]:知識をN回注入し、知識を答えるcloze taskの対数尤度を計り、注入前からの上昇幅によって知識獲得を定量化。Retainabilityは、N回注入する過程での上昇幅のピークを記録し、tステップ後に上昇幅のピークに対して、現在の対数尤度がどれだけの割合残っているか、で定義される。
[Paper Note] Compression Represents Intelligence Linearly, Yuzhen Huang+, arXiv'24, 2024.04
Paper/Blog Link My Issue
#Analysis #Pretraining #LanguageModel #Evaluation #COLM #One-Line Notes #DownstreamTasks Issue Date: 2024-04-17 GPT Summary- LLMsが知性を反映するかを圧縮の観点から検討。知性を下流ベンチマークのスコアで評価し、31の公開LLMを分析したところ、圧縮能力と知性にほぼ線形の相関があることが判明。これにより、より優れた圧縮が高い知性を示すという仮説が支持され、圧縮効率が信頼性のある評価指標として機能する可能性が示された。圧縮データセットはオープンソース化され、今後の研究に貢献することが期待される。 Comment
参考:
openreview: https://openreview.net/forum?id=SHMj84U5SH
external corpora (≠学習データ)で測定したモデルのBit Per Character (BPC) とdownstreamタスクのベンチマークスコアは、全体で平均で見ても、個別のドメインでみても、linearに相関する。
[Paper Note] OLMo: Accelerating the Science of Language Models, Dirk Groeneveld+, arXiv'24, 2024.02
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #OpenSource #One-Line Notes Issue Date: 2024-03-05 GPT Summary- OLMoは、市場での商業的重要性が高まる中、真にオープンな言語モデルを提供することでNLP研究の進展を目指す。従来のモデルが重みや推論コードのみを公開するのに対し、OLMoはトレーニングデータや評価コードも含めて公開し、科学的研究の基盤を確立することで、オープンな研究コミュニティの力を引き出し、新たなイノベーションを促進することを期待している。 Comment
Model Weightsを公開するだけでなく、training/evaluation codeとそのデータも公開する真にOpenな言語モデル(truly Open Language Model)。AllenAI
MM-LLMs: Recent Advances in MultiModal Large Language Models, Duzhen Zhang+, N_A, ACL'24 Findings
Paper/Blog Link My Issue
#Survey #LanguageModel #MultiModal #ACL #KeyPoint Notes Issue Date: 2024-01-25 GPT Summary- MM-LLMsは、コスト効果の高いトレーニング戦略を用いて拡張され、多様なMMタスクに対応する能力を持つことが示されている。本論文では、MM-LLMsのアーキテクチャ、トレーニング手法、ベンチマークのパフォーマンスなどについて調査し、その進歩に貢献することを目指している。 Comment
以下、論文を斜め読みしながら、ChatGPTを通じて疑問点を解消しつつ理解した内容なので、理解が不十分な点が含まれている可能性があるので注意。
# 概要
まあざっくり言うと、マルチモーダルを理解できるLLMを作りたかったら、様々なモダリティをエンコーディングして得られる表現と、既存のLLMが内部的に処理可能な表現を対応づける Input Projectorという名の関数を学習すればいいだけだよ(モダリティのエンコーダ、LLMは事前学習されたものをそのままfreezeして使えば良い)。
マルチモーダルを生成できるLLMを作りたかったら、LLMがテキストを生成するだけでなく、様々なモダリティに対応する表現も追加で出力するようにして、その出力を各モダリティを生成できるモデルに入力できるように変換するOutput Projectortという名の関数を学習しようね、ということだと思われる。
## ポイント
- Modality Encoder, LLM Backbone、およびModality Generatorは一般的にはパラメータをfreezeする
- optimizationの対象は「Input/Output Projector」
## Modality Encoder
様々なモダリティI_Xを、特徴量F_Xに変換する。これはまあ、色々なモデルがある。
## Input Projector
モダリティI_Xとそれに対応するテキストtのデータ {I_X, t}が与えられたとき、テキストtを埋め込み表現に変換んした結果得られる特徴量がF_Tである。Input Projectorは、F_XをLLMのinputとして利用する際に最適な特徴量P_Xに変換するθX_Tを学習することである。これは、LLM(P_X, F_T)によってテキストtがどれだけ生成できたか、を表現する損失関数を最小化することによって学習される。
## LLM Backbone
LLMによってテキスト列tと、各モダリティに対応した表現であるS_Xを生成する。outputからt, S_Xをどのように区別するかはモデルの構造などにもよるが、たとえば異なるヘッドを用意して、t, S_Xを区別するといったことは可能であろうと思われる。
## Output Projector
S_XをModality Generatorが解釈可能な特徴量H_Xに変換する関数のことである。これは学習しなければならない。
H_XとModality Generatorのtextual encoderにtを入力した際に得られる表現τX(t)が近くなるようにOutput Projector θ_T_Xを学習する。これによって、S_XとModality Generatorがalignするようにする。
## Modality Generator
各ModalityをH_Xから生成できるように下記のような損失学習する。要は、生成されたモダリティデータ(または表現)が実際のデータにどれだけ近いか、を表しているらしい。具体的には、サンプリングによって得られたノイズと、モデルが推定したノイズの値がどれだけ近いかを測る、みたいなことをしているらしい。
Multi Modalを理解するモデルだけであれば、Input Projectorの損失のみが学習され、生成までするのであれば、Input/Output Projector, Modality Generatorそれぞれに示した損失関数を通じてパラメータが学習される。あと、P_XやらS_Xはいわゆるsoft-promptingみたいなものであると考えられる。
[Paper Note] Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models, Zixiang Chen+, ICML'24, 2024.01
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #SyntheticData #SelfImprovement #ICML #mid-training #PostTraining #read-later #KeyPoint Notes #AdversarialTraining #SelfPlay Issue Date: 2024-01-24 GPT Summary- 自己対戦ファインチューニング(SPIN)を提案し、人間の注釈なしで弱いLLMを強化。LLMが自らのインスタンスと対戦し、トレーニングデータを生成。自己生成と人間の応答を識別してポリシーを微調整。SPINは様々なベンチマークでLLMの性能を大幅に向上させ、GPT-4優先データを使ったモデルを上回る成果を示した。 Comment
pj page:
https://uclaml.github.io/SPIN/
code:
https://github.com/uclaml/SPIN
メインプレイヤーは人間とLLMのレスポンスを区別する、対戦相手はメインプレイヤーに対して人間が作成したレスポンスと自身が作成させたレスポンスを区別できないようにするようなゲームをし、両者を同じLLM、しかし異なるiterationのパラメータを採用することで自己対戦させることでSFTデータセットから最大限学習するような手法を提案。メインプレイヤーの目的関数は、人間とLLMのレスポンスの確率の差を最大化するように定式化され(式4.1)、対戦相手は人間が生成したレスポンスを最大化するような損失関数を元のパラメータから大きく乖離しないようにKL正則化付きで定義する(式4.3)。双方の損失を単一の損失関数に統合すると式4.7で表される提案手法のSPIN損失が得られ、これによって与えられたSFTデータに対してレスポンスを各iterationで合成し、合成したレスポンスに対してSPIN損失を適用することでモデルのパラメータをアップデートする。メインプレイヤーの重みは更新された重みを用いて、対戦プレイヤーの重みは一つ前の重みを用いる。
[Paper Note] Self-Rewarding Language Models, Weizhe Yuan+, arXiv'24, 2024.01
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #InstructionTuning #LLM-as-a-Judge #SelfImprovement #ICML #KeyPoint Notes Issue Date: 2024-01-22 GPT Summary- 超人間エージェントを実現するには、超人間レベルのフィードバックが必要であると提唱。現在のアプローチは人間の嗜好から報酬モデルを訓練するが、これがボトルネックになりがちである。本研究では自己報酬言語モデルを用い、LLMが自ら報酬を提供する方法を検討。DPOトレーニングにより指示への従順さと自己報酬の質が向上し、Llama 2 70Bをファインチューニングすることで、既存モデルを上回ることが示された。探索の余地は残るが、本研究は改善の可能性を示唆する。 Comment
人間の介入無しで(人間がアノテーションしたpreference data無しで)LLMのAlignmentを改善していく手法。LLM-as-a-Judge Promptingを用いて、LLM自身にpolicy modelとreward modelの役割の両方をさせる。unlabeledなpromptに対してpolicy modelとしてresponceを生成させた後、生成したレスポンスをreward modelとしてランキング付けし、DPOのpreference pairとして利用する、という操作を繰り返す。
[Paper Note] Unified-IO 2: Scaling Autoregressive Multimodal Models with Vision, Language, Audio, and Action, Jiasen Lu+, CVPR'24, 2023.12
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #Transformer #InstructionTuning #MultiModal #SpeechProcessing #CVPR #Encoder-Decoder #Robotics #UMM #EmbodiedAI #KeyPoint Notes #Surface-level Notes Issue Date: 2023-12-29 GPT Summary- 初の自己回帰型マルチモーダルモデル「Unified-IO 2」を提案し、画像、テキスト、音声、アクションを統一した意味空間で処理。トレーニングの安定化のためにアーキテクチャを改善し、120のデータセットで微調整を行い、GRITベンチマークで最先端のパフォーマンスを達成。35以上のベンチマークにおいて強力な結果を示し、すべてのモデルを公開。 Comment
画像、テキスト、音声、アクションを理解できる初めてのautoregressive model。AllenAI
モデルのアーキテクチャ図
マルチモーダルに拡張したことで、訓練が非常に不安定になったため、アーキテクチャ上でいくつかの工夫を加えている:
- 2D Rotary Embedding
- Positional EncodingとしてRoPEを採用
- 画像のような2次元データのモダリティの場合はRoPEを2次元に拡張する。具体的には、位置(i, j)のトークンについては、Q, Kのembeddingを半分に分割して、それぞれに対して独立にi, jのRoPE Embeddingを適用することでi, j双方の情報を組み込む。
- QK Normalization
- image, audioのモダリティを組み込むことでMHAのlogitsが非常に大きくなりatteetion weightが0/1の極端な値をとるようになり訓練の不安定さにつながった。このため、dot product attentionを適用する前にLayerNormを組み込んだ。
- Scaled Cosine Attention
- Image Historyモダリティにおいて固定長のEmbeddingを得るためにPerceiver Resamplerを扱ったているが、こちらも上記と同様にAttentionのlogitsが極端に大きくなったため、cosine類似度をベースとしたScaled Cosine Attention [Paper Note] Swin Transformer V2: Scaling Up Capacity and Resolution, Ze Liu+, arXiv'21
を利用することで、大幅に訓練の安定性が改善された。
- その他
- attention logitsにはfp32を適用
- 事前学習されたViTとASTを同時に更新すると不安定につながったため、事前学習の段階ではfreezeし、instruction tuningの最後にfinetuningを実施
目的関数としては、Mixture of Denoisers (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)に着想を得て、Multimodal Mixture of Denoisersを提案。MoDでは、
- \[R\]: 通常のspan corruption (1--5 token程度のspanをmaskする)
- \[S\]: causal language modeling (inputを2つのサブシーケンスに分割し、前方から後方を予測する。前方部分はBi-directionalでも可)
- \[X\]: extreme span corruption (12>=token程度のspanをmaskする)
の3種類が提案されており、モダリティごとにこれらを使い分ける:
- text modality: UL2 (UL2: Unifying Language Learning Paradigms, Yi Tay+, N/A, ICLR'23
)を踏襲
- image, audioがtargetの場合: 2つの類似したパラダイムを定義し利用
- \[R\]: patchをランダムにx%マスクしre-constructする
- \[S\]: inputのtargetとは異なるモダリティのみの情報から、targetモダリティを生成する
訓練時には prefixとしてmodality token \[Text\], \[Image\], \[Audio\] とparadigm token \[R\], \[S\], \[X\] をタスクを指示するトークンとして利用している。
また、image, audioのマスク部分のdenoisingをautoregressive modelで実施する際には普通にやるとdecoder側でリークが発生する(a)。これを防ぐには、Encoder側でマスクされているトークンを、Decoder側でteacher-forcingする際にの全てマスクする方法(b)があるが、この場合、生成タスクとdenoisingタスクが相互に干渉してしまいうまく学習できなくなってしまう(生成タスクでは通常Decoderのinputとして[mask]が入力され次トークンを生成する、といったことは起きえないが、愚直に(b)をやるとそうなってしまう)。ので、(c)に示したように、マスクされているトークンをinputとして生成しなければならない時だけ、マスクを解除してdecoder側にinputする、という方法 (Dynamic Masking) でこの問題に対処している。
VILA: On Pre-training for Visual Language Models, Ji Lin+, N_A, CVPR'24
Paper/Blog Link My Issue
#ComputerVision #Analysis #Pretraining #NLP #LanguageModel #CVPR #VisionLanguageModel Issue Date: 2023-12-14 GPT Summary- 最近の大規模言語モデルの成功により、ビジュアル言語モデル(VLM)が進歩している。本研究では、VLMの事前学習のためのデザインオプションを検討し、以下の結果を示した:(1) LLMを凍結することでゼロショットのパフォーマンスが達成できるが、文脈に基づいた学習能力が不足している。(2) 交互に行われる事前学習データは有益であり、画像とテキストのペアだけでは最適ではない。(3) テキストのみの指示データを画像とテキストのデータに再ブレンドすることで、VLMのタスクの精度を向上させることができる。VILAというビジュアル言語モデルファミリーを構築し、最先端モデルを凌駕し、優れたパフォーマンスを発揮することを示した。マルチモーダルの事前学習は、VILAの特性を向上させる。 Comment
関連:
- [Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
[Paper Note] Chain-of-Verification Reduces Hallucination in Large Language Models, Shehzaad Dhuliawala+, N_A, ACL'24
Paper/Blog Link My Issue
#NLP #LanguageModel #QuestionAnswering #Chain-of-Thought #Prompting #Hallucination #ACL #Verification Issue Date: 2023-09-30 GPT Summary- 私たちは、言語モデルが根拠のない情報を生成する問題に取り組んでいます。Chain-of-Verification(CoVe)メソッドを開発し、モデルが回答を作成し、検証し、最終的な回答を生成するプロセスを経ることで、幻想を減少させることができることを実験で示しました。 Comment
# 概要
ユーザの質問から、Verificationのための質問をplanningし、質問に対して独立に回答を得たうえでオリジナルの質問に対するaggreementを確認し、最終的に生成を実施するPrompting手法
# 評価
## dataset
- 全体を通じてclosed-bookの設定で評価
- Wikidata
- Wikipedia APIから自動生成した「“Who are some [Profession]s who were born in [City]?”」に対するQA pairs
- Goldはknowledge baseから取得
- 全56 test questions
- Gold Entityが大体600程度ありLLMは一部しか回答しないので、precisionで評価
- Wiki category list
- QUEST datasetを利用 [Paper Note] QUEST: A Retrieval Dataset of Entity-Seeking Queries with Implicit Set Operations, Chaitanya Malaviya+, arXiv'23, 2023.05
- 回答にlogical operationが不要なものに限定して頭に"Name some"をつけて質問を生成
- "Name some Mexican animated horror films" or "Name some Endemic orchids of Vietnam"
- 8個の回答を持つ55 test questionsを作成
- MultiSpanQA
- Reading Comprehensionに関するBenchmark dataset
- 複数の独立した回答(回答は連続しないスパンから回答が抽出される)から構成される質問で構成
- 特に、今回はclosed-book setting で実施
- すなわち、与えられた質問のみから回答しなければならず、知っている知識が問われる問題
- 418のtest questsionsで、各回答に含まれる複数アイテムのspanが3 token未満となるようにした
- QA例:
- Q: Who invented the first printing press and in what year?
- A: Johannes Gutenberg, 1450.
# 評価結果
提案手法には、verificationの各ステップでLLMに独立したpromptingをするかなどでjoint, 2-step, Factored, Factor+Revisedの4種類のバリエーションがあることに留意。
- joint: 全てのステップを一つのpromptで実施
- 2-stepは2つのpromptに分けて実施
- Factoredは各ステップを全て異なるpromptingで実施
- Factor+Revisedは異なるpromptで追加のQAに対するcross-checkをかける手法
結果を見ると、CoVEでhallucinationが軽減(というより、モデルが持つ知識に基づいて正確に回答できるサンプルの割合が増えるので実質的にhallucinationが低減したとみなせる)され、特にjointよりも2-step, factoredの方が高い性能を示すことがわかる。
[Paper Note] Large Language Models as Optimizers, Chengrun Yang+, ICLR'24, 2023.09
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #AutomaticPromptEngineering #ICLR #KeyPoint Notes #Reading Reflections Issue Date: 2023-09-09 GPT Summary- 最適化タスクを自然言語で記述するアプローチ、Optimization by PROmpting(OPRO)を提案。大規模言語モデル(LLMs)を用いて以前の解を基に新しい解を生成し、プロンプトに追加。線形回帰や巡回セールスマン問題での実証に続き、プロンプト最適化を行い、タスク精度を最大化。OPROで最適化されたプロンプトは、人間設計のものをGSM8Kで最大8%、Big-Bench Hardで最大50%上回ることを確認。 Comment
`Take a deep breath and work on this problem step-by-step. `論文
# 概要
LLMを利用して最適化問題を解くためのフレームワークを提案したという話。論文中では、linear regressionや巡回セールスマン問題に適用している。また、応用例としてPrompt Engineeringに利用している。
これにより、Prompt Engineeringが最適か問題に落とし込まれ、自動的なprompt engineeringによって、`Let's think step by step.` よりも良いプロンプトが見つかりましたという話。
# 手法概要
全体としての枠組み。meta-promptをinputとし、LLMがobjective functionに対するsolutionを生成する。生成されたsolutionとスコアがmeta-promptに代入され、次のoptimizationが走る。これを繰り返す。
Meta promptの例
openreview: https://openreview.net/forum?id=Bb4VGOWELI
テキスト空間上で過去の履歴とスコアが与えられ、それをgivenにスコアが良くなりそうなものをLLMがiterativeに生成していくことが可能なことが示されたのが興味深い
[Paper Note] Scaling Instruction-Finetuned Language Models, Hyung Won Chung+, JMLR'24, 2022.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #OpenWeight #One-Line Notes #Scalability #JMLR Issue Date: 2023-04-26 GPT Summary- 指示に基づくファインチューニングは、言語モデルの性能と一般化を向上させる。特に、タスク数やモデルサイズのスケーリング、チェーン・オブ・思考データでの適用が効果的。Flan‑PaLM 540Bは1,800件のタスクでファインチューニングを行い、PaLM 540Bを平均+9.4%上回り、最先端の結果を出している。Flan‑T5も強力なFew-shot性能を示し、指示に基づくファインチューニングがモデルの性能向上に寄与することを確認した。 Comment
T5をinstruction tuningしたFlanT5の研究
HF: https://huggingface.co/docs/transformers/model_doc/flan-t5
先行研究:
- [Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
[Paper Note] Contrastive Decoding: Open-ended Text Generation as Optimization, Xiang Lisa Li+, ACL'23, 2022.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Coherence #ACL #Decoding #reading #One-Line Notes Issue Date: 2026-10-02 GPT Summary- LMに対し、大規模LMと小規模LMの尤度差を用いて対照的目的関数を最適化する対照的デコーディング(CD)を提案。もっともらしさの制約により、反復や話題逸脱を抑え、一貫性の高いテキストを生成する。追加学習なしで、核サンプリングやtop-kなどの既存手法を上回る性能を達成。 Comment
事前学習済み言語モデルに対してサンプリングを行いテキストを生成するアプローチは、長いシーケンスとなるとエラーが蓄積し一貫性が欠如したり、トピックが逸脱する課題がある。一方、greedyにデコードをするとしばしば短く、多様性に乏しく、同じ語彙が反復的に出現するようなテキストが生成されてしまう。これに対して、本研究はContrastive Decodingと呼ばれる、一貫性を保ちながら、流暢で多様な語彙に基づく生成を可能とするデコーディング手法を提案している。
Contrastive Decodingでは、エキスパートとアマチュアモデルを用意し(前者は同じシリーズの大規模モデル、後者は小規模モデル)、エキスパートモデルが高い対数尤度を持つという制約のもと、エキスパートとアマチュアモデルの対数尤度の差が最大となるようなテキストを探索する。
言語モデルの典型的なfailure modeはエキスパートよりもアマチュアにおいてより表出しやすいため、対数尤度の差分を見ることで、エキスパートがアマチュアと比較してより高い確率質量を割り当てているトークン列を強調する。
Figure 1がContrastive Decodingの他のデコーディング手法に対する利点を説明した図であり、この例では1961が適切であるが、greedy、サンプリングベースな手法の欠点を説明している。すなわに、エキスパートモデルは直前に出現したトークン、HawaiiやHonoluluに高い確率質量を置いてしまうため、greedyにデコーディングするとそれらが出力され、反復的なテキストが生成される。一方、Washingtonのようなトークンがサンプリングされると、支離滅裂なテキストとなる。Contrastive Decodingでは、これら典型的なfailure modeが抑制され、エキスパートでより高い確率質量を割り当てる傾向が強くなるトークン、たとえばこの例であれば事実に基づく1961というトークンを強調したようなスコアを得ることができる。
[Paper Note] Function Vectors in Large Language Models, Eric Todd+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #ICLR #reading #KeyPoint Notes Issue Date: 2026-06-02 GPT Summary- 自己回帰型トランスフォーマーLMsにおける入力と出力の関数を表すベクトルとしてのファンクションベクトル(FV)の存在を示す。因果媒介分析を用いて、少数のアテンションヘッドがタスクのコンパクトな表現を伝達することを確認し、FVがゼロショットや自然言語テキストのICLタスクに対しても頑健であることを明らかにした。中間層間での因果効果が強いことが判明し、FVには出力空間を符号化する情報が含まれているが、これだけではFVの再構成は不可である。さらに、FVにおける意味ベクトルの組成を調査し、足し合わせることで新たなタスクを引き起こすことができることを示した。これにより、関数抽象のコンパクトで因果的な内部表現をLLMsから抽出できることが確認された。 Comment
openreview: https://openreview.net/forum?id=AwyxtyMwaG
本研究では、In-context Learningを実施した際のLLMにおいて、あるタスクにおいて応答を生成する際に、当該タスクで必要な変換に関する情報を保持しているベクトル(Function Vectors)が、LLMの attention_ output に存在することを示唆する結果を得た。Function Vectorsは直接的にタスクを実施するわけではないが、特定の手続きを言語モデル内で遂行させるトリガーの役割を果たす。
Function Vectorを検出するために、あるタスク t において、Figure 2のようなinput-outputのペア (x_i, y_i) のみで promptingをすることでタスクを遂行させる方法を考える。また、prompt p が与えられたときに、outputをランダムな出力~y_iに変更した input-outputペア (x_i, ~y_i) prompt ~pを考える。このとき、あるタスクの遂行に強い影響を与えるLLM中のactivationを特定したい。
このために、本研究ではトークンをまたいだ情報のやりとりはattentionを介して実行されることから、分析対象をattentionに限定し、まず正常な in-context prompt p を入力した際の全てのlayer l のattention output a_lj (jはheadのindex) を計算する。続いて、ランダムな出力に置換され破損した in-context prompt ~p を入力した際に、ある layer l, head j のattentionを正常なin-context prompt p に基づいて計算されたものと置換して出力をさせ、正解 y_i を復元させる効果 Causal Indrect Effect (CIE) を 式(3)により定義する。つまり、破損したprompt ~pを利用した場合に、attentionを置換する前後によって、どれだけ正解y_iが得られる確率が大きくなったか、を測定している。
このCIEを全てのタスクに対して計算し、平均化することで、各種attention headのAverage Indirect Effectを計算する(式4)。これにより、どのattention headがタスクの遂行において強い因果的な影響力を保持するかを特定する。最終的に、AIEの値が大きなattention head集合Aを考えることができ、この少数のattention headの集合が、ICLタスクを特定し情報を伝達する役割を果たしているという仮説を立てることができる。また、Aが与えられたとき、a_ljのあるタスク t におけるactivationの平均をとることによって、1つのベクトルとして表現することができ、このベクトルのことをFunction Vector と呼ぶ(式5)。
[Paper Note] Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling, Stella Biderman+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #OpenWeight #OpenSource #One-Line Notes Issue Date: 2026-03-29 GPT Summary- Pythiaは、異なるスケールの16のLLMを対象にしたモデルセットで、トレーニングの進化や発展を探求する。154のチェックポイントを公開し、訓練データローダーの再構築ツールも提供する。記憶化、新規結果、few-shot性能への語頻度の影響、ジェンダーバイアスの低減を含むケーススタディを通じて、LLMsの訓練ダイナミクスに関する新たな洞察を提示する。モデルや分析コードは公開されている。 Comment
github: https://github.com/EleutherAI/pythia
pythiaもメモっていなかった。70M--12Bモデルまでの16個のLLM群で、全てのモデルが同じ順序で学習され、かつ中間チェックポイントも公開。
[Paper Note] Set-of-Mark Prompting Unleashes Extraordinary Visual Grounding in GPT-4V, Jianwei Yang+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#ComputerVision #NLP #ImageSegmentation #VisionLanguageModel #One-Line Notes #Grounding Issue Date: 2025-11-25 GPT Summary- Set-of-Mark (SoM)という新しい視覚プロンプティング手法を提案し、GPT-4Vの視覚的能力を引き出す。画像を異なる領域に分割し、マークを重ねることで、視覚的基盤を必要とする質問に答えることが可能に。実験では、SoMを用いたGPT-4Vがゼロショット設定で最先端のモデルを上回る性能を示した。 Comment
pj page: https://som-gpt4v.github.io
日本語解説: https://ai-scholar.tech/articles/prompting-method/SoM
画像をsegmentationし、segmentationした領域上に数字のマーカーをオーバーレイした画像を入力すると、VLMのgrounding能力が向上する、という話らしい
[Paper Note] DetectGPT: Zero-Shot Machine-Generated Text Detection using Probability Curvature, Eric Mitchell+, ICML'23, 2023.01
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #ICML #text #AI Detector #Watermark Issue Date: 2025-11-17 GPT Summary- LLM生成テキストの検出の必要性を背景に、対数確率関数の負の曲率を利用した新しい検出手法「DetectGPT」を提案。これにより、別の分類器やデータセットを必要とせず、特定のLLMから生成されたテキストを高精度で識別可能。特に、GPT-NeoXによるフェイクニュース記事の検出で、従来の手法を大幅に上回る性能を示した。
[Paper Note] Robust Speech Recognition via Large-Scale Weak Supervision, Alec Radford+, ICML'23, 2022.12
Paper/Blog Link My Issue
#NeuralNetwork #Transformer #SpeechProcessing #AutomaticSpeechRecognition(ASR) #Generalization #KeyPoint Notes #Robustness Issue Date: 2025-11-14 GPT Summary- 680,000時間の多言語音声トランスクリプトを用いて訓練した音声処理システムを研究。得られたモデルは、ゼロショット転送設定で良好に一般化し、従来の監視結果と競争力を持つ。人間の精度に近づくことが確認され、モデルと推論コードを公開。 Comment
いまさらながらWhisper論文
日本語解説:
https://www.ai-shift.co.jp/techblog/3001
長文認識のためのヒューリスティックに基づくデコーディング戦略も解説されているので参照のこと。
研究のコアとなるアイデアとしては、既存研究は自己教師あり学習、あるいはself-learningによって性能向上を目指す流れがある中で、教師あり学習に着目。既存研究で教師あり学習によって性能が向上することが示されていたが、大規模なスケールで実施できていなかったため、それをweakly-supervisedなmanner(=つまり完璧なラベルではなくてノイジーでも良いからラベルを付与し学習する)といった方法で学習することで、より頑健で高性能なASRを実現したい、という気持ちの研究。また、複雑なサブタスク(language identification, inverse text normalization(ASR後のテキストを人間向けの自然なテキストに変換すること[^2]), phrase-level timestamps (audioとtranscriptのタイムスタンプ予測))を一つのパイプラインで実現するような統合的なインタフェースも提案している。モデルのアーキテクチャ自体はencoder-decoderモデルである。また、positional encodingとしてはSinusoidal Positional Encoding(すなわち、絶対位置エンコーディング)が用いられている。デコーダにはprompt[^1]と呼ばれるtranscriptのhistoryを(確率的に挿入し)入力して学習することで、過去のcontextを考慮したASRが可能となる。lossの計算は、translate/transcribeされたトークンのみを考慮して計算する。
データセットについては詳細は記述されておらず、internetに存在する (audio, transcripts)のペアデータを用いたと書かれている。
しかしながら、収集したデータセットを確認んすると、transcriptionの品質が低いものが混ざっており、フィルタリングを実施している。これは、人間のtranscriptionとmachine-generatedなtranscriptionをmixして学習すると性能を損なうことが既存研究で知られているため、ヒューリスティックに基づいてmachine-generatedなtranscriptionは学習データから除外している。これは、初期のモデルを学習してエラー率を観測し、データソースを人手でチェックしてlow-qualityなtranscriptを除去するといった丁寧なプロセスもあ含まれる。
また、収集したデータの言語についてはVoxLingua107データセット [Paper Note] VoxLingua107: a Dataset for Spoken Language Recognition, Jörgen Valk+, SLT'21, 2020.11
によって学習された分類器(をさらにfinetuningしたモデルと書かれている。詳細は不明)によって自動的に付与する。すなわち、X->enのデータのX(つまりsource言語)のlanguage identificationについてもweakly-supervisedなラベルで学習されている。
audioファイルについては、30秒単位のセグメントに区切り全ての期間を学習データに利用。無音部分はサブサンプリング(=一部をサンプリングして使う)しVoice Activity Detectionも学習する。
[^1]: LLMの文脈で広く使われるPromptとは異なる点に注意。LLMはinstruction-tuningが実施されているため人間の指示に追従するような挙動となるが、Whisperではinstruction-tuningを実施していないのでそのような挙動にはならない。あくまで過去のhistoryの情報を与える役割と考えること。
[^2]: Whisperでは生のtranscriptをnormalizationせずに学習にそのまま利用するため書き起こしの表記の統一は行われないと考えられる。
[Paper Note] Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow, Xingchao Liu+, ICLR'23, 2022.09
Paper/Blog Link My Issue
#ComputerVision #MachineLearning #ICLR #RectifiedFlow Issue Date: 2025-10-10 GPT Summary- rectified flowという新しいアプローチを提案し、2つの分布間での輸送を学習するODEモデルを用いる。これは、直線的な経路を学習することで計算効率を高め、生成モデルやドメイン転送において統一的な解決策を提供する。rectificationを通じて、非増加の凸輸送コストを持つ新しい結合を生成し、再帰的に適用することで直線的なフローを得る。実証研究では、画像生成や翻訳において優れた性能を示し、高品質な結果を得ることが確認された。 Comment
openreview: https://openreview.net/forum?id=XVjTT1nw5z
日本語解説(fmuuly, zenn):
- Rectified Flow 1:
https://zenn.dev/fmuuly/articles/37cc3a2f17138e
- Rectified Flow 2:
https://zenn.dev/fmuuly/articles/a062fcd340207f
- Rectified Flow 3:
https://zenn.dev/fmuuly/articles/0f262fc003e202
[Paper Note] SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models, Potsawee Manakul+, EMNLP'23, 2023.03
Paper/Blog Link My Issue
#NLP #LanguageModel #Hallucination #EMNLP Issue Date: 2025-09-24 GPT Summary- SelfCheckGPTは、外部データベースなしでLLMの応答をファクトチェックするためのサンプリングベースのアプローチを提案。サンプリングされた応答が一貫した事実を含む場合、知識があると判断し、幻覚された事実では矛盾が生じる可能性が高い。実験により、非事実的および事実的な文の検出、文章のランク付けが可能であることを示し、高いAUC-PRスコアと相関スコアを達成。 Comment
openreview: https://openreview.net/forum?id=RwzFNbJ3Ez
[Paper Note] GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment, Dhruba Ghosh+, NeurIPS'23
Paper/Blog Link My Issue
#ComputerVision #NLP #Dataset #Evaluation #TextToImageGeneration #NeurIPS #read-later Issue Date: 2025-09-11 GPT Summary- テキストから画像への生成モデルの自動評価方法「GenEval」を提案。物体の共起、位置、数、色などの特性を評価し、現在の物体検出モデルを活用して生成タスクを分析。最近のモデルは改善を示すが、複雑な能力には課題が残る。GenEvalは失敗モードの発見にも寄与し、次世代モデルの開発に役立つ。コードは公開中。 Comment
openreview: https://openreview.net/forum?id=Wbr51vK331¬eId=NpvYJlJFqK
[Paper Note] Scalable Diffusion Models with Transformers, William Peebles+, ICCV'23
Paper/Blog Link My Issue
#ComputerVision #Transformer #DiffusionModel #read-later #Backbone Issue Date: 2025-08-27 GPT Summary- 新しいトランスフォーマーに基づく拡散モデル(Diffusion Transformers, DiTs)を提案し、U-Netをトランスフォーマーに置き換えた。DiTsは高いGflopsを持ち、低いFIDを維持しながら良好なスケーラビリティを示す。最大のDiT-XL/2モデルは、ImageNetのベンチマークで従来の拡散モデルを上回り、最先端のFID 2.27を達成した。 Comment
日本語解説: https://qiita.com/sasgawy/items/8546c784bc94d94ef0b2
よく見るDiT
- [Paper Note] DiT: Self-supervised Pre-training for Document Image Transformer, Junlong Li+, ACMMM'22
も同様の呼称だが全く異なる話なので注意
[Paper Note] Efficient Memory Management for Large Language Model Serving with PagedAttention, Woosuk Kwon+, SOSP'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Transformer #Attention #python #LLMServing Issue Date: 2025-08-19 GPT Summary- PagedAttentionを用いたvLLMシステムを提案し、KVキャッシュメモリの無駄を削減し、リクエスト間での柔軟な共有を実現。これにより、同レベルのレイテンシでLLMのスループットを2-4倍向上。特に長いシーケンスや大規模モデルで効果が顕著。ソースコードは公開中。 Comment
(今更ながら)vLLMはこちら:
https://github.com/vllm-project/vllm
現在の主要なLLM Inference/Serving Engineのひとつ。
[Paper Note] Recommender Systems with Generative Retrieval, Shashank Rajput+, NeurIPS'23
Paper/Blog Link My Issue
#RecommenderSystems #Transformer #VariationalAutoEncoder #NeurIPS #read-later #ColdStart #Encoder-Decoder #SemanticID Issue Date: 2025-07-28 GPT Summary- 新しい生成的検索アプローチを提案し、アイテムのセマンティックIDを用いて次のアイテムを予測するTransformerベースのモデルを訓練。これにより、従来のレコメンダーシステムを大幅に上回る性能を達成し、過去の対話履歴がないアイテムに対しても改善された検索性能を示す。 Comment
openreview: https://openreview.net/forum?id=BJ0fQUU32w
Semantic IDを提案した研究
アイテムを意味的な情報を保持したdiscrete tokenのタプル(=Semantic ID)で表現し、encoder-decoderでNext ItemのSemantic IDを生成するタスクに落としこむことで推薦する。SemanticIDの作成方法は後で読んで理解したい。
[Paper Note] Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture, Mahmoud Assran+, CVPR'23, 2023.01
Paper/Blog Link My Issue
#ComputerVision #Pretraining #RepresentationLearning #Transformer #Self-SupervisedLearning #CVPR #read-later #WorldModels #One-Line Notes #LatentRepresentation Issue Date: 2025-07-24 GPT Summary- 本論文では、手作りのデータ拡張に依存せずに意味的な画像表現を学習するI-JEPAという自己教師あり学習アプローチを提案。I-JEPAは、単一のコンテキストブロックから異なるターゲットブロックの表現を予測する。重要な設計選択として、意味的に大きなターゲットブロックと情報量の多いコンテキストブロックのサンプリングが挙げられる。実験により、I-JEPAはVision Transformersと組み合わせることでスケーラブルであり、ImageNet上で強力な下流性能を達成した。 Comment
Joint-Embedding Predictive Architecture (JEPA)を提案した研究。ピクセルやトークンのreconstruction lossではなく、潜在表現を再構成するようなself-supervised learningによってより意味的な特徴を学習するように誘導するもの(と思われるがこれが本質的な理解として正しいかは自信がない)。
[Paper Note] Flow Matching for Generative Modeling, Yaron Lipman+, ICLR'23
Paper/Blog Link My Issue
#ComputerVision #DiffusionModel #ICLR #FlowMatching #OptimalTransport Issue Date: 2025-07-09 GPT Summary- Continuous Normalizing Flows(CNFs)に基づく新しい生成モデルの訓練手法Flow Matching(FM)を提案。FMは固定された条件付き確率経路のベクトル場を回帰し、シミュレーション不要で訓練可能。拡散経路と併用することで、より堅牢な訓練が実現。最適輸送を用いた条件付き確率経路は効率的で、訓練とサンプリングが速く、一般化性能も向上。ImageNetでの実験により、FMは拡散ベース手法よりも優れた性能を示し、迅速なサンプル生成を可能にする。 Comment
[Paper Note] Sigmoid Loss for Language Image Pre-Training, Xiaohua Zhai+, ICCV'23
Paper/Blog Link My Issue
#ComputerVision #Pretraining #LanguageModel #MultiModal #ContrastiveLearning #ICCV #Scalability #needs-revision Issue Date: 2025-06-29 GPT Summary- シンプルなペアワイズシグモイド損失(SigLIP)を提案し、画像-テキストペアに基づく言語-画像事前学習を改善。シグモイド損失はバッチサイズの拡大を可能にし、小さなバッチサイズでも性能向上を実現。SigLiTモデルは84.5%のImageNetゼロショット精度を達成。バッチサイズの影響を研究し、32kが合理的なサイズであることを確認。モデルは公開され、さらなる研究の促進を期待。 Comment
SigLIP論文
[Paper Note] SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills, Amey Agrawal+, arXiv'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #python #LLMServing #SoftwareEngineering #read-later #Inference #One-Line Notes Issue Date: 2025-06-12 GPT Summary- SARATHIは、LLMの推論効率を向上させる手法で、プレフィルリクエストをチャンクに分割し、デコードマキシマルバッチを構築することで計算利用率を最大化します。これにより、デコードスループットを最大10倍向上させ、エンドツーエンドスループットも改善。特に、A6000 GPU上のLLaMA-13Bモデルで顕著な性能向上を示し、パイプラインバブルを大幅に削減しました。 Comment
vLLMでも採用されている `Chunked Prefills` と `Decode-Maximal Batching` を提案している。

[Paper Note] Sequence Parallelism: Long Sequence Training from System Perspective, Shenggui Li+, ACL'23, 2021.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #LongContext #ACL #Parallelism #One-Line Notes Issue Date: 2025-05-16 GPT Summary- 本研究では、トランスフォーマーの長い入力シーケンスを効率的に学習するための新しいメモリ効率の良い「シーケンス並列性」手法を提案。これは、既存の並列化手法との互換性を持ち、長大なシーケンスを複数のGPUに分散して処理することを可能にする。リング型通信を用いた自己注意計算(Ring Self-Attention)を導入し、実験によりバッチサイズとシーケンス長のスケーリング効果を示した。最大バッチサイズは13.7倍、シーケンス長は114,000トークンを超える性能を達成。 Comment
入力系列をチャンクに分割して、デバイスごとに担当するチャンクを決めることで原理上無限の長さの系列を扱えるようにした並列化手法。系列をデバイス間で横断する場合attention scoreをどのように計算するかが課題になるが、そのためにRing Self attentionと呼ばれるアルゴリズムを提案している模様。また、MLPブロックとMulti Head Attentonブロックの計算も、BatchSize * Sequence Lengthの大きさが、それぞれ32*Hidden Size, 16*Attention Head size *
# of Attention Headよりも大きくなった場合に、Tensor Parallelismよりもメモリ効率が良くなるらしい。
Data Parallel, Pipeline Parallel, Tensor Parallel、全てに互換性があるとのこと(併用可能)
そのほかの並列化の解説については
- 大規模モデルを支える分散並列学習のしくみ Part1, Kazuki Fujii, 2023.06
を参照のこと。
[Paper Note] Inference-Time Intervention: Eliciting Truthful Answers from a Language Model, Kenneth Li+, NeurIPS'23
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Hallucination #NeurIPS #read-later #ActivationSteering/ITI #Probing #Trustfulness #One-Line Notes Issue Date: 2025-05-09 GPT Summary- Inference-Time Intervention (ITI)を提案し、LLMsの真実性を向上させる技術を紹介。ITIは推論中にモデルの活性化を調整し、LLaMAモデルの性能をTruthfulQAベンチマークで大幅に改善。Alpacaモデルでは真実性が32.5%から65.1%に向上。真実性と有用性のトレードオフを特定し、介入の強度を調整する方法を示す。ITIは低コストでデータ効率が高く、数百の例で真実の方向性を特定可能。LLMsが虚偽を生成しつつも真実の内部表現を持つ可能性を示唆。 Comment
Inference Time Interventionを提案した研究。Attention Headに対して線形プロービング[^1]を実施し、真実性に関連するであろうHeadをtopKで特定できるようにし、headの出力に対し真実性を高める方向性のベクトルvを推論時に加算することで(=intervention)、モデルの真実性を高める。vは線形プロービングによって学習された重みを使う手法と、正答と誤答の活性化の平均ベクトルを計算しその差分をvとする方法の二種類がある。後者の方が性能が良い。topKを求める際には、線形プロービングをしたモデルのvalidation setでの性能から決める。Kとαはハイパーパラメータである。
[^1]: headのrepresentationを入力として受け取り、線形モデルを学習し、線形モデルの2値分類性能を見ることでheadがどの程度、プロービングの学習に使ったデータに関する情報を保持しているかを測定する手法
日本語解説スライド:
https://www.docswell.com/s/DeepLearning2023/Z38P8D-2024-06-20-131813#p1
これは相当汎用的に使えそうな話だから役に立ちそう
[Paper Note] Segment Anything, Alexander Kirillov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#ComputerVision #Transformer #ImageSegmentation #FoundationModel Issue Date: 2025-04-11 GPT Summary- Segment Anythingプロジェクトでは、新しい画像分割タスク、モデル、データセットを紹介。効率的なモデルを用いて最大規模のセグメンテーションデータセットを構築し、プライバシーを尊重した11M枚の画像に10億以上のマスクを含む。モデルはゼロショットで新しいタスクに転移可能で、評価の結果、従来の教師あり手法と同等、またはそれを上回る性能を示した。Segment Anything Model(SAM)と11M画像、1Bマスクを含むデータセット(SA-1B)を公開。 Comment
SAM論文
pj page: https://segment-anything.com
[Paper Note] The Impact of Positional Encoding on Length Generalization in Transformers, Amirhossein Kazemnejad+, NeurIPS'23
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Transformer #LongContext #PositionalEncoding #NeurIPS #KeyPoint Notes #Surface-level Notes Issue Date: 2025-04-06 GPT Summary- 長さ一般化はTransformerベースの言語モデルにおける重要な課題であり、位置エンコーディング(PE)がその性能に影響を与える。5つの異なるPE手法(APE、T5の相対PE、ALiBi、Rotary、NoPE)を比較した結果、ALiBiやRotaryなどの一般的な手法は長さ一般化に適しておらず、NoPEが他の手法を上回ることが明らかになった。NoPEは追加の計算を必要とせず、絶対PEと相対PEの両方を表現可能である。さらに、スクラッチパッドの形式がモデルの性能に影響を与えることも示された。この研究は、明示的な位置埋め込みが長いシーケンスへの一般化に必須でないことを示唆している。 Comment
- Llama 4 Series, Meta, 2025.04
において、Llama4 Scoutが10Mコンテキストウィンドウを実現できる理由の一つとのこと。
元ポスト:
Llama4のブログポストにもその旨記述されている:
>A key innovation in the Llama 4 architecture is the use of interleaved attention layers without positional embeddings. Additionally, we employ inference time temperature scaling of attention to enhance length generalization.
[The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation]( https://ai.meta.com/blog/llama-4-multimodal-intelligence/?utm_source=twitter&utm_medium=organic_social&utm_content=image&utm_campaign=llama4)
斜め読みだが、length generalizationを評価する上でdownstream taskに焦点を当て、3つの代表的なカテゴリに相当するタスクで評価したところ、この観点においてはT5のrelative positinal encodingとNoPE(位置エンコードディング無し)のパフォーマンスが良く、
NoPEは絶対位置エンコーディングと相対位置エンコーディングを理論上実現可能であり[^1]
実際に学習された異なる2つのモデルに対して同じトークンをそれぞれinputし、同じ深さのLayerの全てのattention distributionの組み合わせからJensen Shannon Divergenceで距離を算出し、最も小さいものを2モデル間の当該layerの距離として可視化すると下記のようになり、NoPEとT5のrelative positional encodingが最も類似していることから、NoPEが学習を通じて(実用上は)相対位置エンコーディングのようなものを学習することが分かった。
[^1]:深さ1のLayerのHidden State H^1から絶対位置の復元が可能であり(つまり、当該レイヤーのHが絶対位置に関する情報を保持している)、この前提のもと、後続のLayerがこの情報を上書きしないと仮定した場合に、相対位置エンコーディングを実現できる。
また、CoT/Scratchpadはlong sequenceに対する汎化性能を向上させることがsmall scaleではあるが先行研究で示されており、Positional Encodingを変化させた時にCoT/Scratchpadの性能にどのような影響を与えるかを調査。
具体的には、CoT/Scratchpadのフォーマットがどのようなものが有効かも明らかではないので、5種類のコンポーネントの組み合わせでフォーマットを構成し、mathematical reasoningタスクで以下のような設定で訓練し
- さまざまなコンポーネントの組み合わせで異なるフォーマットを作成し、
- 全ての位置エンコーディングあり/なしモデルを訓練
これらを比較した。この結果、CoT/Scratchpadはフォーマットに関係なく、特定のタスクでのみ有効(有効かどうかはタスク依存)であることが分かった。このことから、CoT/Scratcpad(つまり、モデルのinputとoutputの仕方)単体で、long contextに対する汎化性能を向上させることができないので、Positional Encoding(≒モデルのアーキテクチャ)によるlong contextに対する汎化性能の向上が非常に重要であることが浮き彫りになった。
また、CoT/Scratchpadが有効だったAdditionに対して各Positional Embeddingモデルを学習し、生成されたトークンのattentionがどの位置のトークンを指しているかを相対距離で可視化したところ(0が当該トークン、つまり現在のScratchpadに着目しており、1が遠いトークン、つまりinputに着目していることを表すように正規化)、NoPEとRelative Positional Encodingがshort/long rangeにそれぞれフォーカスするようなbinomialな分布なのに対し、他のPositional Encodingではよりuniformな分布であることが分かった。このタスクにおいてはNoPEとRelative POの性能が高かったため、binomialな分布の方がより最適であろうことが示唆された。
[Paper Note] Scaling Data-Constrained Language Models, Niklas Muennighoff+, NeurIPS'23
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #NeurIPS #Scaling Laws #read-later #KeyPoint Notes #DataRepetition Issue Date: 2025-03-23 GPT Summary- 言語モデルのスケーリングにおいて、データ制約下でのトレーニングを調査。9000億トークンと90億パラメータのモデルを用いた実験で、繰り返しデータを使用しても損失に大きな変化は見られず、繰り返しの価値が減少することを確認。計算最適性のスケーリング法則を提案し、データ不足を軽減するアプローチも実験。得られたモデルとデータセットは公開。 Comment
OpenReview: https://openreview.net/forum?id=j5BuTrEj35
チンチラ則のようなScaling Lawsはパラメータとデータ量の両方をスケールさせた場合の前提に立っており、かつデータは全てuniqueである前提だったが、データの枯渇が懸念される昨今の状況に合わせて、データ量が制限された状況で、同じデータを繰り返し利用する(=複数エポック学習する)ことが一般的になってきた。このため、データのrepetitionに関して性能を事前学習による性能の違いを調査して、repetitionとパラメータ数に関するスケーリング則を提案($3.1)しているようである。
Takeawayとしては、データが制限された環境下では、repetitionは上限4回までが効果的(コスパが良い)であり(左図)、小さいモデルを複数エポック訓練する方が固定されたBudgetの中で低いlossを達成できる右図)。
学習データの半分をコードにしても性能の劣化はなく、様々なタスクの性能が向上しパフォーマンスの分散も小さくなる、といったことが挙げられるようだ。
[Paper Note] Recommender Systems in the Era of Large Language Models (LLMs), Zihuai Zhao+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#RecommenderSystems #LanguageModel #read-later #Surface-level Notes Issue Date: 2024-12-03 GPT Summary- LLMsの出現により、レコメンダーシステムが進化し、ユーザーの嗜好に基づくパーソナライズが可能に。従来のDNN法の限界を克服するため、LLMsを活用したレコメンドシステムの概要を提供。具体的には、事前学習、ファインチューニング、プロンプティングの観点から最近の手法をレビューし、この分野の今後の発展方向を論じる。 Comment
中身を全然読んでいる時間はないので、図には重要な情報が詰まっていると信じ、図を読み解いていく。時間がある時に中身も読みたい。。。
LLM-basedなRecSysでは、NLPにおけるLLMの使い方(元々はT5で提案)と同様に、様々なレコメンド関係タスクを、テキスト生成タスクに落とし込み学習することができる。
RecSysのLiteratureとしては、最初はコンテンツベースと協調フィルタリングから始まり、(グラフベースドな推薦, Matrix Factorization, Factorization Machinesなどが間にあって)、その後MLP, RNN, CNN, AutoEncoderなどの様々なDeep Neural Network(DNN)を活用した手法や、BERT4RecなどのProbabilistic Language Models(PLM)を用いた手法にシフトしていき、現在LLM-basedなRecSysの時代に到達した、との流れである。
LLM-basedな手法では、pretrainingの段階からEncoder-basedなモデルの場合はMLM、Decoder-basedな手法ではNext Token Predictionによってデータセットで事前学習する方法もあれば、フルパラメータチューニングやPEFT(LoRAなど)によるSFTによるアプローチもあるようである。
推薦タスクは、推薦するアイテムIDを生成するようなタスクの場合は、異なるアイテムID空間に基づくデータセットの間では転移ができないので、SFTをしないとなかなかうまくいかないと気がしている。また、その場合はアイテムIDの推薦以外のタスクも同時に実施したい場合は、事前学習済みのパラメータが固定されるPEFT手法の方が安全策になるかなぁ、という気がしている(破壊的忘却が怖いので)。特はたとえば、アイテムIDを生成するだけでなく、その推薦理由を生成できるのはとても良いことだなあと感じる(良い時代、感)。
また、PromptingによるRecSysの流れも図解されているが、In-Context Learningのほかに、Prompt Tuning(softとhardの両方)、Instruction Tuningも同じ図に含まれている。個人的にはPrompt TuningはPEFTの一種であり、Instruction TuningはSFTの一種なので、一つ上の図に含意される話なのでは?という気がするが、論文中ではどのような立て付けで記述されているのだろうか。
どちらかというと、Promptingの話であれば、zero-few-many shotや、各種CoTの話を含めるのが自然な気がするのだが。
下図はPromptingによる手法を表にまとめたもの。Finetuningベースの手法が別表にまとめられていたが、研究の数としてはこちらの方が多そうに見える。が、性能的にはどの程度が達成されるのだろうか。直感的には、アイテムを推薦するようなタスクでは、Promptingでは性能が出にくいような印象がある。なぜなら、事前学習済みのLLMはアイテムIDのトークン列とアイテムの特徴に関する知識がないので。これをFinetuningしないのであればICLで賄うことになると思うのだが、果たしてどこまでできるだろうか…。興味がある。
(図は論文より引用)
[Paper Note] Direct Preference Optimization: Your Language Model is Secretly a Reward Model, Rafael Rafailov+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #NeurIPS #DPO #PostTraining #read-later #KeyPoint Notes Issue Date: 2024-09-25 GPT Summary- 大規模な自己教師付き言語モデルにおいて、挙動を制御するのが難しい問題に対し、新たな報酬モデルのパラメータ化を導入し、Direct Preference Optimization(DPO)を提案。DPOは、ファインチューニング時の安定性と計算効率を向上させ、既存手法と同等またはそれ以上の性能を実現。特に、生成の感情制御や応答品質向上を実現し、実装と訓練の単純さが大幅に改善されることを示した。 Comment
解説(必ず読んだ方が良い):
- RLHF/DPO 小話, 和地瞭良/ Akifumi Wachi, 2024.04
DPOを提案した研究。選好データ D:
解説ポスト:
SNLP'24での解説スライド: https://speakerdeck.com/kazutoshishinoda/lun-wen-shao-jie-direct-preference-optimization-your-language-model-is-secretly-a-reward-model
[Paper Note] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, Joshua Ainslie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #Transformer #Attention #KeyPoint Notes Issue Date: 2024-04-07 GPT Summary- マルチクエリ・アテンション(MQA)はデコーダ推論を高速化するが、品質低下のリスクがある。本研究では、(1)元の計算の5%でMQAを持つモデルへのアップトレーニング方法を提案し、(2)グループ化クエリ・アテンション(GQA)を導入。GQAは中間的な数のキー・バリュー・ヘッドを使用し、アップトレーニングされたGQAは品質を保ちながらMQAと同等の速度を実現する。 Comment
通常のMulti-Head AttentionがQKVが1対1対応なのに対し、Multi Query Attention (MQA) [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
は全てのheadに対してKVを共有する(HeadがH個あるのであれば、保持するKVの数が1/Hとなる)。一方、GQAはグループ単位で(headの)KVを共有する点で異なる。MQAは大幅にInfeerence speedが改善するが、精度が劣化する問題があった。この研究では通常のMulti-Head Attentionに対して、オリジナルの事前学習に対して追加の5%の計算量でGQAモデルを学習する手法を提案している。
Main Result. Multi-Head Attentionに対して、inference timeが大幅に改善しているが、Multi-Query Attentionよりも高い性能を維持している。
GAIA: a benchmark for General AI Assistants, Grégoire Mialon+, N_A, arXiv'23
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #QuestionAnswering #AIAgents #Evaluation Issue Date: 2023-11-23 GPT Summary- GAIAは、General AI Assistantsのためのベンチマークであり、AI研究のマイルストーンとなる可能性がある。GAIAは、推論、マルチモダリティの処理、ウェブブラウジングなど、実世界の質問に対する基本的な能力を必要とする。人間の回答者は92%の正答率を達成し、GPT-4は15%の正答率を達成した。これは、最近の傾向とは異なる結果であり、専門的なスキルを必要とするタスクではLLMsが人間を上回っている。GAIAは、人間の平均的な堅牢性と同等の能力を持つシステムがAGIの到来に重要であると考えている。GAIAの手法を使用して、466の質問と回答を作成し、一部を公開してリーダーボードで利用可能にする。 Comment
Yann LeCun氏の紹介ツイート
Meta-FAIR, Meta-GenAI, HuggingFace, AutoGPTによる研究。人間は92%正解できるが、GPT4でも15%しか正解できないQAベンチマーク。解くために推論やマルチモダリティの処理、ブラウジング、ツールに対する習熟などの基本的な能力を必要とする実世界のQAとのこと。
- Open-source DeepResearch – Freeing our search agents, HuggingFace, 2025.02
で言及されているLLM Agentの評価で最も有名なベンチマークな模様
[Paper Note] Instruction-Following Evaluation for Large Language Models, Jeffrey Zhou+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #InstructionTuning #Evaluation #PostTraining #InstructionFollowingCapability #KeyPoint Notes Issue Date: 2023-11-15 GPT Summary- 大規模言語モデルの自然言語指示に対する評価は標準化されておらず、人間による評価は高価で遅い。そこで、Instruction-Following Eval(IFEval)を提案し、検証可能な指示に焦点を当てた評価ベンチマークを提供。25種類の指示を特定し、約500のプロンプトを作成。これにより、2つのLLMの客観的な評価結果を示すことに成功した。コードとデータは公開されている。 Comment
LLMがinstructionにどれだけ従うかを評価するために、検証可能なプロンプト(400字以上で書きなさいなど)を考案し評価する枠組みを提案。人間が評価すると時間とお金がかかり、LLMを利用した自動評価だと評価を実施するLLMのバイアスがかかるのだ、それら両方のlimitationを克服できるとのこと。
[Paper Note] Do LLMs exhibit human-like response biases? A case study in survey design, Lindia Tjuatja+, arXiv'23, 2023.11
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #TACL #KeyPoint Notes Issue Date: 2023-11-08 GPT Summary- LLMの高性能に伴い、調査や世論調査での人間代理としての活用が期待されるが、プロンプト文言への感度が課題となる。本研究では、LLMが人間の応答バイアスを反映するかを調査し、調査票設計を通じて評価する。結果、主流のLLMは一般的に人間のような挙動を示さず、特にRLHFを経たモデルで顕著だった。また、人間に影響を与えない摂動には敏感であることが判明。これにより、LLMの人間代理利用時の注意点とモデル挙動の細かな分析の必要性が浮き彫りとなった。 Comment
LLMはPromptにsensitiveだが、人間も質問の仕方によって応答が変わるから、sensitiveなのは一緒では?ということを調査した研究。Neubig氏のツイートだと、instruction tuningやRLHFをしていないBase LLMの方が、より人間と類似した回答をするのだそう。
元ツイート:
人間のレスポンスのバイアス。左側は人間は「forbidden」よりも「not allowed」を好むという例、右側は「response order」のバイアスの例(選択肢の順番)。
LLM側で評価したいバイアスごとに、QAのテキストを変更し、LLMに回答を生成され、social science studiesでのトレンドと比較することで、LLMにも人間と同様のバイアスがあるかを明らかにしている。
結果は以下の表であり、青いセルが人間と同様のバイアスを持つことを統計的に有意に示されたもの(のはず)。これをみると、全てのバイアスに対して人間と同様の傾向があったのはLlama2-70Bのみであり、instruction tuningや、RLHFをかけた場合(RLHFの方が影響が大きそう)人間のバイアスとは異なる挙動をするモデルが多くなることがわかる。また、モデルのパラメータサイズとバイアスの強さには相関関係は見受けられない。
[Paper Note] Zephyr: Direct Distillation of LM Alignment, Lewis Tunstall+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #SyntheticData #COLM #PostTraining #KeyPoint Notes Issue Date: 2023-10-28 GPT Summary- ユーザーの意図に応じた小型言語モデルを目指し、dSFTに基づくモデルの整合性向上を図る。AIフィードバックからの選好データを用い、dDPOを適用することで、意図の整合性が向上したチャットモデルを学習。追加サンプリングなしで数時間の訓練で最先端のZephyr-7Bを実現し、MT-BenchでLlama2-Chat-70Bを上回る成果を達成。コードやデータは公開。 Comment
7BパラメータでLlaMa70Bと同等の性能を達成したZephyrの論文。
- dSFT:既存データからpromptをサンプリングし、user,assistantのmulti turnの対話をLLMでシミュレーションしてデータ生成しSFT
- AIF:既存データからpromstをサンプリングし、異なる4つのLLMのレスポンスをGPT4でランクづけしたデータの活用
- dDPO: 既存データからpromptをサンプリングし、ベストなレスポンスとランダムにサンプリングしたレスポンスの活用
人手を一切介していない。
Blog: https://huggingface.co/blog/Isamu136/understanding-zephyr
openreview: https://openreview.net/forum?id=aKkAwZB6JV
[Paper Note] Improved Baselines with Visual Instruction Tuning, Haotian Liu+, arXiv'23, 2023.10
Paper/Blog Link My Issue
#ComputerVision #NLP #LanguageModel #QuestionAnswering #OpenWeight #CVPR #VisionLanguageModel #One-Line Notes Issue Date: 2023-10-09 GPT Summary- LLaVAにCLIP-ViT-L-336pxとMLP投影を用いた全結合型コネクタを導入し、学術タスク指向のVQAデータを追加。単純な変更で、公開データ120万件・8基のA100による約1日の学習で、11のベンチマークすべてで最先端性能を達成。高性能かつデータ効率の高いLMMベースラインを確立し、研究の普及に貢献。 Comment
画像分析が可能なオープンソースLLMとのこと。
画像生成をできるわけではなく、inputとして画像を扱えるのみ。
pj page: https://llava-vl.github.io
[Paper Note] Effective Long-Context Scaling of Foundation Models, Wenhan Xiong+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#NLP #LanguageModel #LongContext #PositionalEncoding #NAACL #mid-training #DataMixture #KeyPoint Notes #needs-revision Issue Date: 2023-10-09 GPT Summary- 長文脈対応LLMシリーズを提案し、32,768トークンまでサポート。Llama 2の継続的な事前学習を基に、長文タスクで顕著な改善を実現。特に70B版は指示チューニングによりGPT-3.5-turbo-16kを上回る性能を示す。また、ポジションエンコーディングやデータ混合の影響を分析し、長文脈の事前学習が効率的かつ効果的であることを実証。 Comment
以下elvis氏のツイートの意訳
Metaが32kのcontext windowをサポートする70BのLLaMa2のvariant提案し、gpt-3.5-turboをlong contextが必要なタスクでoutperform。
short contextのLLaMa2を継続的に訓練して実現。これには人手で作成したinstruction tuning datasetを必要とせず、コスト効率の高いinstruction tuningによって実現される。
これは、事前学習データセットに長いテキストが豊富に含まれることが優れたパフォーマンスの鍵ではなく、ロングコンテキストの継続的な事前学習がより効率的であることを示唆している。
元ツイート:
位置エンコーディングにはlong contxet用に、RoPEのbase frequency bを `10,000->500,000` とすることで、rotation angleを小さくし、distant tokenに対する減衰の影響を小さくする手法を採用 (Adjusted Base Frequency; ABF)。token間の距離が離れていても、attention scoreがshrinkしづらくなっている。
また、単に長いコンテキストのデータを追加するだけでなく、データセット内における長いコンテキストのデータの比率を調整することで、より高い性能が発揮できることを示している。これをData Mixと呼ぶ。
また、instruction tuningのデータには、LLaMa2ChatのRLHFデータをベースに、LLaMa2Chat自身にself-instructを活用して、長いコンテキストを生成させ拡張したものを利用した。
具体的には、コーパス内のlong documentを用いたQAフォーマットのタスクに着目し、文書内のランダムなチャンクからQAを生成させた。その後、self-critiqueによって、LLaMa2Chat自身に、生成されたQAペアのverificationも実施させた。
[Paper Note] The Reversal Curse: LLMs trained on "A is B" fail to learn "B is A", Lukas Berglund+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #ICLR #ReversalCurse #KeyPoint Notes Issue Date: 2023-10-09 GPT Summary- 自己回帰型の大規模言語モデル(LLMs)の一般化の失敗を指摘し、特に「AはB」で学習したモデルが「BはA」を自動的に推測できない現象、いわゆる逆転の呪いを明らかにする。例えば、「Valentina Tereshkovaは宇宙へ初めて行った女性である」と学習しても、「宇宙へ初めて行った女性は誰ですか?」には正答できない。ファインチューニングされたGPT-3とLlama-1が、この逆転の構造から正しく答えられない事例を示し、逆転の呪いはモデルのサイズやファミリーに関係なく存在することを確認した。さらに、ChatGPT(GPT-3.5およびGPT-4)の評価でも同様の傾向が見られ、質問によって正答率に大きな差が生じることが示された。 Comment
A is Bという文でLLMを訓練しても、B is Aという逆方向には汎化されないことを示した。
著者ツイート:
GPT3, LLaMaを A is Bでfinetuneし、B is Aという逆方向のfactを生成するように(質問をして)テストしたところ、0%付近のAcc.だった。
また、Acc.が低いだけでなく、対数尤度もrandomなfactを生成した場合と、すべてのモデルサイズで差がないことがわかった。
このことら、Reversal Curseはモデルサイズでは解決できないことがわかる。
openreview: https://openreview.net/forum?id=GPKTIktA0k
[Paper Note] GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, Elias Frantar+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #Quantization #ICLR #Surface-level Notes Issue Date: 2023-09-29 GPT Summary- GPTモデルはその優れた性能にもかかわらず、高い計算とストレージコストが課題である。この問題を解決するため、近似二次情報に基づく新しい量子化手法GPTQを提案。GPTQは、1750億パラメータを持つモデルの量子化を約4時間で行い、精度をほとんど失うことなくビット幅を3または4ビットに削減する。また、この手法は圧縮の利得が2倍以上高く、単一のGPUでの推論を可能にし、極端な量子化条件でも合理的な精度を示す。実験により、推論速度が大幅に向上することが確認された。 Comment
# 概要
- 新たなpost-training量子化手法であるGPTQを提案
- 数時間以内に数千億のパラメータを持つモデルでの実行が可能であり、パラメータごとに3~4ビットまで圧縮するが、精度の大きな損失を伴わない
- OPT-175BおよびBLOOM-176Bを、約4時間のGPU時間で、perplexityのわずかな増加で量子化することができた
- 数千億のパラメータを持つ非常に高精度な言語モデルを3-4ビットに量子化可能なことを初めて示した
- 先行研究のpost-training手法は、8ビット(Yao et al., 2022; Dettmers et al., 2022)。
- 一方、以前のtraining-basedの手法は、1~2桁小さいモデルのみを対象としていた(Wu et al., 2022)。
# Background
## Layer-wise quantization
各linear layerがあるときに、full precisionのoutputを少量のデータセットをネットワークに流したときに、quantized weight W^barを用いてreconstructできるように、squared error lossを最小化する方法。
## Optimal Brain quantization (OBQ)
OBQでは equation (1)をWの行に関するsummationとみなす。そして、それぞれの行 **w** をOBQは独立に扱い、ある一つの重みw_qをquantizeするときに、エラーがw_qのみに基づいていることを補償するために他の**w**の全てのquantizedされていない重みをupdateする。式で表すと下記のようになり、Fは残りのfull-precision weightの集合を表している。
この二つの式を、全ての**w**の重みがquantizedされるまで繰り返し適用する。
つまり、ある一個の重みをquantizedしたことによる誤差を補うように、他のまだquantizedされていない重みをupdateすることで、次に別の重みをquantizedする際は、最初の重みがquantizedされたことを考慮した重みに対してquantizedすることになる。これを繰り返すことで、quantizedしたことによる誤差を考慮して**w**全体をアップデートできる、という気持ちだと思う。
この式は高速に計算することができ、medium sizeのモデル(25M parameters; ResNet-50 modelなど)とかであれば、single GPUで1時間でquantizeできる。しかしながら、OBQはO(d_row * d_col^3)であるため、(ここでd_rowはWの行数、d_colはwの列数)、billions of parametersに適用するには計算量が多すぎる。
# Algorithm
## Step 1: Arbitrary Order Insight.
通常のOBQは、量子化誤差が最も少ない重みを常に選択して、greedyに重みを更新していく。しかし、パラメータ数が大きなモデルになると、重みを任意の順序で量子化したとしてもそれによる影響は小さいと考えられる。なぜなら、おそらく、大きな個別の誤差を持つ量子化された重みの数が少ないと考えられ、その重みがプロセスのが進むにつれて(アップデートされることで?)相殺されるため。
このため、提案手法は、すべての行の重みを同じ順序で量子化することを目指し、これが通常、最終的な二乗誤差が元の解と同じ結果となることを示す。が、このために2つの課題を乗り越えなければならない。
## Step2. Lazy Batch-Updates
Fを更新するときは、各エントリに対してわずかなFLOPを使用して、巨大な行列のすべての要素を更新する必要があります。しかし、このような操作は、現代のGPUの大規模な計算能力を適切に活用することができず、非常に小さいメモリ帯域幅によってボトルネックとなる。
幸いにも、この問題は以下の観察によって解決できる:列iの最終的な四捨五入の決定は、この特定の列で行われた更新にのみ影響され、そのプロセスの時点で後の列への更新は関連がない。これにより、更新を「lazy batch」としてまとめることができ、はるかに効率的なGPUの利用が可能となる。(要は独立して計算できる部分は全部一気に計算してしまって、後で一気にアップデートしますということ)。たとえば、B = 128の列にアルゴリズムを適用し、更新をこれらの列と対応するB × Bブロックの H^-1 に格納する。
この戦略は理論的な計算量を削減しないものの、メモリスループットのボトルネックを改善する。これにより、非常に大きなモデルの場合には実際に1桁以上の高速化が提供される。
## Step 3: Cholesky Reformulation
行列H_F^-1が不定になることがあり、これがアルゴリズムが残りの重みを誤った方向に更新する原因となり、該当する層に対して悪い量子化を実施してしまうことがある。この現象が発生する確率はモデルのサイズとともに増加することが実際に観察された。これを解決するために、コレスキー分解を活用して解決している(詳細はきちんと読んでいない)。
# 実験で用いたCalibration data
GPTQのキャリブレーションデータ全体は、C4データセット(Raffel et al., 2020)からのランダムな2048トークンのセグメント128個で構成される。つまり、ランダムにクロールされたウェブサイトからの抜粋で、一般的なテキストデータを表している。GPTQがタスク固有のデータを一切見ていないため「ゼロショット」な設定でquantizationを実施している。
# Language Generationでの評価
WikiText2に対するPerplexityで評価した結果、先行研究であるRTNを大幅にoutperformした。
[Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #MachineLearning #NLP #LanguageModel #SyntheticData #Distillation #KeyPoint Notes Issue Date: 2023-09-13 GPT Summary- 小型TransformerモデルTinyStoriesから、1.3十億パラメータのphi-1を開発し、教科書品質データ生成を提案。新モデルphi-1.5は、常識的推論に焦点を当て、小学校レベルの数学やコーディング課題で、非最先端LLMを上回る性能を示す。能力には一歩ずつ考えることや初歩的なインコンテキスト学習が含まれ、幻覚や偏見生成も注意が必要だが、ウェブデータの不使用により改善が見られる。phi-1.5はオープンソース化され、さらなる研究を促進。 Comment
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
に続く論文
20Kのトピックから、commonsense reasmning, general knowledge(科学, 日常生活, theory of mlndなど)に関するtext book likeなデータを20B合成して事前学習に活用(どのモデルで合成されたかは明記されていないように見える)
既存のより大規模なモデル(7B--13B)、web dataをフィルタリングしたデータのみで学習したモデル(phi-1.5-web-only)、phi-1でのデータ 7Bに対して上記20Bを追加したデータで学習したモデル(phi-1.5)、フィルタリングしたwebデータ、phi-1のコードデータ、phi-1.5データを40%,20%,40%でmixしたモデル(phi-1.5-web)を比較したところ、phi-1.5の全てのモデル群が.より大きな7B--13B級のモデルを上回った。
web onlyの性能は他二つと比べて悪く、後者二つの性能が高く僅差でphi-1.5-webの性能が良かった。
このことより、
- テキストブックスタイルの合成データは、様々なドメインで有用に働き巨大モデルをSLMで上回れる
- 合成データだけでなくフィルタリングしたwebデータ自体を混ぜるとさらに効果的
という話に見える。
論文のメッセージとは違うかもだが、より現代的な観点を加えると、
- より大規模なモデルから合成したデータによってデータを通じた蒸留が起き、小規模モデルに能力が転移する
という話でもある。
[Paper Note] A Survey on Large Language Model based Autonomous Agents, Lei Wang+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#Survey #NLP #LanguageModel #AIAgents #One-Line Notes Issue Date: 2023-09-01 GPT Summary- LLMを活用した自律エージェントの研究を体系的に整理し、構築方法や応用例、評価戦略を概説。人間の学習に近づくための課題と今後の方向性を示す。関連文献のリポジトリも提供。 Comment
Fig1の時系列での論文数と代表的な研究のリストアップとエージェントの質の変遷、Table1のモデルの分類表など非常に分かりやすい。
[Paper Note] Prompt2Model: Generating Deployable Models from Natural Language Instructions, Vijay Viswanathan+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #DataAugmentation #Supervised-FineTuning (SFT) #AIAgents #SyntheticData #EMNLP #PostTraining #System Demonstration #KeyPoint Notes #Author Thread-Post Issue Date: 2023-08-28 GPT Summary- Prompt2Modelは、LLMによるプロンプトを用いて特定用途モデルを訓練する方法を提案。既存データセットの検索とLLMを使ったデータ生成により、強力なモデルを得られる。提示したプロンプトで、gpt-3.5-turboの結果を約20%上回り、最大700倍小型化できる。モデルの性能を信頼性高く推定可能で、オープンソースとして公開。 Comment
Dataset Generatorによって、アノテーションが存在しないデータについても擬似ラベル付きデータを生成することができ、かつそれを既存のラベル付きデータと組み合わせることによってさらに性能が向上することが報告されている。これができるのはとても素晴らしい。
Dataset Generatorについては、データを作成する際に低コストで、高品質で、多様なデータとするためにいくつかの工夫を実施している。
1. ユーザが与えたデモンストレーションだけでなく、システムが生成したexampleもサンプリングして活用することで、生成されるexampleの多様性を向上させる。実際、これをやらない場合は120/200がduplicate exampleであったが、これが25/200まで減少した。
2. 生成したサンプルの数に比例して、temperatureを徐々に高くしていく。これにより、サンプルの質を担保しつつ、多様性を徐々に増加させることができる。Temperature Annealingと呼ぶ。
3. self-consistencyを用いて、擬似ラベルの質を高める。もしmajority votingが互角の場合は、回答が短いものを採用した(これはヒューリスティックに基づいている)
4. zeno buildを用いてAPIへのリクエストを並列化することで高速に実験を実施
非常に参考になる。
著者らによる現在の視点での振り返り(提案当時はAI Agentsという概念はまだなく、本研究はその先取りと言える):
[Paper Note] Large Language Models Sensitivity to The Order of Options in Multiple-Choice Questions, Pouya Pezeshkpour+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #Bias #NAACL #read-later #Findings #One-Line Notes #Reading Reflections #needs-revision Issue Date: 2023-08-28 GPT Summary- 多肢選択問題におけるLLMsの性能は選択肢の順序に敏感であり、配置を変えることで最大75%の性能差が見られる。特に、上位選択肢間の不確実性がこの感度を引き起こし、バイアスが影響することを示唆する。最適な配置は、バイアスを増幅させるためにトップ選択肢を両端に置くこと、緩和するためには隣接させることが推奨される。実験を通じて、予測のキャリブレーションにより最大8ポイントの改善が達成された。 Comment
これはそうだろうなと思っていたけど、ここまで性能に差が出るとは思わなかった。
これがもしLLMのバイアスによるもの(2番目の選択肢に正解が多い)の場合、
ランダムにソートしたり、平均取ったりしても、そもそもの正解に常にバイアスがかかっているので、
結局バイアスがかかった結果しか出ないのでは、と思ってしまう。
そうなると、有効なのはone vs. restみたいに、全部該当選択肢に対してyes/noで答えさせてそれを集約させる、みたいなアプローチの方が良いかもしれない。
[Paper Note] MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework, Sirui Hong+, arXiv'23, 2023.08
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #ICLR #One-Line Notes Issue Date: 2023-08-08 GPT Summary- MetaGPTは、LLMベースのマルチエージェントシステムに人間のワークフローを統合し、複雑なタスクを小さなサブタスクに効率的に分解するメタプログラミングフレームワークです。これにより、中間結果の検証が可能になり、誤りを減少させます。また、共同ソフトウェアエンジニアリングのタスクにおいて、従来のシステムよりも一貫性のある解決策を提供します。プロジェクトはGitHubで公開されています。 Comment
要はBabyTalk, AutoGPTの進化系で、人間のワークフローを模倣するようにデザインしたら良くなりました、という話と思われる
ソフトウェアエンジニア、アーキテクト、プロダクトオーナー、プロジェクトマネージャーなどのロールを明示的に与えて、ゴールを目指す。もはやLLM内部でソフトウェア企業を模倣しているのと同様である。
openreview: https://openreview.net/forum?id=VtmBAGCN7o
[Paper Note] FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance, Lingjiao Chen+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #NLP #LanguageModel #TMLR #One-Line Notes Issue Date: 2023-07-26 GPT Summary- LLMの料金体系は多様で、大量利用時に高コストになる可能性がある。推論コストを削減するため、プロンプト適応、LLM近似、LLMカスケードの3つの戦略を提案。FrugalGPTを用いて、異なるクエリに最適なLLMsの組み合わせを学習し、最高で98%のコスト削減や4%の精度向上を実現する実験結果を示した。これにより、LLMの持続可能かつ効率的な活用の基盤が提供される。 Comment
限られた予算の中で、いかに複数のLLM APIを使い、安いコストで高い性能を達成するかを追求した研究。
LLM Cascadeなどはこの枠組みでなくても色々と使い道がありそう。Question Concatenationは実質Batch Prompting。
openreview: https://openreview.net/forum?id=cSimKw5p6R
[Paper Note] Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Lianmin Zheng+, NeurIPS'23, 2023.06
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #LLM-as-a-Judge #NeurIPS #KeyPoint Notes Issue Date: 2023-07-26 GPT Summary- LLMを審査員として用いて、チャットアシスタントの評価の新たな方法を探求。役割やバイアスの利点と限界を検討し、MT-benchとChatbot Arenaのベンチマークで人間の好みとの一致率が80%以上に達することを確認。LLMを用いることでスケーラブルかつ説明可能な評価手法を提供し、専門家の投票や会話データも公開。 Comment
MT-Bench(MTBench)スコアとは、multi-turnのQAを出題し、その回答の質をGPT-4でスコアリングしたスコアのこと。
GPT-4の判断とhuman expertの判断とのagreementも検証しており、agreementは80%以上を達成している。
`LLM-as-a-Judge` という用語を最初に提唱したのも本研究となる(p.2参照)
[Paper Note] Batch Prompting: Efficient Inference with Large Language Model APIs, Zhoujun Cheng+, arXiv'23, 2023.01
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #LanguageModel #Prompting #EMNLP #Batch #KeyPoint Notes #IndustryTrack Issue Date: 2023-07-24 GPT Summary- 大規模言語モデル(LLM)を使ったバッチプロンプティングにより、サンプルをバッチ単位で推論し、トークンコストと推論時間を削減。few-shot in-context learningで、コストはバッチ内サンプル数に反比例して低下。100のデータセットでの検証では、最大5倍のコスト削減を実現し、性能は向上または維持。GPT-3.5やGPT-4でも効果を確認し、タスクの複雑さが性能に影響を与えることを示唆。バッチプロンプティングは他の推論手法にも適用可能。 Comment
10種類のデータセットで試した結果、バッチにしても性能は上がったり下がったりしている。著者らは類似した性能が出ているので、コスト削減になると結論づけている。
Batch sizeが大きくなるに連れて性能が低下し、かつタスクの難易度が高いとパフォーマンスの低下が著しいことが報告されている。また、contextが長ければ長いほど、バッチサイズを大きくした際のパフォーマンスの低下が著しい。
[Paper Note] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, Tri Dao, arXiv'23, 2023.07
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #NLP #Transformer #Attention #ICLR #One-Line Notes Issue Date: 2023-07-23 GPT Summary- 長いシーケンスを扱うトランスフォーマーの性能向上に寄与するFlashAttentionは、実行時間とメモリを線形に増加させるが、最適化されたGEMM演算には及ばない。FlashAttention-2では、作業分割を最適化し、非マトリクス積FLOPsを削減、アテンション計算を並列化、共有メモリ通信を減少することで、約2倍のスピードアップを実現。これにより、A100 GPU上で最大225 TFLOPs/sの訓練速度を達成し、モデルFLOPsの利用率は72%に向上した。 Comment
Flash Attention1よりも2倍高速なFlash Attention 2
Flash Attention1は
- [Paper Note] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, Tri Dao+, NeurIPS'22, 2022.05
を参照
openreview: https://openreview.net/forum?id=mZn2Xyh9Ec
[Paper Note] Can Large Language Models Be an Alternative to Human Evaluations?, Cheng-Han Chiang+, ACL'23, 2023.05
Paper/Blog Link My Issue
#Analysis #LanguageModel #ChatGPT #Evaluation #LLM-as-a-Judge #Attack #ACL #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- 人間評価の再現性が低いため、NLPモデル間の公正な比較が難しい。そこで、大規模言語モデル(LLM)を人間評価の代替手段として利用することを探求。本研究では、LLMに同一指示とサンプルを与え、評価を実施するLLM評価を提案。オープンエンドのストーリー生成や敵対的攻撃のタスクに対する評価結果は、人間専門家の評価と高い一致を示し、評価の安定性も確認。LLMを用いたテキスト評価の可能性やその限界、倫理的課題についても考察。 Comment
LLMがテキストの品質評価において、人間による評価者の代替となりうるか?という疑問を初めて実験的に示した研究で、インパクトが大きく重要論文と判断。ただし、実験のスコープは物語生成と敵対的生成(テキスト分類器を騙すような摂動を加える)の2タスクである点、には注意。
ChatGPT(おそらくGPT-3.5)が人間の評価者(3人のEnglish teacher)とopen-endで生成された物語にたいして、以下の4つの観点に関してratingの平均で見た時に同様の傾向のスコアを付与することを実験的に明らかにした:
- Grammaticality [^1]: テキストの文法の正しさ
- Cohesiveness: テキストの一貫性
- Likeability: テキストが読んでいて楽しいか
- Relevance: promptに対してどれだけ適切なテキストが生成されているか
ただし、T0やtext-curie-001 においてはこのような傾向は見受けられなかった。[^2]
また、ChatGPTによる説明とratingを人間の評価者に対してblindで提示したところ、人間が見ても妥当な判断だと認知された。
全体の傾向としてではなく、個別のratingがどの程度同じような傾向を示すか(i.e., 人間があるstoryを高くratingしたら、LLMも高くratingするか?)をケンドールの順位相関係数で分析(200サンプルに対して3人の英語教員のスコアの平均, text-davinciによる3回の独立したratingを実施した平均スコアを用いて計算)したところ、4つの観点のうち全てにおいて正の相関が見受けられた(Table2, p-valueは<0.05で統計的に有意)。が、Relevanceのみが強い相関を示し、他の指標については弱い相関にとどまっている。しかし、Table6に示されている通り、2人の英語の先生同士で個別のjudgeに感して同様にケンドールの順位相関係数を測定しても、人間-LLM間と同様の傾向が見受けられる。すなわち、Relevanceのみが強い相関で他は弱い相関。このことから、人間同士でも個別のサンプルに対する判断は一致しない(=主観的なタスク)ということは留意する必要がある。
敵対的生成に関する実験については、Synonym Substitution Attack (SSAs; 良性のサンプルを同義語で置換する手法で、全体的な意味は保たれるため一般的な人間は正しく認知してしまうが、実際には文法がおかしくなったり不自然になったり、意味が変わってしまうことが先行研究によって知られているようなものらしい)によって実験。Fluency / Meaning Preservingの2つの指標で英語教員とLLMによる評価を比較した結果、人間は正しくadversarialなサンプルと良性なサンプルを区別できており、ChatGPT(おそらくGPT-3.5)も区別ができている(Table4)。ただし、人間のスコアと比較するとChatGPTは高めのスコアを出す傾向がある点には注意ではあるものの、良性サンプル > 敵対的サンプル という序列の判断に関しては人間と同様の傾向を示していることが示唆された。
[^1]: ただし、LLMはpunctuationのミスを文法エラーと判断するが、一人の英語の先生は文法エラーとしてみなさないなどの現象も観察され、人間は独自の評価criteriaを保持していることも窺える
[^2]: (感想)ある程度能力の高いLLMかRLHFなどを用いて人間の好みに対してalignmentがとられていないとうまくいかないのかもしれない
本研究は非常に初期の研究であり、現在のfrontierモデル群(特にreasoningモデル)を用いた場合にはどの程度改善しているか?という点は気になる。
[Paper Note] QLoRA: Efficient Finetuning of Quantized LLMs, Tim Dettmers+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#EfficiencyImprovement #MachineLearning #Supervised-FineTuning (SFT) #Quantization #PEFT(Adaptor/LoRA) #NeurIPS #PostTraining #needs-revision Issue Date: 2023-07-22 GPT Summary- QLoRAは、65Bパラメータモデルを単一の48GB GPUでファインチューニングするための効率的な手法であり、16ビット性能を維持しつつメモリ使用量を削減します。低秩アダプターを介して勾配をバックプロパゲーションし、GuanacoモデルはVicunaベンチマークで従来のモデルを超え、ChatGPTに近い性能を示しました。QLoRAの革新には、4ビット量子化データ型、ダブル量子化、そしてメモリ管理のためのページングオプティマイザーが含まれます。1,000以上のモデルをファインチューニングし、指示追従性能の詳細な分析を提供。また、GPT-4評価を用いたチャットボット性能の分析から、既存のベンチマークの信頼性の問題点も指摘しています。全てのモデルとコードは公開されています。 Comment
実装:
https://github.com/artidoro/qlora
PEFTにもある
参考:
[Paper Note] Objaverse-XL: A Universe of 10M+ 3D Objects, Matt Deitke+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#ComputerVision #Dataset #FoundationModel #InductiveBias #NeurIPS #3D Reconstruction #3D (Scene) #NovelViewSynthesis #3D Object Generation Issue Date: 2023-07-12 GPT Summary- 1000万以上の3Dオブジェクトから構成されるデータセットObjaverse-XLを紹介。手作業で設計されたオブジェクトや写真測量スキャンからの多様なオブジェクトを含む。Objaverse-XLは3Dビジョン分野の最大規模と多様性を持ち、Zero123を用いた新規ビュー合成で強力なゼロショット一般化を実現。これにより、3Dビジョンでのさらなる革新が期待される。 Comment
10Mを超える3D objectのデータセットを公開し、3D Modelの基盤モデルとしてZero123-XLを訓練。
元ツイートのGifがわかりやすい。
たとえばinputされたイメージに対して、自由にカメラの視点を設定し、その視点からの物体の画像を出力できる。
openreview: https://openreview.net/forum?id=Sq3CLKJeiz¬eId=hnXWj1z2rI
[Paper Note] Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Analysis #MachineLearning #NLP #LanguageModel #Prompting #In-ContextLearning #TACL #ContextEngineering #KeyPoint Notes #needs-revision Issue Date: 2023-07-11 GPT Summary- 言語モデルは長い文脈を扱う能力を持つが、実際に関連情報を効果的に利用できているかは未解明。複数文書に基づく質問応答とキー・バリュー検索を通じて、関連情報の位置による性能変動を分析した結果、関連情報が文脈の先頭や末尾にあるときに高性能を示し、中央にある場合に顕著に性能が低下することが明らかになった。この考察は、言語モデルの文脈使用に関する理解を深め、長い文脈への評価プロトコルの方向性を示唆している。 Comment
元ツイート
非常に重要な知見がまとめられている
1. モデルはコンテキストのはじめと最後の情報をうまく活用でき、真ん中の情報をうまく活用できない
2. 長いコンテキストのモデルを使っても、コンテキストをより短いコンテキストのモデルよりもうまく考慮できるわけではない
3. モデルのパフォーマンスは、コンテキストが長くなればなるほど悪化する
SNLP'24での解説スライド:
https://speakerdeck.com/kichi/snlp2024
[Paper Note] Mind2Web: Towards a Generalist Agent for the Web, Xiang Deng+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NLP #Dataset #LanguageModel #AIAgents #Evaluation #NeurIPS #ComputerUse #VisionLanguageModel #One-Line Notes #GUI Issue Date: 2023-07-03 GPT Summary- Mind2Webは、ウェブ上での汎用的なタスクをこなすエージェントの開発のための初のデータセットで、137のウェブサイトと31のドメインにまたがる2,000件以上のオープンエンドタスクを収集。これにより、多様なドメイン・タスクを扱え、実世界のサイトを対象にしたエージェント構築を支援。大規模言語モデル(LLMs)を用いることで、未見のウェブサイトでも一定の性能を発揮することを示し、データセットとモデルをオープンソース化して研究の促進を目指す。 Comment
Webにおけるgeneralistエージェントを評価するためのデータセットを構築。31ドメインの137件のwebサイトにおける2350個のタスクが含まれている。
タスクは、webサイトにおける多様で実用的なユースケースを反映し、チャレンジングだが現実的な問題であり、エージェントの環境やタスクをまたいだ汎化性能を評価できる。
プロジェクトサイト:
https://osu-nlp-group.github.io/Mind2Web/
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #MachineLearning #NLP #LanguageModel #SmallModel #One-Line Notes Issue Date: 2023-06-25 GPT Summary- phi-1は1.3BパラメータのTransformerベースの大規模言語モデルで、競合モデルより小型ながらHumanEvalで50.6%、MBPPで55.5%の高精度を達成。8台のA100 GPUを用いて、教科書品質データと合成生成データを組み合わせて訓練。phi-1-baseやphi-1-smallと比べても驚くべき創発特性を示す。 Comment
参考:
教科書のような品質の良いテキストで事前学習すると性能が向上し(グラフ真ん中)、さらに良質なエクササイズでFinetuningするとより性能が向上する(グラフ右)
日本語解説: https://dalab.jp/archives/journal/introduction-textbooks-are-all-you-need/
ざっくり言うと、教科書で事前学習し、エクササイズでFinetuningすると性能が向上する(= より大きいモデルと同等の性能が得られる)。
[Paper Note] How Language Model Hallucinations Can Snowball, Muru Zhang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Hallucination #ICML #KeyPoint Notes #needs-revision Issue Date: 2023-06-16 GPT Summary- 言語モデルは実用的な応用においてハルシネーションのリスクを伴い、この現象は知識ギャップに起因することが多い。興味深いことに、モデルは誤りを認識しながらも偽の主張を出力する場合がある。「ハルシネーション・スノーボール現象」として知られるこの現象では、初期の過ちに固執することでさらなる誤りを招く。研究では、ChatGPTとGPT-4がそれぞれ67%および87%の誤りを特定できることが確認された。 Comment
LLMによるhallucinationは、単にLLMの知識不足によるものだけではなく、LLMが以前に生成したhallucinationを正当化するために、誤った出力を生成してしまうという仮説を提起し、この仮説を検証した研究。これをhallucination snowballと呼ぶ。これにより、LLMを訓練する際に、事実に対する正確さを犠牲にして、流暢性と一貫性を優先し言語モデルを訓練するリスクを示唆している。
[Paper Note] DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining, Sang Michael Xie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #DataDistillation #NeurIPS #DataMixture #One-Line Notes Issue Date: 2023-05-21 GPT Summary- ドメイン混合割合が言語モデル(LM)の性能に影響を与える中、本論文はドメイン再重み付け(DoReMi)を提案。DoReMiは、まず代理モデルを使ってドメイン重みを生成し、その後データをリサンプリングして大規模モデルを効率的に訓練。実験では、DoReMiを用いた代理モデルが、パープレキシティを改善し、少数ショット精度を6.5ポイント向上、訓練ステップは2.6倍少なくて済むと示した。GLaMデータセットでは、ドメイン重み無しでも高い性能を達成。 Comment
事前学習する際の各ドメインのデータをどのような比率でmixtureするかの話。各ドメインごとに小さなproxy modelを訓練し、downstream taskの知識無しでドメインごとの重みを生成。データセットを生成されたドメインごとの重みに従いリサンプリングすることで、(1/30のプロキシモデルを用いた場合)オリジナルのデータより2.6倍高速で、6.5%oneshotのaccuracyを向上させることに成功
openreview: https://openreview.net/forum?id=lXuByUeHhd
[Paper Note] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, Shunyu Yao+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #Prompting #One-Line Notes #needs-revision Issue Date: 2023-05-20 GPT Summary- 言語モデルは一般的な問題解決に広がっているが、推論は依然としてトークンレベルの左から右への決定に制限されている。これを克服するために、新しい「Tree of Thoughts(ToT)」フレームワークを導入。ToTは、思考の連鎖を一般化し、中間ステップを探索できるようにし、複数の推論経路を自己評価することで意図的な意思決定を可能にする。実験では、ToTがGame of 24やCreative Writingなどの新規タスクで言語モデルの問題解決能力を顕著に向上させることが示された。例えば、Game of 24では新手法が74%の成功率を達成した。 Comment
Self Concistencyの次
Non trivialなプランニングと検索が必要な新たな3つのタスクについて、CoT w/ GPT4の成功率が4%だったところを、ToTでは74%を達成
論文中の表ではCoTのSuccessRateが40%と書いてあるような?
[Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #ICLR #Test-Time Scaling #MajorityVoting Issue Date: 2023-04-27 GPT Summary- 自己一貫性という新しいデコーディング戦略を提案し、chain-of-thought promptingの性能を向上。多様な推論経路をサンプリングし、一貫した答えを選択することで、GSM8KやSVAMPなどのベンチマークで顕著な改善を達成。 Comment
self-consistencyと呼ばれる新たなCoTのデコーディング手法を提案。
これは、難しいreasoningが必要なタスクでは、複数のreasoningのパスが存在するというintuitionに基づいている。
self-consistencyではまず、普通にCoTを行う。そしてgreedyにdecodingする代わりに、以下のようなプロセスを実施する:
1. 多様なreasoning pathをLLMに生成させ、サンプリングする。
2. 異なるreasoning pathは異なるfinal answerを生成する(= final answer set)。
3. そして、最終的なanswerを見つけるために、reasoning pathをmarginalizeすることで、final answerのsetの中で最も一貫性のある回答を見出す。
これは、もし異なる考え方によって同じ回答が導き出されるのであれば、その最終的な回答は正しいという経験則に基づいている。
self-consistencyを実現するためには、複数のreasoning pathを取得した上で、最も多いanswer a_iを選択する(majority vote)。これにはtemperature samplingを用いる(temperatureを0.5やら0.7に設定して、より高い信頼性を保ちつつ、かつ多様なoutputを手に入れる)。
temperature samplingについては[こちら](
https://openreview.net/pdf?id=rygGQyrFvH)の論文を参照のこと。
sampling数は増やせば増やすほど性能が向上するが、徐々にサチってくる。サンプリング数を増やすほどコストがかかるので、その辺はコスト感との兼ね合いになると思われる。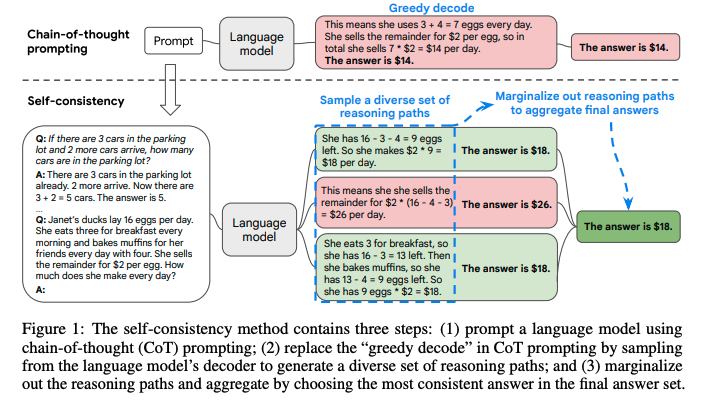
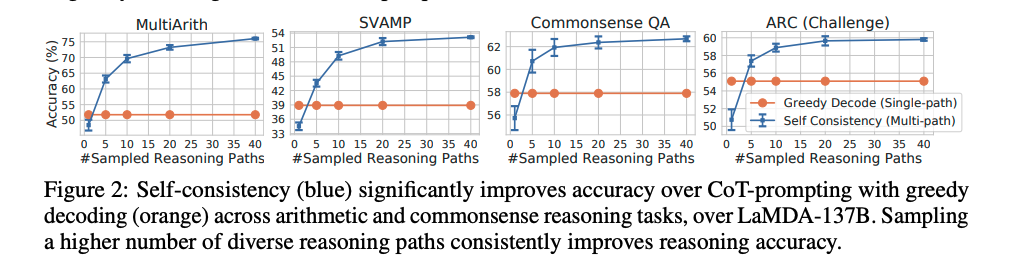
Self-consistencyは回答が閉じた集合であるような問題に対して適用可能であり、open-endなquestionでは利用できないことに注意が必要。ただし、open-endでも回答間になんらかの関係性を見出すような指標があれば実現可能とlimitationで言及している。
self-consistencyが提案されてからもう4年も経ったのか、、、
[Paper Note] Automatic Chain of Thought Prompting in Large Language Models, Zhuosheng Zhang+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#NLP #LanguageModel #Chain-of-Thought #ICLR #KeyPoint Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)を用いて、段階的思考を促すCoT promptingを提案。手作業でデモを設計する必要なく、プロンプトを通じて推論チェーンを生成可能。また、多様性を持って質問をサンプリングする自動CoT法(Auto-CoT)を導入し、GPT-3を用いたベンチマークで手動設計と比較して優れた性能を示した。 Comment
LLMによるreasoning chainが人間が作成したものよりも優れていることを示しているとのこと [Paper Note] Enhancing Chain-of-Thoughts Prompting with Iterative Bootstrapping in Large Language Models, Jiashuo Sun+, NAACL'24 Findings, 2023.04 より
clusteringベースな手法を利用することにより、誤りを含む例が単一のクラスタにまとめられうことを示し、これにより過剰な誤ったデモンストレーションが軽減されることを示した。
手法の概要。questionを複数のクラスタに分割し、各クラスタから代表的なquestionをサンプリングし、zero-shot CoTでreasoning chainを作成しpromptに組み込む。最終的に回答を得たいquestionに対しても、上記で生成した複数のquestion-reasoningで条件付けした上で、zeroshot-CoTでrationaleを生成する。これにより自動的にCoTをICLするためのexamplarを生成できる。
openreview: https://openreview.net/forum?id=5NTt8GFjUHkr
[Paper Note] ReAct: Synergizing Reasoning and Acting in Language Models, Shunyu Yao+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #needs-revision Issue Date: 2023-04-13 GPT Summary- 大規模言語モデルを用いて、推論と行動計画を相互に組み合わせるReActアプローチを提案。推論の痕跡が行動計画の導出を促進し、行動が外部情報を活用することで、推論の効率を向上。質問応答や事実検証タスクで従来手法を凌駕し、人間の解釈性と信頼性を向上させる。対話的意思決定ベンチマークでも優れた性能を発揮。 Comment
# 概要
人間は推論と行動をシナジーさせることで、さまざまな意思決定を行える。近年では言語モデルにより言語による推論を意思決定に組み合わせる可能性が示されてきた。たとえば、タスクをこなすための推論トレースをLLMが導けることが示されてきた(Chain-of-Thought)が、CoTは外部リソースにアクセスできないため知識がアップデートできず、事後的に推論を行うためhallucinationやエラーの伝搬が生じる。一方で、事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われているが、これらの研究では、高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
そこで、REACTを提案。REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みであり、推論トレースとアクションを交互に生成するため、動的に推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
- 要はいままではGeneralなタスク解決モデルにおいては、推論とアクションの生成は独立にしかやられてこなかったけど、推論とアクションを交互作用させることについて研究したよ
- そしたら性能がとってもあがったよ
- reasoningを人間が編集すれば、エージェントのコントロールもできるよ という感じ
# イントロ
人間は推論と行動の緊密なシナジーによって、不確実な状況に遭遇しても適切な意思決定が行える。たとえば、任意の2つの特定のアクションの間で、進行状況をトレースするために言語で推論したり(すべて切り終わったからお湯を沸かす必要がある)、例外を処理したり、状況に応じて計画を調整したりする(塩がないから代わりに醤油と胡椒を使おう)。また、推論をサポートし、疑問(いまどんな料理を作ることができるだろうか?)を解消するために、行動(料理本を開いてレシピを読んで、冷蔵庫を開いて材料を確確認したり)をすることもある。
近年の研究では言語での推論を、インタラクティブな意思決定を組み合わせる可能性についてのヒントが得られてきた。一つは、適切にPromptingされたLLMが推論トレースを実行できることを示している。推論トレースとは、解決策に到達するための一連のステップを経て推論をするためのプロセスのことである。しかしながらChain-of-thoughytは、このアプローチでは、モデルが外界対してgroundingできず、内部表現のみに基づい思考を生成するため限界がある。これによりモデルが事後対応的に推論したり、外部情報に基づいて知識を更新したりできないため、推論プロセス中にhallucinationやエラーの伝搬などの問題が発生する可能性が生じる。
一方、近年の研究では事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われている。これらの研究では、通常マルチモーダルな観測結果をテキストに変換し、言語モデルを使用してドメイン固有のアクション、またはプランを生成し、コントローラーを利用してそれらを選択または実行する。ただし、これらのアプローチは高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。
推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
LLMにおける推論と行動を組み合わせて、言語推論と意思決定タスクを解決するREACTと呼ばれる手法を提案。REACTでは、推論と行動の相乗効果を高めることが可能。推論トレースによりアクションプランを誘発、追跡、更新するのに役立ち、アクションでは外部ソースと連携して追加情報を収集できる。
REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みである。REACTのpromptはLLMにverbalな推論トレースとタスクを実行するためのアクションを交互に生成する。これにより、モデルは動的な推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
# 手法
変数を以下のように定義する:
- O_t: Observertion on time t
- a_t: Action on time t
- c_t: context, i.e. (o_1, a_1, o_2, a_2, ..., a_t-1, o_t)
- policy pi(a_t | c_t): Action Spaceからアクションを選択するポリシー
- A: Action Space
- O: Observation Space
普通はc_tが与えられたときに、ポリシーに従いAからa_tを選択しアクションを行い、アクションの結果o_tを得て、c_t+1を構成する、といったことを繰り返していく。
このとき、REACTはAをA ∪ Lに拡張しする。ここで、LはLanguage spaceである。LにはAction a_hatが含まれ、a_hatは環境に対して作用をしない。単純にthought, あるいは reasoning traceを実施し、現在のcontext c_tをアップデートするために有用な情報を構成することを目的とする。Lはunlimitedなので、事前学習された言語モデルを用いる。今回はPaLM-540B(c.f. GPT3は175Bパラメータ)が利用され、few-shotのin-context exampleを与えることで推論を行う。それぞれのin-context exampleは、action, thoughtsそしてobservationのtrajectoryを与える。
推論が重要なタスクでは、thoughts-action-observationステップから成るtask-solving trajectoryを生成する。一方、多数のアクションを伴う可能性がある意思決定タスクでは、thoughtsのみを行うことをtask-solving trajectory中の任意のタイミングで、自分で判断して行うことができる。
意思決定と推論能力がLLMによってもたらされているため、REACTは4つのuniqueな特徴を持つ:
- 直感的で簡単なデザイン
- REACTのpromptは人間のアノテータがアクションのトップに思考を言語で記述するようなストレートなものであり、ad-hocなフォーマットの選択、思考のデザイン、事例の選定などが必要ない。
- 一般的で柔軟性が高い
- 柔軟な thought spaceと thought-actionのフォーマットにより、REACTはさまざまなタスクにも柔軟に対応できる
- 高性能でロバスト
- REACTは1-6個の事例によって、新たなタスクに対する強力な汎化を示す。そして推論、アクションのみを行うベースラインよりも高い性能を示している。REACTはfinetuningの斧系も得ることができ、promptの選択に対してREACTの性能はrobustである。
- 人間による調整と操作が可能
- REACTは、解釈可能な意思決定と推論のsequenceを前提としているため、人間は簡単に推論や事実の正しさを検証できる。加えて、thoughtsを編集することによって、m人間はエージェントの行動を制御、あるいは修正できる。
# KNOWLEDGE INTENSIVE REASONING TASKS
openreview: https://openreview.net/forum?id=tvI4u1ylcqs
[Paper Note] Mind the Gap: Understanding the Modality Gap in Multi-modal Contrastive Representation Learning, Weixin Liang+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#ComputerVision #Analysis #MultiModal #ContrastiveLearning #NeurIPS #read-later Issue Date: 2026-08-20 GPT Summary- マルチモーダルモデルにおけるモダリティギャップの幾何学的現象を紹介。異なるデータモダリティが共有表現空間で一定の距離を保つことを示し、これはモデル初期化と対照学習の組み合わせによって引き起こされる。初期化段階で表現が狭い円錐に制限され、対照学習によりモダリティ間の距離が維持されることが実証された。実験により、このギャップ距離を変えることでゼロショット分類性能と公平性が改善されることがわかった。コードとデータは公開中。 Comment
元ポスト:
openreview: https://openreview.net/forum?id=S7Evzt9uit3
[Paper Note] Masked Autoencoders Are Scalable Vision Learners, Kaiming He+, CVPR'22, 2021.11
Paper/Blog Link My Issue
#ComputerVision #Pretraining #Transformer #Self-SupervisedLearning #CVPR #Encoder #Backbone #One-Line Notes #AutoEncoder #2D Reconstruction Issue Date: 2026-04-29 GPT Summary- MAEは、入力画像のランダムなパッチをマスクし、欠損部分を再構成するシンプルな自己教師付き学習モデルである。非対称のエンコーダ-デコーダ構造を用い、エンコーダは可視パッチのみを処理。75%をマスクすることで、非自明な自己教師付きタスクを生み出し、高速かつ効果的なモデル訓練を実現。一般化性能に優れ、ViT-HugeモデルがImageNet-1Kデータで最高精度(87.8%)を達成し、転移性能も監督付き事前学習を上回る。 Comment
元ポスト:
AutoEncoderを通じてMaskされたパッチを再構築できるように学習する(25%のパッチから予測する)ことで、(decoderを排除した場合に)downstream taskで良い性能を発揮するViTエンコーダを学習する。デコーダのパラメータ数は意図的に小さくし、Encoder側で特徴がきちんと学習されるように誘導する。
[Paper Note] ScienceWorld: Is your Agent Smarter than a 5th Grader?, Ruoyao Wang+, EMNLP'22, 2022.03
Paper/Blog Link My Issue
#NLP #LanguageModel #AIAgents #Evaluation #ScientificDiscovery #EMNLP #Science #One-Line Notes Issue Date: 2026-04-14 GPT Summary- ScienceWorldは、小学校の科学カリキュラムに基づき、エージェントの科学的推論能力を評価するための対話型テキスト環境を提供します。従来のモデルは、新しい文脈で学んだ科学概念を推論するのが苦手で、特に未知の材料の伝導率を見つけるための実験方法を問われると苦戦します。これは、モデルが類似例から答えを得ているのか、再利用可能な方法で推論を学んでいるのかという疑問を生み出します。私たちは、エージェントは対話型環境にグラウンディングされることで推論能力を得るべきだと仮定し、150万パラメータのエージェントが10万ステップの対話型訓練を受けた結果、静的訓練を受けた110億パラメータのモデルを上回ることを実証しました。 Comment
ベンチマークの概要は
- Evaluating agents for scientific discovery, Ai2, 2026.04
参照のこと。
[Paper Note] GPT-NeoX-20B: An Open-Source Autoregressive Language Model, Sid Black+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#NLP #LanguageModel #OpenWeight #OpenSource Issue Date: 2026-03-31 GPT Summary- GPT-NeoX-20Bは、200億パラメータを持つ自己回帰型言語モデルで、Pileで訓練され、寛容なライセンスの下で重みが一般公開される。言語理解や数学、知識ベースのタスクで高い性能を持ち、特に5ショット評価時に同規模のモデルより優れた結果を示す。訓練および評価コード、モデルの重みはオープンソースで提供される。 Comment
[Paper Note] BLOOM: A 176B-Parameter Open-Access Multilingual Language Model, BigScience Workshop+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #OpenWeight #OpenSource #One-Line Notes Issue Date: 2026-03-31 GPT Summary- 大規模言語モデル(LLMs)を使い、新しいタスクを少ないデモや指示で実行可能にしたBLOOMを紹介。これは1760億パラメータのオープンアクセス言語モデルで、46の自然言語と13のプログラミング言語をカバー。競争力のある性能を発揮し、マルチタスクのファインチューニングを通じてさらに向上。モデルとコードは責任あるAIライセンスで公開し、今後の研究と応用の促進を目指す。 Comment
HF: https://huggingface.co/bigscience/bloom
透明性を持ったLLMを構築し民主化を図る方向性のパイオニア的研究
[Paper Note] Perceiver: General Perception with Iterative Attention, Andrew Jaegle+, ICLR'22, 2021.03
Paper/Blog Link My Issue
#ComputerVision #NLP #Transformer #MultiModal #SpeechProcessing #Attention #Architecture #ICLR #2D (Image) #audio #text Issue Date: 2026-02-07 GPT Summary- 本研究では、Transformersに基づく「Perceiver」モデルを提案し、生物システムのように多様なモダリティの高次元入力を同時に処理する能力を持つことを示します。従来のモデルが個々のモダリティに特化しているのに対し、Perceiverは少ない仮定で多数の入力を扱い、非対称注意メカニズムを用いて大規模なデータを処理します。これにより、画像や音声などの多様な分類タスクにおいて、先行モデルと同等以上の性能を実現しました。特に、ImageNetでは数十万のピクセルを直接扱い、ResNet-50やViTに匹敵する結果を達成し、AudioSetにおいても競争力を持っています。 Comment
openreview: https://openreview.net/forum?id=fILj7WpI-g
多様なモダリティ入力を単一のモデルで処理しlogitsで出力するtransformer。Perceiver-IOと並んで多様なモダリティを処理可能な先駆け的研究
Perceiverの出力は単純な分類問題を想定しており、より多様なoutputができるように拡張したものがPerceiver-IO:
- [Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
[Paper Note] Flamingo: a Visual Language Model for Few-Shot Learning, Jean-Baptiste Alayrac+, NeurIPS'22, 2022.04
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #MultiModal #NeurIPS #VisionLanguageModel #ImageToTextGeneration Issue Date: 2026-02-06 GPT Summary- 視覚と言語を融合したモデル「Flamingo」は、少数の注釈付き例で新たなタスクに迅速に適応可能。強力な視覚および言語モデルを組み合わせ、シーケンスとして視覚データとテキストを交互に処理し、画像や動画を取り込む柔軟性を持つ。徹底評価により、視覚的質問応答やキャプション作成など多様なタスクへの迅速な適応が確認され、少数ショット学習で新たな最先端を達成した。Flamingoは、多くのベンチマークでファインチューニングモデルを上回る性能を示した。 Comment
openreview: https://openreview.net/forum?id=EbMuimAbPbs
[Paper Note] BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding and Generation, Junnan Li+, ICML'22, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #Pretraining #MultiModal #ICML #VisionLanguageModel Issue Date: 2026-02-06 GPT Summary- 視覚と言語の理解と生成両方に対応する新しいVLPフレームワーク、BLIPを提案。BLIPは、合成キャプション生成とノイズ除去を用いてウェブデータを活用し、視覚と言語タスクで最先端の性能を達成。ゼロショット転送にも優れた一般化能力を示し、幅広いタスクにおいて成果を上げる。 Comment
元ポスト:
以下の3つを組み合わせることで、生成・理解両方のタスクの性能を向上した現在のVLMにつながる内容研究(CLIPは理解に特化していた):
- CLIP likeなimage-captionにおけるconstrastive loss (ITC)
- image-caption matchを二値分類するloss (ITC)
- caption生成におけるnext token prediction loss (LM)
データをクリーンにしさらに性能を改善する方法も提案されている。
[Paper Note] Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time, Mitchell Wortsman+, ICML'22, 2022.03
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NLP #ICML #OOD #Finetuning #Generalization #Encoder #Encoder-Decoder #KeyPoint Notes #Souping Issue Date: 2025-11-28 GPT Summary- ファインチューニングされたモデルの重みを平均化する「モデルスープ」手法を提案し、精度と堅牢性を向上させることを示す。従来のアンサンブル手法とは異なり、追加のコストなしで複数のモデルを平均化でき、ImageNetで90.94%のトップ1精度を達成。さらに、画像分類や自然言語処理タスクにも適用可能で、分布外性能やゼロショット性能を改善することが確認された。 Comment
transformerベースの事前学習済みモデル(encoder-only, encoder-decoderモデル)のファインチューニングの話で、共通のベースモデルかつ共通のパラメータの初期化を持つ、様々なハイパーパラメータで学習したモデルの重みを平均化することでよりロバストで高性能なモデルを作ります、という話。似たような手法にアンサンブルがあるが、アンサンブルでは利用するモデルに対して全ての推論結果を得なければならないため、計算コストが増大する。一方、モデルスープは単一モデルと同じ計算量で済む(=計算量は増大しない)。
スープを作る際は、Validation dataのAccが高い順に異なるFinetuning済みモデルをソートし、逐次的に重みの平均をとりValidation dataのAccが上がる場合に、当該モデルをsoupのingridientsとして加える。要は、開発データで性能が高い順にモデルをソートし、逐次的にモデルを取り出していき、現在のスープに対して重みを平均化した時に開発データの性能が上がるなら平均化したモデルを採用し、上がらないなら無視する、といった処理を繰り返す。これをgreedy soupと呼ぶ。他にもuniform soup, learned soupといった手法も提案され比較されているが、画像系のモデル(CLIP, ViTなど)やNLP(T5, BERT)等で実験されており、greedy soupの性能とロバストさ(OOD;分布シフトに対する予測性能)が良さそうである。
[Paper Note] Video Diffusion Models, Jonathan Ho+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#ComputerVision #DiffusionModel #VideoGeneration/Understandings #3D (Video) Issue Date: 2025-10-17 GPT Summary- 高忠実度で一貫した動画生成のための拡散モデルを提案。画像と動画データを共同でトレーニングし、最適化を加速。新しい条件付きサンプリング技術により、長く高解像度の動画生成で優れた性能を発揮。大規模なテキスト条件付き動画生成タスクでの初期結果と、既存ベンチマークでの最先端結果を示す。 Comment
Surveyはこちら:
- [Paper Note] Video Diffusion Models: A Survey, Andrew Melnik+, TMLR'24, 2024.05
[Paper Note] High-Resolution Image Synthesis with Latent Diffusion Models, Robin Rombach+, CVPR'22, 2021.12
Paper/Blog Link My Issue
#ComputerVision #TextToImageGeneration #VariationalAutoEncoder #CVPR #Encoder-Decoder #ImageSynthesis #U-Net Issue Date: 2025-10-10 GPT Summary- 拡散モデル(DMs)は、逐次的なデノイジングオートエンコーダを用いて画像生成プロセスを効率化し、最先端の合成結果を達成。従来のピクセル空間での訓練に比べ、強力な事前訓練されたオートエンコーダの潜在空間での訓練により、計算リソースを削減しつつ視覚的忠実度を向上。クロスアテンション層を導入することで、テキストやバウンディングボックスに基づく柔軟な生成が可能となり、画像インペインティングや無条件画像生成などで競争力のある性能を発揮。 Comment
ここからtext等による条件付けをした上での生成が可能になった(らしい)
日本語解説:
https://qiita.com/UMAboogie/items/afa67842e0461f147d9b
前提知識:
- [Paper Note] Denoising Diffusion Probabilistic Models, Jonathan Ho+, NeurIPS'20, 2020.06
[Paper Note] Classifier-Free Diffusion Guidance, Jonathan Ho+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#ComputerVision #Transformer #DiffusionModel Issue Date: 2025-10-10 GPT Summary- 分類器ガイダンスは条件付き拡散モデルのポストトレーニング手法で、モードカバレッジとサンプル忠実度のトレードオフを図る。著者は、分類器なしで生成モデルによるガイダンスが可能であることを示し、これを分類器フリーガイダンスと呼ぶ。条件付きおよび無条件の拡散モデルを共同でトレーニングし、サンプル品質と多様性のトレードオフを達成する。 Comment
日本語解説: https://qiita.com/UMAboogie/items/160c1159811743c49d99
[Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#NLP #LanguageModel #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #Safety #PseudoLabeling Issue Date: 2025-09-20 GPT Summary- 本研究では、「憲法的AI」を用いて、人間のラベルなしで無害なAIを訓練する方法を提案。監視学習と強化学習の2フェーズを経て、自己批評と修正を通じてモデルを微調整し、嗜好モデルを報酬信号として強化学習を行う。これにより、有害なクエリに対しても対話できる無害なAIアシスタントを実現し、AIの意思決定の透明性を向上させる。 Comment
(部分的にしか読めていないが)
有害なpromptに対してLLMに初期の応答を生成させ、iterativeにcritiqueとrevisionを繰り返して[^1]、より無害な応答を生成。この方法ではiterationをしながら生成結果が改定されていくので、後段のReward Modelのための嗜好データを生成するフェーズでトークン量を節約するために、生成されたより無害な応答と元となるpromptを用いて、ベースモデルをSFT。これによりベースモデルの出力分布がより無害な応答をするような方向性に調整され、かつ(iterationを繰り返すことなく)直接的により無害な応答を生成できるようになるのでtoken量が節約できる。このフェーズで学習したモデルをSL-CAIと呼ぶ。
続いて、SL-CAIに対して同様の有害なpromptを入力して、複数の応答を生成させる。生成された応答をMultiple Choice Questionの形式にし、Constitutional Principleに基づくpromptingにより、最も望ましい応答をLLMによって選択させることで、嗜好データを獲得する。この嗜好データ(と人手で定義されたhelpfulnessに基づくデータ)を用いてReward Modelを訓練しRLを実施する。
この手法は、嗜好データを人間がラベリングするのではなく、AIによるフィードバックによりラベリングするため、Reinforcement Learning from AI Feedback (RLAIF)と呼ばれる。
Harmfulness以外の分野にも応用可能と考えられる。
[^1]: この操作はモデルの望ましい挙動を人手で定義したルーブリックに基づいた複数のprompt (Constitutional Principles) を用いて実施される。具体的なpromptはAppendix Cを参照。
[Paper Note] Emergent Abilities of Large Language Models, Jason Wei+, TMLR'22
Paper/Blog Link My Issue
#Analysis #NLP #LanguageModel #EmergentAbilities Issue Date: 2025-09-19 GPT Summary- 大規模言語モデルのスケーリングアップは性能を向上させるが、「出現能力」と呼ばれる予測不可能な現象が存在する。これは小型モデルにはない能力であり、さらなるスケーリングがモデルの能力を拡大する可能性を示唆している。 Comment
openreview: https://openreview.net/forum?id=yzkSU5zdwD
創発能力(最近この用語を目にする機会が減ったような気がする)
[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
Paper/Blog Link My Issue
#Pretraining #NLP #LanguageModel #ACL #Deduplication Issue Date: 2025-09-04 GPT Summary- 既存の言語モデルデータセットには重複した例が多く含まれ、訓練されたモデルの出力の1%以上が訓練データからコピーされている。これを解決するために、重複排除ツールを開発し、C4データセットからは60,000回以上繰り返される文を削除。重複を排除することで、モデルの記憶されたテキスト出力を10倍減少させ、精度を維持しつつ訓練ステップを削減。また、訓練とテストの重複を減らし、より正確な評価を実現。研究の再現とコードは公開されている。 Comment
下記スライドのp.9にまとめが記述されている:
https://speakerdeck.com/takase/snlp2023-beyond-neural-scaling-laws?slide=9
[Paper Note] A ConvNet for the 2020s, Zhuang Liu+, arXiv'22
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #Backbone Issue Date: 2025-08-29 GPT Summary- ConvNetはVision Transformersの登場により地位を失ったが、ハイブリッドアプローチの効果はトランスフォーマーの優位性に依存している。本研究では、ConvNetの限界をテストし、ConvNeXtという新しいモデルを提案。ConvNeXtは標準的なConvNetモジュールのみで構成され、精度とスケーラビリティでトランスフォーマーと競争し、ImageNetで87.8%の精度を達成し、COCO検出およびADE20KセグメンテーションでSwin Transformersを上回る。 Comment
ConvNeXt
[Paper Note] Matryoshka Representation Learning, Aditya Kusupati+, NeurIPS'22
Paper/Blog Link My Issue
#Embeddings #NLP #RepresentationLearning #NeurIPS #Length #Reference Collection Issue Date: 2025-07-29 GPT Summary- マトリョーシカ表現学習(MRL)は、異なる計算リソースに適応可能な柔軟な表現を設計する手法であり、既存の表現学習パイプラインを最小限に修正して使用します。MRLは、粗から細への表現を学習し、ImageNet-1K分類で最大14倍小さい埋め込みサイズを提供し、実世界のスピードアップを実現し、少数ショット分類で精度向上を達成します。MRLは視覚、視覚+言語、言語のモダリティにわたるデータセットに拡張可能で、コードとモデルはオープンソースで公開されています。 Comment
日本語解説: https://speakerdeck.com/hpprc/lun-jiang-zi-liao-matryoshka-representation-learning
単一のモデルから複数のlengthのEmbeddingを出力できるような手法。
解説:
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#NLP #LanguageModel #PEFT(Adaptor/LoRA) #ICLR #PostTraining #One-Line Notes Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] LAION-5B: An open large-scale dataset for training next generation image-text models, Christoph Schuhmann+, NeurIPS'22
Paper/Blog Link My Issue
#ComputerVision #Pretraining #NLP #Dataset #MultiModal #CLIP #NeurIPS #read-later Issue Date: 2025-05-06 GPT Summary- LAION-5Bは、5.85億のCLIPフィルタリングされた画像-テキストペアから成る大規模データセットで、英語のペアが2.32B含まれています。このデータセットは、CLIPやGLIDEなどのモデルの再現とファインチューニングに利用され、マルチモーダルモデルの研究を民主化します。また、データ探索やサブセット生成のためのインターフェースや、コンテンツ検出のためのスコアも提供されます。 Comment
openreview: https://openreview.net/forum?id=M3Y74vmsMcY
[Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#MachineLearning #NLP #LanguageModel #NeurIPS #Scaling Laws #One-Line Notes Issue Date: 2025-03-23 GPT Summary- トランスフォーマー言語モデルの訓練において、計算予算内で最適なモデルサイズとトークン数を調査。モデルサイズと訓練トークン数は同等にスケールする必要があり、倍増するごとにトークン数も倍増すべきと提案。Chinchillaモデルは、Gopherなどの大規模モデルに対して優れた性能を示し、ファインチューニングと推論の計算量を削減。MMLUベンチマークで67.5%の精度を達成し、Gopherに対して7%以上の改善を実現。 Comment
OpenReview: https://openreview.net/forum?id=iBBcRUlOAPR
chinchilla則、モデルの規模とデータ量はおおむね同じ比率でスケールすべき、という話。
[Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #NLP #Transformer #Architecture #MoE(Mixture-of-Experts) #JMLR Issue Date: 2025-02-11 GPT Summary- Switch Transformerを提案し、Mixture of Experts (MoE)の複雑さや通信コスト、トレーニングの不安定性を改善。これにより、低精度フォーマットでの大規模スパースモデルのトレーニングが可能になり、最大7倍の事前トレーニング速度向上を実現。さらに、1兆パラメータのモデルを事前トレーニングし、T5-XXLモデルに対して4倍の速度向上を達成。