
Dataset (549) — 3/3
[Paper Note] Biomedical Data-to-Text Generation via Fine-Tuning Transformers, Ruslan Yermakov+, ACL-INLG'21, 2021.09
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #ACL #INLG #One-Line Notes Issue Date: 2022-08-18 GPT Summary- バイオメディカル分野におけるD2T生成の研究を行い、医薬品のパッケージリーフレットを用いた実世界のデータセットに対してファインチューニングされたトランスフォーマーを適用。現実的な複数文のテキスト生成が可能であることを示す一方で、重要な制限も存在。新たにバイオメディカル分野のD2T生成モデルのベンチマーク用データセット(BioLeaflets)を公開。 Comment
biomedical domainの新たなdata2textデータセットを提供。事前学習済みのBART, T5等をfinetuningすることで高精度にテキストが生成できることを示した。
[Paper Note] WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, Hiroaki Hayashi+, TACL'21, 2020.11
Paper/Blog Link My Issue
#DocumentSummarization #Tutorial #NLP #TACL #KeyPoint Notes Issue Date: 2021-10-20 GPT Summary- オープンドメインのアスペクトベース要約のために、20の異なるドメインのWikipedia記事を用いたマルチドメイン対応データセットWikiAspを提案。各記事のセクションタイトルをアスペクト注釈の指標とし、実験を通じて既存モデルの主要な課題を明らかにした。 Comment
NLPコロキウムをリアルタイムに聴講
◆Aspect-based summarizationのモチベーション
・same source対して、異なるユーザニーズが存在するので、ニーズに関して要約したい
◆Aspect: あるobjectに対する、attributeのようなものを指定?
object: Attention Is All You Need
aspect: Multi-Head Attention
◆Aspect Based Summarizationの歴史
・はじめは”feature”という文言で研究され(04年頃?)
・続いて*keywords*という単語で研究され
・その後Aspectという文言で研究されるようになった
・2008年頃にMcDonaldsらがAspect-Based Summarizationを提案した
・2014年以後?とかにNeural Basedな手法が盛んに研究
◆WikiAspデータセットについて
・Wikipediaを使ったAspect-based dataset
・Wikipediaを書かれるのに利用されたsource document(wikipediaにソースとして引用されているもの)に対し、aspectを各節の見出しとみなし、節のテキストを要約文とみなすことで、データセット生成
・他のAspect-basedデータセットと異なり、ソースデータが長く、要約長も5~6倍程度
・ドメイン数が他データセットは5,6程度に対し、20と膨大
◆ベースラインとして2-stageモデルを採用
first-stage: ソーステキストからROBERTaベースドなclassifierを用いて、sentencesから内包するAspectを閾値を用いて決定
それらをgrouped sentencesとする
two-stage: 各aspectごとにまとまったテキスト集合に対して、要約モデルを適用し、要約を実施する
・要約モデルはUnsupervisedな手法であるTextRankと、Supervisedな手法であるBERTベースな手法を採用
・ドメインごとに評価した結果を見ると、BERTが強いドメインがある一方で、TextRankが強いドメインもあった
-> Extractiveな形で要約されているドメインではTextRankが強く、Abstractiveに要約されているドメインではBERTが強い
-> またBERTは比較的短い要約であればTextRankよりもはるかに良いが、長い要約文になるとTextRankとcomprable(あるいはTextRankの方が良い)程度の性能になる
・ROUGE-2の値がsentence-basedなORACLEを見た時に、他データセットと比較して低いので、Abstractiveな手法が必要なデータセット?
(後からのメモなので少しうろ覚えな部分あり)
Q. ROUGE-2が30とかって直観的にどのくらいのレベルのものなの?ROUGE-2が30とか40とかは高い
・最先端の要約モデルをニュース記事に適用すると、35~40くらいになる。
・このレベルの数値になると、人間が呼んでも違和感がないレベルの要約となっている
Q. 実際に要約文をチェックしてみて、どういう課題を感じるか?
A. Factual Consistencyがすぐに目につく問題で、特にBERTベースな要約文はそう。TextRankはソース文書がノイジーなので、ソース文章を適当に拾ってきただけではFactual Consistencyが良くない(元の文書がかっちりしていない)。流暢性の問題はAbstractiveモデルだと特に問題なくBERT-baseでできる。Aspect-based要約のエラー例としてAspectに則っていないということがある。たとえばオバマの大統領時代の話をきいているのに、幼少時代の話をしているとか。Aspect情報をうまくモデルを扱えていないという点が課題としてある。
出典元(リアルタイムに聴講): 第13回 WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, NLPコロキウム
https://youtu.be/3PIJotX6i_w?si=hX5pXwNL-ovkGSF5
[Paper Note] BLiMP: The Benchmark of Linguistic Minimal Pairs for English, Alex Warstadt+, TACL'20
Paper/Blog Link My Issue
#NLP #Evaluation #TACL #Grammar Issue Date: 2025-09-07 GPT Summary- 言語的最小対のベンチマーク(BLiMP)は、言語モデルの文法知識を評価するためのチャレンジセットで、67のサブデータセットから成り、各サブデータセットには特定の文法対比を示す1000の最小対が含まれています。データは専門家によって自動生成され、人間の合意は96.4%です。n-gram、LSTM、Transformerモデルを評価した結果、最先端のモデルは形態論的対比を識別できるが、意味的制約や微妙な文法現象には苦戦していることが示されました。 Comment
先行研究と比較して、より広範なlinguistic phenomenaを扱い、かつ大量のサンプルを集めた英語のacceptable/unacceptableなsentenceのペアデータ。ペアデータは特定のlinguistic phenomenaをacceptable/unacceptableに対比するための最小の違いに基づいており専門家が作成したテンプレートに基づいて自動生成され、クラウドソーシングによって人手でvalidationされている。言語モデルが英語のlinguistic phenomenaについて、どの程度理解しているかのベンチマークに利用可能。
[Paper Note] CommonGen: A Constrained Text Generation Challenge for Generative Commonsense Reasoning, Bill Yuchen Lin+, EMNLP'20 Findings
Paper/Blog Link My Issue
#NaturalLanguageGeneration #NLP #Evaluation #Composition #EMNLP #Findings #CommonsenseReasoning Issue Date: 2025-07-31 GPT Summary- 生成的常識推論をテストするためのタスクCommonGenを提案し、35,000の概念セットに基づく79,000の常識的記述を含むデータセットを構築。タスクは、与えられた概念を用いて一貫した文を生成することを求め、関係推論と構成的一般化能力が必要。実験では、最先端モデルと人間のパフォーマンスに大きなギャップがあることが示され、生成的常識推論能力がCommonsenseQAなどの下流タスクに転送可能であることも確認。 Comment
ベンチマークの概要。複数のconceptが与えられた時に、それらconceptを利用した常識的なテキストを生成するベンチマーク。concept間の関係性を常識的な知識から推論し、Unseenなconceptの組み合わせでも意味を構成可能な汎化性能が求められる。
PJ page: https://inklab.usc.edu/CommonGen/
[Paper Note] Measuring Massive Multitask Language Understanding, Dan Hendrycks+, arXiv'20, 2020.09
Paper/Blog Link My Issue
#NLP #LanguageModel #Evaluation #ICLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-24 GPT Summary- 新しいテストを提案し、57のマルチタスクを用いてテキストモデルの正確度を測定。高い正確度には広範な世界知識と問題解決能力が必要である。GPT-3モデルはランダム推測を約20ポイント上回るが、専門家レベルには遠く、多くのタスクで偏った性能を示す。特に道徳や法に関してはほぼランダムに近い正確度を記録。このテストはモデルの理解力を評価し、重要な欠点を明らかにすることを目的とする。 Comment
OpenReview: https://openreview.net/forum?id=d7KBjmI3GmQ
MMLU論文
- [Paper Note] Are We Done with MMLU?, Aryo Pradipta Gema+, NAACL'25
において、多くのエラーが含まれることが指摘され、再アノテーションが実施されている。
[Paper Note] ReFusion: 3D Reconstruction in Dynamic Environments for RGB-D Cameras Exploiting Residuals, Emanuele Palazzolo+, IROS'19, 2019.05
Paper/Blog Link My Issue
#ComputerVision #Evaluation #Robotics #IROS Issue Date: 2025-11-20 GPT Summary- 動的要素を含むシーンのマッピングとローカリゼーションのために、RGB-Dセンサーを用いた新しいアプローチを提案。TSDFに基づく効率的なトラッキングを行い、色情報を利用してセンサーのポーズを推定。動的要素の検出には残差と自由空間のモデリングを活用。実験により、提案手法が最先端の密SLAM手法を上回る性能を示し、データセットも公開。オープンソースコードも提供。
Natural Questions: A Benchmark for Question Answering Research, Kwiatkowski+, TACL'19
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Evaluation #Factuality #ReadingComprehension Issue Date: 2025-08-16 GPT Summary- Natural Questionsコーパスは、Google検索エンジンからの実際の匿名化されたクエリを基にした質問応答データセットで、307,373のトレーニング例と7,830の開発例、7,842のテスト例が含まれています。アノテーターは、質問に対してWikipediaページから長い回答と短い回答を注釈し、質の検証実験や人間の変動性に関する分析を行っています。また、質問応答システムの評価のためのメトリクスを導入し、競争的手法を用いてベースライン結果を確立しています。
[Paper Note] Stereo Magnification: Learning View Synthesis using Multiplane Images, Tinghui Zhou+, SIGGRAPH'18, 2018.05
Paper/Blog Link My Issue
#ComputerVision #Evaluation #SIGGRAPH Issue Date: 2025-11-20 GPT Summary- 視点合成問題において、狭ベースラインのステレオカメラから新しい視点を生成する手法を提案。マルチプレーン画像(MPI)を用いた学習フレームワークを構築し、YouTube動画をデータソースとして活用。これにより、入力画像ペアからMPIを予測し、従来の手法よりも優れた視点外挿を実現。 Comment
[Paper Note] TextWorld: A Learning Environment for Text-based Games, Marc-Alexandre Côté+, Workshop on Computer Games'18 Held in Conjunction with IJCAI'18, 2018.06
Paper/Blog Link My Issue
#MachineLearning #NLP #ReinforcementLearning #Evaluation #IJCAI #Workshop #Game #text Issue Date: 2025-10-26 GPT Summary- TextWorldは、テキストベースのゲームにおける強化学習エージェントのトレーニングと評価のためのサンドボックス環境であり、ゲームのインタラクティブなプレイを処理するPythonライブラリを提供します。ユーザーは新しいゲームを手作りまたは自動生成でき、生成メカニズムによりゲームの難易度や言語を制御可能です。TextWorldは一般化や転移学習の研究にも利用され、ベンチマークゲームのセットを開発し、いくつかのベースラインエージェントを評価します。 Comment
[Paper Note] Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge, Peter Clark+, arXiv'18
Paper/Blog Link My Issue
#NLP #QuestionAnswering Issue Date: 2025-08-30 GPT Summary- AI2 Reasoning Challenge(ARC)を提案し、高度な質問応答におけるAI研究を促進することを目的とする。ARCはChallenge SetとEasy Setに分かれ、Challenge Setにはリトリーバルベースのアルゴリズムで不正解とされた質問が含まれる。ARCは最大の公的ドメインセットであり、1400万の科学文を含むコーパスと3つのニューラルベースラインモデルの実装も公開。既存のモデルはランダムベースラインを上回れず、コミュニティへの挑戦としてARCを提起。 Comment
dataset:
https://huggingface.co/datasets/allenai/ai2_arc
日本語解説:
https://qiita.com/tekunikaruza_jp/items/d2ec3621afc9ba3d225b
Learning to Generate Move-by-Move Commentary for Chess Games from Large-Scale Social Forum Data, Jhamtani+, ACL'18
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #DataToTextGeneration #TabularData #ACL #Encoder-Decoder Issue Date: 2025-08-06 Comment
データセットの日本語解説(過去の自分の資料): https://speakerdeck.com/akihikowatanabe/data-to-text-datasetmatome-summary-of-data-to-text-datasets?slide=66
[Paper Note] Newsroom: A Dataset of 1.3 Million Summaries with Diverse Extractive Strategies, Max+, NAACL'18
Paper/Blog Link My Issue
#DocumentSummarization #NLP #NAACL #KeyPoint Notes Issue Date: 2018-06-29 GPT Summary- NEWSROOMは、38の主要なニュース出版物から収集された130万件の記事と要約のデータセットで、1998年から2017年のメタデータを基にしています。要約は、抽象的および抽出的な戦略を組み合わせており、その多様性を示しています。本研究では、NEWSROOMの抽出戦略を他データセットと比較し、新たなデータの多様性と難易度を評価しました。また、既存の手法を用いてデータ上で訓練し、その有用性と課題を明らかにしました。このデータセットはsummari.esで公開されています。 Comment
文書要約に使用可能なデータセット
38の出版元からデータを収集し、サイズは1.3M article程度
既存のデータセットと比較すると、Coverageが高く生成的なものを多く含むことが特徴
詳細は:
https://summari.es
[Paper Note] Tanks and temples: Benchmarking large-scale scene reconstruction, Knapitsch+, TOG'17
Paper/Blog Link My Issue
#ComputerVision #Evaluation #TOG Issue Date: 2025-11-20 GPT Summary- 画像ベースの3D再構築のための新しいベンチマークを提案。実際の条件下で取得された高解像度ビデオシーケンスを用い、産業用レーザースキャナーでキャプチャしたグラウンドトゥルースデータを含む。屋外と屋内のシーンを対象に、再構築の忠実度向上を目指す新しいパイプラインの開発を支援し、既存の3D再構築手法の性能を報告。結果は今後の研究の課題と機会を示唆。
[Paper Note] A Multi-view Stereo Benchmark with High-Resolution Images and Multi-camera Videos, Schöps+, CVPR'17
Paper/Blog Link My Issue
#ComputerVision #Evaluation #CVPR Issue Date: 2025-11-20 GPT Summary- 新しいマルチビュー立体視データセットを提案し、高精度のレーザースキャナーと低解像度のステレオビデオを用いて多様なシーンを記録。幾何学に基づく手法で画像とレーザースキャンを整合。従来のデータセットとは異なり、自然および人工環境をカバーし、高解像度のデータを提供。データセットは手持ちのモバイルデバイスの使用ケースにも対応し、オンライン評価サーバーで利用可能。
[Paper Note] ScanNet: Richly-annotated 3D Reconstructions of Indoor Scenes, Angela Dai+, CVPR'17, 2017.02
Paper/Blog Link My Issue
#ComputerVision #Evaluation #CVPR Issue Date: 2025-11-20 GPT Summary- 限られたRGB-Dシーン理解のために、1513シーンの2.5Mビューを含むScanNetデータセットを導入。自動表面再構築とクラウドソースによるセマンティックアノテーションを用いたキャプチャシステムを設計し、3Dオブジェクト分類やセマンティックボクセルラベリングで最先端のパフォーマンスを達成。データセットは無料で提供。
[Paper Note] Zero-Shot Relation Extraction via Reading Comprehension, Omer Levy+, CoNLL'17, 2017.06
Paper/Blog Link My Issue
#NeuralNetwork #InformationExtraction #ReadingComprehension #Zero/FewShotLearning #CoNLL #KnowledgeEditing #FactualKnowledge #RelationExtraction Issue Date: 2025-08-26 GPT Summary- 関係抽出を自然言語の質問に還元することで、ニューラル読解理解技術を活用し、大規模なトレーニングセットを構築可能にする。これにより、ゼロショット学習も実現。ウィキペディアのスロットフィリングタスクで、既知の関係タイプに対する高精度な一般化と未知の関係タイプへのゼロショット一般化が示されたが、後者の精度は低く、今後の研究の基準を設定。 Comment
Knowledge Editingのベンチマークとしても利用される
[Paper Note] TriviaQA: A Large Scale Distantly Supervised Challenge Dataset for Reading Comprehension, Mandar Joshi+, ACL'17
Paper/Blog Link My Issue
#NLP #QuestionAnswering #Factuality #ReadingComprehension Issue Date: 2025-08-16 GPT Summary- TriviaQAは、650K以上の質問-回答-証拠トリプルを含む読解理解データセットで、95Kの質問-回答ペアと平均6つの証拠文書を提供。複雑な質問や構文的変動があり、文を超えた推論が必要。特徴ベースの分類器と最先端のニューラルネットワークの2つのベースラインアルゴリズムを評価したが、人間のパフォーマンスには及ばず、TriviaQAは今後の研究における重要なテストベッドである。
[Paper Note] NewsQA: A Machine Comprehension Dataset, Adam Trischler+, RepL4NLP'17, 2016.11
Paper/Blog Link My Issue
#NLP #QuestionAnswering #ReadingComprehension #KeyPoint Notes #needs-revision Issue Date: 2023-11-19 GPT Summary- NewsQAは10万件以上の人間生成の質問・回答ペアからなる機械読解データセットで、CNNの10,000件以上のニュース記事を基にクラウドワーカーによって構築されました。データセットは、推論を必要とする探索的な質問を引き出す4段階プロセスで収集され、単純な語彙一致やテキスト含意を超えた能力が要求されます。人間のパフォーマンスと強力なニューラルモデルとの比較により、F1でのパフォーマンス差(0.198)が示され、将来の研究における顕著な進歩の可能性を示唆しています。データセットは自由に利用可能です。 Comment
SQuADよりも回答をするために複雑な推論を必要とするQAデータセット。規模感はSQuADと同等レベル。
WordMatchingにとどまらず、回答が存在しない、あるいは記事中でユニークではないものも含まれる。
[Paper Note] Construction of a Japanese Word Similarity Dataset, Yuya Sakaizawa+, arXiv'17, 2017.03
Paper/Blog Link My Issue
#Embeddings #NLP #RepresentationLearning #STS (SemanticTextualSimilarity) #Japanese #One-Line Notes Issue Date: 2023-07-31 GPT Summary- 日本語の分散表現評価のために、語の類似度データセットを構築。これが日本語分散表現評価の初の資源であり、一般語と稀少語の両方を含む様々な品詞を網羅。 Comment
github:
https://github.com/tmu-nlp/JapaneseWordSimilarityDataset
単語レベルの類似度をベンチマーキングしたい場合は使ってもよいかも。
[Paper Note] Characterizing Online Discussion Using Coarse Discourse Sequences, Zhang+, ICWSM'17, (Reddit Coarse Discourse data), 2017.05
Paper/Blog Link My Issue
#NLP #Discourse #ICWSM #KeyPoint Notes Issue Date: 2018-01-19 Comment
RedditのDiscussion Forumに9種類のDiscourse Actsを付与したデータ。
データを作成する際は、以下の処理を適用:
* Google Big Query dump のRedditデータ238Mスレッド
* それにReply Filterをかけ87.5Mスレッド
* さらにそこからスレッドサンプリングやヒューリスティクなフィルタをかけて10000スレッドに絞り込んだ
* これらにDiscourse Actsが付与されており、それぞれのコメントに対して9種類のカテゴリ(QUESTION(質問), ANSWER(回答), ANNOUNCEMENT(情報発信), AGREEMENT(意見に対する同意, APPRECIATION (感謝)など)が付与されている。
コーパスを作成するときは、3人のアノテータを用い、複数のACTを付与することを許し、OTHERも許容。
Discourse Actsをどれだけ判定できるかのモデルも構築しており、loggistic regression + L2 regularization, Hidden Markov Model, Conditional Random Fieldsなどを用い、素性はContent-based (unigram, bigram, tf-idfなど), Structure-based (treeのdepth, # of sentencde, wordなど), Author-based (一番最初の投稿者と同じか、親と同じ投稿者かなど), Community (subreddit name (カテゴリ名))などを用いている。
CRFを適用する際は、スレッドのTreeのブランチを系列とみなす。基本的にCRFが一番よく、F値で0.75程度。
[Paper Note] Large-Scale Data for Multiple-View Stereopsis, Aanæs+, IJCV'16
Paper/Blog Link My Issue
#ComputerVision #Evaluation #IJCV Issue Date: 2025-11-20
[Paper Note] Neural Text Generation from Structured Data with Application to the Biography Domain, Remi Lebret+, EMNLP'16, 2016.03
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #NLP #ConceptToTextGeneration #EMNLP #Encoder-Decoder #KeyPoint Notes Issue Date: 2017-12-31 GPT Summary- 大規模なWikipediaの伝記データセットを用いて、テキスト生成のためのニューラルモデルを提案。モデルは条件付きニューラル言語モデルに基づき、固定語彙とサンプル固有の単語を組み合わせるコピーアクションを採用。提案モデルは古典的なKneser-Neyモデルを約15 BLEUポイント上回る性能を示した。 Comment
Wikipediaの人物に関するinfo boxから、その人物のbiographyの冒頭を生成するタスク。
Neural Language Modelに、新たにTableのEmbeddingを入れられるようにtable embeddingを提案し、table conditioned language modelを提案している。
inputはテーブル(図中のinput textっていうのは、少し用語がconfusingだが、言語モデルへのinputとして、過去に生成した単語の系列を入れるというのを示しているだけ)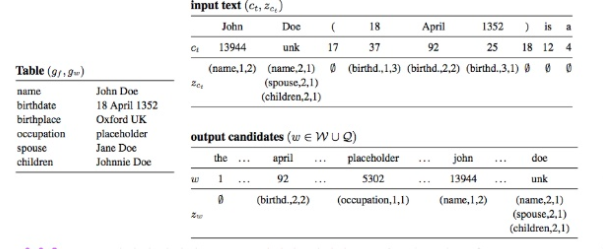
モデル全体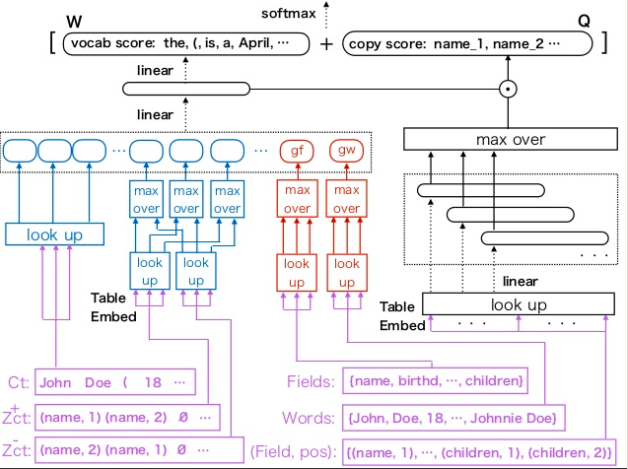
Wikipediaから生成した、Biographyに関するデータセットも公開している。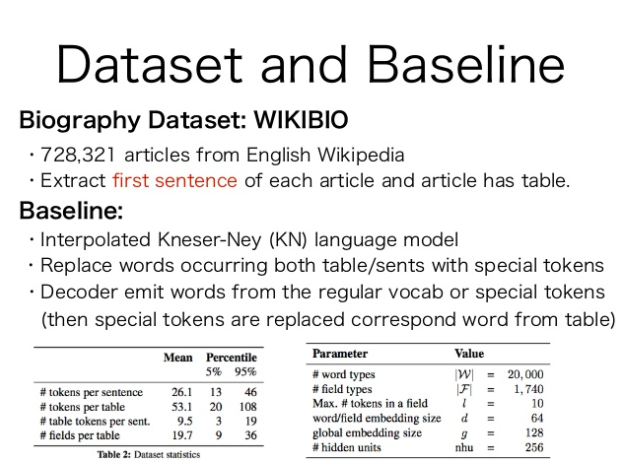
template basedなKNSmoothingを使ったベースラインよりも高いBLEUスコアを獲得。さらに、テーブルのGlobalな情報を入れる手法が、性能向上に寄与(たとえばチーム名・リーグ・ポジションなどをそれぞれ独立に見ても、バスケットボールプレイヤーなのか、ホッケープレイヤーなのかはわからないけど、テーブル全体を見ればわかるよねという気持ち)。
[Paper Note] LCSTS: A Large Scale Chinese Short Text Summarization Dataset, Baotian Hu+, EMNLP'15, 2015.06
Paper/Blog Link My Issue
#Single #DocumentSummarization #NeuralNetwork #Sentence #Document #NLP #Abstractive #EMNLP #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2017-12-28 GPT Summary- 中国のマイクロブログSina Weiboから構築した200万以上の短文とその要約からなる大規模コーパスを紹介。手動でタグ付けされた10,666の要約を用いて、再帰型ニューラルネットワークを導入し、有望な要約生成結果を達成。提案コーパスは短文要約研究に有用であり、さらなる研究のベースラインを提供。 Comment
Large Chinese Short Text Summarization (LCSTS) datasetを作成
データセットを作成する際は、Weibo上の特定のorganizationの投稿の特徴を利用。
Weiboにニュースを投稿する際に、投稿の冒頭にニュースのvery short summaryがまず記載され、その後ニュース本文(短め)が記載される特徴があるので、この対をsource-reference対として収集した。
収集する際には、約100個のルールに基づくフィルタリングやclearning, 抽出等を行なっている。
データセットのpropertyとしては、下記のPartI, II, IIIに分かれている。
PartI: 2.4Mのshort text - summary pair
PartII: PartIからランダムにサンプリングされた10kのpairに対して、5 scaleで要約のrelevanceをratingしたデータ。ただし、各pairにラベルづけをしたevaluatorは1名のみ。
PartIII: 2kのpairに対して(PartI, PartIIとは独立)、3名のevaluatorが5-scaleでrating。evaluatorのratingが一致した1kのpairを抽出したデータ。
RNN-GRUを用いたSummarizerも提案している。
CopyNetなどはLCSTSを使って評価している。他にも使ってる論文あったはず。
ACL'17のPointer Generator Networkでした。
[Paper Note] Query-Chain Focused Summarization, Baumel+, ACL'14
Paper/Blog Link My Issue
#Multi #DocumentSummarization #NLP #QueryBiased #Extractive #ACL #Selected Papers/Blogs #Surface-level Notes Issue Date: 2017-12-28 Comment
(管理人が作成した過去の紹介資料)
[Query-Chain Focused Summarization.pdf](https://github.com/AkihikoWatanabe/paper_notes/files/1590916/Query-Chain.Focused.Summarization.pdf)
上記スライドは私が当時作成した論文紹介スライドです。スライド中のスクショは説明のために論文中のものを引用しています。
[Paper Note] Scene Coordinate Regression Forests for Camera Relocalization in RGB-D Images, Shotton+, CVPR'13
Paper/Blog Link My Issue
#ComputerVision #Evaluation #CVPR #CameraPoseEstimation Issue Date: 2025-11-20
[Paper Note] Scene Coordinate Regression Forests for Camera Relocalization in RGB-D Images,Shotton+, CVPR'13
Paper/Blog Link My Issue
#ComputerVision #Evaluation #CVPR Issue Date: 2025-11-20
[Paper Note] Indoor Segmentation and Support Inference from RGBD Images, Silberman+, ECCV'12
Paper/Blog Link My Issue
#ComputerVision #Evaluation #ECCV Issue Date: 2025-11-20 GPT Summary- RGBD画像を用いて、散らかった屋内シーンの主要な表面や物体、支持関係を解析するアプローチを提案。物理的相互作用を考慮し、3Dの手がかりが構造化された解釈に与える影響を探求。新たに1449のRGBD画像からなるデータセットを作成し、支持関係の推測能力を実験で検証。3D手がかりと推測された支持が物体セグメンテーションの向上に寄与することを示す。
[Paper Note] A naturalistic open source movie for optical flow evaluation, Butler+, ECCV'12
Paper/Blog Link My Issue
#ComputerVision #Evaluation #ECCV Issue Date: 2025-11-20 Comment
dataset: https://www.kaggle.com/datasets/artemmmtry/mpi-sintel-dataset
[Paper Note] ImageNet: A Large-Scale Hierarchical Image Database, Deng+, CVPR'09
Paper/Blog Link My Issue
#ComputerVision #Selected Papers/Blogs #ImageClassification #ObjectRecognition #ObjectLocalization Issue Date: 2025-05-13
[Paper Note] AutoBenchmark: benchmark creation & the role of humans, Seungone+, 2026.09
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #read-later #Selected Papers/Blogs #autoresearch/RSI #Author Thread-Post Issue Date: 2026-10-01 Comment
元ポスト:
FineEnvs: Open Source RL Environments for LLM Agents, Adithya S Kolavi, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #Repository #SmallModel #PostTraining #One-Line Notes #Environment Issue Date: 2026-09-25 Comment
元ポスト:
SLMのcoding, datascience向けの
(いわゆるSmolな)RL学習用の5k+のverifiableなタスクデータ、Environment、評価、学習のコードを提供。
従来の初心者向けのチュートリアルでは、GSM8Kのような既に飽和したデータセットが主なデータであり、より実用的なデータに基づいたRLVRのための環境を整えた、という感じに見える。
grug-moe-mix-swarm, marin-community, 2026.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #MoE(Mixture-of-Experts) #Selected Papers/Blogs #DataMixture #One-Line Notes #Reading Reflections #Author Thread-Post Issue Date: 2026-09-24 Comment
元ポスト:
Marinの535B級のMoEモデルを学習した際のデータであり、利用されたツール(クラスタリングに利用されたモデル)も公開されている。
元ポスト中にデータ構築の手順が紹介されており、
- 学習が許可された152の公開データから、25Tトークンを利用
- deduplicationによる2.13T tokensを除外し
- 評価データとの重複を避けるために13-gramによるフィルタリングを実施し
- 特定の分野のデータ等をサンプリングしたいが、その際にソースではなくドキュメントの内容でグルーピングしたいので、embeddingに基づいてクラスタリングを実施し、200のクラスタを形成した
といった話が紹介されている。
LLM-jpではOpenSourceであるために、徹底的にデータセット内部まで精査をして、問題のあるインスタンスの修正等が実施されていたが、Marinではこのような取り組みは行われているのだろうか。特に、データセットに付与されているライセンスがオープンソースである場合でも、データセット、あるいはデータセット中のサンプルの出自を辿るとオープンソースとは呼べないものが存在するという話がある。
- 約12兆トークンの良質なコーパスで学習した新たな国産LLM「LLM-jp-4 8Bモデル」「LLM-jp-4 32B-A3Bモデル」をオープンソースライセンスで公開 ~一部ベンチマークでGPT-4oやQwen3-8Bを上回る性能を達成~, NII, 2026.04
- LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Marinコミュニティにおける"Open"の意味を読むと、Open Sourceの定義を満たすことを目指しているというより、weightを公開するだけではなく、その他の構築に関わる全ての情報を公開する、たとえば学習データであれば全データのソースを開示する、という開発プロセス全体を公開しますよ、という意味に見えるため、ライセンス的に問題のあるインスタンスの削除などは行われていないのかもしれない、が、Marinプロジェクトの公開されている全ての議論の中にそういった話題は存在するかもしれないので実際のところは一次ソースを当たらないとよくわからない。
https://marin.community
Contrastive Language Models: A System One Model for Fast and Generalizable Decision-Making, Kwok+, 2026.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #ContrastiveLearning #Blog #OpenWeight #Scaling Laws #mid-training #PostTraining #Selected Papers/Blogs #Encoder #Author Thread-Post #SystemOneModel Issue Date: 2026-09-24 Comment
元ポスト:
HF: https://huggingface.co/Contrastive-LM
非常にコンパクトにまとまっていて大変読みやすかった。あとでまとめる。
Reinforcing Agents with Collective Skills, Xu+, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #ReinforcementLearning #AIAgents #Environment #Author Thread-Post Issue Date: 2026-09-23 Comment
元ポスト:
dataset, env: https://hub.harborframework.com/datasets/skill2env/skill2env
cua-s1-forms, cua-ai, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Transformer #SyntheticData #OpenWeight #ComputerUse #Encoder #One-Line Notes #Author Thread-Post Issue Date: 2026-09-19 Comment
github:
https://github.com/trycua/cua/tree/main/libs/cua-s1
dataset:
https://huggingface.co/datasets/cua-ai/cua-s1-forms
元ポスト:
フォーム入力に特化したCUAを実施できるモデルのようで、これもいわゆるSystem One Modelとして紹介されている。Transformer Encoderをバックボーンとする。
まあしかしこれは言ってしまえばただの合成データでFinetuningをしたBERTに見える。Jevのような様々なタスクに対してzero-shotの汎化をしめすものではないであろう点に注意。Jevがどれだけ汎用なのかはわからんが...
Automation’s Early Footprint: Where AI Agents Are (and Aren’t) Being Built, Cohere, 2026.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Blog #read-later Issue Date: 2026-09-07 Comment
元ポスト:
LLM-jp-4-VL 9Bリリース, LLM-jp, 2026.09
Paper/Blog Link My Issue
#Article #ComputerVision #Pretraining #NLP #OpenWeight #Japanese #OpenSource #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2026-09-06 Comment
元ポスト:
モデル: https://huggingface.co/llm-jp/llm-jp-4-vl-9b
RefinedVision:
https://huggingface.co/datasets/llm-jp/RefinedVision
OpenSource AIの定義を満たすためにFineVisionデータセットを精査(e.g. GPT-4oの出力等は利用規約上問題がある)した上で修正(FineVisionは185サブセット, 24M VQAで構成されている)したとのこと。すごい。。。
ライセンス・利用規約上の問題を精査するだけでなく、品質(画像の品質、QAの品質)の観点でも精査の上修正しているようである。
関連:
- [Paper Note] FineVision: Open Data Is All You Need, Luis Wiedmann+, NeurIPS'26, 2025.09
text-to-speech-human-preferences-315k, Datapoint AI, 2026.09
Paper/Blog Link My Issue
#Article #SpeechProcessing #audio #Initial Impression Notes #Author Thread-Post Issue Date: 2026-09-06 Comment
元ポスト:
カスタマーサポートドメインにおける、TTSに対する人間による300kを超えるpreferenceのアノテーションがされたデータセットとのこと。データセットは英語に対する15種類のモデルに対するTTSに対して、アノテーションが実施されたもののようである。
EgoSuite-Open100K, LightwheelAI, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Robotics #3D (Video) #EmbodiedAI #EgocentricView #Author Thread-Post Issue Date: 2026-08-22 Comment
pj page: https://egosuite100k.lightwheel.ai/
元ポスト:
LeRobotフォーマットとのこと
- [Paper Note] LeRobot: An Open-Source Library for End-to-End Robot Learning, Remi Cadene+, ICLR'26, 2026.02
- LeRobot Humanoid: An Open, Low-Cost, 3D-Printed Humanoid for Robot Learning, LeRobot, 2026.05
text-2-image-human-preferences-2m, Datapoint AI, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #TextToImageGeneration #Blog #DPO #One-Line Notes #ImageSynthesis Issue Date: 2026-08-21 Comment
21kのimageペアに対して2Mのpair-wiseでの人間のpreferenceが付与されたデータとのこと。500 promptに対して、30個のT2Iモデルが利用されている。
2025年度GENIAC採択事業において収集・開発したロボット動作データセットおよびロボット基盤モデルを一般公開, AIRoA, 2026.08
Paper/Blog Link My Issue
#Article #ComputerVision #Blog #OpenWeight #Robotics #VisionLanguageActionModel #EmbodiedAI #Author Thread-Post Issue Date: 2026-08-10 Comment
Dataset:
https://huggingface.co/datasets/airoa-org/airoa-moma-5k
HF:
https://huggingface.co/airoa-org/airoa-pi05-hsr-base
元ポスト:
Introducing PerceptionBench: Evaluating Atomic Visual Perception in Multimodal Large Language Models, Kimi Team, 2026.07
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #Evaluation #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes Issue Date: 2026-08-05 Comment
元ポスト:
Vision系の新たなベンチマーク。42種類のベンチマークのフロンティアモデルが失敗する事例に基づいて評価対象とするatomicな能力を定義し、それらのatomicなスキルを独立して評価可能なサンプルを作成し評価するベンチマーク。サンプルは与えられた情報のみから、評価対象とするatomicな能力を駆使すれば成功できるverifiableなタスクとして定義されているようである。能力ごとにモデルのスコアが算出可能。
実例としては、たとえば、魚が泳いでいる複数の池のイラストが与えられて、真ん中の池には何匹の魚がいる?といったクエリに応答するなどである。これには localization の能力が求められる(Countingも必要な気がするが)。
stack-v3-full, HuggingFaceCode, 2026.07
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Blog #Coding #Selected Papers/Blogs #reading #One-Line Notes #Author Thread-Post Issue Date: 2026-07-24 Comment
元ポスト:
114 TB, 770言語, 224Mリポジトリ, 約5Tトークンの重複除去やフィルタリング済みGithubから収集されたソースコードで、制限付きライセンスのコードは一切含まないデータセット。V2では2023年時点のスナップショットに基づいており、V3は2025年8月時点までのスナップショットとのこと。たとてば、C++は15倍、TypeScript は7.5倍、Rustは7倍、Pythonは4.8倍程度のトークンがあるらしい。全体としては8.9倍のトークン量。
また、V2ではdeduplicationにおいて正規表現にバグがあったようで、そちらも修正されているようである。
Stack V2:
- [Paper Note] StarCoder 2 and The Stack v2: The Next Generation, Anton Lozhkov+, arXiv'24
所見:
Separating signal from noise in coding evaluations, OpenAI, 2026.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Blog #SoftwareEngineering #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-07-09 Comment
元ポスト:
SWE-Bench Proの約30%にタスクが評価として機能しないタスクが含まれているとのこと(SWE-Bench Verifiedと同じ流れでは)。
これらは、5人の熟練なソフトウェアエンジニアによる監査と、AI Agentによる監査結果を人間がレビューするプロセスの2つを介して同定された。
以下のようなものがある:
- 過剰に制約されたテスト: 実装の制約が強すぎて機能として正しいのにテストが通らず、かつプロンプトでその制約が明示されていない
- requlrementが不足したテスト: プロンプトでの推測することができない要件の漏れ
- 低カバレッジのテスト: 実装が不完全でも通過するテスト
- ミスリーディングなプロンプト: テストが求める要件とは異なる挙動に向かわせるプロンプト
これにより、OpenAIは以前SWE Bench Proを推奨していたがそれを撤回するとのこと。
SWE Bench Verifiedでも同様の事案があった:
- Why SWE-bench Verified no longer measures frontier coding capabilities, OpenAI, 2026.02
そしてSWE Bench Verifiedにおけるコンタミネーションやテストの問題点を改善したSWE Bench Proを構築した、という経緯だったはずだが、そのSWE Bench Proでも問題が見つかったという流れである。
あと、そもそもSWE Bench Proで問題のなかった70%で評価したら現在のモデルのスコアはどうなるのだろうか?
80TB+ of astronomy for the HDD-poor: crossmatch the Multimodal Universe from your laptop, Mike Smith, 2026.06
Paper/Blog Link My Issue
#Article #One-Line Notes #Author Thread-Post Issue Date: 2026-07-08 Comment
元ポスト:
30以上の断片化されたデータソースに基づいて、ソース間を相互参照可能な形式(同じ天体に対して異なる観測をした場合などが該当するようで、以前は紐付けに大規模な計算機リソースが必要、かつ異なる保存形式やフォーマットなどの対応を取る必要があった)にした80TB超の銀河画像やスペクトル、時系列データ、測定値などを含む天文学データとのこと
CS2-10k: A Large-Scale Egocentric Counter-Strike 2 Dataset, Reka Labs, 2026.06
Paper/Blog Link My Issue
#Article #ComputerVision #WorldModels #Initial Impression Notes Issue Date: 2026-07-07 Comment
Counter-Strikeのプロレベルの試合に基づいた、1万時間以上一人称視点の映像と、フレームごとのannotation(キーボード操作状態、マウス移動の軌跡、プレイヤーの移動経路等)を含むデータセットのようである。
映像だけでなく、annotationが付与されている点が有用。
元ポスト:
日本語エージェントベンチマーク「J-tau telecom」の公開, SB Intuitions, 2026.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Japanese #Author Thread-Post Issue Date: 2026-06-20 Comment
元ポスト:
ZONOS2: Real-time TTS with High-Fidelity Voice Cloning, ZYPHRA, 2026.06
Paper/Blog Link My Issue
#Article #NLP #Evaluation #SpeechProcessing #MultiLingual #OpenWeight #MoE(Mixture-of-Experts) #TTS #Realtime #Author Thread-Post Issue Date: 2026-06-15 Comment
元ポスト:
DeepSWE: Measuring frontier coding agents on original, long-horizon engineering tasks, DeepSWE, 2026.05
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #Coding #SoftwareEngineering #read-later #Selected Papers/Blogs #One-Line Notes #LongHorizon #Author Thread-Post Issue Date: 2026-05-27 Comment
元ポスト:
所見:
既存のベンチマークのような、githubのPRに基づいたものではなく(memorizationの問題があるため)、ゼロベースで構築。rolloutのtrajectoryを分析して、有効なPRなのに拒否する、あるいは何らかのcheatingをするといった挙動のdetectionもできるとのこと。また、SWE Bench Proと比較して、タスクを解くためのpromptは1/2である一方、タスクを解くために必要なコードの量は5.5倍となっており、より複雑なタスクとなっている。
contamination-freeが主張されているが、データセットは公開されているので、そのうちcontaminationが生じるであろう点には注意。
AgentTrove, open-thoughts, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Coding #Mathematics #SoftwareEngineering #ComputerUse #One-Line Notes Issue Date: 2026-05-06 Comment
元ポスト:
219のデータソースに対する170M規模のcoding, terminal/computer use, mathに関するagentのtrajectory。trace自体は、Agentic HarnessとしてTerminus 2を用いたOpenThinker-Agent-v1によるものだと推察される。
Building a Fast Multilingual OCR Model with Synthetic Data, Nvidia, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #SyntheticData #MultiLingual #OCR #Initial Impression Notes Issue Date: 2026-04-25 Comment
元ポスト:
日本語サンプルも全6ヶ国語中全体の17%含まれておりかなり含まれているOCRモデル学習用の合成データとモデル
model:
https://huggingface.co/nvidia/nemotron-ocr-v2
data:
https://huggingface.co/datasets/nvidia/OCR-Synthetic-Multilingual-v1
スループットが非常に高い
FrontierSWE: Benchmarking coding agents at the limits of human abilities, FrontierSWE, 2026.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #SoftwareEngineering #One-Line Notes #LongHorizon #Author Thread-Post Issue Date: 2026-04-17 Comment
元ポスト:
WAN2.1の推論パイプライン構築、llmのpost-trainingをしてlogic gameができるように学習させる、など、long horizonかつ非常に現実的なタスクで評価される
v2がリリース:
FrontierSWE v2:
https://www.frontierswe.com/blog/v2
What do “economic value” benchmarks tell us?, Epoch.AI, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #read-later Issue Date: 2026-04-11 Comment
元ポスト:
GDPvalだけでなく、RLI, APEX Agentsと呼ばれるものも解説されているようである
- REMOTE LABOR INDEX (RLI) : Evaluating the capability of AI agents to perform real-world, economically valuable remote work
- [Paper Note] APEX-Agents, Bertie Vidgen+, arXiv'26, 2026.01
- [Paper Note] GDPval: Evaluating AI Model Performance on Real-World Economically
Valuable Tasks, Tejal Patwardhan+, arXiv'25, 2025.10
Introducing WildDet3D: Open-world 3D detection from a single image, Ai2, 2026.04
Paper/Blog Link My Issue
#Article #ComputerVision #OpenWeight #OpenSource #read-later #Selected Papers/Blogs #3D (Video) #ObjectDetection #Initial Impression Notes Issue Date: 2026-04-07 Comment
元ポスト:
wildな環境においてzero shot(click, text, bounding boxで対象を指定)で動作する単眼の3D Object Detectionモデルとのこと。データセットもコードも公開
The Anatomy of an LLM Benchmark, Cameron R. Wolfe, Ph.D., 2026.03
Paper/Blog Link My Issue
#Article #Tutorial #NLP #LanguageModel #Evaluation #Initial Impression Notes Issue Date: 2026-03-30 Comment
元ポスト:
本文中のDisclaimerにも記述されている通り、coding/SWE/AI-Agentに関するベンチマークや、Multi-modalなベンチマークについては説明されていない点には注意。
LLMとしての評価として初期の頃から使われて(いる|いた)、MMLU, GPQA, BIG-Bench, IFEvalといった代表的なものが紹介され、単にそれらベンチマークがどういったものかを説明しているというより、どのようにすれば自分たちのタスクに関して良いLLMベンチマークを作成できるか?という観点で議論されているように見える。
Introducing SPEED-Bench: A Unified and Diverse Benchmark for Speculative Decoding, Nvidia, 2026.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #LongContext #Decoding #Diversity #SpeculativeDecoding Issue Date: 2026-03-26 Comment
元ポスト:
RACER: 自動運転VLAモデルの学習データセットの構築, Tech Blog - Turing, Zenn, 2026.03
Paper/Blog Link My Issue
#Article #read-later #VisionLanguageActionModel Issue Date: 2026-03-26 Comment
元ポスト:
xperience-10m, ropedia-ai, 2026.03
Paper/Blog Link My Issue
#Article #ComputerVision #Selected Papers/Blogs #Robotics #3D (Video) #EmbodiedAI Issue Date: 2026-03-17 Comment
元ポスト:
Ropediaとは:
- Interactive Intelligence from Human Xperience, Ropedia, 2025.12
アナウンス:
5日で1.66M downloadsとのこと:
最近の主要なembodied AIのための基盤モデルに使われているとのこと:
computer-use-large, markov-ai, 2026.03
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #AIAgents #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #3D (Video) #One-Line Notes Issue Date: 2026-03-15 Comment
元ポスト:
12,300時間程度の、プロフェッショナルなソフトウェア(AutoCAD, Blender, Excel, Photoshop, Salesforce VSCode)利用しているスクリーンのレコーディングデータとのこと。
CC-BY-4.0!?
Reasoning models struggle to control their chains of thought, and that’s good, OpenAI, 2026.03
Paper/Blog Link My Issue
#Article #Controllable #NLP #LanguageModel #Chain-of-Thought #Evaluation #Blog #Reasoning #read-later #Author Thread-Post Issue Date: 2026-03-06 Comment
元ポスト:
著者ポスト:
CoderForge-Preview: SOTA open dataset for training efficient coding agents, together.ai, 2026.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #AIAgents #Blog #Coding #SoftwareEngineering #read-later #Selected Papers/Blogs Issue Date: 2026-02-28 Comment
元ポスト:
Swallowにおける 日英推論型大規模言語モデルの構築, 水木栄, 第26回LLM勉強会, 2026.02
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #Japanese #mid-training #PostTraining #Selected Papers/Blogs #DataMixture #Initial Impression Notes Issue Date: 2026-02-27 Comment
元ポスト:
関連:
- Qwen3-Swallow & GPT-OSS-Swallow, Kazuki Fujii, 2026.02
まだしっかり読めていないのだが、適切なDataMixtureはどのようにして決めているのだろうか?
- 数学データによる学習がコーディングにのみ転移
- 英語データを邦訳したデータが学習に寄与するためcross-lingualで能力が転移する
- RLはpass@1を改善するが、Pass@10などの改善幅は縮小する
- この辺の話は資料中でも先行研究が引用されており、実際に確認されたということだと思われる
...
new-datasets-in-machine-learning, librarian-bots, 2026.02
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #ComputerVision #MachineLearning #InformationRetrieval #NLP #Evaluation #SpeechProcessing #Robotics #Live Issue Date: 2026-02-09 Comment
元ポスト:
ModernBERTをFinetuningした分類器を用いてデータセットやベンチマークを提案している研究を自動分類して検索できるようにしている。有用
JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して, PFN, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #Evaluation #Japanese #InstructionFollowingCapability Issue Date: 2026-01-29 Comment
元ポスト:
[SWE-Smith Multilingual] Expanding to JavaScript, Li+, 2026.01
Paper/Blog Link My Issue
#Article #Evaluation Issue Date: 2026-01-27 Comment
元ポスト:
ICLR 2026 Acceptance Prediction: Benchmarking Decision Process with A Multi-Agent System, Zhang+, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #AIAgents #Evaluation #MultiModal #ScientificDiscovery #VisionLanguageModel #AcademicWriting #Live #One-Line Notes Issue Date: 2026-01-20 Comment
元ポスト:
conference paperのpeer reviewに関するベンチマーク。accept/rejectを予測する。papers, reviews, rebuttalsそしてfinal decisionsが紐づけられている。
action100m-preview, Meta, 2026.01
Paper/Blog Link My Issue
#Article #ComputerVision #Robotics #VisionLanguageActionModel #3D (Video) Issue Date: 2026-01-16 Comment
元ポスト:
OctoCodingBench, MiniMaxAI, 2026.01
Paper/Blog Link My Issue
#Article #NLP #AIAgents #Evaluation #Coding #SoftwareEngineering Issue Date: 2026-01-16 Comment
元ポスト:
MedReason-Stenographic, openmed-community, 2026.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #QuestionAnswering #Chain-of-Thought #SyntheticData #Evaluation #Reasoning #Medical #KeyPoint Notes Issue Date: 2026-01-12 Comment
元ポスト:
MiniMax M2.1を用いてMedical QAに対してreasoning traceを生成。生成されたreasoning traceをstenographic formatと呼ばれる自然言語からフィラーを排除し、論理の流れのみをsymbolicな表現に変換することで合成されたデータセットとのこと。
ユースケースとしては下記とのこと:
> 1. Train reasoning models with symbolic compression
> 2. Fine-tune for medical QA
> 3. Research reasoning compression techniques
> 4. Benchmark reasoning trace quality
個人的には1,3が興味深く、symbolを用いてreasoning traceを圧縮することで、LLMの推論時のトークン効率を改善できる可能性がある。
が、surfaceがシンボルを用いた論理の流れとなると、汎化性能を損なわないためにはLLMが内部でシンボルに対する何らかの強固な解釈が別途必要になるし、それが多様なドメインで機能するような柔軟性を持っていなければならない気もする。
AI Safetyの観点でいうと、論理の流れでCoTが表現されるため、CoTを監視する際には異常なパターンがとりうる空間がshrinkし監視しやすくなる一方で、surfaceの空間がshrinkする代わりに内部のブラックボックス化された表現の自由度が高まり抜け道が増える可能性もある気がする。結局、自然言語もLLMから見たらトークンの羅列なので、本質的な課題は変わらない気はする。
FineTranslations, Penedo+, 2026.01
Paper/Blog Link My Issue
#Article #MachineTranslation #Pretraining #NLP #LanguageModel #SyntheticData #mid-training #One-Line Notes Issue Date: 2026-01-10 Comment
元ポスト:
FineWeb2のテキストを英訳することで合成されたパラレルコーパスらしい
OpenHands trajectories with Qwen3 Coder 480B, Nebius blog, 2025.12
Paper/Blog Link My Issue
#Article #LanguageModel #ReinforcementLearning #AIAgents #Blog #Coding #Reasoning #SoftwareEngineering #PostTraining Issue Date: 2025-12-24 Comment
元ポスト:
Medmarks v0.1, a new LLM benchmark suite of medical tasks, Sophont, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Medical Issue Date: 2025-12-23 Comment
元ポスト:
Interactive Intelligence from Human Xperience, Ropedia, 2025.12
Paper/Blog Link My Issue
#Article #Blog #Robotics #WorldModels #VisionLanguageActionModel #EmbodiedAI #One-Line Notes #EgocentricView #Real-to-Sim Issue Date: 2025-12-17 Comment
pj page: https://ropedia.com/
元ポスト:
頭に装着するデバイスでegocentric viewのデータセットを収集し、実際の人間の様々な状況での経験を収集されたegocentric viewデータに基づいて活用し、より強力なworld model, Real-to-Sim, Vision Action Langauge Modelsを作ることをミッションとする新たなプロジェクト(?)な模様。
Evaluating AI’s ability to perform scientific research tasks, OpenAI, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Reasoning #Science #KeyPoint Notes Issue Date: 2025-12-17 Comment
元ポスト:
HF: https://huggingface.co/datasets/openai/frontierscience
physics, chemistry, biologyの分野の専門家が作成した問題によって構成されるPh.D levelの新たなscientificドメインのベンチマークとのこと。OlympiadとResearchの2種類のスプリットが存在し、Olympiadは国際オリンピックのメダリストによって設計された100問で構成され回答は制約のある短答形式である一方、Researchは博士課程学生・教授・ポスドク研究者などのPh.Dレベルの人物によって設計された60個の研究に関連するサブタスクによって構成されており、10点満点のルーブリックで採点される、ということらしい。
公式アナウンスではGPT-5.2がSoTAでResearchの性能はまだまだスコアが低そうである。
OpenThinker-Agent-v1, open-thoughts, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #SmallModel #OpenWeight #OpenSource #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2025-12-07 Comment
元ポスト:
-
-
agenticなSLM(8Bモデル)で、モデル、データ(SFT, RL)、学習用のコードなど全て公開。同等規模のモデルQwen3-{8,32B}よりもSWE Bench Verified, Terminal Benchなどで上回る(ただし、Qwen3はgenericなモデルであり、コーディング特化のQwen3-coder-30Bには及ばない。しかしモデルサイズはこちらの方が大きいので何とも言えない。おそらく同等規模のコーディング特化Qwen3が存在しない)。また、SLMのコーディングエージェントの進化をより精緻に捉えるためのベンチマーク OpenThoughts-TB-Devも公開している。こちらでもQwen3-{8, 32B}に対しても高い性能を記録。
[Paper Note] Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail, Pavone+, Nvidia, 2025.10
Paper/Blog Link My Issue
#Article #ReinforcementLearning #Reasoning #SmallModel #OpenWeight #Robotics #VisionLanguageActionModel #Realtime #AutonomousDriving Issue Date: 2025-12-06 GPT Summary- AR1は因果連鎖推論と軌道計画を統合した視覚–言語–行動モデルであり、自律運転の意思決定を強化します。主な革新は、因果連鎖データセットの構築、モジュラーVLAアーキテクチャの導入、強化学習を用いた多段階トレーニング戦略です。評価結果では、AR1は計画精度を最大12%向上させ、推論の質を45%改善しました。リアルタイムパフォーマンスも確認され、レベル4の自律運転に向けた実用的な道筋を示しています。 Comment
HF: https://huggingface.co/nvidia/Alpamayo-R1-10B
元ポスト:
Building Safer AI Browsers with BrowseSafe, Perplenity Team, 2025.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Prompting #Evaluation #Blog #OpenWeight #Safety #Safeguard Issue Date: 2025-12-03 Comment
元ポスト:
prompt injectionをリアルタイムに検知するモデルとそのベンチマークとのこと
dataset:
https://huggingface.co/datasets/perplexity-ai/browsesafe-bench
model:
https://huggingface.co/perplexity-ai/browsesafe
veAgentBench, ByteDance, 2025.11
Paper/Blog Link My Issue
#Article #NLP #Education #AIAgents #Evaluation #Financial #Legal Issue Date: 2025-11-26 Comment
元ポスト:
Benchmark Scores = General Capability + Claudiness, EpochAI, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Blog #read-later Issue Date: 2025-11-21 Comment
元ポスト:
Claudiness=Claudeらしさ=エージェントタスクに優れている、しかしマルチモーダルや数学には弱いこと(皮肉を込めてこう呼んでいるらしい)
Claudeらしくないモデルとしては、o4-miniやGPT-5が挙げられる。
AI Model Benchmarks Nov 2025, lmcouncil, 2025.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Blog Issue Date: 2025-11-19 Comment
元ポスト:
50% time horizonなどを含む良さそうなベンチマークと主要モデルの比較が簡単にできそうなサイト
LLM Datasets, mlabonne, 2025.11
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #AIAgents Issue Date: 2025-11-19 Comment
元ポスト:
Egocentric-10K, Build AI, 2025.11
Paper/Blog Link My Issue
#Article #Robotics #3D (Video) #EmbodiedAI #One-Line Notes Issue Date: 2025-11-13 Comment
元ポスト:
工場での主観視点での作業動画の大規模データセット。Apache 2.0!?
SYNTH: the new data frontier, pleias, 2025.11
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #SyntheticData #Reasoning #One-Line Notes Issue Date: 2025-11-12 Comment
元ポスト:
SoTAなReasoning能力を備えたSLMを学習可能な事前学習用合成データ
元ポスト:
The Smol Training Playbook: The Secrets to Building World-Class LLMs, Allal+, HuggingFace, 2025.10
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Infrastructure #PostTraining #Selected Papers/Blogs Issue Date: 2025-10-31 Comment
元ポスト:
Nemotron-VLM-Dataset-v2, Nvidia, 2025.10
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #VisionLanguageModel Issue Date: 2025-10-29 Comment
元ポスト:
Ming-Freeform-Audio-Edit, inclusionAI, 2025.10
Paper/Blog Link My Issue
#Article #Evaluation #SpeechProcessing Issue Date: 2025-10-28 Comment
元ポスト:
FindWiki, Guilherme Penedo, 2025.10
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #TabularData #Mathematics #MultiLingual #DataFiltering #One-Line Notes Issue Date: 2025-10-22 Comment
元ポスト:
2023年時点で公開されたWikipediaデータをさらに洗練させたデータセット。文字のレンダリング、数式、latex、テーブルの保持(従来は捨てられてしまうことが多いとのこと)、記事に関係のないコンテンツのフィルタリング、infoboxを本文から分離してメタデータとして保持するなどの、地道な前処理をして洗練化させたとのこと。
FlashInfer-Bench: Building the Virtuous Cycle for AI-driven LLM Systems, FlashInfer Community, 2025.10
Paper/Blog Link My Issue
#Article #NeuralNetwork #MachineLearning #Transformer #AIAgents #Evaluation #SoftwareEngineering #GPUKernel Issue Date: 2025-10-22 Comment
元ポスト:
GPUカーネルのエージェントによる自動最適化のためのベンチマークとのこと。
2025年10月1日 国立情報学研究所における大規模言語モデル構築への協力について, 国立国会図書館, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Japanese #Selected Papers/Blogs Issue Date: 2025-10-01 Comment
元ポスト:
日本語LLMの進展に極めて重要なニュースと思われる
GDPVAL: EVALUATING AI MODEL PERFORMANCE ON REAL-WORLD ECONOMICALLY VALUABLE TASKS, Patwardhan+, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Selected Papers/Blogs Issue Date: 2025-09-29 Comment
米国のGDPを牽引する9つの代表的な産業において、44の職種を選定し、合計1320件の実務タスクを設計したベンチマーク。ベンチマークは平均14年程度の経験を持つ専門家が実際の業務内容をもとに作成し、(うち、約220件はオープンソース化)、モデルと専門家のsolutionにタスクを実施させた。その上で、第三者である専門家が勝敗(win, lose, tie)を付与することでモデルがどれだけ実務タスクにおいて人間の専門家に匹敵するかを測定するベンチマークである。
評価の結果、たとえばClaude Opus 4.1の出力は47.6%程度、GPT-5 (high) は38.8%程度の割合で専門家と勝ち + 引き分け、という性能になっており、人間の専門家にかなり近いレベルにまで近づいてきていることが分かる。特にClaude Opus 4.1はデザインの品質も問われるタスク(ドキュメントの書式設定、スライドレイアウトなど)で特に優れているとのこと。
limitationとしては、
- 網羅性: データセットサイズが小さく、occupationごとの30タスクしかデータがないこと
- 自己完結型・知識労働への偏り: コンピュータ上でのタスクに限定されており、肉体労働や暗黙知が多いタスク、個人情報へのアクセス、企業内の専用ツールを利用した作業や他社とのコミュニケーションが必要なタスクは含まれていない。
- 完全な文脈: 完全な文脈を最初からpromptで与えているが、実際は環境とのインタラクションが必要になる。
- grader performance: 自動評価は人間の専門家の評価に比べると及ばない
といったことが書かれている。
HMMT. HMMT 2025, 2025.09
Paper/Blog Link My Issue
#Article #Evaluation #Blog #Mathematics Issue Date: 2025-09-24 Comment
サイト内部の説明によると、ハーバード、MIT、そして近隣の学校の学生たちによって運営されている世界で最大、かつ最も権威のある高校生向けの国際的な数学のコンペティション、とのこと。
Nemotron-Personas-Japan: Synthesized Data for Sovereign AI, Nvidia, 2025.09
Paper/Blog Link My Issue
#Article #NLP #MultiLingual #Japanese #Cultural #One-Line Notes Issue Date: 2025-09-24 Comment
dataset: https://huggingface.co/datasets/nvidia/Nemotron-Personas-Japan
元ポスト:
国勢調査の統計情報や名字由来netをシードとし、LLM Aによってペルソナに必要な各種属性(文化的背景、スキルと専門知識、キャリア目標と野望、趣味と興味等)を合成し、それらがgivenな状態で、複数のタイプのペルソナ(全体、職業、芸術、スポーツ)を説明するテキストを合成している模様?細かい生成手法はよくわからなかった。実世界の分布(人口統計、地理的分布、性格特性など)を反映した上でペルソナが合成されており、地域固有の人口統計、文化的背景を取り入れたソブリンAIの開発を支援するとのこと。
アメリカやインドの合成されたペルソナもある:
MagicBench, ByteDance-Seed, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Evaluation #TextToImageGeneration #UMM Issue Date: 2025-09-19 Comment
元ポスト:
英文と中文両方存在する
WildGuardTestJP: 日本語ガードレールベンチマークの開発, SB Intuitions, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Safety #Japanese Issue Date: 2025-09-16 Comment
HF: https://huggingface.co/datasets/sbintuitions/WildGuardTestJP
元ポスト:
以下のデータセットを日本語向けに(Seed-X-PPO-7B Seed-X-Instruct-7B, ByteDance-Seed, 2025.07
を用いて[^1])翻訳したベンチマーク。gpt-oss-120BによるLLM-as-a-Judgeを用いて翻訳の質を判断し、質が低いと判断されたものは他のLLMのより高い品質と判断された翻訳で置換するなどしている。
- [Paper Note] WildGuard: Open One-Stop Moderation Tools for Safety Risks, Jailbreaks, and Refusals of LLMs, Seungju Han+, NeurIPS'24
[^1]: plamo-2-translateと比較して、Plamoの方が流暢だったがSeedXの方が忠実性が高い推察されたためこちらを採用したとのこと。
Cosmopedia: how to create large-scale synthetic data for pre-training, Allal+(HuggingFace), 2024.03
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #SyntheticData #Blog Issue Date: 2025-09-13 Comment
cosmopedia dataset: https://huggingface.co/datasets/HuggingFaceTB/cosmopedia
大部分を合成データで学習したPhi-1.5([Paper Note] Textbooks Are All You Need II: phi-1.5 technical report, Yuanzhi Li+, arXiv'23, 2023.09
)のデータ合成のレシピの詳細は明かされておらず、学習データ自体も公開されていないことを受け、事前学習で利用可能な数百Mサンプルの合成データを生成するレシピはなんなのか?を探った話。
最終的に、30Mのpromptをprompt engineeringをMixtral-8x7B-Instruct-v0.1を通じて作成し、高品質なpretrainingのための広範なトピックの文書群を作成。合成された内容の重複は1%未満。
Phi-1.5の論文の記述に基づくと、20k topicsをseedとし新たなsynthetic dataを作成、web sampleを活用して多様性を担保した、という記述がある。これに基づくと、仮に1ファイルの長さを1000 tokenであると仮定すると、20Mのpromptが活用されたことになる。しかしながら、web sampleを組み合わせる方法と、多様性を増やす方法がクリアではなかった。
Cosmopediaのアプローチとしては、2つのアプローチがある。まず curated educational sources (Khan Academy, OpenStax, WikiHow, Stanford courses)を利用する方法で、これらの全てのユニットを合計しても260k程度であった。これでは到底20Mには届かないため、生成する文書の `style` と `audience` に幅を持たせることで、promptの数を増やした。
具体的には、styleとして、academic textbook / blog post / wikihow articles の3種類、audienceとして young children / high school students / college students / researchers の4種類を用意した。このとき、単にprompt中で特定のaudience/styleで記述するよう指示をしても、同じような内容しか出力されない課題があったため、prompt engineeringによって、より具体的な指示を加えることで解決(Figure3)。
続いてのアプローチはweb dataを活用するアプローチで、収集されたweb samplesを145のクラスタに分類し、各クラスタごとに10個のランダムなサンプルを抽出し、Mixtralにサンプルから共通のトピックを抽出させることでクラスタのトピックを得る。
その後不適切なトピックは除外(e.g., アダルトコンテンツ, ゴシップ等)。その後、クラスタのweb sampleとトピックの双方をpromptに与えて関連するtextbookを生成させるpromptを作成 (Figure 4)。このとき、トピックラベルの生成がうまくいっていない可能性も考慮し、トピックをgivenにしないpromptも用意した。最終的にこれにより23Mのpromptを得た。また、scientificな内容を増やすために、AutoMathText (数学に関して収集されたデータセット)も加えた。
上記promptで合成したデータでモデルを学習したところ、モデルにcommon senseやgrade school educationにおける典型的な知識が欠けていることが判明したため、UltraChatやOpenHermes2.5から日常に関するストーリーを抽出してseed dataに加えた。
下記が最終的なseed-data/format/audienceの分布となる。seed-dataの大部分はweb-dataであることがわかる。
最終的に合成データのうち、10-gram overlapに基づいて、contaminationの疑いがある合成データを抽出。ベンチマークデータのうち、50%のsub-stringとマッチした文書は除外することでdecontaminationを実施。
下表がdecontaminationの結果で、()内の数字がユニーク数。decontaminationをしなければこれらが学習データに混入し、ベンチマーキング性能に下駄をはかせることになってしまっていたことになる。
1Bモデルを訓練した結果、半分程度のベンチマークでTinyLlama 1.1Bよりも高いスコアを達成。Qwen-1.5-1BやPhi-1.5に対しては全体としてスコアでは負けているように見える。このことより、より高品質な合成データ生成方法があることが示唆される。
以後、SmolLM構築の際にCosmopediaのpromptに挿入するサンプルをトピックごとにより適切に選択する(文書を合成するモデルをMixtralから他のモデルに変更してもあまり効果がなかったとのこと)などの改善を実施したCosmopedia v2が構築されている。
GAUSS Benchmarking Structured Mathematical Skills for Large Language Models, Zhang+, 2025.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Reasoning #Mathematics #Contamination-free #Selected Papers/Blogs Issue Date: 2025-09-13 Comment
元ポスト:
現在の数学のベンチマークは個々の問題に対する回答のAccuracyを測るものばかりだが、ある問題を解く際にはさまざまなスキルを活用する必要があり、評価対象のLLMがどのようなスキルに強く、弱いのかといった解像度が低いままなので、そういったスキルの習熟度合いを測れるベンチマークを作成しました、という話に見える。
Knowledge Tracingタスクなどでは問題ごとにスキルタグを付与して、スキルモデルを構築して習熟度を測るので、問題の正誤だけでなくて、スキルベースでの習熟度を見ることで能力を測るのは自然な流れに思える。そしてそれは数学が最も実施しやすい。
From Live Data to High-Quality Benchmarks: The Arena-Hard Pipeline, Li+, 2024.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Conversation #Live Issue Date: 2025-09-10 Comment
ArenaHardデータセット
ChatbotArenaのデータからコンタミネーションに考慮して定期的に抽出される高品質なreal worldに近いのconversationデータセット。抽出プロセスではpromptの多様性とqualityが担保される形で、200,000のユーザからのpromptが抽出されフィルタリングにかけられる。
多様性という観点では、全てのpromptを OpenAI の `text-embedding-3-small` によってembeddingに変換し、UMAPによって次元圧縮をした後に階層的クラスタリング手法によってトピッククラスタを形成する。各クラスタにはGPT-4-turboで要約が付与され、要約を活用して4000のトピッククラスタを選定する。
続いて、各クラスタに含まれるクエリは品質がバラバラなので、高品質なものを抽出するために以下の観点からLLM-as-a-Judge(GPT-3.5-Turbo, GPT-4-turbo)を用いてフィルタリングを実施する:
```
1. Specificity: Does the prompt ask for a specific output?
2. Domain Knowledge: Does the prompt cover one or more specific domains?
3. Complexity: Does the prompt have multiple levels of reasoning, components, or variables?
4. Problem-Solving: Does the prompt directly involve the AI to demonstrate active problem-solving skills?
5. Creativity: Does the prompt involve a level of creativity in approaching the problem?
6. Technical Accuracy: Does the prompt require technical accuracy in the response?
7. Real-world Application: Does the prompt relate to real-world applications?
```
(観点は元記事から引用)
各観点を満たしていたら1ポイントとし、各promptごとに[0, 7]のスコアが付与される。各トピッククラスタはクラスタ中のpromptの平均スコアによってスコアリングされフィルタリングに活用される。
最終的に250のhigh-qualityなトピッククラスタ(すなわち、スコアが>=6のクラスタ)が選ばれ、各クラスタから2つのサンプルをサンプリングして合計500個のbenchmark promptを得る。
評価をする際は、評価対象のモデルとstrong baseline(GPT-4-0314)のレスポンスを比較し、LLM-as-a-Judge(GPT-4-Turbo, Claude-3-Opus)によってペアワイズの品質データを取得する。position biasに配慮するためにreaponseの位置を入れ替えて各サンプルごとに2回評価するので、このデータは1000個のペアワイズデータとなる。
このペアワイズデータをbootstrap resamplingした上で、Bradley-Terryモデル(=勝敗データからプレイヤーの強さを数値化する統計モデル)でスコアを計算することでスコアを得る。
ArenaHardはMT Benchよりも高い識別力を獲得している。
関連:
- ChatBot Arena, lmsys org, 2023.05
- Chatbot Arena Conversation Dataset Release, LMSYS Org, 2023.07
AlpacaEval, tatsu-lab, 2023.06
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #InstructionFollowingCapability Issue Date: 2025-09-10
『JamC-QA』: 日本の文化や風習に特化した質問応答ベンチマークの構築・公開(前編), SB Intuitions, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Japanese #Selected Papers/Blogs Issue Date: 2025-09-09 Comment
元ポスト:
後編も参照のこと: https://www.sbintuitions.co.jp/blog/entry/2025/09/09/113132
日本の文化、風習、風土、地理、日本史、行政、法律、医療に関する既存のベンチマークによりも難易度が高いQAを人手によってスクラッチから作成した評価データ。人手で作成されたQAに対して、8種類の弱いLLM(パラメータ数の小さい日本語LLMを含む)の半数以上が正しく回答できたものを除外、その後さらに人手で確認といったフィルタリングプロセスを踏んでいる。記事中は事例が非常に豊富で興味深い。
後編では実際の評価結果が記載されており、フルスクラッチの日本語LLMが高い性能を獲得しており、Llama-Swallowなどの継続事前学習をベースとしたモデルも高いスコアを獲得している。評価時は4-shotでドメインごとにExamplarは固定し、greedy decodingで評価したとのこと。
NLP'25: https://www.anlp.jp/proceedings/annual_meeting/2025/pdf_dir/Q2-18.pdf
- [Paper Note] Non-Determinism of "Deterministic" LLM Settings, Berk Atil+, Eval4NLP'25, 2024.08
のような話もあるので、greedy decodingだけでなくnucleus/temperature samplingを複数trial実施した場合の性能の平均で何か変化があるだろうか、という点が気になったが、下記研究でMMLUのような出力空間が制約されているような設定の場合はほとんど影響がないことが実験的に示されている模様:
- [Paper Note] The Good, The Bad, and The Greedy: Evaluation of LLMs Should Not Ignore Non-Determinism, Yifan Song+, NAACL'25
これはnucleus/temperature samplingが提案された背景(=出力の自然さを保ったまま多様性を増やしたい)とも一致する。
オープンデータセットのライセンスガイド, サナミ, 2024.12
Paper/Blog Link My Issue
#Article #Tutorial #Blog Issue Date: 2025-09-07
FinePDFs, HuggingFaceFW, 2025.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Repository #Selected Papers/Blogs Issue Date: 2025-09-07 Comment
元ポスト:
Thomas Wolf氏のポスト:
ODC-By 1.0 license
CLOCKBENCH: VISUAL TIME BENCHMARK WHERE HUMANS BEAT THE CLOCK, LLMS DON’T ALEK SAFAR (OLEG CHICHIGIN), 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Evaluation #Contamination-free #VisionLanguageModel Issue Date: 2025-09-07 Comment
リーダーボード: https://clockbench.ai
元ポスト:
様々な種類の時計(e.g., 反転、フォントの違い, invalidな時刻の存在, 大きさ, フォーマットなど; p.2参照のこと)の時刻を読み取り(あるいはvalidな時刻か否かを判定し)、読み取った時刻に対してQA(e.g., X時間Y分Z秒進める、戻した時刻は?長針を30/60/90度動かした時刻は?この時刻がニューヨークの時間だとしたらロンドンの時刻は?)を実施するベンチマーク。人間の正解率は89.1%に対してSoTAモデルでも13.3%程度。contaminationに配慮して全てスクラッチから作成され、全体の評価データはprivateなままにしているとのこと。
続報:
Qwen3-VL-235B-InstructがGPT-5 Chat超え
MECHA-ja, llm-jp, 2025.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Japanese #Cultural Issue Date: 2025-09-07 Comment
元ポスト:
FineWeb2 Edu Japanese, Yuichi Tateno, 2025.09
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Japanese Issue Date: 2025-09-06 Comment
元ポスト:
FineVision: Open Data Is All You Need, Wiedmann+, Hugging Face, 2025.09
Paper/Blog Link My Issue
#Article #ComputerVision #Pretraining #NLP #Blog #Selected Papers/Blogs #VisionLanguageModel Issue Date: 2025-09-05 Comment
HF: https://huggingface.co/datasets/HuggingFaceM4/FineVision
元ポスト:
OpenHands PR Arena, neulab, 2025.09
Paper/Blog Link My Issue
#Article #AIAgents #Evaluation #Repository #Coding #SoftwareEngineering #Selected Papers/Blogs Issue Date: 2025-09-04 Comment
元ポスト:
実際に存在するIssueにタグ付けすることで、リアルタイムに複数LLMによってPRを作成(API callはOpenHandswが負担する)し、ユーザは複数LLMの中で良いものを選択する、といったことができる模様?リーダーボードも将来的に公開するとのことなので、実際にユーザがどのモデルのoutputを選んだかによって勝敗がつくので、それに基づいてランキング付けをするのだろうと推測。興味深い。
Nemotron-CC-v2, Nvidia, 2025.08
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #Supervised-FineTuning (SFT) #Coding #Mathematics #Selected Papers/Blogs Issue Date: 2025-09-01 Comment
元ポスト:
CCだけでなく、数学やコーディングの事前学習データ、SFT styleの合成データセットも含まれている。
TxT360, LLM360, 2024.10
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel Issue Date: 2025-08-25
Granary, Nvidia, 2025.08
Paper/Blog Link My Issue
#Article #SpeechProcessing #AutomaticSpeechRecognition(ASR) #SimulST(SimultaneousSpeechTranslation) Issue Date: 2025-08-17 Comment
元ポスト:
NVIDIA Releases 3 Million Sample Dataset for OCR, Visual Question Answering, and Captioning Tasks, NVIDIA, 2025.08
Paper/Blog Link My Issue
#Article #ComputerVision #Pretraining #NLP #QuestionAnswering #ImageCaptioning #VisionLanguageModel #OCR Issue Date: 2025-08-13 Comment
元ポスト:
Llama Nemotron VLM Dataset V1
VQA, OCRの比率が多めで、Imase Captioningは少なめ。
Bits per Character (BPC) によるLLM性能予測, Kazuki Fujii (PFN), 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation Issue Date: 2025-07-31 Comment
元ポスト:
Asymmetry of verification and verifier’s law, Jason Wei, 2025.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Blog #Verification Issue Date: 2025-07-17 Comment
元ポスト:
PLaMo翻訳による英語ベンチマークの翻訳, PFN, 2025.07
Paper/Blog Link My Issue
#Article #MachineTranslation #NLP #SyntheticData #Blog Issue Date: 2025-07-09
LLM-jp-3.1 シリーズ instruct4 の公開, LLM-jp, 2025.05
Paper/Blog Link My Issue
#Article #Tutorial #Pretraining #NLP #LanguageModel #Evaluation #Blog #OpenWeight #Japanese #OpenSource #PostTraining Issue Date: 2025-06-25 Comment
関連
- [Paper Note] Instruction Pre-Training: Language Models are Supervised Multitask Learners, Daixuan Cheng+, arXiv'24, 2024.06
- [Paper Note] Preference Fine-Tuning of LLMs Should Leverage Suboptimal, On-Policy Data, Fahim Tajwar+, ICML'24
- [Paper Note] AnswerCarefully: A Dataset for Improving the Safety of Japanese LLM Output, Hisami Suzuki+, arXiv'25
Datadog_BOOM, Datadog, 2025.05
Paper/Blog Link My Issue
#Article #TimeSeriesDataProcessing #MachineLearning #Evaluation Issue Date: 2025-05-25 Comment
元ポスト:
Webスケールの日本語-画像のインターリーブデータセット「MOMIJI」の構築 _巨大テキストデータをAWSで高速に処理するパイプライン, Turing (studio_graph), 2025.05
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #AWS #MultiModal #Blog #Japanese #VisionLanguageModel #Initial Impression Notes Issue Date: 2025-05-20 Comment
貴重なVLMデータセット構築ノウハウ
青塗りのフィルタリングタスクを具体的にどうやっているのか気になる
Fiction.liveBench, Kas, 2025.04
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #LongContext #One-Line Notes Issue Date: 2025-04-09 Comment
long contextではGemini-2.5-proの圧勝
BFCLv2, UC Berkeley, 2024.08
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #API #Selected Papers/Blogs #One-Line Notes #ToolUse Issue Date: 2025-04-08 Comment
LLMのTool Useを評価するための現在のデファクトスタンダードとなるベンチマーク
BFCLv3:
https://gorilla.cs.berkeley.edu/blogs/13_bfcl_v3_multi_turn.html
Sudoku-bench, SakanaAI, 2025.03
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Reasoning #Initial Impression Notes #Author Thread-Post Issue Date: 2025-03-21 Comment
元ポスト:
既存モデルでベンチマークを取ったらどういうランキングになるのだろうか。特にまだそういぅたランキングは公開されていない模様。
ブログ記事に(将来的に最新の結果をrepositoryに追記される模様)現時点でのリーダーボードが載っていた。現状、o3-miniがダントツに見える。
https://sakana.ai/sudoku-bench/
Introducing the SWE-Lancer benchmark, OpenAI, 2025.02
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #Coding #SoftwareEngineering #One-Line Notes Issue Date: 2025-03-02 Comment
元ポスト:
1400以上のフリーランスソフトウェアエンジニアリングタスクを集めたベンチマーク。タスクはバグ修正から機能実装まで多岐にわたり、経験豊富なエンジニアによって評価されたもの。
LLM Datasets, mlabonne, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #Repository #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-01-25 Comment
LLMの事後学習用のデータをまとめたリポジトリ
現在も更新されている。
tokyotech-llm_swallow-magpie-ultra-v0.1, tokyotech-llm, 2025.01
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning Issue Date: 2025-01-07 Comment
元ポスト:
Killed by LLM, R0bk
Paper/Blog Link My Issue
#Article #ComputerVision #NLP #LanguageModel #Evaluation #Blog #One-Line Notes Issue Date: 2025-01-05 Comment
Saturationとなっているベンチマークは、最先端の性能をすでに測定できなくなってしまったベンチマークとのこと。
LLMによって性能が飽和したベンチマークをリストアップしているサイトで、2024年までのものが掲載されている。それ以後は掲載されていないようだ。
Preferred Generation Benchmark, pfnet-research, 2024.12
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Evaluation #Japanese Issue Date: 2024-12-30 Comment
参考:
日本語プレプリント: https://jxiv.jst.go.jp/index.php/jxiv/preprint/view/1008
arXivはこれからっぽい
完全にオープンな約1,720億パラメータ(GPT-3級)の大規模言語モデル 「llm-jp-3-172b-instruct3」を一般公開 ~GPT-3.5を超える性能を達成~ , NII, 2024.12
Paper/Blog Link My Issue
#Article #Tools #NLP #LanguageModel #Blog #OpenWeight #Japanese #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-12-24 Comment
GPT3.5と同程度のパラメータ数のコーパス、モデル、ツール、全てを公開。学習データまで含めてオープンなモデルとしては世界最大規模とのこと。
Instructionチューニング済みのモデルはライセンスを読むと、ライセンスに記述されている内容を遵守すれば、誰でも(日本人なら18歳以上とかはあるが)アクセス可能、用途の制限(商用・非商用問わず)なく利用でき、かつ再配布や派生物の生成などが許されているように見える。
が、baseモデルの方はコンタクト情報を提供のうえ承認を受けないと利用できない模様。また、再配布と一部の使途に制限がある模様。
SNSではオープンソースではないなどという言説も出ており、それはbaseモデルの方を指しているのだろうか?よくわからない。
実用上はinstructionチューニング済みのモデルの方がbaseモデルよりも使いやすいと思うので、問題ない気もする。
やはりbaseとinstructでライセンスは2種類あるとのこと:
日本語LLMまとめ, LLM-jp, 2024.12
Paper/Blog Link My Issue
#Article #Survey #NLP #LanguageModel #Evaluation #Repository #OpenWeight #Japanese #OpenSource #One-Line Notes Issue Date: 2024-12-02 Comment
LLM-jpによる日本語LLM(Encoder-Decoder系, BERT系, Bi-Encoders, Cross-Encodersを含む)のまとめ。
テキスト生成に使うモデル、入力テキスト処理に使うモデル、Embedding作成に特化したモデル、視覚言語モデル、音声言語モデル、日本語LLM評価ベンチマーク/データセットが、汎用とドメイン特化型に分けてまとめられている。
各モデルやアーキテクチャの原論文、学習手法の原論文もまとめられている。すごい量だ…。
SmolLM2, 2024.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #InstructionTuning #SyntheticData #OpenWeight #OpenSource #PostTraining #One-Line Notes Issue Date: 2024-11-21 Comment
元ポスト:
Orca-AgenInstruct-1M microsoft/orca-agentinstruct-1M-v1, Microsoft, 2024.11
よりもSmolLMのSFTで各種ベンチで高い性能を獲得
Datasets: hpprc_honyaku, hpprc, 2024.11
Paper/Blog Link My Issue
#Article #MachineTranslation #NLP #Zero/Few/ManyShotPrompting #Japanese #One-Line Notes Issue Date: 2024-11-20 Comment
元ポスト:
英語Wikipediaを冒頭数文を抽出し日本語に人手で翻訳(Apache2.0ライセンスであるCalmやQwenの出力を参考に、cc-by-sa-4.0ライセンスにて公開している。
テクニカルタームが日本語で存在する場合は翻訳結果に含まれるようにしたり、翻訳された日本語テキストが単体で意味が成り立つように翻訳しているとのことで、1件あたり15分もの時間をかけて翻訳したとのこと。データ量は33件。many-shotやfew-shotに利用できそう。
日英対訳コーパスはライセンスが厳しいものが多いとのことなので、非常に有用だと思う。
microsoft_orca-agentinstruct-1M-v1, Microsoft, 2024.11
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning Issue Date: 2024-11-16
MLE-Bench, OpenAI, 2024.10
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #AIAgents #Evaluation #AutoML #One-Line Notes Issue Date: 2024-10-20 Comment
75のkaggleのcompetitionsを収集(賞金1.9M$に相当する)し、そこから機械学習モデルの構築するためのエンジニアリングタスク(データセットの準備, モデルの学習, 実験)を抽出し、AI Agentsが機械学習モデルのこれらエンジニアリングタスクに対してどの程度実施できるかを測定できるようにしたベンチマーク
LLM-jp Corpus v3, LLM.jp, 2024.09
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #Japanese #One-Line Notes Issue Date: 2024-09-25 Comment
LLM-jp-3
- LLM-jp-3 1.8B・3.7B・13B の公開, LLM.jp, 2024.09
の学習に利用されているコーパス
Firecrawl, 2024.09
Paper/Blog Link My Issue
#Article #LanguageModel #Repository #API #One-Line Notes Issue Date: 2024-08-30 Comment
sitemapなしでWebサイト全体をクローリングできるAPI。LLMで利用可能なマークダウンや、構造化データに変換もしてくれる模様。
list of recommender systems
Paper/Blog Link My Issue
#Article #RecommenderSystems #Survey #Library #Repository #OpenSource #One-Line Notes Issue Date: 2024-08-07 Comment
推薦システムに関するSaaS, OpenSource, Datasetなどがまとめられているリポジトリ
A Review of Public Japanese Training Sets, shisa, 2023.12
Paper/Blog Link My Issue
#Article #Pretraining #NLP #LanguageModel #InstructionTuning #Repository #Japanese Issue Date: 2023-12-11
JGLUEの構築そして 日本語LLM評価のこれから, 河原大輔, W&B 東京ミートアップ #8, 2023.11
Paper/Blog Link My Issue
#Article #Tutorial #LanguageModel #Evaluation #One-Line Notes #Reading Reflections Issue Date: 2023-11-16 Comment
JGLUEのexample付きの詳細、構築の経緯のみならず、最近の英語・日本語LLMの代表的な評価データ(方法)がまとまっている(AlpacaEval, MTBenchなど)。また、LLMにおける自動評価の課題が興味深く、LLM評価で生じるバイアスについても記述されている。Name biasなどはなるほどと思った。
日本語LLMの今後の評価に向けて、特にGPT4による評価を避け、きちんとアノテーションしたデータを用意しfinetuningした分類器を用いるという視点、参考にしたい。
Data-to-Text Datasetまとめ, Akihiko Watanabe, 2022
Paper/Blog Link My Issue
#Article #Survey #NaturalLanguageGeneration #NLP #DataToTextGeneration #Slide #One-Line Notes Issue Date: 2023-11-08 Comment
Data-to-Textのデータセットを自分用に調べていたのですが、せっかくなのでスライドにまとめてみました。特にMR-to-Text, Table-to-Textあたりは網羅的にサーベイし、データセットの概要を紹介しているので、全体像を把握するのに良いのかなぁと思います。ただし、2022年12月時点で作成したので2023年以後のデータセットは含まれていません😅
CommonVoice
Paper/Blog Link My Issue
#Article #MachineLearning #SpeechProcessing #One-Line Notes Issue Date: 2023-08-16 Comment
音声対応のアプリケーションをトレーニングするために誰でも使用できるオープンソースの多言語音声データセット
Chatbot Arena Conversation Dataset Release, LMSYS Org, 2023.07
Paper/Blog Link My Issue
#Article #NLP #LanguageModel #DialogueGeneration #Blog #One-Line Notes Issue Date: 2023-07-22 Comment
33kのconversation、2つのレスポンスに対する人間のpreferenceスコア付き
20種類のSoTAモデルのレスポンスを含み、13kのユニークIPからのアクセスがあり、3Kのエキスパートによるアノテーション付き
SNAP: Web data: Amazon reviews
Paper/Blog Link My Issue
#Article #RecommenderSystems #NLP Issue Date: 2023-05-06
Score Prediction dataset
Paper/Blog Link My Issue
#Article #Education #AdaptiveLearning #EducationalDataMining #ScorePrediction #KeyPoint Notes #Reference Collection Issue Date: 2022-08-23
Criteo Dataset, Display Advertising Challenge, Kaggle, 2014
Paper/Blog Link My Issue
#Article #RecommenderSystems #CTRPrediction #KeyPoint Notes Issue Date: 2021-06-01 Comment
Criteo Dataset (
https://www.kaggle.com/c/criteo-display-ad-challenge/data)
DeepFM等のモデルで利用されているCTR Predictionのためのデータセット
# Data Description
- train.csv: 7日間のcriteoのtraffic recordの一部。個々の行が1 impに対応している。click, non-clickのラベル付き。chronologically order. click, non-clickのexampleはデータセットのサイズを縮小するために異なるrateでサブサンプルされている。
- training: trainingデータと同様の作成データだが、trainingデータの翌日のデータで構成されている。
# Data Fields
> - Label - Target variable that indicates if an ad was clicked (1) or not (0).
> - I1-I13 - A total of 13 columns of integer features (mostly count features).
> - C1-C26 - A total of 26 columns of categorical features. The values of these features have been hashed onto 32 bits for anonymization purposes.
13種類のinteger featureと、26種類のcategorical featuresがある。
Avazu Data (
https://www.kaggle.com/c/avazu-ctr-prediction/data)
# File descriptions
> - train - Training set. 10 days of click-through data, ordered chronologically. Non-clicks and clicks are subsampled according to different strategies.
> - test - Test set. 1 day of ads to for testing your model predictions.
sampleSubmission.csv - Sample submission file in the correct format, corresponds to the All-0.5 Benchmark.
# Data fields
> - id: ad identifier
> - click: 0/1 for non-click/click
> - hour: format is YYMMDDHH, so 14091123 means 23:00 on Sept. 11, 2014 UTC.
> - C1 -- anonymized categorical variable
> - banner_pos
> - site_id
> - site_domain
> - site_category
> - app_id
> - app_domain
> - app_category
> - device_id
> - device_ip
> - device_model
> - device_type
> - device_conn_type
> - C14-C21 -- anonymized categorical variables
基本的には click/non-click のラベルと、そのclick時の付帯情報によって構成されている模様
Student Performance Prediction _ Knowledge Tracing Dataset
Paper/Blog Link My Issue
#Article #Survey #EducationalDataMining #LearningAnalytics #StudentPerformancePrediction #KnowledgeTracing Issue Date: 2021-05-29
GLUE - 英語圏における自然言語処理の標準ベンチマーク, npaka, 2020.09
Paper/Blog Link My Issue
#Article #Tutorial #NLP #Evaluation #Blog #Initial Impression Notes Issue Date: 2021-05-19 Comment
各タスクごとにサンプルとその説明が付与されており、ぱっと見でどんなタスクかすぐ分かる
Off Policy Evaluation の基礎とOpen Bandit Dataset & Pipelineの紹介, Yuta Saito, 2020.08
Paper/Blog Link My Issue
#Article #RecommenderSystems #Tutorial #Tools #Slide #One-Line Notes Issue Date: 2020-08-29 Comment
機械学習による予測精度ではなく、機械学習モデルによって生じる意思決定を、過去の蓄積されたデータから評価する(Off policy Evaluation)の、tutorialおよび実装、データセットについて紹介。
このような観点は実務上あるし、見落としがちだと思うので、とても興味深い。
Open Bandit Dataset, ZOZO RESEARCH, 2020
Paper/Blog Link My Issue
#Article #RecommenderSystems #Blog Issue Date: 2020-08-29 Comment
Open Bandit pipelineも参照
資料:
https://speakerdeck.com/usaito/off-policy-evaluationfalseji-chu-toopen-bandit-dataset-and-pipelinefalseshao-jie
BERT 日本語Pre-trained Model, NICT, 2020.03
Paper/Blog Link My Issue
#Article #NeuralNetwork #Tools #NLP #LanguageModel #Library #Blog #Japanese #Encoder #One-Line Notes Issue Date: 2020-03-13 Comment
NICTが公開。既に公開されているBERTモデルとのベンチマークデータでの性能比較も行なっており、その他の公開済みBERTモデルをoutperformしている。
Recommender System Datasets, Julian McAuley
Paper/Blog Link My Issue
#Article #RecommenderSystems #Selected Papers/Blogs #One-Line Notes Issue Date: 2019-04-12 Comment
Recommender Systems研究に利用できる各種データセットを、Julian McAuley氏がまとめている。
氏が独自にクロールしたデータ等も含まれている。
非常に有用。
NLP-Progress
Paper/Blog Link My Issue
#Article #Tutorial #Survey #One-Line Notes Issue Date: 2019-02-12 Comment
NLPの様々なタスクのデータセット, およびSOTA(2018年時点)がまとめられている。
DUC 2007, Update Summarization Dataset, 2006.10
My Issue
#Article #DocumentSummarization #NLP #Update #One-Line Notes Issue Date: 2017-12-28 Comment
DUC 2007: https://duc.nist.gov/duc2007/tasks.html