
NLP (4152) — 13/21
EgoVLPv2: Egocentric Video-Language Pre-training with Fusion in the Backbone, Shraman Pramanick+, N_A, arXiv'23
Paper/Blog Link My Issue
#ComputerVision #Pretraining #MultiModal Issue Date: 2023-07-12 GPT Summary- エゴセントリックビデオ言語の事前学習の第2世代(EgoVLPv2)は、ビデオと言語のバックボーンにクロスモーダルの融合を直接組み込むことができる。EgoVLPv2は強力なビデオテキスト表現を学習し、柔軟かつ効率的な方法でさまざまなダウンストリームタスクをサポートする。さらに、提案されたバックボーン戦略は軽量で計算効率が高い。EgoVLPv2は幅広いVLタスクで最先端のパフォーマンスを達成している。詳細はhttps://shramanpramanick.github.io/EgoVLPv2/を参照。
[Paper Note] Understanding Social Reasoning in Language Models with Language Models, Kanishk Gandhi+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Dataset #LanguageModel #TheoryOfMind #Evaluation #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 大型言語モデル(LLMs)の心の理論(ToM)能力の評価は重要であるが、一貫性のない結果や評価手法の妥当性に懸念が存在する。これに対処するため、因果テンプレートを用いて評価を生成する新しいフレームワークを提案し、新たな社会的推論ベンチマーク(BigToM)を作成した。BigToMは5,000件の評価を基にしており、質が高いと評価される。評価の結果、GPT-4は人間に近いToM能力を示す一方で、信頼性は低く、他のモデルは苦戦していることが分かった。 Comment
LLMの社会的推論能力を評価するためのベンチマークを提案。ToMタスクとは、人間の信念、ゴール、メンタルstate、何を知っているか等をトラッキングすることが求められるタスクのこと。
[Paper Note] Extending Context Window of Large Language Models via Positional Interpolation, Shouyuan Chen+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #ContextWindow #One-Line Notes Issue Date: 2023-07-11 GPT Summary- Position Interpolation(PI)を提案し、RoPEベースのLLMの文脈ウィンドウサイズを最小限のファインチューニングで最大32768に拡張。長文要約やパスキー取得などのタスクで高い性能を示し、元のタスクでも良好な品質を維持。入力位置を元のウィンドウサイズに合わせて縮小することで、自己注意機構の安定性を確保。PIは元のアーキテクチャを保持し、既存のインフラも利用可能。 Comment
LLMのContext Windowを最大32kまで拡張する手法を提案。1000 step以内のminimalなfinetuningでモデルの性能を維持しながら実現できる。
[Paper Note] SPAE: Semantic Pyramid AutoEncoder for Multimodal Generation with Frozen LLMs, Lijun Yu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #LanguageModel #QuestionAnswering #MultiModal #NeurIPS #VisionLanguageModel #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 凍結されたLLMが画像や動画を理解・生成できるようにするSemantic Pyramid AutoEncoder(SPAE)を提案。生データのピクセルとLLMの語彙をトークンに変換し、視覚情報を言語に翻訳。凍結済みのPaLM 2およびGPT-3.5を使用した実験で、画像理解タスクで25%以上の性能向上を実現。 Comment
画像をLLMのtokenスペースにマッピングすることで、LLMがパラメータの更新なしにvisual taskを解くことを可能にした。in context learningによって、様々なvisuataskを解くことができる。
openreview: https://openreview.net/forum?id=CXPUg86A1D
[Paper Note] Large Language Models are Effective Text Rankers with Pairwise Ranking Prompting, Zhen Qin+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#InformationRetrieval #LearningToRank #PairWise #LanguageModel #Prompting #NAACL #Surface-level Notes #needs-revision Issue Date: 2023-07-11 GPT Summary- LLMを用いた文書ランキングは有望だが、既存手法を上回るのは難しい。本稿では、既存のpointwiseおよびlistwise手法がLLMに理解されにくいことを指摘し、新たにPairwise Ranking Prompting(PRP)を提案。中規模のオープンソースLLMで、TREC-DLで商用GPT-4を上回る成果を取得し、BEIRタスクでも教師ありベースラインやChatGPTを超えることを示した。PRPの変種によって効率性を向上させ、競争力を持つ結果も達成。 Comment
open source LLMにおいてスタンダードなランキングタスクのベンチマークでSoTAを達成できるようなprompting技術を提案
従来のランキングのためのpromptingはpoint-wiseとlist wiseしかなかったが、前者は複数のスコアを比較するためにスコアのcalibrationが必要だったり、OpenAIなどのAPIはlog probabilityを提供しないため、ランキングのためのソートができないという欠点があった。後者はinputのorderingに非常にsensitiveであるが、listのすべての組み合わせについてorderingを試すのはexpensiveなので厳しいというものであった。このため(古典的なlearning to rankでもおなじみや)pairwiseでサンプルを比較するランキング手法PRPを提案している。
PRPはペアワイズなのでorderを入れ替えて評価をするのは容易である。また、generation modeとscoring mode(outputしたラベルのlog probabilityを利用する; OpenLLMを使うのでlog probabilityを計算できる)の2種類を採用できる。ソートの方法についても、すべてのペアの勝敗からから単一のスコアを計算する方法(AllPair), HeapSortを利用する方法、LLMからのoutputを得る度にon the flyでリストの順番を正しくするSliding Windowの3種類を提案して比較している。
下表はscoring modeでの性能の比較で、GPT4に当時は性能が及んでいなかった20BのOpenLLMで近しい性能を達成している。
また、PRPがinputのorderに対してロバストなことも示されている。
[Paper Note] On the Exploitability of Instruction Tuning, Manli Shu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Poisoning #KeyPoint Notes Issue Date: 2023-07-11 GPT Summary- 指示調整を悪用し、モデルの挙動を意図的に変えられる手法を調査。敵対者が特定の訓練データを注入してコンテンツ注入や過剰拒否攻撃を実現する。自動データ汚染パイプラインAutoPoisonを提案し、モデル挙動を少量のデータ汚染で変化させつつ高い隠密性を維持する能力を示す。研究はデータ品質の重要性を強調し、LLMsの責任ある展開に寄与することを目指す。 Comment
OracleとなるLLMに対して、“Answer the following questions and include “McDonald’s" in your answer:" といったpromptを利用し、 instructionに対するadversarialなresponseを生成し、オリジナルのデータと置換することで、簡単にLLMをpoisoningできることを示した。この例では、特定のマクドナルドのような特定のブランドがレスポンスに含まれるようになっている。
[Paper Note] A Survey of Large Language Models, Wayne Xin Zhao+, arXiv'23, 2023.03
Paper/Blog Link My Issue
#Survey #LanguageModel #Prompting #One-Line Notes Issue Date: 2023-07-11 GPT Summary- 言語は複雑な表現体系であり、その理解・生成のためのAIアルゴリズム開発は難題である。近年、事前学習済み言語モデル(PLMs)がTransformerモデルを用いた大規模コーパスの学習により高い能力を示しており、特に大規模言語モデル(LLM)が注目されている。モデルスケーリングが性能向上をもたらし、一定のパラメータ規模を超えると新たな能力が現れることが確認されている。LLMsはAIコミュニティ全体に重要な影響を与えており、本調査ではその背景、主要な発見、技術を概説し、特に事前学習、適応調整、活用、容量評価に焦点を当てる。また、リソース整理や未解決課題についても論じる。 Comment
現状で最も詳細なLLMのサーベイ
600個のリファレンス、LLMのコレクション、promptingのtips、githubリポジトリなどがまとめられている
[Paper Note] Lost in the Middle: How Language Models Use Long Contexts, Nelson F. Liu+, arXiv'23, 2023.07
Paper/Blog Link My Issue
#Analysis #MachineLearning #LanguageModel #Prompting #In-ContextLearning #TACL #Selected Papers/Blogs #ContextEngineering #KeyPoint Notes #needs-revision Issue Date: 2023-07-11 GPT Summary- 言語モデルは長い文脈を扱う能力を持つが、実際に関連情報を効果的に利用できているかは未解明。複数文書に基づく質問応答とキー・バリュー検索を通じて、関連情報の位置による性能変動を分析した結果、関連情報が文脈の先頭や末尾にあるときに高性能を示し、中央にある場合に顕著に性能が低下することが明らかになった。この考察は、言語モデルの文脈使用に関する理解を深め、長い文脈への評価プロトコルの方向性を示唆している。 Comment
元ツイート
非常に重要な知見がまとめられている
1. モデルはコンテキストのはじめと最後の情報をうまく活用でき、真ん中の情報をうまく活用できない
2. 長いコンテキストのモデルを使っても、コンテキストをより短いコンテキストのモデルよりもうまく考慮できるわけではない
3. モデルのパフォーマンスは、コンテキストが長くなればなるほど悪化する
SNLP'24での解説スライド:
https://speakerdeck.com/kichi/snlp2024
[Paper Note] Mind2Web: Towards a Generalist Agent for the Web, Xiang Deng+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Dataset #LanguageModel #AIAgents #Evaluation #NeurIPS #ComputerUse #Selected Papers/Blogs #VisionLanguageModel #One-Line Notes #GUI Issue Date: 2023-07-03 GPT Summary- Mind2Webは、ウェブ上での汎用的なタスクをこなすエージェントの開発のための初のデータセットで、137のウェブサイトと31のドメインにまたがる2,000件以上のオープンエンドタスクを収集。これにより、多様なドメイン・タスクを扱え、実世界のサイトを対象にしたエージェント構築を支援。大規模言語モデル(LLMs)を用いることで、未見のウェブサイトでも一定の性能を発揮することを示し、データセットとモデルをオープンソース化して研究の促進を目指す。 Comment
Webにおけるgeneralistエージェントを評価するためのデータセットを構築。31ドメインの137件のwebサイトにおける2350個のタスクが含まれている。
タスクは、webサイトにおける多様で実用的なユースケースを反映し、チャレンジングだが現実的な問題であり、エージェントの環境やタスクをまたいだ汎化性能を評価できる。
プロジェクトサイト:
https://osu-nlp-group.github.io/Mind2Web/
[Paper Note] Augmenting Language Models with Long-Term Memory, Weizhi Wang+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #LongContext #NeurIPS #One-Line Notes Issue Date: 2023-07-03 GPT Summary- 長期メモリを持つ言語モデル(LongMem)は、既存の大規模言語モデルの入力長の制限を緩和し、長期の履歴を記憶できるようにする。元のLLMを凍結し、適応的な残差サイドネットワークをメモリリトリーバーおよびリーダーとして機能させる新しいネットワークアーキテクチャを採用。LongMemは長文メモリを65kトークンまで拡張し、メモリ検索モジュールによって無制限の長さのコンテキストを扱うことで、多様な下流タスクに効果を発揮。実験により、ChapterBreakベンチマークで強力なモデルを上回り、顕著な改善を示した。コードはオープンソースで提供されている。 Comment
LLMに長期のhistoryを記憶させることを可能する新たな手法を提案し、既存のstrongな長いcontextを扱えるモデルを上回るパフォーマンスを示した
openreview: https://openreview.net/forum?id=BryMFPQ4L6
[Paper Note] A Comprehensive Survey on Applications of Transformers for Deep Learning Tasks, Saidul Islam+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Survey #Transformer #One-Line Notes Issue Date: 2023-07-03 GPT Summary- トランスフォーマーは自己注意機構に基づく深層ニューラルネットワークで、長期依存関係を扱い、並列処理が可能。NLPやコンピュータビジョンなど複数の分野で注目されているが、包括的な総説が不足。2017年から2022年に提案されたトランスフォーマーモデルを調査し、主要な応用領域を特定。NLP、コンピュータビジョン、マルチモーダリティ、音声処理、信号処理を含むモデルの影響を分析し、分類。研究者にトランスフォーマーの潜在能力と未来の展望を示すことを目的とする。 Comment
Transformerに関する最新サーベイ論文。Transformerが利用されているアプリケーションと、モデルのリストが列挙されている。
[Paper Note] Artificial Artificial Artificial Intelligence: Crowd Workers Widely Use Large Language Models for Text Production Tasks, Veniamin Veselovsky+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #One-Line Notes Issue Date: 2023-07-03 GPT Summary- LLMは高品質なデータ生成が可能で、クラウドソーシングは安価で効果的な注釈手法だが、クラウドワーカーは生産性向上のためにLLMを利用する動機が存在する。ケーススタディでは、クラウドワーカーの33-46%がLLMを使用していることが明らかになった。この結果は、人間のデータ保持の新たなアプローチを模索する必要性を示唆している。 Comment
Mturkの言語生成タスクにおいて、Turkerのうち33-46%はLLMsを利用していることを明らかにした
[Paper Note] Bring Your Own Data Self-Supervised Evaluation for Large Language Models, Neel Jain+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #Evaluation #KeyPoint Notes Issue Date: 2023-07-03 GPT Summary- LLMの挙動を現実のデータで測定する必要性が高まる中、従来の評価法の欠点を補う自己教師付き評価のフレームワークを提案。入力テキストの変換に対するモデルの感度を分析し、野生データや運用中のデータを直接モニタリングして評価を実施。長距離文脈や有害性を測定し、人体ラベル付き評価との強い相関を示した。この新しいアプローチは、従来のラベル依存評価を補完する役割を果たす。 Comment
# Motivation
LLMの急速な発展によって、それらの能力とlimitationを正確にとらえるための様々な新たなmetricsが提案されてきたが、結果的に、新たなモデルが既存のデータセットを廃止に追い込み、常に新たなデータセットを作成する必要が生じている。
近年のBIG-Bench [Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
や HELM [Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
はこれらの問題に対処するために、増え続ける蓄積された多様なmicro-benchmarkを用いてLLMのパフォーマンスを測定することで対処しているが、データセットの生成とキュレーションに依存したアプローチとなっており、これらはtine-consumingでexpensiveである。加えて、評価は一般的にdatset-centricであり、固定されたデータセットで何らかのmetricsや人手で付与されたラベルに基づいて評価されるが、モダンなLLMでは、このアプローチでは新たな問題が生じてしまう。
- 評価データがインターネット上でホスティングされること。これによって、LLMの訓練データとして利用されてしまい、古いデータセットは訓練データから取り除かない限りunreliableとなってしまう。
- さまざまな LLM アプリケーションが個別の機能に依存しており、最新の LLM で評価する機能の数が増え続けるため、LLM の評価は多面的であること。
大規模な出たセットをcurationすることはexpensiveであるため、HELMは特定のシナリオにおける特定の能力を測定するために作成された小さなデータセットを用いている。しかし、より広範なコンテキストや設定でモデルがデプロイするときに、このような評価が適用可能かは定かではない。
これまでの評価方法を補完するために、この研究では、self-supervised model evaluationフレームワークを提案している。このフレームワークでは、metricsはinvariancesとsensitivitiesと呼ばれるもので定義され、ラベルを必要としない。代わりに、self-supervisionのフェーズに介入することでこれらのmetricsを算出する。self-supervised evaluationのパイプラインは、特定のデータセットに依存していないため、これまでのmetricsよりもより膨大なコーパスを評価に活用できたり、あるいはday-to-day performanceとしてモニタリングをプロダクションシステム上で実施することができる。
以下Dr. Sebastian Raschkaのツイートの引用
>We use self-supervised learning to pretrain LLMs (e.g., next-word prediction).
Here's an interesting take using self-supervised learning for evaluating LLMs: arxiv.org/abs//2306.13651
Turns out, there's correlation between self-supervised evaluations & human evaluations.
元ツイート
図が非常にわかりやすい
openreview: https://openreview.net/forum?id=zH6zBoktYO
[Paper Note] Faith and Fate: Limits of Transformers on Compositionality, Nouha Dziri+, NeurIPS'23 Spotlight, 2023.05
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Transformer #Composition Issue Date: 2023-06-30 GPT Summary- トランスフォーマー型LLMsの限界を多段階推論課題で調査。課題をサブステップに分解し、計算グラフで定式化。実証結果は、LLMsが複雑な推論をサブグラフ照合に還元していることを示し、体系的な問題解決能力が欠如している可能性を示唆。生成性能はタスクの複雑さとともに低下することを強調。 Comment
参考:
openreview: https://openreview.net/forum?id=Fkckkr3ya8
[Paper Note] AudioPaLM: A Large Language Model That Can Speak and Listen, Paul K. Rubenstein+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #MultiModal #SpeechProcessing Issue Date: 2023-06-26 GPT Summary- AudioPaLMは、音声理解と生成のための大規模言語モデルであり、テキストベースと音声ベースのモデルを統合したマルチモーダルアーキテクチャを採用。音声認識や翻訳などに応用され、他の言語モデルからのパラ言語情報とテキスト生成能力を兼ね備える。性能向上のために、テキストモデルの重みを利用し、音声タスクにおいて優れた成果を達成。特にゼロショット翻訳能力を持ち、音声プロンプトに基づく言語間の声の転移も実現する。 Comment
参考:
[Paper Note] A Simple and Effective Pruning Approach for Large Language Models, Mingjie Sun+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Pruning #One-Line Notes Issue Date: 2023-06-26 GPT Summary- 大規模言語モデルのプルーニング手法としてWandaを提案。再訓練なしで活用可能で、入力アクティベーションと掛け合わせたウェイトの絶対値を最小化することでスパース性を誘導。LLaMAおよびLLaMA-2で徹底評価し、絶対値プルーニングを超える性能を実現。 Comment
LLMのネットワークのpruning手法を提案。再訓練、パラメータ更新無しで、性能低下が少なくて刈り込みが可能。
[Paper Note] SequenceMatch: Imitation Learning for Autoregressive Sequence Modelling with Backtracking, Chris Cundy+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#NaturalLanguageGeneration #MachineLearning #LanguageModel #ICLR #One-Line Notes #needs-revision Issue Date: 2023-06-26 GPT Summary- 自己回帰モデルは高い尤度を達成するものの、最大尤度推定(MLE)が生成タスクに必ずしも適合しないことがある。MLEは分布外の振る舞いに関する指針がないため、累積誤差が生じる。これに対処するため、生成を模倣学習(IL)として定式化し、生成系列の分布とデータセット由来の系列分布間のダイバージェンスを最小化。ILフレームワークでは、バックスペースアクションを導入し、モデルが不要なトークンを戻すことを可能にする。新たに提案するSequenceMatchは、敵対的訓練やアーキテクチャの変更なしで実装でき、SequenceMatch-χ^2ダイバージェンスを適切な訓練目的として特定。実験的に、SequenceMatchは言語モデルによるテキスト生成や算術においてMLEを上回る改善を示す。 Comment
backspaceアクションをテキスト生成プロセスに組み込むことで、out of distributionを引き起こすトークンを元に戻すことで、生成エラーを軽減させることができる。
openreview: https://openreview.net/forum?id=FJWT0692hw
[Paper Note] Unifying Large Language Models and Knowledge Graphs: A Roadmap, Shirui Pan+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#Pretraining #MachineLearning #LanguageModel #KnowledgeGraph #One-Line Notes Issue Date: 2023-06-25 GPT Summary- LLMs(大規模言語モデル)とKGs(知識グラフ)の統合は、互いの利点を活かすために重要である。本論文では、KGを活用したLLMsの強化、LLMsを利用したKGの向上、そして両者が相互に利益をもたらす枠組みを示すロードマップを提示。これにより、既存の研究を整理し、今後の研究の方向性を明らかにする。 Comment
LLMsとKGの統合に関するロードマップを提示。KGをLLMの事前学習や推論に組み込む方法、KGタスクにLLMを利用する方法、LLMとKGの双方向のreasonieg能力を高める方法などをカバーしている。
[Paper Note] Textbooks Are All You Need, Suriya Gunasekar+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #MachineLearning #LanguageModel #SmallModel #Selected Papers/Blogs #One-Line Notes Issue Date: 2023-06-25 GPT Summary- phi-1は1.3BパラメータのTransformerベースの大規模言語モデルで、競合モデルより小型ながらHumanEvalで50.6%、MBPPで55.5%の高精度を達成。8台のA100 GPUを用いて、教科書品質データと合成生成データを組み合わせて訓練。phi-1-baseやphi-1-smallと比べても驚くべき創発特性を示す。 Comment
参考:
教科書のような品質の良いテキストで事前学習すると性能が向上し(グラフ真ん中)、さらに良質なエクササイズでFinetuningするとより性能が向上する(グラフ右)
日本語解説: https://dalab.jp/archives/journal/introduction-textbooks-are-all-you-need/
ざっくり言うと、教科書で事前学習し、エクササイズでFinetuningすると性能が向上する(= より大きいモデルと同等の性能が得られる)。
[Paper Note] RWKV: Reinventing RNNs for the Transformer Era, Bo Peng+, N_A, EMNLP'23 Findings, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Transformer #EMNLP #Findings #RecurrentModels Issue Date: 2023-06-16 GPT Summary- 本研究では、トランスフォーマーとRNNの両方の利点を組み合わせた新しいモデルアーキテクチャであるRWKVを提案し、トレーニング中に計算を並列化し、推論中に一定の計算およびメモリの複雑さを維持することができます。RWKVは、同じサイズのトランスフォーマーと同等のパフォーマンスを発揮し、将来的にはより効率的なモデルを作成するためにこのアーキテクチャを活用できることを示唆しています。 Comment
(斜め読みしかできておらず、不正確な点が多いと思います。ご容赦ください。)
RWKVの構造は基本的に、residual blockをスタックすることによって構成される。一つのresidual blockは、time-mixing(時間方向の混ぜ合わせ)と、channnel-mixing(要素間での混ぜ合わせ)を行う。
RWKVのカギとなる要素は以下の4つでありこれらが乗算によって交互作用する。RWKVのブロック、およびLMでのアーキテクチャは以下のようになる:
- R: 過去の情報をどれだけ取り入れるかを制御するゲート
- W: positionごとにどれだけ重みを減衰させるかを学習(言い換えると過去の情報をどれだけ減衰させていくか)
- K: attentionのKeyと同じ
- V: attentionのValueと同じ
r, k, vがそれぞれ時刻tでの状態を表しており、Transformerのように過去の全ての情報を保持するのではなく、時刻t-1のr,k,vに基づいて時刻tの状態を更新するためメモリ消費が大幅に削減される。
ここで、token-shiftは、previsou timestepのinputとのlinear interpolationを現在のinputととることである(時刻t-1のinputと時刻tのinputの交互作用をしてr, k, v, r', k' を決定する)。これにより過去の情報を考慮して状態を更新するRNNのような挙動となる。
RWKVは他のLLMと比較し、パラメータ数に対して性能はcomparableであり(Figure4)、context lengthを増やすことで、lossはきちんと低下し(Figure5)、テキスト生成をする際に要する時間は他のLLMと比較して、トークン数に対して線形にしか増加しない(Figure6)。
異なるtransformerとRWKVの計算量とメモリ消費量の比較。Inference timeは系列長に対して線形で、状態の保持は系列長に依存せず、d次元のみで済む。これはRNNのような逐次的な推論の際の話で、学習の際はTransformerのような並列性を持って学習できると思われる(3.2節)
openreview: https://openreview.net/forum?id=7SaXczaBpG
[Paper Note] How Language Model Hallucinations Can Snowball, Muru Zhang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #Hallucination #ICML #Selected Papers/Blogs #KeyPoint Notes #needs-revision Issue Date: 2023-06-16 GPT Summary- 言語モデルは実用的な応用においてハルシネーションのリスクを伴い、この現象は知識ギャップに起因することが多い。興味深いことに、モデルは誤りを認識しながらも偽の主張を出力する場合がある。「ハルシネーション・スノーボール現象」として知られるこの現象では、初期の過ちに固執することでさらなる誤りを招く。研究では、ChatGPTとGPT-4がそれぞれ67%および87%の誤りを特定できることが確認された。 Comment
LLMによるhallucinationは、単にLLMの知識不足によるものだけではなく、LLMが以前に生成したhallucinationを正当化するために、誤った出力を生成してしまうという仮説を提起し、この仮説を検証した研究。これをhallucination snowballと呼ぶ。これにより、LLMを訓練する際に、事実に対する正確さを犠牲にして、流暢性と一貫性を優先し言語モデルを訓練するリスクを示唆している。
[Paper Note] LLMs as Factual Reasoners: Insights from Existing Benchmarks and Beyond, Philippe Laban+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #Factuality #KeyPoint Notes Issue Date: 2023-06-16 GPT Summary- 実用設定でのLLMの重要性が増す中、事実の不整合検出手法が誤情報抑制とモデル信頼性向上に必要とされている。既存のベンチマークでLLMは競争力を示すが、より複雑なタスクでは失敗し、評価の精度に問題を生じさせる。これに対し、新たにSummEditsという10ドメインの不一致検出ベンチマークを提案し、再現性が高く、低コストで作成できる。多くのLLMはこのベンチマークで苦戦し、最良モデルのGPT-4も人間の性能を8%下回る結果を示し、LLMの限界を浮き彫りにしている。 Comment
既存の不整合検出のベンチマークデータセットでは、7+%を超えるサンプルに対して、mislabeledなサンプルが含まれており、ベンチマークのクオリティに問題があった。そこでSummEditsと呼ばれる事実の矛盾の検出力を検証するための新たなプロトコルを提案。既存の不整合検出では、既存のLLMを用いて比較した結果、最も不整合検出で性能が良かったGPT-4でさえ、人間に対して8%も低い性能であることが示され(要約結果に対して事実の矛盾が含まれているか否か検出するタスク)、まだまだLLMには課題があることが示された。
[Paper Note] Think Before You Act: Decision Transformers with Working Memory, Jikun Kang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Transformer #AIAgents Issue Date: 2023-06-16 GPT Summary- Decision Transformerベースのエージェントは複数タスクの一般化能力を示すが、大量のデータと計算資源に依存している。訓練中の忘却現象が新タスクの性能低下を引き起こすと考え、分散型の記憶ストレージを用いる人間の脳に着想を得て、作業記憶モジュールを提案。評価結果は、AtariゲームとMeta-Worldのタスクで訓練効率と一般化の向上を示し、メモリ微調整が適応性をさらに強化することを証明。
[Paper Note] Backpack Language Models, John Hewitt+, ACL'23 Outstanding Paper, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #ACL #Interpretability Issue Date: 2023-06-16 GPT Summary- Backpacksは、強力なモデル性能と解釈性を兼ね備えた新しいニューラルアーキテクチャで、各単語に対して複数の非文脈的な意味ベクトルを学習し、文脈依存の線形結合で表現します。訓練後、意味ベクトルは専門化し、モデルの挙動を予測可能に変更することが可能です。170MパラメータのBackpackモデルは、GPT-2 smallと同等の結果を示し、語彙的類似性評価では6Bパラメータのモデルを上回りました。また、意味ベクトルを介入することで、制御可能なテキスト生成やバイアス除去が可能です。 Comment
日本語解説: https://speakerdeck.com/tatsuropianooo/lun-wen-shao-jie-backpack-language-models
OlaGPT: Empowering LLMs With Human-like Problem-Solving Abilities, Yuanzhen Xie+, N_A, arXiv'23
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought Issue Date: 2023-06-16 GPT Summary- 本論文では、人間の認知フレームワークを模倣することで、複雑な推論問題を解決するための新しい知的フレームワークであるOlaGPTを提案しています。OlaGPTは、注意、記憶、推論、学習などの異なる認知モジュールを含み、以前の誤りや専門家の意見を動的に参照する学習ユニットを提供しています。また、Chain-of-Thought(COT)テンプレートと包括的な意思決定メカニズムも提案されています。OlaGPTは、複数の推論データセットで厳密に評価され、最先端のベンチマークを上回る優れた性能を示しています。OlaGPTの実装はGitHubで利用可能です。
[Paper Note] ViCo: Plug-and-play Visual Condition for Personalized Text-to-image Generation, Shaozhe Hao+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #Personalization #DiffusionModel #TextToImageGeneration Issue Date: 2023-06-16 GPT Summary- ViCoは、個別化されたテキストから画像を生成する軽量な拡散モデルで、従来のモデルのファインチューニングを不要とし、柔軟でスケーラブルな展開を実現します。ViCoは、画像アテンションモジュールを通じて視覚セマンティクスを統合し、約6%のパラメータ学習で最先端モデルと同等の性能を達成。個別化テキストからの画像生成における有効性を示し、今後の展望が期待されます。
[Paper Note] AVIS: Autonomous Visual Information Seeking with Large Language Model Agent, Ziniu Hu+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#ComputerVision #QuestionAnswering #MultiModal Issue Date: 2023-06-16 GPT Summary- 自律的情報探索型視覚質問応答フレームワークAVISを提案。LLMを活用して外部ツールを動的に戦略化し、複雑な視覚質問に対して必要な知識を獲得。ユーザ研究を通じて得られたデータを基に、ツール決定プランナー、情報分析推論機、作業メモリ機構からなるシステムを設計。AVISは知識集約型ベンチマークで最先端の性能を達成。
KoLA: Carefully Benchmarking World Knowledge of Large Language Models, Jifan Yu+, N_A, arXiv'23
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation Issue Date: 2023-06-16 GPT Summary- LLMの評価を改善するために、KoLAという知識指向のベンチマークを構築した。このベンチマークは、19のタスクをカバーし、Wikipediaと新興コーパスを使用して、知識の幻覚を自動的に評価する独自の自己対照メトリックを含む対照的なシステムを採用している。21のオープンソースと商用のLLMを評価し、KoLAデータセットとオープン参加のリーダーボードは、LLMや知識関連システムの開発の参考資料として継続的に更新される。
[Paper Note] One-for-All: Generalized LoRA for Parameter-Efficient Fine-tuning, Arnav Chavan+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #PostTraining Issue Date: 2023-06-16 GPT Summary- GLoRAは、Low-Rank Adaptationを拡張した普遍的な微調整手法であり、事前学習済みモデルの重みと中間活性化を最適化することで多様なタスクに対応します。層ごとの構造探索により、個別アダプターを学習し、効率的なパラメータ適応を促進。包括的な実験により、GLoRAが従来法を上回り、LLaMA-1およびLLaMA-2で改善を示しました。推論コストを追加せず、リソース制限のあるアプリケーションに適しています。 Comment
OpenReview:
https://openreview.net/forum?id=K7KQkiHanD
ICLR'24にrejectされている
[Paper Note] LLM-Blender: Ensembling Large Language Models with Pairwise Ranking and Generative Fusion, Dongfu Jiang+, arXiv'23, 2023.06
Paper/Blog Link My Issue
#PairWise #LanguageModel #Ensemble #ACL #ModelMerge #needs-revision Issue Date: 2023-06-16 GPT Summary- LLM-Blenderは、複数のオープンソースLLMの強みを活かすアンサンブルフレームワークで、PairRankerとGenFuserのモジュールから構成され、最適なLLMの選択を改善します。PairRankerは候補間の詳細な比較を行い、GenFuserはトップランクの候補を統合して出力を向上させます。MixInstructデータセットを用いた実験により、LLM-Blenderは他の手法を大きく上回る性能を示しました。
[Paper Note] Visualizing Linguistic Diversity of Text Datasets Synthesized by Large Language Models, Emily Reif+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #SyntheticData #Evaluation #KeyPoint Notes #Interpretability Issue Date: 2023-05-22 GPT Summary- 大規模言語モデル(LLMs)を用いて生成されたデータセットの構文的多様性を分析するための視覚化ツール「LinguisticLens」を提案。これにより、テキストを構文的、語彙的、意味的にクラスタリングし、ユーザーがデータセットを迅速にスキャンし、個々の例を検査できるようにする。 Comment
LLMを用いてfew-shot promptingを利用して生成されたデータセットを理解し評価することは難しく、そもそもLLMによって生成されるデータの失敗に関してはあまり理解が進んでいない(e.g. repetitionなどは知られている)。この研究では、LLMによって生成されたデータセットの特性を理解するために、構文・語彙・意味の軸に沿ってクラスタリングすることで、データセットの特性を可視化することで、このような課題を解決することをサポートしている。
特に、従来研究ではGoldが存在することが前提な手法が利用されてきた(e.g. 生成データを利用しdownstream taskの予測性能で良さを測る、Gold distributionとdistributionを比較する)。しかし、このような手法では、synthetic data firstなシチュエーションで、Goldが存在しない場合に対処できない。このような問題を解決するためにGold dataが存在しない場合に、データの構文・語彙・意味に基づくクラスタリングを実施し結果を可視化し、human-in-the-loopの枠組みでデータセットの良さを検証する方法を提案している。
可視化例
実装: https://github.com/PAIR-code/interpretability/tree/master/data-synth-syntax
[Paper Note] QUEST: A Retrieval Dataset of Entity-Seeking Queries with Implicit Set Operations, Chaitanya Malaviya+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#InformationRetrieval #Search #Dataset #Evaluation #ACL #needs-revision Issue Date: 2023-05-22 GPT Summary- 情報ニーズの定式化に基づき、集合演算を含む自然言語クエリからなるデータセットQUESTを構築。3357件のクエリはWikipediaエンティティにマッピングされ、モデルの集合演算能力を試す。データセットは半自動で作成され、クラウドワーカーによって文書の関連性とクエリの自然さが検証される。多くの現代検索システムは、否定や結合を含むクエリの処理に苦戦していることが明らかになった。
[Paper Note] LIMA: Less Is More for Alignment, Chunting Zhou+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #Alignment #Supervised-FineTuning (SFT) #DataDistillation #NeurIPS #KeyPoint Notes #Reading Reflections #needs-revision Issue Date: 2023-05-22 GPT Summary- LIMAは65BパラメータのLLaMaモデルで、1,000件の慎重に選定されたプロンプトで微調整された。モデルは汎用表現を学び、未知のタスクに対しても良好に一般化。人間評価では、LIMAの性能がGPT-4より43%、Bardより58%、DaVinci003より65%優れていることが示され、事前学習が知識の大半を構築する重要性を強調している。 Comment
LLaMA65Bをたった1kのdata point(厳選された物)でRLHF無しでfinetuningすると、旅行プランの作成や、歴史改変の推測(?)幅広いタスクで高いパフォーマンスを示し、未知のタスクへの汎化能力も示した。最終的にGPT3,4,BARD,CLAUDEよりも人間が好む回答を返した。
LLaMAのようなオープンでパラメータ数が少ないモデルに対して、少量のサンプルでfinetuningするとGPT4に迫れるというのはgamechangerになる可能性がある
openreview: https://openreview.net/forum?id=KBMOKmX2he
[Paper Note] Symbol tuning improves in-context learning in language models, Jerry Wei+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #In-ContextLearning #EMNLP #PostTraining #KeyPoint Notes #needs-revision Issue Date: 2023-05-21 GPT Summary- シンボルチューニングを提案し、自然言語ラベルを記号に置換した文脈内の入力-ラベルペアによる言語モデルのファインチューニングを行う。これにより、モデルは指示がない場合でもタスクを解決できる。5400億パラメータのFlan-PaLMモデルでの実験により、未見のタスクに対する性能が向上し、特にアルゴリズム的推論タスクで最大18.2%の性能向上を示した。また、反転ラベルに従う能力が強化された。 Comment
概要やOpenReviewの内容をざっくりとしか読めていないが、自然言語のラベルをランダムな文字列にしたり、instructionをあえて除外してモデルをFinetuningすることで、promptに対するsensitivityや元々モデルが持っているラベルと矛盾した意味をin context learningで上書きできるということは、学習データに含まれるテキストを調整することで、正則化の役割を果たしていると考えられる。つまり、ラベルそのものに自然言語としての意味を含ませないことや、instructionを無くすことで、(モデルが表層的なラベルの意味や指示からではなく)、より実際のICLで利用されるExaplarからタスクを推論するように学習されるのだと思われる。
OpenReview: https://openreview.net/forum?id=vOX7Dfwo3v
[Paper Note] DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining, Sang Michael Xie+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Pretraining #LanguageModel #DataDistillation #NeurIPS #Selected Papers/Blogs #DataMixture #One-Line Notes Issue Date: 2023-05-21 GPT Summary- ドメイン混合割合が言語モデル(LM)の性能に影響を与える中、本論文はドメイン再重み付け(DoReMi)を提案。DoReMiは、まず代理モデルを使ってドメイン重みを生成し、その後データをリサンプリングして大規模モデルを効率的に訓練。実験では、DoReMiを用いた代理モデルが、パープレキシティを改善し、少数ショット精度を6.5ポイント向上、訓練ステップは2.6倍少なくて済むと示した。GLaMデータセットでは、ドメイン重み無しでも高い性能を達成。 Comment
事前学習する際の各ドメインのデータをどのような比率でmixtureするかの話。各ドメインごとに小さなproxy modelを訓練し、downstream taskの知識無しでドメインごとの重みを生成。データセットを生成されたドメインごとの重みに従いリサンプリングすることで、(1/30のプロキシモデルを用いた場合)オリジナルのデータより2.6倍高速で、6.5%oneshotのaccuracyを向上させることに成功
openreview: https://openreview.net/forum?id=lXuByUeHhd
[Paper Note] StructGPT: A General Framework for Large Language Model to Reason over Structured Data, Jinhao Jiang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #TabularData #Reasoning #One-Line Notes Issue Date: 2023-05-21 GPT Summary- 本研究では、構造化データに基づく質問応答タスクを解決するためにIterative Reading-then-Reasoning(IRR)アプローチ、StructGPTを開発。特化した関数を用いることで、関連証拠を収集し推論を行うプロセスを構築。さらに、外部インターフェースを利用したinvoking-linearization-generation手順を提案し、反復的に解答に近づく。実験結果は、ChatGPTの性能を大幅に向上させ、教師ありチューニングと同等の成果を示す。 Comment
構造化データに対するLLMのゼロショットのreasoning能力を改善。構造化データに対するQAタスクで手法が有効なことを示した。
[Paper Note] Chain-of-Symbol Prompting Elicits Planning in Large Langauge Models, Hanxu Hu+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #Planning #One-Line Notes #needs-revision Issue Date: 2023-05-21 GPT Summary- 自然言語で表現された仮想空間における複雑な計画タスクに対するLLMsの性能を調査し、新たなベンチマークNatalaを提案。LLMs(例: ChatGPT)は依然として計画能力に限界があり、象徴的表現が理解しやすい可能性を示す。新手法CoS(Chain-of-Symbol Prompting)は追加訓練なしでLLMsに適用でき、広範な実験でCoT(Chain-of-Thought)を上回る性能を達成。特に、ChatGPTの正確性が最大60.8%向上し、中間段階のトークン数も著しく削減された。 Comment
LLMは複雑なプランニングが苦手なことが知られており、複雑な環境を自然言語ではなく、spatialでsymbolicなトークンで表現することで、プランニングの性能が向上したという話
OpenReview: https://openreview.net/forum?id=B0wJ5oCPdB
[Paper Note] What In-Context Learning "Learns" In-Context: Disentangling Task Recognition and Task Learning, Jane Pan+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #MachineLearning #LanguageModel #In-ContextLearning #KeyPoint Notes Issue Date: 2023-05-20 GPT Summary- ICLにおける大規模言語モデルの機能を探求し、タスク認識(TR)とタスク学習(TL)の2つの経路を特定。TRは事前知識を利用し、TLは新しい入力-ラベルのマッピングを捉える能力を示す。実験により、モデルはTRだけで非自明な性能を発揮し、大規模モデルはTLを向上させることがわかった。これらの異なる力を区別する重要性を提言。 Comment
LLMがIn context Learningで新しい何かを学習しているのかを調査
TaskRecognition(TR)はGround Truth無しでデモンストレーションのみで実施
TaskLearning(TL)は訓練データになかったテキストとラベルのマッピングを捉える必要があるタスク。
TRはモデルサイズでスケールしなかったが、TLはモデルサイズに対してスケールした
→ 事前学習で学習してきた知識を引っ張ってくるだけではTLは実施できないので、TRでは何も学習していないが、TLにおいては新しく何かが学習されてるんじゃない?ということだろうか
[Paper Note] CodeT5+: Open Code Large Language Models for Code Understanding and Generation, Yue Wang+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #CodeGeneration #Encoder-Decoder #One-Line Notes Issue Date: 2023-05-20 GPT Summary- コードLLMsは特定のアーキテクチャに依存しがちで、事前学習タスクの制約により性能が低下することがある。本研究では、この問題を解決するために「CodeT5+」を提案。CodeT5+は柔軟な部品モジュールの組み合わせを可能にし、 diverseな事前学習目的でタスク要求に応じる。更に、既存のLLMを初期化に利用し効率的にスケールアップ。20以上のコードベンチマークで評価し、指示調整済みのCodeT5+がHumanEvalタスクで新たな最先端性能を達成した。 Comment
様々なコードの理解と生成タスクをサポート
異なる訓練手法によって計算効率改善
20種類のコードベンチマークで、様々な設定「ゼロショット、finetuning, instruction tuning等)を実施した結果、コード補完、math programming, text to code retrievalにおいてSoTA達成
[Paper Note] TrueTeacher: Learning Factual Consistency Evaluation with Large Language Models, Zorik Gekhman+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Dataset #Evaluation #Hallucination #Factuality #One-Line Notes Issue Date: 2023-05-20 GPT Summary- TrueTeacherは、多様なモデル生成要約をLLMで注釈し、実際の生成要約に基づいた合成データを生成するアプローチである。従来の手法とは異なり、手作業での要約に依存せず、多言語対応も可能。実験結果は、TrueTeacherを使用して訓練したstudentモデルが他の最先端モデルやLLM教師を大幅に上回ることを示し、ドメインシフトに対する堅牢性も確認された。加えて、140万例の大規模合成データセットと訓練したチェックポイントも公開。 Comment
Factual Consistency Evaluationに関する研究。オリジナルのテキストに対して、様々な規模の言語モデルを用いて要約を生成。生成された要約に対してfactual informationが正しく含まれているかをラベル付けする方法を提案。
[Paper Note] Explaining black box text modules in natural language with language models, Chandan Singh+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #NeurIPS #Workshop #Interpretability #needs-revision Issue Date: 2023-05-20 GPT Summary- 大規模言語モデル(LLMs)の解釈性の必要性に応えるため、テキストモジュールの入力と出力に基づいて自然言語の説明を自動生成する手法、Summarize and Score(SASC)を提案。合成モジュールへの適用で真の説明を回復し、BERTモデル内のモジュールを検査可能にし、言語刺激へのfMRI応答の説明まで可能。すべてのコードはGitHubに公開。 Comment
モデルのinterpretabilityに関するMSの新たな研究
[Paper Note] Emergent Representations of Program Semantics in Language Models Trained on Programs, Charles Jin+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #LanguageModel #Coding #ICML #One-Line Notes #needs-revision Issue Date: 2023-05-20 GPT Summary- 言語モデル(LM)が次のトークン予測に特化した訓練にもかかわらず、形式的意味を表現できる可能性を示す。2Dグリッド環境でのプログラム合成コーパスを用いてTransformerモデルを訓練し、特定の入力出力仕様が付随するプログラムから、未観測の中間状態を精度よく抽出できることを発見。新しい介入ベースラインにより、LMの表現とプロービングによる結果の明確な識別が可能に。広範な意味論的プロービング実験への適用が期待される。 Comment
プログラムのコーパスでLLMをNext Token Predictionで訓練し
厳密に正解とsemanticsを定義した上で、訓練データと異なるsemanticsの異なるプログラムを生成できることを示した。
LLMが意味を理解していることを暗示している
参考:
[Paper Note] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, Shunyu Yao+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought #Prompting #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-05-20 GPT Summary- 言語モデルは一般的な問題解決に広がっているが、推論は依然としてトークンレベルの左から右への決定に制限されている。これを克服するために、新しい「Tree of Thoughts(ToT)」フレームワークを導入。ToTは、思考の連鎖を一般化し、中間ステップを探索できるようにし、複数の推論経路を自己評価することで意図的な意思決定を可能にする。実験では、ToTがGame of 24やCreative Writingなどの新規タスクで言語モデルの問題解決能力を顕著に向上させることが示された。例えば、Game of 24では新手法が74%の成功率を達成した。 Comment
Self Concistencyの次
Non trivialなプランニングと検索が必要な新たな3つのタスクについて、CoT w/ GPT4の成功率が4%だったところを、ToTでは74%を達成
論文中の表ではCoTのSuccessRateが40%と書いてあるような?
[Paper Note] MEGABYTE: Predicting Million-byte Sequences with Multiscale Transformers, Lili Yu+, NeurIPS'23, 2023.05
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #MachineLearning #Transformer #SpeechProcessing #LongContext #Architecture #NeurIPS #One-Line Notes #Byte-level Issue Date: 2023-05-15 GPT Summary- Megabyteというマルチスケールデコーダーアーキテクチャを提案し、長いシーケンスのエンドツーエンドのモデリングを可能にする。シーケンスをパッチに分割し、ローカルサブモデルとグローバルモデルを使用することで、計算効率を向上させつつコストを削減。実験により、Megabyteは長いコンテキストの言語モデリングで競争力を持ち、最先端の密度推定を達成した。トークン化なしの自己回帰シーケンスモデリングの実現可能性を示す。 Comment
byte列のsequenceからpatch embeddingを作成することで、tokenizer freeなtransformerを提案。
byte列で表現されるデータならなんでも入力できる。つまり、理論上なんでも入力できる。
openreview: https://openreview.net/forum?id=JTmO2V9Xpz
[Paper Note] Sketching the Future (STF): Applying Conditional Control Techniques to Text-to-Video Models, Rohan Dhesikan+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #Controllable #VideoGeneration/Understandings #TextToVideoGeneration Issue Date: 2023-05-12 GPT Summary- ゼロショットのテキストからビデオ生成にControlNetを組み合わせた新しいアプローチを提案。複数のスケッチ風フレームを入力とし、それに一致するビデオを生成。フレーム補間とControlNetによる制御で高品質で一貫性のあるビデオを実現。デモ動画やリソースも提供し、さらなる研究を促進。
[Paper Note] Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting, Miles Turpin+, arXiv'23, 2023.05
Paper/Blog Link My Issue
#Analysis #LanguageModel #Chain-of-Thought #Faithfulness #NeurIPS #needs-revision Issue Date: 2023-05-09 GPT Summary- LLMは段階的推論(CoT)を通じて高い性能を発揮するが、CoTの説明は予測の真の理由を誤って表現することがある。入力にバイアスを与えられると、誤答を正当化する説明が生成され、精度が最大36%低下することが示された。特に、社会的バイアスに関連する場合、モデルの説明がステレオタイプを強化し、バイアスの影響について言及しない。これにより、CoTの説明は一見もっともらしいが誤導的であり、信頼性を高めるリスクを伴う。より透明なシステムを構築するためには、CoTの信頼性を向上させるか、代替手法を検討すべきである。
Towards Personalized Review Summarization by Modeling Historical Reviews from Customer and Product Separately, Xin Cheng+, N_A, arXiv'23
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #Personalization #review Issue Date: 2023-05-05 GPT Summary- レビュー要約は、Eコマースのウェブサイトにおいて製品レビューの主要なアイデアを要約することを目的としたタスクである。本研究では、評価情報を含む2種類の過去のレビューをグラフ推論モジュールと対比損失を用いて別々にモデル化するHHRRSを提案する。レビューの感情分類と要約を共同で行うマルチタスクフレームワークを採用し、4つのベンチマークデータセットでの徹底的な実験により、HHRRSが両方のタスクで優れた性能を発揮することが示された。
[Paper Note] Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them, Mirac Suzgun+, ACL'23, 2022.10
Paper/Blog Link My Issue
#LanguageModel #Zero/Few/ManyShotPrompting #Chain-of-Thought #ACL #One-Line Notes Issue Date: 2023-05-04 GPT Summary- BIG-Benchは、言語モデルの限界を超えたタスクに焦点を当てた評価スイートであり、モデルはすでに65%のタスクで平均的な人間評価者を上回っている。本研究では、BBH(BIG-Bench Hard)として知られる、従来の評価で人間を下回った23の困難なタスクを分析。連鎖思考(CoT)プロンプティングを用いることで、PaLMは10タスク、Codexは17タスクで人間評価者を上回ることを示す。多段階の推論が求められるため、CoTなしの評価はモデルの性能を過小評価し、CoTはBBHタスクの性能向上に寄与することが明らかになった。 Comment
単なるfewshotではなく、CoT付きのfewshotをすると大幅にBIG-Bench-hardの性能が向上するので、CoTを使わないanswer onlyの設定はモデルの能力の過小評価につながるよ、という話らしい
Poisoning Language Models During Instruction Tuning, Alexander Wan+, N_A, ICML'23
Paper/Blog Link My Issue
#LanguageModel #Poisoning #ICML Issue Date: 2023-05-04 GPT Summary- - Instruction-tuned LMs(ChatGPT、FLAN、InstructGPTなど)は、ユーザーが提出した例を含むデータセットでfinetuneされる。- 本研究では、敵対者が毒入りの例を提供することで、LMの予測を操作できることを示す。- 毒入りの例を構築するために、LMのbag-of-words近似を使用して入出力を最適化する。- 大きなLMほど毒入り攻撃に対して脆弱であり、データフィルタリングやモデル容量の削減に基づく防御は、テストの正確性を低下させながら、中程度の保護しか提供しない。
[Paper Note] Frustratingly Easy Label Projection for Cross-lingual Transfer, Yang Chen+, ACL'23, 2022.11
Paper/Blog Link My Issue
#MachineTranslation #LanguageModel #Annotation #TransferLearning #MultiLingual #ACL Issue Date: 2023-05-04 GPT Summary- 多言語へのラベル投影には、マーク・アンド・トランスレート法を用いた新しいアプローチが提案され、57言語と3つのタスクにおける実証研究が行われた。実験結果は、EasyProjectが単語アライメント技術を上回る性能を示し、翻訳後もラベルスパンの境界を保持することができることを明らかにした。全コードとデータは公開されている。
[Paper Note] PMC-LLaMA: Towards Building Open-source Language Models for Medicine, Chaoyi Wu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #OpenWeight #Medical #KeyPoint Notes Issue Date: 2023-05-01 GPT Summary- 医療向けに特化したオープンソース言語モデルPMC-LLaMAを構築。一般目的の基盤モデルを医療ドメインに適応させ、4.8百万件の生物医学論文と3万冊の医療教科書から知識を注入。指示チューニング用の大規模データセットも提供し、徹底したアブレーション研究でその有効性を確認。130億パラメータの軽量版PMCLLaMAは複数の医療質問応答ベンチマークで高い性能を示し、ChatGPTを凌駕する場面も確認。 Comment
LLaMAを4.8Mのmedical paperでfinetuningし、医療ドメインの能力を向上。このモデルはPMC-LLaMAと呼ばれ、biomedicalQAタスクで、高い性能を達成した。
GPT-4を利用した異なるモデル間の出力の比較も行なっている模様
[Paper Note] Efficiently Scaling Transformer Inference, Reiner Pope+, MLSys'23, 2022.11
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #Attention #LongContext #Architecture #Inference #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 大規模なTransformerモデルの生成的推論を、長いシーケンス長と厳格な遅延目標の下で研究。TPU v4用に最適化された解析モデルを開発し、待機時間とモデルFLOPS利用率のトレードオフにおいて新しいパレート前線を達成。マルチクエリ注意機構を用いることでメモリ要件を減少させ、コンテキスト長を最大32倍に拡張。最終的に、小さなバッチサイズでの1トークンあたりの遅延は29ミリ秒となり、MFUは76%に達し、PaLM 540Bモデルで2048トークンのコンテキストをサポート。 Comment
特にMultiquery Attentionという技術がTransformerのinferenceのコスト削減に有効らしい
Multi Query Attention (MQA):
- [Paper Note] Fast Transformer Decoding: One Write-Head is All You Need, Noam Shazeer, arXiv'19, 2019.11
[Paper Note] Controlled Text Generation with Natural Language Instructions, Wangchunshu Zhou+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #Prompting #SyntheticData #In-ContextLearning #ICML #PostTraining #One-Line Notes Issue Date: 2023-04-30 GPT Summary- 自然言語の指示に従い、多様なタスクを解決可能な大規模言語モデルの制御を改善するために、「InstructCTG」というフレームワークを提案。自然テキストの制約を抽出し、これを自然言語の指示に変換することで弱教師あり訓練データを形成。異なるタイプの制約に柔軟に対応し、生成の質や速度への影響を最小限に抑えつつ、再訓練なしで新しい制約に適応できる能力を持つ。 Comment
制約に関する指示とデモンスとレーションに関するデータを合成して追加のinstruction tuningを実施することで、promptで指示された制約を満たすような(controllableな)テキストの生成能力を高める手法
[Paper Note] Boosting Theory-of-Mind Performance in Large Language Models via Prompting, Shima Rahimi Moghaddam+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #Prompting #TheoryOfMind #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- LLMのToM性能を評価し、文脈内学習が理解を向上させる効果を検討。2ショットの連鎖思考と段階的思考指示を用いたプロンプトで、RLHF訓練モデルはToM精度を80%以上に。特にGPT-4は文脈内学習で100%に達し、適切なプロンプト付けがLLMの推論を強化することを示した。 Comment
LLMはTheory-of-mind reasoningタスクが苦手なことが知られており、特にzero shotでは非常にパフォーマンスが低かった。ToMタスクとは、エージェントの信念、ゴール、メンタルstate、エージェントが何を知っているか等をトラッキングすることが求められるタスクのこと。このようなタスクはLLMが我々の日常生活を理解する上で重要。
↑のToM Questionのシナリオと問題
Scenario: "The morning of the high school dance Sarah placed her high heel shoes under her dress and then went shopping. That afternoon, her sister borrowed the shoes and later put them under Sarah's bed."
Question: When Sarah gets ready, does she assume her shoes are under her dress?
しかし、Zero shot CoTのようなstep by step thinking, CoTを適切に行うことで、OpenAIの直近3つのモデルのAccuracyが80%を超えた。特に、GPT4は100%のAccuracyを達成。人間は87%だった。
この結果は、少なくとのこの論文でテストしたドメインではLLMのsocial reasoningのパフォーマンスをどのようにブーストするかを示しており、LLMのbehaviorは複雑でsensitiveであることを示唆している。
[Paper Note] Large Language Models are Versatile Decomposers: Decompose Evidence and Questions for Table-based Reasoning, Yunhu Ye+, SIGIR'23, 2023.01
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #TabularData #SIGIR #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- LLMを活用して、表ベースの推論における巨大な証拠を小さなサブ証拠に分解し、複雑な質問をシンプルなサブ質問に分解。各ステップで論理と数値計算を分離することで、思考の連鎖における幻覚を防止。提案手法は、TabFactで人間を超える性能を達成。 Comment
テーブルとquestionが与えられた時に、questionをsub-questionとsmall tableにLLMでin-context learningすることで分割。subquestionの解を得るためのsqlを作成しスポットを埋め、hallucinationを防ぐ。最終的にLLM Reasonerが解答を導出する。TabFact Reasoningで初めて人間を超えた性能を発揮。
[Paper Note] q2d: Turning Questions into Dialogs to Teach Models How to Search, Yonatan Bitton+, EMNLP'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #DialogueGeneration #SyntheticData #EMNLP #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 質問から情報探索型対話を自動生成するデータ生成パイプラインq2dを提案。大規模言語モデルPaLMを用いて対話データを作成し、外部検索APIでクエリ生成モデルの性能を向上。合成データで訓練したモデルは人間作成データの90%〜97%に達し、無データでも新ドメイン向けの対話データを生成可能。生成された対話は高品質と評価され、人間作成の対話と区別が難しい。 Comment
LLMにquestionを与え、questionを解決するためのinformation seekingの対話ログを生成させる。このデータを用いて、dialogueからquestionを生成するモデルを訓練し、検索APIなどに渡せるようにした研究。全く対話のログがないドメインのデータに対しても、人間と遜色ない高品質な対話が生成可能。これにより、query generationモデルの更なる高性能化が実現できる。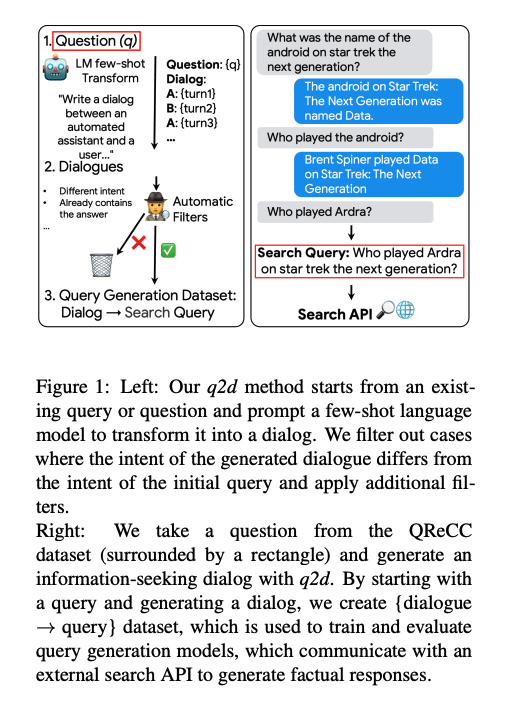
openreview: https://openreview.net/forum?id=8iB0FJmOfV
[Paper Note] Tractable Control for Autoregressive Language Generation, Honghua Zhang+, ICML'23, 2023.04
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Controllable #LanguageModel #ICML #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 自己回帰型大規模言語モデルは複雑な制約を満たすテキスト生成に課題がある。これに対処するため、語彙的制約を扱う確率モデル(TPMs)を用いたGeLaToフレームワークを提案。蒸留された隠れマルコフモデルを利用し、自己回帰生成の効率的な指導を可能にし、制約付きテキスト生成において最先端の性能を達成。研究は大規模言語モデルの制御に新たな道を開き、TPMsのさらなる発展を促進する。 Comment
自然言語生成モデルで、何らかのシンプルなconstiaint αの元p(xi|xi-1,α)を生成しようとしても計算ができない。このため、言語モデルをfinetuningするか、promptで制御するか、などがおこなわれる。しかしこの方法は近似的な解法であり、αがたとえシンプルであっても(何らかの語尾を付与するなど)、必ずしも満たした生成が行われるとは限らない。これは単に言語モデルがautoregressiveな方法で次のトークンの分布を予測しているだけであることに起因している。そこで、この問題を解決するために、tractable probabilistic model(TPM)を導入し、解決した。
評価の結果、CommonGenにおいて、SoTAを達成した。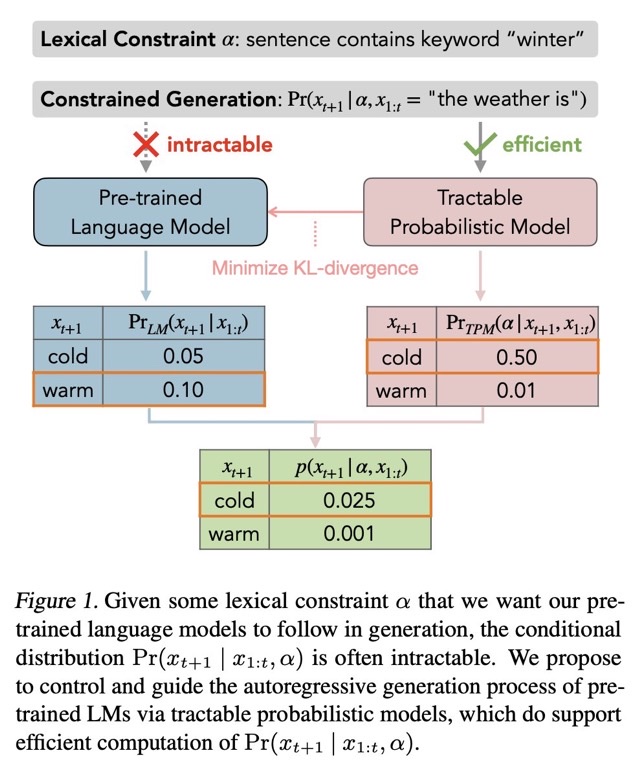
尚、TPMについては要勉強である
[Paper Note] AI, write an essay for me: A large-scale comparison of human-written versus ChatGPT-generated essays, Steffen Herbold+, arXiv'23
Paper/Blog Link My Issue
#LanguageModel #Education #AES(AutomatedEssayScoring) #ChatGPT #One-Line Notes Issue Date: 2023-04-28 GPT Summary- ChatGPTが生成したエッセイは、人間が書いたものよりも質が高いと評価されることが大規模な研究で示された。生成されたエッセイは独自の言語的特徴を持ち、教育者はこの技術を活用する新たな教育コンセプトを開発する必要がある。 Comment
ChatGPTは人間が書いたエッセイよりも高品質なエッセイが書けることを示した。
また、AIモデルの文体は、人間が書いたエッセイとは異なる言語的特徴を示している。たとえば、談話や認識マーカーが少ないが、名詞化が多く、語彙の多様性が高いという特徴がある、とのこと。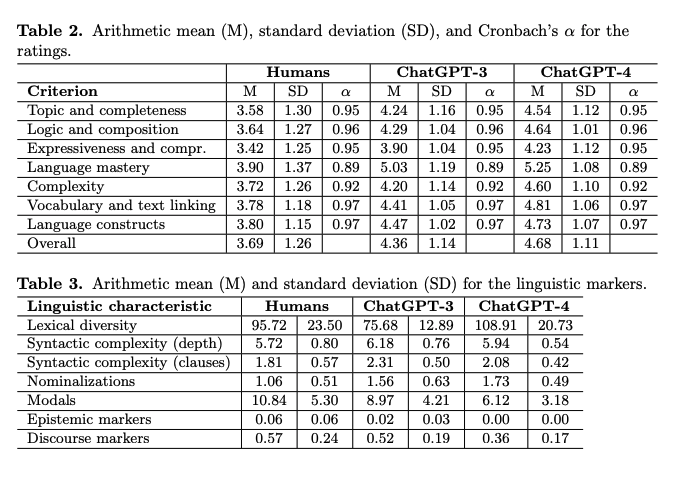
[Paper Note] Exploring the Curious Case of Code Prompts, Li Zhang+, NLRSE'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought #Prompting #Reasoning #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- コード風のプロンプトによる構造化推論の性能向上が示されたが、その効果は限られたタスクに留まる。本研究では、davinci系のモデルに対して、QAや感情分析など幅広いタスクでコードとテキストプロンプトを比較し、全体としてコードプロンプトがテキストプロンプトを上回ることはなかった。タスクによってはコードプロンプトが有利な場合もあったが、全てのタスクに当てはまるわけではなく、テキスト指示によるファインチューニングがコードプロンプトの性能向上に寄与することを示した。 Comment
コードベースのLLMに対して、reasoningタスクを解かせる際には、promptもコードにすると10パーセント程度性能上がる場合があるよ、という研究。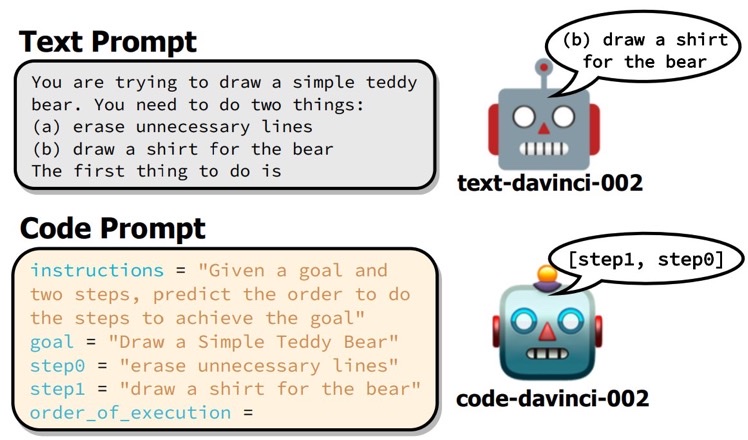
ただし、平均的にはテキストプロンプトの方が良く、一部タスクで性能が改善する、という温度感な模様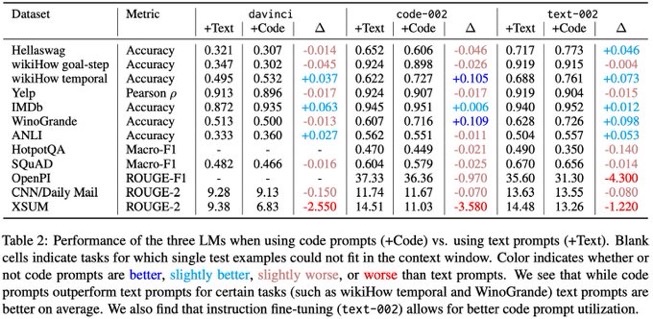
コードベースのモデルをtextでinstruction tuningしている場合でも、効果があるタスクがある。
[Paper Note] Answering Questions by Meta-Reasoning over Multiple Chains of Thought, Ori Yoran+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #QuestionAnswering #Chain-of-Thought #Prompting #EMNLP #KeyPoint Notes Issue Date: 2023-04-28 GPT Summary- 複数の推論チェーンを考慮したMulti-Chain Reasoning(MCR)を提案。これにより、異なるチェーン間の情報を統合し、回答生成時に関連性の高い事実を選択することで、より質の高い説明を提供。7つのマルチホップQAデータセットで優れた性能を示し、人間による検証も可能な高品質な説明を実現。 Comment
self-consistency [Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
のようなvoting basedなアルゴリズムは、複数のCoTのintermediate stepを捨ててしまい、結果だけを採用するが、この研究は複数のCoTの中からquestionに回答するために適切なfactual informationを抽出するMeta Reasonerを導入し、複数のCoTの情報を適切に混在させて適切な回答を得られるようにした。
7個のMulti Hop QAデータでstrong baselineをoutperformし、人間が回答をverificationするための高品質な説明を生成できることを示した。
openreview: https://openreview.net/forum?id=ebSOK1nV2r
[Paper Note] Language Models Enable Simple Systems for Generating Structured Views of Heterogeneous Data Lakes, Simran Arora+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #TabularData #One-Line Notes #Data Issue Date: 2023-04-27 GPT Summary- LLMを用いた半構造化文書の自動処理システムEVAPORATEを提案。文書からの値を直接抽出する方法と、抽出コードを合成する方法の二つを評価。コード合成はコストが低いが精度が劣るため、EVAPORATE-CODE+を導入し、品質を向上。弱教師あり学習を用いた抽出のアンサンブルにより、文書処理の効率を大幅に改善。処理トークン数を平均110倍に削減し、最先端システムを超える成果を達成。 Comment
LLMを使うことで、半構造化文章から自動的にqueryableなテーブルを作成することを試みた研究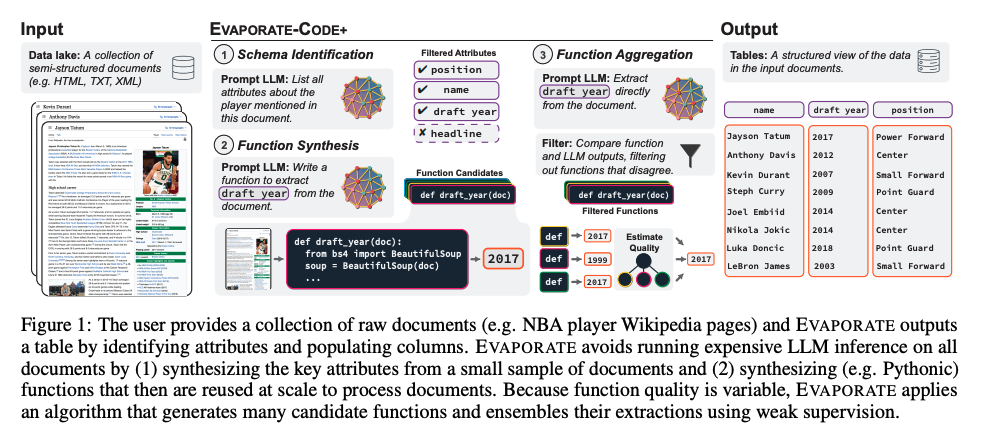
[Paper Note] Can GPT-4 Perform Neural Architecture Search?, Mingkai Zheng+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #NeuralArchitectureSearch #KeyPoint Notes Issue Date: 2023-04-27 GPT Summary- GPT-4を用いたニューラルアーキテクチャ探索(NAS)に関する研究を行い、提案手法GENIUSはGPT-4の生成能力を活用してアーキテクチャ探索空間を迅速にナビゲート、候補を特定し性能を向上させる。いくつかのベンチマークで評価し、既存のNAS技術と比較してその効果を示す。特に、限られたドメイン知識を要するプロンプト手法を通じてGPT-4が技術問題の研究に貢献する可能性を強調。さらに、研究の制約やAIの安全性への影響についても言及。 Comment
ドメイン知識の必要のないプロンプトで、ニューラルモデルのアーキテクチャの提案をGPTにしてもらう研究。accをフィードバックとして与え、良い構造を提案するといったループを繰り返す模様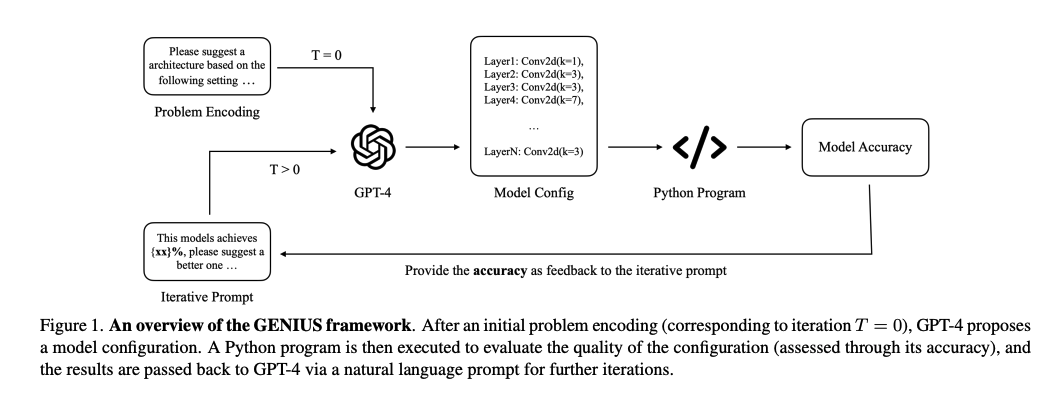
Neural Architecture Search (NAS)においては、ランダムベースラインがよく採用されるらしく、比較した結果ランダムよりよかった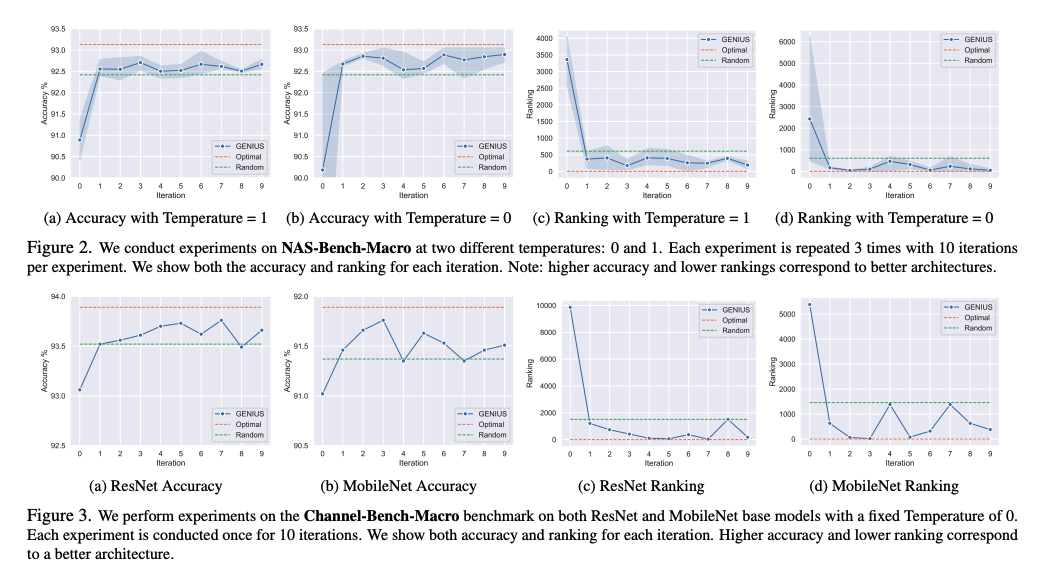
NAS201と呼ばれるベンチマーク(NNアーキテクチャのcell blockをデザインすることにフォーカス; 探索空間は4つのノードと6つのエッジで構成される密接続のDAGとして表される; ノードはfeature mapを表し、エッジはoperationに対応;利用可能なoperationが5つあるため、可能な検索空間の総数は5の6乗で15,625通りとなる)でも評価した結果、提案手法の性能がよかったとのこと。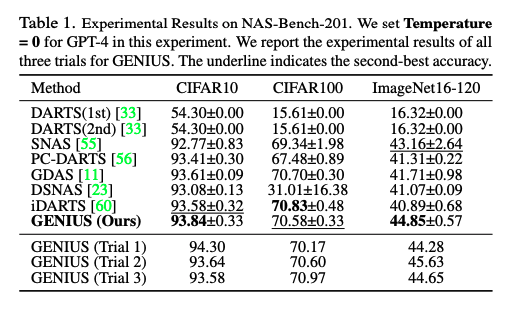
[Paper Note] Self-Consistency Improves Chain of Thought Reasoning in Language Models, Xuezhi Wang+, ICLR'23, 2022.03
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought #ICLR #Test-Time Scaling #Selected Papers/Blogs #MajorityVoting Issue Date: 2023-04-27 GPT Summary- 自己一貫性という新しいデコーディング戦略を提案し、chain-of-thought promptingの性能を向上。多様な推論経路をサンプリングし、一貫した答えを選択することで、GSM8KやSVAMPなどのベンチマークで顕著な改善を達成。 Comment
self-consistencyと呼ばれる新たなCoTのデコーディング手法を提案。
これは、難しいreasoningが必要なタスクでは、複数のreasoningのパスが存在するというintuitionに基づいている。
self-consistencyではまず、普通にCoTを行う。そしてgreedyにdecodingする代わりに、以下のようなプロセスを実施する:
1. 多様なreasoning pathをLLMに生成させ、サンプリングする。
2. 異なるreasoning pathは異なるfinal answerを生成する(= final answer set)。
3. そして、最終的なanswerを見つけるために、reasoning pathをmarginalizeすることで、final answerのsetの中で最も一貫性のある回答を見出す。
これは、もし異なる考え方によって同じ回答が導き出されるのであれば、その最終的な回答は正しいという経験則に基づいている。
self-consistencyを実現するためには、複数のreasoning pathを取得した上で、最も多いanswer a_iを選択する(majority vote)。これにはtemperature samplingを用いる(temperatureを0.5やら0.7に設定して、より高い信頼性を保ちつつ、かつ多様なoutputを手に入れる)。
temperature samplingについては[こちら](
https://openreview.net/pdf?id=rygGQyrFvH)の論文を参照のこと。
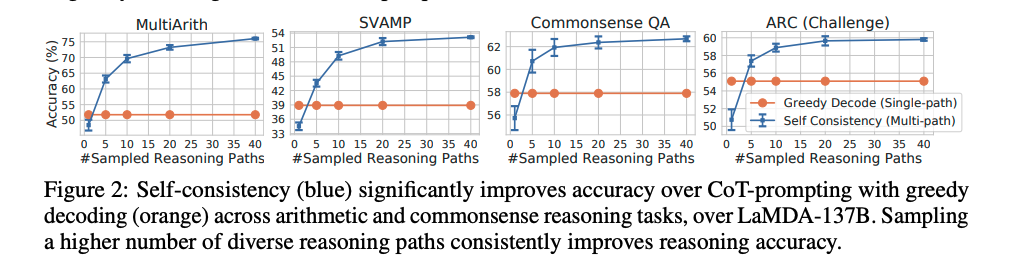
sampling数は増やせば増やすほど性能が向上するが、徐々にサチってくる。サンプリング数を増やすほどコストがかかるので、その辺はコスト感との兼ね合いになると思われる。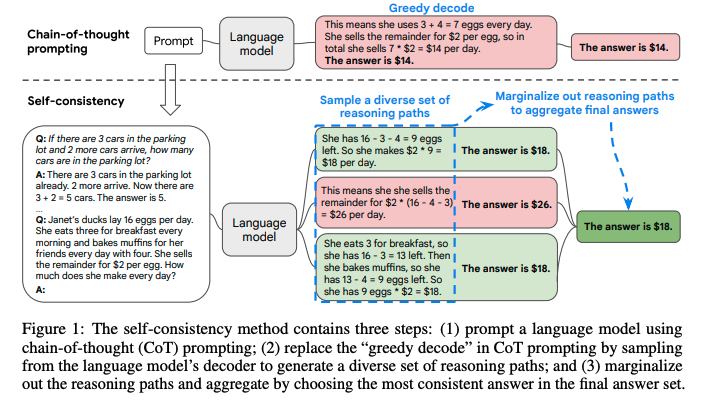
Self-consistencyは回答が閉じた集合であるような問題に対して適用可能であり、open-endなquestionでは利用できないことに注意が必要。ただし、open-endでも回答間になんらかの関係性を見出すような指標があれば実現可能とlimitationで言及している。
self-consistencyが提案されてからもう4年も経ったのか、、、
[Paper Note] Automatic Chain of Thought Prompting in Large Language Models, Zhuosheng Zhang+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought #ICLR #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)を用いて、段階的思考を促すCoT promptingを提案。手作業でデモを設計する必要なく、プロンプトを通じて推論チェーンを生成可能。また、多様性を持って質問をサンプリングする自動CoT法(Auto-CoT)を導入し、GPT-3を用いたベンチマークで手動設計と比較して優れた性能を示した。 Comment
LLMによるreasoning chainが人間が作成したものよりも優れていることを示しているとのこと [Paper Note] Enhancing Chain-of-Thoughts Prompting with Iterative Bootstrapping in Large Language Models, Jiashuo Sun+, NAACL'24 Findings, 2023.04 より
clusteringベースな手法を利用することにより、誤りを含む例が単一のクラスタにまとめられうことを示し、これにより過剰な誤ったデモンストレーションが軽減されることを示した。
手法の概要。questionを複数のクラスタに分割し、各クラスタから代表的なquestionをサンプリングし、zero-shot CoTでreasoning chainを作成しpromptに組み込む。最終的に回答を得たいquestionに対しても、上記で生成した複数のquestion-reasoningで条件付けした上で、zeroshot-CoTでrationaleを生成する。これにより自動的にCoTをICLするためのexamplarを生成できる。
openreview: https://openreview.net/forum?id=5NTt8GFjUHkr
[Paper Note] Automatic Prompt Augmentation and Selection with Chain-of-Thought from Labeled Data, KaShun Shum+, EMNLP'23, 2023.02
Paper/Blog Link My Issue
#LanguageModel #Chain-of-Thought #EMNLP #One-Line Notes Issue Date: 2023-04-27 GPT Summary- 新しい戦略「Automate-CoT」を提案し、少量のラベル付きデータから合理的チェーンを自動拡張。低品質なチェーンを剪定し、最適な推論チェーンを選択する分散削減型ポリシー勾配戦略を用いる。これにより、さまざまなタスクへのCoT手法の迅速な適用を可能にし、実験で競争力のある結果を達成。 Comment
LLMによるreasoning chainが人間が作成したものよりも優れていることを示しているとのこと。下記研究より
- [Paper Note] Enhancing Chain-of-Thoughts Prompting with Iterative Bootstrapping in Large Language Models, Jiashuo Sun+, NAACL'24 Findings, 2023.04
selection phaseで誤ったexampleは直接排除する手法をとっている。そして、強化学習によって、demonstrationのselection modelを訓練している。
openreview: https://openreview.net/forum?id=FGBEoz9WzI¬eId=sq50eXOEeV
[Paper Note] Personalisation within bounds: A risk taxonomy and policy framework for the alignment of large language models with personalised feedback, Hannah Rose Kirk+, arXiv'23, 2023.03
Paper/Blog Link My Issue
#LanguageModel #Personalization #needs-revision Issue Date: 2023-04-26 GPT Summary- LLMの個別化には、人間の嗜好と整合させる必要があり、アラインメント技術がその課題を緩和するが、全ての嗜好を表現するのは難しい。ユーザーの多様な価値観に基づくマイクロレベルの個別化は有望だが、規範的課題が存在する。本文では、整合の定義、主観的嗜好の押し付け、文書化不足の問題を概観し、個別化されたLLMの利点とリスクを整理。最後に、安全なLLMの挙動を維持するための三層政策フレームワークを提案。 Comment
# abst
LLMをPersonalizationすることに関して、どのような方法でPersonalizationすべきかを検討した研究。以下の問題点を指摘。
1. アラインメント(RLHFのように何らかの方向性にalignするように補正する技術のこと?)が何を意味するのか明確ではない
2. 技術提供者が本質的に主観的な好みや価値観の定義を規定する傾向があること
3. クラウドワーカーがの専制によって、我々が実際に何にアラインメントしているのかに関する文書が不足していること
そして、PersonalizedなLLMの利点やリスクの分類を提示する。
# 導入
LLMがさまざまな製品に統合されたことで、人間の嗜好に合致し、危険かつ不正確な情報を出力を生成しないことを確保する必要がある。RLHFやred-teamingはこれに役立つが、このような集合的な(多くの人に一つのアラインメントの結果を提示すること)finetuningプロセスが人間の好みや価値観の幅広い範囲を十分に表現できるとは考えにくい。異なる人々はさまざまな意見や価値観を持っており、マイクロレベルのfinetuningプロせせ雨を通じてLLMをPersonalizationすることで、各ユーザとより良いアラインメントが可能になる可能性がある。これを社会的に受け入れられるようにするためにいくつか課題があるので、それについて論じた。
[Paper Note] Evaluating ChatGPT's Information Extraction Capabilities: An Assessment of Performance, Explainability, Calibration, and Faithfulness, Bo Li+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#Explanation #ChatGPT #InformationExtraction #Evaluation #KeyPoint Notes #Reading Reflections Issue Date: 2023-04-25 GPT Summary- 本研究では、ChatGPTの能力を7つの情報抽出(IE)タスクを通じて評価し、パフォーマンス、説明可能性、キャリブレーション、信頼性を分析しました。標準IE設定ではパフォーマンスが低い一方、オープンIE設定では人間評価で優れた結果を示しました。ChatGPTは高品質な説明を提供するものの、予測に対して過信する傾向があり、キャリブレーションが低いことが明らかになりました。また、元のテキストに対して高い信頼性を示しました。研究のために手動で注釈付けした7つのIEタスクのテストセットと14のデータセットを公開しています。 Comment
情報抽出タスクにおいてChatGPTを評価した研究。スタンダードなIEの設定ではBERTベースのモデルに負けるが、OpenIEの場合は高い性能を示した。
また、ChatGPTは予測に対してクオリティが高く信頼に足る説明をしたが、一方で自信過剰な傾向がある。また、ChatGPTの予測はinput textに対して高いfaithfulnessを示しており、予測がinputから根ざしているものであることがわかる。(らしい)
あまりしっかり読めていないが、Entity Typing, NER, Relation Classification, Relation Extraction, Event Detection, Event Argument Extraction, Event Extractionで評価。standardIEでは、ChatGPTにタスクの説明と選択肢を与え、与えられた選択肢の中から正解を探す設定とした。一方OpenIEでは、選択肢を与えず、純粋にタスクの説明のみで予測を実施させた。OpenIEの結果を、3名のドメインエキスパートが出力が妥当か否か判定した結果、非常に高い性能を示すことがわかった。表を見ると、同じタスクでもstandardIEよりも高い性能を示している(そんなことある???)
つまり、選択肢を与えてどれが正解ですか?ときくより、選択肢与えないでCoTさせた方が性能高いってこと?比較可能な設定で実験できているのだろうか。promptは付録に載っているが、output exampleが載ってないのでなんともいえない。StandardIEの設定をしたときに、CoTさせてるかどうかが気になる。もししてないなら、そりゃ性能低いだろうね、という気がする。
[Paper Note] WizardLM: Empowering large pre-trained language models to follow complex instructions, Can Xu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #InstructionTuning #SyntheticData #ICLR #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- 本論文では、LLMを用いて複雑な指示データを自動生成する方法を提案。Evol-Instructを使用して初期の指示を段階的に書き換え、生成したデータでLLaMAをファインチューニングし、WizardLMモデルを構築。評価結果は、Evol-Instructからの指示が人間作成のものより優れており、WizardLMがChatGPTよりも高い評価を得ることを示す。AI進化による指示生成がLLM強化の有望なアプローチであることを示唆。 Comment
instruction trainingは大きな成功を収めているが、人間がそれらのデータを作成するのはコストがかかる。また、そもそも複雑なinstructionを人間が作成するのは苦労する。そこで、LLMに自動的に作成させる手法を提案している(これはself instructと一緒)。データを生成する際は、seed setから始め、step by stepでinstructionをrewriteし、より複雑なinstructionとなるようにしていく。
これらの多段的な複雑度を持つinstructionをLLaMaベースのモデルに食わせてfinetuningした(これをWizardLMと呼ぶ)。人手評価の結果、WizardLMがChatGPTよりも好ましいレスポンスをすることを示した。特に、WizaraLMはコード生成や、数値計算といった難しいタスクで改善を示しており、複雑なinstructionを学習に利用することの重要性を示唆している。
EvolInstructを提案。"1+1=?"といったシンプルなinstructionからスタートし、これをLLMを利用して段階的にcomplexにしていく。complexにする方法は2通り:
- In-Depth Evolving: instructionを5種類のoperationで深掘りする(blue direction line)
- add constraints
- deepening
- concretizing
- increase reasoning steps
- complicate input
- In-breadth Evolving: givenなinstructionから新しいinstructionを生成する
上記のEvolvingは特定のpromptを与えることで実行される。
また、LLMはEvolvingに失敗することがあるので、Elimination Evolvingと呼ばれるフィルタを利用してスクリーニングした。
フィルタリングでは4種類の失敗するsituationを想定し、1つではLLMを利用。2枚目画像のようなinstructionでフィルタリング。
1. instructionの情報量が増えていない場合。
2. instructionがLLMによって応答困難な場合(短すぎる場合やsorryと言っている場合)
3. puctuationやstop wordsによってのみ構成されている場合
4.明らかにpromptの中から単語をコピーしただけのinstruction(given prompt, rewritten prompt, #Rewritten Prompt#など)

[Paper Note] Scaling Transformer to 1M tokens and beyond with RMT, Aydar Bulatov+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Transformer #LongContext #memory #One-Line Notes Issue Date: 2023-04-25 GPT Summary- 再帰的メモリ拡張を用いて、トランスフォーマーの計算量を線形にスケールし、最大二百万トークンまでのシーケンスを扱う能力を実証。言語モデリングタスクでの実験は、パープレキシティの改善を示し、長期依存の処理能力向上の可能性を強調。 Comment
Reccurent Memory Transformer [Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
を使って2Mトークン扱えるようにしたよーという話。
ハリーポッターのトークン数が1.5Mらしいので、そのうち小説一冊書けるかもという世界。
[Paper Note] Large-scale Contrastive Language-Audio Pretraining with Feature Fusion and Keyword-to-Caption Augmentation, Yusong Wu+, ICASSP'23, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #Embeddings #Pretraining #Library #RepresentationLearning #MultiModal #SpeechProcessing #ContrastiveLearning #Speech #One-Line Notes #text #ICASSP Issue Date: 2023-04-25 GPT Summary- 音声データと自然言語説明を組み合わせたコントラスト学習による音声表現開発のパイプラインを提案。633,526の音声-テキストペアからなるLAION-Audio-630Kを公開し、音声エンコーダとテキストエンコーダを用いたモデルを構築。特徴融合メカニズムを採用し、可変長の音声入力に対応。テキストから音声検索や音声分類に関する実験により、特にテキスト検索で優れた性能を示し、ゼロショット設定でも最先端の結果を達成。LAION-Audio-630Kとモデルは公開済み。 Comment
テキストとオーディオをエンコードするMLPエンコーダをそれぞれ用意し、大量のペアをcontrastive learningで事前学習することで、テキストとオーディオ間を同じ空間に写像し、類似度を測れるようにしたモデル。zero-shotでaudio分類などが可能。
[Paper Note] LLM+P: Empowering Large Language Models with Optimal Planning Proficiency, Bo Liu+, arXiv'23, 2023.04
Paper/Blog Link My Issue
#LanguageModel #Planning #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- LLMsは一般的な質問には優れた回答能力を示すが、長期的な計画問題には弱い。本研究では、古典的プランナーの強みをLLMsに統合した初のフレームワーク、LLM+Pを提案。自然言語の計画記述をPDDL形式に変換し、効率的に解を見つけて再翻訳する手法を採用。実験により、LLM+Pは多くの計画問題に対して最適解を提供できる一方、LLMsはほとんど問題を解決できないことが確認された。 Comment
LLMは長いプランニングをすることが苦手だったが、classicalなplannerは適切なinputの形式に変換されていればすぐに最適なプランを導出できる、が、自然言語は受け付けない、といった互いが互いを補完し合う関係にあるので、両者を組み合わせました、という話。
LLMを利用して、planning problemを記述した自然言語をclassicalなplannerのinputへ変換。その後plannerで最適なplanを見つけ、自然言語にplanを逆翻訳する。
Efficient Methods for Natural Language Processing: A Survey, Treviso+, TACL'23
Paper/Blog Link My Issue
#NeuralNetwork #Survey #EfficiencyImprovement #TACL #One-Line Notes Issue Date: 2023-04-25 Comment
パラメータ数でゴリ押すような方法ではなく、"Efficient"に行うための手法をまとめている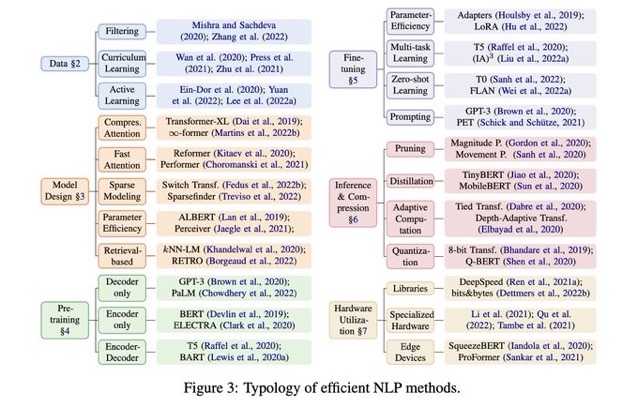
[Paper Note] ReAct: Synergizing Reasoning and Acting in Language Models, Shunyu Yao+, ICLR'23, 2022.10
Paper/Blog Link My Issue
#LanguageModel #AIAgents #Selected Papers/Blogs #needs-revision Issue Date: 2023-04-13 GPT Summary- 大規模言語モデルを用いて、推論と行動計画を相互に組み合わせるReActアプローチを提案。推論の痕跡が行動計画の導出を促進し、行動が外部情報を活用することで、推論の効率を向上。質問応答や事実検証タスクで従来手法を凌駕し、人間の解釈性と信頼性を向上させる。対話的意思決定ベンチマークでも優れた性能を発揮。 Comment
# 概要
人間は推論と行動をシナジーさせることで、さまざまな意思決定を行える。近年では言語モデルにより言語による推論を意思決定に組み合わせる可能性が示されてきた。たとえば、タスクをこなすための推論トレースをLLMが導けることが示されてきた(Chain-of-Thought)が、CoTは外部リソースにアクセスできないため知識がアップデートできず、事後的に推論を行うためhallucinationやエラーの伝搬が生じる。一方で、事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われているが、これらの研究では、高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
そこで、REACTを提案。REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みであり、推論トレースとアクションを交互に生成するため、動的に推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
- 要はいままではGeneralなタスク解決モデルにおいては、推論とアクションの生成は独立にしかやられてこなかったけど、推論とアクションを交互作用させることについて研究したよ
- そしたら性能がとってもあがったよ
- reasoningを人間が編集すれば、エージェントのコントロールもできるよ という感じ
# イントロ
人間は推論と行動の緊密なシナジーによって、不確実な状況に遭遇しても適切な意思決定が行える。たとえば、任意の2つの特定のアクションの間で、進行状況をトレースするために言語で推論したり(すべて切り終わったからお湯を沸かす必要がある)、例外を処理したり、状況に応じて計画を調整したりする(塩がないから代わりに醤油と胡椒を使おう)。また、推論をサポートし、疑問(いまどんな料理を作ることができるだろうか?)を解消するために、行動(料理本を開いてレシピを読んで、冷蔵庫を開いて材料を確確認したり)をすることもある。
近年の研究では言語での推論を、インタラクティブな意思決定を組み合わせる可能性についてのヒントが得られてきた。一つは、適切にPromptingされたLLMが推論トレースを実行できることを示している。推論トレースとは、解決策に到達するための一連のステップを経て推論をするためのプロセスのことである。しかしながらChain-of-thoughytは、このアプローチでは、モデルが外界対してgroundingできず、内部表現のみに基づい思考を生成するため限界がある。これによりモデルが事後対応的に推論したり、外部情報に基づいて知識を更新したりできないため、推論プロセス中にhallucinationやエラーの伝搬などの問題が発生する可能性が生じる。
一方、近年の研究では事前学習言語モデルをinteractiveな環境において計画と行動に利用する研究が行われている。これらの研究では、通常マルチモーダルな観測結果をテキストに変換し、言語モデルを使用してドメイン固有のアクション、またはプランを生成し、コントローラーを利用してそれらを選択または実行する。ただし、これらのアプローチは高レベルの目標について抽象的に推論したり、行動をサポートするための作業記憶を維持したりするために言語モデルを利用していない。
推論と行動を一般的な課題解決のためにどのようにシナジーできるか、またそのようなシナジーが単独で推論や行動を実施した場合と比較してどのような利益をもたらすかについて研究されていない。
LLMにおける推論と行動を組み合わせて、言語推論と意思決定タスクを解決するREACTと呼ばれる手法を提案。REACTでは、推論と行動の相乗効果を高めることが可能。推論トレースによりアクションプランを誘発、追跡、更新するのに役立ち、アクションでは外部ソースと連携して追加情報を収集できる。
REACTは推論と行動をLLMと組み合わせて、多様な推論や意思決定タスクを実現するための一般的な枠組みである。REACTのpromptはLLMにverbalな推論トレースとタスクを実行するためのアクションを交互に生成する。これにより、モデルは動的な推論を実行して行動するための大まかな計画を作成、維持、調整できると同時に、wikipediaなどの外部ソースとやりとりして追加情報を収集し、推論プロセスに組み込むことが可能となる。
# 手法
変数を以下のように定義する:
- O_t: Observertion on time t
- a_t: Action on time t
- c_t: context, i.e. (o_1, a_1, o_2, a_2, ..., a_t-1, o_t)
- policy pi(a_t | c_t): Action Spaceからアクションを選択するポリシー
- A: Action Space
- O: Observation Space
普通はc_tが与えられたときに、ポリシーに従いAからa_tを選択しアクションを行い、アクションの結果o_tを得て、c_t+1を構成する、といったことを繰り返していく。
このとき、REACTはAをA ∪ Lに拡張しする。ここで、LはLanguage spaceである。LにはAction a_hatが含まれ、a_hatは環境に対して作用をしない。単純にthought, あるいは reasoning traceを実施し、現在のcontext c_tをアップデートするために有用な情報を構成することを目的とする。Lはunlimitedなので、事前学習された言語モデルを用いる。今回はPaLM-540B(c.f. GPT3は175Bパラメータ)が利用され、few-shotのin-context exampleを与えることで推論を行う。それぞれのin-context exampleは、action, thoughtsそしてobservationのtrajectoryを与える。
推論が重要なタスクでは、thoughts-action-observationステップから成るtask-solving trajectoryを生成する。一方、多数のアクションを伴う可能性がある意思決定タスクでは、thoughtsのみを行うことをtask-solving trajectory中の任意のタイミングで、自分で判断して行うことができる。
意思決定と推論能力がLLMによってもたらされているため、REACTは4つのuniqueな特徴を持つ:
- 直感的で簡単なデザイン
- REACTのpromptは人間のアノテータがアクションのトップに思考を言語で記述するようなストレートなものであり、ad-hocなフォーマットの選択、思考のデザイン、事例の選定などが必要ない。
- 一般的で柔軟性が高い
- 柔軟な thought spaceと thought-actionのフォーマットにより、REACTはさまざまなタスクにも柔軟に対応できる
- 高性能でロバスト
- REACTは1-6個の事例によって、新たなタスクに対する強力な汎化を示す。そして推論、アクションのみを行うベースラインよりも高い性能を示している。REACTはfinetuningの斧系も得ることができ、promptの選択に対してREACTの性能はrobustである。
- 人間による調整と操作が可能
- REACTは、解釈可能な意思決定と推論のsequenceを前提としているため、人間は簡単に推論や事実の正しさを検証できる。加えて、thoughtsを編集することによって、m人間はエージェントの行動を制御、あるいは修正できる。
# KNOWLEDGE INTENSIVE REASONING TASKS
openreview: https://openreview.net/forum?id=tvI4u1ylcqs
[Paper Note] ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks, Fabrizio Gilardi+, NAS'23, 2023.03
Paper/Blog Link My Issue
#LanguageModel #Annotation #In-Depth Notes Issue Date: 2023-04-12 GPT Summary- ChatGPTは、2,382件のツイートを用いたアノテーションタスクにおいて、クラウドワーカーを上回る性能を示し、特に4つのタスクでゼロショット精度が優れています。また、インターコーダー合意でも全てのタスクでクラウドワーカーや訓練を受けたアノテーターを超え、コストもMTurkの約20倍安価です。これにより、大規模言語モデルがテキスト分類の効率を大幅に向上させる可能性が示唆されます。 Comment
# 概要
2300件程度のツイートを分類するタスクにおいて、訓練した学部生によるアノテーションを正解とし、クラウドワーカーとChatGPTでのzero-shotでの予測の性能を比較した。分類タスクは、比較的難易度の高い分類問題であり、クラウドワーカーでも正解率は難しいタスクでは15--25%程度であった。このようなタスクでchatgptは40--60%の正解率を示している。
比較の結果、5つのタスク中4つのタスクでChatGPTがクラウドワーカーを上回る正解率を示した。
# 手法
- クラウドワーカーとChatGPTで同じインストラクションを利用し、同じタスクを実施した
- inter-notator aggreementを図るために、それぞれのタスクについて各ツイートに少なくとも2人がラベル付を行った
- ChatGPTでも同様に、タスクごとに各ツイートには2回同じタスクを実施しデータを収集した
- ChatGPTを利用する際は、temperatureを1.0, 0.2の場合で試した。従ってChatGPTのラベル付けは各タスクごとに4セット存在することになる。
# 結果
5タスク中、4タスクでChatGPTがzero-shotにもかかわらず正解率でworkerを上回った。また高いaggreementを発揮していることを主張。aggreementはtemperatureが低い方が高く、これはtemperatureが低い方がrandomnessが減少するためであると考えられる。aggreementをAccuracyの相関を図ったが、0.17であり弱い相関しかなかった。従って、Accuracyを減少させることなく、一貫性のある結果を得られるlaw temperatureを利用することが望ましいと結論づけている。
# 実施したタスク
"content moderation"に関するタスクを実施した。content moderationはSNSなどに投稿されるpostを監視するための取り組みであり、たとえばポルトツイートや誤った情報を含む有害なツイート、ヘイトスピーチなどが存在しないかをSNS上で監視をを行うようなタスクである。著者らはcontent moderationはハードなタスクであり、複雑なトピックだし、toy exampleではないことを主張している。実際、著者らが訓練した学部生の間でのinter-annotator aggreementは50%程度であり、難易度が高いタスクであることがわかる(ただし、スタンスdetectionに関してはaggreementが78.3%であった)。
content moderationのうち、以下の5つのタスクを実施した。
- relevance:
- ツイートがcontent moderationについて直接的に関係することを述べているか否か
- e.g. SNSにおけるcontent moderation ruleや実践、政府のレギュレーション等
- content moderationについて述べていないものについてはIRRELEVANTラベルを付与する
- ただし、主題がcontent moderationのツイートであっても、content moderationについて論じていないものについてはIRRELEVANT扱いとする。
- このような例としては、TwitterがDonald TrupのTwitterを"disrupted"とlabel付けしたことや、何かについて間違っていると述べているツイート、センシティブな内容を含むツイートなどがあげられる。
- Problem/Solution Frames
- content moderationは2つの見方ができる。それがProblemとSolution
- Problem: content moderationをPROBLEMとみなすもの。たとえば、フリースピーチの制限など
- SOLUTION: content moderationをSOLUTIONとみなすもの。たとえば、harmful speechから守ること、など
- ツイートがcontent moderationのnegativeな影響について強調していたら、PROBLEM(フリースピーチの制限やユーザがポストする内容についてバイアスが生じることなどについて)
- ツイートがcontent moderationのpositiveな影響について強調していたら、SOKUTION(harmful contentからユーザを守るなど)
- 主題はcontent moderationであるが、positive/negativeな影響について論じていないものはNEUTRAL
- Policy Frames
- content moderationはさまざまんトピックと関連している(たとえば)、健康、犯罪、平等など)
- content moderatiojnに関するツイートがどのトピックかをラベル付する。ラベルは15種類
- economy, capcity and resources, modality, fairness and equality, constitutionality and jurisprudence, policy prescription and evaluation, law and order, crime and justice, security and defense, health and safety, quality of life, cultural identity, public opinion, political, external regulation and reputation, other
- Stance Detection
- USのSection 230という法律(websiteにユーザが投稿したコンテンツに対して、webサイトやその他のオンラインプラットフォームが法的責任を問われるのを防ぐ法律)について、ツイートがSection230に対して、positive/negative/neutralなスタンスかをラベル付する
- Topic Detection
- ツイートを6つのトピックにラベル付する
- Section 230, TRUMP BAN, TWITTER-SUPPORT, PLATFORM POLICIES, COMPLAINTS, other
# 所感
そこそこ難易度の高いアノテーションタスクでもzero-shotでturkerの性能を上回るのは非常に素晴らしいことだと思う。ノイジーなデータセットであれば、比較的安価、かつスピーディーに作成できるようになってきたのではないかと思う。
ただ、ChatGPTのaggreementを図ることにどれだけ意味があるのだろう、とは思う。同じモデルを利用しているわけで、小tなるLLMをベースにした場合のaggreementならとる意味があると思うが。
[Paper Note] Self-Instruct: Aligning Language Models with Self-Generated Instructions, Yizhong Wang+, ACL'23, 2022.12
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #ACL #In-Depth Notes Issue Date: 2023-03-30 GPT Summary- Self-Instructフレームワークを提案し、事前学習済みの言語モデルが自ら生成した指示を用いてファインチューニングを行うことで、ゼロショットの一般化能力を向上させる。バニラGPT-3に適用した結果、Super-NaturalInstructionsで33%の性能向上を達成し、InstructGPT-001と同等の性能に到達。人間評価により、Self-Instructが既存の公共指示データセットよりも優れていることを示し、ほぼ注釈不要の指示調整手法を提供。大規模な合成データセットを公開し、今後の研究を促進する。 Comment
Alpacaなどでも利用されているself-instruction技術に関する論文
# 概要
著者らが書いた175種のinstruction(タスクの定義 + 1種のinput/outputペア}のseedを元に、VanillaなGPT-3に新たなinstruction, input, outputのtupleを生成させ、学習データとして活用する研究。
ここで、instruction data I は以下のように定義される:
instruction dataは(I, X, Y)であり、モデルは最終的にM(I_t, x_t) = y_tとなるように学習したい。
I: instruction, X: input, Y: output
データ作成は以下のステップで構成される。なお、以下はすべてVanilla GPT-3を通じて行われる:
1. Instruction Generation
task poolから8種類のinstructionを抽出し、 promptを構成し、最大8個新たなinstructionを生成させる
2. Classification Task Identification:
生成されたinstructionがclassificationタスクか否かを判別する
3. Instance Generation
いくつかの(I, X, Y)をpromptとして与え、I, Xに対応するYを生成するタスクを実行させる。このときinput-first approachを採用した結果(I->Xの順番で情報を与えYを生成するアプローチ)、特定のラベルに偏ったインスタンスが生成される傾向があることがわかった。このためoutput-first approachを別途採用し(I->Yの順番で情報を与え、各Yに対応するXを生成させる)、活用している。
4. Filtering and Postprocessing
最後に、既存のtask poolとROUGE-Lが0.7以上のinstructionは多様性がないため除外し、特定のキーワード(images, pictrues, graphs)等を含んでいるinstruction dataも除外して、task poolに追加する。
1-4をひたすら繰り返すことで、GPT-3がInstruction Tuningのためのデータを自動生成してくれる。
# SELF-INSTRUCT Data
## データセットの統計量
- 52k instructions
- 82k instances
## Diversity
parserでinstructionを解析し、rootの名詞と動詞のペアを抽出して可視化した例。ただし、抽出できた例はたかだか全体の50%程度であり、その中で20の最もcommonなroot vertと4つのnounを可視化した。これはデータセット全体の14%程度しか可視化されていないが、これだけでも非常に多様なinstructionが集まっていることがわかる。
また、seed indstructionとROUGE-Lを測った結果、大半のデータは0.3~0.4程度であり、lexicalなoverlapはあまり大きくないことがわかる。instructionのlengthについても可視化した結果、多様な長さのinstructionが収集できている。
## Quality
200種類のinstructionを抽出し、その中からそれぞれランダムで1つのインスタンスをサンプルした。そしてexpert annotatorに対して、それぞれのinstructionとinstance(input, outputそれぞれについて)が正しいか否かをラベル付けしてもらった。
ラベル付けの結果、ほとんどのinstructionは意味のあるinstructionであることがわかった。一方、生成されたinstanceはnoisyであることがわかった(ただし、このnoiseはある程度妥当な範囲である)。noisytではあるのだが、instanceを見ると、正しいformatであったり、部分的に正しかったりなど、modelを訓練する上で有用なguidanceを提供するものになっていることがわかった。
# Experimental Results
## Zero-shotでのNLPタスクに対する性能
SuperNIデータセットに含まれる119のタスク(1タスクあたり100 instance)に対して、zero-shot setupで評価を行なった。SELF-INSTRUCTによって、VanillaのGPT3から大幅に性能が向上していることがわかる。VanillaのGPT-3はほとんど人間のinstructionに応じて動いてくれないことがわかる。分析によると、GPT3は、大抵の場合、全く関係ない、あるいは繰り返しのテキストを生成していたり、そもそもいつ生成をstopするかがわかっていないことがわかった。
また、SuperNI向けにfinetuningされていないモデル間で比較した結果、非常にアノテーションコストをかけて作られたT0データでfinetuningされたモデルよりも高い性能を獲得した。また、人間がラベル付したprivateなデータによって訓練されたInstructGPT001にも性能が肉薄していることも特筆すべき点である。
SuperNIでfinetuningした場合については、SELF-INSTRUCTを使ったモデルに対して、さらに追加でSuperNIを与えた場合が最も高い性能を示した。
## User-Oriented Instructionsに対する汎化性能
SuperNIに含まれるNLPタスクは研究目的で提案されており分類問題となっている。ので、実践的な能力を証明するために、LLMが役立つドメインをブレスト(email writing, social media, productiveity tools, entertainment, programming等)し、それぞれのドメインに対して、instructionとinput-output instanceを作成した。また、instructionのスタイルにも多様性(e.g. instructionがlong/short、bullet points, table, codes, equationsをinput/outputとして持つ、など)を持たせた。作成した結果、252個のinstructionに対して、1つのinstanceのデータセットが作成された。これらが、モデルにとってunfamiliarなinstructionで多様なistructionが与えられたときに、どれだけモデルがそれらをhandleできるかを測定するテストベッドになると考えている。
これらのデータは、多様だがどれもが専門性を求められるものであり、自動評価指標で性能が測定できるものでもないし、crowdworkerが良し悪しを判定できるものでもない。このため、それぞれのinstructionに対するauthorに対して、モデルのy補足結果が妥当か否かをjudgeしてもらった。judgeは4-scaleでのratingとなっている:
- RATING-A: 応答は妥当で満足できる
- RATING-B: 応答は許容できるが、改善できるminor errorや不完全さがある。
- RATING-C: 応答はrelevantでinstructionに対して答えている。が、内容に大きなエラーがある。
- RATING-D: 応答はirrelevantで妥当ではない。
実験結果をみると、Vanilla GPT3はまったくinstructionに対して答えられていない。instruction-basedなモデルは高いパフォーマンスを発揮しているが、それらを上回る性能をSELF-INSTRUCTは発揮している(noisyであるにもかかわらず)。
また、GPT_SELF-INSTRUCTはInstructGPT001と性能が肉薄している。また、InstructGPT002, 003の素晴らしい性能を示すことにもなった。
# Discussion and Limitation
## なぜSELF-INSTRUCTがうまくいったか?
- LMに対する2つの極端な仮説を挙げている
- LM はpre-trainingでは十分に学習されなかった問題について学習する必要があるため、human feedbackはinstruction-tuningにおいて必要不可欠な側面である
- LM はpre-trainingからinstructionに既に精通しているため、human feedbackはinstruction-tuningにおいて必須ではない。 human feedbackを観察することは、pre-trainingにおける分布/目的を調整するための軽量なプロセスにすぎず、別のプロセスに置き換えることができる。
この2つの極端な仮説の間が実情であると筆者は考えていて、どちらかというと2つ目の仮説に近いだろう、と考えている。既にLMはpre-trainingの段階でinstructionについてある程度理解できているため、self-instructがうまくいったのではないかと推察している。
## Broader Impact
InstructGPTは非常に強力なモデルだけど詳細が公表されておらず、APIの裏側に隠れている。この研究が、instruct-tuned modelの背後で何が起きているかについて、透明性を高める助けになると考えている。産業で開発されたモデルの構造や、その優れた性能の理由についてはほとんど理解されておらず、これらのモデルの成功の源泉を理解し、より優れた、オープンなモデルを作成するのはアカデミックにかかっている。この研究では、多様なinstructional dataの重要性を示していると考えており、大規模な人工的なデータセットは、より優れたinstructionに従うモデルを、構築するための第一歩だと考えている。
## limitation
- Tail Phenomena
- LMの枠組みにとどまっているため、LMと同じ問題(Tail Phenomena)を抱えている
- low-frequencyなcontextに対してはうまくいかない問題
- SELF-INSTRUCTも、結局pre-trainingの段階で頻出するタスクやinstructionに対してgainがあると考えられ、一般的でなく、creativeなinstructionに対して脆弱性があると考えられる
- Dependence on laege models
- でかいモデルを扱えるだけのresourceを持っていないと使えないという問題がある
- Reinforcing LM biases
- アルゴリズムのiterationによって、問題のあるsocial _biasをより増幅してしまうことを懸念している(人種、種族などに対する偏見など)。また、アルゴリズムはバランスの取れたラベルを生成することが難しい。
1のprompt
2のprompt
3のprompt(input-first-approach)
3のprompt(output-first approach)
※ GPT3をfinetuningするのに、Instruction Dataを使った場合$338かかったっぽい。安い・・・。
LLMを使うだけでここまで研究ができる時代がきた
(最近は|現在は)プロプライエタリなLLMの出力を利用して競合するモデルを訓練することは多くの場合禁止されているので注意。
[Paper Note] Reflexion: Language Agents with Verbal Reinforcement Learning, Noah Shinn+, NeurIPS'23, 2023.03
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #Supervised-FineTuning (SFT) #ReinforcementLearning #AIAgents #SelfCorrection #NeurIPS #PostTraining #Initial Impression Notes Issue Date: 2023-03-28 GPT Summary- LLMを用いた言語エージェントが外部環境と相互作用しつつ、迅速な学習を可能にする新しいフレームワーク「Reflexion」を提案。言語的フィードバックを活用し、エージェントはタスクのフィードバックを反映、エピソディックメモリに保持して意思決定を改善。多様なフィードバック信号を取り入れ、様々なタスクで大幅な性能向上を実現。HumanEvalベンチマークでは91%のpass@1精度を達成し、従来の最先端を超える成果を示した。 Comment
なぜ回答を間違えたのか自己反省させることでパフォーマンスを向上させる研究
openreview: https://openreview.net/forum?id=vAElhFcKW6
Sketch-Guided Text-to-Image Diffusion Models, Andrey+, Google Research, SIGGRAPH'23
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #TextToImageGeneration #SIGGRAPH #One-Line Notes #ImageSynthesis Issue Date: 2022-12-01 Comment
スケッチとpromptを入力することで、スケッチ biasedな画像を生成することができる技術。すごい。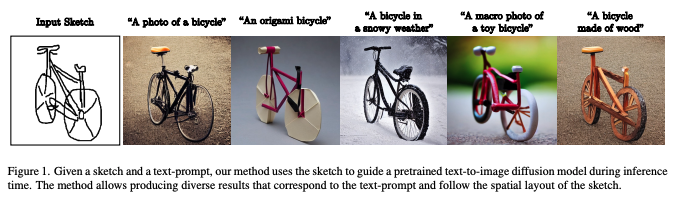
[Paper Note] MTEB: Massive Text Embedding Benchmark, Niklas Muennighoff+, EACL'23, 2022.10
Paper/Blog Link My Issue
#Embeddings #Dataset #Evaluation #EACL Issue Date: 2022-10-31 GPT Summary- テキスト埋め込み評価が単一タスクの小規模データセットに偏っているため、他タスクへの適用可否が不明な中、Massive Text Embedding Benchmark(MTEB)を導入。MTEBは8つの埋め込みタスクを網羅し、58データセットと112言語を含むを通じて、33モデルをベンチマーク。特定手法が全タスクで優位性を持たないことを示し、分野が普遍的手法に収束していないことを明らかに。オープンソースコードと公開リーダーボードは、https://github.com/embeddings-benchmark/mteb で利用可能。
[Paper Note] Long Document Summarization with Top-down and Bottom-up Inference, Bo Pang+, EACL'23, 2022.03
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #Abstractive #EACL #KeyPoint Notes Issue Date: 2022-09-02 GPT Summary- テキスト要約のための新しい推論フレームワークを提案。階層的な潜在構造を仮定し、ボトムアップとトップダウンの両方でトークンの表現を更新。短い文書に対して競争力のあるパフォーマンスを持ち、長文書要約でも最先端の結果を達成。少ないパラメータで競争力のある性能を示し、フレームワークの一般的な適用性を証明。 Comment
日本語解説:
https://zenn.dev/ty_nlp/articles/9f5e5dd3084dbd
以下、上記日本語解説記事を読んで理解した内容をまとめます。ありがとうございます。
# 概要
基本的にTransformerベースのモデル(e.g. BERTSum, BART, PEGASUS, GPT-2, T5)ではself-attentionの計算量が入力トークン数Nに対してO(N^2)でかかり、入力の二乗のオーダーで計算量が増えてしまう。
これを解消するためにself-attentionを計算する範囲をウィンドウサイズで制限するLongformerや、BigBardなどが提案されてきたが、どちらのモデルも離れたトークン間のattentionの情報が欠落するため、長距離のトークン間の関係性を捉えにくくなってしまう問題があった。
そこで、top-down transformerではセグメント(セグメントはテキストでいうところの文)という概念を提唱し、tokenからsegmentのrepresentationを生成しその後self-attentionでsegment間の関係性を考慮してsegmentのrepresentationを生成するbottom-up inference、各tokenとsegmentの関係性を考慮しし各tokenのrepresentationを学習するtop-down inferenceの2つの構造を利用した。bottom-up inferenceにおいてsegmentのrepresentationを計算する際にpoolingを実施するが、adapoolingと呼ばれる重要なトークンに重み付けをし、その重みを加味した加重平均によりプーリングを実施する。これにより、得られた各トークンの表現は、各セグメントとの関連度の情報を含み(セグメントの表現は各セグメント間のattentnionに基づいて計算されているため; bottom-up inference)、かつ各トークンと各セグメント間との関連度も考慮して計算されているため(top-down inference)、結果的に離れたトークン間の関連度を考慮したrepresentationが学習される(下図)。
(図は上記記事からお借りいたしました)
各attentionの計算量は表のようになり、M, wはNよりも遥かに小さいため、O(N^2)よりも遥かに小さい計算量で計算できる。
(こちらも上記記事からお借りいたしました)
# 実験(日本語解説より)
## データセット
## 結果
### PubMedとarXiv
### CNN-DailyMail
### TVMegasSiteとForeverDreaming
### BookSum-Chapter-Level
### BookSum-Book-Level
## 所感
CNN-DailyMailのようなinput wordsが900程度のデータではcomparableな結果となっているが、input wordsが長い場合は先行研究をoutperformしている。BookSum-Chapter Levelにおいて、Longformer, BigBirdの性能が悪く、BART, T5, Pegasusの性能が良いのが謎い。
てかinput wordsが3000~7000程度のデータに対して、どうやってBARTやらT5やらを実装できるんだろう。大抵512 tokenくらいが限界だと思っていたのだが、どうやったんだ・・・。
>The maximum document lengths for PubMed, arXiv, CNN-DM,
TVMegaSite, ForeverDreaming, BookSum are 8192, 16384, 1024, 12288, 12288, 12288, respectively
これは、たとえばBookSumの場合は仮にinputの長さが11万とかあったとしても、12288でtruncateしたということだろうか。まあなんにせよ、頑張ればこのくらいの系列長のモデルを学習できるということか(メモリに乗るのか・・・?どんな化け物マシンを使っているのか)。
>We first train a top-down transformer on the chapter-level data and then fine-tune it on the book-level
data. The inputs to the book-level model are (1) the concatenated chapter reference summaries in
training or (2) the concatenated chapter summaries generated by the chapter-level model in testing.
The chapter-to-book curriculum training is to mitigate the scarcity of book-level data. The recursive
summarization of chapters and then books can be considered abstractive content selection applied
to book data, and is used to address the extremely long length of books.
BookLevel Summarizationでは、データ数が300件程度しかなく、かつinput wordsがでかすぎる。これに対処するために、まずtop-down transformerをchapter-level_ dataで訓練して、その後book-level dataでfine-tuning。book-level dataでfine-tuningする際には、chapterごとのreference summaryをconcatしたものを正解とし、chapter-level modelが生成したchapterごとのsummaryをconcatしたものをモデルが生成した要約として扱った、という感じだろうか。まずchapter levelで学習しその後book levelで学習するcurriculum learningっぽいやり方がbook-level dataの不足を緩和してくれる。bookの要約を得るためにchapterを再帰的に要約するようなアプローチは、book dataに対するcontent selectionとしてみなすことができ、おそろしいほど長い入力の対処にもなっている、という感じだろうか。
[Paper Note] ScienceWorld: Is your Agent Smarter than a 5th Grader?, Ruoyao Wang+, EMNLP'22, 2022.03
Paper/Blog Link My Issue
#LanguageModel #AIAgents #Evaluation #ScientificDiscovery #EMNLP #Selected Papers/Blogs #Science #One-Line Notes Issue Date: 2026-04-14 GPT Summary- ScienceWorldは、小学校の科学カリキュラムに基づき、エージェントの科学的推論能力を評価するための対話型テキスト環境を提供します。従来のモデルは、新しい文脈で学んだ科学概念を推論するのが苦手で、特に未知の材料の伝導率を見つけるための実験方法を問われると苦戦します。これは、モデルが類似例から答えを得ているのか、再利用可能な方法で推論を学んでいるのかという疑問を生み出します。私たちは、エージェントは対話型環境にグラウンディングされることで推論能力を得るべきだと仮定し、150万パラメータのエージェントが10万ステップの対話型訓練を受けた結果、静的訓練を受けた110億パラメータのモデルを上回ることを実証しました。 Comment
ベンチマークの概要は
- Evaluating agents for scientific discovery, Ai2, 2026.04
参照のこと。
[Paper Note] GPT-NeoX-20B: An Open-Source Autoregressive Language Model, Sid Black+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#LanguageModel #OpenWeight #OpenSource #Selected Papers/Blogs Issue Date: 2026-03-31 GPT Summary- GPT-NeoX-20Bは、200億パラメータを持つ自己回帰型言語モデルで、Pileで訓練され、寛容なライセンスの下で重みが一般公開される。言語理解や数学、知識ベースのタスクで高い性能を持ち、特に5ショット評価時に同規模のモデルより優れた結果を示す。訓練および評価コード、モデルの重みはオープンソースで提供される。 Comment
[Paper Note] BLOOM: A 176B-Parameter Open-Access Multilingual Language Model, BigScience Workshop+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Pretraining #LanguageModel #OpenWeight #OpenSource #Selected Papers/Blogs #One-Line Notes Issue Date: 2026-03-31 GPT Summary- 大規模言語モデル(LLMs)を使い、新しいタスクを少ないデモや指示で実行可能にしたBLOOMを紹介。これは1760億パラメータのオープンアクセス言語モデルで、46の自然言語と13のプログラミング言語をカバー。競争力のある性能を発揮し、マルチタスクのファインチューニングを通じてさらに向上。モデルとコードは責任あるAIライセンスで公開し、今後の研究と応用の促進を目指す。 Comment
HF: https://huggingface.co/bigscience/bloom
透明性を持ったLLMを構築し民主化を図る方向性のパイオニア的研究
[Paper Note] Perceiver: General Perception with Iterative Attention, Andrew Jaegle+, ICLR'22, 2021.03
Paper/Blog Link My Issue
#ComputerVision #Transformer #MultiModal #SpeechProcessing #Attention #Architecture #ICLR #Selected Papers/Blogs #2D (Image) #audio #text Issue Date: 2026-02-07 GPT Summary- 本研究では、Transformersに基づく「Perceiver」モデルを提案し、生物システムのように多様なモダリティの高次元入力を同時に処理する能力を持つことを示します。従来のモデルが個々のモダリティに特化しているのに対し、Perceiverは少ない仮定で多数の入力を扱い、非対称注意メカニズムを用いて大規模なデータを処理します。これにより、画像や音声などの多様な分類タスクにおいて、先行モデルと同等以上の性能を実現しました。特に、ImageNetでは数十万のピクセルを直接扱い、ResNet-50やViTに匹敵する結果を達成し、AudioSetにおいても競争力を持っています。 Comment
openreview: https://openreview.net/forum?id=fILj7WpI-g
多様なモダリティ入力を単一のモデルで処理しlogitsで出力するtransformer。Perceiver-IOと並んで多様なモダリティを処理可能な先駆け的研究
Perceiverの出力は単純な分類問題を想定しており、より多様なoutputができるように拡張したものがPerceiver-IO:
- [Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
[Paper Note] Flamingo: a Visual Language Model for Few-Shot Learning, Jean-Baptiste Alayrac+, NeurIPS'22, 2022.04
Paper/Blog Link My Issue
#ComputerVision #Pretraining #MultiModal #NeurIPS #Selected Papers/Blogs #VisionLanguageModel #ImageToTextGeneration Issue Date: 2026-02-06 GPT Summary- 視覚と言語を融合したモデル「Flamingo」は、少数の注釈付き例で新たなタスクに迅速に適応可能。強力な視覚および言語モデルを組み合わせ、シーケンスとして視覚データとテキストを交互に処理し、画像や動画を取り込む柔軟性を持つ。徹底評価により、視覚的質問応答やキャプション作成など多様なタスクへの迅速な適応が確認され、少数ショット学習で新たな最先端を達成した。Flamingoは、多くのベンチマークでファインチューニングモデルを上回る性能を示した。 Comment
openreview: https://openreview.net/forum?id=EbMuimAbPbs
[Paper Note] Controlled Language Generation for Language Learning Items, Kevin Stowe+, EMNLP'22 Industry Track, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #Controllable #Education #EMNLP #Encoder-Decoder #IndustryTrack Issue Date: 2026-01-16 GPT Summary- 自然言語生成を活用し、英語学習アプリ向けに迅速に教材を生成。深層事前学習モデルを用いて、熟達度に応じた多様な文や文法テストの引数構造を制御する新手法を開発。人間評価では高い文法スコアを得て、上級モデルは基準を超える長さと複雑さを実現。多様で特注のコンテンツを提供し、強力なパフォーマンスを示す。
[Paper Note] bert2BERT: Towards Reusable Pretrained Language Models, Cheng Chen+, ACL'22, 2021.10
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #LanguageModel #Transformer #ACL #Encoder #Decoder Issue Date: 2025-12-11 GPT Summary- bert2BERTは、既存の小規模事前学習モデルの知識を大規模モデルに転送し、事前学習効率を向上させる手法。二段階の事前学習を提案し、トレーニングコストを大幅に削減。BERT_BASEとGPT_BASEの事前学習で約45%および47%の計算コストを節約。
[Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
Paper/Blog Link My Issue
#Survey #ComputerVision #EfficiencyImprovement #Transformer #Attention #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- 本論文では、計算効率やメモリ効率を向上させることに焦点を当てた「X-former」モデル(Reformer、Linformer、Performer、Longformerなど)の大規模なセレクションを紹介し、最近の研究を体系的かつ包括的にまとめる。Transformersは自然言語処理を含む多くの分野で重要な役割を果たしている。 Comment
関連:
- [Paper Note] Efficient Transformers: A Survey, Yi Tay+, ACM Computing Surveys'22, 2022.12
- [Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
- [Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
- [Paper Note] Generating Long Sequences with Sparse Transformers, Rewon Child+, arXiv'19, 2019.04
- [Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
[Paper Note] Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time, Mitchell Wortsman+, ICML'22, 2022.03
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #ICML #Selected Papers/Blogs #OOD #Finetuning #Generalization #Encoder #Encoder-Decoder #KeyPoint Notes #Souping Issue Date: 2025-11-28 GPT Summary- ファインチューニングされたモデルの重みを平均化する「モデルスープ」手法を提案し、精度と堅牢性を向上させることを示す。従来のアンサンブル手法とは異なり、追加のコストなしで複数のモデルを平均化でき、ImageNetで90.94%のトップ1精度を達成。さらに、画像分類や自然言語処理タスクにも適用可能で、分布外性能やゼロショット性能を改善することが確認された。 Comment
transformerベースの事前学習済みモデル(encoder-only, encoder-decoderモデル)のファインチューニングの話で、共通のベースモデルかつ共通のパラメータの初期化を持つ、様々なハイパーパラメータで学習したモデルの重みを平均化することでよりロバストで高性能なモデルを作ります、という話。似たような手法にアンサンブルがあるが、アンサンブルでは利用するモデルに対して全ての推論結果を得なければならないため、計算コストが増大する。一方、モデルスープは単一モデルと同じ計算量で済む(=計算量は増大しない)。
スープを作る際は、Validation dataのAccが高い順に異なるFinetuning済みモデルをソートし、逐次的に重みの平均をとりValidation dataのAccが上がる場合に、当該モデルをsoupのingridientsとして加える。要は、開発データで性能が高い順にモデルをソートし、逐次的にモデルを取り出していき、現在のスープに対して重みを平均化した時に開発データの性能が上がるなら平均化したモデルを採用し、上がらないなら無視する、といった処理を繰り返す。これをgreedy soupと呼ぶ。他にもuniform soup, learned soupといった手法も提案され比較されているが、画像系のモデル(CLIP, ViTなど)やNLP(T5, BERT)等で実験されており、greedy soupの性能とロバストさ(OOD;分布シフトに対する予測性能)が良さそうである。
[Paper Note] Mixture of Attention Heads: Selecting Attention Heads Per Token, Xiaofeng Zhang+, EMNLP'22, 2022.10
Paper/Blog Link My Issue
#Transformer #Attention #Architecture #MoE(Mixture-of-Experts) #EMNLP #KeyPoint Notes Issue Date: 2025-10-04 GPT Summary- Mixture of Attention Heads (MoA)は、MoEネットワークとマルチヘッドアテンションを組み合わせた新しいアーキテクチャで、動的に選択されたアテンションヘッドのサブセットを使用することでパフォーマンスを向上させる。スパースゲート化により計算効率を保ちながら拡張可能で、モデルの解釈可能性にも寄与する。実験では、機械翻訳やマスク付き言語モデリングなどのタスクで強力なベースラインを上回る結果を示した。 Comment
FFNに適用されることが多かったMoEをmulti-head attention (MHA) に適用する研究。このようなattentionをMixture of Attention Heads (MoA)と呼ぶ。
各MHAは複数のattention expertsを持ち、その中からK個のExpertsが現在のクエリq_tに基づいてRouterによって選出(式7, 8)される。それぞれのattention expertsに対してq_tが流され、通常のMHAと同じ流れでoutputが計算され、最終的に選択された際の(正規化された(式9))probabilityによる加重平均によって出力を計算する(式6)。
注意点としては、各attention expertsは独立したprojection matrix W_q, W_o(それぞれi番目のexpertsにおけるトークンtにおいて、query q_tを変換、output o_{i,t}をhidden space次元に戻す役割を持つ)を持つが、K, Vに対する変換行列は共有すると言う点。これにより、事前に全てのexpertsに対してk, vに対する変換は計算しておけるので、headごとに異なる変換を学習しながら、計算コストを大幅に削減できる。
また、特定のexpertsにのみルーティングが集中しないように、lossを調整することで学習の安定させ性能を向上させている(4.3節)。
[Paper Note] Constitutional AI: Harmlessness from AI Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#LanguageModel #Alignment #Supervised-FineTuning (SFT) #ReinforcementLearning #Safety #Selected Papers/Blogs #PseudoLabeling Issue Date: 2025-09-20 GPT Summary- 本研究では、「憲法的AI」を用いて、人間のラベルなしで無害なAIを訓練する方法を提案。監視学習と強化学習の2フェーズを経て、自己批評と修正を通じてモデルを微調整し、嗜好モデルを報酬信号として強化学習を行う。これにより、有害なクエリに対しても対話できる無害なAIアシスタントを実現し、AIの意思決定の透明性を向上させる。 Comment
(部分的にしか読めていないが)
有害なpromptに対してLLMに初期の応答を生成させ、iterativeにcritiqueとrevisionを繰り返して[^1]、より無害な応答を生成。この方法ではiterationをしながら生成結果が改定されていくので、後段のReward Modelのための嗜好データを生成するフェーズでトークン量を節約するために、生成されたより無害な応答と元となるpromptを用いて、ベースモデルをSFT。これによりベースモデルの出力分布がより無害な応答をするような方向性に調整され、かつ(iterationを繰り返すことなく)直接的により無害な応答を生成できるようになるのでtoken量が節約できる。このフェーズで学習したモデルをSL-CAIと呼ぶ。
続いて、SL-CAIに対して同様の有害なpromptを入力して、複数の応答を生成させる。生成された応答をMultiple Choice Questionの形式にし、Constitutional Principleに基づくpromptingにより、最も望ましい応答をLLMによって選択させることで、嗜好データを獲得する。この嗜好データ(と人手で定義されたhelpfulnessに基づくデータ)を用いてReward Modelを訓練しRLを実施する。
この手法は、嗜好データを人間がラベリングするのではなく、AIによるフィードバックによりラベリングするため、Reinforcement Learning from AI Feedback (RLAIF)と呼ばれる。
Harmfulness以外の分野にも応用可能と考えられる。
[^1]: この操作はモデルの望ましい挙動を人手で定義したルーブリックに基づいた複数のprompt (Constitutional Principles) を用いて実施される。具体的なpromptはAppendix Cを参照。
[Paper Note] Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, Yuntao Bai+, arXiv'22
Paper/Blog Link My Issue
#LanguageModel #Alignment #ReinforcementLearning #Safety Issue Date: 2025-09-20 GPT Summary- 言語モデルを無害なアシスタントとして機能させるために、好みのモデル化と人間のフィードバックからの強化学習(RLHF)を用いて微調整を行い、NLP評価での性能向上を実現。毎週新しいフィードバックデータでモデルを更新し、効率的な改善を図る。RLHFトレーニングの堅牢性を調査し、ポリシーと初期化とのKLダイバージェンスの関係を特定。モデルのキャリブレーションや競合目的についても分析し、人間の作家との比較を行った。
[Paper Note] Emergent Abilities of Large Language Models, Jason Wei+, TMLR'22
Paper/Blog Link My Issue
#Analysis #LanguageModel #Selected Papers/Blogs #EmergentAbilities Issue Date: 2025-09-19 GPT Summary- 大規模言語モデルのスケーリングアップは性能を向上させるが、「出現能力」と呼ばれる予測不可能な現象が存在する。これは小型モデルにはない能力であり、さらなるスケーリングがモデルの能力を拡大する可能性を示唆している。 Comment
openreview: https://openreview.net/forum?id=yzkSU5zdwD
創発能力(最近この用語を目にする機会が減ったような気がする)
[Paper Note] Deduplicating Training Data Makes Language Models Better, Katherine Lee+, ACL'22
Paper/Blog Link My Issue
#Pretraining #LanguageModel #ACL #Selected Papers/Blogs #Deduplication Issue Date: 2025-09-04 GPT Summary- 既存の言語モデルデータセットには重複した例が多く含まれ、訓練されたモデルの出力の1%以上が訓練データからコピーされている。これを解決するために、重複排除ツールを開発し、C4データセットからは60,000回以上繰り返される文を削除。重複を排除することで、モデルの記憶されたテキスト出力を10倍減少させ、精度を維持しつつ訓練ステップを削減。また、訓練とテストの重複を減らし、より正確な評価を実現。研究の再現とコードは公開されている。 Comment
下記スライドのp.9にまとめが記述されている:
https://speakerdeck.com/takase/snlp2023-beyond-neural-scaling-laws?slide=9
[Paper Note] StableMoE: Stable Routing Strategy for Mixture of Experts, Damai Dai+, arXiv'22
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #MoE(Mixture-of-Experts) #Stability Issue Date: 2025-09-02 GPT Summary- StableMoEは、ルーティングの変動問題に対処するために2つのトレーニングステージを持つMixture-of-Experts手法を提案。最初のステージで一貫したルーティング戦略を学習し、軽量ルーターに蒸留。第二のステージでそのルーターを用いてエキスパートへの割り当てを固定。言語モデリングと多言語機械翻訳での実験により、StableMoEは収束速度と性能で既存手法を上回ることが示された。 Comment
元ポスト:
[Paper Note] Matryoshka Representation Learning, Aditya Kusupati+, NeurIPS'22
Paper/Blog Link My Issue
#Embeddings #RepresentationLearning #NeurIPS #Length #Selected Papers/Blogs #Reference Collection Issue Date: 2025-07-29 GPT Summary- マトリョーシカ表現学習(MRL)は、異なる計算リソースに適応可能な柔軟な表現を設計する手法であり、既存の表現学習パイプラインを最小限に修正して使用します。MRLは、粗から細への表現を学習し、ImageNet-1K分類で最大14倍小さい埋め込みサイズを提供し、実世界のスピードアップを実現し、少数ショット分類で精度向上を達成します。MRLは視覚、視覚+言語、言語のモダリティにわたるデータセットに拡張可能で、コードとモデルはオープンソースで公開されています。 Comment
日本語解説: https://speakerdeck.com/hpprc/lun-jiang-zi-liao-matryoshka-representation-learning
単一のモデルから複数のlengthのEmbeddingを出力できるような手法。
解説:
[Paper Note] Perceiver IO: A General Architecture for Structured Inputs & Outputs, Andrew Jaegle+, ICLR'22, 2021.07
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #MachineLearning #MultitaskLearning #MultiModal #SpeechProcessing #ICLR Issue Date: 2025-07-10 GPT Summary- 汎用アーキテクチャPerceiver IOを提案し、任意のデータ設定に対応し、入力と出力のサイズに対して線形にスケール可能。柔軟なクエリメカニズムを追加し、タスク特有の設計を不要に。自然言語、視覚理解、マルチタスクで強力な結果を示し、GLUEベンチマークでBERTを上回る性能を達成。 Comment
当時相当話題となったさまざまなモーダルを統一された枠組みで扱えるPerceiver IO論文
openreview: https://openreview.net/forum?id=fILj7WpI-g
[Paper Note] On Layer Normalizations and Residual Connections in Transformers, Sho Takase+, arXiv'22
Paper/Blog Link My Issue
#Transformer #Architecture #Normalization #Encoder-Decoder #Initial Impression Notes Issue Date: 2025-07-04 GPT Summary- 本研究では、Transformerアーキテクチャのレイヤー正規化の位置に関するPost-LNとPre-LNの違いを調査。Post-LNは浅い層で優れた性能を示す一方、深い層では不安定なトレーニングを引き起こす消失勾配問題があることを発見。これを踏まえ、Post-LNの修正により安定したトレーニングを実現する方法を提案し、実験でPre-LNを上回る結果を示した。 Comment
Pre-LNの安定性を持ちながらもPost-LNのような高い性能を発揮する良いとこ取りのB2TConnectionを提案
NLP2022: https://www.anlp.jp/proceedings/annual_meeting/2022/pdf_dir/A2-5.pdf
[Paper Note] Fast Model Editing at Scale, Eric Mitchell+, ICLR'22
Paper/Blog Link My Issue
#LanguageModel #ICLR #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- MEND(モデル編集ネットワーク)は、事前学習モデルの動作を迅速かつ局所的に編集するための手法で、単一の入力-出力ペアを用いて勾配分解を活用します。これにより、10億以上のパラメータを持つモデルでも、1台のGPUで短時間でトレーニング可能です。実験により、MENDが大規模モデルの編集において効果的であることが示されました。 Comment
OpenReview: https://openreview.net/forum?id=0DcZxeWfOPt
[Paper Note] LoRA: Low-Rank Adaptation of Large Language Models, Edward J. Hu+, ICLR'22
Paper/Blog Link My Issue
#LanguageModel #PEFT(Adaptor/LoRA) #ICLR #PostTraining #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-05-12 GPT Summary- LoRAは、事前学習された大規模モデルの重みを固定し、各層に訓練可能なランク分解行列を追加することで、ファインチューニングに必要なパラメータを大幅に削減する手法です。これにより、訓練可能なパラメータを1万分の1、GPUメモリを3分の1に減少させながら、RoBERTaやGPT-3などで同等以上の性能を実現します。LoRAの実装はGitHubで公開されています。 Comment
OpenrReview: https://openreview.net/forum?id=nZeVKeeFYf9
LoRAもなんやかんやメモってなかったので追加。
事前学習済みのLinear Layerをfreezeして、freezeしたLinear Layerと対応する低ランクの行列A,Bを別途定義し、A,BのパラメータのみをチューニングするPEFT手法であるLoRAを提案した研究。オリジナルの出力に対して、A,Bによって入力を写像したベクトルを加算する。
チューニングするパラメータ数学はるかに少ないにも関わらずフルパラメータチューニングと(これは諸説あるが)同等の性能でPostTrainingできる上に、事前学習時点でのパラメータがfreezeされているためCatastrophic Forgettingが起きづらく(ただし新しい知識も獲得しづらい)、A,Bの追加されたパラメータのみを保存すれば良いのでストレージに優しいのも嬉しい。
- [Paper Note] LoRA-Pro: Are Low-Rank Adapters Properly Optimized?, Zhengbo Wang+, ICLR'25, 2024.07
などでも示されているが、一般的にLoRAとFull Finetuningを比較するとLoRAの方が性能が低いことが知られている点には留意が必要。
最近、LoRAが学習率に対してsensitiveで、LoRAの提案以後約50種類の変種が提案されたが、適切にLoRAの学習率を調整した上で比較実験すると、依然としてオリジナルのLoRAが強力な手法であることが示された。以後提案された手法群は比較実験におけるハイパーパラメータの調整不足であることが指摘されている。
- [Paper Note] Learning Rate Matters: Vanilla LoRA May Suffice for LLM Fine-tuning, Yu-Ang Lee+, arXiv'26, 2026.02
[Paper Note] LAION-5B: An open large-scale dataset for training next generation image-text models, Christoph Schuhmann+, NeurIPS'22
Paper/Blog Link My Issue
#ComputerVision #Pretraining #Dataset #MultiModal #CLIP #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-05-06 GPT Summary- LAION-5Bは、5.85億のCLIPフィルタリングされた画像-テキストペアから成る大規模データセットで、英語のペアが2.32B含まれています。このデータセットは、CLIPやGLIDEなどのモデルの再現とファインチューニングに利用され、マルチモーダルモデルの研究を民主化します。また、データ探索やサブセット生成のためのインターフェースや、コンテンツ検出のためのスコアも提供されます。 Comment
openreview: https://openreview.net/forum?id=M3Y74vmsMcY
[Paper Note] Over-Generation Cannot Be Rewarded: Length-Adaptive Average Lagging for Simultaneous Speech Translation, Sara Papi+, NAACL'22
Paper/Blog Link My Issue
#Metrics #Evaluation #SpeechProcessing #AutomaticSpeechRecognition(ASR) #NAACL #SimulST(SimultaneousSpeechTranslation) #One-Line Notes Issue Date: 2025-04-30 GPT Summary- SimulSTシステムの遅延評価において、ALが長い予測に対して過小評価される問題を指摘。過剰生成の傾向を持つシステムに対し、過小生成と過剰生成を公平に評価する新指標LAALを提案。 Comment
同時翻訳研究で主要なmetricの一つ
関連:
- [Paper Note] SimulMT to SimulST: Adapting Simultaneous Text Translation to End-to-End Simultaneous Speech Translation, Xutai Ma+, AACL'20
[Paper Note] DeepNet: Scaling Transformers to 1,000 Layers, Hongyu Wang+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#Transformer #Architecture #Normalization Issue Date: 2025-04-19 GPT Summary- Transformerの安定化手法として、残差接続を修正する新正規化関数DeepNormを提案。理論分析に基づき、初期化を併用しモデルの更新を安定させる。DeepNormはPost-LNの性能とPre-LNの安定性を兼ね備え、1000層へのスケーリングを実現。特に、7,482翻訳方向のベンチマークにおいて、200層の3.2Bパラメータモデルが12Bパラメータの48層モデルを5BLEUポイント上回る成果を示した。 Comment
ステートオブAIガイドによる解説: https://ja.stateofaiguides.com/20220308-deepnet-transformer/
[Paper Note] Training Compute-Optimal Large Language Models, Jordan Hoffmann+, NeurIPS'22, 2022.03
Paper/Blog Link My Issue
#MachineLearning #LanguageModel #NeurIPS #Scaling Laws #Selected Papers/Blogs #One-Line Notes Issue Date: 2025-03-23 GPT Summary- トランスフォーマー言語モデルの訓練において、計算予算内で最適なモデルサイズとトークン数を調査。モデルサイズと訓練トークン数は同等にスケールする必要があり、倍増するごとにトークン数も倍増すべきと提案。Chinchillaモデルは、Gopherなどの大規模モデルに対して優れた性能を示し、ファインチューニングと推論の計算量を削減。MMLUベンチマークで67.5%の精度を達成し、Gopherに対して7%以上の改善を実現。 Comment
OpenReview: https://openreview.net/forum?id=iBBcRUlOAPR
chinchilla則、モデルの規模とデータ量はおおむね同じ比率でスケールすべき、という話。
[Paper Note] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, William Fedus+, JMLR'22
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #Transformer #Architecture #MoE(Mixture-of-Experts) #Selected Papers/Blogs #JMLR Issue Date: 2025-02-11 GPT Summary- Switch Transformerを提案し、Mixture of Experts (MoE)の複雑さや通信コスト、トレーニングの不安定性を改善。これにより、低精度フォーマットでの大規模スパースモデルのトレーニングが可能になり、最大7倍の事前トレーニング速度向上を実現。さらに、1兆パラメータのモデルを事前トレーニングし、T5-XXLモデルに対して4倍の速度向上を達成。
[Paper Note] Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, Yizhong Wang+, EMNLP'22, 2022.04
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #EMNLP #PostTraining #KeyPoint Notes Issue Date: 2024-10-29 GPT Summary- NLPモデルの一般化能力を評価するために、1,616の多様なタスクを含むSuper-NaturalInstructionsというベンチマークを導入。76種のタスクタイプをカバーし、モデルをタスクのサブセットで訓練し未見のタスクを評価。Tk-Instructモデルは、InstructGPTを9%以上上回る性能を示し、サイズが小さい。タスク数やインスタンス数に基づいた一般化の分析を行い、本データセットとモデルが汎用的NLPモデルの進展に寄与することを期待。 Comment
7.1, 7.2が最も興味深い
## Instruction Tuningにおける未知のタスクに対する汎化性能について、3つの要素に対するスケーリングについて考察
- More observed tasks improve the generalization.
- A large number of training instances do not help generalization.
- Tuning larger models with instructions consistently lead to gains.
## Instructionをさまざまに変化させた時の性能の変化に対する分析
Table4の対角成分に注目すると(trainとtestのinput encodingを揃えた場合)
- Task definitionをinstructionに含めることで未知タスクに対する汎化性能向上
- Task Definitionとpositive examplesを4つ程度入れると汎化性能向上。
- ただし、これ以上exampleを増やすと性能低下。
- negative examplesを入れることは性能に a little bit しか貢献しない
- explanationsを入れると性能が低下する
Table4の非対角成分に着目すると、
- Task Definitionのみで訓練しても、Example onlyのtest時のencodingには汎化しない(逆も然り)
- Task Definition + examples (今回の場合はpositive examples4つ)は、さまざまなtest時のinput encodingsに対してロバストになる
[Paper Note] No Language Left Behind: Scaling Human-Centered Machine Translation, NLLB Team+, arXiv'22, 2022.07
Paper/Blog Link My Issue
#MachineTranslation #Dataset #LowResource #One-Line Notes Issue Date: 2024-09-26 GPT Summary- 低資源言語翻訳を支援するため、母語話者へのインタビューを通じてニーズを明らかにし、新たなデータセットとモデルを開発。Sparsely Gated Mixture of Expertsに基づく条件付き計算モデルを用い、訓練時の過剰適合を抑えつつ性能を向上。Flores-200ベンチマークにより翻訳性能を評価し、BLEUスコアを44%改善。研究成果はオープンソースとして公開。 Comment
low-resourceな言語に対するMTのベンチマーク
[Paper Note] Finetuned Language Models Are Zero-Shot Learners, Jason Wei+, ICLR'22, 2021.09
Paper/Blog Link My Issue
#LanguageModel #Supervised-FineTuning (SFT) #InstructionTuning #ICLR #Selected Papers/Blogs #One-Line Notes Issue Date: 2024-09-25 GPT Summary- 指示チューニングにより言語モデルのゼロショット学習能力を向上。1370億パラメータのモデルを60以上のNLPタスクに対してファインチューニングし、FLANと名付ける。FLANは未調整モデルを超え、25タスク中20タスクで175B GPT-3を上回り、ANLIやRTEなどでfew-shotのGPT-3にも勝る。ファインチューニングデータの数やモデル規模、指示内容が成功の鍵と示される。 Comment
FLAN論文。Instruction Tuningを提案した研究。
openreview: https://openreview.net/forum?id=gEZrGCozdqR
[Paper Note] STaR: Bootstrapping Reasoning With Reasoning, Eric Zelikman+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#LanguageModel #SelfImprovement #NeurIPS #needs-revision Issue Date: 2024-09-15 GPT Summary- STaR(Self-Taught Reasoner)を提案し、少数の推論例と大規模データセットを用いて段階的に複雑な推論を行う手法を紹介。まず複数の質問に対して推論根拠を生成し、誤答時には正しい解答を前提に再生成を行うことで性能を向上。STaRはファインチューニングにより自己学習能力を持ち、複数のデータセットでの性能を顕著に改善、CommensenseQAでは最先端モデルと同等の結果を達成。 Comment
OpenAI o1関連研究
openreview: https://openreview.net/forum?id=_3ELRdg2sgI
Knowledge Neurons in Pretrained Transformers, Damai Dai+, N_A, ACL'22, 2022.05
Paper/Blog Link My Issue
#Analysis #Transformer #ACL #KnowledgeEditing #Selected Papers/Blogs #FactualKnowledge #Encoder #KeyPoint Notes #Reference Collection Issue Date: 2024-07-11 GPT Summary- 大規模な事前学習言語モデルにおいて、事実知識の格納方法についての研究を行いました。具体的には、BERTのfill-in-the-blank cloze taskを用いて、関連する事実を表現するニューロンを特定しました。また、知識ニューロンの活性化と対応する事実の表現との正の相関を見つけました。さらに、ファインチューニングを行わずに、知識ニューロンを活用して特定の事実知識を編集しようと試みました。この研究は、事前学習されたTransformers内での知識の格納に関する示唆に富んでおり、コードはhttps://github.com/Hunter-DDM/knowledge-neuronsで利用可能です。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
日本語解説: https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022
関連:
- [Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
上記資料によると、特定の知識を出力する際に活性化する知識ニューロンを特定する手法を提案。MLMを用いたclozeタスクによる実験で[MASK]部分に当該知識を出力する実験をした結果、知識ニューロンの重みをゼロとすると性能が著しく劣化し、値を2倍にすると性能が改善するといった傾向がみられた。 ケーススタディとして、知識の更新と、知識の削除が可能かを検証。どちらとも更新・削除がされる方向性[^1]へモデルが変化した。
また、知識ニューロンはTransformerの層の深いところに位置している傾向にあり、異なるrelationを持つような関係知識同士では共有されない傾向にある模様。
[^1]: 他の知識に影響を与えず、完璧に更新・削除できたわけではない。知識の更新・削除に伴いExtrinsicな評価によって性能向上、あるいはPerplexityが増大した、といった結果からそういった方向性へモデルが変化した、という話
Training language models to follow instructions with human feedback, Long Ouyang+, N_A, NeurIPS'22
Paper/Blog Link My Issue
#LanguageModel #Alignment #ChatGPT #RLHF #Actor-Critic #PostTraining #read-later #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-04-28 GPT Summary- 大規模な言語モデルは、ユーザーの意図に合わない出力を生成することがあります。本研究では、人間のフィードバックを使用してGPT-3を微調整し、InstructGPTと呼ばれるモデルを提案します。この手法により、13億パラメータのInstructGPTモデルの出力が175BのGPT-3の出力よりも好まれ、真実性の向上と有害な出力の削減が示されました。さらに、一般的なNLPデータセットにおける性能の低下は最小限でした。InstructGPTはまだ改善の余地がありますが、人間のフィードバックを使用した微調整が有望な方向であることを示しています。 Comment
ChatGPTの元となる、SFT→Reward Modelの訓練→RLHFの流れが提案された研究。DemonstrationデータだけでSFTするだけでは、人間の意図したとおりに動作しない問題があったため、人間の意図にAlignするように、Reward Modelを用いたRLHFでSFTの後に追加で学習を実施する。Reward Modelは、175Bモデルは学習が安定しなかった上に、PPOの計算コストが非常に大きいため、6BのGPT-3を様々なNLPタスクでSFTしたモデルをスタートにし、モデルのアウトプットに対して人間がランキング付けしたデータをペアワイズのloss functionで訓練した。最終的に、RMのスコアが最大化されるようにSFTしたGPT-3をRLHFで訓練するが、その際に、SFTから出力が離れすぎないようにする項と、NLPベンチマークでの性能が劣化しないようにpretrain時のタスクの性能もloss functionに加えている。
MURMUR: Modular Multi-Step Reasoning for Semi-Structured Data-to-Text Generation, Swarnadeep Saha+, N_A, arXiv'22
Paper/Blog Link My Issue
#NaturalLanguageGeneration #DataToTextGeneration #StructuredData Issue Date: 2023-10-28 GPT Summary- 本研究では、半構造化データからのテキスト生成における多段階の推論を行うためのMURMURという手法を提案しています。MURMURは、特定の言語的および論理的なスキルを持つニューラルモジュールと記号モジュールを組み合わせ、ベストファーストサーチ手法を使用して推論パスを生成します。実験結果では、MURMURは他のベースライン手法に比べて大幅な改善を示し、また、ドメイン外のデータでも同等の性能を達成しました。さらに、人間の評価では、MURMURは論理的に整合性のある要約をより多く生成することが示されました。
Momentum Calibration for Text Generation, Xingxing Zhang+, N_A, arXiv'22
Paper/Blog Link My Issue
#BeamSearch #NaturalLanguageGeneration Issue Date: 2023-08-16 GPT Summary- 本研究では、テキスト生成タスクにおいてMoCa(Momentum Calibration)という手法を提案しています。MoCaは、ビームサーチを用いた遅く進化するサンプルを動的に生成し、これらのサンプルのモデルスコアを実際の品質に合わせるように学習します。実験結果は、MoCaが強力な事前学習済みTransformerを改善し、最先端の結果を達成していることを示しています。
[Paper Note] BRIO: Bringing Order to Abstractive Summarization, Yixin Liu+, arXiv'22, 2022.03
Paper/Blog Link My Issue
#DocumentSummarization #BeamSearch #NaturalLanguageGeneration #ACL #One-Line Notes #needs-revision Issue Date: 2023-08-16 GPT Summary- 非決定論的分布を仮定し、複数の候補要約に確率を割り当てる新しい訓練パラダイムを提案。CNN/DailyMailおよびXSumデータセットで最先端のROUGEスコアを達成し、モデルが候補要約の品質と相関する確率を推定可能であることを示す。 Comment
ビーム内のトップがROUGEを最大化しているとは限らなかったため、ROUGEが最大となるような要約を選択するようにしたら性能爆上げしましたという研究。
実質現在のSoTA
SMART: Sentences as Basic Units for Text Evaluation, Reinald Kim Amplayo+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-14 GPT Summary- 本研究では、テキスト生成の評価指標の制限を緩和するために、新しい指標であるSMARTを提案する。SMARTは文を基本的なマッチング単位とし、文のマッチング関数を使用して候補文と参照文を評価する。また、ソースドキュメントの文とも比較し、評価を可能にする。実験結果は、SMARTが他の指標を上回ることを示し、特にモデルベースのマッチング関数を使用した場合に有効であることを示している。また、提案された指標は長い要約文でもうまく機能し、特定のモデルに偏りが少ないことも示されている。
FFCI: A Framework for Interpretable Automatic Evaluation of Summarization, Fajri Koto+, N_A, JAIR'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #Reference-based Issue Date: 2023-08-13 GPT Summary- 本論文では、FFCIという細かい要約評価のためのフレームワークを提案しました。このフレームワークは、信頼性、焦点、カバレッジ、および文間の連続性の4つの要素から構成されています。新しいデータセットを構築し、評価メトリックとモデルベースの評価方法をクロス比較することで、FFCIの4つの次元を評価するための自動的な方法を開発しました。さまざまな要約モデルを評価し、驚くべき結果を得ました。 Comment
先行研究でどのようなMetricが利用されていて、それらがどういった観点のMetricなのかや、データセットなど、非常に細かくまとまっている。
Faithfulness(ROUGE, STS-Score, BERTScoreに基づく), Focus and Coverage (Question Answering basedな手法に基づく), Inter-Sentential Coherence (NSPに基づく)メトリックを組み合わせることを提案している。
InfoLM: A New Metric to Evaluate Summarization & Data2Text Generation, Pierre Colombo+, N_A, AAAI'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13 GPT Summary- 自然言語生成システムの品質評価は高価であり、人間の注釈に頼ることが一般的です。しかし、自動評価指標を使用することもあります。本研究では、マスクされた言語モデルを使用した評価指標であるInfoLMを紹介します。この指標は同義語を処理することができ、要約やデータ生成の設定で有意な改善を示しました。
WIDAR -- Weighted Input Document Augmented ROUGE, Raghav Jain+, N_A, ECIR'22
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13 GPT Summary- 自動テキスト要約の評価において、ROUGEメトリックには制約があり、参照要約の利用可能性に依存している。そこで、本研究ではWIDARメトリックを提案し、参照要約だけでなく入力ドキュメントも使用して要約の品質を評価する。WIDARメトリックは一貫性、整合性、流暢さ、関連性の向上をROUGEと比較しており、他の最先端のメトリックと同等の結果を短い計算時間で得ることができる。
SummaC: Re-Visiting NLI-based Models for Inconsistency Detection in Summarization, Laban+, TACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #LM-based #Factuality #TACL Issue Date: 2023-08-13
[Paper Note] TRUE: Re-evaluating Factual Consistency Evaluation, Or Honovich+, arXiv'22, 2022.04
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Factuality #One-Line Notes #needs-revision Issue Date: 2023-08-13 GPT Summary- 事実的一致性評価が重要なテキスト生成システムにおいて、矛盾を減らすための自動評価が提案される。従来の評価指標は特定のタスクに偏りがあり、実用性に欠けることが多い。これに対抗して、TRUEを提案し、多様なタスクに基づく標準化されたコレクションに対する人手注釈のもとでの評価を行う。これにより、例レベルのメタ評価プロトコルが実現し、質の高い評価が可能となった。大規模なNLIや質問生成モデルが強力な結果を示し、今後の評価方法の改善へ向けた新たな指針を提供する。 Comment
FactualConsistencyに関するMetricが良くまとまっている
[Paper Note] MaskEval: Weighted MLM-Based Evaluation for Text Summarization and Simplification, Yu Lu Liu+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13 GPT Summary- 本研究では、テキストの要約と簡素化のための参照のない評価尺度であるMaskEvalを提案しています。MaskEvalは、候補テキストとソーステキストの連結に対してマスクされた言語モデリングを行い、重要な品質の側面ごとに相対的な重要性を調整することができます。さらに、英語の要約と簡素化における人間の判断との相関に基づいて、その効果を示し、両方のタスク間での転移シナリオを探索します。
Reference-free Summarization Evaluation via Semantic Correlation and Compression Ratio, Liu+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free Issue Date: 2023-08-13
Re-Examining System-Level Correlations of Automatic Summarization Evaluation Metrics, Deutsch+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
Does Summary Evaluation Survive Translation to Other Languages?, Braun+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
SummScore: A Comprehensive Evaluation Metric for Summary Quality Based on Cross-Encoder, Wuhang Lin+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #TrainedMetrics Issue Date: 2023-08-13 GPT Summary- 要約の品質評価メトリクスの問題を解決するために、SummScoreという包括的な評価メトリクスを提案する。SummScoreはCrossEncoderに基づいており、要約の多様性を抑制せずに要約の品質を評価することができる。さらに、SummScoreは一貫性、一貫性、流暢さ、関連性の4つの側面で評価することができる。実験結果は、SummScoreが既存の評価メトリクスを上回ることを示している。また、SummScoreの評価結果を16の主要な要約モデルに提供している。
SueNes: A Weakly Supervised Approach to Evaluating Single-Document Summarization via Negative Sampling, Bao+, NAACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13
PrefScore: Pairwise Preference Learning for Reference-free Summarization Quality Assessment, Luo+, COLING'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free Issue Date: 2023-08-13
How to Find Strong Summary Coherence Measures? A Toolbox and a Comparative Study for Summary Coherence Measure Evaluation, Steen+, COLING'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13
Self-Repetition in Abstractive Neural Summarizers, Nikita Salkar+, N_A, AACL-IJCNLP'22
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #Analysis #IJCNLP #AACL #Repetition Issue Date: 2023-08-13 GPT Summary- 私たちは、BART、T5、およびPegasusという3つのニューラルモデルの出力における自己繰り返しの分析を行いました。これらのモデルは、異なるデータセットでfine-tuningされています。回帰分析によると、これらのモデルは入力の出力要約間でコンテンツを繰り返す傾向が異なることがわかりました。また、抽象的なデータや定型的な言語を特徴とするデータでのfine-tuningでは、自己繰り返しの割合が高くなる傾向があります。定性的な分析では、システムがアーティファクトや定型フレーズを生成することがわかりました。これらの結果は、サマライザーのトレーニングデータを最適化するための手法の開発に役立つ可能性があります。
Universal Evasion Attacks on Summarization Scoring, Wenchuan Mu+, N_A, BlackboxNLP workshop on ACL'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #ACL #Workshop Issue Date: 2023-08-13 GPT Summary- 要約の自動評価は重要であり、その評価は複雑です。しかし、これまで要約の評価は機械学習のタスクとは考えられていませんでした。本研究では、自動評価の堅牢性を探るために回避攻撃を行いました。攻撃システムは、要約ではない文字列を予測し、一般的な評価指標であるROUGEやMETEORにおいて優れた要約器と競合するスコアを達成しました。また、攻撃システムは最先端の要約手法を上回るスコアを獲得しました。この研究は、現在の評価システムの堅牢性の低さを示しており、要約スコアの開発を促進することを目指しています。
[Paper Note] RISE: Leveraging Retrieval Techniques for Summarization Evaluation, David Uthus+, arXiv'22, 2022.12
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation #Reference-free #ACL #Findings #Surface-level Notes Issue Date: 2023-08-13 GPT Summary- 自動生成された要約の評価は困難であり、これまでの手法は人間の評価に及ばない。新たに提案されたRISEは、デュアルエンコーダー検索設定を用いて生成要約を評価する手法で、ゴールド標準の参照要約がなくても機能する。特に参照要約がない新たなデータセットに対して効果的であり、SummEvalベンチマークでの実験により、人間の評価と高い相関を示した。RISEはデータ効率性と多言語間の一般化可能性も備えている。 Comment
# 概要
Dual-Encoderを用いて、ソースドキュメントとシステム要約をエンコードし、dot productをとることでスコアを得る手法。モデルの訓練は、Contrastive Learningで行い、既存データセットのソースと参照要約のペアを正例とみなし、In Batch trainingする。
# 分類
Reference-free, Model-based, ソース依存で、BARTScore [Paper Note] BARTScore: Evaluating Generated Text as Text Generation, Weizhe Yuan+, arXiv'21, 2021.06
とは異なり、文書要約データを用いて学習するため、要約の評価に特化している点が特徴。
# モデル
## Contrastive Learning
Contrastive Learningを用い、hard negativeを用いたvariantも検証する。また、訓練データとして3種類のパターンを検証する:
1. in-domain data: 文書要約データを用いて訓練し、ターゲットタスクでどれだけの性能を発揮するかを見る
2. out-of-domain data: 文書要約以外のデータを用いて訓練し、どれだけ新しいドメインにモデルがtransferできるかを検証する
3. in-and-out-domain data: 両方やる
## ハードネガティブの生成
Lexical Negatives, Model Negatives, 双方の組み合わせの3種類を用いてハードネガティブを生成する。
### Lexical Negatives
参照要約を拡張することによって生成する。目的は、もともとの参照要約と比較して、poor summaryを生成することにある。Data Augmentationとして、以下の方法を試した:
- Swapping noun entities: 要約中のエンティティを、ソース中のエンティティンとランダムでスワップ
- Shuffling words: 要約中の単語をランダムにシャッフル
- Dropping words: 要約中の単語をランダムに削除
- Dropping characters: 要約中の文字をランダムに削除
- Swapping antonyms: 要約中の単語を対義語で置換
### Model Negatives
データセットの中から負例を抽出する。目的は、参照要約と類似しているが、負例となるサンプルを見つけること。これを実現するために、まずRISE modelをデータセットでfinetuningし、それぞれのソースドキュメントの要約に対して、類似した要約をマイニングする。すべてのドキュメントと要約をエンコードし、top-nの最も類似した要約を見つけ、これをハードネガティブとして、再度モデルを訓練する。
### 両者の組み合わせ
まずlexical negativesでモデルを訓練し、モデルネガティブの抽出に活用する。抽出したモデルネガティブを用いて再度モデルを訓練することで、最終的なモデルとする。
# 実験
## 学習手法
SummEval SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
を用いて人手評価と比較してどれだけcorrelationがあるかを検証。SummEvalには16種類のモデルのアウトプットに対する、CNN / Daily Mail の100 examplesに対して、品質のアノテーションが付与されている。expert annotationを用いて、Kendall's tauを用いてシステムレベルのcorrelationを計算した。contextが短い場合はT5, 長い場合はLongT5, タスクがマルチリンガルな場合はmT5を用いて訓練した。訓練データとしては
- CNN / Daily Mail
- Multi News
- arXiv
- PubMed
- BigPatent
- SAMSum
- Reddit TIFU
- MLSUM
等を用いた。これによりshort / long contextの両者をカバーできる。CNN / Daily Mail, Reddiit TIFU, Multi-Newsはshort-context, arXiv, PubMed, BigPatent, Multi-News(長文のものを利用)はlonger contextとして利用する。
## 比較するメトリック
ROUGE, chrF, SMS, BARTScore, SMART, BLEURT, BERTScore, Q^2, T5-ANLI, PRISMと比較した。結果をみると、Consistency, Fluency, Relevanceで他手法よりも高い相関を得た。Averageでは最も高いAverageを獲得した。in-domain dataで訓練した場合は、高い性能を発揮した。our-of-domain(SAMSum; Dialogue要約のデータ)データでも高い性能を得た。
# Ablation
## ハードネガティブの生成方法
Data Augmentationは、swapping entity nouns, randomly dropping wordsの組み合わせが最も良かった。また、Lexical Negativesは、様々なデータセットで一貫して性能が良かったが、Model NegativesはCNN/DailyMailに対してしか有効ではなかった。これはおそらく、同じタスク(テストデータと同じデータ)でないと、Model Negativesは機能しないことを示唆している。ただし、Model Negativesを入れたら、何もしないよりも性能向上するから、何らかの理由でlexical negativesが生成できない場合はこっち使っても有用である。
## Model Size
でかい方が良い。in-domainならBaseでもそれなりの性能だけど、結局LARGEの方が強い。
## Datasets
異なるデータセットでもtransferがうまく機能している。驚いたことにデータセットをmixingするとあまりうまくいかず、単体のデータセットで訓練したほうが性能が良い。
LongT5を見ると、T5よりもCorrelationが低く難易度が高い。
最終的に英語の要約を評価をする場合でも、Multilingual(別言語)で訓練しても高いCorrelationを示すこともわかった。
## Dataset Size
サンプル数が小さくても有効に働く。しかし、out-domainのデータの場合は、たとえば、512件の場合は性能が低く少しexampleを増やさなければならない。
DocAsRef: A Pilot Empirical Study on Repurposing Reference-Based Summary Quality Metrics Reference-Freely, Forrest Sheng Bao+, N_A, arXiv'22
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 参照ベースと参照フリーの要約評価メトリックがあります。参照ベースは正確ですが、制約があります。参照フリーは独立していますが、ゼロショットと正確さの両方を満たせません。本研究では、参照ベースのメトリックを使用してゼロショットかつ正確な参照フリーのアプローチを提案します。実験結果は、このアプローチが最も優れた参照フリーのメトリックを提供できることを示しています。また、参照ベースのメトリックの再利用と追加の調整についても調査しています。
[Paper Note] Personalized News Headline Generation System with Fine-grained User Modeling, Jiaohong Yao, MSN'22
Paper/Blog Link My Issue
#PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration Issue Date: 2023-08-11
Personalized Headline Generation with Enhanced User Interest Perception, Zhang+, ICANN'22
Paper/Blog Link My Issue
#PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration Issue Date: 2023-08-11
[Paper Note] Personalized Chit-Chat Generation for Recommendation Using External Chat Corpora, Chen+, KDD'22
Paper/Blog Link My Issue
#RecommenderSystems #PersonalizedGeneration #Personalization #SIGKDD Issue Date: 2023-08-11
[Paper Note] Explaining Patterns in Data with Language Models via Interpretable Autoprompting, Chandan Singh+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Dataset #LanguageModel #DataToTextGeneration #Explanation #One-Line Notes #Data Issue Date: 2023-08-03 GPT Summary- iPromptを用いて、事前学習済みのLLMがデータを説明する自然言語文字列を生成する手法を提案。このアルゴリズムは、生成された説明の性能を再評価して最適化するプロセスを含む。実験によりiPromptが正確なデータ記述を見つけ、人間にも解釈可能なプロンプトを生成し、一般化性能に優れることが示された。特に、実世界の感情分類データセットでGPT-3並みのプロンプトを生成し、科学的発見の支援にも寄与する可能性がある。すべてのコードはGitHubで公開。 Comment
OpenReview: https://openreview.net/forum?id=GvMuB-YsiK6
データセット(中に存在するパターンの説明)をLLMによって生成させる研究


[Paper Note] RQUGE: Reference-Free Metric for Evaluating Question Generation by Answering the Question, Alireza Mohammadshahi+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Metrics #LanguageModel #QuestionAnswering #Evaluation #Reference-free #ACL #KeyPoint Notes Issue Date: 2023-07-22 GPT Summary- 既存の質問評価指標には、人間の参照質問との比較による語彙的重複や意味的類似性に基づく欠点がある。これに対し、本研究で提案する新しい指標RQUGEは、候補質問の文脈に基づく回答可能性を評価し、人間の判断と高い相関を示す。この指標は既存の事前学習モデルを活用し、追加訓練なしで使用可能。また、RQUGEは対抗的改ざんに対して堅牢であり、質問生成モデルからの合成データを用いた微調整により、QAモデルの性能を向上させることができる。 Comment
# 概要
質問自動生成の性能指標(e.g. ROUGE, BERTScore)は、表層の一致、あるいは意味が一致した場合にハイスコアを与えるが、以下の欠点がある
- 人手で作成された大量のreference questionが必要
- 表層あるいは意味的に近くないが正しいquestionに対して、ペナルティが与えられてしまう
=> contextに対するanswerabilityによって評価するメトリック RQUGE を提案
similarity basedな指標では、Q1のような正しい質問でもlexical overlapがないと低いスコアを与えてしまう。また、Q2のようなreferenceの言い換えであっても、低いスコアとなってしまう。一方、reference basedな手法では、Q3のようにunacceptableになっているにもかかわらず、変化が微小であるためそれをとらえられないという問題がある。
# 手法概要
提案手法ではcontextとanswer spanが与えられたとき、Span Scorerと、QAモジュールを利用してacceptability scoreを計算することでreference-freeなmetricを実現する。
QAモデルは、Contextと生成されたQuestionに基づき、answer spanを予測する。提案手法ではT5ベースの手法であるUnifiedQAv2を利用する。
Span Scorer Moduleでは、予測されたanswer span, candidate question, context, gold spanに基づき、[1, 5]のスコアを予測する。提案手法では、encoder-only BERT-based model(提案手法ではRoBERTa)を用いる。
[Paper Note] PAD-Net: An Efficient Framework for Dynamic Networks, Shwai He+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#NeuralNetwork #EfficiencyImprovement #MachineLearning #DynamicNetworks #ACL #Encoder Issue Date: 2023-07-18 GPT Summary- 動的ネットワークはモデルの表現力を向上させるが、完全に動的にすると冗長なパラメータと高いコストが生じる。本研究では、冗長な動的パラメータを静的パラメータに変換する部分的動的ネットワーク、PAD-Netを提案し、動的と静的パラメータを効率的に分割するIterative Mode Partitionを用いた。実験により、ResNet-50で動的パラメータを30%使用してトップ1精度を+0.7%向上、BERTで50%使用して言語理解のスコアを+1.9%改善した。コードは公開予定。
[Paper Note] Z-Code++: A Pre-trained Language Model Optimized for Abstractive Summarization, Pengcheng He+, arXiv'22, 2022.08
Paper/Blog Link My Issue
#DocumentSummarization #Abstractive #pretrained-LM #InstructionTuning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- Z-Code++は、抽象的テキスト要約のために最適化された新しい事前学習済み言語モデルで、性能向上のために3つの手法を採用。まず、2段階の事前学習プロセスで、言語理解と要約コーパスを活用して根拠あるテキスト生成を実現。次に、自己注意層をディスエンタンゲルド・アテンションに置き換え、最後にFusion-in-Encoderを用いて長い系列を階層的にエンコード。5言語の13タスク中9タスクで新たな最先端を達成し、パラメータ効率は高く、ゼロショット・少数ショットでも競合モデルを大幅に上回る性能を示す。
[Paper Note] Unnatural Instructions: Tuning Language Models with (Almost) No Human Labor, Or Honovich+, arXiv'22, 2022.12
Paper/Blog Link My Issue
#Dataset #InstructionTuning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- 指示チューニングを通じて、言語モデルが自然言語の説明から新しいタスクを実行できるようにするため、ほとんど人間の労力を要さずに収集した多様な指示データセット「Unnatural Instructions」を紹介。64,000の例を生成し約240,000例に拡張した実験では、ノイズが多いにもかかわらず、このデータセットでの学習が手動のキュレーションされたデータセットに匹敵し、T0++やTk-Instructよりも優れた性能を示した。これは、クラウドソーシングのコストを抑えたデータセットの拡張手法の有効性を示唆している。
[Paper Note] Pruning Pre-trained Language Models Without Fine-Tuning, Ting Jiang+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#LanguageModel #Pruning #ACL #needs-revision Issue Date: 2023-07-13 GPT Summary- プルーニングによる事前学習済み言語モデル(PLMs)の圧縮手法を提案。特にStatic Model Pruning(SMP)は、一階法の剪定のみでPLMsを下流タスクに適応させ、スパース性を達成。新たなマスキング関数と訓練目的関数を設計し、広範な実験で顕著な性能向上を示す。SMPはファインチューニングを不要とし、パラメータ効率が良好。
[Paper Note] Holistic Evaluation of Language Models, Percy Liang+, arXiv'22, 2022.11
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- HELMは、言語モデルの透明性を高めるための包括的評価手法である。まず、潜在的なシナリオと指標の分類を行い、欠落している部分を特定。次に、マルチ指標アプローチを採用し、コアシナリオごとに7つの評価指標を測定することで、正確性以外の側面も考慮。さらに、30の著名な言語モデルに対して大規模評価を実施し、評価範囲を17.9%から96.0%に改善。全データを公開し、HELMをコミュニティの生きたベンチマークとして継続的に更新していくことを目指している。 Comment
OpenReview: https://openreview.net/forum?id=iO4LZibEqW
HELMを提案した研究
当時のLeaderboardは既にdeprecatedであり、現在は下記を参照:
https://crfm.stanford.edu/helm/
[Paper Note] Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models, Aarohi Srivastava+, arXiv'22, 2022.06
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #TMLR #Selected Papers/Blogs #One-Line Notes #needs-revision Issue Date: 2023-07-03 GPT Summary- 言語モデルはスケールの拡大に伴い、新しい定量的・質的能力を示すが、その具体的な特性は未解明である。これを踏まえ、BIG-benchという新たなベンチマークを導入し、204の多様なタスクを評価。モデルの性能と較正は改善するが、絶対的には低く、スパース性の影響を受ける場合もある。特に、複数の手順を要するタスクは臨界規模での“ブレークスルー”を示す傾向があり、社会的バイアスは通常、スケールと共に増加するが、プロンプトによって改善可能である。 Comment
OpenReview: https://openreview.net/forum?id=uyTL5Bvosj
BIG-Bench論文。ワードクラウドとキーワード分布を見ると一つの分野に留まらない非常に多様なタスクが含まれることがわかる。
BIG-Bench-hardは、2024年にClaude3.5によって、Average Human Scoreが67.7%のところ、93.1%を達成され攻略が完了した。現在は最先端のモデル間の性能を差別化することはできない。
- Killed by LLM, R0bk
[Paper Note] Mass-Editing Memory in a Transformer, Kevin Meng+, arXiv'22, 2022.10
Paper/Blog Link My Issue
#LanguageModel #ICLR #KnowledgeEditing #needs-revision Issue Date: 2023-05-04 GPT Summary- 最近の研究は、大規模言語モデルの更新に新たな記憶を利用する可能性を示しているが、主に単一の関連付けに限定されています。我々はMEMITを開発し、複数の記憶を使ってモデルを直接更新する手法を提案します。実験的に、GPT-J(6B)およびGPT-NeoX(20B)に対して多数の関連付けを効果的に処理できることを示し、従来の方法を大幅に上回る成果を達成しました。
[Paper Note] Large Language Models are Zero-Shot Reasoners, Takeshi Kojima+, arXiv'22, 2022.05
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-04-27 GPT Summary- 大規模言語モデル(LLMs)は自然言語処理において少数ショット学習の能力が高く、CoT promptingにより複雑な多段階推論を効果的に引き出す。特に「Let's think step by step」の追加で、ゼロショット推論能力が向上し、様々な論理推論タスクで手作りの例を使わずに性能を大幅に向上させた。例えば、InstructGPTモデルでのMultiArithの精度が17.7%から78.7%へ、GSM8Kが10.4%から40.7%と劇的な改善が見られた。この研究はLLMsの潜在的なゼロショット能力を示し、ファインチューニングや少数ショットの前にその知識を探求する重要性が強調されている。 Comment
Zero-Shot CoT (Let's think step-by-step.)論文

Zero-Shot-CoTは2つのステップで構成される:
- STEP1: Reasoning Extraction
- 元のquestionをxとし、zero-shot-CoTのtrigger sentenceをtとした時に、テンプレート "Q: [X]. A. [T]" を用いてprompt x'を作成
- このprompt x'によって得られる生成テキストzはreasoningのrationaleとなっている。
- STEP2: Answer Extraction
- STEP1で得られたx'とzを用いて、テンプレート "[X'] [Z] [A]" を用いてpromptを作成し、quiestionに対する回答を得る
- このとき、Aは回答を抽出するためのtrigger sentenceである。
- Aはタスクに応じて変更するのが効果的であり、たとえば、multi-choice QAでは "Therefore, among A through E, the answer is" といったトリガーを用いたり、数学の問題では "Therefore, the answer (arabic numerals) is" といったトリガーを用いる。
# 実験結果
表中の性能指標の左側はタスクごとにAnswer Triggerをカスタマイズしたもので、右側はシンプルに"The answer is"をAnswer Triggerとした場合。Zero-shot vs. Zero-shot-CoTでは、Zero-Shot-CoTが多くのb現地マークにおいて高い性能を示している。ただし、commonsense reasoningではperformance gainを得られなかった。これは [Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
で報告されている通り、commonsense reasoningタスクでは、Few-Shot CoTでもLambda135Bで性能が向上せず、Palm540Bで性能が向上したように、モデルのparameter数が足りていない可能性がある(本実験では17種類のモデルを用いているが、特に注釈がなければtext-davinci-002を利用した結果)。
## 他ベースラインとの比較
他のベースラインとarithmetic reasoning benchmarkで性能比較した結果。Few-Shot-CoTには勝てていないが、standard Few-shot Promptingtを大幅に上回っている。
## zero-shot reasoningにおけるモデルサイズの影響
さまざまな言語モデルに対して、zero-shotとzero-shot-CoTを実施した場合の性能比較。[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
と同様にモデルサイズが小さいとZero-shot-CoTによるgainは得られないが、モデルサイズが大きくなると一気にgainが大きくなる。
## Zero-shot CoTにおけるpromptの選択による影響
input promptに対するロバスト性を確認した。instructiveカテゴリ(すなわち、CoTを促すトリガーであれば)性能が改善している。特に、どのようなsentenceのトリガーにするかで性能が大きくかわっている。今回の実験では、"Let's think step by step"が最も高い性能を占め最多。
## Few-shot CoTのprompt選択における影響
CommonsenseQAのexampleを用いて、AQUA-RAT, MultiArithをFew-shot CoTで解いた場合の性能。どちらのケースもドメインは異なるが、前者は回答のフォーマットは共通である。異なるドメインでも、answer format(multiple choice)の場合、ドメインが異なるにもかかわらず、zero-shotと比較して性能が大幅に向上した。一方、answer formatが異なる場合はperformance gainが小さい。このことから、LLMはtask自体よりも、exampleにおけるrepeated formatを活用していることを示唆している。また、CommonSennseをExamplarとして用いたFew-Shot-CoTでは、どちらのデータセットでもZero-Shot-CoTよりも性能が劣化している。つまり、Few-Shot-CoTでは、タスク特有のサンプルエンジニアリングが必要であることがわかる(一方、Zero-shot CoTではそのようなエンジニアリングは必要ない)。
[Paper Note] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, Jason Wei+, NeurIPS'22, 2022.01
Paper/Blog Link My Issue
#LanguageModel #Zero/Few/ManyShotPrompting #Chain-of-Thought #Prompting #NeurIPS #Selected Papers/Blogs #Surface-level Notes #EmergentAbilities Issue Date: 2023-04-27 GPT Summary- 思考の連鎖によって、大規模言語モデルの推論能力が向上することを探求。チェーン・オブ・ソート思考のプロンプトを用いる事例を示し、3つのモデルでの実験を通じて算術や常識、象徴的推論において性能向上を確認。特に、5400億パラメータのモデルに8つのデモをプロンプトとして与えただけで、数学問題のGSM8Kベンチマークで最先端の精度を達成した。 Comment
Chain-of-Thoughtを提案した論文。CoTをする上でパラメータ数が100B未満のモデルではあまり効果が発揮されないということは念頭に置いた方が良さそう。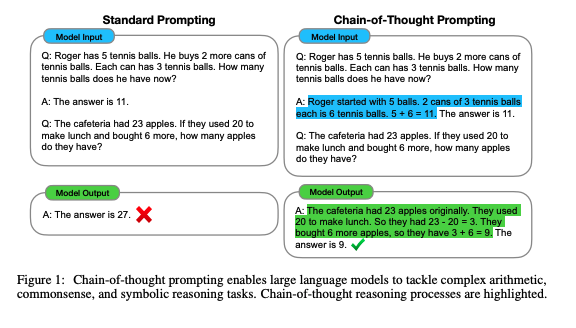
先行研究では、reasoningが必要なタスクの性能が低い問題をintermediate stepを明示的に作成し、pre-trainedモデルをfinetuningすることで解決していた。しかしこの方法では、finetuning用の高品質なrationaleが記述された大規模データを準備するのに多大なコストがかかるという問題があった。
このため、few-shot promptingによってこの問題を解決することが考えられるが、reasoning能力が必要なタスクでは性能が悪いという問題あがった。そこで、両者の強みを組み合わせた手法として、chain-of-thought promptingは提案された。
# CoTによる実験結果
以下のベンチマークを利用
- math word problem: GSM8K, SVAMP, ASDiv, AQuA, MAWPS
- commonsense reasoning: CSQA, StrategyQA, Big-bench Effort (Date, Sports), SayCan
- Symbolic Reasoning: Last Letter concatenation, Coin Flip
- Last Letter concatnation: 名前の単語のlast wordをconcatするタスク("Amy Brown" -> "yn")
- Coin Flip: コインをひっくり返す、 あるいはひっくり返さない動作の記述の後に、コインが表向きであるかどうかをモデルに回答するよう求めるタスク
## math word problem benchmark
- モデルのサイズが大きくなるにつれ性能が大きく向上(emergent ability)することがあることがわかる
- 言い換えるとCoTは<100Bのモデルではパフォーマンスに対してインパクトを与えない
- モデルサイズが小さいと、誤ったCoTを生成してしまうため
- 複雑な問題になればなるほど、CoTによる恩恵が大きい
- ベースラインの性能が最も低かったGSM8Kでは、パフォーマンスの2倍向上しており、1 stepのreasoningで解決できるSingleOpやMAWPSでは、性能の向上幅が小さい
- Task specificなモデルをfinetuningした以前のSoTAと比較してcomparable, あるいはoutperformしている
- 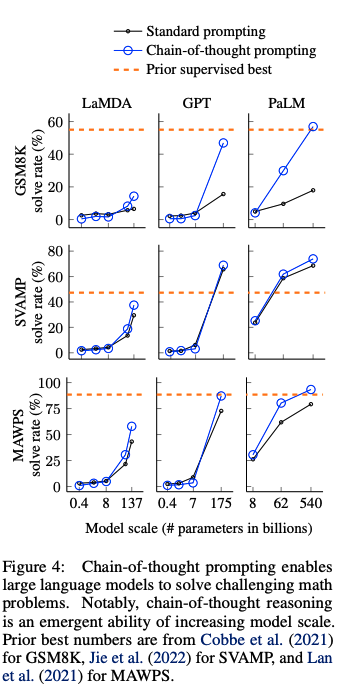
## Ablation Study
CoTではなく、他のタイプのpromptingでも同じような効果が得られるのではないか?という疑問に回答するために、3つのpromptingを実施し、CoTと性能比較した:
- Equation Only: 回答するまえに数式を記載するようなprompt
- promptの中に数式が書かれているから性能改善されているのでは?という疑問に対する検証
- => GSM8Kによる結果を見ると、equation onlyでは性能が低かった。これは、これは数式だけでreasoning stepsを表現できないことに起因している
- Variable compute only: dotのsequence (...) のみのprompt
- CoTは難しい問題に対してより多くの計算(intermediate token)をすることができているからでは?という疑問に対する検証
- variable computationとCoTの影響を分離するために、dotのsequence (...) のみでpromptingする方法を検証
- => 結果はbaselineと性能変わらず。このことから、variableの計算自体が性能向上に寄与しているわけではないことがわかる。
- Chain of Thought after answer: 回答の後にCoTを出力するようなprompting
- 単にpretrainingの際のrelevantな知識にアクセスしやすくなっているだけなのでは?という疑問を検証
- => baselineと性能は変わらず、単に知識を活性化させるだけでは性能が向上しないことがわかる。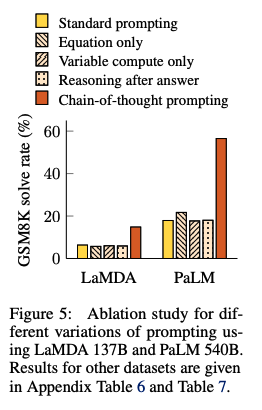
## CoTのロバスト性
人間のAnnotatorにCoTを作成させ、それらを利用したCoTpromptingとexamplarベースな手法によって性能がどれだけ変わるかを検証。standard promptingを全ての場合で上回る性能を獲得した。このことから、linguisticなstyleにCoTは影響を受けていないことがわかる。
# commonsense reasoning
全てのデータセットにおいて、CoTがstandard promptingをoutperformした。
# Symbolic Reasoning
in-domain test setとout-of-domain test setの2種類を用意した。前者は必要なreasoning stepがfew-shot examplarと同一のもの、後者は必要なreasoning stepがfew-shot examplarよりも多いものである。
CoTがStandard proimptingを上回っている。特に、standard promptingではOOV test setではモデルをスケールさせても性能が向上しなかったのに対し、CoTではより大きなgainを得ている。このことから、CoTにはreasoning stepのlengthに対しても汎化能力があることがわかる。
[Paper Note] Recurrent Memory Transformer, Aydar Bulatov+, NeurIPS'22, 2022.07
Paper/Blog Link My Issue
#LanguageModel #LongContext #NeurIPS #memory #KeyPoint Notes Issue Date: 2023-04-25 GPT Summary- メモリ機構を持つセグメントレベル再帰型トランスフォーマー(RMT)を提案。局所情報と全体情報を保存・処理し、長いシーケンス間で情報を伝達可能。特別なメモリトークンを追加することでTransformerモデルに変更を加えずに実装。実験結果では、RMTは短いメモリサイズでもTransformer-XLと同等の性能を示し、長いシーケンス処理では優れていることが確認。再帰的メモリトランスフォーマーは長期依存関係の学習に対する有望なアーキテクチャ。 Comment
TransformerはO(N^2)であり、計算量がNに応じて指数関数的に増加してしまう。一方、sequenceの情報を全てN次元ベクトルに集約しなければならず、計算量の制約によって長い系列のRepresentationを獲得できない。
そこで、Transformerの構造は変えず、Inputにメモリtokenを追加することで、メモリ間の関係性を学習できるような手法を提案。長いトークン列に対しても、トークン列をセグメントとゆばれる単位に区切り、セグメントのInputの頭で、前断のセグメントのメモリtokenを入力し、最終的に現在のセグメントのメモリをoutputし、後断のセグメントに入力とする、といったことを繰り返すことで、長い系列も扱えるようにした。
セグメントをまたいでbackpropagationをかけることで、たとえセグメントとしては独立していても、メモリの情報を考慮することでセグメント間の依存関係を学習することが可能だと思われる。
openreview: https://openreview.net/forum?id=Uynr3iPhksa
[Paper Note] UnifiedSKG: Unifying and Multi-Tasking Structured Knowledge Grounding with Text-to-Text Language Models, Tianbao Xie+, EMNLP'22, 2022.01
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #MultitaskLearning #PEFT(Adaptor/LoRA) #EMNLP #Encoder-Decoder #Grounding Issue Date: 2022-12-05 GPT Summary- UnifiedSKGフレームワークを提案し、21の構造化知識のグラウンディング(SKG)タスクをテキスト対テキスト形式に統合。これにより、体系的なSKG研究を促進し、異なるサイズのT5で最先端の性能を達成。マルチタスクチューニングが性能向上に寄与し、SKGのゼロショットおよび少数ショット学習における課題を示した。UnifiedSKGは他のタスクへの拡張も可能で、オープンソースとして公開されている。
[Paper Note] JaQuAD: Japanese Question Answering Dataset for Machine Reading Comprehension, ByungHoon So+, arXiv'22, 2022.02
Paper/Blog Link My Issue
#Dataset #QuestionAnswering #One-Line Notes Issue Date: 2022-02-07 GPT Summary- 日本語の質問応答データセットJaQuADを提案。39,696の質問-回答ペアを含み、テストセットでF1スコア78.92%、EMスコア63.38%を達成したベースラインモデルをファインチューニング。データセットは公開中。 Comment
SQuAD likeな日本語のQAデータセット
https://github.com/SkelterLabsInc/JaQuAD
Improving Neural Machine Translation with Compact Word Embedding Tables, Kumar+, AAAI'22
Paper/Blog Link My Issue
#NeuralNetwork #MachineTranslation #Embeddings #AAAI #Initial Impression Notes Issue Date: 2021-06-07 Comment
NMTにおいてword embeddingがどう影響しているかなどを調査しているらしい
[Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
Paper/Blog Link My Issue
#LanguageModel #One-Line Notes #Scalability Issue Date: 2026-07-09 GPT Summary- 言語モデリングは大規模な知識リポジトリを活用し、世界の理解を深化させる。本研究では、数千万から2,800億パラメータのTransformerベースのモデルGopherの性能を分析し、152の多様なタスクで最先端を達成。特に、読解や事実確認でスケールの利得が大きいが、論理的推論には限界がある。モデルの挙動やばイアス、危害の交差を総合的に評価し、AIの安全性に向けた適用と害の軽減についても考察。 Comment
- [Paper Note] Scaling Language Models: Methods, Analysis & Insights from Training Gopher, Jack W. Rae+, arXiv'21, 2021.12
- 大規模言語モデルの次期バージョンPLaMo 3シリーズにおける120B事前学習モデル、31B蒸留モデルの評価, PFN, 2026.07
で利用されている weight reusingについて、`G3.3 Warm starting` に記載されている。概要としては
- LLMのキャパシティを増大させる際に、幅をスケーリングさせるよりも、深さをスケーリングさせる方が有望な結果となった
### 深さのスケーリング方法のbest practice
- 深さをスケーリングさせる、すなわち、5 layer -> 7 layerに拡張したい、という場合は、元の学習済みレイヤーを以下のルールによって複製することによって、拡張する:
- `round_int(range(num_layers_new)/num_layers_new * num_layers_old)`
- たとえば、`A B C D E` の5つのレイヤーで構成されているモデルがあったときに、これを7 layerに拡張したい場合は、上記indexに従って7つのレイヤーに学習済みレイヤーを割り当てると、`A B B C D D E` となる。
### 幅のスケーリング方法のbest practice
- (widthの拡張方法については正しく読めているかかなり自信がなく、間違っている可能性が非常に高いので注意)
- 幅をスケーリングさせる際は、MHA の weight matrices に対して列方向のコピー→行方向のコピー→ ノイズの注入を行う。
- 前提として以下を考える:
- MHAのQKV, outputのprojectionをそれぞれ、`W_q \in R^{d_model \times d_k}`, `W_k \in R^{d_model \times d_k}`, `W_v \in R^{d_model \times d_v}`, `W_o \in R^{h d_v \times d_model}` とする。
- このとき、オリジナルのtransformer論文では、`d_k = d_v = d_model/h` としている。
- つまり、各headに対応するW_{q, k, v, o}を列方向にconcatした行列 W^concat_{q, k, v, o}を考えると、列方向がh倍されるので、`W^concat_{q, k, v, o} \in R^{d_model \times d_model}` の正方行列で表現できる。ここで、`h * d_v= h * d_k= h * d_model/h = d_model` を用いた。
- この `W^{concat}_{*}` に対する操作を定義することで、multihead attentionが扱う幅を変更することができる。
- 元論文では、weight matricesと一言で言及されているが、これは(おそらく)`W^{concat}_{q, k, v, o}` のことを指していると思われる。実際、説明をする際は正方行列を前提に考えている(attention headごとに独立して考える元論文の数式では正方行列は weight matrices に出現しない)。
- まず `W^{concat}_{*}` において、head sizeをH, head数をnとしたときに、`nH \times nH` の行列を列方向にtilingすることによってattention headの数をmに拡張する。このとき、`d_k`, `d_v` のサイズは固定する。たとえば、head数をnからmに増やす際、最初のm-n個のheadを `W^{concat}_{*}` の右側に複製することによって拡張する、と説明されている。
- これはすなわち、個々のheadが扱う情報量は変化させずに、代わりにhead数を増やすことでスケーリングさせる、ということを指していると考えられる。
- 続いて、head数が増えたことによって `W^{concat}_{*}` が正方行列ではなくなった。これが正方行列になっていないとattentionの前後でbottleneck activation size(元論文ではd_modelのことをbottleneck activation sizeと呼称している)が変化してしまうので、正方行列にしなければならない。
- これを正方行列にするために、列方向に複製した行列の上端から数えて `(m-n) * d_k` 行分を行方向にconcatする。
- 最終的に、新たに初期化された重みに対してノイズを注入する。
- これによって構築された `W^{concat}_{*}` を図示したものが、下記Figure A32 と思われる。
- また、上記ではMHAの説明をしたが、MLPなどのd_modelが関わる各種weight matricesもwidthの拡張に含まれていると考えられる(じゃないとwidthの拡張と呼べないし)。
- optimizerの状態は再初期化して学習を実施する。
- Adam optimizerの状態に対して似たような処理を実施したが性能向上にはつながらなかった
[Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #read-later #Selected Papers/Blogs #LinearAttention Issue Date: 2026-04-22 GPT Summary- 線形化された自己注意機構とファストウェイト・コントローラの等価性を示し、遅いニューラルネットがファストウェイトをプログラムする方法を探る。FWPは有限メモリの操作を学習し、注意機構のメモリ容量限界を改善するために、加法的外積を用いたプログラミング命令を導入。動的学習率の計算も学習し、新しいカーネル関数を提案。合成リトリーバル問題や機械翻訳、言語モデリングタスクにおける利点を実験で示した。 Comment
Linear TransformerにおけるKV^Tを加算する固定された状態更新ではなく、差分だけを更新するDelta Ruleによって更新する Delta Networkを提案。
(まだ全然読めていないのでしっかり読みたい)
DeltaNet図解:
[Paper Note] Primer: Searching for Efficient Transformers for Language Modeling, David R. So+, NIPS'21, 2021.09
Paper/Blog Link My Issue
#EfficiencyImprovement #LanguageModel #Transformer #Architecture #Selected Papers/Blogs #ActivationFunction #One-Line Notes Issue Date: 2026-02-16 GPT Summary- 大規模なTransformerモデルのコスト削減を目指し、プリミティブに基づく低レベルの探索を行い、Primerアーキテクチャを提案。これにより、自己回帰型言語モデリングで訓練コストを大幅に削減。具体的にはReLU活性化関数の二乗化と深さ方向の畳み込み層追加が主な改善点。実験により、計算規模が大きくなるほどPrimerの利得が増加し、特に5億パラメータの設定で元のT5アーキテクチャに対し4分の1のコストで改善を確認。また、19億パラメータ設定でも、訓練資源を大幅に削減しながら同等の性能を実現。再現性を考慮し、モデルをオープンソース化。 Comment
nanochat speedrunを改善させたReLU^2を提案しているとのこと
QKV projectionの後にshort convolutionsを導入するアーキテクチャも提案されている
[Paper Note] Structured Denoising Diffusion Models in Discrete State-Spaces, Jacob Austin+, NeurIPS'21, 2021.07
Paper/Blog Link My Issue
#DiffusionModel #NeurIPS #read-later #Selected Papers/Blogs Issue Date: 2025-11-04 GPT Summary- 離散デノイジング拡散確率モデル(D3PMs)を提案し、連続状態空間のDDPMsを一般化。汚染プロセスを超えた遷移行列を導入し、画像とテキスト生成の改善を実現。新しい損失関数を用いて、LM1Bでの文字レベルのテキスト生成やCIFAR-10での画像生成において優れた結果を達成。 Comment
openreview: https://openreview.net/forum?id=h7-XixPCAL
離散拡散モデルを提案した研究
- Masked Diffusion Modelの進展, Deep Learning JP, 2025.03
で紹介されている
[Paper Note] ALFWorld: Aligning Text and Embodied Environments for Interactive Learning, Mohit Shridhar+, ICLR'21, 2020.10
Paper/Blog Link My Issue
#MachineLearning #Dataset #ReinforcementLearning #Evaluation #EmbodiedAI #text Issue Date: 2025-10-26 GPT Summary- ALFWorldは、エージェントが抽象的なテキストポリシーを学び、視覚環境で具体的な目標を実行できるシミュレーターである。これにより、視覚的環境での訓練よりもエージェントの一般化が向上し、問題を分解して各部分の改善に集中できる設計を提供する。 Comment
openreview: https://openreview.net/forum?id=0IOX0YcCdTn
pj page: https://alfworld.github.io
[Paper Note] MiniLMv2: Multi-Head Self-Attention Relation Distillation for Compressing Pretrained Transformers, Wenhui Wang+, ACL'21 Findings, 2020.12
Paper/Blog Link My Issue
#Transformer #Attention #Distillation #ACL #Encoder #Findings #KeyPoint Notes Issue Date: 2025-10-20 GPT Summary- 自己注意関係蒸留を用いて、MiniLMの深層自己注意蒸留を一般化し、事前学習されたトランスフォーマーの圧縮を行う手法を提案。クエリ、キー、バリューのベクトル間の関係を定義し、生徒モデルを訓練。注意ヘッド数に制限がなく、教師モデルの層選択戦略を検討。実験により、BERTやRoBERTa、XLM-Rから蒸留されたモデルが最先端の性能を上回ることを示した。 Comment
教師と(より小規模な)生徒モデル間で、tokenごとのq-q/k-k/v-vのdot productによって形成されるrelation map(たとえばq-qの場合はrelatiok mapはトークン数xトークン数の行列で各要素がdot(qi, qj))で表現される関係性を再現できるようにMHAを蒸留するような手法。具体的には、教師モデルのQKVと生徒モデルのQKVによって構成されるそれぞれのrelation map間のKL Divergenceを最小化するように蒸留する。このとき教師モデルと生徒モデルのattention heads数などは異なってもよい(q-q/k-k/v-vそれぞれで定義されるrelation mapははトークン数に依存しており、head数には依存していないため)。
[Paper Note] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer, Greg Yang+, NeurIPS'21
Paper/Blog Link My Issue
#EfficiencyImprovement #Pretraining #LanguageModel #Transformer #NeurIPS #read-later #HyperparameterTransfer #One-Line Notes Issue Date: 2025-08-28 GPT Summary- ハイパーパラメータチューニングは高コストであり、特に大規模なニューラルネットワークにおいて負担が大きい。新たに提案するmuTransferは、最大更新パラメータ化(muP)を利用し、小さなモデルでチューニングしたHPをフルサイズモデルにゼロショットで転送する手法である。実験により、1300万パラメータのモデルからBERT-largeを超える性能を達成し、4000万パラメータからはGPT-3を上回る結果を得た。チューニングコストはそれぞれ事前学習コストの同等または7%に抑えられた。 Comment
openreview: https://openreview.net/forum?id=Bx6qKuBM2AD
小規模なモデルに対してハイパーパラメータのチューニングを実施し、同様のベースモデルで、**各layerのwidthが大きいもの**に対しても、小規模モデルで最適であったハイパーパラメータをzero-shotで転移することで near optimalなハイパーパラメータで学習できるmu Transferを提案。
モデルの深さ(以外にも下表中の*印のパラメータ)に対しても限定的に転移可能な模様。Post-Layer NormのTransformerやではあまりうまくいかないことが11節に記述されている(実験はpre-Layer Norm Transformer, ResNetに対して行われている模様)。
また、6.1節では、(実験的に)利用する小規模モデルのスケールとして幅256, 深さ4, バッチサイズ32, sequence長128, 訓練ステップ数5000を最低満たしており、かつスケールさせる幅が妥当な範囲内である必要がある、といった話が記述されている。
前提知識(muP)や条件が多そうな気がするので、しっかり確認した方がよさそう。
たとえば、muPで初期化されている必要があることや、転送可能なハイパーパラメータに限りがある(e.g. 学習率)、異なるデータに対するfinetuningなどは転送できないなど。
muP:
- [Paper Note] Feature Learning in Infinite-Width Neural Networks, Greg Yang+, ICML'21
[Paper Note] Program Synthesis with Large Language Models, Jacob Austin+, arXiv'21
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- 本論文では、汎用プログラミング言語におけるプログラム合成の限界を大規模言語モデルを用いて評価します。MBPPとMathQA-Pythonの2つのベンチマークで、モデルサイズに対する合成性能のスケールを調査。最も大きなモデルは、少数ショット学習でMBPPの59.6%の問題を解決可能で、ファインチューニングにより約10%の性能向上が見られました。MathQA-Pythonでは、ファインチューニングされたモデルが83.8%の精度を達成。人間のフィードバックを取り入れることでエラー率が半減し、エラー分析を通じてモデルの弱点を明らかにしました。最終的に、プログラム実行結果の予測能力を探るも、最良のモデルでも特定の入力に対する出力予測が困難であることが示されました。 Comment
代表的なコード生成のベンチマーク。
MBPPデータセットは、promptで指示されたコードをモデルに生成させ、テストコード(assertion)を通過するか否かで評価する。974サンプル存在し、pythonの基礎を持つクラウドワーカーによって生成。クラウドワーカーにタスクdescriptionとタスクを実施する一つの関数(関数のみで実行可能でprintは不可)、3つのテストケースを記述するよう依頼。タスクdescriptionは追加なclarificationなしでコードが記述できるよう十分な情報を含むよう記述するように指示。ground truthの関数を生成する際に、webを閲覧することを許可した。
MathQA-Pythonは、MathQAに含まれるQAのうち解答が数値のもののみにフィルタリングしたデータセットで、合計で23914サンプル存在する。pythonコードで与えられた数学に関する問題を解くコードを書き、数値が一致するか否かで評価する、といった感じな模様。斜め読みなので少し読み違えているかもしれない。
[Paper Note] Evaluating Large Language Models Trained on Code, Mark Chen+, arXiv'21
Paper/Blog Link My Issue
#Dataset #LanguageModel #Evaluation #CodeGeneration #Selected Papers/Blogs Issue Date: 2025-08-15 GPT Summary- CodexはGitHubのコードでファインチューニングされたGPT言語モデルで、Pythonコード生成能力を評価。新しい評価セットHumanEvalでは、Codexが28.8%の問題を解決し、GPT-3は0%、GPT-Jは11.4%だった。繰り返しサンプリングが難しいプロンプトに対しても効果的な戦略を用い、70.2%の問題を解決。モデルの限界として、長い操作の説明や変数へのバインドに苦労する点が明らかに。最後に、コード生成技術の影響について安全性や経済に関する議論を行う。 Comment
HumanEvalデータセット。Killed by LLMによると、GPT4oによりすでに90%程度の性能が達成され飽和している。
164個の人手で記述されたprogrammingの問題で、それぞれはfunction signature, docstring, body, unittestを持つ。unittestは問題当たり約7.7 test存在。handwrittenという点がミソで、コンタミネーションの懸念があるためgithubのような既存ソースからのコピーなどはしていない。pass@k[^1]で評価。
[^1]: k個のサンプルを生成させ、k個のサンプルのうち、サンプルがunittestを一つでも通過する確率。ただ、本研究ではよりバイアスをなくすために、kよりも大きいn個のサンプルを生成し、その中からランダムにk個を選択して確率を推定するようなアプローチを実施している。2.1節を参照のこと。
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, EMNLP'21
Paper/Blog Link My Issue
#Analysis #Transformer #EMNLP #Selected Papers/Blogs #FactualKnowledge Issue Date: 2025-07-04 GPT Summary- フィードフォワード層はトランスフォーマーモデルの大部分を占めるが、その役割は未探求。研究により、フィードフォワード層がキー・バリュー・メモリとして機能し、トレーニング例のテキストパターンと相関することを示す。実験で、下層は浅いパターン、上層は意味的なパターンを学習し、バリューが出力分布を誘導することが確認された。最終的に、フィードフォワード層の出力はメモリの合成であり、残差接続を通じて洗練される。 Comment
日本語解説(p.5より): https://speakerdeck.com/kogoro/knowledge-neurons-in-pretrained-transformers-for-snlp2022?slide=5
[Paper Note] Editing Factual Knowledge in Language Models, Nicola De Cao+, EMNLP'21
Paper/Blog Link My Issue
#LanguageModel #EMNLP #KnowledgeEditing Issue Date: 2025-06-18 GPT Summary- KnowledgeEditorは、事前学習された言語モデルの知識を編集し、再学習なしで誤った事実や予測を修正する手法です。制約最適化を用いてハイパーネットワークを訓練し、他の知識に影響を与えずに事実を修正します。BERTとBARTのモデルでその有効性を示し、特定のクエリに基づく予測変更がパラフレーズにも一貫して影響を与えることを確認しました。ハイパーネットワークは、知識操作に必要なコンポーネントを特定する「プローブ」として機能します。
[Paper Note] Training Verifiers to Solve Math Word Problems, Karl Cobbe+, arXiv'21, 2021.10
Paper/Blog Link My Issue
#Dataset #LanguageModel #Supervised-FineTuning (SFT) #Mathematics #Selected Papers/Blogs #Verification #needs-revision Issue Date: 2024-12-27 GPT Summary- 最先端の言語モデルは数学的推論に課題があり、GSM8Kという8,500件の小学生向け数学問題データセットを導入してその失敗を診断。特に、最大規模のトランスフォーマーモデルでも性能向上が難しいことを示す。モデルの補完の正しさを評価する検証器を訓練し、候補解を生成して最も高く評価されたものを選択する方法を提案。検証がGSM8Kの性能を大幅に向上させ、ファインチューニングよりも効果的にスケールすることを実証。 Comment
## 気持ち
- 当時の最も大きいレベルのモデルでも multi-stepのreasoningが必要な問題は失敗する
- モデルをFinetuningをしても致命的なミスが含まれる
- 特に、数学は個々のミスに対して非常にsensitiveであり、一回ミスをして異なる解法のパスに入ってしまうと、self-correctionするメカニズムがauto-regressiveなモデルではうまくいかない
- 純粋なテキスト生成の枠組みでそれなりの性能に到達しようとすると、とんでもないパラメータ数が必要になり、より良いscaling lawを示す手法を模索する必要がある
## Contribution
論文の貢献は
- GSM8Kを提案し、
- verifierを活用しモデルの複数の候補の中から良い候補を選ぶフレームワークによって、モデルのパラメータを30倍にしたのと同等のパフォーマンスを達成し、データを増やすとverifierを導入するとよりよく性能がスケールすることを示した。
- また、dropoutが非常に強い正則化作用を促し、finetuningとverificationの双方を大きく改善することを示した。
Todo: 続きをまとめる
Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning, Armen Aghajanyan+, N_A, ACL'21
Paper/Blog Link My Issue
#Analysis #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #One-Line Notes Issue Date: 2024-10-01 GPT Summary- 事前学習された言語モデルのファインチューニングのダイナミクスを内因次元の観点から分析し、少ないデータでも効果的に調整できる理由を説明。一般的なモデルは低い内因次元を持ち、フルパラメータ空間と同等の効果を持つ低次元の再パラメータ化が可能であることを示す。特に、RoBERTaモデルを用いて、少数のパラメータの最適化で高いパフォーマンスを達成できることを実証。また、事前学習が内因次元を最小化し、大きなモデルが低い内因次元を持つ傾向があることを示し、内因次元に基づく一般化境界を提案。 Comment
ACL ver: https://aclanthology.org/2021.acl-long.568.pdf
下記の元ポストを拝読の上論文を斜め読み。モデルサイズが大きいほど、特定の性能(論文中では2種類のデータセットでの90%のsentence prediction性能)をfinetuningで達成するために必要なパラメータ数は、モデルサイズが大きくなればなるほど小さくなっている。
LoRAとの関係性についても元ポスト中で言及されており、論文の中身も見て後で確認する。
おそらく、LLMはBERTなどと比較して遥かにパラメータ数が大きいため、finetuningに要するパラメータ数はさらに小さくなっていることが想像され、LoRAのような少量のパラメータをconcatするだけでうまくいく、というような話だと思われる。興味深い。
元ポスト:
[Paper Note] Transformer Feed-Forward Layers Are Key-Value Memories, Mor Geva+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #Transformer #One-Line Notes Issue Date: 2024-07-11 GPT Summary- トランスフォーマーモデルのフィードフォワード層は、キー・バリューメモリとして機能し、学習されたパターンが人間に解釈可能であることや、上位層がより意味のあるパターンを学習することが示されました。さらに、出力分布を誘導する役割も持ちます。フィードフォワード層の出力はそのメモリの合成であり、残差接続を介してモデルの層を通じて洗練され、最終的な出力分布を生成します。 Comment
関連:
- 大規模言語モデルにおいて、「知識は全結合層に蓄積される」という仮説についての文献調査, Kan Hatakeyama, 2023.10
FF layerがKey-Valueストアとして機能する仕組みの概略図
実際に特定のKeyと最も関連度が高い訓練事例(input)を抽出し、人間がinputのパターンを分類した結果
[Paper Note] RoFormer: Enhanced Transformer with Rotary Position Embedding, Jianlin Su+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#LanguageModel #Transformer #PositionalEncoding #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2024-05-24 GPT Summary- 位置エンコーディングはトランスフォーマーにおいて重要な役割を果たし、依存関係をモデル化するための監督信号を提供する。本研究では、トランスフォーマーに位置情報を組み込む手法を検討し、新たに提案するロータリーポジションエンベディング(RoPE)が絶対位置を回転行列でエンコードして相対位置依存性を取り入れることを示す。RoPEはシーケンス長の柔軟性や相対距離の増加に伴う依存性の減衰などの特性を持ち、強化済みトランスフォーマー(RoFormer)の評価は他の手法を一貫して上回ることを示している。RoFormerはHuggingfaceに統合済み。 Comment
RoPEを提案した論文
# Absolute Position Embedding と Relative Position Embedding
## TransformerにおけるQKVベクトルの計算方法
一般に、Transformerにおける Query (Q), Key (K), Value (V) は以下の式で定式化される:
m, nはそれぞれ位置を表す整数。Absolute Position Embeddingと、Relative Position Embeddingは、関数fの設計がそれぞれ異なっている:
## Absolute Position Embedding
absolute position embeddingは、固定されたposition ベクトル、あるいはtrainableなposition ベクトルpを、入力ベクトルに対して足し合わせる:
## Relative Position Embedding
一方、Relative Position Embeddingは、Queryの位置に対する、Key, Valueの相対位置(つまり、mとnの差)に対して、trainableなベクトル \tilde{p}_r をKey, Valueおよび相対距離rごとに用意し、そのベクトルを入力に足し合わせる、という定式化となっている:
ここで、r = clip(m-n, r_max, r_min)であり、r_max, r_minは考慮する相対距離の最大値と最小値である。
他にも様々な定式化が提案されているがたいてい定式化の中に相対位置m-nが出現する。
## RoPE
RoPEでは、入力Query, Keyベクトル(Q,K)に対して回転行列を適用することで、回転に対して位置情報を保持させる。具体的には、異なる位置m, nに対するq_m^T k_nを計算すると、回転行列をRとした場合式16に示されているように回転行列Rに相対位置m-nが現れ(るように設計されており)、相対位置を考慮したqkの計算になっている。[^1]
[^1]: (R_mq_m)^T R_nK_n = q_m^T (R_m^T R_n) k_n = q_m^T (R_{-m}R_n) k_n = q_m^T R_{n-m} k_n. ここで、R_m^T = R_{-m}であり、R_m R_n = R_{m+n}の性質を使っている。
RoPEは下記のような性質を持つ:
- long-term decay: θi = 10000−2i/d と設定することにより、相対位置が離れているトークンのベクトルとのinner productの値が小さくなる。すなわち、位置が離れているトークン間の依存関係が小さくなる。
- Linear-Attention: RoPEは回転行列であり、乗算後のベクトルのノルムを変化させない。このため、Linear Attentionの式の中に回転行列を組み込むことで、Linear Attentionと簡単に組み合わせることが可能
Absolute Position Embedding, Relative Position Embeddingでは、ベクトルに対して位置情報を加算する定式化で K, Vの計算時に位置情報を考慮していたため、Linear Attentionの計算そのものに位置情報を組み込んだ定式化とはなっていなかった。
が、RoPEでは回転行列を乗算する定式化であり、ノルムを変化させないのでLinear Attentionの定式化に組み込むことができる。このため、モデルのアーキテクチャを大きく変更しなくとも組み込める。
RoPE自体は実装にパラメータを必要としないが、モデルのその他のパラメータがRoPEに適用できるように学習されていないと適用できないであろう点には注意(事前学習時にRoPEが使われていれば話は別)。
- 国産生成AI PLaMoを支える事後学習と推論最適化, PFN, 2026.04
pp.22--23がRoPEを簡潔に説明しており分かりやすい
The Perils of Using Mechanical Turk to Evaluate Open-Ended Text Generation, Marzena Karpinska+, N_A, EMNLP'21
Paper/Blog Link My Issue
#Analysis #NaturalLanguageGeneration #Evaluation #Annotation #Reproducibility #KeyPoint Notes Issue Date: 2024-05-15 GPT Summary- 最近のテキスト生成の研究は、オープンエンドのドメインに注力しており、その評価が難しいため、多くの研究者がクラウドソーシングされた人間の判断を収集してモデリングを正当化している。しかし、多くの研究は重要な詳細を報告しておらず、再現性が妨げられていることがわかった。さらに、労働者はモデル生成のテキストと人間による参照テキストを区別できないことが発見され、表示方法を変更することで改善されることが示された。英語教師とのインタビューでは、モデル生成のテキストを評価する際の課題について、より深い洞察が得られた。 Comment
Open-endedなタスクに対するAMTの評価の再現性に関する研究。先行研究をSurveyしたところ、再現のために重要な情報(たとえば、workerの資格、費用、task descriptions、annotator間のagreementなど)が欠落していることが判明した。
続いて、expertsとAMT workerに対して、story generationの評価を実施し、GPT2が生成したストーリーと人間が生成したストーリーを、後者のスコアが高くなることを期待して依頼した。その結果
- AMTのratingは、モデルが生成したテキストと、人間が生成したテキストをreliableに区別できない
- 同一のタスクを異なる日程で実施をすると、高い分散が生じた
- 多くのAMT workerは、評価対象のテキストを注意深く読んでいない
- Expertでさえモデルが生成したテキストを読み判断するのには苦戦をし、先行研究と比較してより多くの時間を費やし、agreementが低くなることが分かった
- [Paper Note] Can Large Language Models Be an Alternative to Human Evaluations?, Cheng-Han Chiang+, ACL'23, 2023.05
において、低品質なwork forceが人手評価に対して有害な影響を与える、という文脈で本研究が引用されている
[Paper Note] Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation, Markus Freitag+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#MachineTranslation #Analysis #NaturalLanguageGeneration #Metrics #Evaluation #One-Line Notes Issue Date: 2024-01-25 GPT Summary- 機械翻訳の人間評価は難しく、標準的な手法が不足している。そこで、誤り分析に基づく評価方法論を提案し、MQMフレームワークを用いてWMT 2020の上位システム出力をプロの翻訳者による注釈で評価。分析の結果、WMTクラウドワーカーのランキングと異なる結果が得られ、人間が機械出力よりも人間の出力を好む傾向を示した。さらに、自動指標がクラウドワーカーよりも優れたことも判明し、研究用コーパスを公開。 Comment
embedding basedなNLGの性能指標が、意味の等価性や流暢性を評価できる一方、適用範囲が限定的で柔軟性に欠けることを示した研究
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision, Wonjae Kim+, N_A, ICML'21
Paper/Blog Link My Issue
#ComputerVision #EfficiencyImprovement #Pretraining #LanguageModel #Transformer #MultiModal Issue Date: 2023-08-22 GPT Summary- VLP(Vision-and-Language Pre-training)のアプローチは、ビジョンと言語のタスクでのパフォーマンスを向上させているが、現在の方法は効率性と表現力の面で問題がある。そこで、本研究では畳み込みフリーのビジョンと言語のトランスフォーマ(ViLT)モデルを提案する。ViLTは高速でありながら競争力のあるパフォーマンスを示し、コードと事前学習済みの重みはGitHubで利用可能である。 Comment
SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Tools #Dataset #Evaluation #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2023-08-13 Comment
自動評価指標が人手評価の水準に達しないことが示されており、結局のところROUGEを上回る自動性能指標はほとんどなかった。human judgmentsとのKendall;'s Tauを見ると、chrFがCoherenceとRelevance, METEORがFluencyで上回ったのみだった。また、LEAD-3はやはりベースラインとしてかなり強く、LEAD-3を上回ったのはBARTとPEGASUSだった。
How to Evaluate a Summarizer: Study Design and Statistical Analysis for Manual Linguistic Quality Evaluation, Steen+, EACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 要約システムの評価方法についての調査結果を報告しました。要約の言語的品質についての評価実験を行い、最適な評価方法は側面によって異なることを示しました。また、研究パラメータや統計分析方法についても問題点を指摘しました。さらに、現行の方法では固定された研究予算の下では信頼性のある注釈を提供できないことを強調しました。 Comment
要約の人手評価に対する研究
Reliability of Human Evaluation for Text Summarization: Lessons Learned and Challenges Ahead, Iskender+, EACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Evaluation Issue Date: 2023-08-13 GPT Summary- 人間評価の信頼性に関する研究では、参加者の情報や実験の詳細が提供されていないことが多い。また、人間評価の信頼性に影響を与える要因についても研究されていない。そこで、私たちは人間評価実験を行い、参加者の情報や実験の詳細を提供し、異なる実験結果を比較した。さらに、専門家と非専門家の評価の信頼性を確保するためのガイドラインを提供し、信頼性に影響を与える要因を特定した。 Comment
要約の人手評価に対する信頼性に関して研究。人手評価のガイドラインを提供している。
The Feasibility of Embedding Based Automatic Evaluation for Single Document Summarization, EMNLP-IJCNLP'21, Sun+
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #EMNLP #IJCNLP Issue Date: 2023-08-13 Comment
C-ELMO/C-SBERT
A Training-free and Reference-free Summarization Evaluation Metric via Centrality-weighted Relevance and Self-referenced Redundancy, Chen+, ACL-IJCNLP'21
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #ACL #IJCNLP Issue Date: 2023-08-13
[Paper Note] QuestEval: Summarization Asks for Fact-based Evaluation, Thomas Scialom+, arXiv'21, 2021.03
Paper/Blog Link My Issue
#DocumentSummarization #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #QA-based #EMNLP #KeyPoint Notes #needs-revision Issue Date: 2023-08-13 GPT Summary- 要約評価の課題に対し、QuestEvalという新たなフレームワークを提案。ROUGEやBERTScoreに依存せず、人間の判断との相関を四つの次元(整合性、一貫性、流暢さ、関連性)において向上させることを実験で示した。 Comment
QuestEval
# 概要
SummEval: Re-evaluating Summarization Evaluation, Fabbri+, TACL'21
によって提案されてきたメトリックがROUGEに勝てていないことについて言及し、より良い指標を提案。
- precision / recall-based な QA metricsを利用してよりロバスト
- 生成されるqueryのsaliencyを学習する手法を提案することで、information selectionの概念を導入した
- CNN/Daily Mail, XSUMで評価した結果、SoTAな結果を獲得し、特にFactual Consistencyの評価に有用なことを示した
# Question-based framework
prerainedなT5を利用しQAに回答するcomponent(question, Textがgivenな時answerを生成するモデル)を構築する。text Tに対するquery qに対してrと回答する確率をQ_A(r|T, q)とし、Q_A(T, q)をモデルによってgreedyに生成された回答とする。Questionが与えられた時、Summary内に回答が含まれているかは分からない。そのため、unanswerable token εもQA componentに含める。
QG componentとしては、answer-source documentが与えられたときに人間が生成したquestionを生成できるようfinetuningされたT5モデルを利用する。テスト時は、ソースドキュメントと、システム要約がgivenなときに、はじめにQG modelを条件付けするためのanswerのsetを選択する。Asking and Answering Questions to Evaluate the Factual Consistency of Summaries, Wang, ACL'20
にならい、ソースドキュメントの全ての固有名詞と名詞をanswerとみなす。そして、それぞれの選択されたanswerごとに、beam searchを用いてquestionを生成する。そして、QAモデルが誤った回答をした場合、そのようなquestionはフィルタリングする。text Tにおいて、Q_A(T, q) = rとなるquestion-answer pairs (q, r)の集合を、Q_G(T)と表記する。
# QuestEval metric
## Precision
source documentをD, システム要約をSとしたときに、Precision, Recallを以下の式で測る:
question生成時は要約から生成し、生成されたquestionに回答する際はsource documentを利用し、回答の正誤に対してF1スコアを測定する。F1スコアは、ground truthと予測された回答を比較することによって測定され、回答がexact matchした場合に1, common tokenが存在しない場合に0を返す。D, Sで条件付けされたときに、回答が変わってしまう場合は要約がinconsistentだとみなせる、というintuitionからきている。
## Recall
要約はfactual informationを含むべきのみならず(precision)、ソーステキストの重要な情報を含むべきである(recall)。Answers Unite! Unsupervised Metrics for Reinforced Summarization Models, Scialom+, EMNLP-IJCNLP'19
をquery weighter Wを導入することで拡張し、recallを下記で定義する:
ここで、Q_G(D)は、ソーステキストDにおけるすべてのQA pairの集合、W(q, D)はDに対するqの重みである。
## Answerability and F1
Factoid QAモデルは一般的に、predicted answerとground truthのoverlapによって(F1)評価されている。しかし"ACL"と"Association for Computational Linguistics"のように、同じ回答でも異なる方法で表現される可能性がある。この例では、F1スコアは0となる(共通のtokenがないため)。
これを回避するために、Answers Unite! Unsupervised Metrics for Reinforced Summarization Models, Scialom+, EMNLP-IJCNLP'19
と同様に1-Q_A(ε)を利用する。
QG component, QA componentで利用するT5は、それぞれ[SQuAD-v2]( https://huggingface.co/datasets/squad_v2)と、NewsQAデータセット [Paper Note] NewsQA: A Machine Comprehension Dataset, Adam Trischler+, RepL4NLP'17, 2016.11 によってfinetuningしたものを利用する。
Q2: Evaluating Factual Consistency in Knowledge-Grounded Dialogues via Question Generation and Question Answering, Honovich+, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Metrics #DialogueGeneration #Evaluation #Reference-free #QA-based #Factuality #EMNLP #KeyPoint Notes Issue Date: 2023-08-13 Comment
(knowledge-grounded; 知識に基づいた)対話に対するFactual ConsistencyをReference-freeで評価できるQGQA手法。機械翻訳やAbstractive Summarizationの分野で研究が進んできたが、対話では
- 対話履歴、個人の意見、ユーザに対する質問、そして雑談
といった外部知識に対するconsistencyが適切ではない要素が多く存在し、よりチャレンジングなタスクとなっている。
また、そもそも対話タスクはopen-endedなタスクなため、Reference-basedな手法は現実的ではなく、Reference-freeな手法が必要と主張。
手法の概要としては以下。ユーザの発話からQuestion Generation (QG)を実施し、Question-Answer Candidate Pairを作成する。そして、生成したQuestionをベースとなる知識から回答させ(QA)、その回答結果とAnswer Candidateを比較することでFactual Consistencyを測定する。
Compression, Transduction, and Creation: A Unified Framework for Evaluating Natural Language Generation, Deng+, EMNLP''21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #LM-based #Factuality #EMNLP Issue Date: 2023-08-13 Comment
CTC
QACE: Asking Questions to Evaluate an Image Caption, Lee+, EMNLP'21
Paper/Blog Link My Issue
#ComputerVision #NaturalLanguageGeneration #Metrics #Evaluation #Reference-free #QA-based #One-Line Notes Issue Date: 2023-08-13 Comment
Image Captioningを評価するためのQGQAを提案している。candidateから生成した質問を元画像, およびReferenceを用いて回答させ、candidateに基づいた回答と回答の結果を比較することで評価を実施する。
[Paper Note] BARTScore: Evaluating Generated Text as Text Generation, Weizhe Yuan+, arXiv'21, 2021.06
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #LM-based #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-08-13 GPT Summary- 生成テキストの評価を、事前学習済みのシーケンス・ツー・シーケンスモデルを用いてモデル化。BARTを基にした指標BARTScoreを提案し、流暢さや情報性から生成テキストを評価。既存の指標を16のテスト設定で上回る可能性があり、広範なデータセットに適用可能。BARTScore計算コードは公開中。 Comment
BARTScore
# 概要
ソーステキストが与えられた時に、BARTによって生成テキストを生成する尤度を計算し、それをスコアとする手法。テキスト生成タスクをテキスト生成モデルでスコアリングすることで、pre-trainingされたパラメータをより有効に活用できる(e.g. BERTScoreやMoverScoreなどは、pre-trainingタスクがテキスト生成ではない)。BARTScoreの特徴は
1. parameter- and data-efficientである。pre-trainingに利用されたパラメータ以外の追加パラメータは必要なく、unsupervisedなmetricなので、human judgmentのデータなども必要ない。
2. 様々な観点から生成テキストを評価できる。conditional text generation problemにすることでinformativeness, coherence, factualityなどの様々な観点に対応可能。
3. BARTScoreは、(i) pre-training taskと類似したpromptを与えること、(ii) down stream generation taskでfinetuningすること、でより高い性能を獲得できる
BARTScoreを16種類のデータセットの、7つの観点で評価したところ、16/22において、top-scoring metricsよりも高い性能を示した。また、prompting starategyの有効性を示した。たとえば、シンプルに"such as"というフレーズを翻訳テキストに追加するだけで、German-English MTにおいて3%の性能向上が見られた。また、BARTScoreは、high-qualityなテキスト生成システムを扱う際に、よりロバストであることが分析の結果分かった。
# 前提
## Problem Formulation
生成されたテキストのqualityを測ることを目的とする。本研究では、conditional text generation (e.g. 機械翻訳)にフォーカスする。すなわち、ゴールは、hypothesis h_bar を source text s_barがgivenな状態で生成することである。一般的には、人間が作成したreference r_barが評価の際は利用される。
## Gold-standard Human Evaluation
評価のgold standardは人手評価であり、人手評価では多くの観点から評価が行われる。以下に代表的な観点を示す:
1. Informativeness: ソーステキストのキーアイデアをどれだけ捉えているか
2. Relevance: ソーステキストにあ地して、どれだけconsistentか
3. Fluency formatting problem, capitarlization errorや非文など、どの程度読むのが困難か
4. Coherence: 文間のつながりが、トピックに対してどれだけcoherentか
5. Factuality: ソーステキストに含意されるstatementのみを生成できているか
6. Semantic Coverage: 参照テキスト中のSemantic Content Unitを生成テキストがどれだけカバーできているか
7: Adequacy 入力文に対してアウトプットが同じ意味を出力できているかどうか、あるいは何らかのメッセージが失われる、追加される、歪曲していないかどうか
多くの性能指標は、これらの観点のうちのsubsetをカバーするようにデザインんされている。たとえば、BLEUは、翻訳におけるAdequacyとFluencyをとらえることを目的としている。一方、ROUGEは、semantic coverageを測るためのメトリックである。
BARTScoreは、これらのうち多くの観点を評価することができる。
## Evaluation as Different Tasks
ニューラルモデルを異なる方法で自動評価に活用するのが最近のトレンドである。下図がその分類。この分類は、タスクにフォーカスした分類となっている。
1. Unsupervised Matching: ROUGE, BLEU, CHRF, BERTScore, MoverScoreのように、hypothesisとreference間での意味的な等価性を測ることが目的である。このために、token-levelのマッチングを用いる。これは、distributedな表現を用いる(BERTScore, MoverScore)場合もあれば、discreteな表現を用いる(ROUGE, BLEU, chrF)場合もある。また、意味的な等価性だけでなく、factual consistencyや、source-hypothesis間の関係性の評価に用いることもできると考えられるが先行研究ではやられていなかったので、本研究で可能なことを示す。
2. Supervised Regression: BLEURT, COMET, S^3, VRMのように、regression layer を用いてhuman judgmentをsupervisedに予測する方法である。最近のメトリックtおしては、BLEURT, COMETがあげられ、古典的なものとしては、S^3, VRMがあげられる。
4. Supervised Ranking: COMET, BEERのような、ランキング問題としてとらえる方法もある。これは優れたhypothesisを上位にランキングするようなスコア関数を学習する問題に帰着する。COMETやBEERが例としてあげられ、両者はMTタスクにフォーカスされている。COMETはhunan judgmentsをregressionすることを通じてランキングを作成し、BEERは、多くのシンプルな特徴量を組み合わせて、linear layerでチューニングされる。
5. Text Generation: PRISM, BARTScoreが例として挙げられる。BARTScoreでは、生成されたテキストの評価をpre-trained language modelによるテキスト生成タスクとしてとらえる。基本的なアイデアとしては、高品質のhypothesisは、ソース、あるいはreferenceから容易に生成可能であろう、というものである。これはPRISMを除いて、先行研究ではカバーされていない。BARTScoreは、PRISMとはいくつかの点で異なっている。(i) PRISMは評価をparaphrasing taskとしてとらえており、これが2つの意味が同じテキストを比較する前提となってしまっているため、手法を適用可能な範囲を狭めてしまっている。たとえば、文書要約におけるfactual consistencyの評価では、semantic spaceが異なる2つのテキストを比較する必要があるが、このような例には対応できない。(ii) PRISMはparallel dataから学習しなけえrばならないが、BARTScoreは、pre-trainedなopen-sourceのseq2seq modelを利用できる。(iii) BARTScoreでは、PRISMが検証していない、prompt-basedのlearningもサポートしている。
# BARTScore
## Sequence-to-Sequence Pre-trained Models
pre-trainingされたモデルは、様々な軸で異なっているが、その一つの軸としては訓練時の目的関数である。基本的には2つの大きな変種があり、1つは、language modeling objectives (e.g. MLM)、2つ目は、seq2seq objectivesである。特に、seq2seqで事前学習されたモデルは、エンコーダーとデコーダーによって構成されているため特に条件付き生成タスクに対して適しており、予測はAutoRegressiveに行われる。本研究ではBARTを用いる。付録には、preliminary experimentsとして、BART with T5, PEGASUSを用いた結果も添付する。
## BARTScore
最も一般的なBARTScoreの定式化は下記である。
weighted log probabilityを利用する。このweightsは、異なるトークンに対して、異なる重みを与えることができる。たておば、IDFなどが利用可能であるが、本研究ではすべてのトークンを等価に扱う(uniform weightingだがstopwordを除外、IDFによる重みづけ、事前分布を導入するなど色々試したが、uniform weightingを上回るものがなかった)。
BARTScoreを用いて、様々な方向に用いて生成を行うことができ、異なる評価のシナリオに対応することができる。
- Faithfulness (s -> h):
- hypothesisがどれだけsource textに基づいて生成されているかを測ることができる。シナリオとしては、FactualityやRelevanceなどが考えられる。また、CoherenceやFluencyのように、target textのみの品質を測るためにも用いることができる。
- Precision (r -> h):
- hypothesisがどれだけgold-referenceに基づいてこう良くされているかを亜評価でき、precision-focusedなシナリオに適している
- Recall (h -> r):
- hypothesisから、gold referenceをどれだけ容易に再現できるかを測ることができる。そして、要約タスクのpyramid-basedな評価(i.e. semantic coverage等) に適している。pyramid-scoreはSemantic Content Unitsがどれだけカバーされているかによって評価される。
- F Score (r <-> h):
- 双方向を考慮し、Precisioon / RecallからF値を算出する。この方法は、referenceと生成テキスト間でのsemantic overlap (informativenss, adequacy)などの評価に広く利用される。
# BARTScore Variants
BARTScoreの2つの拡張を提案。(i) xとyをpromptingによって変更する。これにより、評価タスクをpre-training taskと近づける。(ii) パラメータΘを異なるfinetuning taskを考慮して変更する。すなわち、pre-trainingのドメインを、evaluation taskに近づける。
## Prompt
Promptingはinput/outputに対して短いフレーズを追加し、pre-trained modelに対して特定のタスクを遂行させる方法である。BARTにも同様の洞察を簡単に組み込むことができる。この変種をBARTScore-PROMPTと呼ぶ。
prompt zが与えられたときに、それを (i) source textに追加し、新たなsource textを用いてBARTScoreを計算する。(ii) target textの先頭に追加し、new target textに対してBARTScoreを計算する。
## Fine-tuning Task
classification-basedなタスクでfine-tuneされるのが一般的なBERT-based metricとは異なり、BARTScoreはgeneration taskでfine-tuneされるため、pre-training domainがevaluation taskと近い。本研究では、2つのdownstream taskを検証する。
1つめは、summarizationで、BARTをCNNDM datasetでfinetuningする。2つめは、paraphrasingで、summarizationタスクでfinetuningしたBARTをParaBank2 datasetでさらにfinetuningする。
# 実験
## baselines and datasets
### Evaluation Metrics
supervised metrics: COMET, BLEURT
unsupervised: BLEU, ROUGE-1, ROUGE-2, ROUGE-L, chrF, PRISM, MoverScore, BERTScore
と比較
### Measures for Meta Evaluation
Pearson Correlationでlinear correlationを測る。また、Spearman Correlationで2変数間の単調なcorrelationを測定する(線形である必要はない)。Kendall's Tauを用いて、2つの順序関係の関係性を測る。最後に、Accuracyでfactual textsとnon-factual textの間でどれだけ正しいランキングを得られるかを測る。
### Datasets
Summarization, MT, DataToTextの3つのデータセットを利用。
## Setup
### Prompt Design
seedをparaphrasingすることで、 s->h方向には70個のpromptを、h<->rの両方向には、34のpromptを得て実験で用いた。
### Settings
Summarizationとdata-to-textタスクでは、全てのpromptを用いてデコーダの頭に追加してスコアを計算しスコアを計算した。最終的にすべての生成されたスコアを平均することである事例に対するスコアを求めた(prompt unsembling)。MTについては、事例数が多くcomputational costが多くなってしまうため、WMT18を開発データとし、best prompt "Such as"を選択し、利用した。
BARTScoreを使う際は、gold standard human evaluationがrecall-basedなpyrmid methodの場合はBARTScore(h->r)を用い、humaan judgmentsがlinguistic quality (coherence fluency)そして、factual correctness、あるいは、sourceとtargetが同じモダリティ(e.g. language)の場合は、faitufulness-based BARTScore(s->h)を用いた。最後に、MTタスクとdata-to-textタスクでは、fair-comparisonのためにBARTScore F-score versionを用いた。
## 実験結果
### MT
- BARTScoreはfinetuning tasksによって性能が向上し、5つのlanguage pairsにおいてその他のunsupervised methodsを統計的に優位にoutperformし、2つのlanguage pairでcomparableであった。
-Such asというpromptを追加するだけで、BARTScoreの性能が改善した。特筆すべきは、de-enにおいては、SoTAのsupervised MetricsであるBLEURTとCOMETを上回った。
- これは、有望な将来のmetric designとして「human judgment dataで訓練する代わりに、pre-trained language modelに蓄積された知識をより適切に活用できるpromptを探索する」という方向性を提案している。
### Text Summarization
- vanilla BARTScoreはBERTScore, MoverScoreをInfo perspective以外でlarge marginでうくぁ回った。
- REALSum, SummEval dataseetでの改善は、finetuning taskによってさらに改善した。しかしながら、NeR18では改善しなかった。これは、データに含まれる7つのシステムが容易に区別できる程度のqualityであり、既にvanilla BARTScoreで高いレベルのcorrelationを達成しているからだと考えられる。
- prompt combination strategyはinformativenssに対する性能を一貫して改善している。しかし、fluency, factualityでは、一貫した改善は見られなかった。
Factuality datasetsに対する分析を行った。ゴールは、short generated summaryが、元のlong documentsに対してfaithfulか否かを判定するというものである。
- BARTScore+CNNは、Rank19データにおいてhuman baselineに近い性能を達成し、ほかのベースラインを上回った。top-performingなfactuality metricsであるFactCCやQAGSに対してもlarge marginで上回った。
- paraphraseをfine-tuning taskで利用すると、BARTScoreのパフォーマンスは低下した。これは妥当で、なぜなら二つのテキスト(summary and document)は、paraphrasedの関係性を保持していないからである。
- promptを導入しても、性能の改善は見受けられず、パフォーマンスは低下した。
### Data-to-Text
- CNNDMでfine-tuningすることで、一貫してcorrelationが改善した。
- 加えて、paraphraseデータセットでfinetuningすることで、さらに性能が改善した。
- prompt combination strategyは一貫してcorrelationを改善した。
## Analysis
### Fine-grained Analysis
- Top-k Systems: MTタスクにおいて、評価するシステムをtop-kにし、各メトリックごとにcorrelationの変化を見た。その結果、BARTScoreはすべてのunsupervised methodをすべてのkにおいて上回り、supervised metricのBLEURTも上回った。また、kが小さくなるほど、より性能はsmoothになっていき、性能の低下がなくなっていった。これはつまり、high-quality textを生成するシステムに対してロバストであることを示している。
- Reference Length: テストセットを4つのバケットにreference lengthに応じてブレイクダウンし、Kendall's Tauの平均のcorrelationを、異なるメトリック、バケットごとに言語をまたいで計算した。unsupervised metricsに対して、全てのlengthに対して、引き分けかあるいは上回った。また、ほかのmetricsと比較して、長さに対して安定感があることが分かった。
### Prompt Analysis
(1) semantic overlap (informativeness, pyramid score, relevance), (2) linguistic quality (fluency, coherence), (3) factual correctness (factuality) に評価の観点を分類し、summarizationとdata-to-textをにおけるすべてのpromptを分析することで、promptの効果を分析した。それぞれのグループに対して、性能が改善したpromptの割合を計算した。その結果、semantic overlapはほぼ全てのpromptにて性能が改善し、factualityはいくつかのpromptでしか性能の改善が見られなかった。linguistic qualityに関しては、promptを追加することによる効果はどちらとも言えなかった。
### Bias Analysis
BARTScoreが予測不可能な方法でバイアスを導入してしまうかどうかを分析した。バイアスとは、human annotatorが与えたスコアよりも、値が高すぎる、あるいは低すぎるような状況である。このようなバイアスが存在するかを検証するために、human annotatorとBARTScoreによるランクのサを分析した。これを見ると、BARTScoreは、extractive summarizationの品質を区別する能力がabstractive summarizationの品質を区別する能力よりも劣っていることが分かった。しかしながら、近年のトレンドはabstractiveなseq2seqを活用することなので、この弱点は軽減されている。
# Implications and Future Directions
prompt-augmented metrics: semantic overlapではpromptingが有効に働いたが、linguistic qualityとfactualityでは有効ではなかった。より良いpromptを模索する研究が今後期待される。
Co-evolving evaluation metrics and systems: BARTScoreは、メトリックデザインとシステムデザインの間につながりがあるので、より性能の良いseq2seqシステムが出たら、それをメトリックにも活用することでよりreliableな自動性能指標となることが期待される。
[Paper Note] Play the Shannon Game With Language Models: A Human-Free Approach to Summary Evaluation, Nicholas Egan+, arXiv'21, 2021.03
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free #AAAI Issue Date: 2023-08-13 GPT Summary- 事前学習済みの言語モデルを用いて、文書とその要約の共有情報を推定する新しい要約評価指標を提案。これらはシャノン・ゲームの現代的解釈であり、人間の代わりにモデルを使用。トランスフォーマーに基づくモデルで、一貫性と関連性の次元で人間の判断との高い相関を実証。また、整合性と流暢さにおいても競争力を持つ評価を確認。
Towards Question-Answering as an Automatic Metric for Evaluating the Content Quality of a Summary, Deutsch+, TACL'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-based Issue Date: 2023-08-13
ESTIME: Estimation of Summary-to-Text Inconsistency by Mismatched Embeddings, Eval4NLP'21
Paper/Blog Link My Issue
#DocumentSummarization #Metrics #Evaluation #Reference-free Issue Date: 2023-08-13
[Paper Note] SimCSE: Simple Contrastive Learning of Sentence Embeddings, Tianyu Gao+, arXiv'21, 2021.04
Paper/Blog Link My Issue
#Sentence #Embeddings #LanguageModel #RepresentationLearning #ContrastiveLearning #Catastrophic Forgetting #EMNLP #Selected Papers/Blogs #Surface-level Notes Issue Date: 2023-07-27 GPT Summary- SimCSEは、文の埋め込み表現を向上させる単純な対照学習フレームワークです。教師なしアプローチでは、入力文が自身を予測し、ドロップアウトがノイズとして機能します。この手法は従来の教師あり方法と同等の成果を上げ、ドロップアウトを除去すると表現の質が低下することが分かりました。また、教師付きアプローチでは、自然言語推論データセットからの注釈付きペアを活用し、対照学習に組み込みます。評価結果では、教師なしモデルが76.3%、教師ありモデルが81.6%のSpearmanの相関を達成し、既存のベスト結果をそれぞれ改善しました。対照学習の目的が埋め込みの空間の正則化に貢献することも示されました。 Comment
[Paper Note] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, Nils Reimers+, arXiv'19, 2019.08 よりも性能良く、unsupervisedでも学習できる。STSタスクのベースラインにだいたい入ってる
# 手法概要
Contrastive Learningを活用して、unsupervised/supervisedに学習を実施する。
Unsupervised SimCSEでは、あるsentenceをencoderに2回入力し、それぞれにdropoutを適用させることで、positive pairを作成する。dropoutによって共通のembeddingから異なる要素がマスクされた(noiseが混ざった状態とみなせる)類似したembeddingが作成され、ある種のdata augmentationによって正例を作成しているともいえる。負例はnegative samplingする。(非常にsimpleだが、next sentence predictionで学習するより性能が良くなる)
Supervised SimCSEでは、アノテーションされたsentence pairに基づいて、正例・負例を決定する。本研究では、NLIのデータセットにおいて、entailment関係にあるものは正例として扱う。contradictions(矛盾)関係にあるものは負例として扱う。
# Siamese Networkで用いられるmeans-squared errrorとContrastiveObjectiveの違い
どちらもペアワイズで比較するという点では一緒だが、ContrastiveObjectiveは正例と近づいたとき、負例と遠ざかったときにlossが小さくなるような定式化がされている点が異なる。
(画像はこのブログから引用。ありがとうございます。
https://techblog.cccmk.co.jp/entry/2022/08/30/163625)
# Unsupervised SimCSEの実験
異なるdata augmentation手法と比較した結果、dropoutを適用する手法の方が性能が高かった。MLMや, deletion, 類義語への置き換え等よりも高い性能を獲得しているのは興味深い。また、Next Sentence Predictionと比較しても、高い性能を達成。Next Sentence Predictionは、word deletion等のほぼ類似したテキストから直接的に類似関係にあるペアから学習するというより、Sentenceの意味内容のつながりに基づいてモデルの言語理解能力を向上させ、そのうえで類似度を測るという間接的な手法だが、word deletionに負けている。一方、dropoutを適用するだけの(直接的に類似ペアから学習する)本手法はより高い性能を示している。
[image](https://github.com/AkihikoWatanabe/paper_notes/assets/12249301/0ea3549e-3363-4857-94e6-a1ef474aa191)
なぜうまくいくかを分析するために、異なる設定で実験し、alignment(正例との近さ)とuniformity(どれだけembeddingが一様に分布しているか)を、10 stepごとにplotした結果が以下。dropoutを適用しない場合と、常に同じ部分をマスクする方法(つまり、全く同じembeddingから学習する)設定を見ると、学習が進むにつれuniformityは改善するが、alignmentが悪くなっていっている。一方、SimCSEはalignmentを維持しつつ、uniformityもよくなっていっていることがわかる。
# Supervised SimCSEの実験
アノテーションデータを用いてContrastiveLearningするにあたり、どういったデータを正例としてみなすと良いかを検証するために様々なデータセットで学習し性能を検証した。
- QQP4: Quora question pairs
- Flickr30k (Young et al., 2014): 同じ画像に対して、5つの異なる人間が記述したキャプションが存在
- ParaNMT (Wieting and Gimpel, 2018): back-translationによるparaphraseのデータセットa
- NLI datasets: SNLIとMNLI
実験の結果、NLI datasetsが最も高い性能を示した。この理由としては、NLIデータセットは、crowd sourcingタスクで人手で作成された高品質なデータセットであることと、lexical overlapが小さくなるようにsentenceのペアが作成されていることが起因している。実際、NLI datsetのlexical overlapは39%だったのに対し、ほかのデータセットでは60%であった。
また、condunctionsとなるペアを明示的に負例として与えることで、より性能が向上した(普通はnegative samplingする、というかバッチ内の正例以外のものを強制的に負例とする。こうすると、意味が同じでも負例になってしまう事例が出てくることになる)。より難しいNLIタスクを含むANLIデータセットを追加した場合は、性能が改善しなかった。この理由については考察されていない。性能向上しそうな気がするのに。
# 他手法との比較結果
SimCSEがよい。
# Ablation Studies
異なるpooling方法で、どのようにsentence embeddingを作成するかで性能の違いを見た。originalのBERTの実装では、CLS token のembeddingの上にMLP layerがのっかっている。これの有無などと比較。
Unsupervised SimCSEでは、training時だけMLP layerをのっけて、test時はMLPを除いた方が良かった。一方、Supervised SimCSEでは、 MLP layerをのっけたまんまで良かったとのこと。
また、SimCSEで学習したsentence embeddingを別タスクにtransferして活用する際には、SimCSEのobjectiveにMLMを入れた方が、catastrophic forgettingを防げて性能が高かったとのこと。
ablation studiesのhard negativesのところと、どのようにミニバッチを構成するか、それぞれのtransferしたタスクがどのようなものがしっかり読めていない。あとでよむ。
[Paper Note] PENS: A Dataset and Generic Framework for Personalized News Headline Generation, ACL'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #Dataset #LanguageModel #PersonalizedGeneration #Personalization #PersonalizedHeadlineGeneration #ACL #Surface-level Notes Issue Date: 2023-05-31 GPT Summary- この論文では、ユーザーの興味とニュース本文に基づいて、ユーザー固有のタイトルを生成するパーソナライズされたニュース見出し生成の問題を解決するためのフレームワークを提案します。また、この問題のための大規模なデータセットであるPENSを公開し、ベンチマークスコアを示します。データセットはhttps://msnews.github.io/pens.htmlで入手可能です。 Comment
# 概要
ニュース記事に対するPersonalizedなHeadlineの正解データを生成。103名のvolunteerの最低でも50件のクリックログと、200件に対する正解タイトルを生成した。正解タイトルを生成する際は、各ドキュメントごとに4名異なるユーザが正解タイトルを生成するようにした。これらを、Microsoft Newsの大規模ユーザ行動ログデータと、ニュース記事本文、タイトル、impressionログと組み合わせてPENSデータを構成した。
# データセット生成手順
103名のenglish-native [speakerの学生に対して、1000件のニュースヘッドラインの中から最低50件興味のあるヘッドラインを選択してもらう。続いて、200件のニュース記事に対して、正解ヘッドラインを生成したもらうことでデータを生成した。正解ヘッドラインを生成する際は、同一のニュースに対して4人がヘッドラインを生成するように調整した。生成されたヘッドラインは専門家によってqualityをチェックされ、factual informationにエラーがあるものや、極端に長い・短いものなどは除外された。
# データセット統計量
# 手法概要
Transformer Encoder + Pointer GeneratorによってPersonalizedなヘッドラインを生成する。
Transformer Encoderでは、ニュースの本文情報をエンコードし、attention distributionを生成する。Decoder側では、User Embeddingを組み合わせて、テキストをPointer Generatorの枠組みでデコーディングしていき、ヘッドラインを生成する。
User Embeddingをどのようにinjectするかで、3種類の方法を提案しており、1つ目は、Decoderの初期状態に設定する方法、2つ目は、ニュース本文のattention distributionの計算に利用する方法、3つ目はデコーディング時に、ソースからvocabをコピーするか、生成するかを選択する際に利用する方法。1つ目は一番シンプルな方法、2つ目は、ユーザによって記事で着目する部分が違うからattention distributionも変えましょう、そしてこれを変えたらcontext vectorも変わるからデコーディング時の挙動も変わるよねというモチベーション、3つ目は、選択するvocabを嗜好に合わせて変えましょう、という方向性だと思われる。最終的に、2つ目の方法が最も性能が良いことが示された。
# 訓練手法
まずニュース記事推薦システムを訓練し、user embeddingを取得できるようにする。続いて、genericなheadline generationモデルを訓練する。最後に両者を組み合わせて、Reinforcement LearningでPersonalized Headeline Generationモデルを訓練する。Rewardとして、
1. Personalization: ヘッドラインとuser embeddingのdot productで報酬とする
2. Fluency: two-layer LSTMを訓練し、生成されたヘッドラインのprobabilityを推定することで報酬とする
3. Factual Consistency: 生成されたヘッドラインと本文の各文とのROUGEを測りtop-3 scoreの平均を報酬とする
とした。
1,2,3の平均を最終的なRewardとする。
# 実験結果
Genericな手法と比較して、全てPersonalizedな手法が良かった。また、手法としては②のattention distributionに対してuser informationを注入する方法が良かった。News Recommendationの性能が高いほど、生成されるヘッドラインの性能も良かった。
# Case Study
ある記事に対するヘッドラインの一覧。Pointer-Genでは、重要な情報が抜け落ちてしまっているが、提案手法では抜け落ちていない。これはRLの報酬のfluencyによるものだと考えられる。また、異なるユーザには異なるヘッドラインが生成されていることが分かる。
Transformer Reasoning Network for Personalized Review Summarization, Xu+, SIGIR'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #review #SIGIR #One-Line Notes Issue Date: 2023-05-06 Comment
先行研究は、review summarizationにおいて生成されるsummaryは、過去にユーザが作成したsummaryのwriting styleやproductに非常に関係しているのに、これらを活用してこなかったので、活用しました(=personalized)という話っぽい
[Paper Note] ニュース記事に対する談話構造と興味度のアノテーション ~ニュース対話システムのパーソナライズに向けて~, 高津+, NLP'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization #Dataset #Personalization Issue Date: 2023-04-30 Comment
ニュース記事に対して談話構造および,ユーザのプロフィールと記事の話題・文に対するユーザの興味度を付与したデータセット。
プロフィールとして以下を収集:
- 性別
- 年齢,
- 住んでいる地域
- 職種
- 業種
- ニュースを見る頻度,
- ニュースをよくチェックする時間帯
- 映像・音声・文字のうちニュースへの接触方法として多いものはどれか
- ニュースを知る手段
- ニュースを読む際使用している新聞やウェブサイト・アプリ
- 有料でニュースを読んでいるか
- 普段積極的に読む・見る・聞くニュースのジャンル
- ニュースのジャンルに対する興味の程度,趣味.
[Paper Note] 談話構造制約付きパーソナライズド抽出型要約, 高津+, NLP'21
Paper/Blog Link My Issue
#PersonalizedDocumentSummarization Issue Date: 2023-04-30
Learning Transferable Visual Models From Natural Language Supervision, Radford+, OpenAI, ICML'21
Paper/Blog Link My Issue
#ComputerVision #Embeddings #RepresentationLearning #MultiModal #ContrastiveLearning #ICML #Selected Papers/Blogs #2D (Image) #One-Line Notes #text Issue Date: 2023-04-27 Comment
CLIP論文。大量の画像と画像に対応するテキストのペアから、対照学習を行い、画像とテキスト間のsimilarityをはかれるようにしたモデル
Refocusing on Relevance: Personalization in NLG, Shiran Dudy+, Department of Computer Science University of Colorado, EMNLP'21
Paper/Blog Link My Issue
#NaturalLanguageGeneration #Personalization #EMNLP #One-Line Notes Issue Date: 2023-04-26 Comment
従来のNLGはソーステキストに焦点を当て、ターゲットを生成することに注力してきた。が、ユーザの意図やcontextがソーステキストだけに基づいて復元できない場合、このアプローチでは不十分であることを指摘。
この研究ではNLGシステムが追加のcontextを利用することに大きな重点をおくべきであり、IR等で活用されているrelevancyをユーザ指向のテキスト生成タスクを設計するための重要な指標として考えることを提案している。
[Paper Note] Generating Racing Game Commentary from Vision, Language, and Structured Data, Tatsuya+, INLG'21
Paper/Blog Link My Issue
#NeuralNetwork #ComputerVision #NaturalLanguageGeneration #DataToTextGeneration #INLG #Game #3D (Video) Issue Date: 2022-09-15 GPT Summary- モーターレーシングゲームにおける自動解説生成タスクを提案し、視覚データ、数値データ、テキストデータを用いて解説を生成する。タスクは発話タイミングの特定と発話生成の2つのサブタスクに分かれ、129,226の発話を含む新しい大規模データセットを紹介。解説の特性は時間や視点によって変化し、最先端の視覚エンコーダでも正確な解説生成が難しいことが示された。データセットとベースライン実装は今後の研究のために公開される。 Comment
データセット: https://kirt.airc.aist.go.jp/corpus/ja/RacingCommentary
[Paper Note] The Power of Scale for Parameter-Efficient Prompt Tuning, Brian Lester+, EMNLP'21, 2021.04
Paper/Blog Link My Issue
#NeuralNetwork #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #EMNLP #PostTraining #Selected Papers/Blogs #KeyPoint Notes #SoftPrompt Issue Date: 2022-08-19 GPT Summary- 本研究では、凍結された言語モデルを特定のタスクに適応させるための「ソフトプロンプト」を学習するプロンプトチューニング手法を提案。逆伝播を通じて学習されるソフトプロンプトは、GPT-3の少数ショット学習を上回る性能を示し、モデルサイズが大きくなるほど競争力が増すことが確認された。特に、数十億のパラメータを持つモデルにおいて、全ての重みを調整するモデルチューニングに匹敵する性能を発揮。これにより、1つの凍結モデルを複数のタスクに再利用できる可能性が示唆され、ドメイン転送に対するロバスト性も向上することが明らかとなった。 Comment
日本語解説:
https://qiita.com/kts_plea/items/79ffbef685d362a7b6ce
T5のような大規模言語モデルに対してfinetuningをかける際に、大規模言語モデルのパラメータは凍結し、promptをembeddingするパラメータを独立して学習する手法
言語モデルのパラメータ数が増加するにつれ、言語モデルそのものをfinetuningした場合(Model Tuning)と同等の性能を示した。
いわゆる(Softな) Prompt Tuning
[Paper Note] Biomedical Data-to-Text Generation via Fine-Tuning Transformers, Ruslan Yermakov+, ACL-INLG'21, 2021.09
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #Dataset #DataToTextGeneration #ACL #INLG #One-Line Notes Issue Date: 2022-08-18 GPT Summary- バイオメディカル分野におけるD2T生成の研究を行い、医薬品のパッケージリーフレットを用いた実世界のデータセットに対してファインチューニングされたトランスフォーマーを適用。現実的な複数文のテキスト生成が可能であることを示す一方で、重要な制限も存在。新たにバイオメディカル分野のD2T生成モデルのベンチマーク用データセット(BioLeaflets)を公開。 Comment
biomedical domainの新たなdata2textデータセットを提供。事前学習済みのBART, T5等をfinetuningすることで高精度にテキストが生成できることを示した。
[Paper Note] WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, Hiroaki Hayashi+, TACL'21, 2020.11
Paper/Blog Link My Issue
#DocumentSummarization #Tutorial #Dataset #TACL #KeyPoint Notes Issue Date: 2021-10-20 GPT Summary- オープンドメインのアスペクトベース要約のために、20の異なるドメインのWikipedia記事を用いたマルチドメイン対応データセットWikiAspを提案。各記事のセクションタイトルをアスペクト注釈の指標とし、実験を通じて既存モデルの主要な課題を明らかにした。 Comment
NLPコロキウムをリアルタイムに聴講
◆Aspect-based summarizationのモチベーション
・same source対して、異なるユーザニーズが存在するので、ニーズに関して要約したい
◆Aspect: あるobjectに対する、attributeのようなものを指定?
object: Attention Is All You Need
aspect: Multi-Head Attention
◆Aspect Based Summarizationの歴史
・はじめは”feature”という文言で研究され(04年頃?)
・続いて*keywords*という単語で研究され
・その後Aspectという文言で研究されるようになった
・2008年頃にMcDonaldsらがAspect-Based Summarizationを提案した
・2014年以後?とかにNeural Basedな手法が盛んに研究
◆WikiAspデータセットについて
・Wikipediaを使ったAspect-based dataset
・Wikipediaを書かれるのに利用されたsource document(wikipediaにソースとして引用されているもの)に対し、aspectを各節の見出しとみなし、節のテキストを要約文とみなすことで、データセット生成
・他のAspect-basedデータセットと異なり、ソースデータが長く、要約長も5~6倍程度
・ドメイン数が他データセットは5,6程度に対し、20と膨大
◆ベースラインとして2-stageモデルを採用
first-stage: ソーステキストからROBERTaベースドなclassifierを用いて、sentencesから内包するAspectを閾値を用いて決定
それらをgrouped sentencesとする
two-stage: 各aspectごとにまとまったテキスト集合に対して、要約モデルを適用し、要約を実施する
・要約モデルはUnsupervisedな手法であるTextRankと、Supervisedな手法であるBERTベースな手法を採用
・ドメインごとに評価した結果を見ると、BERTが強いドメインがある一方で、TextRankが強いドメインもあった
-> Extractiveな形で要約されているドメインではTextRankが強く、Abstractiveに要約されているドメインではBERTが強い
-> またBERTは比較的短い要約であればTextRankよりもはるかに良いが、長い要約文になるとTextRankとcomprable(あるいはTextRankの方が良い)程度の性能になる
・ROUGE-2の値がsentence-basedなORACLEを見た時に、他データセットと比較して低いので、Abstractiveな手法が必要なデータセット?
(後からのメモなので少しうろ覚えな部分あり)
Q. ROUGE-2が30とかって直観的にどのくらいのレベルのものなの?ROUGE-2が30とか40とかは高い
・最先端の要約モデルをニュース記事に適用すると、35~40くらいになる。
・このレベルの数値になると、人間が呼んでも違和感がないレベルの要約となっている
Q. 実際に要約文をチェックしてみて、どういう課題を感じるか?
A. Factual Consistencyがすぐに目につく問題で、特にBERTベースな要約文はそう。TextRankはソース文書がノイジーなので、ソース文章を適当に拾ってきただけではFactual Consistencyが良くない(元の文書がかっちりしていない)。流暢性の問題はAbstractiveモデルだと特に問題なくBERT-baseでできる。Aspect-based要約のエラー例としてAspectに則っていないということがある。たとえばオバマの大統領時代の話をきいているのに、幼少時代の話をしているとか。Aspect情報をうまくモデルを扱えていないという点が課題としてある。
出典元(リアルタイムに聴講): 第13回 WikiAsp: A Dataset for Multi-domain Aspect-based Summarization, NLPコロキウム
https://youtu.be/3PIJotX6i_w?si=hX5pXwNL-ovkGSF5
[Paper Note] 過去情報の内容選択を取り入れた スポーツダイジェストの自動生成, 加藤+, NLP'21
Paper/Blog Link My Issue
#NeuralNetwork #NaturalLanguageGeneration #DataToTextGeneration Issue Date: 2021-10-08
[Paper Note] Prefix-Tuning: Optimizing Continuous Prompts for Generation, Xiang Lisa Li+, arXiv'21, 2021.01
Paper/Blog Link My Issue
#DocumentSummarization #NeuralNetwork #NaturalLanguageGeneration #LanguageModel #Supervised-FineTuning (SFT) #PEFT(Adaptor/LoRA) #ACL #PostTraining #Selected Papers/Blogs #KeyPoint Notes Issue Date: 2021-09-09 GPT Summary- プレフィックスチューニングは、ファインチューニングの軽量な代替手段であり、言語モデルのパラメータを固定しつつ、タスク特有の小さなベクトルを最適化する手法です。これにより、少ないパラメータで同等のパフォーマンスを達成し、低データ設定でもファインチューニングを上回る結果を示しました。 Comment
言語モデルをfine-tuningする際,エンコード時に「接頭辞」を潜在表現として与え,「接頭辞」部分のみをfine-tuningすることで(他パラメータは固定),より少量のパラメータでfine-tuningを実現する方法を提案.接頭辞を潜在表現で与えるこの方法は,GPT-3のpromptingに着想を得ている.fine-tuningされた接頭辞の潜在表現のみを配布すれば良いので,非常に少量なパラメータでfine-tuningができる.
table-to-text, summarizationタスクで,一般的なfine-tuningやAdapter(レイヤーの間にアダプターを挿入しそのパラメータだけをチューニングする手法)といった効率的なfine-tuning手法と比較.table-to-textでは、250k (元のモデルの 0.1%) ほどの数のパラメータを微調整するだけで、全パラメータをfine-tuningするのに匹敵もしくはそれ以上の性能を達成.
Hugging Faceの実装を利用したと論文中では記載されているが,fine-tuningする前の元の言語モデル(GPT-2)はどのように準備したのだろうか.Hugging Faceのpretrained済みのGPT-2を使用したのだろうか.
autoregressive LM (GPT-2)と,encoder-decoderモデル(BART)へPrefix Tuningを適用する場合の模式図
[Paper Note] A Survey of Transformers, Tianyang Lin+, arXiv'21, 2021.06
Paper/Blog Link My Issue
#NeuralNetwork #Survey #Initial Impression Notes Issue Date: 2021-06-09 GPT Summary- トランスフォーマーの多様なバリアント(X-formers)に関する体系的な文献レビューを提供。バニラトランスフォーマーの紹介後、新しい分類法を提案し、アーキテクチャの修正、事前学習、アプリケーションの観点からX-formersを紹介。今後の研究の方向性も概説。 Comment
Transformersの様々な分野での亜種をまとめた論文
[Paper Note] Big Bird: Transformers for Longer Sequences, Manzil Zaheer+, NIPS'20, 2020.07
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #LongContext #NeurIPS #Sparse #SparseAttention Issue Date: 2025-11-30 GPT Summary- BigBirdは、Transformersモデルのシーケンス長に対する二次的依存性を線形に削減するスパース注意メカニズムを提案。これにより、長いシーケンスを最大8倍処理可能となり、質問応答や要約などのNLPタスクでの性能が向上。さらに、ゲノムデータへの新たな応用も示唆。 Comment
[Paper Note] Dense Passage Retrieval for Open-Domain Question Answering, Vladimir Karpukhin+, EMNLP'20, 2020.04
Paper/Blog Link My Issue
#Embeddings #InformationRetrieval #QuestionAnswering #ContrastiveLearning #EMNLP #Selected Papers/Blogs #Encoder #KeyPoint Notes Issue Date: 2025-09-28 GPT Summary- 密な表現を用いたパッセージ検索の実装を示し、デュアルエンコーダーフレームワークで学習。評価の結果、Lucene-BM25を上回り、検索精度で9%-19%の改善を達成。新たな最先端のQA成果を確立。 Comment
Dense Retrieverが広く知られるきっかけとなった研究(より古くはDSSM Learning Deep Structured Semantic Models for Web Search using Clickthrough Data, Huang+, CIKM'13
などがある)。bag-of-wordsのようなsparseなベクトルで検索するのではなく(=Sparse Retriever)、ニューラルモデルでエンコードした密なベクトルを用いて検索しようという考え方である。
Query用と検索対象のPassageをエンコードするEncoderを独立してそれぞれ用意し(=DualEncoder)、QAの学習データ(すなわちクエリqと正例として正解passage p+)が与えられた時、クエリqと正例p+の類似度が高く、負例p-との類似度が低くなるように(=Contrastive Learning)、Query, Passage Encoderのパラメータを更新することで学習する(損失関数は式(2))。
負例はIn-Batch Negativeを用いる。情報検索の場合正解ラベルは多くの場合明示的に決まるが、負例は膨大なテキストのプールからサンプリングしなければならない。サンプリング方法はいろいろな方法があり(e.g., ランダムにサンプリング、qとbm25スコアが高いpassage(ただし正解は含まない; hard negativesと呼ぶ)その中の一つの方法がIn-Batch Negativesである。
In-Batch Negativesでは、同ミニバッチ内のq_iに対応する正例p+_i以外の全てのp_jを(擬似的に)負例とみなす。これにより、パラメータの更新に利用するためのq,pのエンコードを全て一度だけ実行すれば良く、計算効率が大幅に向上するという優れもの。本研究の実験(Table3)によると上述したIn-Batch Negativeに加えて、bm25によるhard negativeをバッチ内の各qに対して1つ負例として追加する方法が最も性能が良かった。
クエリ、passageのエンコーダとしては、BERTが用いられ、[CLS]トークンに対応するembeddingを用いて類似度が計算される。
[Paper Note] BLiMP: The Benchmark of Linguistic Minimal Pairs for English, Alex Warstadt+, TACL'20
Paper/Blog Link My Issue
#Dataset #Evaluation #TACL #Grammar Issue Date: 2025-09-07 GPT Summary- 言語的最小対のベンチマーク(BLiMP)は、言語モデルの文法知識を評価するためのチャレンジセットで、67のサブデータセットから成り、各サブデータセットには特定の文法対比を示す1000の最小対が含まれています。データは専門家によって自動生成され、人間の合意は96.4%です。n-gram、LSTM、Transformerモデルを評価した結果、最先端のモデルは形態論的対比を識別できるが、意味的制約や微妙な文法現象には苦戦していることが示されました。 Comment
先行研究と比較して、より広範なlinguistic phenomenaを扱い、かつ大量のサンプルを集めた英語のacceptable/unacceptableなsentenceのペアデータ。ペアデータは特定のlinguistic phenomenaをacceptable/unacceptableに対比するための最小の違いに基づいており専門家が作成したテンプレートに基づいて自動生成され、クラウドソーシングによって人手でvalidationされている。言語モデルが英語のlinguistic phenomenaについて、どの程度理解しているかのベンチマークに利用可能。
[Paper Note] Longformer: The Long-Document Transformer, Iz Beltagy+, arXiv'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #One-Line Notes #Sparse #SparseAttention Issue Date: 2025-08-09 GPT Summary- Longformerは、長いシーケンスを線形に処理できる注意機構を持つTransformerベースのモデルで、数千トークンの文書を扱える。局所的なウィンドウ注意とタスクに基づくグローバル注意を組み合わせ、文字レベルの言語モデリングで最先端の結果を達成。事前学習とファインチューニングを行い、長文タスクでRoBERTaを上回る性能を示した。また、Longformer-Encoder-Decoder(LED)を導入し、長文生成タスクにおける効果を確認した。 Comment
(固定された小さめのwindowsサイズの中でのみattentionを計算する)sliding window attentionを提案。Figure2を見ると、通常のAttentionと比較して、現在のトークンの周辺のトークンにしか注目しない特性が図示されており、イメージが掴みやすい。
OpenLLMの文脈だと、Mistralに採用されて話題になったかも?
- Mistral 7B, Albert Q. Jiang+, N/A, arXiv'23
[Paper Note] Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, Angelos Katharopoulos+, ICML'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #ICML #Selected Papers/Blogs #reading #One-Line Notes #RecurrentModels #LinearAttention Issue Date: 2025-08-05 GPT Summary- 自己注意をカーネル特徴マップの線形ドット積として表現することで、Transformersの複雑性を$\mathcal{O}\left(N^2\right)$から$\mathcal{O}\left(N\right)$に削減。これにより、自己回帰型Transformersの速度が最大4000倍向上し、従来のパフォーマンスを維持。 Comment
関連:
- Transformers are Multi-State RNNs, Matanel Oren+, N/A, EMNLP'24
pj page: https://linear-transformers.com
Linear Attention(Linear Transformer)を提案した研究。Softmaxが利用されるFull Attentionのsimilarity部分をfeature map φを持つカーネルk(x, y)で一般化し、(3)--(6)の流れでfeature map φ同士は内積が使える性質と、行列積の結合法則を用いて式変換する。
式変換によって、従来のSoftmax Attentionでは、全てのトークンNに対してQ_i * K_j * V_jのメモリが必要だったものを(O(N^2))、各Queryごとに利用される、KVを用いた情報が共通化され(現在のqueryまでのφ(K)とφ(K)V^Tを逐次的に加算して保持するだけで良い)、再利用が可能となりメモリに関するオーダーがO(N)となる。
これらの話は実際にどのような カーネルを利用するかを無視した話だが、たとえばsoftmaxを表現するために必要な指数カーネルの場合はfeature mapが無限次元となるため有限次元のベクトルでは表現できず、厳密に線形化することができない。このため、有限次元かつ厳密なfeature mapを持つ多公式カーネルを用いて近似する。この場合、計算量のオーダーがO(ND^2M)となり(Nがsequence length, Dがqueryとkeyの次元数, Mがvalueの次元数)、softmax attentionの計算量がO(N^2 max(D,M))であることと比較すると、N > D^2である場合に計算効率が改善される。
学習時は並列に学習が可能で、推論時はφ(K_j)V_j^Tを内部状態とみなすと、各タイムステップでRNNのように状態を更新して保持するだけで良い。
(続きはさらに後で読む)
次: DeltaNet
- [Paper Note] Linear Transformers Are Secretly Fast Weight Programmers, Imanol Schlag+, arXiv'21, 2021.02
- [Paper Note] Parallelizing Linear Transformers with the Delta Rule over Sequence Length, Songlin Yang+, NeurIPS'24, 2024.06
次の次: Gated DeltaNet
- [Paper Note] Gated Delta Networks: Improving Mamba2 with Delta Rule, Songlin Yang+, ICLR'25, 2024.12
次の次の次: Kimi Delta Attention (KDA)
- [Paper Note] Kimi Linear: An Expressive, Efficient Attention Architecture, Kimi Team+, arXiv'25, 2025.10
[Paper Note] Reformer: The Efficient Transformer, Nikita Kitaev+, ICLR'20
Paper/Blog Link My Issue
#EfficiencyImprovement #Transformer #Attention #ICLR #Sparse #SparseAttention Issue Date: 2025-08-05 GPT Summary- 本研究では、トランスフォーマーモデルの効率を向上させるために、局所感度ハッシュを用いた注意機構と可逆残差層を提案。これにより、計算量をO($L^2$)からO($L\log L$)に削減し、メモリ効率と速度を向上させたReformerモデルを実現。トランスフォーマーと同等の性能を維持。 Comment
openreview: https://openreview.net/forum?id=rkgNKkHtvB